

Databricks vs. Cloudera: Vergleich und Bewertungen für 2026
Die Entscheidung zwischen Databricks und Cloudera hängt davon ab, wie Ihr Team Daten über Cloud- und hybride Umgebungen hinweg verwaltet. Ich vergleiche ihre Stärken, Kompromisse und am besten geeigneten Anwendungsfälle.

Wir bewerten Tools unabhängig; Provisionen helfen, unsere Tests zu finanzieren. Siehe unsere Transparenzrichtlinie und unsere Methodik.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Databricks vs. Cloudera: Preise & versteckte Kosten
Databricks verwendet eine verbrauchsbasierte Preisgestaltung für Datenengineering, Data Warehousing, KI und andere Arbeitslasten. Die Kosten werden durch die Rechennutzung sowie Cloud-Infrastruktur, Speicher, Netzwerk und Unterstützung bestimmt. Cloudera verfolgt einen hybriden Ansatz: Die Cloud-Dienste werden verbrauchsabhängig über Cloudera Compute Units (CCUs) abgerechnet, während lokale Bereitstellungen auf Jahresabonnements basieren. In beiden Fällen können Infrastruktur und Netzwerk die Gesamtkosten über die grundlegenden Plattformgebühren hinaus erhöhen.
Beim Vergleich der beiden Lösungen ist es hilfreich, über die öffentlich genannten Preise hinauszublicken und zu ermitteln, wo Ihre Arbeitslasten ausgeführt werden und wie häufig Pipelines, Streaming-Aufträge und Transformationen laufen. Bei Databricks können ineffiziente oder lang laufende Rechenprozesse und Datenübertragungen die Ausgaben erhöhen. Bei Cloudera können unterdessen durch Infrastruktur, Netzwerk, Private Link, Überwachung sowie Dienste wie Data Flow oder Lakehouse Optimizer zusätzliche Kosten entstehen. Wenn Sie Bereitstellungsmodell, Arbeitslastvolumen, Unterstützung und Skalierungsanforderungen berücksichtigen, erhalten Sie ein realistischeres Bild der langfristigen Kosten.
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Integration | Databricks | Cloudera |
|---|---|---|
| IntegrationMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntegrationAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntegrationGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntegrationTableau | Databricks✅ | Cloudera✅ |
| IntegrationInformatica | Databricks✅ | Cloudera✅ |
| IntegrationSalesforce | Databricks✅ | Cloudera✅ |
| IntegrationQlik | Databricks✅ | Cloudera✅ |
| IntegrationOracle Database | Databricks✅ | Cloudera✅ |
| IntegrationMongoDB | Databricks✅ | Cloudera✅ |
| IntegrationAPI | Databricks✅ | Cloudera✅ |
| IntegrationZapier | Databricks✅ | Cloudera❌ |
Sowohl Databricks als auch Cloudera unterstützen umfassende Ökosysteme aus Cloud-Plattformen, Datenbanken, BI-Werkzeugen, APIs und Datendiensten. Databricks bindet diese Verbindungen in Lakeflow, Partner Connect und seine verwalteten Datenengineering-Arbeitsabläufe ein, während Cloudera die Konnektivität über Cloud-, lokale und hybride Umgebungen hinweg in den Mittelpunkt stellt.
| Faktor | Databricks | Cloudera |
|---|---|---|
| FaktorVerschlüsselung | DatabricksVerschlüsselt Daten im Ruhezustand und bei der Übertragung und unterstützt kundenseitig verwaltete Schlüssel, cloudnative Schlüsselverwaltung sowie granularen Schutz für verwaltete Daten und KI-Ressourcen. | ClouderaUnterstützt die Verschlüsselung im Ruhezustand und bei der Übertragung, Schlüsselverwaltung und Sicherheitskontrollen in Cloud- und lokalen Umgebungen. |
| FaktorZugriffskontrollen | DatabricksUnity Catalog zentralisiert granular definierte Zugriffsrichtlinien für Daten, Modelle, Anwendungen und KI-Ressourcen und bietet SSO, Identitätsintegrationen, Zeilen- und Spaltenkontrollen sowie Bindungen an Arbeitsbereiche. | ClouderaVerwendet Apache Ranger, Knox und Identitätsintegrationen zur Verwaltung von Authentifizierung, Autorisierung, SSO und granularen Zugriffen in hybriden Umgebungen. |
| FaktorRegulatorische Compliance | DatabricksVerfügt über die Zertifizierungen SOC 1 Type II, SOC 2 Type II, ISO 27001, ISO 27017 und ISO 27018 sowie über Compliance-Unterstützung für HIPAA, PCI DSS, HITRUST und FedRAMP Moderate und High, abhängig von Cloud, Region und Konfiguration. | ClouderaVerfügt über Zertifizierungen und Programme wie SOC 2 Type II, ISO 27001, PCI DSS und FedRAMP Moderate für entsprechende Cloudera-Umgebungen. |
| FaktorZuverlässigkeit | DatabricksUnterstützt automatische Skalierung, serverloses und verwaltetes Computing, Workload-Isolierung und cloudnative Verfügbarkeit über AWS, Azure und Google Cloud hinweg, mit Wiederherstellungsstrategien, die an den Anforderungen der Workloads ausgerichtet sind. | ClouderaUnterstützt Bereitstellungen über mehrere Zonen, redundante Infrastruktur, Ausfallsicherung und Notfallwiederherstellung in Cloud- und hybriden Bereitstellungen. |
| FaktorDatenverwaltung | DatabricksUnity Catalog bietet zentrale Prüfung, Erkennung, Klassifizierung und automatisierte Datenherkunft von Quelldaten über Notebooks, Jobs, Modelle, Dienste und Dashboards hinweg. | ClouderaSDX kombiniert Apache Ranger und Atlas, um Richtlinien, Prüfung, Metadatenverwaltung, Klassifizierung und Datenherkunft für Cloud- und lokale Daten anzuwenden. |
Beide Plattformen bieten Sicherheit und Governance auf Enterprise-Niveau, setzen jedoch unterschiedliche Schwerpunkte. Databricks führt Zugriffskontrolle, Prüfung, Klassifizierung und Datenherkunft über Unity Catalog für Daten- und KI-Workloads zusammen, während Cloudera die zentrale Governance über hybride und lokale Umgebungen hinweg mithilfe von SDX, Ranger und Atlas erweitert.
| Faktor | Databricks | Cloudera |
|---|---|---|
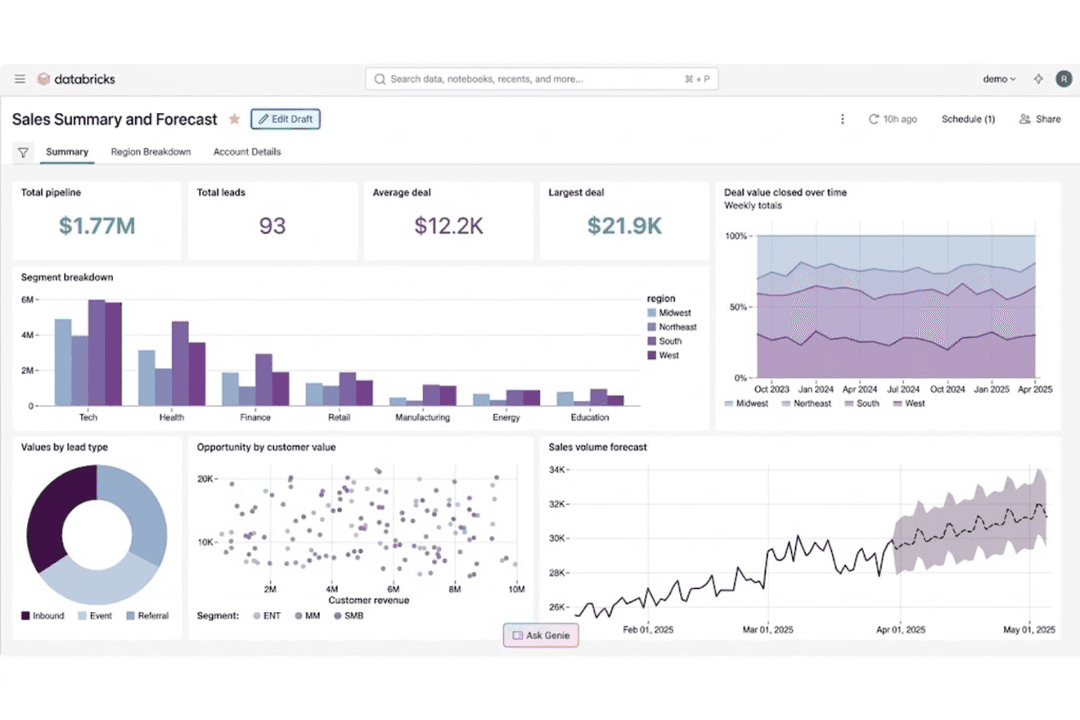
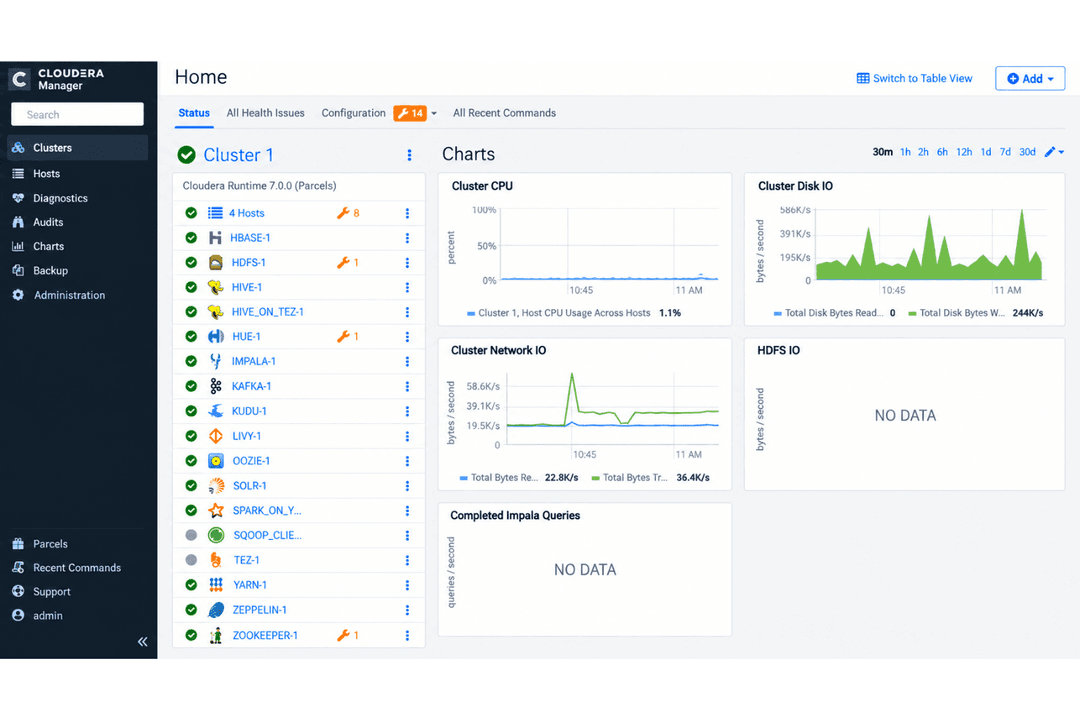
| FaktorBenutzeroberfläche | DatabricksKombiniert kollaborative Notebooks, SQL-Tools, Dashboards und visuelle Workflows in einem Arbeitsbereich für Engineering-, Analyse- und KI-Teams. | ClouderaVerwendet Administrationskonsolen und dienstspezifische Oberflächen zur Verwaltung von Daten und hybrider Infrastruktur. |
| FaktorEinrichtungsprozess | DatabricksCloud-Arbeitsbereiche können schnell bereitgestellt werden, während serverloses und verwaltetes Computing die Infrastrukturkonfiguration für gängige Workloads reduziert. | ClouderaDie Einrichtung hängt vom Bereitstellungsmodell ab und erfordert zusätzliche Konfiguration für hybride und lokale Umgebungen. |
| FaktorEinarbeitung | DatabricksBietet eine geführte Einrichtung, Beispiel-Notebooks, Schulungen und verwaltete Dienste, die Teams beim Übergang von ersten Experimenten zu kontrollierten Produktions-Workflows unterstützen. | ClouderaErfordert Vertrautheit mit dem umfassenderen Ökosystem, insbesondere wenn Teams mit Technologien wie NiFi, Spark, Ranger und hybrider Infrastruktur arbeiten. |
| FaktorDokumentation | DatabricksBietet umfangreiche Dokumentation, Tutorials, Implementierungsanleitungen und Schulungen für Datenengineering, Governance, Analysen und KI. | ClouderaBietet technische Dokumentation für Cloud, lokale Umgebungen, Sicherheit und Plattformadministration. |
| FaktorSupportzugang | DatabricksBietet öffentliche Ressourcen und abgestuften kostenpflichtigen Support mit technischen Ansprechpartnern, Eskalationswegen und Abdeckung kritischer Probleme für Enterprise-Bereitstellungen. | ClouderaUmfasst Unternehmenssupport und technische Ressourcen für Cloud- und lokale Angebote. |
Unter dem Gesichtspunkt der Benutzerfreundlichkeit kombiniert Databricks eine technische Entwicklungsumgebung mit verwalteten Diensten, die den Infrastrukturaufwand für Pipelines, Analysen und KI reduzieren. Cloudera unterstützt Cloud-, lokale und hybride Umgebungen, was zusätzliche Überlegungen bei der Bereitstellung mit sich bringt. Für cloudorientierte Datenteams bietet Databricks einen einheitlichen Workflow von der Entwicklung bis zur Produktion, während Cloudera für Organisationen geeignet ist, die über verschiedene Infrastrukturen hinweg arbeiten müssen.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
Wer sollte Databricks und wer sollte Cloudera verwenden?
Wenn Sie nach einer DataOps-Plattform suchen, die Datenengineering, Analysen, Governance und KI in derselben cloudorientierten Umgebung zusammenführt, ist Databricks wahrscheinlich die bessere Wahl. Die Plattform ist besonders nützlich für Teams, die verwaltete Pipelines, kollaborative Notebooks, Streaming-Unterstützung und zentrale Governance nutzen möchten, ohne so viel Infrastruktur manuell verwalten zu müssen.
Wenn Sie stattdessen Datenverarbeitungs-Workflows über Cloud-, lokale und hybride Umgebungen hinweg ausführen müssen, eignet sich Cloudera möglicherweise besser für Ihre Infrastruktur. Es ist eine starke Wahl für Unternehmen mit strengen Anforderungen an Compliance oder den Speicherort von Daten, etablierten Ökosystemen für quelloffene Software und Teams, die verteilte Datenplattformen über mehrere Umgebungen hinweg verwalten.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |