

Data-Lake-Tools ermöglichen es Ihnen, riesige Mengen strukturierter und unstrukturierter Daten in Ihrem gesamten Unternehmen zu speichern, zu organisieren und zu analysieren. Wenn Sie die besten Data-Lake-Tools vergleichen, können Sie es sich nicht leisten, zu raten – welche Plattform sorgt dafür, dass Ihr Team die Kontrolle über Kosten, Compliance und Leistung behält, während Ihre Daten wachsen?
In diesem Leitfaden stelle ich Ihnen bewährte Optionen vor, mit denen IT-Verantwortliche Governance, Skalierbarkeit, Integration und Zukunftssicherheit gewährleisten können, damit Sie in 2026 selbstbewusst die richtige Grundlage für Analyse- und KI-Workloads auswählen können.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle für Data-Lake-Tools
Diese Vergleichstabelle fasst die Preisdetails meiner Auswahl der besten Data-Lake-Tools zusammen:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten geeignet für automatisch optimierte Apache-Iceberg-Lakehouses | Kostenlose Testversion verfügbar | Ab $300/Monat (jährlich abgerechnet) | Website | |
| 2 | Am besten für die Governance hybrider Lakehouse-Umgebungen in regulierten Unternehmen geeignet | 60-tägige kostenlose Testversion verfügbar | Ab $0.04/CCU/Stunde | Website | |
| 3 | Am besten für ein offenes Iceberg-Lakehouse ohne Anbieterbindung | 30-tägige kostenlose Testversion | Ab $0.20/DCU | Website | |
| 4 | Am besten geeignet für die Governance von Datenlagern in regulierten Branchen | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 5 | Am besten für die Governance über mehrere Engines bei offenen Lake-Tabellen | 90-tägige kostenlose Testversion | Ab $0.12 pro DCU-Stunde | Website | |
| 6 | Am besten für die Datenfreigabe ohne Kopieren über mehrere Clouds hinweg | 30-tägige kostenlose Testversion | Ab $2.00/Guthaben | Website | |
| 7 | Am besten für GCP-natives Lakehouse mit abgestuftem Speicher | Kostenloser Tarif verfügbar | Ab $0.020/GB/Monat | Website | |
| 8 | Am besten für ein Lakehouse auf Basis offener Tabellenformate geeignet | 14-tägige kostenlose Testversion | Ab $0.22/DBU | Website | |
| 9 | Am besten geeignet für Objektspeicher im Kern von AWS Data Lakes | Nicht verfügbar | Ab $0.023/GB/Monat | Website | |
| 10 | Am besten für Microsoft-eigene Unternehmens-Data-Lakes geeignet | $200 Guthaben für 30 Tage (keine dedizierte kostenlose Stufe) | Ab $0.023/GB/Monat | Website |




Bewertungen von Data-Lake-Tools
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Data-Lake-Tools, die es in meine Auswahlliste geschafft haben. Meine Bewertungen bieten einen detaillierten Überblick über die Funktionen, Möglichkeiten und besten Einsatzbereiche jeder Plattform, damit Sie die beste Lösung für Ihre Anforderungen finden.
 1Am besten geeignet für automatisch optimierte Apache-Iceberg-Lakehouses
Qlik
- Kostenlose Testversion verfügbar
- Ab $300/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.4/5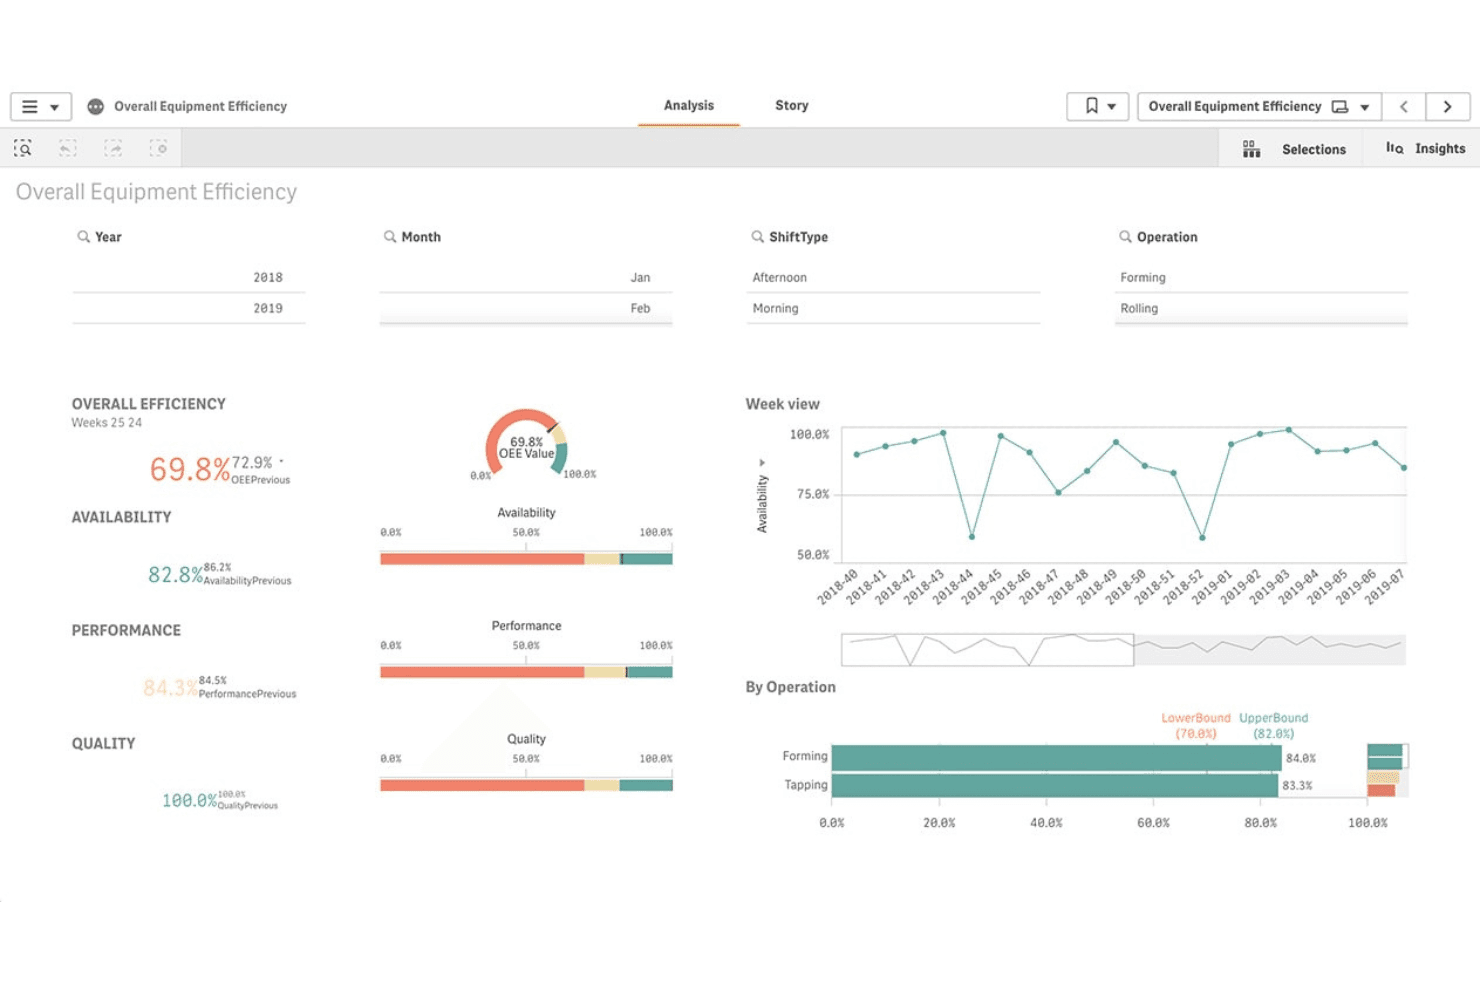
Qlik verfolgt die Gesamtanlageneffektivität mit Live-KPI-Dashboards. Qlik ist eine nativ auf Apache Iceberg entwickelte Datenintegrations- und Lakehouse-Plattform, die CDC-basierte Erfassung, automatisierte Schemaentwicklung, Datenpipelines in mehreren Formaten und integrierte Governance in Cloud-Objektspeicherumgebungen kombiniert.
Für wen ist Qlik am besten geeignet?
Qlik eignet sich besonders für große Unternehmen in regulierten Branchen, die End-to-End-Datenintegration, Governance und Lakehouse-Management auf einer einzigen Plattform benötigen.
Warum ich Qlik ausgewählt habe
Ich habe Qlik ausgewählt, weil sich der Adaptive-Iceberg-Optimierer von anderen Lösungen abhebt: Er führt kontinuierlich Komprimierung, Indizierung und Snapshot-Bereinigung für Ihre Iceberg-Tabellen durch, ohne dass eine manuelle Optimierung erforderlich ist. Dadurch werden Abfragegeschwindigkeiten um das 2,5- bis 5-Fache erhöht und Speicherkosten um bis zu 50 % gesenkt. Außerdem nutze ich die Zero-Copy-Spiegelung, um Live-Iceberg-Tabellen direkt nach Snowflake zu übertragen, ohne Daten zu duplizieren oder die Pipeline-Komplexität zu erhöhen.
Wichtige Funktionen von Qlik
- Protokollbasierte CDC-Replikation: Qlik Replicate erfasst Änderungen direkt aus den Transaktionsprotokollen von Datenbanken, ohne dass Agenten erforderlich sind. Dadurch bleiben Daten im Lake aktuell, ohne die Leistung des Quellsystems zu beeinträchtigen.
- Datenpipeline für die Aufnahme mehrerer Formate: Nehmen Sie Daten in den Formaten Parquet, Avro, ORC, JSON und CSV aus mehr als 200 Quellen auf – darunter Datenbanken, SaaS-Anwendungen, SAP, Großrechner und Streaming-Plattformen wie Kafka und Kinesis.
- Spaltenbasierte Datenherkunft und Auswirkungsanalyse: Verfolgen Sie Daten von der Quelle bis zur Nutzung auf Spaltenebene und erhalten Sie so einen klaren Prüfpfad für Governance und Compliance-Berichte.
- Automatisierte Verwaltung von Bronze-, Silber- und Gold-Zonen: Qlik Compose for Data Lakes automatisiert die Schemagenerierung, die Erstellung von Hive-Katalogen und kontinuierliche Zonenaktualisierungen über CDC – dadurch entfällt die manuelle Pipeline-Programmierung für mehrstufige Lake-Architekturen.
Qlik-Integrationen
Qlik unterstützt mehr als 200 Quellen für die Datenaufnahme, darunter Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP und Salesforce. Die Iceberg-Tabellen lassen sich in Spark, Amazon Athena, Trino, Presto, Databricks, Dremio und Tableau integrieren.
Pros and Cons
Pros:
- Automatisch optimierte Verwaltung von Apache-Iceberg-Tabellen
- Fortschrittliche protokollbasierte CDC-Replikation in Echtzeit
- Umfassende Compliance- und Governance-Steuerungen für Unternehmen
Cons:
- Komplexe Plattform mit hohen technischen Anforderungen
- Intransparenter Prozess zur Lizenzierung und Kostenschätzung
Learn more about Qlik: Am besten für die Governance hybrider Lakehouse-Umgebungen in regulierten Unternehmen geeignet
- 60-tägige kostenlose Testversion verfügbar
- Ab $0.04/CCU/Stunde
Visit WebsiteCustomer Rating:4.1/5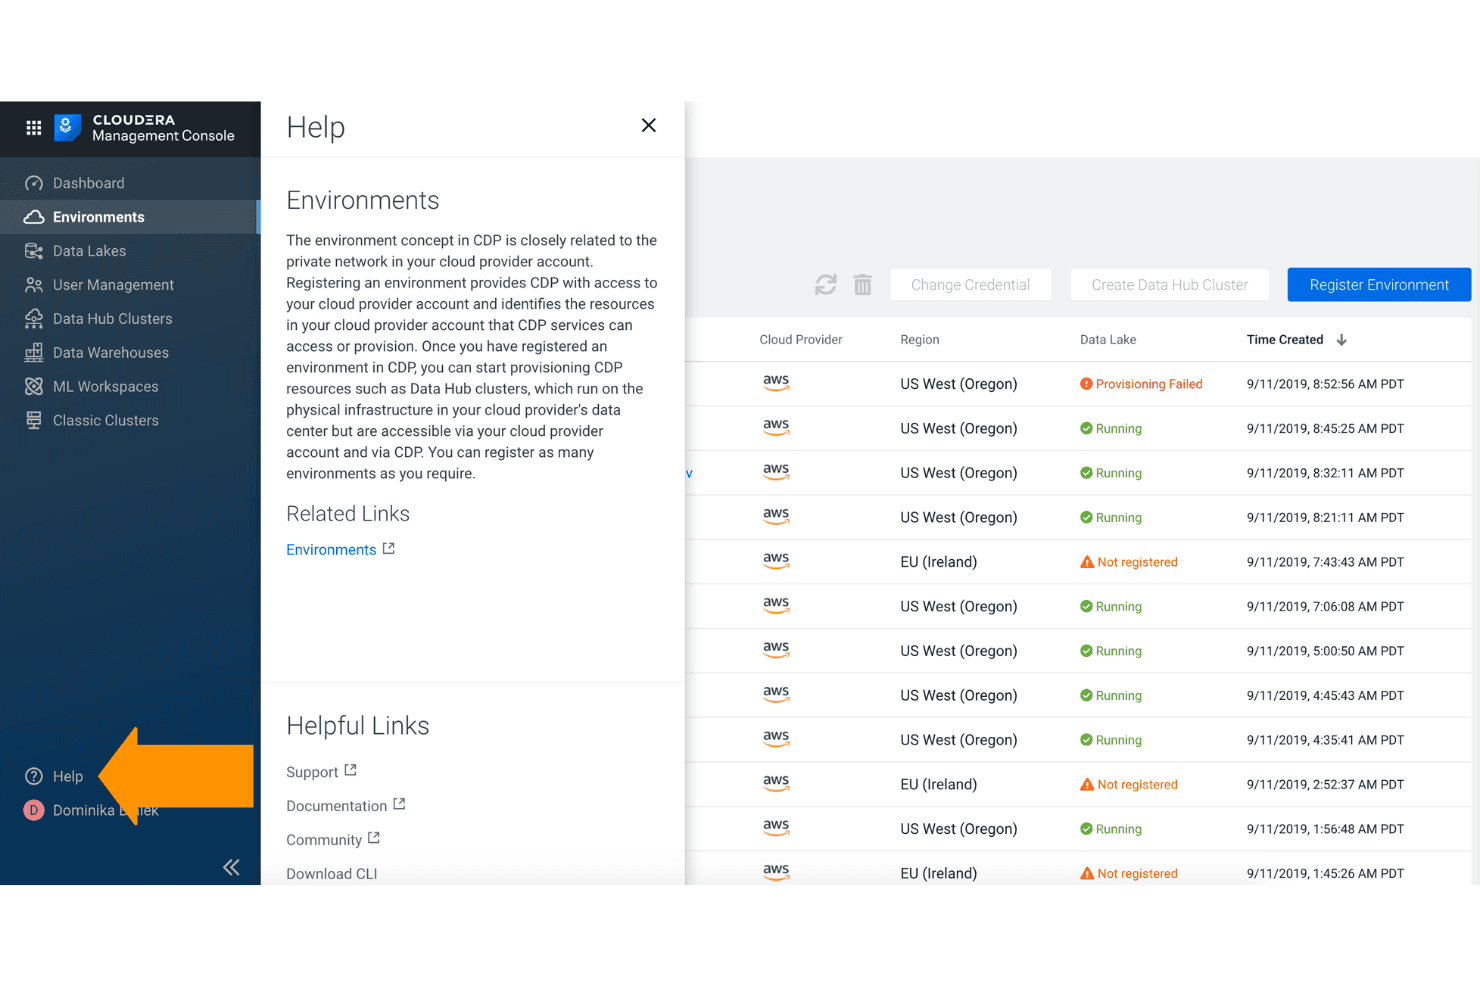
Mit Cloudera können Benutzer Cloud-Umgebungen regionsübergreifend verwalten und überwachen. Cloudera ist eine offene Data-Lakehouse-Plattform, die skalierbaren Multi-Cloud- und On-Premises-Speicher, die Datenaufnahme in mehreren Formaten über mehr als 450 Konnektoren, ein auf Apache Iceberg basierendes Schema-beim-Lesen und eine zentrale Governance über hybride Umgebungen hinweg abdeckt.
Für wen ist Cloudera am besten geeignet?
Cloudera eignet sich besonders für große Unternehmen in regulierten Branchen – Banken, Behörden und Telekommunikationsunternehmen –, die eine einheitliche Governance über On-Premises- und Multi-Cloud-Umgebungen hinweg benötigen.
Warum ich Cloudera ausgewählt habe
Cloudera steht auf meiner Auswahlliste, weil keine andere Plattform eine vergleichbare Governance-Tiefe über hybride Umgebungen hinweg bietet. Besonders beeindruckt mich Cloudera SDX, das Richtlinien von Apache Ranger und Apache Atlas einmal anwendet und überall durchsetzt – unabhängig davon, ob sich Ihre Daten in einem lokalen HDFS-Cluster, Azure ADLS oder AWS S3 befinden. Banken und Behörden mit gemischten Infrastrukturen können Regeln zur Maskierung auf Spaltenebene und ABAC-Richtlinien zentral definieren, wobei die Zertifizierungen nach FedRAMP Moderate und PCI DSS 4.0 die Compliance-Anforderungen zusätzlich untermauern.
Wichtige Funktionen von Cloudera
- Zeitreisen mit Apache Iceberg: Fragen Sie historische Momentaufnahmen Ihrer Daten zu jedem beliebigen Zeitpunkt ab, indem Sie die integrierte Versionierung und Zeitreisefunktionen von Iceberg nutzen.
- Lakehouse-Optimierer: Automatisiert die Kompaktierung von Iceberg-Tabellen, die Z-Reihenfolge und die Partitionsbereinigung, um die Abfrageleistung zu verbessern und Rechenkosten zu senken.
- Visueller Pipeline-Builder für Cloudera Data Flow (NiFi): Entwerfen und implementieren Sie Datenaufnahme-Pipelines über eine Drag-and-Drop-Oberfläche mit mehr als 450 vorgefertigten Prozessoren und Konnektoren.
- Datenaustausch ohne Kopieren über den Iceberg REST Catalog: Externe Engines wie Databricks, Snowflake und Athena können von Cloudera verwaltete Iceberg-Tabellen direkt abfragen, ohne dass Daten verschoben oder dupliziert werden.
Cloudera-Integrationen
Cloudera Data Flow bietet mehr als 450 vorgefertigte Konnektoren, darunter Apache Kafka, MongoDB, Salesforce, Snowflake und Google BigQuery. Über seinen Iceberg REST Catalog lässt es sich außerdem mit AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau und Power BI integrieren.
Pros and Cons
Pros:
- Die Unterstützung hybrider und lokaler Umgebungen ist unübertroffen
- Unternehmensweite Governance für strenge Compliance-Anforderungen
- Datenaustausch ohne Kopieren über externe Abfrage-Engines hinweg
Cons:
- Die Ersteinrichtung erfordert häufig Expertenkenntnisse
- Die Zufriedenheit mit der Metadatenverwaltung liegt unter dem Wettbewerberdurchschnitt
Learn more about Cloudera: Am besten für ein offenes Iceberg-Lakehouse ohne Anbieterbindung
- 30-tägige kostenlose Testversion
- Ab $0.20/DCU
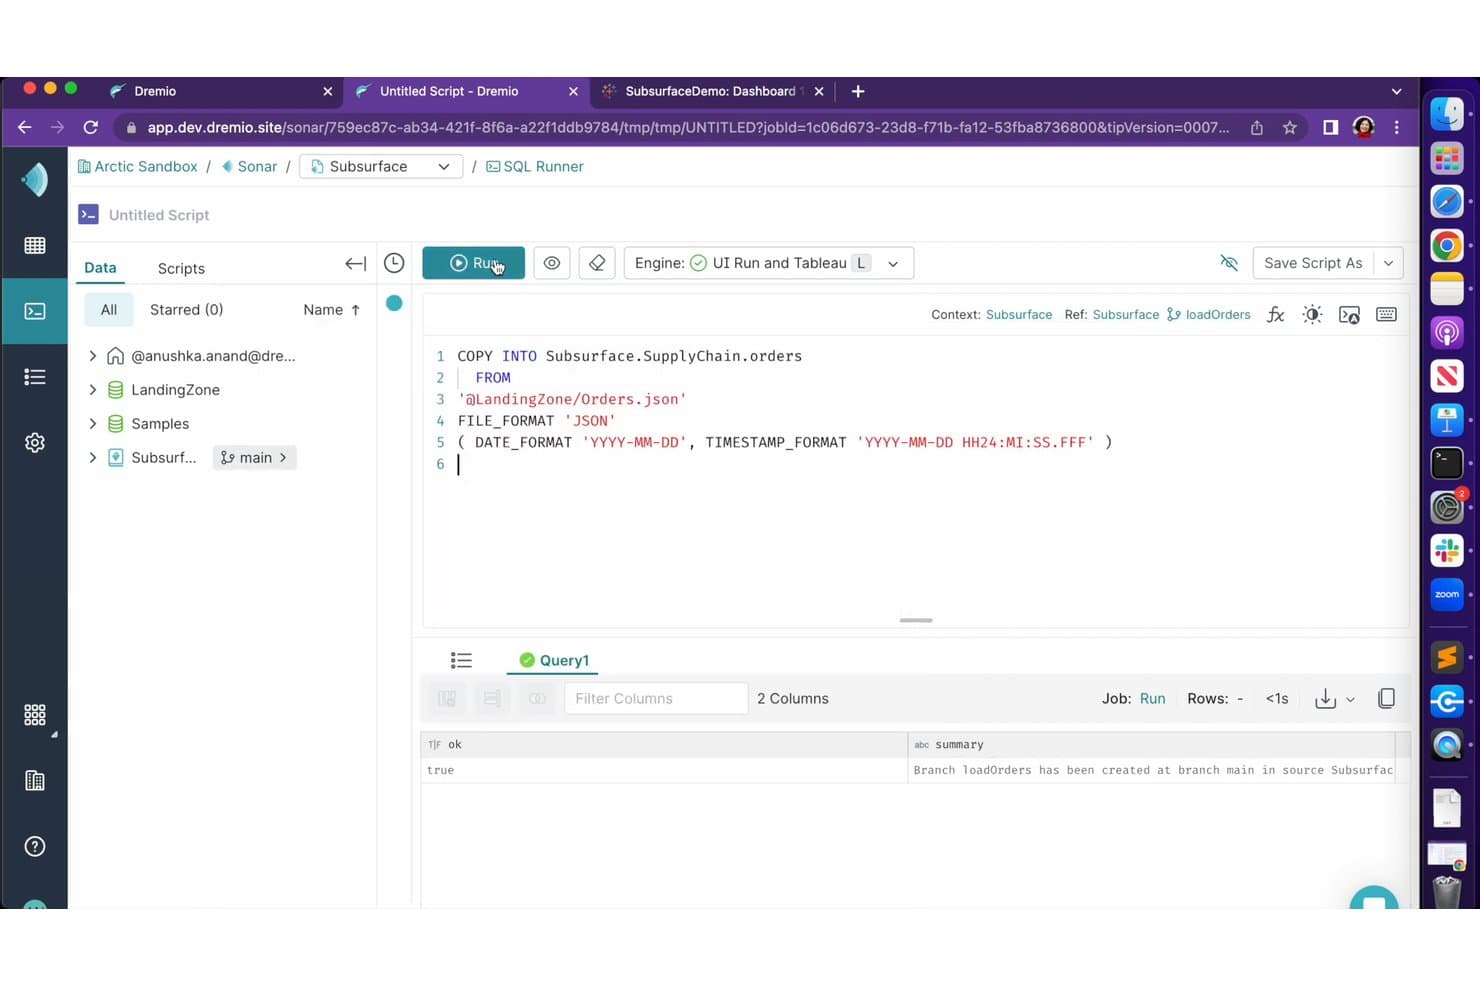
Dremio ermöglicht es Benutzern, JSON-Daten mithilfe von SQL-COPY-INTO-Befehlen in Tabellen zu laden. Dremio ist eine offene Lakehouse-Plattform, die nativ auf Apache Iceberg und Apache Arrow basiert und eine SQL-Abfrage-Engine, föderierten Datenzugriff, automatisierte Abfragebeschleunigung, eine Git-ähnliche Datenversionierung und einen offenen Katalog für mehrere Engines kombiniert.
Für wen eignet sich Dremio am besten?
Dremio eignet sich besonders für Datenengineering- und Datenarchitekturteams, die offene Lakehouses auf Apache Iceberg aufbauen und Abfragen mit mehreren Engines benötigen, ohne an einen proprietären Katalog oder ein proprietäres Speicherformat gebunden zu sein.
Warum ich mich für Dremio entschieden habe
Dremio hat sich seinen Platz auf meiner Auswahlliste verdient, weil es nativ auf Apache Iceberg basiert. Das bedeutet, dass Ihre Daten in Ihren eigenen S3- oder ADLS-Buckets bleiben und jede Engine (Spark, Flink, Trino, DuckDB) sie über den offenen Polaris-Katalog lesen und schreiben kann, ohne dass eine Formatkonvertierung erforderlich ist. Besonders gut gefallen mir die autonomen Reflections, die Abfragemuster unauffällig beobachten und im Hintergrund Beschleunigungen materialisieren, sodass Ihre BI-Dashboards schnelle Ergebnisse liefern, ohne dass eine manuelle Optimierung oder proprietäre Extrakte erforderlich sind.
Wichtige Funktionen von Dremio
- Offener Katalog (Apache Polaris): Ein Katalog für mehrere Engines, der auf Apache Polaris basiert und es Spark, Flink, Trino und DuckDB ermöglicht, Iceberg-Tabellen über eine standardmäßige REST-API zu lesen und zu schreiben.
- Verzweigung von Daten als Code: Die Git-ähnliche Versionskontrolle über Project Nessie erstellt isolierte Datenzweige ohne Datenkopien für Entwicklung, Tests und ML-Experimente mit atomaren Zusammenführungen und Rollbacks.
- COPY INTO-Aufnahme: Ein nativer SQL-Befehl, der CSV-, JSON- und Parquet-Dateien aus dem Objektspeicher direkt in Iceberg-Tabellen lädt und dabei Schemaentwicklung und Partitionsverarbeitung unterstützt.
- Feingranulare Zugriffskontrolle: Sicherheit auf Zeilenebene und Maskierung von Spalten, die zum Abfragezeitpunkt durchgesetzt werden und konsistent für jede Engine gelten, die den Katalog abfragt.
Dremio-Integrationen
Dremio lässt sich mit Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage und Google Cloud Storage integrieren. Die Polaris-REST-Schnittstelle für Kataloge sowie ODBC-, JDBC- und Arrow-Flight-Schnittstellen unterstützen Verbindungen mit benutzerdefinierten Engines und Anwendungen.
Pros and Cons
Pros:
- Verarbeitet Apache Iceberg nativ ohne Konvertierung
- Git-ähnliche Datenverzweigung für Zeitreisen
- Offener REST-Katalog verbindet jede Abfrage-Engine
Cons:
- Höherer Verwaltungsaufwand als bei vergleichbaren Tools
- Kein dedizierter integrierter ML-Feature-Store
Learn more about Dremio: Am besten geeignet für die Governance von Datenlagern in regulierten Branchen
- Kostenlose Demo verfügbar
- Preis auf Anfrage
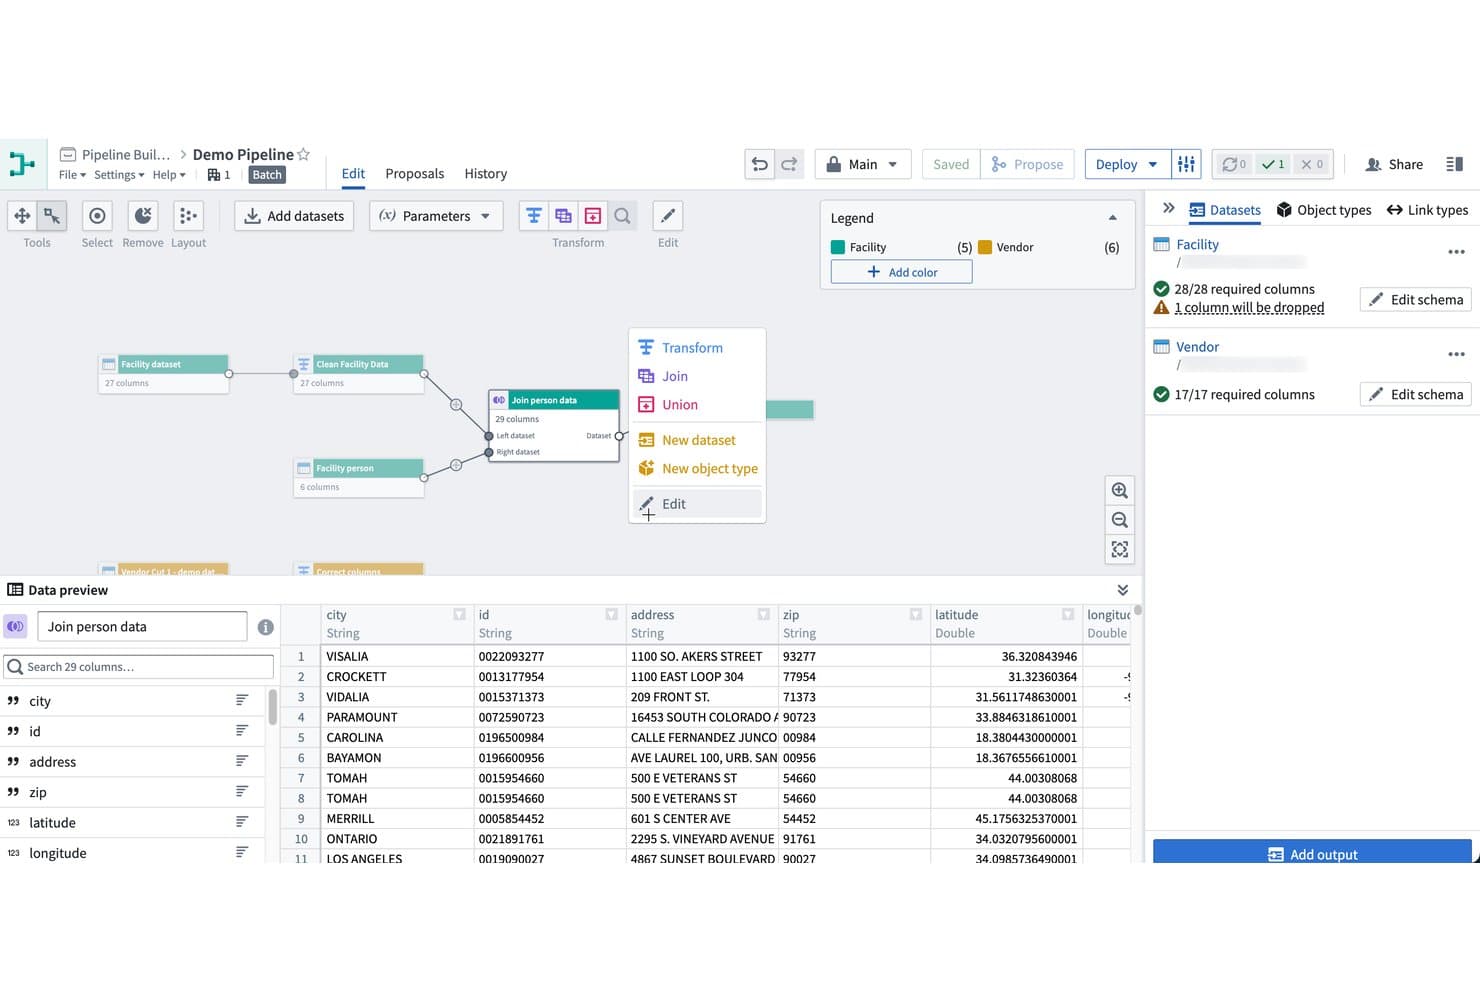
Mit Palantir Foundry können Benutzer Datensätze in Pipelines visuell erstellen und verknüpfen. Palantir Foundry ist eine Datenlake-Plattform, die die Aufnahme von Daten in mehreren Formaten, die Orchestrierung von Pipelines, die semantische Datenmodellierung über ihre Ontologie-Schicht und integrierte Governance-Kontrollen in Cloud-, lokalen und isolierten Umgebungen kombiniert.
Für wen ist Palantir Foundry am besten geeignet?
Palantir Foundry wurde speziell für große Unternehmen in regulierten Branchen wie Finanzwesen, Gesundheitswesen, Verteidigung und Regierung entwickelt, die eine granulare Daten-Governance in komplexen Umgebungen mit mehreren Datenquellen benötigen.
Warum ich Palantir Foundry ausgewählt habe
Ich habe Palantir Foundry ausgewählt, weil seine Governance-Architektur in regulierten Branchen tatsächlich konkurrenzlos ist. Die Plattform kombiniert zweckbasierte, klassifizierungsbasierte und rollenbasierte Zugriffskontrollen, wobei Datenmarkierungen automatisch entlang der Datenherkunft weitergegeben werden, sodass eine PII-Kennzeichnung an einem Quelldatensatz den Daten durch jede nachgelagerte Transformation folgt. In Kombination mit den Zertifizierungen FedRAMP High, HIPAA, ITAR und SOC 2 Type 2 sowie der Ontologie-Schicht, die Rohdaten aus dem Datenlake auf prüfbare Geschäftsobjekte abbildet, ergibt sich eine Plattform, die von Grund auf für Umgebungen entwickelt wurde, in denen Governance keine optionale Funktion ist.
Wichtigste Funktionen von Palantir Foundry
- Über 200 vorgefertigte Datenkonnektoren: Stellen Sie über eine einheitliche Aufnahmeschnittstelle Verbindungen zu Datenbanken, Datenlagern, Streaming-Plattformen, ERP-Systemen, Cloud-Speichern, IoT-Quellen und Geodatenwerkzeugen her.
- Apache-Iceberg-REST-Katalog: Machen Sie Foundry-Datensätze externen, mit Iceberg kompatiblen Verarbeitungs-Engines zugänglich – darunter Trino, Spark, Flink, Databricks und Snowflake – ohne Daten zu duplizieren.
- Virtuelle Tabellen für eine Föderierung ohne Datenkopien: Fragen Sie externe Tabellen in Databricks, Snowflake und S3-kompatiblen Speichern direkt aus Foundry ab, ohne die zugrunde liegenden Daten aufzunehmen oder zu verschieben.
- AIP-Modellstudio: Erstellen, trainieren, evaluieren und stellen Sie ML-Modelle innerhalb von Foundry bereit – mit nativem Zugriff auf LLMs und Unterstützung für Python- und R-Entwicklungsumgebungen.
Integrationen von Palantir Foundry
Palantir Foundry bietet über 200 native Datenkonnektoren, darunter Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau und Power BI. Darüber hinaus werden benutzerdefinierte Verbindungen über die S3-kompatible API, den Iceberg-REST-Katalog und virtuelle Tabellen unterstützt.
Pros and Cons
Pros:
- Branchenführende Daten-Governance für Compliance
- Die Ontologie-Schicht ermöglicht Geschäftsanwendern den Datenzugriff
- Datenfreigabe ohne Datenkopien mit virtuellen Tabellen
Cons:
- Hohe Vertragspreise bei unklaren Gesamtkosten
- Risiko einer Plattformbindung aufgrund proprietärer Modelle
Learn more about Palantir Foundry: Am besten für die Governance über mehrere Engines bei offenen Lake-Tabellen
- 90-tägige kostenlose Testversion
- Ab $0.12 pro DCU-Stunde
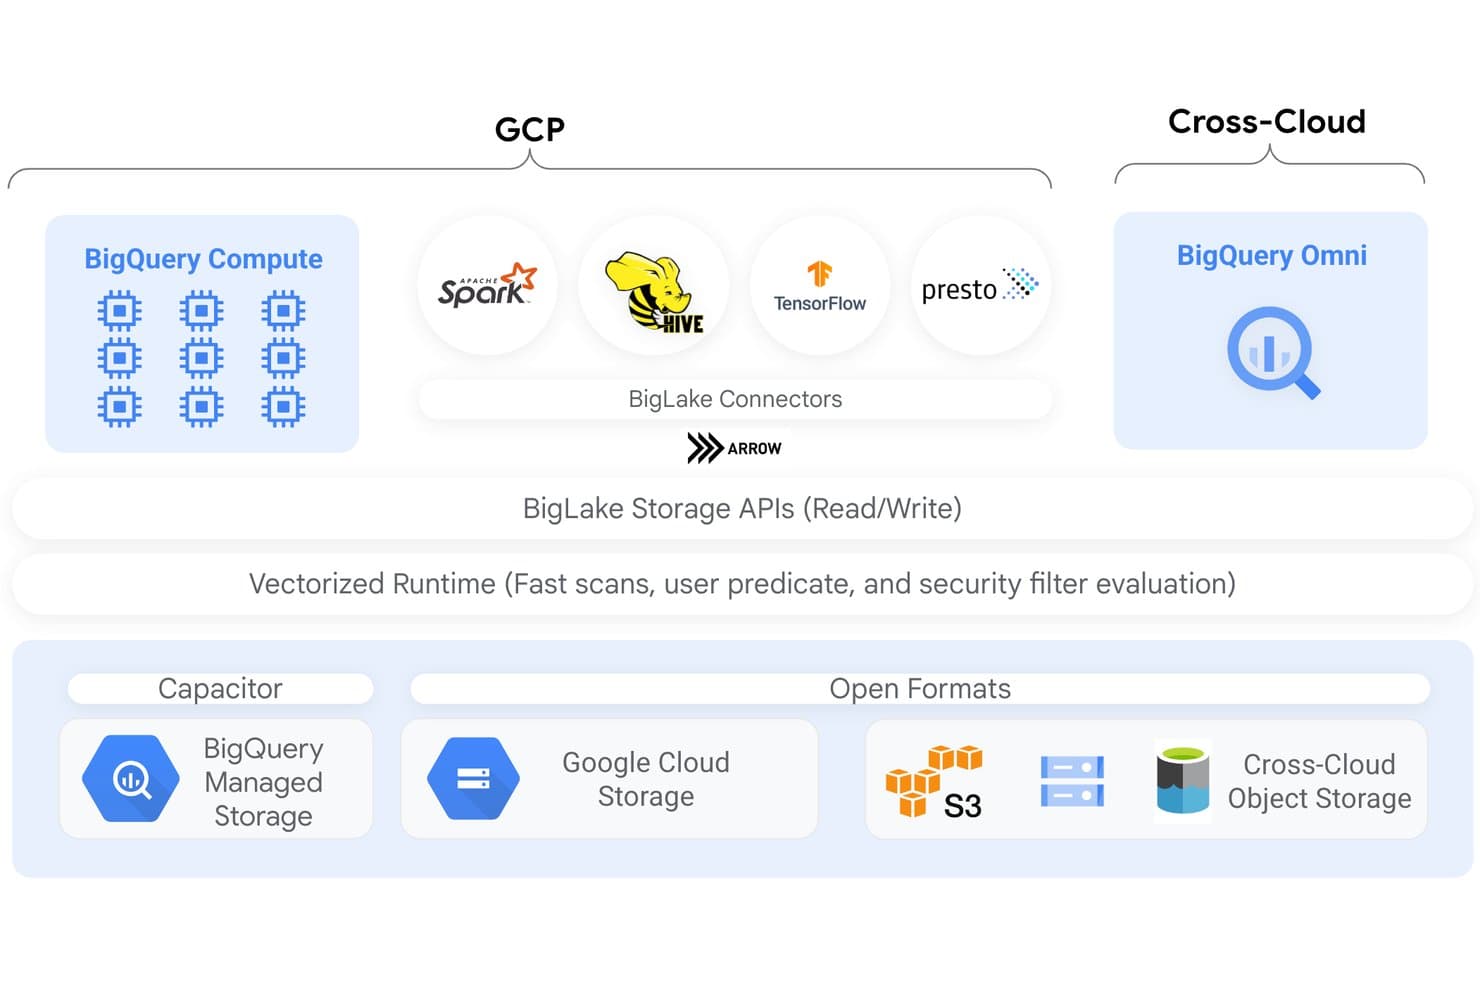
BigLake vereinheitlicht Rechenleistung und Speicher über GCP und cloudübergreifende Umgebungen hinweg. BigLake ist die Lakehouse-Plattform von Google, die BigQuery um Unterstützung für Tabellen in offenen Formaten, den Zugriff durch mehrere Abfrage-Engines, eine einheitliche Metadatenverwaltung und detaillierte Governance für GCS, S3 und Azure Blob Storage erweitert.
Für wen eignet sich BigLake am besten?
BigLake eignet sich besonders für Datenengineering- und Architekturteams, die bereits in Google Cloud investieren und eine konsistente Governance über mehrere Abfrage-Engines und offene Tabellenformate hinweg benötigen.
Warum ich BigLake ausgewählt habe
Ich habe BigLake als eine der besten Lösungen ausgewählt, weil es die einzige Lakehouse-Plattform ist, die ich kenne, die Zugriffsrichtlinien auf Zeilen- und Spaltenebene konsistent über BigQuery, Spark, Trino und Presto hinweg durchsetzt und nicht nur innerhalb einer einzelnen Engine. Das bedeutet, dass ein auf eine sensible Spalte angewendetes Richtlinien-Tag den Daten folgt, unabhängig davon, über welche Engine Ihr Team darauf zugreift. Der Lakehouse-Iceberg-REST-Katalog macht dies möglich, indem er als einheitlicher, governancefähiger Endpunkt für alle Open-Source-Abfrage-Engines dient, die dieselben Iceberg-Tabellen lesen und schreiben.
Wichtige Funktionen von BigLake
- Automatisierte Tabellenwartung: BigLake übernimmt automatisch die Dateikomprimierung, Clusterbildung, Speicherbereinigung und Metadatengenerierung für in GCS gespeicherte Iceberg-Tabellen.
- Datenaufnahme in mehreren Formaten: Nehmen Sie Daten in Parquet, ORC, Avro, CSV, JSON und offenen Tabellenformaten wie Apache Iceberg, Delta Lake und Apache Hudi über Manifestdateien auf.
- Cloudübergreifende Abfragen mit BigQuery Omni: Führen Sie BigQuery-SQL-Abfragen direkt für Daten aus, die in Amazon S3 oder Azure Data Lake Storage Gen 2 gespeichert sind, ohne sie nach GCS zu verschieben.
- Replikation mittels Change Data Capture: Streamen Sie operative Daten aus Cloud Spanner, AlloyDB und Cloud SQL direkt in BigLake-Tabellen, um Analysen nahezu in Echtzeit zu ermöglichen.
BigLake-Integrationen
BigLake bietet native Integrationen mit BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker und Vertex AI. Sein Iceberg-REST-Katalog verbindet Open-Source-Abfrage-Engines mit gemeinsam genutzten Lake-Tabellen.
Pros and Cons
Pros:
- Sicherheit auf Zeilen- und Spaltenebene wird über mehrere Engines hinweg durchgesetzt
- Offene Tabellenformate mit vollständiger Iceberg-Unterstützung
- Katalogföderation für die Verwaltung von Metadaten in mehreren Clouds
Cons:
- DML wird für externe Tabellen, die nicht auf Iceberg basieren, nicht unterstützt
- CMEK ist für zwischengespeicherte S3- oder Azure-Tabellen nicht verfügbar
Learn more about BigLake: Am besten für die Datenfreigabe ohne Kopieren über mehrere Clouds hinweg
- 30-tägige kostenlose Testversion
- Ab $2.00/Guthaben
Visit WebsiteCustomer Rating:4.6/5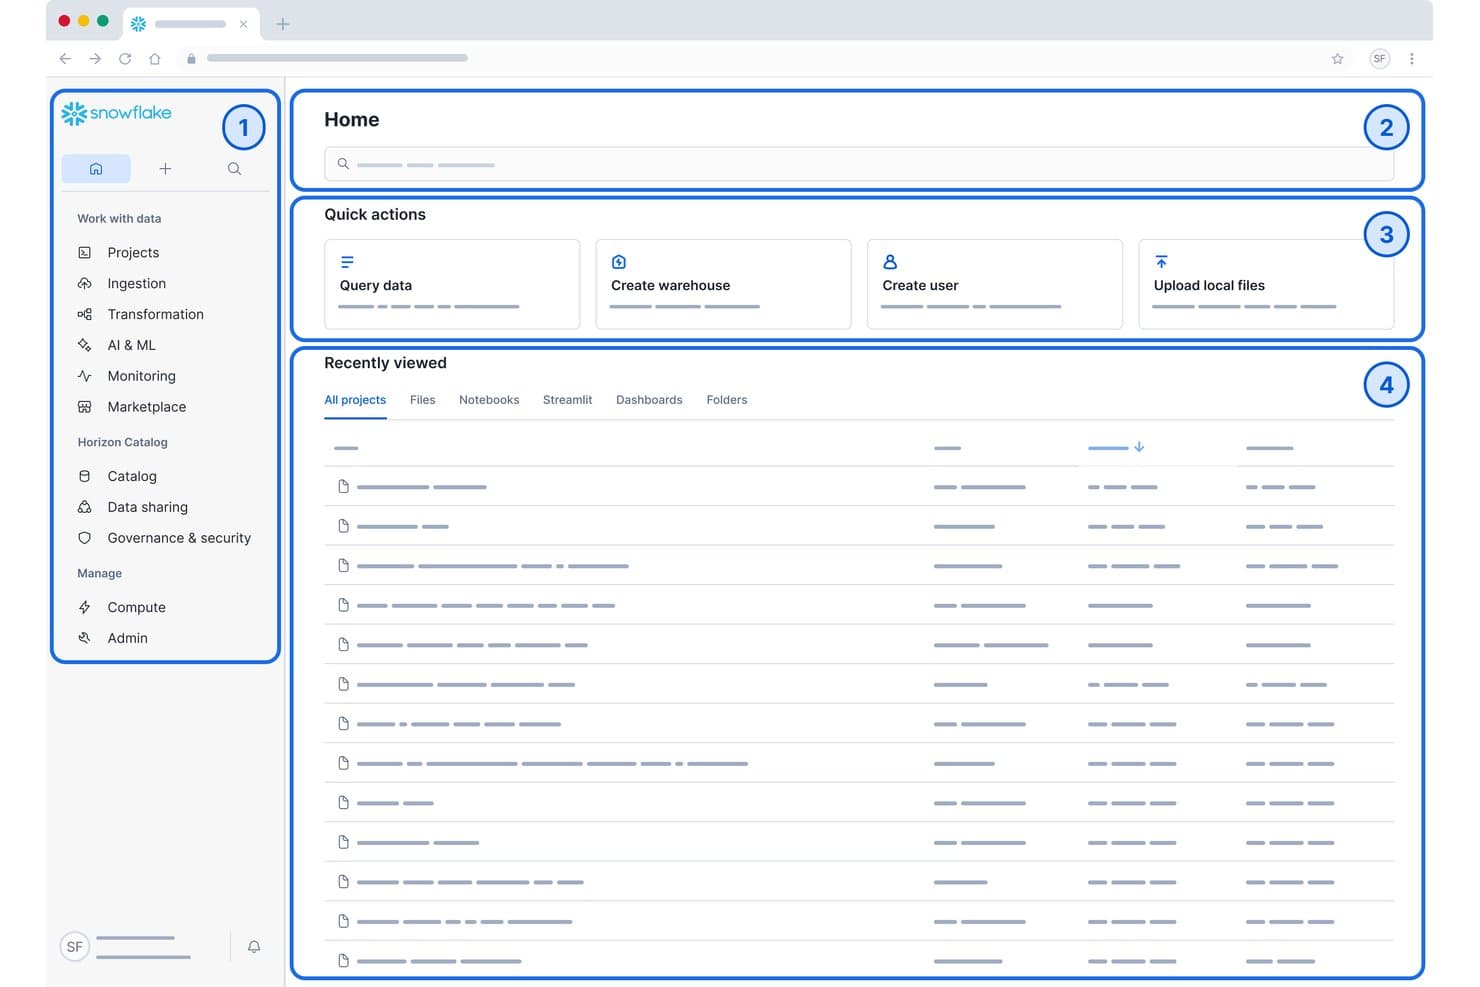
Das Snowflake-Startdashboard zentralisiert Datenabfragen, die Erstellung von Warehouses und aktuelle Projekte. Snowflake ist eine cloudnative Data-Lake- und Analyseplattform, die elastischen Speicher, eine integrierte SQL-Abfrage-Engine, Snowpark für Python-/Java-/Scala-Workloads, Unterstützung für Apache Iceberg und die Datenfreigabe ohne Kopieren über AWS, Azure und GCP hinweg kombiniert.
Für wen eignet sich Snowflake am besten?
Snowflake eignet sich besonders für Datenteams in Unternehmen, die große Multi-Cloud-Umgebungen verwalten und für die Governance, Compliance und der organisationsübergreifende Datenaustausch unverzichtbare Anforderungen sind.
Warum ich Snowflake ausgewählt habe
Snowflake steht auf meiner engeren Auswahlliste, weil die Datenfreigabe ohne Kopieren das Teilen von Live-Datensätzen über AWS-, Azure- und GCP-Konten hinweg ermöglicht, ohne auch nur ein Byte zu duplizieren oder zu verschieben. Ich habe mit dem Snowflake Marketplace gearbeitet, der Verbindungen zu mehr als 820 Datenanbietern herstellt, und die cloudübergreifende automatische Bereitstellung macht das Teilen über Regionen hinweg tatsächlich reibungslos. In Kombination mit der nativen Unterstützung für Apache Iceberg und Snowpipe Streaming, das mehr als 1 Mio. Transaktionen pro Sekunde verarbeitet, ergibt sich eine Data-Lake-Plattform für den echten Einsatz in Unternehmen jeder Größenordnung.
Hauptfunktionen von Snowflake
- Mehrsprachige Snowpark-Laufzeitumgebung: Schreiben Sie Data-Engineering- und ML-Workloads in Python, Java oder Scala und führen Sie sie direkt in der Abfrage-Engine von Snowflake aus, ohne Daten nach außen zu verschieben.
- Unterstützung für Apache-Iceberg-Tabellen: Speichern und verwalten Sie Daten im offenen Iceberg-Tabellenformat auf von Snowflake verwaltetem Speicher, mit Schemaentwicklung, Zeitreise und Interoperabilität mit Spark, Trino und Flink.
- Horizon-Katalog: Eine integrierte Governance-Ebene mit Nachverfolgung der Datenherkunft auf Spaltenebene, automatisierter PII-Klassifizierung, KI-gestützter Anreicherung von Metadaten und Datenmetrikenfunktionen zur kontinuierlichen Überwachung der Datenqualität.
- Snowpipe Streaming: Erfassen Sie Daten auf Zeilenebene in Echtzeit mit mehr als 1 Mio. Transaktionen pro Sekunde direkt in Snowflake- oder Apache-Iceberg-Tabellen, ohne Verzögerungen durch Stapelverarbeitung.
Snowflake-Integrationen
Snowflake bietet native Integrationen mit Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker und Apache Airflow. Es stellt Verbindungen zu Apache Spark, Trino, Amazon S3, Azure Blob Storage und Google Cloud Storage her und bietet APIs für benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Datenfreigabe ohne Kopieren über mehrere Clouds hinweg
- Integrierte Governance und Datenherkunft auf Spaltenebene
- Elastische Trennung von Speicher und Rechenleistung
Cons:
- Keine Unterstützung für die Bereitstellung vor Ort
- Die Kostenverfolgung kann schwierig sein
Learn more about Snowflake: Am besten für GCP-natives Lakehouse mit abgestuftem Speicher
- Kostenloser Tarif verfügbar
- Ab $0.020/GB/Monat
Visit WebsiteCustomer Rating:4.3/5
Google Cloud Storage zeigt Dashboards zur Überwachung von GKE-Apps mit Pod-Ereignissen und Latenzmetriken. Google Cloud Storage ist ein verwalteter Objektspeicherdienst für Lakehouse-Architekturen, der abgestufte Speicherklassen, Unterstützung für offene Tabellenformate über Apache Iceberg und BigLake sowie eine enge Integration mit BigQuery, Dataflow, Dataproc und Vertex AI bietet.
Für wen eignet sich Google Cloud Storage am besten?
Google Cloud Storage eignet sich besonders für Datenengineering- und Infrastrukturteams, die bereits im GCP-Ökosystem arbeiten und einen skalierbaren Objektspeicher als Grundlage einer Lakehouse-Architektur benötigen.
Warum ich Google Cloud Storage ausgewählt habe
Ich habe Google Cloud Storage ausgewählt, weil es die native Grundlage für ein GCP-basiertes Lakehouse bildet und abgestufte Speicherklassen bietet (von Standard bis Archive für $0.0012/GB/Monat). Außerdem verschiebt Autoclass Objekte automatisch anhand ihrer Zugriffsmuster zwischen den Speicherklassen. Besonders überzeugend finde ich BigLake: Es ergänzt direkt auf GCS-basierten Apache-Iceberg-Tabellen ACID-Transaktionen, Zeitreisen und die Weiterentwicklung von Schemata und verwandelt so den reinen Objektspeicher in ein abfragbares Lakehouse, ohne Daten verschieben zu müssen. BigQuery kann anschließend dieselben Iceberg-Tabellen direkt abfragen, ohne dass ein Export erforderlich ist.
Wichtige Funktionen von Google Cloud Storage
- Aufnahme in mehreren Formaten: Storage Transfer Service, Dataflow, Pub/Sub und Datastream unterstützen die stapelweise und kontinuierliche Datenaufnahme sowie CDC-Aufnahme aus Datenbanken wie MySQL, PostgreSQL und Oracle in GCS.
- Governance und Zugriffskontrollen: IAM-basierte Berechtigungen, CMEK-/CSEK-Verschlüsselung, VPC Service Controls, Cloud DLP und Audit-Protokollierung sorgen für Sicherheit bei allen gespeicherten Daten.
- Metadatenerkennung über den Knowledge-Katalog: Dataplex durchsucht GCS-Buckets automatisch, um Schemata zu extrahieren, Geschäftsglossare zu erstellen und eine durchgängige Datenherkunft über GCS und BigQuery hinweg zu erzeugen.
- Abfrageunterstützung für mehrere Engines: GCS-basierte Iceberg-Tabellen können über den Iceberg REST Catalog mit BigQuery, serverlosem Spark, Trino, Flink und Presto abgefragt werden.
Integrationen von Google Cloud Storage
Google Cloud Storage bietet native Integrationen mit BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker und dem Knowledge-Katalog. REST-, XML-, gRPC- und Client-Bibliotheks-APIs unterstützen benutzerdefinierte Integrationen mit Datenplattformen und Datenverarbeitungs-Engines.
Pros and Cons
Pros:
- Lakehouse-Unterstützung mit Apache-Iceberg-Tabellen
- Analysen mit mehreren Engines über BigQuery und Spark
- Automatisierte Archivierung und Optionen zur Speicherklassenverwaltung
Cons:
- Für die meisten Funktionen sind mehrere GCP-Dienste erforderlich
- Komplexe Abrechnung mit separaten Gebühren für Vorgänge und ausgehenden Datenverkehr
Learn more about Google Cloud Storage: Am besten für ein Lakehouse auf Basis offener Tabellenformate geeignet
- 14-tägige kostenlose Testversion
- Ab $0.22/DBU
Databricks visualisiert Avocado-Verkaufsdaten in interaktiven Dashboard-Diagrammen. Die Databricks-Lakehouse-Plattform ist eine cloudnative Daten-Lakehouse-Plattform, die Datenengineering, SQL-Analysen, maschinelles Lernen und KI-Entwicklung auf offenen Tabellenformaten wie Delta Lake, Apache Iceberg und Apache Hudi vereint.
Für wen eignet sich die Databricks-Lakehouse-Plattform am besten?
Databricks eignet sich besonders für Daten- und ML-Teams in Unternehmen, die Engineering-Pipelines, SQL-Analysen und KI-Workloads auf einer einzigen Plattform ausführen müssen, ohne Daten zwischen Systemen zu verschieben.
Warum ich die Databricks-Lakehouse-Plattform ausgewählt habe
Databricks steht auf meiner engeren Auswahlliste, weil das Team Delta Lake tatsächlich entwickelt hat. Diese Entstehungsgeschichte ist wichtig, wenn man die Unterstützung offener Tabellenformate bewertet. Ich habe mit der nativen Unterstützung der Plattform für Delta Lake, Iceberg und Hudi gearbeitet. Was sie auszeichnet, ist, dass ACID-Transaktionen, Zeitreisen und Schemaentwicklung keine nachträglich hinzugefügten Funktionen sind. Unity Catalog ergänzt dies direkt um eine automatisierte Herkunftsverfolgung auf Spaltenebene und eine attributbasierte Zugriffskontrolle, sodass die Governance die Daten cloudübergreifend begleitet.
Wichtige Funktionen der Databricks-Lakehouse-Plattform
- Lakeflow Connect: Eine verwaltete, serverlose Erfassungsschicht mit mehr als 100 nativen Konnektoren für SaaS-Anwendungen, Datenbanken, Cloud-Speicher und Streaming-Quellen wie Kafka, Kinesis und Event Hubs.
- Deklarative Apache-Spark-Pipelines: Ein Framework zum Erstellen von Batch- und Echtzeit-Streaming-ETL-Pipelines mit integrierter, auf Einschränkungen basierender Durchsetzung der Datenqualität und automatisierter CDC.
- Databricks-SQL-Warehouses: Eine durch Photon beschleunigte SQL-Engine, die ANSI SQL für Analyse-Workloads unterstützt, mit JDBC/ODBC-Konnektivität für BI-Tools wie Tableau, Power BI und Looker.
- MLflow-Integration: Eine verwaltete MLflow-Umgebung für die Nachverfolgung von Experimenten, die Modellregistrierung und die Bereitstellung, die gemeinsam mit Ihren Lake-Daten betrieben und mit dem Merkmalspeicher sowie der Modellbereitstellung verbunden wird.
Integrationen der Databricks-Lakehouse-Plattform
Databricks bietet mehr als 100 native Lakeflow-Connect-Konnektoren, darunter Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive und Google Analytics. Außerdem stellt die Plattform Verbindungen zu Kafka, Kinesis, Event Hubs, S3, ADLS und GCS her und bietet JDBC/ODBC sowie APIs für benutzerdefinierte Konnektivität.
Pros and Cons
Pros:
- Native Unterstützung für Delta Lake, Iceberg und Hudi
- Automatisierte Herkunftsverfolgung auf Spaltenebene mit Unity Catalog
- Integriertes MLflow und ein vereinheitlichtes KI-Ökosystem
Cons:
- DBU- und Cloud-Kosten können schnell steigen
- Keine Option für die Bereitstellung vor Ort verfügbar
Learn more about Databricks Lakehouse Platform: Am besten geeignet für Objektspeicher im Kern von AWS Data Lakes
- Nicht verfügbar
- Ab $0.023/GB/Monat
Amazon S3 analysiert Speichernutzungsmuster, um die Kosten für den Datenabruf zu optimieren. Amazon S3 ist der Objektspeicherdienst von AWS, der als grundlegende Speicherebene für Data Lakes fungiert und jedes Datenformat im Exabyte-Maßstab unterstützt – mit abgestuften Speicherklassen, nativer Apache-Iceberg-Tabellenverwaltung über S3 Tables und tiefer Integration in das AWS-Analyseökosystem.
Für wen ist Amazon S3 am besten geeignet?
Amazon S3 eignet sich für Datenengineering- und Infrastrukturteams, die Analysepipelines auf AWS erstellen und eine bewährte Speichergrundlage im Exabyte-Maßstab benötigen, die direkt mit dem übrigen AWS-Ökosystem verbunden ist.
Warum ich mich für Amazon S3 entschieden habe
Amazon S3 steht auf meiner Auswahlliste, weil es die Objektspeicherebene ist, auf der die meisten produktiven Data Lakes bereits aufgebaut sind. Besonders schätze ich, dass S3 Tables native Apache-Iceberg-Unterstützung mit integrierten ACID-Transaktionen, Zeitreisen und automatischer Kompaktierung bietet und damit das Problem kleiner Dateien löst, das die meisten Lake-Architekturen beeinträchtigt. In Verbindung mit S3 Intelligent-Tiering, das kalte Daten automatisch auf $0.00099/GB/month verschiebt, erhalten Sie eine umfassende Kontrolle über die Speicherkosten ohne manuelle Eingriffe.
Wichtige Funktionen von Amazon S3
- Aufnahme mehrerer Formate: S3 akzeptiert jeden Dateityp – Parquet, ORC, Avro, JSON, CSV und unstrukturierte Formate – über Batch-Uploads, Streaming mit Kinesis und MSK oder ereignisgesteuerte Auslöser mithilfe von S3 Event Notifications.
- Feingranulare Zugriffskontrolle mit Lake Formation: Erzwingen Sie Datenzugriffsrichtlinien auf Tabellen-, Spalten-, Zeilen- und Zellenebene in Ihrem gesamten S3-basierten Data Lake, ohne Daten zu duplizieren.
- S3 Vectors: Ein nativer Speicher- und Abfragedienst für Vektorindizes, der direkt in S3 integriert ist und für semantische Suche sowie Workloads zur retrieval-augmentierten Generierung entwickelt wurde – mit bis zu 90 % geringeren Kosten als herkömmliche Ansätze.
- S3 Inventory: Erstellen Sie geplante Berichte zu Objektattributen, Speicherklasse, Verschlüsselungsstatus und Replikationsstatus in Ihren Buckets für Audit- und Governance-Workflows.
Integrationen von Amazon S3
Amazon S3 bietet native Integrationen in AWS, darunter AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum und Amazon SageMaker. Über dokumentierte Konnektoren und APIs lässt es sich außerdem mit Apache Spark, Trino, Snowflake, Databricks, Tableau und Power BI verbinden.
Pros and Cons
Pros:
- Objektspeicher im Exabyte-Maßstab unterstützt jedes Datenformat
- Integrierte ACID-Iceberg-Tabellen mit automatischer Kompaktierung
- 143 Compliance-Zertifizierungen und Zugriffskontrolle auf Objektebene
Cons:
- Die Preisgestaltung ist komplex und erfordert eine genaue Verwaltung
- Für den Aufbau eines Data Lakes müssen mehrere AWS-Dienste kombiniert werden
Learn more about Amazon S3: Am besten für Microsoft-eigene Unternehmens-Data-Lakes geeignet
- $200 Guthaben für 30 Tage (keine dedizierte kostenlose Stufe)
- Ab $0.023/GB/Monat
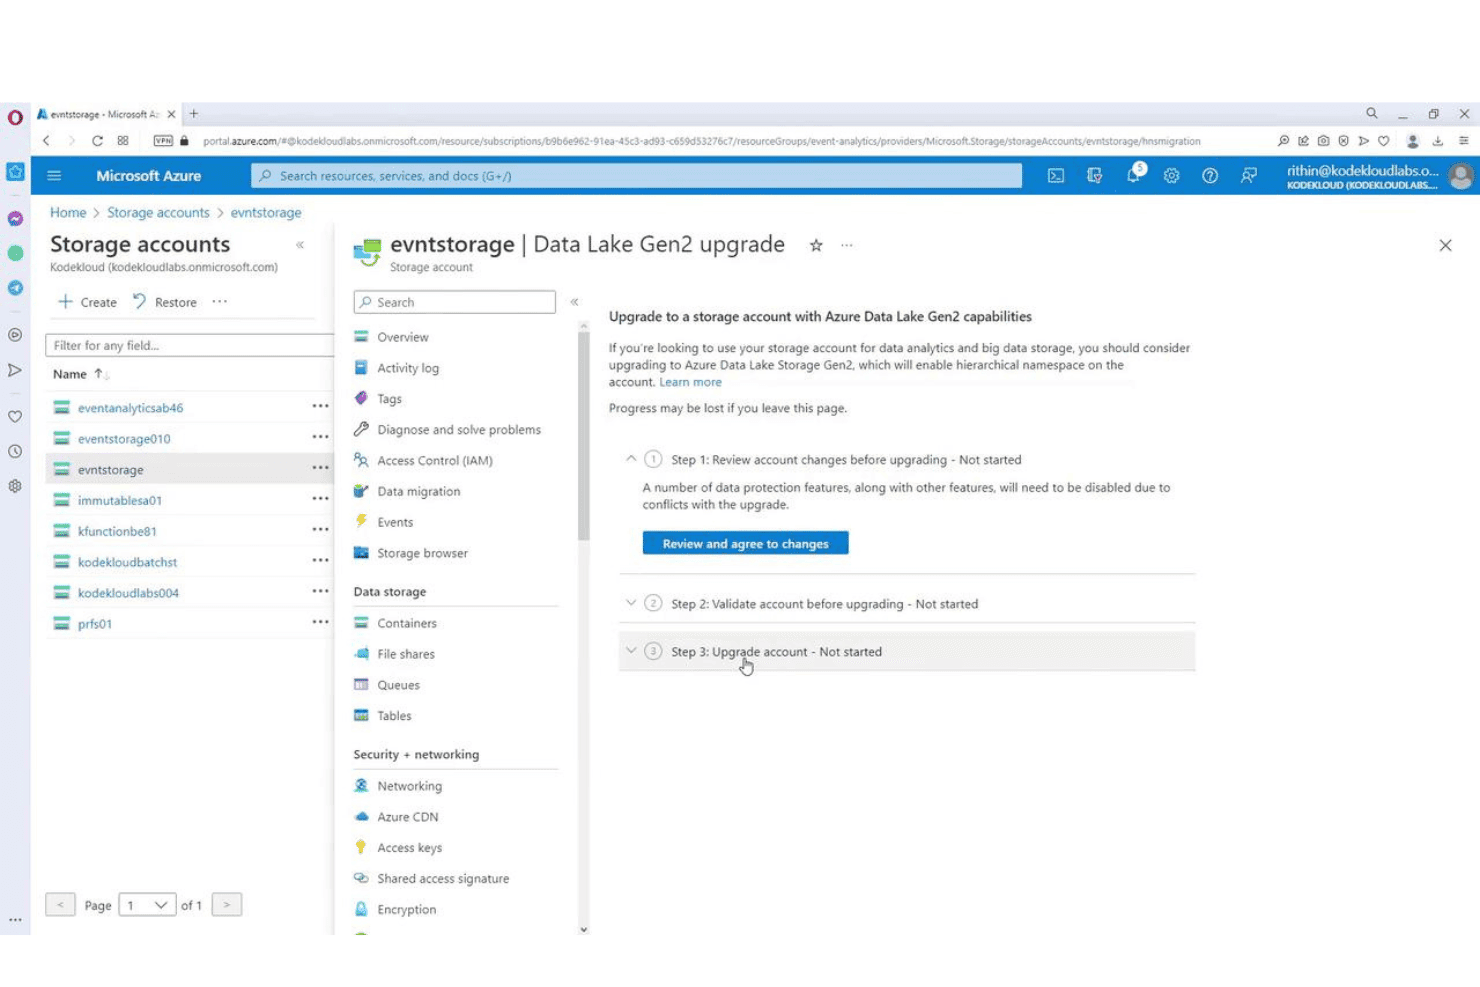
Azure Storage ermöglicht Benutzern, Konten auf Data-Lake-Gen2-Funktionen zu aktualisieren. Azure Data Lake Storage Gen2 ist Microsofts cloudbasierter Data-Lake-Speicherdienst, der auf Azure Blob Storage mit einem hierarchischen Namespace aufbaut und Speicher im Exabyte-Maßstab, die Aufnahme von Daten in mehreren Formaten, POSIX-konforme Zugriffskontrollen sowie native Integration in das Azure-Ökosystem für Analysen und maschinelles Lernen unterstützt.
Für wen eignet sich Azure Data Lake Storage am besten?
Azure Data Lake Storage Gen2 eignet sich besonders für IT- und Datenteams in Unternehmen, die bereits Microsoft Azure nutzen und Speicher im Exabyte-Maßstab benötigen, der eng mit Synapse, Databricks und Microsoft Fabric verbunden ist.
Warum ich mich für Azure Data Lake Storage entschieden habe
Ich habe Azure Data Lake Storage Gen2 als eine der besten Lösungen ausgewählt, weil es die native Speichergrundlage für den gesamten Microsoft-Analyse-Stack bildet und diese enge Verbindung im Unternehmensmaßstab entscheidend ist. Wenn Ihr Unternehmen Synapse, Databricks und Microsoft Fabric nutzt, bildet ADLS Gen2 bereits die zugrunde liegende Schicht für all diese Dienste. Das bedeutet, dass eine einzige Datenkopie von jeder Engine über den ABFS-Treiber abgefragt werden kann. Besonders gefallen mir die POSIX-konformen ACLs, mit denen sich Lese-, Schreib- und Ausführungsberechtigungen auf Ebene einzelner Dateien und Verzeichnisse festlegen lassen, nicht nur auf Containerebene.
Wichtige Funktionen von Azure Data Lake Storage
- Automatisierte Tiering-Richtlinien: Legen Sie Richtlinien fest, die Daten abhängig vom Alter oder vom Zeitpunkt des letzten Zugriffs automatisch zwischen den Ebenen Hot, Cool, Cold und Archive verschieben, um Speicherkosten im großen Maßstab zu verwalten.
- Kompatibilität mit dem ABFS-Treiber: Der Azure Blob File System-Treiber ermöglicht Hadoop-, Spark-, Hive- und HDFS-basierten Workloads den nativen Lese- und Schreibzugriff auf ADLS Gen2, ohne dass Codeänderungen erforderlich sind.
- OneLake-Verknüpfungen: Erstellen Sie Live-Verweise auf Daten in anderen OneLake-Arbeitsbereichen, in Amazon S3 oder in Azure Blob Storage-Containern, ohne die zugrunde liegenden Daten zu kopieren oder zu verschieben.
- Integration in Azure Machine Learning-Datenspeicher: Registrieren Sie ADLS Gen2-Container direkt als Datenspeicher in Azure ML-Arbeitsbereichen und ermöglichen Sie Datenwissenschaftlern so den direkten Zugriff auf Lake-Daten für das Modelltraining und Experimente.
Integrationen von Azure Data Lake Storage
Azure Data Lake Storage bietet native Integrationen im gesamten Microsoft-Ökosystem, darunter Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning und Azure Event Hubs. Außerdem werden Apache Spark und Kafka über dokumentierte Konnektoren sowie ABFS und APIs für den benutzerdefinierten Datenzugriff unterstützt.
Pros and Cons
Pros:
- Native Integration in Microsoft-Analysetools
- Hierarchischer Namespace unterstützt granulare Zugriffskontrolle
- Offene Tabellenformate über die Compute-Ebene
Cons:
- Für erweiterte Datenkatalogisierung ist Purview erforderlich
- Nur auf Microsoft Azure verfügbar
Learn more about Azure Data Lake Storage:
Weitere Data-Lake-Tools
Hier finden Sie einige weitere Data-Lake-Tools, die es nicht in meine Auswahlliste geschafft haben, aber dennoch einen Blick wert sind:
- 11IBM watsonx.dataAm besten geeignet für ein offenes Lakehouse mit Mainframe-Datenzugriff
- 12Microsoft FabricAm besten für die Integration von Datenlakes im Microsoft-Stack geeignet
- 13StarburstAm besten für föderiertes SQL über Multi-Cloud-Datenseen
- 14Alibaba Cloud Hybrid CloudAm besten für hybride Cloud-Datensee-Bereitstellungen im APAC-Raum
- 15Teradata VantageOptimal für KI-/ML-Arbeitslasten mit Daten aus Data Lakes im Petabyte-Maßstab
- 16MinIOIdeal für KI und lokalen Lakehouse-Speicher
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
So wählen Sie Data-Lake-Tools aus
Welche Faktoren beeinflussen tatsächlich, ob ein Data-Lake-Tool die Skalierbarkeit, Governance und Integration bereitstellen kann, die Ihr Team für reale Analyse-Workloads benötigt?
| Wenn Ihre Priorität ... ist | Achten Sie auf ... |
|---|---|
| Wenn Ihre Priorität ... istRegulatorische Compliance | Achten Sie auf ...Integrierte Prüfprotokollierung und Zugriffsrichtlinien |
| Wenn Ihre Priorität ... istMulti-Cloud- oder Hybrid-Bereitstellung | Achten Sie auf ...Native Unterstützung für mehrere Cloud-Anbieter |
| Wenn Ihre Priorität ... istUnabhängigkeit vom Anbieter | Achten Sie auf ...Kompatibilität mit offenen Tabellenformaten |
| Wenn Ihre Priorität ... istAnalyseleistung bei großen Datenmengen | Achten Sie auf ...Gestaffelter Speicher und native Abfrageintegration |
| Wenn Ihre Priorität ... istBereitschaft für KI und ML | Achten Sie auf ...Direkte Konnektoren zu KI-/ML-Tools und -Engines |
So prüfen Sie Ihre Auswahlliste
- Governance-Funktionen bestätigen: Fordern Sie Screenshots der Administrationskonsole an, auf denen die rollenbasierte Zugriffskontrolle und die Einrichtung des Prüfprotokolls zu sehen sind.
- Unterstützung offener Formate testen: Führen Sie in einer Testumgebung einen Live-Import von Parquet- oder Iceberg-Dateien durch und überprüfen Sie die Schemaentwicklung.
- Multi-Cloud-Angaben überprüfen: Bitten Sie um öffentlich zugängliche Dokumentation, die die Bereitstellungsschritte bei mindestens zwei Cloud-Anbietern zeigt.
- Analyseintegration prüfen: Fordern Sie ein Workflow-Beispiel oder eine Konfiguration für Spark, Trino oder Presto mit dokumentierten Abfrageergebnissen an.
- Abwägung – Enterprise-Suite oder offenes Lakehouse: Entscheiden Sie, ob Sie Compliance und Support einer sofort einsatzbereiten Suite benötigen oder ob Flexibilität und Kompatibilität mit einem offenen Stack für Ihre Architektur wertvoller sind.
Was sind Data-Lake-Tools?
Data-Lake-Tools sind Plattformen und Softwarelösungen, die Sie dabei unterstützen, große Mengen strukturierter und unstrukturierter Daten in einem zentralen Repository zu speichern, zu verwalten und zu analysieren. Mit diesen Tools kann Ihr Team Rohdaten aufnehmen, bei Bedarf ein Schema anwenden und Datenbestände für Analyse- oder KI-Projekte organisieren. Sie können Funktionen erwarten, die Governance, Skalierbarkeit und die Integration mit gängigen Abfrage-Engines und Analyseplattformen unterstützen.
Funktionen von Data-Lake-Tools
Achten Sie bei der Auswahl von Data-Lake-Tools auf die folgenden wichtigen Funktionen:
- Skalierbarer Objektspeicher: Ermöglicht das Speichern und Verwalten von Petabytes strukturierter und unstrukturierter Daten sowie die Nutzung von Optionen für abgestuften oder kalten Speicher, um die Kosten zu kontrollieren, wenn Ihr Speicherbedarf wächst.
- Unterstützung für Schema-on-Read: Ermöglicht es, Rohdaten zunächst zu speichern und ein Schema erst später zum Abfragezeitpunkt anzuwenden. Dadurch lassen sich vielfältige, sich weiterentwickelnde Datensätze einfacher verarbeiten, ohne sie neu zu laden.
- Datenerfassung in mehreren Formaten: Unterstützt den Import von Daten in verschiedenen Formaten wie Parquet, Avro, JSON, ORC und CSV und verarbeitet sowohl Batch- als auch Streaming-Datenquellen. So sind Sie bei der Ankunft der Daten flexibler.
- Integration von Abfrage-Engines: Bietet Kompatibilität mit Engines wie Spark, Trino, Presto oder Athena, sodass Sie Analyse- und Berichtsauslastungen direkt auf Ihrem Data Lake ausführen können, ohne zusätzliche Middleware zu benötigen.
- Metadaten- und Katalogverwaltung: Umfasst Werkzeuge für die Datenkatalogisierung, die Suche nach Datenbeständen, die Nachverfolgung der Datenherkunft und die Verschlagwortung. Dadurch bleiben Daten organisiert und auffindbar, wenn neue Datensätze hinzukommen.
- Governance und Zugriffskontrollen: Bietet detaillierte Berechtigungen, Verschlüsselung und Prüfprotokollierung, sodass Sie kontrollieren können, wer auf welche Daten zugreift, die Nutzung überwachen und gesetzliche Anforderungen erfüllen können.
- Datenversionierung und Zeitreisen: Ermöglicht es, Änderungen nachzuverfolgen, zu früheren Versionen von Datensätzen zurückzukehren und historische Ansichten zu erhalten. Dies ist für Auditing, Wiederherstellung und Reproduzierbarkeit wertvoll.
- Integration mit Orchestrierungswerkzeugen: Stellt native Verbindungen zu Workflow-Orchestratoren wie Apache Airflow her, sodass Sie Datenpipelines automatisieren und Aufgaben systemübergreifend koordinieren können.
- Werkzeuge zur Überwachung und Kostenverwaltung: Bietet Dashboards und Warnmeldungen zur Speichernutzung, zu Zugriffsmustern und zu Kosten, sodass Sie Ihre Umgebung effizient und budgetfreundlich halten können.
- Unterstützung für offene Tabellenformate: Unterstützt Formate wie Delta Lake oder Apache Iceberg und ermöglicht fortgeschrittene Funktionen wie ACID-Transaktionen sowie die Interoperabilität mit mehreren Analysewerkzeugen.
Häufige KI-Funktionen von Data-Lake-Tools
Über die oben aufgeführten Standardfunktionen von Data-Lake-Tools hinaus integrieren viele dieser Lösungen KI mit Funktionen wie:
- Automatisierte Datenklassifizierung: Verwendet KI-Modelle, um eingehende Daten anhand ihres Inhalts, ihrer Sensibilität oder von Compliance-Anforderungen zu prüfen und zu kategorisieren. Dies hilft Ihrem Team, Datenbestände schneller zu organisieren und die richtigen Zugriffskontrollen ohne manuelle Verschlagwortung anzuwenden.
- Anomalieerkennung für die Datenqualität: Wendet Algorithmen des maschinellen Lernens an, um Datenströme zu überwachen und ungewöhnliche Muster, fehlende Werte oder Ausreißer zu kennzeichnen. So können Sie Probleme mit der Datenintegrität frühzeitig erkennen und das Risiko fehlerhafter Analysen oder nachgelagerter Fehler reduzieren.
- Prädiktive Optimierung von Arbeitslasten: Nutzt KI, um historische Abfragemuster und die Speichernutzung zu analysieren und anschließend Optimierungen wie Partitionierung, Caching oder Ressourcenskalierung zu empfehlen oder automatisch anzuwenden. So können Sie die Leistung aufrechterhalten und die Kosten kontrollieren, wenn die Nutzung wächst.
- Abfrageschnittstellen in natürlicher Sprache: Integriert KI-gestützte Chat- oder Suchwerkzeuge, mit denen Benutzer in allgemein verständlicher Sprache Fragen zu Daten stellen können. Dadurch wird die Hürde für technisch nicht versierte Benutzer gesenkt, Datensätze zu erkunden und Erkenntnisse zu gewinnen, ohne SQL oder Code schreiben zu müssen.
- Automatisierte Metadatenanreicherung: Nutzt KI, um Kontext, Beziehungen und Geschäftsbegriffe aus Rohdaten zu extrahieren und den Datenkatalog anschließend mit ausführlicheren Beschreibungen und Informationen zur Datenherkunft zu ergänzen. Dadurch können Teams Datenbestände leichter auffinden, ihnen vertrauen und sie wiederverwenden.
Vorteile von Data-Lake-Tools
Die Implementierung von Data-Lake-Tools bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Zentralisierte Datenverwaltung: Mit Data-Lake-Tools können Sie strukturierte und unstrukturierte Daten an einem Ort speichern. Dadurch lassen sich Datenbestände leichter organisieren und Analyse- oder KI-Projekte unterstützen.
- Skalierbarkeit für Workloads im Petabyte-Maßstab: Diese Plattformen können enorme Datenmengen verarbeiten und sowohl Cloud- als auch lokale Speicherebenen unterstützen, sodass Sie sich an wachsende Anforderungen anpassen können, ohne die Architektur neu zu entwerfen.
- Flexible Datenaufnahme: Dank integrierter Konnektoren und Formatunterstützung können Sie Daten aus einer Vielzahl von Formaten und Quellen aufnehmen sowie sowohl Stapelverarbeitungs- als auch Echtzeitdatenströme verarbeiten.
- Granulare Datenverwaltung und Zugriffskontrolle: Fein abgestufte Berechtigungen, Verschlüsselung und Prüfprotokollierung helfen Ihnen, Sicherheit und die Einhaltung von Standards wie HIPAA, SOC 2 und GDPR zu gewährleisten.
- Integration mit Analyse- und KI-Tools: Die native Kompatibilität mit Abfrage-Engines wie Spark, Trino und Presto sowie direkte Konnektoren zu AI/ML-Tools ermöglichen es Ihnen, Daten ohne Verzögerungen oder zusätzlichen Integrationsaufwand zu analysieren.
- Automatisierte Metadaten- und Datenqualitätsverwaltung: Viele Plattformen umfassen Kataloge, die Nachverfolgung der Datenherkunft und KI-gestützte Tools, die Ihnen helfen, Metadaten anzureichern, Daten zu klassifizieren und Anomalien zu erkennen, um die Datenintegrität zu wahren.
- Unterstützung für offene Tabellenformate und fortgeschrittene Anwendungsfälle: Funktionen wie die Kompatibilität mit Delta Lake oder Apache Iceberg ermöglichen ACID-Transaktionen, Datenversionierung und die gemeinsame Datennutzung ohne Kopieren, um fortgeschrittene Analysen und Multi-Cloud-Architekturen zu unterstützen.
Kosten und Preise von Data-Lake-Tools
Bei der Auswahl von Data-Lake-Tools ist es erforderlich, die verschiedenen verfügbaren Preismodelle und Tarife zu verstehen. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre Durchschnittspreise und typische enthaltene Funktionen von Data-Lake-Tool-Lösungen zusammen:
Vergleichstabelle der Tarife für Data-Lake-Tools
| Tariftyp | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| TariftypKostenloser Tarif | Durchschnittlicher Preis$0 | Übliche FunktionenGrundlegender Objektspeicher, begrenzte Datenaufnahme, Unterstützung für Schemata beim Lesen und Integration mit einer Abfrage-Engine. |
| TariftypPersönlicher Tarif | Durchschnittlicher Preis$50–$300/Monat | Übliche FunktionenGrößere Speichergrenzen, Unterstützung für mehrere Datenformate, grundlegende Katalogisierung und Integration mit Analysetools. |
| TariftypGeschäftstarif | Durchschnittlicher Preis$1,000–$5,000/Monat | Übliche FunktionenSpeicher im Petabyte-Maßstab, erweiterte Steuerungen für die Datenverwaltung, Multi-Cloud-Optionen und Funktionen zur Datenkatalogisierung. |
| TariftypUnternehmenstarif | Durchschnittlicher Preis$10,000+/Monat | Übliche FunktionenUnbegrenzter Speicher, umfassende Funktionen zur Einhaltung von Vorschriften, KI-gestützte Automatisierung, Integration mit Orchestrierungswerkzeugen und erstklassige Unterstützung. |
Häufig gestellte Fragen zu Data-Lake-Werkzeugen
Hier finden Sie Antworten auf häufige Fragen zu Data-Lake-Werkzeugen:
Wie erfüllen Data-Lake-Werkzeuge Sicherheits- und Compliance-Anforderungen?
Data-Lake-Werkzeuge setzen Sicherheitsmaßnahmen wie Zugriffskontrollen, Verschlüsselung und Prüfprotokollierung ein. Die meisten führenden Plattformen unterstützen granulare Berechtigungen bis auf Zeilen- oder Spaltenebene sowie Integrationen mit SSO- und Identitätsanbietern. Achten Sie im Hinblick auf Compliance auf Anbieterzertifizierungen wie SOC 2, HIPAA oder GDPR sowie auf Optionen für kundenseitig verwaltete Verschlüsselungsschlüssel. Mit diesen Funktionen können Sie regulatorische Anforderungen erfüllen, ohne zusätzliche Ebenen selbst entwickeln zu müssen.
Können Data-Lake-Werkzeuge in bestehende Analyse- oder BI-Plattformen integriert werden?
Ja, die meisten Data-Lake-Werkzeuge bieten direkte Konnektoren für Analyse- und BI-Plattformen. Sie sollten eine sofort einsatzbereite Unterstützung für Spark, Trino, Presto und Athena sowie Integrationen mit Tableau und Power BI erwarten. Wenn Ihre Teams spezialisierte Werkzeuge verwenden, prüfen Sie, ob offene APIs oder ODBC/JDBC-Treiber verfügbar sind, über die Sie benutzerdefinierte Workflows anbinden können.
Was ist der Unterschied zwischen Data-Lake-Werkzeugen und Data-Warehouse-Systemen?
Data-Lake-Werkzeuge konzentrieren sich auf die Speicherung roher, semistrukturierter und unstrukturierter Daten mithilfe eines Schemas beim Lesen, während Data-Warehouse-Systeme strukturierte Daten mit vordefinierten Schemata (Schema beim Schreiben) speichern. Data Lakes eignen sich besser für die flexible Datenaufnahme und KI-/ML-Workloads, während Data-Warehouse-Systeme für kuratierte Analysen mit optimierter Abfrageleistung geeignet sind. Einige Anbieter bieten inzwischen Lakehouse-Architekturen an, die beide Ansätze kombinieren.
Unterstützen Data-Lake-Werkzeuge mehrere Datenformate und Arten der Datenaufnahme?
Ja, die meisten Data-Lake-Werkzeuge akzeptieren eine große Bandbreite an Formaten wie Parquet, Avro, JSON, ORC und CSV. Außerdem werden sowohl Batch- als auch Streaming-Datenquellen unterstützt. Dadurch können Sie mit vorgefertigten oder benutzerdefinierten Konnektoren alles von täglichen Aufnahmeprozessen bis hin zu Echtzeit-Ereignisströmen verarbeiten.
Wie bewertet man Data-Lake-Werkzeuge hinsichtlich ihrer Skalierbarkeit?
Ich betrachte die Optionen jeder Plattform für Objektspeicher, die Leistung bei Datenmengen im Petabyte-Bereich und die Unterstützung mehrerer Clouds. Die Möglichkeit, Speicher in verschiedene Ebenen zu unterteilen, Daten regionsübergreifend zu verarbeiten und Engpässe mit Formaten wie Delta Lake oder Iceberg zu vermeiden, ist entscheidend. Prüfen Sie unbedingt dokumentierte Benchmarks und holen Sie Referenzen von Kunden mit ähnlichen Datenmengen wie Ihren ein.
Sind offene Tabellenformate wie Delta Lake oder Apache Iceberg wichtig?
Ja, offene Tabellenformate sind wichtig, wenn Sie ACID-Transaktionen, Versionierung und ein anbieterneutrales Datenmanagement wünschen. Sie ermöglichen Funktionen wie historische Datenabfragen und die gemeinsame Datennutzung ohne Datenkopien. Wenn Sie ein Lakehouse-Modell anstreben oder Ihre Architektur zukunftssicher gestalten möchten, sollten Sie auf die Kompatibilität mit offenen Formaten in Ihrem Data-Lake-Werkzeug bestehen.