

Når man bevæger sig ind i kunstig intelligens, støder man ofte på et væld af værktøjer til behandling af naturligt sprog, som hver især fremhæver unikke funktioner. Fra bots, der drives af avancerede NLP-modeller, til apps, der muliggør maskinoversættelse og opsummering, er disse værktøjer rygraden i nutidens automatiseringslandskab.
Med udgangspunkt i min erfaring med forståelse af naturligt sprog, besvarelse af spørgsmål, udtrækning af entiteter og programmeringssprogs finurligheder har jeg set, hvordan virtuelle assistenter og NLP-applikationer har revolutioneret interaktioner. Ved at undersøge disse muligheder kan du undgå udfordringen ved at gennemgå data manuelt og bygge bro mellem enorme informationsmængder og brugbar indsigt.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel: NLP-software
Denne sammenligningstabel opsummerer prisoplysningerne for mine bedste udvalg af NLP-software.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til lokal implementering af konversationsbaseret NLP | Gratis abonnement og gratis demo er tilgængelige | Priser oplyses efter forespørgsel | Website | |
| 2 | Bedst til API-adgang til avancerede LLM'er | Gratis abonnement tilgængeligt | Fra $20/bruger/måned | Website | |
| 3 | Bedst til samlet analyse af tekst og strukturerede data | 14 dages gratis prøveperiode + gratis demo tilgængelig | Pris oplyses efter forespørgsel | Website | |
| 4 | Bedst til behandling af dokumenter med lang kontekst via åbne LLM'er | Ikke tilgængelig | Priser oplyses efter forespørgsel | Website | |
| 5 | Bedst til fuldskala-finjustering af LLM'er fra start til slut | Gratis abonnement er tilgængeligt | Fra $0.04/kredit | Website | |
| 6 | Bedst til AWS-baseret tekstanalyse i stor skala | Gratis abonnement tilgængeligt | Fra $0.0001/enhed | Website | |
| 7 | Bedst til implementering af produktionsklare NLP-pipelines | Gratis abonnement tilgængeligt | Gratis abonnement tilgængeligt | Website | |
| 8 | Bedst til styret NLP på tværs af hybride cloudimplementeringer | Gratis abonnement + gratis prøveperiode + gratis demo tilgængelig | Fra $1,110/måned | Website | |
| 9 | Bedst til GCP-baserede tekstanalysepipelines | Gratis abonnement tilgængeligt | Fra $0.90/1,000 tegn (faktureres årligt) | Website | |
| 10 | Bedst til finjustering af modeller med åben kildekode i stor skala | Gratis abonnement tilgængeligt | Fra $9/måned | Website |




Anmeldelser af den bedste NLP-software
 1Bedst til lokal implementering af konversationsbaseret NLP
Rasa
- Gratis abonnement og gratis demo er tilgængelige
- Priser oplyses efter forespørgsel
Visit WebsiteCustomer Rating:4.2/5
Rasa giver brugerne mulighed for at konfigurere samtaleforløb med en visuel flowbygger. Rasa er et rammeværk med åben kildekode til konversationsbaseret NLP, der tilbyder et modulært NLU-behandlingsforløb, brugerdefineret klassifikation af brugerhensigter, genkendelse af navngivne entiteter, LLM-integration via sin CALM-arkitektur samt produktionsklare implementeringsmuligheder, herunder lokale installationer og luftgabte miljøer.
Hvem er Rasa bedst egnet til?
Rasa er et stærkt valg for ML-/NLP-ingeniører og DevOps-teams i regulerede brancher, der har brug for fuld kontrol over deres implementeringsmiljø for konversationsbaseret AI.
Hvorfor jeg valgte Rasa
Jeg har inkluderet Rasa blandt mine bedste valg, fordi det er den stærkeste løsning, jeg har fundet til teams, der har brug for at implementere konversationsbaseret NLP udelukkende på deres egen infrastruktur. Den Kubernetes-baserede implementering via Helm-diagrammer, understøttelse af luftgabte miljøer og administration af hemmeligheder med HashiCorp Vault gør Rasa velegnet til regulerede brancher som sundhedssektoren og finanssektoren, hvor data aldrig forlader jeres perimeter. Jeg sætter også pris på CALM-arkitekturen, som adskiller LLM-drevet sprogforståelse fra deterministisk forretningslogik og dermed holder agentens adfærd forudsigelig og kontrollerbar i produktion.
Rasas vigtigste funktioner
- DIET-klassifikator: En transformerbaseret model, der håndterer klassifikation af brugerhensigter og entitetsudtræk samtidigt i en enkelt træningsbar arkitektur.
- Dirigering af flere LLM'er: Giver dig mulighed for at tildele forskellige LLM'er til forskellige opgaver inden for den samme agent, så du får kontrol over afvejningen mellem omkostninger og svartid.
- RAG-modul til virksomheder: Opretter forbindelse til brugerdefinerede vektordatabaser for at hente viden i realtid og forankre svarene i dine egne data uden at træne modellen igen.
- Genbrug af flersprogede samtaleforløb: Implementerer de samme samtaleforløb på flere sprog og understøtter sprogskift midt i samtalen uden at miste konteksten.
Rasa-integrationer
Rasa dokumenterer integrationer med Hugging Face Transformers, spaCy, scikit-learn, Duckling, GPT-4, Llama, Redis, Apache Kafka, HashiCorp Vault og OpenTelemetry. REST- og WebSocket-API'er understøtter brugerdefinerede integrationer.
Pros and Cons
Pros:
- Understøtter lokale installationer og luftgabte miljøer
- Fuldstændig åben kildekode med brugerdefinerbare behandlingsforløb
- Genbrug af flersprogede samtaleforløb med bevarelse af kontekst
Cons:
- Ingen indbygget sentimentanalyse eller opsummering
- Udgaven med åben kildekode er i vedligeholdelsestilstand
Learn more about Rasa: Bedst til API-adgang til avancerede LLM'er
- Gratis abonnement tilgængeligt
- Fra $20/bruger/måned

OpenAIs Playground lader brugere køre forespørgsler med kodefortolkeren via assistenter. OpenAI er en AI-platform, der giver udviklere API-adgang til et bredt katalog af store sprogmodeller, indlejringsmodeller og talebehandlingsmodeller til udvikling af NLP-applikationer inden for opgaver som tekstklassifikation, entitetsudtræk, opsummering, oversættelse og semantisk søgning.
Hvem er OpenAI bedst egnet til?
OpenAI er velegnet til ML-ingeniører og udviklingsteams, der har brug for pålidelig og skalerbar API-adgang til avancerede sprogmodeller uden at skulle administrere den underliggende infrastruktur.
Hvorfor jeg valgte OpenAI
OpenAI kommer med på min shortlist, fordi ingen anden platform giver direkte API-adgang til et bredere katalog af avancerede modeller på dette kvalitetsniveau. Jeg kan især godt lide, hvordan Responses API, Batch API og indlejringsmodellerne fungerer sammen: Du kan køre NER- eller klassifikationsopgaver i stor skala til 50 % af prisen via Batch API og derefter sende resultaterne til
text-embedding-3-largefor semantisk klyngedannelse, alt sammen uden at administrere nogen infrastruktur. Programmet for brugerdefinerede modeller er endnu et højdepunkt med dokumenterede resultater i produktion, såsom Harveys forbedring på 83 % i juridisk NLP.OpenAIs vigtigste funktioner
- Tiktoken-tokenizer: En open source-BPE-tokenizer, der afspejler OpenAIs interne tokenisering og lader dig tælle tokens og administrere grænserne for kontekstvinduet, før du foretager API-kald.
- Strukturerede output via JSON-tilstand: Tvinger modellens svar ind i et defineret JSON-skema, hvilket gør den pålidelig til udtræk af entiteter eller klassifikationsetiketter i stor skala.
- Indlejrings-API: Genererer tætte vektorrepræsentationer af tekst ved hjælp af
text-embedding-3-smallellertext-embedding-3-largetil semantisk søgning, klyngedannelse og klassifikationsopgaver. - Batch API: Behandler store mængder inferensanmodninger asynkront med 50 % rabat sammenlignet med synkrone API-kald.
OpenAI-integrationer
OpenAI integreres med LangChain, LlamaIndex, Azure OpenAI Service, Pinecone, Weaviate, Qdrant, Chroma og Temporal. API'erne og de officielle SDK'er understøtter brugerdefinerede forbindelser til vektordatabaser, virksomhedssystemer og CI/CD-arbejdsgange.
Pros and Cons
Pros:
- Avancerede LLM'er opdateret med førende benchmarks
- Batch API reducerer omkostningerne ved behandling i stor skala
- Finjustering med dokumenterede casestudier fra virksomheder
Cons:
- Ingen lokal installation eller hosting i privat cloud
- Ingen eksponeret klassisk NLP-forbehandlingspipeline
Learn more about OpenAI: Bedst til samlet analyse af tekst og strukturerede data
- 14 dages gratis prøveperiode + gratis demo tilgængelig
- Pris oplyses efter forespørgsel

SAS Model Studio giver brugerne mulighed for at organisere projekter til tekstanalyse ét sted. SAS Visual Analytics er en virksomhedsplatform til analyse og NLP, der kombinerer visuel dataudforskning, tekstanalyse, emnemodellering, sentimentanalyse og NER med en arbejdsgangsbygger uden kodning samt en generativ AI-assistent.
Hvem er SAS Visual Analytics bedst egnet til?
SAS Visual Analytics er velegnet til virksomheders datavidenskabsteams, der har brug for at analysere strukturerede og ustrukturerede tekstdata inden for én samlet, styret platform.
Hvorfor valgte jeg SAS Visual Analytics?
Jeg valgte SAS Visual Analytics, fordi det er en af de få NLP-platforme, der reelt samler analyse af strukturerede data og tekstanalyse uden at tvinge dig til at sammenkoble separate værktøjer. SAS Visual Text Analytics, som kører sammen med platformen, håndterer NER, BERT-baseret sentimentanalyse og emnemodellering i det samme styrede miljø, hvor dine strukturerede data allerede befinder sig. Jeg kan især godt lide funktionen til kalibrering af LLM'er, som giver dig mulighed for at justere modellens adfærd til RAG-arbejdsgange uden at ændre selve grundmodellen. Det er en klar fordel, når man arbejder med følsomme virksomhedsdata.
Vigtige funktioner i SAS Visual Analytics
- Forbehandling af tekst på 33 sprog: Tokenisering, lemmatisering og POS-mærkning er tilgængelige direkte på 33 sprog, herunder arabisk, hindi, thai og vietnamesisk.
- Hybrid arbejdsgangsbygger til NLP: En visuel grænseflade uden kodning gør det muligt at kombinere regelbaserede noder, ML-noder og noder til dyb læring i én samlet arbejdsgang til tekstanalyse.
- SAS Micro Analytic Score API: En tilstandsløs, hukommelsesbaseret API til scoring, der er udviklet til højtydende modelinferens i realtid i produktionsmiljøer.
- Flytbare ASTORE-modelfiler: Trænede modeller eksporteres som binære ASTORE-filer, hvilket muliggør scoring uden for SAS-miljøet på både skybaserede og lokale målplatforme.
Integrationer med SAS Visual Analytics
SAS Visual Analytics har indbyggede integrationer på tværs af Microsoft-økosystemet, herunder Microsoft 365 og Azure, samt understøttelse af implementering på AWS, Google Cloud Platform og Red Hat OpenShift. SAS Viya REST API'er og SDK'er understøtter tilpassede integrationer.
Pros and Cons
Pros:
- Indbygget flersproget understøttelse af 33 sprog
- Samlet platform til tekst og strukturerede data
- Generativ AI med indbyggede kontroller til bias
Cons:
- Avancerede NLP-funktioner kræver et separat tilføjelsesmodul
- Mindre fleksibel end rammer med åben kildekode til NLP
Learn more about SAS Visual Analytics: Bedst til behandling af dokumenter med lang kontekst via åbne LLM'er
- Ikke tilgængelig
- Priser oplyses efter forespørgsel

AI21 Studio giver brugerne mulighed for at definere eksplicitte outputkrav for hver API-kørsel. AI21 Studio er en LLM-platform bygget omkring Jamba-familien af hybride Mamba-Transformer-modeller, der tilbyder tekstgenerering, opsummering, spørgsmålsbesvarelse, klassifikation, RAG-orkestrering og finjustering i flere niveauer via API, SDK og administrerede cloudtjenester.
Hvem er AI21 Studio bedst egnet til?
AI21 Studio er velegnet til ML-ingeniører og virksomhedsteams, der bygger RAG-pipelines eller vidensarbejdsgange oven på store, ustrukturerede dokumentsamlinger.
Hvorfor jeg valgte AI21 Studio
AI21 Studio kommer med på min liste over favoritter på grund af, hvor godt Jamba-modelserien håndterer reelt store dokumentarbejdsbelastninger. Kontekstvinduet på 256K tokens er det største, der findes blandt modeller med åbne vægte, hvilket betyder, at jeg kan indlæse hele kontrakter, rapporter om kliniske forsøg eller M&A-indberetninger i ét enkelt inferenskald uden at opdele dem i tekststykker. Kombiner det med Maestro RAG-orkestreringslaget, som dynamisk dirigerer mellem filsøgning, websøgning og LLM'er, samtidig med at det leverer en visuel udførelsesgraf, og du har en stærk pipeline til at udtrække struktureret indsigt fra tætte, ustrukturerede dokumentsamlinger.
Vigtigste funktioner i AI21 Studio
- Jambas hybride arkitektur: Jamba-modeller kombinerer Mamba-SSM-lag med Transformer-opmærksomhed i et design baseret på en blanding af eksperter, hvilket giver op til 2,5× hurtigere inferens end transformerbaserede modeller af sammenlignelig størrelse.
- API til finjustering i flere niveauer: Understøtter fuld finjustering, LoRA og QLoRA via standardbiblioteker fra HuggingFace samt en administreret eftertræningstjeneste til virksomhedsteams, der ønsker at eje den resulterende model.
- Intelligent gateway: Et dirigeringslag, der kan indsættes direkte, og som profilerer omkostningen pr. agent, komprimerer overflødig kontekst og adaptivt vælger modeller pr. tur – i øjeblikket gratis under betatest.
- Åbne modelvægte på Hugging Face: Jamba-modeller er offentligt tilgængelige under Jamba Open Model License, så dit team kan hoste dem selv, inspicere dem eller tilpasse dem yderligere uden leverandørlåsning.
Integrationer i AI21 Studio
AI21 Studio integreres med AWS, Microsoft Azure, Google Cloud, NVIDIA NIM, Hugging Face, LangChain, LlamaIndex, Pinecone, Snowflake og Databricks. Dets REST API, Python SDK og TypeScript SDK understøtter tilpassede integrationer og implementeringsarbejdsgange.
Pros and Cons
Pros:
- Håndterer lange dokumentinput på 256K tokens
- Understøtter fuld finjustering samt LoRA- og QLoRA-finjustering
- Åbne modelvægte til selvhosting
Cons:
- Ingen dedikeret NER- eller sentiment-API
- Mangler en visuel NLP-pipelinebygger uden kode
Learn more about AI21 Studio: Bedst til fuldskala-finjustering af LLM'er fra start til slut
- Gratis abonnement er tilgængeligt
- Fra $0.04/kredit
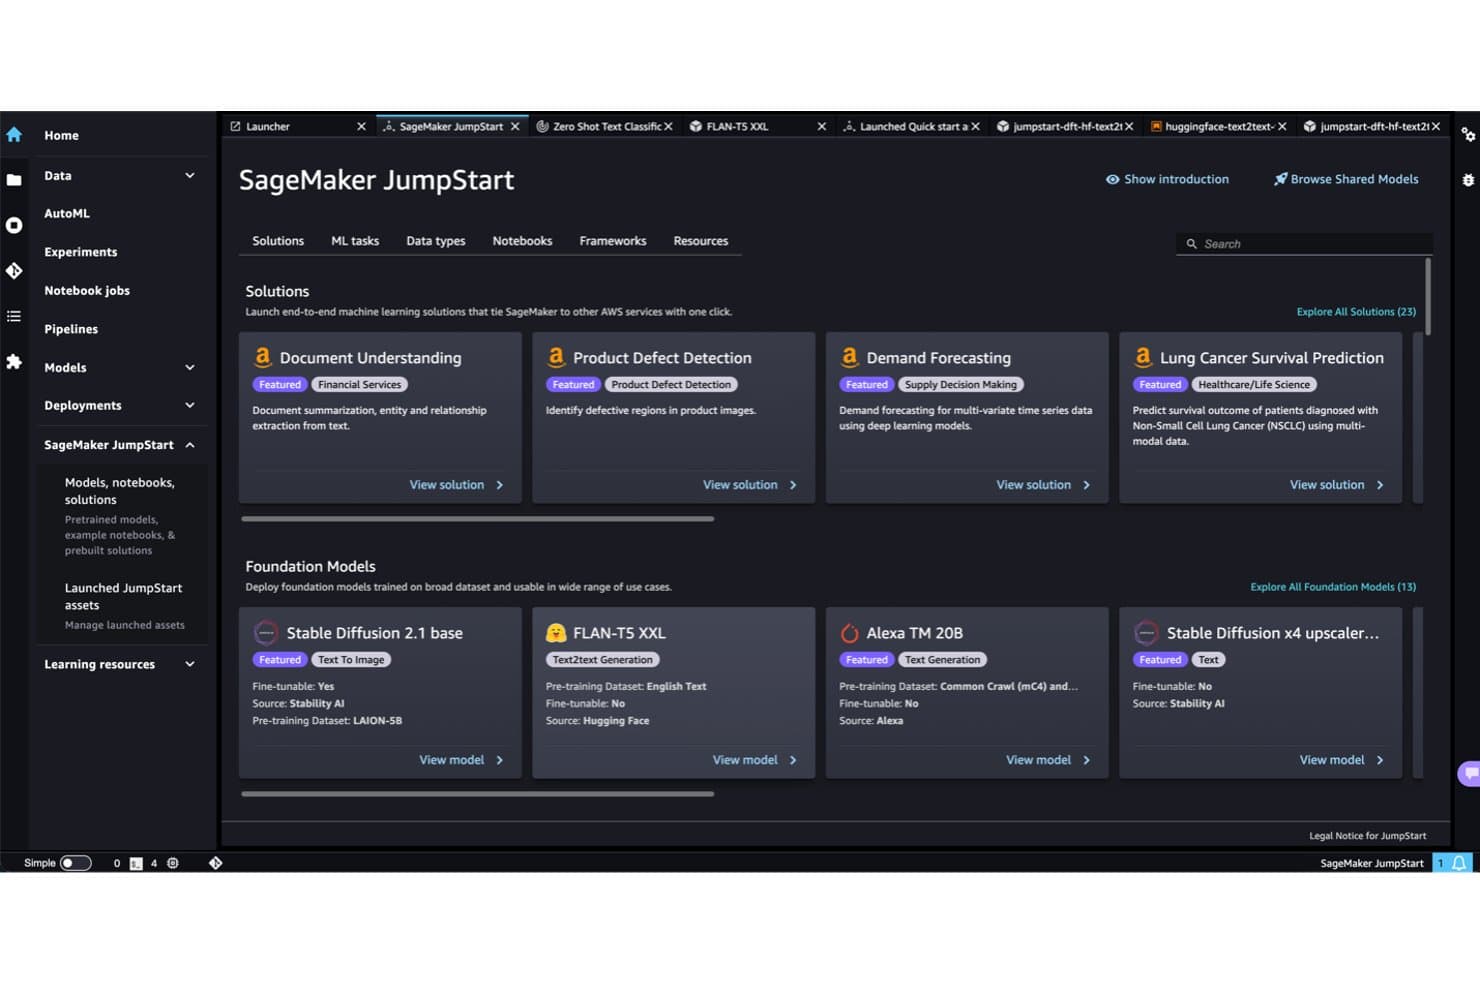
Amazon SageMaker JumpStart tilbyder forudbyggede NLP-modeller, der er klar til implementering. Amazon SageMaker er AWS' administrerede ML-platform, der dækker hele NLP-modellens livscyklus – fra databehandling og tokenisering til træning, finjustering og implementering af store sprogmodeller i stor skala via værktøjer som JumpStart, HyperPod og native integrationer med Hugging Face.
Hvem er Amazon SageMaker bedst egnet til?
Amazon SageMaker er det rette valg for ML-ingeniører og MLOps-teams i mellemstore til store virksomheder, som har brug for én platform til at føre LLM'er fra rådata til produktion i stor skala.
Hvorfor jeg valgte Amazon SageMaker
Amazon SageMaker kommer med på min slutliste, fordi ingen anden administreret ML-platform matcher dens dybde inden for fuldskala-finjustering af LLM'er fra start til slut. Jeg er især imponeret over HyperPod, som lader dig køre distribueret finjustering på tværs af hundredvis af acceleratorer med checkpointløs, elastisk træning, der reducerer træningstiden med op til 40 %. JumpStarts katalog med over 1.000 modeller, herunder Llama 4, DeepSeek R1 og John Snow Labs' medicinske LLM'er, betyder, at jeg kan gå fra at vælge en domænespecifik grundmodel til at finjustere den med tilpassede data uden at forlade platformen.
Vigtige funktioner i Amazon SageMaker
- SageMaker Clarify: Registrerer bias og genererer forklaringsrapporter for NLP-modeller på tværs af træning, evaluering og overvågning efter implementering.
- SageMaker Data Wrangler: Tilbyder en kodefattig grænseflade til import, transformation og klargøring af tekstdata før modeltræning.
- Inferenspunkter med flere tilstande: Understøtter realtids-, serverløs, asynkron og batchbaseret inferens på over 70 instanstyper, herunder Inferentia- og Trainium-chips.
- Administreret MLflow-integration: Sporer eksperimenter, sammenligner modelkørsler og administrerer versionsstyring på tværs af NLP-arbejdsgange uden behov for separat infrastruktur.
Integrationer med Amazon SageMaker
Amazon SageMaker har native integrationer med Amazon S3, Amazon Bedrock, Amazon OpenSearch Service, Amazon EKS, AWS Lambda, Amazon CloudWatch, AWS IAM, Hugging Face og MLflow. Den tilbyder også REST API'er, SDK'er og adgang via AWS CLI til tilpassede integrationer.
Pros and Cons
Pros:
- Det største tilgængelige katalog over forudtrænede modeller
- HyperPod understøtter omfattende distribueret LLM-træning
- Livscyklus fra start til slut med værktøjer til forklarbarhed
Cons:
- Det er vanskeligt for de fleste teams at følge omkostningerne
- Risiko for leverandørlåsning for virksomheder med flere cloudmiljøer
Learn more about Amazon SageMaker: Bedst til AWS-baseret tekstanalyse i stor skala
- Gratis abonnement tilgængeligt
- Fra $0.0001/enhed
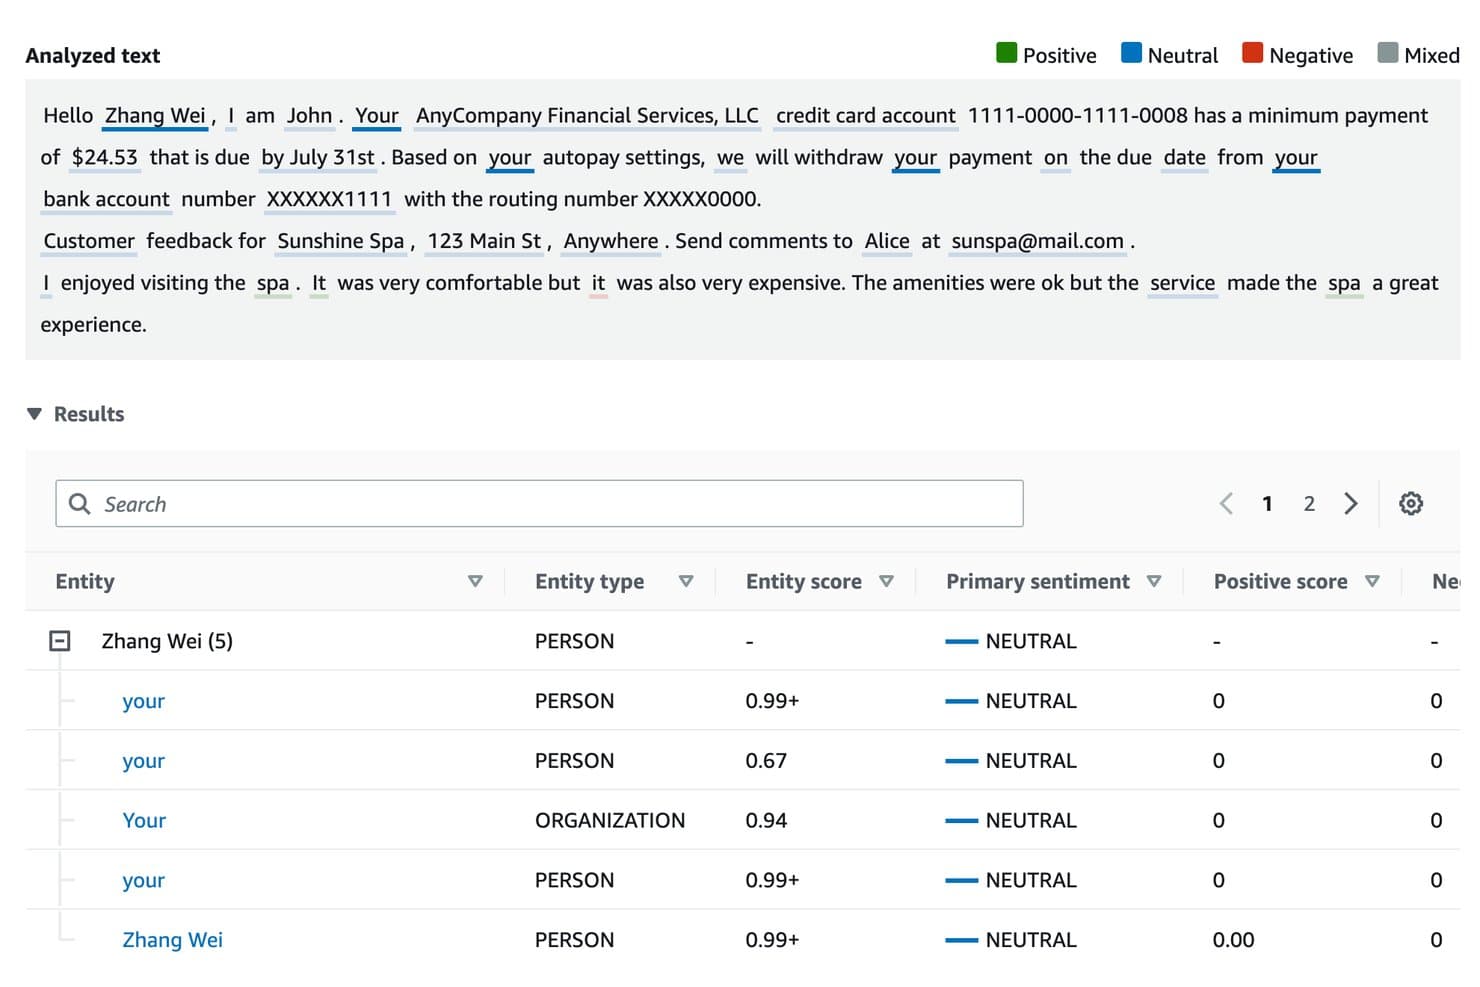
Amazon Comprehend identificerer entiteter og sentiment i analyseret tekst. Amazon Comprehend er en fuldt administreret AWS NLP-tjeneste, der leverer forudbyggede API-drevne tekstanalysfunktioner—herunder sentimentanalyse, genkendelse af navngivne entiteter, detektering af PII, udtrækning af nøglefraser og træning af tilpassede modeller via AutoML—uden at kræve, at du administrerer nogen underliggende infrastruktur.
Hvem er Amazon Comprehend bedst egnet til?
Amazon Comprehend er velegnet til udviklings- og DevOps-teams, der allerede kører arbejdsbelastninger i AWS, og som har brug for produktionsklar NLP uden at administrere nogen ML-infrastruktur.
Hvorfor jeg valgte Amazon Comprehend
Amazon Comprehend kommer med på min liste over favoritter, fordi det er det mest naturlige valg til AWS-baseret tekstanalyse i stor skala. Jeg kan godt lide, at man kan køre sentimentanalyse, målrettet entitetsgenkendelse og PII-redigering direkte gennem administrerede API-endepunkter uden at klargøre en eneste server. I praksis betyder det, at mit team kan behandle millioner af kundeoplysninger asynkront fra S3 med volumenbaseret prissætning, der faktisk bliver billigere, jo mere du analyserer.
Vigtige funktioner i Amazon Comprehend
- Tilpasset entitetsgenkendelse: Træn en domænespecifik entitetsgenkender på dine egne mærkede eksempler for at udtrække termer som policenumre eller interne koder, som forudbyggede modeller ikke kan registrere.
- Detektering og redigering af PII: Identificer og rediger automatisk følsomme personoplysninger—navne, amerikanske personnumre og kreditkortnumre—direkte i din dokumentbehandlingspipeline.
- Automatisering af MLOps med svinghjulsmetoden: Administrer hele livscyklussen for tilpassede modeller, fra dataindlæsning til gen-træning og promovering af versioner, uden at opbygge et separat MLOps-lag.
- Ontologikobling i Comprehend Medical: Knyt udtrukne kliniske entiteter til standardiserede kodningssystemer som ICD-10-CM, RxNorm og SNOMED CT til NLP-arbejdsgange inden for sundhedssektoren.
Integrationer med Amazon Comprehend
Amazon Comprehend har indbyggede integrationer med Amazon S3, AWS Lambda, AWS KMS, AWS IAM, Amazon Kendra, Amazon Lex, Amazon Connect, AWS CloudTrail og Amazon CloudWatch. Dets REST API, AWS SDK'er, AWS CLI, Step Functions og EventBridge understøtter tilpassede datapipelines og automatisering af arbejdsgange.
Pros and Cons
Pros:
- Naturlig integration i AWS-centrerede NLP-arbejdsgange
- NLP til sundhedssektoren med klinisk ontologikortlægning
- Indbygget detektering og redigering af PII
Cons:
- Ingen adgang til modellernes interne funktioner
- Begrænset finjustering ud over grundlæggende AutoML
Learn more about Amazon Comprehend: Bedst til implementering af produktionsklare NLP-pipelines
- Gratis abonnement tilgængeligt
- Gratis abonnement tilgængeligt
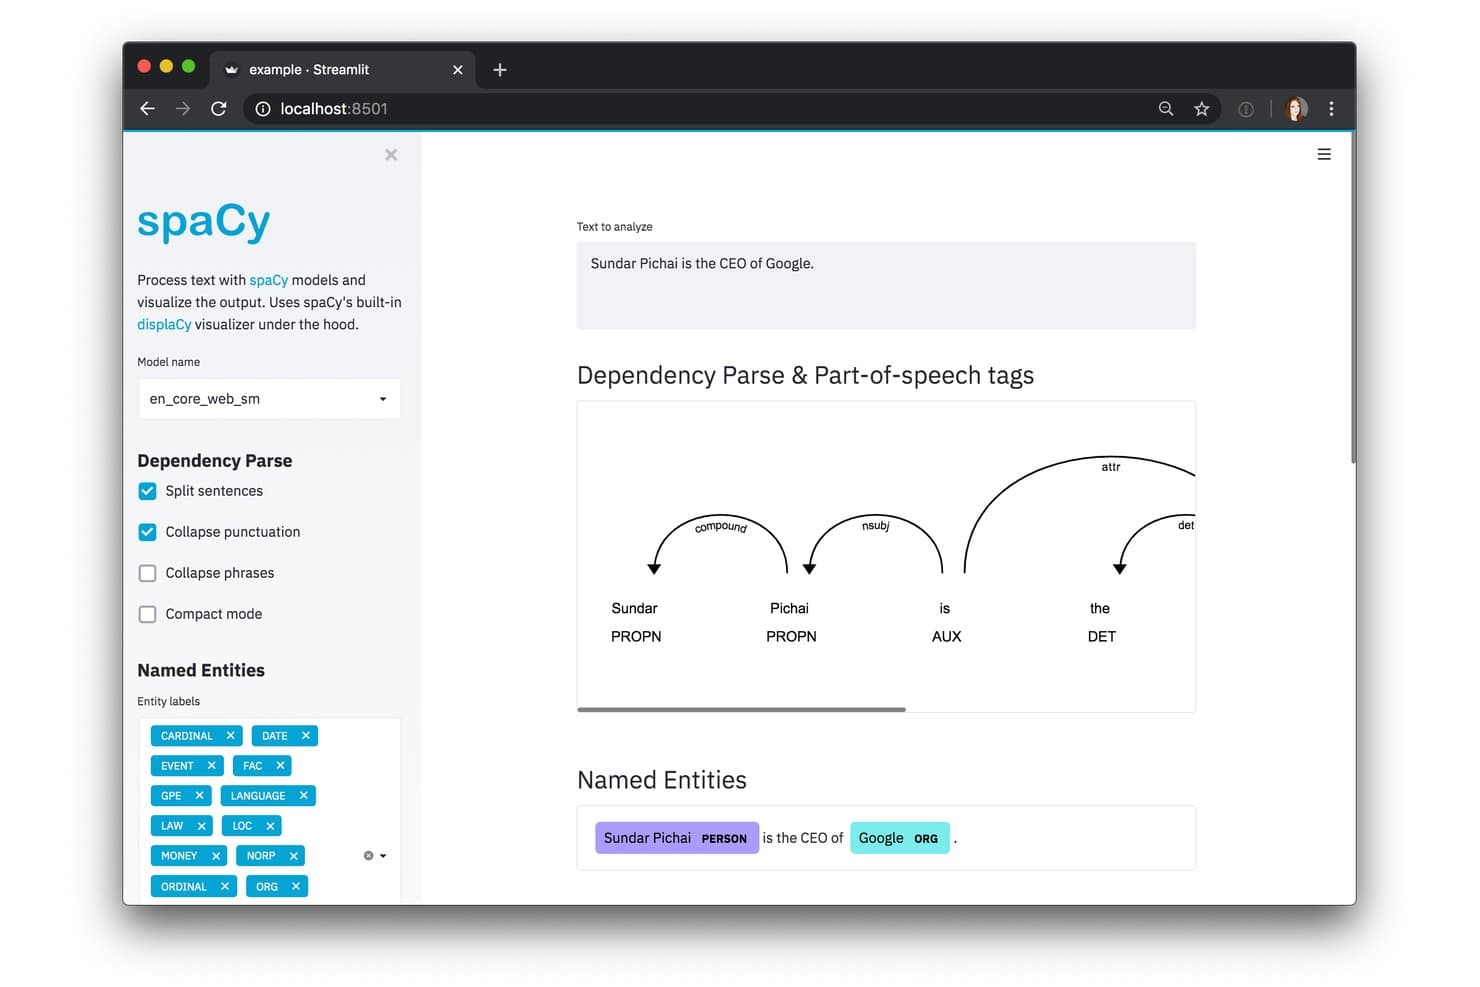
spaCy visualiserer afhængighedsanalyse og navngivne entiteter interaktivt. spaCy er et Pythonbibliotek med åben kildekode til NLP, der dækker tokenisering, genkendelse af navngivne entiteter, afhængighedsanalyse, tekstklassificering og træning af transformerbaserede modeller på tværs af mere end 75 sprog.
Hvem er spaCy bedst egnet til?
spaCy er et godt valg for ML-ingeniører og dataforskere, der har brug for at bygge, træne og implementere NLP-pipelines i Python uden at være afhængige af en administreret platform.
Hvorfor jeg valgte spaCy
spaCy fortjener sin plads på min liste over kandidater, fordi biblioteket er bygget fra bunden til produktion og ikke kun til eksperimenter. Jeg kan godt lide, at trænede pipelines pakkes som Python-moduler, der kan installeres, hvilket betyder, at implementering af en tilpasset NER-model i en Docker-container eller et AWS Lambda-lag bliver en gentagelig, versionsstyret proces i stedet for en enkeltstående nødløsning. Det konfigurationsstyrede
spaCy train-system samler alle hyperparametre og arkitekturvalg i én fil, så mine pipelines kan genskabes på tværs af miljøer. Det er kombinationen af disciplineret pakkehåndtering og Cython-drevet batchgennemløb vianlp.pipe(), der gør spaCy reelt produktionsklart.spaCys vigtigste funktioner
- 84 forudtrænede pipelines: Download og kør forudtrænede pipelines på tværs af 25 sprog, fra kompakte CPU-optimerede modeller til komplette transformerbaserede varianter bygget på RoBERTa og BERT.
spaCy-LLM-integration: Forbind spaCy-pipelines direkte til hostede LLM-API'er (OpenAI, Anthropic, Cohere) eller modeller med åben kildekode for at udføre NLP-opgaver uden behov for mærkede træningsdata.- displaCy-visualiseringsværktøj: Gengiv annoteringer af navngivne entiteter og afhængighedstræer i browseren ved hjælp af spaCys indbyggede visualiseringskomponent.
- Økosystem af domænespecifikke pipelines: Få adgang til brugsklare fællesskabsudviklede pipelines til sundhedssektoren (medspaCy) og juridisk tekst (Blackstone) gennem spaCy Universe-biblioteket.
spaCy-integrationer
spaCy integreres med Hugging Face Transformers, PyTorch, TensorFlow, OpenAI, Anthropic, Cohere, LangChain, Prodigy, DVC, Prefect og Ray. Dets Python-API understøtter tilpassede integrationer, men inkluderer ikke en indbygget REST-API.
Pros and Cons
Pros:
- Kører udelukkende på din egen infrastruktur
- Tilbyder domænespecifikke pipelines til sundhedssektoren og juridiske områder
- Pakkehåndtering muliggør reproducerbare, versionsstyrede modelimplementeringer
Cons:
- Ingen indbygget REST-API til levering
- Ingen grænseflade til kodefri eller visuelle arbejdsgange
Learn more about spaCy: Bedst til styret NLP på tværs af hybride cloudimplementeringer
- Gratis abonnement + gratis prøveperiode + gratis demo tilgængelig
- Fra $1,110/måned

IBM watsonx.ai udtrækker strukturerede fakta fra SEC 10-K-indberetninger ved hjælp af få-eksempel-prompter. IBM watsonx.ai er en AI-platform til virksomheder, der kombinerer et katalog over fundamentmodeller fra flere leverandører, Watson NLP-biblioteket, LoRA/QLoRA-finjustering, AutoML samt fleksible muligheder for SaaS-, lokale og hybride cloud-implementeringer til opbygning og skalering af NLP-arbejdsbelastninger.
Hvem er IBM watsonx.ai bedst egnet til?
IBM watsonx.ai er velegnet til IT- og datavidenskabsteams i virksomheder, der har brug for at opbygge, finjustere og implementere NLP-arbejdsbelastninger på tværs af lokale, hybride og cloudbaserede miljøer med strenge krav til styring og overholdelse af regler.
Hvorfor jeg valgte IBM watsonx.ai
IBM watsonx.ai kommer på min kortliste på grund af den fremragende håndtering af styret NLP på tværs af hybride cloudmiljøer, hvilket er en reel fordel for virksomhedsteams med strenge krav til overholdelse af regler. Jeg er især imponeret over Watson NLP-biblioteket, som dækker entitetsgenkendelse, sentimentanalyse, toneklassifikation og semantisk rollemærkning på over 20 sprog i en enkelt, revisionsklar pipeline. Kombineret med CP4D på Red Hat OpenShift til lokale eller hybride implementeringer og AI Factsheets til revisionsspor for modeller får man styring indbygget i hvert eneste lag fra ende til anden.
Vigtige funktioner i IBM watsonx.ai
- Katalog over fundamentmodeller fra flere leverandører: Få adgang til forudtrænede modeller fra IBM Granite, Meta Llama, Mistral, DeepSeek og NVIDIA fra ét samlet hostet bibliotek.
- LoRA/QLoRA-finjustering: Tilpas fundamentmodeller til domænespecifikke NLP-opgaver ved hjælp af parameter-effektiv finjustering i GPU-accelererede miljøer.
- AutoAI-pipelinebygger: Håndterer automatisk dataforberedelse, funktionsudvikling, modeludvælgelse og justering af hyperparametre til prædiktive ML-arbejdsgange.
- OpenAI-kompatibelt API-slutpunkt: Forbind eksisterende applikationer med inferens i watsonx.ai ved hjælp af et OpenAI-kompatibelt REST API-format sammen med Python-, Node.js- og Java-SDK'er.
Integrationer med IBM watsonx.ai
IBM watsonx.ai integreres med Hugging Face, Red Hat OpenShift, watsonx.data, Watson Assistant, watsonx Orchestrate, Watson Discovery og IBM Cloud Object Storage. Dets REST API samt Python-, Node.js- og Java-SDK'er understøtter tilpassede integrationer.
Pros and Cons
Pros:
- Bred dækning af NLP-opgaver på over 20 sprog
- Skadesløsholdelse for immaterielle rettigheder for IBM-modeller til virksomheder
- Indbygget understøttelse af RAG og vektorsøgning
Cons:
- IBMs proprietære modeller er ikke tilgængelige til AWS
- Grænsefladen kan være forvirrende for nye brugere
Learn more about IBM watsonx.ai: Bedst til GCP-baserede tekstanalysepipelines
- Gratis abonnement tilgængeligt
- Fra $0.90/1,000 tegn (faktureres årligt)

Google Cloud Natural Language AI annoterer entiteter i CV'er, f.eks. færdigheder og arbejdsgivere. Google Cloud Natural Language AI er en administreret NLP-API fra Google, der leverer forudtrænet sentimentanalyse, entitetsgenkendelse, syntaktisk parsing, indholdsklassificering og tekstmoderering via REST- og gRPC-grænseflader med klientbiblioteker til otte programmeringssprog.
Hvem er Google Cloud Natural Language AI bedst egnet til?
Google Cloud Natural Language AI er velegnet til udviklingsteams, der allerede kører arbejdsbelastninger på GCP og har brug for produktionsklar NLP uden at skulle administrere infrastruktur.
Hvorfor jeg valgte Google Cloud Natural Language AI
Google Cloud Natural Language AI kommer med på min liste over kandidater på grund af den naturlige integration i tekstanalysepipelines, der er opbygget til GCP. Hvis dit team allerede kører data gennem BigQuery, kan du kalde
ML.UNDERSTAND_TEXTdirekte i SQL for at køre sentiment- eller entitetsanalyse uden nogensinde at forlade datalageret. Jeg kan også godt lide, at v2-API'en bruger en PaLM-baseret model til entitets- og sentimentopgaver, og at metodenannotateTextgiver dig mulighed for at hente flere NLP-funktioner i et enkelt API-kald, hvilket reducerer den samlede rundrejsetid betydeligt.Vigtige funktioner i Google Cloud Natural Language AI
- Sentimentanalyse af entiteter: Registrerer det sentiment, der er knyttet til hver navngiven entitet i en tekst, og returnerer pointtal for hver entitet på engelsk, japansk og spansk.
- Automatisk maskinlæring til naturligt sprog: Giver dig mulighed for at træne brugerdefinerede tekstklassificerings- og entitetsudtrækningsmodeller på dine egne mærkede datasæt via en visuel grænseflade uden kode gennem Vertex AI.
- Slutpunkter til flere regioner: Sender API-anmodninger gennem slutpunkter i USA eller EU for at holde data behandlet og lagret inden for en bestemt region af hensyn til overholdelse af krav til datalokalitet.
- HIPAA-kompatibelt API: Er omfattet af Google Clouds aftale om forretningspartner, hvilket gør API'en anvendelig til arbejdsgange, der håndterer beskyttede sundhedsoplysninger.
Integrationer med Google Cloud Natural Language AI
Google Cloud Natural Language AI integreres med Vertex AI, BigQuery, Cloud Composer, Speech-to-Text, Translation API, Vision API, Dataflow, Cloud Run og Cloud Functions. REST, gRPC og otte klientbiblioteker understøtter brugerdefinerede integrationer.
Pros and Cons
Pros:
- Forudtrænede modeller kræver ingen træningsdata
- Data gemmes aldrig efter API-behandlingen
- Flersproget understøttelse af vigtige NLP-funktioner
Cons:
- Ingen modelbaseret forklarlighed eller biasmålinger
- Finjustering er kun tilgængelig via Vertex AI
Learn more about Google Cloud Natural Language AI: Bedst til finjustering af modeller med åben kildekode i stor skala
- Gratis abonnement tilgængeligt
- Fra $9/måned

HuggingChat giver brugerne mulighed for at forespørge AI-modeller via en webchatgrænseflade. Hugging Face er en platform med åben kildekode til NLP, der giver dig adgang til over 2 millioner forudtrænede modeller samt en komplet værktøjspakke til tokenisering, finjustering og modelimplementering på tværs af skybaserede og lokale miljøer.
Hvem er Hugging Face bedst egnet til?
Hugging Face er førstevalget for ML- og NLP-ingeniører, der har brug for direkte adgang til modeller med åben kildekode og hele værktøjskæden til at finjustere, evaluere og implementere dem i stor skala.
Hvorfor jeg valgte Hugging Face
Hugging Face har fortjent sin plads på min liste over udvalgte løsninger, fordi ingen anden platform kommer i nærheden, når det gælder finjustering af modeller med åben kildekode i stor skala. Jeg er vild med, at PEFT og QLoRA gør det muligt at finjustere LLM'er med milliarder af parametre, såsom LLaMA eller Mistral, på en enkelt GPU, hvilket reducerer beregningsomkostningerne markant uden at gå på kompromis med kvaliteten. TRL-biblioteket tilføjer fuld understøttelse af RLHF og DPO oveni, så du kan tilpasse domænespecifikke modeller med et minimalt ressourceforbrug.
Vigtige funktioner i Hugging Face
- Transformers Pipeline API: En grænseflade på én linje til at køre NLP-opgaver—klassifikation, NER, opsummering, oversættelse og QA—mod enhver model på Hub.
- AutoTrain: En træningsgrænseflade uden kode, hvor du uploader et mærket datasæt, vælger en opgave, og platformen automatisk håndterer modelvalg og træning.
- Tekst-embedding-inferens (TEI): En dedikeret inferensmotor, der er optimeret til generering af embeddings med høj gennemstrømning og understøtter semantisk søgning og RAG-pipelines i stor skala.
- API til inferensudbydere: Et samlet slutpunkt, der er kompatibelt med OpenAI, og som dirigerer anmodninger på tværs af udbydere som Groq, Together AI og Cerebras ved hjælp af ét enkelt Hugging Face-token.
Hugging Face-integrationer
Hugging Face integreres med PyTorch, TensorFlow, JAX, AWS SageMaker, Google Cloud, Azure, Weights & Biases, MLflow og Snowflake. Dets Python-, JavaScript-, REST- og CLI-API'er understøtter brugerdefinerede integrationer og implementeringsarbejdsgange.
Pros and Cons
Pros:
- Uovertruffent udvalg af NLP-modeller med åben kildekode
- Gør det muligt at finjustere enorme modeller på én GPU
- AutoTrain gør det muligt at træne modeller uden kode
Cons:
- Fællesskabsmodeller varierer i kvalitet og sikkerhed
- Implementering, der er klar til virksomheder, kræver DevOps-ekspertise
Learn more about Hugging Face:
Anden NLP-software
Nedenfor finder du en liste over yderligere NLP-software, som jeg udvalgte, men som ikke kom med blandt de 10 bedste. De er bestemt værd at se nærmere på.
- 11NLP CloudBedst til implementering af NLP-API'er med fokus på databeskyttelse
- 12SnorkelBedst til programmatisk mærkning i virksomhedsskala
- 13ClaudeBedst til sikkerhedsorienteret NLP på tværs af alle større cloudplatforme
- 14Cohere NorthBedst til implementering af NLP-modeller i et isoleret netværk
- 15Microsoft Azure AI LanguageBedst til isoleret NLP i regulerede brancher
- 16NLTKBedst til klassisk NLP uden omkostninger til infrastruktur
- 17Stanford NLPBedst til sproglig præcision på tværs af over 80 sprog
Sådan evaluerer jeg NLP-software
Fra NER-arbejdsgange til implementering af transformermodeller i produktion evaluerer jeg NLP-værktøjer i to lag: det grundniveau, som enhver platform skal bestå for at komme på listen, og de forskelle, der får de bedste til at skille sig ud.
Kernefunktionalitet (minimumskrav for denne liste)
Når jeg udvælger værktøjer til min liste, vurderer jeg hvert enkelt på en skala fra 0 (tilbyder ikke funktionaliteten) til 5 (udmærker sig på dette område) for hver af de centrale funktioner, der er angivet nedenfor. Derefter omregner jeg værktøjets samlede score til en procentdel. Hvert værktøj skal opnå en samlet minimumsscore på 75 % for at komme i betragtning til listen.
- Forbehandling af tekst & tokenisering: Jeg undersøger, om en platform håndterer hele oprydningskæden—tokenisering, stemming, lemmatisering og fjernelse af stopord—så rå tekst er klar til arbejdsgange på tværs af flere sprog.
- Fortrænede sprogmodeller: Adgang til aktuelle transformerarkitekturer er vigtig. Jeg ser efter et bredt, regelmæssigt opdateret modelkatalog frem for en håndfuld forældede muligheder.
- Dækning af centrale NLP-opgaver: Hvert værktøj bør understøtte grundlæggende opgaver som NER, sentimentanalyse, klassifikation og opsummering—byggestenene i de fleste NLP-arbejdsgange i produktion.
- Modelltræning & finjustering: Jeg vurderer, om du kan medbringe dit eget datasæt og finjustere modeller med reel kontrol over hyperparametre, ikke blot slå nogle få forudindstillinger til i en guide.
- API- & SDK-adgang: Gode NLP-værktøjer stiller REST-API'er og SDK'er til rådighed på sprog som Python og Java. Jeg ser efter tydelig dokumentation, versionsstyrede slutpunkter og kompatibilitet med rammeværker.
- Implementering & skalerbarhed: Jeg ser på, hvordan hver platform håndterer arbejdsbelastninger i produktion—om den understøtter autoskalering af inferens, batchbehandling og fleksible beregningsmuligheder som klargøring af GPU'er eller TPU'er.
Når jeg har en liste over værktøjer, der opfylder kriterierne, ser jeg på, hvad der får hver platform til at skille sig ud.
Differentierende faktorer (det, der får leverandørerne til at skille sig ud)
Sådan sammenligner jeg forskellige leverandører:
Fremtrædende funktioner
RAG-rammeværker og understøttelse af vektorsøgning er i øjeblikket en vigtig differentierende faktor. Teams, der bygger LLM-drevne applikationer, har brug for indbygget generering af vektorindlejringer og hentningsarbejdsgange, ikke eftermonterede nødløsninger. Jeg ser også efter værktøjer til forklarbarhed og registrering af skævhed—når man implementerer sentimentmodeller i produktion, vil interessenter gerne forstå, hvorfor en forudsigelse blev foretaget. Domænespecifikke modelbiblioteker sparer også betydelig tid, især for teams inden for sundhedssektoren eller jura, som ellers skulle bruge uger på at finjustere modeller til generelle formål.
Ud over funktionerne
Fleksibilitet i forbindelse med implementering er vigtig, når sikkerhedsteamet kræver lokal hosting eller isolerede netværksmiljøer. Jeg vurderer, om en platform understøtter sky-, hybrid- og selvhostede muligheder sammen med Kubernetes-orkestrering. Kontroller til databeskyttelse er lige så vigtige—jeg undersøger, om der er understøttelse af SOC 2, muligheder for dataplacering og politikker om nulopbevaring, især når arbejdsgange behandler følsom tekst som patientjournaler. Et godt økosystem afrunder det hele: Et værktøj, der kan integreres med din MLOps-stak og datainfrastruktur, sparer måneder med specialudviklet integrationsarbejde.
Sådan vælger du NLP-software
Det er let at fare vild i lange funktionslister og komplekse prisstrukturer. For at hjælpe dig med at holde fokus, mens du arbejder dig gennem din unikke udvælgelsesproces for software, får du her en tjekliste over faktorer, du bør have in mente:
| Faktor | Hvad skal du overveje? |
|---|---|
| FaktorSkalerbarhed | Hvad skal du overveje?Kan softwaren vokse sammen med dit team? Se efter værktøjer, der kan håndtere øgede datamængder uden ekstra omkostninger. Overvej fremtidige behov og potentielle udvidelser. |
| FaktorIntegrationer | Hvad skal du overveje?Fungerer den sammen med dine eksisterende systemer? Kontrollér, at den er kompatibel med dine nuværende værktøjer, så du undgår afbrydelser i arbejdsgangen. |
| FaktorTilpasningsmuligheder | Hvad skal du overveje?Kan du tilpasse den til dine behov? Sørg for, at du kan justere indstillinger eller funktioner, så de passer til dine specifikke processer. |
| FaktorBrugervenlighed | Hvad skal du overveje?Er brugerfladen brugervenlig? Komplekse værktøjer kan bremse ibrugtagningen. Se efter intuitive designs, der kræver minimal oplæring. |
| FaktorImplementering og introduktion | Hvad skal du overveje?Hvor lang tid tager det at komme i gang? Vurder den tid, der kræves til opsætning og oplæring. En hurtig introduktion kan spare tid og ressourcer. |
| FaktorPris | Hvad skal du overveje?Passer den til dit budget? Sammenlign prisplaner, og vær opmærksom på skjulte gebyrer. Overvej de samlede ejeromkostninger, ikke kun den oprindelige pris. |
| FaktorSikkerhedsforanstaltninger | Hvad skal du overveje?Er dine data beskyttet? Sørg for, at kravene til databeskyttelse overholdes, og se efter kryptering og andre sikkerhedsfunktioner. |
| FaktorTilgængelig support | Hvad skal du overveje?Er supporttjenesterne tilgængelige, når der er brug for dem? Vurder tilgængeligheden og kvaliteten af kundesupportkanaler som chat, e-mail eller telefon. |
Hvad er NLP-software?
NLP-software er et værktøj, der behandler og analyserer data om menneskeligt sprog. Fagfolk som dataforskere, marketingmedarbejdere og kundeserviceteams bruger disse værktøjer til at udlede indsigt og forbedre kommunikationen. Funktioner til tekstanalyse, sentimentanalyse og sprogoversættelse hjælper med at forstå og imødekomme brugernes behov.
Overordnet set forbedrer disse værktøjer, herunder software til samtaleintelligens, beslutningstagningen og effektiviteten i sprogrelaterede opgaver.
Funktioner
Når du vælger NLP-software, bør du holde øje med følgende vigtige funktioner:
- Tekstanalyse: Behandler store mængder tekstdata for at udlede meningsfuld indsigt, så teams kan forstå tendenser og mønstre.
- Sentimentanalyse: Identificerer og kategoriserer holdninger, der kommer til udtryk i tekst, for at vurdere kundernes indstilling og forbedre strategier for kundeengagement.
- Sprogoversættelse: Konverterer tekst fra ét sprog til et andet og letter global kommunikation og tilgængelighed.
- Software til stemmegenkendelse: Transskriberer talt sprog til tekst, muliggør stemmeinput og forbedrer tilgængeligheden.
- Entitetsgenkendelse: Identificerer og klassificerer vigtige elementer i tekst, f.eks. navne og datoer, for at organisere data bedre.
- Flersproget understøttelse: Tilbyder funktioner på flere sprog, hvilket muliggør bredere anvendelse på tværs af forskellige regioner.
- Tilpasningsmodeller: Giver brugerne mulighed for at tilpasse algoritmer til specifikke behov, hvilket øger resultaternes relevans og nøjagtighed.
- Behandling i realtid: Giver øjeblikkelig analyse og feedback, hvilket er afgørende for tidsfølsomme anvendelser og beslutningstagning.
- Indstillinger for databeskyttelse: Sikrer overholdelse af regler om databeskyttelse og beskytter følsomme oplysninger.
- Cloudintegration: Muliggør problemfrit samarbejde og adgang til data på tværs af forskellige platforme og enheder.
Fordele
Implementering af NLP-software giver flere fordele for dit team og din virksomhed. Her er nogle af dem, du kan se frem til:
- Forbedret kommunikation: Software til naturlig sproggenerering og talegenkendelse gør global og tilgængelig kommunikation lettere.
- Bedre beslutningstagning: Tekstanalyse og sentimentanalyse giver indsigt, der kan danne grundlag for strategier og handlinger.
- Tidsbesparelser: Behandling i realtid leverer hurtig feedback, så der kan reageres og handles hurtigere.
- Omkostningseffektivitet: Automatisering af opgaver som entitetsgenkendelse reducerer behovet for manuel datahåndtering og sparer ressourcer.
- Øget nøjagtighed: Tilpasningsmodeller sikrer, at resultaterne er skræddersyet til specifikke behov, hvilket forbedrer resultatets præcision.
- Datasikkerhed: Indstillinger for databeskyttelse hjælper med at holde følsomme oplysninger sikre og i overensstemmelse med reglerne.
- Skalerbarhed: Flersproget understøttelse og cloudintegration muliggør vækst og tilpasning på tværs af forskellige markeder.
Omkostninger & priser
Valg af NLP-software kræver en forståelse af de forskellige prismodeller og tilgængelige abonnementer. Omkostningerne varierer afhængigt af funktioner, teamstørrelse, tilføjelser og meget mere. Tabellen nedenfor opsummerer almindelige abonnementer, deres gennemsnitlige priser og typiske funktioner, der er inkluderet i NLP-softwareløsninger:
Sammenligningstabel for abonnementer til NLP-software
| Abonnementstype | Gennemsnitlig pris | Almindelige funktioner |
|---|---|---|
| AbonnementstypeGratis abonnement | Gennemsnitlig pris$0 | Almindelige funktionerGrundlæggende tekstanalyse, begrænset sprogunderstøttelse og support fra fællesskabet. |
| AbonnementstypePersonligt abonnement | Gennemsnitlig pris$10-$30/user/month | Almindelige funktionerSentimentanalyse, sprogoversættelse og e-mailsupport. |
| AbonnementstypeVirksomhedsabonnement | Gennemsnitlig pris$40-$100/user/month | Almindelige funktionerTalegenkendelse, entitetsgenkendelse og telefonsupport. |
| AbonnementstypeEnterprise-abonnement | Gennemsnitlig pris$150+/user/month | Almindelige funktionerTilpasningsmodeller, behandling i realtid og dedikeret kontoadministration. |
Ofte stillede spørgsmål om NLP-software
Her er nogle svar på almindelige spørgsmål om NLP-software:
Kan NLP-software integreres med mine eksisterende værktøjer?
De fleste NLP-softwareløsninger tilbyder integrationsmuligheder med populære platforme såsom CRM-systemer og dataanalyseværktøjer. Tjek kompatibiliteten med din nuværende teknologistak for at sikre et problemfrit workflow og deling af data. Nogle løsninger kan kræve tilpasset API-udvikling for at kunne integreres.
Hvor sikkert er NLP-software?
Sikkerhedsfunktionerne varierer fra udbyder til udbyder, men se efter datakryptering, overholdelse af regler om databeskyttelse og regelmæssige sikkerhedsopdateringer. Sørg for, at softwaren opfylder branchens standarder for databeskyttelse og datasikkerhed, især hvis den håndterer følsomme oplysninger.
Er tilpasning mulig med NLP-software?
Mange NLP-værktøjer tilbyder tilpasningsmuligheder, så funktioner og modeller kan skræddersys til dine behov. Det kan omfatte justering af algoritmer eller oprettelse af specifikke workflows til databehandling. Graden af tilpasning kan dog variere, så kontrollér funktionerne, før du vælger en løsning.
Hvilken form for support er tilgængelig for brugere af NLP-software?
Supporttjenester spænder fra online-ressourcer som ofte stillede spørgsmål og vejledninger til live-kundesupport via chat, e-mail eller telefon. Vurder disse tjenesters tilgængelighed og svartid, og overvej, hvor vigtigt det er at have dedikeret support, især under implementeringen.
Er NLP det samme som AI?
NLP er et underområde inden for kunstig intelligens. Mens AI-software dækker en bred vifte af funktioner, fokuserer NLP specifikt på behandling af menneskesprog.
Kan NLP-software forstå slang eller uformelt sprog?
Nogle NLP-værktøjer er trænet til at genkende uformelt sprog, slang eller regionale udtryk, men nøjagtigheden kan variere afhængigt af de data, der blev brugt til at træne modellen.