ETL-pipelines er et sæt processer, der bruges til at flytte data fra én eller flere kilder til en database eller et datavarehus. ETL står for “udtræk, transformering og indlæsning” og beskriver de processer, der kræves for at gøre dette. Viden om, hvordan man opbygger effektive ETL-pipelines, kan i høj grad forbedre din virksomheds indsats inden for forretningsintelligens og forenkle datastyringen.
ETL-pipelines bruges ofte inden for datavidenskab på grund af deres anvendelighed til datarensning og optimering af datasæt. De er dog også nyttige i erhvervssammenhænge, især i den moderne verden med store datamængder.
I dag kan mange værktøjer effektivisere arbejdsgange inden for datastyring, og som vi vil gennemgå i denne vejledning, udgør disse værktøjer en afgørende del af moderne ETL-pipelines.
Hvad er ETL-pipelines?
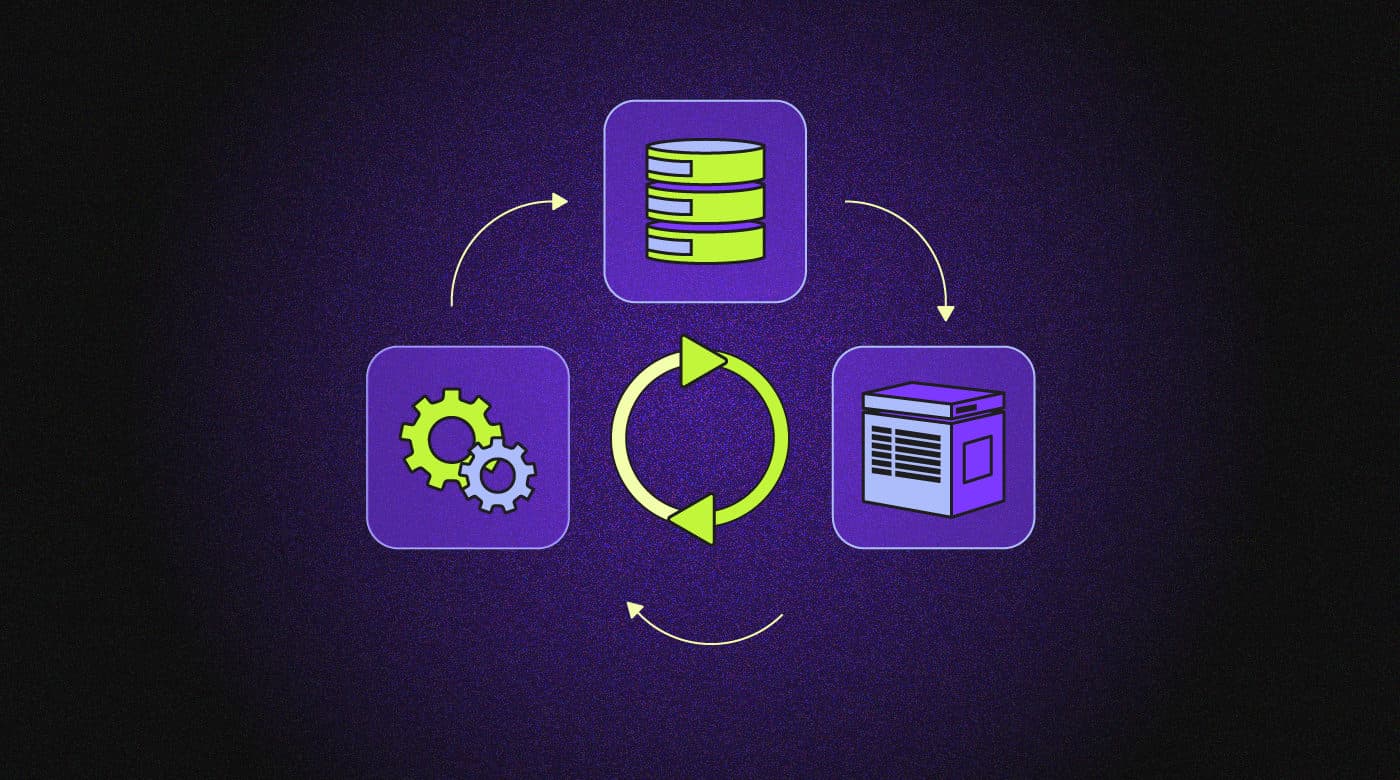
ETL står for udtræk, transformering og indlæsning. Lad os se på hvert trin i processen:
- Udtræk: Denne proces henter data fra en API, udtrækker dem fra en database eller læser dem fra et dump (f.eks. en XML- eller JSON-fil). Afhængigt af antallet af datakilder, du gerne vil udtrække data fra, kan opsætning af forbindelser og fortolkning af data være en kompleks proces. Værktøjer til datastyring kan ofte hjælpe med at konvertere data fra flere kilder til ét ensartet format.
- Transformering: Når dataene er indhentet, er næste trin at rense dem, fjerne dubletter, standardisere dataene (f.eks. ved at sikre, at alle datoer følger det samme format), omstrukturere dem, så de matcher måldatabasens skema, og sikre, at alle felter er tilknyttet korrekt. Dette kan være en tidskrævende proces, og den kan kræve regelmæssig gennemgang, hvis nogle af datakilderne ændrer den måde, de leverer data på.
- Indlæsning: Endelig kan de transformerede data importeres til måldatabasen, datavarehuset eller platformen. Den præcise proces for gennemførelse af denne upload kan variere afhængigt af målplatformen. Den første indlæsning kan tage noget tid, da den indebærer upload af store datamængder for at udfylde databasen. Fremover kan opdateringer håndteres gennem trinvise dataændringer, men der kan lejlighedsvis udføres fulde opdateringer for at sikre dataintegriteten. Mange dataingeniører automatiserer opdateringsprocessen og planlægger den til perioder uden for spidsbelastning, hvor kildesystemerne vil opleve minimal trafik.
Planlægning og design af effektive ETL-pipelines
Den enorme datamængde, som ETL-pipelines håndterer, gør implementeringen til en betydelig opgave. For at sikre, at processen bliver en succes, skal dataingeniører have en god forståelse af de data, de skal behandle, samt målene for dem, der arbejder med dataene.
Have an account? Log In
Vigtige overvejelser, før du opbygger en ETL-pipeline
Der er nogle få vigtige udfordringer ved håndtering af store datamængder:
- Datamængde: Et centralt element er mængden af indsamlede data og de omkostninger, der er forbundet med lagring (og transmission) af disse data. I nogle tilfælde har organisationer ingen kontrol over mængden af data, der leveres af tredjeparter, når de anmoder om en eksport. Du kan dog beslutte, hvilke data der skal gemmes, og hvilke der er overflødige.
- Datavariation: Du skal også overveje de typer og formater af data, du arbejder med, samt om dataene er strukturerede eller ustrukturerede. Dataingeniører kan håndtere denne udfordring ved at bruge værktøjer til transformation og standardisering for at konvertere alle data til et fælles format.
- Datahastighed: Beskriver den hastighed og hyppighed, hvormed data indsamles. En høj datahastighed kan skabe problemer, når du forsøger at automatisere dine pipelines, især hvis du leder efter de mest nøjagtige data fra alle kilder til datadrevet beslutningstagning.
Når du har håndteret disse problemer, kan du overveje formålet med at konsolidere dataene og de overordnede mål for dataanalysen. Disse mål kan påvirke beslutninger om databasedesign.
Valg af de rette ETL-værktøjer og -teknologier
Det er muligt at skrive dine egne ETL-værktøjer fra bunden — og nogle mindre organisationer vælger denne vej, fordi de antager, at det vil være billigere og nemmere end at arbejde med standardløsninger.
Selvom dette kan være tilfældet, når der kun importeres fra én eller to datakilder, som sjældent ændrer deres eksportformater, er det sjældent den bedste løsning. ETL-værktøjer tilbyder mere avancerede løsninger til databehandling, datarensning og profilering, avancerede funktioner til automatisering og batchbehandling samt betydelige fordele med hensyn til pålidelighed og brugervenlighed.
Når du vælger en ETL-løsning, skal du overveje følgende:
- Understøttede dataformater (SQL-, XML-, JSON- og CSV-filer osv.)
- API-integrationer
- Muligheden for streaming i realtid til indlæsning af data (Apache Kafka er en populær løsning til dette)
- Om løsningen er cloudbaseret (Værktøjer, der understøtter nem indlæsning af data i Amazon AWS- eller Google Cloud-datasøer, kan være uvurderlige for organisationer, der kræver fleksibilitet og smidighed i deres datalager)
- Svartider ved support
- Priser
Der findes mange løsninger med åben kildekode til ETL, hvoraf nogle tilbyder gratis fællesskabsudgaver og finansierer deres udvikling ved at opkræve betaling for teknisk support. Hvis din organisation har et begrænset budget til implementering af ETL, kan du spare mange penge ved at vælge en udbredt løsning med åben kildekode.
Designprincipper for skalerbare og vedligeholdelsesvenlige ETL-pipelines
Når du designer en ETL-pipeline, er det afgørende ikke kun at overveje de datakilder, du arbejder med nu, men også hvordan dine behov kan udvikle sig i fremtiden. Nogle ting, du bør overveje, omfatter:
- Modulært design: Opdel systemet i dataudtræk, datarensning og indlæsningsprocessen. Overvej de forskellige dataformater, du muligvis skal arbejde med, og opret et modulært system, så det er nemt at ændre forskellige dele af systemet uden at ødelægge hele pipelinen.
- Fejlhåndtering: Design dit system, så det håndterer fejl på en hensigtsmæssig måde og viser en tydelig fejlmeddelelse, hvis det møder data, det ikke forstår, eller som er i et forkert format. Det er bedre at lade et system springe poster over, som det ikke kan håndtere, og vise en advarselsmeddelelse end at lade det fejle fuldstændigt, hvilket kan medføre forsinkelser i indlæsningsprocessen eller, endnu værre, indlæse forkerte data og beskadige det primære datalager.
- Tydelig og komplet dokumentation: Tydelig dokumentation er afgørende. Husk, at ikke alle i dit team er dataforskere. Mange af de personer, der arbejder med dataene, kan være teamledere eller afdelingschefer, som blot ønsker en nem måde at få adgang til realtidsdata fra flere forskellige kilder på én gang. Udarbejd ét sæt dokumentation til dem og ét sæt til udviklerne, der forklarer pipelinen mere detaljeret. Beskriv vigtige designprincipper som modularitet, fejlhåndtering og dokumentationspraksis.
ETL-pipeline kontra datapipeline
ETL- og datapipelines er processer, der ligner hinanden, men som bruges til lidt forskellige formål. En ETL-pipeline omfatter udtræk af data fra en eller flere kilder, transformation af disse data og derefter indlæsning af dem.
En datapipeline kan derimod omfatte nogle eller alle ovenstående trin, men slutter ikke med indlæsningsprocessen. Når dataene er blevet indlæst, kan de bruges i andre processer og arbejdsgange, for eksempel i et visualiseringssystem eller til betinget at udløse en handling i et automatiseringssystem.

Author's Tip
Betragt en ETL-pipeline som en type datapipeline med en snævert defineret rolle: at tage strukturerede og ustrukturerede data, transformere dem til et fælles format og gemme dem i et datalager eller en database.
Vigtige fordele ved ETL-pipelines
ETL-pipelines kan være utroligt nyttige til at understøtte systemer til analyse og forretningsanalyse. Fordi de samler data fra flere kilder, for eksempel ved at samle data fra sociale medier, CRM-systemer, ERP-værktøjer og andre databaser, gør de det nemmere at opnå præcis indsigt i virksomheden.
ETL-processen omfatter optimering, validering og rensning af data, hvilket hjælper med at sikre, at de oplysninger, der ender i databasen, er så præcise og aktuelle som muligt.
Pålideligheden af dine ETL-pipelines afhænger af de værktøjer, du bruger. En pipeline kan være så enkel som nogle få Python-skripter eller noget mere robust, der bruger Snowflake, Kafka og andre moderne værktøjer. I dag er de tilgængelige værktøjer til behandling af data og opbygning af en ETL-pipeline ganske modne. Brugervenlige grafiske brugergrænseflader og aktive brugerfællesskaber gør det muligt for selv nybegyndere inden for datavidenskab at komme i gang med ETL-pipelines.
Ulemper ved ETL-pipelines
Selvom værktøjskæderne til opbygning af ETL-pipelines er modne, og skydatalagre i dag er langt mere overkommelige, end de var for nogle få år siden, er der stadig nogle udfordringer forbundet med opbygning af datapipelines:
- Det kan være vanskeligt at håndtere strukturerede, ustrukturerede og semistrukturerede data.
- Omkostningerne til datalagring kan være uoverkommelige for nogle organisationer.
- Datastreaming i realtid kan både være komplekst og ressourcekrævende.
- Kortlægning af databaser og opsætning af integrationer er ikke en engangsopgave. Dataleverandører kan ændre deres eksportformater eller databaseskemaer, hvilket kræver, at du ændrer din datapipeline.
Implementering af ETL-pipeline
Overvej følgende arbejdsgang ved implementering af en ETL-pipeline:
- Opret referencedata, så du har noget at arbejde med, når du udfører datatransformationer.
- Byg forbindelser til de datakilder, du gerne vil arbejde med, f.eks.:
- API-grænseflader til sociale medieplatforme
- Skrabeværktøjer til websider (hvis TOS tillader det)
- Parsere til XML-/CSV-/JSON-filer
- Databaseforbindelser til dine egne lokale systemer
- Definer regler for validering af dataene.
- Anvend transformationer til at rense og standardisere dataene samt fjerne dubletter.
- Upload dataene til et staging-system.
- Indlæs dataene fra staging-systemet i datalageret.
Nogle af ovenstående trin er valgfrie. Referencedata er f.eks. ikke påkrævet, men det er nyttigt, fordi det gør det nemmere at definere regler for test af dataene og udførelse af transformationer. Derudover er det ikke nødvendigt at placere data i staging, før de indlæses. Det er dog en god praksis at gøre det, fordi det er nemmere at rulle staging-laget tilbage, hvis noget går galt, og laget kan bruges til revisionsrapporter og andre krav til overholdelse.
More Articles
ETL-pipelineværktøjer, du kan afprøve
Mange tilgængelige ETL-værktøjer kan effektivisere databehandling, aggregering, rensning og indlæsning i dit målsystem. Markedet for ETL-software er vurderet til omkring 3,1 milliarder dollar og forventes at nå 10,3 milliarder dollar i 2030, så der mangler ikke muligheder.
Nogle populære værktøjer omfatter:
- Informatica Power Center: En alsidig løsning med cloud-understøttelse, herunder værktøjer uden eller med minimal kodning til ETL-pipelines
- Apache Airflow: En effektiv open source-platform med muligheder for kommandolinje- og grafisk brugergrænseflade
- IBM Infosphere Datastage: En hurtig og effektiv løsning med funktioner til belastningsfordeling og parallelisering
Der findes mange andre muligheder, herunder løsninger fra Oracle og Microsoft. Når du vælger en ETL-løsning, bør du overveje dit budget og dit eksisterende økosystem, da det kan være et pålideligt og omkostningseffektivt valg at fortsætte med leverandører, du allerede kender godt.
Vigtigste pointer
ETL-pipelines er en afgørende del af datastyringen i moderne virksomheder, der behandler store datamængder. Implementering af en ETL-pipeline kan hjælpe med at forbedre organisationens beslutningstagning og give virksomheden en konkurrencemæssig fordel.
Det kan dog være udfordrende at håndtere rådata fra flere kilder, og teknologiledere skal understrege vigtigheden af omhyggelig planlægning og dokumentation gennem hele processen samt overholde reglerne for databeskyttelse og privatliv.
Hvis du vil vide mere om ETL-pipelines, databehandling og andre udfordringer og innovationer inden for big data, kan du tilmelde dig CTO Club-nyhedsbrevet.