

Databricks är kraftfullt, men passar inte alltid. Kanske har ditt team stött på problem med prissättningen, haft svårt att komma över plattformens inlärningskurva eller behöver något mer flexibelt för lösningar med flera moln eller lokala installationer. Oavsett vilket är du som läser detta förmodligen på jakt efter ett alternativ som erbjuder liknande datalakehouse-funktionalitet utan kompromisserna.
Jag har arbetat med datateam i allt från nystartade företag till större organisationer för att utvärdera och implementera plattformar som Databricks, Snowflake och andra. Jag har på nära håll sett vad som krävs för att stödja storskalig analys, sammanföra röriga datakällor och bygga tillförlitliga datapipelines som faktiskt används.
I den här guiden går jag igenom de Databricks-alternativ som är värda att överväga – verktyg som hjälper dig att lagra, omvandla och utforska data på ett mer intuitivt sätt, samtidigt som du får utrymme att skala upp och anpassa lösningen när ditt team växer.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell: Databricks-konkurrenter
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val bland Databricks-konkurrenterna.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för molnbaserad datalagring | Nej | Pris på begäran | Website | |
| 2 | Beste voor cloudopslag met end-to-endversleuteling | 14 dagen gratis proefperiode | Vanaf $19/gebruiker/maand (jaarlijks gefactureerd) | Website | |
| 3 | Het meest geschikt voor uitgebreide analyses van IT-prestaties | Niet beschikbaar | $25/user/month | Website | |
| 4 | Bäst för minnesbaserad bearbetning | Gratisplan tillgänglig | Pris på begäran | Website | |
| 5 | Bäst för snabba SQL-frågor | Ja | Från $6.25/TiB bearbetad | Website | |
| 6 | Bäst för företagsdatabasbehov | Gratis provperiod tillgänglig | $68/användare/månad (faktureras årsvis) | Website | |
| 7 | Bäst för SQL-analys | 30 dagars kostnadsfri provperiod | $30/user/month (faktureras årligen) | Website | |
| 8 | Bäst för Hadoop-bearbetning | Inte tillgängligt | Från $0.007084/vCPU-timme | Website | |
| 9 | Bäst för hanterad Spark och Hadoop | Inte tillgängligt | Från $0.06/DCU-timme | Website | |
| 10 | Bäst för AI- och ML-lösningar | Gratis demo tillgänglig | Pris på begäran | Website |


Recension av de bästa Databricks-konkurrenterna
Nedan hittar du mina detaljerade sammanfattningar av de bästa Databricks-konkurrenterna som kom med på min kortlista. I mina recensioner får du en detaljerad genomgång av de viktigaste funktionerna, fördelarna & nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.

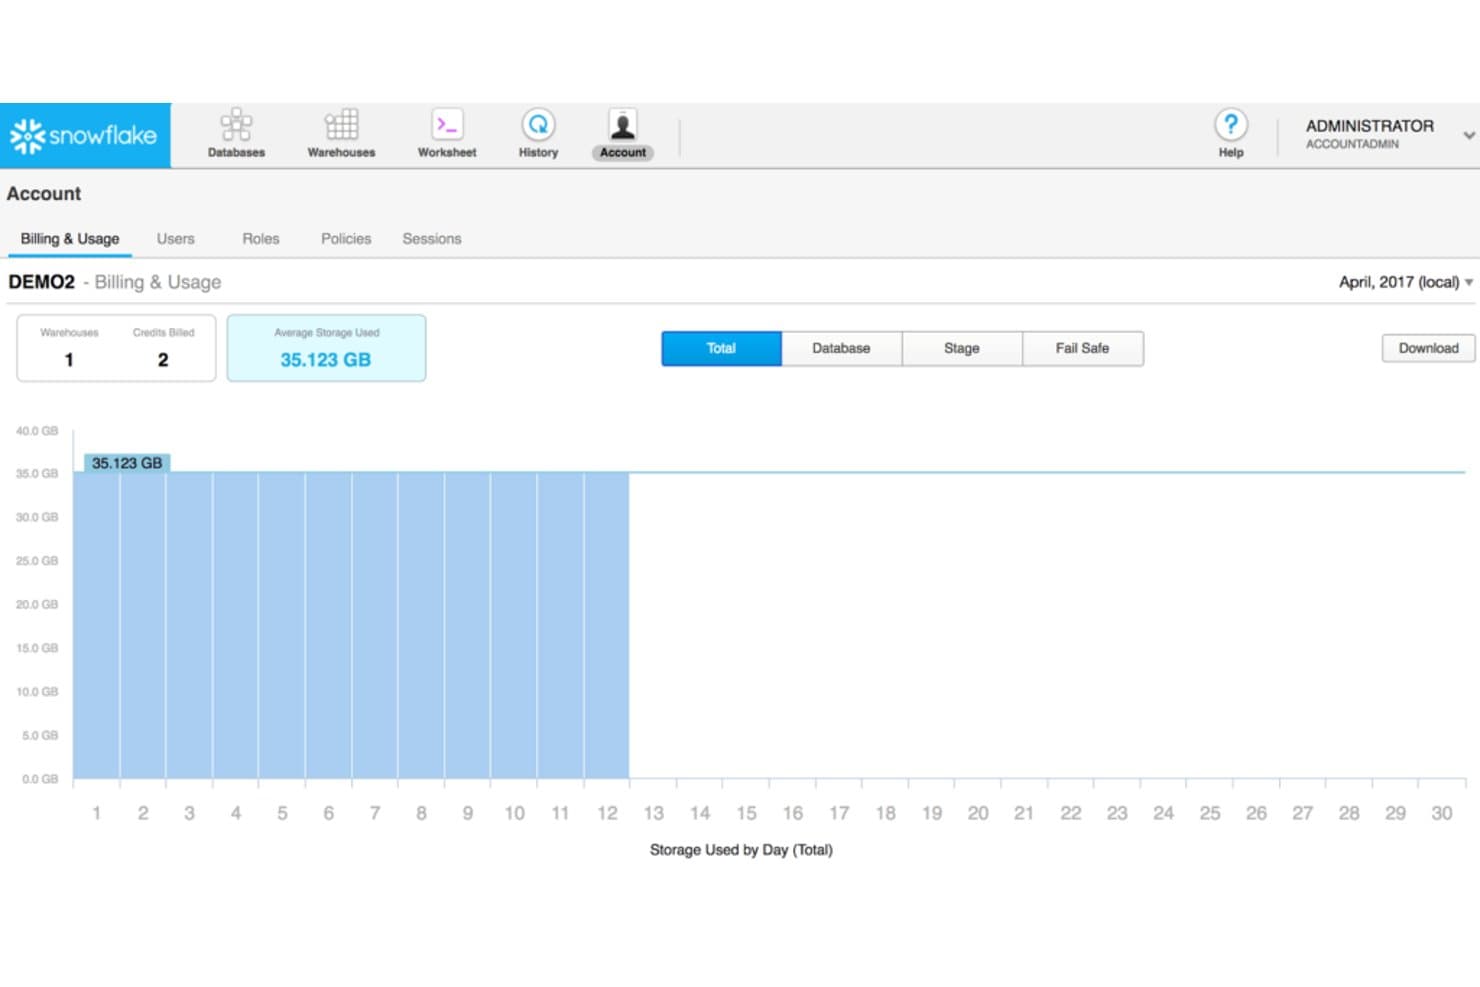
Snowflake följer lagrings- och kreditförbrukningen per dag i en och samma instrumentpanel. Snowflake ger IT- och analysteam en molnbaserad dataplattform för att sammanföra olika datamängder, köra SQL-frågor i stor skala och tillhandahålla styrd åtkomst utan att hantera datalagerinfrastruktur.
Vem passar Snowflake bäst för?
Datateknik- och analysteam som behöver ett molndatalager för att söka i och dela data mellan affärssystem.
Varför jag valde Snowflake
Jag valde Snowflake som ”Bäst för molnbaserad datalagring” eftersom den separata lagringen och beräkningskapaciteten gör att jag kan skala SQL-analyser utan att ändra storlek på datalagret. Jag uppskattar också den styrda datadelningen när team behöver söka i datamängder mellan affärssystem utan att kopiera dem till separata datalager.
Snowflakes viktigaste funktioner
- Dynamiska tabeller: Definiera datapipelines med SQL och ange önskad uppdateringsfördröjning.
- Snowpipe: Läs in data från förberedda filer när de anländer.
- Tidsresa: Sök i, klona eller återställ historiska data inom lagringsperioden.
- Snowflake Marketplace: Upptäck och få åtkomst till datamängder och applikationer från tredje part.
Snowflake-integrationer
Snowflake erbjuder Openflow-anslutningar för Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL och Microsoft SQL Server. Plattformen tillhandahåller även inbyggda anslutningar för ServiceNow, MySQL och Kafka samt REST API:er för anpassade integrationer.
Pros and Cons
Pros:
- Oberoende skalning av beräkningskapaciteten hanterar variationer i arbetsbelastningen
- Hanterade SQL-datalager minskar behovet av infrastrukturunderhåll
- Säker delning eliminerar behovet av att kopiera datamängder mellan team
Cons:
- Förbrukningstoppar kan göra kostnaderna oförutsägbara
- Proprietära funktioner kan försvåra migrering till en annan plattform
Learn more about Snowflake: Beste voor cloudopslag met end-to-endversleuteling
- 14 dagen gratis proefperiode
- Vanaf $19/gebruiker/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5
Tresorit biedt versleutelde synchronisatie en het delen van bestanden, waardoor de privacy en naleving van regelgeving van bedrijven worden gewaarborgd. Tresorit is een platform voor cloudopslag en het delen van bestanden. Het biedt veilige cloudwerkruimten, het delen van bestanden met toestemmingsbeheer, oplossingen voor digitale ondertekening en e-mailversleuteling.
Waarom ik Tresorit heb gekozen: Tresorit biedt sterke end-to-endversleuteling, waardoor gegevens vanaf het aanmaken tot het delen en ondertekenen worden beschermd. Hierdoor onderscheidt het zich van andere cloudopslagoplossingen die mogelijk niet hetzelfde beveiligingsniveau bieden. Bovendien betekent het versleutelingsmodel zonder inzage dat alleen de gebruiker toegang heeft tot de versleutelingssleutels, waardoor het de beste keuze is voor veilige cloudopslag.
Opvallende functies & integraties:
Functies omvatten end-to-endversleuteling, veilig delen van bestanden met toestemmingsbeheer, oplossingen voor digitale ondertekening en e-mailversleuteling.
Integraties omvatten Microsoft Outlook, Google Drive, Dropbox, Box, Nextcloud, ownCloud, Egnyte, Boxcryptor, Gmail en Swiss Post.
Pros and Cons
Pros:
- End-to-endversleuteling
- Veilig delen van bestanden
- Oplossingen voor digitale ondertekening
Cons:
- Hogere kosten dan sommige alternatieven
- Installatie kan lastig zijn voor niet-technische gebruikers
Learn more about MongoDB Atlas: Het meest geschikt voor uitgebreide analyses van IT-prestaties
- Niet beschikbaar
- $25/user/month
Visit WebsiteCustomer Rating:4.2/5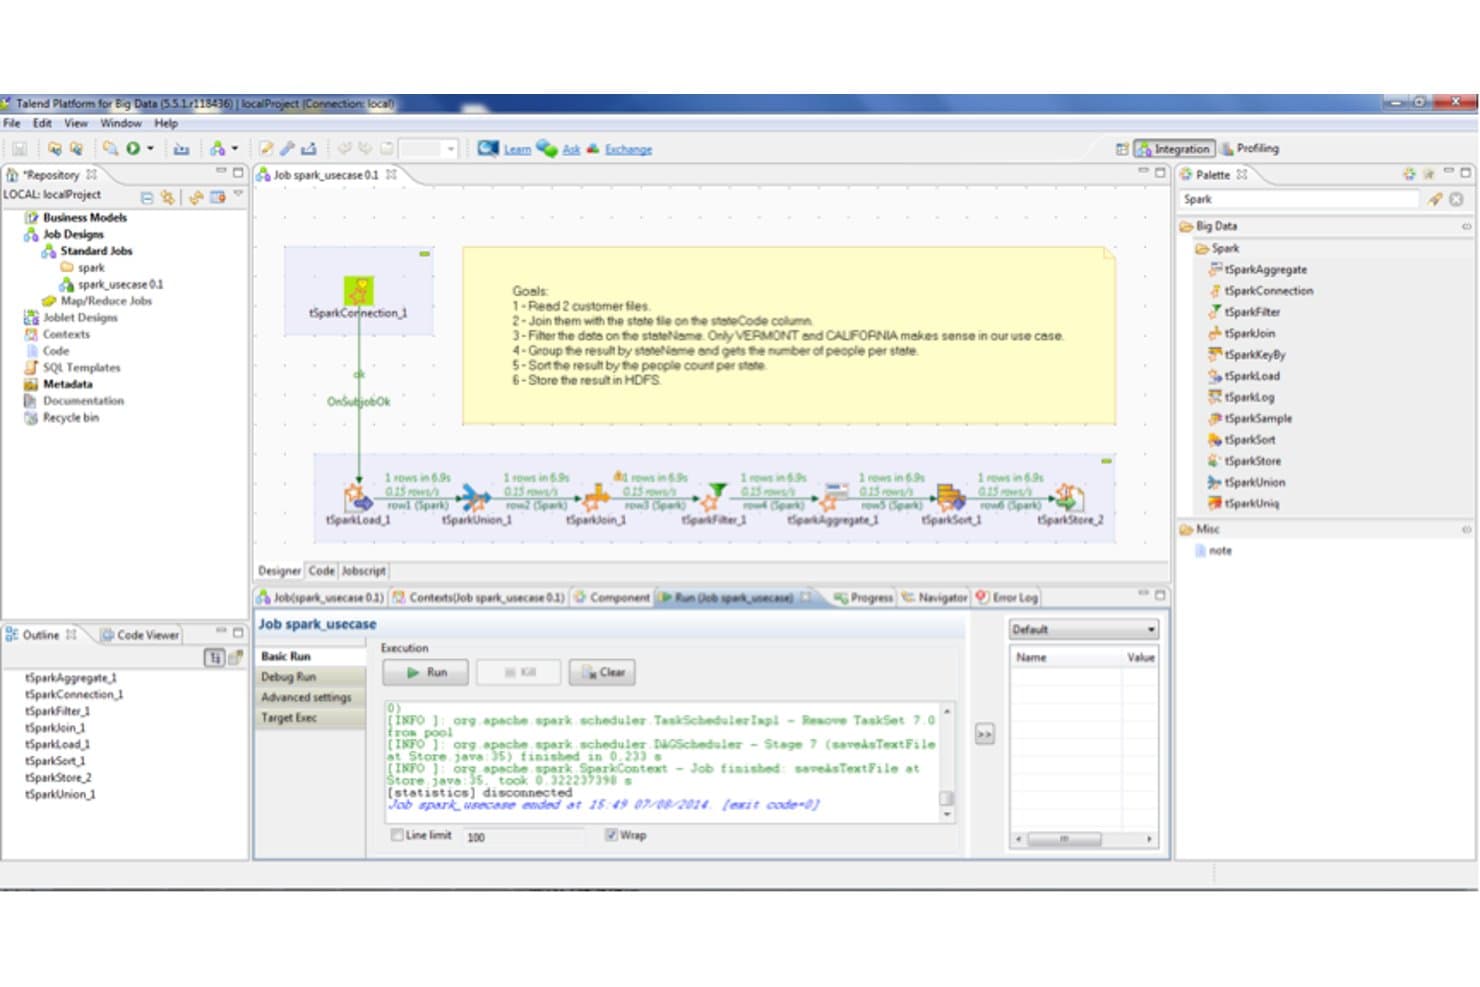
SysAid biedt een uitgebreide bibliotheek met ingebouwde rapporten voor belangrijke IT-categorieën. SysAid combineert IT-servicemanagement, assettracking en workflowautomatisering voor IT-teams die aanvragen, incidenten en ondersteuningsactiviteiten moeten beheren naarmate hun organisatie groeit.
Voor wie is SysAid het meest geschikt?
SysAid is een goede keuze voor IT-operationsteams en servicedeskteams die analyses nodig hebben om de prestaties van de ondersteuning te volgen en trends te identificeren.
Waarom ik voor SysAid heb gekozen
Ik heb SysAid gekozen als ServiceNow-concurrent voor ondernemingen van de volgende generatie, omdat het aansluit bij “Het meest geschikt voor uitgebreide analyses van IT-prestaties.” De BI-analysedashboards tonen het volume van serviceregistraties, SLA-naleving, oplossingstrends en overdrachten tussen medewerkers, zodat ik kan zien waar tickets blijven hangen. Ik kan ook de werklast van incidenten en aanvragen vergelijken om te zien waar de vraag toeneemt.
Belangrijkste functies van SysAid
- Selfserviceportaal: Medewerkers kunnen serviceaanvragen indienen en volgen via een centraal portaal.
- IT-assetbeheer: Houd hardware- en software-assets bij naast serviceregistraties.
- Workflowautomatisering: Configureer regels voor het routeren en verwerken van serviceaanvragen.
- Kennisbank: Maak artikelen waarmee medewerkers veelvoorkomende IT-problemen kunnen oplossen.
Integraties van SysAid
SysAid biedt integraties met Jira, Lansweeper en Microsoft Teams, plus door Workato mogelijk gemaakte verbindingen met meer dan 1.000 apps, waaronder Salesforce, Azure DevOps, Slack, Zoom, Workday en Zendesk. Het ondersteunt ook Zapier en biedt een REST API voor aangepaste integraties.
Pros and Cons
Pros:
- BI-dashboards tonen SLA- en oplossingstrends
- Inzicht in tickettoewijzing en werklast ondersteunt triage
- Automatisering verwerkt repetitieve ticketroutering en onboarding
Cons:
- Voor geavanceerde rapporten is specialistische configuratie nodig
- Het instellen van workflows kan star en complex aanvoelen
Learn more about Talend:
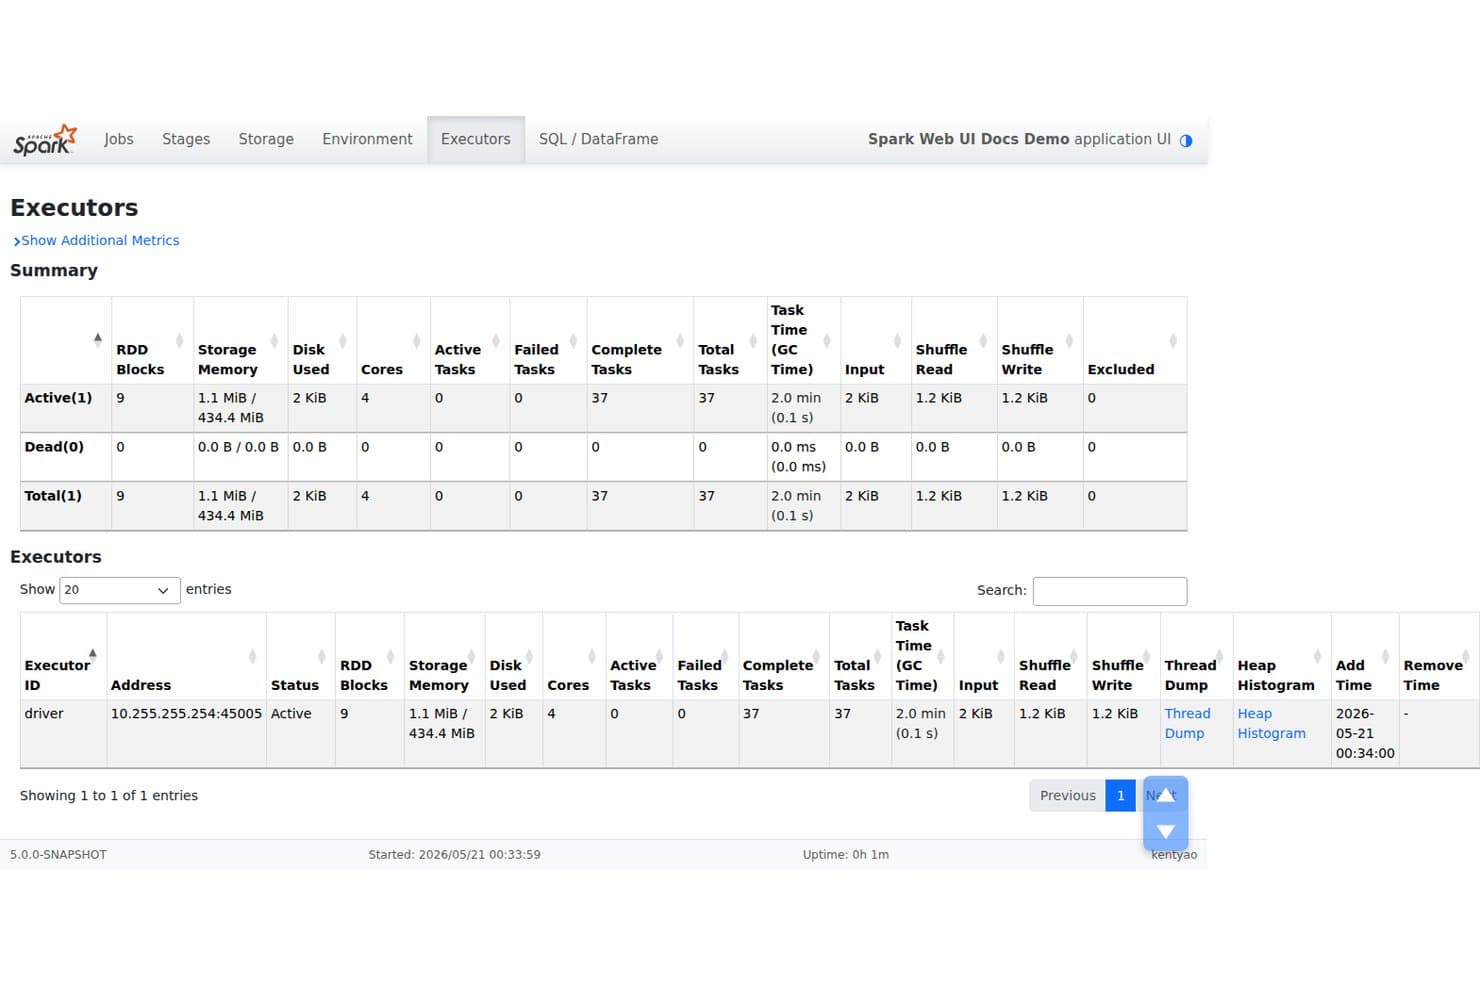
Apache Spark följer exekveringsresurser, uppgifter och minne i realtid. Apache Spark är en analysmotor med öppen källkod för data- och infrastrukturteam som behöver bearbeta stora datamängder, köra distribuerade arbetsbelastningar och bygga datapipelines i olika miljöer.
Vem passar Apache Spark bäst för?
Datateknik- och analysteam som behöver snabb, iterativ bearbetning av stora datamängder över kluster passar bra för Apache Spark.
Därför valde jag Apache Spark
Jag valde Apache Spark som ett alternativ till Databricks eftersom det är bäst för minnesbaserad bearbetning. Spark kan cachelagra eller beständiggöra RDD:er och DataFrames i minnet, så upprepade frågor och iterativa beräkningar slipper läsa om källdata. Det är användbart när stora aggregeringar av händelsedata förfinas genom flera analysomgångar.
Viktiga funktioner i Apache Spark
- Spark SQL: Fråga strukturerade data med SQL- och DataFrame-API:er.
- Strukturerad strömning: Bearbeta livedata med Sparks strömnings-API:er.
- MLlib: Skapa arbetsflöden för maskininlärning med skalbara algoritmer och pipelines.
- Klusterhanterare: Distribuera applikationer på fristående kluster, YARN eller Kubernetes.
Integrationer med Apache Spark
Apache Spark har stöd för anslutningar till Apache Kafka och Apache Hive samt JDBC-anslutningar till databaser som PostgreSQL, MySQL, Oracle och Microsoft SQL Server. Dess API för datakällor stöder anpassade anslutningar; beroenden för Kafka-anslutningen och databasspecifika JDBC-drivrutiner kan behöva läggas till separat.
Pros and Cons
Pros:
- Cachelagrade datamängder snabbar upp iterativa arbetsbelastningar
- Batchbearbetning, strömning, SQL och ML delar en motor
- Körs lokalt eller över Kubernetes- och YARN-kluster
Cons:
- Minnestryck kan utlösa fel på grund av slut på minne
- Optimering och felsökning av distribuerade jobb kräver expertkunskaper
Learn more about Apache Spark:
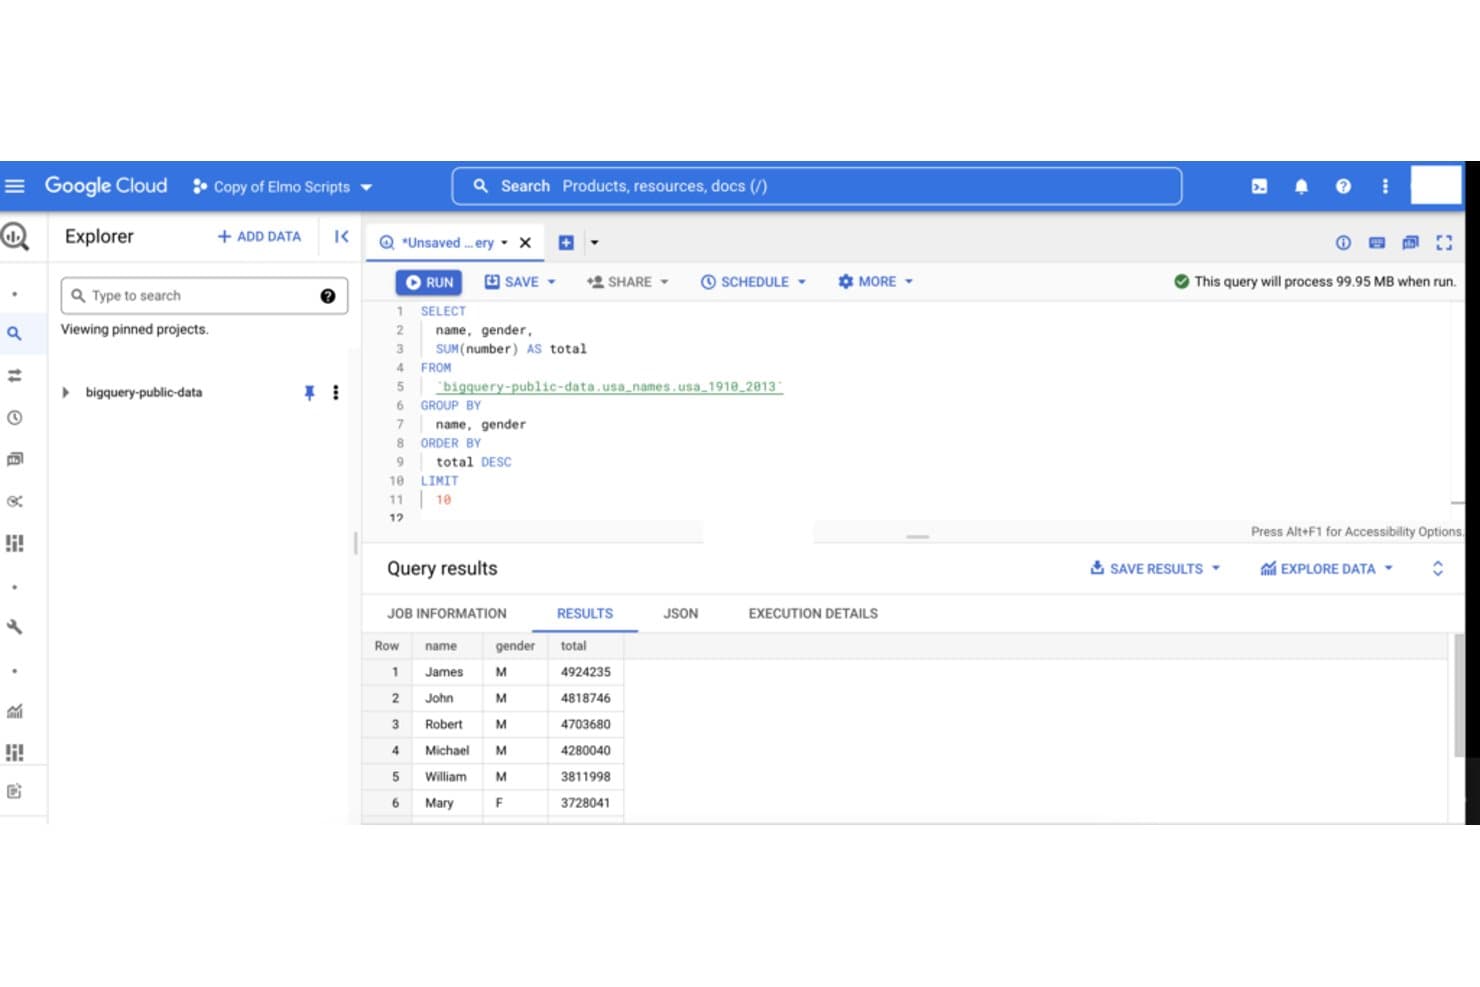
Google BigQuery låter användare köra SQL-frågor på stora offentliga datamängder. För IT- och datateam som behöver skalbar analys utan att hantera datalagrets infrastruktur är Google BigQuery ett molndatalager för att fråga och analysera stora datamängder med SQL.
Vem passar Google BigQuery bäst för?
Dataanalytiker och ingenjörer som behöver köra snabba SQL-frågor över stora molnbaserade datamängder kommer att finna Google BigQuery praktiskt.
Varför jag valde Google BigQuery
Jag valde Google BigQuery som mitt alternativ till Databricks som är ”Bäst för snabba SQL-frågor”. Dess serverlösa frågemotor kör GoogleSQL över stora datamängder, medan tabellpartitionering och klustring kan minska mängden data som skannas för återkommande rapporter. Jag tycker om det för att fråga applikationsloggar eller händelsedata utan att behöva hantera datalagerkluster.
Viktiga funktioner i Google BigQuery
- BigQuery ML: Skapa och kör maskininlärningsmodeller med SQL.
- Schemalagda frågor: Ställ in SQL-jobb så att de körs med valda intervall.
- BigQuery Data Transfer Service: Schemalägg dataimporter från stödda källor.
- Auktoriserade vyer: Dela frågeresultat utan att ge åtkomst till de underliggande tabellerna.
Integrationer med Google BigQuery
Google dokumenterar direkta BigQuery-integrationer med Looker, Looker Studio, Vertex AI Workbench, Managed Service for Apache Spark och Tableau. Dataanslutningar och arbetsflöden för inläsning stöder även Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 och Azure Blob Storage; BigQuerys REST- och Storage-API:er stöder anpassade integrationer.
Pros and Cons
Pros:
- Snabba SQL-skanningar över stora datamängder
- Serverlös drift eliminerar klusterhantering
- Partitionering och klustring kan minska mängden skannad data
Cons:
- Frågekostnaderna kan öka kraftigt utan begränsningar
- Utforskning för affärsanvändare kräver ofta SQL-kunskaper
Learn more about Google BigQuery: Bäst för företagsdatabasbehov
- Gratis provperiod tillgänglig
- $68/användare/månad (faktureras årsvis)
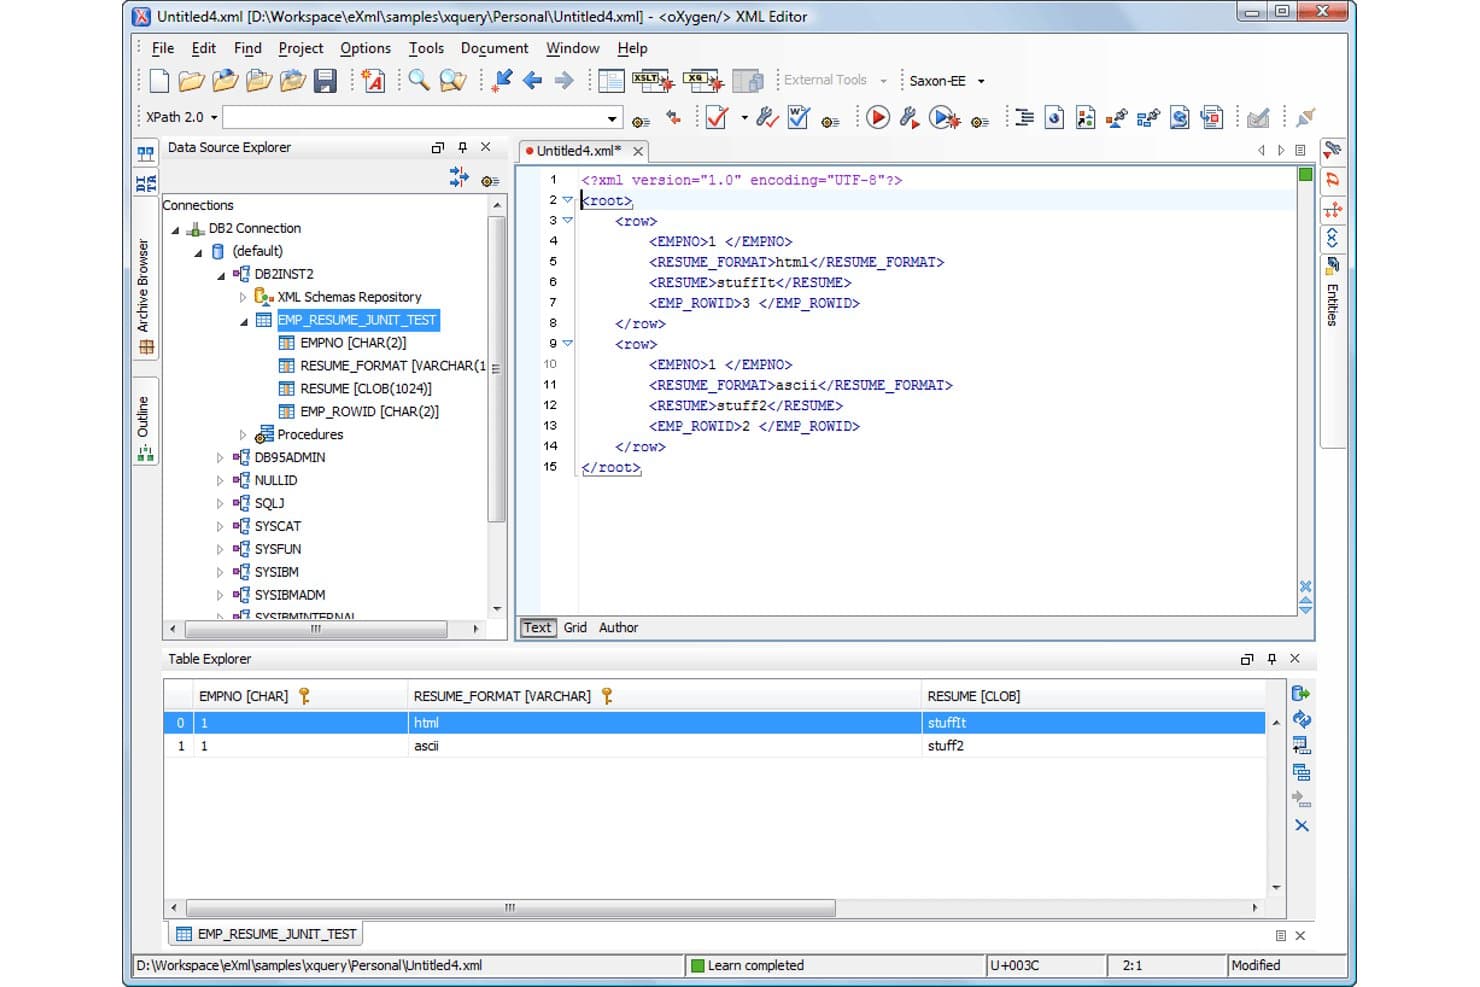
IBM Db2 låter användare bläddra bland databasscheman och visuellt köra frågor mot XML-data. IBM Db2 är ett relationsdatabashanteringssystem för organisationer som behöver köra strukturerade dataarbetsbelastningar i komplexa miljöer och stöder team som hanterar företagsapplikationer, transaktioner och analyser.
Vem passar IBM Db2 bäst för?
Databasadministratörer och IT-team på stora organisationer som stöder verksamhetsapplikationer med stora datavolymer.
Varför jag valde IBM Db2
Jag valde IBM Db2, bäst för företagsdatabasbehov, som ett alternativ till Databricks för centrala affärssystem. Det stöder transaktionsdata, analytiska data och vektordata på en plattform, med AI-driven optimering av arbetsbelastningar för ERP, fakturering och orderhantering. Jag uppskattar den lösningen när relationsdatabasarbetsbelastningar och analyser behöver dela infrastruktur.
Viktiga funktioner i IBM Db2
- Hybridimplementering: Kör Db2 lokalt, i molnet eller i hybridmiljöer.
- Inbyggd kryptering: Kryptera databasinformation och hantera krypteringsnycklar via ett nyckellager.
- Tabellpartitionering: Dela upp tabelldata i partitioner baserat på angivna kolumnvärden.
- Verktyg för säkerhetskopiering och återställning: Db2 Advanced Recovery stöder säkerhetskopiering, återställning och dataextrahering av databaser.
IBM Db2-integrationer
Inbyggda integrationer är inte tydligt dokumenterade. Db2 stöder federerad åtkomst till datakällor som Oracle och Microsoft SQL Server, samt JDBC-, ODBC- och CLI-anslutning för applikationer.
Pros and Cons
Pros:
- Snabb bearbetning för företagets transaktionsarbetsbelastningar
- Hög tillgänglighet med HADR och återställning
- Partitionering stöder stora, blandade arbetsbelastningar
Cons:
- Administration och optimering kräver specialistkompetens
- Molnbaserad drift ligger efter nyare plattformar
Learn more about IBM Db2: Bäst för SQL-analys
- 30 dagars kostnadsfri provperiod
- $30/user/month (faktureras årligen)
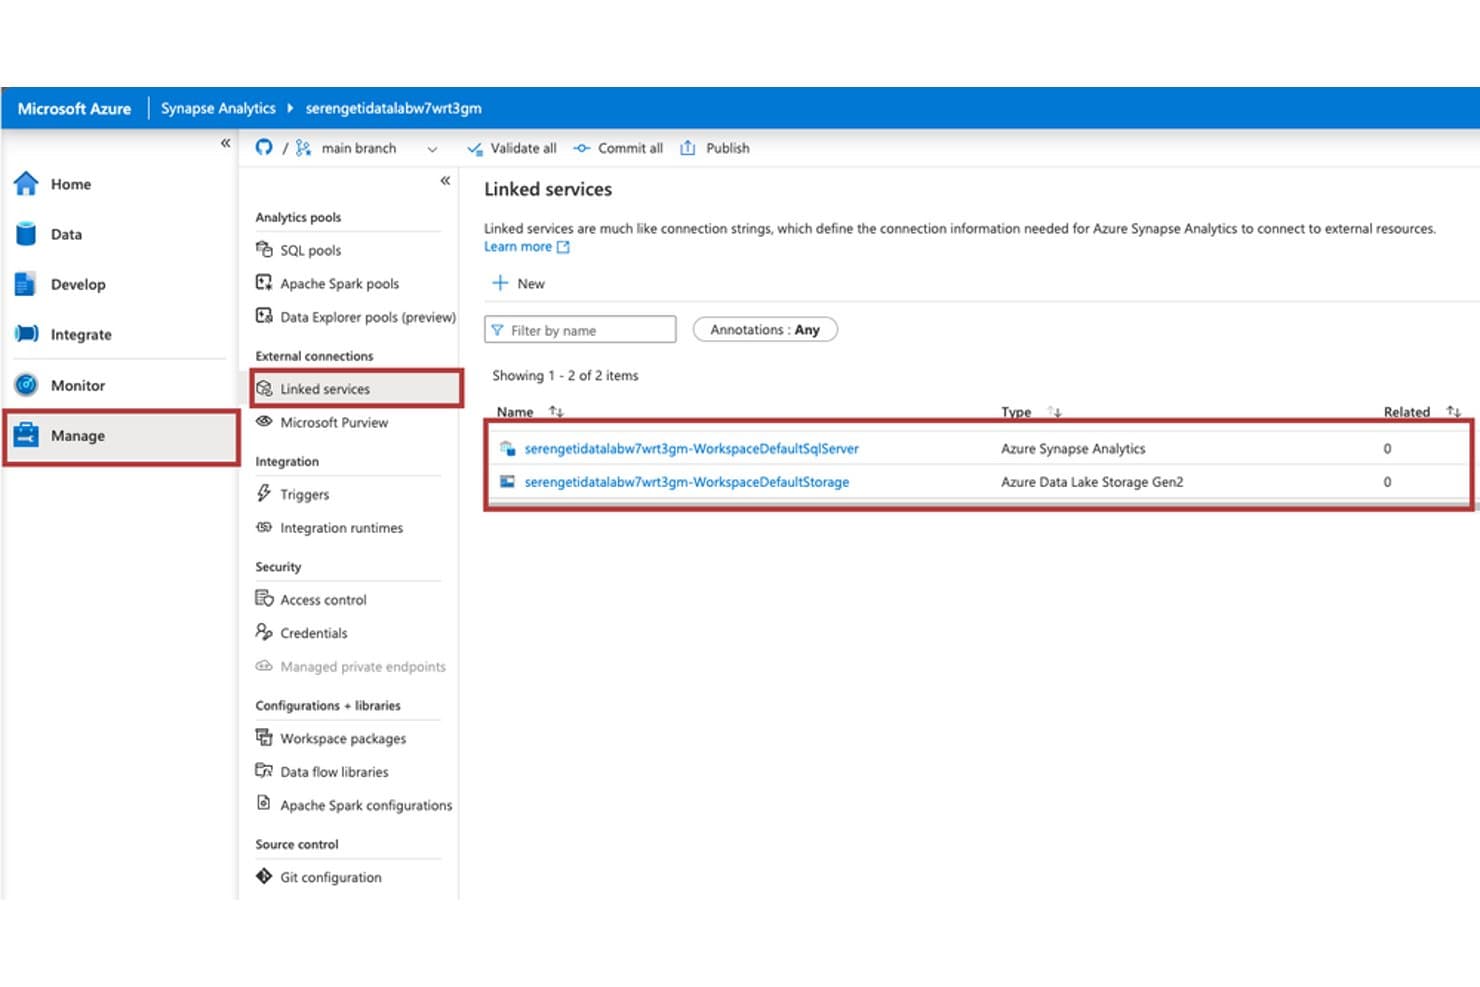
Azure Synapse Analytics hanterar externa anslutningar via länkade tjänster. Azure Synapse Analytics är en molnbaserad analysplattform för data- och IT-team som behöver ansluta företagsdata, köra frågor och stödja rapportering för arbetsbelastningar inom datalager och stordata.
För vem passar Azure Synapse Analytics bäst?
Det passar dataingenjörer och analytiker som behöver SQL-åtkomst till integrerade datamängder för företagsrapportering och analys.
Varför jag valde Azure Synapse Analytics
Jag valde Azure Synapse Analytics för användningsfallet Bäst för SQL-analys: den serverlösa SQL-poolen frågar datafiler i datasjön med T-SQL, medan dedikerade SQL-pooler stöder provisionerade arbetsbelastningar i datalager. Jag uppskattar denna uppdelning när jag behöver granska rådatamängder och leverera återkommande BI-rapporter via SQL.
Viktiga funktioner i Azure Synapse Analytics
- Apache Spark-pooler: Kör Spark-jobb och anteckningsböcker för distribuerad databehandling.
- Pipelines: Orkestrera dataförflyttning och transformering mellan anslutna källor.
- Synapse Studio: Hantera data, kod och analysresurser i en gemensam arbetsyta.
- Power BI-integrering: Anslut Synapse-data till Power BI för att skapa rapporter.
Integreringar med Azure Synapse Analytics
Azure Synapse Analytics har inbyggda pipeline-anslutningar för Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 och SAP HANA, samt en direkt Power BI-anslutning via Synapse Studio. Det tillhandahåller även REST API:er för anpassade integreringar.
Pros and Cons
Pros:
- Serverlösa T-SQL-frågor läser filer i datasjön
- Dedikerade MPP-pooler hanterar arbetsbelastningar i datalager
- Kombinerar SQL-frågor med Spark-bearbetning
Cons:
- Justering av SQL-pooler kräver praktisk expertis
- Felsökning och övervakning av pipelines kan vara begränsade
Learn more about Azure Synapse Analytics:
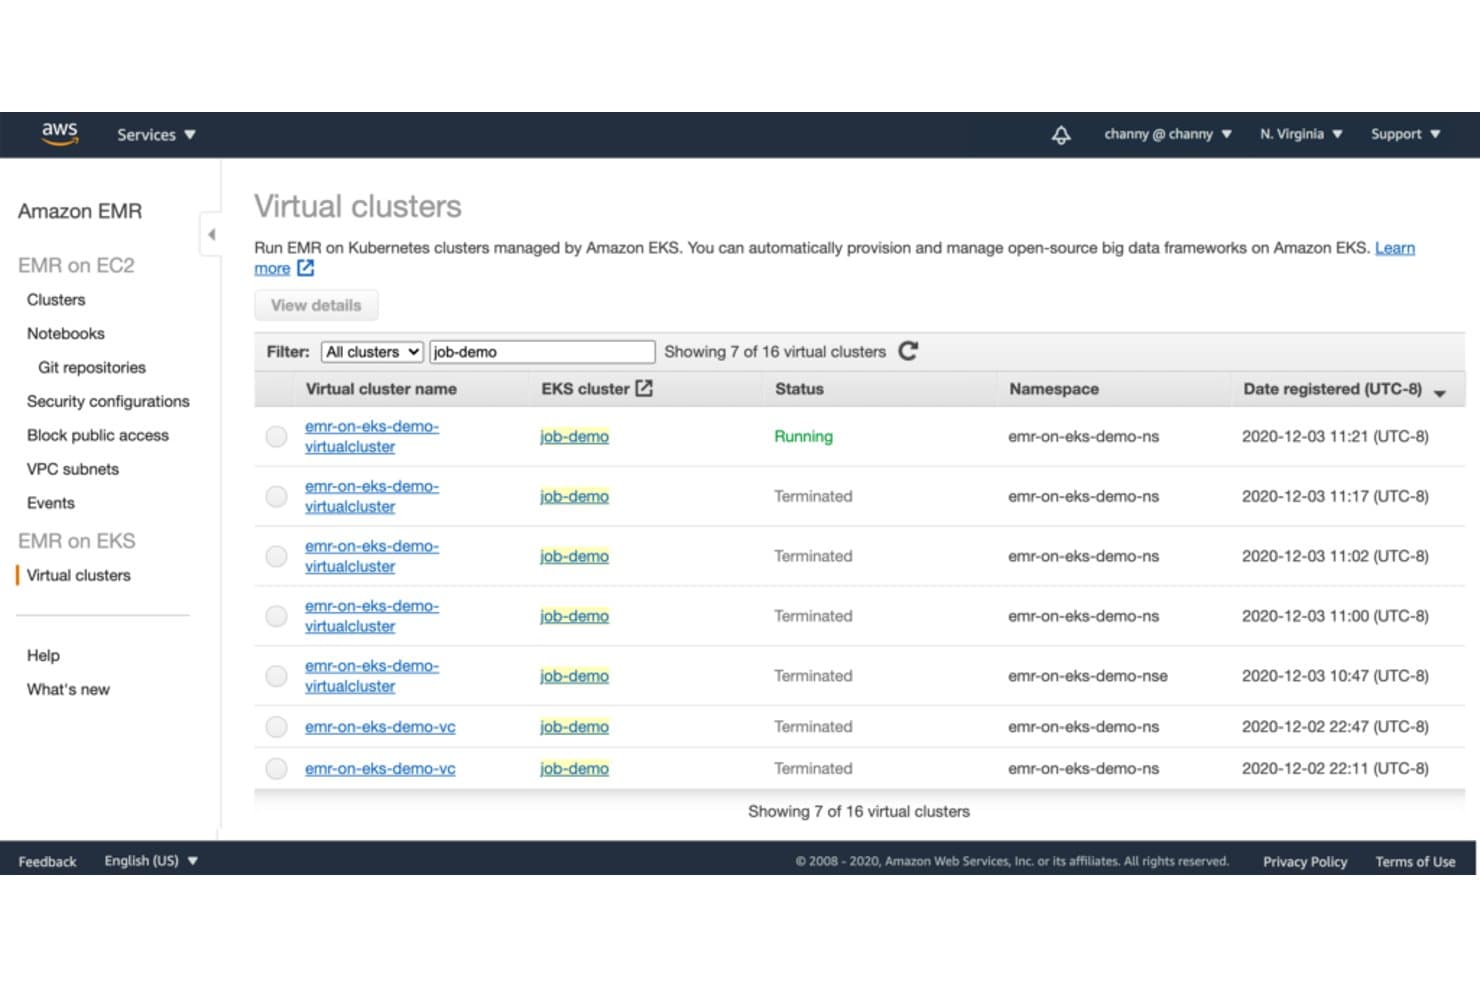
Amazon EMR låter användare hantera virtuella kluster som körs på Amazon EKS. Amazon EMR är AWS:s hanterade plattform för stordata för datateknik- och analysteam som behöver bearbeta stora datamängder, skala distribuerade arbetsbelastningar och minska arbetet med att driva beräkningskluster.
Vem passar Amazon EMR bäst för?
Amazon EMR passar datateknikteam som kör Hadoop- eller Spark-jobb för att bearbeta stora datamängder över distribuerade kluster.
Varför jag valde Amazon EMR
Jag valde Amazon EMR som ett alternativ till Databricks av en anledning: Bäst för Hadoop-bearbetning. De hanterade klustren kör Apache Hadoop och Spark, så jag kan använda MapReduce för att bearbeta arkiverade applikationsloggar och Spark för att analysera resultaten.
Viktiga funktioner i Amazon EMR
- EMR Serverless: Kör dataapplikationer utan att tillhandahålla eller hantera kluster.
- Automatisk skalning: Justera klusterkapaciteten baserat på arbetsbelastningens efterfrågan.
- EMR på EKS: Kör EMR-arbetsbelastningar på Amazon EKS-kluster.
- AWS Glue Data Catalog: Använd en gemensam katalog för tabellmetadata.
Amazon EMR-integreringar
Amazon EMR har dokumenterade integreringar med AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 och Amazon CloudWatch. Tjänsten tillhandahåller även ett API för programmatisk åtkomst och anpassade integreringar.
Pros and Cons
Pros:
- Kör etablerade Hadoop- och Spark-arbetsbelastningar
- Stöder kluster-, serverlös- och EKS-distribution
- Bearbetar stora datamängder över varierande arbetsbelastningar
Cons:
- Långsam automatisk skalning kan göra att jobben får otillräckliga resurser
- Klusterskalning kräver ibland manuell finjustering
Learn more about Amazon EMR: Bäst för hanterad Spark och Hadoop
- Inte tillgängligt
- Från $0.06/DCU-timme
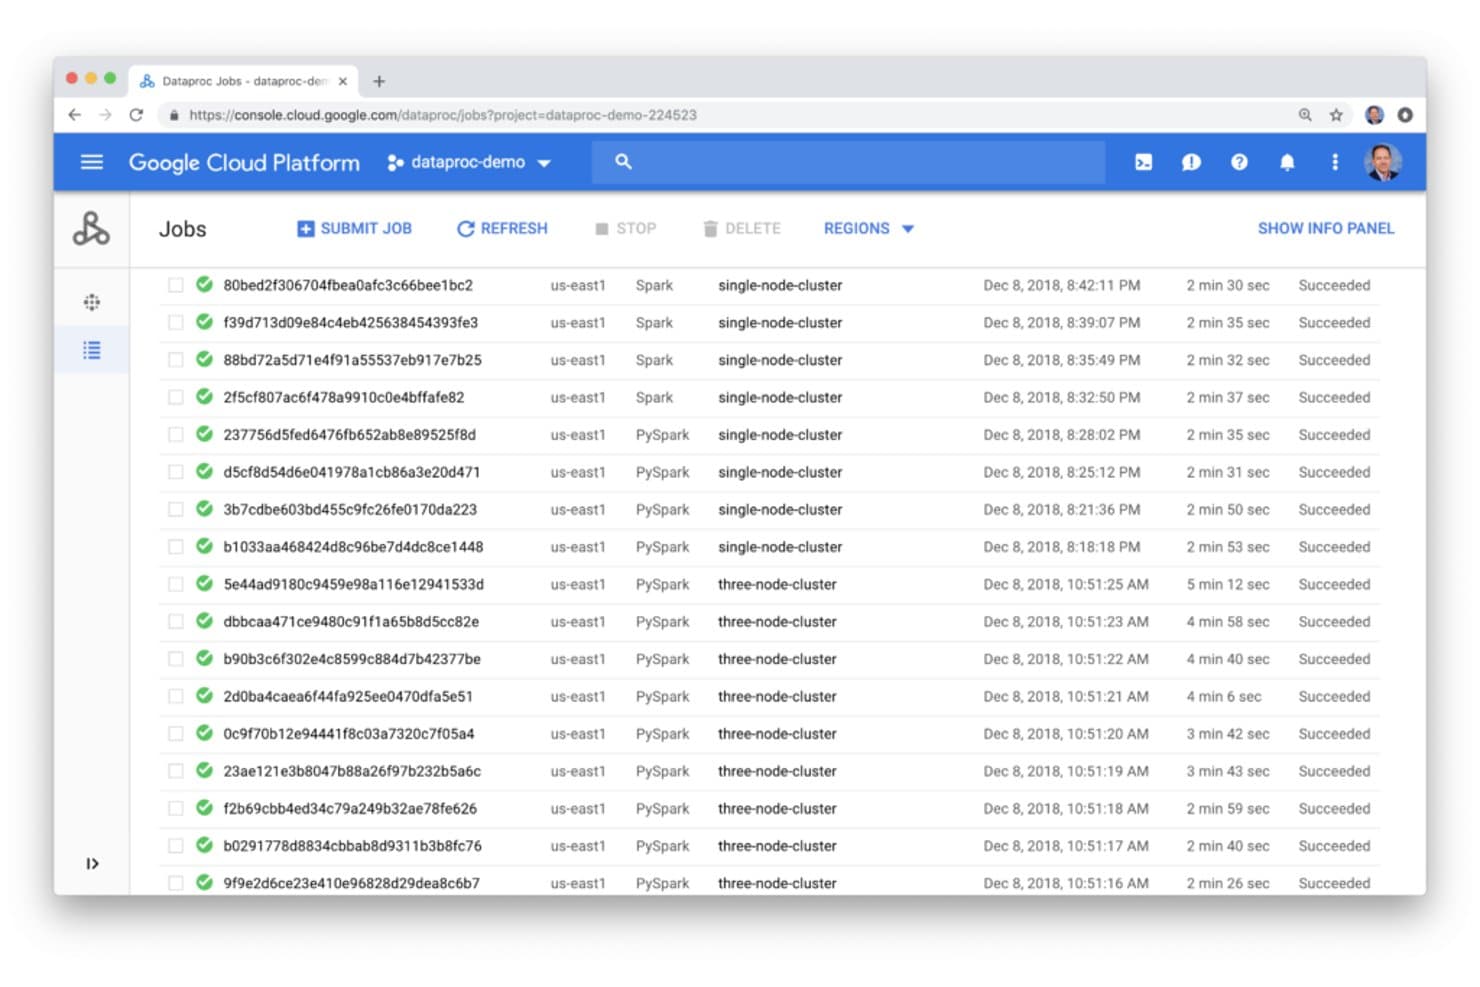
Google Cloud Dataproc låter användare övervaka och hantera Spark-jobb med en överblick. Google Cloud Dataproc ger datateknik- och IT-team en hanterad molnplattform för storskaliga analysarbetsbelastningar, vilket bidrar till att minska klusteradministrationen och stödja datapipelines i Google Cloud.
För vilka passar Google Cloud Dataproc bäst?
Datateknikteam som kör Spark- eller Hadoop-jobb i Google Cloud kan använda Dataproc för att hantera klusterdrift.
Därför valde jag Google Cloud Dataproc
Jag valde Google Cloud Dataproc för arbetsbelastningar där ”Bäst för hanterad Spark och Hadoop” är prioriterat. Hanterade kluster och policyer för automatisk skalning hjälper till att hantera batchjobb med varierande resursbehov, medan Dataproc Serverless kör Spark-batcher utan att kluster behöver etableras. Du kan till exempel bearbeta nattliga händelseloggar med Spark och undvika att låta ett kluster stå oanvänt mellan körningarna.
Viktiga funktioner i Google Cloud Dataproc
- Lightning Engine: Snabbar upp Spark-körningen med vektoriserad bearbetning, cachning och optimerad omfördelning av data.
- Stöd för Apache Iceberg: Fungerar med öppna tabellformat i Google Cloud Storage.
- GPU-acceleration: Stöder NVIDIA RAPIDS för GPU-aktiverad databearbetning.
- Säkerhetskontroller: Integreras med IAM, VPC Service Controls och Kerberos.
Integrationer med Google Cloud Dataproc
Google Cloud Dataproc har inbyggda integrationer med BigQuery, Cloud Storage, Bigtable, Cloud Logging och Cloud Monitoring. Det tillhandahåller även ett REST API och Cloud SDK för hantering av kluster och jobb.
Pros and Cons
Pros:
- Kör befintliga Spark-jobb med minimala omskrivningar
- Snabbt skapande och snabb avveckling av kluster
- Serverlösa batchkörningar eliminerar klusteradministration
Cons:
- Klusteroptimering kräver fortfarande infrastrukturkompetens
- Kostnaderna kan kännas höga för kontinuerliga arbetsbelastningar
Learn more about Google Cloud Dataproc:
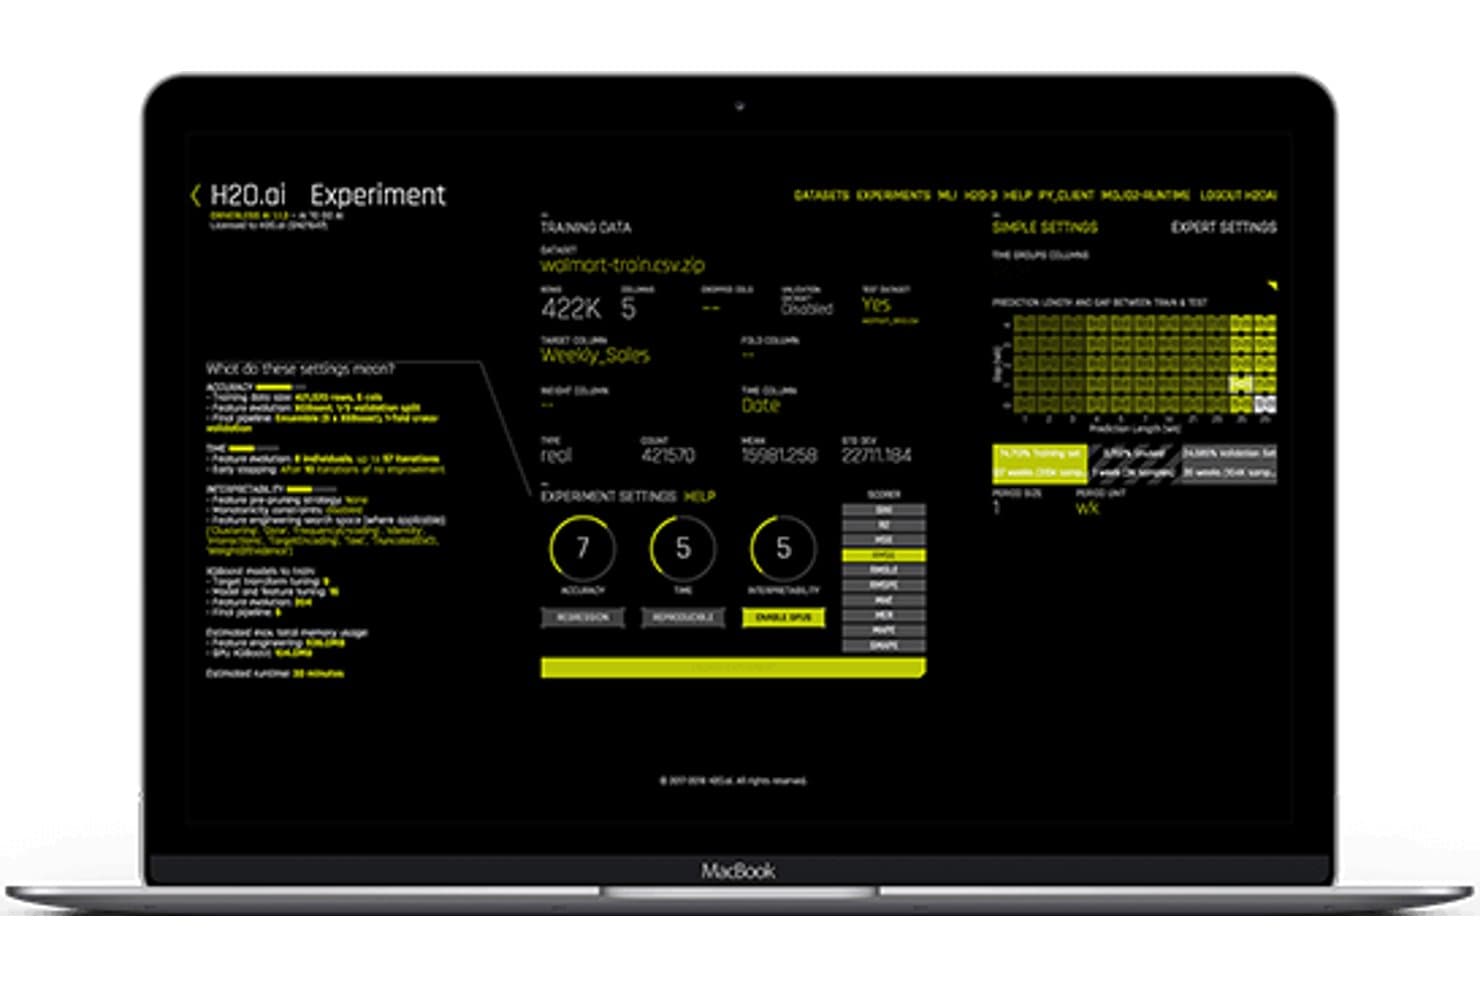
H2O.ai låter användare konfigurera och köra AutoML-experiment visuellt. För team som utvärderar alternativ till Databricks erbjuder H2O.ai en AI- och maskininlärningsplattform som hjälper datateam och IT-team att bygga prediktiva modeller från stora datamängder och omsätta analyser i praktiken.
Vilka passar H2O.ai bäst för?
H2O.ai passar datavetare och maskininlärningsingenjörer som ansvarar för att utveckla AI-modeller och sätta dem i produktion.
Varför jag valde H2O.ai
Jag valde H2O.ai som mitt alternativ till Databricks som är ”bäst för AI- och ML-lösningar” eftersom plattformen fokuserar på att bygga prediktiva modeller från stora datamängder. H2O-3 distribuerar minnesbaserad maskininlärning över kluster, medan AutoML testar algoritmer och rangordnar modeller i en topplista. Jag uppskattar denna lösning när jag behöver jämföra modeller innan jag sätter en av dem i produktion.
Viktiga funktioner i H2O.ai
- Flexibel driftsättning: Kör plattformen lokalt, i ett privat moln, i molnet eller i isolerade nätverksmiljöer.
- Modelloberoende stöd: Välj, byt ut eller finjustera modeller och stora språkmodeller.
- Förklarbarhet: Granska förklaringar till AI-drivna beslut.
- Revisionsspår: Spåra plattformsaktivitet med revisionsspår som är redo för granskning.
H2O.ai-integrationer
H2O Driverless AI tillhandahåller dataanslutningar för Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, JDBC-källor och Delta Tables. Med dessa anslutningar kan team söka i eller importera data från befintliga plattformar för maskininlärningsarbetsflöden.
Pros and Cons
Pros:
- AutoML påskyndar modelljämförelser och prototyputveckling
- Distribuerad minnesbaserad träning skalas över kluster
- Driftsättning i isolerade nätverksmiljöer stöder kontrollerade miljöer
Cons:
- Alternativen för databearbetning är begränsade
- Ett omständligt användargränssnitt kan bromsa arbetsflöden
Learn more about H2O.ai:
Andra Databricks-konkurrenter
Här är några ytterligare alternativ till Databricks som inte kom med på min kortlista, men som ändå är värda att ta en titt på:
- 11DremioBäst för självbetjäningsanalys
- 12QuboleBäst för arbetsbelastningar med stora datamängder
- 13Azure DatabricksBäst för kollaborativ analys
Så utvärderar jag Databricks-konkurrenter
Jag utvärderar varje alternativ i två lager: grundläggande krav på datasjöhus och beräkning samt särskiljande faktorer.
Grundläggande funktioner
- Enhetlig datasjöhusarkitektur: Stöd för strukturerade och ostrukturerade data samt öppna tabellformat som Delta, Iceberg eller Hudi.
- Distribuerad databehandling: Skalbar satsvis bearbetning och strömningsbearbetning för stora arbetsbelastningar.
- Integrerade ML/AI-arbetsflöden: Experiment, modellregister, driftsättning och betjäning.
- Samarbetsmiljö för notebookar: Delade notebookar, versionshantering och stöd för SQL, Python, Scala och R.
- Datastyrning och säkerhet: Datakatalog, detaljerade åtkomstkontroller och datahärkomst.
- Flera moln och öppen integration: Stöd för AWS, Azure och GCP samt integrationer med Airflow, Tableau och dbt.
Varje verktyg poängsätts från 0 till 5 för varje grundläggande funktion och måste nå minst 65 procent för att inkluderas.
Särskiljande faktorer
Jag jämför serverlös beräkning, inbyggda GenAI-verktyg, kostnadsoptimering, total ägandekostnad, ekosystemets bredd, implementeringstid, migreringsverktyg och dokumentation.
Så väljer du en Databricks-konkurrent
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för att välja programvara kommer här en checklista över faktorer att tänka på:
| Faktor | Vad man bör tänka på |
| Skalbarhet | Säkerställ att lösningen kan hantera din datatillväxt utan prestandaförlust. Kontrollera om den stöder både horisontell och vertikal skalning för flexibilitet. |
| Integrationer | Leta efter kompatibilitet med dina befintliga verktyg, till exempel datasjöar eller BI-verktyg, för att säkerställa ett smidigt dataflöde och undvika isolerade processer. |
| Anpassningsbarhet | Utvärdera plattformens förmåga att anpassa sig till teamets specifika arbetsflöden och processer. Anpassningsbara instrumentpaneler kan tillgodose olika teambehov. |
| Användarvänlighet | Ta hänsyn till inlärningskurvan och hur intuitivt gränssnittet är för ditt team. En användarvänlig plattform kan minska utbildningstiden och öka användningen. |
| Budget | Jämför prismodeller och säkerställ att de ryms inom din budget. Ta hänsyn till dolda kostnader, som lagring eller avgifter för ytterligare användare, som kan påverka ditt beslut. |
| Säkerhetsåtgärder | Bedöm plattformens säkerhetsfunktioner, till exempel datakryptering och efterlevnad av branschstandarder, för att skydda känsliga data. |
| Kundsupport | Kontrollera tillgängligheten för olika kundsupportalternativ, inklusive livechatt och communityforum, för att säkerställa att ditt team kan få hjälp när det behövs. |
| Prestanda | Ta reda på hur plattformen hanterar stora datamängder och bearbetning i realtid för att säkerställa att den uppfyller teamets prestandaförväntningar. |
Trender bland Databricks-konkurrenter
I min efterforskning samlade jag in otaliga produktuppdateringar, pressmeddelanden och versionsloggar från olika leverantörer som konkurrerar med Databricks. Här är några av de framväxande trenderna som jag håller ögonen på:
- Realtidsanalys: Företag efterfrågar i allt högre grad datainsikter i realtid. Leverantörer förbättrar sina plattformar för att bearbeta och analysera data i realtid, vilket gör det möjligt för användare att fatta omedelbara beslut. Lösningar som Google BigQuery inför funktioner som stöder dataströmning i realtid.
- Förstärkt analys: Den här trenden innebär att AI och maskininlärning används för att förbättra dataanalysprocesser. Den blir allt populärare eftersom den hjälper användare att upptäcka insikter utan manuellt arbete. IBM Watson Studio är ett exempel som erbjuder funktioner för förstärkt analys för att automatisera dataanalys.
- Demokratisering av data: Allt fler plattformar fokuserar på att göra data tillgängliga för icke-tekniska användare. Den här trenden är avgörande för att främja en datadriven kultur inom organisationer. Verktyg utvecklas med intuitiva gränssnitt och funktioner för självbetjäning, som de som finns i Alteryx.
- Datastyrning: När dataskyddsbestämmelserna blir strängare blir funktioner för datastyrning allt viktigare. Leverantörer integrerar styrningsverktyg för att hjälpa användare att följa bestämmelser och hantera data ansvarsfullt. Azure Synapse Analytics erbjuder till exempel inbyggda funktioner för datastyrning.
- Stöd för hybridmoln: Många företag vill ha flexibilitet i sina molnstrategier. Stöd för hybridmoln ökar, vilket gör det möjligt för användare att hantera data i både lokala miljöer och molnmiljöer. Cloudera leder denna trend genom att tillhandahålla lösningar som stöder hybridmolndistributioner.
Vad är en Databricks-konkurrent?
Databricks-konkurrenter är programvarulösningar som är utformade för att tillhandahålla funktioner för databearbetning, analys och maskininlärning. Dessa verktyg används vanligtvis av datavetare, ingenjörer och analytiker för att få insikter och driva affärsbeslut.
Funktioner för realtidsanalys, förstärkt analys och datastyrning hjälper till att bearbeta data effektivt, upptäcka insikter och hantera data ansvarsfullt. Sammantaget ger dessa verktyg företag möjlighet att utnyttja sina data för förbättrat beslutsfattande och strategisk planering.
Funktioner hos Databricks-konkurrenter
När du väljer en Databricks-konkurrent bör du hålla utkik efter följande viktiga funktioner:
- Analys i realtid: Möjliggör omedelbar databearbetning och insikter, så att du kan fatta snabba affärsbeslut.
- Förstärkt analys: Använder AI för att automatisera dataanalys och hjälper till att upptäcka insikter utan manuellt arbete.
- Datastyrning: Säkerställer efterlevnad av dataskyddsbestämmelser och ansvarsfull datahantering.
- Stöd för hybridmoln: Möjliggör hantering av data i både lokala miljöer och molnmiljöer för ökad flexibilitet.
- Interaktivt samarbete: Underlättar teamwork genom att tillhandahålla gemensamma arbetsytor och verktyg för gemensam dataanalys.
- Automatisk skalning: Anpassar resurserna efter arbetsbelastningen och optimerar prestandan utan manuella åtgärder.
- Integrering av maskininlärning: Erbjuder inbyggda funktioner för maskininlärning för avancerade dataprediktioner och insikter.
- Anpassningsbarhet: Möjliggör personliga arbetsflöden och instrumentpaneler som passar specifika teambehov och processer.
- Säkerhetsskydd: Tillhandahåller kryptering och funktioner för efterlevnad för att skydda känsliga data.
- Användarvänligt gränssnitt: Säkerställer enkel användning, minskar inlärningskurvan och ökar användningen inom teamet.
Fördelar med en Databricks-konkurrent
Att implementera en Databricks-konkurrent ger flera fördelar för ditt team och din verksamhet. Här är några av dem du kan se fram emot:
- Förbättrat beslutsfattande: Analys i realtid och förstärkt analys ger omedelbara insikter och förbättrar teamets beslutsförmåga.
- Ökat samarbete: Funktioner för interaktivt samarbete gör det möjligt för teamet att arbeta effektivt tillsammans, vilket leder till mer sammanhållna dataprojekt.
- Skalbarhet: Automatisk skalning gör att systemet effektivt kan hantera ökande datamängder utan manuella justeringar.
- Kostnadseffektivitet: Prismodeller där du betalar efter användning säkerställer att du bara betalar för de resurser du använder och optimerar budgethanteringen.
- Förbättrad säkerhet: Inbyggda säkerhetsskydd skyddar dina data och säkerställer efterlevnad av branschstandarder.
- Flexibilitet: Stöd för hybridmoln ger flexibilitet att hantera data i olika miljöer och anpassa sig efter verksamhetens behov.
- Anpassning: Anpassningsbara funktioner låter dig skräddarsy arbetsflöden och instrumentpaneler efter dina specifika krav, vilket ökar produktiviteten.
Kostnader och priser för en Databricks-konkurrent
När du väljer en Databricks-konkurrent behöver du förstå de olika prismodellerna och tillgängliga abonnemangen. Kostnaderna varierar beroende på funktioner, teamets storlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar från Databricks-konkurrenter:
Jämförelsetabell för abonnemang hos en Databricks-konkurrent
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
| Gratisabonnemang | $0 | Grundläggande databearbetning, begränsad lagring och community-support. |
| Personligt abonnemang | $10-$30 /user /month | Förbättrad dataanalys, personliga instrumentpaneler och e-postsupport. |
| Företagsabonnemang | $50-$100 /user /month | Avancerade analysverktyg, funktioner för teamsamarbete och prioriterad support. |
| Enterprise-abonnemang | $150-$300/user /month | Anpassade integreringar, dedikerad kontohantering och säkerhet på företagsnivå. |
Vanliga frågor om Databricks konkurrenter
Här är några svar på vanliga frågor om Databricks konkurrenter:
Vem är Databricks största konkurrent?
Snowflake anses ofta vara Databricks största konkurrent på grund av dess liknande molnbaserade dataplattformsfunktioner. Båda erbjuder omfattande funktioner för databearbetning och analys, men Snowflake är känt för sina styrkor inom datalager. Beroende på dina specifika behov kan vilket som helst av dem vara ett bra val.
Vad kommer att ersätta Databricks?
Även om inget enskilt verktyg är inställt på att ersätta Databricks erbjuder alternativ som SQL Server övertygande funktioner. SQL Server integreras väl med dataanalysverktyg som Power BI och erbjuder ett robust relationsdatabashanteringssystem. Ditt val beror på dina specifika krav på databearbetning.
Vilka begränsningar har Databricks?
Databricks har vissa begränsningar, till exempel begränsningar av antalet widgetar i en notebook samt teckenbegränsningar för widgetnamn och inmatningar. Dessa begränsningar kan påverka hur du utformar och interagerar med data i notebooks, så planera därefter om dessa begränsningar påverkar dina arbetsflöden.
Vilka är Amazon Databricks konkurrenter?
Amazon Databricks möter konkurrens från plattformar som Snowflake, vilka erbjuder liknande funktioner för databearbetning. Snowflake tillhandahåller en molnbaserad datalagerlösning som är allmänt erkänd för sin skalbarhet och användarvänlighet, vilket gör den till en stark konkurrent på marknaden.
Hur står sig Databricks prissättning jämfört med konkurrenternas?
Databricks prissättning kan variera avsevärt beroende på användning och funktioner. Det är viktigt att jämföra den med konkurrenter som Snowflake och Google BigQuery och ta hänsyn till faktorer som datalagring, bearbetningskostnader och ytterligare funktioner. Utvärdera varje plattforms prisstruktur för att hitta den bästa lösningen för din budget.
Vilka funktioner bör jag leta efter hos en Databricks-konkurrent?
När du utvärderar Databricks konkurrenter bör du leta efter funktioner som realtidsanalys, integrering av maskininlärning och datastyrning. Dessa funktioner förbättrar databearbetningen och analysen och skapar värde för ditt team. Ta hänsyn till dina specifika affärsbehov för att avgöra vilka funktioner som är mest kritiska.