

10 bästa verktygen för övervakning av ML-modeller 2026

Bästa verktygen för övervakning av ML-modeller


Verktyg för övervakning av ML-modeller spårar, analyserar och varnar dig om prestandan och hälsan hos maskininlärningsmodeller i produktion. Om du ansvarar för att hålla modeller tillförlitliga och korrekta vet du hur snabbt dataförskjutningar eller prediktionsfel kan äventyra dina resultat – eller din verksamhet. Dessa verktyg hjälper dig att snabbt upptäcka problem, förstå grundorsaker och upprätthålla förtroendet för dina lösningar.
I den här guiden får du en tydlig jämförelse av de främsta plattformarna för övervakning av ML-modeller, så att du kan hitta rätt alternativ för teamets arbetsflöden, efterlevnadskrav och verkliga behov.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning: bästa verktygen för övervakning av ML-modeller
Den här jämförelsetabellen sammanfattar prisuppgifter för mina främsta verktyg för övervakning av ML-modeller, så att du kan hitta det bästa alternativet för din budget, dina behov och din strategi för maskininlärning.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för spårningsbaserad utvärdering av agenter | Gratisplan tillgänglig | Från $39/användare/månad | Website | |
| 2 | Bäst för automatisering av produktionsarbetsflöden | 14 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 3 | Bäst för automatiserade hälsorapporter | Gratisplan tillgänglig | Från $19/månad | Website | |
| 4 | Bäst för säker företagsdriftsättning | Gratisplan tillgänglig | Från $0.204/timme | Website | |
| 5 | Bäst för anpassningsbara valideringssviter | Inte tillgänglig | Pris på begäran | Website | |
| 6 | Bäst för flexibilitet med öppen källkod | Gratis att använda | Gratis att använda | Website | |
| 7 | Bäst för bedömning av partiskhet och rättvisa | Gratisplan tillgänglig | Från $60/månad | Website | |
| 8 | Bäst för enhetlig integration av observerbarhet | 14 dagars kostnadsfri provperiod | Från $15/värd/månad (faktureras årsvis) | Website | |
| 9 | Bäst för anpassade visualiseringspaneler | Gratisplan + kostnadsfri provperiod tillgänglig | Från $19/månad + användning | Website | |
| 10 | Bäst för korrelation mellan affärsmått | Not available | Website |
Recensioner av de bästa verktygen för övervakning av ML-modeller
Nedan hittar du mina detaljerade sammanfattningar av de bästa verktygen för övervakning av ML-modeller som kom med på min kortlista. Mina recensioner ger en detaljerad bild av funktionerna, integrationerna och de bästa användningsområdena för varje plattform, så att du kan hitta det bästa alternativet för dig.
Bäst för spårningsbaserad utvärdering av agenter

LangSmith är en plattform för agentutveckling byggd kring observerbarhet för LLM:er, spårningsbaserad utvärdering och distribution av agenter, med verktyg för övervakning av kostnad, fördröjning och utdatakvalitet i AI-system i produktion.
Vem passar LangSmith bäst för?
LangSmith passar bra för AI-utvecklingsteam som bygger och vidareutvecklar LLM-drivna applikationer och agenter i produktion.
Varför jag valde LangSmith
Jag valde LangSmith som en av de bästa eftersom det spårningsbaserade utvärderingsarbetsflödet verkligen skiljer sig från allt annat på området. Varje steg en agent tar, från verktygsanrop till delegering till underagenter, registreras och kan inspekteras i sin helhet. Jag använder utvärderare där en LLM fungerar som domare för att köra strukturerade kvalitetskontroller direkt mot verkliga produktionsspår, och Insights Agent grupperar automatiskt fel för att synliggöra återkommande mönster mellan körningar.
Viktiga funktioner i LangSmith
- Instrumentpaneler för observerbarhet: Övervaka agentbeteende, kostnad, fördröjning och felmätvärden i realtid från en enhetlig instrumentpanel.
- Felsökning i Agent Studio: Stega igenom och ändra agentens körningsflöden med brytpunkter och visuella verktyg under felsökning.
- Distributionsregister: Hantera agentversioner med återställningar, centraliserad registrering och stöd för distribution i flera miljöer.
- Företagskontroller: Använd SSO, RBAC, granskningsloggar och alternativ för distribution i flera regioner för att uppfylla organisationens säkerhetskrav.
Integrationer med LangSmith
LangSmith erbjuder inbyggda integrationer med ramverken LangChain och LangGraph och stöder protokoll som A2A, MCP och Agent Protocol. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Särskilt utformad för LLM- och agentarbetsflöden
- Registrerar och visualiserar detaljerade körningsspår
- Möjliggör poängsättning med LLM som domare på verkliga data
Cons:
- Ingen detektering av dataförskjutning eller konceptförskjutning
- Saknar mätvärden för traditionella ML-modeller


DataRobot är en AI-observabilitetsplattform som övervakar prediktiva, generativa och agentbaserade AI-modeller i produktion och omfattar identifiering av drift, prestandaspårning, prediktionsloggning, grundorsaksanalys och automatisk omskolning i moln-, lokala och hybrida miljöer.
Vem passar DataRobot bäst för?
DataRobot passar väl för företagsinriktade MLOps- och plattformsteknikteam som hanterar storskaliga AI-distributioner inom reglerade branscher som bank, sjukvård och försäkring.
Varför jag valde DataRobot
Jag valde DataRobot som en av de bästa lösningarna eftersom dess automatiska omskolning och policyer för utmanarmodeller eliminerar de manuella steg som fördröjer hanteringen av produktionsincidenter. När drift upptäcks jämför DataRobot en utmanarmodell med den aktuella produktionsmodellen och kan byta ut den utan en manuell distributionscykel. Jag uppskattar också att man kan pausa, omdirigera eller återställa en specifik agent utan att störa resten av det distribuerade systemet.
DataRobots viktigaste funktioner
- Enhetlig agentobservabilitet: Övervaka prediktiva, generativa och agentbaserade AI-modeller i olika miljöer från en enda instrumentpanel.
- Mätvärden för LLM och vektordatabaser: Följ LLM-specifika signaler som kostnad, toxicitet och partiskhet samt vektordatabasernas prestanda.
- Spårning av AI-härstamning från början till slut: Samla in och organisera hela livscykeln för modeller, promptar och vektordatabastillgångar för transparens och granskningsspår.
- Inbyggda skyddsräcken och moderering: Använd promptmoderering, förebyggande av PII-läckor och NVIDIA NeMo-skyddsräcken för AI-säkerhet och efterlevnad.
DataRobot-integreringar
DataRobot erbjuder inbyggda integreringar med Snowflake, BigQuery, Databricks, AzureML, SAP, AWS och Salesforce samt stöd för OpenTelemetry för att ta in extern agenttelemetri. Ett API finns tillgängligt för anpassade integreringar.
Pros and Cons
Pros:
- Automatisk omskolning och byten av utmanarmodeller
- Övervakar prediktiva, generativa och agentbaserade AI-tillgångar
- Inbyggda skyddsräcken för identifiering av partiskhet och PII
Cons:
- Prisinformationen är inte transparent
- Vissa avancerade inställningar kräver support från leverantören

Bäst för automatiserade hälsorapporter

SuperWise är en plattform för ML-observabilitet och styrning som övervakar prestandan hos produktionsmodeller, upptäcker data- och konceptdrift, loggar förutsägelser i stor skala och levererar automatiserad anomalidetektering med realtidsinstrumentpaneler för traditionella ML-modeller, LLM:er och AI-agenter.
Vem passar SuperWise bäst för?
SuperWise passar särskilt bra för MLOps- och AI-teknikteam i reglerade branscher som behöver granskningsbar och styrningsklar modellobservabilitet i stor skala.
Varför jag valde SuperWise
SuperWise tar plats som ett av de bästa alternativen på min kortlista tack vare hur plattformen hanterar automatiserad hälsorapportering för produktionsmodeller. Jag uppskattar särskilt den adaptiva anomalidetekteringen, som tar hänsyn till säsongsvariationer och statistiskt brus i stället för att reagera på varje liten förändring i mätvärdena. Tillsammans med poängsättningen AI-konsensus kopplar den automatiskt datadrift till prestandaförsämringar, så att mitt team får en grundorsak tillsammans med varje avisering.
Viktiga funktioner i SuperWise
- Telemetri för drift i realtid: Övervaka latens, genomströmning och felfrekvenser för flera modeller med instrumentpaneler som uppdateras på under en sekund.
- Anpassade styrningsinstrumentpaneler: Skapa visuella rapporter med diagram, tabeller och fördelningar för alla spårade mätvärden.
- Flexibelt integrationsstöd: Anslut datakällor och aviseringskanaler via Slack, Datadog, PagerDuty, REST API och mycket mer.
- Loggning av granskningsspår: Registrera varje modellbeslut och varje interaktion med fullständig kontext för efterlevnad och incidentgranskningar.
SuperWise-integrationer
SuperWise erbjuder inbyggda integrationer med Slack, PagerDuty, OpsGenie, Datadog, New Relic, Grafana, AWS S3, BigQuery och Snowflake. Ett API och ett Python-SDK finns tillgängliga för anpassade integrationer.
Pros and Cons
Pros:
- Realtidsinstrumentpaneler uppdaterar latens och genomströmning omedelbart
- Automatiserad anomalidetektering anpassar sig efter säsongsvariationer
- AI-driven grundorsaksanalys för aviseringar
Cons:
- Begränsade verktyg för analys av rättvisa och partiskhet
- Fullständig datalagring kräver företagsabonnemang

Amazon SageMaker är en ML-plattform från AWS som täcker hela kedjan, från modellträning och driftsättning till övervakning i produktion – inklusive identifiering av dataförskjutning, spårning av partiskhet, attributering av funktioner och loggning av prestandamått via SageMaker Model Monitor.
Vem passar Amazon SageMaker bäst för?
Det passar mycket bra för team som ansvarar för ML-plattformar i företag och kör storskaliga arbetsbelastningar i reglerade branscher där AWS-inbyggda säkerhetskontroller är ett absolut krav.
Varför jag valde Amazon SageMaker
Jag valde Amazon SageMaker på grund av hur väl plattformen skyddar övervakningsdata i reglerade miljöer. Funktionen Data Capture krypterar indata och utdata från förutsägelser i vila med KMS, dirigerar trafik via VPC-slutpunkter och lagrar allt i en angiven S3-bucket med detaljerade åtkomstkontroller som du definierar. Granskning med CloudTrail omfattar hela Model Monitor-pipelinen och loggar varje API-anrop mot din övervakningskonfiguration, vilket är exakt vad informationssäkerhetsteam kräver innan de godkänner en ML-driftsättning i produktion.
Viktiga funktioner i Amazon SageMaker
- Modellöversikt: Samlar översikten över driftsatta modeller, slutpunkter och övervakningsstatus i ett enda gränssnitt.
- Övervakning av dataförskjutning och partiskhet: Använder inbyggda regler för att söka efter dataförskjutning, kvalitetsproblem, partiskhet och förändringar i funktionsattributering.
- CloudWatch-integrering: Strömmar detaljerade övervakningsmått och loggar till Amazon CloudWatch för anpassade instrumentpaneler och aviseringar.
- Flexibel konfiguration för datainsamling: Låter dig välja samplingsfrekvenser, nyttolasttyper och lagringsalternativ för insamlade indata och förutsägelser.
Integrationer med Amazon SageMaker
Amazon SageMaker erbjuder inbyggda integrationer med Amazon S3, Amazon Redshift, Amazon CloudWatch, AWS CloudTrail och Amazon EventBridge samt stöd för djupgående anslutning till hela AWS-ekosystemet. Ett API är tillgängligt för anpassade integrationer. AI-appar på Marketplace omfattar Lakera Guard, Comet, DeepChecks och Fiddler.
Pros and Cons
Pros:
- Datainsamling stöder krypterade nyttolaster i S3
- Centraliserad vy över modellernas övervakningsstatus
- Övervakar partiskhet och förändringar i attributering av funktioner
Cons:
- Analys av grundorsaker kräver manuellt arbete i notebooks
- Aviseringar om dataförskjutning är inte ML-drivna eller automatiserade


Deepchecks är en plattform för validering och övervakning av ML som kombinerar anpassningsbara kontrollsviter, detektering av drift, prestandaspårning i realtid, rotorsaksanalys och LLM-utvärdering för tabellbaserade modeller samt NLP- och visionsmodeller.
Vem passar Deepchecks bäst för?
Deepchecks passar mycket bra för MLOps-ingenjörer och datavetenskapsteam som kör flera produktionsmodeller och behöver detaljerad, konfigurerbar validering för olika datatyper.
Varför jag valde Deepchecks
Jag valde Deepchecks som en av de bästa lösningarna eftersom dess arkitektur för kontrollsviter verkligen skiljer sig från mängden. Du kan bygga sviter från dussintals inbyggda kontroller, lägga till anpassade villkor med gränsvärden för godkänd, varning eller underkänd, och köra dem på tabellbaserade data samt NLP- och visionsdata i samma bearbetningskedja. I praktiken innebär det att mitt team kan upptäcka ett driftproblem i en textklassificeringsmodell med samma valideringsramverk som vi använder för en regressionsmodell, utan att underhålla separata verktyg för varje modelltyp.
Viktiga funktioner i Deepchecks
- Övervakning och avisering i realtid: Följ modellmått i realtid och få meddelanden när avvikelser eller överträdelser av gränsvärden inträffar.
- Verktyg för rotorsaksanalys: Segmentera, dela upp och undersök prestandaförsämringar för att identifiera problem direkt i dina data eller modeller.
- Integrationer med ML-ramverk och plattformar: Ansluter till scikit-learn, PyTorch, TensorFlow, AWS SageMaker, Databricks och andra stora ML-miljöer.
- Funktioner för LLM-utvärdering: Analysera LLM-resultat med avseende på partiskhet, toxicitet, PII och avancerade prestandamått i både agentbaserade arbetsflöden och arbetsflöden i ett enda steg.
Deepchecks-integrationer
Deepchecks erbjuder inbyggda integrationer med Databricks, HuggingFace, AWS SageMaker, Amazon Bedrock, H2O.ai, W&B, Airflow, ZenML och Slack. Ett API och en webhook finns tillgängliga för anpassade integrationer och dirigering av aviseringar.
Pros and Cons
Pros:
- Mycket anpassningsbara sviter för validering och testning
- Visualiserar drift, partiskhet och prestandaproblem tydligt
- Stöder automatiserad övervakning för flera datatyper
Cons:
- Kräver Python för avancerad valideringslogik
- Begränsade möjligheter att anpassa färdiga instrumentpaneler


Evidently AI är ett ramverk med öppen källkod för ML-observabilitet som omfattar driftidentifiering, prestandaövervakning, LLM-utvärdering och automatiserade testsviter för modeller i produktion.
Vem passar Evidently AI bäst för?
MLOps-ingenjörer och ML-plattformsteam som behöver en kodcentrerad övervakningslösning som kan hostas på egen hand, med full kontroll över sin observabilitetsstack.
Varför jag valde Evidently AI
Evidently AI tar plats på min kortlista eftersom Apache 2.0-licensen innebär att jag äger hela övervakningsstacken utan leverantörsberoende. Jag uppskattar särskilt att ramverket är modulärt: jag kan köra fristående driftrapporter med statistiska tester som Kolmogorov-Smirnov och PSI, eller bygga fullständiga testsviter som kopplas direkt till CI/CD-pipelines utan att behöva en betald SaaS-nivå. Det alternativ som kan hostas på egen hand och som ingår i Enterprise utökar samma flexibilitet till team med strikta krav på datalokalitet.
Viktiga funktioner i Evidently AI
- Interaktiv övervakningspanel: Visualiserar produktionsdata, modellmått och prestandatrender med anpassningsbara diagram.
- LLM- och RAG-utvärdering: Stöder integrerad utvärdering och övervakning för stora språkmodeller och system för hämtningförstärkt generering.
- Automatiserade testsviter: Låter dig skapa godkänd/underkänd-kontroller av modellkvalitet för CI/CD- och produktionsarbetsflöden.
- Spårvisare: Gör det möjligt att granska enskilda prediktionsspår för att felsöka och analysera modellens beteende i detalj.
Integrationer med Evidently AI
Evidently AI erbjuder inbyggda integrationer med MLflow, Apache Airflow, Grafana och Prometheus. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Öppen källkod och kan hostas helt på egen hand
- Omfattande alternativ för statistisk driftövervakning
- Modulära testsviter för automatiserade modellkontroller
Cons:
- Inbyggda funktioner för aviseringar kräver en betald nivå
- Inga inbyggda visualiseringar för modellförklarbarhet
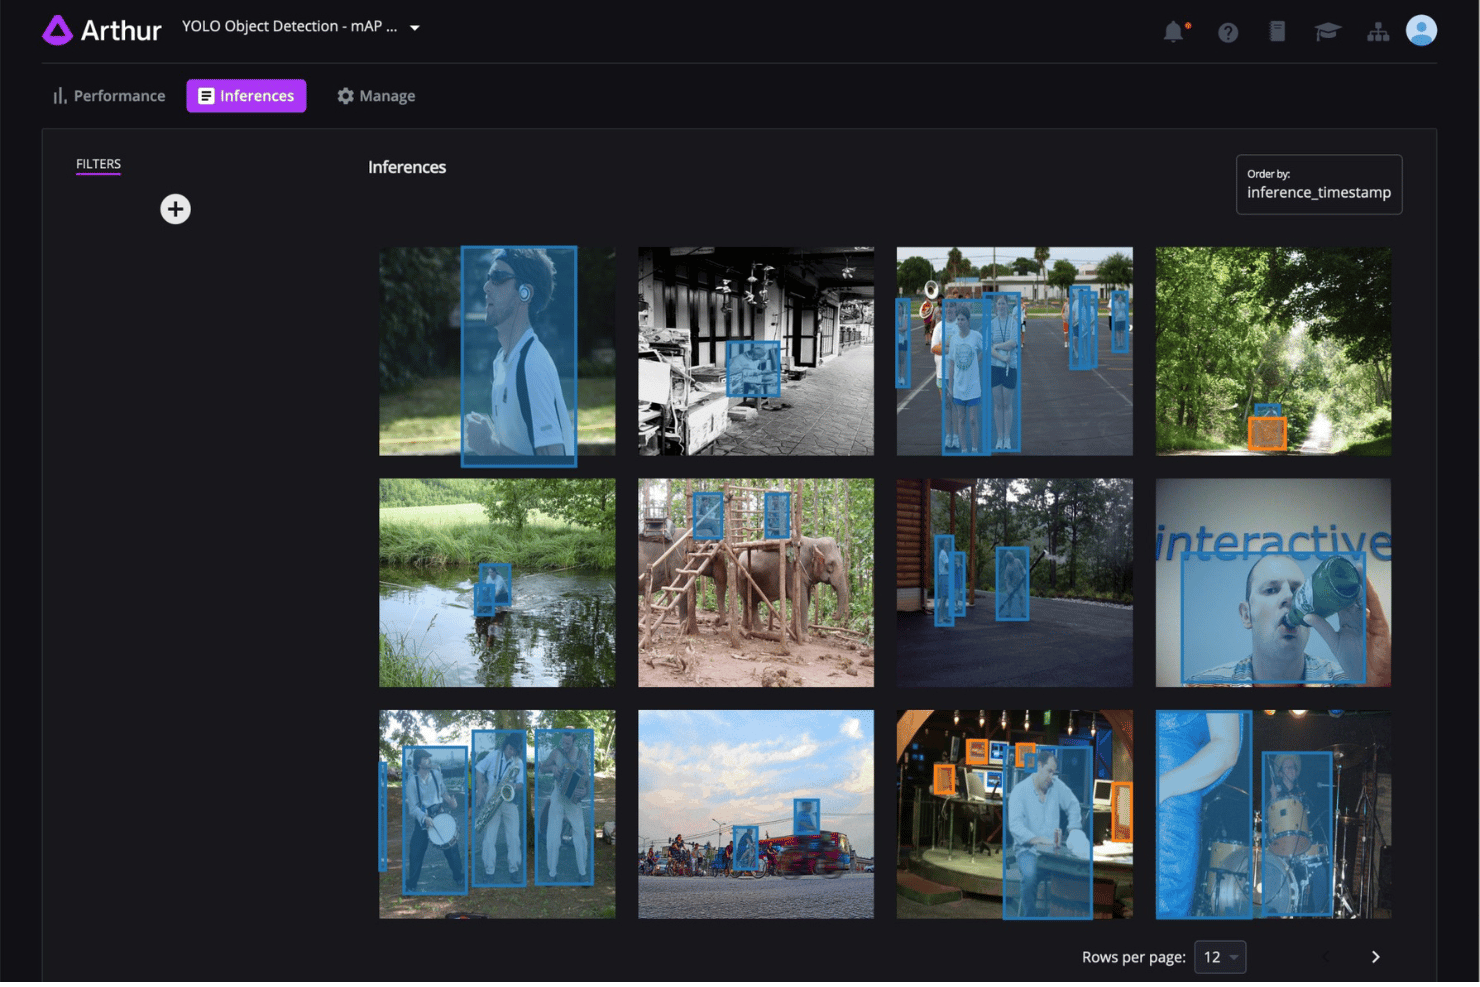
Arthur är en plattform för övervakning och styrning av AI-modeller som spårar prestandamått, upptäcker drift, flaggar problem med partiskhet och rättvisa samt övervakar LLM-utdata i produktionsmiljöer.
Vem passar Arthur bäst för?
Arthur passar särskilt bra för ML-plattformsteam i reglerade branscher som finansiella tjänster, hälso- och sjukvård samt försäkring, där rättvisa och efterlevnad för modeller inte är förhandlingsbara.
Varför jag valde Arthur
Arthur förtjänar sin plats som ett av de bästa alternativen på min kortlista tack vare hur plattformen hanterar upptäckt av partiskhet i produktion. Jag uppskattar att den använder aktiv sondering för att jämföra resultat mellan undergrupper, även när gruppidentitet inte är en indata till modellen. När en rättvisevarning utlöses visar Arthur automatiskt vilka datasegment och tidsperioder som driver försämringen. Det innebär att jag inte bara ser att partiskhet förekommer, utan kan spåra exakt var den började.
Arthurs viktigaste funktioner
- Övervakning av LLM-utdata: Spåra hallucinationer, toxicitet, promptinjektioner och läckage av känsliga data i generativa AI-arbetsflöden.
- Anpassade prestandamått: Ange och övervaka anpassade utvärderingsmått för valfri produktionsmodell eller användningsfall.
- Varningar i realtid och webhooks: Konfigurera varningar och skicka aviseringar till efterföljande system när tröskelvärden överskrids.
- Oföränderlig datalagring: Säkerställ att all inläst modelldata är låst och revisionsbar för företags behov av regelefterlevnad.
Arthurs integrationer
Arthur erbjuder inbyggda integrationer med OpenTelemetry, LangChain, LlamaIndex, AWS och GCP. Ett API finns tillgängligt för anpassade integrationer, och plattformen stöder anpassade webhooks för arbetsflöden för varningar och övervakning.
Pros and Cons
Pros:
- Avancerad segmentering av rättvisa och partiskhet
- Automatiserad rotorsaksanalys för drift
- Övervakar risker och hallucinationer i LLM-utdata
Cons:
- Konfiguration av anpassade mått kräver teknisk utvecklingsinsats
- Begränsad dokumentation för vissa avancerade funktioner
Datadog
Bäst för enhetlig integration av observerbarhet
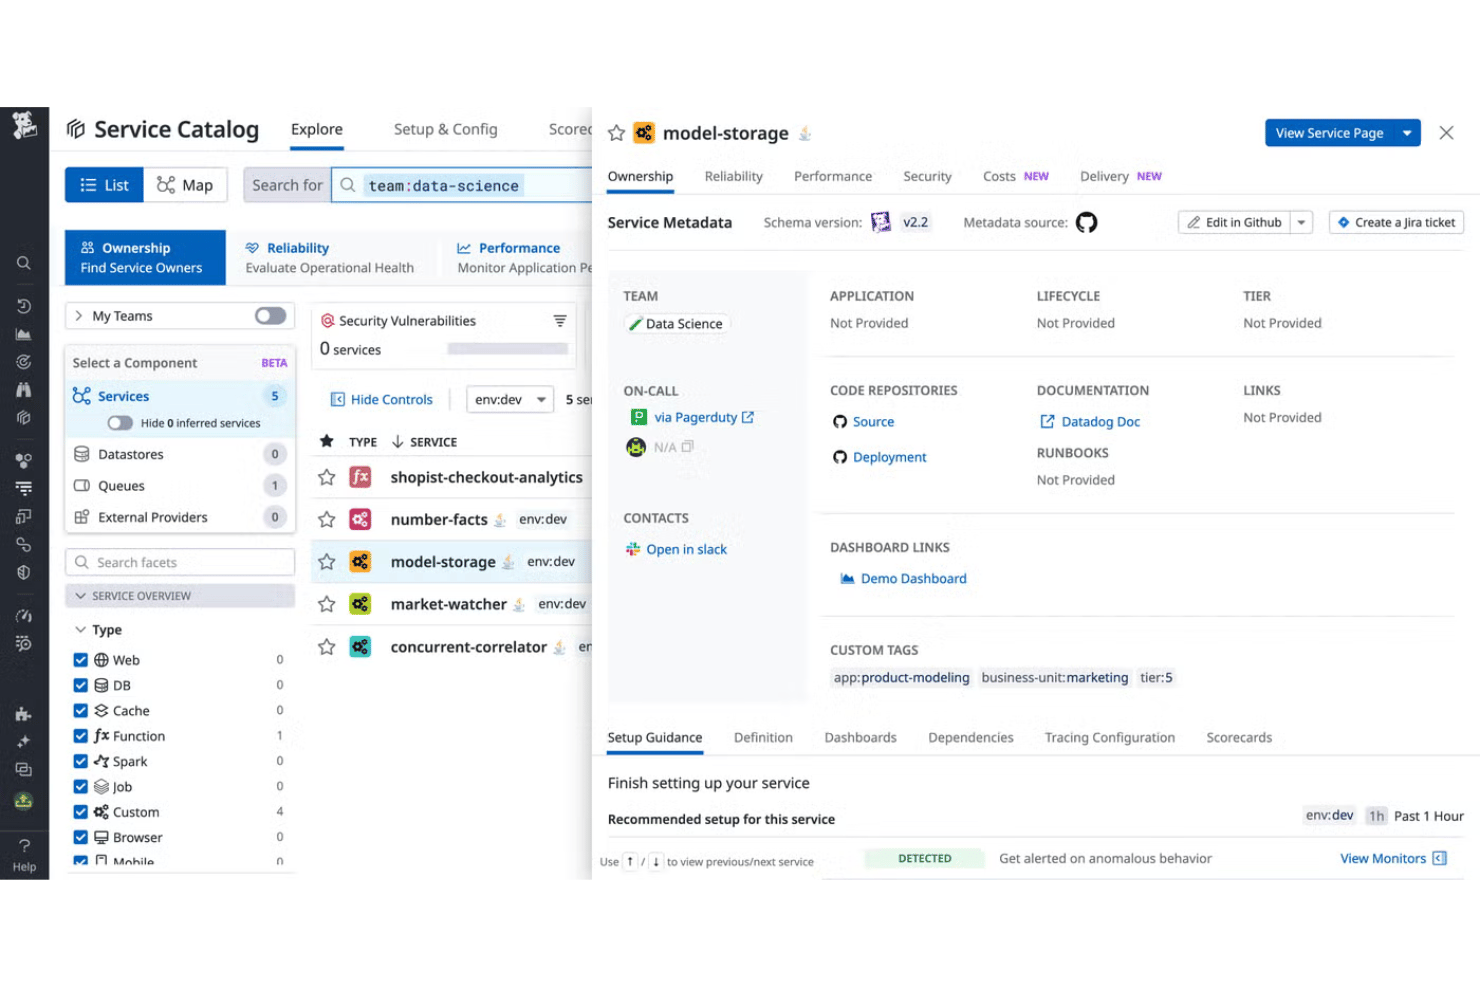
Datadog är en plattform för observerbarhet i hela teknikstacken som utökar infrastrukturövervakning, APM och logghantering till ML-arbetsflöden och omfattar LLM-spårning, avvikelsedetektering och observerbarhet för ML-pipelines i molnmiljöer.
Vem passar Datadog bäst för?
Det passar mycket bra för arkitekter för ML-plattformar och tekniska team på medelstora till stora företag som redan använder Datadog för infrastruktur- och applikationsobserverbarhet.
Varför jag valde Datadog
Datadog finns med på min kortlista eftersom inget annat verktyg kopplar ML-pipelinehälsa till resten av din teknikstack på samma sätt. Jag uppskattar hur Watchdog RCA automatiskt spårar avvikelser över tjänster, så att jag kan jämföra en försämrad modellslutpunkt med infrastrukturmätvärden, loggar och spårningar i en och samma vy. Agentobserverbarhet ger mitt team spårning på span-nivå genom varje LLM-anrop, verktygsanrop och hämtningssteg utan någon manuell instrumentering.
Viktiga funktioner i Datadog
- Logghantering och analys: Samla in och analysera stora mängder modelloggar med anpassad parsning, taggning och flexibel lagringstid.
- Integration med PyTorch och TorchServe: Övervaka inferenspipelines för djupinlärning direkt med färdig insamling av mätvärden.
- Insamling av anpassade mätvärden: Skicka prediktionskvalitet och ML-mätvärden till Datadog för övervakning i realtid och historisk analys.
- Dynamiska instrumentpaneler: Skapa enhetliga instrumentpaneler för att visualisera ML-modellernas prestanda tillsammans med infrastruktur- och applikationsdata.
Datadog-integrationer
Datadog erbjuder fler än 1 000 inbyggda integrationer, däribland Amazon SageMaker, Azure Machine Learning, Google Vertex AI, Databricks, PyTorch/TorchServe, OpenAI, Anthropic, Gemini, LangChain, CrewAI och LiteLLM. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Kopplar ML-mätvärden till observerbarhet i hela teknikstacken
- Har inbyggt stöd för LLM- och agentspårning
- Inbyggd avvikelsedetektering för modellslutpunkter
Cons:
- Ingen inbyggd detektering av funktions- eller konceptdrift
- Saknar verktyg för övervakning av rättvisa och partiskhet

Grafana
Bäst för anpassade visualiseringspaneler
Andra verktyg för övervakning av ML-modeller
Här är några ytterligare alternativ för verktyg för övervakning av ML-modeller som inte kom med på min kortlista, men som ändå är värda att undersöka:
- TrueFoundry
Bäst för snabb integrering i distributionspipeline
- JFrog ML
Bäst för hantering av artefakters livscykel
- Braintrust
Bäst för samarbete kring arbetsflöden inom datavetenskap


Hur jag utvärderar verktyg för övervakning av ML-modeller
Jag delar upp min utvärdering i kärnkriterier – som driftdetektering och loggning av prediktioner – samt särskiljande faktorer som visar vilka verktyg som utmärker sig i produktion.
Kärnfunktionalitet (grundkrav för den här listan)
När jag väljer verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- Driftdetektering: Jag kontrollerar om verktyget upptäcker data-, funktions- och konceptdrift med hjälp av statistiska metoder som PSI- eller KS-tester – särskilt när indata i produktion förändras gradvis efter att en modell varit i drift i flera månader.
- Prestandaövervakning: Det är viktigt att följa noggrannhet, precision, återkallning eller RMSE över tid, så jag letar efter verktyg som hanterar fördröjda facitdata, vilket är vanligt i modeller för bedrägeri eller kundbortfall.
- Loggning av prediktioner: Jag utvärderar hur väl varje verktyg tar emot och lagrar modellindata och modellutdata i stor skala, eftersom miljöer med högt genomflöde kan generera miljontals prediktioner dagligen.
- Aviseringar & avvikelsedetektering: Bra aviseringar går längre än statiska tröskelvärden. Jag letar efter konfigurerbara aviseringar som skickas till Slack, PagerDuty eller e-post när avvikande utdatamönster uppstår.
- Analys av grundorsaker: När en modells mätvärden sjunker behöver du kunna gå ner på segmentnivå. Jag utvärderar om verktyget erbjuder uppdelning efter kohorter och funktioner för förklarbarhet, som attributioner med SHAP eller LIME.
- Integrationer med ML-ramverk: Jag kontrollerar om SDK-stöd finns för ramverk som TensorFlow, PyTorch och scikit-learn, samt anslutningar till distributionsplattformar som Kubernetes eller Databricks.
När jag har en lista över verktyg som uppfyller kriterierna undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Observerbarhet för LLM och GenAI är en viktig särskiljande faktor. Team som distribuerar generativa modeller tillsammans med traditionell ML behöver insyn i promptkvalitet, hallucinationer och tokenkostnader. Förklarbarhet och biasövervakning är också viktiga – jag letar efter SHAP-baserade attributioner och rättvisemått för olika demografiska segment som stödjer regulatoriska revisioner. Anpassade aviseringar kompletterar detta, eftersom verksamhetsspecifika SLO:er och dirigering av avvikelseaviseringar till Slack eller PagerDuty hjälper till att upptäcka regressioner innan kunderna gör det.
Bortom funktionerna
Flexibilitet vid driftsättning är mycket viktigt här. Jag utvärderar om en plattform erbjuder SaaS, VPC eller lokala alternativ, eftersom team i reglerade branscher som sjukvård eller finans ofta inte kan låta inferensloggar lämna sin miljö. Skalbarhet är en annan faktor – jag undersöker hur väl varje verktyg hanterar loggning av stora mängder prediktioner utan sampling och om prissättningen skalar förutsägbart när antalet modeller ökar. Efterlevnadscertifieringar som SOC 2 Type II och HIPAA väger också tungt för företagskunder som behöver granskningsspår och rollbaserade åtkomstkontroller.
Så väljer du verktyg för övervakning av ML-modeller
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du går igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kommer verktyget att hantera din högsta trafik för förutsägelser och dina lagringsbehov när modeller och datamängder växer? Kontrollera begränsningar för lagringstid och inmatningskapacitet. |
| Integrationer | Ansluter det till de ML-ramverk, distributionsplattformar och datalager du förlitar dig på? Luckor kan skapa manuellt merarbete och påverka arbetsflödets hastighet. |
| Anpassningsbarhet | Kan du definiera anpassade mätvärden, aviseringar eller instrumentpaneler som passar dina användningsområden? Se till att du inte låses till endast förinställda alternativ från leverantören. |
| Användarvänlighet | Är användargränssnittet tydligt, och är instrumentpaneler och aviseringar intuitiva att konfigurera? Komplexa verktyg kan göra felsökning och introduktion av nya användare långsammare. |
| Implementering och introduktion | Hur snabbt kan ditt team gå från installation av SDK till aktiv övervakning? Leta efter exempelbaserade anteckningsböcker, färdiga mallar och stöd vid introduktionen. |
| Kostnad | Hur skalar prissättningen när du lägger till modeller, användare eller förutsägelser? Klargör enhetspriserna för att undvika ovälkomna kostnadsöverraskningar när användningen ökar. |
| Säkerhetsskydd | Vilka kontroller för dataåtkomst, autentiseringsmetoder och granskningsspår finns tillgängliga? Tänk på SSO, RBAC och datakryptering både i vila och under överföring. |
| Efterlevnadskrav | Behöver du certifieringar som SOC 2, HIPAA eller datalagring inom EU? Se till att verktygets efterlevnadsnivå faktiskt uppfyller organisationens skyldigheter. |
Vad är verktyg för övervakning av ML-modeller?
Verktyg för övervakning av ML-modeller är plattformar som spårar prestanda, datakvalitet och hälsa hos maskininlärningsmodeller i produktion. Dessa verktyg hjälper ditt team att upptäcka dataförskjutning, försämrad prestanda och avvikelser så att ni snabbt kan åtgärda problem. Genom att kontinuerligt övervaka förutsägelseutdata och relaterade mätvärden säkerställer du att dina distribuerade modeller förblir korrekta, rättvisa och tillförlitliga för verklig affärsanvändning. Funktioner
Funktioner
När du väljer verktyg för övervakning av ML-modeller bör du hålla utkik efter följande viktiga funktioner:
- Detektering av dataförskjutning: Identifierar förändringar i data eller modellbeteende mellan tränings- och produktionsmiljöer och flaggar potentiella problem innan de påverkar modellens träffsäkerhet.
- Prestandaövervakning: Mäter kontinuerligt modellmätvärden som träffsäkerhet, precision, återkallning och felfrekvenser för att följa hur väl dina distribuerade modeller fungerar över tid.
- Loggning av förutsägelser: Registrerar alla modellindata, utdata och förutsägelser, så att du kan granska, analysera och felsöka modellens beteende när som helst i arbetsflödet.
- Aviseringar och notiser: Skickar aviseringar i realtid när specifika tröskelvärden överskrids eller när avvikande modellbeteenden upptäcks, vilket hjälper team att snabbt reagera på problem.
- Analys av grundorsaker: Möjliggör undersökning av försämrad prestanda eller avvikelser i förutsägelser med verktyg för segmentering, uppdelning och attribuering för att hitta problemens källa.
- Integration med ML-ramverk: Ansluter till populära maskininlärningsbibliotek, plattformar för modellkörning och distributionsverktyg, vilket effektiviserar övervakningen i befintliga arbetsflöden.
- Rollbaserad åtkomstkontroll: Begränsar systemåtkomst och åtgärder baserat på användarroller, vilket stöder behov av datastyrning och förbättrar systemsäkerheten.
- Alternativ för datalagring: Gör det möjligt att konfigurera hur länge loggade data och förutsägelser ska lagras, vilket balanserar efterlevnadskrav mot lagringskostnader.
- Spårning av anpassade mätvärden: Låter dig definiera och övervaka verksamhets- eller modellspecifika mätvärden som är viktigast för din applikation eller dina mål.
Vanliga AI-funktioner i verktyg för övervakning av ML-modeller
Utöver de standardfunktioner i verktyg för övervakning av ML-modeller som anges ovan integrerar många av dessa lösningar AI med funktioner som:
- Automatiserad avvikelsedetektering: Använder AI-algoritmer för att identifiera ovanliga mönster eller avvikande värden i förutsägelsedata, vilket minskar behovet av manuell övervakning och synliggör problem som traditionella regler kan missa.
- Analys av grundorsaker med förklarbar AI: Använder AI-drivna tekniker för förklarbarhet för att automatiskt framhäva vilka funktioner eller datasegment som bidrog mest till försämrad prestanda eller avvikelser.
- Adaptiv detektering av dataförskjutning: Utnyttjar AI för att dynamiskt justera tröskelvärden och metoder för detektering av dataförskjutning baserat på föränderliga datamönster, vilket förbättrar känsligheten och minskar antalet falska positiva resultat.
- Prediktiva varningar: Använder AI-modeller för att förutsäga potentiella modellfel eller försämringar innan de inträffar, så att team kan vidta proaktiva åtgärder.
- Analys av bias och rättvisa: Använder AI för att kontinuerligt söka efter framväxande bias i modellernas förutsägelser mellan demografiska grupper, vilket stödjer ansvarsfull AI-användning och efterlevnadskrav.
Fördelar
Implementering av verktyg för övervakning av ML-modeller ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Snabbare upptäckt av problem: Automatiserade varningar om förskjutningar och avvikelser gör att ditt team kan upptäcka och åtgärda problem så snart de uppstår.
- Förbättrad modelltillförlitlighet: Löpande prestandaspårning och loggning av förutsägelser bidrar till att säkerställa att dina modeller fortsätter att prestera som förväntat i produktionsmiljöer.
- Starkare efterlevnad och säkerhet: Funktioner som granskningsspår, RBAC och kontroller för datalagring gör det enklare att uppfylla regulatoriska krav och skydda känsliga data.
- Förenklad felsökning: Verktyg för grundorsaksanalys, förklarbarhet och kohortindelning hjälper ditt team att snabbt fastställa vad som driver prestandaförändringar eller avvikelser i resultaten.
- Bättre överensstämmelse med verksamheten: Anpassad mätvärdesspårning och varningshantering gör det möjligt att övervaka de KPI:er och resultat som är viktigast för din organisation.
- Minskad operativ risk: Övervakning i realtid och proaktiva varningar begränsar dåliga förutsägelsers påverkan på verksamhetens resultat och beslutsfattande.
- Stöd för ansvarsfull AI: Biasövervakning och rättvisemått hjälper dig att bygga och underhålla modeller som är korrekta och rättvisa för olika användargrupper.
Kostnader och prissättning
Vid val av verktyg för övervakning av ML-modeller krävs en förståelse för de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för övervakning av ML-modeller:
Jämförelsetabell för abonnemang för verktyg för övervakning av ML-modeller
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisabonnemang | $0 | Grundläggande övervakning, begränsad detektering av förskjutningar, communitysupport, begränsad datalagring och användningsbegränsningar. |
| Personligt abonnemang | $10-$50/användare/månad | Åtkomst för enskilda användare, utökad dataloggning, grundläggande prestandamått, vissa integrationer och e-postsupport. |
| Företagsabonnemang | $50-$200/användare/månad | Teamsamarbete, avancerad detektering av förskjutningar och avvikelser, anpassningsbara varningar, API-åtkomst och prioriterad support. |
| Storföretagsabonnemang | $200+/användare/månad | Obegränsat antal användare, fullständiga alternativ för efterlevnad, lokal distribution, dedikerad introduktion, granskningsspår, SLA-garantier och SSO. |
Vanliga frågor om verktyg för övervakning av ML-modeller
Här är några svar på vanliga frågor om verktyg för övervakning av ML-modeller:
Hur hanterar verktyg för övervakning av ML-modeller modelldrift?
Verktyg för övervakning av ML-modeller upptäcker modelldrift genom att kontinuerligt jämföra inkommande data och förutsägelser med historiska mönster med hjälp av statistiska metoder. Det hjälper ditt team att tidigt upptäcka förändringar i data, egenskaper eller fördelningar av utdata, så att ni kan träna om eller justera modellerna efter behov.
Kan dessa verktyg integreras med våra befintliga ML-arbetsflöden?
Ja, de flesta verktyg för övervakning av ML-modeller erbjuder integration med populära ML-ramverk, molnplattformar, orkestreringsverktyg och datalager. Vanligtvis kan du ansluta dem med hjälp av SDK:er, API:er eller inbyggda anslutningar så att de smidigt passar in i din distributionspipeline.
Vilka säkerhetsåtgärder bör jag leta efter?
Du bör leta efter funktioner som rollbaserade åtkomstkontroller, SSO/SAML-autentisering, datakryptering, granskningsloggar och efterlevnadscertifieringar. Dessa skyddsåtgärder hjälper till att skydda känsliga förutsägelsedata och stödja regulatoriska krav.
Stöder dessa verktyg både realtids- och batchförutsägelser?
Ja, många verktyg för övervakning av ML-modeller stöder loggning och övervakning av både realtids- och batchbaserade arbetsflöden för förutsägelser. Det gör det möjligt för ditt team att övervaka hela bredden av modelldistributioner, oavsett om förutsägelserna sker omedelbart eller enligt ett schema.
Hur länge lagras förutsägelsedata vanligtvis?
Lagringsperioden för förutsägelsedata kan variera, men med de flesta verktyg kan du konfigurera den utifrån dina behov av regelefterlevnad och lagring. Vissa leverantörer erbjuder nivåindelad lagringstid – korttidslagring för basabonnemang och förlängd eller obegränsad lagring för företagsnivåer.
Är onboarding komplicerad om vårt team är nytt inom modellövervakning?
De flesta ledande verktyg erbjuder tydlig dokumentation, onboardingstöd och exempel på anteckningsböcker för att hjälpa ditt team att komma igång. Komplexiteten beror på din befintliga arkitektur, men bra lösningar effektiviserar den inledande konfigurationen så att du snabbt kan börja med övervakningen.