

Med datalakeverktyg kan du lagra, organisera och analysera stora mängder strukturerade och ostrukturerade data i hela verksamheten. Om du jämför de bästa datalakeverktygen har du inte råd att gissa – vilken plattform håller ditt team i kontroll över kostnader, efterlevnad och prestanda när datamängden växer?
I den här guiden går jag igenom beprövade alternativ som hjälper IT-ledare att leverera styrning, skalbarhet, integration och framtidsberedskap, så att du tryggt kan välja rätt grund för analys- och AI-arbetsbelastningar i 2026.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell för datalakeverktyg
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina utvalda datalakeverktyg:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för autooptimerade Apache Iceberg-datalagerhus | Gratis provperiod tillgänglig | Från $300/månad (faktureras årsvis) | Website | |
| 2 | Bäst för styrning av hybrida datasjöar i reglerade företag | 60 dagars kostnadsfri provperiod tillgänglig | Från $0.04/CCU/timme | Website | |
| 3 | Bäst för öppna Iceberg-lakehouses utan inlåsning | 30 dagars kostnadsfri provperiod | Från $0.20/DCU | Website | |
| 4 | Bäst för datastyrning i datasjöar inom reglerade branscher | Gratis demo tillgänglig | Pris på begäran | Website | |
| 5 | Bäst för styrning över flera motorer i öppna tabeller i datasjöar | 90 dagars kostnadsfri provperiod | Från $0.12 per DCU-timme | Website | |
| 6 | Bäst för datadelning utan kopiering mellan moln | 30 dagars kostnadsfri provperiod | Från $2.00/kredit | Website | |
| 7 | Bäst för GCP-inbyggda lakehouse-lösningar med lagring i flera nivåer | Gratisplan tillgänglig | Från $0.020/GB/månad | Website | |
| 8 | Bäst för datasjöhus baserat på öppna tabellformat | 14 dagars gratis provperiod | Från $0.22/DBU | Website | |
| 9 | Bäst för objektlagring som kärnan i AWS-datasjöar | Inte tillgängligt | Från $0.023/GB/månad | Website | |
| 10 | Bäst för Microsoft-inbyggda datasjöar för företag | $200 i kredit i 30 dagar (ingen särskild kostnadsfri nivå) | Från $0.023/GB/månad | Website |




Recensioner av datalakeverktyg
Nedan hittar du mina detaljerade sammanfattningar av de bästa datalakeverktygen som kom med på min kortlista. Mina recensioner ger en detaljerad bild av funktionerna, möjligheterna och de bästa användningsområdena för varje plattform, så att du kan hitta det bästa alternativet för dig.
 1Bäst för autooptimerade Apache Iceberg-datalagerhus
Qlik
- Gratis provperiod tillgänglig
- Från $300/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.4/5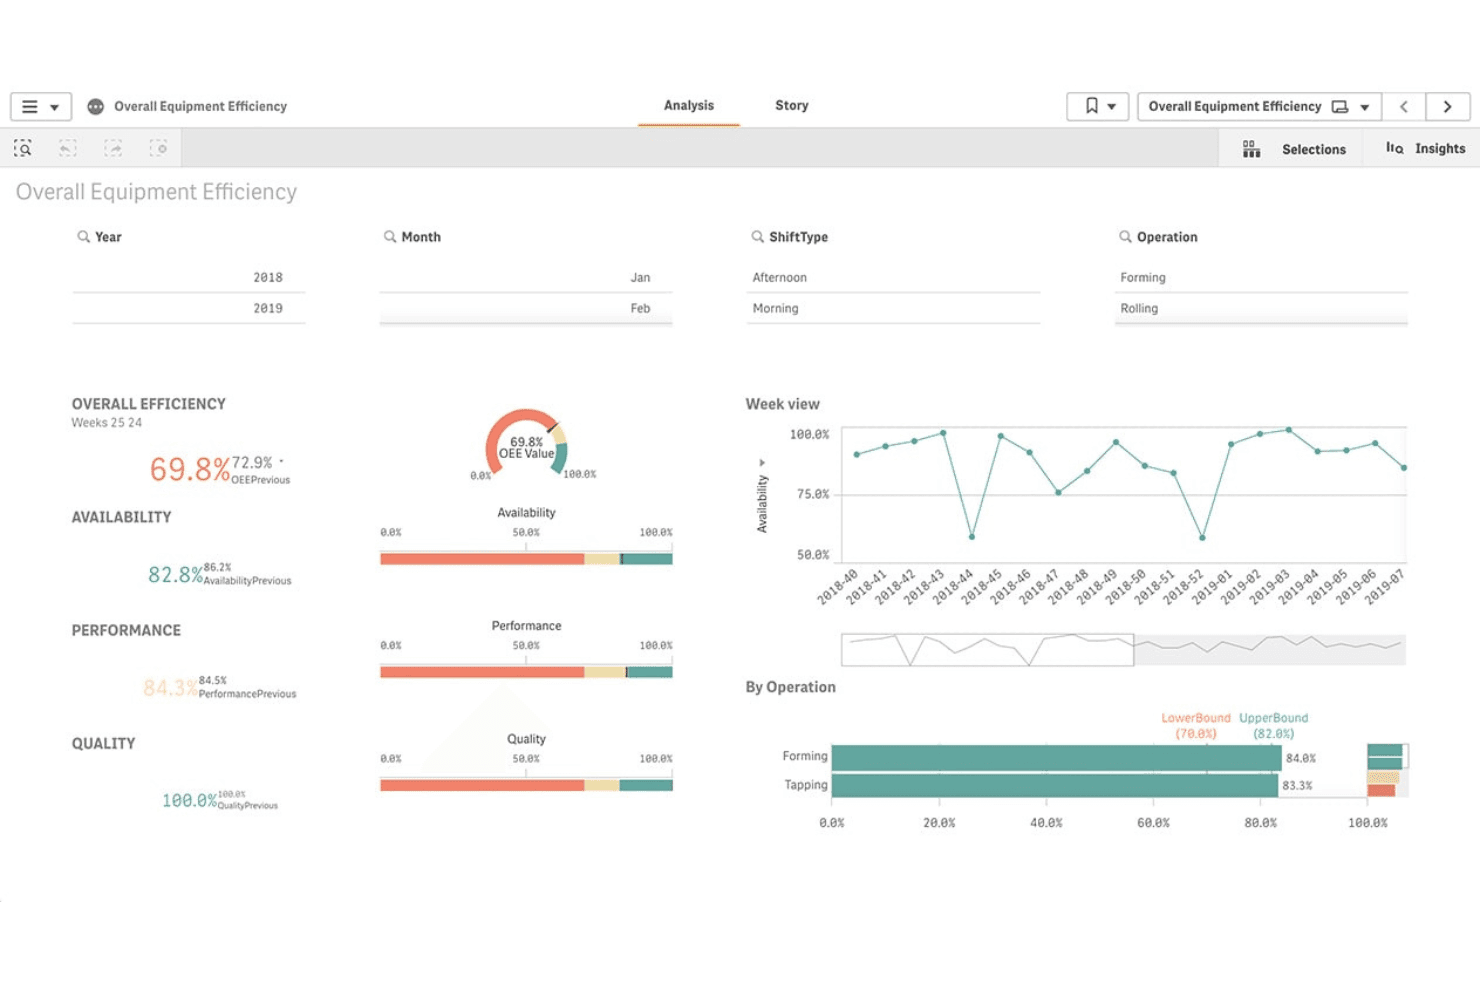
Qlik följer övergripande utrustningseffektivitet med instrumentpaneler med realtidsdata och KPI:er. Qlik är en dataintegrations- och datalagerhusplattform som är byggd direkt på Apache Iceberg och kombinerar CDC-baserad inmatning, automatiserad schemautveckling, datapipelines i flera format och inbyggd styrning i molnbaserade objektlagringsmiljöer.
Vem passar Qlik bäst för?
Qlik passar särskilt bra för stora företag i reglerade branscher som behöver heltäckande dataintegration, styrning och hantering av datalagerhus på en enda plattform.
Varför jag valde Qlik
Jag valde Qlik eftersom den adaptiva Iceberg-optimeraren gör att plattformen sticker ut: den kör kontinuerligt komprimering, indexering och rensning av ögonblicksbilder på dina Iceberg-tabeller utan någon manuell finjustering, vilket ger 2,5x–5x snabbare frågehastigheter och upp till 50 % lägre lagringskostnader. Jag förlitar mig också på dess spegling utan datakopiering för att överföra aktiva Iceberg-tabeller direkt till Snowflake utan att duplicera data eller öka komplexiteten i datapipelines.
Viktiga Qlik-funktioner
- Loggbaserad CDC-replikering: Qlik Replicate fångar ändringar direkt från databasernas transaktionsloggar utan att några agenter krävs, vilket håller data i datalagerhusmiljön aktuell utan att påverka källsystemets prestanda.
- Inmatningspipeline i flera format: Läs in data i Parquet, Avro, ORC, JSON och CSV från fler än 200 källor – inklusive databaser, SaaS-appar, SAP, stordatorer och strömningsplattformar som Kafka och Kinesis.
- Spårbarhet och konsekvensanalys på kolumnnivå: Följ data från källa till användning på kolumnnivå, vilket ger dig ett tydligt granskningsspår för styrning och rapportering av regelefterlevnad.
- Automatiserad hantering av brons-, silver- och guldzoner: Qlik Compose for Data Lakes automatiserar schemagenerering, skapande av Hive-katalog och kontinuerliga zonuppdateringar via CDC – vilket eliminerar behovet av manuell kodning av pipelines för datalagerhusarkitekturer i flera nivåer.
Qlik-integreringar
Qlik stöder fler än 200 inmatningskällor, inklusive Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP och Salesforce. Dess Iceberg-tabeller integreras med Spark, Amazon Athena, Trino, Presto, Databricks, Dremio och Tableau.
Pros and Cons
Pros:
- Autooptimerad hantering av Apache Iceberg-tabeller
- Avancerad loggbaserad CDC-replikering i realtid
- Djupgående efterlevnads- och styrningskontroller för företag
Cons:
- Komplex plattform med höga tekniska krav
- Otydlig process för licensiering och kostnadsberäkning
Learn more about Qlik: Bäst för styrning av hybrida datasjöar i reglerade företag
- 60 dagars kostnadsfri provperiod tillgänglig
- Från $0.04/CCU/timme
Visit WebsiteCustomer Rating:4.1/5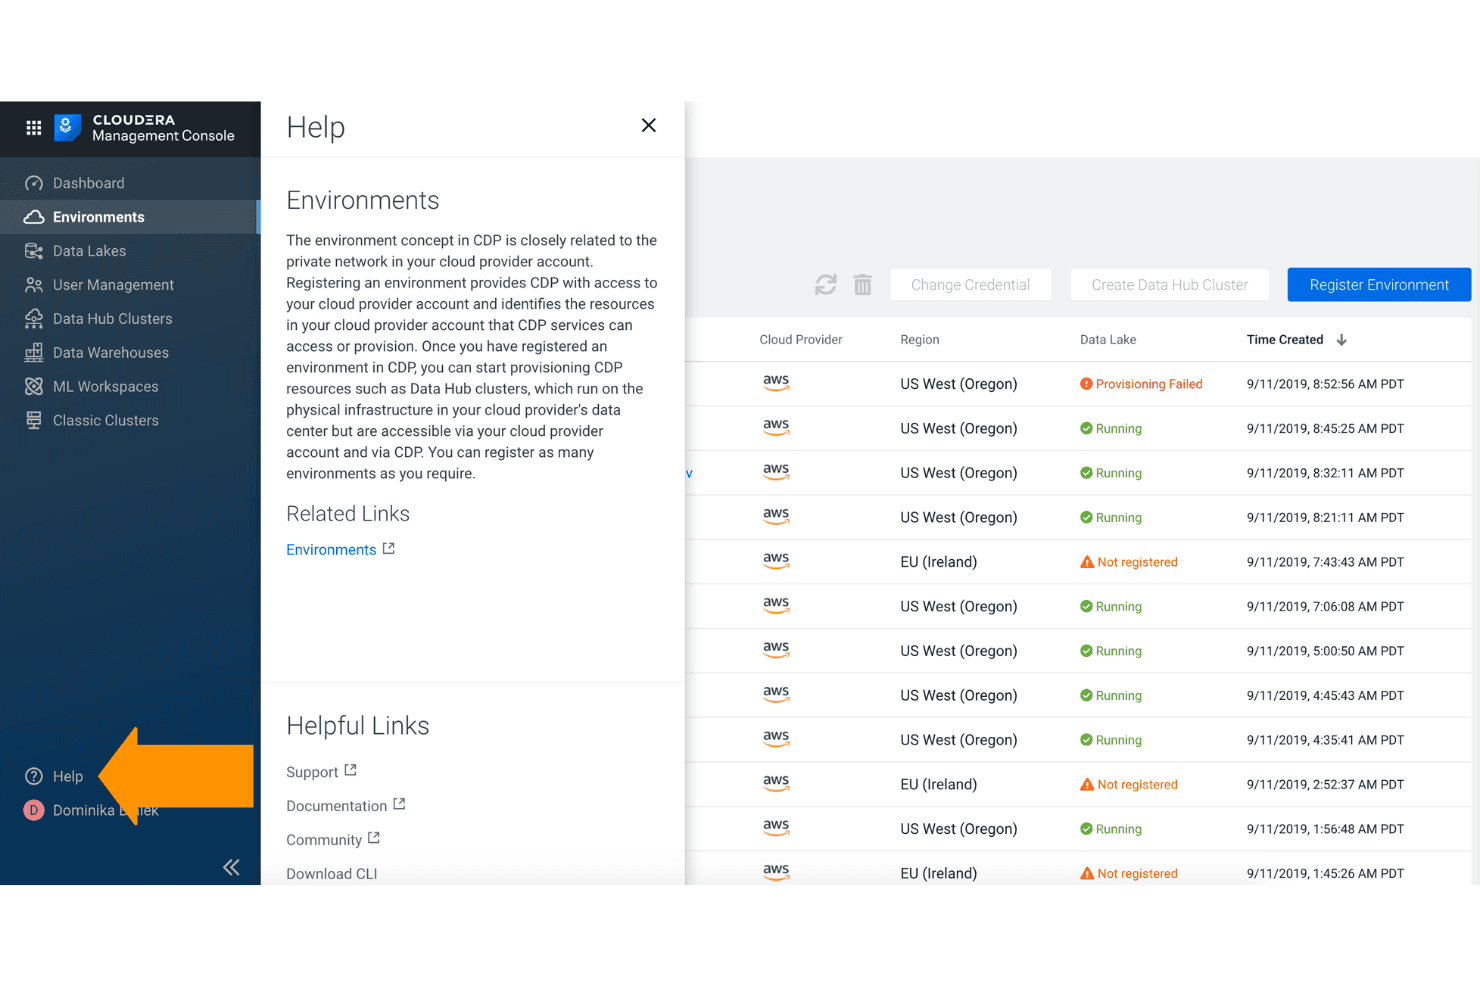
Cloudera låter användare hantera och övervaka molnmiljöer i olika regioner. Cloudera är en öppen lakehouse-plattform som omfattar skalbar lagring i flera moln och lokalt, dataimport i flera format via över 450 anslutningar, Apache Iceberg-baserat schema vid läsning samt centraliserad styrning i hybridmiljöer.
För vem passar Cloudera bäst?
Cloudera passar mycket bra för stora företag i reglerade branscher—banker, myndigheter och telekomföretag—som behöver enhetlig styrning över lokala miljöer och miljöer med flera moln.
Varför jag valde Cloudera
Cloudera finns med på min kortlista eftersom ingen annan plattform matchar dess djupgående styrning över hybridmiljöer. Jag är särskilt imponerad av Cloudera SDX, som tillämpar policyer från Apache Ranger och Apache Atlas en gång och verkställer dem överallt, oavsett om dina data finns i ett lokalt HDFS-kluster, Azure ADLS eller AWS S3. Banker och myndigheter som kör blandad infrastruktur kan definiera maskeringsregler på kolumnnivå och ABAC-policyer centralt, med FedRAMP Moderate- och PCI DSS 4.0-certifieringar som stöd för efterlevnaden.
Viktiga funktioner i Cloudera
- Apache Iceberg-tidsresor: Fråga historiska ögonblicksbilder av dina data vid valfri tidpunkt med hjälp av Icebergs inbyggda versionshantering och tidsresefunktioner.
- Optimering av lakehouse: Automatiserar komprimering av Iceberg-tabeller, Z-ordning och partitionsgallring för att förbättra frågeprestandan och minska beräkningskostnaderna.
- Visuell pipelinebyggare för Cloudera Data Flow (NiFi): Utforma och distribuera datapipelines för dataimport med hjälp av ett dra-och-släpp-gränssnitt med över 450 förbyggda processorer och anslutningar.
- Datadelning utan kopiering via Iceberg REST Catalog: Externa motorer som Databricks, Snowflake och Athena kan direkt fråga Iceberg-tabeller som hanteras av Cloudera utan dataförflyttning eller duplicering.
Cloudera-integrationer
Cloudera Data Flow tillhandahåller över 450 förbyggda anslutningar, däribland Apache Kafka, MongoDB, Salesforce, Snowflake och Google BigQuery. Det integreras även med AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau och Power BI via Iceberg REST Catalog.
Pros and Cons
Pros:
- Oöverträffat stöd för hybridmiljöer och lokala miljöer
- Företagsstyrning för strikta efterlevnadskrav
- Delning utan kopiering mellan externa frågemotorer
Cons:
- Den initiala konfigurationen kräver ofta expertkunskaper
- Tillfredsställelsen med metadatastrukturen ligger under konkurrenternas genomsnitt
Learn more about Cloudera: Bäst för öppna Iceberg-lakehouses utan inlåsning
- 30 dagars kostnadsfri provperiod
- Från $0.20/DCU
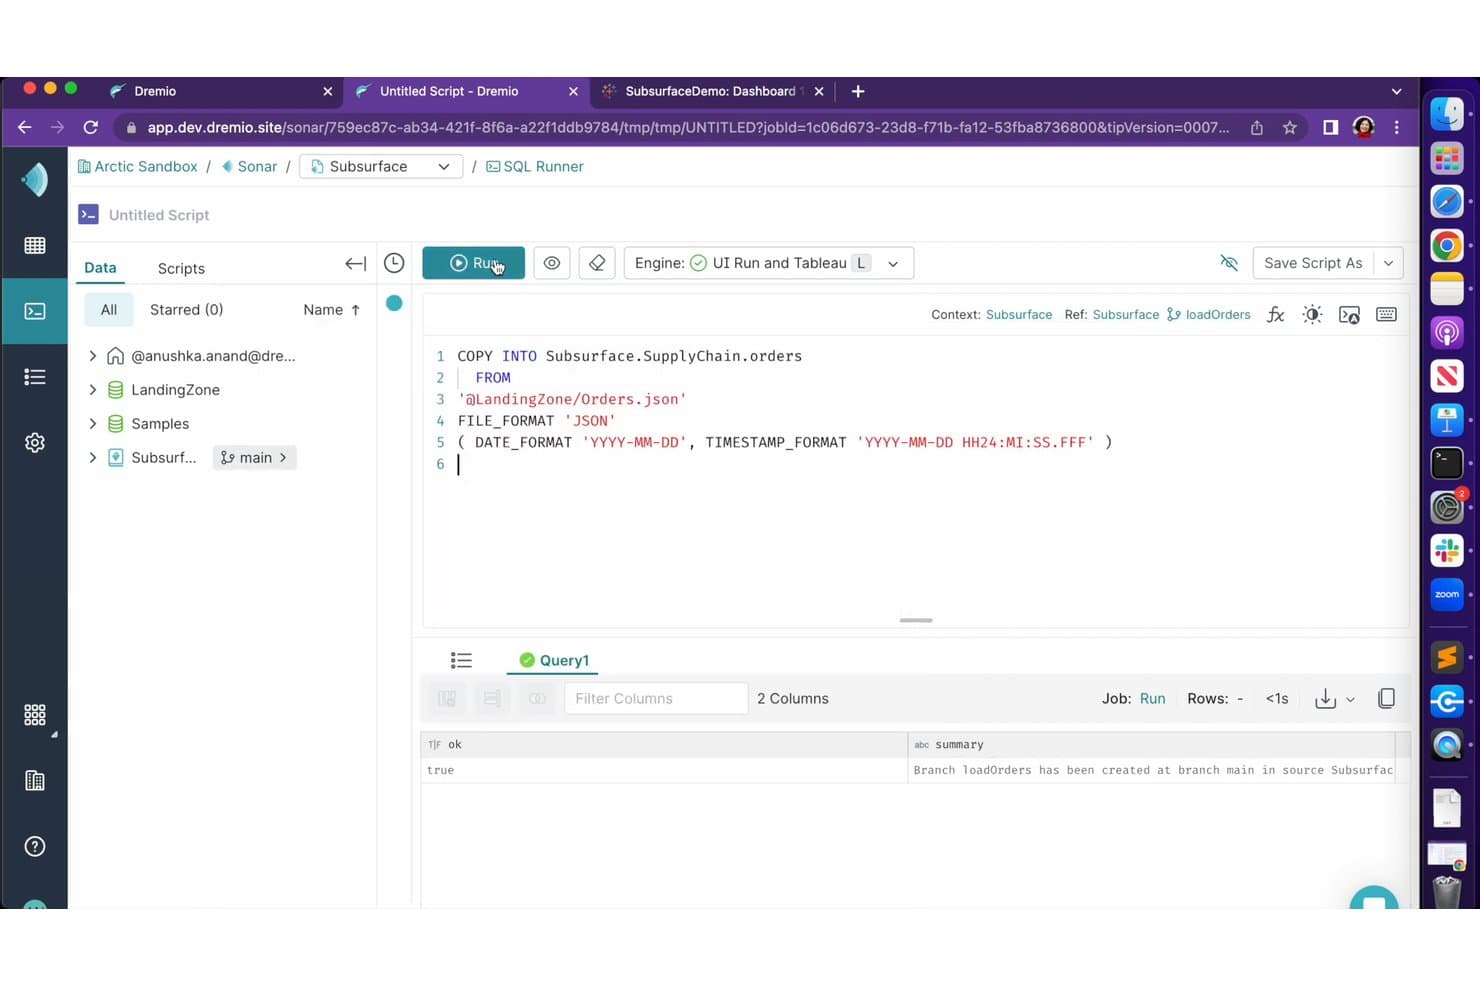
Dremio låter användare läsa in JSON-data i tabeller med SQL-kommandon av typen COPY INTO. Dremio är en öppen lakehouse-plattform byggd direkt på Apache Iceberg och Apache Arrow, som kombinerar en SQL-frågemotor, federerad dataåtkomst, automatisk frågeacceleration, Git-liknande dataversionshantering och en öppen katalog med stöd för flera motorer.
Vem passar Dremio bäst för?
Dremio passar bra för datateknik- och arkitekturteam som bygger öppna lakehouses på Apache Iceberg och behöver frågeåtkomst från flera motorer utan att låsas till en egenutvecklad katalog eller lagringsformat.
Varför jag valde Dremio
Dremio tar plats på min kortlista eftersom plattformen är byggd direkt på Apache Iceberg, vilket innebär att dina data förblir i dina egna S3- eller ADLS-buckets och att alla motorer (Spark, Flink, Trino, DuckDB) kan läsa och skriva dem via den öppna Polaris-katalogen utan formatkonvertering. Jag uppskattar särskilt autonoma reflektionsvyer, som i bakgrunden observerar frågemönster och materialiserar accelerationer, så att dina BI-instrumentpaneler får snabba resultat utan manuell finjustering eller egenutvecklade extrakt.
Dremios viktigaste funktioner
- Öppen katalog (Apache Polaris): En katalog för flera motorer byggd på Apache Polaris som låter Spark, Flink, Trino och DuckDB läsa och skriva Iceberg-tabeller via ett standardiserat REST-API.
- Förgrening av data som kod: Git-liknande versionshantering via Project Nessie skapar isolerade datagrener utan kopiering för utveckling, testning och ML-experiment med atomära sammanfogningar och återställningar.
- Inläsning med COPY INTO: Ett inbyggt SQL-kommando som massladdar CSV-, JSON- och Parquet-filer från objektlagring direkt till Iceberg-tabeller, med stöd för schemautveckling och partitionshantering.
- Detaljerad åtkomstkontroll: Säkerhet på radnivå och maskering av kolumner som tillämpas vid frågetillfället och konsekvent gäller för varje motor som frågar katalogen.
Dremio-integrationer
Dremio integreras med Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage och Google Cloud Storage. Dess Polaris REST-katalog samt ODBC-, JDBC- och Arrow Flight-gränssnitt stöder anslutningar från anpassade motorer och applikationer.
Pros and Cons
Pros:
- Bearbetar Apache Iceberg direkt utan konvertering
- Git-liknande dataförgrening för tidsresor
- Öppen REST-katalog som ansluter valfri frågemotor
Cons:
- Mer komplex administration än jämförbara verktyg
- Ingen särskild inbyggd ML-funktionsbutik
Learn more about Dremio: Bäst för datastyrning i datasjöar inom reglerade branscher
- Gratis demo tillgänglig
- Pris på begäran
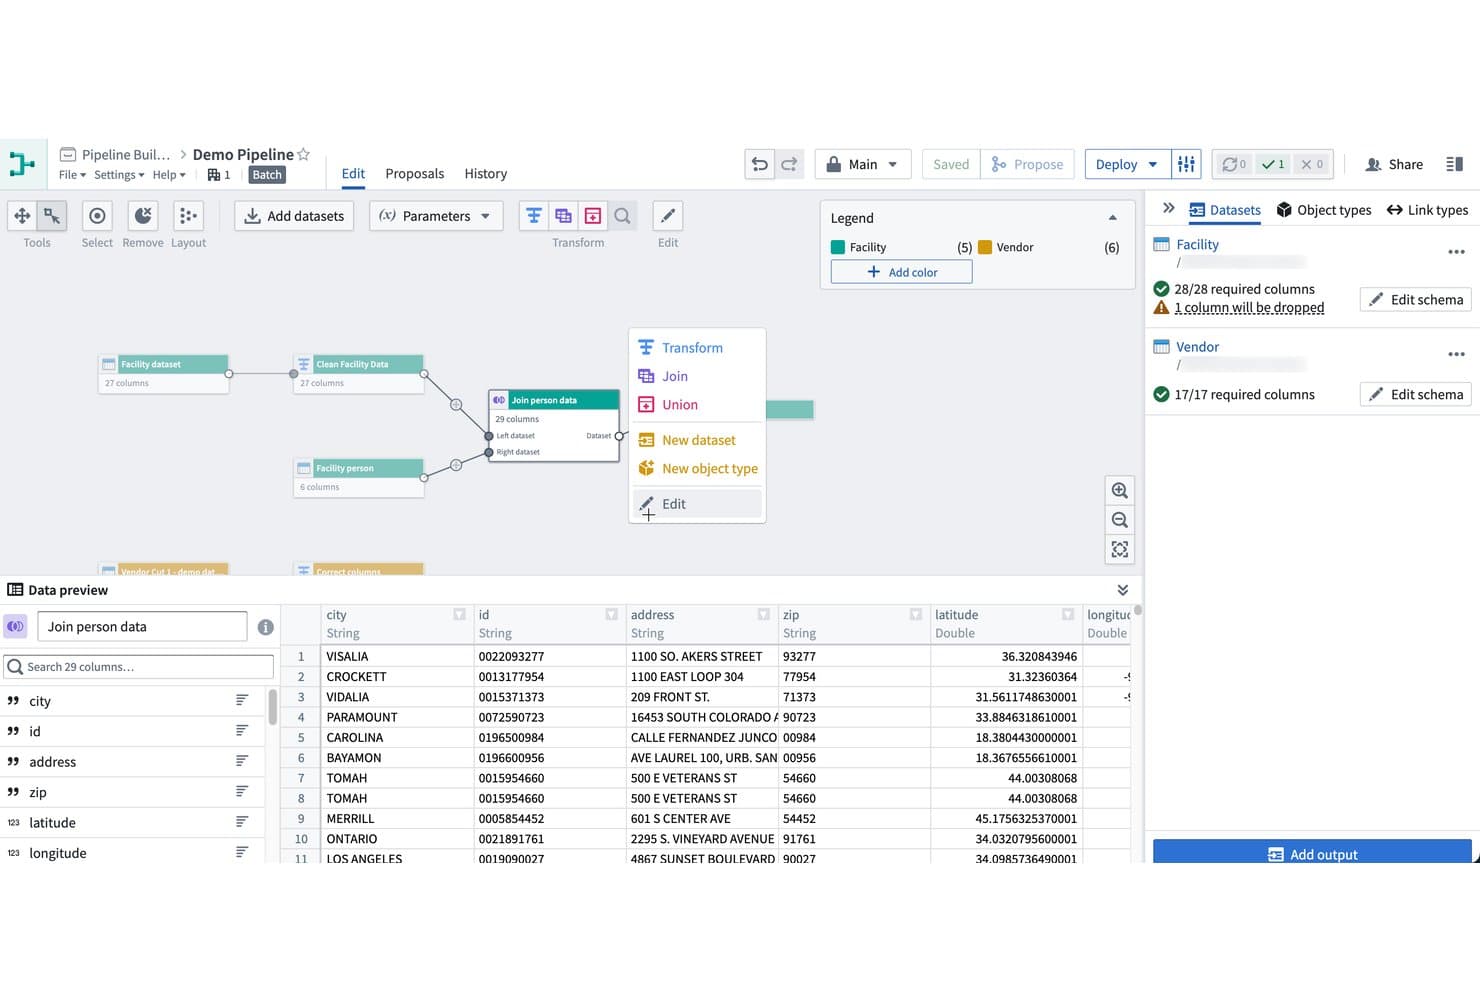
Palantir Foundry låter användare visuellt bygga och sammanfoga dataset i pipelines. Palantir Foundry är en datasjöplattform som kombinerar inmatning i flera format, pipelineorkestrering, semantisk datamodellering via sitt Ontology-lager och inbyggda styrningskontroller i moln-, lokala och nätverksisolerade miljöer.
Vem passar Palantir Foundry bäst för?
Palantir Foundry är särskilt utformad för stora företag i reglerade branscher—finans, hälso- och sjukvård, försvar och offentlig sektor—som behöver detaljerad datastyrning i komplexa miljöer med flera datakällor.
Varför jag valde Palantir Foundry
Jag valde Palantir Foundry eftersom dess styrningsarkitektur verkligen saknar motstycke i reglerade branscher. Plattformen kombinerar syftesbaserade, klassificeringsbaserade och rollbaserade åtkomstkontroller, med datamärkningar som automatiskt följer datahärkomsten så att en PII-tagg på ett källdataset följer datan genom varje efterföljande transformation. Kombinera detta med certifieringarna FedRAMP High, HIPAA, ITAR och SOC 2 Type 2 samt Ontology-lagret, som kopplar rådata från datasjön till granskningsbara affärsobjekt, så får du en plattform som från grunden är byggd för miljöer där styrning inte är valfri.
Viktiga funktioner i Palantir Foundry
- 200+ förbyggda datakopplingar: Anslut till databaser, datalager, strömningsplattformar, ERP-system, molnlagring, IoT-källor och geospatiala verktyg via ett enda gränssnitt för dataimport.
- Apache Iceberg REST Catalog: Tillgängliggör Foundry-dataset för externa Iceberg-kompatibla beräkningsmotorer—inklusive Trino, Spark, Flink, Databricks och Snowflake—utan att duplicera data.
- Virtuella tabeller för federering utan kopiering: Fråga externa tabeller i Databricks, Snowflake och S3-kompatibla lagringsutrymmen direkt från Foundry utan att importera eller flytta den underliggande datan.
- AIP-modellstudio: Bygg, träna, utvärdera och tillgängliggör ML-modeller i Foundry, med inbyggd åtkomst till LLM:er och stöd för utvecklingsmiljöer i Python och R.
Integrationer med Palantir Foundry
Palantir Foundry erbjuder över 200 inbyggda datakopplingar, inklusive Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau och Power BI. Plattformen stöder även anpassade anslutningar via sitt S3-kompatibla API, Iceberg REST Catalog och virtuella tabeller.
Pros and Cons
Pros:
- Datastyrning i toppklass för efterlevnad
- Ontology-lagret möjliggör dataåtkomst för verksamhetsanvändare
- Datadelning utan kopiering med virtuella tabeller
Cons:
- Höga avtalspriser med otydliga totalsummor
- Risk för plattformsinlåsning på grund av proprietära modeller
Learn more about Palantir Foundry: Bäst för styrning över flera motorer i öppna tabeller i datasjöar
- 90 dagars kostnadsfri provperiod
- Från $0.12 per DCU-timme
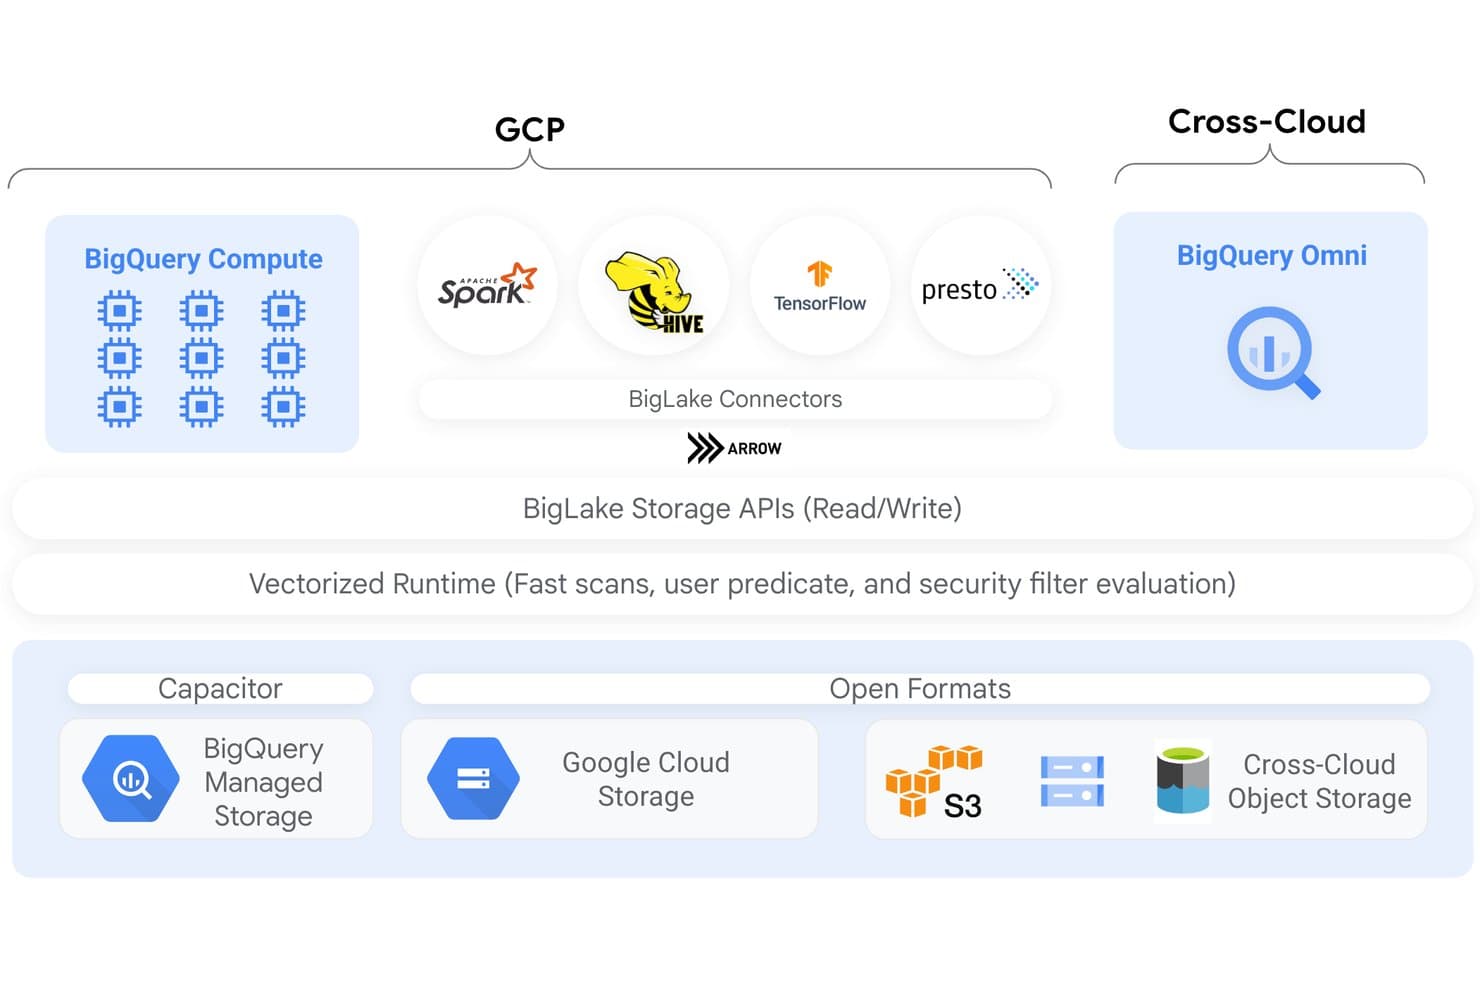
BigLake förenar beräkning och lagring över GCP och miljöer med flera moln. BigLake är Google Clouds lakehouse-plattform som utökar BigQuery med stöd för tabeller i öppna format, frågeåtkomst över flera motorer, enhetlig metadatahantering och detaljerad styrning över GCS, S3 och Azure Blob Storage.
Vem passar BigLake bäst för?
BigLake passar bra för dataingenjörs- och arkitekturteam som redan har investerat i Google Cloud och behöver enhetlig styrning över flera frågemotorer och öppna tabellformat.
Varför jag valde BigLake
Jag valde BigLake som en av de bästa plattformarna eftersom det är den enda lakehouse-plattform jag har sett som konsekvent tillämpar åtkomstpolicyer på rad- och kolumnnivå i BigQuery, Spark, Trino och Presto, inte bara i en enda motor. Det innebär att en policytagg som tillämpas på en känslig kolumn följer med datan oavsett vilken motor teamet använder för att fråga den. Lakehouse Iceberg REST-katalogen gör detta möjligt genom att fungera som en enda styrningsmedveten slutpunkt för alla motorer med öppen källkod som läser och skriver till samma Iceberg-tabeller.
Viktiga funktioner i BigLake
- Automatiserat tabellunderhåll: BigLake hanterar automatiskt filkomprimering, klustring, skräpsamling och generering av metadata för Iceberg-tabeller som lagras i GCS.
- Datainläsning i flera format: Läs in data i Parquet, ORC, Avro, CSV, JSON och öppna tabellformat som Apache Iceberg, Delta Lake och Apache Hudi via manifestfiler.
- Frågor över flera moln med BigQuery Omni: Kör BigQuery SQL-frågor direkt mot data som lagras i Amazon S3 eller Azure Data Lake Storage Gen 2 utan att flytta den till GCS.
- Replikering av ändringsdatafångst: Strömma operativa data från Cloud Spanner, AlloyDB och Cloud SQL direkt till BigLake-tabeller för analys nära realtid.
BigLake-integreringar
BigLake har inbyggda integreringar med BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker och Vertex AI. Dess Iceberg REST-katalog ansluter motorer med öppen källkod till delade tabeller i datasjön.
Pros and Cons
Pros:
- Rad- och kolumnsäkerhet som tillämpas över flera motorer
- Öppna tabellformat med fullständigt Iceberg-stöd
- Katalogfederation för metadatahantering i flera moln
Cons:
- DML stöds inte för externa tabeller som inte använder Iceberg
- CMEK är inte tillgängligt för cachelagrade tabeller i S3 eller Azure
Learn more about BigLake: Bäst för datadelning utan kopiering mellan moln
- 30 dagars kostnadsfri provperiod
- Från $2.00/kredit
Visit WebsiteCustomer Rating:4.6/5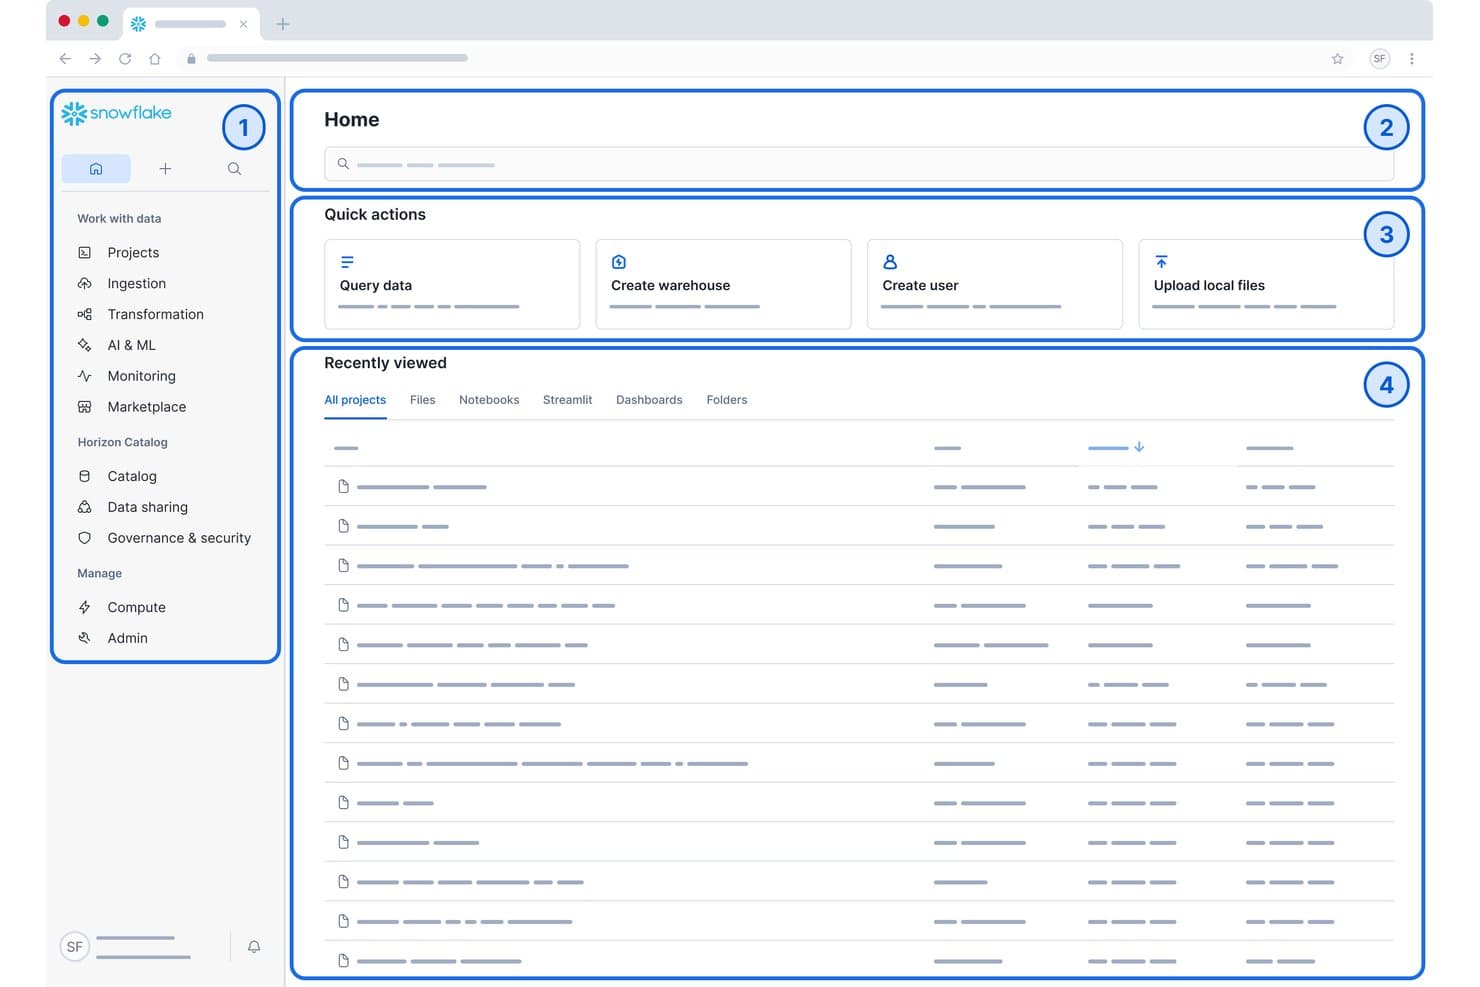
Snowflakes hemöversikt samlar datafrågor, skapande av datalager och aktuella projekt på ett ställe. Snowflake är en molnbaserad datasjö- och analysplattform som kombinerar elastisk lagring, en inbyggd SQL-frågemotor, Snowpark för Python-/Java-/Scala-arbetsbelastningar, stöd för Apache Iceberg och datadelning utan kopiering mellan AWS, Azure och GCP.
Vem passar Snowflake bäst för?
Snowflake passar mycket bra för företagsdatateam som hanterar storskaliga miljöer med flera moln, där styrning, efterlevnad och datadelning mellan organisationer är oumbärliga krav.
Varför jag valde Snowflake
Snowflake finns med på min kortlista eftersom datadelning utan kopiering gör det möjligt att dela live-datauppsättningar mellan AWS-, Azure- och GCP-konton utan att duplicera eller flytta en enda byte. Jag har arbetat med Snowflake Marketplace, som ansluter till fler än 820 dataleverantörer, och den automatiska leveransen mellan moln gör det verkligt smidigt att dela data mellan regioner. Kombinera det med inbyggt stöd för Apache Iceberg och Snowpipe Streaming, som hanterar över 1 miljon transaktioner per sekund, så får du en datasjöplattform byggd för verklig företagsskala.
Viktiga funktioner i Snowflake
- Flerspråkig körningsmiljö i Snowpark: Skriv arbetsbelastningar för datateknik och maskininlärning i Python, Java eller Scala och kör dem direkt i Snowflakes frågemotor utan att flytta ut data.
- Stöd för Apache Iceberg-tabeller: Lagra och hantera data i det öppna Iceberg-tabellformatet på Snowflake-hanterad lagring, med schemautveckling, historikåtkomst och kompatibilitet med Spark, Trino och Flink.
- Horizon-katalogen: Ett inbyggt styrningslager med spårning av härkomst på kolumnnivå, automatiserad PII-klassificering, AI-stödd berikning av metadata och datamätfunktioner för kontinuerlig övervakning av datakvalitet.
- Snowpipe Streaming: Läs in data på radnivå i realtid med över 1 miljon transaktioner per sekund direkt i Snowflake- eller Apache Iceberg-tabeller utan fördröjningar från batchbearbetning.
Snowflake-integreringar
Snowflake erbjuder inbyggda integreringar med Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker och Apache Airflow. Det ansluter till Apache Spark, Trino, Amazon S3, Azure Blob Storage och Google Cloud Storage, med API:er för anpassade integreringar.
Pros and Cons
Pros:
- Datadelning utan kopiering mellan moln
- Inbyggd styrning och härkomst på kolumnnivå
- Elastisk separering av lagring och beräkning
Cons:
- Stöd saknas för lokal distribution
- Det kan vara svårt att följa kostnader
Learn more about Snowflake: Bäst för GCP-inbyggda lakehouse-lösningar med lagring i flera nivåer
- Gratisplan tillgänglig
- Från $0.020/GB/månad
Visit WebsiteCustomer Rating:4.7/5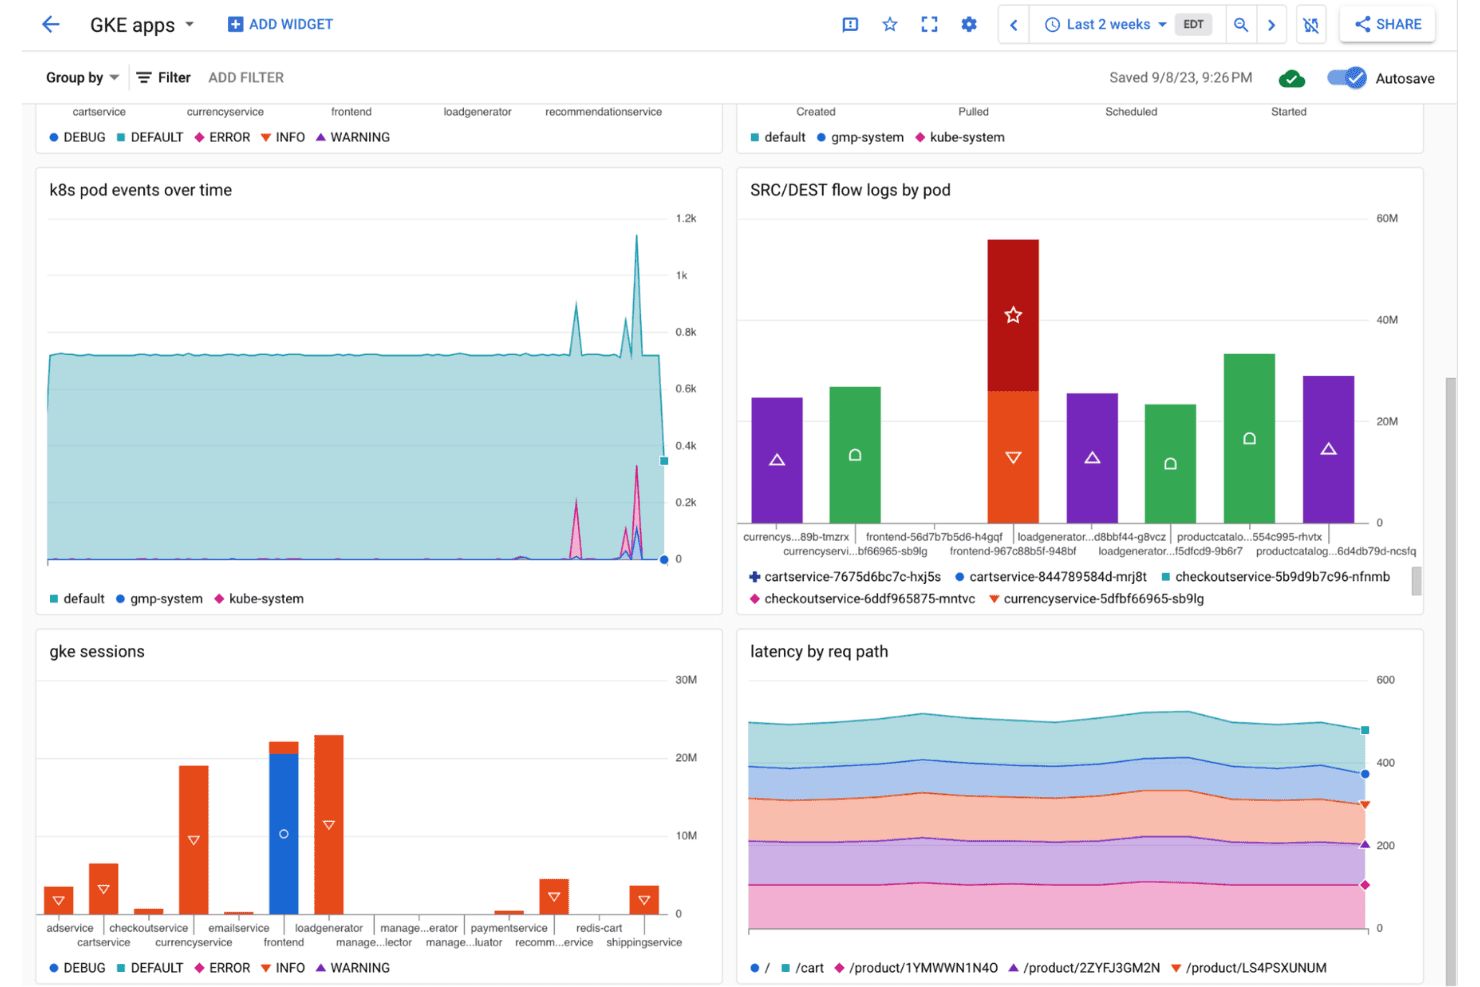
Google Cloud Storage visar instrumentpaneler för övervakning av GKE-appar med poddhändelser och fördröjningsmått. Google Cloud Storage är en hanterad objektlagringstjänst byggd för datasjöarkitekturer, med lagringsklasser i flera nivåer, stöd för öppna tabellformat via Apache Iceberg och BigLake samt djup integration med BigQuery, Dataflow, Dataproc och Vertex AI.
För vem passar Google Cloud Storage bäst?
Google Cloud Storage passar bra för datateknik- och infrastrukt urteam som redan arbetar inom GCP-ekosystemet och behöver skalbar objektlagring som grund för en lakehouse-arkitektur.
Varför jag valde Google Cloud Storage
Jag valde Google Cloud Storage eftersom det är den inbyggda grunden för en GCP-baserad lakehouse-arkitektur, med lagringsklasser i flera nivåer (från Standard till Archive för $0.0012/GB/month) och Autoclass som automatiskt flyttar objekt mellan nivåerna baserat på åtkomstmönster. Det jag tycker är särskilt övertygande är BigLake: det lägger till ACID-transaktioner, tidsresor och schemau tveckling direkt på Apache Iceberg-tabeller som stöds av GCS, vilket omvandlar rå objektlagring till ett frågebart lakehouse utan att data behöver flyttas. BigQuery kan sedan fråga samma Iceberg-tabeller på plats, utan att någon export krävs.
Viktiga funktioner i Google Cloud Storage
- Inläsning i flera format: Storage Transfer Service, Dataflow, Pub/Sub och Datastream stöder batch-, strömnings- och CDC-inläsning från databaser som MySQL, PostgreSQL och Oracle till GCS.
- Styrning och åtkomstkontroller: IAM-baserade behörigheter, CMEK/CSEK-kryptering, VPC Service Controls, Cloud DLP och granskningsloggning upprätthåller säkerheten för all lagrad data.
- Metadataidentifiering via Knowledge Catalog: Dataplex skannar automatiskt GCS-buckets för att extrahera scheman, skapa företagsordlistor och generera fullständig datahärstamning över GCS och BigQuery.
- Stöd för frågor via flera motorer: Iceberg-tabeller som stöds av GCS kan frågas av BigQuery, Serverless Spark, Trino, Flink och Presto via Iceberg REST Catalog.
Integrationer med Google Cloud Storage
Google Cloud Storage har inbyggda integrationer med BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker och Knowledge Catalog. REST-, XML- och gRPC-API:er samt klientbiblioteks-API:er stöder anpassade integrationer med dataplattformar och bearbetningsmotorer.
Pros and Cons
Pros:
- Lakehouse-stöd med Apache Iceberg-tabeller
- Analys med flera motorer via BigQuery och Spark
- Automatiserade alternativ för arkivering och lagring i flera nivåer
Cons:
- De flesta funktioner kräver flera GCP-tjänster
- Komplex fakturering med separata avgifter för åtgärder och utgående trafik
Learn more about Google Cloud Storage: Bäst för datasjöhus baserat på öppna tabellformat
- 14 dagars gratis provperiod
- Från $0.22/DBU
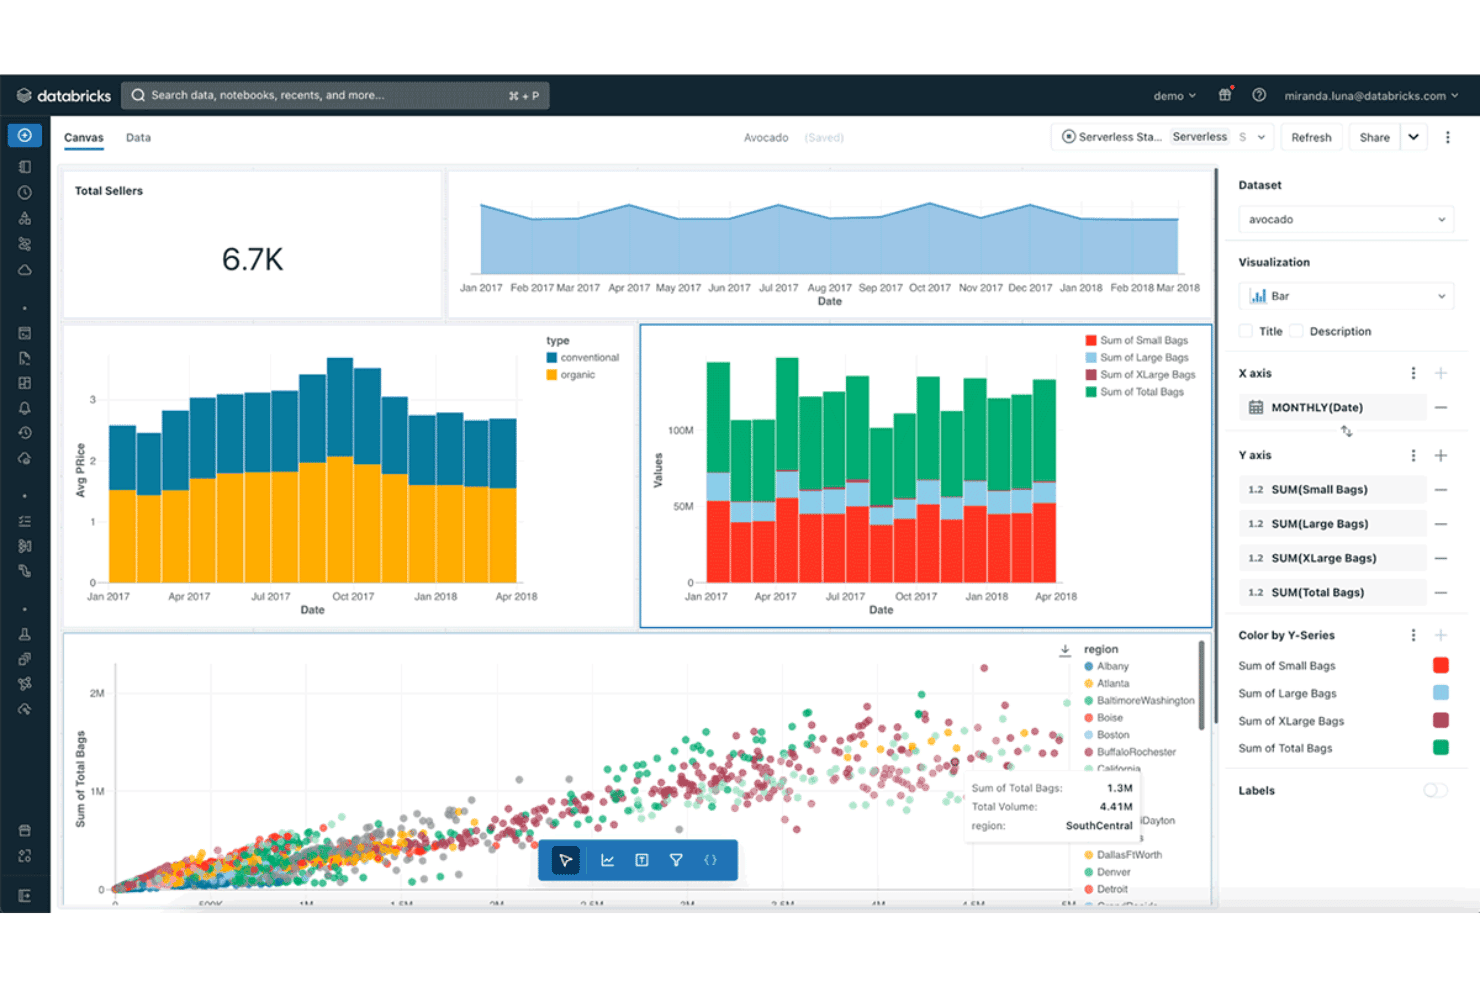
Databricks visualiserar avokadoförsäljning med interaktiva diagram i en instrumentpanel. Databricks Lakehouse Platform är en molnbaserad datasjöhusplattform som förenar datateknik, SQL-analys, maskininlärning och AI-utveckling på öppna tabellformat som Delta Lake, Apache Iceberg och Apache Hudi.
Vem passar Databricks Lakehouse Platform bäst för?
Databricks passar bra för företagsinriktade data- och ML-team som behöver köra tekniska pipelines, SQL-analys och AI-arbetsbelastningar på en enda plattform utan att flytta data mellan system.
Varför jag valde Databricks Lakehouse Platform
Databricks finns med på min kortlista eftersom det är teamet som bokstavligen uppfann Delta Lake, och den bakgrunden är viktig när man utvärderar stöd för öppna tabellformat. Jag har arbetat med plattformens inbyggda stöd för Delta Lake, Iceberg och Hudi, och det som skiljer den från mängden är att ACID-transaktioner, tidsresor och schemautveckling inte är påbyggnader. Unity Catalog lägger automatiserad spårbarhet på kolumnnivå och attributbaserad åtkomstkontroll direkt ovanpå, så att styrningen följer med data mellan moln.
Viktiga funktioner i Databricks Lakehouse Platform
- Lakeflow Connect: Ett hanterat, serverlöst inmatningslager med över 100 inbyggda anslutningar för SaaS-appar, databaser, molnlagring och strömningskällor, inklusive Kafka, Kinesis och Event Hubs.
- Deklarativa Apache Spark-pipelines: Ett ramverk för att bygga ETL-pipelines för batchbearbetning och realtidsströmning, med inbyggd regelbaserad hantering av datakvalitet och automatiserad CDC.
- Databricks SQL Warehouses: En Photon-accelererad SQL-motor som stöder ANSI SQL för analysarbetsbelastningar, med JDBC/ODBC-anslutning för BI-verktyg som Tableau, Power BI och Looker.
- MLflow-integration: En hanterad MLflow-miljö för experimentuppföljning, modellregister och distribution, samlokaliserad med dina datasjödata och ansluten till Feature Store och Model Serving.
Integrationer med Databricks Lakehouse Platform
Databricks erbjuder över 100 inbyggda Lakeflow Connect-anslutningar, inklusive Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive och Google Analytics. Plattformen ansluter även till Kafka, Kinesis, Event Hubs, S3, ADLS och GCS, med JDBC/ODBC och API:er för anpassad anslutning.
Pros and Cons
Pros:
- Inbyggt stöd för Delta Lake, Iceberg och Hudi
- Automatiserad spårbarhet på kolumnnivå med Unity Catalog
- Inbyggd MLflow och en enhetlig AI-plattform
Cons:
- DBU- och molnkostnader kan snabbt öka
- Det finns inget alternativ för lokal distribution
Learn more about Databricks Lakehouse Platform: Bäst för objektlagring som kärnan i AWS-datasjöar
- Inte tillgängligt
- Från $0.023/GB/månad
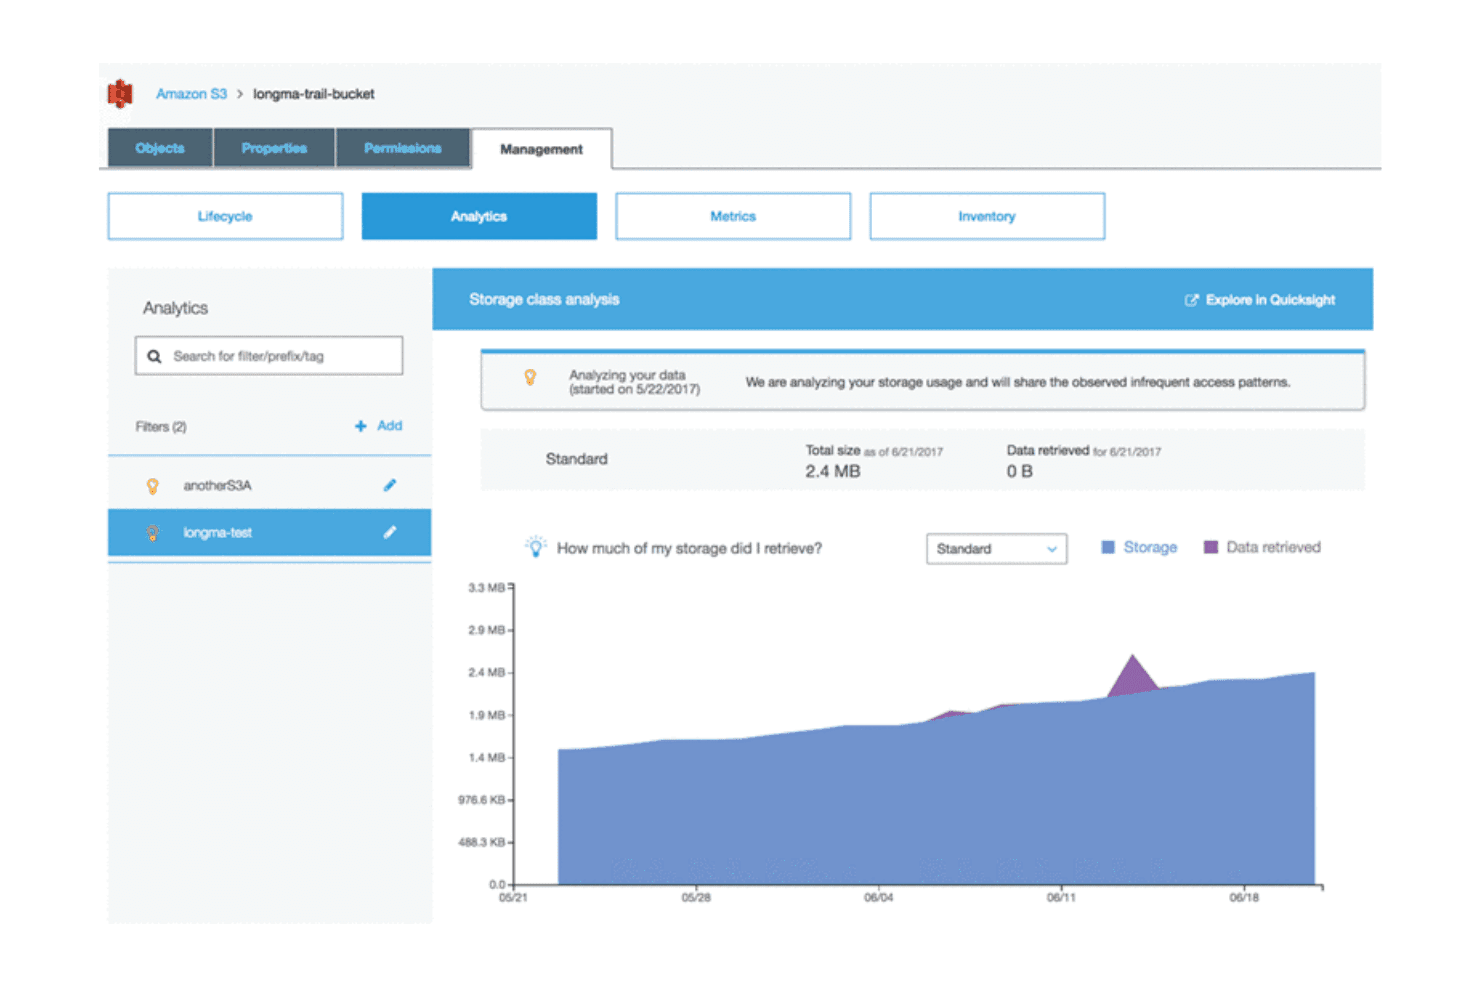
Amazon S3 analyserar mönster i lagringsanvändningen för att optimera kostnaderna för datahämtning. Amazon S3 är AWS:s objektlagringstjänst som fungerar som det grundläggande lagringslagret för datasjöar och stöder alla dataformat i exabyteskala, med nivåindelade lagringsklasser, inbyggd Apache Iceberg-tabellhantering via S3 Tables och djup integration i hela AWS-analys-ekosystemet.
Vem passar Amazon S3 bäst för?
Amazon S3 passar datateknik- och infrastrukturteam som bygger analys- och datapipelines på AWS och behöver en beprövad lagringsgrund i exabyteskala som ansluter direkt till resten av AWS-ekosystemet.
Varför jag valde Amazon S3
Amazon S3 finns med på min kortlista eftersom det är det objektlagringslager som de flesta produktionsdatasjöar redan bygger på. Jag uppskattar att S3 Tables erbjuder inbyggt stöd för Apache Iceberg med ACID-transaktioner, tidsresor och automatisk komprimering, vilket löser problemet med små filer som plågar de flesta datasjöarkitekturer. Kombinera det med att S3 Intelligent-Tiering automatiskt flyttar kalla data till $0.00099/GB/månad, så får du betydande kontroll över lagringskostnaderna utan manuella åtgärder.
Viktiga funktioner i Amazon S3
- Inläsning av flera format: S3 accepterar alla filtyper—Parquet, ORC, Avro, JSON, CSV och ostrukturerade format—via batchuppladdningar, direktuppspelning genom Kinesis och MSK eller händelsestyrda utlösare med S3 Event Notifications.
- Finkornig åtkomstkontroll med Lake Formation: Tillämpa dataåtkomstprinciper på tabell-, kolumn-, rad- och cellnivå i hela din S3-baserade datasjö utan att duplicera data.
- S3 Vectors: En inbyggd tjänst för lagring och sökning i vektorindex som är direkt integrerad i S3 och utformad för arbetsbelastningar med semantisk sökning och generering med förstärkt informationshämtning, till upp till 90 % lägre kostnad än traditionella metoder.
- S3 Inventory: Skapa schemalagda rapporter om objektattribut, lagringsklass, krypteringsstatus och replikeringsstatus i dina lagringsbehållare för gransknings- och styrningsarbetsflöden.
Integrationer med Amazon S3
Amazon S3 erbjuder inbyggda integrationer i AWS, inklusive AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum och Amazon SageMaker. Det ansluter även till Apache Spark, Trino, Snowflake, Databricks, Tableau och Power BI via dokumenterade anslutningar och API:er.
Pros and Cons
Pros:
- Objektlagring i exabyteskala som stöder alla dataformat
- Inbyggda ACID-tabeller med Iceberg och automatisk komprimering
- 143 efterlevnadscertifieringar och åtkomstkontroll på objektnivå
Cons:
- Prissättningen är komplex och kräver noggrann hantering
- Att bygga en datasjö kräver att flera AWS-tjänster kombineras
Learn more about Amazon S3: Bäst för Microsoft-inbyggda datasjöar för företag
- $200 i kredit i 30 dagar (ingen särskild kostnadsfri nivå)
- Från $0.023/GB/månad
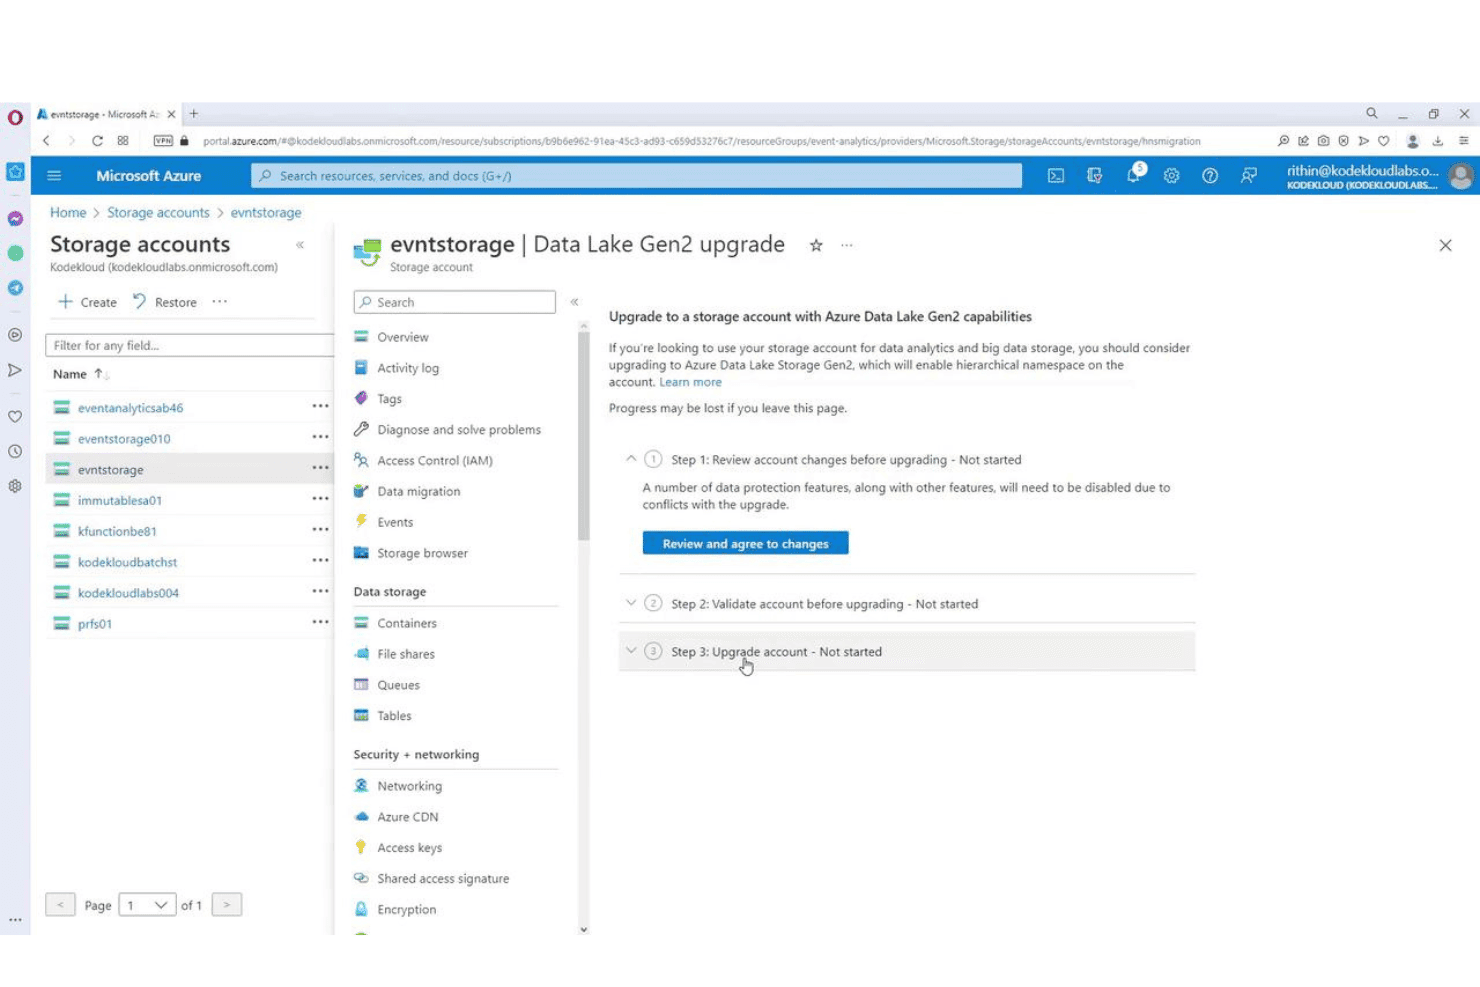
Azure Storage låter användare uppgradera konton med Data Lake Gen2-funktioner. Azure Data Lake Storage Gen2 är Microsofts molnbaserade datalagertjänst, byggd på Azure Blob Storage med ett hierarkiskt namnområde, som stöder lagring i exabyte-skala, dataimport i flera format, POSIX-kompatibla åtkomstkontroller samt inbyggd integration med Azures ekosystem för analys och maskininlärning.
Vem passar Azure Data Lake Storage bäst för?
Azure Data Lake Storage Gen2 passar naturligt för företags-IT- och datateam som redan använder Microsoft Azure och behöver lagring i exabyte-skala som är tätt integrerad med Synapse, Databricks och Microsoft Fabric.
Varför jag valde Azure Data Lake Storage
Jag valde Azure Data Lake Storage Gen2 som en av de bästa lösningarna eftersom det är den inbyggda lagringsgrunden för hela Microsofts analysstack, och den täta integrationen är viktig i företagsskala. När organisationen använder Synapse, Databricks och Microsoft Fabric finns ADLS Gen2 redan som underliggande lager för allt detta, vilket innebär att en enda datakopia kan frågas av alla motorer via ABFS-drivrutinen. Jag uppskattar särskilt de POSIX-kompatibla ACL:erna, som gör att du kan ange läs-, skriv- och körningsbehörigheter på individuell fil- och katalognivå, inte bara för containern.
Viktiga funktioner i Azure Data Lake Storage
- Automatisk livscykelbaserad nivåindelning: Ange principer som automatiskt flyttar data mellan nivåerna Hot, Cool, Cold och Archive baserat på ålder eller senaste åtkomst för att hantera lagringskostnader i stor skala.
- Kompatibilitet med ABFS-drivrutinen: Azure Blob File System-drivrutinen ger Hadoop-, Spark-, Hive- och HDFS-baserade arbetsbelastningar inbyggd läs- och skrivåtkomst till ADLS Gen2 utan kodändringar.
- OneLake-genvägar: Skapa aktiva referenser till data i andra OneLake-arbetsytor, Amazon S3 eller Azure Blob Storage-containrar utan att kopiera eller flytta underliggande data.
- Integration med Azure Machine Learning-datalager: Registrera ADLS Gen2-containrar direkt som datalager i Azure ML-arbetsytor, så att dataforskare får direkt åtkomst till data i datasjön för modellträning och experiment.
Integrationer med Azure Data Lake Storage
Azure Data Lake Storage har inbyggda integrationer i hela Microsofts ekosystem, inklusive Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning och Azure Event Hubs. Det stöder även Apache Spark och Kafka via dokumenterade anslutningar samt ABFS och API:er för anpassad dataåtkomst.
Pros and Cons
Pros:
- Inbyggd integration med Microsofts analysverktyg
- Hierarkiskt namnområde stöder detaljerad åtkomstkontroll
- Öppna tabellformat via beräkningslagret
Cons:
- Kräver Purview för avancerad datakatalogisering
- Finns endast på Microsoft Azure
Learn more about Azure Data Lake Storage:
Andra datalakeverktyg
Här är några ytterligare datalakeverktyg som inte kom med på min kortlista, men som ändå är värda att titta närmare på:
- 11IBM watsonx.dataBäst för öppet lakehouse med åtkomst till stordata
- 12Microsoft FabricBäst för dataintegration med Microsofts stack i datasjöar
- 13StarburstBäst för federerad SQL över datasjöar i flera moln
- 14Alibaba Cloud Hybrid CloudBäst för hybridmolnbaserade datasjödistributioner i APAC
- 15Teradata VantageBäst för AI/ML-arbetsbelastningar på datasjödata i petabyteskala
- 16MinIOBäst för AI och lakehouse-lagring lokalt
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Så väljer du datalakeverktyg
Vilka faktorer påverkar faktiskt om ett datalakeverktyg kan leverera den skalning, styrning och integration som ditt team behöver för analysarbetsbelastningar i verkligheten?
| Om din prioritet är... | Leta efter... |
|---|---|
| Om din prioritet är...Efterlevnad av regelverk | Leta efter...Inbyggd granskningsloggning och åtkomstpolicyer |
| Om din prioritet är...Driftsättning i flera moln eller hybridmiljö | Leta efter...Inbyggt stöd för flera molnleverantörer |
| Om din prioritet är...Oberoende från leverantören | Leta efter...Kompatibilitet med öppna tabellformat |
| Om din prioritet är...Analysprestanda i stor skala | Leta efter...Lagrad data på olika nivåer och inbyggd frågeintegration |
| Om din prioritet är...Beredskap för AI och ML | Leta efter...Direkta anslutningar till AI/ML-verktyg och motorer |
Så utvärderar du din kortlista
- Bekräfta styrningsfunktionerna: Be om skärmbilder från administratörskonsolen som visar rollbaserad åtkomstkontroll och konfigurationen av granskningsloggar.
- Testa stöd för öppna format: Genomför en liveinläsning av Parquet- eller Iceberg-filer och verifiera schemats utveckling i en testmiljö.
- Validera påståenden om flera moln: Be om offentlig dokumentation som visar driftsättningssteg hos minst två molnleverantörer.
- Kontrollera analysintegrationen: Be om ett arbetsflödesexempel eller en konfiguration för Spark, Trino eller Presto, med dokumenterade frågeresultat.
- Avvägning – företagssvit kontra öppen lakehouse-arkitektur: Avgör om du behöver efterlevnad och support i en färdig företagssvit, eller om flexibilitet och kompatibilitet med en öppen stack är mer värdefullt för din arkitektur.
Vad är datalakeverktyg?
Datalakeverktyg är plattformar och programvara som hjälper dig att lagra, hantera och analysera stora volymer strukturerade och ostrukturerade data i ett centraliserat arkiv. Med dessa verktyg kan ditt team läsa in rådata, tillämpa scheman vid behov och organisera tillgångar för analys- eller AI-projekt. Du kan förvänta dig funktioner som stöder styrning, skalbarhet och integration med populära frågemotorer och analysplattformar.
Funktioner hos verktyg för datasjöar
När du väljer verktyg för datasjöar bör du hålla utkik efter följande nyckelfunktioner:
- Skalbar objektlagring: Gör det möjligt att lagra och hantera petabyte med strukturerade och ostrukturerade data, med alternativ för lagring i olika nivåer eller kall lagring för att kontrollera kostnaderna när lagringsbehoven växer.
- Stöd för schema vid läsning: Gör det möjligt att först lagra rådata och tillämpa ett schema senare vid frågetillfället, vilket underlättar hanteringen av varierande datamängder som utvecklas över tid utan att behöva läsa in dem på nytt.
- Datainläsning i flera format: Stöder import av data i olika format som Parquet, Avro, JSON, ORC och CSV, och hanterar både batch- och dataströmmar för större flexibilitet i hur data anländer.
- Integrering med frågemotorer: Erbjuder kompatibilitet med motorer som Spark, Trino, Presto och Athena, så att du kan köra analys- och rapporteringsarbetsbelastningar direkt mot din datasjö utan extra mellanprogramvara.
- Hantering av metadata och kataloger: Inkluderar verktyg för datakatalogisering, sökning efter tillgångar, spårning av dataflöden och taggning, vilket hjälper dig att hålla data organiserade och sökbara när nya datamängder läggs till.
- Styrning och åtkomstkontroller: Erbjuder detaljerade behörigheter, kryptering och granskningsloggar så att du kan kontrollera vem som får åtkomst till vilka data, övervaka användningen och uppfylla lagstadgade krav.
- Dataversionshantering och tidsresor: Gör det möjligt att spåra ändringar, återgå till tidigare versioner av datamängder och bevara historiska vyer, vilket är värdefullt för granskning, återställning och reproducerbarhet.
- Integrering med orkestreringsverktyg: Ansluter inbyggt till arbetsflödesorkestrerare som Apache Airflow, vilket gör det möjligt att automatisera datapipelines och samordna uppgifter mellan olika system.
- Verktyg för övervakning och kostnadshantering: Tillhandahåller instrumentpaneler och aviseringar för lagringsanvändning, åtkomstmönster och kostnader, så att du kan hålla miljön effektiv och kostnadseffektiv.
- Stöd för öppna tabellformat: Hanterar format som Delta Lake och Apache Iceberg, vilket möjliggör avancerade funktioner som ACID-transaktioner och kompatibilitet med flera analysverktyg.
Vanliga AI-funktioner i verktyg för datasjöar
Utöver de standardfunktioner hos verktyg för datasjöar som anges ovan integrerar många av dessa lösningar AI med funktioner som:
- Automatisk dataklassificering: Använder AI-modeller för att genomsöka och kategorisera inkommande data baserat på innehåll, känslighet eller efterlevnadskrav. Detta hjälper teamet att organisera tillgångar snabbare och tillämpa rätt åtkomstkontroller utan manuell taggning.
- Avvikelsedetektering för datakvalitet: Tillämpar maskininlärningsalgoritmer för att övervaka dataströmmar och flagga ovanliga mönster, saknade värden eller avvikande värden. Detta gör att du kan upptäcka problem med dataintegriteten tidigt och minska risken för felaktiga analyser eller efterföljande fel.
- Prediktiv optimering av arbetsbelastningar: Använder AI för att analysera historiska frågemönster och lagringsanvändning och rekommenderar eller tillämpar automatiskt optimeringar som partitionering, cachning eller resursskalning. Detta hjälper dig att upprätthålla prestandan och kontrollera kostnaderna när användningen ökar.
- Frågegränssnitt på naturligt språk: Integrerar AI-drivna chatt- eller sökverktyg som låter användare ställa frågor om data på ett vardagligt språk. Detta sänker tröskeln för icke-tekniska användare att utforska datamängder och generera insikter utan att skriva SQL eller kod.
- Automatisk berikning av metadata: Använder AI för att extrahera sammanhang, relationer och affärstermer från rådata och fyller sedan datakatalogen med mer omfattande beskrivningar och information om dataflöden. Detta gör det enklare för team att hitta, lita på och återanvända datatillgångar.
Fördelar med verktyg för datasjöar
Att implementera verktyg för datasjöar ger flera fördelar för ditt team och din verksamhet. Här är några av dem:
- Centraliserad datahantering: Datalakeverktyg låter dig lagra strukturerade och ostrukturerade data på ett ställe, vilket gör det enklare att organisera tillgångar och stödja analys- eller AI-projekt.
- Skalbarhet för arbetsbelastningar i petabyteskala: Dessa plattformar kan hantera enorma datamängder och stödja både molnbaserade och lokala lagringsnivåer, så att du kan anpassa dig till växande behov utan att behöva göra om arkitekturen.
- Flexibel dataimport: Du kan importera data från en mängd olika format och källor samt hantera både batch- och dataströmmar i realtid, tack vare inbyggda anslutningar och stöd för olika format.
- Detaljerad styrning och åtkomstkontroll: Finkorniga behörigheter, kryptering och granskningsloggning hjälper dig att upprätthålla säkerhet och efterlevnad av standarder som HIPAA, SOC 2 och GDPR.
- Integration med analys- och AI-verktyg: Inbyggd kompatibilitet med frågemotorer som Spark, Trino och Presto – samt direkta anslutningar till AI/ML-verktyg – innebär att du kan analysera data utan fördröjningar eller extra integrationsarbete.
- Automatiserad hantering av metadata och datakvalitet: Många plattformar innehåller kataloger, spårning av datahärkomst och AI-drivna verktyg som hjälper dig att berika metadata, klassificera data och upptäcka avvikelser för att upprätthålla dataintegriteten.
- Stöd för öppna tabellformat och avancerade användningsområden: Funktioner som kompatibilitet med Delta Lake eller Apache Iceberg möjliggör ACID-transaktioner, dataversionshantering och datadelning utan kopiering för att stödja mer avancerad analys och arkitekturer med flera moln.
Kostnader och priser för datalakeverktyg
Att välja datalakeverktyg kräver en förståelse av de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i datalakelösningar:
Jämförelsetabell för abonnemang för datalakeverktyg
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| AbonnemangstypGratisabonnemang | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande objektlagring, begränsad dataimport, stöd för schema vid läsning och integration med en frågemotor. |
| AbonnemangstypPersonligt abonnemang | Genomsnittligt pris$50–$300/månad | Vanliga funktionerStörre lagringsgränser, stöd för flera dataformat, grundläggande katalogisering och integration med analysverktyg. |
| AbonnemangstypFöretagsabonnemang | Genomsnittligt pris$1,000–$5,000/månad | Vanliga funktionerLagring i petabyteskala, avancerade styrningskontroller, alternativ för flera moln och funktioner för datakatalogisering. |
| AbonnemangstypStorföretagsabonnemang | Genomsnittligt pris$10,000+/månad | Vanliga funktionerObegränsad lagring, fullständiga funktioner för efterlevnad, AI-driven automatisering, integration med orkestreringsverktyg och premiumsupport. |
Vanliga frågor om verktyg för datasjöar
Här är några svar på vanliga frågor om verktyg för datasjöar:
Hur hanterar verktyg för datasjöar säkerhets- och efterlevnadskrav?
Verktyg för datasjöar tillämpar säkerhet med åtkomstkontroller, kryptering och granskningsloggning. De flesta ledande plattformar stöder detaljerade behörigheter ned på rad- eller kolumnnivå samt integrationer med SSO- och identitetsleverantörer. För efterlevnad bör du leta efter leverantörscertifieringar som SOC 2, HIPAA eller GDPR samt alternativ för krypteringsnycklar som hanteras av kunden. Dessa funktioner hjälper dig att uppfylla regulatoriska krav utan att bygga ytterligare lager.
Kan verktyg för datasjöar integreras med befintliga analys- eller BI-plattformar?
Ja, de flesta verktyg för datasjöar erbjuder direkta anslutningar till analys- och BI-plattformar. Du kan förvänta dig inbyggt stöd för Spark, Trino, Presto och Athena samt integrationer med Tableau och Power BI. Om dina team använder specialiserade verktyg bör du kontrollera om det finns öppna API:er eller ODBC/JDBC-drivrutiner som gör det möjligt att ansluta anpassade arbetsflöden.
Vad är skillnaden mellan verktyg för datasjöar och datalager?
Verktyg för datasjöar fokuserar på att lagra rå, semistrukturerad och ostrukturerad data med schema vid läsning, medan datalager lagrar strukturerad data med fördefinierade scheman (schema vid skrivning). Datasjöar lämpar sig bättre för flexibel inläsning och AI/ML-arbetsbelastningar, medan datalager passar för bearbetad analys med optimerad frågeprestanda. Vissa leverantörer erbjuder nu datasjöhusarkitekturer som kombinerar båda metoderna.
Stöder verktyg för datasjöar flera dataformat och typer av datainläsning?
Ja, de flesta verktyg för datasjöar accepterar ett stort antal format som Parquet, Avro, JSON, ORC och CSV. Du hittar också stöd för både batch- och strömmande datakällor, vilket gör det möjligt att hantera allt från dagliga inläsningsjobb till händelseströmmar i realtid med hjälp av förbyggda eller anpassade anslutningar.
Hur utvärderar man verktyg för datasjöar när det gäller skalbarhet?
Jag tittar på varje plattforms alternativ för objektlagring, prestanda vid datamängder i petabyteskala och stöd för flera moln. Möjligheten att nivåindela lagring, bearbeta data över regioner och undvika flaskhalsar med format som Delta Lake eller Iceberg är avgörande. Se till att kontrollera dokumenterade riktmärken och samla in referenser från kunder med datamängder som liknar dina.
Är öppna tabellformat som Delta Lake eller Apache Iceberg viktiga?
Ja, öppna tabellformat är viktiga om du vill ha ACID-transaktioner, versionshantering och leverantörsoberoende datahantering. De gör det möjligt att aktivera funktioner som tidsresor och datadelning utan kopiering. Om du siktar på en datasjöhusmodell eller vill framtidssäkra din arkitektur bör du kräva kompatibilitet med öppna format i ditt verktyg för datasjöar.