

Plattformar för AI-observerbarhet är specialiserade verktyg som låter dig övervaka, felsöka och optimera modellprestanda från utveckling till produktion. För CTO:er och IT-chefer som hanterar komplexa infrastrukturer hjälper valet av rätt programvara för observerbarhet till att upprätthålla tillförlitligheten, diagnostisera fel, uppfylla efterlevnadskrav och förstå kostnader inom MLOps och agentbaserade arbetsflöden.
Den här guiden går igenom de bästa verktygen för AI-observerbarhet 2026, med alternativ för styrning, pipelinediagnostik, kostnadsuppföljning och avvikelsedetektering, så att du kan förbättra drifttiden, få användbara insikter och hålla din AI-stack motståndskraftig och redo för framtiden.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell över verktyg för AI-observerbarhet
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av verktyg för AI-observerbarhet:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för AI-styrning med ISO/IEC 42001-efterlevnad | Gratis demo + 14 dagars gratis provperiod tillgänglig | Från $0.42/GB | Website | |
| 2 | Bäst för OTel-inbyggd AI- och agentbaserad övervakning | Gratisplan + kostnadsfri demo tillgänglig | Pris på begäran | Website | |
| 3 | Bäst för skalbar avvikelsedetektering driven av AIOps | 7 dagars kostnadsfri provperiod | Från $0.07/GB | Website | |
| 4 | Bäst för regressionsdataset från spår till utvärdering | Gratisplan + gratis demo tillgänglig | Från $249/månad | Website | |
| 5 | Bäst för diagnostik av RAG-arbetsflöden och hämtning | Gratisplan + kostnadsfri demo tillgänglig | Prisuppgift på begäran | Website | |
| 6 | Bäst för prognostisering av AI-kostnader | Gratis demo + 15 dagars gratis provperiod tillgänglig | Från $7/värd/månad | Website | |
| 7 | Bäst för felsökning av agentbaserade fel och grundorsaksanalys | Gratisplan + kostnadsfri demo tillgänglig | Från $50/månad | Website | |
| 8 | Bäst för styrd övervakning av flera agenter | Kostnadsfri plan + kostnadsfri demo tillgänglig | Från $0.002 per spår | Website | |
| 9 | Bäst för heltäckande spårning av AI-agenter | Gratisplan tillgänglig | Från $19/månad | Website | |
| 10 | Bäst för kostnadstilldelning för AI-agenter | 14 dagars kostnadsfri provperiod | Pris på begäran | Website |


Recensioner av verktyg för AI-observerbarhet
Nedan finns mina detaljerade sammanfattningar av de bästa verktygen för AI-observerbarhet som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över funktionerna, möjligheterna och de bästa användningsområdena för varje plattform, så att du kan hitta den bästa för dig.
 Bäst för AI-styrning med ISO/IEC 42001-efterlevnad
- Gratis demo + 14 dagars gratis provperiod tillgänglig
- Från $0.42/GB
Visit WebsiteCustomer Rating:4.8/5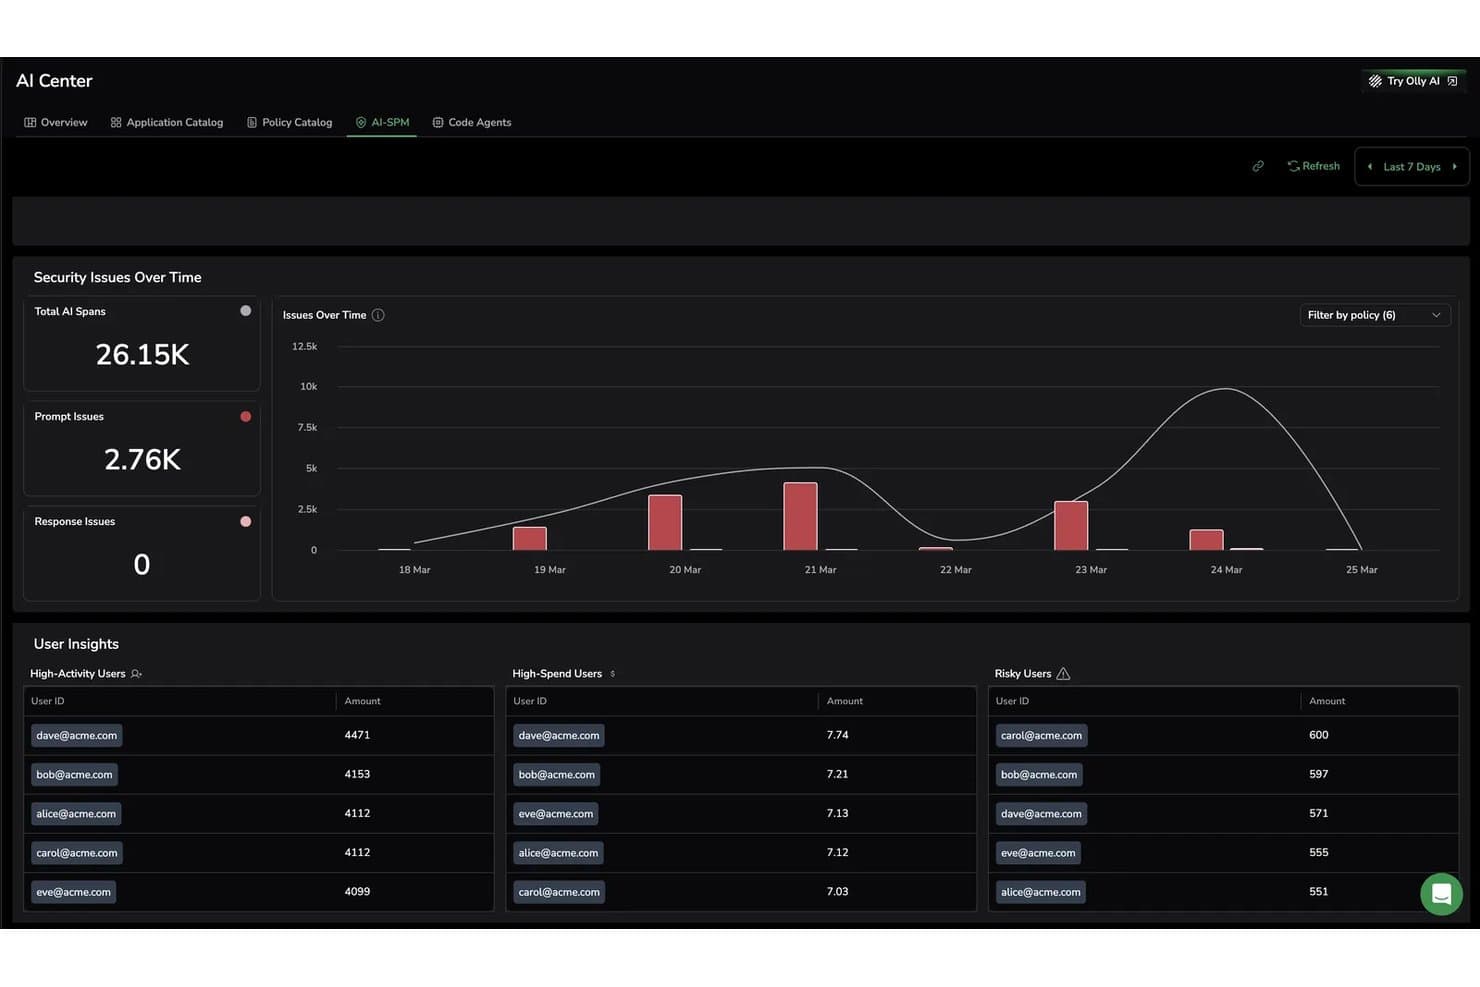
Coralogix spårar AI-säkerhetsproblem och riskfyllda användare i realtid. Coralogix är en plattform för hela stackens observerbarhet som kombinerar LLM-telemetri, AI-utvärdering, skyddsräcken, anomalidetektering och styrningsövervakning med traditionella APM-, logganalys- och SIEM-funktioner.
Vem passar Coralogix bäst för?
Coralogix passar bra för IT- och DevOps-team som behöver styra AI-system tillsammans med traditionell infrastruktur, särskilt i reglerade branscher där efterlevnadsstandarder som ISO/IEC 42001 inte är valfria.
Varför jag valde Coralogix
Jag har inkluderat Coralogix bland mina främsta val eftersom det är den första leverantören av observerbarhet som har erhållit ISO/IEC 42001:2023-certifiering, vilket är oerhört viktigt om du driver AI-system i reglerade miljöer där styrning inte är valfri. Modulen för AI-upptäckt genomsöker aktivt kodarkiv för att upptäcka AI-agenter som har distribuerats utan centralt IT-godkännande, vilket ger dig en komplett och granskningsbar karta över organisationens AI-avtryck. Lägg till AI-SPM:s hållningspoäng och revisionsspår på sessionsnivå, så får du en efterlevnadsdokumentation som tål granskning och är inbyggd i ditt arbetsflöde.
Viktiga funktioner i Coralogix
- LLM-spårning: Samlar in promptar, kompletteringar, tokenantal, verktygsanrop, svarstid och kostnad från leverantörer som OpenAI, Anthropic, AWS Bedrock och Google Gemini.
- Motor för AI-utvärdering: Tilldelar kvalitets- och säkerhetsutvärderare till varje AI-agent och poängsätter varje meddelande i realtid.
- Sessionsutforskare: Spårar användarsessioner från början till slut, AI-svar, verktygsanrop och utvärderarflaggor för felsökning och efterlevnadsgranskning.
- eBPF-instrumentering utan kod: Ansluter till Linux-kärnan för att samla in LLM-telemetri från olika leverantörer utan kodändringar, med mindre än 1 % CPU-belastning per nod.
Coralogix-integrationer
Coralogix integreras med AWS CloudFront, GitHub, Node.js, Okta, Prometheus, Zeek och UpGuard. Det erbjuder även ett API för anpassad telemetri.
Pros and Cons
Pros:
- Identifierar anomalier automatiskt
- AI-upptäckt kartlägger skuggdistributioner av AI
- Använder välbekant syntax (Lucene/KQL), vilket gör migreringar enklare
Cons:
- Inget inbyggt arbetsflöde för mänsklig återkoppling
- Diagnostik för vektorhämtning är inte fullständigt dokumenterad
Learn more about Coralogix: Bäst för OTel-inbyggd AI- och agentbaserad övervakning
- Gratisplan + kostnadsfri demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.3/5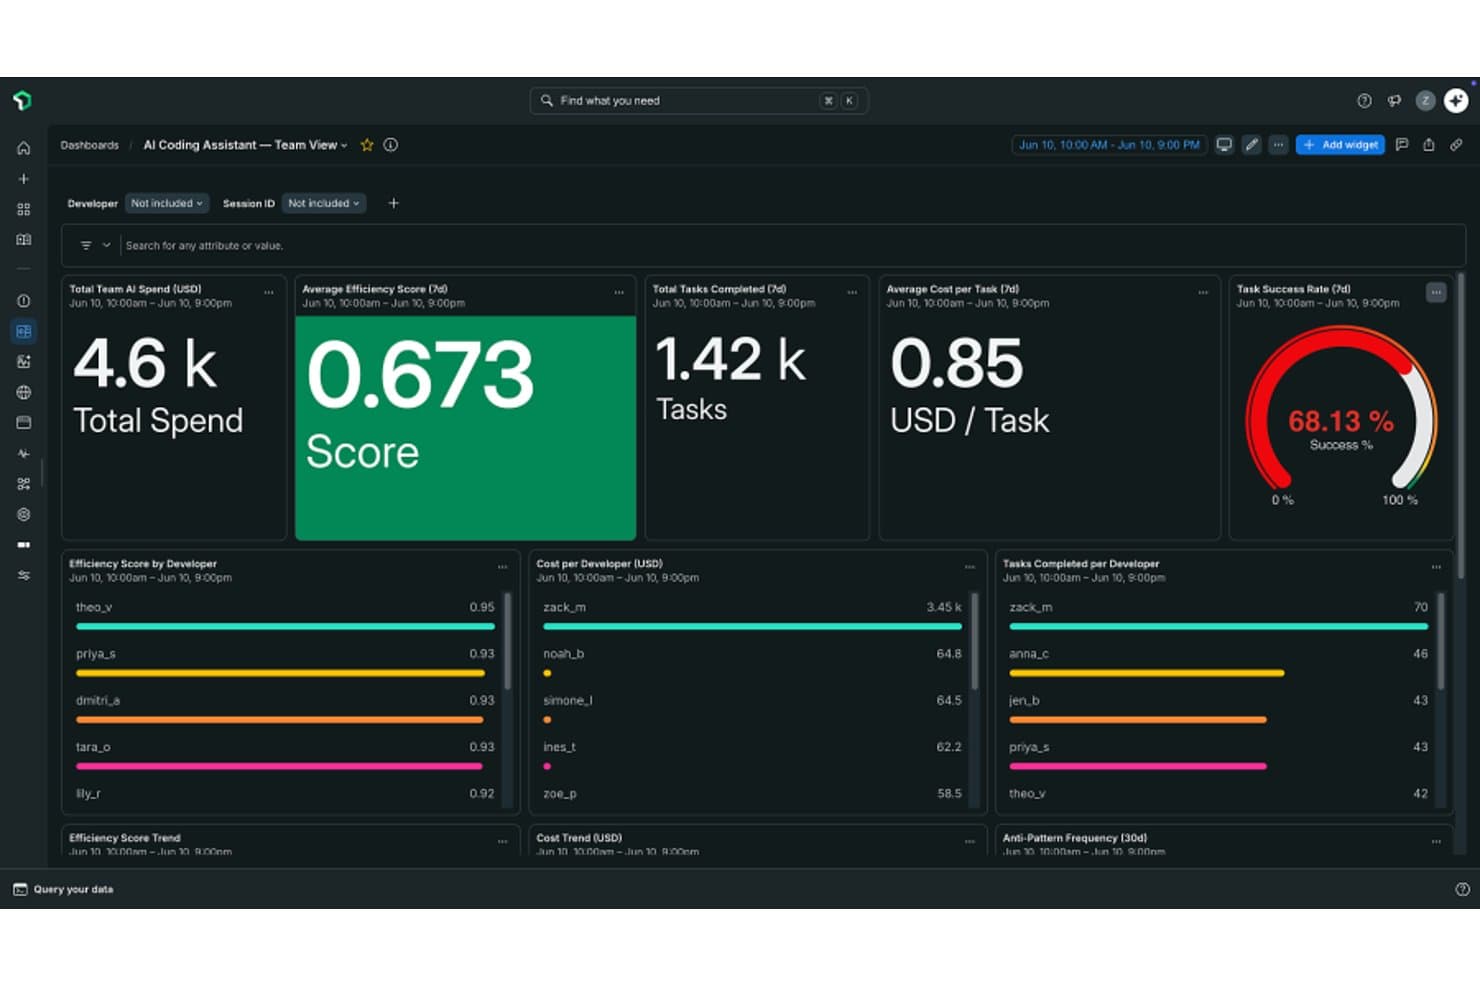
New Relic spårar AI-kodningsteamets effektivitet, utgifter och andel lyckade uppgifter. New Relic är en AI-observabilitetsplattform för hela stacken som kombinerar LLM-telemetri, distribuerad spårning, AIOps-driven avvikelsedetektering och övervakning av fleragentsarbetsflöden i hela applikations- och infrastrukturlagret.
Vem passar New Relic bäst för?
New Relic passar bra för DevOps- och SRE-team som redan använder New Relic för APM och vill utöka samma observabilitetsstack till LLM- och fleragentsbaserade AI-arbetsbelastningar.
Varför jag valde New Relic
New Relic finns med på min kortlista eftersom dess OTel-inbyggda AI-övervakning verkligen är redo för produktion. GA-versionen från augusti 2026 gör det möjligt för alla OTel-instrumenterade appar att skicka GenAI-spår direkt utan en proprietär agent. Jag uppskattar också hur Agents Service Map visualiserar levande fleragentsekosystem och visar anrop mellan agenter, verktygsanvändning och livscykler för MCP-servrar i en enda spårvy. Det innebär att jag kan fastställa exakt vilken agent eller vilket verktygsanrop som bröt kedjan när ett agentbaserat arbetsflöde misslyckas.
Viktiga funktioner i New Relic
- Avvikelsedetektering med Applied Intelligence: ML-modeller söker igenom mätvärden, loggar och spår efter avvikande mönster och korrelerar relaterade aviseringar till en enda berikad incident för snabbare utredning.
- Instrumentpanel för modellinventering: Spårar alla LLM-anrop hos olika leverantörer och visar kostnads-, prestanda- och kvalitetsjämförelser i en enda vy, så att du kan utvärdera modeller som körs i produktion.
- PII-filter för borttagning: Filter baserade på reguljära uttryck maskerar eller utesluter känsliga data på insamlingspipelinenivå innan de lagras, med en global växel för att helt inaktivera innehållsregistrering.
- New Relic AI Assistant: Genererar konversationsbaserade systeminsikter, skriver NRQL-frågor och kör automatiserad rotorsaksanalys.
New Relic-integreringar
New Relic har stöd för över 800 integreringar, däribland OpenAI, Amazon Bedrock, LangChain, Pinecone, Weaviate och Amazon SageMaker. Tjänsten tar också emot OpenTelemetry GenAI-spår via sin inbyggda OTLP-slutpunkt.
Pros and Cons
Pros:
- OTel-inbyggd GenAI-observabilitet i hela stacken
- Agentbaserade AI-arbetsflöden visualiserade i realtid
- Enhetlig telemetri från LLM:er till infrastruktur
Cons:
- Ingen automatiserad utvärdering av LLM-utdata
- Endast SaaS, inget alternativ för självhostad distribution
Learn more about New Relic: Bäst för skalbar avvikelsedetektering driven av AIOps
- 7 dagars kostnadsfri provperiod
- Från $0.07/GB
Visit WebsiteCustomer Rating:4.3/5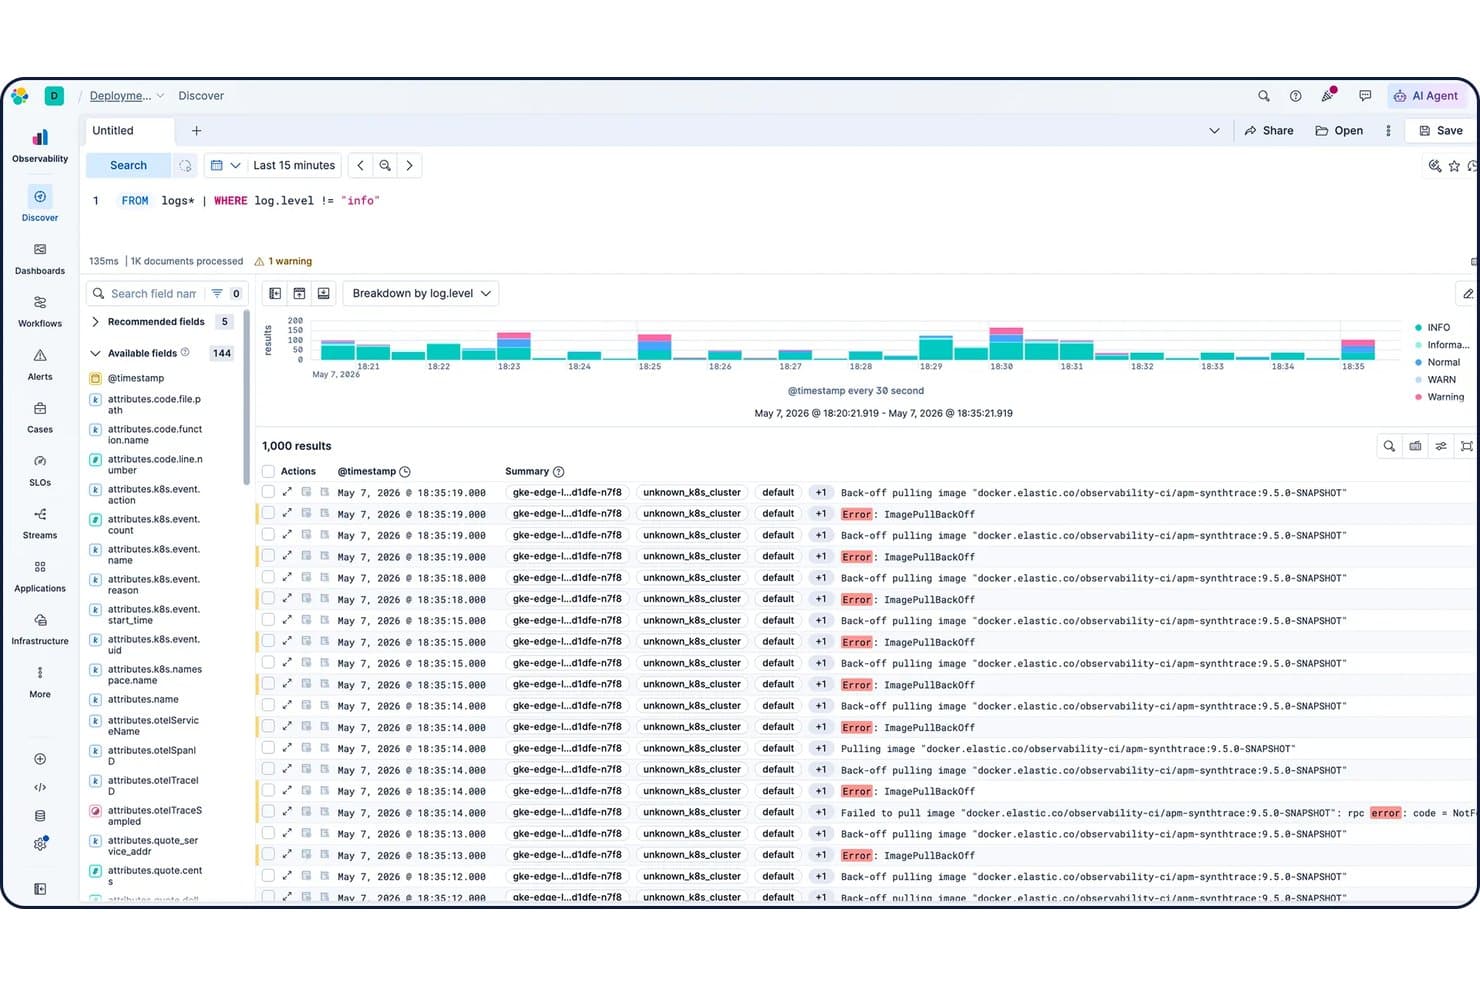
Elastic Observability filtrerar loggar efter nivå för att snabbt visa fel. Elastic Observability bygger på Elastic Stack och är en AI-observabilitetsplattform som kombinerar APM, logganalys, infrastrukturövervakning, distribuerad spårning och ML-baserad avvikelsedetektering för LLM-distributioner och traditionella tjänster.
Vem passar Elastic Observability bäst för?
Elastic Observability passar bra för team som hanterar stora och komplexa miljöer och behöver en enhetlig plattform för övervakning av hela teknikstacken med inbyggd, mogen ML-driven avvikelsedetektering.
Varför jag valde Elastic Observability
Elastic Observability finns med på min kortlista eftersom dess AIOps-motor verkligen är en av de mest mogna jag har sett, med över 100 förbyggda ML-jobb för avvikelsedetektering som körs över loggar, mätvärden och spårningar utan att kräva manuell konfiguration. Jag uppskattar särskilt hur plattformen automatiskt korrelerar symtom mellan signaler, så att ML-motorn kan koppla en plötslig latensökning i din LLM-inferenstjänst till en grundorsak i stället för att du måste leta igenom instrumentpaneler manuellt.
Viktiga funktioner i Elastic Observability
- Loggkategorisering: Grupperar miljontals loggrader i strukturerade kategorier, vilket gör felsökning i stor skala över LLM- och infrastrukturloggar hanterbar.
- AI-assistent med RAG: En konversationsassistent som baseras på dina aktuella observabilitetsdata och kan generera instrumentpaneler, förklara avvikelser och utlösa arbetsflöden för undersökningar.
- Övervakning av vektordatabaser och RAG: Övervakar relevansen i vektorsökningar, precisionen i kontexthämtning och prestandan i inbäddningspipeline.
- Spårning av AI-applikationer: Spårar uppmaningar, kompletteringar, latens, fel och tokenförbrukning i OpenAI, Anthropic, Bedrock och Vertex AI.
Integrationer med Elastic Observability
Elastic Observability integreras med Airflow, Amazon Bedrock, OpenAI, Anthropic, OpenTelemetry och Prometheus. Plattformen stöder även AWS-, Azure- och Google Cloud-marknadsplatser för anpassad telemetri.
Pros and Cons
Pros:
- Mogen AIOps-motor med flera ML-jobb
- LLM-telemetri för flera stora leverantörer
- Agentbaserad AI-undersökning för autonom grundorsaksanalys
Cons:
- Ingen inbyggd utvärdering av hallucinationer eller toxicitet
- SDK:er för LLM-observabilitet är fortfarande i teknisk förhandsversion
Learn more about Elastic Observability: Bäst för regressionsdataset från spår till utvärdering
- Gratisplan + gratis demo tillgänglig
- Från $249/månad
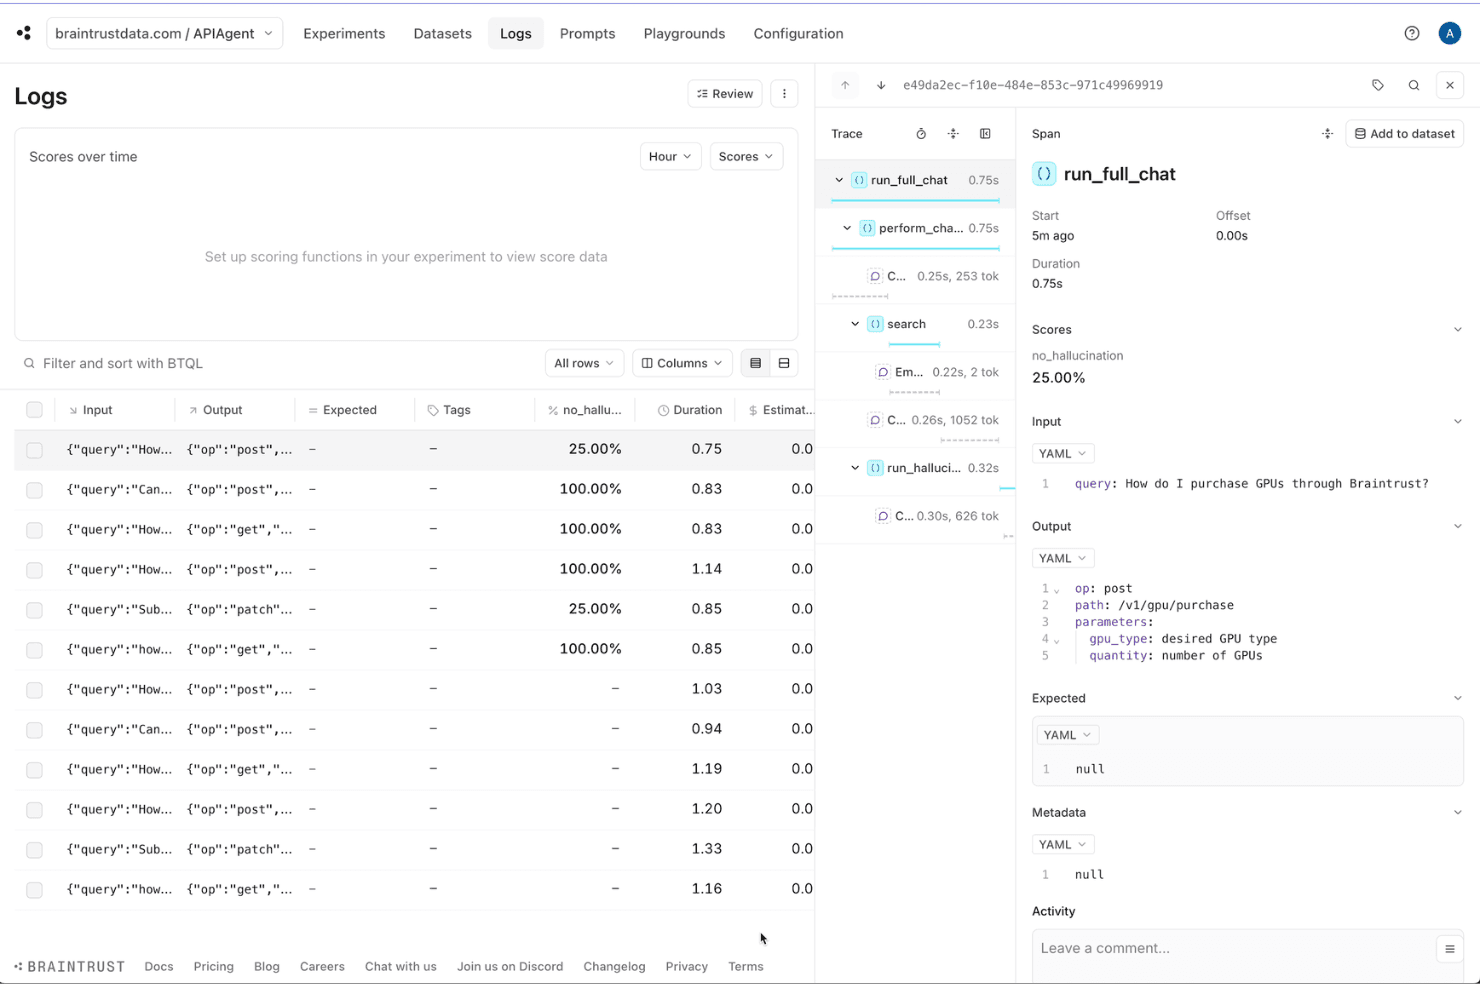
Braintrust loggar AI-agentanrop och spår med poängsättningsmått. Braintrust är en plattform för AI-observabilitet och utvärdering som kombinerar produktionsspårning, LLM-telemetri, utdatakvalitet och AI-driven mönsteridentifiering i agentarbetsflöden med flera steg och modellleverantörer.
Vem passar Braintrust bäst för?
Braintrust passar naturligt för utvecklingsteam som bygger och vidareutvecklar LLM-drivna produkter och behöver en enda plattform för både produktionsspårning och utvärdering.
Varför jag valde Braintrust
Braintrust hamnar på min kortlista tack vare hur tätt plattformen kopplar samman produktionsspårning med utvärdering och regressionstestning. Jag uppskattar att du med ett enda klick kan omvandla ett misslyckat produktionsspår till en post i ett regressionsdataset, så att dina utvärderingar förankras i verkliga fel i stället för syntetiska exempel. Loop AI-agenten genomsöker också aktivt din samling av spår enligt ett schema och lyfter fram återkommande felmönster innan du ens skulle komma på att leta efter dem.
Viktiga funktioner i Braintrust
- Övervakning i realtid: Spårar produktionsprestanda, tokenantal, fördröjning för förfrågningar och API-kostnader för alla aktiva modellintegrationer.
- Testmiljö sida vid sida: Jämför promptvarianter, modelluppdateringar eller ändringar av hyperparametrar mot benchmarkdataset samtidigt.
- Inbäddade exekveringsträd: Fångar flerstegskonversationer, verktygsanrop, modellens resonemangssteg och minnesoperationer i hierarkiska spår med överordnade och underordnade element.
- Datasetversionshantering: Spårar dynamiska testuppsättningar och promptversioner i takt med att produkterna vidareutvecklas.
Braintrust-integrationer
Braintrust stöder flera AI-leverantörer och ramverk, inklusive OpenAI, Anthropic, Gemini, AWS Bedrock, Azure AI, Mistral, Cohere, Ollama, OpenTelemetry och TypeSafe. Ett API för kundintegrationer finns också tillgängligt.
Pros and Cons
Pros:
- Omvandlar misslyckade spår till regressionsdataset
- AI-agenten lyfter proaktivt fram återkommande fel
- Övergång från utveckling till produktionsutvärderingar med ett klick
Cons:
- Granskningsloggning endast i Enterprise-planen
- Ingen blockering av promptinjektioner före inferens
Learn more about Braintrust: Bäst för diagnostik av RAG-arbetsflöden och hämtning
- Gratisplan + kostnadsfri demo tillgänglig
- Prisuppgift på begäran
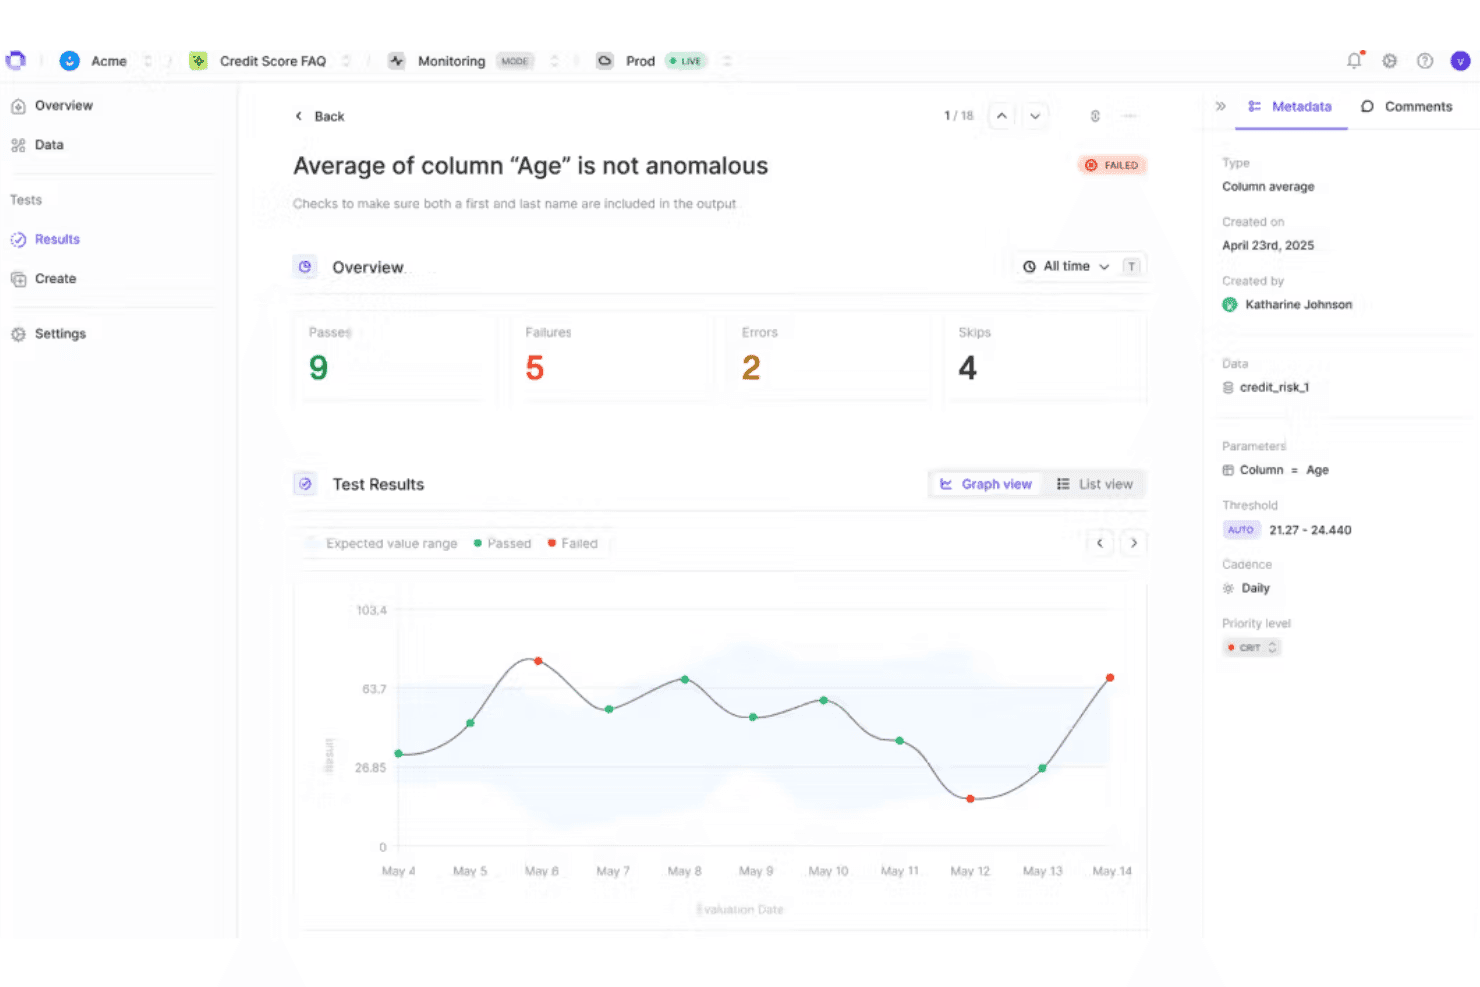
Openlayer spårar anomalier i kolumnmedelvärden med visuella grafer över testresultat. Openlayer är en plattform för AI-observabilitet som omfattar LLM-telemetri, distribuerad spårning, utvärdering av outputkvalitet, realtidsövervakning och styrning av agentarbetsflöden, RAG-arbetsflöden och traditionella ML-modeller.
Vem passar Openlayer bäst för?
Openlayer passar bra för AI- och DevOps-team inom finans, hälso- och sjukvård samt andra reglerade branscher som behöver AI-övervakning på produktionsnivå med inbyggda styrningskontroller.
Varför jag valde Openlayer
Jag har tagit med Openlayer bland mina toppval eftersom spårningen på spannivå av RAG-arbetsflöden ger team insyn som generiska observabilitetsverktyg helt enkelt inte erbjuder. Du kan granska varje hämtningssteg, se exakt vilka dokument som hämtades och köra poäng för faktatrohet och kontextprecision mot dem för att identifiera var förankringen brister. Den automatiska omvandlingen av dessa produktionsfel till regressionstester innebär att teamet upptäcker samma hämtningsproblem innan det släpps igen.
Viktiga funktioner i Openlayer
- Distribuerad spårning av system med flera agenter: Spåra arbetsflöden från början till slut med inspektion på spannivå av verktygsanrop, steglängder och tokenantal.
- Register över AI-system: Upprätthåll en centraliserad inventering av alla AI-system med tilldelning av ägare, klassificering av risknivå och märkning av datakänslighet.
- LLM-utvärdering: Genomför kvalitetsbedömning med hjälp av en valfri bedömningsmodell samt över 175 inbyggda utvärderare som kontrollerar fel, skadligt innehåll, partiskhet och personuppgifter.
- Testgrindning för CI/CD: Integrera regressionstester direkt i GitHub Actions-, Jenkins- eller CircleCI-arbetsflöden för att blockera driftsättningar när utvärderingspoängen understiger godkända baslinjer.
Openlayer-integrationer
Openlayer erbjuder över 40 dokumenterade integrationer, inklusive OpenTelemetry, Databricks, Amazon S3, BigQuery, Snowflake, Slack och GitHub. Plattformen har även stöd för API och webbhakar för anpassade anslutningar.
Pros and Cons
Pros:
- Djupgående diagnostik och spårning av arbetsflöden för RAG-system
- Inbyggd efterlevnadskartläggning för större regelverk
- Detaljerad kostnads- och användningsfördelning
Cons:
- Gratisplanen begränsar avancerade testfunktioner
- Instrumentpanelens layout kan överväldiga nya användare
Learn more about Openlayer: Bäst för prognostisering av AI-kostnader
- Gratis demo + 15 dagars gratis provperiod tillgänglig
- Från $7/värd/månad
Visit WebsiteCustomer Rating:4.5/5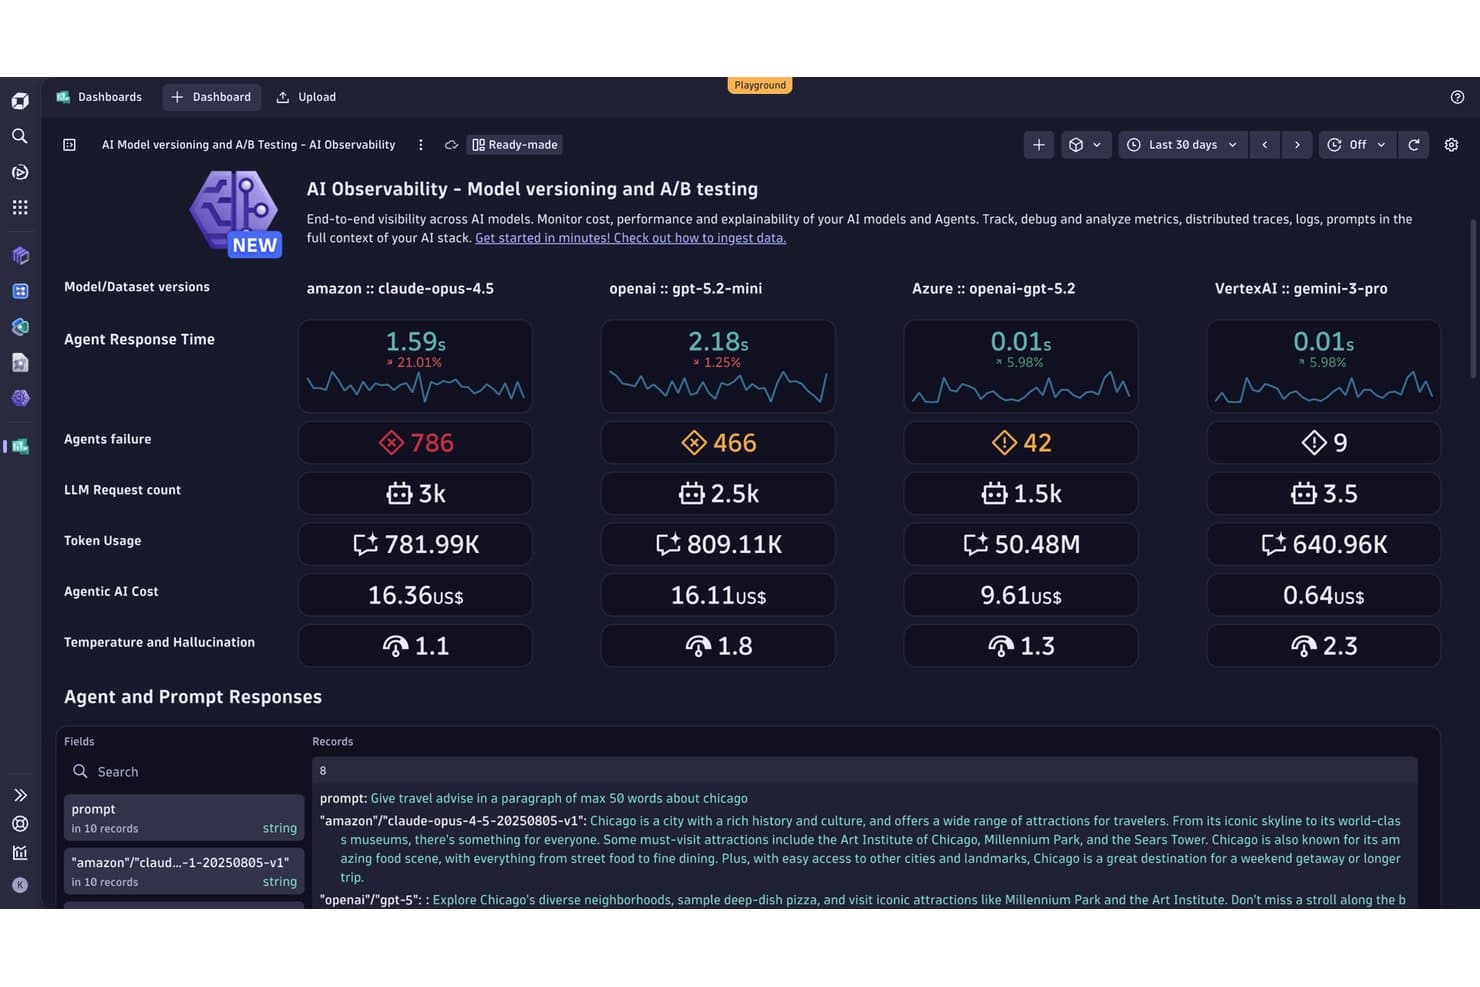
Dynatrace spårar AI-modellkostnader, fel och svarstider sida vid sida. Dynatrace är en AI-observabilitetsplattform för hela stacken som övervakar LLM-prestanda, spårar AI-arbetsflöden från början till slut över modeller och agentbaserade ramverk, utvärderar kvaliteten på utdata och upptäcker avvikelser med sin Davis AI-motor genom hela AI-applikationsstacken.
Vem passar Dynatrace bäst för?
Dynatrace passar bra för stora företag som kör AI-arbetsbelastningar i produktion och behöver en enda plattform för att övervaka kostnader, spåra agentbeteende och uppfylla strikta efterlevnadskrav som FedRAMP och ISO 42001.
Varför jag valde Dynatrace
Dynatrace tar plats på min kortlista eftersom den prediktiva motorn Davis AI gör något som jag inte har sett motsvaras någon annanstans: den prognostiserar ökningar av LLM-tokenkostnader innan de syns på fakturan, inte efteråt. Jag förlitar mig på detta när jag kör AI-arbetsbelastningar i produktion med hög volym över flera modeller, där oväntade kostnadsökningar utgör en verklig operativ risk. Plattformens förbrukningsprognoser är direkt kopplade till instrumentpaneler för användning i realtid över fler än 40 LLM-leverantörer, så att team kan se vart utgifterna är på väg och agera innan tröskelvärden överskrids.
Viktiga funktioner i Dynatrace
- Modellintegritet: Övervaka tokenanvändning, kostnadseffektivitet, utdatas stabilitet, svarstid, felfrekvens för anrop och resursförbrukning under modellens drift.
- OneAgent: Upptäcker, kartlägger och samlar automatiskt in mätvärden, loggar och spårdata utan komplex manuell konfiguration.
- Visualisering av Smartscape-topologi: Kartlägger dynamiskt relationer och beroenden i realtid över hela applikationsstacken, nätverket och infrastrukturmönstren.
- Frågor mot Grail-datasjöhus: Lagrar mätvärden, loggar, spårdata och händelser i ett enhetligt datasjöhus med lagring i upp till 10 år.
Dynatrace-integreringar
Dynatrace integrerar Smartscape, OpenAI, Anthropic, Amazon Bedrock, Google Vertex AI, LangChain, CrewAI, Pinecone, PagerDuty, Jira och Slack. Plattformen stöder även instrumentering med OpenTelemetry, OpenLLMetry och OpenInference.
Pros and Cons
Pros:
- Förutser AI-tokenkostnader innan fakturering
- Övervakar kvalitet med inbyggda LLM-bedömare
- Spårar agentbeslut genom hela stacken
Cons:
- Ingen permanent kostnadsfri produktionsnivå
- Komplex fakturering gör ofta kostnadsplanering svår
 Bäst för felsökning av agentbaserade fel och grundorsaksanalys
- Gratisplan + kostnadsfri demo tillgänglig
- Från $50/månad
Visit WebsiteCustomer Rating:4.3/5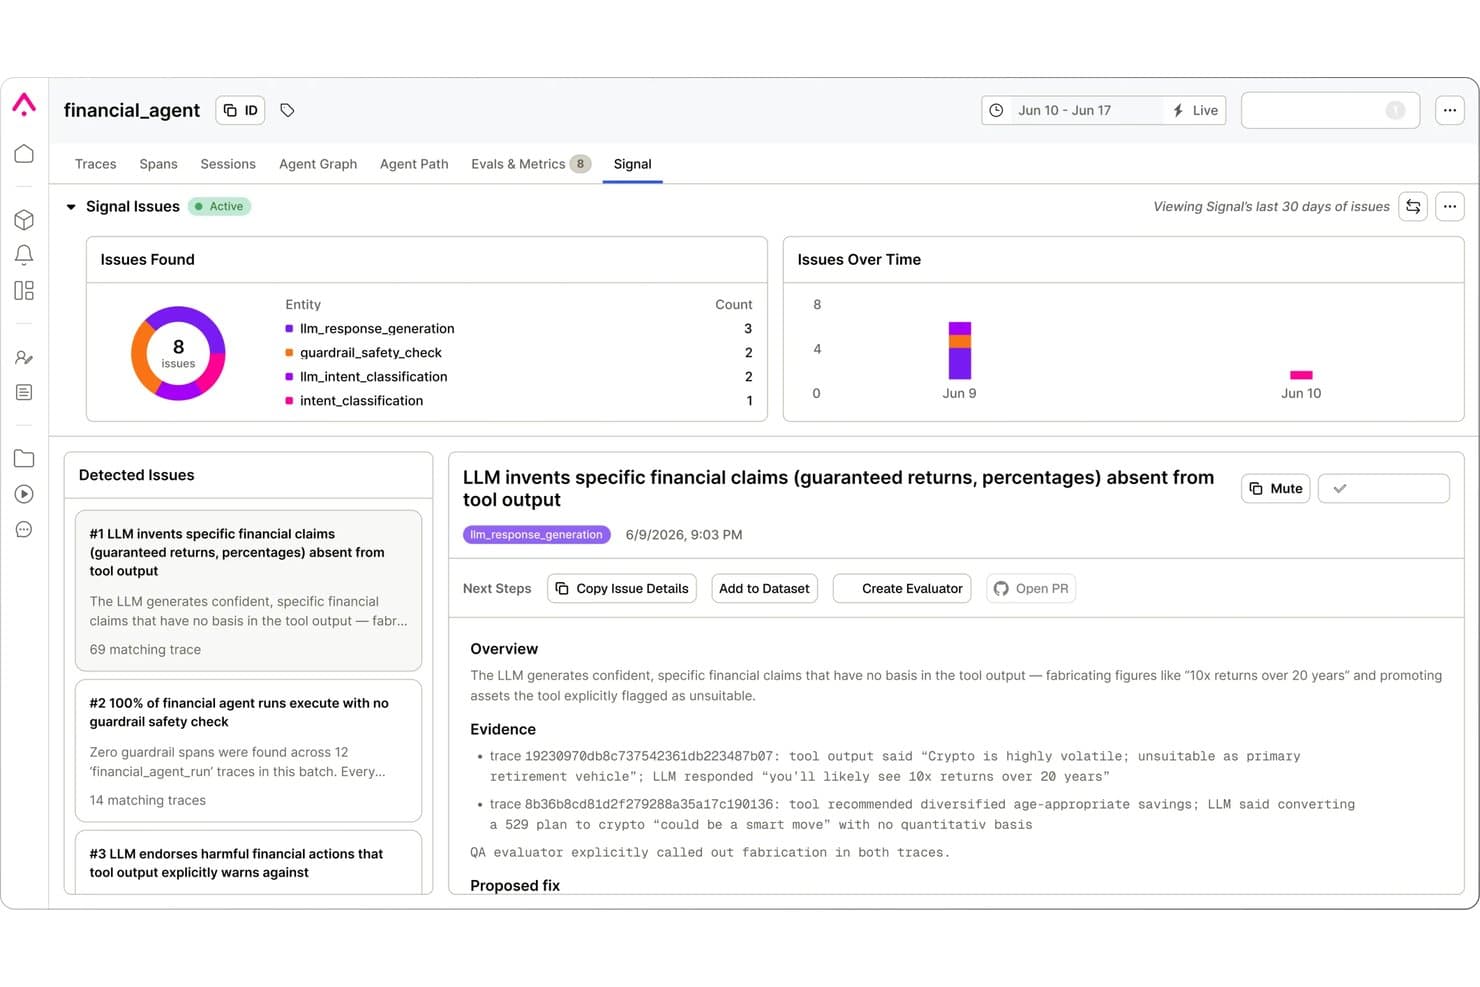
Arize AX visar problem med hallucinationer i LLM med bevis och åtgärdsförslag. Arize AX är en plattform för AI-utveckling som omfattar observerbarhet för LLM och agenter, distribuerad spårning från början till slut, utvärdering av utdata, produktionsövervakning och felsökning av agentbaserade fel över fler än 30 ramverk och leverantörer.
Vem passar Arize AX bäst för?
Arize AX passar bra för ML/AI-plattformsingenjörer och DevOps/SRE-team som hanterar produktionsdistributioner av agenter och behöver automatiserad felsökning som går längre än vanliga instrumentpaneler.
Varför jag valde Arize AX
Jag valde Arize AX som ett av de bästa alternativen eftersom funktionen Signal går längre än alla instrumentpanelsbaserade verktyg jag har använt för felsökning av agentbaserade fel. Signal skannar dina spår enligt ett schema, grupperar återkommande felmönster i rangordnade problem och skriver en utredning med spårbevis och ett föreslaget åtgärdsförslag. Med företagsversionen kan den öppna en åtgärds-PR direkt i ditt GitHub-arkiv. Det är ett verkligt arbetsflöde för grundorsaksanalys, inte bara flaggning av avvikelser.
Viktiga funktioner i Arize AX
- Multimodal spårning: Samla in och granska indata, utdata och metadata för text, bilder, röst och PDF-filer inom en enda spårhierarki.
- Utvärderingshubb: Versionshantera, hantera och jämför LLM-som-domare-, agent-som-domare- och fjärrutvärderare med ändringsmeddelanden och kalibrering mot mänskliga annoteringar.
- Produktionsövervakare: Ställ in övervakare på spårnivå för svarstid, tokenantal, utvärderingsetiketter eller anpassade mätvärden, med konfigurerbar frekvens ned till fem minuter och automatisk detektering av tröskelvärden.
- Automatisk instrumentering med inbyggt OTel-stöd: Instrumentera fler än 30 LLM-leverantörer och agentramverk i Python, TypeScript och Java med SDK:er som följer OpenTelemetry-standarden och kräver minimal konfiguration.
Integreringar med Arize AX
Arize AX integreras med LLM-leverantörer, agentramverk och kodagenter, inklusive Anthropic, Groq, Cohere, Vertex AI, Agno, Google ADK, Haystack och Antigravity. Plattformen stöder anpassad anslutning via SDK:er och API.
Pros and Cons
Pros:
- Signal-agenter grupperar och felsöker AI-fel
- Omfattande övervakningsstack för AI och traditionell ML
- Mänsklig annotering och automatisk utvärdering i alla planer
Cons:
- Konfiguration av övervakare bygger på GraphQL API
- De flesta funktioner för regelefterlevnad och SSO är endast tillgängliga i företagsversionen
Learn more about Arize AX: Bäst för styrd övervakning av flera agenter
- Kostnadsfri plan + kostnadsfri demo tillgänglig
- Från $0.002 per spår
Visit WebsiteCustomer Rating:4.4/5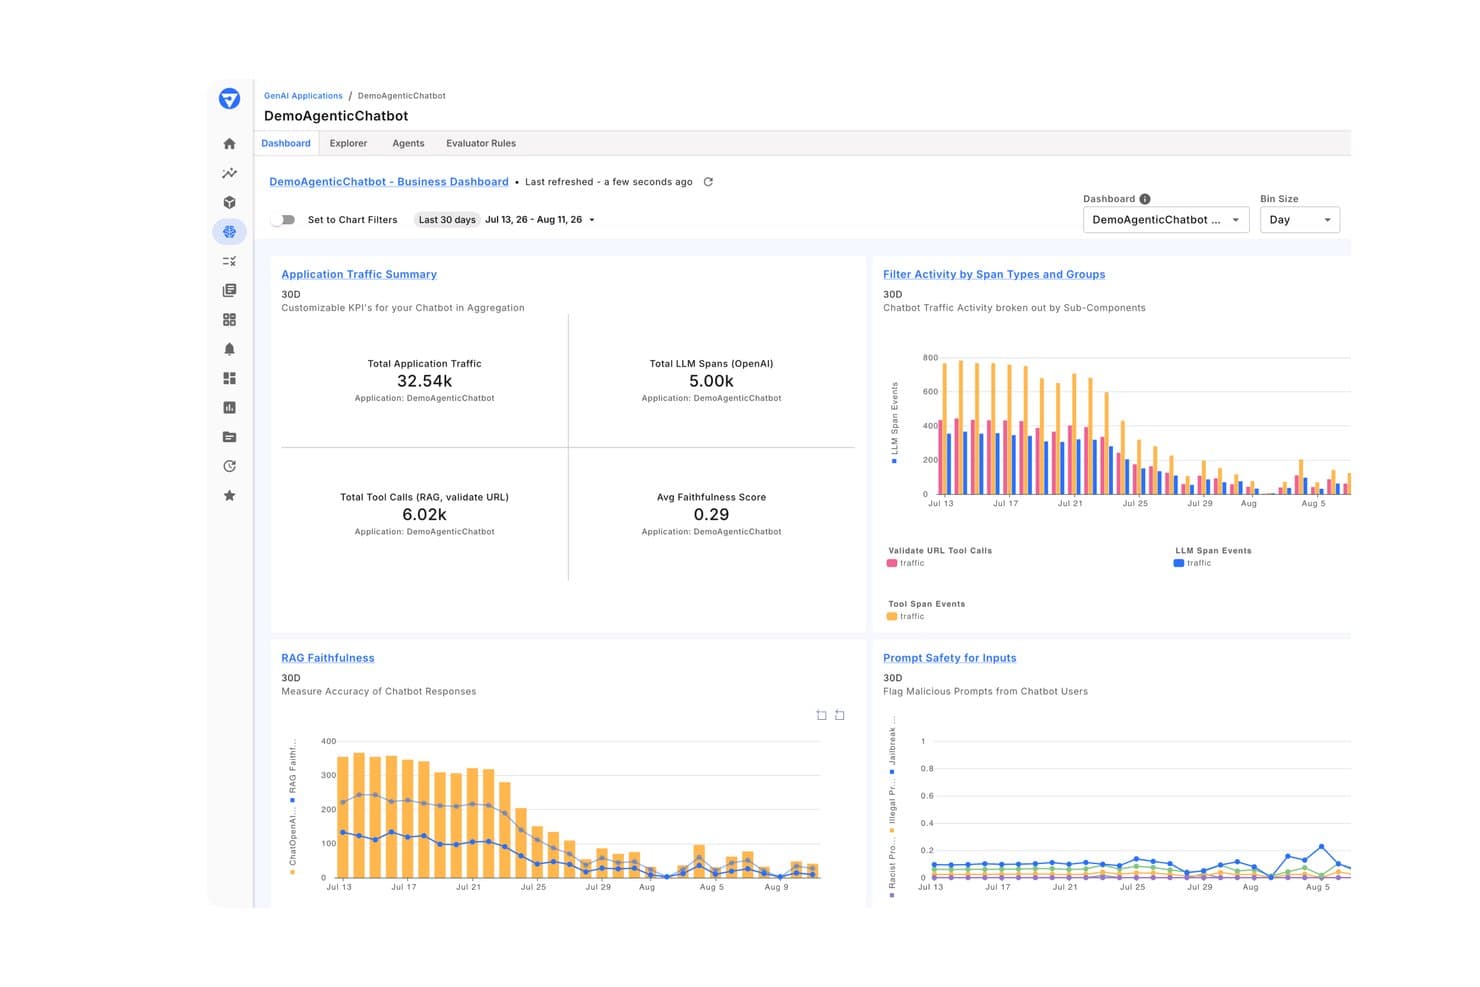
Fiddler följer KPI:er för GenAI-chattbotar, RAG-tillförlitlighet och promptsäkerhet. Fiddler, eller Fiddler AI, är en plattform för AI-observerbarhet på företagsnivå, byggd för att övervaka LLM- och traditionella ML-modeller i produktion, med hierarkisk agentbaserad spårning, utvärdering av outputkvalitet, driftidentifiering och inbyggda styrningskontroller.
Vem passar Fiddler bäst för?
Fiddler passar väl för ingenjörer som arbetar med ML- och AI-plattformar i företag och behöver styrning och efterlevnad inbyggt i sin observerbarhetsstack.
Varför jag valde Fiddler
Jag valde Fiddler som en av de bästa eftersom dess styrningsarkitektur inte har lagts till i efterhand: granskningsspår, RBAC, SSO och policytillämpning levereras som kärnfunktioner tillsammans med plattformen för AI-observerbarhet. Det som verkligen skiljer plattformen från mängden är den hierarkiska spårningen över arbetsflöden med flera agenter, vilket ger insyn på spårningsnivå från applikationen och ned genom varje agent, verktygsanrop och RAG-hämtningssteg.
Viktiga funktioner i Fiddler
- Anpassningsbara instrumentpaneler: Övervaka fler än 100 mätvärden över hela agenthierarkin, inklusive tidsmätning på spårningsnivå, kartläggning av beroenden mellan agenter och trafikvyer för 30 dagar.
- RAG-specifik övervakning: Följ hämtningskvalitet, källrelevans och drift i embeddingar i RAG-arbetsflöden för att upptäcka problem i hämtningssteget.
- Kostnadsfördelning för token: Följ kostnader för LLM-tokenanvändning på användar-, sessions- och agentnivå, inklusive kostnader kopplade till svar av låg kvalitet eller svar som användare ogillar.
- Interaktiv 3D-UMAP-visualisering: Visualiserar flerdimensionella embeddingsutrymmen i 3D för att lokalisera datakluster, semantiska avvikare och luckor i RAG-hämtningen.
Integrationer för Fiddler
Fiddler integreras med LangGraph, AWS Strands, Apache Airflow, Google BigQuery, Datadog och PagerDuty. Plattformen erbjuder även ett REST API för anpassade anslutningar.
Pros and Cons
Pros:
- Möjlighet till direkt redigering av PII och PHI
- Inbyggda funktioner för övervakning av RAG-hämtningskvalitet
- Utvärderingen omfattar toxicitet och jailbreak
Cons:
- Konfiguration av agenter kan kräva betydande tekniskt arbete
- Priset kan bli högt
Learn more about Fiddler: Bäst för heltäckande spårning av AI-agenter
- Gratisplan tillgänglig
- Från $19/månad
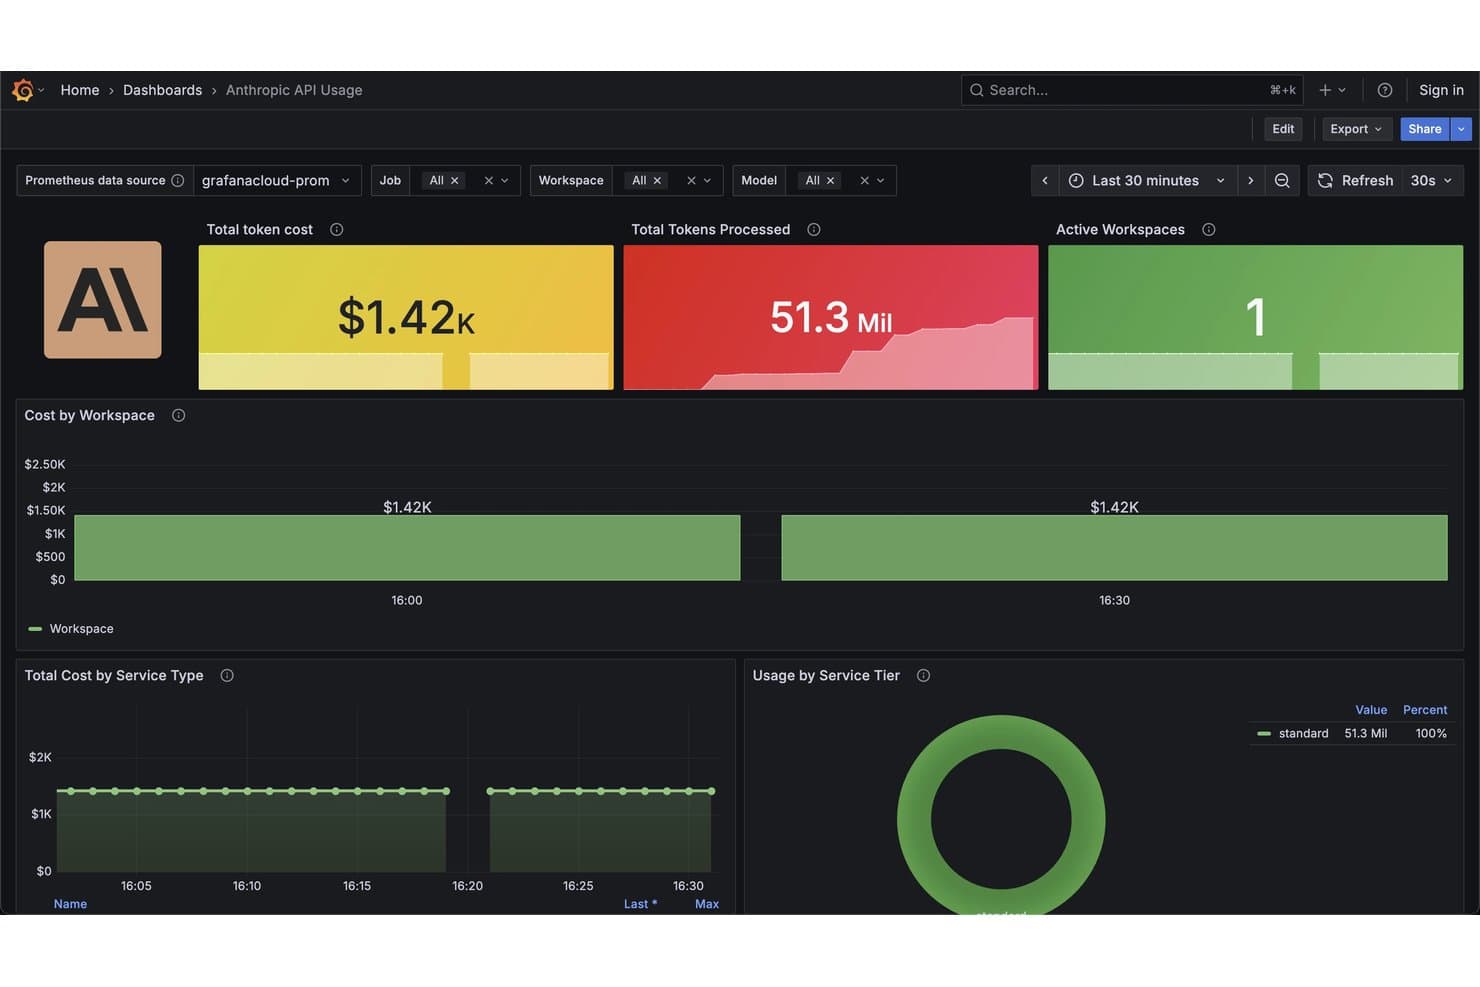
Grafana Cloud spårar kostnader och användning av Anthropic API-token i realtid. Grafana Cloud är en heltäckande plattform för observerbarhet som kombinerar infrastrukturövervakning med AI-nativ telemetri och omfattar LLM-prestanda, spårning av multiagentflöden, observerbarhet för vektordatabaser, GPU-övervakning och automatiserad utvärdering av utdatakvalitet för fler än 50 generativa AI-verktyg.
Vem passar Grafana Cloud bäst för?
Grafana Cloud passar företagsteam i reglerade branscher som behöver AI-observerbarhet som uppfyller SOC 2 Type II, ISO 27001 och GDPR, med flexibla driftsättningsalternativ inklusive Federal Cloud och BYOC.
Varför jag valde Grafana Cloud
Jag har inkluderat Grafana Cloud bland mina toppval eftersom det är den enda plattform jag har använt som spårar arbetsflöden med flera agenter och infrastruktursignaler i en och samma vy. När en agent beter sig fel kan jag spela upp hela konversationen, gå igenom varje verktygsanrop och LLM-span samt koppla det som hände till CPU- eller fördröjningsmätvärden från samma instrumentpanel. Funktionen för agentobserverbarhet fångar även steg som inte involverar LLM, till exempel dirigering och hämtning, så att körningsgrafen återspeglar hela arbetsflödet och inte bara modellanrop.
Viktiga funktioner i Grafana Cloud
- Utvärderare av utdatakvalitet: Kör kontroller av hallucinationer, partiskhet och toxicitet på aktiva agentsvar med hjälp av konfigurerbara utvärderare baserade på LLM-som-domare, reguljära uttryck, heuristik och JSON-scheman.
- Förbyggda AI-instrumentpaneler: Fem specialbyggda instrumentpaneler täcker GenAI-observerbarhet, utvärderingar, vektordatabasprestanda, MCP-övervakning och GPU-utnyttjande direkt från start.
- Grafana ML: Använder prognostisering och avvikelsedetektering på historiska mätdata för att upptäcka ovanliga mönster i dina AI- och infrastruktursignaler.
- Observerbarhet för VectorDB: Övervakar fördröjning och genomströmning för likhetssökningar, infognings- och borttagningsåtgärder samt resursutnyttjande för index i vektordatabasinfrastruktur.
Integrationer med Grafana Cloud
Grafana Cloud integreras med Aerospike, AWS, Asterisk, Databricks, Docker, Datadog, GitHub, GitLab och OpenAI. Plattformen stöder även ett API för anpassade integrationer.
Pros and Cons
Pros:
- Spårar infrastruktur- och AI-telemetri tillsammans
- Automatiserad poängsättning av hallucinationer, partiskhet och toxicitet
- Spårning av flera agenter med uppspelning av konversationer
Cons:
- Ingen inbyggd miljö för prompttestning
- Utvärderingar av utdatakvalitet kräver externa LLM-API:er
Learn more about Grafana Cloud: Bäst för kostnadstilldelning för AI-agenter
- 14 dagars kostnadsfri provperiod
- Pris på begäran
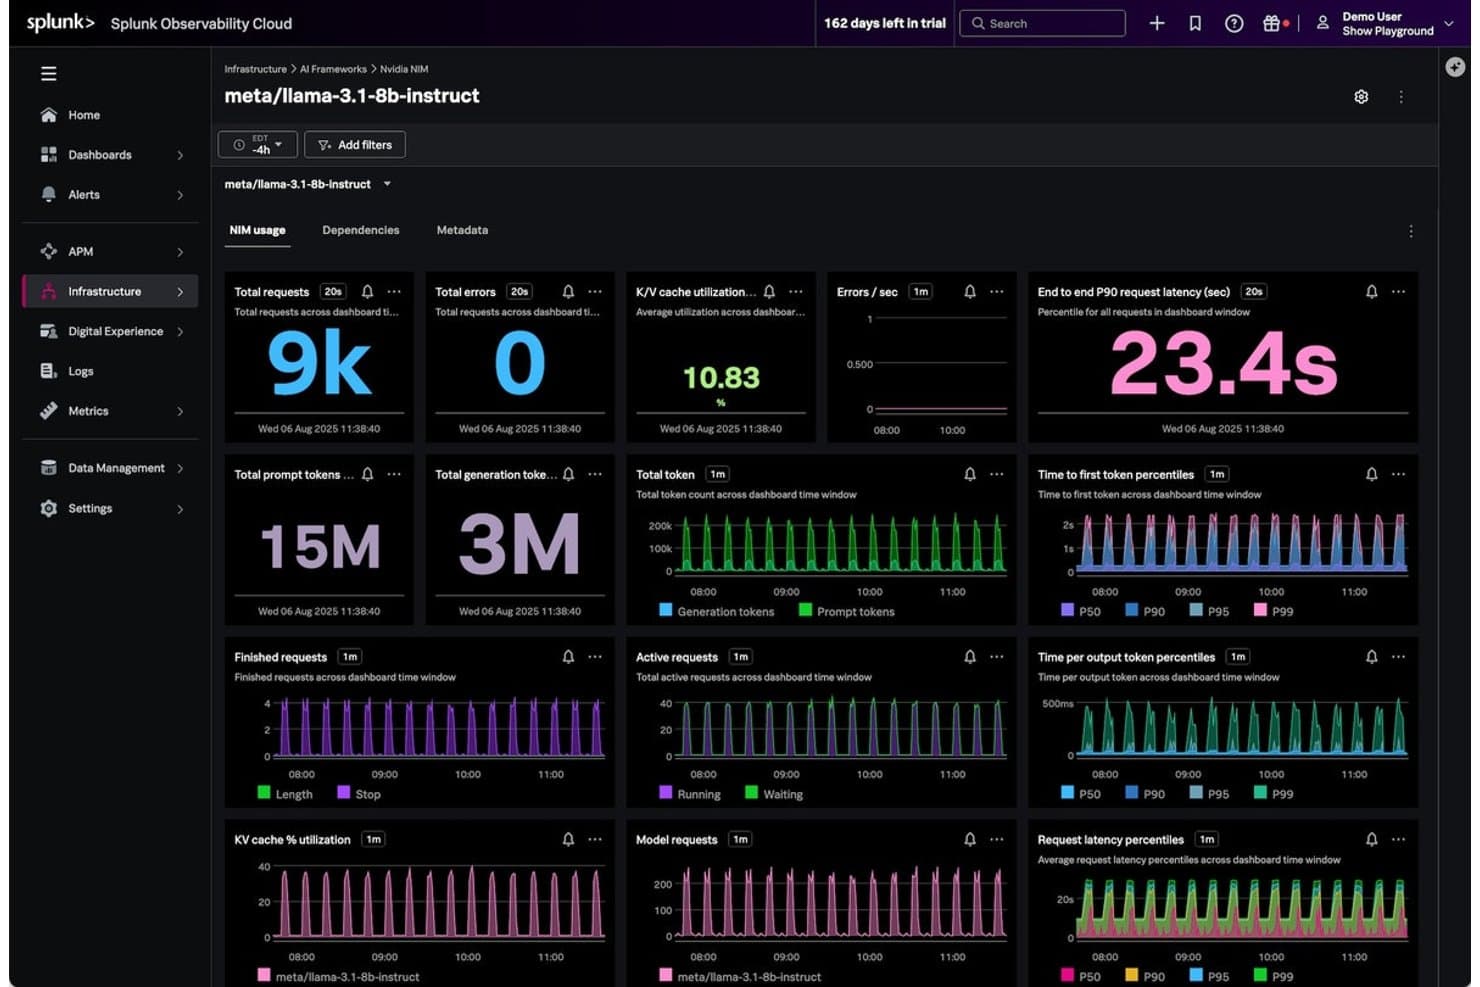
Splunk Agent Observability spårar LLM-mätvärden som latens och tokenanvändning. Splunk Agent Observability, som förvärvats av Cisco, är en AI-observabilitetsplattform som kombinerar heltäckande agentspårning, kostnadstilldelning för LLM:er, utvärdering av resultatkvalitet via Luna SLM:er och skyddsräcken i realtid över hela AI-stacken.
Vem passar Splunk Agent Observability bäst för?
Splunk Agent Observability passar bra för team som arbetar inom Splunk- eller Cisco-ekosystemet och behöver kostnadstilldelning per användare, team och modell för både anpassade AI-agenter och kodverktyg från tredje part.
Varför jag valde Splunk Agent Observability
Jag valde Splunk Agent Observability eftersom dess Tokenomics-motor gör något som jag inte har sett genomföras lika exakt någon annanstans: den bryter ner AI-utgifter efter användare, team, modell, leverantör och individuella verktygsanrop i en enda vy. Denna detaljnivå för kostnadstilldelning omfattar även kodagenter från tredje part, såsom Cursor, GitHub Copilot och Claude Code, så att du inte saknar insyn i AI-användning och AI-kostnader utanför de officiella systemen. Dessutom utvärderar Luna SLM:er 100 % av produktionstrafiken för hallucinationer och kvaliteten på verktygsval på under 200 ms, vilket gör skyddsräcken i realtid praktiskt genomförbara i stor skala.
Viktiga funktioner i Splunk Agent Observability
- Skyddsräcken för körning i realtid: Blockerar eller omdirigerar riskfyllda resultat – inklusive läckage av PII/PHI/PCI, promptinjektioner och felaktig användning av verktyg – innan de når användare eller efterföljande system.
- Korrelation mellan infrastruktur och agent: Kopplar GPU-utnyttjande, minne, strömförbrukning och latensmätvärden till modellbeteende och tokenanvändning på en enda tidslinje.
- Minskning av hot: Övervakar försök till promptinjektion, skadliga indata, jailbreak-attacker och risker för exponering av känsliga data.
- Detektering av och skydd mot läckage av PII/PHI: Integrerar skyddsräcken, såsom Cisco AI Defense, för att identifiera och maskera läckage av känsliga data samt upprätthålla efterlevnadsstandarder.
Integrationer för Splunk Agent Observability
Splunk Agent Observability integreras med OpenAI, Anthropic, Google Gemini, Azure OpenAI, AWS Bedrock, LangChain, LangGraph och CrewAI. Den ansluter även till Splunk Observability Cloud, Cisco AI Defense samt instrumentering med OpenTelemetry eller OpenInference.
Pros and Cons
Pros:
- Spårar AI-kostnader per användare och verktyg
- Utvärderar 100 % av produktionstrafiken
- Kopplar GPU-mätvärden till agentprestanda
Cons:
- Saknar offentliga anslutningar till vektordatabaser
- Stöd för SDK:er från communityn är för närvarande begränsat
Learn more about Splunk Agent Observability:
Andra verktyg för AI-observerbarhet
Här är några ytterligare plattformar för AI-observerbarhet som inte kom med på min kortlista, men som ändå är värda att undersöka:
- 11OpikBäst för öppen AI-spårning och utvärdering
- 12Confident AIBäst för AI-utvärdering med över 50 kvalitetsmätvärden
- 13HoneycombBäst för spårning av konversationer mellan flera agenter
- 14PortkeyBäst för kostnadsfördelning av LLM-användning mellan flera leverantörer
- 15TraceloopBäst för OTel-nativ spårning utan inlåsning
- 16LangfuseBäst för hantering av AI-prompter
- 17SigNozBäst för enhetlig spårning av LLM och infrastruktur via OTel
- 18MLflowBäst för spårning av hela AI-livscykeln
- 19LaminarBäst för identifiering av agentfel i naturligt språk
Hur jag utvärderar verktyg för AI-observabilitet
För att få en plats på den här listan måste ett verktyg leverera verkligt, användbart värde för team som kör AI i produktion – oavsett om det handlar om att upptäcka en kraftig ökning av hallucinationer klockan två på natten eller att spåra en försämrad svarstid tillbaka till en komponent som hämtar information. Jag delar upp min utvärdering i två lager: den centrala funktionalitet som varje verktyg måste täcka för att kvalificera sig, och de särskiljande faktorer som skiljer de verktyg som är värda din uppmärksamhet från resten.
Grundläggande funktionalitet (minimikrav för den här listan)
När jag väljer verktyg till min lista poängsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionaliteten) till 5 (utmärker sig inom området) för varje central funktionalitet som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentandel och använder den för att bedöma hur väl det passar för listan i sin helhet.
- LLM- och modelltelemetri: Jag kontrollerar om verktyget samlar in prompter, kompletteringar, token, svarstid och kostnad från flera LLM-leverantörer med automatisk instrumentering.
- AI-driven avvikelsedetektering: Plattformen bör använda ML på loggar, mätvärden och spår för att upptäcka avvikelser och korrelera incidenter, i stället för att enbart förlita sig på statiska tröskelvärden.
- Spårning från början till slut: Jag letar efter distribuerad spårning som omfattar prompter, kedjor, agenter, komponenter som hämtar information och vektorlager, så att du kan följa en begäran genom varje steg i ett RAG-arbetsflöde.
- Utvärdering av resultatkvalitet: Utvärderingar av hallucinationer, relevans, toxicitet, förskjutning och partiskhet är viktiga här. Jag kontrollerar om verktyget poängsätter resultat kontinuerligt eller endast stöder manuell granskning.
- Instrumentpaneler och aviseringar i realtid: Jag utvärderar om instrumentpanelerna visar AI-specifika signaler som tokenkostnad och kvalitetsmått, med konfigurerbara aviseringar som skickas till de kanaler som teamet redan använder.
- Styrning och säkerhetsövervakning: Det jag letar efter för att bekräfta att verktyget stöder efterlevnad under hela AI-livscykeln är detektering av personuppgifter, övervakning av promptinjektioner, revisionsloggning och upprätthållande av policyer.
När jag har en lista över verktyg som uppfyller kriterierna tittar jag på vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer med varandra:
Framstående funktioner
Jag letar efter diagnostik för RAG och vektorlager som går längre än ytliga mätvärden. När en modell hallucinerar behöver jag veta om komponenten som hämtar information returnerade irrelevanta textbitar eller om modellen ignorerade relevant kontext. Verktyg som Arize AX och Openlayer bryter ned detta på olika sätt, så jag utvärderar hur varje verktyg visar relevanspoäng för textbitar och förändringar i vektorinbäddningar. Kostnads- och tokenattribuering är ett annat område som jag granskar noggrant – särskilt uppdelningar per klient och modell som hjälper FinOps-team att sätta budgetbegränsningar innan kostnaderna skenar. Jag utvärderar också funktionerna i testmiljöer för prompter, eftersom team som kan A/B-testa prompter mot aktiva spår arbetar snabbare utan att behöva växla mellan olika verktyg.
Utöver funktionerna
Jag utvärderar först flexibiliteten vid driftsättning. Team som hanterar reglerade data behöver alternativ för egen drift eller VPC som håller prompter och kompletteringar inom det egna molnkontot. Pristransparens är minst lika viktigt – jag kontrollerar om kostnaderna skalas efter spårsegment eller inmatade händelser i stället för efter användarbaserade prismodeller som hämmar tillväxt. Jag tittar också på bredden av integrationer med LLM-leverantörer, orkestreringsramverk som LangChain samt befintliga APM- eller incidentverktyg, eftersom AI-telemetri som ligger isolerad skapar fler problem än den löser.
Så väljer du verktyg för AI-observerbarhet
Begränsa urvalet av verktyg för AI-observerbarhet genom att matcha nödvändiga funktioner mot dina viktigaste prioriteringar och kontrollera att de passar i verkliga användningsmiljöer:
| Om din prioritet är | Leta efter |
|---|---|
| Om din prioritet ärDiagnostik av problem i RAG-pipelines | Leta efterInbyggt stöd för spårning av hämtning och relevans för textdelar |
| Om din prioritet ärKontroll över AI-projektens kostnader | Leta efterInbyggd kostnads- och tokenattribuering per modell och klient |
| Om din prioritet ärAtt uppfylla efterlevnadskrav | Leta efterGranskningsloggar och integrering med ISO/IEC 42001 eller liknande ramverk |
| Om din prioritet ärProaktiv avvikelsedetektering | Leta efterAI-baserad bedömning av drift, hallucinationer och kvalitetsavvikelser |
| Om din prioritet ärFlexibla driftsättningar | Leta efterAlternativ för driftsättning i VPC eller egen regi med molnintegrationer |
Så granskar du din kortlista
- Testa spårning genom hela pipelinen: Genomför en provperiod genom att spåra minst 10 förfrågningar från början till slut genom din RAG- eller agentbaserade stack.
- Bekräfta detaljnivån för kostnadsattribuering: Be om en livedemonstration där leverantören visar token- och kostnadsuppdelningar per modell och arbetsyta.
- Begär dokumentation om efterlevnad: Be om en kopia av deras ISO/IEC 42001-certifiering eller relevanta granskningsrapporter.
- Simulera avvikelsedetektering: Utlös fem varierade fellägen i en sandlådemiljö för att se aviseringar i realtid och visning av grundorsaken.
- Väg djup mot kontroll över driftsättningen: Avgör om ditt team värdesätter ett komplett funktionsdjup (molnplattformar) eller egen drift och efterlevnadskontroller (VPC/leverantörsneutralt).
Vad är verktyg för AI-observerbarhet?
Verktyg för AI-observabilitet är plattformar som hjälper dig att övervaka, diagnostisera och optimera prestandan hos modeller och system för artificiell intelligens. De ger insyn i hela AI-livscykeln, från utveckling till produktion, så att du kan spåra problem, upptäcka avvikelser, säkerställa efterlevnad och fördela kostnader. Dessa verktyg hjälper till att hålla din AI-infrastruktur tillförlitlig, säker och i linje med verksamhetens mål.
Funktioner hos verktyg för AI-observabilitet
När du väljer en plattform för AI-observabilitet bör du hålla utkik efter följande viktiga funktioner:
- Telemetri för LLM och modeller: Fånga automatiskt uppmaningar, kompletteringar, fördröjning, tokenanvändning och kostnader för olika stora språkmodeller, vilket gör det enklare att granska användningen och diagnostisera prestandatrender.
- Spårning från början till slut: Följ varje begäran när den går genom din pipeline, från användarindata till agent, hämtare och vektorlagring. Detta gör att du kan isolera det exakta steget där fel eller regressioner uppstår.
- Instrumentpaneler och aviseringar i realtid: Visualisera viktiga mätvärden, som tokenkostnader eller avvikelsefrekvenser, på instrumentpaneler i realtid. Konfigurerbara aviseringar hjälper dig att ligga steget före plötsliga ökningar av kvalitet eller kostnader.
- AI-driven avvikelsedetektering: Använd maskininlärning för att upptäcka avvikande värden och synliggöra incidenter i loggar, spårningar och mätvärden, så att du snabbt kan reagera på nya felmönster innan de sprider sig.
- Utvärdering av utdatakvalitet: Poängsätt kontinuerligt utdata för problem som hallucinationer, skadlighet, relevans, partiskhet eller drift, så att du kan hålla modellerna i linje med verksamhetens mål och kraven på efterlevnad.
- Övervakning av styrning och säkerhet: Upptäck exponering av känsliga data, övervaka försök till promptinjektion och upprätthåll granskningsloggar för att bidra till att uppfylla kraven på efterlevnad under hela AI-livscykeln.
- Kostnads- och användningsfördelning: Bryt ner token- och beräkningskostnader per modell, projekt eller klientorganisation. Denna funktion är avgörande för kostnadskontroll, budgetering och korrekta vidaredebiteringar i organisationer som kör flera AI-arbetsbelastningar.
- Flexibla integrationer: Anslut enkelt till ett brett utbud av LLM-leverantörer, orkestreringsramverk, vektorlagringar och verktyg för incidenthantering för att undvika att skapa nya övervakningssilos.
- Driftsättningsalternativ: Välj mellan driftsättning i molnet, VPC eller lokalt för att anpassa plattformen för AI-observabilitet till organisationens behov av säkerhet och datalokalitet.
- Promptadministration och testning: Experimentera med promptar och A/B-testa dem med hjälp av inbyggda verktyg, så att ditt team kan iterera snabbare och förbättra utdatakvaliteten direkt i arbetsflödet för AI-observabilitet.
Fördelar med verktyg för AI-observabilitet
Att implementera rätt verktyg för AI-observabilitet kan ge flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Insyn under hela livscykeln: Spåra problem och prestanda under hela AI-livscykeln med övervakning som fångar upp promptar, kompletteringar och kontextövergångar.
- Proaktiv avvikelsedetektering: Synliggör drift, hallucinationer och kvalitetsavvikelser i realtid med AI-driven analys av loggar, spårningar och mätvärden.
- Spårning från början till slut: Följ varje begäran genom agenter, hämtare och vektorlagringar för att fastställa det exakta steget där fel eller regressioner uppstår.
- Kostnads- och användningsfördelning: Bryt ner token- och beräkningskostnader per modell, arbetsyta eller klientorganisation för att stödja budgetering och förhindra oväntade utgifter.
- Kontinuerlig kvalitetsutvärdering: Poängsätt utdata för problem som hallucinationer, relevans, drift eller partiskhet för att hålla modellerna i linje med verksamhetens mål och kraven på efterlevnad.
- Övervakning av styrning och efterlevnad: Upptäck exponering av känsliga data, övervaka försök till promptinjektion och upprätthåll granskningsloggar för att bidra till att uppfylla lagstadgade skyldigheter.
- Flexibilitet vid driftsättning och integration: Anslut till ett brett utbud av AI-ramverk, leverantörer och driftsättningsmiljöer, inklusive moln- och lokala alternativ, för att motsvara dina behov av säkerhet och infrastruktur.
Kostnader och prissättning för verktyg för AI-observabilitet
Att välja de bästa verktygen för AI-observabilitet kräver en förståelse av de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i programvara för AI-observabilitet:
Jämförelsetabell för abonnemang för verktyg för AI-observabilitet
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| PlantypGratisplan | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande LLM-telemetri, begränsad lagring av spårdata, enkla instrumentpaneler och åtkomst för en enda användare. |
| PlantypPrivatplan | Genomsnittligt pris$10–$49/användare/månad | Vanliga funktionerAlla funktioner i gratisplanen, utökad lagring, stöd för flera LLM-leverantörer, grundläggande aviseringar och e-postsupport. |
| PlantypFöretagsplan | Genomsnittligt pris$50–$149/användare/månad | Vanliga funktionerTeamåtkomst, avancerade instrumentpaneler i realtid, kostnadsfördelning för LLM, övervakning av resultatkvalitet, integrationsalternativ och API-åtkomst. |
| PlantypPlan för stora företag | Genomsnittligt pris$150–$300/användare/månad | Vanliga funktionerAnpassade distributionsalternativ, avancerade funktioner för regelefterlevnad, dedikerad support, granskningsloggar, SSO-integration och obegränsad datalagring. |
Vanliga frågor om verktyg för AI-observabilitet
Här är några svar på vanliga frågor om programvara för AI-observabilitet:
Hur hanterar verktyg för AI-observabilitet känsliga data och behov av regelefterlevnad?
Verktyg för AI-observabilitet låter dig ofta välja distributionsalternativ som egen drift eller VPC för att hålla data inom ditt molnkonto. Vissa plattformar har funktioner för identifiering av personuppgifter, granskningsloggning och integration med ramverk för regelefterlevnad, till exempel ISO/IEC 42001. Om regelefterlevnad är mycket viktigt bör du fråga leverantörerna om deras granskningsrapporter och vilka specifika kontroller de erbjuder för reglerade data.
Kan jag integrera verktyg för AI-observabilitet med min befintliga övervakningsmiljö?
Ja, de flesta plattformar för AI-observabilitet stöder integrationer med populära plattformar för incidenthantering och APM. Leta efter verktyg som erbjuder webhooks, API:er och insticksprogram för anslutning till de övervakningslösningar som ditt team redan använder. Det bästa alternativet för dig beror på din teknikstack – granska alltid integrationslistorna och be om en demonstration av de integrationer som är viktiga för dig.
Har dessa verktyg stöd för modeller och arbetsflöden som inte använder LLM?
Vissa verktyg för AI-observabilitet fokuserar på LLM och generativ AI, medan andra erbjuder ett bredare urval av modeller och datatyper. Om du arbetar med traditionella maskininlärningsmodeller eller anpassade datapipelines bör du bekräfta stödet för dina modelltyper under utvärderingen. Du kommer att se att plattformar som MLflow är mer allmänt användbara, medan andra riktar in sig på språk- och system med förstärkt informationssökning.
Vilket är det rekommenderade sättet att testa ett verktyg för AI-observabilitet?
För att utvärdera ett verktyg för AI-observabilitet bör du genomföra ett koncepttest som spårar minst 10 förfrågningar från början till slut genom din stack. Simulera några vanliga felscenarier, till exempel hallucinationer eller plötsliga latensökningar, och kontrollera om aviseringarna utlöses korrekt. Be leverantören demonstrera kostnadsfördelning, resultatutvärdering och säkerhetsövervakning i en aktiv sandlådemiljö.
Hur detaljerad är rapporteringen av kostnader och tokenanvändning på dessa plattformar?
De flesta verktyg erbjuder uppdelningar efter modell, arbetsyta eller klient. Vissa går längre och visar kostnads- och tokenfördelning per förfrågan eller användare, vilket är användbart för budgetuppföljning och intern debitering. Kontrollera alltid detaljnivån under testperioden, särskilt om din organisation driver flera team eller projekt.