

Att övervaka nätverket med en allt-i-ett-plattform för övervakning kan vara en utmaning, särskilt när dina nuvarande verktyg inte riktigt uppfyller dina behov. Du kanske använder PRTG och upptäcker att det inte passar teamets specifika krav eller saknar vissa funktioner.
Av egen erfarenhet vet jag att det kan göra arbetsbelastningen betydligt mindre, minska driftstopp och förbättra den övergripande prestandan att hitta rätt lösning för nätverksövervakning. Därför har jag undersökt och testat olika alternativ till PRTG för att hjälpa dig hitta det som passar bäst för ditt företag.
I den här artikeln hittar du opartiska recensioner av de främsta alternativen, med fokus på deras unika funktioner och fördelar. Oavsett om du letar efter bättre skalbarhet, specifik branschmässig regelefterlevnad eller en förbättrad användarupplevelse vägleder jag dig genom alternativen. Låt oss hitta den programvara för nätverksövervakning som bäst stöder ditt team.
Vad är PRTG?
Paessler Router Traffic Grapher (PRTG), som ofta kallas PRTG Network Monitor, är ett övervakningsverktyg som är utformat för att hjälpa dig följa nätverkets hälsa och prestanda. Yrkesverksamma inom IT-övervakning och nätverksadministratörer använder i allmänhet PRTG för dess förmåga att ge detaljerade insikter i nätverkstrafik och systemets drifttid. Funktioner som övervakning i realtid, anpassningsbara aviseringar och detaljerad rapportering stöder ditt behov av effektiv nätverkshantering. PRTG kan ge värdefulla insikter som hjälper dina system att fungera smidigt, men det finns alternativ.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell över alternativ till PRTG
I den här jämförelsetabellen sammanfattas prisuppgifterna för mina främsta alternativ till PRTG:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bäst för detaljerad SLA-rapportering | 4.0 out of 5 | 4 | 4 | 4 | 4 | 4 | 4 | $1,400/år Kostnadsfri plan + 60 dagars kostnadsfri provperiod tillgänglig | Website |
Bäst för fjärrhantering av IT | 2.7 out of 5 | 3 | 4 | 2 | 2 | 2 | 3 | Pris på begäran Gratis demo tillgänglig | Website |
Bäst för skalbarhet med öppen källkod | 4.2 out of 5 | 4 | 5 | 4 | 4 | 4 | 4 | $325/månad Gratisplan + 5 dagars gratis provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för molnbaserad observerbarhet | 3.5 out of 5 | 4 | 4 | 3 | 3 | 3 | 4 | $0.60/månad Gratisabonnemang + 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för anpassningsbara instrumentpaneler | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $2,595 som engångskostnad Kostnadsfri plan + 30 dagars provperiod + demo tillgänglig | Website |
Bäst för insyn i Internetvägar | 3.2 out of 5 | 4 | 3 | 2 | 3 | 3 | 4 | Pris på begäran 15 dagars kostnadsfri provperiod + demo tillgänglig | Website |
Bäst för enhetlig hantering av slutpunkter | 3.3 out of 5 | 4 | 4 | 4 | 3 | 2 | 3 | $3.75/månad 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |
Bäst för automatisk nätverksidentifiering | 3.3 out of 5 | 4 | 4 | 4 | 3 | 3 | 2 | Pris på begäran Kostnadsfritt abonnemang + kostnadsfri demo tillgänglig | Website |
Bäst för syntetisk nätverksövervakning | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $249/månad Gratisplan + 14 dagars provperiod + gratis demo tillgänglig | Website |
Bäst för automatiserad nätverkskartläggning | 3.8 out of 5 | 4 | 4 | 5 | 4 | 4 | 2 | Prisuppgift på begäran 14 dagars kostnadsfri provperiod + demo tillgänglig | Website |


Recensioner av de bästa alternativen till PRTG
Nedan hittar du mina detaljerade sammanfattningar av de bästa alternativen till PRTG som kom med på min kortlista. I mina recensioner får du en detaljerad genomgång av de viktigaste funktionerna, för- och nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
 Bäst för detaljerad SLA-rapportering
- Kostnadsfri plan + 60 dagars kostnadsfri provperiod tillgänglig
- Från $1,400/år (faktureras årsvis)
Visit WebsiteCustomer Rating:4.7/5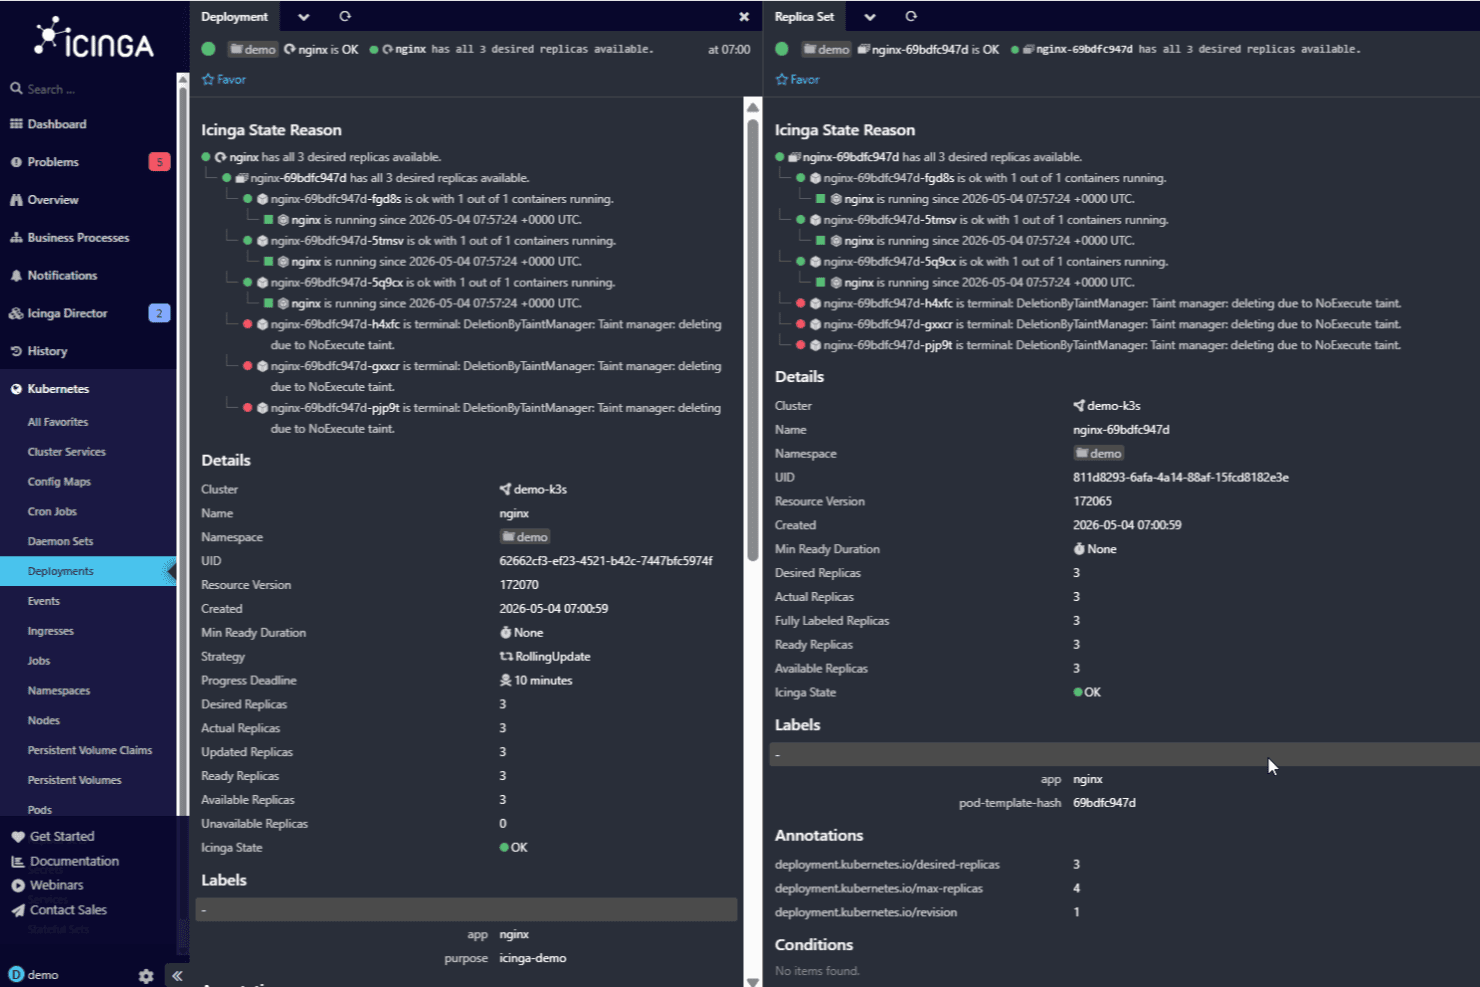
Icinga håller reda på alla distributioner på en instrumentpanel med etiketter, detaljer och anteckningar. Icinga är en plattform med öppen källkod för infrastrukturövervakning som tilltalar systemingenjörer, nätverksadministratörer och MSP:er som behöver obegränsad värdövervakning, flexibla kontrollmetoder och detaljerad SLA-rapportering utan begränsningar för licensiering per sensor.
Vem passar Icinga bäst för?
Icinga passar bra för systemingenjörer och MSP-tekniker som behöver övervaka stora, distribuerade infrastrukturer utan att licenskostnader per värd begränsar dem.
Varför jag valde Icinga
Jag valde Icinga som ett av de bästa alternativen eftersom dess SLA-rapportering går djupare än hos de flesta övervakningsverktyg jag har arbetat med. Icinga DB underhåller separata historiktabeller för SLA som bevarar exakt de data som behövs för tillgänglighetsberäkningar, och historik raderas inte som standard. Du kan generera tillgänglighetsrapporter för värdar och tjänster, förhandsgranska dem i Icinga Web, exportera dem som PDF-filer och schemalägga att de skickas automatiskt med regelbundna intervall.
Viktiga funktioner i Icinga
- Distribuerad arkitektur med huvudnoder, satelliter och agenter: Fördelar övervakningen över flera platser med hjälp av överordnade och underordnade noder som fortsätter att kontrollera och samla in data under nätverksavbrott.
- Permanent kostnadsfri utgåva med obegränsat antal värdar: Övervakar obegränsat antal värdar och tjänster utan kostnad, utan licensbegränsningar per sensor eller enhet.
- API-baserad konfigurationshantering: Använder ett REST API för att dynamiskt skapa, ändra och ta bort värdar, tjänster och konfigurationsobjekt, med stöd för versionshanterade konfigurationer och återställning.
- Stöd för kontroller med flera protokoll: Övervakar enheter och tjänster via SNMP, SSH, ICMP, agentbaserade kontroller, NSClient++ och passiva resultat som skickas via REST API.
Integrationer med Icinga
Icinga har dokumenterade integrationer med Grafana, Elasticsearch, NetBox, Graphite, InfluxDB, Prometheus, Ansible, Puppet och Terraform. Dess REST API stöder anpassade integrationer, konfigurationsautomatisering, händelseströmmar och anslutningar till arbetsflöden för ärendehantering.
Pros and Cons
Pros:
- Detaljerade SLA-rapporter om tillgänglighet
- Distribuerade kontroller fortsätter under avbrott
- Anpassade kontroller täcker blandad infrastruktur
Cons:
- Konfigurationen kräver omfattande manuellt arbete
- Långsiktig trendanalys kräver separata verktyg
Learn more about Icinga: Bäst för fjärrhantering av IT
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.7/5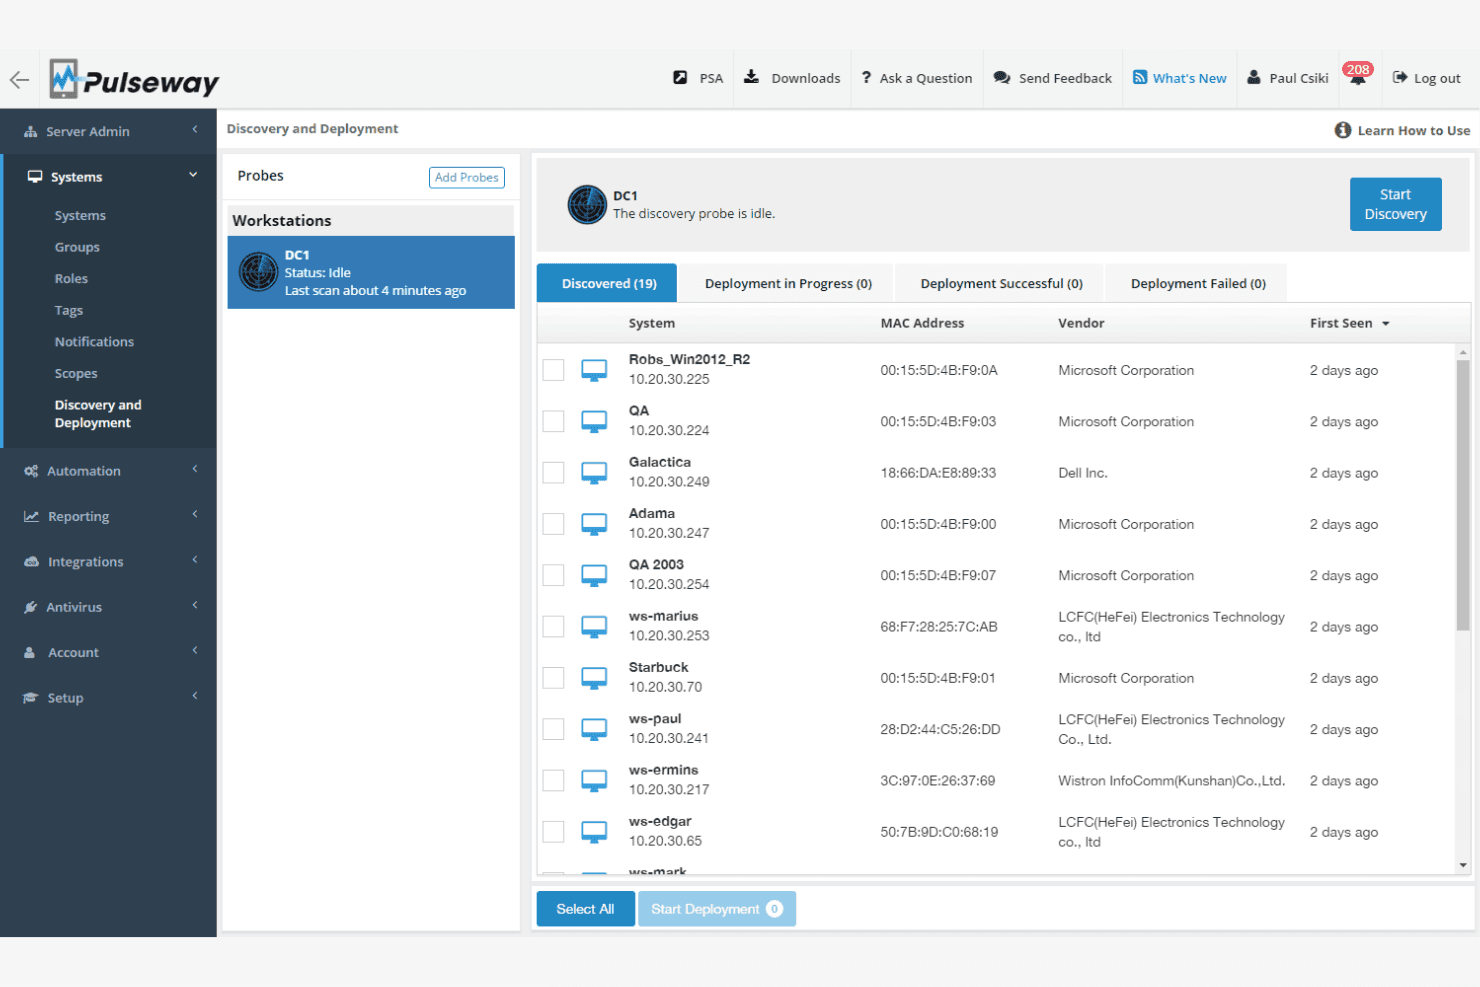
Pulseways skärm för upptäckt och driftsättning hittar enheter i nätverket och spårar deras driftsättningsstatus. Pulseway är en RMM-plattform för MSP:er och IT-team som behöver övervaka, hantera och felsöka slutpunkter, servrar och nätverksenheter – med starkt fokus på mobil fjärråtkomst och hantering av aviseringar.
Vem passar Pulseway bäst för?
Pulseway passar bra för MSP-tekniker som behöver övervaka och hantera kunders slutpunkter på distans, särskilt från en mobil enhet.
Varför jag valde Pulseway
Jag valde Pulseway som ett av de bästa alternativen eftersom den mobilfokuserade fjärrhanteringen skiljer den från verktyg som PRTG, som binder dig till en skrivbordskonsol. Jag kan svara på en kritisk serveravisering, köra ett åtgärdsskript och starta om en tjänst direkt från telefonen innan någon märker ett avbrott. Dess SNMP-baserade villkorsstyrda aviseringar integreras med automatiseringsarbetsflöden, så svaret är inte bara en avisering – det är en åtgärd som redan har satts i verket.
Viktiga funktioner i Pulseway
- Nätverkstopologikartor: Skapar automatiskt anpassningsbara topologikartor med redigerbara enhetstyper, logiska grupperingar och nätverksrelationer.
- Patchhantering: Automatiserar patchning av operativsystem och tredjepartsprogram i Windows, Mac och Linux med konfigurerbara principer och scheman.
- Inspelning av fjärrstyrningssessioner: Spelar in fjärrstyrningssessioner för Windows-agenter manuellt eller automatiskt, inklusive både delade och privata sessioner.
- Automatiseringsarbetsflöden som utlöses av aviseringar: Kör skript och arbetsflöden som svar på aviseringar för att automatiskt lösa IT-problem utan manuellt ingripande.
Integrationer med Pulseway
Pulseway erbjuder inbyggda integrationer med PagerDuty, Slack, ConnectWise Manage, Autotask, Zendesk och IT Glue. Plattformen tillhandahåller även REST-, klient- och moln-API:er samt plugin-program för anpassad anslutning.
Pros and Cons
Pros:
- Mobila aviseringar möjliggör snabba fjärråtgärder
- Aviseringsutlösta skript minskar repetitiv felsökning
- Topologikartor tydliggör relationerna mellan upptäckta enheter
Cons:
- SNMP-konfigurationen kan vara svår
- Rapporteringen erbjuder begränsade möjligheter till anpassning och begränsat djup
Learn more about Pulseway: Bäst för skalbarhet med öppen källkod
- Gratisplan + 5 dagars gratis provperiod + kostnadsfri demo tillgänglig
- Från $325/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.5/5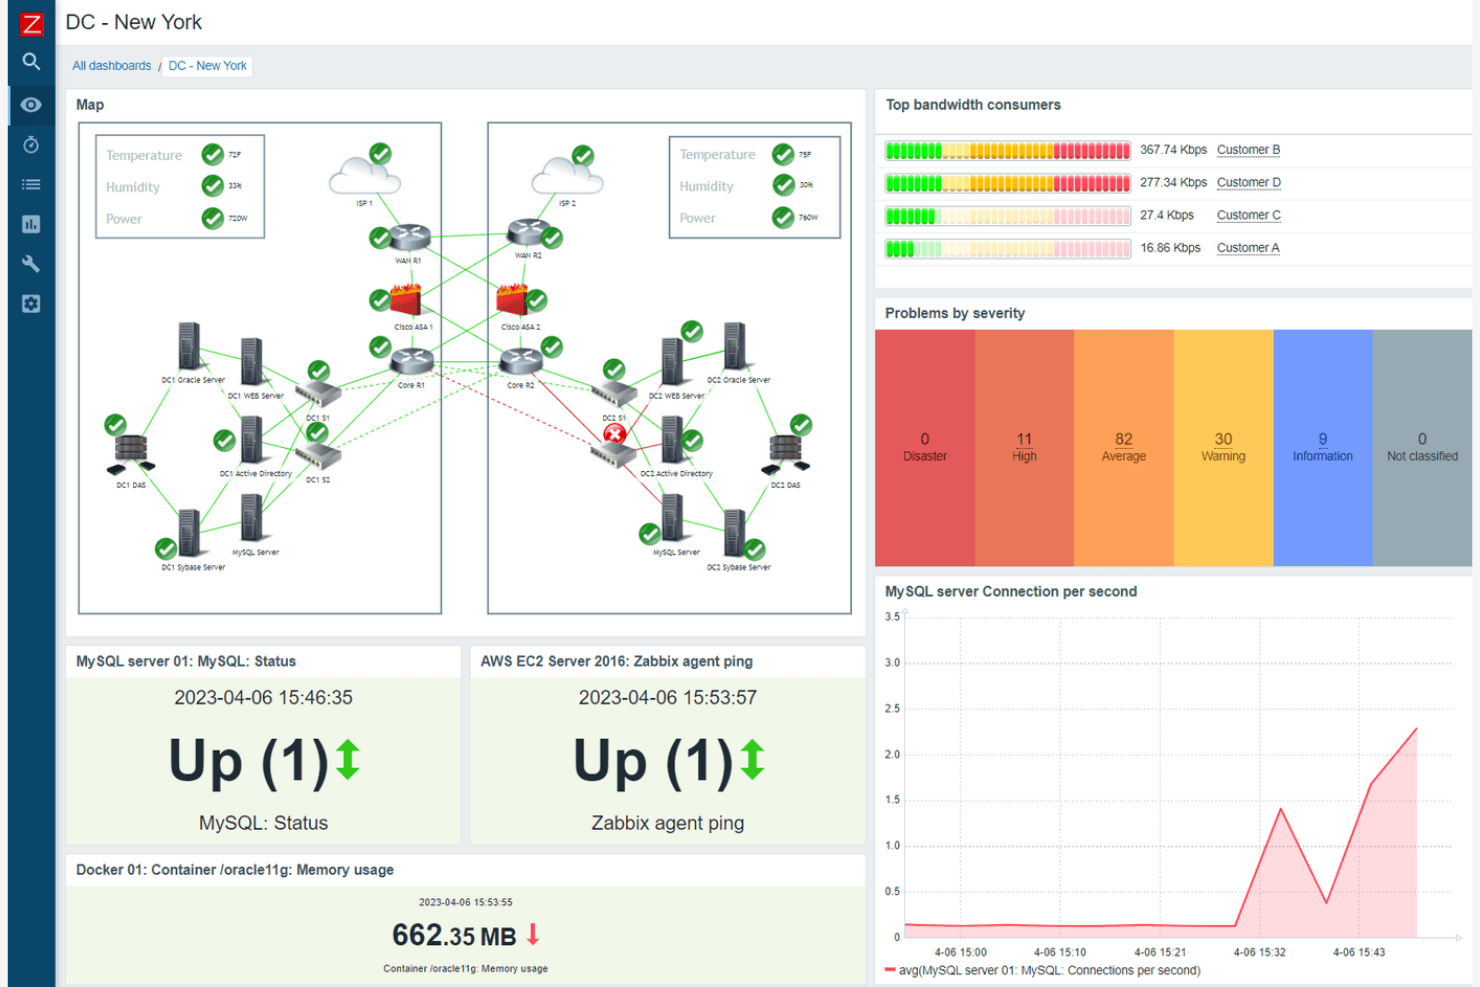
Zabbix-instrumentpanel som visar en nätverkskarta över ett datacenter, bandbreddsanvändning och problem efter allvarlighetsgrad. Zabbix är en övervakningsplattform med öppen källkod som låter infrastruktur- och driftteam övervaka servrar, nätverksenheter, molnresurser och applikationer utan att betala per sensor eller enhet.
Vem passar Zabbix bäst för?
Zabbix passar bra för infrastruktur- och driftteam som behöver övervaka stora, komplexa miljöer utan kostnaden för licenser per enhet eller sensor.
Varför jag valde Zabbix
Zabbix finns med på min kortlista eftersom det är en av få övervakningsplattformar som verkligen kan skalas till miljontals mätvärden utan att ta betalt per enhet eller sensor. Jag uppskattar hur den proxybaserade arkitekturen låter mig distribuera insamlingen över fjärrplatser, DMZ:er och brandväggar, så att en enda Zabbix-server realistiskt kan täcka en omfattande infrastruktur på flera platser. Licensen med öppen källkod innebär att det inte finns något PRTG-liknande sensortak som i det tysta väntar på att överraska dig när miljön växer.
Viktiga funktioner i Zabbix
- Agentlös övervakning med flera protokoll: Övervaka nätverksenheter, servrar och tjänster med SNMP, IPMI, SSH/Telnet, ICMP/TCP, Prometheus, Modbus och MQTT utan att distribuera en agent.
- Eskalering av arbetsflöden: Konfigurera eskaleringar av aviseringar i flera steg med fördröjningar, upprepade aviseringar, dirigering till användargrupper och automatiserad körning av fjärrkommandon.
- Träd för företagstjänster: Definiera tjänstehierarkier, beräkna tjänstestatus med konfigurerbara algoritmer och mät tillgänglighet mot SLA-mål.
- JSON-RPC-API: Få åtkomst till över 200 API-metoder för att automatisera konfiguration, hämta historiska data och integrera verktyg från tredje part med Zabbix.
Integrationer med Zabbix
Zabbix erbjuder inbyggda integrationer med ServiceNow, Jira ServiceDesk, Slack, Microsoft Teams, PagerDuty, AWS, Microsoft Azure, Google Cloud, Kubernetes och VMware. Dess JSON-RPC-API tillhandahåller mer än 200 metoder för anpassade integrationer, med strömning till Kafka, RabbitMQ, Amazon SQS och Amazon Kinesis.
Pros and Cons
Pros:
- Proxybaserad avfrågning buffrar data från fjärrplatser
- Agentlös och agentbaserad övervakning täcker olika system
- Ingen licensgräns baserad på sensorer
Cons:
- Den initiala konfigurationen av värdar och utlösare kräver arbete
- Aviseringströsklar behöver finjusteras för att minska brus
 Bäst för molnbaserad observerbarhet
- Gratisabonnemang + 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $0.60/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.5/5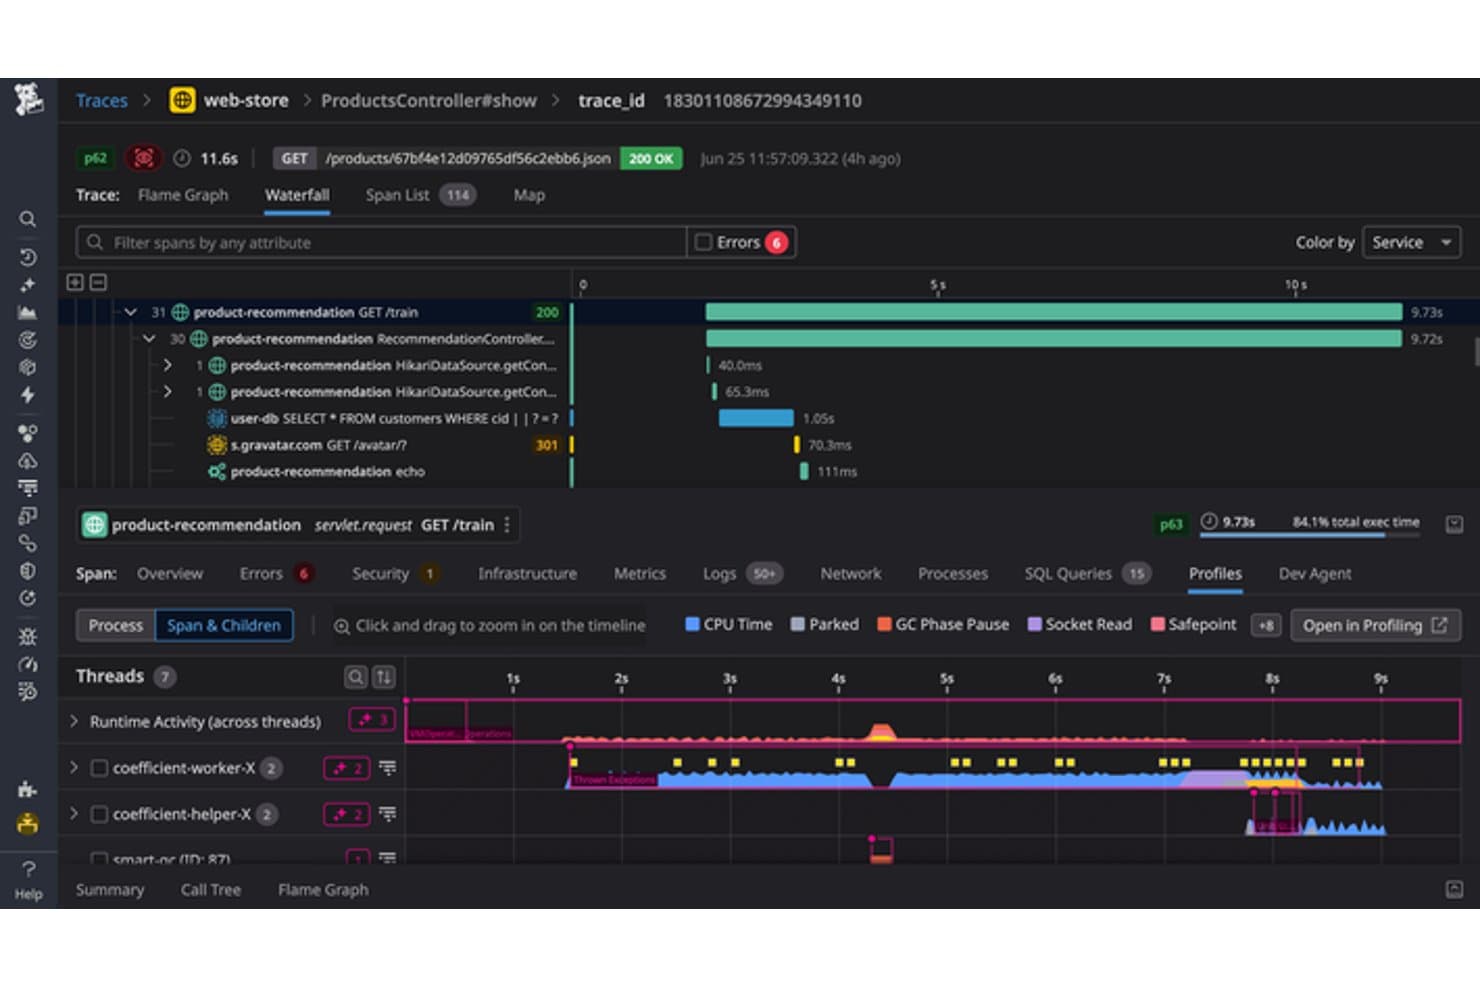
Datadog APM-spårningens vattenfallsvisning med profileringsvy för en begäran till en tjänst för produktrekommendationer. Datadog är en molnbaserad övervakningsplattform som förenar insyn i nätverk, infrastruktur och applikationer över miljöer med flera moln och hybrida miljöer – vilket gör den väl lämpad för IT-driftteam som behöver korrelerade insikter över flera lager utan att hantera flera verktyg.
Vem passar Datadog bäst för?
Datadog passar IT-driftteam som hanterar miljöer med flera moln och hybrida miljöer och behöver nätverks-, infrastruktur- och applikationsdata på ett och samma ställe.
Varför jag valde Datadog
Jag valde Datadog som ett av de bästa alternativen till PRTG eftersom plattformen tillför molnbaserad observerbarhet till nätverksövervakning på ett sätt som traditionella NMS-verktyg helt enkelt inte gör. Jag uppskattar hur molnnätverksövervakningen korrelerar trafik mellan mikrotjänster, molnslutpunkter och lokal infrastruktur i en enda vy, så att mitt team kan gå från en nätverksavvikelse till den applikation eller värd som ligger bakom den utan att byta verktyg. Nätverkssökvägen ger insyn i fördröjning och paketförlust hop för hop över VPC:er, WAN och SaaS-leverantörer, vilket gör det praktiskt att spåra försämrade nätverksvägar i hybrida miljöer.
Viktiga funktioner i Datadog
- Övervakning av nätverksenheter: Upptäcker fysiska och virtuella enheter via SNMP (v1–v3), traps, NetFlow och syslog, med automatiskt genererade instrumentpaneler för enheter och gränssnitt.
- Topologikarta över enheter: Visualiserar automatiskt fysiska nätverksanslutningar samt uppströms- och nedströmsberoenden i hela ditt enhetslager.
- NetFlow-övervakning: Samlar in data från NetFlow v5/v9, IPFIX, sFlow och jFlow för att identifiera de största trafikförbrukarna, protokollen och trender för bandbreddsanvändning.
- Kontohantering för flera organisationer: Separera klientdata i isolerade underordnade organisationer, med insyn i användningen på överordnad nivå och programmatisk konfiguration via API eller Terraform.
Datadog-integreringar
Datadog listar över 1 000 inbyggda integreringar för hela plattformen, bland annat Arista, Aruba, Cisco, Cisco Meraki, F5 och Juniper. Plattformen erbjuder även en integrering med PRTG Marketplace, berikning av ServiceNow CMDB samt ett HTTP REST API för anpassade integreringar.
Pros and Cons
Pros:
- Korrelerar problem i nätverk, infrastruktur och applikationer
- Kartlägger fördröjning och paketförlust hop för hop
- Instrumentpaneler hjälper team att upptäcka problem med systemets hälsa
Cons:
- Konfiguration av SNMP kan vara arbetskrävande
- Lagringstiden för nätverksdata är kortare än i dedikerade NMS-verktyg
 Bäst för anpassningsbara instrumentpaneler
- Kostnadsfri plan + 30 dagars provperiod + demo tillgänglig
- Från $2,595 som engångskostnad
Visit WebsiteCustomer Rating:4.6/5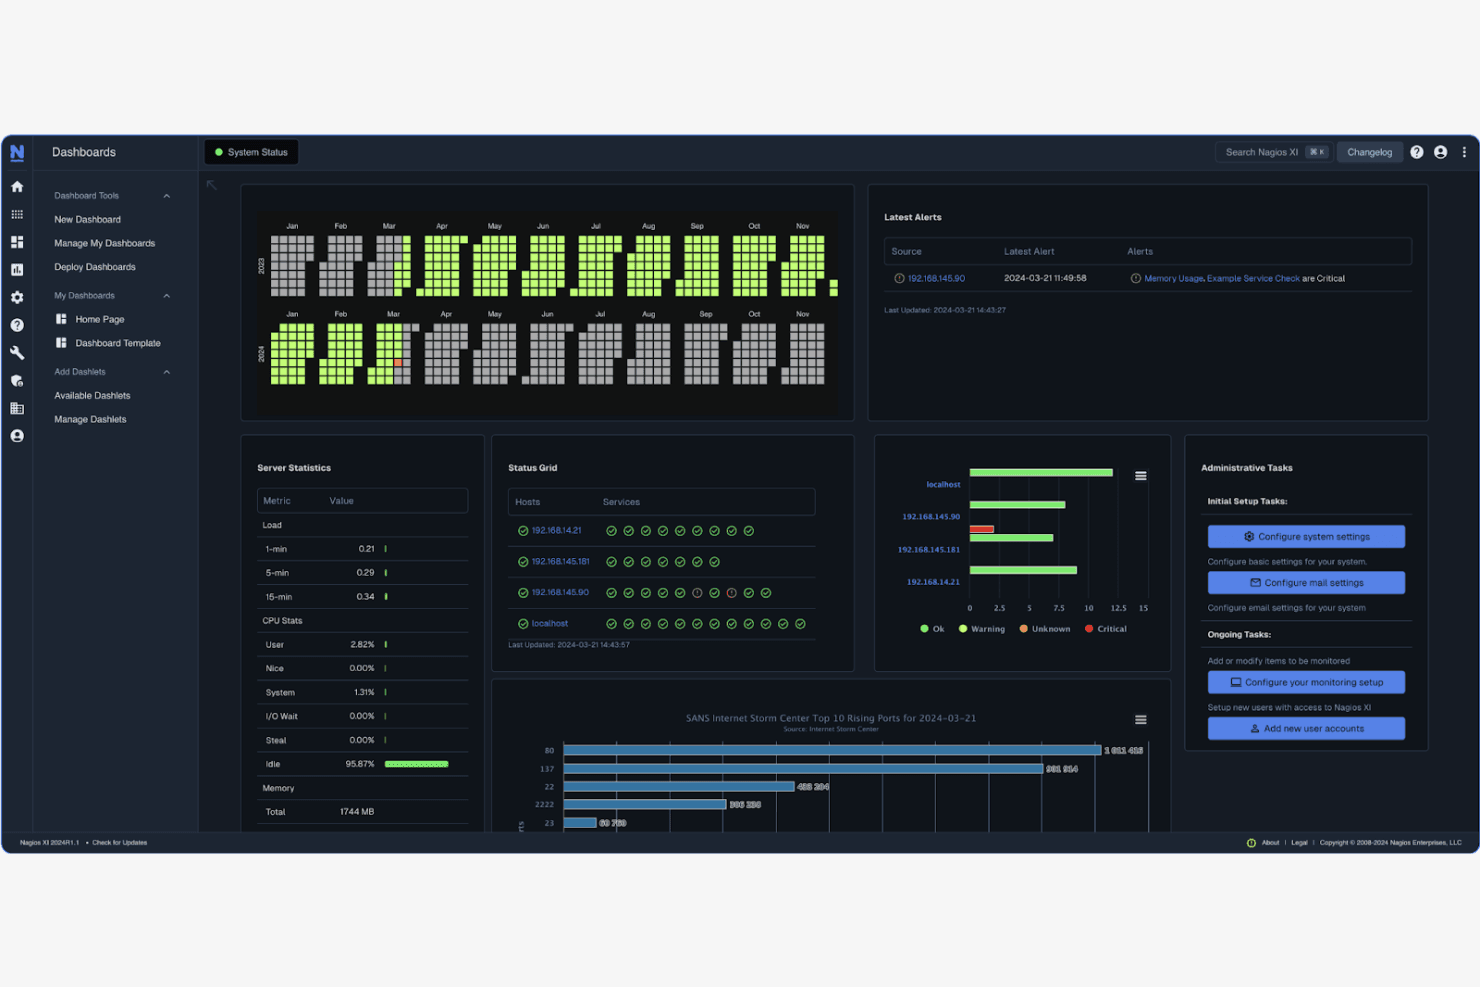
Nagios XI-instrumentpanelen som sammanfattar aviseringar, värd- och tjänstestatus, serverstatistik och administrativa uppgifter. Nagios XI är en plattform för infrastrukturövervakning med egen drift, utvecklad för nätverksadministratörer och IT-driftteam som behöver detaljerad kontroll över hur de övervakar servrar, nätverksenheter och applikationer – utan de begränsningar med prissättning per sensor som följer med PRTG.
Vem passar Nagios XI bäst för?
Nagios XI passar bra för nätverksadministratörer och systemingenjörer som behöver djupgående kontroll över en övervakningsmiljö med egen drift, utan licensbegränsningar baserade på sensorer.
Varför jag valde Nagios XI
Jag valde Nagios XI som en av de bästa eftersom anpassningen av instrumentpaneler går djupare än hos de flesta andra alternativ med egen drift. Varje användare bygger sin egen taktiska vy från instrumentpanelkomponenter som omfattar diagram, statusöversikter, nätverkskartor och mätare, och Enterprise-utgåvan låter administratörer distribuera dessa instrumentpaneler till andra användare eller synkronisera dem med en central administratörsvy. Jag uppskattar också att du kan schemalägga instrumentpaneler som PDF-bilagor i e-post enligt ett återkommande schema, vilket gör det enkelt att hålla intressenter uppdaterade utan manuellt rapporteringsarbete.
Viktiga funktioner i Nagios XI
- Licensiering per nod: XI licensieras efter övervakad nod i stället för per sensor eller kontroll, utan någon angiven gräns för hur många kontroller du kör per enhet.
- Policyer för eskalering av aviseringar: Du kan konfigurera eskaleringar så att aviseringar automatiskt skickas till en annan kontaktgrupp efter ett visst antal aviseringar.
- Återställning av konfiguration: Administratörer kan återställa konfigurationsfel till en känd fungerande ögonblicksbild, vilket minskar risken för att en felkonfiguration slår ut övervakningen.
- Kapacitetsplanering: Enterprise-utgåvan visualiserar förväntad framtida prestanda och kan varna dig när tröskelvärden ser ut att överskridas.
Integrationer med Nagios XI
Nagios XI erbjuder dokumenterade integrationer med Microsoft Azure AD för SSO och Slack för aviseringar. Det tillhandahåller även ett REST API för anpassade integrationer och stöder SNMP-trapanslutning.
Pros and Cons
Pros:
- Licensiering per enhet undviker begränsningar av antalet sensorer
- Instrumentpanelkomponenter anpassar infrastruktursvyer för enskilda operatörer
- Distribuerade arbetare utökar täckningen för fjärrkontroller
Cons:
- Den första enhetsintegrationen kan kräva betydande arbete
- Rapportmallar erbjuder begränsad flexibilitet
Learn more about Nagios XI: Bäst för insyn i Internetvägar
- 15 dagars kostnadsfri provperiod + demo tillgänglig
- Pris på begäran
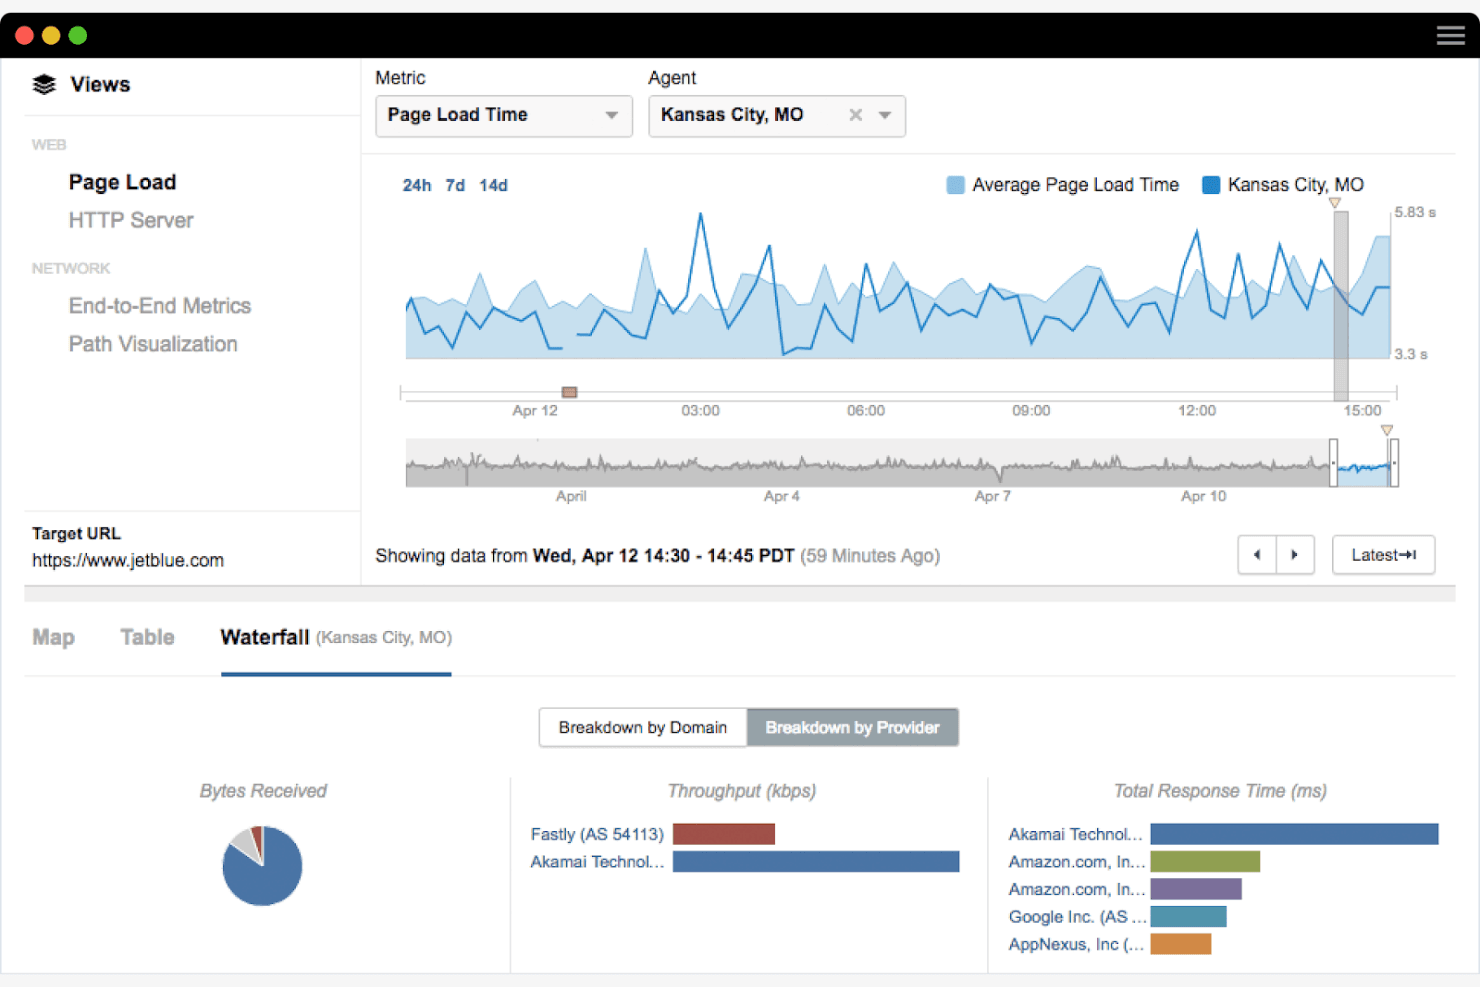
ThousandEyes-vyn för sidinläsning som följer sidinläsningstider från en agent i Kansas City, med uppdelning på leverantörsnivå. ThousandEyes är en Cisco-stödd plattform för nätverksövervakning som ger IT-team insyn från början till slut i hur trafik rör sig över Internet, molntjänster och SaaS-applikationer—vilket gör den särskilt användbar när du behöver fastställa om ett prestandaproblem finns i ditt nätverk eller någon annanstans utanför det.
Vem passar ThousandEyes bäst för?
ThousandEyes passar bra för IT- och nätverksdriftteam på medelstora till stora företag som är starkt beroende av molntjänster, SaaS-applikationer eller distribuerade kontorsmiljöer där insyn i Internetvägar är prioriterad.
Varför jag valde ThousandEyes
Jag valde ThousandEyes som en av de bästa lösningarna eftersom den gör något som traditionella PRTG-konfigurationer helt enkelt inte kan: den visar exakt var på Internetvägen ett problem finns. När en SaaS-app som Salesforce börjar fungera felaktigt spårar ThousandEyes visualisering av nätverksvägen varje hopp mellan dina användare och tjänsten, så att jag omedelbart kan avgöra om felet finns i mitt nätverk, hos en internetleverantör eller i molnleverantörens infrastruktur. Dess molnagenter finns i 276 städer i 71 länder, vilket ger mig insyn utifrån och in som ingen lokal sensor kan återskapa.
Viktiga funktioner i ThousandEyes
- Typer av syntetiska tester: Kör HTTP-, FTP-, webbläsar-, DNS-, BGP-rutt-, VoIP- och UCaaS-övervakningstester från moln- och företagsagenter.
- Övervakning av SNMP-enhetslagret: Hämtar information från nätverksenheter med SNMPv2c eller SNMPv3 genom distribuerade företagsagenter, med manuella eller schemalagda identifieringssökningar.
- Testning av API:er i flera steg: Emulerar backend-interaktioner med API-slutpunkter, validerar svarsinnehåll och stöder påståenden för dataintegritet och testning av specialfall.
- Konfiguration av aviseringsregler: Stöder både manuella och adaptiva aviseringsregler med dirigering av aviseringar till PagerDuty, Slack, ServiceNow eller anpassade webhooks.
Integrationer med ThousandEyes
ThousandEyes erbjuder dokumenterade integrationer med PagerDuty, Slack, ServiceNow, Splunk Observability Cloud, AppDynamics, OpenTelemetry och CyberArk Secrets Manager. Plattformen tillhandahåller även ett REST API och anpassade webhooks för ytterligare integrationer.
Pros and Cons
Pros:
- Lokaliserar fel över externa nätverksvägar
- Synliggör problem med fördröjning, paketförlust och SaaS-anslutningar
- Jämför prestanda från globala nätverksobservationspunkter
Cons:
- Begränsad lokal telemetri för switchar och servrar
- Enhetsavläsning omfattar färre protokoll än PRTG
Learn more about ThousandEyes: Bäst för enhetlig hantering av slutpunkter
- 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från $3.75/månad
Visit WebsiteCustomer Rating:5/5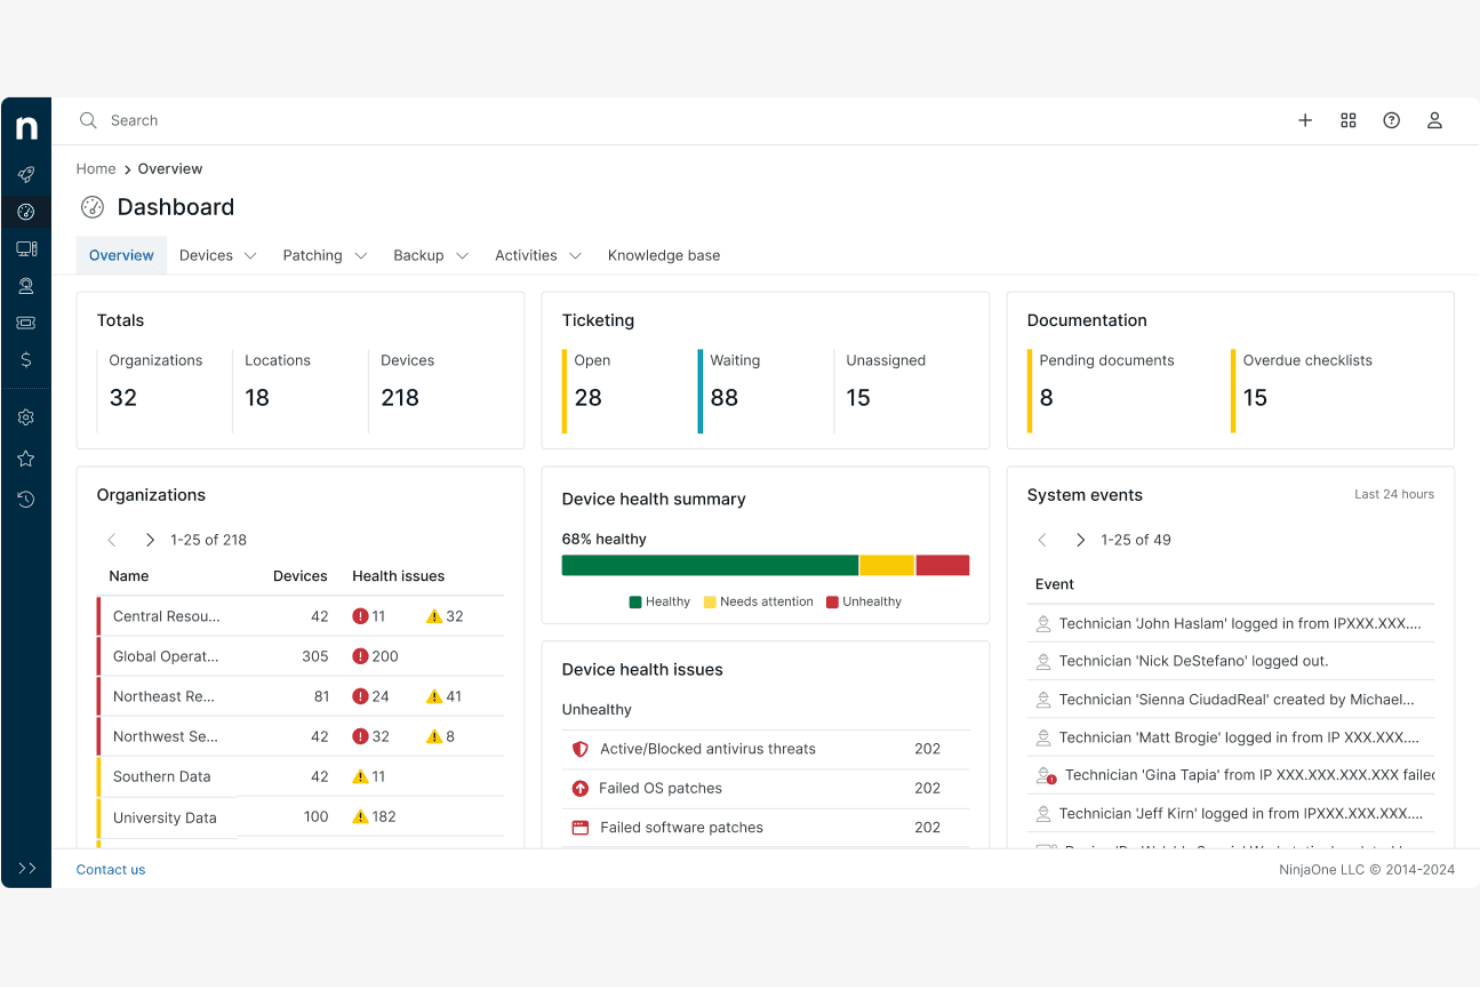
Översikt över NinjaOnes instrumentpanel, som sammanfattar enheter, organisationer, ärenden, enhetshälsa och systemhändelser i en och samma vy. NinjaOne RMM är en plattform för övervakning av slutpunkter och nätverk, utvecklad för MSP:er och IT-team som behöver centraliserad överblick över slutpunkter, nätverksenheter och molninfrastruktur – med inbyggd patchhantering, aviseringar och verktyg för fjärrhantering som minskar manuellt arbete.
Vem passar NinjaOne bäst för?
NinjaOne passar bra för MSP-tekniker och IT-driftteam som hanterar slutpunkter i flera kundmiljöer från en enda konsol.
Varför jag valde NinjaOne
Jag valde NinjaOne som ett av de bästa alternativen till PRTG eftersom plattformen samlar övervakning av slutpunkter, synlighet för nätverksenheter och automatiserad åtgärdshantering i en enda konsol, vilket är precis vad MSP-tekniker som hanterar flera kundmiljöer behöver. Jag uppskattar att NMS är direkt inbyggt i RMM, så att mitt team kan övervaka routrar, switchar och brandväggar tillsammans med Windows-, macOS- och Linux-slutpunkter utan att byta verktyg. Policybaserade villkor gör att jag kan ställa in tröskelvärden för CPU, minne, adaptertrafik och pingfördröjning och sedan utlösa automatiska åtgärder när dessa trösklar överskrids.
NinjaOnes viktigaste funktioner
- Aviseringar via flera kanaler: Konfigurera aviseringskanaler, inklusive e-post, SMS, Slack, PagerDuty, Microsoft Teams och webhooks, för att leverera tröskelbaserade aviseringar till ditt team.
- Villkorsbaserad automatisk åtgärdshantering: Definiera skriptarbetsflöden som automatiskt upptäcker och löser problem med slutpunkter, till exempel stoppade tjänster, öppna portar eller uteblivna omstarter, utan teknikerinsatser.
- Stöd för flödesövervakning: Samla in och analysera NetFlow-, JFlow-, sFlow- och IPFIX-data från kompatibla nätverksenheter för att få insyn i trafikmönster.
- Offentligt API och webhooks: Få åtkomst till NinjaOne-data och utlös åtgärder programmatiskt med hjälp av ett OAuth 2.0-API med fullständigt stöd för metoderna POST, GET, PATCH, DELETE och PUT.
NinjaOne-integrationer
NinjaOne listar integrationer med ServiceNow, Autotask, ConnectWise Manage, HaloPSA, Slack, PagerDuty, Microsoft Azure och AWS. Dess offentliga OAuth 2.0-API och webhooks stöder anpassade integrationer och övervakningsarbetsflöden.
Pros and Cons
Pros:
- Centraliserar överblicken över slutpunkter och nätverk i flera kundmiljöer
- Policyautomatisering bidrar till att minska det rutinmässiga arbetet med åtgärder
- Övervakar flödesdata tillsammans med mätvärden för enhetshälsa
Cons:
- Nätverksövervakning kan kräva manuell OID-mappning
- Begränsad dokumentation om lagringstiden för prestandahistorik
Learn more about NinjaOne: Bäst för automatisk nätverksidentifiering
- Kostnadsfritt abonnemang + kostnadsfri demo tillgänglig
- Pris på begäran
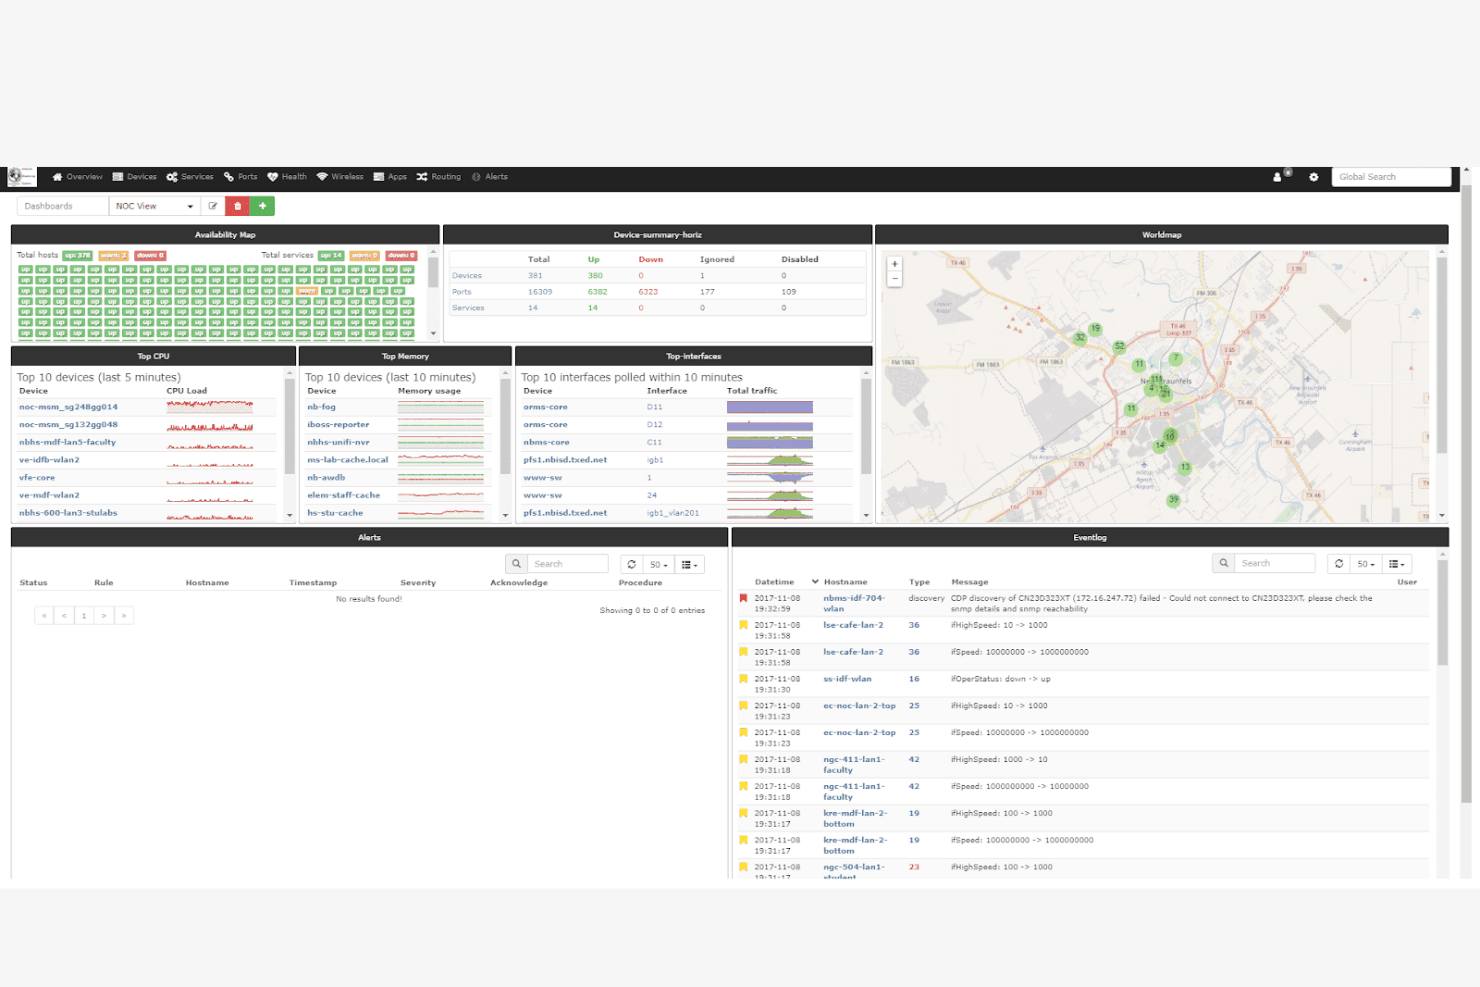
LibreNMS NOC-instrumentpanel som visar enhetstillgänglighet, högsta CPU- och minnesanvändning, gränssnittstrafik och en live-logg över händelser. LibreNMS är ett kostnadsfritt nätverksövervakningssystem med öppen källkod som passar systemingenjörer och nätverksadministratörer som behöver omfattande enhetsidentifiering och insyn i infrastrukturen utan kostnaderna eller licensbegränsningarna hos kommersiella verktyg.
Vem passar LibreNMS bäst för?
LibreNMS passar bra för systemingenjörer och nätverksadministratörer som vill ha omfattande enhetsidentifiering och insyn i infrastrukturen utan sensorbaserade licenskostnader.
Varför jag valde LibreNMS
Jag valde LibreNMS som ett av de bästa alternativen eftersom den automatiska nätverksidentifieringen verkligen är imponerande: systemet använder CDP, LLDP, OSPF, BGP, SNMP och ARP för att hitta enheter i nätverket utan manuell inmatning. Jag har sett hur det snabbt identifierar routrar, switchar och åtkomstpunkter efter installationen, vilket är precis vad du behöver när du ersätter ett sensorbegränsat verktyg som PRTG. De inbyggda ICMP-tillgänglighetskontrollerna och programövervakningen för tjänster som NGINX, MySQL och Docker kompletterar den insyn du får redan från första dagen.
Viktiga funktioner i LibreNMS
- Anpassningsbara larmåtgärder: Konfigurera aviseringsarbetsflöden i flera steg med tidsstyrda segment som eskalerar via kanaler som Slack, e-post och Telegram tills ett larm har lösts eller bekräftats.
- System för bandbreddsfakturering: Skapa fakturor för nätverksportar baserat på faktisk användning eller datatrafik direkt i plattformen.
- Distribuerad avfrågning: Fördela avfrågnings- och identifieringsuppgifter mellan flera servrar genom att tilldela enheter till avfrågningsgrupper när nätverket växer.
- Programövervakning med flera protokoll: Samla in programstatistik från tjänster som MySQL, NGINX, Docker och PostgreSQL via direktanslutning, SNMP extend eller Check_MK-agenten.
LibreNMS-integreringar
Dokumenterade integreringar omfattar NfSen, collectd, SmokePing, RANCID och Oxidized. LibreNMS tillhandahåller även ett HTTP-API med JSON- och PNG-svar för anpassade integreringar, enhetshantering, generering av grafer och datahämtning.
Pros and Cons
Pros:
- Omfattande automatisk identifiering av enheter
- Eskalierande larm via olika aviseringskanaler
- Övervakar drifttid och nätverksprestanda
Cons:
- Begränsade inbyggda rapporteringsalternativ
- Distribuerad avfrågning är inte utformad för fjärrplatser
Learn more about LibreNMS: Bäst för syntetisk nätverksövervakning
- Gratisplan + 14 dagars provperiod + gratis demo tillgänglig
- Från $249/månad
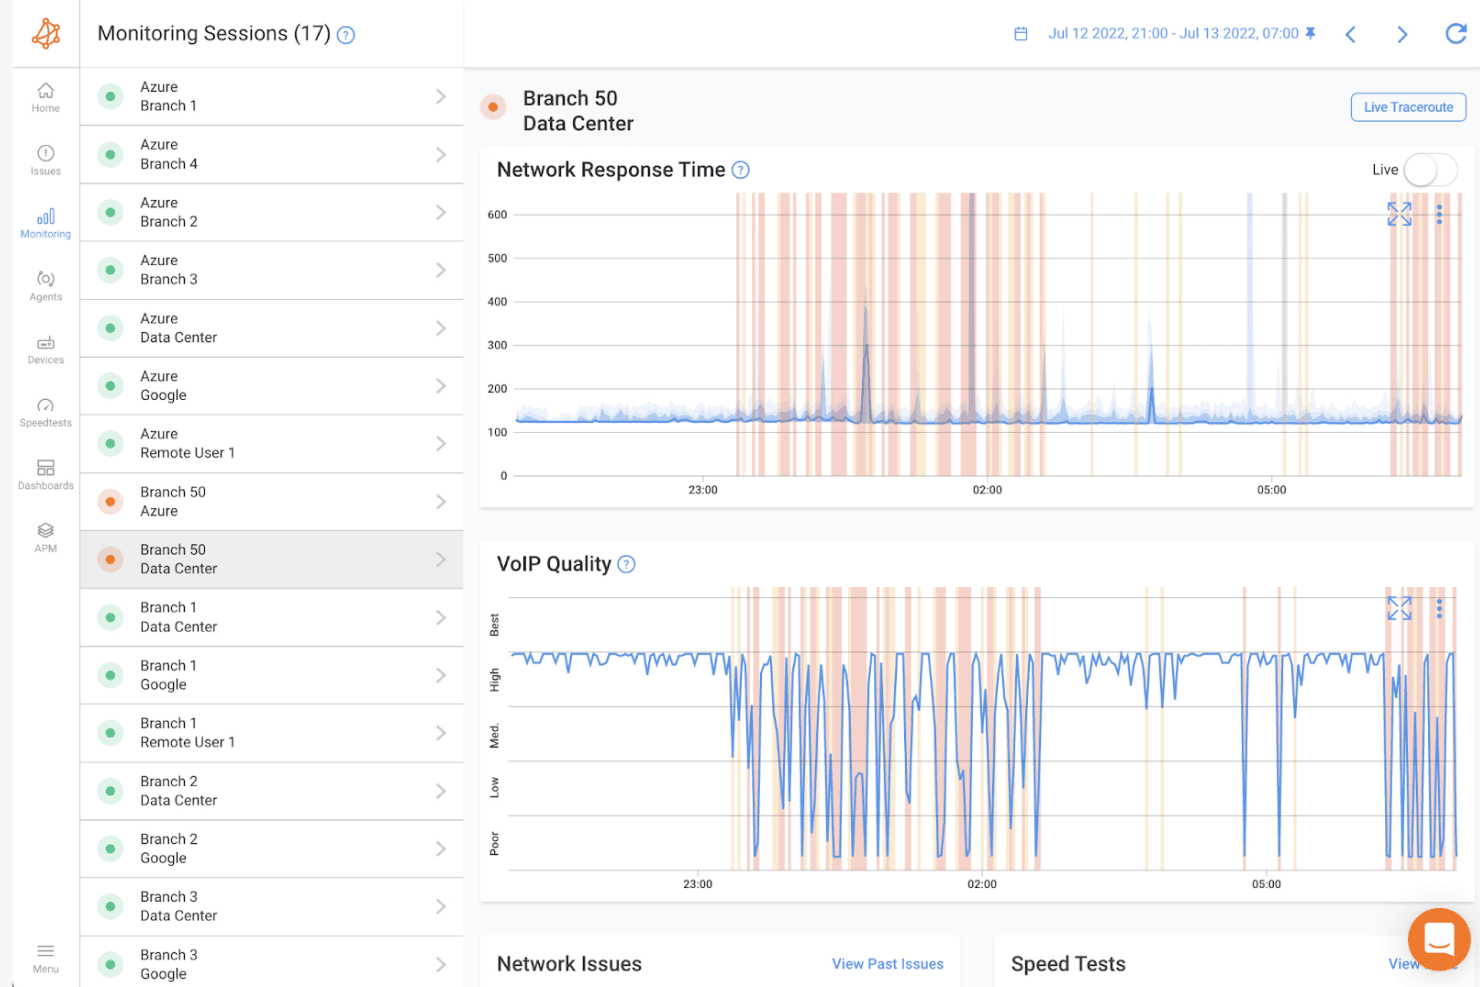
Obkios övervakningspanel som följer nätverkets svarstid och VoIP-kvalitet mellan sessioner på filialer och datacenter. Obkio är ett molnbaserat verktyg för övervakning av nätverksprestanda som använder syntetisk trafik mellan distribuerade agenter för att hjälpa nätverksadministratörer och MSP:er att upptäcka, diagnostisera och felsöka problem med fördröjning, paketförlust och anslutning i miljöer med flera platser.
Vem passar Obkio bäst för?
Obkio passar bra för nätverksadministratörer och MSP-tekniker som behöver övervaka prestanda i distribuerade miljöer med flera platser med hjälp av syntetisk trafik.
Varför jag valde Obkio
Obkio tar plats på min kortlista tack vare sitt annorlunda sätt att hantera nätverksövervakning jämfört med PRTG: i stället för att fråga enheter från en enda punkt distribuerar verktyget agenter på varje plats och utbyter kontinuerligt syntetisk UDP-trafik mellan dem var 500:e millisekund. Jag uppskattar särskilt korddiagrammet, som ger en direkt, dubbelriktad bild av anslutningarnas status på alla platser. Funktionen Obkio Insights korrelerar också automatiskt prestandadata, SNMP-mätvärden och traceroute-resultat för att identifiera en sannolik grundorsak utan manuellt analysarbete.
Viktiga funktioner i Obkio
- Övervakning av SNMP-enheter: Övervakar routrar, switchar, brandväggar och trådlösa åtkomstpunkter och samlar automatiskt in information om CPU-användning, bandbreddsutnyttjande, gränssnittsfel och tillgänglighet via SNMP v1, v2c eller v3.
- Visuella traceroutes: Kör kontinuerliga, automatiska traceroutes parallellt med övervakningssessioner och visar fördröjning per hopp, paketförlust och jitter i interaktiva, färgkodade sökvägskartor.
- Aviseringar via flera kanaler: Skickar tröskelbaserade aviseringar via e-post, Slack, Microsoft Teams, PagerDuty, ServiceNow eller HTTP-webhooks, med konfigurerbara allvarlighetsnivåer och smart gruppering av händelser.
- Schemalagd rapportering: Genererar automatiskt Excel-, PDF- eller JSON-rapporter dagligen, veckovis eller månadsvis och skickar dem via e-post till mottagare som inte behöver ett Obkio-konto.
Integrationer med Obkio
Obkio erbjuder fyra dokumenterade inbyggda integrationer: Microsoft Teams, PagerDuty, ServiceNow och Slack. Det har även stöd för HTTP-webhooks för aviseringar och färdiga rapporter, men något allmänt offentligt API var inte dokumenterat.
Pros and Cons
Pros:
- Dubbelriktad insyn mellan distribuerade platser
- Syntetiska sonder upptäcker kortvariga försämringar i WAN-prestandan
- Recensenter berömmer tydliga visualiseringar av nätverkets status
Cons:
- Enhetsfrågor är beroende av lokala insamlingsagenter
- Recensenter vill ha bättre exportmöjligheter för historiska rapporter
Learn more about Obkio: 10Bäst för automatiserad nätverkskartläggning
Auvik
- 14 dagars kostnadsfri provperiod + demo tillgänglig
- Prisuppgift på begäran
Visit WebsiteCustomer Rating:4.7/5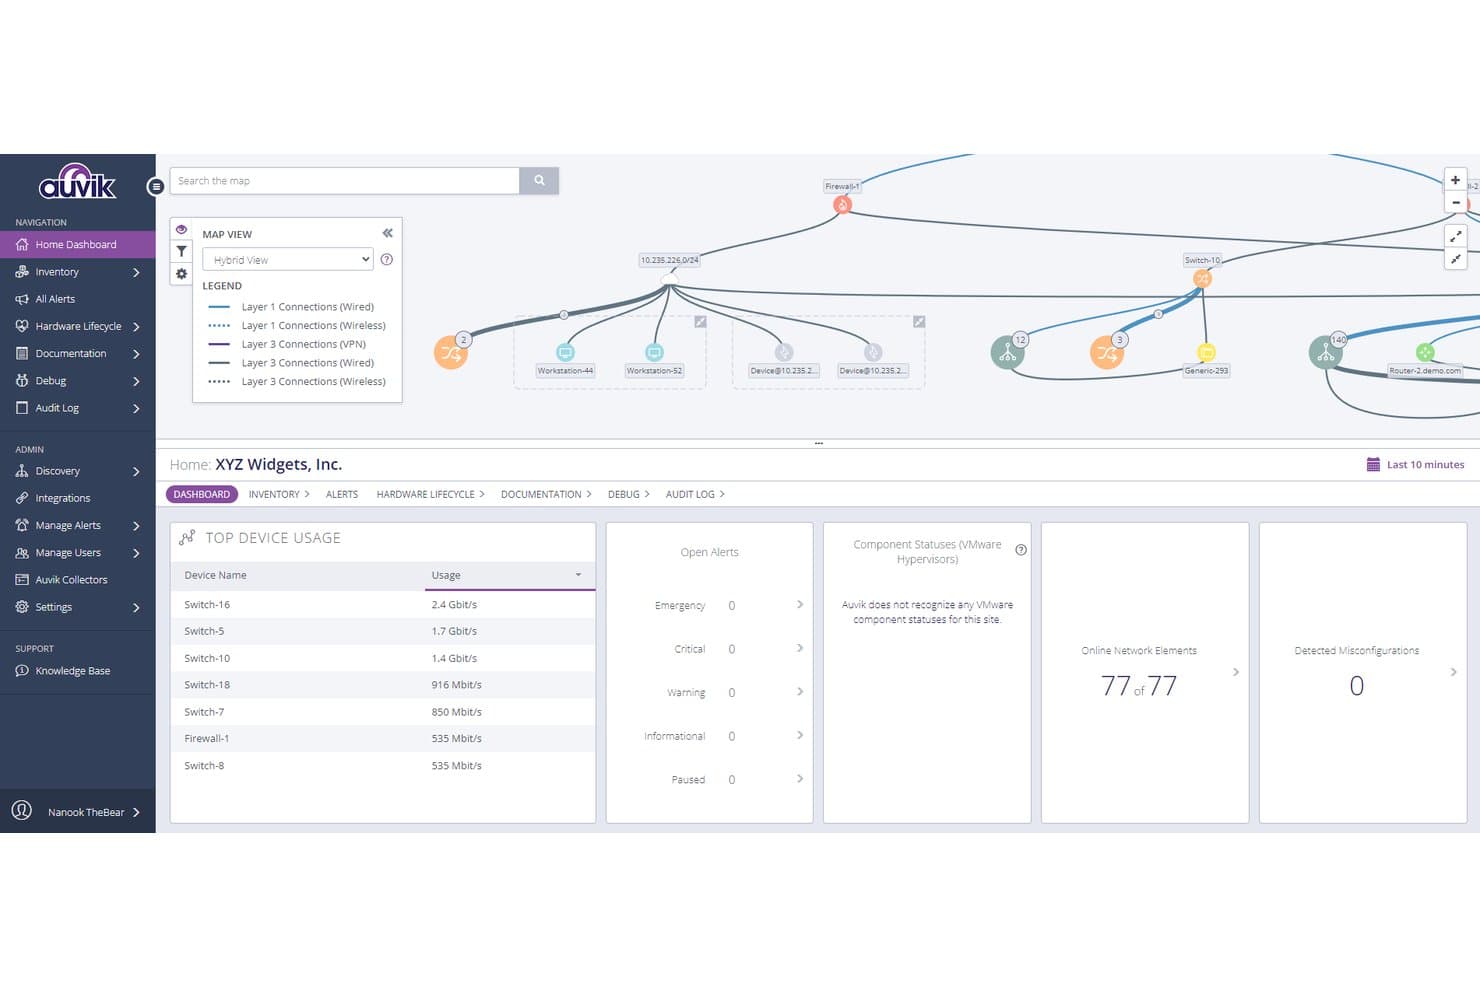
Auviks startsida kombinerar en livekarta över nätverket med sammanfattningar av enhetsanvändning och varningar. Auvik är en molnbaserad plattform för nätverkshantering, byggd för IT-team och MSP:er som behöver automatiserad enhetsidentifiering, livekartläggning av topologi och insyn i flera platser utan det manuella arbete som krävs för att dokumentera och underhålla nätverksregister.
Vem passar Auvik bäst för?
Auvik passar naturligt för MSP-tekniker och nätverksadministratörer som behöver övervaka och dokumentera klientmiljöer på flera platser utan att lägga timmar på manuell identifiering och kartläggning.
Varför jag valde Auvik
Jag valde Auvik som ett av de bästa alternativen eftersom automatisk nätverkskartläggning är ett område där det verkligen överträffar det PRTG erbjuder direkt ur lådan. Så snart en insamlare har distribuerats identifierar Auvik alla IP-anslutna enheter och återger en livekarta över topologin i lager 1, 2 och 3, som uppdateras kontinuerligt när nätverket förändras. Jag uppskattar särskilt att historiska ögonblicksbilder av topologin sparas, så att jag kan se exakt hur nätverket såg ut innan en incident inträffade.
Auviks viktigaste funktioner
- Analys av trafik i flera lager: Auvik samlar in NetFlow v5/v9-, J-Flow-, IPFIX- och sFlow-data för att visa de mest trafikintensiva enheterna, bandbreddskrävande applikationer och trafikfördelningar på protokollnivå i hela nätverket.
- Automatiserade konfigurationssäkerhetskopior: Auvik säkerhetskopierar kontinuerligt enhetskonfigurationer, spårar versionshistorik och låter dig jämföra ändringar sida vid sida för revision och felsökning.
- Förkonfigurerat varningsbibliotek: Auvik levereras med över 50 färdiga varningar som täcker enhetsstatus, gränssnittsutnyttjande, paketfel, latens, jitter och syslog-händelser, med anpassningsbara tröskelvärden.
- Integrationer med MSP-verktyg: Auvik ansluter integrerat till ConnectWise Manage, Datto Autotask och IT Glue för att synkronisera enhetsinventarier och hantera ärenden i båda riktningarna mellan klientmiljöer.
Auvik-integrationer
Auvik har integrerade anslutningar till ConnectWise Manage, Datto Autotask, ServiceNow, PagerDuty, Slack, Microsoft Teams och Opsgenie. Plattformen tillhandahåller även API:er och webhooks för anpassade integrationer, inklusive en generell inkommande webhook.
Pros and Cons
Pros:
- Automatiserade topologikartor snabbar upp felsökningen
- Centraliserade vyer omfattar flera klientplatser
- Konfigurationshistoriken hjälper till att spåra nätverksändringar
Cons:
- Vissa kartor kräver manuell rensning
- Standardvarningar kan skapa störande falska positiva resultat
Learn more about Auvik:
Andra alternativ till PRTG
Här är några ytterligare alternativ till PRTG som inte kom med på min kortlista, men som ändå är värda att kolla in:
Related Reviews
Hur jag utvärderar PRTG-alternativ
Jag delar upp min utvärdering i två lager: de grundläggande funktionerna – som SNMP-enhetsövervakning och tröskelbaserad avisering – som ett verktyg måste ha för att ersätta PRTG, samt de särskiljande faktorer som skiljer alternativen åt.
Grundläggande funktioner (minimikrav för den här listan)
När jag väljer verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje grundläggande funktion som anges nedan. Därefter omvandlar jag verktygets totala poäng till en procentandel. Varje verktyg måste uppnå en minsta totalpoäng på 65 % för att övervägas för inkludering.
- Övervakning av nätverksenheter: Jag kontrollerar stöd för flera protokoll (SNMP, ICMP, NetFlow) och färdiga mallar som omfattar routrar, switchar, brandväggar och trådlösa åtkomstpunkter från större leverantörer.
- Server- och infrastrukturövervakning: Varje verktyg bör spåra mätvärden på operativsystemnivå i Windows och Linux samt stödja VMware, Hyper-V, containrar och molnleverantörer som AWS och Azure.
- Aviserings- och notifieringssystem: Jag granskar hur detaljerad konfigurationen av tröskelvärden är och vilka leveransalternativ för flera kanaler som finns, inklusive om aviseringar kan integreras med verktyg som PagerDuty, Slack eller Teams.
- Instrumentpaneler och visualisering: Instrumentpaneler i realtid med topologikartor och detaljerade vyer är viktiga här, särskilt för NOC-team som behöver en överblick över statusen för hundratals enheter.
- Historisk rapportering och analys: Jag utvärderar flexibiliteten i datalagringen, möjligheten att generera SLA- och drifttidsrapporter samt om trender för kapacitetsplanering enkelt kan tas fram för presentationer för intressenter.
- Automatisk upptäckt och skalbarhet: Verktyget bör automatiskt skanna och kartlägga tillgångar, och jag lägger stor vikt vid hur licensiering och arkitektur hanterar tillväxt över distribuerade platser.
När jag har en lista över verktyg som uppfyller detta kriterium överväger jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
AI-baserad avvikelsedetektering är en viktig särskiljande faktor. Verktyg som fastställer normala trafikmönster och markerar avvikelser upptäcker problem som statiska tröskelvärden helt missar – exempelvis en långsam minnesläcka på en produktionsserver. Jag letar också efter inbyggd logghantering, eftersom en korrelation av syslogdata med prestandamätvärden under ett avbrott sparar mycket tid jämfört med att växla mellan separata verktyg. För MSP-team avgör stöd för flera klienter med klientisolering och varumärkesanpassade instrumentpaneler om en plattform kan skalas över kundmiljöer.
Utöver funktionerna
Licensstrukturen har stor betydelse när du byter från PRTG. Jag utvärderar om prissättningen skalas förutsägbart när du lägger till enheter – modeller med licensiering per sensor kan snabbt bli dyra i en miljö med 1 000 noder. Flexibilitet vid driftsättning är en annan faktor jag kontrollerar, eftersom vissa team behöver lokala installationer för isolerade nätverk medan andra föredrar SaaS. Jag tar också hänsyn till integrationsekosystemet, särskilt inbyggda anslutningar till ITSM-verktyg som ServiceNow eller Jira, eftersom övervakningsdata är mest användbar när den matas direkt in i arbetsflödena för incidenthantering.
Varför leta efter ett alternativ till PRTG?
PRTG är ett bra val bland övervakningsverktyg, men det finns flera anledningar till att vissa användare söker alternativa lösningar. Du kanske letar efter ett alternativ till PRTG eftersom…
- Du behöver bättre skalbarhet för växande nätverk
- Du letar efter fler anpassningsmöjligheter
- Ditt team behöver enklare integration med molntjänster
- Du behöver mer avancerade analysfunktioner
- Du söker ett mer intuitivt användargränssnitt
Om något av detta stämmer in på dig har du kommit rätt. Min lista innehåller flera alternativ bland övervakningsverktyg som passar bättre för team som möter dessa utmaningar med PRTG och letar efter alternativa och kostnadseffektiva lösningar.
Viktiga funktioner i PRTG
Här är några av de viktigaste funktionerna i PRTG, så att du kan jämföra vad alternativa lösningar erbjuder:
- Nätverks- och serverövervakning: Tillhandahåller övervakning i realtid av routrar, switchar, brandväggar och annat, vilket säkerställer att nätverket fungerar smidigt.
- Bandbreddsövervakning: Spårar bandbreddsanvändningen för att hjälpa dig förstå trafikmönster i nätverket och förhindra flaskhalsar.
- Anpassningsbara instrumentpaneler: Erbjuder kartor och instrumentpaneler i realtid som du kan anpassa för att visa de viktigaste mätvärdena för ditt team.
- Varningar och aviseringar: Skickar anpassningsbara varningar via e-post, SMS eller pushaviseringar för att hålla dig informerad om eventuella problem.
- Distribuerad övervakning: Möjliggör centraliserad övervakning av flera fjärrplatser och datacenter, vilket ger en fullständig överblick över hela nätverket.
- Anpassad rapportering: Gör det möjligt för dig att skapa skräddarsydda rapporter för att effektivt kommunicera statusen för din IT-infrastruktur.
- SNMP-övervakning: Stöder SNMP för övervakning av olika nätverksenheter, vilket säkerställer kompatibilitet med ett stort antal typer av maskinvara.
- Wi-Fi-övervakning: Övervakar Wi-Fi-nätverk för att säkerställa tillförlitlig anslutning och prestanda i hela den trådlösa infrastrukturen.