

10 bästa MLOps-verktygen 2026
Bästa MLOps-verktygen – kortlista


MLOps-verktyg är plattformar och ramverk som hjälper dig att automatisera, hantera och övervaka hela livscykeln för maskininlärning – från dataförberedelse till driftsättning och underhåll av modeller. Om du letar efter de bästa MLOps-verktygen vill du sannolikt minska manuellt arbete, förbättra samarbetet och hålla dina maskininlärningsprojekt tillförlitliga och skalbara. I den här listan hittar du beprövade alternativ som hanterar verkliga utmaningar som versionshantering, reproducerbarhet och säker driftsättning, så att du kan välja det alternativ som passar bäst för ditt teams arbetsflöde och verksamhetens behov.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Sammanfattning av de bästa MLOps-verktygen
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av MLOps-verktyg för att hjälpa dig att hitta det bästa alternativet för din budget och verksamhetens behov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för samarbetsinriktade arbetsflöden baserade på anteckningsböcker | 14 dagars kostnadsfri provperiod + kostnadsfri plan tillgänglig | Pris på begäran | Website | |
| 2 | Bäst för enhetlig hantering av data och tillgångar | Gratisabonnemang tillgängligt | Prisuppgift på begäran | Website | |
| 3 | Bäst för observerbarhet i LLM-applikationer | Gratisplan tillgänglig | Från $39/användare/månad | Website | |
| 4 | Bäst för säkerhet och efterlevnad på företagsnivå | 30 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 5 | Bäst för integrering med funktionslager | Gratisabonnemang + gratisdemo tillgänglig | Från $0.35/credit | Website | |
| 6 | Bäst för automatiserad versionshantering av pipelines | 14 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 7 | Bäst för dynamisk skalning av resurser | Gratisabonnemang tillgängligt | Från $15/användare/månad | Website | |
| 8 | Bäst för Kubernetes-inbyggd orkestrering av arbetsflöden | Gratisabonnemang tillgängligt | Gratis och med öppen källkod | Website | |
| 9 | Bäst för experimentspårning och reproducerbarhet | Gratis demo tillgänglig | Prisuppgift på begäran | Website | |
| 10 | Bäst för hanterad molnbaserad modelldistribution | Gratisplan tillgänglig | Från $0.204/timme | Website |

Recensioner av de bästa MLOps-verktygen
Nedan följer mina detaljerade sammanfattningar av de bästa MLOps-verktygen som kom med på min kortlista. I mina recensioner får du en detaljerad inblick i funktionerna, integrationerna och de bästa användningsområdena för varje plattform, så att du kan hitta det bästa alternativet för dig.
Bäst för samarbetsinriktade arbetsflöden baserade på anteckningsböcker
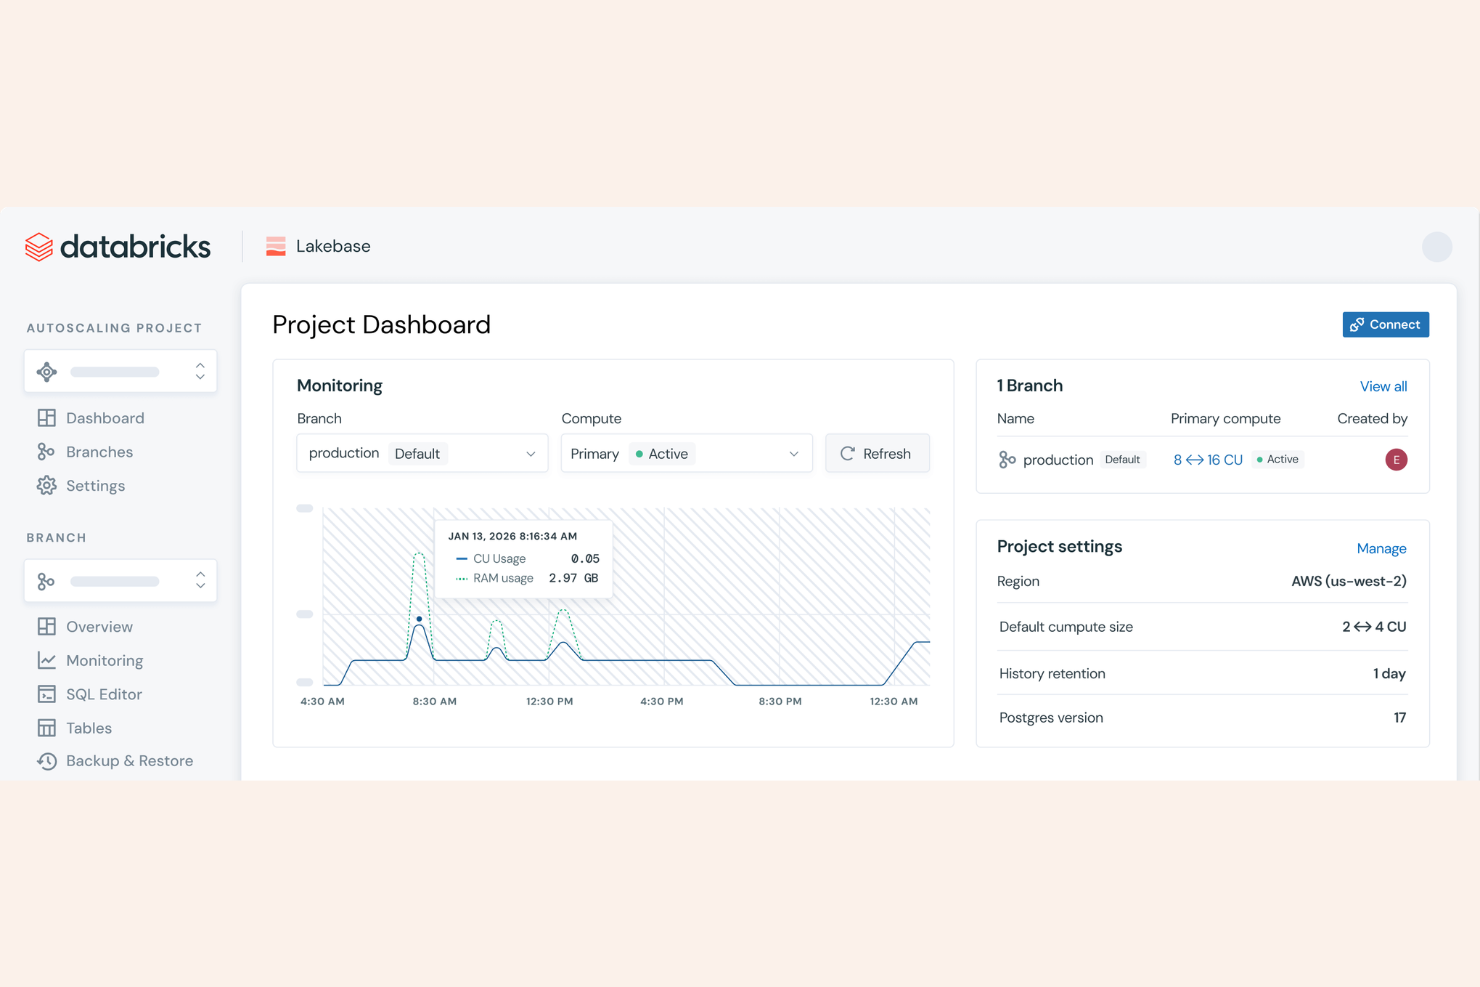
Databricks är en enhetlig plattform för analys och MLOps som samlar samarbetsinriktade anteckningsböcker, skalbar beräkningskapacitet, automatiserade arbetsflöden för maskininlärning och integrerad datahantering för team som bygger och distribuerar maskininlärningsmodeller.
Vem passar Databricks bäst för?
Datateknik- och datavetenskapsteam på medelstora till stora företag som behöver molnbaserade, samarbetsinriktade arbetsflöden för maskininlärning.
Varför jag valde Databricks
Jag valde Databricks som en av de bästa lösningarna eftersom jag kan konfigurera samarbetsinriktade anteckningsboksmiljöer där mitt team arbetar tillsammans med kod, data och resultat i realtid. Jag uppskattar att Databricks stöder versionshanterade arbetsflöden och låter oss följa experiment direkt i arbetsytan. Mitt team använder den inbyggda MLflow-integrationen för att hantera modellernas livscykel och reproducerbarhet utan att lämna anteckningsboksgränssnittet.
Viktiga funktioner i Databricks
- Delta Lake-integration: Lagra och hantera storskaliga data med ACID-transaktioner.
- Jobb schemaläggning: Automatisera och orkestrera data- och ML-arbetsflöden med inbyggda schemaläggningsverktyg.
- Rollbaserad åtkomstkontroll: Hantera användarbehörigheter och datasäkerhet på detaljerad nivå.
- Kluster med automatisk skalning: Justera beräkningsresurser dynamiskt utifrån arbetsbelastningens behov.
Databricks-integrationer
Databricks erbjuder över 40 inbyggda integrationer, däribland Apache Spark, Delta Lake, MLflow, Tableau, Power BI, GitHub, GitLab, Snowflake, Amazon S3, Azure Data Lake och Zapier, samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Samarbetsinriktade anteckningsböcker stöder redigering i realtid för team
- Inbyggd MLflow-integration för modellspårning
- Delta Lake möjliggör tillförlitlig versionshantering av data
Cons:
- Det kan ta lång tid att starta kluster
- Kostnaderna kan vara oförutsägbara vid hög arbetsbelastning

Bäst för enhetlig hantering av data och tillgångar
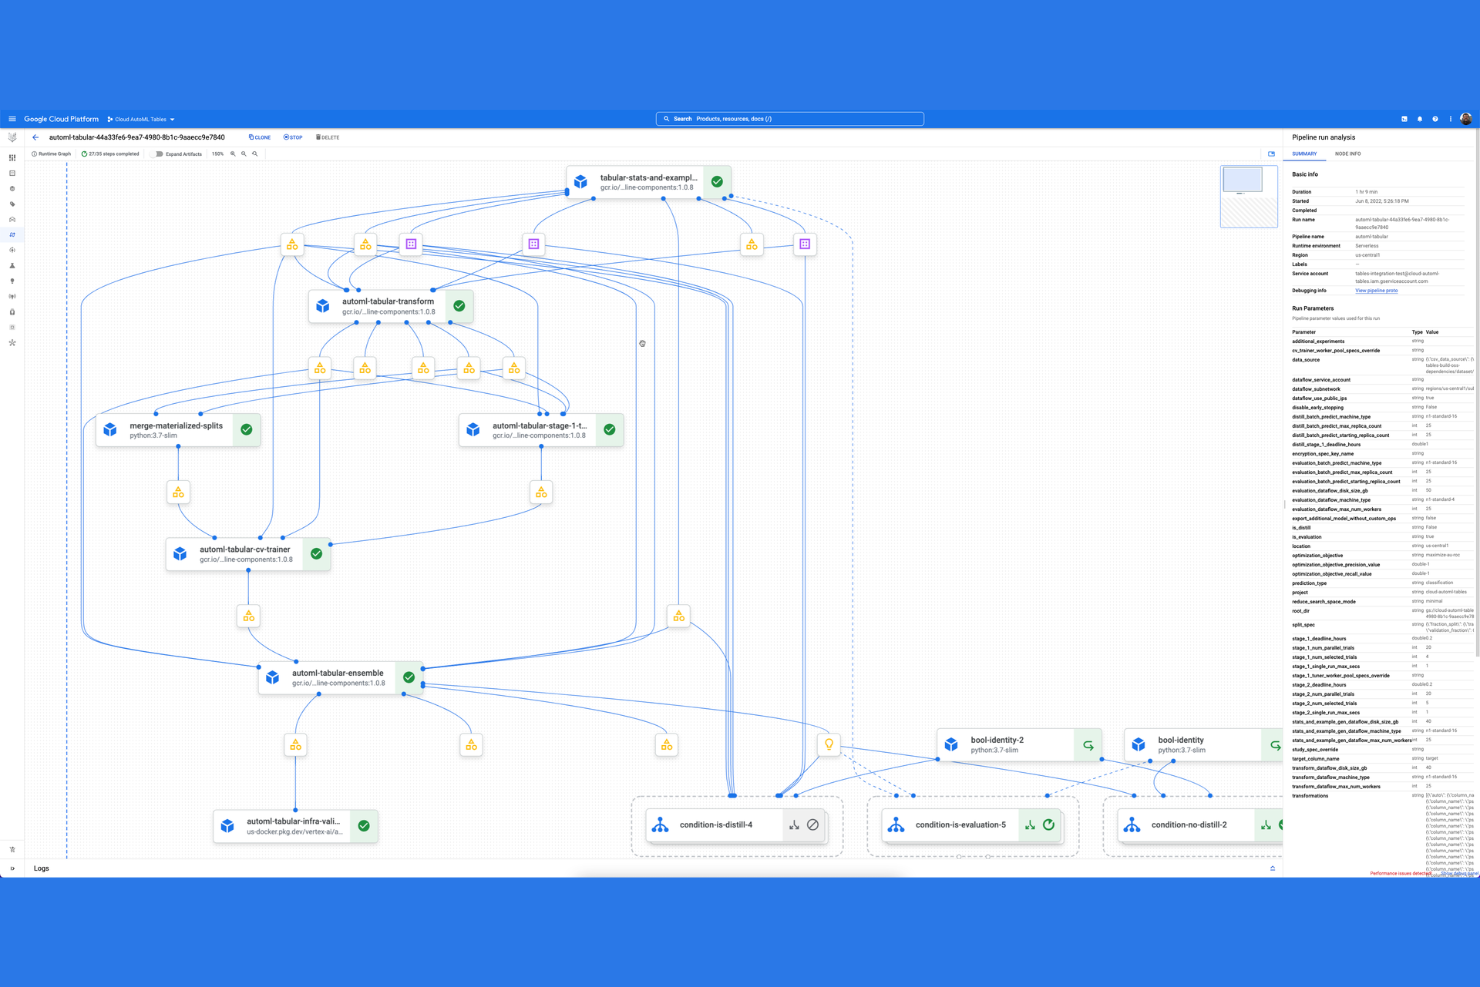
Vertex AI är en molnbaserad MLOps-plattform från Google Cloud som låter dig bygga, distribuera och hantera maskininlärningsmodeller med integrerad datamärkning, experimentuppföljning och automatiserade pipelines.
Vem passar Vertex AI bäst för?
Datavetenskapliga team på stora organisationer som behöver enhetlig hantering av modeller, data och tillgångar i Google Cloud.
Varför jag valde Vertex AI
Jag valde Vertex AI som en av de bästa lösningarna eftersom jag kan hantera alla mina modeller, datamängder och artefakter i en enda arbetsyta, vilket håller mitt team organiserat och redo för granskning. Jag gillar att Vertex AI:s Feature Store låter oss återanvända funktioner mellan projekt utan att duplicera arbete. Mitt team använder också Vertex AI Pipelines för att automatisera och följa upp varje steg i våra arbetsflöden för maskininlärning.
Viktiga funktioner i Vertex AI
- Integrerade anteckningsböcker: Starta Jupyter-baserade anteckningsböcker direkt på plattformen för kodutveckling och experiment.
- Inbyggd modellövervakning: Följ distribuerade modeller för prediktionsdrift och problem med datakvaliteten.
- Vertex AI Workbench: Få tillgång till en hanterad utvecklingsmiljö med förinstallerade bibliotek för maskininlärning.
- Förtränade API:er: Använd Googles färdiga API:er för distribution för uppgifter inom bildanalys, språk och strukturerade data.
Vertex AI-integreringar
Vertex AI erbjuder inbyggda integreringar med BigQuery, Looker, Dataproc, Dataflow, Google Cloud Storage, Google Kubernetes Engine, Cloud Functions, Pub/Sub och det bredare Google Cloud-ekosystemet, med ett API tillgängligt för anpassade integreringar.
Pros and Cons
Pros:
- Händelsestyrda automatiska återställningar av modeller
- Deklarativ pipelinehantering via Ansible
- Inbyggt stöd för BigQuery ML-integrering
Cons:
- Begränsat stöd för molnplattformar som inte kommer från Google
- Betydande kvoter för instanser av anteckningsböcker
Bäst för observerbarhet i LLM-applikationer
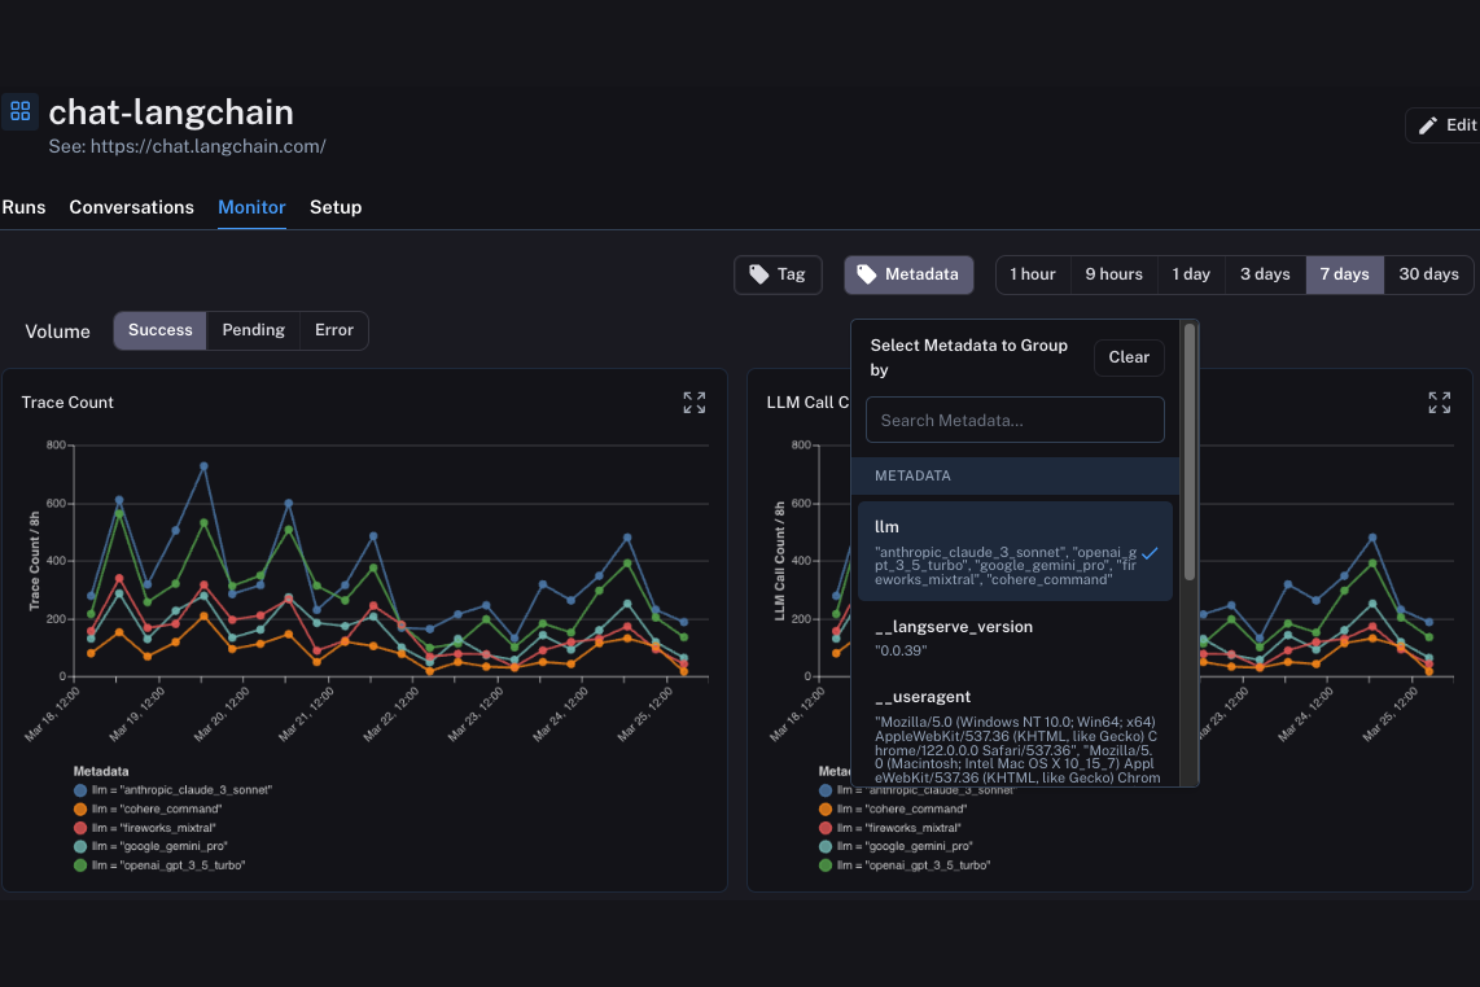
LangSmith är en MLOps-plattform för team som utvecklar LLM-drivna applikationer och erbjuder experimentspårning, datauppsättningshantering, utvärderingsverktyg och detaljerad spårning av prompt- och kedjekörningar.
Vem passar LangSmith bäst för?
LangSmith passar bra för ML-ingenjörer och datavetare som utvecklar, testar och övervakar LLM-drivna applikationer.
Varför jag valde LangSmith
Jag valde LangSmith som ett av de bästa alternativen eftersom jag kan spåra, felsöka och utvärdera varje steg i mina LLM-applikationspipelines i detalj. Jag uppskattar att jag kan logga promptkörningar, kedjekörningar och modellutdata för detaljerad observerbarhet. Mitt team använder dess experimentspårning och datauppsättningshantering för att jämföra LLM-versioner och övervaka beteendet i produktion i realtid.
Viktiga funktioner i LangSmith
- Rollbaserad åtkomstkontroll: Hantera användarbehörigheter och dataåtkomst för olika projekt.
- Anpassade utvärderingsmått: Definiera och följ upp dina egna mått för LLM-utdata.
- Versionshantering av datauppsättningar: Lagra och hantera flera versioner av datauppsättningar för reproducerbarhet.
- API-integration: Anslut LangSmith till dina befintliga MLOps-arbetsflöden med hjälp av dess API.
LangSmith-integrationer
LangSmith erbjuder inbyggda integrationer med LangChain, OpenAI, Anthropic, Hugging Face, Weights & Biases, Slack och Zapier samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Detaljerad spårning av LLM-promptkörningar
- Inbyggd integration med LangChain och OpenAI
- Stöder anpassade utvärderingsmått och datauppsättningar
Cons:
- Begränsat stöd för icke-LLM-modelltyper
- Inget hanterat SaaS- eller värdalternativ

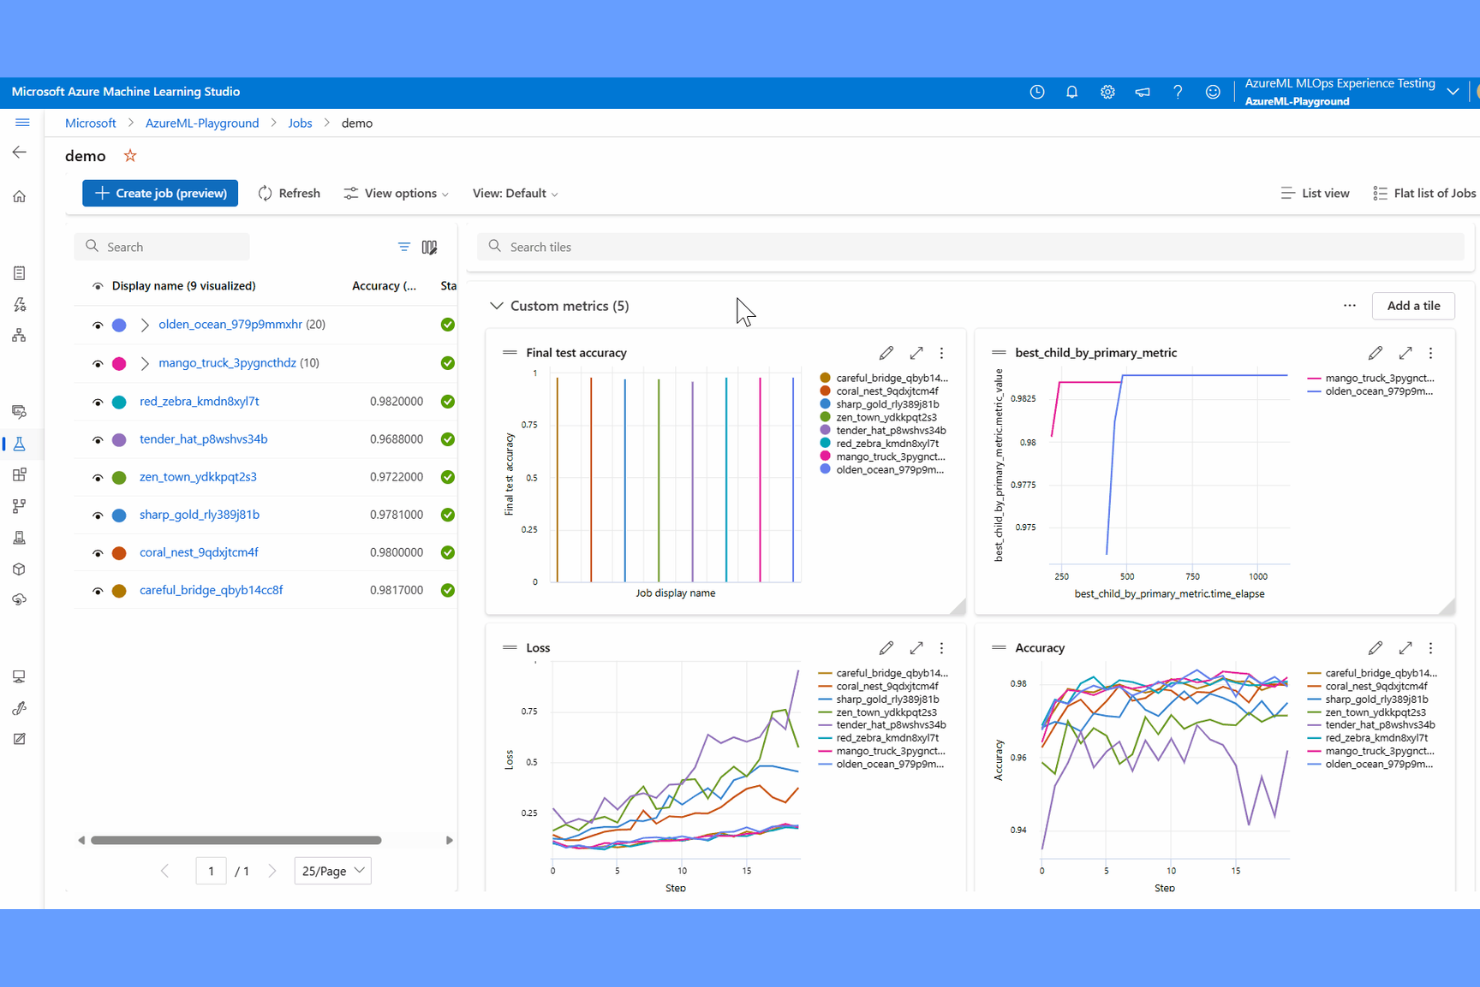
Azure Machine Learning är en molnbaserad MLOps-plattform för att bygga, träna, distribuera och hantera maskininlärningsmodeller med automatiserade pipelines, versionskontroll och integrerad övervakning.
Vem passar Azure Machine Learning bäst för?
Datavetenskapsteam på företag i reglerade branscher som behöver avancerade säkerhets- och efterlevnadskontroller.
Varför jag valde Azure Machine Learning
Jag valde Azure Machine Learning som en av de bästa lösningarna eftersom jag kan konfigurera maskininlärningsarbetsflöden från början till slut med inbyggt stöd för säkerhetsstandarder för företag, såsom privata slutpunkter och hanterade identiteter. Mitt team använder rollbaserad åtkomstkontroll och granskningsspår för att uppfylla efterlevnadskraven. Jag uppskattar också att vi kan distribuera modeller i isolerade miljöer för projekt med känsliga data.
Viktiga funktioner i Azure Machine Learning
- Automatiserad maskininlärning: Väljer automatiskt algoritmer och justerar hyperparametrar för modellträning.
- Projekt för datamärkning: Skapa och hantera arbetsflöden för datamärkning med mänsklig medverkan.
- Modellregister: Lagra, versionshantera och hantera maskininlärningsmodeller för distribution.
- Integrerade notebook-miljöer: Utveckla och kör kod i Jupyter-baserade notebook-miljöer på plattformen.
Integrationer med Azure Machine Learning
Azure Machine Learning erbjuder integreringar med Microsofts ekosystem, bland annat Microsoft 365, Azure och Power BI, samt GitHub, Databricks, TensorFlow, PyTorch och Zapier. Ett API finns tillgängligt för anpassade integreringar.
Pros and Cons
Pros:
- Djupgående integrering med Power BI-rapportering
- Automatiserade maskininlärningsarbetsflöden med lite kod
- Inbyggd säkerhet med Microsoft Entra ID
Cons:
- Högre kostnad för reserverad kapacitet
- Manuell genomgång av loggar för felsökning
Bäst för integrering med funktionslager
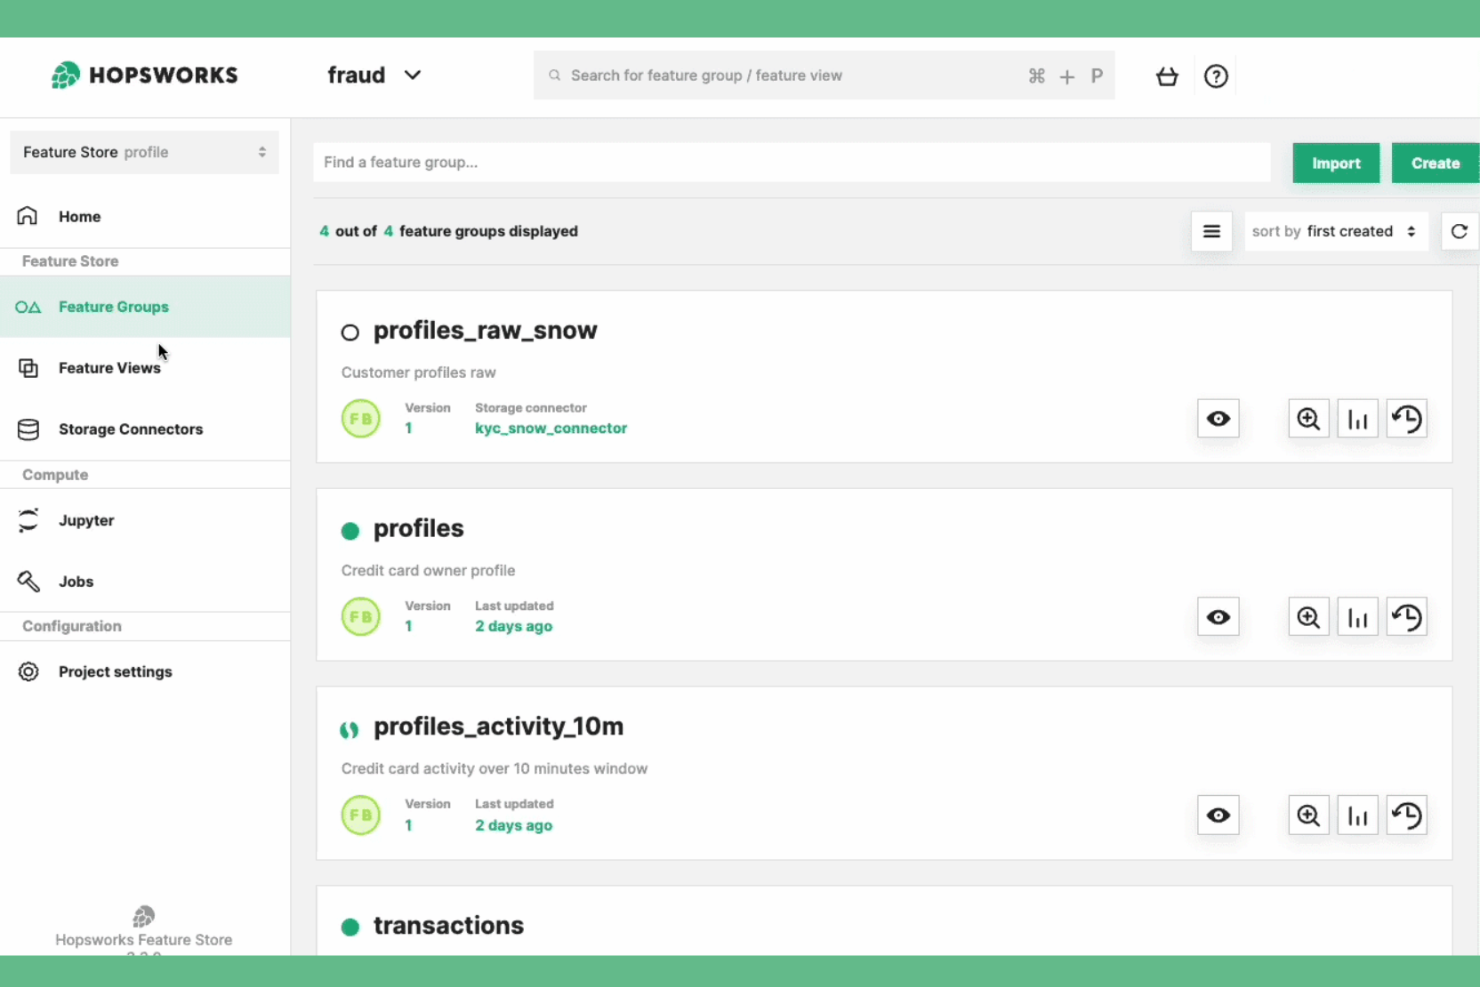
Hopsworks är en MLOps-plattform byggd för team som behöver en enhetlig miljö för funktionsutveckling, modellträning, dataversionshantering och samarbetsinriktade maskininlärningsarbetsflöden.
Vem passar Hopsworks bäst för?
Datavetenskapliga team på företag eller inom reglerade branscher som behöver avancerade funktioner för funktionslager för maskininlärning i produktion.
Varför jag valde Hopsworks
Jag valde Hopsworks som en av de bästa plattformarna eftersom jag kan hantera och dela funktioner mellan projekt med hjälp av dess integrerade funktionslager. Mitt team använder plattformens dataversionshantering och spårning av datahärkomst för att säkerställa reproducerbarhet i våra ML-pipelines. Jag uppskattar också att Hopsworks stöder både batchbaserad och realtidsbaserad leverans av funktioner, vilket gör att vi kan distribuera modeller som är beroende av färska data.
Hopsworks viktigaste funktioner
- Integrering med notebook-miljöer: Arbeta direkt med Jupyter- och Databricks-notebook-miljöer för interaktiv utveckling.
- Rollbaserad åtkomstkontroll: Ange detaljerade behörigheter för användare och team i olika projekt.
- Datavalidering: Validera och övervaka automatiskt funktionsdata för kvalitet och konsekvens.
- REST- och Python-API:er: Få åtkomst till och hantera funktioner programmatiskt för automatisering och integrering.
Hopsworks-integreringar
Hopsworks erbjuder inbyggda integreringar med Databricks, Snowflake, Amazon S3, Google Cloud Storage, Azure Data Lake, Apache Kafka, Apache Spark, TensorFlow, PyTorch och Zapier, samt ett API för anpassade integreringar.
Pros and Cons
Pros:
- Projektbaserad multitenans för känsliga data
- Integrerad Spark- och Flink-bearbetning
- GDPR-kompatibel säker lagring av tillgångar
Cons:
- Stor påverkan på den operativa infrastrukturen
- Kräver särskild hantering av conda-miljöer

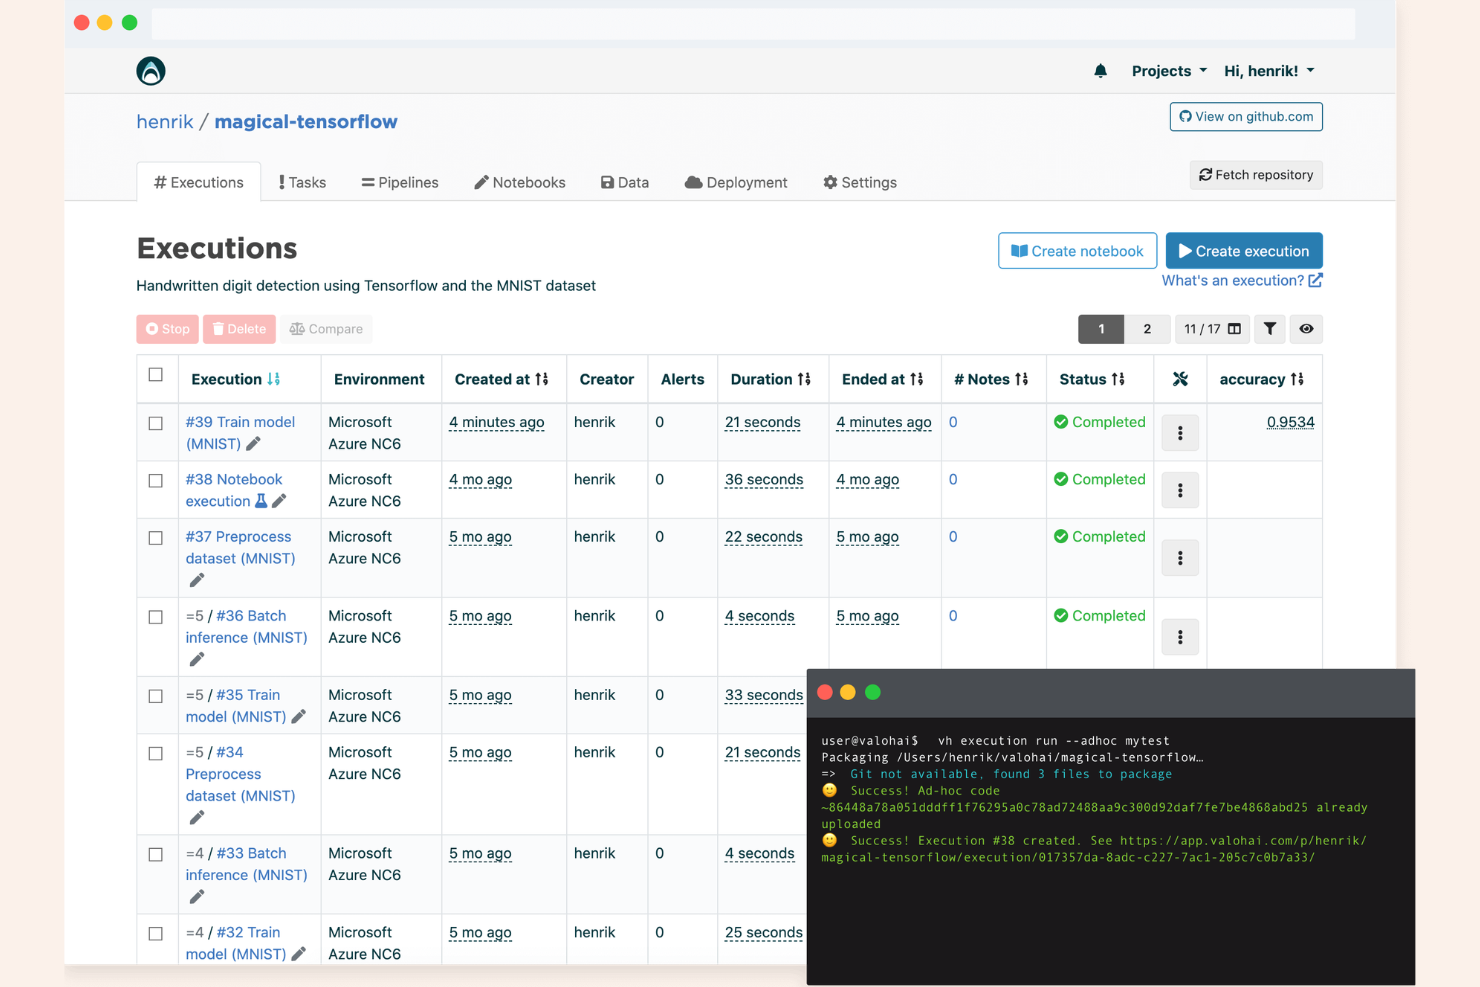
Valohai är en MLOps-plattform från början till slut, utformad för team som behöver automatiserad orkestrering av maskininlärningspipelines, reproducerbarhet och samarbete över moln- och lokala miljöer.
Vem passar Valohai bäst för?
Valohai passar bra för datavetenskaps- och ML-team på medelstora till stora företag som behöver automatiserade, versionshanterade pipelines för komplexa arbetsflöden inom maskininlärning.
Varför jag valde Valohai
Jag valde Valohai som en av de bästa lösningarna eftersom jag förlitar mig på dess automatiserade versionshantering av pipelines för att hålla varje experiment, datauppsättning och kodändring fullt spårbar. Jag uppskattar hur mitt team kan starta reproducerbara pipelines i valfri moln- eller lokal miljö utan manuell konfiguration. Den visuella pipeline-redigeraren och den automatiska insamlingen av metadata gör det enkelt för oss att granska och återställa arbetsflöden allt eftersom våra projekt utvecklas.
Viktiga funktioner i Valohai
- Parallell körning: Kör flera experiment eller träningsjobb samtidigt i olika miljöer.
- Dataversionshantering: Spåra och hantera varje datauppsättning som används i dina arbetsflöden.
- Stöd för anpassade miljöer: Definiera och använd valfri Docker-avbildning eller körtidsmiljö för dina uppgifter.
- API-åtkomst: Integrera Valohai med externa system och automatisera arbetsflöden med hjälp av ett REST-API.
Valohai-integreringar
Valohai erbjuder inbyggda integreringar med Azure, Google Cloud Platform, OpenStack, Kubernetes, Spark, Hugging Face, SuperGradients och V7 Labs, samt ett API och webhooks för anpassade integreringar och CI/CD-arbetsflöden.
Pros and Cons
Pros:
- Automatisk versionshantering av varje körning
- Språkneutral kapacitet för kodkörning
- Inbyggd orkestrering av hybridmoln
Cons:
- Kräver extern hantering av Docker-avbildningar
- Inget integrerat användargränssnitt för modelldistribution


ClearML är en MLOps-plattform för team som behöver experimentspårning, orkestrering, datahantering och automatisering på ett och samma ställe, med fokus på flexibel infrastruktur och skalbara arbetsflöden.
Vem passar ClearML bäst för?
ClearML passar bra för datavetenskaps- och ML-teknikteam på medelstora till stora organisationer som hanterar komplexa, distribuerade arbetsflöden för maskininlärning.
Varför jag valde ClearML
Jag valde ClearML som ett av de bästa alternativen eftersom jag kan skala beräkningsresurser dynamiskt för tränings- och inferensjobb utan manuella ingrepp. Mitt team använder orkestreringsfunktionerna för att automatisera arbetsbelastningsfördelningen mellan lokala och molnbaserade miljöer. Jag uppskattar också hur ClearML:s resurshantering låter oss optimera användningen av GPU och CPU för kostnad och prestanda.
Viktiga funktioner i ClearML
- Experimentspårning: Logga, jämför och återskapa maskininlärningsexperiment automatiskt.
- Dataversionering: Spåra och hantera dataset och datahärkomst mellan projekt.
- Automatisering av pipelines: Skapa och schemalägg ML-arbetsflöden från början till slut med visuella verktyg.
- Modellregister: Lagra, organisera och distribuera tränade modeller från en central plats.
ClearML-integrationer
ClearML erbjuder inbyggda integrationer med GitHub, GitLab, Bitbucket, Jenkins, Azure DevOps, Google Cloud Platform, Amazon Web Services, Microsoft Azure, Slack och Zapier, samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Fjärrkloning av uppgifter via användargränssnittet
- Spårning av maskinvaruresursutnyttjande i realtid
- Integrerat internt system för datasetversionering
Cons:
- Komplex installation av server för egen drift
- Brant inlärningskurva för agenter


Kubeflow är en MLOps-plattform med öppen källkod som är utformad för team som kör maskininlärningsarbetsflöden på Kubernetes och erbjuder verktyg för automatisering av pipelines, modellträning, distribution och övervakning i en molnbaserad miljö.
Vem passar Kubeflow bäst för?
Kubeflow passar bra för DevOps- och datavetenskapsteam i organisationer som redan använder Kubernetes för infrastrukturhantering.
Varför jag valde Kubeflow
Jag valde Kubeflow som ett av de bästa alternativen eftersom det är särskilt utformat för att köra maskininlärningsarbetsflöden på Kubernetes, vilket är ovanligt bland MLOps-verktyg. Jag uppskattar att mitt team kan definiera, distribuera och hantera komplexa ML-pipelines som inbyggda Kubernetes-resurser. Integrationen med Jupyter-anteckningsböcker och stödet för distribuerade träningsjobb gör det enkelt för oss att skala experiment och produktionsarbetsbelastningar på ett molnbaserat sätt.
Viktiga funktioner i Kubeflow
- Central instrumentpanel: Få åtkomst till och hantera alla Kubeflow-komponenter från ett enhetligt webbaserat gränssnitt.
- Katib-justering av hyperparametrar: Kör automatiserade experiment för optimering av hyperparametrar för dina modeller.
- TensorBoard-integration: Visualisera och följ modellernas träningsmått direkt i plattformen.
- Stöd för flera ramverk: Kör arbetsflöden med TensorFlow, PyTorch, MXNet och andra populära ML-ramverk.
Kubeflow-integrationer
Kubeflow erbjuder inbyggda integrationer med Jupyter, TensorBoard, Katib, KFServing och Argo, samt ett API för anpassade integrationer och automatisering av CI/CD-pipelines.
Pros and Cons
Pros:
- Stöd för distribuerad träning i flera ramverk
- Central instrumentpanel för hantering av alla komponenter
- Inbyggd justering av hyperparametrar med Katib
Cons:
- Begränsat antal inbyggda verktyg för övervakning och aviseringar
- Dokumentationen kan vara inkonsekvent eller föråldrad


MLflow är en MLOps-plattform med öppen källkod som hjälper team att spåra experiment, hantera modeller, paketera kod och distribuera maskininlärningsprojekt i olika miljöer.
Vem passar MLflow bäst för?
MLflow passar bra för dataforskare och ML-ingenjörer som behöver spåra, återskapa och hantera maskininlärningsexperiment i stor skala.
Varför jag valde MLflow
Jag valde MLflow som en av de bästa lösningarna eftersom jag förlitar mig på funktionerna för experimentspårning och återskapande för att hålla mitt teams ML-projekt organiserade och möjliga att granska. Jag gillar att vi kan logga varje körning, parameter och artefakt och sedan jämföra resultaten sida vid sida i användargränssnittet. Modellregistret låter oss hantera modellversioner och övergångar, vilket är avgörande för produktionsarbetsflöden.
Viktiga MLflow-funktioner
- MLflow-projekt: Paketera kod i ett återanvändbart och reproducerbart format för att dela och köra ML-projekt.
- MLflow-modeller: Hantera och distribuera modeller i flera format och i olika serveringsmiljöer.
- MLflow-tillägg: Utöka MLflows funktioner med anpassade komponenter och integrationer.
- REST API: Automatisera experimentspårning och modellhantering via ett programmatiskt gränssnitt.
MLflow-integrationer
MLflow erbjuder inbyggda integrationer med Databricks, Azure Machine Learning, Amazon SageMaker, Google Cloud Platform, TensorFlow, PyTorch, scikit-learn, H2O.ai, Kubernetes och Zapier samt ett REST API för anpassade integrationer och CI/CD-arbetsflöden.
Pros and Cons
Pros:
- Infrastruktur-agnostisk experimentspårning
- Smidig lokal utvecklingskonfiguration
- Standard för paketering av modeller med öppen källkod
Cons:
- Ingen inbyggd orkestrerare för pipelinekörning
- Saknar inbyggd åtkomstkontroll för användare


Amazon SageMaker är en molnbaserad MLOps-plattform som låter dig bygga, träna, finjustera och distribuera maskininlärningsmodeller i stor skala, med integrerade verktyg för datamärkning, modellövervakning och automatiserade arbetsflöden.
Vem passar Amazon SageMaker bäst för?
Amazon SageMaker passar bra för datavetenskapsteam på företagsnivå som distribuerar och hanterar maskininlärningsmodeller i molnmiljöer.
Varför jag valde Amazon SageMaker
Jag valde Amazon SageMaker som en av de bästa lösningarna eftersom jag kan distribuera modeller direkt från Jupyter-anteckningsböcker till helt hanterade slutpunkter utan att behöva hantera infrastrukturen. Jag uppskattar att använda den inbyggda modellövervakningen för att spåra förändringar och automatisera omträning. Mitt team använder SageMaker Pipelines för att samordna komplexa arbetsflöden och säkerställa att allt är reproducerbart i molnet.
Viktiga funktioner i Amazon SageMaker
- Datamärkningsjobb: Starta och hantera arbetsflöden för datamärkning med människa i loopen.
- Inbyggda algoritmer: Få tillgång till ett bibliotek med optimerade maskininlärningsalgoritmer som är redo för träning.
- Automatisk modellfinjustering: Kör jobb för optimering av hyperparametrar för att förbättra modellens prestanda.
- Modellregister: Lagra, versionshantera och hantera godkända modeller för distribution.
Integrationer med Amazon SageMaker
Amazon SageMaker erbjuder inbyggda integrationer med AWS-tjänster som S3, Lambda, Glue, Redshift, CloudWatch och SageMaker Studio Lab, samt GitHub, TensorFlow, PyTorch och Scikit-learn, med ett API för anpassade integrationer.
Pros and Cons
Pros:
- Djup integration med AWS-datatjänster
- Specialiserade kostnadsbesparingar för punktträning
- Visuell identifiering av datakvalitetsinsikter
Cons:
- Inlåsning i det proprietära Data Wrangler-formatet
- Komplex konfiguration av behörigheter för flera konton
Andra MLOps-verktyg
Här är några ytterligare MLOps-verktyg som inte kom med på min kortlista, men som ändå är värda att titta närmare på:
- TrueFoundry
Bäst för snabb modelldistribution via mallar
- Feast
Bäst för tillhandahållande av funktioner i realtid
- Metaflow
Bäst för att skapa kodcentrerade arbetsflöden


Så utvärderar jag MLOps-verktyg
Jag delar upp min utvärdering i två lager: grundläggande krav som modelldistribution och pipelineorkestrering samt särskiljande faktorer som skiljer de bästa alternativen från resten.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer verktyg till min lista rangordnar jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion som listas nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 75 % för att övervägas för inkludering.
- Modelldistribution och modellbetjäning: Jag utvärderar hur varje verktyg hanterar att få modeller i produktion, oavsett om det sker via REST API-slutpunkter, batchinferensjobb eller containeriserad modellbetjäning med stöd för återställning.
- Experimentspårning och versionshantering: Det är mycket viktigt att spåra körningar, hyperparametrar och artefakter. Jag letar efter verktyg som låter dig jämföra experiment sida vid sida och spåra ursprunget tillbaka till exakta kod- och dataversioner.
- Pipelineorkestrering och automatisering: Jag kontrollerar om du kan bygga DAG-baserade arbetsflöden som kopplar samman steg för träning, validering och distribution med CI/CD-utlösare och schemaläggning.
- Modellövervakning och observerbarhet: Produktionsmodeller försämras över tid. Jag letar efter detektering av avvikelser, spårning av prediktionskvalitet och varningssystem som flaggar problem innan de påverkar efterföljande beslut.
- Modellregister och styrning: Ett centralt register med stegövergångar, åtkomstkontroller och granskningsloggar är det jag utvärderar här, särskilt för team som hanterar dussintals modeller i olika miljöer.
- Skalbarhet för beräkning och infrastruktur: Oavsett om det handlar om GPU-accelererad träning eller autoskalande inferensslutpunkter kontrollerar jag hur varje verktyg hanterar distribuerade arbetsbelastningar över molnresurser och lokala resurser.
När jag har en lista över verktyg som uppfyller kriterierna undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer med varandra:
Utmärkande funktioner
Stöd för LLM och generativ AI är en viktig särskiljande faktor just nu. Jag letar efter verktyg som har inbyggt stöd för finjustering, prompthantering och RAG-pipelineflöden i stället för att kräva kringlösningar. Ett inbyggt funktionslager är också viktigt för team som delar kuraterade funktioner mellan projekt, eftersom det minskar överflödig förbehandling. Jag utvärderar även verktyg för förklarbarhet och rättvisa, särskilt för team som distribuerar modeller inom reglerade områden där granskning av partiskhet och SHAP-baserade förklaringar förväntas under granskningscykler.
Mer än funktioner
Integrationer med ekosystemet är något av det första jag kontrollerar. Ett MLOps-verktyg måste kunna ansluta till din befintliga teknikstack, oavsett om det handlar om PyTorch, Airflow, Snowflake eller teamets CI/CD-pipeline i GitHub Actions. Flexibilitet vid distribution väger också tungt; vissa team behöver Kubernetes-inbyggda, självhostade lösningar medan andra vill ha fullt hanterad SaaS. Jag utvärderar även säkerhets- och regelefterlevnadsnivån genom att granska RBAC, SSO, granskningsloggning och certifieringar som SOC 2, eftersom ML-pipelines ofta hanterar känsliga produktionsdata som omfattas av strikta styrningskrav.
Så väljer du MLOps-verktyg
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du går igenom din unika process för programvaruval finns här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan verktyget hantera din nuvarande och beräknade modellvolym, datamängd och användarbas när du växer? |
| Integrationer | Kan det ansluta direkt till dina datakällor, molnleverantörer och arbetsflödesverktyg? |
| Anpassningsbarhet | Kan du anpassa dataflöden, mätvärden och instrumentpaneler efter ditt teams unika processer och behov? |
| Användarvänlighet | Kommer ditt team att kunna navigera i och börja använda verktyget snabbt, eller kräver det omfattande utbildning? |
| Implementering och introduktion | Hur lång tid tar det att komma igång, och vilka resurser eller vilken expertis behövs för installationen? |
| Kostnad | Är prisnivåerna transparenta och överensstämmer de med dina användningsmönster och budgetbegränsningar? |
| Säkerhetsåtgärder | Erbjuder verktyget kryptering, åtkomstkontroller och granskningsloggar som uppfyller organisationens säkerhetsstandarder? |
| Tillgång till support | Vilka supportkanaler erbjuds, och finns SLA:er eller dedikerad support för brådskande problem? |
Vad är MLOps-verktyg?
MLOps-verktyg är programvaruplattformar som hjälper team att hantera maskininlärningsmodellernas livscykel från början till slut, från utveckling och träning till driftsättning och övervakning. Dessa verktyg främjar samarbete, automatiserar arbetsflöden och säkerställer reproducerbarhet och styrning mellan datavetenskaps- och ingenjörsteam. MLOps-verktyg är avgörande för att skala upp maskininlärningsverksamheten och bibehålla modellernas prestanda i produktionsmiljöer.
Funktioner i MLOps-verktyg
Håll utkik efter följande viktiga funktioner när du väljer MLOps-verktyg:
- Experimentuppföljning: Logga, organisera och jämför modellkörningar, parametrar och resultat för att stödja reproducerbarhet och samarbete.
- Modellversionshantering: Lagra och hantera flera versioner av modeller, så att det blir enkelt att återställa eller granska ändringar över tid.
- Dataproveniens: Spåra datans ursprung, förflyttning och omvandling genom hela maskininlärningspipeline för transparens och efterlevnad.
- Pipelineorkestrering: Utforma, schemalägg och automatisera arbetsflöden från början till slut för databeredning, träning och driftsättning.
- Modelldriftsättning: Paketera och lansera modeller i produktionsmiljöer med verktyg för skalning, återställning och övervakning.
- Övervakning och aviseringar: Följ kontinuerligt modellprestanda, datadrift och systemhälsa och utlös aviseringar när problem uppstår.
- Samarbetsverktyg: Gör det möjligt för team att dela experiment, kod och resultat och stödjer tvärfunktionellt arbete och kunskapsöverföring.
- Åtkomstkontroll: Hantera användarbehörigheter och roller för att skydda känsliga data och upprätthålla styrning i olika projekt.
- Integrationsstöd: Anslut till datakällor, molnplattformar och DevOps-verktyg för att passa in i befintliga teknikstackar.
- Granskningsloggning: Upprätthåll detaljerade register över åtgärder, ändringar och åtkomst för efterlevnad och felsökning.
Vanliga AI-funktioner i MLOps-verktyg
Utöver de vanliga funktionerna i MLOps-verktyg som listas ovan integrerar många av dessa lösningar AI med funktioner som:
- Automatiserat modellval: Använd AI-algoritmer för att utvärdera och rekommendera de bäst presterande modellerna från en uppsättning kandidater, vilket sparar tid och förbättrar precisionen.
- Intelligent justering av hyperparametrar: Använd AI-driven optimering för att automatiskt söka efter de mest effektiva inställningarna för hyperparametrar, vilket minskar manuella försök och misstag.
- Avvikelsedetektering: Tillämpa AI för att övervaka data och modellutdata efter ovanliga mönster eller beteenden och varna team om potentiella problem innan de påverkar produktionen.
- Förutsägande underhåll: Använd AI för att förutsäga fel i infrastruktur eller modeller, vilket möjliggör proaktiva åtgärder och minimerar driftstopp.
- AutoML-pipelines: Automatisera processen från början till slut för funktionsteknik, modellträning och utvärdering med hjälp av AI, vilket gör avancerad maskininlärning tillgänglig för fler användare.
Fördelar med MLOps-verktyg
Att implementera MLOps-verktyg ger flera fördelar för ditt team och din verksamhet. Här är några som du kan se fram emot:
- Snabbare modelldriftsättning: Förenkla processen med att flytta modeller från utveckling till produktion med automatiserade pipelines och driftsättningsverktyg.
- Förbättrat samarbete: Gör det möjligt för datavetare, ingenjörer och intressenter att arbeta effektivt tillsammans genom delade instrumentpaneler, experimentuppföljning och versionshantering.
- Större reproducerbarhet: Säkerställ att experiment och resultat kan återskapas på ett tillförlitligt sätt med funktioner som dataproveniens, modellversionshantering och granskningsloggning.
- Förbättrad övervakning och tillförlitlighet: Följ kontinuerligt modellprestanda och systemhälsa, vilket möjliggör snabb upptäckt och lösning av problem.
- Starkare styrning och efterlevnad: Behåll kontrollen över dataåtkomst, användarbehörigheter och granskningsspår för att uppfylla lagstadgade och organisatoriska standarder.
- Skalbarhet för växande arbetsbelastningar: Stöd ökande datamängder, antal användare och modellkomplexitet med verktyg som är utformade för att skalas i takt med verksamheten.
- Minskad operativ risk: Minimera driftstopp och fel genom att automatisera rutinuppgifter och tillhandahålla funktioner för förutsägande underhåll och avvikelsedetektering.
Kostnader och priser för MLOps-verktyg
För att välja MLOps-verktyg krävs en förståelse för de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamets storlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i MLOps-verktygslösningar:
Jämförelsetabell för abonnemang för MLOps-verktyg
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisplan | $0 | Grundläggande experimentuppföljning, begränsad versionshantering av modeller, support från communityn och åtkomst för ett litet team. |
| Personlig plan | $10-$30/användare/månad | Åtkomst för enskilda användare, mer lagringsutrymme, grundläggande integrationer och begränsad pipelineorkestrering. |
| Företagsplan | $40-$80/användare/månad | Teamsamarbete, avancerad övervakning, rollbaserad åtkomstkontroll och integration med molnverktyg. |
| Plan för stora företag | $100-$200/användare/månad | Anpassade SLA:er, dedikerad support, avancerad säkerhet, funktioner för regelefterlevnad och obegränsad skalbarhet. |
Vanliga frågor om MLOps-verktyg
Här är några svar på vanliga frågor om MLOps-verktyg:
Hur hjälper MLOps-verktyg till med reproducerbarhet för modeller?
MLOps-verktyg hjälper till med reproducerbarhet för modeller genom att spåra experiment, hantera versioner av data och modeller samt logga alla ändringar under hela ML-livscykeln. Genom att använda funktioner som versionshantering av data (eller specifika verktyg som DVC) kan team säkerställa att det exakta tillståndet för de datapipelines som används för att träna AI-modeller bevaras. Det gör det enkelt att köra om experiment, granska resultat och säkerställa att modeller tillförlitligt kan återskapas av olika teammedlemmar under modellutvecklingen.
Kan MLOps-verktyg integreras med befintliga DevOps-pipelines?
Ja, de flesta MLOps-verktyg erbjuder integrationer med populära DevOps-plattformar, inklusive GIT för versionshantering av kod och olika CI/CD-verktyg. Det gör att du kan automatisera distribution, testning och övervakning av modeller som en del av dina befintliga arbetsflöden för programvaruleverans, vilket säkerställer att dina appar förblir redo för produktion.
Vilka säkerhetsfunktioner bör jag leta efter i MLOps-verktyg?
Leta efter funktioner som rollbaserad åtkomstkontroll, datakryptering, granskningsloggning och certifieringar för regelefterlevnad. Dessa hjälper till att skydda känsliga data, särskilt vid hantering av stora datamängder, och säkerställer att du kan kontrollera användarbehörigheter samtidigt som du uppfyller lagstadgade krav.
Hur lång tid tar det att implementera ett MLOps-verktyg?
Implementeringstiden varierar, men många team kan komma igång inom några dagar till några veckor. Faktorer som påverkar är komplexiteten i dina iterativa arbetsflöden, teamets storlek och den integrationsnivå som krävs. Många team börjar med ett verktyg med öppen källkod för att prova innan de skalar upp.
Har MLOps-verktyg stöd för både molnbaserade och lokala distributioner?
Ja, många MLOps-verktyg har stöd för både molnbaserade och lokala distributioner. Denna flexibilitet låter dig välja den bästa miljön för dina behov av datasäkerhet, regelefterlevnad och infrastruktur, oavsett om du utför den inledande träningen eller den slutliga finjusteringen av en specialiserad modell.