

O Databricks é uma plataforma poderosa, mas nem sempre é a escolha certa. Talvez a sua equipa tenha esbarrado nos custos, tido dificuldades com a curva de aprendizagem da plataforma ou precise de algo mais flexível para configurações multicloud ou no local. Seja qual for o caso, se está aqui, provavelmente procura uma alternativa que ofereça funcionalidades semelhantes às de um lakehouse de dados, sem as desvantagens.
Trabalhei com equipas de dados em startups e em contextos empresariais para avaliar e implementar plataformas como o Databricks, o Snowflake e outras. Vi em primeira mão o que é necessário para dar suporte a análises em grande escala, unificar fontes de dados desorganizadas e criar pipelines fiáveis que sejam realmente utilizados.
Neste guia, apresentarei as alternativas ao Databricks que vale a pena considerar — ferramentas que ajudam a armazenar, transformar e explorar dados de forma mais intuitiva, dando-lhe espaço para crescer e adaptar-se à medida que a sua equipa se desenvolve.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela de comparação: concorrentes do Databricks
Esta tabela de comparação resume os detalhes de preços das minhas principais escolhas entre os concorrentes do Databricks.
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Best for cloud data warehousing | 3.5 out of 5 | 4 | 3 | 4 | 3 | 3 | 4 | Pricing upon request 30-day free trial | Website |
Best for multi-cloud data deployment | Not rated | 3 | 2 | 3 | 2 | Not rated | 4 | $8/month Free plan available | Website |
Best for data integration tasks | Not rated | 4 | 4 | 4 | 2 | Not rated | 3 | Pricing upon request Free trial available | Website |
Best for in-memory processing | 2.2 out of 5 | 4 | 2 | 2 | 2 | 1 | 2 | Pricing upon request Free plan available | Website |
Best for fast SQL queries | 3.5 out of 5 | 4 | 3 | 4 | 3 | 3 | 4 | $6.25/TiB processed Free plan available | Website |
Best for enterprise database needs | Not rated | 3 | Not rated | 3 | 3 | Not rated | 3 | Pricing upon request Free trial available | Website |
Best for SQL analytics | 3.3 out of 5 | 4 | 4 | 3 | 2 | 3 | 4 | Pricing upon request 30-day free trial | Website |
Best for Hadoop processing | 3.3 out of 5 | 4 | 3 | 4 | 2 | 3 | 4 | $0.007084/vCPU-hour Not available | Website |
Best for managed Spark and Hadoop | 3.3 out of 5 | 4 | 3 | 4 | 3 | 2 | 4 | $0.06/DCU-hour Not available | Website |
Best for AI and ML solutions | 2.7 out of 5 | 2 | 2 | 3 | 5 | 3 | 1 | Pricing upon request Free demo available | Website |


Análise dos melhores concorrentes do Databricks
Abaixo encontrará os meus resumos detalhados dos melhores concorrentes do Databricks que entraram na minha lista. As minhas análises apresentam uma visão detalhada das principais funcionalidades, vantagens e desvantagens, integrações e casos de utilização ideais de cada ferramenta, para o ajudar a encontrar a melhor opção para si.
 Best for cloud data warehousing
- 30-day free trial
- Pricing upon request
Visit WebsiteCustomer Rating:4.6/5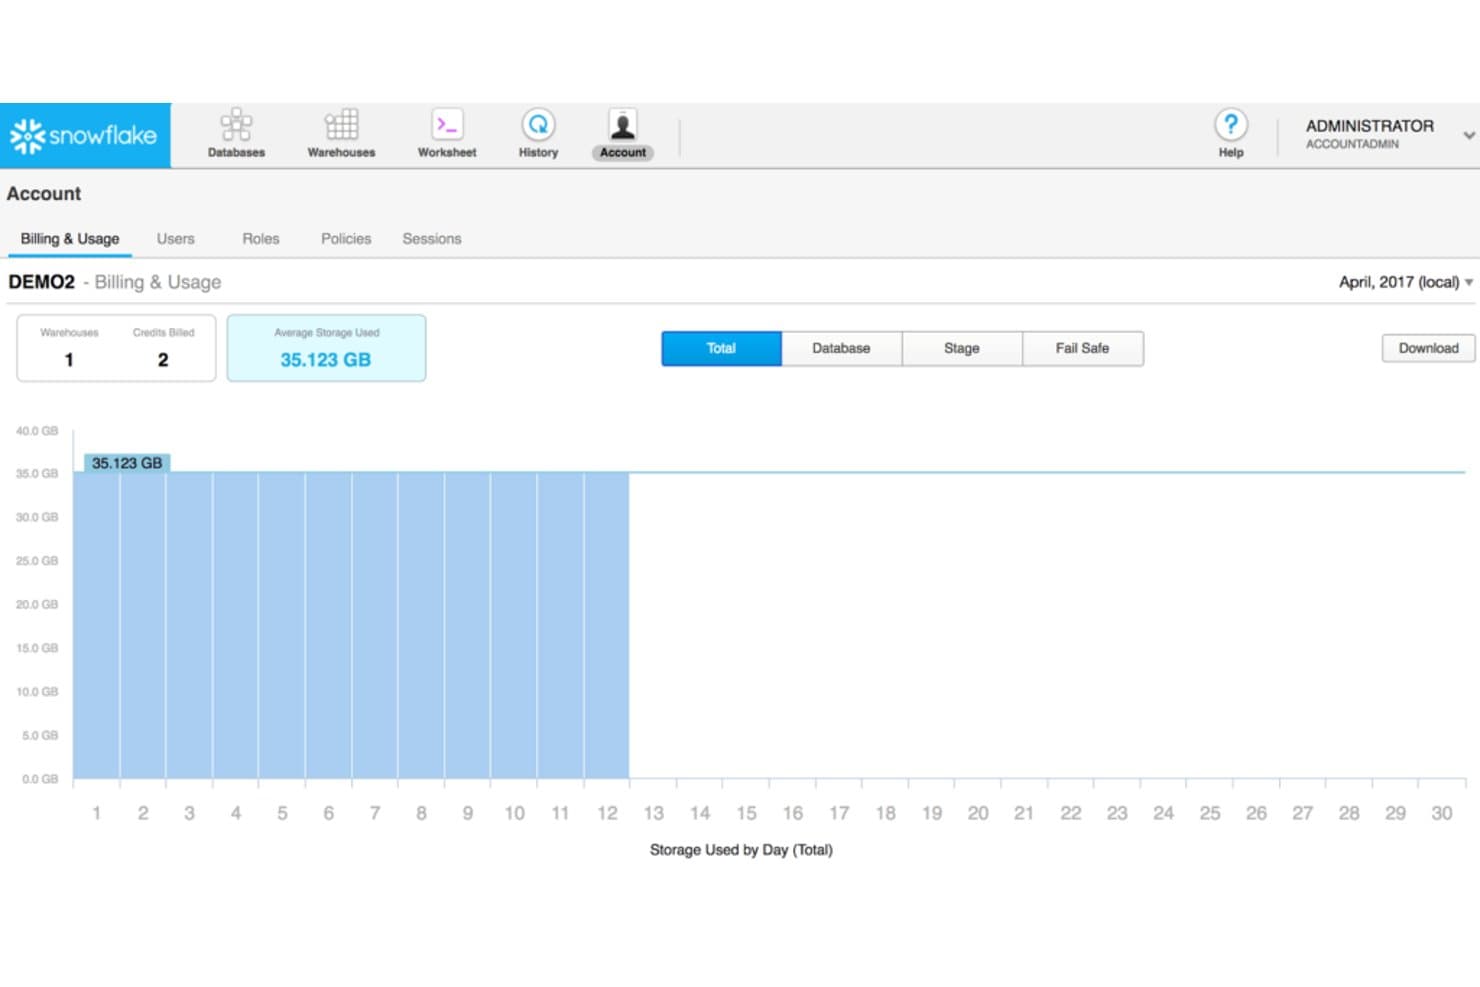
Snowflake tracks storage and credit usage by day in one dashboard. Snowflake gives IT and analytics teams a cloud data platform for bringing disparate datasets together, running SQL queries at scale, and providing governed access without managing warehouse infrastructure.
Who Is Snowflake Best For?
Data engineering and analytics teams that need a cloud warehouse to query and share data across business systems.
Why I Picked Snowflake
I picked Snowflake as “Best for cloud data warehousing” because its separate storage and compute let me scale SQL analytics without resizing the data layer. I also value its governed data sharing when teams need to query datasets across business systems without copying them into separate warehouses.
Snowflake Key Features
- Dynamic tables: Define data pipelines with SQL and set target refresh lag.
- Snowpipe: Load data from staged files as they arrive.
- Time Travel: Query, clone, or restore historical data within the retention period.
- Snowflake Marketplace: Discover and access third-party data sets and applications.
Snowflake Integrations
Snowflake offers Openflow connectors for Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL, and Microsoft SQL Server. It also provides native connectors for ServiceNow, MySQL, and Kafka, plus REST APIs for custom integrations.
Pros and Cons
Pros:
- Secure sharing avoids dataset copies between teams
- Managed SQL warehouses reduce infrastructure upkeep
- Independent compute scaling handles workload swings
Cons:
- Proprietary features can complicate platform migration
- Usage spikes can make spend unpredictable
Learn more about Snowflake: Best for multi-cloud data deployment
- Free plan available
- From $8/month
Visit WebsiteCustomer Rating:4.5/5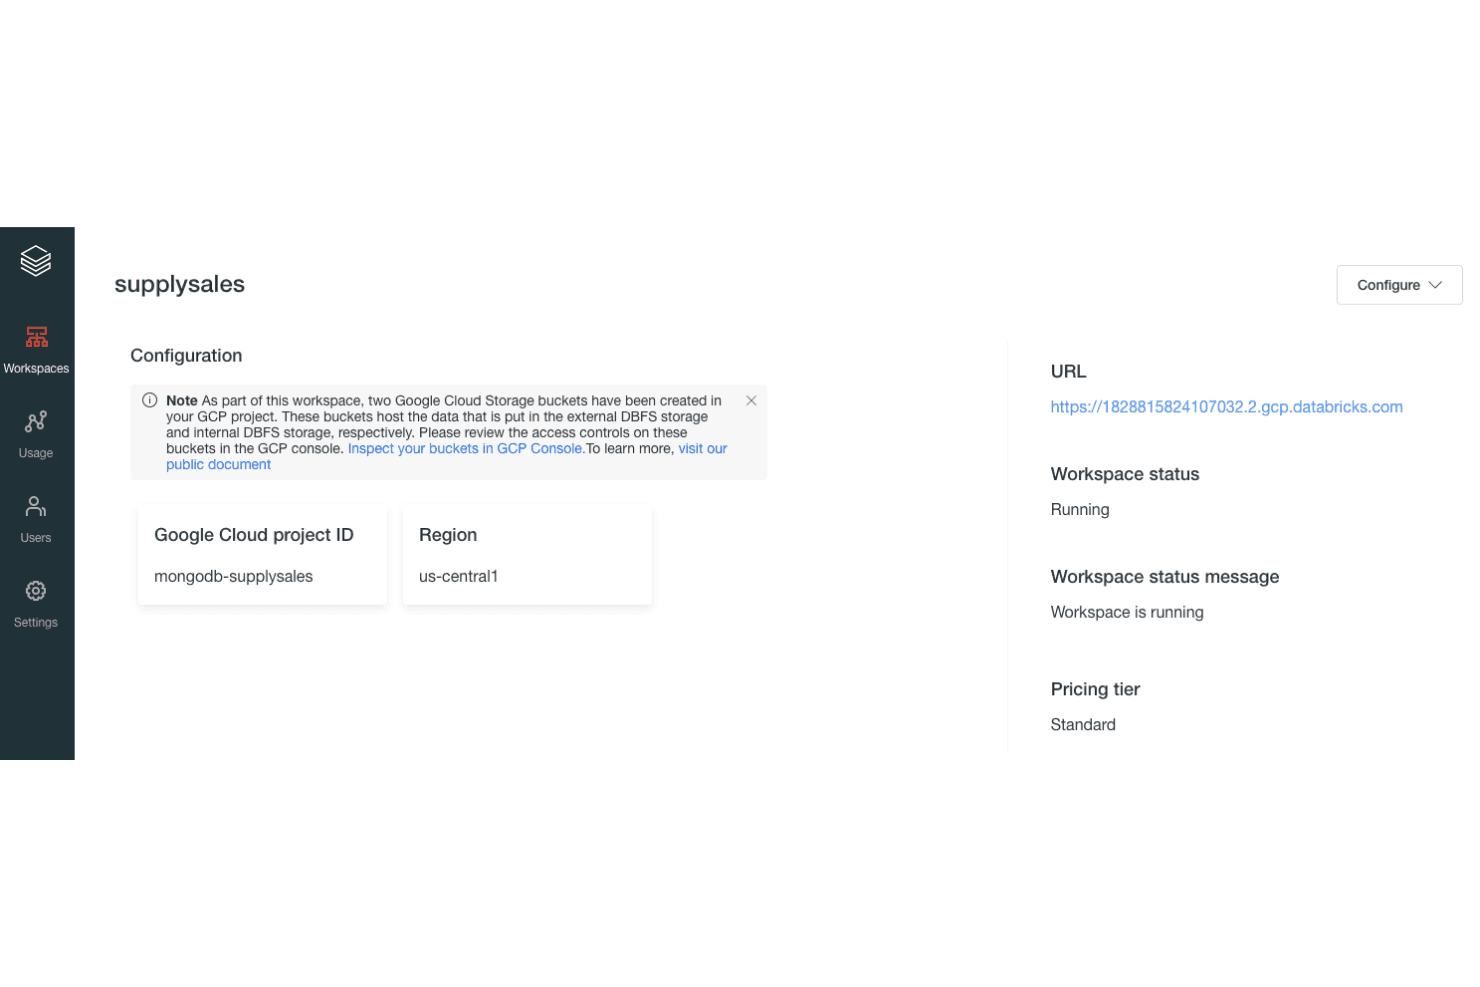
MongoDB Atlas integrates with Databricks workspaces on GCP for data processing. MongoDB Atlas gives IT and data teams a managed document database for applications that need flexible data models, dependable queries, and less database maintenance.
Who Is MongoDB Atlas Best For?
IT and platform teams deploying applications across multiple cloud providers will value MongoDB Atlas’s managed database and multi-cloud flexibility.
Why I Picked MongoDB Atlas
I picked MongoDB Atlas as a Databricks alternative for Best for multi-cloud data deployment. Atlas supports multi-cloud clusters across AWS, Azure, and Google Cloud, while its aggregation pipeline lets you analyze application data stored in MongoDB. I’d use it to query operational data close to services running across different cloud providers.
MongoDB Atlas Key Features
- Atlas Search: Create full-text indexes and run relevance-ranked searches.
- Atlas Charts: Build dashboards and visualizations from MongoDB data.
- Data Federation: Query data across Atlas databases and cloud object storage.
- Automated backups: Schedule database snapshots and restore from saved points.
MongoDB Atlas Integrations
MongoDB Atlas documents integrations with Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta, and Microsoft Entra ID. It also provides an Administration API for custom integrations.
Pros and Cons
Pros:
- Aggregation pipelines analyze operational data in place
- Flexible documents accommodate changing application data models
- Multi-cloud clusters across AWS, Azure, and Google Cloud
Cons:
- Aggregation performance can require careful query tuning
- Less suited to broad lakehouse analytics workloads
Learn more about MongoDB Atlas: Best for data integration tasks
- Free trial available
- Pricing upon request
Visit WebsiteCustomer Rating:4.2/5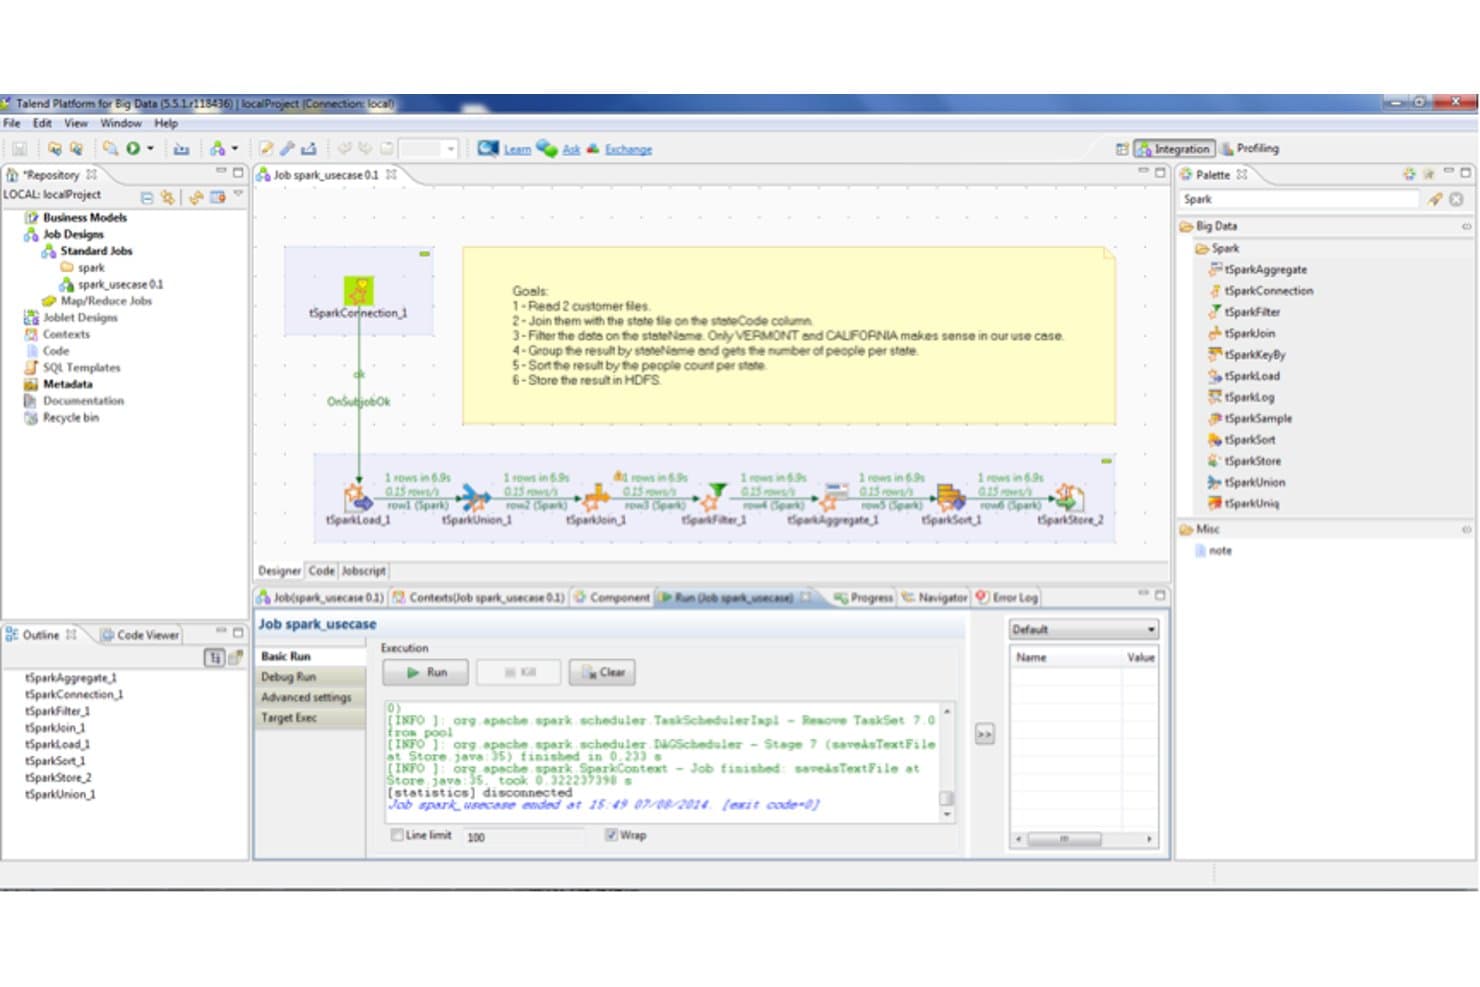
Talend lets users build and run Spark data pipelines visually. Talend is a data integration platform for IT and data teams that connects information across systems, helping reduce silos and keep data pipelines manageable as environments grow.
Who Is Talend Best For?
Talend suits IT and data engineering teams that need to connect cloud, on-premises, and legacy systems.
Why I Picked Talend
I picked Talend as a Databricks competitor because “Best for data integration tasks” is exactly where it fits. Its visual job designer and tMap transformations let me join and reshape records between a legacy database and a cloud warehouse. I also value Talend’s data quality components for catching malformed records before they reach downstream systems.
Talend Key Features
- Connectors: Connect databases, cloud applications, files, and other systems through prebuilt connectors.
- Change data capture: Capture database inserts, updates, and deletes as they occur.
- Data lineage: Trace data flows from source systems through jobs to their destinations.
- Metadata discovery: Scan data sources to identify datasets, formats, and patterns.
Talend Integrations
Talend includes connectors or components for systems such as Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle, and MongoDB. It also supports REST and SOAP services, and Qlik Talend Data Integration provides APIs for managing data connections.
Pros and Cons
Pros:
- Data quality tools flag malformed records
- Batch and real-time pipelines support varied workloads
- Visual jobs handle joins and reshaping
Cons:
- Generated Java complicates debugging and audits
- Large jobs can demand JVM tuning
Learn more about Talend:
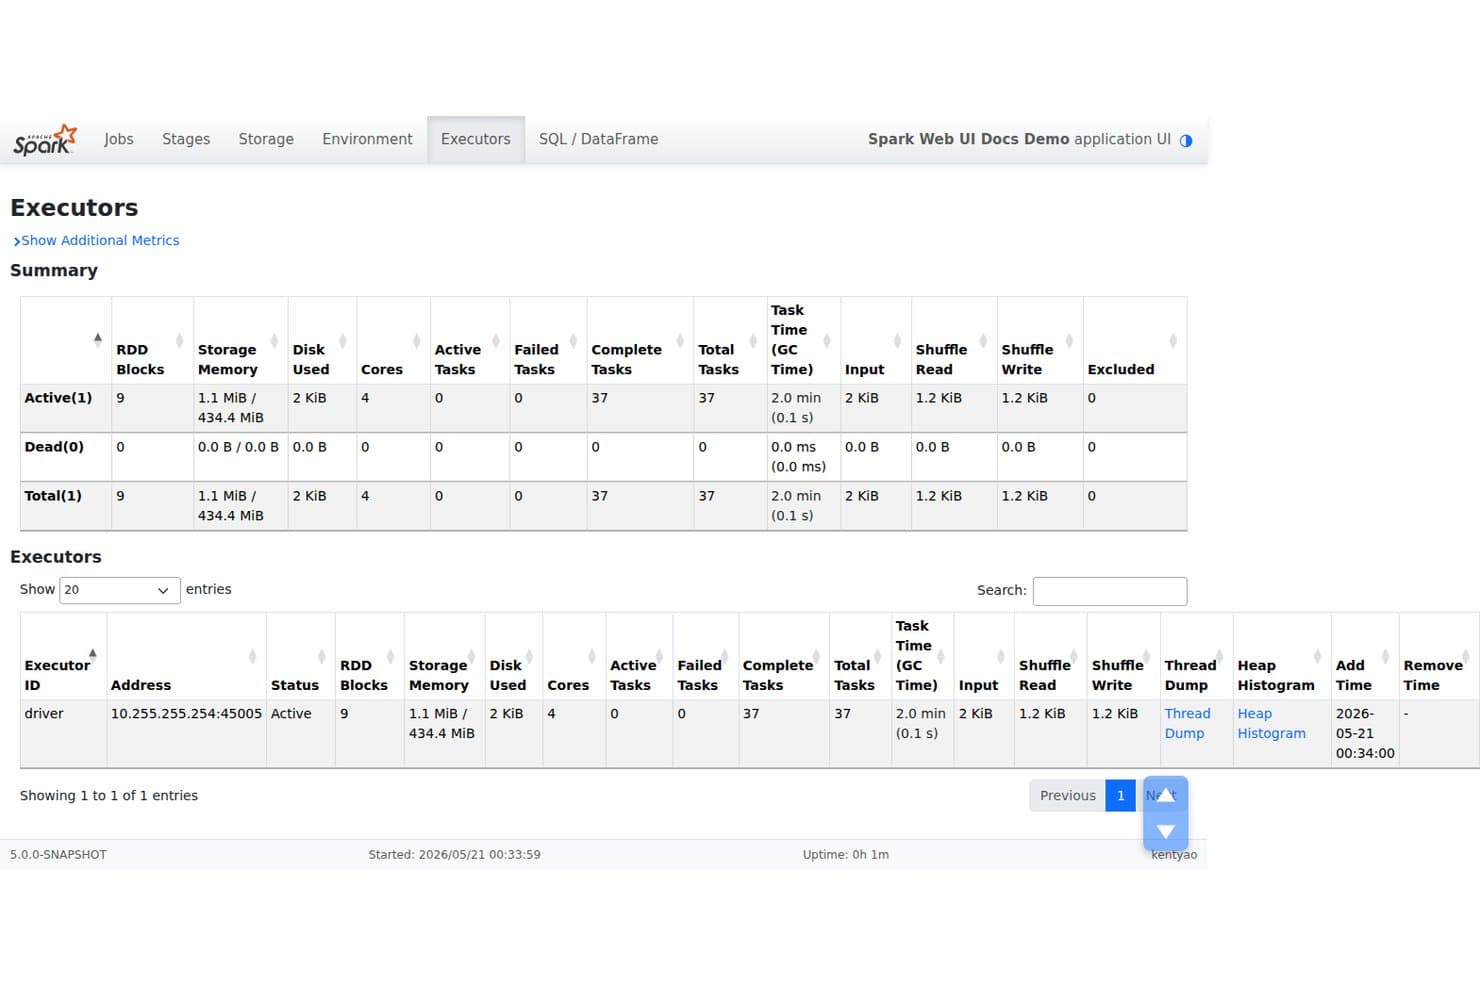
Apache Spark tracks executor resources, tasks, and memory in real time. Apache Spark is an open-source analytics engine for data and infrastructure teams that need to process large datasets, run distributed workloads, and build data pipelines across diverse environments.
Who Is Apache Spark Best For?
Data engineering and analytics teams that need fast, iterative processing of large datasets across clusters are a good fit for Apache Spark.
Why I Picked Apache Spark
I picked Apache Spark as a Databricks alternative because it’s Best for in-memory processing. Spark can cache or persist RDDs and DataFrames in memory, so repeated queries and iterative calculations avoid rereading source data. That helps when refining large event-data aggregates across multiple analysis passes.
Apache Spark Key Features
- Spark SQL: Query structured data with SQL and DataFrame APIs.
- Structured Streaming: Process live data with Spark’s streaming APIs.
- MLlib: Build machine learning workflows with scalable algorithms and pipelines.
- Cluster managers: Deploy applications on standalone clusters, YARN, or Kubernetes.
Apache Spark Integrations
Apache Spark supports connectors for Apache Kafka and Apache Hive, plus JDBC connections to databases such as PostgreSQL, MySQL, Oracle, and Microsoft SQL Server. Its Data Source API supports custom connectors; Kafka connector dependencies and database-specific JDBC drivers may need to be added separately.
Pros and Cons
Pros:
- Runs locally or across Kubernetes and YARN clusters
- Batch, streaming, SQL, and ML share one engine
- Cached datasets speed iterative workloads
Cons:
- Tuning and debugging distributed jobs take expertise
- Memory pressure can trigger out-of-memory failures
Learn more about Apache Spark:
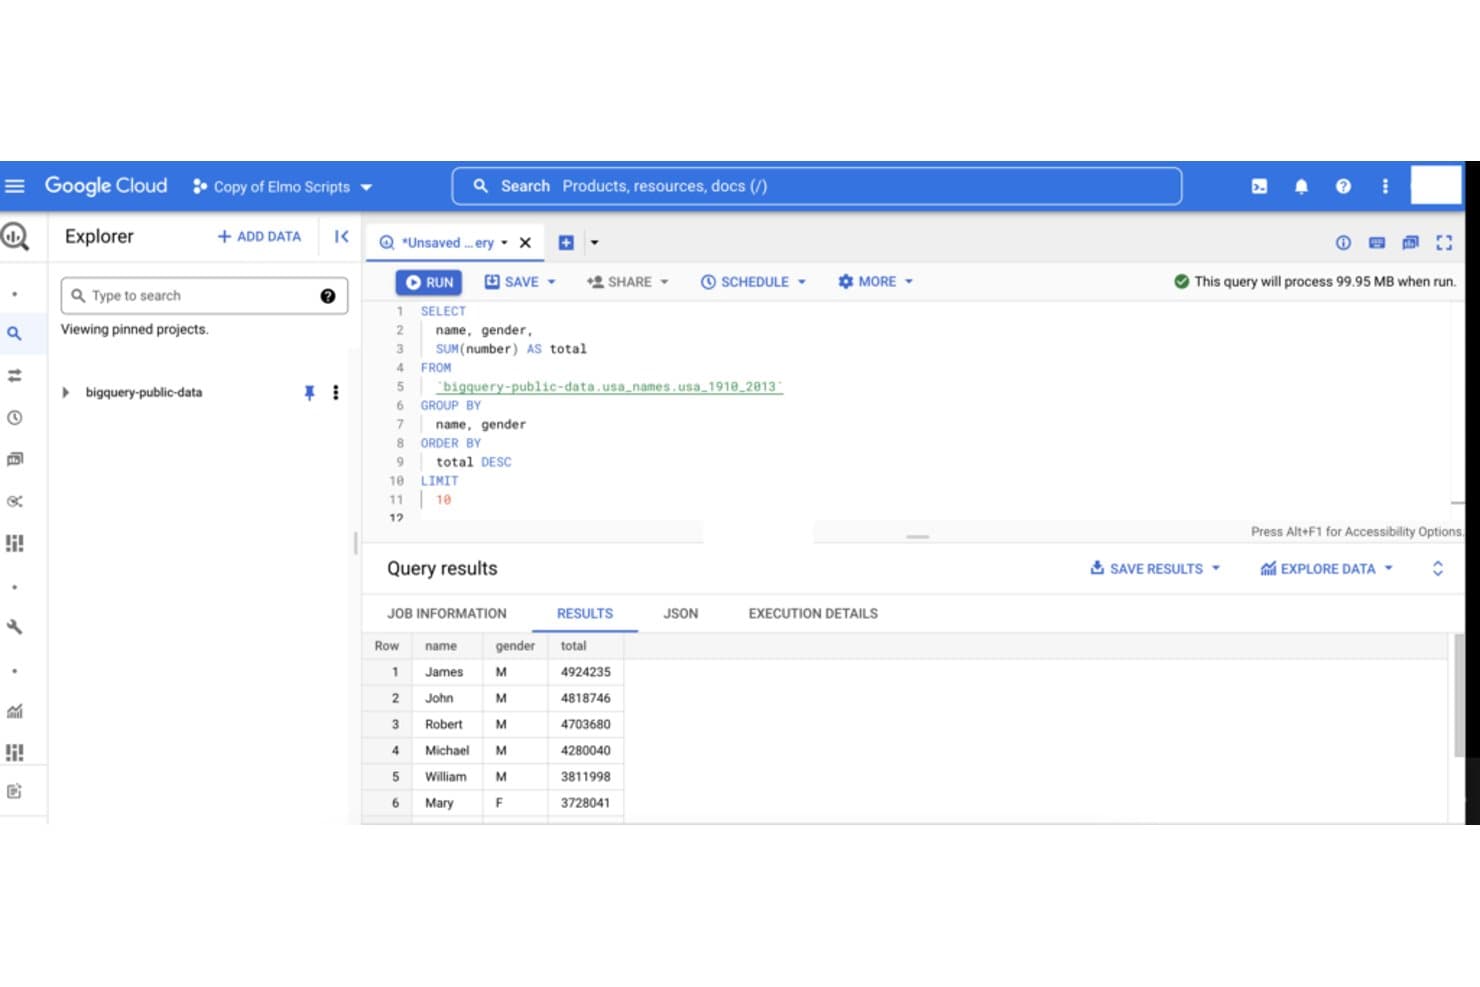
Google BigQuery lets users run SQL queries on large public datasets. For IT and data teams that need scalable analytics without managing warehouse infrastructure, Google BigQuery is a cloud data warehouse for querying and analyzing large datasets with SQL.
Who Is Google BigQuery Best For?
Data analysts and engineers who need to run fast SQL queries across large cloud datasets will find Google BigQuery a practical fit.
Why I Picked Google BigQuery
I picked Google BigQuery as my “Best for fast SQL queries” alternative to Databricks. Its serverless query engine runs GoogleSQL across large datasets, while table partitioning and clustering can reduce data scanned for recurring reports. I like it for querying application logs or event data without managing warehouse clusters.
Google BigQuery Key Features
- BigQuery ML: Create and run machine learning models with SQL.
- Scheduled queries: Set SQL jobs to run at chosen intervals.
- BigQuery Data Transfer Service: Schedule data imports from supported sources.
- Authorized views: Share query results without granting access to underlying tables.
Google BigQuery Integrations
Google documents direct BigQuery integrations with Looker, Looker Studio, Vertex AI Workbench, Managed Service for Apache Spark, and Tableau. Data connections and loading workflows also support Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3, and Azure Blob Storage; BigQuery’s REST and Storage APIs support custom integrations.
Pros and Cons
Pros:
- Partitioning and clustering can reduce scanned data
- Serverless operation removes cluster management
- Fast SQL scans across large datasets
Cons:
- Business-user exploration often requires SQL expertise
- Query costs can spike without guardrails
Learn more about Google BigQuery:
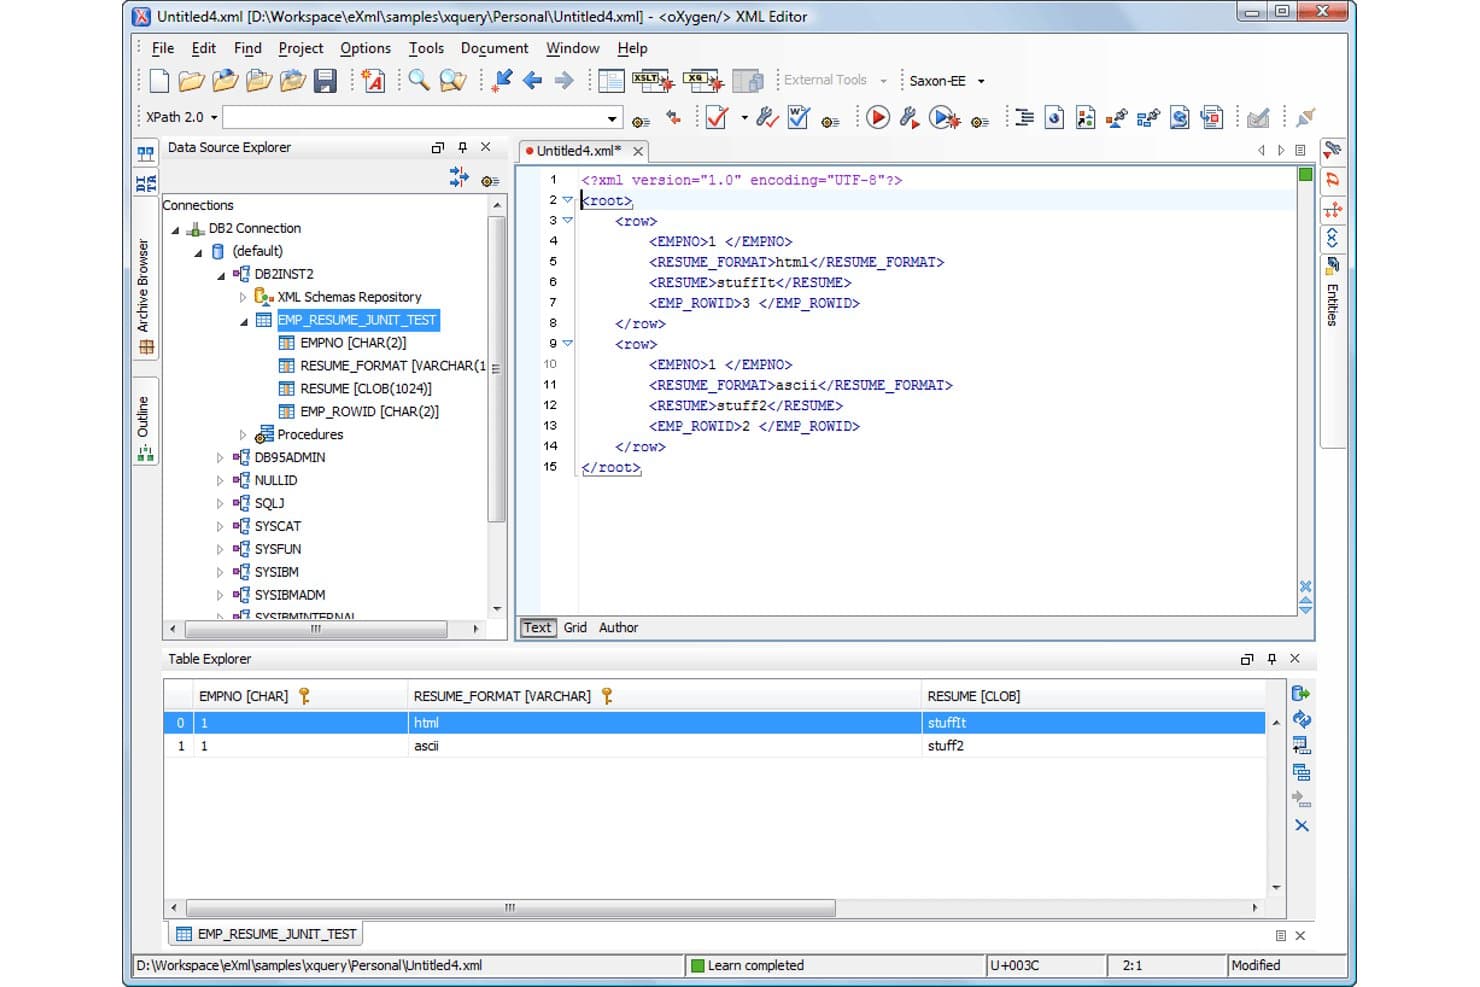
IBM Db2 lets users browse database schemas and query XML data visually. IBM Db2 is a relational database management system for organizations that need to run structured data workloads across complex environments, supporting teams that manage enterprise applications, transactions, and analytics.
Who Is IBM Db2 Best For?
Database administrators and IT teams at large organizations that support high-volume business applications.
Why I Picked IBM Db2
I picked IBM Db2, Best for enterprise database needs, as a Databricks alternative for core business systems. It supports transactional, analytical, and vector data on one platform, with AI-powered workload optimization for ERP, billing, and order processing. I value that fit when relational workloads and analytics need to share infrastructure.
IBM Db2 Key Features
- Hybrid deployment: Run Db2 on premises, in the cloud, or in hybrid environments.
- Native encryption: Encrypt database data and manage encryption keys through a keystore.
- Table partitioning: Divide table data into partitions based on specified column values.
- Backup and recovery tools: Db2 Advanced Recovery supports database backup, recovery, and data extraction.
IBM Db2 Integrations
Native integrations aren’t clearly documented. Db2 supports federated access to data sources such as Oracle and Microsoft SQL Server, plus JDBC, ODBC, and CLI connectivity for applications.
Pros and Cons
Pros:
- Partitioning supports large, mixed workloads
- High availability with HADR and recovery
- Fast processing for enterprise transaction workloads
Cons:
- Cloud-native operations trail newer platforms
- Administration and tuning require specialist expertise
Learn more about IBM Db2:
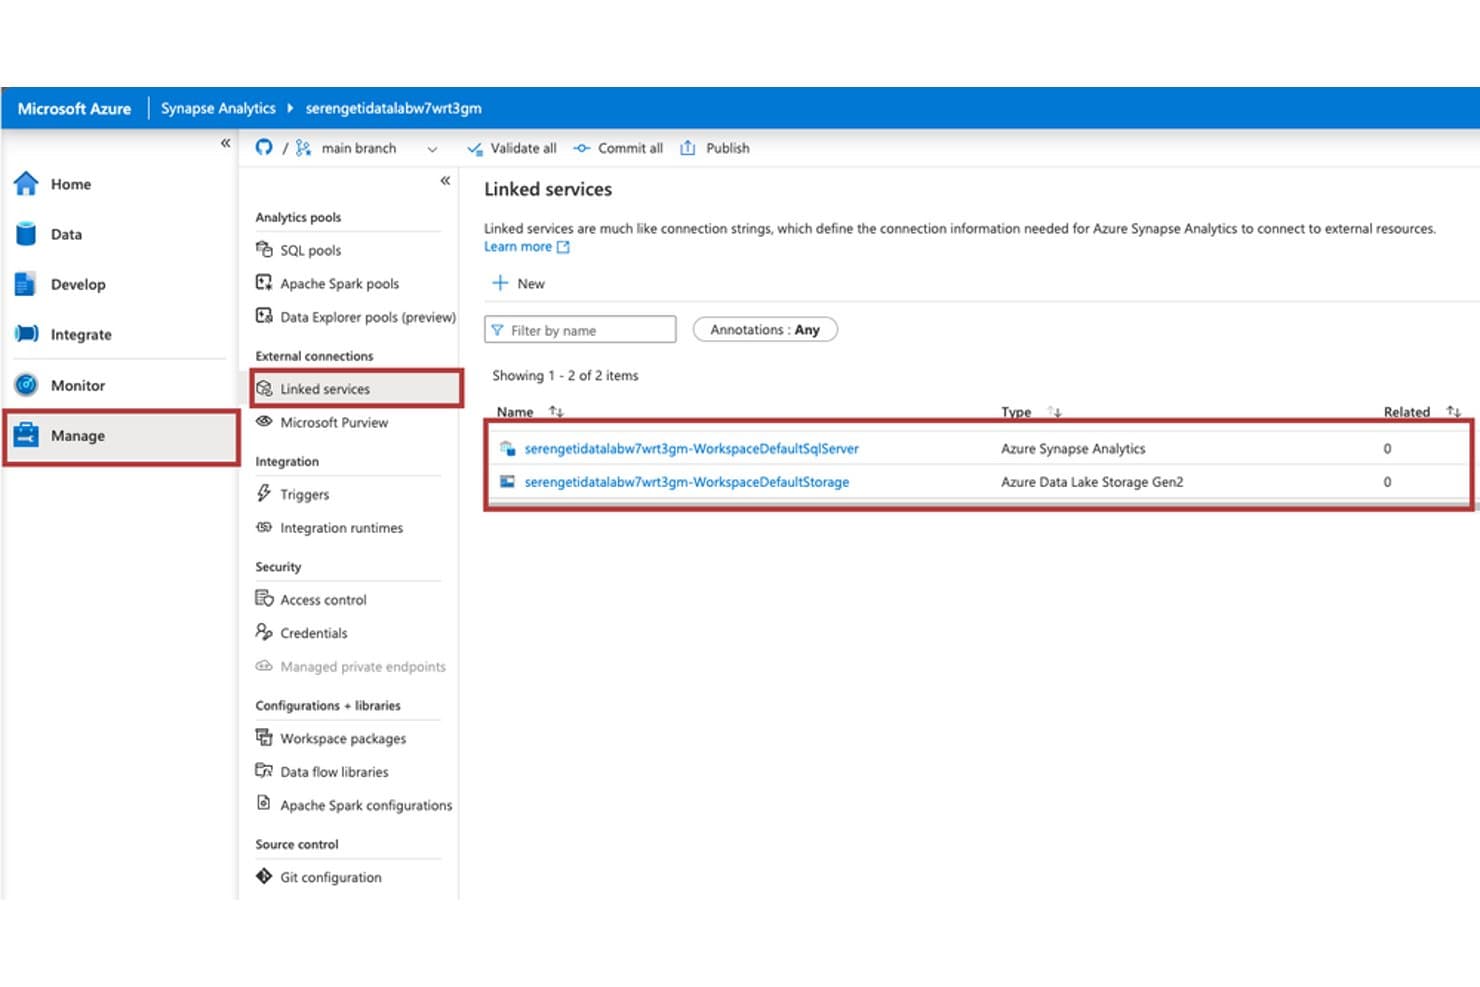
Azure Synapse Analytics manages external connections via Linked Services. Azure Synapse Analytics is a cloud analytics platform for data and IT teams that need to connect enterprise data, run queries, and support reporting across data warehousing and big data workloads.
Who Is Azure Synapse Analytics Best For?
It suits data engineers and analysts who need SQL access to integrated datasets for enterprise reporting and analytics.
Why I Picked Azure Synapse Analytics
I picked Azure Synapse Analytics for the Best for SQL analytics use case: its serverless SQL pool queries data lake files with T-SQL, while dedicated SQL pools support provisioned warehouse workloads. I like this split when I need to inspect raw datasets and serve recurring BI reports through SQL.
Azure Synapse Analytics Key Features
- Apache Spark pools: Run Spark jobs and notebooks for distributed data processing.
- Pipelines: Orchestrate data movement and transformation across connected sources.
- Synapse Studio: Manage data, code, and analytics resources in a shared workspace.
- Power BI integration: Connect Synapse data to Power BI for report creation.
Azure Synapse Analytics Integrations
Azure Synapse Analytics has built-in pipeline connectors for Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3, and SAP HANA, plus a direct Power BI connection through Synapse Studio. It also provides REST APIs for custom integrations.
Pros and Cons
Pros:
- Combines SQL queries with Spark processing
- Dedicated MPP pools handle warehouse workloads
- Serverless T-SQL queries read lake files
Cons:
- Pipeline debugging and monitoring can be limited
- SQL pool tuning demands hands-on expertise
Learn more about Azure Synapse Analytics:
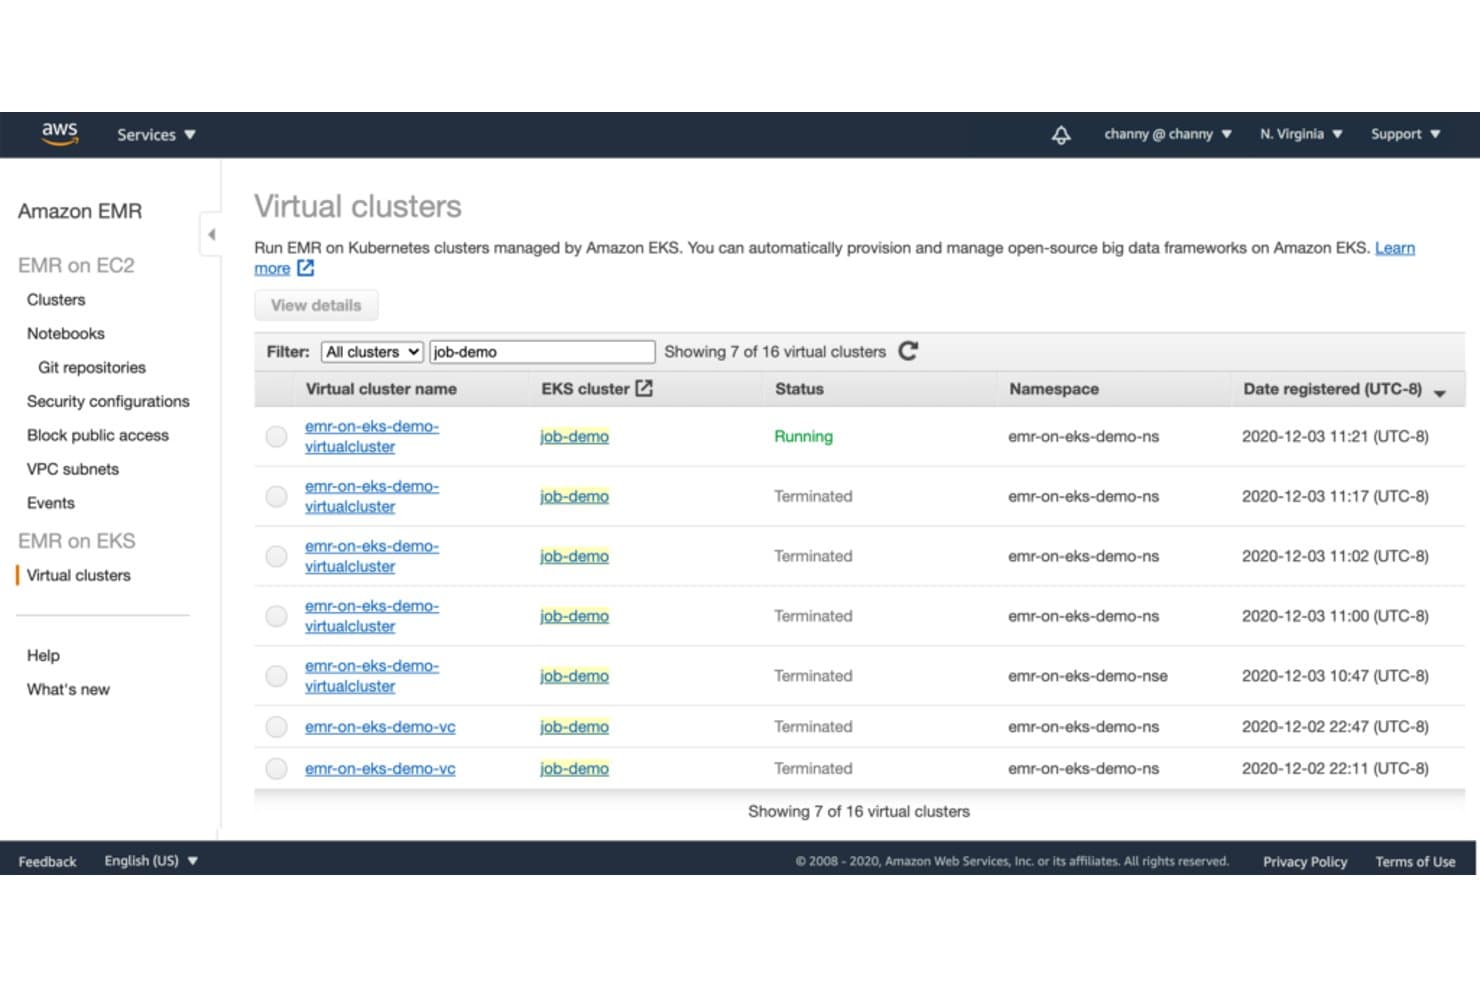
Amazon EMR lets users manage virtual clusters running on Amazon EKS. Amazon EMR is AWS’s managed big data platform for data engineering and analytics teams that need to process large datasets, scale distributed workloads, and reduce the work of operating compute clusters.
Who Is Amazon EMR Best For?
Amazon EMR suits data engineering teams that run Hadoop or Spark jobs to process large datasets across distributed clusters.
Why I Picked Amazon EMR
I picked Amazon EMR as a Databricks alternative for one reason: Best for Hadoop processing. Its managed clusters run Apache Hadoop and Spark, so I can use MapReduce to process archived application logs and Spark to analyze the results.
Amazon EMR Key Features
- EMR Serverless: Run data applications without provisioning or managing clusters.
- Automatic scaling: Adjust cluster capacity based on workload demand.
- EMR on EKS: Run EMR workloads on Amazon EKS clusters.
- AWS Glue Data Catalog: Use a shared catalog for table metadata.
Amazon EMR Integrations
Amazon EMR has documented integrations with AWS Glue Data Catalog, AWS Lake Formation, Amazon S3, and Amazon CloudWatch. It also provides an API for programmatic access and custom integrations.
Pros and Cons
Pros:
- Processes large datasets across varied workloads
- Supports cluster, serverless, and EKS deployment
- Runs established Hadoop and Spark workloads
Cons:
- Cluster scaling sometimes requires manual tuning
- Slow autoscaling can leave jobs under-resourced
Learn more about Amazon EMR: Best for managed Spark and Hadoop
- Not available
- From $0.06/DCU-hour
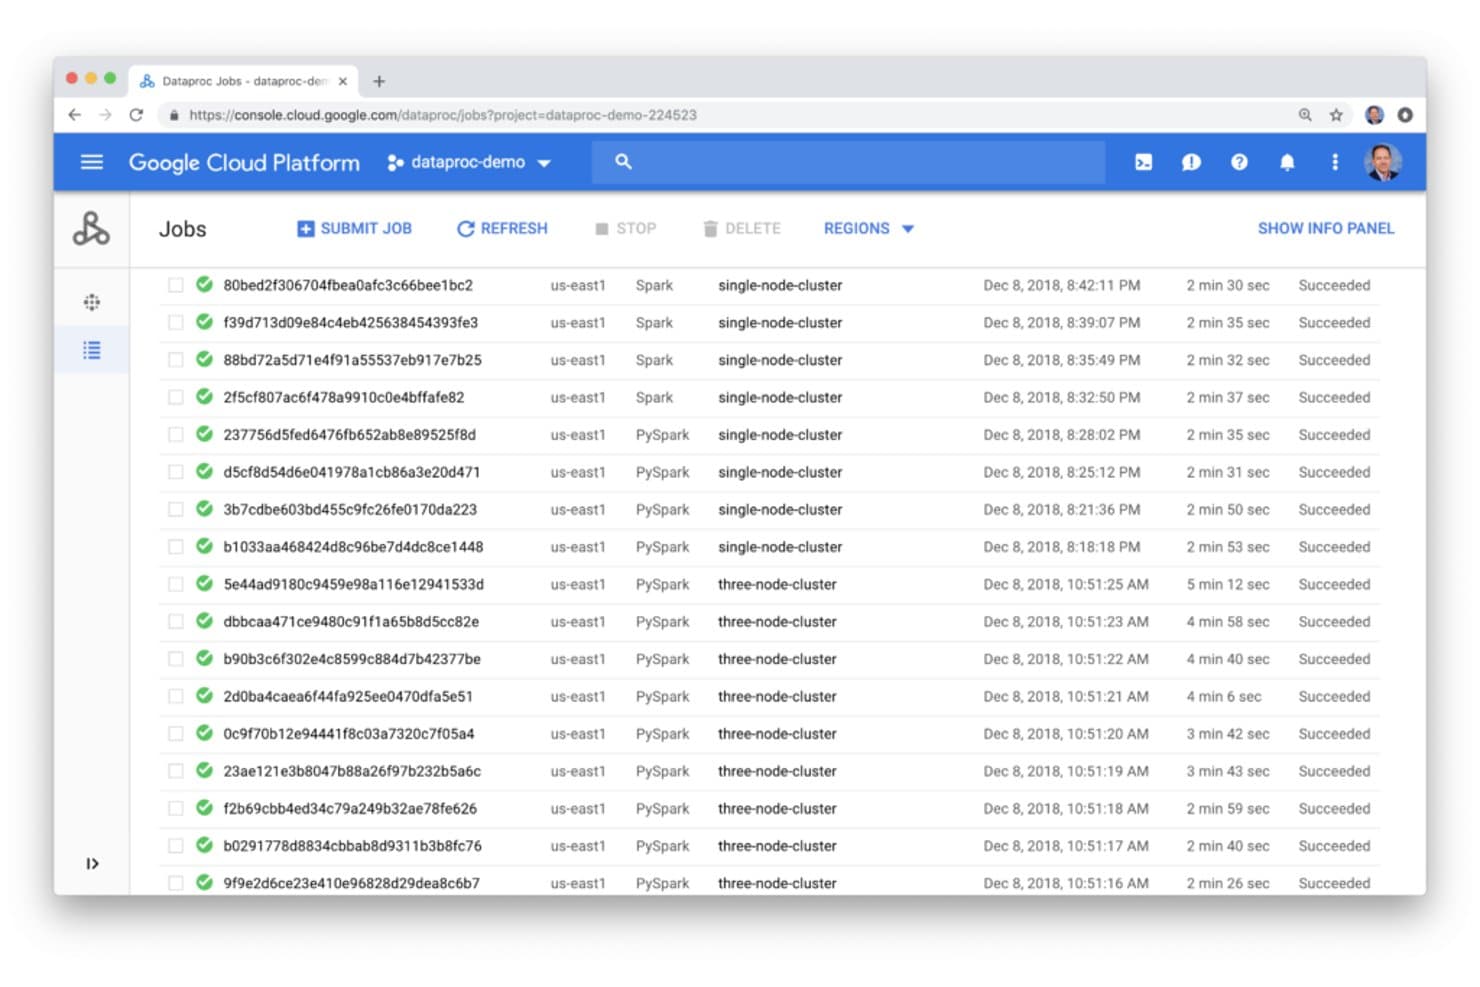
Google Cloud Dataproc lets users monitor and manage Spark jobs at a glance. Google Cloud Dataproc gives data engineering and IT teams a managed cloud platform for large-scale analytics workloads, helping reduce cluster administration and support data pipelines across Google Cloud.
Who Is Google Cloud Dataproc Best For?
Data engineering teams that run Spark or Hadoop jobs on Google Cloud can use Dataproc to manage cluster operations.
Why I Picked Google Cloud Dataproc
I picked Google Cloud Dataproc for workloads where “Best for managed Spark and Hadoop” is the priority. Managed clusters and autoscaling policies help handle batch jobs with changing resource needs, while Dataproc Serverless runs Spark batches without cluster provisioning. For example, you can process nightly event logs with Spark and avoid leaving a cluster idle between runs.
Google Cloud Dataproc Key Features
- Lightning Engine: Accelerates Spark execution with vectorized processing, caching, and optimized shuffling.
- Apache Iceberg support: Works with open table formats on Google Cloud Storage.
- GPU acceleration: Supports NVIDIA RAPIDS for GPU-enabled data processing.
- Security controls: Integrates with IAM, VPC Service Controls, and Kerberos.
Google Cloud Dataproc Integrations
Google Cloud Dataproc has built-in integrations with BigQuery, Cloud Storage, Bigtable, Cloud Logging, and Cloud Monitoring. It also provides a REST API and Cloud SDK for managing clusters and jobs.
Pros and Cons
Pros:
- Serverless batches avoid cluster administration
- Quick cluster creation and teardown
- Runs existing Spark jobs with minimal rewrites
Cons:
- Costs can feel high for sustained workloads
- Cluster tuning still needs infrastructure expertise
Learn more about Google Cloud Dataproc:
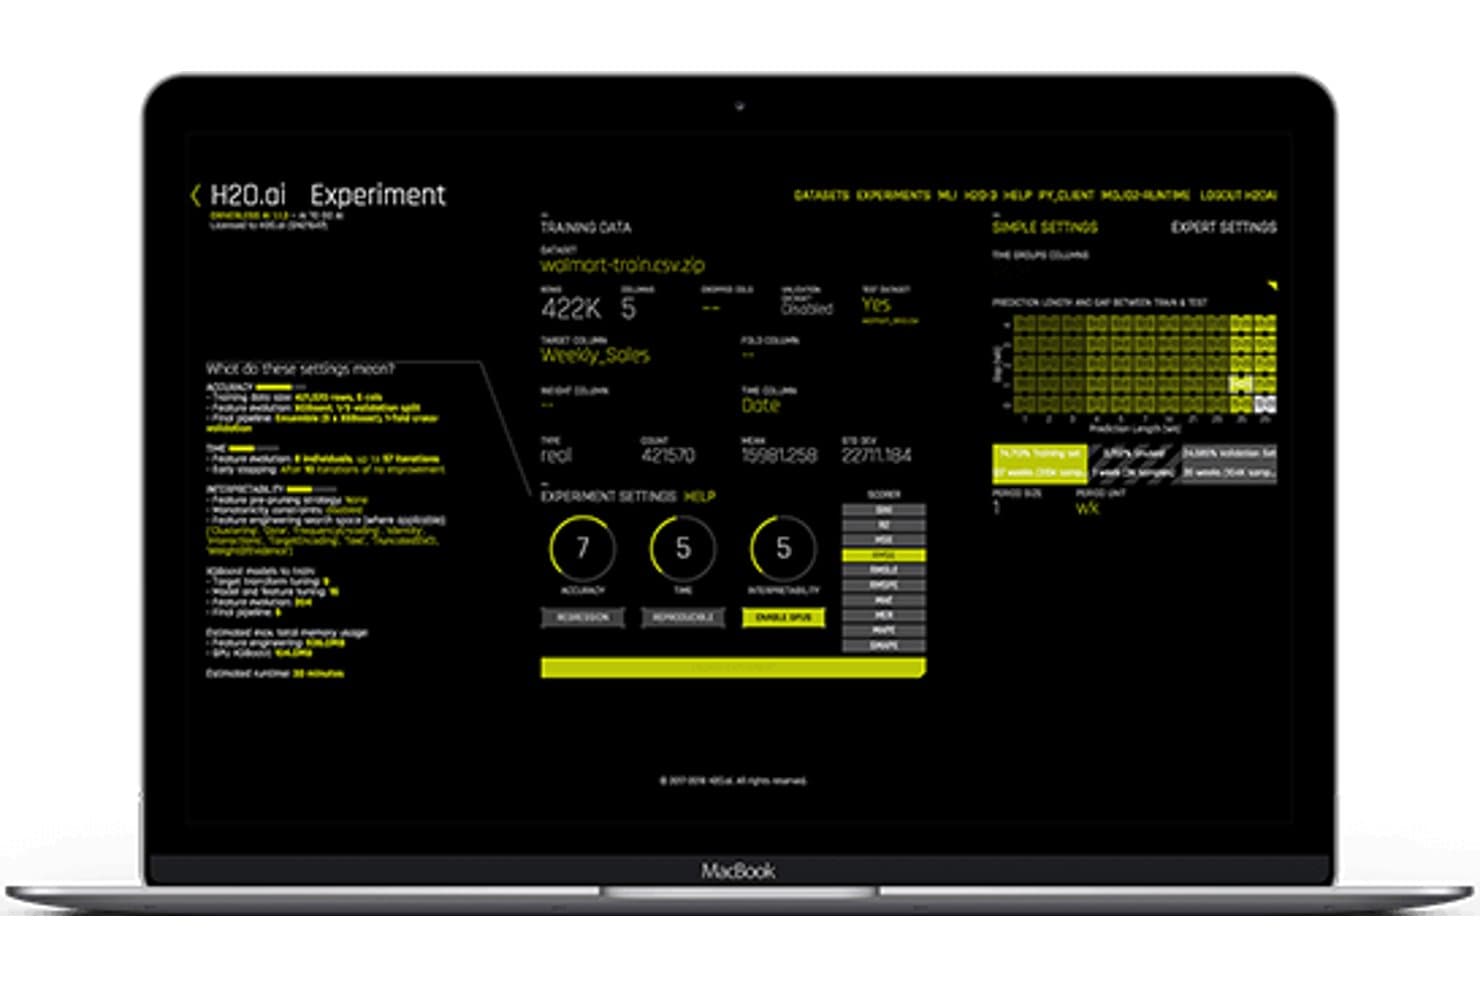
H2O.ai lets users configure and run AutoML experiments visually. For teams evaluating Databricks alternatives, H2O.ai provides an AI and machine learning platform that helps data and IT teams build predictive models from large datasets and put analytics to work.
Who Is H2O.ai Best For?
H2O.ai suits data scientists and machine learning engineers responsible for developing AI models and putting them into production.
Why I Picked H2O.ai
I picked H2O.ai as my “Best for AI and ML solutions” alternative to Databricks because it focuses on building predictive models from large datasets. H2O-3 distributes in-memory machine learning across clusters, while AutoML tests algorithms and ranks models in a leaderboard. I like this fit when I need to compare models before putting one into production.
H2O.ai Key Features
- Flexible deployment: Run the platform on-premises, in private cloud, in cloud, or in air-gapped environments.
- Model-agnostic support: Choose, swap, or fine-tune models and large language models.
- Explainability: Review explanations for AI-driven decisions.
- Audit trails: Track platform activity with audit-ready trails.
H2O.ai Integrations
H2O Driverless AI provides data connectors for Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, JDBC sources, and Delta Tables. These connectors let teams query or import data from existing platforms for machine learning workflows.
Pros and Cons
Pros:
- Air-gapped deployment supports controlled environments
- Distributed in-memory training scales across clusters
- AutoML speeds model comparison and prototyping
Cons:
- Cumbersome UI can slow workflows
- Data manipulation options are limited
Learn more about H2O.ai:
Outro concorrente do Databricks
Eis algumas opções adicionais de concorrentes do Databricks que não entraram na minha lista, mas que vale a pena conhecer:
- 11DremioBest for self-service analytics
- 12QuboleBest for big data workloads
- 13Azure DatabricksBest for collaborative analytics
- 14Amazon RedshiftBest for scalable data warehousing
- 15ClouderaBest for hybrid cloud deployments
- 16DataStaxBest for real-time data applications
- 17AlteryxBest for data preparation and blending
- 18RedisBest for in-memory data storage
- 19IBM Watson StudioBest for AI model development
- 20MongoDBBest for flexible document storage
- 21Neo4jBest for graph database solutions
- 22Teradata VantageBest for enterprise analytics solutions
- 23Oracle DatabaseBest for complex transaction processing
- 24SingleStoreBest for single-store database management
- 25Couchbase ServerBest for high-performance caching
- 26TigerGraphBest for graph analytics
- 27YellowbrickBest for hybrid cloud data warehousing
How I Evaluate Databricks Competitors
Whether your team is running Spark pipelines at scale or managing an ML lifecycle, I evaluate each alternative in two layers: core lakehouse and compute requirements first, then the differentiators.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score into a percentage. Each tool needs to achieve a minimum total score of 65% to be considered for inclusion.
- Unified Lakehouse Architecture: I check whether a platform can handle both structured warehouse queries and unstructured data lake storage, with support for open table formats like Delta, Iceberg, or Hudi.
- Distributed Data Processing: Large-scale batch and streaming workloads need a distributed engine that autoscales, so I evaluate compute options and how the platform handles jobs like multi-terabyte ETL runs.
- Integrated ML/AI Workflows: I look for end-to-end ML lifecycle support, from experiment tracking and model registry to deployment and serving, rather than just a notebook that can run training scripts.
- Collaborative Notebook Environment: Teams of data engineers, analysts, and ML engineers need shared, multi-language notebooks, so I evaluate real-time collaboration, version control, and language support across SQL, Python, Scala, and R.
- Data Governance & Security: A unified data catalog, fine-grained access controls, and lineage tracking matter here. I look at how each platform manages permissions across tables, columns, and AI assets in one place.
- Multi-Cloud & Open Integration: Vendor lock-in is a real concern, so I evaluate whether each tool runs across AWS, Azure, and GCP and how well it connects with orchestrators like Airflow, BI tools like Tableau, and ingestion layers like dbt.
Once I have a list of tools that meet this criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
Serverless compute is a major differentiator. I evaluate whether a platform lets teams run queries and jobs without managing clusters, which cuts overhead for groups with unpredictable workloads. Native GenAI tooling matters more each year, especially for teams building RAG pipelines or fine-tuning LLMs directly within their data platform. I also look at cost optimization controls like per-workload spend tracking and automated cluster policies, since cloud compute costs can spiral fast across large engineering teams.
Beyond Features
Total cost of ownership is one of the first things I evaluate. Consumption-based pricing can look appealing until data egress fees and premium support tiers inflate the bill. Ecosystem depth also matters—I check how well each platform connects with tools like Airflow, dbt, and Tableau, since most teams aren't replacing their entire stack. Implementation and time-to-value round out my evaluation. Migration tooling from legacy systems like Hadoop or Redshift can shave weeks off a transition, and strong documentation makes onboarding new engineers far less painful.
Como escolher um concorrente do Databricks
É fácil perder-se em listas extensas de funcionalidades e estruturas de preços complexas. Para o ajudar a manter o foco enquanto analisa o seu processo específico de seleção de software, eis uma lista de fatores a ter em conta:
| Fator | O que considerar |
| Escalabilidade | Garanta que a solução consegue lidar com o crescimento dos seus dados sem perda de desempenho. Verifique se suporta tanto o aumento horizontal como o vertical para maior flexibilidade. |
| Integrações | Procure compatibilidade com as suas ferramentas existentes, como lagos de dados ou ferramentas de BI, para garantir um fluxo de dados contínuo e evitar processos isolados. |
| Personalização | Avalie a capacidade da plataforma para se adaptar aos fluxos de trabalho e processos específicos da sua equipa. Os painéis personalizáveis podem responder às diferentes necessidades das equipas. |
| Facilidade de utilização | Considere a curva de aprendizagem e o grau de intuitividade da interface para a sua equipa. Uma plataforma fácil de utilizar pode reduzir o tempo de formação e aumentar a adoção. |
| Orçamento | Compare os modelos de preços e certifique-se de que se enquadram no seu orçamento. Considere custos ocultos, como armazenamento ou taxas adicionais por utilizador, que podem influenciar a sua decisão. |
| Medidas de segurança | Avalie as funcionalidades de segurança da plataforma, como a encriptação de dados e a conformidade com as normas do setor, para proteger dados sensíveis. |
| Suporte | Verifique a disponibilidade de opções de suporte ao cliente, incluindo chat em direto e fóruns da comunidade, para garantir que a sua equipa consegue obter ajuda quando necessário. |
| Desempenho | Analise a forma como a plataforma lida com grandes conjuntos de dados e com o processamento em tempo real, para garantir que corresponde às expectativas de desempenho da sua equipa. |
Tendências nos concorrentes da Databricks
Na minha pesquisa, recolhi inúmeras atualizações de produtos, comunicados de imprensa e registos de lançamentos de diferentes fornecedores concorrentes da Databricks. Estas são algumas das tendências emergentes que estou a acompanhar:
- Análise em tempo real: As empresas exigem cada vez mais informações sobre os dados em tempo real. Os fornecedores estão a melhorar as suas plataformas para processar e analisar dados em tempo real, permitindo aos utilizadores tomar decisões imediatas. Soluções como o Google BigQuery estão a incorporar funcionalidades que suportam a transmissão de dados em tempo real.
- Análise aumentada: Esta tendência consiste em utilizar IA e aprendizagem automática para melhorar os processos de análise de dados. Está a tornar-se popular, uma vez que ajuda os utilizadores a descobrir informações sem esforço manual. O IBM Watson Studio é um exemplo, disponibilizando funcionalidades de análise aumentada para automatizar a análise de dados.
- Democratização dos dados: Cada vez mais plataformas estão a concentrar-se em tornar os dados acessíveis a utilizadores não técnicos. Esta tendência é crucial para promover uma cultura orientada por dados nas organizações. Estão a ser desenvolvidas ferramentas com interfaces intuitivas e funcionalidades de autoatendimento, como as disponibilizadas pelo Alteryx.
- Governação de dados: À medida que as regulamentações de privacidade dos dados se tornam mais rigorosas, as funcionalidades de governação de dados assumem uma importância crescente. Os fornecedores estão a integrar ferramentas de governação para ajudar os utilizadores a cumprir os regulamentos e a gerir os dados de forma responsável. O Azure Synapse Analytics, por exemplo, disponibiliza funcionalidades de governação integradas.
- Suporte para a nuvem híbrida: Muitas empresas pretendem flexibilidade nas suas estratégias de nuvem. O suporte para a nuvem híbrida está a crescer, permitindo aos utilizadores gerir dados em ambientes locais e na nuvem. A Cloudera está na vanguarda desta tendência, fornecendo soluções que suportam implementações de nuvem híbrida.
O que é um concorrente da Databricks?
Os concorrentes da Databricks são soluções de software concebidas para disponibilizar funcionalidades de processamento de dados, análise e aprendizagem automática. Estas ferramentas são geralmente utilizadas por cientistas de dados, engenheiros e analistas para obter informações e apoiar decisões empresariais.
As funcionalidades de análise em tempo real, análise aumentada e governação de dados ajudam a processar dados de forma eficiente, a descobrir informações e a gerir os dados de forma responsável. De um modo geral, estas ferramentas permitem às empresas tirar partido dos seus dados para melhorar a tomada de decisões e o planeamento estratégico.
Funcionalidades de um concorrente da Databricks
Ao selecionar um concorrente da Databricks, tenha em atenção as seguintes funcionalidades essenciais:
- Análise em tempo real: Permite o processamento imediato de dados e a obtenção de informações, permitindo-lhe tomar decisões empresariais rápidas.
- Análise aumentada: Utiliza a IA para automatizar a análise de dados, ajudando a descobrir informações sem esforço manual.
- Governação de dados: Garante a conformidade com os regulamentos de privacidade dos dados e uma gestão responsável dos dados.
- Suporte para a nuvem híbrida: Permite gerir dados em ambientes locais e na nuvem, proporcionando flexibilidade.
- Colaboração interativa: Facilita o trabalho em equipa ao disponibilizar espaços de trabalho partilhados e ferramentas para a análise conjunta de dados.
- Dimensionamento automático: Ajusta os recursos com base na carga de trabalho, otimizando o desempenho sem intervenção manual.
- Integração de aprendizagem automática: Disponibiliza capacidades integradas de aprendizagem automática para previsões e informações avançadas sobre os dados.
- Personalização: Permite criar fluxos de trabalho e painéis personalizados para responder às necessidades e aos processos específicos da equipa.
- Medidas de segurança: Disponibiliza funcionalidades de encriptação e conformidade para proteger dados sensíveis.
- Interface intuitiva: Garante uma utilização fácil, reduzindo a curva de aprendizagem e aumentando a adoção na sua equipa.
Vantagens de um concorrente do Databricks
A implementação de um concorrente do Databricks proporciona várias vantagens à sua equipa e à sua empresa. Eis algumas das que pode esperar:
- Tomada de decisões melhorada: A análise em tempo real e a análise aumentada fornecem informações imediatas, melhorando a capacidade de tomada de decisões da sua equipa.
- Maior colaboração: As funcionalidades de colaboração interativa permitem que a sua equipa trabalhe em conjunto de forma eficaz, conduzindo a projetos de dados mais coesos.
- Escalabilidade: O dimensionamento automático permite que o seu sistema processe o crescimento dos dados de forma eficiente, sem ajustes manuais.
- Eficiência de custos: Os modelos de preços com pagamento conforme a utilização garantem que só paga pelos recursos que utiliza, otimizando a gestão do orçamento.
- Segurança melhorada: As medidas de segurança integradas protegem os seus dados, garantindo a conformidade com as normas do setor.
- Flexibilidade: O suporte para a nuvem híbrida oferece a flexibilidade necessária para gerir dados em vários ambientes, adaptando-se às necessidades da sua empresa.
- Personalização: As funcionalidades personalizáveis permitem adaptar os fluxos de trabalho e os painéis aos seus requisitos específicos, melhorando a produtividade.
Custos e preços de um concorrente do Databricks
A seleção de um concorrente do Databricks requer uma compreensão dos vários modelos de preços e planos disponíveis. Os custos variam consoante as funcionalidades, o tamanho da equipa, os complementos, entre outros fatores. A tabela abaixo resume os planos comuns, os respetivos preços médios e as funcionalidades normalmente incluídas nas soluções concorrentes do Databricks:
Tabela de comparação de planos de um concorrente do Databricks
| Tipo de plano | Preço médio | Funcionalidades comuns |
| Plano gratuito | $0 | Processamento básico de dados, armazenamento limitado e suporte da comunidade. |
| Plano pessoal | $10-$30 /utilizador /mês | Análise de dados melhorada, painéis pessoais e suporte por e-mail. |
| Plano empresarial | $50-$100 /utilizador /mês | Ferramentas de análise avançada, funcionalidades de colaboração em equipa e suporte prioritário. |
| Plano empresarial avançado | $150-$300/utilizador /mês | Integrações personalizadas, gestão dedicada da conta e segurança de nível empresarial. |
Perguntas frequentes sobre concorrentes da Databricks
Eis algumas respostas a perguntas comuns sobre concorrentes da Databricks:
Quem é o maior concorrente da Databricks?
A Snowflake é frequentemente considerada a maior concorrente da Databricks devido às capacidades semelhantes da sua plataforma de dados baseada na nuvem. Ambas oferecem funcionalidades abrangentes de processamento e análise de dados, mas a Snowflake é conhecida pelos seus pontos fortes no armazenamento de dados. Dependendo das suas necessidades específicas, qualquer uma das duas pode ser uma boa escolha.
O que irá substituir a Databricks?
Embora não exista uma única ferramenta destinada a substituir a Databricks, alternativas como o SQL Server disponibilizam funcionalidades apelativas. O SQL Server integra-se bem com ferramentas de análise de dados como o Power BI, oferecendo um sistema robusto de gestão de bases de dados relacionais. A sua escolha dependerá dos seus requisitos específicos de processamento de dados.
Quais são as limitações da Databricks?
A Databricks tem algumas limitações, como restrições ao número de widgets num notebook e limites de caracteres para os nomes e as entradas dos widgets. Estas limitações podem afetar a forma como concebe e utiliza os dados nos notebooks, por isso planeie em conformidade caso afetem os seus fluxos de trabalho.
Quais são os concorrentes da Amazon Databricks?
A Amazon Databricks enfrenta a concorrência de plataformas como a Snowflake, que oferecem capacidades semelhantes de processamento de dados. A Snowflake disponibiliza uma solução de armazém de dados baseada na nuvem, amplamente reconhecida pela sua escalabilidade e facilidade de utilização, o que a torna uma forte concorrente no mercado.
Como se comparam os preços da Databricks com os dos concorrentes?
Os preços da Databricks podem variar significativamente consoante a utilização e as funcionalidades. É importante compará-los com os de concorrentes como a Snowflake e o Google BigQuery, tendo em conta fatores como o armazenamento de dados, os custos de processamento e as funcionalidades adicionais. Avalie a estrutura de preços de cada plataforma para encontrar a opção mais adequada ao seu orçamento.
Que funcionalidades devo procurar num concorrente da Databricks?
Ao avaliar concorrentes da Databricks, procure funcionalidades como análise em tempo real, integração com aprendizagem automática e governação de dados. Estas capacidades melhoram o processamento e a análise dos seus dados, proporcionando valor à sua equipa. Tenha em consideração as necessidades específicas da sua empresa para determinar quais são as funcionalidades mais importantes.