


Jako lider technologiczny lub właściciel firmy rozumiesz, że wyprzedzenie konkurencji wymaga czegoś więcej niż tylko ambicji — wymaga podejmowania decyzji na podstawie danych. Właśnie tutaj do gry wkraczają narzędzia DevOps.
Za pomocą niewielkiej ilości danych możesz poprawić wydajność zespołu, efektywność procesów i zadowolenie klientów.
Nie oznacza to jednak, że jest to łatwe. Wdrożenie DevOps wiąże się z wyzwaniami w zakresie metryk. Wymaga strategicznego myślenia, kultury współpracy i zaangażowania w ciągłe doskonalenie. Rezultatem są jednak zoptymalizowane przepływy pracy i procesy, na których można zbudować solidne podstawy skalowania firmy.
W tym artykule omówimy najważniejsze metryki DevOps i sposoby ich pomiaru w celu ustalenia odpowiednich kluczowych wskaźników wydajności (KPI). Następnie dowiemy się, jak skutecznie wykorzystywać te metryki do skalowania firmy.
5 filarów dojrzałości procesów
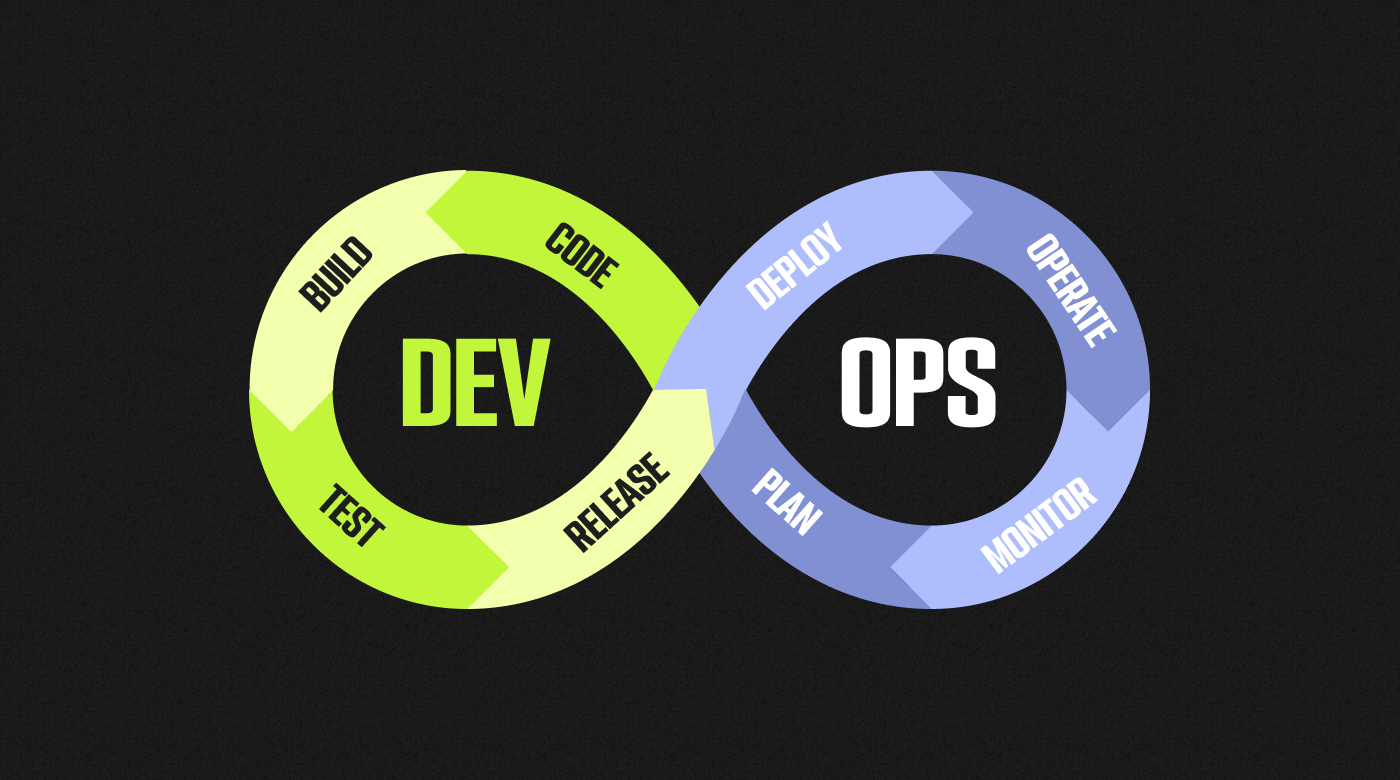
DevOps łączy i automatyzuje procesy, praktyki oraz narzędzia wykorzystywane w tworzeniu oprogramowania i operacjach, aby zwiększyć jakość i szybkość cykli życia oprogramowania.
Wdrażanie procesów biznesowych opiera się na pięciu kluczowych filarach, znanych jako Model Dojrzałości Zdolności (CMM). Model ten koncentruje się na pięciu poziomach dojrzałości wdrażania i ciągłego doskonalenia rozwoju usług lub produktów w ramach modelu biznesowego.
Pięć filarów ma wiele wariantów, ale początkowy, powtarzalny, zdefiniowany, zdolny i efektywny to oryginalne etapy. Alternatywą są kultura, automatyzacja, pomiar, dzielenie się wiedzą i informacje zwrotne. Każdy etap opiera się na tej samej koncepcji — zmieniły się jedynie ich nazwy.
Oto przykład pięciu filarów dojrzałości procesów wraz z krótkimi opisami każdego z nich:

Istnieje wiele metryk i struktur, które można wykorzystać do wdrożenia i pomiaru sukcesu DevOps w zespole. Przyjrzyjmy się im w tej sekcji.
Struktury DevOps oparte na zasadach
W DevOps istnieją trzy główne struktury oparte na zasadach. Podejście oparte na zasadach oznacza praktyczne podejście z ogólnymi wytycznymi, w przeciwieństwie do podejścia opartego na regułach, które zakłada stosowanie nakazowych kroków.
Struktura Accelerate
Autorzy, dr Nicole Forsgren, Jez Humble i Gene Kim, analizują w swojej książce „Accelerate: nauka o szczupłym tworzeniu oprogramowania i DevOps: budowanie i skalowanie wysokowydajnych organizacji technologicznych”, co wyróżnia wysokowydajne firmy technologiczne.
To właśnie w tej książce powstała struktura Accelerate DevOps, która koncentruje się na praktykach technicznych i zarządczych w zespołach DevOps wysokowydajnych organizacji technologicznych. Można ją postrzegać jako analizę najlepszych praktyk zespołu DevOps.
Trzy kluczowe obszary praktyk technicznych to:
- Ciągłe dostarczanie: Ciągłe dostarczanie obejmuje takie obszary jak kontrola wersji, ciągła integracja, wdrażanie i automatyzacja testów oraz zarządzanie danymi testowymi. Chociaż ciągłe dostarczanie jest samodzielną zasadą, w ramach struktury Accelerate jest stosowane jako pojęcie nadrzędne. Wynika to z faktu, że zespoły DevOps osiągające najwyższy poziom wykonują te elementy jednocześnie, zamiast realizować je w izolacji.
- Architektura: Stwierdzono, że wysokowydajne zespoły DevOps przeprowadzają większość testów bez potrzeby korzystania ze zintegrowanego środowiska, wdrażają nowe aplikacje niezależnie od aplikacji, od których zależą, oraz przedkładają testowanie i możliwość wdrażania nad najnowsze technologie.
- Produkt i proces: W trakcie całego procesu tworzenia regularnie zbierane są opinie klientów, prace prowadzone są w małych partiach, przeprowadzane są eksperymenty, a procesy są stale optymalizowane. Stwierdzono, że takie podejście dostarcza wartość, szybko naprawia błędy i umożliwia utworzenie pętli informacji zwrotnych od klientów.
Praktyki zarządcze koncentrują się na dwóch kluczowych obszarach. Są to:
- Szczupłe zarządzanie i monitorowanie: Struktura Accelerate wykazała, że minimalna liczba procesów zatwierdzania poprawia wydajność dostarczania oprogramowania w porównaniu z zespołami wymagającymi zatwierdzenia przez stronę trzecią. Monitorowanie możliwości za pomocą limitów prac w toku i wizualnych narzędzi do zarządzania projektami również poprawia wydajność.
- Kultura: Struktura kładzie duży nacisk na znaczenie tworzenia odpowiedniego środowiska pracy w celu poprawy wydajności DevOps. Współpraca i nauka to dwa kluczowe elementy, którym powinno towarzyszyć wspierające i zachęcające podejście do pracy zespołowej. Zespoły te powinny otrzymywać wsparcie transformacyjnego przywództwa. Osoby na takich stanowiskach zazwyczaj motywują innych, stymulują intelektualnie i doceniają osiągnięcia swoich zespołów.
„Czas realizacji zmian” to metryka DevOps, którą omówimy bardziej szczegółowo poniżej. Mierzy ona, ile czasu upływa od zatwierdzenia zmiany kodu przez programistę do jej pomyślnego wdrożenia na środowisko produkcyjne. Stosując tę metrykę w ramach Przyspieszenia, można mierzyć i poprawiać szybkość oraz efektywność procesu dostarczania oprogramowania, co prowadzi do szybszych i bardziej niezawodnych wdrożeń.
Struktura Trzech Dróg
Przedstawiona w Projekcie Feniks, której autorami są Gene Kim, Kevin Behr i George Spafford, oraz opisana w Podręczniku DevOps, struktura Trzech Dróg poprawia wydajność DevOps, koncentrując się na zasadach przepływu, informacji zwrotnej i ciągłego uczenia się.

Oto przegląd struktury Trzech Dróg:
- Pierwsza Droga: myślenie w kategoriach przepływu:
Pierwsza droga polega na osiągnięciu nieprzerwanego przepływu pracy od etapu rozwoju do operacji oraz szybkim i niezawodnym dostarczaniu wartości klientom.
„Czas realizacji do środowiska produkcyjnego” to metryka, którą można tu wykorzystać, mierząc czas potrzebny na przejście zmiany kodu od pierwszego zatwierdzenia do wdrożenia na środowisko produkcyjne i dążąc do skrócenia tego czasu poprzez optymalizację potoku dostarczania, automatyzację procesów oraz ograniczenie ręcznych interwencji.
- Druga Droga: wzmacnianie pętli informacji zwrotnej
Druga droga ustanawia szybkie i skuteczne pętle informacji zwrotnej w całym procesie dostarczania oprogramowania, aby umożliwić ciągłe uczenie się, doskonalenie i zapewnianie jakości.
W przypadku metryki „średni czas wykrycia (MTTD)” oblicza się średni czas potrzebny na wykrycie problemu lub anomalii po wdrożeniu zmiany kodu na środowisko produkcyjne. Należy skupić się na skróceniu MTTD poprzez usprawnienie monitorowania, systemów alertów i pętli informacji zwrotnej, aby szybko identyfikować problemy i reagować na nie.
- Trzecia Droga: kultura ciągłego eksperymentowania i uczenia się
Trzecia i ostatnia droga promuje kulturę ciągłego uczenia się, eksperymentowania i podejmowania ryzyka, aby napędzać innowacyjność, zdolność adaptacji i rozwój organizacji.
Idealnie nadaje się tu metryka „wskaźnik nieudanych zmian”. Śledzi się odsetek zmian kodu, które po wdrożeniu skutkują awariami lub problemami. Należy stworzyć kulturę eksperymentowania poprzez zapewnienie bezpiecznego środowiska do testowania, wyciąganie wniosków z porażek i ciągłe doskonalenie procesów w celu zmniejszenia wskaźnika nieudanych zmian.
Struktura CALMS
Struktura CALMS obejmuje zasady kultury, automatyzacji, podejścia Lean, pomiaru i współdzielenia. Jest idealnym rozwiązaniem dla zespołów, które chcą przejść na podejście DevOps do tworzenia oprogramowania i wyeliminować pracę zespołów deweloperskich oraz operacyjnych w odizolowanych silosach.
Twórcę struktury CALMS już znasz, ponieważ był współautorem Przyspieszenia i Podręcznika DevOps, w których opisano odpowiednio struktury Przyspieszenia i Trzech Dróg. Jez Humble stworzył strukturę CALMS jako ocenę przydatności, która pozwala sprawdzić, czy firmy są przygotowane i gotowe do wdrożenia procesów DevOps.
Podobnie jak CMM, ale przeznaczona konkretnie do zarządzania DevOps, struktura CALMS pozwala sprawdzić, czy firma jest gotowa.
Oto pięć filarów, których należy przestrzegać:
- Kultura: Twoje zespoły deweloperskie i operacyjne pracowały w ramach własnych grup, z własnymi procesami i stylami komunikacji. Musisz pielęgnować poczucie wspólnej odpowiedzialności, aby zapewnić kulturę gotową na DevOps.
- Automatyzacja: DevOps polega na usprawnianiu procesów, zwiększaniu szybkości i efektywności. Klucz do tego? Automatyzacja. Twoje zespoły muszą przygotować się do automatyzacji ręcznych zadań i procedur wszędzie tam, gdzie jest to możliwe. Ten krok wesprze ciągłe tworzenie, testowanie, wdrażanie i monitorowanie wydań oprogramowania składających się na cykl życia DevOps.
- Lean: Zasady metodyki Lean, podejścia do zarządzania firmą i projektami, służą do ograniczania marnotrawstwa i optymalizacji strumieni wartości. Musisz utrzymywać realistyczne obciążenie pracą i wizualizować statusy projektów, aby przyspieszać procesy.
- Pomiar: Twoja firma może być gotowa do wdrożenia DevOps, jeśli zaszła już tak daleko, a Twoje zespoły są zaangażowane w gromadzenie i analizowanie danych w celu usprawniania procesów.
- Współdzielenie: Oprócz kultury wspólnej odpowiedzialności Twoje zespoły muszą być otwarte i chętne do współdzielenia danych oraz informacji, aby zapewnić wszystkim zgodność ze wspólnymi celami i wyeliminować rywalizację. Ten ostatni punkt oceny zapewnia płynne przekazywanie zadań i szybki rozwój.
Have an account? Log In
Wyzwania związane z wdrażaniem DevOps
Jednym z największych wyzwań związanych z wdrażaniem DevOps jest opór przed zmianą kultury organizacyjnej. Masz do czynienia z dwoma zespołami, z których każdy ma własne procesy, narzędzia i style komunikacji. Przekształcenie ich w jedną spójną jednostkę ze wspólnymi celami, obowiązkami i wskaźnikami jest znaczącą transformacją. Utrzymanie wysokiego morale i przejrzystego podejścia do każdego etapu procesu wdrażania ma kluczowe znaczenie dla zapewnienia jego sprawnego przebiegu. Należy również uwzględnić koszty nowych narzędzi i metod.
Jeśli Twój zespół preferuje korzystanie z ram opartych na regułach, rozpoczęcie pracy z ramami opartymi na zasadach może być sporą zmianą. Jest to podejście dynamiczne i często ewoluuje wraz z zespołem, dlatego może być trudne do opanowania dla pracowników, którzy przez wiele lat stosowali tradycyjne podejścia, lub dla nowych członków zespołu próbujących odnaleźć się w tej dynamicznej strukturze.
Wreszcie ciągły przepływ pracy może powodować różne podatności, a wydania oprogramowania mogą być wdrażane bez szyfrowania danych lub uwierzytelniania, a także z przepełnieniami bufora. Może to narazić zespoły DevOps na ryzyko naruszeń bezpieczeństwa, dlatego w miarę dojrzewania zespołu DevOps konieczne jest zaostrzenie procesów w tym obszarze. To również powód, dla którego wdrażanie nie powinno się rozpocząć, dopóki nie zostanie wykorzystany model CALMS do oceny gotowości.
Dlaczego metryki DevOps są ważne?
Jak wspomniano powyżej, wspólne cele i metryki mogą stanowić wyzwanie dla zespołów wdrażających DevOps w firmie. Bez metryk DevOps nie byłoby testowania ani pomiarów, a także żadnych usprawnień w procesie tworzenia oprogramowania. Byłyby tylko kolejne iteracje tego samego oprogramowania oparte na przeczuciach i pomysłach, wypuszczane w otchłań, a następnie zastępowane próbami czegoś nowego. Bez informacji zwrotnych lub metryk sukcesu produktu pozwalających zrozumieć, jak coś działa, nie ma wyznaczonego kierunku.
Na przykład działy finansowe chcą utrzymywać koszty na możliwie niskim poziomie, podczas gdy deweloperzy chcą utrzymywać wydajność na możliwie wysokim poziomie. Te dwa cele mogą nie być zgodne, chyba że ryzyko zostało ocenione, a zespoły rozumieją wzajemne cele.
Podczas gdy deweloperzy mogą zdecydować się na wydanie nieukończonego produktu i zajęcie się nim później, koszt tego wpływu powoduje powstanie długu technicznego. Wdrażanie DevOps może ujednolicić cele i strategie obu zespołów, a także pomóc deweloperom zrozumieć wpływ kosztowy ich decyzji technicznych.
To tylko niewielka część DevOps i znaczenia wspólnych metryk.
Zrozumienie metryk DevOps
Wdrażanie DevOps i rozumienie ram opartych na zasadach to jedno, ale to właśnie metryki DevOps pozwalają naprawdę dostrzec korzyści płynące z tego opartego na współpracy podejścia do cyklu życia oprogramowania. Podobnie jak w przypadku większości strategii biznesowych, istnieje nieskończenie wiele metryk, które można wybrać do pomiaru rozwoju, w zależności od branży, odbiorców i celów.
Zespół Google Cloud DevOps Research and Assessment (DORA) jest najdłużej działającym zespołem badawczym tego rodzaju. Początkowo wskazał cztery kluczowe metryki służące do pomiaru wydajności „elity” w DevOps. Od tego czasu do zestawu dodano jednak piątą kluczową metrykę, a analiza skupień wykrywa obecnie tylko trzy poziomy zespołów DevOps: wysoki, średni i niski, przy czym „elita” należy już do przeszłości.
4 kluczowe metryki DORA
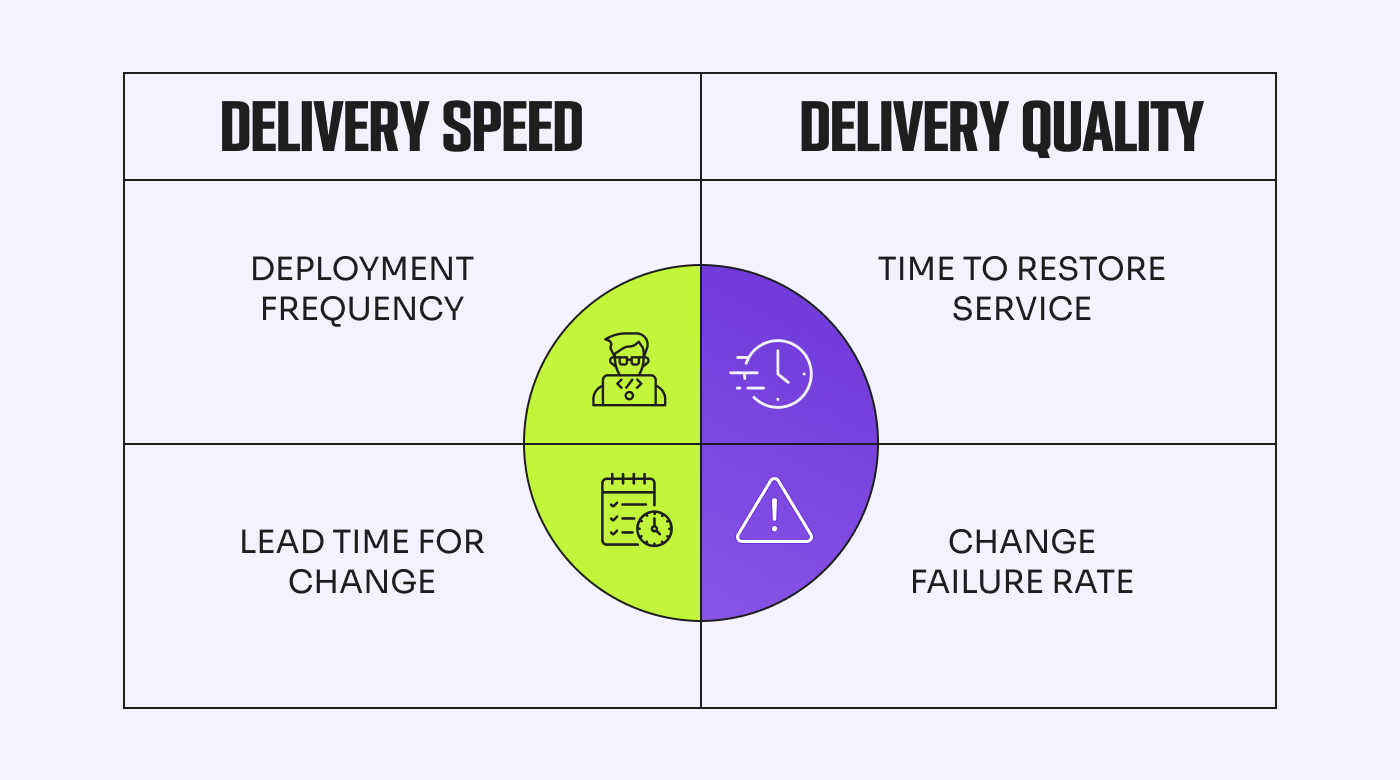
Oto bliższe omówienie czterech metryk DORA:
1. Częstotliwość wdrożeń (DF)
DF mierzy, jak często pomyślnie wdrażasz oprogramowanie na produkcji. Ta metryka dotyczy spójności i stanowi doskonały wskaźnik realizacji celów.
Zespoły zaliczane do kategorii „elity” konsekwentnie wdrażałyby oprogramowanie na produkcji wiele razy dziennie, podczas gdy zespoły osiągające słabe wyniki robiłyby to mniej więcej raz na sześć miesięcy.
Poprawa DF jest tak prosta, jak wydawanie kilku drobnych aktualizacji. Główną korzyścią takiego działania jest wskazanie wszelkich blokad procesów, wąskich gardeł lub złożonych projektów wymagających uwagi. Większe zespoły mogą preferować wdrażanie w regularnych odstępach poprzez tworzenie pociągów wydań Agile; pomoże to zmniejszyć przytłoczenie wynikające z bardzo szybkiego tempa i dużej liczby osób.
2. Czas realizacji zmian (LTC)
LTC oznacza czas potrzebny na przejście zatwierdzenia do środowiska produkcyjnego. Ta metryka jest dobrym wskaźnikiem responsywności i elastyczności zespołu, ponieważ mierzy, jak szybko może on reagować na potrzeby i wymagania użytkowników.
Dziedziczny standard „elitarny” zakładałby mniej niż jeden dzień dla LTC, podczas gdy zespoły osiągające słabsze wyniki mogłyby potrzebować ponad sześciu miesięcy. Wyniki z dolnego końca skali LTC prawdopodobnie wynikają z nieefektywnych procesów.
Możesz poprawić ten wskaźnik, usprawniając procesy automatyzacji, zwłaszcza testowanie. Udoskonalając potok ciągłej integracji i ciągłego dostarczania (CI/CD), możesz szybciej wdrażać aktualizacje na produkcję. Należy jednak zwrócić uwagę na ryzyko związane ze zrównoważonym rozwojem. Jeśli Twój zespół nie będzie w stanie utrzymać tego zwiększonego tempa, możesz napotkać problemy z doświadczeniami użytkowników i potencjalne luki w zabezpieczeniach.
3. Wskaźnik nieudanych zmian (CFR)
CFR to odsetek wdrożeń powodujących awarię w środowisku produkcyjnym. Awarią może być niedostępność, wycofanie zmian lub pogorszenie jakości usługi. Ten wskaźnik pokazuje skuteczność zespołu podczas wdrażania zmian.
Elitarne wartości referencyjne wynoszą 0–15%, podczas gdy wyniki wysokie, średnie i niskie mieszczą się w przedziale 16–30%.
Poprawa CFR polega na stawianiu jakości ponad ilością. Firmy wdrażają różną liczbę zmian, a zatem odnotowują również różną liczbę awarii. Jednak modyfikacje najwyższej jakości skutkują mniejszą liczbą awarii, niezależnie od tego, czy zmiany są wdrażane dwa razy w roku, czy dwa razy dziennie.
4. Średni czas przywracania działania (MTTR)
MTTR określa, ile czasu zespół potrzebuje na przywrócenie działania usługi po awarii lub zakłóceniu. Wskaźnik ten mierzy nie tylko elastyczność zespołu, ale także dobrze pokazuje stabilność oprogramowania.
Jeśli dążysz do poziomu „elitarnego”, MTTR powinien wynosić mniej niż godzinę. Zespoły osiągające słabe wyniki mogą potrzebować ponad sześciu miesięcy.
Możesz zmniejszyć MTTR, koncentrując się na niewielkich, szybkich wydaniach, dzięki którym łatwiej znaleźć i naprawić awarie. Możesz również rozważyć flagi funkcji aby zapewnić zespołowi większą kontrolę — zwłaszcza w przypadku funkcji eksperymentalnych.
Pozostał jeszcze jeden wskaźnik do omówienia.
5. Niezawodność
Piątym, dodatkowym wskaźnikiem jest niezawodność. Wskaźnik ten został później wyodrębniony przez zespół DORA (w 2021 roku), ponieważ wcześniej dostępność była mierzona jako punkt odniesienia dla niezawodnego oprogramowania. Uznano jednak, że niezawodność lepiej obejmuje dostępność, opóźnienia, wydajność i skalowalność. Zasadniczo oznacza to uwzględnienie pomiaru wydajności operacyjnej obok procesu tworzenia oprogramowania.
Inne istotne wskaźniki DevOps
- Czas cyklu: Czas cyklu to całkowity czas od rozpoczęcia zadania do jego ostatecznego dostarczenia. Na pierwszy rzut oka mierzy on szybkość pracy zespołu. Możesz jednak przeanalizować ten wskaźnik dokładniej, aby znaleźć wąskie gardła, takie jak długi czas oczekiwania w kolejce i długo otwarte żądania ściągnięcia.
- Średni czas między awariami (MTBF): MTBF mierzy średni czas, który upływa między awariami systemu, przestojami lub incydentami. Wskaźnik ten ocenia niezawodność i stabilność systemów oprogramowania, wskazując skuteczność strategii konserwacji zapobiegawczej i ograniczania błędów.
- Średni czas wykrycia (MTTD): Jest to średni czas potrzebny zespołowi na potwierdzenie wystąpienia awarii. Niska wartość MTTD wskazuje na sprawne systemy monitorowania i alarmowania, umożliwiające szybką reakcję na incydenty i ich rozwiązanie.
- Czas ograniczenia skutków (TTM): TTM to czas potrzebny na naprawienie problemu po jego wykryciu. Wskaźnik ten pomaga ocenić procesy reagowania na incydenty i ich rozwiązywania, wskazując skuteczność zespołów w usuwaniu problemów i przywracaniu działania.
- Czas realizacji zmiany (CLT): CLT stanowi punkt odniesienia dla kompleksowego procesu wdrażania zmiany, obejmującego tworzenie, testowanie, przegląd i wdrażanie. Krótszy CLT oznacza szybsze cykle dostarczania i większą elastyczność.
- Wskaźnik przedostawania się defektów: Wskaźnik przedostawania się defektów określa, ile błędów pominięto podczas testowania i wydano na środowisko produkcyjne — czyli ile z nich „przedostało się”. Wskaźnik ten doskonale nadaje się do śledzenia postępów, jeśli chcesz usprawnić procesy testowania i automatyzacji.
Jak ustalać KPI za pomocą wskaźników DevOps
Teraz, gdy dobrze rozumiesz wskaźniki, których możesz używać do wdrażania i optymalizacji DevOps w swojej firmie, warto poznać kluczowe wskaźniki efektywności (KPI), aby wyznaczyć cele i wartości referencyjne dla swojego zespołu.
Wskaźniki a KPI
Możesz zastanawiać się, czym różnią się metryki od KPI. Metryka to to, co mierzysz. Jest to mierzalny parametr dostarczający danych na temat określonego aspektu wydajności. Nie wszystkie metryki muszą być powiązane z konkretnymi celami lub założeniami.
Z drugiej strony KPI to rodzaj metryki strategicznie wybranej i zdefiniowanej w celu odzwierciedlenia najważniejszych aspektów wydajności i postępów w realizacji celów strategicznych. KPI są zazwyczaj powiązane z celami i często mają przypisane założenia, wartości progowe lub punkty odniesienia, które należy osiągnąć.
Ustalanie KPI dla zespołu DevOps
Pierwszym krokiem do ustalenia KPI dla zespołu DevOps jest powiązanie metryk DevOps ze strategią i celami biznesowymi. Ustalając priorytety najważniejszych metryk, które należy śledzić, możesz zacząć wyznaczać założenia i punkty odniesienia dla ciągłego doskonalenia. Wybór odpowiednich metryk wymaga uwzględnienia wielkości firmy, produktu i rynku. Skoncentruj się na tym, co dostarczy najbardziej praktycznych informacji, unikając powszechnego problemu nadmiaru metryk.
Monitorowanie KPI jest równie ważne jak ich ustalanie. Zapoznaj się z narzędziami do wizualizacji danych zapewniającymi zespołowi dane w czasie rzeczywistym na intuicyjnych pulpitach. Gwarantuje to pełną widoczność, zapewnia rozliczalność i pozwala wszystkim wspólnie pracować nad celami, harmonizując zespoły programistyczne i operacyjne oraz wspierając wdrażanie i rozwój DevOps.

Na podstawie podstawowych metryk DORA możemy zobaczyć wartości referencyjne dla każdej metryki w przypadku zespołów o wysokiej, dobrej, średniej i niskiej wydajności. Tabela ta może pomóc w ustaleniu KPI dla własnej firmy, w zależności od tego, co uznajesz za priorytet.
Ustalając KPI, najlepiej dokładnie przeanalizować swój zespół i firmę, nie porównując ich z innymi przedsiębiorstwami. Jeśli spojrzymy na CFR jako przykład, wartość referencyjna jest taka sama dla wysokiej, średniej i niskiej wydajności. Będzie to w dużej mierze zależeć od częstotliwości wdrożeń, ale może również wpływać na nią w odwrotny sposób. Jeśli zespół poświęca cały czas na naprawianie awarii, ma mniej czasu na opracowywanie i wdrażanie aktualizacji. KPI mogą również zmieniać się wraz z rozwojem zespołu DevOps. Szczelne procesy automatyzacji i testowania powinny automatycznie oznaczać możliwość podniesienia poprzeczki dla założeń.
More Articles
Jak wykorzystywać metryki DevOps do skalowania
Przewiduje się, że wartość globalnego rynku DevOps osiągnie 24.71 miliarda dolarów do 2027 roku (złożona roczna stopa wzrostu wynosząca 22.9%, obliczona na podstawie wartości rynku 10.84 miliarda dolarów w 2023 roku), więc jeśli zastanawiasz się, kiedy najlepiej rozpocząć wdrażanie tego rozwiązania w swojej firmie, potraktuj to jako sygnał.
DevOps nie tylko przyspiesza rozwój, skracając czas wprowadzenia produktu na rynek, lecz także usprawnia współpracę poprzez eliminowanie silosów, podnosi jakość dzięki ciągłemu testowaniu i pętlom informacji zwrotnej oraz efektywnie wykorzystuje zasoby, co pozwala oszczędzać pieniądze. Wreszcie można go łatwo skalować, wspierając rozwój firmy i przekraczanie jej dotychczasowych granic — w 2021 roku 83% osób decyzyjnych w IT uzyskało większą wartość biznesową dzięki wdrożeniu DevOps.
Pomiar wydajności i ciągłe doskonalenie
Monitorowanie wydajności jest kluczem do skalowania firmy wykorzystującej DevOps. Jest to podejście o szybkim tempie i stałym przepływie prac produkcyjnych, dlatego pomiary i raportowanie powinny odbywać się równie często. Metryki DevOps pozwalają śledzić wydajność procesów programistycznych i procesów dostarczania. Kwantyfikując kluczowe aspekty, takie jak częstotliwość wdrożeń, czas realizacji i współczynnik nieudanych zmian, możesz identyfikować wąskie gardła, nieefektywności i obszary wymagające poprawy. Umożliwia to częstą optymalizację przepływów pracy i procesów.
Śledzenie metryk, takich jak współczynnik nieudanych zmian i średni czas przywrócenia działania, pomaga identyfikować trendy umożliwiające wczesne wykrywanie problemów. To proaktywne podejście oznacza możliwość podjęcia działań naprawczych i zminimalizowania wpływu na klientów, zapewniając niezawodność — kolejny kluczowy składnik skalowania przy zachowaniu wysokiej jakości.
Wreszcie korzystanie z metryk DevOps pomoże rozwijać zespół DevOps poprzez budowanie kultury ciągłego doskonalenia. Pętle informacji zwrotnej sprzyjają uczeniu się i rozwojowi; zawsze musi istnieć przestrzeń do eksperymentowania z różnymi podejściami.
Które metryki DevOps wspierają rozwój firmy?
Podczas ustalania KPI większość metryk należy rozpatrywać w kontekście własnego zespołu i ukierunkowywać na rozwój, zamiast porównywać je z innymi firmami i grupami znajdującymi się na różnych poziomach dojrzałości.
Na przykład niski LTC może wskazywać, że Twój zespół działa wydajnie, ale jeśli nie jest w stanie utrzymać tempa, nie jest to zrównoważone i może ostatecznie wpłynąć na doświadczenia użytkowników. Ten wskaźnik należy mierzyć w czasie, zamiast ustalać KPI na poziomie odpowiadającym wysoko wydajnemu, a nawet elitarnemu, dojrzałemu zespołowi DevOps. Ustalanie KPI mających na celu zmniejszanie LTC z miesiąca na miesiąc, z kwartału na kwartał lub z roku na rok pokazuje rozwój Twojego zespołu i firmy.
CFR jest wartościowym wskaźnikiem, ponieważ nie każdy ma taką samą liczbę awarii lub problemów, ale wyrażenie tego w procentach pozwala mierzyć skuteczność wdrożeń. Twój zespół może odnotowywać bardzo niewiele awarii, jeśli rzadko publikuje zmiany, ale jeśli każde wydanie powoduje problem, CFR będzie bardzo wysoki. Jeśli stosujesz praktyki CI/CD, możesz odnotowywać większą liczbę awarii, ale jeśli Twój CFR jest niski, zyskujesz przewagę, ponieważ szybkość i jakość wspierają rozwój. MTTR również należy mierzyć w czasie, aby zapewnić stały rozwój.
DORA ustaliło, że zespoły o każdym poziomie wydajności programistycznej osiągały lepsze wyniki, gdy koncentrowały się na wydajności operacyjnej. Może to oznaczać ustalenie KPI dotyczących raportów dotyczących incydentów lub otwartych zgłoszeń, czasu działania aplikacji i jej dostępności.
Duża liczba otwartych zgłoszeń może wskazywać na problem z satysfakcją klientów, ale dążenie do jej zmniejszania w czasie odzwierciedla rozwój w tym obszarze. Możesz przeanalizować ten temat dokładniej i mierzyć czas reakcji oraz czas oczekiwania w kolejce, aby przyspieszyć poprawę tego wskaźnika.
Jedynym wskaźnikiem, który w pełni łączy rozwój i operacje w ramach zespołu DevOps, jest czas cyklu. Stwarza to przestrzeń do budowania kultury informacji zwrotnej i rozwoju. W miarę poprawy innych wskaźników i dojrzewania automatyzacji należy oczekiwać skrócenia czasu cyklu. Jeśli obsługa klienta stoi na wysokim poziomie, a liczba awarii podczas rozwoju jest niska, udało Ci się znaleźć zwycięską kombinację umożliwiającą skalowanie firmy.
Postaw na kulturę opartą na metrykach, aby osiągnąć długoterminowy sukces
Dowiedzieliśmy się, jak wdrażać podejmowanie decyzji oparte na danych poprzez śledzenie i mierzenie odpowiednich wskaźników DevOps. Właściwe podejście może przynieść korzyści w zakresie wydajności zespołu, efektywności procesów i satysfakcji klientów.
Chociaż wszystkie struktury DevOps koncentrują się na kulturze, współpracy i ciągłym doskonaleniu, określenie, która struktura i które wskaźniki pasują do Twojej strategii rozwoju, pomoże Twojej firmie najskuteczniej się skalować.
Pamiętaj, aby zapisać się do naszego newslettera i być na bieżąco ze wszystkimi najnowszymi informacjami od naszych ekspertów branżowych.

