

Po dogłębnej analizie wybrałem 12 najlepszych narzędzi do generowania języka naturalnego , które pomogą sprostać wyzwaniu, przed którym stoisz.
W erze chatbotów i wirtualnych asystentów oprogramowanie do generowania języka naturalnego (NLG) wyróżnia się jako rozwiązanie przełomowe. Dzięki wykorzystaniu analityki danych i dużych zbiorów danych narzędzia te symulują ludzki język, przekształcając dane tekstowe w spójne narracje. Na własne oczy przekonałem się, jak technologia NLG pomaga w tworzeniu podsumowań dla mediów społecznościowych, odpowiadaniu na pytania w portalach samoobsługowych oraz klasyfikowaniu tekstu w ochronie zdrowia.
Dostawcy zintegrowali struktury NLG i NLU ze swoimi platformami, odblokowując potężne korzyści. W istocie oprogramowanie NLG przekształca dane w historie przypominające ludzkie wypowiedzi, oferując firmom narzędzie, które usprawnia każdą interakcję z klientem i sprawia, że technologia staje się bardziej intuicyjna oraz skoncentrowana na człowieku.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza oprogramowania do generowania języka naturalnego
Ta tabela porównawcza zawiera podsumowanie informacji o cenach wybranych przeze mnie najlepszych programów do generowania języka naturalnego:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepszy do NLG z kontekstem 1 miliona tokenów na poziomie API | Dostępny plan bezpłatny | Od $20/miesiąc | Website | |
| 2 | Najlepsze rozwiązanie do generowania języka naturalnego w całym stosie Google Cloud | Dostępny bezpłatny plan | Ceny dostępne na żądanie | Website | |
| 3 | Najlepsze rozwiązanie dla zarządzanego NLG w regulowanych przedsiębiorstwach | Nie | Ceny na życzenie | Website | |
| 4 | Najlepsze rozwiązanie do konwersji dokumentów na tekst NLG na dużą skalę | Dostępny plan bezpłatny | Od $14.99/miesiąc | Website | |
| 5 | Najlepszy do NLG w całym stosie chmurowym AWS | 6-miesięczny bezpłatny okres próbny + dostępne bezpłatne demo | Ceny dostępne na żądanie | Website | |
| 6 | Najlepsze rozwiązanie do opisów produktów e-commerce | Niedostępne | Ceny dostępne na żądanie | Website | |
| 7 | Najlepsze rozwiązanie do tworzenia dokumentacji regulacyjnej w branży farmaceutycznej i finansowej | Dostępna bezpłatna wersja demonstracyjna | Ceny dostępne na żądanie | Website | |
| 8 | Najlepsze rozwiązanie do prywatnie wdrażanego NLG z cytowaniami RAG | Dostępna bezpłatna wersja demonstracyjna | Ceny dostępne na żądanie | Website | |
| 9 | Najlepszy wybór dla NLG w ramach stosu chmurowego Azure | Dostępny bezpłatny plan | Ceny dostępne na żądanie | Website | |
| 10 | Najlepsze do generowania języka naturalnego (NLG) opartego na grafowym RAG za pośrednictwem API | Dostępna bezpłatna wersja próbna + bezpłatne demo | Ceny ustalane na żądanie | Website |


Recenzje najlepszego oprogramowania do generowania języka naturalnego
Poniżej znajdują się moje szczegółowe podsumowania najlepszych programów do generowania języka naturalnego, które trafiły na moją listę. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety & wady, integracje oraz idealne zastosowania każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Najlepszy do NLG z kontekstem 1 miliona tokenów na poziomie API
- Dostępny plan bezpłatny
- Od $20/miesiąc
Visit WebsiteCustomer Rating:4.4/5
Claude wskazuje problemy dotyczące warunków umowy i sugeruje precyzyjne zmiany NLG. Claude to platforma API NLG firmy Anthropic, która łączy okno kontekstowe o rozmiarze 1 miliona tokenów, generowanie tekstu w wielu formatach oraz ekosystem SDK obsługujący siedem języków, aby wspierać strukturyzowanie danych do tekstu, przetwarzanie wsadowe i przepływy pracy RAG na dużą skalę.
Dla kogo Claude jest najlepszym wyborem?
Claude doskonale sprawdzi się w zespołach inżynieryjnych i DevOps, które muszą obsługiwać duże obciążenia NLG za pośrednictwem API, szczególnie gdy w ramach jednego wywołania przetwarzają pełne pliki dzienników, zestawy dokumentacji lub eksporty danych.
Dlaczego wybrałem Claude
Uwzględniłem Claude wśród najlepszych rozwiązań, ponieważ jego okno kontekstowe o rozmiarze 1 miliona tokenów jest naprawdę bezkonkurencyjne w przypadku obciążeń NLG obsługiwanych przez API. Mogę przekazać mu cały plik dziennika, pełny eksport bazy danych lub obszerny zestaw dokumentacji w ramach jednego wywołania i otrzymać spójną, ustrukturyzowaną narrację. Interfejs API partii komunikatów obsługuje do 100 000 żądań w jednej partii przy połowie standardowego kosztu tokenów, dzięki czemu potoki generowania tekstu o dużej przepustowości stają się praktyczne bez gwałtownego zwiększania budżetu.
Najważniejsze funkcje Claude
- Ustrukturyzowane dane wyjściowe: Ogranicza odpowiedzi API do zdefiniowanych przez klienta schematów JSON, zapewniając, że dalsze potoki otrzymują czysty, możliwy do przeanalizowania tekst bez ręcznego przetwarzania końcowego.
- Funkcja cytowania: Bezpośrednio opiera wygenerowany tekst na dokumentach źródłowych dostarczonych w czasie wnioskowania, zapewniając możliwą do prześledzenia ścieżkę dla każdego twierdzenia w danych wyjściowych.
- Strumieniowanie w czasie rzeczywistym za pośrednictwem zdarzeń wysyłanych przez serwer (SSE): Dostarcza dane wyjściowe token po tokenie przez zdarzenia wysyłane przez serwer, dzięki czemu można tworzyć bieżące podsumowania incydentów i dynamiczne pulpity bez oczekiwania na pełne zakończenie generowania odpowiedzi.
- Obsługa wielojęzycznych danych wyjściowych: Rozpoznaje i generuje tekst w języku wynikającym z kontekstu rozmowy, a także umożliwia precyzyjne sterowanie językiem za pomocą komunikatu systemowego w przepływach pracy związanych z tłumaczeniem.
Integracje Claude
Claude obsługuje ponad 818 integracji konektorów MCP, w tym GitHub, Atlassian, Microsoft 365, Slack, Notion, Google Drive i Asana. Jego interfejs REST API oraz siedem oficjalnych SDK obsługują niestandardowe integracje i przepływy pracy CI/CD.
Pros and Cons
Pros:
- Obsługuje pełne pliki dzienników w ramach jednego wywołania
- Wymusza schemat JSON dla ustrukturyzowanych danych wyjściowych
- Dostępne strumieniowanie w czasie rzeczywistym token po tokenie
Cons:
- Brak bezpośredniego dostrajania poza AWS
- Ścisłe limity szybkości irytują użytkowników o dużym zapotrzebowaniu
Learn more about Claude: Najlepsze rozwiązanie do generowania języka naturalnego w całym stosie Google Cloud
- Dostępny bezpłatny plan
- Ceny dostępne na żądanie
Visit WebsiteCustomer Rating:4.3/5
Vertex AI Studio pozwala użytkownikom tworzyć i testować prompty do generowania języka naturalnego w jednym miejscu. Vertex AI to platforma Google Cloud do tworzenia rozwiązań AI, która zapewnia dostęp do ponad 200 modeli językowych — w tym rodziny Gemini — do generowania tekstu, podsumowywania, tworzenia ustrukturyzowanych danych na podstawie tekstu oraz automatycznego tworzenia raportów i dokumentacji.
Dla kogo Vertex AI jest najlepszym wyborem?
Vertex AI dobrze sprawdzi się w zespołach IT i inżynieryjnych, które już działają w ekosystemie Google Cloud i potrzebują osadzić generowanie języka naturalnego (NLG) w istniejących potokach danych, procesach obserwowalności lub wewnętrznych narzędziach na dużą skalę.
Dlaczego wybrałem Vertex AI
Vertex AI znalazło się na mojej krótkiej liście, ponieważ jest najlepszą opcją, jaką znalazłem dla zespołów już korzystających z Google Cloud, które chcą bezpośrednio zintegrować generowanie języka naturalnego z istniejącymi potokami danych. Podoba mi się, że można pobierać ustrukturyzowane dane bezpośrednio z BigQuery lub Cloud Storage, przekazywać je do modelu Gemini z wymuszonym wyjściem zgodnym ze schematem JSON i uzyskiwać niezawodne generowanie tekstu bez konieczności tworzenia oddzielnej infrastruktury. Natywny silnik RAG oznacza również, że mogę opierać generowane podsumowania incydentów lub raporty techniczne na rzeczywistych bazach wiedzy przedsiębiorstwa, co znacząco ogranicza halucynacje w przypadku danych wyjściowych IT o wysokim znaczeniu.
Najważniejsze funkcje Vertex AI
- Nadzorowane dostrajanie: Dostrajaj modele Gemini na własnych oznaczonych zbiorach danych za pośrednictwem w pełni zarządzanej usługi — bez konieczności aprowizowania procesorów GPU.
- Rejestr modeli: Śledź, wersjonuj i zarządzaj niestandardowo wytrenowanymi modelami dzięki pełnemu rejestrowaniu audytowemu i mechanizmom kontroli wdrożeń.
- Wnioskowanie wsadowe: Przetwarzaj asynchronicznie do 200 000 żądań w ramach jednego zadania, korzystając z automatycznej równoległości i obsługi ponownych prób.
- Konfigurowalne filtry bezpieczeństwa: Ustawiaj progi treści dla poszczególnych kategorii i typów zagrożeń, aby kontrolować ton oraz bezpieczeństwo generowanych danych wyjściowych.
Integracje Vertex AI
Vertex AI oferuje natywne integracje z BigQuery, Cloud Storage, Cloud SQL, Looker, Pub/Sub, Google Kubernetes Engine, Cloud Run, Cloud Logging, Cloud Monitoring i Apigee. Jego interfejs REST API oraz zestawy SDK obsługują niestandardowe integracje i procesy CI/CD.
Pros and Cons
Pros:
- Generowanie języka naturalnego oparte na źródłach danych przedsiębiorstwa
- Generowanie w czasie rzeczywistym i skalowalne generowanie wsadowe
- Obsługa wielu języków wspiera zespoły globalne
Cons:
- Błędy limitów przydziału są częste w przypadku nowych kont
- Zadania wsadowe nie zapewniają gwarancji dostępności ani przepustowości
Learn more about Vertex AI: Najlepsze rozwiązanie dla zarządzanego NLG w regulowanych przedsiębiorstwach
- Nie
- Ceny na życzenie
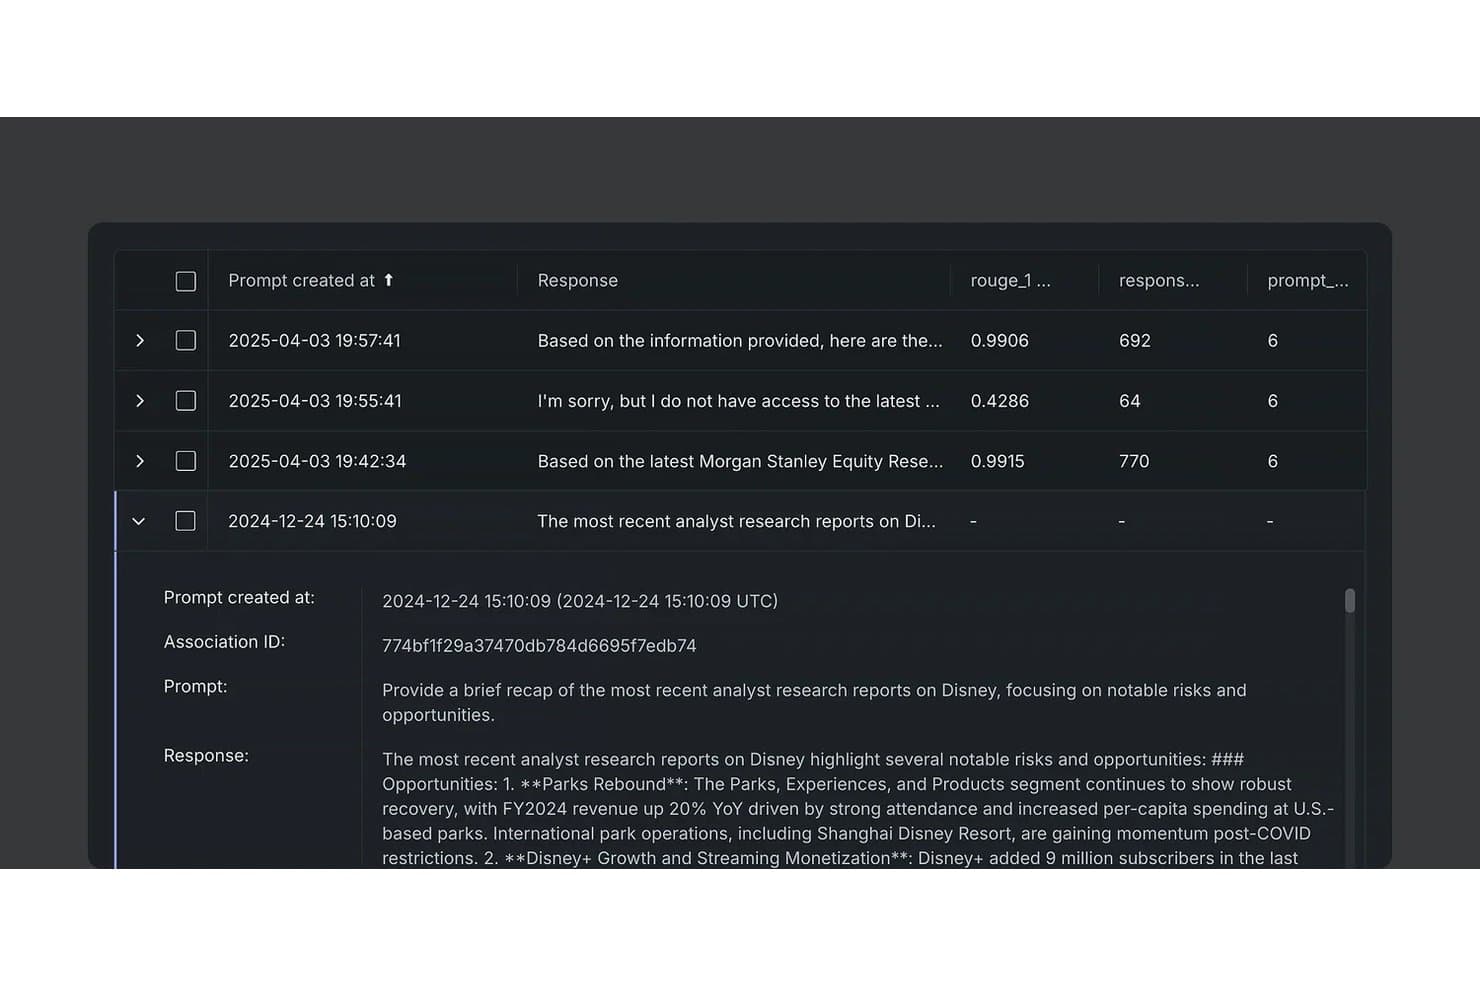
DataRobot śledzi odpowiedzi na prompty NLG za pomocą wyników ROUGE i liczby tokenów. DataRobot to platforma AI i uczenia maszynowego dla przedsiębiorstw, która dostarcza NLG za pośrednictwem środowiska roboczego generatywnej AI, obsługując generowanie tekstu na podstawie danych strukturalnych, potoki RAG, dostrajanie LLM oraz przepływy pracy agentowej w regulowanych środowiskach wdrożeniowych.
Dla kogo DataRobot jest najlepszym rozwiązaniem?
DataRobot to doskonały wybór dla korporacyjnych zespołów AI i ML w regulowanych branżach, które potrzebują zarządzanego i podlegającego audytowi NLG z elastycznymi opcjami wdrażania, w tym w środowiskach odizolowanych od sieci i lokalnych.
Dlaczego wybrałem DataRobot
Wybrałem DataRobot jako jedno z najlepszych rozwiązań, ponieważ jest to jedyna opcja NLG, której zaufałbym w regulowanym środowisku, w którym każdy wygenerowany wynik wymaga pełnego śladu audytowego. Śledzenie pochodzenia LLM rejestruje każdy prompt i każde dane wejściowe wektorowe, a warstwa zarządzania odnosi się bezpośrednio do ram, takich jak unijny akt o AI i NIST AI RMF. Wysoko oceniam również mechanizmy kontroli halucynacji: ewaluacja LLM jako sędziego i NVIDIA NeMo Guardrails współpracują ze sobą, aby oznaczać niewiarygodne wyniki, zanim trafią one do środowiska produkcyjnego.
Najważniejsze funkcje DataRobot
- Kreator potoków RAG: Twórz, rejestruj i wdrażaj wektorowe bazy danych z obsługą Pinecone, Elasticsearch i FAISS, w tym strategii dzielenia na fragmenty, indeksowania metadanych i przepisywania zapytań.
- Brama dostępu do ponad 70 LLM: Uzyskuj dostęp do ponad 70 wielkich modeli językowych i modeli reprezentacji wektorowych za pośrednictwem jednego interfejsu, bez konieczności zarządzania oddzielnymi kluczami API lub kontami.
- Interfejs API predykcji wsadowej: Uruchamiaj wielkoskalowe zadania predykcji offline dla źródeł JDBC, chmurowych hurtowni danych i S3 z zarządzaną orkiestracją Apache Airflow.
- Śledzenie zgodne z OpenTelemetry: Śledź pełne pochodzenie promptów, danych wejściowych wektorowych i wersji modeli za pomocą śladów audytowych, które trafiają bezpośrednio do narzędzi SIEM i potoków obserwowalności.
Integracje DataRobot
DataRobot oferuje integracje z AWS, Microsoft Azure, Google Cloud Platform, Snowflake, Databricks, SAP, OpenAI, Google Gemini, Pinecone i Elasticsearch. Jego REST API, Python SDK, klient R, CLI oraz punkty końcowe zgodne z OpenAI obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Pełne ślady audytowe i funkcje zapewniania zgodności
- Mechanizmy kontroli halucynacji z monitorowaniem w czasie rzeczywistym
- Dostęp do ponad 70 modeli językowych
Cons:
- Funkcje NLG są drugorzędne wobec platformy ML
- Nieprzejrzysty, niestandardowy model licencjonowania dla przedsiębiorstw
Learn more about DataRobot: Najlepsze rozwiązanie do konwersji dokumentów na tekst NLG na dużą skalę
- Dostępny plan bezpłatny
- Od $14.99/miesiąc

Mistral Document AI konwertuje obrazy paragonów na ustrukturyzowane dane JSON. Mistral Document AI to platforma NLG oparta na korporacyjnym OCR i rozumieniu dokumentów, która konwertuje pliki PDF, skany, DOCX i pliki odręcznie pisane na ustrukturyzowany tekst, JSON oraz wyniki w języku naturalnym w ponad 170 językach.
Dla kogo najlepiej nadaje się Mistral Document AI?
Mistral Document AI to dobry wybór dla inżynierów AI/ML i zespołów technicznych, które muszą przetwarzać duże ilości dokumentów — plików PDF, skanów i plików DOCX — na ustrukturyzowany tekst lub JSON w skali korporacyjnej.
Dlaczego wybrałem Mistral Document AI
Wybrałem Mistral Document AI, ponieważ obsługuje konwersję dokumentów na tekst w skali, której większość platform NLG po prostu nie jest w stanie dorównać, przetwarzając do 1000 stron na minutę na pojedynczym procesorze GPU i obsługując zadania wsadowe obejmujące do miliona żądań. Model OCR 4.1 znacznie wykracza poza podstawowe wyodrębnianie tekstu, zwracając ramki ograniczające na poziomie akapitów oraz wskaźniki pewności na poziomie bloków w ponad 170 językach, w tym dla danych odręcznie pisanych. Podoba mi się również możliwość definiowania niestandardowych schematów JSON w celu precyzyjnego kontrolowania tego, jakie ustrukturyzowane dane wyjściowe zostaną wyodrębnione, dzięki czemu narzędzie sprawdza się przy tworzeniu zautomatyzowanych potoków przetwarzania dokumentów, a nie tylko przy jednorazowym wyodrębnianiu danych.
Najważniejsze funkcje Mistral Document AI
- Natywna obsługa RAG: Łączy model osadzania
mistral-embedz wyszukiwaniem dokumentów, umożliwiając zadawanie pytań w języku naturalnym na podstawie wyodrębnionej treści. - API moderacji: Bezpłatny klasyfikator oznaczający wyniki w 11 kategoriach treści, z konfigurowalnymi progami, które można bezpośrednio dodawać do żądań API.
- Trzystopniowe dostrajanie: Oferuje samodzielnie hostowane LoRA, zarządzane środowisko bezserwerowe oraz niestandardowe wstępne trenowanie dla przedsiębiorstw, aby dopasować rozwiązanie do wymagań infrastruktury i danych.
- Strumieniowe dane wyjściowe SSE: Dostarcza odpowiedzi token po tokenie za pośrednictwem zdarzeń wysyłanych przez serwer, obsługując pulpity na żywo, chatboty i interfejsy do podsumowywania incydentów w czasie rzeczywistym.
Integracje Mistral Document AI
Mistral Document AI obsługuje ponad 20 konektorów MCP, w tym GitHub, Notion, Jira, Confluence, Pinecone i Sentry. Oferuje również zestawy SDK dla języków Python i JavaScript/TypeScript oraz interfejs REST API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Doskonale radzi sobie z konwersją dużych ilości dokumentów na tekst
- Najszersza w tej kategorii obsługa wielojęzycznego OCR
- Elastyczne wdrażanie, w tym lokalnie i w środowiskach odizolowanych od sieci
Cons:
- Brak natywnych konektorów do narzędzi ITSM i obserwowalności
- Niskie limity szybkości w planach podstawowych
Learn more about Mistral Document AI: Najlepszy do NLG w całym stosie chmurowym AWS
- 6-miesięczny bezpłatny okres próbny + dostępne bezpłatne demo
- Ceny dostępne na żądanie

Amazon Bedrock obsługuje NLG za pośrednictwem środowisk do pracy z czatem, tekstem i obrazami. Amazon Bedrock to w pełni zarządzana przez AWS platforma do NLG i modeli bazowych, zapewniająca dostęp przez API do ponad 100 modeli dostawców takich jak Anthropic, Meta i Mistral, a także wbudowanych narzędzi do RAG, dostrajania, wnioskowania wsadowego i mechanizmów ochronnych.
Dla kogo Amazon Bedrock jest najlepszym wyborem?
Amazon Bedrock doskonale sprawdzi się w zespołach inżynieryjnych i IT, które już uruchamiają obciążenia w AWS i potrzebują osadzić NLG w istniejącej infrastrukturze chmurowej bez samodzielnego zarządzania hostingiem modeli.
Dlaczego wybrałem Amazon Bedrock
Amazon Bedrock znalazł się na mojej krótkiej liście, ponieważ został zbudowany w całości w ekosystemie AWS, co czyni go najbardziej naturalnym wyborem, jeśli Twoja infrastruktura już się tam znajduje. Podoba mi się, że zapewnia dostęp przez API do ponad 100 modeli bazowych za pośrednictwem jednego ujednoliconego interfejsu, dzięki czemu można przełączać się między Anthropic Claude, Meta Llama i Amazon Nova bez przeprojektowywania potoku. Wbudowana warstwa Guardrails, której kontrole automatycznego rozumowania osiągają 99% dokładności, wyróżnia tę platformę w przypadku zespołów, które potrzebują możliwych do zweryfikowania wyników NLG, a nie tylko tekstu brzmiącego wiarygodnie.
Najważniejsze funkcje Amazon Bedrock
- Generowanie wspomagane wyszukiwaniem (RAG): W pełni zarządzana usługa baz wiedzy, która pobiera dane z S3, SharePoint, Confluence i Google Drive oraz wyszukuje ugruntowany kontekst na potrzeby generowania tekstu.
- API do wnioskowania wsadowego: Asynchronicznie przetwarza zadania z dużą liczbą promptów, przy koszcie niższym o około 50% niż w przypadku cen na żądanie, a wyniki dostarcza do S3.
- Mechanizmy ochronne Bedrock: Konfigurowalny, sześciowarstwowy system polityk bezpieczeństwa obejmujący anonimizację danych osobowych, tematy objęte zakazem, filtry treści oraz matematycznie weryfikowane kontrole dokładności wyników.
- Import niestandardowych modeli: Umożliwia przenoszenie zewnętrznie wytrenowanych modeli do Bedrock i udostępnianie ich za pośrednictwem tego samego zarządzanego API co natywne modele bazowe.
Integracje Amazon Bedrock
Amazon Bedrock oferuje natywne integracje w całym AWS, w tym z Amazon S3, Amazon CloudWatch, AWS CloudTrail, AWS IAM, AWS KMS, Amazon VPC i AWS PrivateLink. Łączy się z SharePoint, Confluence, Google Drive, Splunk MLTK, LangChain, LlamaIndex i CrewAI, a także udostępnia API i zestawy SDK do niestandardowych integracji.
Pros and Cons
Pros:
- Ujednolicony dostęp do ponad 100 modeli językowych
- Zaawansowane mechanizmy ochronne z kontrolami automatycznego rozumowania
- Obsługuje generowanie tekstu w czasie rzeczywistym i w trybie wsadowym
Cons:
- Wymagana złożona konfiguracja wielu usług
- Ograniczone możliwości dostrajania popularnych modeli
Learn more about Amazon Bedrock: Najlepsze rozwiązanie do opisów produktów e-commerce
- Niedostępne
- Ceny dostępne na żądanie
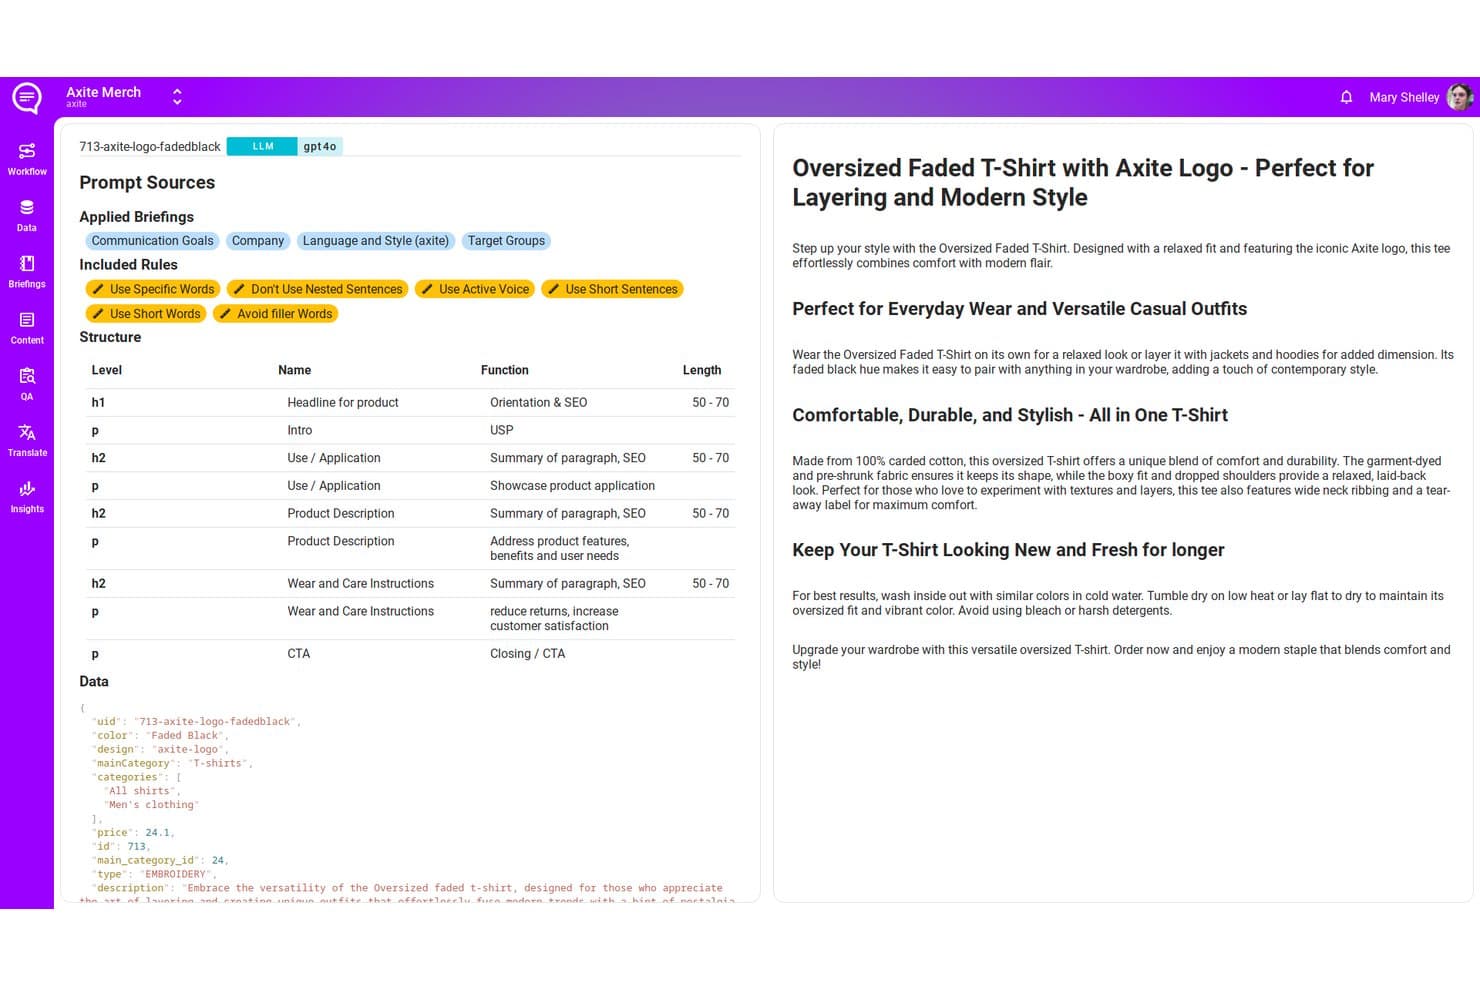
AX Semantics generuje ustrukturyzowane opisy produktów na podstawie reguł i danych. AX Semantics to oparta na regułach platforma NLG, która przekształca ustrukturyzowane dane produktów w tekst w języku naturalnym w ponad 110 językach, wykorzystując deklaratywny silnik treści ze wbudowaną kontrolą jakości, przetwarzaniem wsadowym i dostarczaniem za pośrednictwem webhooków.
Dla kogo najlepiej nadaje się AX Semantics?
AX Semantics to dobry wybór dla zespołów e-commerce zarządzających dużymi katalogami produktów, które potrzebują dokładnych, wielojęzycznych opisów produktów tworzonych na dużą skalę.
Dlaczego wybrałem AX Semantics
AX Semantics znalazło się na mojej krótkiej liście, ponieważ jego oparty na regułach silnik NLG został stworzony dokładnie z myślą o potrzebach dużych katalogów e-commerce: przekształca ustrukturyzowane dane produktów w dokładne opisy zgodne z charakterem marki, tworzone na dużą skalę. Podoba mi się, że platforma obsługuje naturalną morfologię w ponad 110 językach, dzięki czemu opis produktu w języku niemieckim lub japońskim nie jest jedynie przetłumaczonym dodatkiem, lecz gramatycznie poprawnym tekstem generowanym na podstawie reguł źródłowych. Jej deklaratywny silnik treści wymusza również automatyczne kontrole jakości przed opublikowaniem dowolnego tekstu, dzięki czemu poprawność faktograficzna pozostaje zgodna z danymi źródłowymi.
Najważniejsze funkcje AX Semantics
- Pętla informacji zwrotnych dotyczących skuteczności: Łączy opublikowane treści z pozycjami w wynikach SEO, współczynnikami konwersji i danymi dotyczącymi zwrotów, aby dostarczać informacji i ulepszać przyszłe reguły generowania treści.
- Automatyczne bramki kontroli jakości: Sprawdza wygenerowany tekst względem danych źródłowych przed publikacją, aby wykrywać niespójności faktograficzne, zanim tekst zostanie udostępniony.
- Przypisywanie wariantów treści w testach A/B: Przypisuje warianty treści różnym segmentom odbiorców na potrzeby testów za pośrednictwem axite Tag, bez konieczności ręcznego powielania treści.
- Wsadowe pobieranie danych o rozmiarze 5 GB: Akceptuje przesyłane pliki JSONL o rozmiarze do 5 GB, umożliwiając przetwarzanie dużych katalogów produktów w ramach jednego uruchomienia potoku.
Integracje AX Semantics
AX Semantics oferuje łącznik z platformą handlową Contentserv, interfejs REST API danych, dostarczanie za pośrednictwem webhooków oraz moduł Make do tworzenia niestandardowych przepływów pracy związanych z treścią. Platforma jest również dostępna w Zapier.
Pros and Cons
Pros:
- Wyniki pozbawione halucynacji, oparte na danych źródłowych
- Naturalne reguły gramatyczne dla ponad 110 języków
- Pętla informacji zwrotnych dotyczących skuteczności łączy treści z wynikami
Cons:
- Brak bezpłatnego okresu próbnego i wersji demonstracyjnej
- Nie nadaje się do dokumentacji technicznej ani raportów IT
Learn more about AX Semantics: Najlepsze rozwiązanie do tworzenia dokumentacji regulacyjnej w branży farmaceutycznej i finansowej
- Dostępna bezpłatna wersja demonstracyjna
- Ceny dostępne na żądanie

Yseop automatyzuje generowanie narracji raportów za pomocą konfigurowalnych ustawień tekstu. Yseop to platforma NLG, która wykorzystuje połączenie symbolicznej sztucznej inteligencji i dużych modeli językowych do przekształcania ustrukturyzowanych danych w zgodne z przepisami, zrozumiałe dla człowieka dokumenty regulacyjne i finansowe.
Dla kogo Yseop jest najlepszym rozwiązaniem?
Yseop został stworzony dla autorów dokumentacji medycznej i analityków finansowych w przedsiębiorstwach z branży farmaceutycznej i bankowej, którzy potrzebują generować zgodne z przepisami, gotowe do audytu dokumenty regulacyjne na dużą skalę.
Dlaczego wybrałem Yseop
Yseop znalazł się na mojej krótkiej liście, ponieważ został zaprojektowany specjalnie z myślą o dwóch regulowanych środowiskach tworzenia dokumentacji, w których błędy NLG wiążą się z największym ryzykiem: składaniu dokumentacji regulacyjnej w branży farmaceutycznej i sprawozdawczości finansowej. Szczególnie imponuje mi jego architektura złożonej sztucznej inteligencji, która łączy symboliczną sztuczną inteligencję z dużymi modelami językowymi wyspecjalizowanymi w określonych dziedzinach, aby generować w pełni identyfikowalne wyniki — aż do danych źródłowych stojących za każdym wygenerowanym zdaniem. W ramach walidacji przeprowadzonej w GSK mniej niż 7% treści wymagało ponownego opracowania. To właśnie taki poziom dokładności sprawia, że rozwiązanie nadaje się zarówno do składania dokumentacji eCTD, jak i raportów dotyczących ryzyka kredytowego.
Najważniejsze funkcje Yseop
- Pakiety automatyzacji: Wstępnie skonfigurowane pakiety komponentów, które pozwalają autorom dokumentacji medycznej i zespołom finansowym skonfigurować generowanie dokumentów dla określonych typów dokumentów bez pisania kodu.
- Wielojęzyczne generowanie dokumentów: Tworzy dokumenty regulacyjne i finansowe w wielu językach, aby wspierać globalne wymagania dotyczące składania dokumentacji.
- Bramki zatwierdzania przez człowieka: Wbudowane punkty kontroli, które uniemożliwiają przejście automatycznie wygenerowanych treści do kolejnego etapu procesu bez zatwierdzenia przez wykwalifikowanego weryfikatora.
- Ścieżka audytu zgodna z GxP: Śledzi wszystkie interakcje z danymi, dostęp oraz zmiany treści, aby utrzymywać dokumentację gotową do złożenia przez cały proces tworzenia.
Integracje Yseop
Yseop ma udokumentowane integracje z Microsoft Word, Veeva Vault, Tableau, Qlik i Power BI. Nie ma publicznie udokumentowanego interfejsu REST API ani zestawu SDK do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Zaprojektowane specjalnie dla dokumentów farmaceutycznych i finansowych
- Deterministyczne wyniki z pełną identyfikowalnością danych
- Wbudowana zgodność z GxP i ścieżka audytu
Cons:
- Brak publicznego interfejsu API dla programistów i dostępu do zestawu SDK
- Nie nadaje się do zastosowań NLG ogólnego przeznaczenia
Learn more about Yseop: Najlepsze rozwiązanie do prywatnie wdrażanego NLG z cytowaniami RAG
- Dostępna bezpłatna wersja demonstracyjna
- Ceny dostępne na żądanie
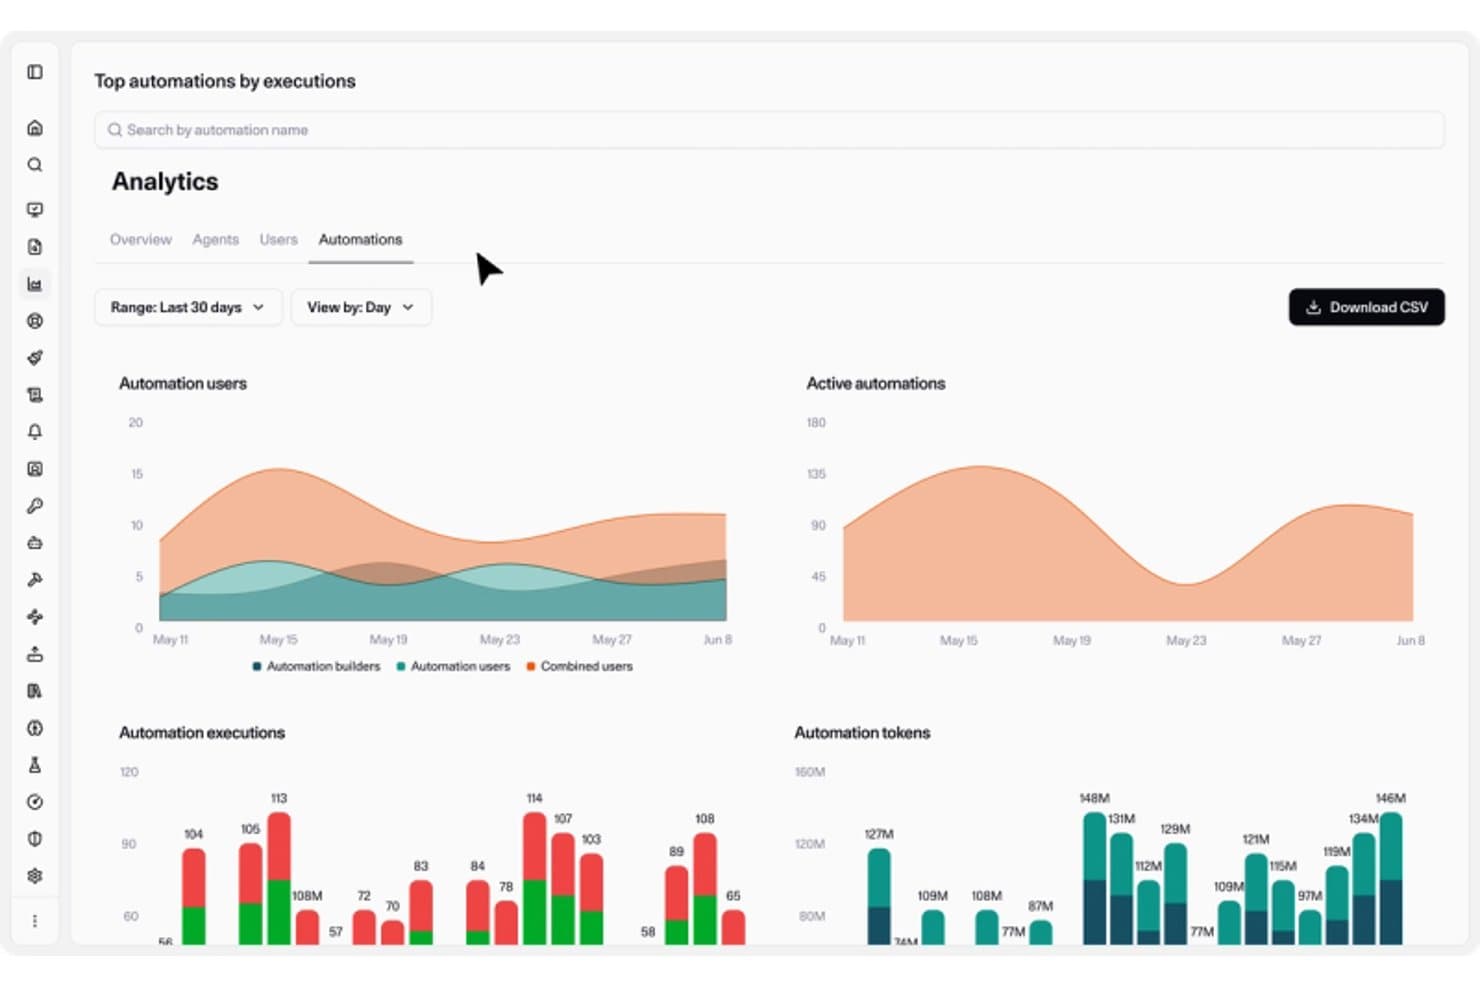
Cohere North śledzi w czasie wykonania automatyzacji, liczbę tokenów i aktywnych użytkowników. Cohere North to platforma NLG dla przedsiębiorstw, oparta na rodzinie modeli Command, która łączy generowanie tekstu ugruntowane za pomocą RAG, automatyzację agentowych przepływów pracy, dostrajanie oraz opcje prywatnego wdrażania, w tym instalacje w środowiskach odłączonych od sieci i lokalne.
Dla kogo najlepiej nadaje się Cohere North?
Cohere North jest dobrym rozwiązaniem dla dużych przedsiębiorstw z dedykowanymi zespołami inżynieryjnymi, które potrzebują wdrażać NLG w środowiskach w pełni prywatnych lub odłączonych od sieci.
Dlaczego wybrałem Cohere North
Cohere North znalazło się na mojej krótkiej liście, ponieważ jest jedyną znaną mi platformą NLG, która łączy prywatne wdrażanie (w tym instalacje w pełni odłączone od sieci) z generowaniem tekstu ugruntowanym za pomocą cytowań. Szczególnie podoba mi się zastosowanie dwóch trybów cytowania: po wygenerowaniu odpowiedzi oraz w tekście, z których każdy wiąże wygenerowany wynik z możliwym do zweryfikowania źródłem przedsiębiorstwa. Ma to praktyczne znaczenie, gdy zespół potrzebuje podsumowań incydentów IT lub raportów zgodności, które można rzeczywiście poddać audytowi.
Najważniejsze funkcje Cohere North
- Kreator przepływów pracy North Automations: Narzędzie niewymagające kodowania, które pozwala opisywać cele prostym językiem i tworzyć wieloetapowe agentowe przepływy pracy z harmonogramami, wyzwalaczami API, etapami zatwierdzania i testowaniem w piaskownicy.
- Dostrajanie na własnych danych: Obsługuje dostrajanie modeli Command R na własnych danych przedsiębiorstwa, z możliwością wyboru modelu dla każdego przepływu pracy w celu zrównoważenia kosztów i jakości wyników.
- Okno kontekstu obejmujące 256 tys. tokenów: Rozszerzone okno kontekstu modelu Command A pozwala przekazywać duże dzienniki, dokumenty lub zbiory danych w jednym przebiegu, bez dzielenia ich na fragmenty.
- Wielojęzyczne generowanie tekstu: Natywnie obsługuje ponad 23 języki w rodzinach modeli Command A i Aya, w tym dedykowany model North Small Translate do suwerennego tłumaczenia maszynowego.
Integracje Cohere North
Cohere North oferuje natywne integracje z Gmailem, Slackiem, Salesforce i Microsoft Outlook. Jego interfejs REST API, zestawy SDK dla języków Python, TypeScript, Go i Java, API kompatybilne z OpenAI oraz modułowa platforma konektorów umożliwiają tworzenie niestandardowych integracji.
Pros and Cons
Pros:
- Umożliwia wdrażanie w środowiskach odłączonych od sieci lub lokalnych
- Generowanie RAG z cytowaniami w tekście i po wygenerowaniu odpowiedzi
- Obsługuje dostrajanie z wykorzystaniem własnych danych technicznych
Cons:
- Do dostosowania wymaga dedykowanego zespołu inżynieryjnego
- Brak publicznego cennika
Learn more about Cohere North: Najlepszy wybór dla NLG w ramach stosu chmurowego Azure
- Dostępny bezpłatny plan
- Ceny dostępne na żądanie
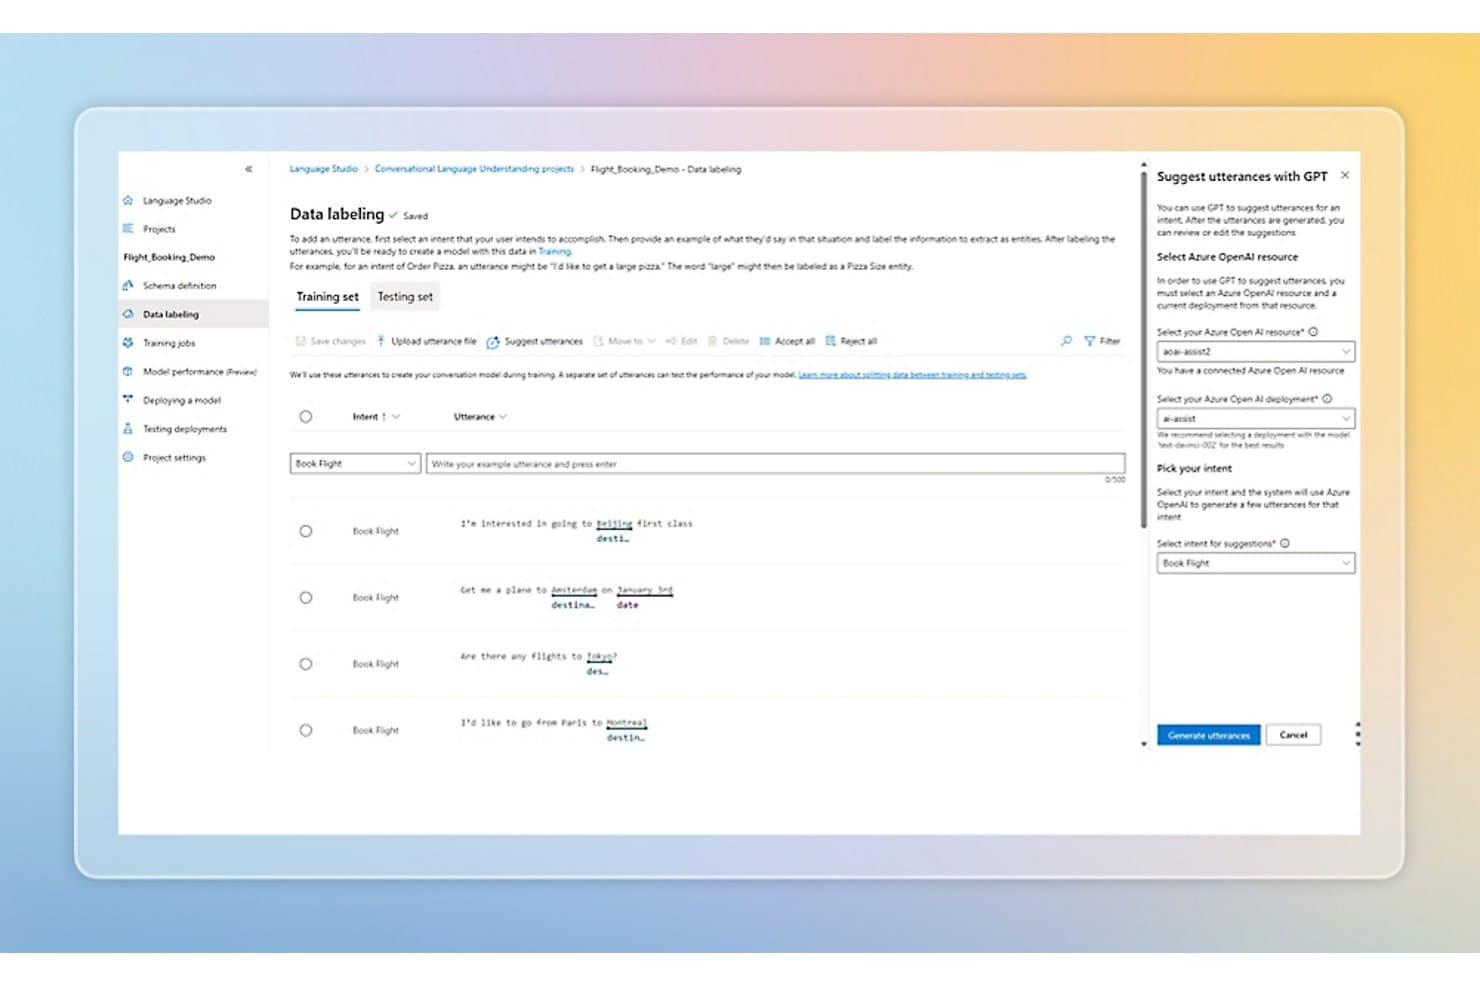
Azure OpenAI sugeruje oznaczone wypowiedzi na potrzeby trenowania modelu NLG. Azure OpenAI to platforma korporacyjnego interfejsu API NLG firmy Microsoft, która zapewnia dostęp do najnowszych modeli OpenAI — w tym GPT-4o i GPT-4.1 — z wbudowanymi funkcjami RAG, dostrajania, przetwarzania wsadowego i wielojęzycznego generowania tekstu.
Dla kogo Azure OpenAI jest najlepszym wyborem?
Azure OpenAI to właściwy wybór dla zespołów inżynieryjnych i IT, które już uruchamiają obciążenia na platformie Azure i chcą osadzić funkcje NLG bez wychodzenia poza istniejącą infrastrukturę chmurową.
Dlaczego wybrałem Azure OpenAI
Azure OpenAI znalazło się na mojej liście, ponieważ najlepiej pasuje do zespołów, które już uruchamiają obciążenia na platformie Azure i chcą dodać NLG bez przebudowywania swojego stosu technologicznego. Szczególnie podoba mi się wbudowana funkcja RAG dostępna za pośrednictwem opcji 'Na Twoich danych', która opiera generowanie tekstu na własnych indeksach Azure AI Search, usłudze Blob Storage lub bazie Cosmos DB, dzięki czemu praktyczne staje się generowanie podsumowań incydentów lub raportów technicznych na podstawie aktualnych danych przedsiębiorstwa. Wyróżnia się również interfejs API Batch: przetwarza do 100 000 żądań w jednym pliku przy koszcie wynoszącym mniej więcej połowę kosztu wywołań w czasie rzeczywistym, co okazało się dla mnie niezwykle cenne podczas generowania dużych ilości dokumentacji.
Najważniejsze funkcje Azure OpenAI
- Dostrajanie za pomocą SFT i DPO: Trenuj modele GPT-4o i GPT-4.1 na własnych zbiorach danych JSONL, korzystając z nadzorowanego dostrajania lub bezpośredniej optymalizacji preferencji na potrzeby prywatnych, niestandardowych wdrożeń.
- Filtr wykrywania oparcia na źródłach: Weryfikuje wyniki modelu na podstawie materiałów źródłowych oraz oznacza lub automatycznie koryguje treści nieoparte na źródłach, zanim dotrą one do użytkowników.
- Obsługa wielojęzycznych zestawów SDK: Oficjalne zestawy SDK dla języków Python, C#, JavaScript, Java i Go pozwalają zespołowi integrować NLG z aplikacjami przy użyciu dowolnego języka, na którym już działa stos technologiczny.
- Jednostki aprowizowanej przepustowości (PTU): Rezerwuj dedykowaną przepustowość modelu rozliczaną godzinowo, aby zagwarantować stałe opóźnienia i przepustowość w przypadku obciążeń NLG o dużej skali.
Integracje Azure OpenAI
Azure OpenAI oferuje natywne integracje w całym ekosystemie Microsoft, w tym z usługami Azure AI Search, Azure Cosmos DB, Azure Blob Storage, Azure API Management, Azure Monitor i Azure Event Hubs. Integruje się również z Datadog oraz obsługuje interfejsy API REST i zestawy SDK na potrzeby niestandardowych połączeń.
Pros and Cons
Pros:
- Filtr wykrywania oparcia na źródłach ogranicza halucynacje
- Głęboka integracja ze stosem Azure na potrzeby przepływów pracy IT
- Strumieniowe przesyłanie wyników w czasie rzeczywistym obsługuje podsumowania incydentów
Cons:
- Złożona konfiguracja wymaga specjalistycznej wiedzy na temat Azure
- Aktualizacje modeli pojawiają się później niż w bezpośredniej usłudze OpenAI
Learn more about Azure OpenAI: 10Najlepsze do generowania języka naturalnego (NLG) opartego na grafowym RAG za pośrednictwem API
Writer
- Dostępna bezpłatna wersja próbna + bezpłatne demo
- Ceny ustalane na żądanie
Visit WebsiteCustomer Rating:4.4/5 Learn more about Writer:
Inne programy do generowania języka naturalnego
Poniżej znajduje się lista dodatkowych programów do generowania języka naturalnego, które znalazły się na mojej liście, ale nie trafiły do pierwszej dziesiątki. Zdecydowanie warto się z nimi zapoznać.
- 11NarrativaNajlepsze do automatyzacji tworzenia wiadomości i raportów
- 12RetrescoNajlepsze rozwiązanie do automatyzacji treści korporacyjnych
- 13Hugging Face TransformersNajlepsze do dostrajania NLG na zastrzeżonych danych
Jak oceniam oprogramowanie do generowania języka naturalnego
Dzielę ocenę na dwie warstwy: podstawowe wymagania — takie jak przekształcanie danych dzienników w podsumowania incydentów za pośrednictwem interfejsu API — oraz elementy wyróżniające, które odróżniają dobre narzędzie od właściwego narzędzia.
Podstawowa funkcjonalność (wymagania konieczne na tej liście)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcjonalności) do 5 (wyróżnia się w tym obszarze) dla każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi uzyskać minimalny łączny wynik na poziomie 65%, aby zostać uwzględnione na liście.
- Generowanie tekstu na podstawie danych strukturyzowanych: Sprawdzam, czy narzędzie potrafi przyjmować dane wejściowe o ustrukturyzowanej formie, takie jak ładunki JSON, zapytania do baz danych lub dzienniki systemowe, i przekształcać je w czytelne opisy.
- Dostęp do interfejsu API/SDK dla programistów: Każde oceniane przeze mnie narzędzie musi udostępniać programistyczne punkty końcowe, aby zespoły mogły osadzać generowanie języka naturalnego w potokach, aplikacjach wewnętrznych lub stosach monitorowania.
- Konfigurowalne modele językowe: Sprawdzam, czy można dostrajać lub konfigurować modele na podstawie danych specyficznych dla danej domeny, na przykład trenować je z użyciem języka stosowanego w podręcznikach operacyjnych organizacji lub historii zgłoszeń.
- Obsługa wielu formatów wyjściowych: Narzędzie powinno generować różne rodzaje tekstu na podstawie tego samego źródła danych, niezależnie od tego, czy jest to podsumowanie dla kadry kierowniczej, szczegółowy raport dotyczący incydentu czy dokumentacja kodu umieszczona bezpośrednio w kodzie.
- Konfiguracja szablonów i reguł: Oceniam zakres kontroli nad strukturą, tonem i logiką danych wyjściowych — na przykład możliwość ustawienia reguł, dzięki którym analiza po incydencie będzie zgodna ze standardowym formatem zespołu.
- Skalowalne przetwarzanie wsadowe: Zastosowania wymagające obsługi dużych ilości danych mają znaczenie, dlatego sprawdzam, jak dobrze platforma radzi sobie z równoczesnymi żądaniami, takimi jak generowanie setek podsumowań stanu serwerów w ciągu nocy.
Gdy mam już listę narzędzi spełniających te kryteria, analizuję cechy wyróżniające poszczególne platformy.
Czynniki różnicujące (co wyróżnia dostawców)
Oto jak porównuję poszczególnych dostawców:
Najważniejsze funkcje
Generowanie wspomagane wyszukiwaniem to jeden z kluczowych wyróżników, których szukam, ponieważ umożliwia narzędziu opieranie danych wyjściowych na rzeczywistej bazie wiedzy — na przykład podręcznikach operacyjnych, wewnętrznych wiki lub repozytoriach kodu. Ma to znaczenie, gdy generowane podsumowania incydentów muszą odzwierciedlać rzeczywistą infrastrukturę. Oceniam również mechanizmy kontroli halucynacji, takie jak punktacja poziomu pewności i warstwy weryfikacji faktów, ponieważ niedokładne dane wyjściowe w analizie po incydencie lub aktualizacji strony statusu mogą szybko podważyć zaufanie. Warto również rozważyć przesyłanie strumieniowe w czasie rzeczywistym, zwłaszcza w przypadku zespołów tworzących chatboty działające na żywo lub dynamiczne opisy na pulpitach nawigacyjnych.
Poza funkcjami
Elastyczność wdrażania ma tutaj duże znaczenie. Sprawdzam, czy dostawca obsługuje hosting lokalny, hosting z izolacją VPC lub hosting hybrydowy, ponieważ wiele zespołów IT przetwarza poufne dane dotyczące infrastruktury, które nie mogą opuszczać ich środowiska. Zakres integracji to kolejny istotny czynnik — oceniam natywne konektory do narzędzi takich jak Datadog, ServiceNow i GitHub, ponieważ dane wyjściowe generowania języka naturalnego są użyteczne tylko wtedy, gdy pasują do istniejących przepływów pracy związanych z obserwowalnością i zarządzaniem usługami IT. Certyfikaty bezpieczeństwa, takie jak SOC 2 Type II, oraz mechanizmy kontroli rezydencji danych również mają znaczenie, szczególnie gdy generowany tekst dotyczy danych produkcyjnych systemów.
Jak wybrać oprogramowanie do generowania języka naturalnego
Łatwo ugrzęznąć w długich listach funkcji i złożonych strukturach cenowych. Aby pomóc Ci zachować koncentrację podczas przechodzenia przez wyjątkowy dla Ciebie proces wyboru oprogramowania, przygotowałem listę czynników, które warto wziąć pod uwagę:
| Czynnik | Na co zwrócić uwagę |
|---|---|
| CzynnikSkalowalność | Na co zwrócić uwagęCzy oprogramowanie może rozwijać się wraz z Twoją firmą? Weź pod uwagę limity użytkowników, możliwości przetwarzania danych oraz to, jak dobrze oprogramowanie dostosowuje się do zwiększonego obciążenia bez utraty wydajności. |
| CzynnikIntegracje | Na co zwrócić uwagęCzy oprogramowanie współpracuje z obecnie używanymi narzędziami? Sprawdź zgodność z systemami CRM, platformami analitycznymi i innymi niezbędnymi aplikacjami, aby zapewnić płynną integrację przepływów pracy. |
| CzynnikMożliwość dostosowania | Na co zwrócić uwagęJak elastyczne jest oprogramowanie? Poszukaj opcji dostosowania interfejsu, raportów i wyników do konkretnych potrzeb oraz wymagań branżowych. |
| CzynnikŁatwość obsługi | Na co zwrócić uwagęCzy oprogramowanie jest przyjazne dla użytkownika? Oceń krzywą uczenia się, projekt interfejsu oraz dostępność materiałów pomocniczych dla nowych użytkowników. |
| CzynnikWdrożenie i rozpoczęcie pracy | Na co zwrócić uwagęJak sprawnie przebiega proces konfiguracji? Oceń czas i zasoby potrzebne do początkowego wdrożenia i szkolenia, w tym dostęp do samouczków i pomocy technicznej. |
| CzynnikKoszt | Na co zwrócić uwagęCzy oprogramowanie mieści się w Twoim budżecie? Porównaj plany cenowe, ukryte opłaty i stosunek jakości do ceny. Weź pod uwagę koszty długoterminowe oraz potencjalny zwrot z inwestycji. |
| CzynnikZabezpieczenia | Na co zwrócić uwagęJak bezpieczne są Twoje dane? Upewnij się, że oprogramowanie jest zgodne z przepisami dotyczącymi ochrony danych oraz oferuje szyfrowanie, kontrolę dostępu i regularne aktualizacje zabezpieczeń. |
Czym jest oprogramowanie do generowania języka naturalnego?
Oprogramowanie do generowania języka naturalnego (NLG) to podzbiór sztucznej inteligencji, który automatyzuje tworzenie tekstu na podstawie uporządkowanych danych. Jest używane przede wszystkim przez twórców treści, analityków danych i firmy. Jego celem jest tworzenie spójnych narracji, raportów lub opisów, usprawnianie procesów generowania treści, zapewnianie spójności oraz przekształcanie danych w zrozumiałe narracje dostosowane do różnych odbiorców.
Funkcje
Wybierając oprogramowanie do generowania języka naturalnego, zwróć uwagę na następujące kluczowe funkcje:
- Automatyczne tworzenie tekstu: Automatycznie generuje tekst na podstawie danych wejściowych, oszczędzając użytkownikom czas i wysiłek.
- Obsługa wielu języków: Obsługuje wiele języków, umożliwiając dotarcie z treściami do odbiorców na całym świecie.
- Spostrzeżenia oparte na danych: Analizuje dane w celu tworzenia dokładnych i trafnych treści, wspierając podejmowanie świadomych decyzji.
- Dostosowywalne szablony: Oferuje szablony, które można dostosować do konkretnych potrzeb branży lub firmy.
- Predykcyjna ocena skuteczności: Ocenia potencjalny sukces treści przed jej publikacją, optymalizując wyniki.
- Integracja danych w czasie rzeczywistym: Integruje się ze źródłami danych w czasie rzeczywistym, aby zapewnić aktualność i trafność treści. Ta funkcja jest szczególnie ważna przy wyborze oprogramowania do analizy konwersacji.
- Uczenie adaptacyjne: Dostosowuje generowanie treści na podstawie opinii użytkowników, poprawiając dokładność z czasem.
- Personalizacja treści: Dostosowuje treści do stylu komunikacji marki i preferencji odbiorców, zwiększając zaangażowanie.
- Zabezpieczenia: Chroni dane za pomocą szyfrowania i kontroli dostępu, zapewniając zgodność z przepisami.
Korzyści
Wdrożenie oprogramowania do generowania języka naturalnego lub oprogramowania NLP przynosi wiele korzyści Twojemu zespołowi i firmie. Oto kilka z nich:
- Oszczędność czasu: Automatyzuje tworzenie tekstu, pozwalając zespołowi skupić się na bardziej strategicznych zadaniach.
- Globalny zasięg: Obsługa wielu języków umożliwia skuteczną komunikację z odbiorcami międzynarodowymi.
- Większa dokładność: Spostrzeżenia oparte na danych zapewniają, że tworzone treści są trafne i precyzyjne.
- Większe zaangażowanie: Funkcje personalizacji dostosowują treści do odbiorców, zwiększając interakcję i zainteresowanie.
- Skalowalność: Łatwo dostosowuje się do rosnącego zapotrzebowania na treści wraz z rozwojem firmy.
- Spójność: Dostosowywalne szablony zapewniają jednolitość treści i zachowanie stylu komunikacji marki we wszystkich materiałach.
Koszty i ceny
Wybór oprogramowania do generowania języka naturalnego wymaga zrozumienia dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i innych czynników. Poniższa tabela podsumowuje typowe plany, ich średnie ceny oraz najczęściej uwzględniane funkcje rozwiązań do generowania języka naturalnego:
Tabela porównawcza planów oprogramowania do generowania języka naturalnego
| Typ planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Typ planuPlan bezpłatny | Średnia cena$0 | Typowe funkcjePodstawowe tworzenie tekstu, ograniczone możliwości dostosowywania i dostęp do zasobów pomocy. |
| Typ planuPlan osobisty | Średnia cena$10-$30/user/month | Typowe funkcjeTworzenie tekstu, podstawowa analityka, obsługa wielu języków i ograniczone możliwości personalizacji. |
| Typ planuPlan biznesowy | Średnia cena$50-$100/user/month | Typowe funkcjeZaawansowana analityka, rozszerzone możliwości dostosowywania, integracja danych w czasie rzeczywistym i narzędzia do współpracy zespołowej. |
| Typ planuPlan dla przedsiębiorstw | Średnia cena$200+/user/month | Typowe funkcjePełne dostosowywanie, dedykowane wsparcie, zaawansowane funkcje bezpieczeństwa i kompleksowa integracja danych. |
Najczęściej zadawane pytania dotyczące oprogramowania do generowania języka naturalnego
Oto odpowiedzi na często zadawane pytania dotyczące oprogramowania do generowania języka naturalnego:
Jak oprogramowanie do generowania języka naturalnego chroni prywatność danych?
Oprogramowanie do generowania języka naturalnego zazwyczaj obejmuje szyfrowanie danych i mechanizmy kontroli dostępu w celu ochrony prywatności. Należy upewnić się, że oprogramowanie jest zgodne z odpowiednimi przepisami dotyczącymi ochrony danych, takimi jak RODO. Ważne jest również sprawdzenie, w jaki sposób dostawca oprogramowania przechowuje i udostępnia dane.
Jakie możliwości integracji oferuje oprogramowanie do generowania języka naturalnego?
Większość narzędzi do generowania języka naturalnego integruje się z popularnymi platformami, takimi jak systemy CRM, oprogramowanie analityczne i systemy zarządzania treścią. Sprawdź, czy oprogramowanie obsługuje dostęp do API na potrzeby niestandardowych integracji. Upewnij się, że można je połączyć z narzędziami, z których Twój zespół już korzysta.
Jak mogę mierzyć skuteczność oprogramowania do generowania języka naturalnego?
Skuteczność można mierzyć, oceniając jakość i trafność wygenerowanych treści. Warto zwrócić uwagę na funkcje takie jak predykcyjna ocena wydajności. Należy również ocenić, jak dobrze narzędzie odpowiada na konkretne potrzeby biznesowe i usprawnia przepływ pracy.
Jaki poziom dostosowywania jest dostępny w oprogramowaniu do generowania języka naturalnego?
Zakres możliwości dostosowywania różni się w zależności od narzędzia, ale często obejmuje możliwość dopasowywania szablonów, zmiany tonu języka i modyfikowania wyników tak, aby odpowiadały wytycznym marki. Upewnij się, że oprogramowanie zapewnia wystarczającą elastyczność, aby spełnić wymagania Twojej firmy bez konieczności przeprowadzania rozległych zmian technicznych.
Jak ważne jest wsparcie użytkownika przy wyborze oprogramowania do generowania języka naturalnego?
Dobre wsparcie użytkownika ma kluczowe znaczenie dla płynnego korzystania z oprogramowania. Warto szukać dostawców oferujących całodobowe wsparcie, kompleksową dokumentację i materiały szkoleniowe. Krótki czas reakcji oraz wiele kanałów wsparcia mogą znacząco wpłynąć na produktywność Twojego zespołu.
Czy istnieją rozwiązania do generowania języka naturalnego przeznaczone dla konkretnych branż?
Tak, niektóre rozwiązania są przeznaczone dla konkretnych branż, takich jak finanse, opieka zdrowotna czy handel elektroniczny. Narzędzia te mogą oferować specjalistyczne szablony i funkcje zaprojektowane z myślą o potrzebach związanych z treściami charakterystycznymi dla danej branży. Zastanów się, czy narzędzie przeznaczone dla konkretnej branży może lepiej odpowiadać na Twoje wyjątkowe wymagania.