

Narzędzia do skrobania stron internetowych to aplikacje, które automatyzują wyodrębnianie danych ze stron internetowych, ułatwiając zbieranie informacji bez ręcznego kopiowania i wklejania. Jeśli szukasz najlepszych narzędzi do skrobania stron internetowych, prawdopodobnie musisz niezawodnie gromadzić duże ilości danych internetowych — bez napotykania przeszkód, takich jak zabezpieczenia przed botami czy zmieniające się struktury stron.
Przy tak wielu opcjach dostępnych na rynku trudno stwierdzić, które narzędzie rzeczywiście będzie pasować do Twojego stosu technologicznego, obsłuży docelowe strony i będzie skalować się wraz z Twoimi potrzebami. W tym przewodniku omawiam najlepsze narzędzia, aby ułatwić Ci porównanie ich funkcji i podejść oraz znalezienie rozwiązania idealnego dla Twoich projektów IT.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza: narzędzia do skrobania stron internetowych
Ta tabela porównawcza podsumowuje informacje o cenach wybranych przeze mnie najlepszych narzędzi do skrobania stron internetowych.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepszy wybór do wbudowanego sterowania bezgłową przeglądarką | Dostępny bezpłatny plan | Od $30/miesiąc | Website | |
| 2 | Najlepsze rozwiązanie do ukrytego scrapowania i omijania wykrywania | 14-dniowy bezpłatny okres próbny | Od 69 USD/miesiąc | Website | |
| 3 | Najlepsze narzędzie do obsługi dynamicznych witryn wykorzystujących JavaScript | Dostępny bezpłatny plan | Od $189/miesiąc | Website | |
| 4 | Najlepsze do bezpośredniej integracji z potokami danych | 30-dniowy bezpłatny okres próbny | Od $199 miesięcznie (rozliczane rocznie) | Website | |
| 5 | Najlepszy do korzystania z gotowych szablonów automatyzacji robotów | Dostępny bezpłatny plan | Od 19 USD/miesiąc (przy rozliczeniu rocznym) | Website | |
| 6 | Najlepsze do zarządzanego gromadzenia danych z ochroną przed botami | Dostępny bezpłatny okres próbny | Od $0.5/1,000 rekordów | Website | |
| 7 | Najlepsze rozwiązanie dla infrastruktury proxy na skalę przedsiębiorstwa | Dostępny plan bezpłatny | Od $1.5/1,000 rekordów/miesiąc | Website | |
| 8 | Najlepszy wybór do automatycznego wykrywania schematów danych | 30-dniowy bezpłatny okres próbny | Od $0.13/1,000 żądań | Website | |
| 9 | Najlepszy do prostych przepływów scrapingu opartych na interfejsie API | Dostępny bezpłatny plan | Od $49/miesiąc | Website | |
| 10 | Najlepsze rozwiązanie do bezproblemowej rotacji adresów IP na dużą skalę | 7-dniowy bezpłatny okres próbny | Od 49 USD/miesiąc | Website |


Recenzje najlepszych narzędzi do skrobania stron internetowych
Poniżej znajdziesz moje szczegółowe podsumowania najlepszych narzędzi do skrobania stron internetowych, które trafiły na moją listę. W recenzjach szczegółowo omawiam funkcje, integracje i najlepsze zastosowania każdego narzędzia, aby pomóc Ci znaleźć rozwiązanie odpowiednie dla Ciebie.
 Najlepszy wybór do wbudowanego sterowania bezgłową przeglądarką
- Dostępny bezpłatny plan
- Od $30/miesiąc
Visit WebsiteCustomer Rating:4.9/5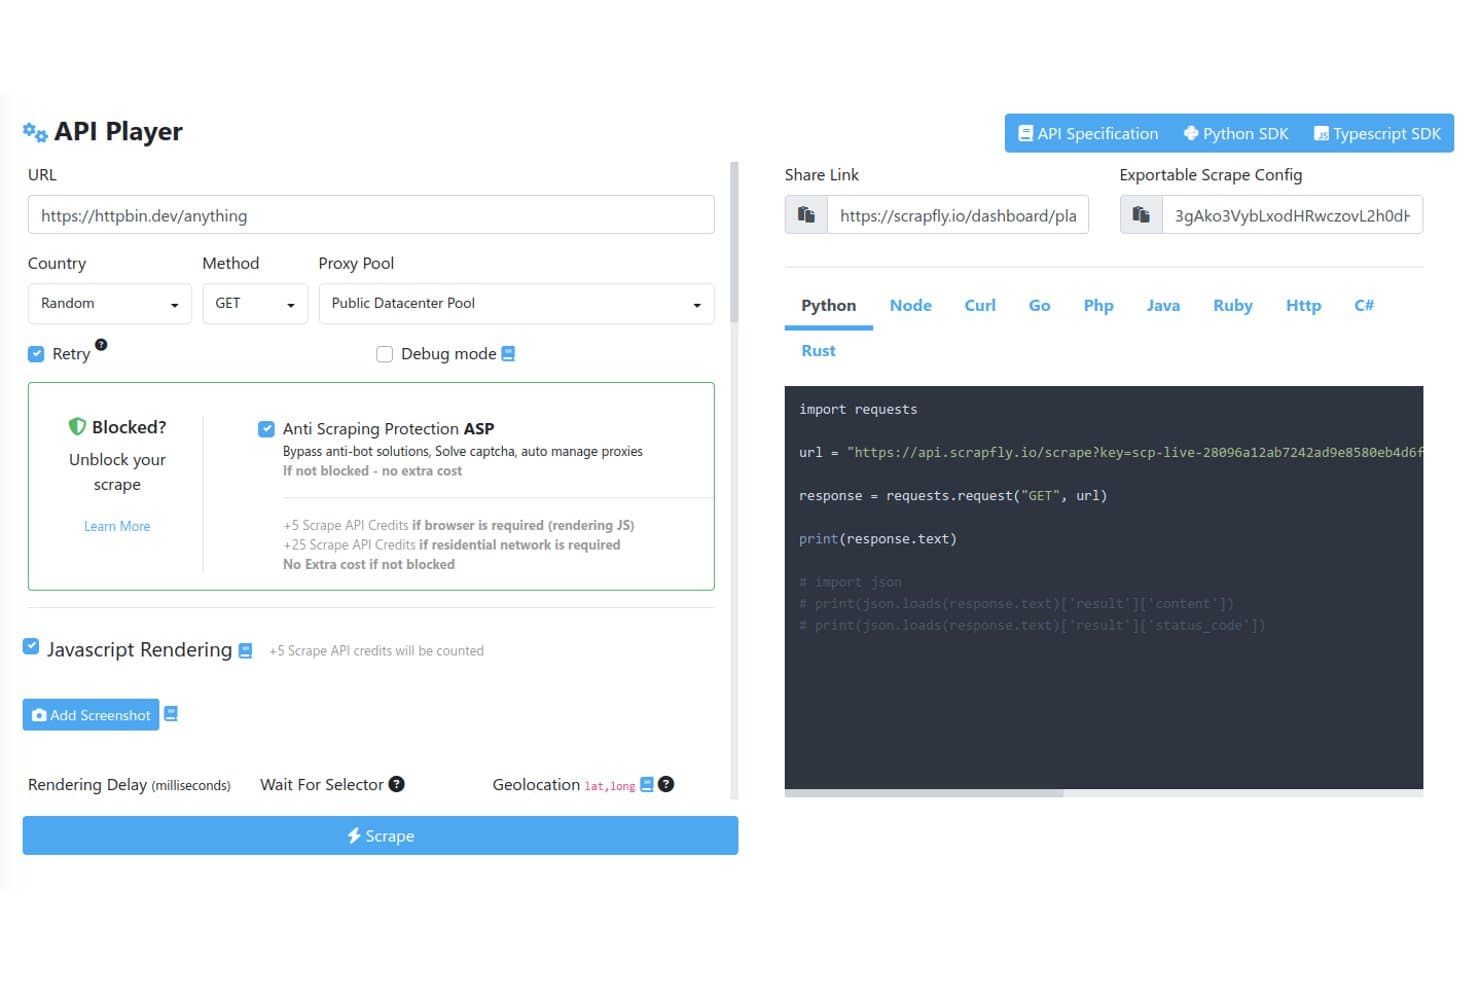
Scrapfly oferuje interaktywny odtwarzacz API z konfigurowalnymi opcjami scrapowania, w tym pulami serwerów proxy, omijaniem zabezpieczeń antyscrapingowych, renderowaniem JavaScript oraz automatycznie generowanymi fragmentami kodu w wielu językach. Scrapfly to interfejs API do scrapowania stron internetowych, który łączy rotację serwerów proxy, omijanie zabezpieczeń antybotowych, renderowanie w bezgłowej przeglądarce, przeszukiwanie witryn, przechwytywanie zrzutów ekranu oraz ekstrakcję danych wspomaganą przez LLM w ramach jednego klucza API.
Dla kogo Scrapfly jest najlepszym wyborem?
Scrapfly to dobre rozwiązanie dla programistów i inżynierów danych, którzy szukają interfejsu API do scrapowania opartego na kodzie, z zestawami SDK dla języków Python, TypeScript, Go i Rust.
Dlaczego wybrałem Scrapfly
Wybrałem Scrapfly, ponieważ jego architektura przeglądarki z dwoma silnikami nie ma odpowiednika wśród rozwiązań, które testowałem. Curlium obsługuje odwzorowywanie odcisku palca Chrome JA4 z dokładnością do bajtu, zapewniając wysoką szybkość, natomiast Scrapium uruchamia ukryty Chromium przez CDP z dopasowanymi odciskami palców, dzięki czemu sesje mogą przełączać się w trakcie przeszukiwania witryny bez wywoływania mechanizmów wykrywania. Podoba mi się również pełna zgodność Scrapium z Playwright i Puppeteer, co oznacza, że mogę pisać niestandardowe scenariusze JavaScript i reguły oczekiwania bez modyfikowania istniejącego kodu automatyzacji przeglądarki.
Najważniejsze funkcje Scrapfly
- Interfejs API do ekstrakcji wieloma metodami: Ekstrahuje uporządkowane dane za pomocą CSS, XPath, wyrażeń regularnych, schematów JSON i szablonów wspomaganych przez LLM.
- Zintegrowane pule serwerów proxy: Udostępnia zarządzane serwery proxy z centrów danych i serwery proxy rezydencyjne z targetowaniem geograficznym oraz obsługą własnych serwerów proxy.
- Interfejs API robota indeksującego: Przeszukuje całe witryny z możliwością kontrolowania głębokości przeszukiwania, limitów szybkości i podziału projektów.
- Natywne integracje z harmonogramami: Obsługuje Zapier, Make i n8n na potrzeby zautomatyzowanych przepływów pracy, cyklicznych zadań i wyzwalaczy webhooków.
Integracje Scrapfly
Scrapfly oferuje natywne integracje z Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI i OpenClaw. Udostępnia również zestawy SDK dla języków Python, TypeScript, Go i Rust. Do niestandardowych integracji dostępny jest interfejs API.
Pros and Cons
Pros:
- Dwa ukryte silniki przeglądarek
- Omija zabezpieczenia Cloudflare, DataDome i Imperva
- Szablony ekstrakcji dla popularnych typów witryn
Cons:
- Brak natywnego harmonogramu zadań w produkcie
- Nie nadaje się dla użytkowników nietechnicznych
Learn more about Scrapfly: Najlepsze rozwiązanie do ukrytego scrapowania i omijania wykrywania
- 14-dniowy bezpłatny okres próbny
- Od 69 USD/miesiąc
Visit WebsiteCustomer Rating:4.7/5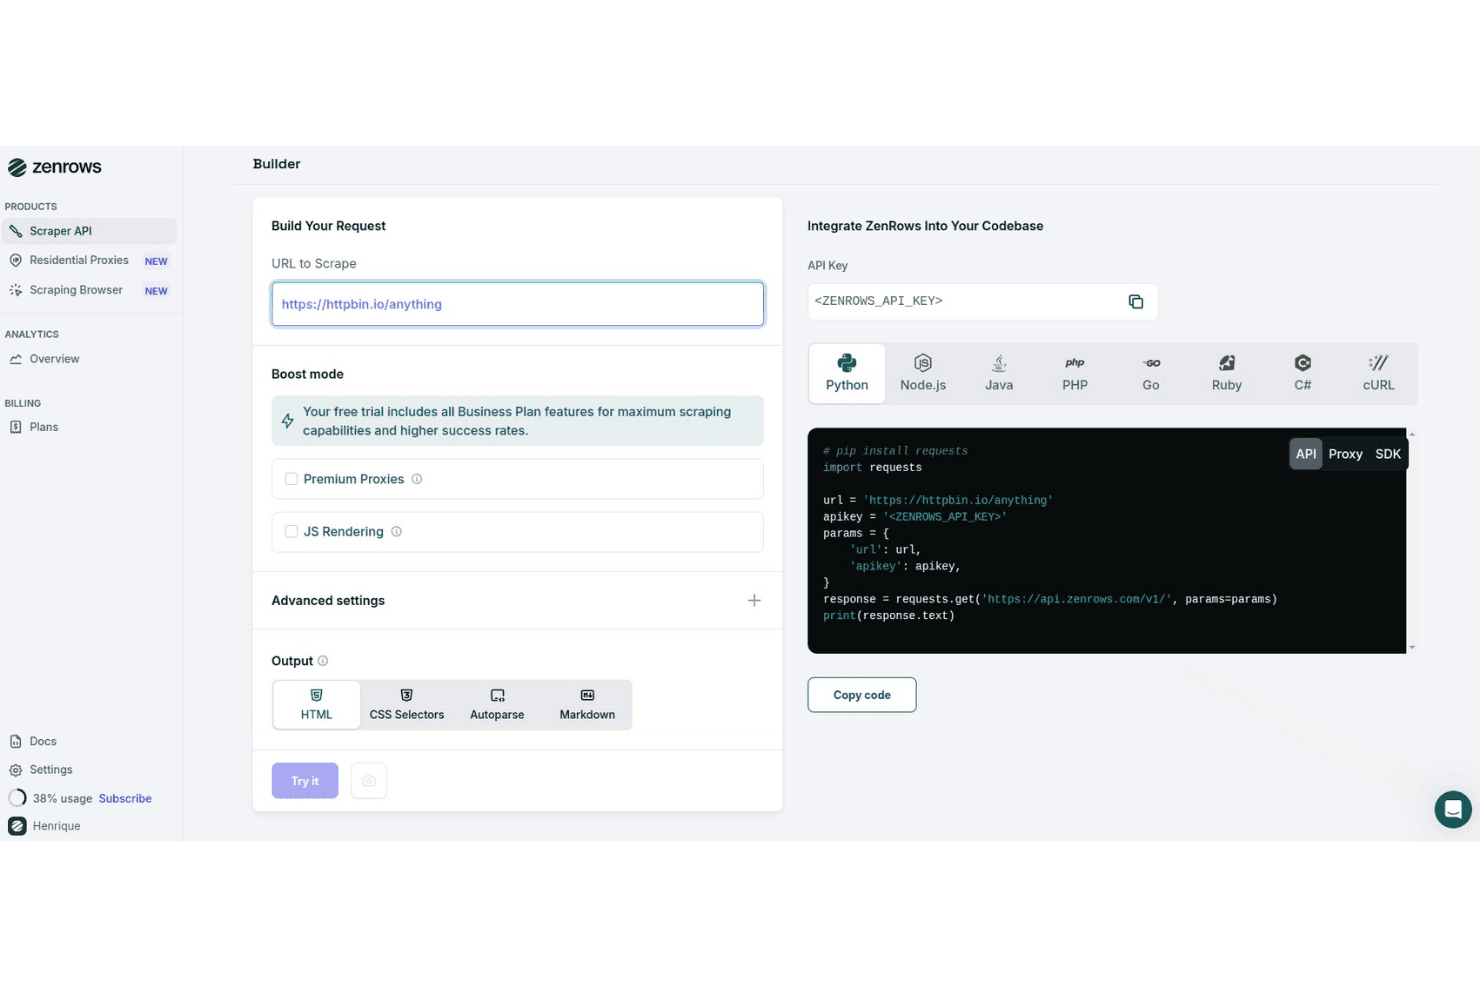
ZenRows oferuje wizualny kreator żądań z generowaniem kodu w wielu językach, opcjami trybu zwiększonej skuteczności i wyborem formatu danych wyjściowych do scrapowania stron internetowych. ZenRows to interfejs API do scrapowania stron internetowych i platforma przeglądarki w chmurze, która łączy omijanie zabezpieczeń antybotowych, rotację rezydencjalnych serwerów proxy, renderowanie JavaScriptu i wyodrębnianie ustrukturyzowanych danych w jednym zestawie narzędzi dla deweloperów.
Dla kogo ZenRows jest najlepszym wyborem?
ZenRows to dobry wybór dla deweloperów i inżynierów danych, którzy potrzebują scrapować witryny z zaawansowaną ochroną antybotową na dużą skalę.
Dlaczego wybrałem ZenRows
ZenRows znalazł się na mojej krótkiej liście ze względu na sposób obsługi zabezpieczeń antybotowych. Scrapowałem witryny chronione przez Cloudflare, na których standardowe narzędzia konsekwentnie zawodziły, a ZenRows uzyskuje do nich dostęp dzięki omijaniu mechanizmów identyfikacji przeglądarki i automatycznemu rozwiązywaniu CAPTCHA bez konieczności ręcznej konfiguracji. Przeglądarka do scrapowania idzie o krok dalej, uruchamiając pełne sesje Chromium z ukrytymi nagłówkami, które dokładnie naśladują zachowanie prawdziwego użytkownika, aby uniknąć wykrycia w witrynach korzystających z DataDome lub PerimeterX.
Najważniejsze funkcje ZenRows
- Uniwersalne API do scrapowania: Wysyłaj żądania za pomocą jednego punktu końcowego, który dostosowuje się do różnych struktur witryn i wymagań dotyczących scrapowania.
- Infrastruktura rezydencjalnych serwerów proxy: Wybieraj spośród puli ponad 55 milionów rezydencjalnych adresów IP w ponad 185 krajach, aby prowadzić ukierunkowane geograficznie przeszukiwanie.
- Automatyczne parsowanie na potrzeby ustrukturyzowanych danych wyjściowych: Automatycznie wyodrębniaj i odbieraj dane w formacie JSON, HTML lub Markdown dzięki wbudowanemu parsowaniu popularnych witryn.
- Wielojęzyczne zestawy SDK: Korzystaj z oficjalnych zestawów SDK dla języków Python, Node.js, Go, PHP, Ruby, Java i C#, aby integrować narzędzie z procesami programistycznymi.
Integracje ZenRows
ZenRows oferuje natywne integracje z Playwright, Puppeteer, n8n, Make, Clay i Zapier. Dostępne jest API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Niezawodne omijanie zabezpieczeń Cloudflare i DataDome
- Wysoki wskaźnik skuteczności na chronionych stronach
- Pełne sesje przeglądarki bez interfejsu z trybem ukrycia
Cons:
- Brak natywnego planowania lub orkiestracji zadań
- Koszty szybko rosną przy dużej liczbie żądań
Learn more about ZenRows: Najlepsze narzędzie do obsługi dynamicznych witryn wykorzystujących JavaScript
- Dostępny bezpłatny plan
- Od $189/miesiąc
Visit WebsiteCustomer Rating:4.4/5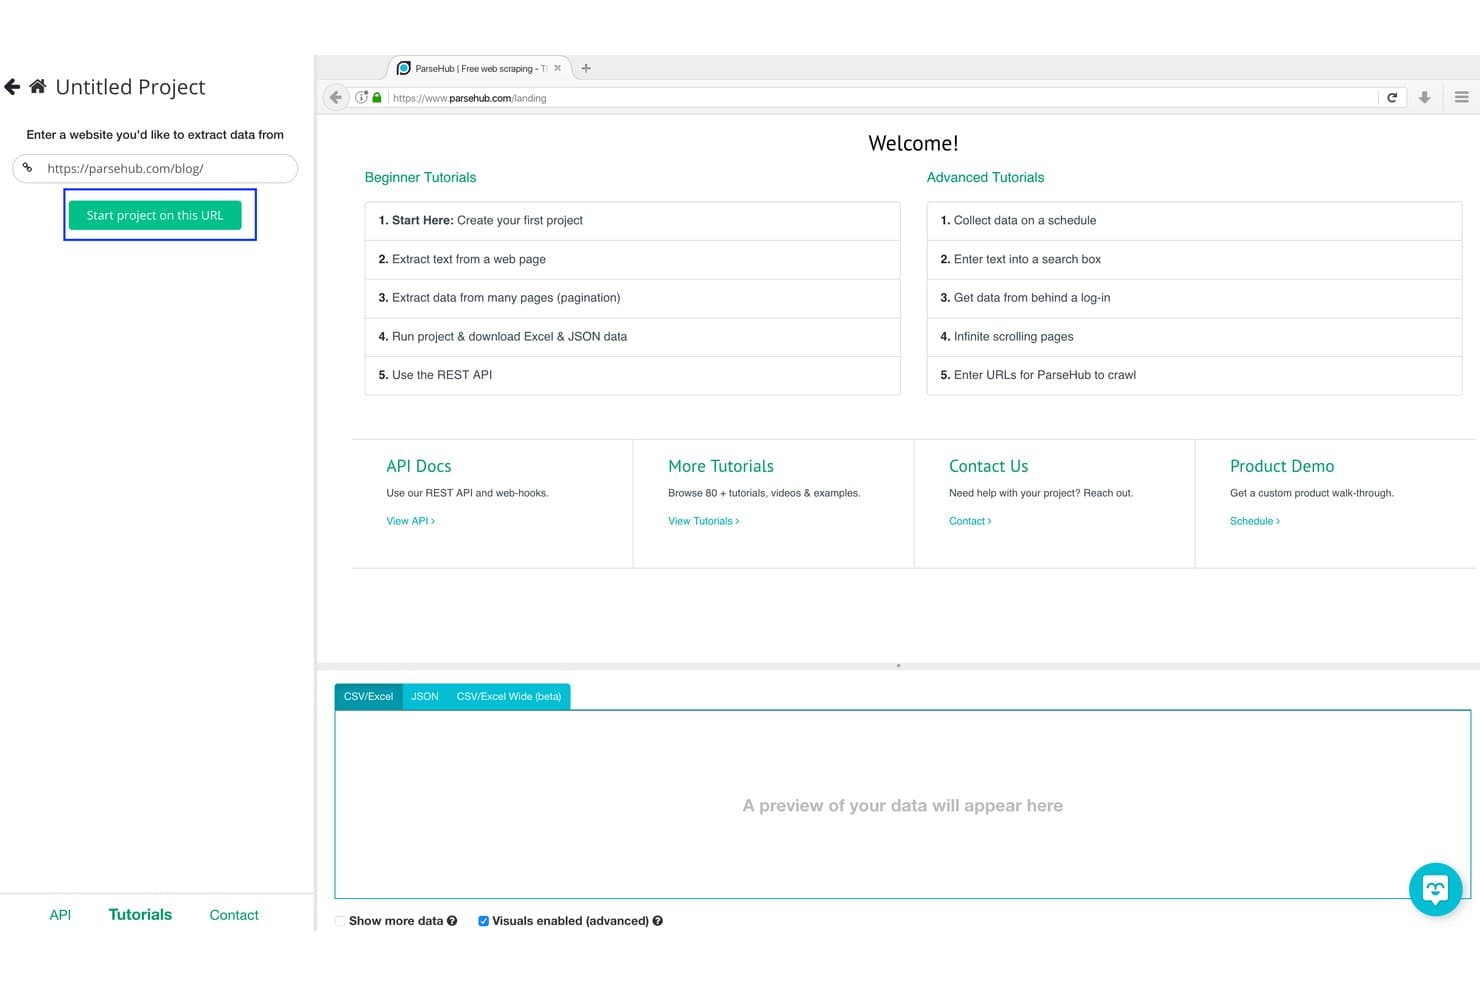
ParseHub oferuje wizualny interfejs konfiguracji projektu, w którym użytkownicy wpisują adres URL i klikają „Rozpocznij projekt pod tym adresem”, aby rozpocząć pobieranie danych ze stron internetowych. ParseHub to wizualne narzędzie do ekstrakcji danych ze stron internetowych, które pobiera dane z dynamicznych witryn za pomocą interfejsu opartego na klikaniu, z obsługą JavaScriptu, AJAX, nieskończonego przewijania, pól formularzy oraz zaplanowanych uruchomień w chmurze.
Dla kogo ParseHub jest najlepszym wyborem?
ParseHub to dobry wybór dla analityków wywiadu konkurencyjnego i nietechnicznych badaczy, którzy muszą zbierać dane z witryn intensywnie korzystających z JavaScriptu bez pisania kodu.
Dlaczego wybrałem ParseHub
ParseHub znalazł się na mojej krótkiej liście najlepszych narzędzi, ponieważ radzi sobie z problemami renderowania JavaScriptu, które sprawiają trudności większości narzędzi do ekstrakcji danych bez kodowania. Korzystałem z niego do pobierania danych ze stron z nieskończonym przewijaniem i treściami wywoływanymi przez listy rozwijane, gdzie narzędzia pobierające dane ze statycznego kodu HTML zwracają puste wyniki. Jego silnik uczenia maszynowego automatycznie wykrywa strukturę strony, dzięki czemu mogę utworzyć działające narzędzie do ekstrakcji danych z katalogu produktów intensywnie korzystającego z AJAX, bez napisania ani jednej linii XPath.
Najważniejsze funkcje ParseHub
- Wizualny kreator typu wskaż i kliknij: Wybieraj i pobieraj elementy strony bez ręcznego kodowania selektorów.
- Harmonogramowanie w chmurze: Planuj cykliczne zadania ekstrakcji danych w infrastrukturze chmurowej ParseHub.
- Dostęp do REST API: Zarządzaj wynikami ekstrakcji danych, uruchamiaj zadania i pobieraj wyniki programowo za pomocą API.
- Automatyczna rotacja adresów IP: Ograniczaj blokowanie poprzez rotację wychodzących adresów IP podczas uruchomień w chmurze.
Integracje ParseHub
ParseHub oferuje natywne integracje z Google Sheets, Tableau, Dropbox i AWS S3. API jest dostępne na potrzeby niestandardowych integracji i automatyzacji przepływów pracy.
Pros and Cons
Pros:
- Natywnie obsługuje JavaScript, AJAX i nieskończone przewijanie
- Wizualny kreator nie wymaga kodowania selektorów
- Ekstrakcja danych jest automatycznie wykonywana w infrastrukturze chmurowej
Cons:
- Ograniczenia przy dużej liczbie równoczesnych zadań ekstrakcji danych
- Brak wbudowanego rozwiązywania CAPTCHA
Learn more about ParseHub: Najlepsze do bezpośredniej integracji z potokami danych
- 30-dniowy bezpłatny okres próbny
- Od $199 miesięcznie (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.2/5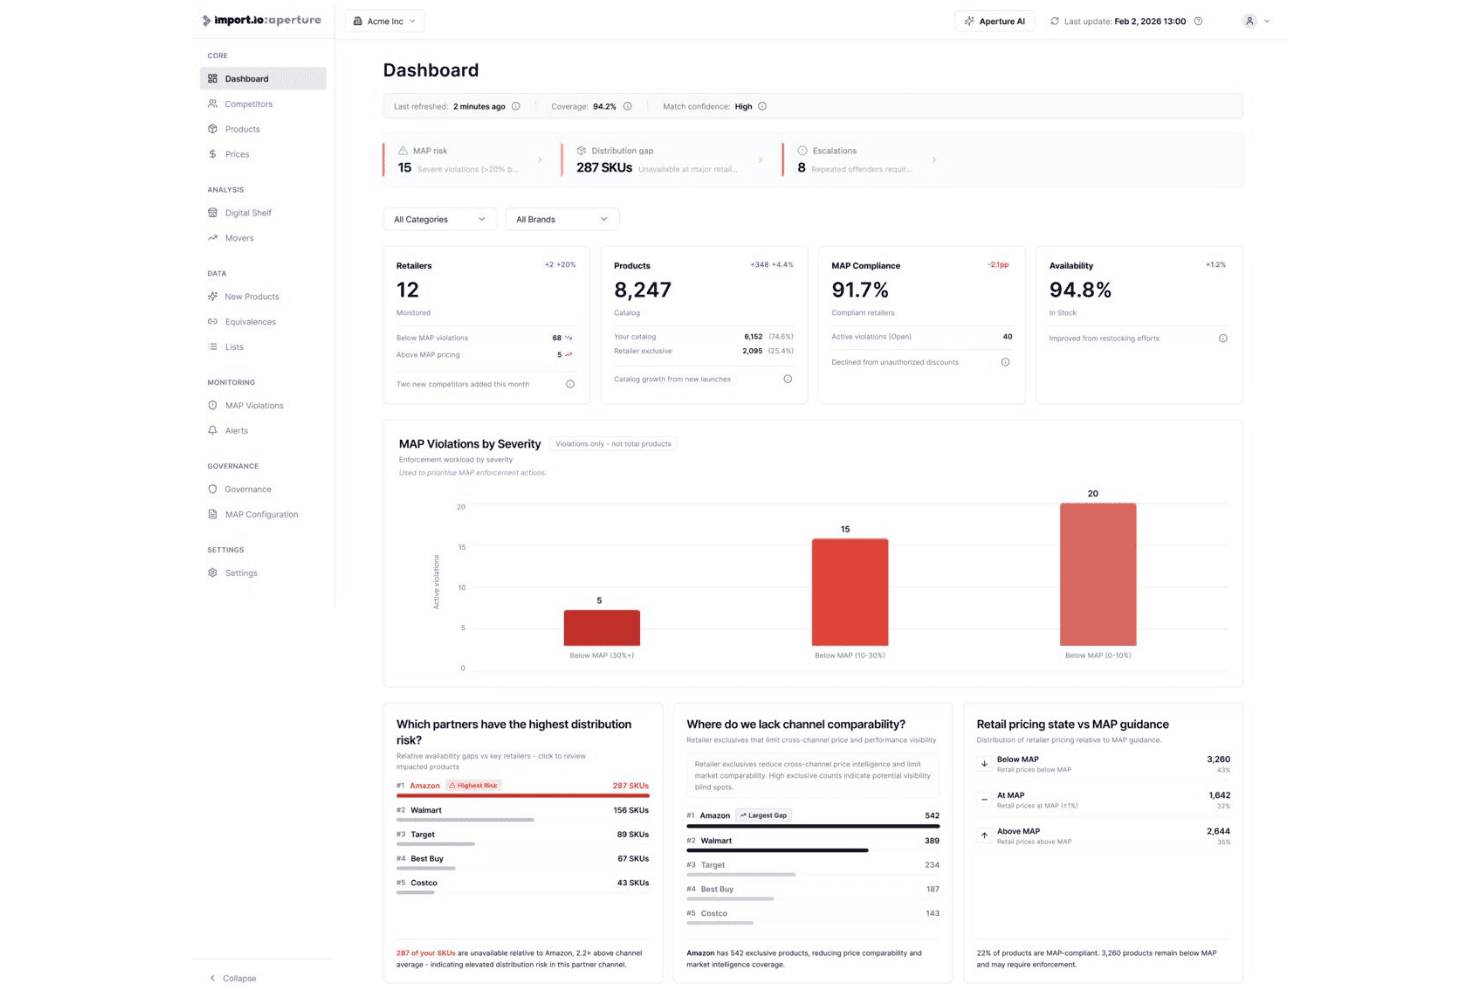
Platforma Aperture firmy Import.io oferuje pulpit nawigacyjny przedstawiający zgodność z MAP, dostępność produktów, luki w dystrybucji u sprzedawców oraz naruszenia zasad cenowych. Import.io to natywna dla AI, zarządzana platforma do ekstrakcji danych z sieci, która pozyskuje ustrukturyzowane dane ze stron internetowych na skalę korporacyjną, obsługując strony renderowane za pomocą JavaScriptu, chronione źródła oraz bezpośrednie dostarczanie danych do potoków danych i systemów analitycznych.
Dla kogo Import.io jest najlepszym rozwiązaniem?
Import.io odpowiada potrzebom zespołów zajmujących się inżynierią danych i analizą konkurencji w średnich i dużych przedsiębiorstwach, które potrzebują utrzymywanych potoków danych bez konieczności tworzenia lub zarządzania własnymi narzędziami do ekstrakcji danych.
Dlaczego wybrałem Import.io
Import.io znalazło się na mojej krótkiej liście, ponieważ ustrukturyzowane dane trafiają bezpośrednio z sieci do hurtowni danych, pulpitu nawigacyjnego lub punktu końcowego API, bez konieczności wykonywania po drodze ręcznego eksportu. Podoba mi się, że webhooki i dostarczanie danych przez API są natywnymi funkcjami platformy, a nie dodatkiem wdrożonym w późniejszym czasie. Za najbardziej wartościowe uważam samonaprawiające się potoki danych: automatycznie dostosowują się, gdy docelowe witryny zmieniają strukturę, więc nie muszę za każdym razem przebudowywać ekstraktorów, gdy sprzedawca aktualizuje układ swojej strony.
Najważniejsze funkcje Import.io
- Modele ekstrakcji wspomagane przez AI: Automatycznie wykrywają struktury stron i dostosowują schemat, gdy witryny się zmieniają.
- Korporacyjne zarządzanie serwerami proxy: Obsługuje serwery proxy premium i rezydencjalne do ekstrakcji danych z chronionych lub ograniczonych geograficznie witryn.
- Wizualny kreator typu wskaż i kliknij: Umożliwia wybieranie i ekstrakcję danych ze złożonych stron internetowych bez pisania kodu.
- Automatyczne maskowanie danych PII: Identyfikuje i usuwa dane umożliwiające identyfikację osób ze zbiorów pozyskanych danych w celu zapewnienia zgodności z przepisami.
Integracje Import.io
Import.io oferuje natywne integracje z Google Sheets, Power BI, Tableau i Excelem, a także udostępnia API do tworzenia niestandardowych integracji oraz webhooków z innymi systemami.
Pros and Cons
Pros:
- Samonaprawiające się potoki danych automatycznie dostosowują się do zmian w witrynach
- Obsługuje silnie chronione witryny oraz witryny wymagające logowania
- Zarządzana ekstrakcja zmniejsza obciążenie wewnętrznego zespołu inżynieryjnego
Cons:
- Ograniczona przejrzystość podstawowej infrastruktury ekstrakcji danych
- Ograniczona przydatność do zadań związanych z ekstrakcją danych na małą skalę
Learn more about Import.io: Najlepszy do korzystania z gotowych szablonów automatyzacji robotów
- Dostępny bezpłatny plan
- Od 19 USD/miesiąc (przy rozliczeniu rocznym)
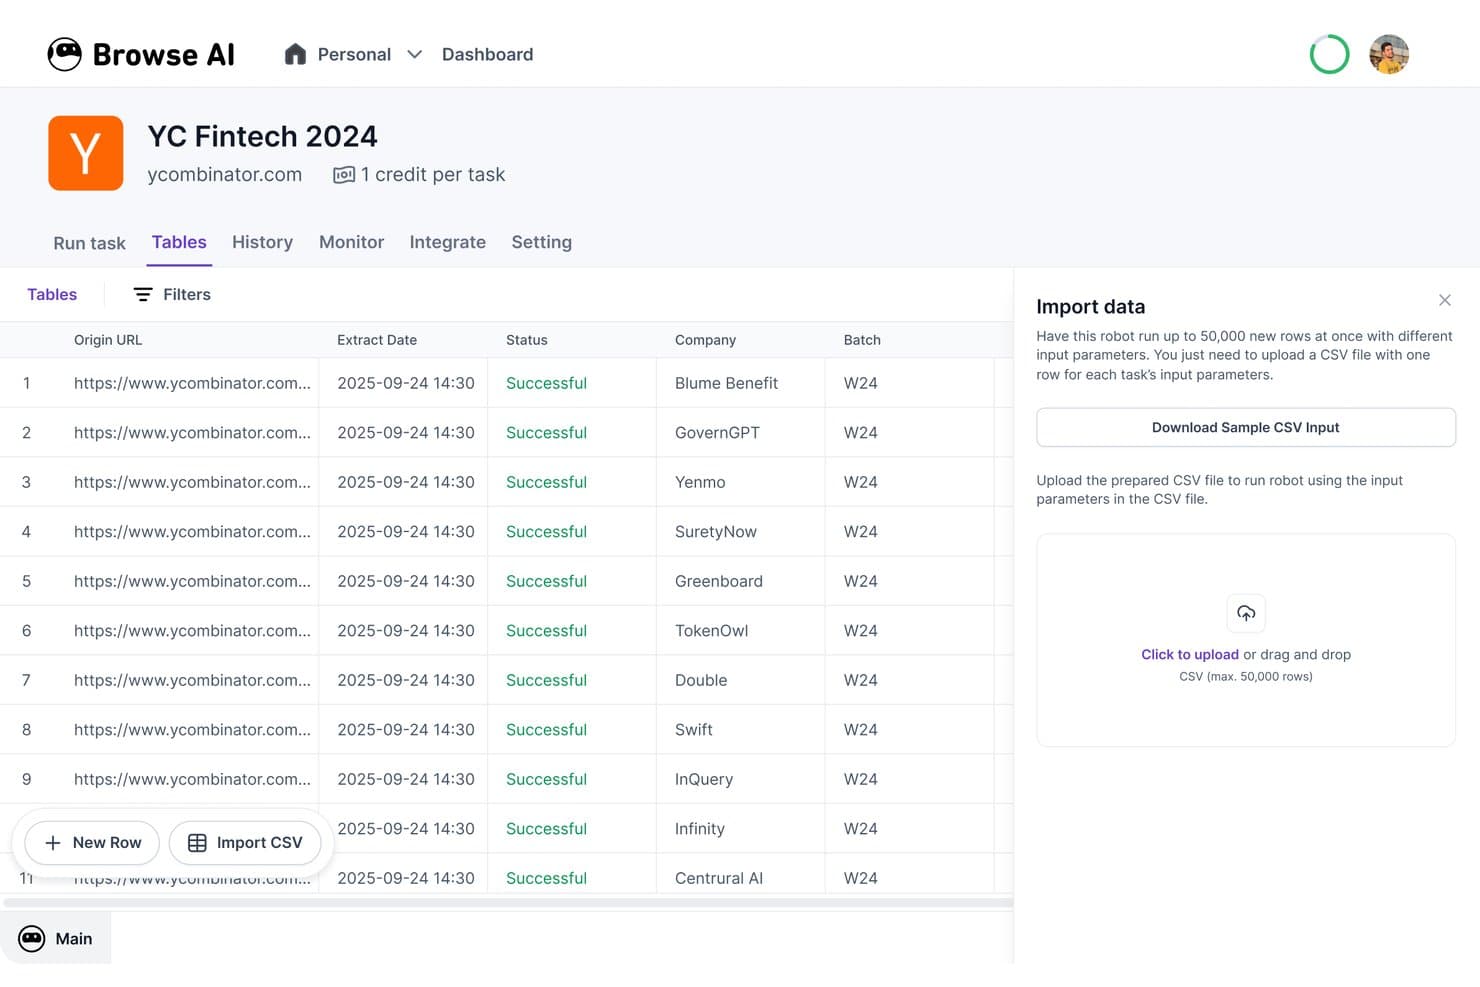
Browse AI oferuje pulpit do skrobania stron internetowych bez kodowania, za pomocą którego użytkownicy mogą wyodrębniać uporządkowane dane ze stron takich jak Y Combinator i eksportować wyniki jako pliki CSV. Browse AI to platforma do skrobania stron internetowych i monitorowania witryn bez kodowania, która łączy wizualny ekstraktor danych działający metodą wskaż i kliknij z ponad 250 gotowymi szablonami robotów do automatycznego, zaplanowanego zbierania danych ze stron internetowych.
Dla kogo Browse AI jest najlepszym wyborem?
Browse AI to dobre rozwiązanie dla analityków wywiadu konkurencyjnego i zespołów nietechnicznych, które muszą zbierać uporządkowane dane internetowe bez pisania kodu.
Dlaczego wybrałem Browse AI
Browse AI trafia na moją krótką listę przede wszystkim ze względu na przewagę, jaką daje jego biblioteka gotowych robotów. Mogę pobierać uporządkowane oferty z Amazon, Google Maps lub Indeed bez tworzenia ekstraktora od podstaw, a każdy robot obsługuje już paginację i dynamiczną zawartość właściwą dla danej witryny. Doceniam również adaptację układu opartą na AI, która automatycznie aktualizuje robota, gdy docelowa witryna zmienia strukturę strony, dzięki czemu skrobanie nie przestaje po cichu działać w połowie procesu.
Najważniejsze funkcje Browse AI
- Renderowanie JavaScript: Automatyzuje ekstrakcję z nowoczesnych stron internetowych intensywnie wykorzystujących JavaScript oraz aplikacji jednostronicowych.
- Obsługa rezydencyjnych serwerów proxy: Automatycznie zmienia rezydencyjne adresy IP, aby omijać systemy antybotowe bez ręcznej konfiguracji serwerów proxy.
- Webhooki i dostęp przez API: Umożliwia programowe przesyłanie zadań skrobania i pobieranie danych w celu integracji z systemami wewnętrznymi.
- Automatyczne wykrywanie zmian: Monitoruje witryny pod kątem zmian wizualnych lub zmian treści i wysyła alerty po wykryciu aktualizacji.
Integracje Browse AI
Browse AI oferuje natywne integracje z Google Sheets, Airtable, AWS S3, Zapier i Make.com. Dostęp przez API i webhooki jest dostępny na potrzeby niestandardowych integracji.
Pros and Cons
Pros:
- Ponad 250 gotowych robotów do wdrożenia
- Automatycznie dostosowuje się do zmian układu docelowej witryny
- Natywnie obsługuje CAPTCHA i strony dynamiczne
Cons:
- Ograniczona kontrola na poziomie selektorów dla programistów
- Koszty kredytów szybko rosną przy dużej skali
Learn more about Browse AI: Najlepsze do zarządzanego gromadzenia danych z ochroną przed botami
- Dostępny bezpłatny okres próbny
- Od $0.5/1,000 rekordów
Visit WebsiteCustomer Rating:4.5/5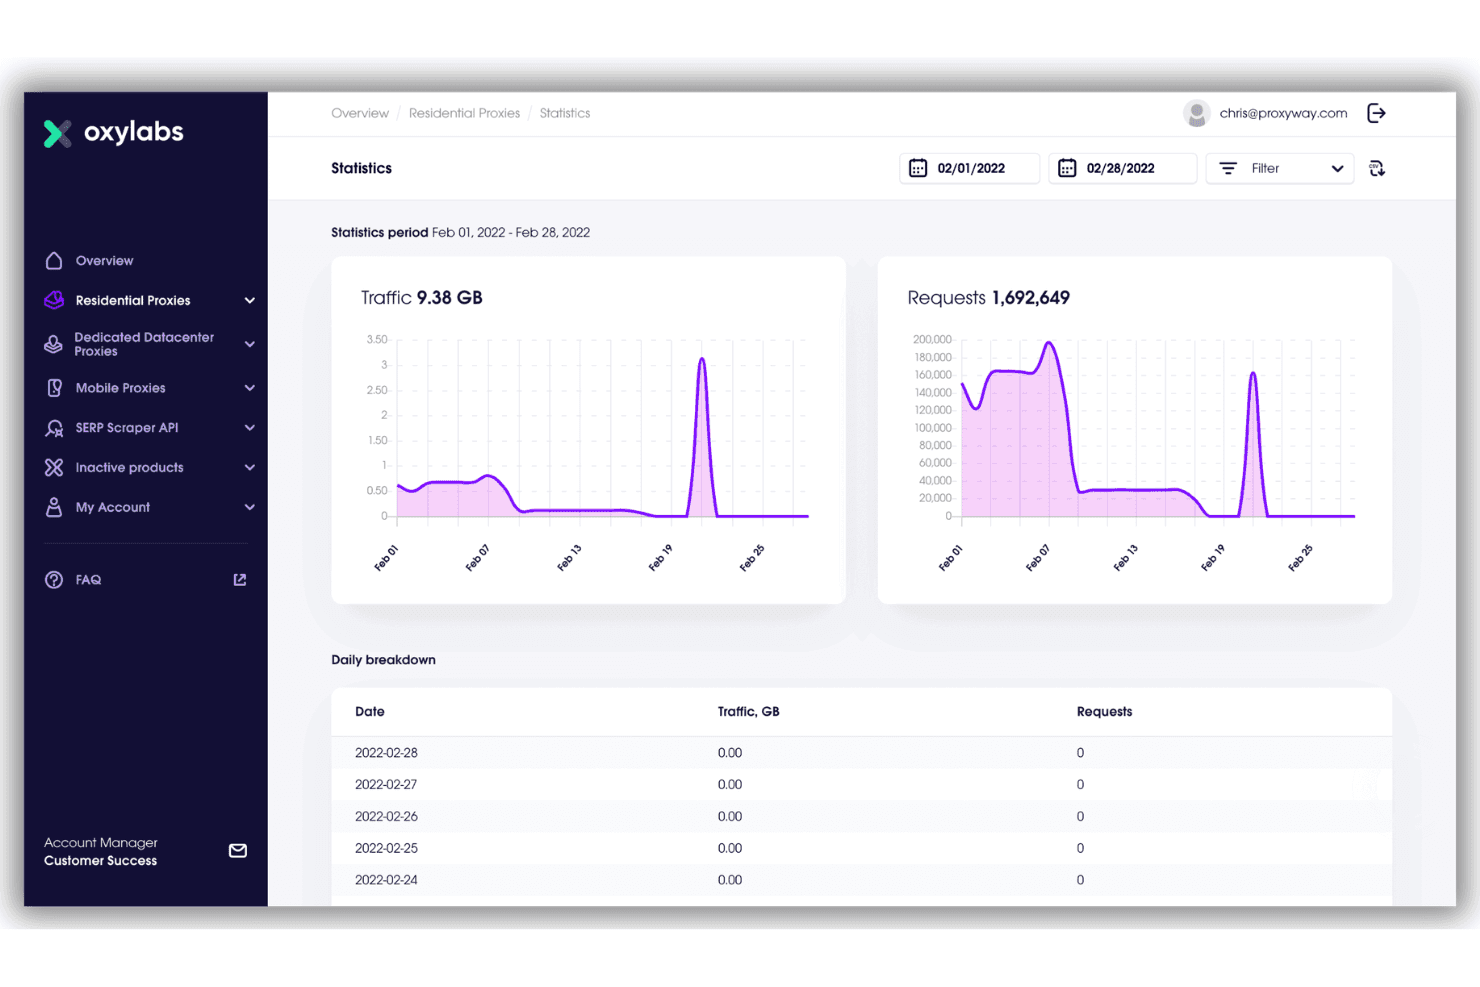
Oxylabs oferuje szczegółowy panel statystyk dla rezydencjalnych serwerów proxy, pokazujący ruch i metryki żądań w wybranym zakresie dat w lutym 2022 roku. Oxylabs to interfejs API do scrapowania stron internetowych, który obsługuje zarządzanie serwerami proxy, rozwiązywanie CAPTCHA, renderowanie JavaScriptu i ekstrakcję ustrukturyzowanych danych z ponad 50 wstępnie skonfigurowanych celów internetowych.
Dla kogo Oxylabs jest najlepszym wyborem?
Dla inżynierów danych i programistów backendu prowadzących zakrojone na dużą skalę, krytyczne dla działalności potoki scrapowania, którzy potrzebują infrastruktury klasy enterprise i niezawodnej ochrony przed botami.
Dlaczego wybrałem Oxylabs
Oxylabs trafia na moją krótką listę ze względu na sposób, w jaki radzi sobie z najtrudniejszym elementem scrapowania stron internetowych: omijaniem wykrywania botów bez konieczności samodzielnego zarządzania tym procesem. Interfejs API obsługuje rozwiązywanie CAPTCHA, rotację proxy wśród ponad 177 mln rezydencjalnych adresów IP oraz automatyczne ponawianie prób bez konieczności stosowania po mojej stronie niestandardowej logiki obsługi błędów. Podoba mi się również model cenowy oparty na sukcesie, w którym tylko odpowiedzi 2xx i 4xx są wliczane do limitu, dzięki czemu awarie po stronie systemu nie zużywają wyników.
Najważniejsze funkcje Oxylabs
- Niestandardowy parser: Zdefiniuj selektory CSS lub XPath, aby wyodrębniać precyzyjnie ustrukturyzowane dane z treści strony.
- Asystent AI OxyCopilot: Generuj instrukcje scrapowania i logikę parsowania za pomocą poleceń w języku naturalnym.
- Wstępnie utworzone konektory celów: Korzystaj z dedykowanych punktów końcowych dla Amazon, Google, eBay, Walmart, Zillow i innych dużych serwisów.
- Integracje z pamięcią masową w chmurze: Eksportuj wyniki bezpośrednio do AWS S3 i Google Cloud Storage, aby wykorzystywać je w potokach danych.
Integracje Oxylabs
Oxylabs oferuje natywne integracje z AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com i Zapier. Do niestandardowych integracji dostępne są interfejs API oraz zestawy SDK dla języków Python i Go.
Pros and Cons
Pros:
- Ponad 177 mln rezydencjalnych adresów IP w 195 krajach
- Ceny oparte na sukcesie zapobiegają marnowaniu limitu żądań
- Wstępnie utworzone punkty końcowe dla ponad 50 dużych serwisów
Cons:
- Wyższy koszt niż w przypadku narzędzi do samodzielnego zarządzania scrapowaniem
- Brak dostępnego wizualnego interfejsu narzędzia do scrapowania bez kodowania
Learn more about Oxylabs: Najlepsze rozwiązanie dla infrastruktury proxy na skalę przedsiębiorstwa
- Dostępny plan bezpłatny
- Od $1.5/1,000 rekordów/miesiąc
Visit WebsiteCustomer Rating:4.7/5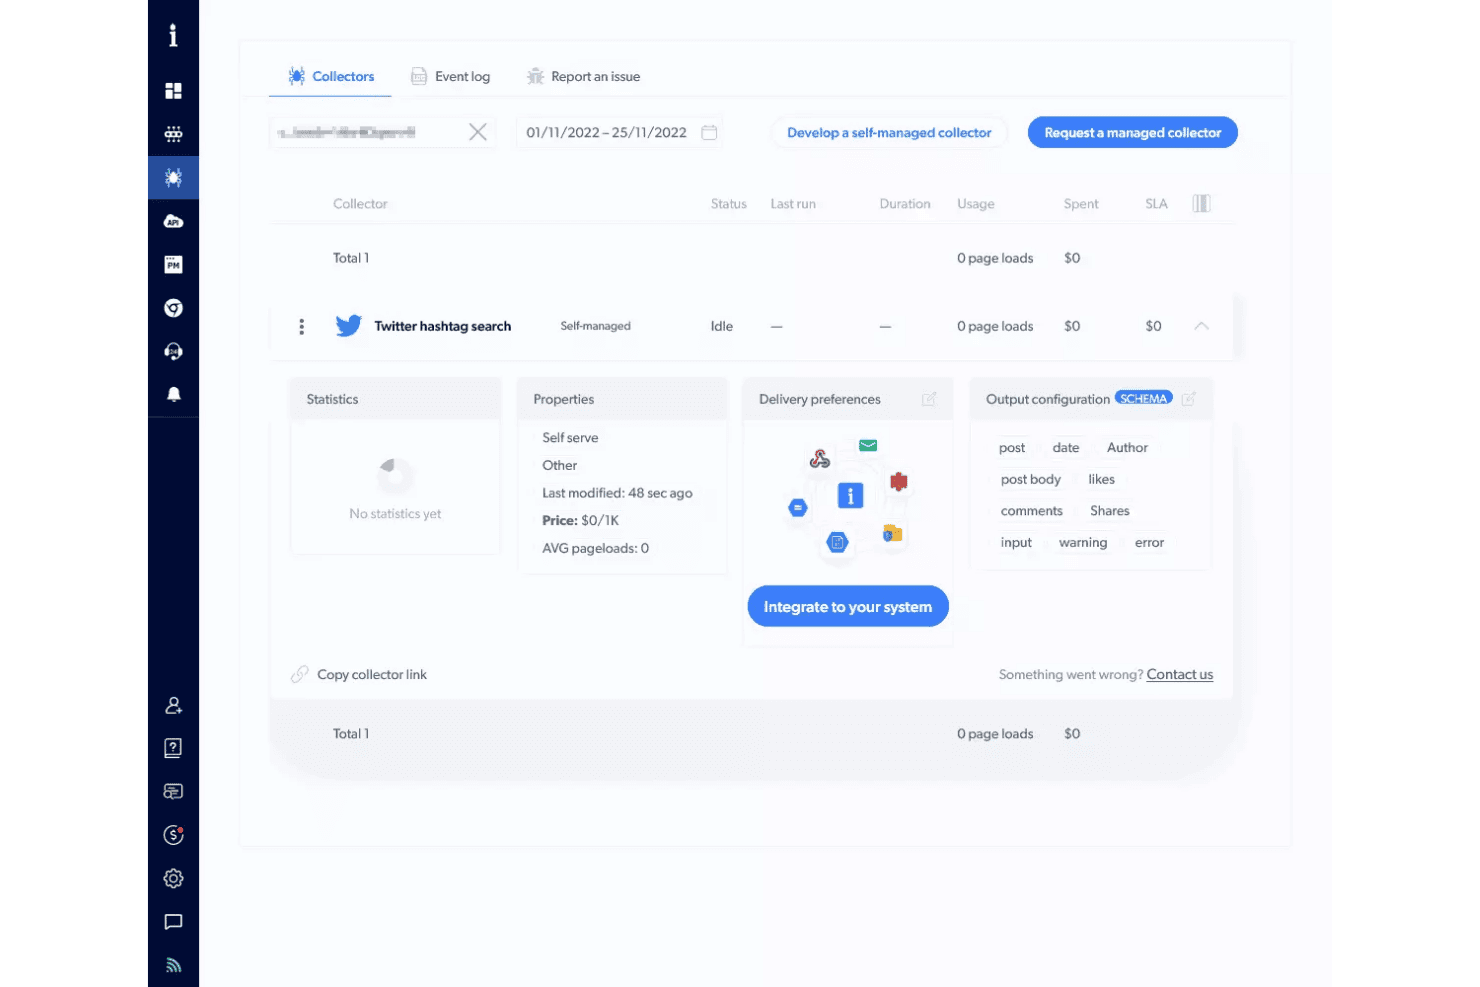
Panel Collectors firmy Bright Data oferuje kolektor wyszukujący hashtagi na Twitterze, z samodzielnie zarządzanym statusem, konfiguracją wyników i opcjami integracji z systemem. Bright Data to interfejs API do web scrapingu oraz platforma do scrapowania bez kodowania, która łączy zarządzanie serwerami proxy, renderowanie JavaScript, rozwiązywanie CAPTCHA i dostarczanie ustrukturyzowanych danych za pośrednictwem ponad 1 278 gotowych skraperów dla popularnych witryn.
Dla kogo Bright Data jest najlepszym rozwiązaniem?
Dla inżynierów danych i programistów backendu w średnich i dużych organizacjach, którzy potrzebują gromadzić ustrukturyzowane dane internetowe na dużą skalę bez samodzielnego zarządzania infrastrukturą proxy.
Dlaczego wybrałem Bright Data
Bright Data znalazło się na mojej krótkiej liście ze względu na ogromną skalę swojej sieci proxy: ponad 400 mln rezydencyjnych adresów IP w 195 krajach, z automatyczną rotacją, rozwiązywaniem CAPTCHA i funkcją Web Unlocker stworzoną do omijania zabezpieczeń Cloudflare, Akamai i DataDome bez konieczności konfiguracji. Korzystając z Bright Data, scrapowałem LinkedIn Sales Navigator i Amazon na dużą skalę i nie napotkałem żadnych blokad przy tysiącach żądań. AI Scraper Studio pozwala również wygenerować działający interfejs API skrapera dla dowolnej nowej domeny w ciągu kilku minut.
Najważniejsze funkcje Bright Data
- Gotowe szablony skraperów: Dostępnych jest ponad 1 200 gotowych skraperów umożliwiających szybkie wdrożenie dla najważniejszych platform, takich jak LinkedIn, Amazon i YouTube.
- Wykrywanie schematów oparte na sztucznej inteligencji: AI Scraper Studio generuje niestandardowe schematy wynikowe i automatyzuje mapowanie danych z nowych domen.
- Interfejsy API do zarządzania zadaniami: Zapewniają planowanie zadań wsadowych, cykliczne uruchomienia i wyzwalacze webhooków do integracji z narzędziami automatyzacji przepływów pracy.
- Bezpośrednie dostarczanie danych: Obsługuje eksport danych do formatów JSON, NDJSON, CSV i XLSX, a także bezpośrednie przesyłanie do S3, Snowflake, GCS, PubSub lub SFTP.
Integracje Bright Data
Bright Data oferuje natywne integracje z Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake i Pub/Sub oraz udostępnia interfejs API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Ponad 400 mln rezydencyjnych adresów IP w 195 krajach
- Gotowe skrapery dla ponad 1 200 popularnych witryn
- Web Unlocker omija zabezpieczenia Cloudflare i DataDome
Cons:
- Użytkownicy zgłaszają spory dotyczące opłat za nieudane scrapowanie
- Zbyt skomplikowane dla nabywców niebędących programistami
Learn more about Bright Data: Najlepszy wybór do automatycznego wykrywania schematów danych
- 30-dniowy bezpłatny okres próbny
- Od $0.13/1,000 żądań
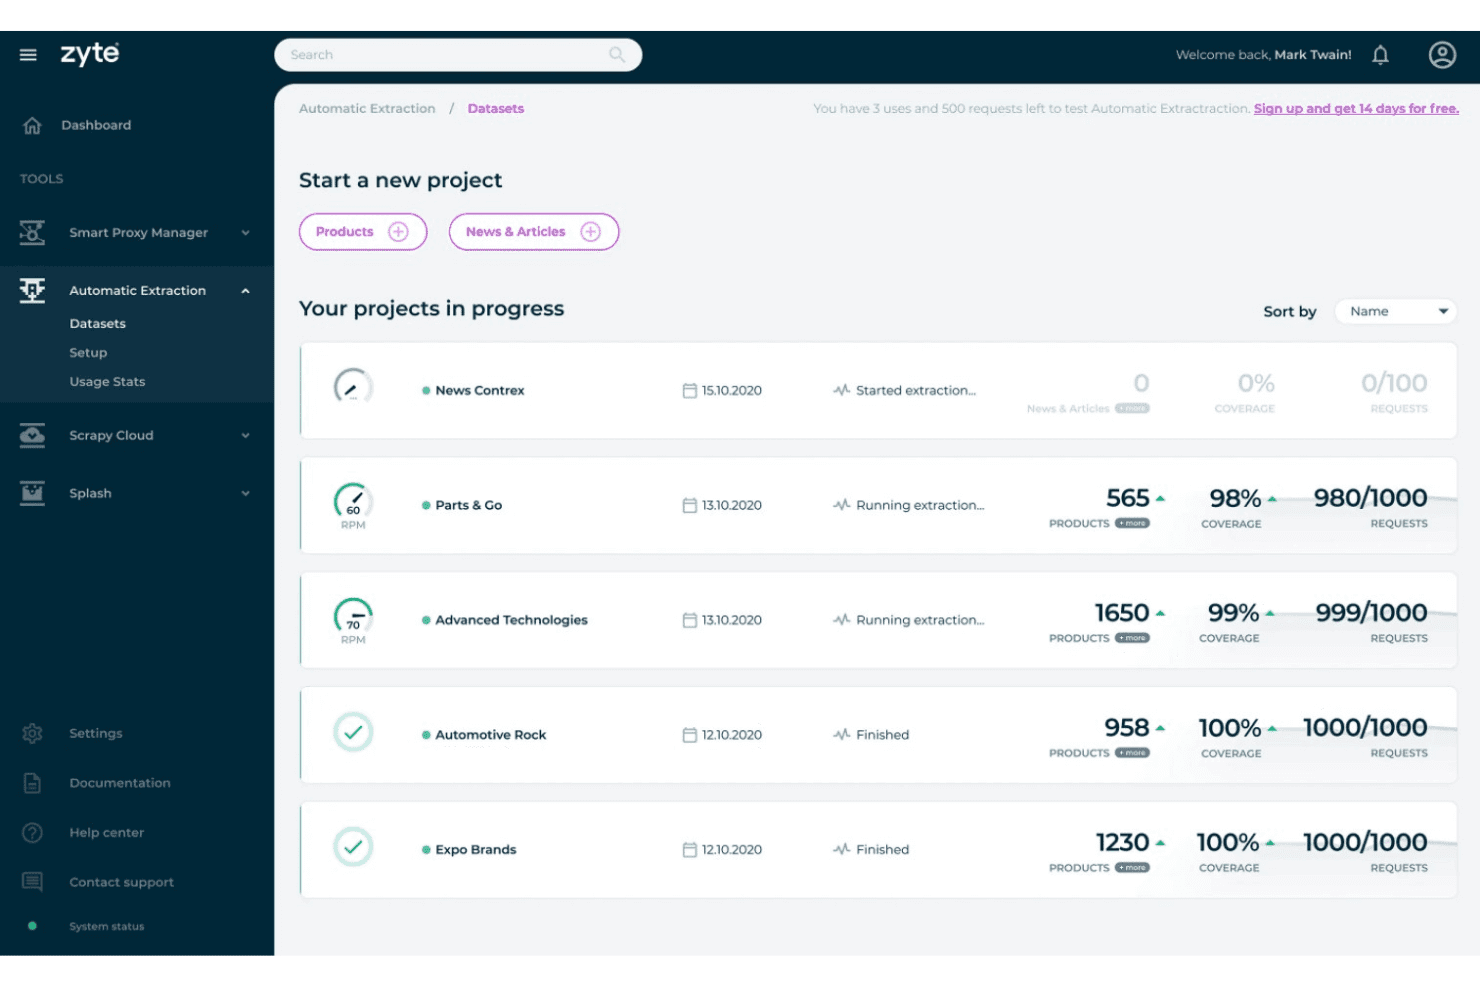
Funkcja automatycznej ekstrakcji Zyte oferuje trwające i ukończone projekty ekstrakcji danych wraz ze wskaźnikami zasięgu, liczbą produktów i wykorzystaniem żądań. Zyte API to interfejs API do skrobania stron internetowych, który łączy renderowanie w przeglądarce bez interfejsu graficznego, automatyczną rotację serwerów proxy, rozwiązywanie CAPTCHA oraz ekstrakcję danych opartą na sztucznej inteligencji w jednym punkcie końcowym.
Dla kogo Zyte API jest najlepszym wyborem?
Zyte API doskonale sprawdza się w przypadku inżynierów danych i programistów Pythona tworzących potoki skrobania na skalę produkcyjną, które zasilają modele ML lub systemy analityczne.
Dlaczego wybrałem Zyte API
Zyte API znalazło się na mojej krótkiej liście dzięki sposobowi, w jaki obsługuje automatyczne wykrywanie schematów. Wskaż stronę produktu lub artykuł, a warstwa ekstrakcji oparta na LLM zwróci typowany, ustrukturyzowany JSON bez konieczności użycia po mojej stronie choćby jednego selektora CSS lub wyrażenia XPath. Gdy witryna aktualizuje układ, sztuczna inteligencja dostosowuje się, dzięki czemu nie muszę nieustannie poprawiać parserów za każdym razem, gdy konkurent przeprojektuje stronę swojego katalogu.
Najważniejsze funkcje Zyte API
- Natychmiastowe renderowanie w przeglądarce: Zyte API uruchamia wstępnie rozgrzane przeglądarki bez interfejsu graficznego, aby ładować dynamiczne witryny na żądanie.
- Kompletna infrastruktura proxy: Automatycznie zmienia przy każdym żądaniu adresy IP z sieci domowych, centrów danych i urządzeń mobilnych.
- Zarządzanie sesjami: Utrzymuje trwałe pliki cookie i sesje użytkowników na potrzeby procesów wymagających uwierzytelniania lub wieloetapowych działań.
- Integracje z dostarczaniem do chmury: Przesyła zeskrobane dane bezpośrednio do miejsc docelowych, takich jak AWS S3, Google Cloud lub Azure, w celu dalszego przetwarzania.
Integracje Zyte API
Zyte API oferuje natywne integracje z narzędziami Scrapy, Scrapy Cloud i zestawami SDK dla Pythona, a także interfejs API do tworzenia niestandardowych integracji. Obsługuje również dostarczanie do chmury AWS S3, Google Cloud i Azure.
Pros and Cons
Pros:
- Sztuczna inteligencja automatycznie wykrywa schematy bez ręcznego definiowania selektorów
- Omija zabezpieczenia przed botami bez dodatkowej konfiguracji
- Wstępnie rozgrzane przeglądarki eliminują opóźnienia związane z uruchamianiem
Cons:
- Planowanie cyklicznych zadań wymaga zewnętrznych narzędzi
- Do wdrożenia wymagana jest znajomość programowania
Learn more about Zyte API: Najlepszy do prostych przepływów scrapingu opartych na interfejsie API
- Dostępny bezpłatny plan
- Od $49/miesiąc
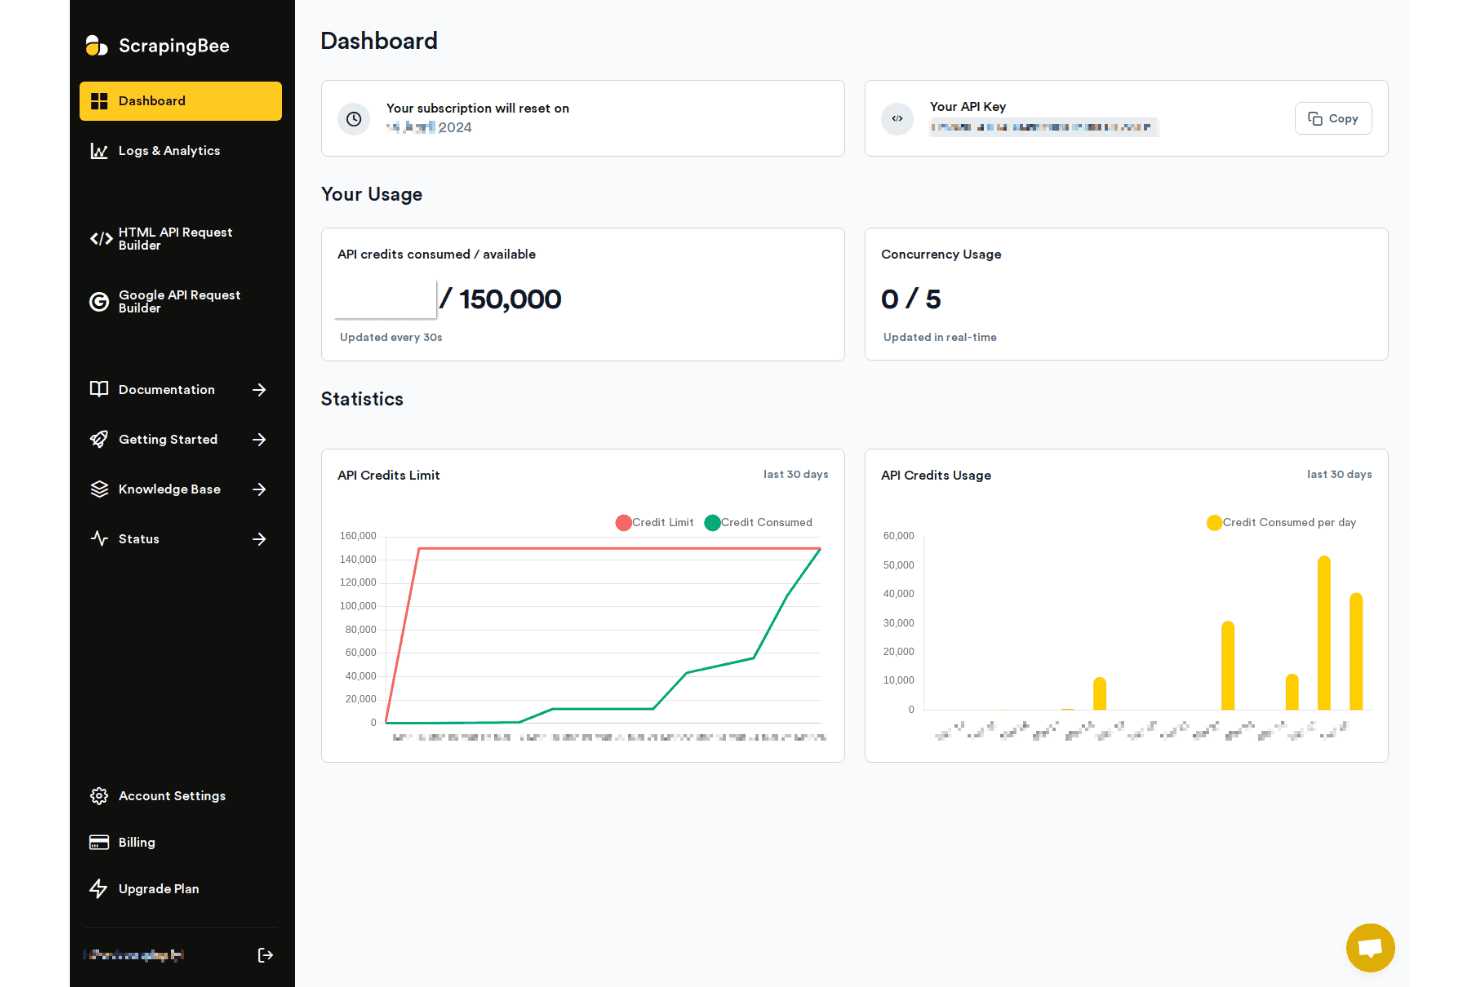
ScrapingBee oferuje pulpit nawigacyjny z informacjami o wykorzystaniu kredytów API, statystykami jednoczesności oraz wykresami wykorzystania z ostatnich 30 dni do monitorowania aktywności związanej ze scrapingiem. ScrapingBee to interfejs API do scrapingu stron internetowych, który obsługuje renderowanie za pomocą bezgłowej przeglądarki Chrome, rotację serwerów proxy i omijanie zabezpieczeń przed botami, a także oferuje dedykowane interfejsy API do ekstrakcji danych z platform takich jak Google, Amazon i Walmart.
Dla kogo najlepiej nadaje się ScrapingBee?
ScrapingBee to dobry wybór dla programistów i inżynierów danych, którzy potrzebują niezawodnego interfejsu API opartego na kodzie do pozyskiwania danych z sieci bez konieczności samodzielnego tworzenia infrastruktury serwerów proxy lub przeglądarek.
Dlaczego wybrałem ScrapingBee
ScrapingBee znalazł się na mojej krótkiej liście ze względu na to, jak sprawnie jego interfejs API ukrywa złożoność współczesnego scrapingu stron internetowych. Pojedyncze żądanie obsługuje renderowanie za pomocą bezgłowej przeglądarki Chrome, rotację serwerów proxy w trybie ukrytym oraz wykonywanie kodu JavaScript, więc nie muszę pisać kodu do zarządzania przeglądarką ani osobno konfigurować pul serwerów proxy. Podoba mi się również funkcja zapytań AI, która pozwala opisać, co ma zostać wyodrębnione, w języku naturalnym, zamiast pisać selektory CSS lub XPath dla każdej nowej witryny, którą chcę analizować.
Najważniejsze funkcje ScrapingBee
- Dedykowane interfejsy API do scrapingu: Wybieraj gotowe punkty końcowe dla platform takich jak Amazon, Walmart i wyszukiwarka Google, aby uprościć typowe zadania związane z gromadzeniem danych.
- Ekstrakcja za pomocą zapytań AI: Opisz w języku naturalnym, jakie dane mają zostać wyodrębnione, i automatycznie generuj uporządkowane wyniki.
- Narzędzie do scrapingu w Markdown: Konwertuj dowolną stronę internetową do formatu Markdown lub zwykłego tekstu, aby szybko przekazywać ją do kolejnych modeli AI lub baz danych.
- Integracje bez kodu: Połącz się z Make, n8n i Zapier, aby automatyzować przepływy pracy bez pisania niestandardowych skryptów do planowania zadań.
Integracje ScrapingBee
ScrapingBee oferuje natywne integracje z Make, n8n i Zapier oraz udostępnia interfejs API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Opłaty są naliczane tylko za pomyślne żądania
- Obsługa bezgłowej przeglądarki Chrome bez dodatkowej konfiguracji
- Dedykowane interfejsy API dla Amazon i Google
Cons:
- Brak natywnego, wbudowanego harmonogramu zadań
- Koszty kredytów szybko rosną wraz ze skalą
Learn more about ScrapingBee: Najlepsze rozwiązanie do bezproblemowej rotacji adresów IP na dużą skalę
- 7-dniowy bezpłatny okres próbny
- Od 49 USD/miesiąc
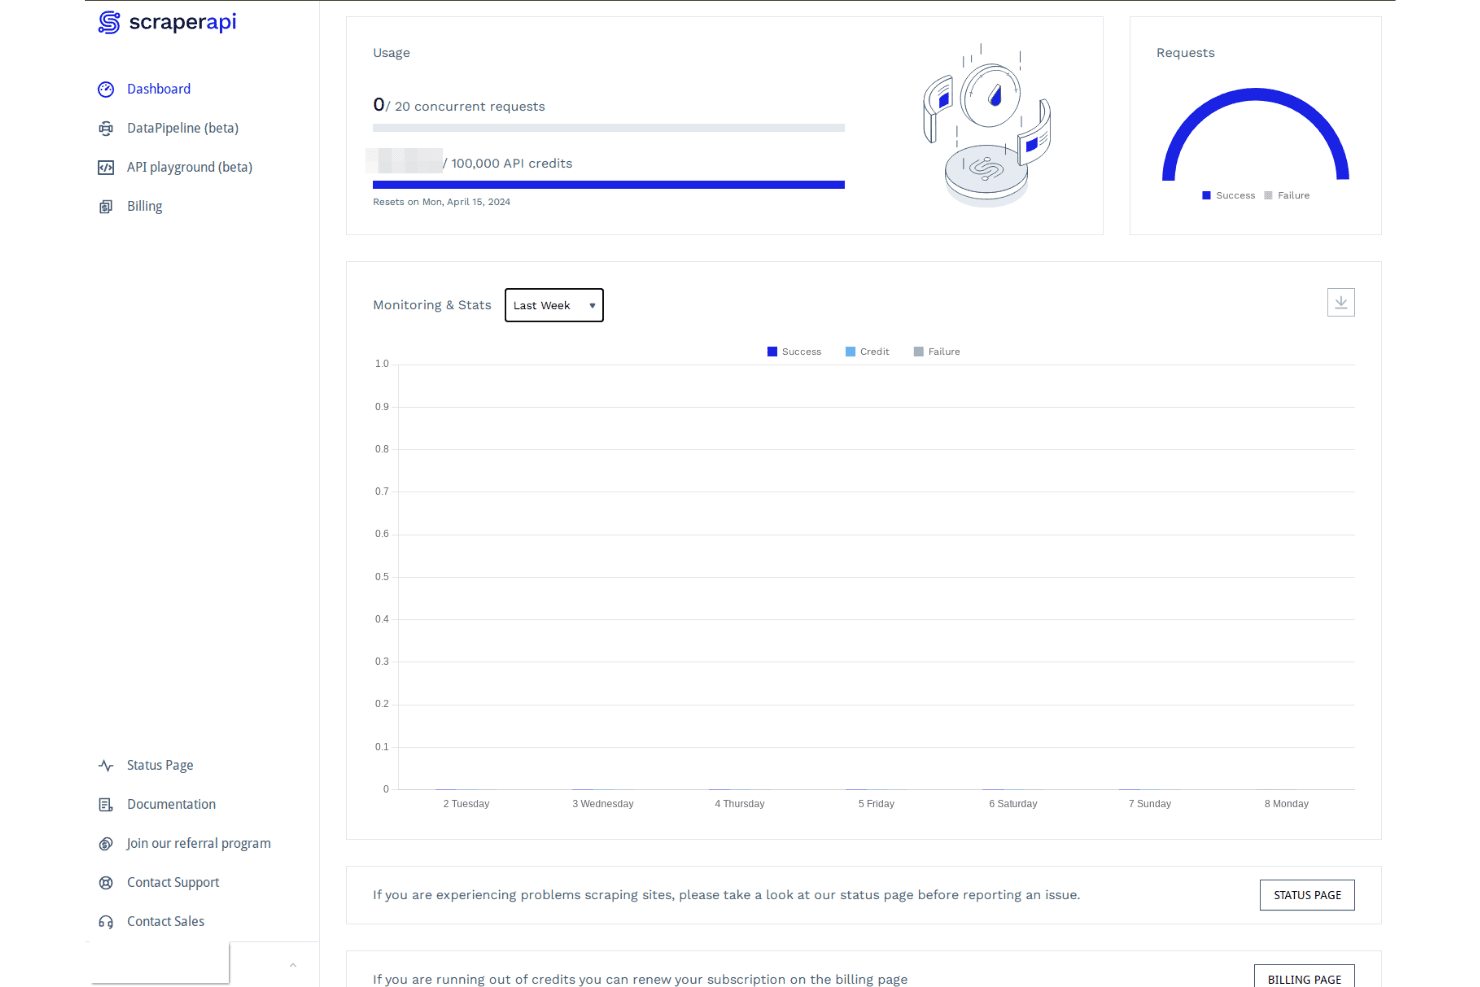
Panel ScraperAPI oferuje statystyki wykorzystania, informacje o kredytach API, liczbę jednoczesnych żądań oraz tygodniowy wykres monitorowania do śledzenia wydajności scrapowania. ScraperAPI to interfejs API do scrapowania stron internetowych, który obsługuje rotację serwerów proxy, renderowanie JavaScript, omijanie CAPTCHA oraz ekstrakcję ustrukturyzowanych danych, a także oferuje gotowe punkty końcowe dla najważniejszych platform e-commerce i wyszukiwarek.
Dla kogo ScraperAPI jest najlepszym wyborem?
ScraperAPI jest dobrym rozwiązaniem dla programistów backendu i inżynierów danych, którzy potrzebują gromadzić dane z witryn chronionych przed botami lub intensywnie wykorzystujących JavaScript na dużą skalę.
Dlaczego wybrałem ScraperAPI
ScraperAPI znalazło się na mojej krótkiej liście ze względu na sposób, w jaki zarządza serwerami proxy w tle. Gdy na dużą skalę pobieram dane o cenach produktów z Amazon lub Google Shopping, nie muszę samodzielnie konfigurować ani utrzymywać puli serwerów proxy. ScraperAPI kieruje każde żądanie przez swoją sieć ponad 40 mln serwerów proxy i automatycznie ponawia próbę w przypadku niepowodzenia. Podoba mi się również poziom serwerów proxy premium, który jest automatycznie używany w przypadku witryn chronionych przez Cloudflare lub Datadome, bez konieczności dodatkowej konfiguracji z mojej strony.
Najważniejsze funkcje ScraperAPI
- Punkty końcowe ustrukturyzowanych danych: Gotowe interfejsy API zwracają przeanalizowane dane JSON z Amazon, Google Search, Walmart i podobnych witryn dla typowych celów scrapowania.
- Trwałość sesji: Obsługuje przypięte sesje, aby w razie potrzeby zachować ten sam adres IP przy wielu żądaniach.
- Obsługa asynchronicznego scrapowania: Umożliwia asynchroniczne gromadzenie danych w celu wydajnego obsługiwania milionów jednoczesnych żądań.
- Globalna sieć serwerów proxy: Zapewnia dostęp do ponad 40 milionów adresów IP w ponad 50 krajach, umożliwiając scrapowanie z uwzględnieniem lokalizacji na dużą skalę.
Integracje ScraperAPI
ScraperAPI udostępnia SDK dla języków Python, Node.js, PHP, Ruby, Java i cURL, a także integrację z LangChain na potrzeby procesów AI. Dostępne jest API do niestandardowych integracji. Integracje natywne nie są jasno udokumentowane.
Pros and Cons
Pros:
- Opłaty naliczane wyłącznie za pomyślne żądania
- Gotowe punkty końcowe JSON dla Amazon, Google i Walmart
- Targetowanie geograficzne w ponad 50 krajach
Cons:
- Kredyty nie przechodzą na kolejne okresy rozliczeniowe
- Renderowanie JS i serwery proxy premium zwiększają koszty
Learn more about ScraperAPI:
Inne narzędzia do skrobania stron internetowych
Oto kilka dodatkowych narzędzi do skrobania stron internetowych, które nie trafiły na moją listę, ale nadal warto się z nimi zapoznać:
- 11CrawlbaseNajlepsze rozwiązanie do uzyskiwania dostępu za pośrednictwem API do globalnych źródeł danych
- 12ScrapyNajlepsze rozwiązanie do konfigurowalnych frameworków do web scrapingu w Pythonie
- 13ScrapingdogNajlepsze rozwiązanie do szybkiego wdrożenia przy minimalnej konfiguracji
Jak oceniam narzędzia do scrapingu stron internetowych
Dzielę ocenę na dwie warstwy: podstawowe funkcje, które narzędzie musi obsługiwać w rzeczywistym scrapingu — renderowanie JS, rotację proxy i zaplanowane zadania — oraz czynniki wyróżniające najlepsze opcje.
Podstawowa funkcjonalność (wymagana na tej liście)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcji) do 5 (doskonale radzi sobie w tym obszarze) dla każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Aby narzędzie mogło zostać uwzględnione na liście, musi uzyskać łączny wynik na poziomie co najmniej 65%.
- Silnik ekstrakcji danych: Oceniam, czy narzędzie obsługuje wiele metod wyboru elementów, takich jak CSS, XPath i wyrażenia regularne, lub oferuje wizualny kreator dla zespołów, które preferują konfigurację metodą wskaż i kliknij.
- Renderowanie JavaScript: Strony zbudowane w React, Vue lub Angular wymagają obsługi przeglądarek bez interfejsu graficznego. Sprawdzam, czy narzędzie zapewnia niezawodne renderowanie z możliwością konfiguracji warunków oczekiwania.
- Obsługa proxy i zabezpieczeń antybotowych: Szukam wbudowanej rotacji proxy, rozwiązywania CAPTCHA i mechanizmów omijania zabezpieczeń, takich jak Cloudflare lub DataDome, bez konieczności dodatkowej konfiguracji.
- Planowanie i automatyzacja: Cykliczne zadania scrapingu powinny działać bez nadzoru. Oceniam, czy narzędzie obsługuje planowanie w stylu cron, wyzwalacze webhooków i mechanizmy ponawiania prób po błędach.
- Eksport danych strukturalnych: Sprawdzam, jakie formaty wyjściowe są dostępne oraz czy narzędzie może bezpośrednio przesyłać dane do takich miejsc docelowych jak S3, Arkusze Google, bazy danych lub interfejsy API.
- Skalowalność i współbieżność: Duże zadania obejmujące tysiące stron wymagają równoległych żądań. Analizuję limity współbieżności oraz to, czy narzędzie obsługuje rozproszone indeksowanie.
Gdy mam już listę narzędzi spełniających kryteria, sprawdzam, co wyróżnia każdą z platform.
Czynniki wyróżniające (co odróżnia dostawców)
Oto jak porównuję ze sobą różnych dostawców:
Najważniejsze funkcje
Największe różnice między narzędziami dostrzegam w obszarze omijania zabezpieczeń antybotowych. Szukam wbudowanego rozwiązywania CAPTCHA i odcisków palca przeglądarki, które radzą sobie z zabezpieczeniami takimi jak Cloudflare lub DataDome bez konieczności pozyskiwania usług proxy od zewnętrznych dostawców. Duże znaczenie mają również szablony automatycznego wykrywania — narzędzia takie jak Bright Data i Zyte oferują gotowe scrapery dla popularnych celów, takich jak Amazon czy wyniki wyszukiwania Google, co pozwala zaoszczędzić wiele godzin ręcznej konfiguracji selektorów. Oceniam także możliwości planowania i monitorowania, w szczególności alerty o błędach i automatyczne ponawianie prób, które zapewniają ciągłość działania potoków danych, gdy docelowe witryny zmieniają układ z dnia na dzień.
Nie tylko funkcje
Modele cenowe znacznie się różnią w tej branży — niektórzy dostawcy naliczają opłaty za żądanie API, a inni za przepustowość lub liczbę pomyślnie zwróconych stron. Oceniam, czy koszty pozostają przewidywalne po zwiększeniu skali do milionów stron miesięcznie. Kolejnym kluczowym czynnikiem wyróżniającym jest infrastruktura proxy. Sprawdzam, czy narzędzie obejmuje pule proxy rezydencjalnych i centrów danych z wbudowanym kierowaniem geograficznym na poziomie miasta, ponieważ pozyskiwanie oddzielnych umów proxy zwiększa koszty i złożoność. Istotne jest również podejście do zgodności z przepisami, szczególnie w przypadku zespołów scrapujących dane w regulowanych branżach, gdzie sposób postępowania zgodny z GDPR i obsługa robots.txt muszą być jasno udokumentowane.
Jak wybrać narzędzia do skrobania stron internetowych
Łatwo zagubić się w długich listach funkcji i skomplikowanych strukturach cenowych. Aby pomóc Ci zachować koncentrację podczas przechodzenia przez unikalny proces wyboru oprogramowania, przygotowałem listę czynników, które warto wziąć pod uwagę:
| Czynnik | Co należy wziąć pod uwagę |
|---|---|
| CzynnikSkalowalność | Co należy wziąć pod uwagęCzy narzędzie poradzi sobie z oczekiwanym wzrostem ilości danych i równoległym indeksowaniem bez znacznych wzrostów kosztów lub limitów szybkości? |
| CzynnikIntegracje | Co należy wziąć pod uwagęCzy narzędzie dostarczy dane bezpośrednio do docelowych systemów (pamięci masowej w chmurze, baz danych, przepływów pracy), czy będzie wymagać ręcznych czynności? |
| CzynnikMożliwość dostosowania | Co należy wziąć pod uwagęCzy możesz dostosować logikę wyodrębniania do unikalnych struktur stron, czy jesteś ograniczony do gotowych szablonów i reguł? |
| CzynnikŁatwość obsługi | Co należy wziąć pod uwagęCzy zarówno użytkownicy techniczni, jak i nietechniczni mogą zarządzać procesami skrobania, czy do wprowadzania zmian potrzebne będzie stałe zaangażowanie programisty? |
| CzynnikWdrożenie i rozpoczęcie pracy | Co należy wziąć pod uwagęJak szybko Twój zespół może skonfigurować pierwszy potok danych i jakie wsparcie lub dokumentacja są dostępne, jeśli napotkasz problemy? |
| CzynnikKoszt | Co należy wziąć pod uwagęCzy ceny są przewidywalne wraz ze wzrostem wykorzystania? Realistycznie uwzględnij nagłe wzrosty obciążenia, logikę ponawiania prób i fałszywe wyniki dodatnie w swoim obciążeniu roboczym. |
| CzynnikZabezpieczenia | Co należy wziąć pod uwagęCzy narzędzie naraża Twoją firmę lub przepływ pracy na ryzyko związane ze zgodnością, wyciek danych lub nieuprawnione punkty dostępu? |
| CzynnikWymogi dotyczące zgodności | Co należy wziąć pod uwagęCzy podejście dostawcy jest zgodne z wewnętrznymi i regionalnymi przepisami (np. RODO, przestrzeganiem robots.txt, przetwarzaniem danych osobowych)? |
Czym są narzędzia do skrobania stron internetowych?
Narzędzia do skrobania stron internetowych to platformy programowe, które automatyzują pobieranie i wyodrębnianie uporządkowanych danych ze stron internetowych. Narzędzia te umożliwiają przechwytywanie informacji ze stron — w tym treści dynamicznych i generowanych przez JavaScript — na potrzeby analiz, raportowania lub integracji z wewnętrznymi bazami danych. Większość z nich oferuje opcje konfigurowania reguł wyodrębniania i eksportowania danych w formatach przyjaznych programistom.
Funkcje narzędzi do skrobania stron internetowych
Wybierając narzędzia do web scrapingu, zwróć uwagę na następujące kluczowe funkcje:
- Silnik ekstrakcji danych: Umożliwia zdefiniowanie sposobu zbierania treści ze stron internetowych za pomocą selektorów CSS, XPath lub interfejsów typu wskaż i kliknij, aby uzyskać uporządkowane wyniki.
- Renderowanie JavaScript: Ładuje dynamiczne aplikacje lub aplikacje jednostronicowe poprzez wykonywanie kodu JavaScript, zapewniając przechwycenie danych, które nie pojawiają się w statycznym kodzie HTML.
- Zarządzanie serwerami proxy: Rotuje adresy IP, często korzystając z usług proxy z adresami rezydencjalnymi, aby omijać blokady geograficzne, limity zapytań lub ochronę przed botami, dzięki czemu można niezawodnie skrobać witryny na dużą skalę.
- Obsługa CAPTCHA: Automatycznie wykrywa i rozwiązuje wyzwania CAPTCHA lub je omija, aby zapewnić ciągłość działania potoków danych po uruchomieniu mechanizmów antybotowych.
- Harmonogramowanie i automatyzacja: Ustawia cykliczne skrobanie lub uruchamia zadania w określonych odstępach czasu, umożliwiając działanie bez nadzoru i integrację z potokami danych.
- Eksport uporządkowanych danych: Obsługuje zapis do formatów JSON, CSV i XML lub bezpośrednie dostarczanie danych do pamięci masowej w chmurze, interfejsów API albo baz danych, eliminując konieczność ręcznej konwersji i przesyłania plików.
- Wykrywanie zmian i alerty: Monitoruje docelowe witryny pod kątem aktualizacji treści, zmian cen lub nowych ofert oraz powiadamia o różnicach względem poprzednich uruchomień.
- Kontrola współbieżności: Zarządza wieloma równoległymi żądaniami, przyspieszając sesje skrobania i obsługując zadania indeksowania na dużą skalę obejmujące tysiące stron.
- Obsługa błędów i rejestrowanie: Śledzi nieudane ekstrakcje, przerwane połączenia lub zmiany w witrynach, udostępniając szczegółowe dzienniki błędów, które ułatwiają szybkie diagnozowanie i rozwiązywanie problemów ze skrobaniem.
- Kontrola dostępu użytkowników: Ogranicza możliwość edytowania projektów, zarządzania zadaniami lub przeglądania eksportów, aby zachować bezpieczeństwo i zapobiegać przypadkowym lub nieautoryzowanym zmianom.
Typowe funkcje AI w narzędziach do web scrapingu
Oprócz wymienionych powyżej standardowych funkcji narzędzi do web scrapingu wiele z tych rozwiązań wykorzystuje sztuczną inteligencję, oferując takie funkcje jak:
- Automatyczne wykrywanie pól danych: Wykorzystuje sztuczną inteligencję do automatycznego identyfikowania i mapowania odpowiednich pól danych na złożonych lub nieznanych stronach internetowych, ograniczając konieczność ręcznego konfigurowania selektorów.
- Adaptacyjne rozpoznawanie struktury witryny: Uczy się zmian w układach witryn i dostosowuje do nich, minimalizując przestoje i konieczność konserwacji po aktualizacji projektu docelowych witryn.
- Inteligentne omijanie zabezpieczeń antybotowych: Wykorzystuje sztuczną inteligencję do naśladowania wzorców przeglądania charakterystycznych dla ludzi i dostosowywania strategii skrobania w czasie rzeczywistym, pomagając omijać zaawansowane systemy wykrywania botów.
- Parsowanie treści w języku naturalnym: Wykorzystuje sztuczną inteligencję do wyodrębniania, podsumowywania lub kategoryzowania nieustrukturyzowanego tekstu, ułatwiając analizę recenzji, artykułów lub wpisów na forach.
- Automatyczne generowanie szablonów: Tworzy wielokrotnego użytku szablony skrobania dla podobnych witryn, analizując strukturę stron i wzorce treści za pomocą uczenia maszynowego.
- Inteligentne korygowanie błędów: Wykrywa i rozwiązuje typowe błędy ekstrakcji lub anomalie za pomocą diagnostyki opartej na sztucznej inteligencji, ograniczając potrzebę ręcznego rozwiązywania problemów.
Korzyści z narzędzi do web scrapingu
Wdrożenie narzędzi do web scrapingu zapewnia zespołowi i firmie wiele korzyści. Oto kilka z nich:
- Gromadzenie danych na dużą skalę: Automatyzuje wyodrębnianie informacji z wielu witryn i stron, udostępniając duże zbiory danych do analizy lub uczenia maszynowego.
- Wgląd w rynek w czasie rzeczywistym: Umożliwia natychmiastowe monitorowanie cen konkurencji, katalogów produktów i zmian w witrynach dzięki funkcjom harmonogramowania, wykrywania zmian i alertów.
- Efektywne wykorzystanie zasobów: Umożliwia harmonogramowanie i automatyzację zadań, ograniczając pracę ręczną i pozwalając deweloperom skupić się na projektach o większej wartości.
- Stała jakość danych: Eksportuje uporządkowane dane w niezawodnych formatach, takich jak JSON lub CSV, ograniczając żmudne czyszczenie danych i pracę związaną z integracją.
- Omijanie przeszkód antybotowych: Wykorzystuje wbudowaną rotację serwerów proxy lub zewnętrzne usługi rotacyjnych serwerów proxy, a także obsługę CAPTCHA i omijanie zabezpieczeń antybotowych, aby uzyskiwać dostęp do treści, do których inne rozwiązania nie mogą dotrzeć.
- Dostosowanie do zmian w witrynach: Wykorzystuje inteligentną obsługę błędów oraz, w przypadku narzędzi obsługujących sztuczną inteligencję, automatyczne dostosowywanie ekstrakcji po zmianie układów lub struktur witryn.
- Bezpieczny dostęp i zgodność z przepisami: Chroni potoki danych za pomocą uprawnień użytkowników, rejestrowania audytowego oraz zgodności z wymogami lub przepisami dotyczącymi prywatności.
Koszty i ceny narzędzi do web scrapingu
Wybór narzędzi do skrobania stron internetowych wymaga zrozumienia różnych dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i innych czynników. Poniższa tabela przedstawia najpopularniejsze plany, ich średnie ceny oraz typowe funkcje zawarte w rozwiązaniach do skrobania stron internetowych:
Tabela porównawcza planów narzędzi do skrobania stron internetowych
| Typ planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Typ planuPlan bezpłatny | Średnia cena$0-$10/miesiąc | Typowe funkcjeOgraniczona liczba uruchomień ekstrakcji, podstawowe harmonogramy, pomoc społeczności oraz podstawowe formaty eksportu danych. |
| Typ planuPlan osobisty | Średnia cena$15-$40/miesiąc | Typowe funkcjeWięcej kredytów na ekstrakcję, renderowanie JavaScript, dostęp do API oraz podstawowa obsługa błędów. |
| Typ planuPlan biznesowy | Średnia cena$55-$150/miesiąc | Typowe funkcjeWiększa współbieżność, rotacja serwerów proxy, zaawansowane harmonogramy, narzędzia do współpracy zespołowej oraz priorytetowa pomoc techniczna. |
| Typ planuPlan dla przedsiębiorstw | Średnia cena$250+/miesiąc | Typowe funkcjeNiestandardowe integracje, gwarancje SLA, serwery proxy kierowane geograficznie, zarządzane wdrożenie oraz dedykowana obsługa klienta. |
Najczęściej zadawane pytania dotyczące narzędzi do skrobania stron internetowych
Oto odpowiedzi na często zadawane pytania dotyczące narzędzi do skrobania stron internetowych:
Czy do korzystania z narzędzi do skrobania stron internetowych potrzebne są umiejętności programistyczne?
Nie, znajomość programowania nie jest konieczna. Wiele narzędzi wizualnych oferuje rozwiązanie niewymagające kodowania, takie jak rozszerzenie Chrome obsługiwane metodą wskaż i kliknij, które pozwala użytkownikom nietechnicznym wizualnie tworzyć procedury ekstrakcji oraz przeglądać mapę witryny w celu gromadzenia rekordów do zadań takich jak generowanie potencjalnych klientów.
Jednak niestandardowa logika, złożone potoki danych lub skrobanie na dużą skalę zazwyczaj opierają się na narzędziach programistycznych:
- Python: Tradycyjna biblioteka Python, taka jak BeautifulSoup, doskonale nadaje się do przejrzystego analizowania statycznych dokumentów HTML.
- JavaScript: Specjalistyczna biblioteka Node.js, taka jak Puppeteer lub Playwright, pozwala programistom programowo wchodzić w interakcje z dynamicznymi elementami stron internetowych.
Czy narzędzia do skrobania stron internetowych obsługują dynamiczne witryny intensywnie wykorzystujące JavaScript?
Tak, większość nowoczesnych narzędzi udostępnia silniki renderowania JavaScript umożliwiające skrobanie dynamicznej zawartości z aplikacji jednostronicowych (SPA) i interaktywnych witryn.
Jak narzędzia do skrobania stron internetowych radzą sobie ze środkami ochrony witryn przed botami?
Aby pokonać zabezpieczenia przed botami, zaawansowane narzędzia stosują kilka strategii omijania zabezpieczeń:
- Rotacyjne serwery proxy: Rozdzielanie żądań między rozległe pule adresów IP (z centrów danych i mieszkaniowych) w celu uniknięcia limitów szybkości lub blokad adresów IP.
- Automatyczne rozwiązywanie CAPTCHA: Rozwiązywanie lub omijanie wyzwań wizualnych i behawioralnych.
- Maskowanie odcisku palca przeglądarki: Modyfikowanie nagłówków przeglądarki, śladów kanwy i agentów użytkownika w silnikach takich jak WebKit lub Chromium w celu naśladowania interakcji człowieka w głównych przeglądarkach, takich jak Firefox lub Chrome.
Czy skrobanie stron internetowych jest legalne?
Legalność skrobania stron internetowych zależy od tego, jakie dane zbierasz, jak ich używasz oraz jakie są warunki korzystania z witryny. Przed rozpoczęciem zawsze zapoznaj się z wytycznymi prawnymi i wymogami dotyczącymi zgodności.
Jak otrzymywać i przechowywać zeskanowane dane?
Zazwyczaj można eksportować dane do formatów takich jak CSV, JSON i Excel lub przesyłać je bezpośrednio do pamięci w chmurze, elementów webhook albo baz danych, w zależności od opcji integracji danego narzędzia.