

Monitorowanie sieci za pomocą kompleksowej platformy monitorującej może być trudne, zwłaszcza gdy obecnie używane narzędzia nie spełniają wszystkich potrzeb. Możliwe, że korzystasz z PRTG i stwierdzasz, że nie odpowiada on konkretnym wymaganiom Twojego zespołu lub nie oferuje niektórych potrzebnych funkcji.
Z mojego doświadczenia wynika, że znalezienie odpowiedniego rozwiązania do monitorowania sieci może znacznie zmniejszyć obciążenie pracą, ograniczyć przestoje i poprawić ogólną wydajność. Dlatego przeanalizowałem i przetestowałem różne alternatywy dla PRTG, aby pomóc Ci znaleźć rozwiązanie najlepiej dopasowane do Twojej firmy.
W tym artykule znajdziesz bezstronne recenzje najlepszych alternatyw, koncentrujące się na ich unikalnych funkcjach i zaletach. Niezależnie od tego, czy szukasz lepszej skalowalności, zgodności z wymaganiami konkretnej branży czy wygodniejszej obsługi, przedstawię Ci dostępne opcje. Znajdźmy oprogramowanie do monitorowania sieci, które najlepiej wesprze Twój zespół.
Czym jest PRTG?
Paessler Router Traffic Grapher (PRTG), często określany jako PRTG Network Monitor, to narzędzie do monitorowania zaprojektowane z myślą o śledzeniu stanu i wydajności sieci. Specjaliści ds. monitorowania IT i administratorzy sieci zazwyczaj korzystają z PRTG ze względu na możliwość uzyskiwania szczegółowych informacji o ruchu sieciowym i dostępności systemu. Funkcje takie jak monitorowanie w czasie rzeczywistym, konfigurowalne alerty i szczegółowe raportowanie wspierają potrzebę sprawnego zarządzania siecią. PRTG może dostarczać cennych informacji, które pomagają w płynnym działaniu systemów, ale istnieją również alternatywy.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza alternatyw dla PRTG
W tej tabeli porównawczej podsumowano szczegóły cenowe wybranych przeze mnie najlepszych alternatyw dla PRTG:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Najlepsze rozwiązanie do szczegółowego raportowania SLA | 4.0 out of 5 | 4 | 4 | 4 | 4 | 4 | 4 | $1,400/rok Dostępny bezpłatny plan + 60-dniowy bezpłatny okres próbny | Website |
Najlepsze do zdalnego zarządzania IT | 2.7 out of 5 | 3 | 4 | 2 | 2 | 2 | 3 | Cena na żądanie Dostępne bezpłatne demo | Website |
Najlepszy wybór pod względem skalowalności rozwiązania o otwartym kodzie źródłowym | 4.2 out of 5 | 4 | 5 | 4 | 4 | 4 | 4 | Od 325 USD/miesiąc Bezpłatny plan + 5-dniowy bezpłatny okres próbny + dostępna bezpłatna wersja demonstracyjna | Website |
Najlepszy do obserwowalności opartej na chmurze | 3.5 out of 5 | 4 | 4 | 3 | 3 | 3 | 4 | Od 0,60 USD/miesiąc Bezpłatny plan + 14-dniowy bezpłatny okres próbny + dostępna bezpłatna wersja demonstracyjna | Website |
Najlepsze rozwiązanie do dostosowywanych pulpitów nawigacyjnych | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | Od 2 595 $ jednorazowo Bezpłatny plan + 30-dniowy okres próbny + dostępne demo | Website |
Najlepszy wybór pod kątem widoczności trasy internetowej | 3.2 out of 5 | 4 | 3 | 2 | 3 | 3 | 4 | Cena na zapytanie 15-dniowy bezpłatny okres próbny + dostępna wersja demonstracyjna | Website |
Najlepszy do ujednoliconego zarządzania punktami końcowymi | 3.3 out of 5 | 4 | 4 | 4 | 3 | 2 | 3 | $3.75/miesiąc 14-dniowy bezpłatny okres próbny + dostępne bezpłatne demo | Website |
Najlepszy do automatycznego wykrywania sieci | 3.3 out of 5 | 4 | 4 | 4 | 3 | 3 | 2 | Ceny na zapytanie Bezpłatny plan + dostępne bezpłatne demo | Website |
Najlepsze do syntetycznego monitorowania sieci | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $249/miesiąc Bezpłatny plan + 14-dniowy okres próbny + bezpłatne demo | Website |
Najlepszy do automatycznego mapowania sieci | 3.8 out of 5 | 4 | 4 | 5 | 4 | 4 | 2 | Ceny dostępne na żądanie 14-dniowy bezpłatny okres próbny + dostępne demo | Website |


Recenzje najlepszych alternatyw dla PRTG
Poniżej znajdziesz moje szczegółowe podsumowania najlepszych alternatyw dla PRTG, które trafiły na moją listę. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety i wady, integracje oraz idealne zastosowania każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Najlepsze rozwiązanie do szczegółowego raportowania SLA
- Dostępny bezpłatny plan + 60-dniowy bezpłatny okres próbny
- Od $1,400/rok (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.7/5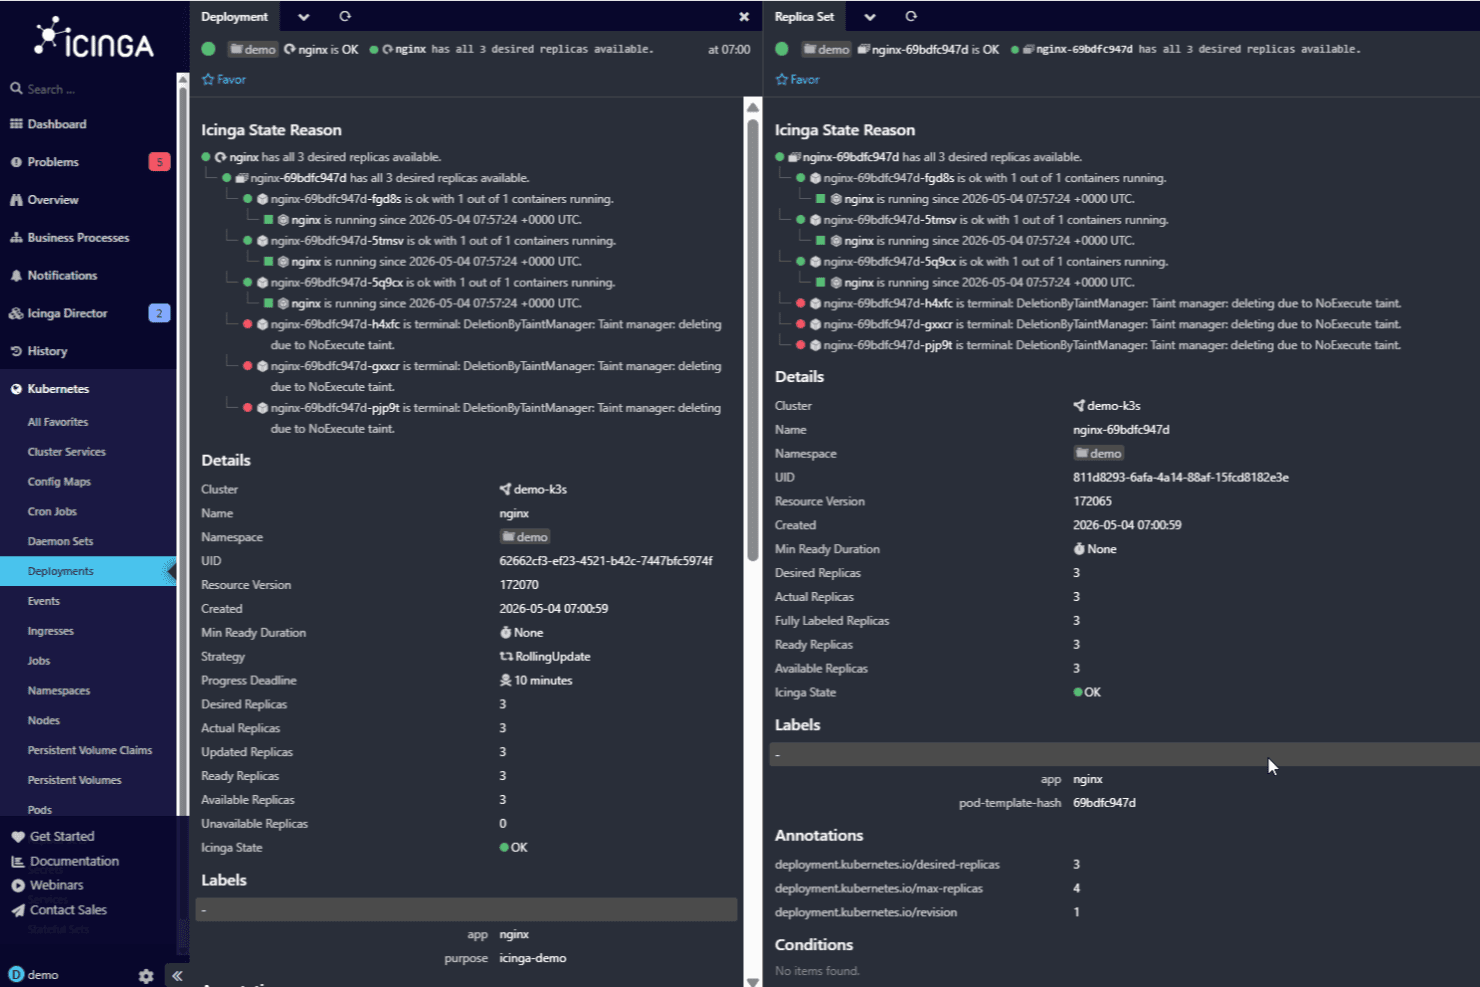
Icinga śledzi wszystkie wdrożenia na jednym pulpicie za pomocą etykiet, szczegółów i adnotacji. Icinga to platforma monitorowania infrastruktury typu otwartego oprogramowania, która jest atrakcyjna dla inżynierów systemowych, administratorów sieci i dostawców usług zarządzanych (MSP), którzy potrzebują monitorowania nieograniczonej liczby hostów, elastycznych metod sprawdzania oraz szczegółowego raportowania SLA bez ograniczeń licencyjnych naliczanych za każdy czujnik.
Dla kogo Icinga jest najlepszym wyborem?
Icinga doskonale sprawdza się w przypadku inżynierów systemowych i techników MSP, którzy muszą monitorować dużą, rozproszoną infrastrukturę bez ograniczania się kosztami licencji naliczanymi za każdy host.
Dlaczego wybrałem Icinga
Wybrałem Icinga jako jedno z najlepszych rozwiązań, ponieważ raportowanie SLA sięga w nim głębiej niż w większości narzędzi monitorujących, z którymi pracowałem. Icinga DB przechowuje oddzielne tabele historii SLA, które zachowują dokładnie dane niezbędne do obliczania dostępności, a historia nie jest domyślnie usuwana. Można generować raporty dostępności hostów i usług, wyświetlać ich podgląd w Icinga Web, eksportować je jako pliki PDF oraz planować ich automatyczne wysyłanie w regularnych odstępach czasu.
Najważniejsze funkcje Icinga
- Rozproszona architektura nadrzędny/satelita/agent: Umożliwia wdrażanie monitorowania w wielu lokalizacjach za pomocą węzłów nadrzędnych i podrzędnych, które nadal wykonują sprawdzenia i gromadzą dane podczas awarii sieci.
- Bezpłatna edycja na zawsze z nieograniczoną liczbą hostów: Monitoruje nieograniczoną liczbę hostów i usług bez żadnych kosztów, bez ograniczeń licencyjnych naliczanych za czujnik lub urządzenie.
- Zarządzanie konfiguracją sterowane przez API: Wykorzystuje interfejs REST API do dynamicznego tworzenia, modyfikowania i usuwania hostów, usług oraz obiektów konfiguracyjnych, z obsługą konfiguracji wersjonowanych i wycofywania zmian.
- Obsługa sprawdzania za pomocą wielu protokołów: Monitoruje urządzenia i usługi za pośrednictwem SNMP, SSH, ICMP, sprawdzeń opartych na agentach, NSClient++ oraz pasywnych wyników przesyłanych przez REST API.
Integracje Icinga
Icinga ma udokumentowane integracje z Grafaną, Elasticsearch, NetBox, Graphite, InfluxDB, Prometheus, Ansible, Puppet i Terraform. Jej REST API obsługuje niestandardowe integracje, automatyzację konfiguracji, strumienie zdarzeń oraz połączenia z procesami obsługi zgłoszeń.
Pros and Cons
Pros:
- Szczegółowe raporty dostępności SLA
- Rozproszone sprawdzenia są kontynuowane podczas awarii
- Niestandardowe sprawdzenia obejmują zróżnicowaną infrastrukturę
Cons:
- Konfiguracja wymaga znacznego nakładu pracy ręcznej
- Analiza trendów długoterminowych wymaga oddzielnych narzędzi
Learn more about Icinga: Najlepsze do zdalnego zarządzania IT
- Dostępne bezpłatne demo
- Cena na żądanie
Visit WebsiteCustomer Rating:4.7/5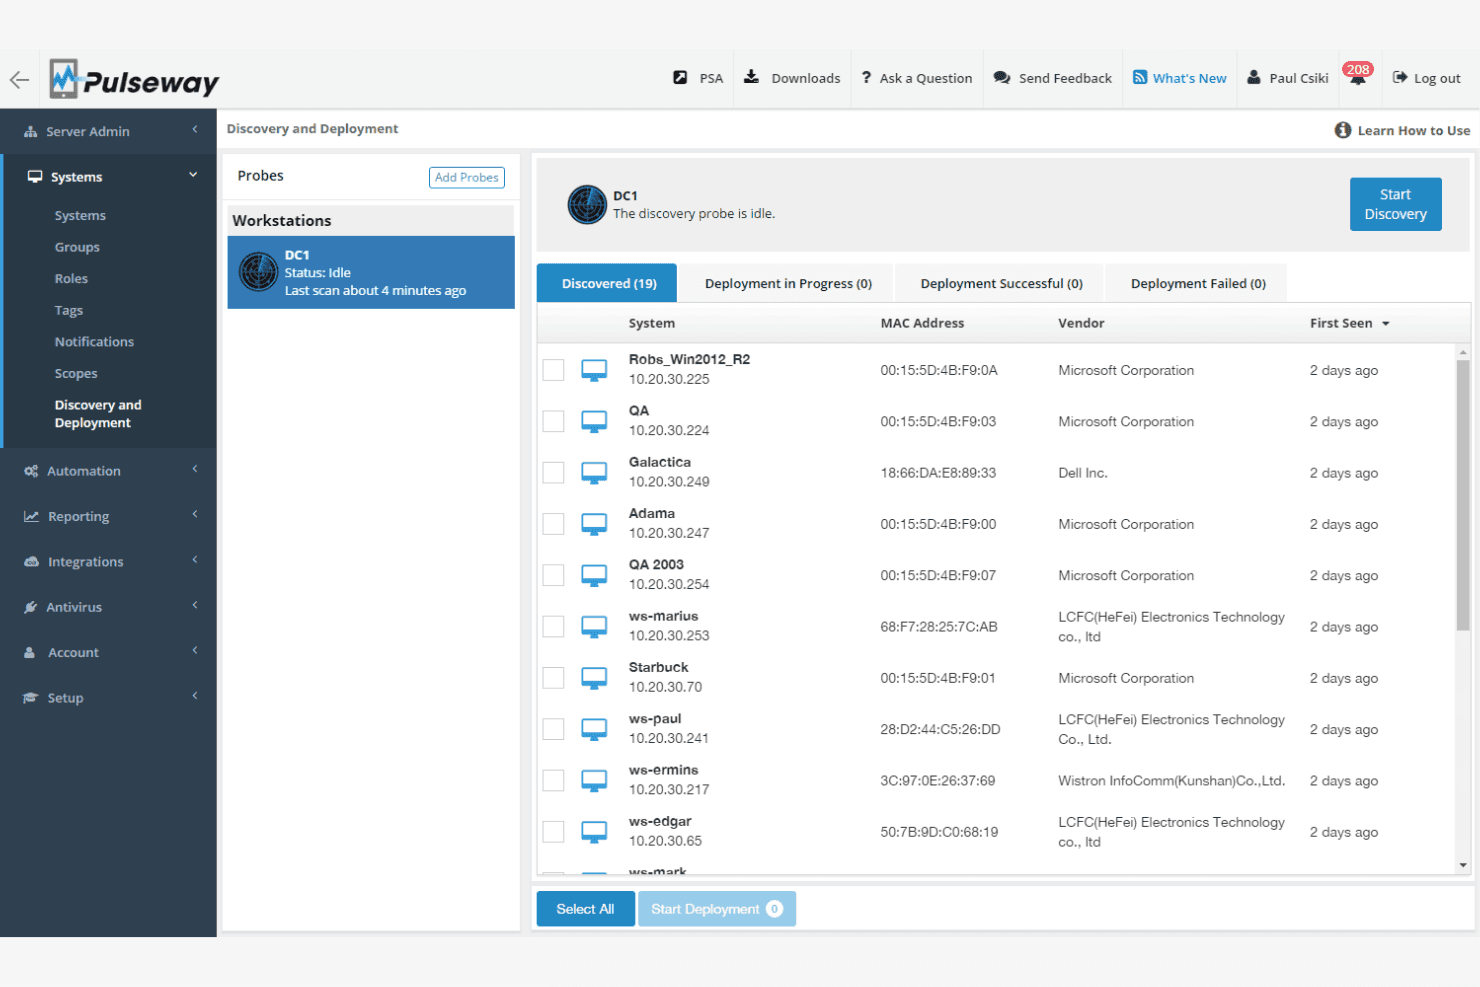
Ekran wykrywania i wdrażania w Pulseway wyszukuje urządzenia w sieci i śledzi ich stan wdrożenia. Pulseway to platforma RMM stworzona dla dostawców usług zarządzanych (MSP) i zespołów IT, które potrzebują monitorować, zarządzać i rozwiązywać problemy z punktami końcowymi, serwerami oraz urządzeniami sieciowymi — ze szczególnym naciskiem na zdalny dostęp z urządzeń mobilnych i reagowanie na alerty.
Dla kogo Pulseway jest najlepszym rozwiązaniem?
Pulseway dobrze sprawdza się w przypadku techników MSP, którzy muszą zdalnie monitorować punkty końcowe klientów i zarządzać nimi, zwłaszcza za pomocą urządzenia mobilnego.
Dlaczego wybrałem Pulseway
Wybrałem Pulseway jako jedno z najlepszych rozwiązań, ponieważ jego zdalne zarządzanie z priorytetem dla urządzeń mobilnych wyróżnia je na tle narzędzi takich jak PRTG, które uzależniają użytkownika od konsoli na komputerze. Mogę zareagować na krytyczny alert serwera, uruchomić skrypt naprawczy i ponownie uruchomić usługę bezpośrednio z telefonu, zanim ktokolwiek zauważy awarię. Alerty warunkowe oparte na SNMP integrują się z przepływami automatyzacji, więc reakcja nie ogranicza się do powiadomienia — naprawa jest już w toku.
Najważniejsze funkcje Pulseway
- Mapy topologii sieci: Automatycznie generuje konfigurowalne mapy topologii z możliwością edycji typów urządzeń, grup logicznych i zależności sieciowych.
- Zarządzanie poprawkami: Automatyzuje instalowanie poprawek systemu operacyjnego i aplikacji innych firm w systemach Windows, Mac i Linux, korzystając z konfigurowalnych zasad i harmonogramów.
- Nagrywanie sesji zdalnego sterowania: Ręcznie lub automatycznie nagrywa sesje zdalnego sterowania dla agentów systemu Windows, obejmując zarówno sesje współdzielone, jak i prywatne.
- Przepływy automatyzacji wyzwalane alertami: Uruchamia skrypty i przepływy pracy w odpowiedzi na alerty, aby automatycznie rozwiązywać problemy IT bez ręcznej ingerencji.
Integracje Pulseway
Pulseway oferuje natywne integracje z PagerDuty, Slack, ConnectWise Manage, Autotask, Zendesk i IT Glue. Udostępnia również interfejsy API REST, klienta i chmurowy oraz wtyczki umożliwiające niestandardową łączność.
Pros and Cons
Pros:
- Alerty mobilne umożliwiają szybką zdalną reakcję
- Skrypty wyzwalane alertami ograniczają powtarzalne rozwiązywanie problemów
- Mapy topologii ułatwiają zrozumienie zależności między wykrytymi urządzeniami
Cons:
- Konfiguracja SNMP może być trudna
- Raporty oferują ograniczone możliwości dostosowywania i niewielką głębię
Learn more about Pulseway: Najlepszy wybór pod względem skalowalności rozwiązania o otwartym kodzie źródłowym
- Bezpłatny plan + 5-dniowy bezpłatny okres próbny + dostępna bezpłatna wersja demonstracyjna
- Od 325 USD/miesiąc (rozliczenie roczne)
Visit WebsiteCustomer Rating:4.5/5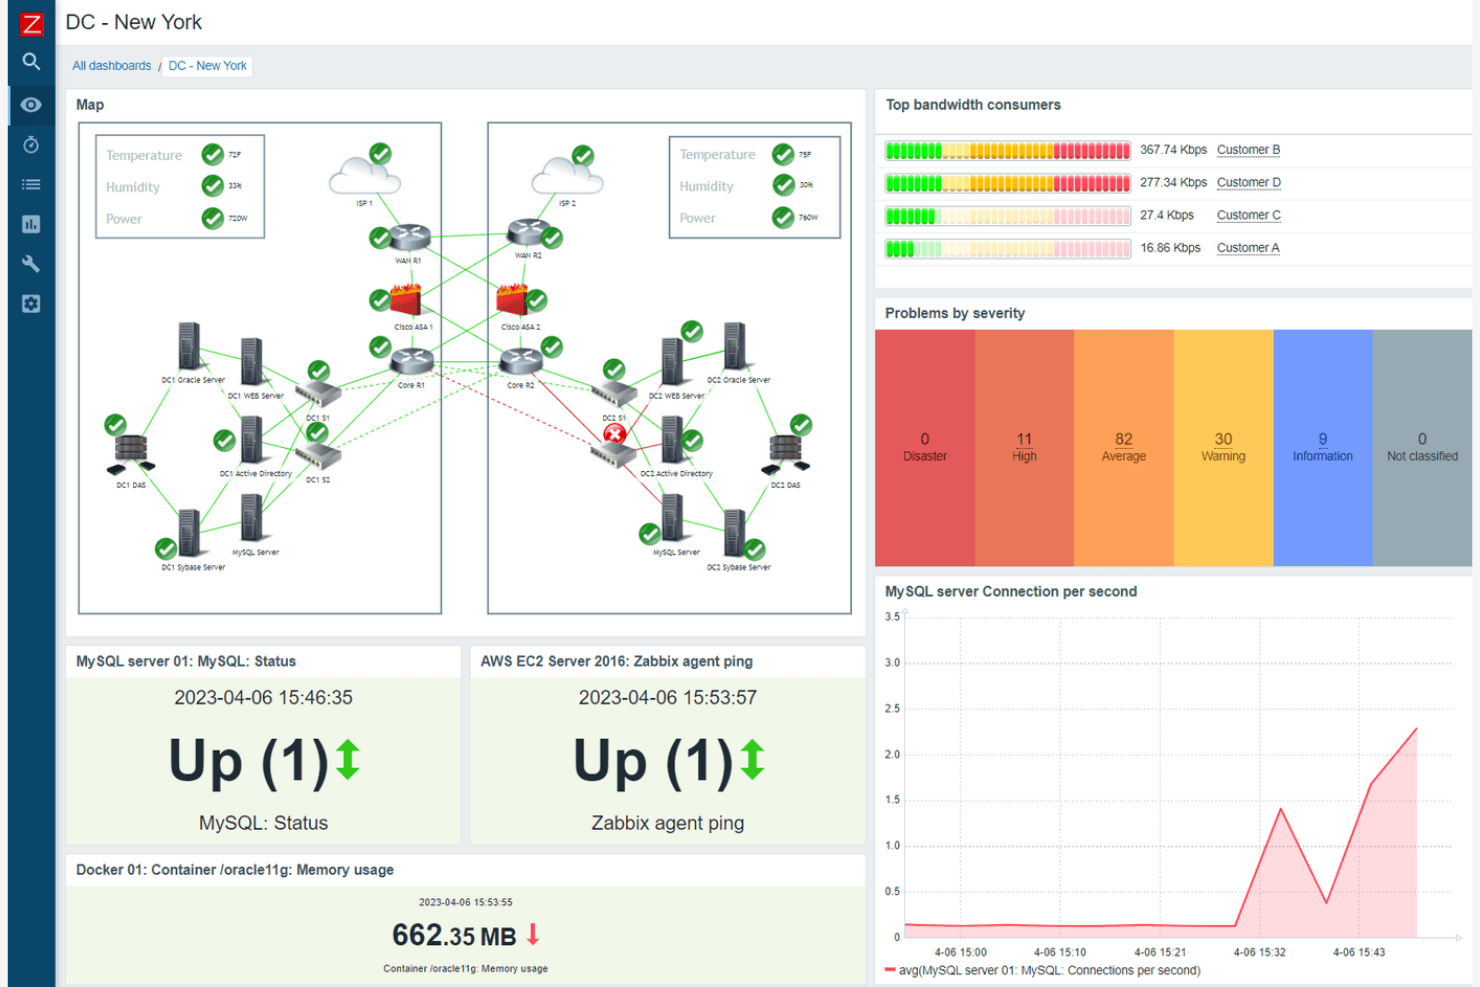
Panel Zabbix wyświetlający mapę sieci centrum danych, wykorzystanie przepustowości i problemy według ważności. Zabbix to platforma monitorowania o otwartym kodzie źródłowym, która pozwala zespołom infrastruktury i operacji śledzić serwery, urządzenia sieciowe, zasoby chmurowe i aplikacje bez płacenia za każdy czujnik lub urządzenie.
Dla kogo Zabbix jest najlepszym wyborem?
Zabbix doskonale sprawdza się w przypadku zespołów infrastruktury i operacji, które muszą monitorować duże, złożone środowiska bez kosztów licencjonowania naliczanych za każde urządzenie lub czujnik.
Dlaczego wybrałem Zabbix
Zabbix znalazł się na mojej krótkiej liście, ponieważ jest jedną z niewielu platform monitorowania, które rzeczywiście skalują się do milionów metryk bez naliczania opłat za urządzenie lub czujnik. Doceniam to, że jego architektura oparta na serwerach proxy pozwala rozdzielić zbieranie danych między zdalne lokalizacje, strefy DMZ i zapory sieciowe, dzięki czemu pojedynczy serwer Zabbix może realistycznie obsługiwać rozległą infrastrukturę obejmującą wiele lokalizacji. Licencja o otwartym kodzie źródłowym oznacza, że wraz z rozwojem środowiska nie czeka na Ciebie ukryty limit czujników w stylu PRTG.
Najważniejsze funkcje Zabbix
- Bezagentowe monitorowanie wielu protokołów: Monitoruj urządzenia sieciowe, serwery i usługi za pomocą SNMP, IPMI, SSH/Telnet, ICMP/TCP, Prometheus, Modbus i MQTT bez wdrażania agenta.
- Procedury eskalacji: Konfiguruj wieloetapowe eskalacje alertów z opóźnieniami, powtarzanymi powiadomieniami, kierowaniem do grup użytkowników i automatycznym wykonywaniem zdalnych poleceń.
- Drzewa usług biznesowych: Definiuj hierarchie usług, obliczaj stan usług za pomocą konfigurowalnych algorytmów i mierz dostępność względem celów SLA.
- Interfejs API JSON-RPC: Uzyskuj dostęp do ponad 200 metod API, aby automatyzować konfigurację, pobierać dane historyczne i integrować narzędzia innych firm z Zabbix.
Integracje Zabbix
Zabbix oferuje wbudowane integracje z ServiceNow, Jira ServiceDesk, Slack, Microsoft Teams, PagerDuty, AWS, Microsoft Azure, Google Cloud, Kubernetes i VMware. Jego interfejs API JSON-RPC udostępnia ponad 200 metod na potrzeby niestandardowych integracji, a także przesyłanie strumieniowe do Kafka, RabbitMQ, Amazon SQS i Amazon Kinesis.
Pros and Cons
Pros:
- Odpytywanie oparte na serwerach proxy buforuje dane zdalnych lokalizacji
- Monitorowanie bezagentowe i agentowe obejmuje różnorodne systemy
- Brak górnego limitu licencji zależnego od liczby czujników
Cons:
- Początkowa konfiguracja hostów i wyzwalaczy wymaga pracy
- Progi alertów wymagają dostrojenia w celu ograniczenia liczby niepotrzebnych powiadomień
 Najlepszy do obserwowalności opartej na chmurze
- Bezpłatny plan + 14-dniowy bezpłatny okres próbny + dostępna bezpłatna wersja demonstracyjna
- Od 0,60 USD/miesiąc (przy rozliczeniu rocznym)
Visit WebsiteCustomer Rating:4.5/5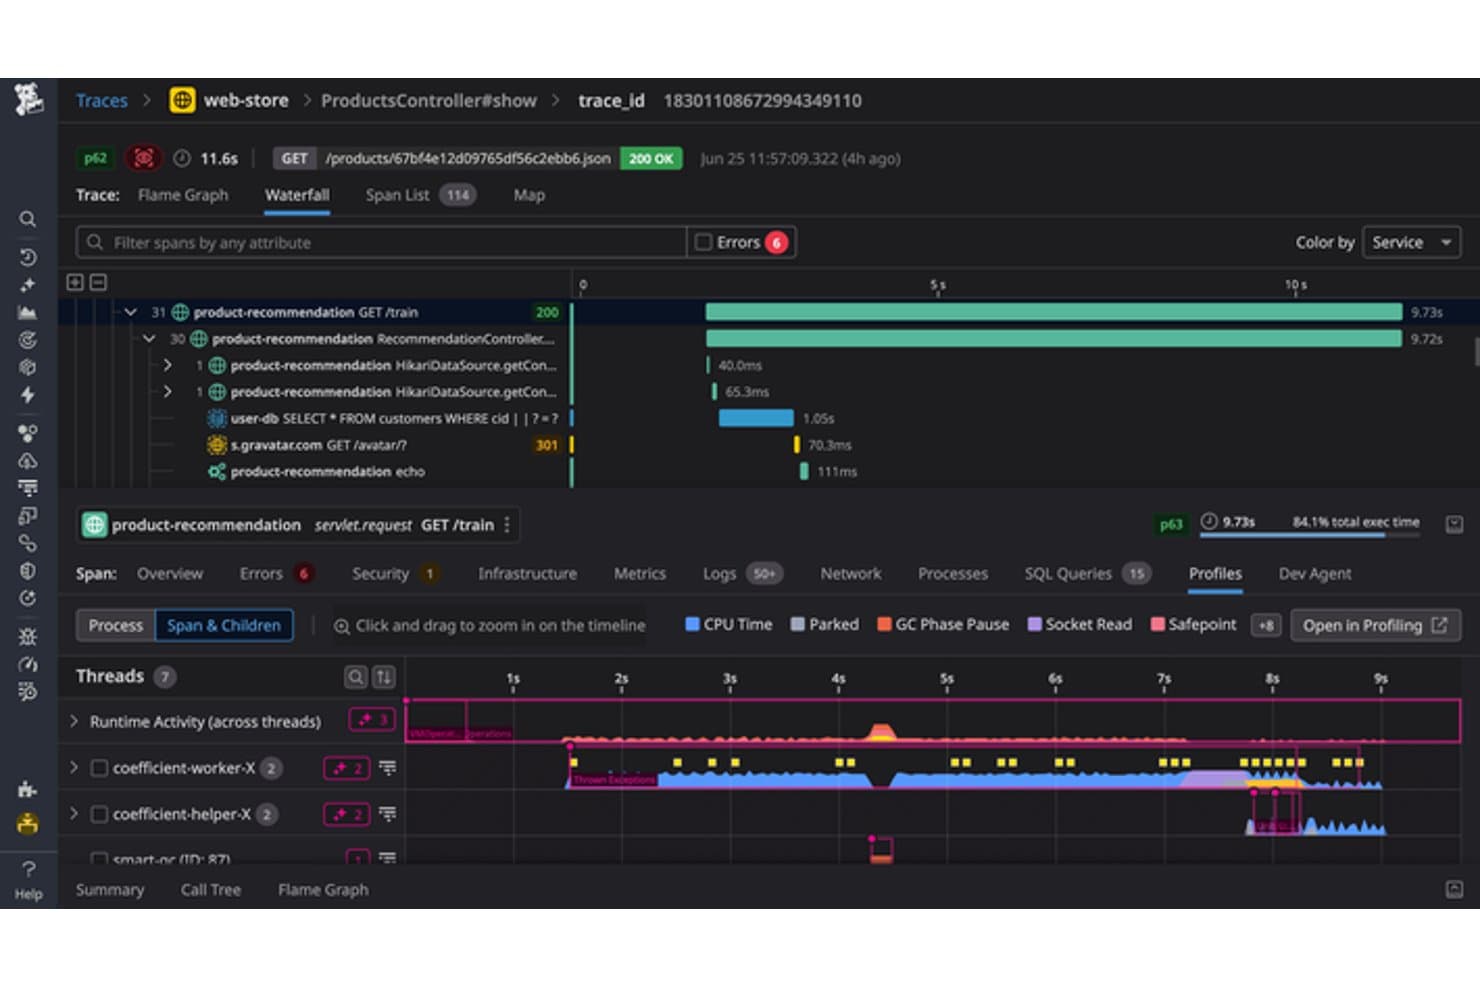
Śledzenie APM Datadog w formie kaskadowej wraz z widokiem profilowania dla żądania usługi rekomendacji produktów. Datadog to natywna dla chmury platforma monitorowania, która ujednolica widoczność sieci, infrastruktury i aplikacji w środowiskach wielochmurowych i hybrydowych — dzięki czemu doskonale sprawdza się w zespołach operacji IT, które potrzebują skorelowanych informacji z różnych warstw bez zarządzania wieloma narzędziami.
Dla kogo Datadog jest najlepszym wyborem?
Datadog jest odpowiedni dla zespołów operacji IT zarządzających środowiskami wielochmurowymi i hybrydowymi, które potrzebują danych dotyczących sieci, infrastruktury i aplikacji w jednym miejscu.
Dlaczego wybrałem Datadog
Wybrałem Datadog jako jedną z najlepszych alternatyw dla PRTG, ponieważ zapewnia natywną dla chmury obserwowalność w monitorowaniu sieci w sposób, którego tradycyjne narzędzia NMS po prostu nie oferują. Szczególnie podoba mi się to, że monitorowanie sieci w chmurze koreluje ruch między mikrousługami, punktami końcowymi w chmurze i infrastrukturą lokalną w jednym widoku, dzięki czemu mój zespół może przejść od anomalii sieciowej do aplikacji lub hosta, który za nią odpowiada, bez przełączania narzędzi. Ścieżka sieciowa zapewnia widoczność opóźnień i utraty pakietów dla każdego przeskoku między sieciami VPC, WAN i dostawcami SaaS, co sprawia, że śledzenie pogorszonych ścieżek w środowiskach hybrydowych jest naprawdę praktyczne.
Najważniejsze funkcje Datadog
- Monitorowanie urządzeń sieciowych: Wykrywa urządzenia fizyczne i wirtualne za pośrednictwem SNMP (v1–v3), pułapek, NetFlow i syslog, automatycznie generując pulpity nawigacyjne urządzeń i interfejsów.
- Mapa topologii urządzeń: Automatycznie przedstawia wizualnie fizyczne połączenia sieciowe oraz zależności nadrzędne i podrzędne w całym spisie urządzeń.
- Monitorowanie NetFlow: Gromadzi dane NetFlow v5/v9, IPFIX, sFlow i jFlow, aby identyfikować najaktywniejszych użytkowników ruchu, protokoły oraz trendy wykorzystania przepustowości.
- Zarządzanie kontami wielu organizacji: Oddziela dane klientów w izolowanych organizacjach podrzędnych, zapewniając widoczność wykorzystania na poziomie organizacji nadrzędnej oraz programową konfigurację za pośrednictwem API lub Terraform.
Integracje Datadog
Datadog wymienia ponad 1000 wbudowanych integracji dostępnych na całej platformie, w tym Arista, Aruba, Cisco, Cisco Meraki, F5 i Juniper. Oferuje również integrację z platformą Marketplace PRTG, wzbogacanie danych CMDB ServiceNow oraz interfejs HTTP REST API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Koreluje problemy dotyczące sieci, infrastruktury i aplikacji
- Mapuje opóźnienia i utratę pakietów dla każdego przeskoku
- Pulpity nawigacyjne pomagają zespołom wykrywać problemy ze stanem systemu
Cons:
- Konfiguracja SNMP może wymagać dużego nakładu pracy
- Okres przechowywania danych sieciowych jest krótszy niż w dedykowanych narzędziach NMS
 Najlepsze rozwiązanie do dostosowywanych pulpitów nawigacyjnych
- Bezpłatny plan + 30-dniowy okres próbny + dostępne demo
- Od 2 595 $ jednorazowo
Visit WebsiteCustomer Rating:4.6/5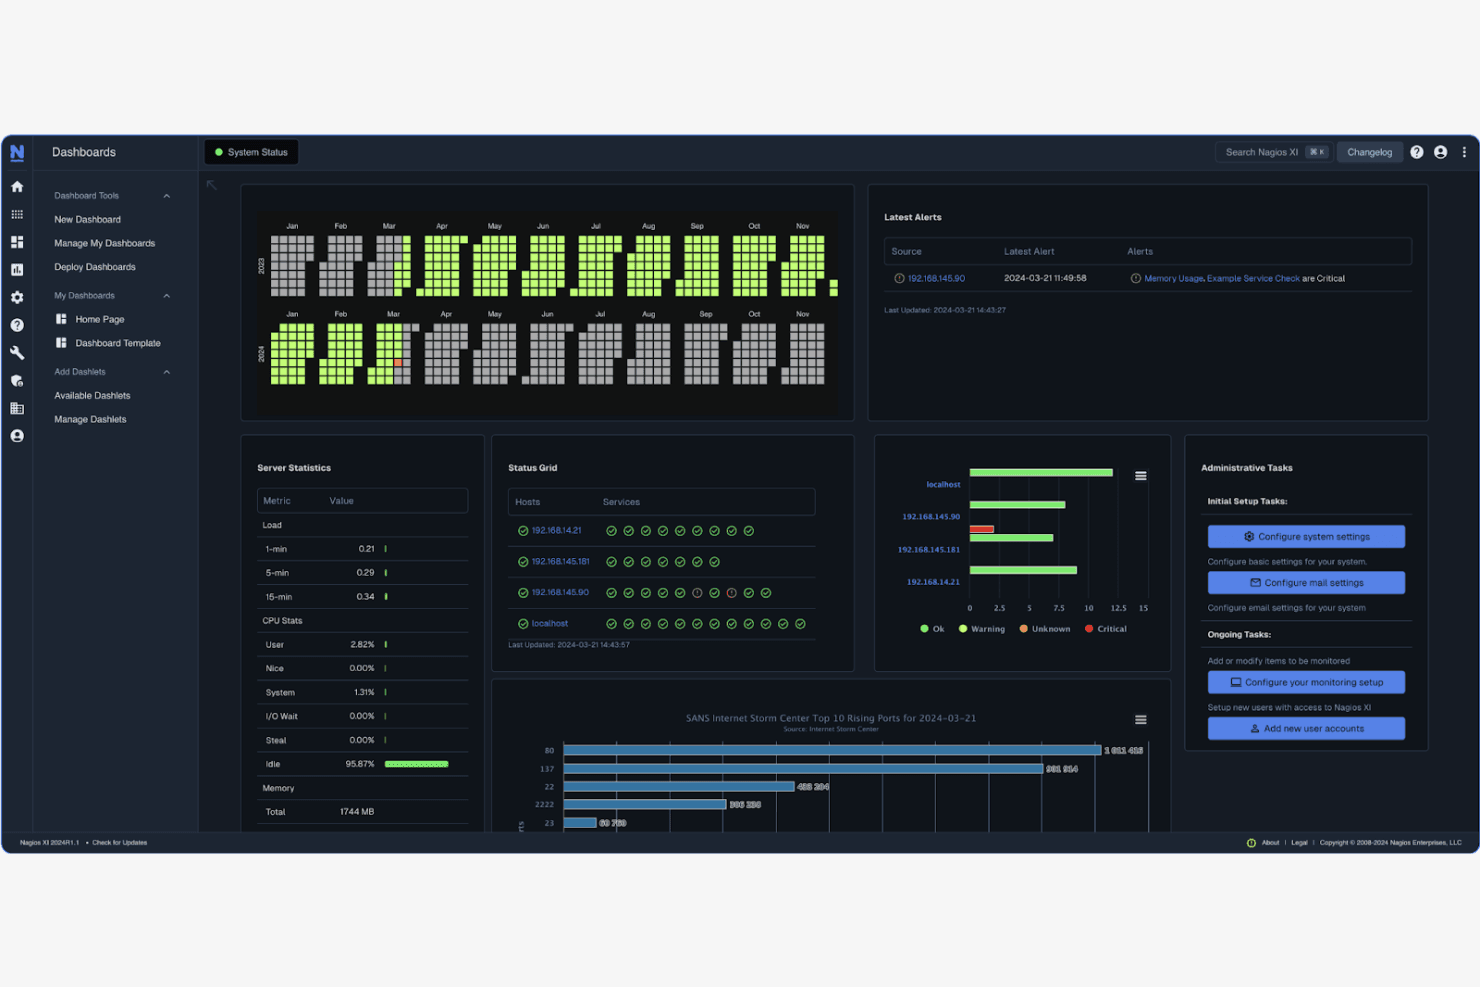
Pulpit nawigacyjny Nagios XI podsumowujący alerty, stan hostów i usług, statystyki serwera oraz zadania administracyjne. Nagios XI to samodzielnie hostowana platforma do monitorowania infrastruktury, stworzona dla administratorów sieci i zespołów operacyjnych IT, którzy potrzebują szczegółowej kontroli nad monitorowaniem serwerów, urządzeń sieciowych i aplikacji — bez ograniczeń cenowych naliczanych za każdy czujnik, które występują w przypadku PRTG.
Dla kogo Nagios XI jest najlepszym wyborem?
Nagios XI jest dobrym rozwiązaniem dla administratorów sieci i inżynierów systemowych, którzy potrzebują szczegółowej kontroli nad samodzielnie hostowanym środowiskiem monitorowania bez ograniczeń licencyjnych opartych na liczbie czujników.
Dlaczego wybrałem Nagios XI
Wybrałem Nagios XI jako jedno z najlepszych rozwiązań, ponieważ jego możliwości dostosowywania pulpitów nawigacyjnych sięgają dalej niż w przypadku większości samodzielnie hostowanych alternatyw. Każdy użytkownik tworzy własny widok taktyczny z daskletów obejmujących wykresy, podsumowania stanu, mapy sieci i wskaźniki, a edycja Enterprise pozwala administratorom udostępniać te pulpity innym użytkownikom lub synchronizować je z głównym widokiem administratora. Doceniam również możliwość planowania cyklicznego wysyłania pulpitów nawigacyjnych jako załączników PDF do wiadomości e-mail, co ułatwia informowanie interesariuszy bez konieczności ręcznego przygotowywania raportów.
Najważniejsze funkcje Nagios XI
- Licencjonowanie na węzeł: Licencje XI są naliczane za monitorowany węzeł, a nie za czujnik lub sprawdzenie, bez określonego limitu liczby sprawdzeń uruchamianych dla każdego urządzenia.
- Zasady eskalacji powiadomień: Możesz skonfigurować eskalacje tak, aby po określonej liczbie powiadomień alerty były automatycznie kierowane do innej grupy kontaktów.
- Wycofywanie konfiguracji: Administratorzy mogą przywrócić konfigurację po wystąpieniu błędu do znanej, prawidłowej migawki, zmniejszając ryzyko, że nieprawidłowa konfiguracja spowoduje przerwę w monitorowaniu.
- Planowanie wydajności: Edycja Enterprise wizualizuje prognozowaną przyszłą wydajność i może ostrzegać, gdy istnieje ryzyko przekroczenia progów.
Integracje Nagios XI
Nagios XI oferuje udokumentowane integracje z Microsoft Azure AD na potrzeby jednokrotnego logowania oraz ze Slackiem na potrzeby powiadomień. Udostępnia również interfejs REST API do tworzenia niestandardowych integracji i obsługuje łączność za pośrednictwem pułapek SNMP.
Pros and Cons
Pros:
- Licencjonowanie za urządzenie eliminuje limity liczby czujników
- Dasklety pozwalają dostosować widoki infrastruktury do potrzeb poszczególnych operatorów
- Rozproszeni pracownicy zwiększają zakres zdalnych sprawdzeń
Cons:
- Początkowa integracja urządzeń może wymagać znacznego nakładu pracy
- Szablony raportów oferują ograniczoną elastyczność
Learn more about Nagios XI: Najlepszy wybór pod kątem widoczności trasy internetowej
- 15-dniowy bezpłatny okres próbny + dostępna wersja demonstracyjna
- Cena na zapytanie
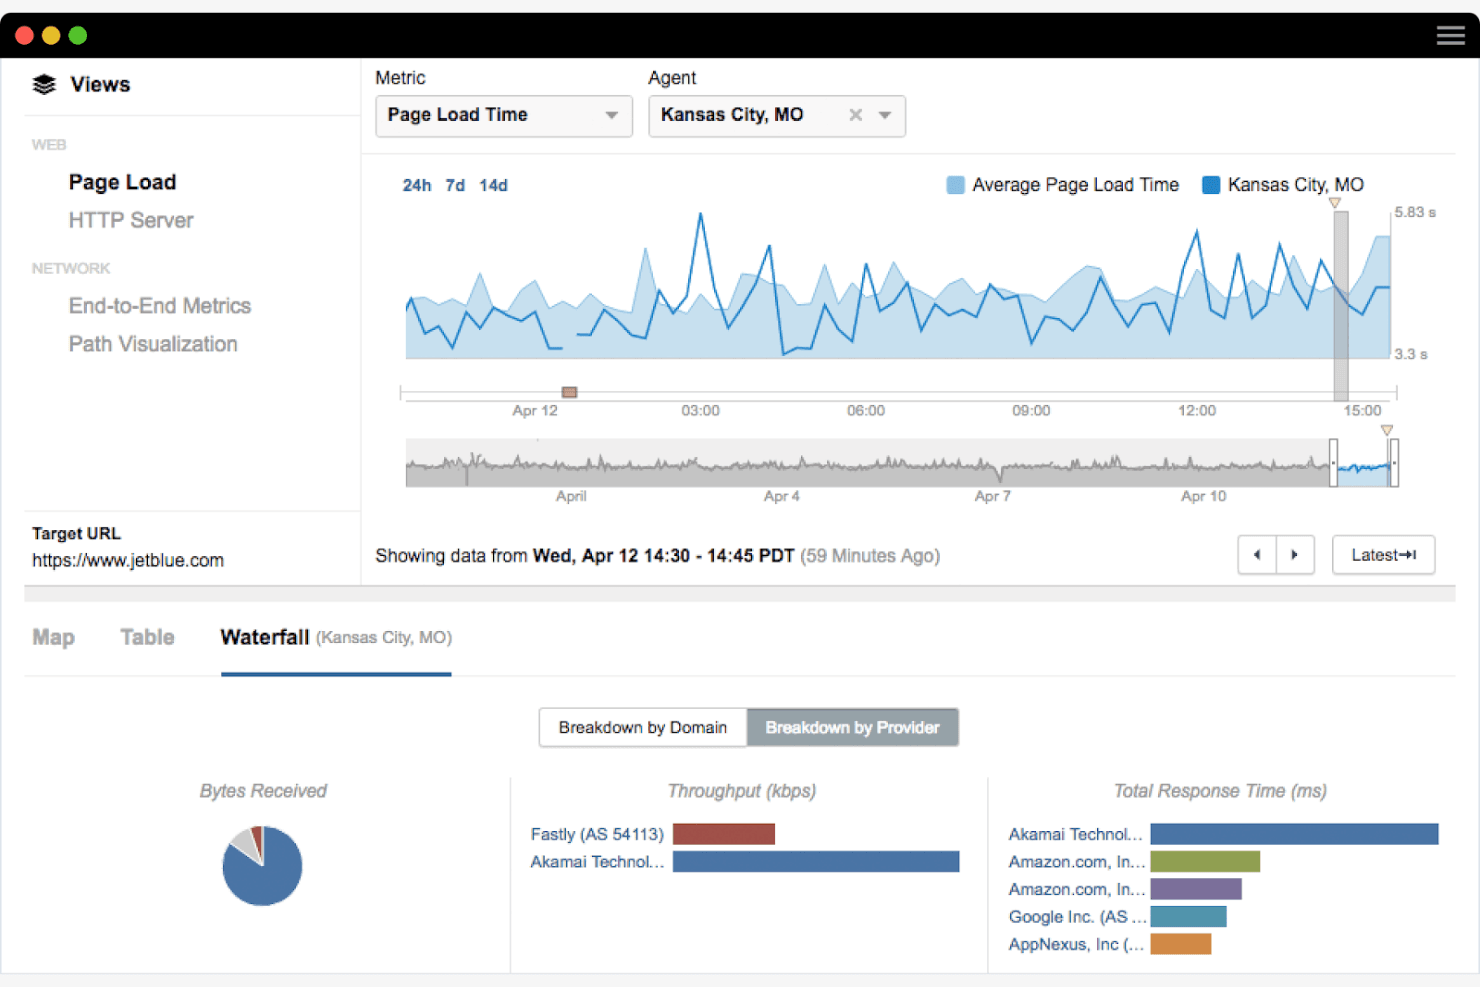
Widok ładowania strony ThousandEyes śledzący czasy ładowania strony z agenta w Kansas City, z podziałem na poziomie dostawców. ThousandEyes to wspierana przez Cisco platforma do monitorowania sieci, która zapewnia zespołom IT kompleksowy wgląd w sposób, w jaki ruch przebiega przez Internet, usługi chmurowe i aplikacje SaaS — dzięki czemu jest szczególnie przydatna, gdy trzeba określić, czy problem z wydajnością występuje wewnątrz sieci, czy gdzieś poza nią.
Dla kogo ThousandEyes jest najlepszym wyborem?
ThousandEyes dobrze sprawdzi się w zespołach IT i operacjach sieciowych w średnich i dużych przedsiębiorstwach, które intensywnie korzystają z usług chmurowych, aplikacji SaaS lub rozproszonych środowisk oddziałowych, gdzie priorytetem jest widoczność trasy internetowej.
Dlaczego wybrałem ThousandEyes
Wybrałem ThousandEyes jako jedno z najlepszych rozwiązań, ponieważ oferuje coś, czego tradycyjne wdrożenia PRTG po prostu nie potrafią: pokazuje dokładnie, w którym miejscu na trasie internetowej występuje problem. Gdy aplikacja SaaS, taka jak Salesforce, zaczyna działać nieprawidłowo, wizualizacja ścieżki sieciowej ThousandEyes śledzi każdy przeskok między użytkownikami a usługą, dzięki czemu mogę od razu stwierdzić, czy usterka występuje w mojej sieci, u dostawcy usług internetowych czy w infrastrukturze dostawcy chmury. Jego agenci chmurowi działają w 276 miastach w 71 krajach, zapewniając mi widoczność z zewnątrz do wewnątrz, której nie jest w stanie odtworzyć żaden czujnik lokalny.
Najważniejsze funkcje ThousandEyes
- Typy testów syntetycznych: Uruchamia testy monitorowania HTTP, FTP, przeglądarki, DNS, tras BGP, VoIP i UCaaS z agentów chmurowych i lokalnych.
- Monitorowanie warstwy urządzeń SNMP: Odpytuje urządzenia sieciowe za pomocą SNMPv2c lub SNMPv3 poprzez wdrożonych agentów lokalnych, z ręcznym lub zaplanowanym skanowaniem wykrywania.
- Wielostopniowe testowanie interfejsów API: Symuluje interakcje zaplecza z punktami końcowymi API, sprawdza zawartość odpowiedzi oraz obsługuje asercje służące do weryfikacji integralności danych i testowania przypadków brzegowych.
- Konfiguracja reguł alertów: Obsługuje zarówno ręczne, jak i adaptacyjne reguły alertów, z kierowaniem powiadomień do PagerDuty, Slack, ServiceNow lub niestandardowych webhooków.
Integracje ThousandEyes
ThousandEyes oferuje udokumentowane integracje z PagerDuty, Slack, ServiceNow, Splunk Observability Cloud, AppDynamics, OpenTelemetry i CyberArk Secrets Manager. Udostępnia również interfejs REST API oraz niestandardowe webhooki na potrzeby dodatkowych integracji.
Pros and Cons
Pros:
- Precyzyjnie wskazuje usterki w zewnętrznych trasach sieciowych
- Ujawnia problemy z opóźnieniami, utratą pakietów i łącznością z aplikacjami SaaS
- Porównuje wydajność z globalnych punktów obserwacyjnych sieci
Cons:
- Ograniczona lokalna telemetria przełączników i serwerów
- Odpytywanie urządzeń obejmuje mniej protokołów niż PRTG
Learn more about ThousandEyes: Najlepszy do ujednoliconego zarządzania punktami końcowymi
- 14-dniowy bezpłatny okres próbny + dostępne bezpłatne demo
- Od $3.75/miesiąc
Visit WebsiteCustomer Rating:5/5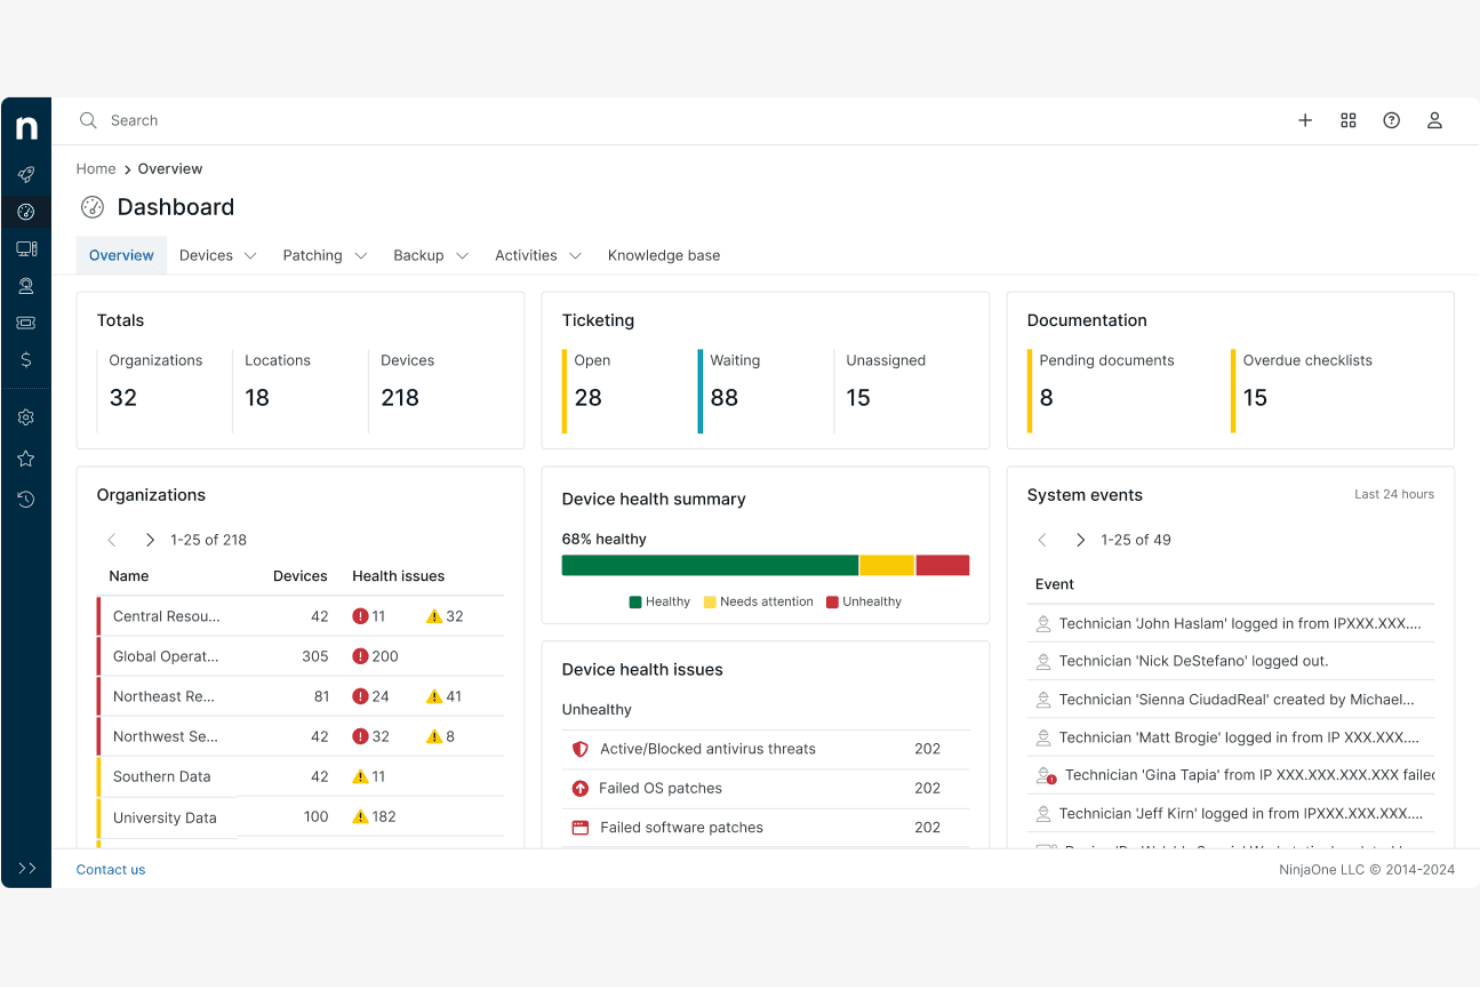
Przegląd pulpitu nawigacyjnego NinjaOne, podsumowujący urządzenia, organizacje, zgłoszenia, stan urządzeń i zdarzenia systemowe w jednym widoku. NinjaOne RMM to platforma monitorowania punktów końcowych i sieci przeznaczona dla dostawców usług zarządzanych (MSP) oraz zespołów IT, które potrzebują scentralizowanego wglądu w punkty końcowe, urządzenia sieciowe i infrastrukturę chmurową — z wbudowanym zarządzaniem poprawkami, alertami i narzędziami do zdalnego zarządzania, które ograniczają pracę ręczną.
Dla kogo NinjaOne jest najlepszym wyborem?
NinjaOne dobrze sprawdzi się w przypadku techników MSP i zespołów operacyjnych IT zarządzających punktami końcowymi w wielu środowiskach klientów z poziomu jednej konsoli.
Dlaczego wybrałem NinjaOne
Wybrałem NinjaOne jako jedną z najlepszych alternatyw dla PRTG, ponieważ łączy monitorowanie punktów końcowych, widoczność urządzeń sieciowych i automatyczne działania naprawcze w jednej konsoli, co jest dokładnie tym, czego potrzebują technicy MSP zarządzający wieloma środowiskami klientów. Podoba mi się, że NMS jest bezpośrednio wbudowany w RMM, dzięki czemu mój zespół może monitorować routery, przełączniki i zapory sieciowe obok punktów końcowych z systemami Windows, macOS i Linux bez przełączania się między narzędziami. Warunki oparte na zasadach pozwalają ustawiać progi dla procesora, pamięci, ruchu adaptera i opóźnienia ping, a następnie uruchamiać automatyczne działania naprawcze po przekroczeniu tych progów.
Najważniejsze funkcje NinjaOne
- Alertowanie wielokanałowe: Skonfiguruj kanały powiadomień, w tym pocztę e-mail, SMS, Slack, PagerDuty, Microsoft Teams i webhooki, aby dostarczać zespołowi alerty oparte na progach.
- Automatyczne działania naprawcze oparte na warunkach: Zdefiniuj przepływy pracy skryptów, które automatycznie wykrywają i rozwiązują problemy z punktami końcowymi, takie jak zatrzymane usługi, otwarte porty lub pominięte ponowne uruchomienia, bez udziału technika.
- Obsługa monitorowania przepływu: Zbieraj i analizuj dane NetFlow, JFlow, sFlow i IPFIX z obsługiwanych urządzeń sieciowych, aby uzyskać wgląd we wzorce ruchu.
- Publiczny interfejs API i webhooki: Uzyskuj dostęp do danych NinjaOne i wyzwalaj działania programowo za pomocą interfejsu API OAuth 2.0 z pełną obsługą metod POST, GET, PATCH, DELETE i PUT.
Integracje NinjaOne
NinjaOne wymienia integracje z ServiceNow, Autotask, ConnectWise Manage, HaloPSA, Slack, PagerDuty, Microsoft Azure i AWS. Jego publiczny interfejs API OAuth 2.0 oraz webhooki obsługują niestandardowe integracje i przepływy pracy związane z monitorowaniem.
Pros and Cons
Pros:
- Centralizuje widoczność punktów końcowych i sieci w wielu środowiskach klientów
- Automatyzacja oparta na zasadach pomaga ograniczyć rutynową pracę związaną z reagowaniem
- Monitoruje dane o przepływie obok wskaźników stanu urządzeń
Cons:
- Monitorowanie sieci może wymagać ręcznego mapowania OID
- Ograniczona udokumentowana retencja historii wydajności
Learn more about NinjaOne: Najlepszy do automatycznego wykrywania sieci
- Bezpłatny plan + dostępne bezpłatne demo
- Ceny na zapytanie
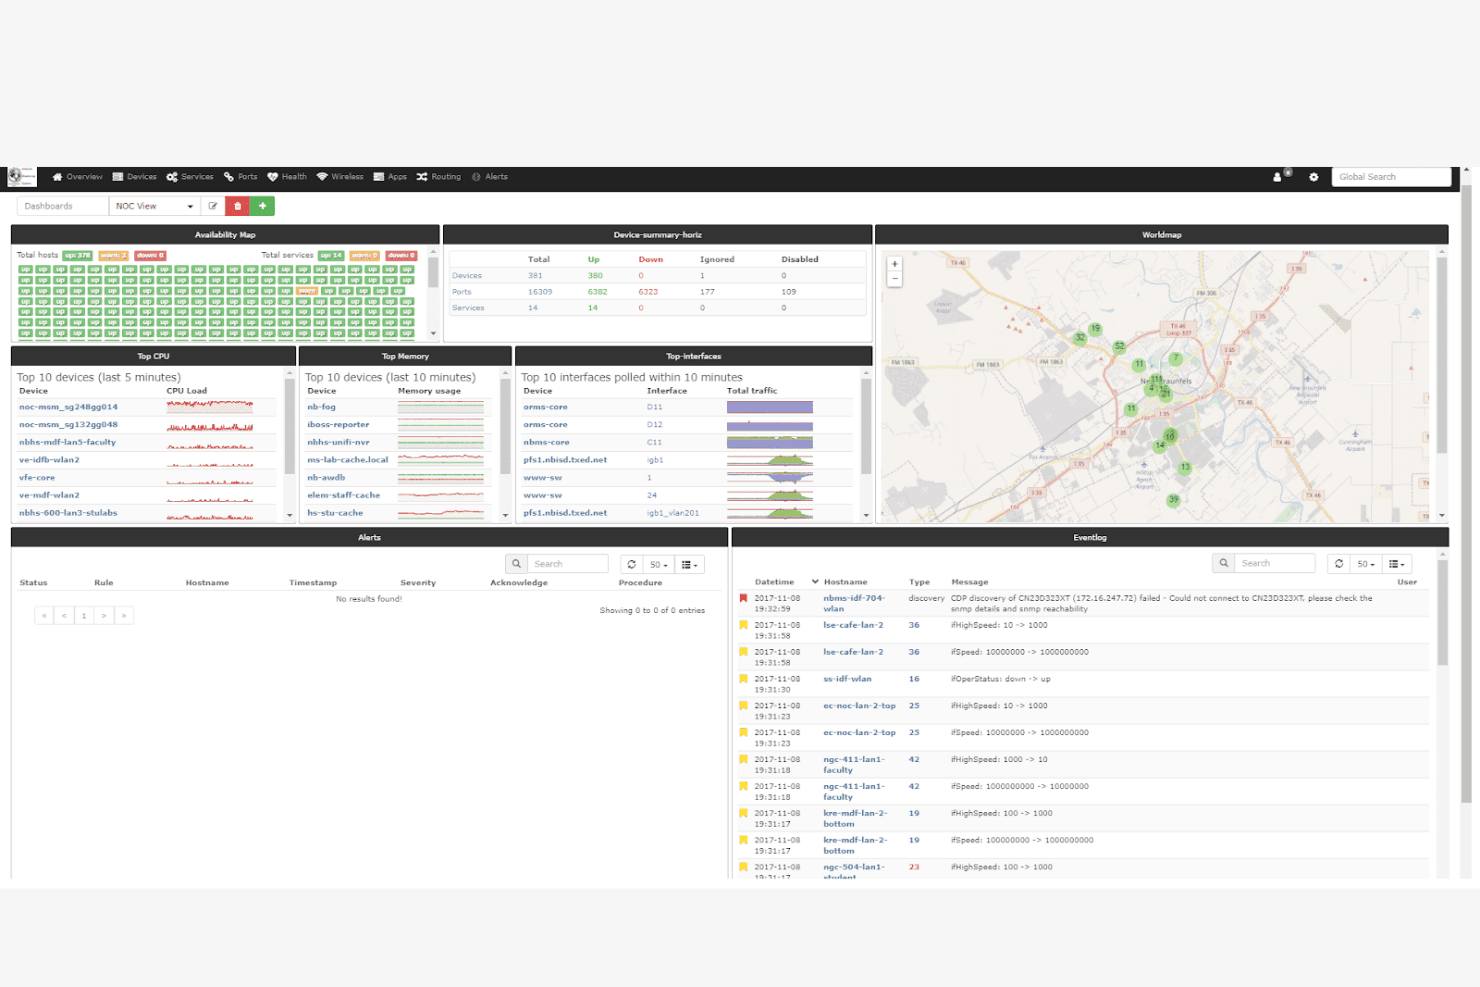
Panel NOC LibreNMS pokazujący dostępność urządzeń, najwyższe użycie procesora i pamięci, ruch na interfejsach oraz dziennik zdarzeń na żywo. LibreNMS to bezpłatny system monitorowania sieci o otwartym kodzie źródłowym, który odpowiada inżynierom systemowym i administratorom sieci potrzebującym szerokiego wykrywania urządzeń oraz widoczności infrastruktury bez kosztów i ograniczeń licencyjnych komercyjnych narzędzi.
Dla kogo LibreNMS jest najlepszym wyborem?
LibreNMS to dobry wybór dla inżynierów systemowych i administratorów sieci, którzy chcą uzyskać szerokie wykrywanie urządzeń oraz widoczność infrastruktury bez kosztów licencji zależnych od liczby sensorów.
Dlaczego wybrałem LibreNMS
Wybrałem LibreNMS jako jedno z najlepszych rozwiązań, ponieważ jego automatyczne wykrywanie sieci robi naprawdę duże wrażenie: wykorzystuje CDP, LLDP, OSPF, BGP, SNMP i ARP do wyszukiwania urządzeń w sieci bez ręcznego wprowadzania danych. Widziałem, jak po konfiguracji szybko wykrywa routery, przełączniki i punkty dostępowe, co jest dokładnie tym, czego potrzebujesz podczas zastępowania narzędzia ograniczonego liczbą sensorów, takiego jak PRTG. Wbudowane kontrole dostępności ICMP oraz monitorowanie aplikacji, takich jak NGINX, MySQL i Docker, uzupełniają widoczność dostępną od pierwszego dnia.
Najważniejsze funkcje LibreNMS
- Konfigurowalne działania alertów: Konfiguruj wieloetapowe przepływy powiadomień z segmentami czasowymi, które eskalują za pośrednictwem kanałów takich jak Slack, e-mail i Telegram do momentu rozwiązania alertu lub potwierdzenia jego otrzymania.
- System rozliczania przepustowości: Generuj rachunki za porty sieciowe na podstawie rzeczywistego wykorzystania lub ilości przesłanych danych bezpośrednio w platformie.
- Rozproszone odpytywanie: Rozdzielaj zadania odpytywania i wykrywania między wiele serwerów, przypisując urządzenia do grup odpytywania w miarę rozwoju sieci.
- Monitorowanie aplikacji z użyciem wielu protokołów: Zbieraj statystyki aplikacji z usług takich jak MySQL, NGINX, Docker i PostgreSQL za pośrednictwem bezpośredniego połączenia, rozszerzenia SNMP lub agenta Check_MK.
Integracje LibreNMS
Udokumentowane integracje obejmują NfSen, collectd, SmokePing, RANCID i Oxidized. LibreNMS udostępnia również interfejs API HTTP z odpowiedziami w formatach JSON i PNG do obsługi niestandardowych integracji, zarządzania urządzeniami, generowania wykresów i pobierania danych.
Pros and Cons
Pros:
- Szerokie automatyczne wykrywanie urządzeń
- Eskalowane alerty w wielu kanałach powiadomień
- Monitorowanie dostępności i wydajności sieci
Cons:
- Ograniczone natywne opcje raportowania
- Rozproszone odpytywanie nie jest przeznaczone dla zdalnych lokalizacji
Learn more about LibreNMS: Najlepsze do syntetycznego monitorowania sieci
- Bezpłatny plan + 14-dniowy okres próbny + bezpłatne demo
- Od $249/miesiąc
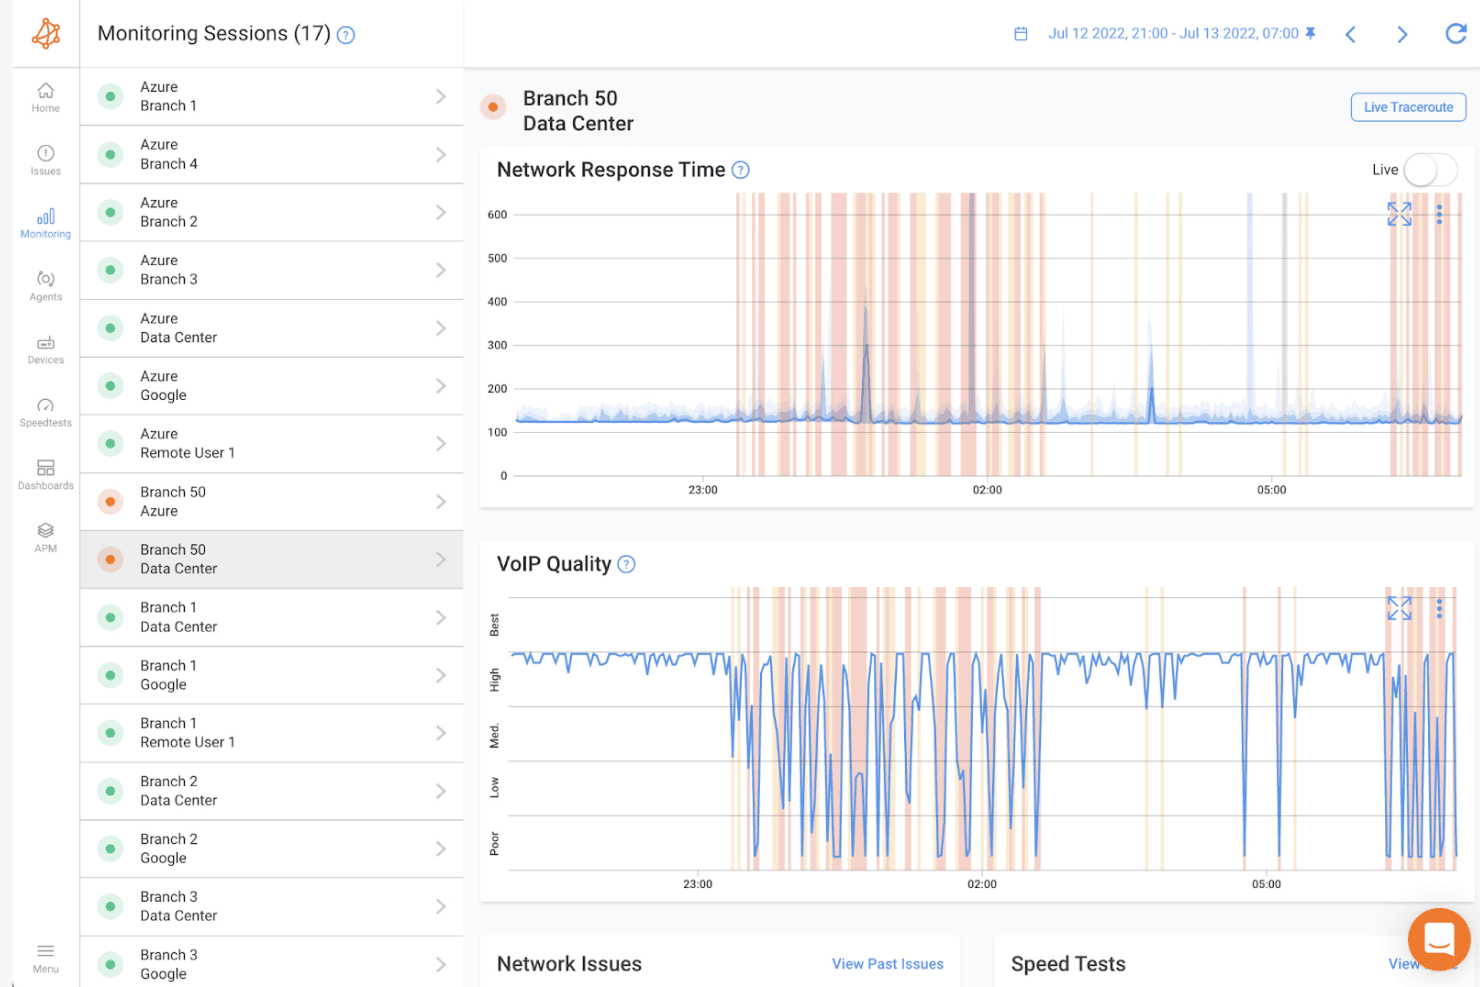
Panel monitorowania Obkio śledzący czas odpowiedzi sieci i jakość VoIP między oddziałami a centrami danych. Obkio to oparte na chmurze narzędzie do monitorowania wydajności sieci, które wykorzystuje syntetyczny ruch między rozproszonymi agentami, aby pomagać administratorom sieci i dostawcom usług zarządzanych (MSP) wykrywać, diagnozować i rozwiązywać problemy z opóźnieniami, utratą pakietów i łącznością w środowiskach obejmujących wiele lokalizacji.
Dla kogo Obkio jest najlepszym rozwiązaniem?
Obkio jest dobrym rozwiązaniem dla administratorów sieci i techników MSP, którzy muszą monitorować wydajność w rozproszonych środowiskach obejmujących wiele lokalizacji, korzystając z syntetycznego ruchu.
Dlaczego wybrałem Obkio
Obkio znalazło się na mojej krótkiej liście ze względu na odmienne podejście do monitorowania sieci w porównaniu z PRTG: zamiast odpytywać urządzenia z jednego punktu, wdraża agentów w każdej lokalizacji i nieprzerwanie wymienia między nimi syntetyczny ruch UDP co 500 milisekund. Szczególnie podoba mi się diagram cięciwowy, który zapewnia bieżący, dwukierunkowy wgląd w stan połączeń we wszystkich lokalizacjach. Funkcja Obkio Insights automatycznie koreluje również dane dotyczące wydajności, dane SNMP i wyniki traceroute, aby wskazać prawdopodobną przyczynę źródłową bez konieczności ręcznego analizowania danych.
Najważniejsze funkcje Obkio
- Monitorowanie urządzeń SNMP: Monitoruje routery, przełączniki, zapory sieciowe i punkty dostępu Wi-Fi, automatycznie gromadząc informacje o użyciu procesora, wykorzystaniu przepustowości, błędach interfejsów i dostępności za pośrednictwem SNMP v1, v2c lub v3.
- Wizualne trasy traceroute: Uruchamia ciągłe, automatyczne trasy traceroute równolegle z sesjami monitorowania i wyświetla opóźnienia dla każdego przeskoku, utratę pakietów oraz jitter na interaktywnych mapach ścieżek z kodowaniem kolorami.
- Alerty wielokanałowe: Wysyła powiadomienia oparte na progach przez pocztę elektroniczną, Slack, Microsoft Teams, PagerDuty, ServiceNow lub webhooki HTTP, z możliwością konfiguracji poziomów ważności i inteligentnego grupowania zdarzeń.
- Raportowanie według harmonogramu: Automatycznie generuje raporty w formatach Excel, PDF lub JSON według harmonogramu dziennego, tygodniowego albo miesięcznego i wysyła je pocztą elektroniczną do odbiorców, którzy nie potrzebują konta Obkio.
Integracje Obkio
Obkio oferuje cztery udokumentowane natywne integracje: Microsoft Teams, PagerDuty, ServiceNow i Slack. Obsługuje również webhooki HTTP do wysyłania powiadomień i gotowych raportów, ale nie udokumentowano ogólnego publicznego interfejsu API.
Pros and Cons
Pros:
- Dwukierunkowy wgląd w rozproszone lokalizacje
- Syntetyczne sondy wykrywają krótkotrwałe pogorszenia działania sieci WAN
- Recenzenci chwalą przejrzyste wizualizacje stanu sieci
Cons:
- Odpytywanie urządzeń zależy od lokalnych agentów kolektorów
- Recenzenci oczekują lepszego eksportu raportów historycznych
Learn more about Obkio: 10Najlepszy do automatycznego mapowania sieci
Auvik
- 14-dniowy bezpłatny okres próbny + dostępne demo
- Ceny dostępne na żądanie
Visit WebsiteCustomer Rating:4.7/5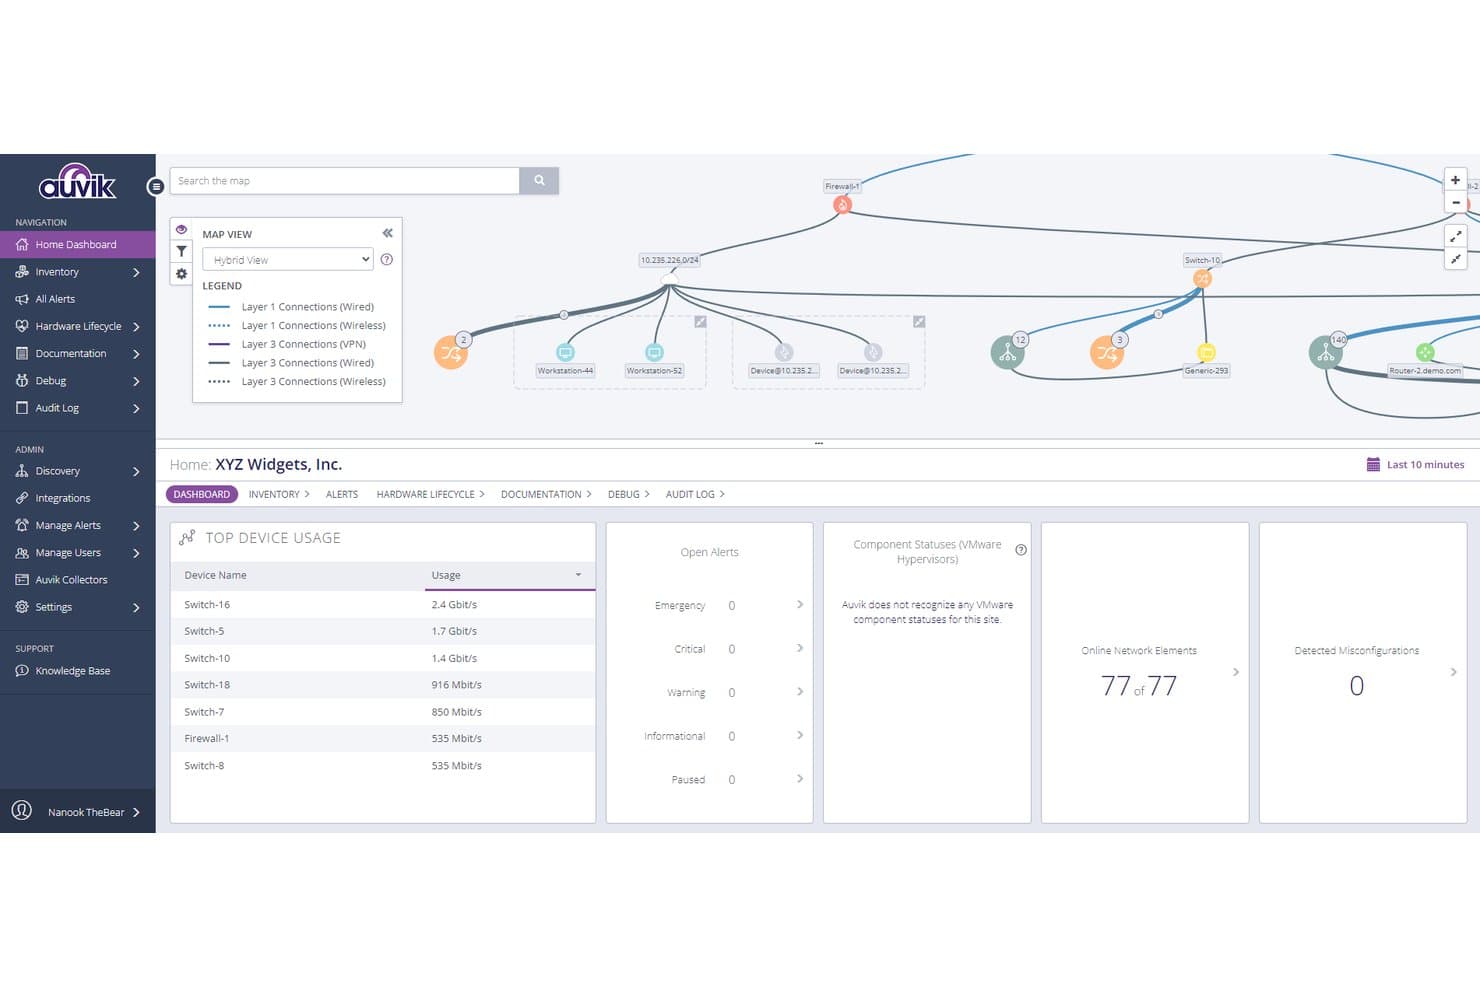
Panel główny Auvik łączy mapę sieci na żywo z podsumowaniami wykorzystania urządzeń i alertów. Auvik to oparta na chmurze platforma do zarządzania siecią, stworzona dla zespołów IT i dostawców usług zarządzanych (MSP), którzy potrzebują automatycznego wykrywania urządzeń, mapowania topologii na żywo oraz widoczności w wielu lokalizacjach bez ręcznego nakładu pracy związanego z dokumentowaniem i utrzymywaniem rejestrów sieci.
Dla kogo Auvik jest najlepszym wyborem?
Auvik to naturalny wybór dla techników MSP i administratorów sieci, którzy muszą monitorować i dokumentować środowiska klientów obejmujące wiele lokalizacji, bez spędzania wielu godzin na ręcznym wykrywaniu urządzeń i mapowaniu sieci.
Dlaczego wybrałem Auvik
Wybrałem Auvik jako jedno z najlepszych rozwiązań, ponieważ automatyczne mapowanie sieci to obszar, w którym wyraźnie przewyższa funkcje oferowane przez PRTG w standardzie. Zaraz po wdrożeniu kolektora Auvik wykrywa każde urządzenie połączone z adresem IP i renderuje mapę topologii na żywo obejmującą warstwy 1, 2 i 3, aktualizując ją bez przerwy wraz ze zmianami w sieci. Szczególnie podoba mi się to, że przechowuje historyczne migawki topologii, dzięki czemu mogę dokładnie sprawdzić, jak wyglądała sieć przed wystąpieniem incydentu.
Najważniejsze funkcje Auvik
- Wielowarstwowa analiza ruchu: Auvik pobiera dane NetFlow v5/v9, J-Flow, IPFIX i sFlow, aby prezentować najbardziej aktywne urządzenia, aplikacje intensywnie wykorzystujące przepustowość oraz szczegółowe zestawienia ruchu na poziomie protokołów w całej sieci.
- Automatyczne kopie zapasowe konfiguracji: Auvik stale tworzy kopie zapasowe konfiguracji urządzeń, śledzi historię wersji i umożliwia porównywanie zmian obok siebie na potrzeby audytów i rozwiązywania problemów.
- Wstępnie skonfigurowana biblioteka alertów: Auvik zawiera ponad 50 gotowych do użycia alertów dotyczących stanu urządzeń, wykorzystania interfejsów, błędów pakietów, opóźnień, zmienności opóźnień i zdarzeń syslog, z możliwością dostosowania progów.
- Integracje z narzędziami MSP: Auvik natywnie łączy się z ConnectWise Manage, Datto Autotask i IT Glue, aby synchronizować inwentarz urządzeń oraz dwukierunkowo zarządzać zgłoszeniami w środowiskach klientów.
Integracje Auvik
Auvik oferuje natywne integracje z ConnectWise Manage, Datto Autotask, ServiceNow, PagerDuty, Slack, Microsoft Teams i Opsgenie. Udostępnia również interfejsy API oraz webhooki do tworzenia niestandardowych integracji, w tym ogólny webhook przychodzący.
Pros and Cons
Pros:
- Automatyczne mapy topologii przyspieszają rozwiązywanie problemów
- Scentralizowane widoki obejmują wiele lokalizacji klientów
- Historia konfiguracji pomaga śledzić zmiany w sieci
Cons:
- Niektóre mapy wymagają ręcznego uporządkowania
- Domyślne alerty mogą generować wiele fałszywych alarmów
Learn more about Auvik:
Inne alternatywy dla PRTG
Oto kilka dodatkowych alternatyw dla PRTG, które nie trafiły na moją listę, ale nadal warto je sprawdzić:
Related Reviews
Jak oceniam alternatywy dla PRTG
Dzielę swoją ocenę na dwie warstwy: podstawowe możliwości — takie jak monitorowanie urządzeń SNMP i alertowanie progowe — które narzędzie musi oferować, aby zastąpić PRTG, oraz elementy wyróżniające, które odróżniają poszczególne opcje.
Podstawowe funkcje (wymagane na tej liście)
Wybierając narzędzia do swojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcji) do 5 (doskonale sprawdza się w tym obszarze) pod kątem każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi osiągnąć minimalny łączny wynik wynoszący 65%, aby zostać uwzględnione na liście.
- Monitorowanie urządzeń sieciowych: Sprawdzam obsługę wielu protokołów (SNMP, ICMP, NetFlow) oraz gotowe szablony obejmujące routery, przełączniki, zapory sieciowe i bezprzewodowe punkty dostępowe głównych dostawców.
- Monitorowanie serwerów i infrastruktury: Każde narzędzie powinno śledzić metryki na poziomie systemu operacyjnego w środowiskach Windows i Linux, a także obsługiwać VMware, Hyper-V, kontenery oraz dostawców usług chmurowych, takich jak AWS i Azure.
- System alertów i powiadomień: Analizuję szczegółowość konfiguracji progów oraz opcje dostarczania powiadomień wieloma kanałami, w tym możliwość integracji alertów z narzędziami takimi jak PagerDuty, Slack czy Teams.
- Pulpity nawigacyjne i wizualizacja: Duże znaczenie mają pulpity nawigacyjne działające w czasie rzeczywistym, z mapami topologii i widokami umożliwiającymi przechodzenie do szczegółów, szczególnie dla zespołów NOC, które potrzebują szybkiego podglądu stanu setek urządzeń.
- Raportowanie historyczne i analityka: Oceniam elastyczność przechowywania danych, możliwość generowania raportów SLA i dostępności oraz to, czy trendy pomocne w planowaniu wydajności można łatwo przygotować na potrzeby prezentacji dla interesariuszy.
- Automatyczne wykrywanie i skalowalność: Narzędzie powinno automatycznie skanować zasoby i tworzyć ich mapy, a ja zwracam szczególną uwagę na to, jak licencjonowanie i architektura radzą sobie ze wzrostem środowiska w rozproszonych lokalizacjach.
Gdy mam już listę narzędzi spełniających te kryteria, analizuję to, co wyróżnia poszczególne platformy.
Czynniki różnicujące (co wyróżnia dostawców)
Oto sposób, w jaki porównuję różnych dostawców:
Wyróżniające się funkcje
Wykrywanie anomalii oparte na sztucznej inteligencji jest istotnym czynnikiem różnicującym. Narzędzia, które ustalają wzorce normalnego ruchu i oznaczają odchylenia, wykrywają problemy całkowicie pomijane przez statyczne progi — na przykład powolny wyciek pamięci na serwerze produkcyjnym. Zwracam również uwagę na wbudowane zarządzanie dziennikami, ponieważ korelowanie danych syslog z metrykami wydajności podczas awarii pozwala zaoszczędzić rzeczywisty czas w porównaniu z przełączaniem się między oddzielnymi narzędziami. W przypadku zespołów MSP o możliwości skalowania platformy w środowiskach klientów decyduje obsługa wielu dzierżawców z izolacją klientów oraz pulpitami nawigacyjnymi z własną marką.
Więcej niż funkcje
Struktura licencjonowania ma duże znaczenie podczas przechodzenia z PRTG. Oceniam, czy koszty rosną przewidywalnie wraz z dodawaniem urządzeń — modele rozliczane za czujnik mogą szybko stać się drogie w środowisku obejmującym 1000 węzłów. Kolejnym czynnikiem jest elastyczność wdrażania, ponieważ niektóre zespoły potrzebują instalacji lokalnych w sieciach odizolowanych od innych sieci, podczas gdy inne preferują model SaaS. Biorę również pod uwagę ekosystem integracji, a w szczególności natywne połączenia z narzędziami ITSM, takimi jak ServiceNow czy Jira, ponieważ dane monitorowania są najbardziej użyteczne, gdy trafiają bezpośrednio do procedur reagowania na incydenty.
Dlaczego szukać alternatywy dla PRTG?
Choć PRTG jest dobrym wyborem wśród narzędzi do monitorowania, istnieje kilka powodów, dla których niektórzy użytkownicy szukają alternatywnych rozwiązań. Możesz szukać alternatywy dla PRTG, ponieważ…
- Potrzebujesz lepszej skalowalności dla rozwijających się sieci
- Szukasz większych możliwości dostosowywania
- Twój zespół potrzebuje łatwiejszej integracji z usługami w chmurze
- Potrzebujesz bardziej zaawansowanych funkcji analitycznych
- Szukasz bardziej intuicyjnego interfejsu użytkownika
Jeśli którykolwiek z tych opisów pasuje do Twojej sytuacji, jesteś we właściwym miejscu. Moja lista zawiera kilka opcji narzędzi do monitorowania, które lepiej odpowiadają zespołom mierzącym się z tymi wyzwaniami związanymi z PRTG i szukającym alternatywnych, opłacalnych rozwiązań.
Najważniejsze funkcje PRTG
Oto niektóre z najważniejszych funkcji PRTG, które pomogą Ci zestawić i porównać ofertę alternatywnych rozwiązań:
- Monitorowanie sieci i serwerów: Zapewnia monitorowanie routerów, przełączników, zapór sieciowych i innych urządzeń w czasie rzeczywistym, gwarantując płynne działanie sieci.
- Monitorowanie przepustowości: Śledzi wykorzystanie przepustowości, pomagając zrozumieć wzorce ruchu sieciowego i zapobiegać wąskim gardłom.
- Konfigurowalne pulpity: Oferuje mapy i pulpity działające w czasie rzeczywistym, które można dostosować tak, aby wyświetlały najważniejsze wskaźniki dla zespołu.
- Alerty i powiadomienia: Wysyła konfigurowalne alerty za pośrednictwem poczty e-mail, wiadomości SMS lub powiadomień push, aby informować o wszelkich problemach.
- Monitorowanie rozproszone: Umożliwia scentralizowane monitorowanie wielu zdalnych lokalizacji i centrów danych, zapewniając pełny wgląd w całą sieć.
- Niestandardowe raportowanie: Umożliwia tworzenie dostosowanych raportów, które pozwalają skutecznie komunikować stan infrastruktury IT.
- Monitorowanie SNMP: Obsługuje SNMP do monitorowania różnych urządzeń sieciowych, zapewniając zgodność z szeroką gamą sprzętu.
- Monitorowanie Wi-Fi: Monitoruje sieci Wi-Fi, aby zapewnić niezawodną łączność i wydajność w całej infrastrukturze bezprzewodowej.