

Het vinden van de juiste tool voor testgegevensbeheer kan een lastige taak zijn. Met zoveel beschikbare opties is het moeilijk om te bepalen welke tool echt aan je behoeften voldoet zonder kostbare tijd of middelen te verspillen. Als je problemen hebt ondervonden met tools die onnodig complex zijn, niet met je projecten kunnen meegroeien of niet voldoen aan regelgeving voor gegevensprivacy, ben je niet de enige. Een goede tool voor testgegevensbeheer moet het aanmaken, beheren en beveiligen van je gegevenssets stroomlijnen en tegelijkertijd naadloos integreren in je testwerkstromen.
Als professional op het gebied van softwaretesten met praktijkervaring met tientallen tools, ben ik dezelfde uitdagingen als jij tegengekomen en heb ik ze opgelost. Daarom heb ik deze gids samengesteld: om je zoektocht te vereenvoudigen en een zorgvuldig samengestelde lijst te bieden van de beste tools voor testgegevensbeheer die momenteel beschikbaar zijn. Of je prioriteit nu ligt bij automatisering, naleving van regelgeving of schaalbaarheid, dit artikel helpt je een weloverwogen beslissing te nemen.
Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Vergelijkingstabel van tools voor testgegevensbeheer
In de onderstaande tabel worden de prijsgegevens van mijn beste tools voor testgegevensbeheer vergeleken.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Het beste voor compliancegerichte maskering met automatische subsetselectie | Gratis proefperiode van 14 dagen | Prijs op aanvraag | Website | |
| 2 | Het beste voor synthetische testgegevens die native in CI/CD zijn geïntegreerd | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 3 | Het beste voor het beheren van verschillende testgegevensomgevingen vanaf één centrale locatie | Gratis proefperiode van 14 dagen | Vanaf €15,000/gebruiker/jaar (jaarlijks gefactureerd) | Website | |
| 4 | Beste voor TDM gedurende de volledige levenscyclus met databaseklonen | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 5 | Het meest geschikt voor testdatamaskering inclusief mainframes | Niet beschikbaar | Prijs op aanvraag | Website | |
| 6 | Het beste voor ondernemingen met complexe omgevingen | Gratis proefperiode van 30 dagen beschikbaar | Prijs op aanvraag | Website | |
| 7 | Beste subsetselectie over meerdere databases in gereguleerde sectoren | Gratis demo beschikbaar | Prijzen op aanvraag | Website | |
| 8 | Meest geschikt voor maskering in pipelines met meerdere databases | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 9 | Het beste voor visueel, op dekking gericht gegevensontwerp | 14 dagen gratis proefversie | Prijs op aanvraag | Website | |
| 10 | Ideaal voor het klonen van databases in Git-stijl voor vijf engines | Gratis demo beschikbaar | Prijs op aanvraag | Website |




Beoordelingen van de beste tools voor testgegevensbeheer
Hieronder vind je mijn gedetailleerde samenvattingen van de beste tools voor testgegevensbeheer die in mijn selectie zijn opgenomen. In mijn beoordelingen bespreek ik de belangrijkste functies, voor- en nadelen, integraties en ideale gebruiksscenario’s van elke tool, zodat je de beste tool voor jouw situatie kunt vinden.
 Het beste voor compliancegerichte maskering met automatische subsetselectie
- Gratis proefperiode van 14 dagen
- Prijs op aanvraag
Visit WebsiteCustomer Rating:4.3/5
Tonic maskeert en de-identificeert gevoelige databasekolommen voor veilige testgegevens. Tonic Structural is een platform voor testdatabeheer dat productiegegevens maskeert, subset en beschikbaar stelt voor niet-productieomgevingen, met ondersteuning voor relationele databases, NoSQL, datawarehouses en bestandsbronnen.
Voor wie is Tonic het meest geschikt?
Tonic Structural is zeer geschikt voor teams in de gezondheidszorg en financiële sector die compliance centraal stellen en productiegegevens moeten maskeren en subsetten, terwijl ze privacydocumentatie bijhouden die klaar is voor audits.
Waarom ik voor Tonic koos
Tonic verdient een plaats op mijn shortlist omdat de mogelijkheden voor maskering en subsetselectie zo nauw geïntegreerd zijn op een manier die ik zelden zie. Ik vind het geweldig dat het privacycentrum elke kolom markeert als Risicovol, Beschermd of Niet gevoelig, waarna je generatoren in bulk kunt toepassen en een volledig privacyrapport voor auditdoeleinden kunt exporteren. De gepatenteerde subsetter verwerkt virtuele vreemde sleutels en circulaire afhankelijkheden automatisch, zodat je gemaskeerde subset referentieel intact blijft, zelfs bij complexe schema's met meerdere tabellen.
Belangrijkste functies van Tonic
- Structural-agent: Een AI-chatassistent die in de app is ingebouwd, de resultaten van gevoeligheidsscans samenvat, generatoren aanbeveelt en deze automatisch op je kolommen toepast.
- Controles voor differentiële privacy: Categorische en continue generatoren ondersteunen differentiële privacy, met een configureerbaar privacybudget om statistische gevolgtrekkingen uit getransformeerde gegevens te beperken.
- Uitvoer naar containerrepository: Structural schrijft gemaskeerde, gesubsette gegevens rechtstreeks weg als containervolumes voor PostgreSQL, MySQL en SQL Server, zodat je op verzoek geïsoleerde databases kunt starten.
- Versiegeschiedenis: Legt elke wijziging in de werkruimteconfiguratie vast—generatoren, regels voor subsetselectie, tabelmodi en scripts na taken—met toeschrijving en de mogelijkheid om eerdere versies te herstellen.
Integraties van Tonic
Tonic biedt rechtstreekse integraties met PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, Snowflake, BigQuery, Redshift, Databricks en Amazon S3. Het ondersteunt ook REST API, GitHub Actions, Kubernetes, Helm en containerregisters, waaronder Amazon ECR, Google Artifact Registry en Azure Container Registry.
Pros and Cons
Pros:
- Behoudt joins in complexe schema's
- Privacy Hub brengt gevoelige kolommen voor audits in kaart
- Productiegetrouwe gegevens behouden statistische relaties
Cons:
- Synthese vanaf nul vereist het afzonderlijke product Fabricate
- Gecontaineriseerde databases vereisen een Kubernetes-implementatie
Learn more about Tonic: Het beste voor synthetische testgegevens die native in CI/CD zijn geïntegreerd
- Gratis demo beschikbaar
- Prijs op aanvraag
Visit WebsiteCustomer Rating:4.6/5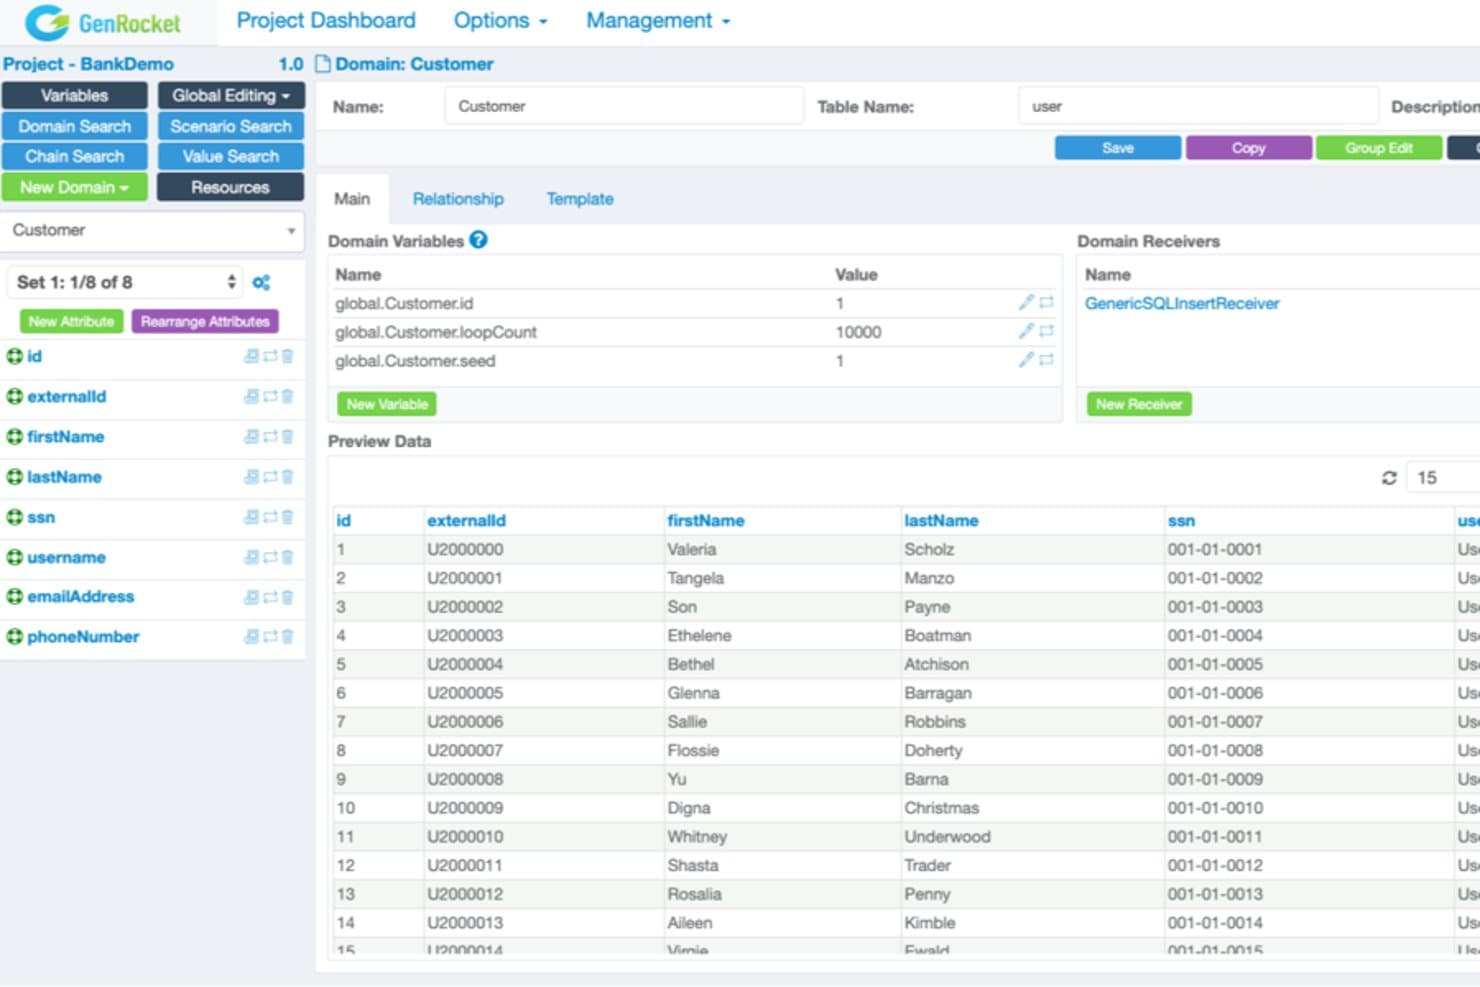
Met GenRocket kunnen gebruikers testgegevensdomeinen visueel bekijken en configureren. GenRocket is een platform voor het beheer van synthetische testgegevens dat in realtime gegevens genereert op basis van metadata en schema's, met ondersteuning voor gegevensmaskering, intelligente subsetselectie, uitvoer in meerdere indelingen en zelfbedieningsprovisioning binnen CI/CD-pijplijnen.
Voor wie is GenRocket het meest geschikt?
GenRocket is zeer geschikt voor QA- en DevOps-teams die op aanvraag synthetische testgegevens rechtstreeks binnen CI/CD-pijplijnen moeten genereren, zonder ooit productiegegevens aan te raken.
Waarom ik voor GenRocket koos
GenRocket staat op mijn kandidatenlijst omdat het het enige platform voor testgegevens is dat ik heb gezien en dat specifiek is ontwikkeld om in realtime synthetische gegevens te genereren, rechtstreeks binnen een CI/CD-pijplijn, zonder ooit productiegegevens aan te raken. De gepatenteerde motor voor referentiële integriteit houdt gegevens consistent over meerdere schema's en databases tegelijk, wat echt zeldzaam is. Ik vind het ook prettig dat elke testgegevensset in slechts 100 milliseconden kan worden gegenereerd, zodat de uitvoering van de pijplijn niet wordt vertraagd door te wachten op het beschikbaar stellen van gegevens.
Belangrijkste functies van GenRocket
- Detectie van schemamutaties met G-Delta: Identificeert automatisch wijzigingen in databaseschema's in MySQL, MS SQL, Oracle en PostgreSQL en activeert vervolgens G-Refactor om alle getroffen testgegevenssets bij te werken.
- Maskering op locatie: Vervangt gevoelige velden in Oracle-, MS SQL Server-, IBM DB2-, PostgreSQL- en MySQL-databases door synthetisch gegenereerde equivalenten, zonder ooit echte productiegegevens te lezen.
- G-Portal-zelfbedieningsportal: Biedt ontwikkelaars en testers een interface op basis van rollen om testgegevenssets te zoeken, aan te vragen, te volgen en te downloaden, zonder voor elk verzoek een centraal datateam te hoeven inschakelen.
- Meer dan 750 intelligente gegevensgeneratoren: Dekt vrijwel elk gegevenstype, domein of elke bedrijfsregel, inclusief voorwaardelijke logica, afhankelijkheden tussen velden en beperkingen op basis van reguliere expressies.
Integraties van GenRocket
GenRocket kan worden geïntegreerd met Jenkins, Azure DevOps, TeamCity, CircleCI, GitHub, Cucumber, Selenium, JUnit, JMeter en LoadRunner. Het ondersteunt ook REST API, JDBC, SOAP, TCP/IP-sockets en Docker-implementatie voor aangepaste CI/CD-workflows.
Pros and Cons
Pros:
- Generatie van synthetische gegevens behoudt de referentiële integriteit
- Realtime beschikbaarstelling van gegevens voor CI/CD-pijplijnen
- Onbeperkt gegevensvolume zonder vernieuwingscycli
Cons:
- Geen formaatbehoudende of omkeerbare maskering
- PII-detectie is pas volledig beschikbaar vanaf {{year}}
Learn more about GenRocket: Het beste voor het beheren van verschillende testgegevensomgevingen vanaf één centrale locatie
- Gratis proefperiode van 14 dagen
- Vanaf €15,000/gebruiker/jaar (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5
Gegevensmaskering helpt je gevoelige klantinformatie privé te houden. DATPROF is een platform voor testgegevensbeheer dat gegevensmaskering, subsetselectie, synthetische gegevensgeneratie, PII-ontdekking, databasevirtualisatie en gecentraliseerde provisioning combineert voor relationele, NoSQL- en cloudgegevensbronnen.
Voor wie is DATPROF het meest geschikt?
DATPROF is zeer geschikt voor data-ingenieurs en DBA's bij middelgrote tot grote ondernemingen die complexe omgevingen met meerdere databases beheren, waar referentiële integriteit en naleving van regelgeving niet onderhandelbaar zijn.
Waarom ik voor DATPROF heb gekozen
Ik heb DATPROF gekozen als een van de beste oplossingen omdat het licentiemodel, dat onafhankelijk is van het gegevensvolume, het platform echt onderscheidt: de licentiekosten blijven gelijk, of je nu 500 GB of 100 TB maskeert. Dat is belangrijk wanneer je een productiedatabase subsetselecteert, zoals de database van 23 TB die Heineken terugbracht tot 130 GB. De gepatenteerde detectie van cycli van vreemde sleutels in DATPROF Subset verwerkt complexe schema's met duizenden tabellen en behoudt tegelijkertijd de referentiële integriteit tussen systemen. Combineer dat met de gecentraliseerde orkestratie van de Runtime-portal, en elk teamlid kan zijn eigen vernieuwde omgeving beschikbaar stellen zonder op een DBA te hoeven wachten.
Belangrijkste functies van DATPROF
- Deterministische maskering tussen systemen: Past gelijktijdig consistente gemaskeerde waarden toe voor dezelfde invoer in meerdere databases, waarbij de referentiële integriteit behouden blijft voor volledige traceerbaarheid van tests.
- Ontdekking en profilering van PII: Scant databases om automatisch te identificeren waar gevoelige gegevens zich bevinden, met ondersteuning voor aangepaste detectieregels met reguliere expressies of expressies op basis van lijsten.
- Selfserviceportal voor provisioning: Stelt testers en ontwikkelaars in staat om in te loggen bij DATPROF Runtime en zelfstandig hun eigen testomgevingen te vernieuwen, zonder op een DBA te hoeven wachten.
- Databaseklonen volgens het kopiëren-bij-schrijven-principe: DATPROF Virtualize start virtuele databaseomgevingen van volledige omvang op zonder extra opslagruimte te gebruiken, waarbij terugdraaien naar een snapshot in minder dan 20 seconden is voltooid.
Integraties van DATPROF
DATPROF ondersteunt CI/CD-integraties met Jenkins, Azure DevOps, GitLab en Bamboo, evenals integraties voor testautomatisering met Parasoft en Tosca. De REST API ondersteunt aangepaste integraties. Er zijn ook vermeldingen beschikbaar in Azure Marketplace en AWS Marketplace.
Pros and Cons
Pros:
- Maskering behoudt de referentiële integriteit tussen databases
- Subsetselectie verkleint enorme productiedatasets efficiënt
- Webportal met rollen voor selfservicevernieuwing
Cons:
- Beperkte native ondersteuning voor SaaS-gegevensbronnen
- Geen ondersteuning voor mainframes of een bredere dekking van NoSQL-databases
Learn more about DATPROF: Beste voor TDM gedurende de volledige levenscyclus met databaseklonen
- Gratis demo beschikbaar
- Prijs op aanvraag

Enov8 biedt in één oogopslag inzicht in PII voor leidinggevenden in verschillende gegevensbronnen. Enov8 is een platform voor het beheer van testgegevens dat de volledige TDM-levenscyclus omvat, inclusief AI-aangedreven gegevensprofilering, maskering, subsetselectie, synthetische gegevensgeneratie en databasevirtualisatie via de vME-kloonengine.
Voor wie is Enov8 het meest geschikt?
Enov8 is zeer geschikt voor DevOps- en QA-teams in gereguleerde sectoren die één platform nodig hebben om maskering, subsetselectie, synthetische gegevens en databasevirtualisatie gezamenlijk te beheren.
Waarom ik voor Enov8 heb gekozen
Ik heb Enov8 gekozen als een van de beste oplossingen, omdat het de enige tool op mijn lijst is die TDM gedurende de volledige levenscyclus combineert met de vME-databasekloonengine, waarmee databasekopieën die de productie realistisch weerspiegelen worden opgestart met ongeveer 40 MB per kloon, ongeacht de omvang van de bron. Ik vind het geweldig dat maskering, subsetselectie en synthetische gegevensgeneratie rechtstreeks in de virtualisatielaag terechtkomen, zodat klonen al privacyveilig zijn voordat ze een testomgeving bereiken.
Belangrijkste functies van Enov8
- AI-aangedreven PII-detectie: Een ML-aangedreven profileringengine scant automatisch verbonden gegevensbronnen om gevoelige velden te classificeren en kolommen met regelgevingsrisico te markeren voordat de maskering begint.
- Reserveringen van testgegevens: Een ingebouwd boekingssysteem stelt teams in staat datasets centraal te reserveren en te beheren, waardoor conflicten tussen gelijktijdige gebruikers en omgevingen worden voorkomen.
- Validatiescan na maskering: Een ML-aangedreven validatierun bevestigt de effectiviteit van de maskering na elke beveiligingsronde en genereert controleklare nalevingsdocumentatie.
- Integratiehub voor DevOps Manager: Een taalonafhankelijke orkestratielaag waarin automatiseringsscripts in Python, Bash, Ansible, Java en meer worden beheerd, waarmee Enov8 wordt verbonden met CI/CD-pipelines via Jenkins, GitLab CI/CD en Azure DevOps.
Enov8-integraties
Enov8 ondersteunt meer dan 100 integraties, waaronder Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy en Ansible. De REST API, webhooks, planner en DevOps Manager-ondersteuning maken aangepaste CI/CD-workflows mogelijk.
Pros and Cons
Pros:
- Databasevirtualisatie met kleine klonen van 40 MB
- AI-aangedreven PII-detectie en validatie van maskering
- Centrale reservering van testgegevens voorkomt allocatieconflicten
Cons:
- Het aantal openbare beoordelingen is relatief beperkt
- Er zijn geen attesten van externe nalevingsinstanties vermeld
Learn more about Enov8: Het meest geschikt voor testdatamaskering inclusief mainframes
- Niet beschikbaar
- Prijs op aanvraag

Broadcom Test Data Manager houdt de status van importtaken bij in één weergave. Broadcom Test Data Manager is een platform voor enterprise-testdatabeheer dat datamaskering, synthetische datageneratie, subsetselectie, PII-detectie, databasevirtualisatie en selfservice-provisioning combineert — met speciale ondersteuning voor mainframeomgevingen naast moderne gedistribueerde en clouddatabases.
Voor wie is Broadcom Test Data Manager het meest geschikt?
Grote ondernemingen die mainframeomgevingen naast moderne gedistribueerde systemen gebruiken, halen het meeste uit dit platform.
Waarom ik Broadcom Test Data Manager heb gekozen
Ik heb Broadcom Test Data Manager opgenomen in mijn topkeuzes omdat het het enige platform is dat ik heb gezien dat mainframeomgevingen als volwaardige omgeving ondersteunt naast moderne gedistribueerde systemen. Met de speciale module CA TDM for Mainframe kunt u gegevens maskeren en subsets maken in z/OS, VSAM en IMS via dezelfde interface die u gebruikt voor SQL Server of Oracle. De geautomatiseerde PII-heatmap scant volledige mainframeschema's en markeert gevoelige velden voordat u ook maar één maskerregel toepast. Hierdoor neemt het handmatige mappingwerk af dat compliance-teams doorgaans vertraagt.
Belangrijkste functies van Broadcom Test Data Manager
- Selfservice-dataportal: Een gecentraliseerde catalogus waarin testers op aanvraag testgegevens kunnen aanvragen, reserveren en vrijgeven via dynamische formulieren, zonder op databasebeheerders te hoeven wachten.
- DAVE-databasevirtualisatie: Een copy-on-write-kloonengine die binnen enkele minuten onafhankelijke databaseklonen opstart vanuit een gedeelde basisimage, met minimale extra opslagruimte.
- Javelin-workflowautomatisering: Een ingebouwde visuele automatiseringsengine die masker-, subset- en provisioningtaken orkestreert en kan worden geactiveerd via een REST API of CI/CD-pipelines.
- Behoud van referentiële integriteit: Maskerings- en subsetbewerkingen behouden relaties tussen tabellen, zodat testdatasets functioneel samenhangend blijven voor end-to-endtesten.
Integraties van Broadcom Test Data Manager
Gedocumenteerde integraties omvatten Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM en CA Agile Central. REST API's ondersteunen aangepaste CI/CD-workflows, terwijl Docker en Kubernetes ondersteuning bieden voor gecontaineriseerde implementaties.
Pros and Cons
Pros:
- Testdatamaskering inclusief mainframes
- Geautomatiseerde PII-detectie en heatmaps
- Copy-on-write-databasevirtualisatie (DAVE)
Cons:
- Geen SaaS-implementatieoptie beschikbaar
- De gebruikersinterface voelt verouderd en complex aan
Learn more about Broadcom Test Data Manager: Het beste voor ondernemingen met complexe omgevingen
- Gratis proefperiode van 30 dagen beschikbaar
- Prijs op aanvraag
Visit WebsiteCustomer Rating:4.5/5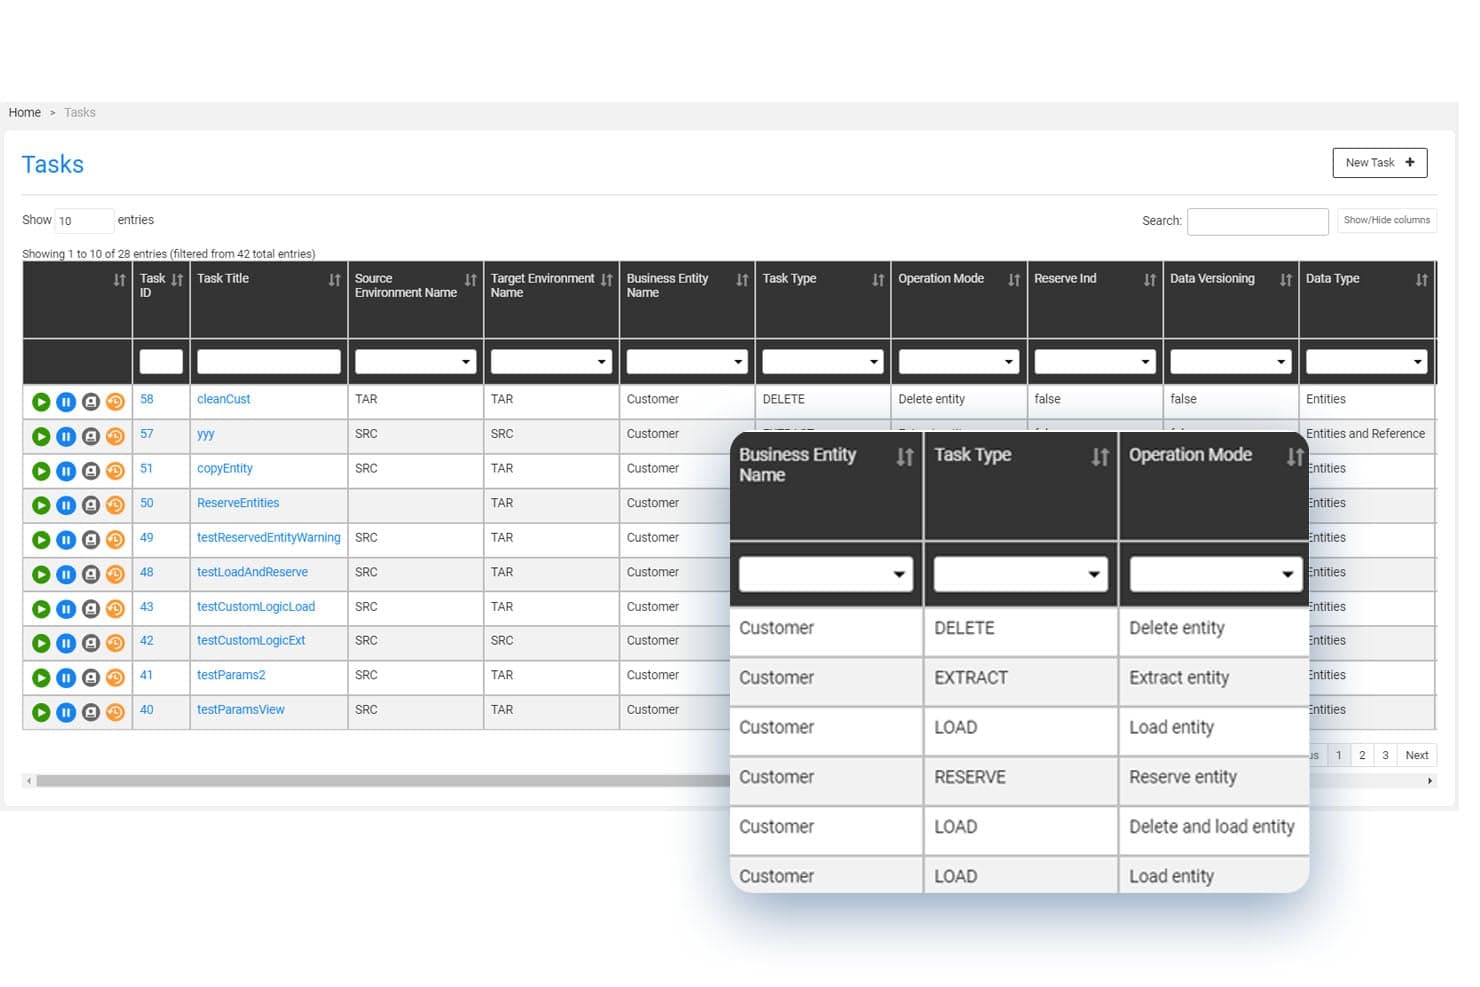
Met K2View-testdatabeheer kunnen gebruikers gegevenstaken beheren en filteren op type en bedieningsmodus. K2View-testdatabeheer is een enterpriseplatform voor TDM dat gegevensmaskering, synthetische gegevensgeneratie, subsetting en selfservice-provisioning verenigt voor relationele, NoSQL-, mainframe- en cloudgegevensbronnen via een gepatenteerde Micro-database™-architectuur.
Voor wie is K2View-testdatabeheer het meest geschikt?
K2View is ontwikkeld voor grote ondernemingen die testgegevens beheren in gemengde omgevingen—mainframe, cloud, NoSQL en relationele systemen—allemaal tegelijk.
Waarom ik voor K2View-testdatabeheer heb gekozen
K2View staat op mijn selectielijst omdat de gepatenteerde Micro-database™-architectuur een probleem oplost dat de meeste TDM-tools omzeilen: het behouden van referentiële integriteit tussen mainframe-, NoSQL- en cloudbronnen tegelijk. Ik ben vooral onder de indruk van de maskering tijdens de gegevensstroom, wat betekent dat PII op het moment van extractie wordt gemaskeerd en nooit ongemaskeerd in een testomgeving terechtkomt. Dankzij de entiteitsgerichte subsetting kunnen teams in één bewerking een volledig klantrecord ophalen dat zich uitstrekt over Oracle, Kafka en MongoDB, zonder handmatige joinregels.
Belangrijkste functies van K2View-testdatabeheer
- Selfserviceportaal voor TDM: Een webgebaseerde interface waarmee testers testgegevens kunnen aanvragen, reserveren en terugdraaien zonder data- of DBA-teams erbij te betrekken.
- Momentopname en terugdraaien met de Tijdmachine: Slaat op elk moment specifieke statussen van testgegevens op, zodat testers omgevingen direct kunnen herstellen naar een bekende configuratie.
- Geautomatiseerde PII-detectie: Ingebouwde classificatiemodellen scannen alle verbonden bronnen, labelen gevoelige velden en bevelen automatisch maskeringsbeleid aan of passen dit toe.
- Agentisch TDM: Een AI-gestuurde mogelijkheid die testgevallen leest en autonoom conforme datasets samenstelt die klaar zijn voor provisioning, zonder handmatige configuratie.
Integraties van K2View-testdatabeheer
K2View biedt ingebouwde verbindingsmodules voor Oracle, SQL Server, PostgreSQL, DB2, MongoDB, Snowflake, Salesforce, Amazon S3, Kafka en mainframesystemen. REST-, JDBC- en ODBC-connectiviteit ondersteunt aangepaste integraties en CI/CD-werkstromen met Jenkins, GitHub Actions en Azure DevOps.
Pros and Cons
Pros:
- Maskering tijdens de gegevensstroom voorkomt blootstelling van ongemaskeerde PII
- Entiteitsgerichte subsetting omvat mainframe en cloud
- Geautomatiseerde PII-detectie ingebouwd in het platform
Cons:
- Niet ontworpen voor kleine teams
- Voor API-gebaseerde CI/CD-integratie is configuratie vereist
Learn more about K2View Test Data Management: Beste subsetselectie over meerdere databases in gereguleerde sectoren
- Gratis demo beschikbaar
- Prijzen op aanvraag

IBM InfoSphere Optim helpt u snel testgegevens te maken. IBM Test Data Management is een oplossing voor testgegevensbeheer voor ondernemingen die gegevensmaskering, subsetselectie over meerdere databases en gegevensvoorziening op aanvraag omvat voor een breed scala aan relationele en mainframegegevensbronnen.
Voor wie is IBM Test Data Management het meest geschikt?
IBM Test Data Management is zeer geschikt voor grote ondernemingen in gereguleerde sectoren—financiële dienstverlening, gezondheidszorg en verzekeringen—met complexe omgevingen met meerdere databases of mainframes, waar gegevensmaskering en subsetselectie over meerdere databases nalevingsvereisten zijn.
Waarom ik IBM Test Data Management heb gekozen
IBM Test Data Management staat in mijn selectie vanwege de manier waarop het subsetselectie over meerdere databases op het niveau van bedrijfsobjecten afhandelt, waarbij het tegelijkertijd referentieel intacte subsets uit meerdere verbonden databases haalt. Ik ben vooral onder de indruk van de federatieve extractiemogelijkheid, waarmee teams kunnen werken in heterogene gegevenslandschappen, inclusief mainframebronnen zoals VSAM en IMS, waar vrijwel geen concurrerend hulpmiddel actief is. De meer dan 40 vooraf gedefinieerde maskeringsregels met uitvoer die de indeling behoudt, maken het echt nuttig in omgevingen die onder de GDPR en HIPAA vallen.
Belangrijkste functies van IBM Test Data Management
- Integratie met Governance Catalog: Sleep gegevensclassificatieregels rechtstreeks naar kolomtoewijzingen om automatisch maskeringsroutines toe te wijzen vanuit een centrale beleidscatalogus.
- Apache Spark-uitvoeringsomgeving: Een ingebouwde Spark-engine verwerkt grote hoeveelheden gegevens binnen geautomatiseerde workflows voor subsetselectie en maskering.
- Op rollen gebaseerde toegangscontrole: RBAC op basis van Keycloak, met ondersteuning voor LDAP, SAML, OIDC en Kerberos, bepaalt wie toegang heeft tot testgegevenssets, deze kan aanvragen en vernieuwen.
- Nalevingsrapportage: Ingebouwde rapportage valideert de handhaving van privacybeleid voor gegevens in omgevingen die onder de GDPR en HIPAA vallen.
Integraties van IBM Test Data Management
Gedocumenteerde integraties omvatten IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark en databases zoals Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza en beperkte ondersteuning voor MongoDB. De OpenAPI 2.0 REST API ondersteunt aangepaste orkestratie en CI/CD-werkstromen, terwijl de z/OS-editie verbinding maakt met VSAM en IMS.
Pros and Cons
Pros:
- Behoudt referentiële integriteit tussen databases
- Maskering met behoud van indeling ondersteunt gereguleerde gegevens
- Verwerkt subsets van VSAM en IMS
Cons:
- Geen systeemeigen generatie van synthetische gegevens
- Fysieke kopieën in plaats van virtueel klonen
Learn more about IBM Test Data Management: Meest geschikt voor maskering in pipelines met meerdere databases
- Gratis demo beschikbaar
- Prijs op aanvraag

Met Tonic.ai kunnen gebruikers regels voor gegevensmaskering voor databasetabellen beheren. Tonic.ai is een platform voor testgegevensbeheer dat het maskeren en subsetten van gestructureerde gegevens, het redigeren van ongestructureerde gegevens en het volledig synthetisch genereren van gegevens ondersteunt voor relationele databases, NoSQL-opslag en clouddatawarehouses.
Voor wie is Tonic.ai het meest geschikt?
Tonic.ai is zeer geschikt voor data-engineers en databasebeheerders die testgegevens beheren in complexe omgevingen met meerdere databases, waaronder relationele databases, NoSQL-opslag en clouddatawarehouses.
Waarom ik voor Tonic.ai heb gekozen
Ik heb Tonic.ai geselecteerd als een van de beste oplossingen omdat de deterministische maskeerengine consistente gemaskeerde waarden toepast voor dezelfde invoer in PostgreSQL, MongoDB, Snowflake en elke andere bron in uw pipeline, allemaal tegelijk. Dat betekent dat een klant-ID die in uw relationele database wordt gemaskeerd, overeenkomt met dezelfde gemaskeerde waarde in uw datawarehouse en documentopslag, waardoor joins tussen systemen intact blijven. De gepatenteerde subset-engine versterkt dit door referentieel coherente gegevenssegmenten te extraheren. Zo kon eBay een dataset van 8 PB terugbrengen tot een schone testomgeving van 1 GB zonder relaties tussen tabellen te verbreken.
Belangrijkste functies van Tonic.ai
- Geautomatiseerde PII/PHI-detectie: Scant verbonden gegevensbronnen, detecteert gevoelige velden en beveelt maskeringstransformaties aan zonder handmatige toewijzing van kolom tot kolom.
- Tonic Ephemeral: Start databases op aanvraag en geïsoleerd binnen CI/CD-pipelines met behulp van rechtstreekse DNS-verbindingen en verwijdert ze vervolgens automatisch na het uitvoeren van tests.
- Detectie van schemainstellingen: Identificeert nieuwe of gewijzigde kolommen en kan het genereren van gegevens automatisch blokkeren om onbedoeld lekken van PII naar testomgevingen te voorkomen.
- Generatorvoorinstellingen: Hiermee kunt u benoemde masker- en transformatieregels opslaan en opnieuw gebruiken in alle werkruimten, zodat maskeringsbeleid op grote schaal consistent blijft.
Integraties van Tonic.ai
Tonic.ai biedt een native integratie met GitHub Actions en daarnaast REST API-connectiviteit voor Jenkins en GitLab CI. Het maakt verbinding met PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, DynamoDB, Snowflake, BigQuery, Redshift en Databricks.
Pros and Cons
Pros:
- Gepatenteerde subset-engine behoudt referentiële integriteit
- Deterministische maskering op meerdere databaseplatforms
- Geautomatiseerde PII-detectie met AI-aanbevelingen
Cons:
- Geen native ondersteuning voor mainframegegevensbronnen
- De initiële configuratie kan complex zijn voor ondernemingen
Learn more about Tonic.ai: Het beste voor visueel, op dekking gericht gegevensontwerp
- 14 dagen gratis proefversie
- Prijs op aanvraag

Curiosity Software visualiseert gegevensrelaties via een radiaal partitiediagram. Curiosity Software is een platform voor testgegevensbeheer dat gegevensmaskering, het genereren van synthetische gegevens, subsetselectie, virtualisatie en selfserviceprovisioning combineert voor meer dan 250 bronintegraties, waaronder mainframesystemen zoals VSAM, IMS en CICS.
Voor wie is Curiosity Software het meest geschikt?
Curiosity Software is geschikt voor QA-teams en data-engineers binnen ondernemingen die werken in complexe omgevingen met meerdere bronnen, vooral voor teams die mainframesystemen ondersteunen of op grote schaal compliancegedreven testgegevens beheren.
Waarom ik voor Curiosity Software heb gekozen
Ik heb Curiosity Software geselecteerd als een van de beste oplossingen, omdat de op dekking gerichte benadering van gegevensontwerp het platform echt onderscheidt. In plaats van handmatig regels voor testgegevens te scripten, bouw je visuele gegevensstroommodellen die bedrijfslogica en beperkingen vastleggen. Het platform identificeert automatisch hiaten in de dekking en genereert synthetische gegevens om deze op te vullen. Ik vind het hulpmiddel 'Vinden en maken' bijzonder nuttig: het zoekt bestaande gegevens die je tests nodig hebben en genereert alleen gerichte synthetische records waar nog hiaten zijn, zodat je nooit te veel gegevens beschikbaar stelt of zonder inzicht werkt.
Belangrijkste functies van Curiosity Software
- Geautomatiseerde PII-detectie: Scant verbonden gegevensbronnen om gevoelige velden automatisch te vinden en te markeren voordat gegevens beschikbaar worden gesteld aan niet-productieomgevingen.
- Selfserviceportal voor provisioning: Via een webgebaseerd portaal kunnen teams op aanvraag testgegevens aanvragen en beschikbaar stellen met behulp van geparametriseerde, herbruikbare taken, zonder het testgegevensteam in te schakelen.
- Integratie met CI/CD-pijplijnen: Testgegevenstaken kunnen dynamisch via API worden geactiveerd vanuit Jenkins, GitLab, GitHub, Azure DevOps en Bitbucket voor just-in-time-levering van gegevens.
- Op grafieken gebaseerde gegevenslineage: Slaat traceerbaarheids- en relatiegegevens tussen bronnen op met Neo4j en produceert visuele pijplijnweergaven die externe sleutels, joins en verweesde verwijzingen zichtbaar maken.
Integraties van Curiosity Software
Curiosity Software biedt meer dan 250 integraties, waaronder Oracle, SQL Server, Snowflake, Salesforce, VSAM, IMS, Jenkins, GitHub, GitLab en Azure DevOps. De API's ondersteunen aangepaste integraties en just-in-time-levering van testgegevens die door CI/CD worden geactiveerd in cloud-, on-premises- en hybride omgevingen.
Pros and Cons
Pros:
- Visueel, op modellen gebaseerd ontwerp van testgegevens
- Maskering en subsetselectie van mainframegegevens inbegrepen
- Geautomatiseerde PII-detectie met compliancegedreven functies
Cons:
- Opties voor subsetselectie minder gedetailleerd beschreven in de documentatie
- Geen gepubliceerde SOC 2- of ISO 27001-certificeringen
Learn more about Curiosity Software: Ideaal voor het klonen van databases in Git-stijl voor vijf engines
- Gratis demo beschikbaar
- Prijs op aanvraag

Met Redgate SQL Provision kunnen gebruikers databaseklonen in meerdere SQL-instanties beheren. Redgate SQL Provision is een beheertool voor testgegevens die gegevensmaskering, subsets en databaseklonen in Git-stijl omvat voor SQL Server, PostgreSQL, MySQL, MariaDB en Oracle.
Voor wie is Redgate SQL Provision het meest geschikt?
Redgate SQL Provision is zeer geschikt voor databasebeheerders en QA-testengineers die snel databases willen klonen en maskeren met versiebeheer voor meerdere relationele engines.
Waarom ik voor Redgate SQL Provision heb gekozen
Ik heb Redgate SQL Provision geselecteerd als een van de beste oplossingen, omdat het klonen van databases in Git-stijl echt anders is dan alles wat ik voor vijf engines heb gezien. Redgate Clone start binnen enkele seconden een live gegevenscontainer op, ongeacht de grootte van de database, waardoor een SQL Server-database van 5 TB even snel wordt ingericht als een database van 128 MB. Je kunt revisies vertakken, terugzetten en opslaan zoals in een Git-workflow. Daardoor kun je elke tester eenvoudig een eigen geïsoleerde omgeving geven zonder opslag te dupliceren.
Belangrijkste functies van Redgate SQL Provision
- Anonimiseer-CLI (
rganonymize): Een opdrachtregelprogramma in drie stappen dat PII-kolommen classificeert, maskeringsregels toewijst en echte waarden vervangt in SQL Server, PostgreSQL, MySQL, MariaDB en Oracle. - Deterministische maskering: Maskeert dezelfde invoerwaarde elke keer naar dezelfde uitvoer met behulp van een vaste beginwaarde, zodat gemaskeerde gegevens consistent blijven in gerelateerde tabellen.
- Gegevenssubset: De
rgsubset-CLI haalt een configureerbaar deel van je brondatabase op — standaard 10% — en volgt daarbij vreemde sleutels om de referentiële integriteit te behouden. - Aangepaste AI-gegevenssets: Hiermee kun je in gewone taal de benodigde waarden beschrijven. Vervolgens wordt een controleerbare lijst met maximaal 1.000 waarden gegenereerd voor gebruik bij vervanging tijdens het maskeren.
Integraties van Redgate SQL Provision
Redgate SQL Provision integreert met SQL Server, PostgreSQL, MySQL, MariaDB, Oracle, Docker, AWS CloudFormation, Azure Kubernetes Service, SQL Data Catalog, PowerShell en dbatools. De CLI's ondersteunen gescripte CI/CD-workflows, maar native plug-ins voor Jenkins, Azure DevOps en GitHub Actions zijn niet gedocumenteerd.
Pros and Cons
Pros:
- Vertakkingen in Git-stijl vernieuwen testdatabases snel
- Deterministische maskering behoudt consistentie tussen tabellen
- Subsets op basis van vreemde sleutels beschermen de relationele integriteit
Cons:
- Het genereren van synthetische gegevens stopt bij waardelijsten
- De positionering van het product zorgt voor onzekerheid bij kopers
Learn more about Redgate SQL Provision:
Andere tools voor testgegevensbeheer
Hier zijn enkele aanvullende opties voor tools voor testgegevensbeheer die niet in mijn selectie zijn opgenomen, maar toch het bekijken waard zijn:
- 11Perforce DelphixIdeaal voor het virtualiseren van volledige kopieën van productiedatabases
- 12SynthesizedHet beste voor SAP-eigen maskering van testgegevens
- 13Tricentis ToscaBeste voor AI-aangedreven testen
- 14InformaticaHet beste voor testen op ondernemingsniveau
- 15BMC CompuwareBeste voor direct testen
- 16Rocket Data ExpressHet beste voor het besparen van testresources
- 17Accelario Continuous DataOps PlatformHet meest geschikt voor door CI/CD geactiveerde databasevirtualisatie
- 18Avo Test Data ManagementHet beste voor het snel en betrouwbaar genereren van testgegevens
- 19SynthoBeste voor privacygerichte synthetische gegevensgeneratie
- 20IRI VoracityHet beste voor het gezamenlijk maskeren van gestructureerde en onzichtbare gegevens
Hoe ik tools voor testgegevensbeheer beoordeel
Ik bekijk deze tools op twee niveaus: de kernmogelijkheden—maskering, subsetselectie, CI/CD-provisioning—die een tool moet hebben om in aanmerking te komen, en de onderscheidende factoren die de ene tool geschikter maken dan de andere.
Kernfunctionaliteit (Basisvereisten voor deze lijst)
Wanneer ik tools voor mijn lijst selecteer, beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde kernfunctionaliteit. Vervolgens zet ik de totaalscore van de tool om in een percentage. Elke tool moet een minimale totaalscore van 65% behalen om voor opname in aanmerking te komen.
- Gegevensmaskering & anonimisering: Ik controleer of een tool PII in gekoppelde tabellen consistent kan maskeren—bijvoorbeeld door echte namen in een bestellingentabel te vervangen en dezelfde gemaskeerde waarde in de klantentabel te behouden.
- Synthetische gegevensgeneratie: Het genereren van nepgegevens die realistisch zijn en de referentiële integriteit behouden, is hierbij belangrijk, vooral voor teams die vanwege privacyregelgeving geen productiegegevens kunnen gebruiken.
- Gegevenssubsetselectie: Ik kijk hoe goed een tool een kleiner deel uit een productiedatabase extraheert en daarbij de relaties tussen externe sleutels intact houdt in tientallen of honderden gerelateerde tabellen.
- Ondersteuning voor databases uit meerdere bronnen: Een tool moet verbinding kunnen maken met de databases die je team daadwerkelijk gebruikt—Oracle, PostgreSQL, SQL Server, MongoDB, mainframebronnen, platte bestanden—zonder dat voor elke bron aangepaste scripts nodig zijn.
- Testgegevensprovisioning & selfservice: Ik beoordeel of QA-engineers en ontwikkelaars zelfstandig datasets kunnen aanvragen, vernieuwen of resetten via een portaal of API, in plaats van tickets bij een DBA in te dienen.
- CI/CD- & automatiseringsintegratie: De tool moet aansluiten op je bestaande pijplijn—Jenkins, GitLab CI, Azure DevOps—zodat het provisionen van gegevens automatisch samen met bouwprocessen en testreeksen wordt uitgevoerd.
Zodra ik een lijst heb met tools die aan de criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (Waarin leveranciers zich onderscheiden)
Zo vergelijk ik verschillende leveranciers:
Opvallende functies
Gegevensvirtualisatie is een belangrijke factor—ik zoek naar tools die lichte klonen vanuit één gouden kopie kunnen starten, zodat teams niet uren hoeven te wachten op nieuwe omgevingen. AI-gestuurde gegevensdetectie is ook belangrijk, omdat het handmatig labelen van PII in honderden kolommen tijdrovend en foutgevoelig is. Tools die gevoelige velden automatisch classificeren, besparen veel tijd bij het instellen van maskeringsbeleid. Ik controleer ook of er ingebouwde compliancerapportage met audittrailregistratie aanwezig is, vooral voor teams die onderworpen zijn aan GDPR- of HIPAA-beoordelingen, waarbij het essentieel is om aan te tonen dat gegevens correct zijn gemaskeerd voordat ze een testomgeving bereiken.
Meer dan functies
Flexibiliteit bij de implementatie is iets wat ik altijd beoordeel—of een tool lokale, cloud- of hybride hosting ondersteunt, is belangrijk wanneer beleid voor gegevensresidentie bepaalt waar kopieën van productiegegevens mogen worden opgeslagen. Beveiligingscertificeringen zoals SOC 2 Type II en ISO 27001 wegen ook mee, omdat deze tools dagelijks omgaan met gevoelige productiegegevens. Ik controleer ook de schaalbaarheid, met name hoe maskerings- en subsetselectietaken presteren op databases van terabyteschaal met complexe schema's. Een tool die prima werkt met een ontwikkelingsvoorbeeld maar vastloopt in de acceptatieomgeving, is niet geschikt voor grote organisaties.
Een tool voor testgegevensbeheer kiezen
Het is gemakkelijk om verstrikt te raken in lange lijsten met functies en complexe prijsstructuren. Om je te helpen gefocust te blijven tijdens je unieke softwareselectieproces, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waar je op moet letten |
|---|---|
| FactorSchaalbaarheid | Waar je op moet lettenGroeit de tool mee met je team? Houd rekening met toekomstige gegevensvolumes en gebruikersgroei. Zoek naar flexibele abonnementen die schaalvergroting mogelijk maken zonder aanzienlijke kostenstijgingen. |
| FactorIntegraties | Waar je op moet lettenWerkt de tool met je bestaande systemen? Controleer de compatibiliteit met je huidige testtools, databases en werkstromen om verstoringen te voorkomen. |
| FactorAanpasbaarheid | Waar je op moet lettenKun je de tool aanpassen aan je behoeften? Beoordeel of de tool aangepaste gegevenssjablonen en werkstromen ondersteunt die aansluiten op je processen. |
| FactorGebruiksgemak | Waar je op moet lettenIs de tool gebruiksvriendelijk voor je team? Houd rekening met de leercurve en of niet-technische medewerkers de tool gemakkelijk kunnen gebruiken zonder uitgebreide training. |
| FactorImplementatie en ingebruikname | Waar je op moet lettenHoe snel kun je aan de slag? Zoek naar tools met een snelle installatie, trainingsmateriaal en ondersteuning om een soepele overgang te garanderen. |
| FactorKosten | Waar je op moet lettenPast de tool binnen je budget? Vergelijk prijsmodellen en controleer of er geen verborgen kosten zijn. Kijk of er een gratis proefperiode of demo beschikbaar is om de tool te testen voordat je je vastlegt. |
| FactorBeveiligingsmaatregelen | Waar je op moet lettenHoe beschermt de tool je gegevens? Zorg ervoor dat de tool voldoet aan beveiligingsstandaarden voor gegevens en versleuteling en toegangsbeheer biedt om gevoelige informatie te beschermen. |
| FactorNalevingsvereisten | Waar je op moet lettenVoldoet de tool aan wettelijke vereisten? Controleer of de tool naleving ondersteunt van relevante regelgeving voor gegevensbescherming, zoals de AVG of HIPAA, afhankelijk van de vereisten binnen jouw sector. |
Wat zijn tools voor testgegevensbeheer?
Tools voor testgegevensbeheer zijn softwareprogramma's die worden gebruikt om gegevens voor softwaretestdoeleinden te genereren, beheren en onderhouden. Ze verwerken het aanmaken en manipuleren van testgegevens en zorgen ervoor dat deze nauwkeurig, veilig en geschikt zijn voor verschillende testsituaties.
Deze tools spelen een essentiële rol bij het organiseren en beschikbaar stellen van gegevens voor functionele tests, prestatietests en regressietests in softwareontwikkeling. Ze werken vaak samen met tools voor databasetests om uitgebreide gegevensvalidatie te garanderen.
Functies
Let bij het selecteren van tools voor testgegevensbeheer op de volgende belangrijke functies:
- Gegevensmaskering: Beschermt gevoelige informatie door deze te vervangen door fictieve gegevens en zorgt zo voor naleving van privacyvoorschriften.
- Gegevenssubsetselectie: Extraheert een subset van gegevens uit grote gegevensverzamelingen, waardoor testen beheersbaarder en efficiënter wordt.
- Integratiemogelijkheden: Maakt verbinding met bestaande testtools en databases en ondersteunt zo soepele werkstromen.
- Aangepaste gegevenssjablonen: Stelt gebruikers in staat sjablonen te maken die zijn afgestemd op hun specifieke testbehoeften, wat de flexibiliteit vergroot.
- Door AI aangestuurde gegevensgeneratie: Gebruikt kunstmatige intelligentie om realistische testgegevens te genereren en de nauwkeurigheid van tests te verbeteren.
- Realtime beschikbaarstelling van gegevens: Biedt direct toegang tot de benodigde testgegevens en vermindert vertragingen in het testproces.
- Ondersteuning voor meerdere clouds: Stelt de tool in staat om in verschillende cloudomgevingen te werken en biedt flexibiliteit bij de implementatie.
- Versleuteling en toegangsbeheer: Garandeert gegevensbeveiliging door gegevens te versleutelen en toegangsrechten voor gebruikers in te stellen.
- Trainingsbronnen: Biedt handleidingen, webinars en ander leermateriaal ter ondersteuning van de introductie van gebruikers en de ingebruikname van de tool.
- Ondersteuning voor naleving: Helpt ervoor te zorgen dat de verwerking van gegevens voldoet aan branchenormen en regelgeving zoals de AVG of HIPAA.
Voordelen
De implementatie van tools voor testgegevensbeheer biedt verschillende voordelen voor je team en je bedrijf. Hier zijn enkele voordelen waar je naar kunt uitkijken:
- Verbeterde gegevensprivacy: Functies voor gegevensmaskering helpen gevoelige informatie te beschermen en zorgen voor naleving van privacyregelgeving.
- Efficiënter testen: Realtime beschikbaarstelling van gegevens vermindert vertragingen, waardoor testcycli sneller verlopen.
- Grotere gegevensnauwkeurigheid: Door AI aangestuurde gegevensgeneratie creëert realistische testgegevens, waardoor de betrouwbaarheid van testresultaten toeneemt.
- Besparingen: Gegevenssubsetselectie extraheert alleen de benodigde gegevens, waardoor opslag- en verwerkingskosten worden verlaagd.
- Flexibiliteit bij implementatie: Ondersteuning voor meerdere clouds zorgt ervoor dat de tool in verschillende omgevingen kan werken en zich aanpast aan je infrastructuurbehoeften.
- Gebruiksvriendelijke introductie: Toegang tot trainingsbronnen en handleidingen ondersteunt een snelle ingebruikname en efficiënt gebruik van de tool.
- Naleving van regelgeving: Functies voor nalevingsondersteuning helpen te voldoen aan branchenormen en verkleinen het risico op juridische problemen.
Kosten & prijzen
Bij het selecteren van tools voor testgegevensbeheer is inzicht nodig in de verschillende beschikbare prijsmodellen en abonnementen. De kosten variëren op basis van functies, teamgrootte, uitbreidingen en meer. De onderstaande tabel geeft een overzicht van veelvoorkomende abonnementen, hun gemiddelde prijzen en de typische functies die in oplossingen voor testgegevensbeheer zijn opgenomen:
Vergelijkingstabel van abonnementen voor tools voor testgegevensbeheer
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Type abonnementGratis abonnement | Gemiddelde prijs$0 | Veelvoorkomende functiesBasisgegevensmaskering, beperkte gegevenssubsetselectie en beperkte integratiemogelijkheden. |
| Type abonnementPersoonlijk abonnement | Gemiddelde prijs$5-$25/gebruiker/maand | Veelvoorkomende functiesVerbeterde gegevensprivacy, door AI aangestuurde gegevensgeneratie en basisondersteuning. |
| Type abonnementZakelijk abonnement | Gemiddelde prijs$30-$75/gebruiker/maand | Veelvoorkomende functiesGeavanceerde gegevenssubsetselectie, ondersteuning voor meerdere clouds en toegang tot trainingsbronnen. |
| Type abonnementBedrijfsabonnement | Gemiddelde prijs$100+/gebruiker/maand | Veelvoorkomende functiesAangepaste gegevenssjablonen, uitgebreide nalevingsondersteuning, premiumklantenondersteuning en volledige integratiemogelijkheden. |
Veelgestelde vragen over tools voor testdatabeheer
Hier volgen antwoorden op veelgestelde vragen over tools voor testdatabeheer:
Moet je kiezen voor functies voor maskering of synthetische gegevens?
Maskering beschermt echte gegevens door persoonlijke gegevens te verbergen. Software die synthetische gegevens genereert maakt nepgegevensverzamelingen die toch realistisch zijn. Kies voor maskering als je productiegegevens gebruikt; kies voor synthetische gegevens als je veiligere, volledig gegenereerde testsets wilt.
Als je nog in de fase “meer testgegevens verzamelen” zit, probeer dan: 10 beste tools voor bruikbaarheidstests voor echte gebruikersfeedback.
Waarom is gegevensbeveiliging belangrijk in TDM-tools?
TDM-software verwerkt vaak gevoelige productiegegevens. Zonder juiste maskering of versleuteling loop je het risico op datalekken of nalevingsproblemen. Kies altijd een tool die versleuteling, anonimisering en toegangscontroles ondersteunt.
Welke integraties moet een TDM-tool ondersteunen?
De tool moet werken met je CI/CD-tools, zoals Jenkins, GitLab of Azure DevOps. Integratie met belangrijke databases (Oracle, SQL Server, PostgreSQL) en cloudplatforms is ook essentieel voor soepele automatisering.
Hoe test je een TDM-tool voordat je deze aanschaft?
Voer een kleinschalige praktijktest uit. Probeer gegevens te klonen, maskeren en vernieuwen in je eigen omgeving. Bekijk hoe snel de tool werkt en of deze in je bestaande workflow past.
Hoe kunnen TDM-tools helpen met naleving?
Goede tools registreren elke wijziging in gegevens, houden auditlogboeken bij en zorgen ervoor dat gemaskeerde gegevens consistent blijven. Zo kan je team blijven voldoen aan regelgeving zoals GDPR, HIPAA of CCPA.