

Met datalaketools kunt u enorme hoeveelheden gestructureerde en ongestructureerde gegevens binnen uw bedrijf opslaan, organiseren en analyseren. Als u de beste datalaketools vergelijkt, kunt u zich geen gok veroorloven: welk platform houdt uw team de controle over kosten, naleving en prestaties naarmate uw gegevens groeien?
In deze gids bespreek ik bewezen opties waarmee IT-leiders beheer, schaalbaarheid, integratie en toekomstbestendigheid kunnen realiseren, zodat u vol vertrouwen de juiste basis voor analyse- en AI-werklasten in 2026 kunt kiezen.
Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Vergelijkingstabel van datalaketools
Deze vergelijkingstabel vat de prijsdetails samen van mijn selectie van de beste datalaketools:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Het beste voor automatisch geoptimaliseerde Apache Iceberg-lakehouses | Gratis proefversie beschikbaar | Vanaf $300/maand (jaarlijks gefactureerd) | Website | |
| 2 | Het beste voor governance van hybride datalakes bij gereguleerde ondernemingen | Gratis proefperiode van 60 dagen beschikbaar | Vanaf $0.04/CCU/uur | Website | |
| 3 | Het beste open Iceberg-lakehouse zonder afhankelijkheid van één leverancier | 30-daagse gratis proefperiode | Vanaf $0.20/DCU | Website | |
| 4 | Het beste voor datalakegovernance in gereguleerde sectoren | Gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 5 | Het beste voor beheer via meerdere engines op open lake-tabellen | Gratis proefperiode van 90 dagen | Vanaf $0.12 per DCU-uur | Website | |
| 6 | Het beste voor het delen van gegevens zonder kopiëren tussen clouds | 30 dagen gratis uitproberen | Vanaf $2.00/credit | Website | |
| 7 | Het meest geschikt voor een GCP-native lakehouse met gelaagde opslag | Gratis abonnement beschikbaar | Vanaf $0.020/GB/maand | Website | |
| 8 | Beste voor een lakehouse op basis van open tabelindelingen | 14 dagen gratis proefversie | Vanaf $0.22/DBU | Website | |
| 9 | Het beste voor objectopslag als kern van AWS-datalakes | Niet beschikbaar | Vanaf $0.023/GB/month | Website | |
| 10 | Het meest geschikt voor Microsoft-eigen datalakes voor ondernemingen | $200 tegoed voor 30 dagen (geen speciale gratis laag) | Vanaf $0.023/GB/maand | Website |




Beoordelingen van datalaketools
Hieronder staan mijn gedetailleerde samenvattingen van de beste datalaketools die in mijn selectie zijn opgenomen. In mijn beoordelingen vindt u een gedetailleerd overzicht van de functies, mogelijkheden en beste gebruiksscenario’s van elk platform, zodat u de beste optie voor uw situatie kunt vinden.
 1Het beste voor automatisch geoptimaliseerde Apache Iceberg-lakehouses
Qlik
- Gratis proefversie beschikbaar
- Vanaf $300/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.4/5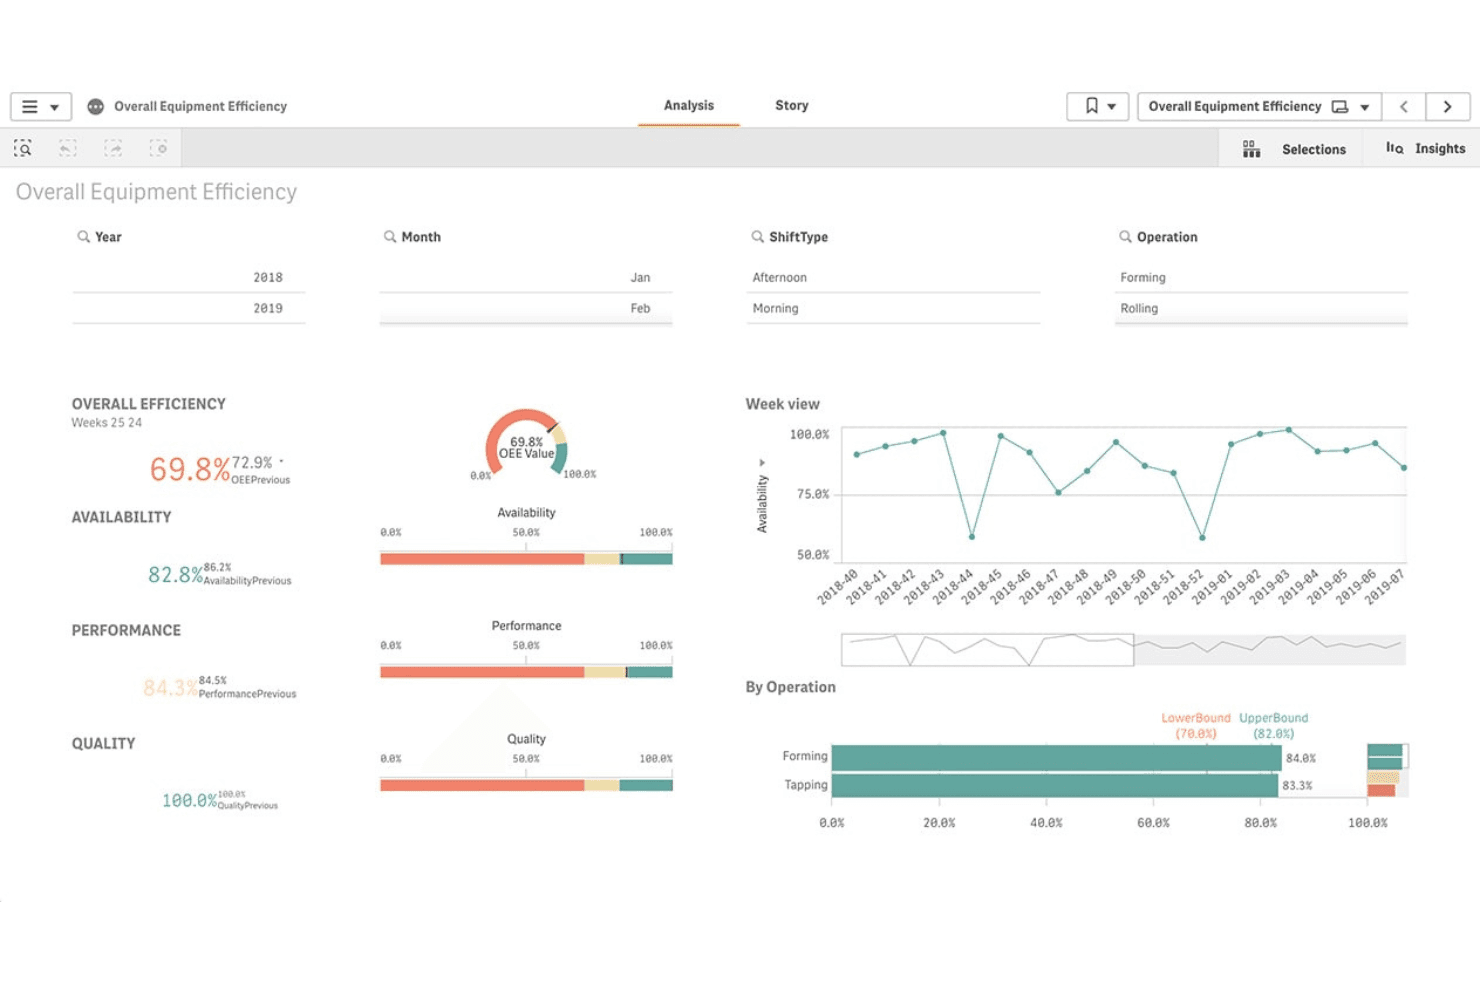
Qlik houdt de algehele effectiviteit van apparatuur bij met realtime KPI-dashboards. Qlik is een platform voor data-integratie en lakehouses, dat native op Apache Iceberg is gebouwd en CDC-gebaseerde opname, geautomatiseerde schema-evolutie, datapijplijnen voor meerdere indelingen en ingebouwde governance combineert voor cloudomgevingen met objectopslag.
Voor wie is Qlik het meest geschikt?
Qlik is zeer geschikt voor grote ondernemingen in gereguleerde sectoren die behoefte hebben aan data-integratie van begin tot eind, governance en lakehousebeheer op één platform.
Waarom ik voor Qlik koos
Ik koos voor Qlik omdat de adaptieve Iceberg-optimalisatie het platform onderscheidt: deze voert continu verdichting, indexering en het opschonen van snapshots uit op je Iceberg-tabellen, zonder handmatige afstemming. Dit levert 2,5x–5x hogere querysnelheden en tot 50% besparing op opslagkosten op. Ik vertrouw ook op de spiegeling zonder gegevenskopieën om actieve Iceberg-tabellen rechtstreeks naar Snowflake te pushen, zonder gegevens te dupliceren of extra complexiteit aan de pijplijn toe te voegen.
Belangrijkste functies van Qlik
- Loggebaseerde CDC-replicatie: Qlik Replicate legt wijzigingen rechtstreeks vast vanuit transactielogboeken van databases, zonder dat agents nodig zijn. Zo blijven lakegegevens actueel zonder de prestaties van bronsystemen te beïnvloeden.
- Opnamepijplijn voor meerdere indelingen: Neem gegevens op in Parquet, Avro, ORC, JSON en CSV vanuit meer dan 200 bronnen, waaronder databases, SaaS-apps, SAP, mainframes en streamingplatforms zoals Kafka en Kinesis.
- Herkomst op kolomniveau en impactanalyse: Volg gegevens van bron tot gebruik op kolomniveau, zodat je beschikt over een duidelijk audittraject voor governance en nalevingsrapportage.
- Geautomatiseerd beheer van brons-, zilver- en goudzones: Qlik Compose for Data Lakes automatiseert schemageneratie, het aanmaken van Hive-catalogi en continue zone-updates via CDC, waardoor handmatige codering van pijplijnen voor meerlaagse lake-architecturen overbodig wordt.
Qlik-integraties
Qlik ondersteunt meer dan 200 opnamebronnen, waaronder Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP en Salesforce. De Iceberg-tabellen kunnen worden geïntegreerd met Spark, Amazon Athena, Trino, Presto, Databricks, Dremio en Tableau.
Pros and Cons
Pros:
- Automatisch geoptimaliseerd beheer van Apache Iceberg-tabellen
- Geavanceerde realtime loggebaseerde CDC-replicatie
- Diepgaande compliance- en governancecontroles voor ondernemingen
Cons:
- Complex platform met hoge technische vereisten
- Ondoorzichtig proces voor licentie- en kostenramingen
Learn more about Qlik: Het beste voor governance van hybride datalakes bij gereguleerde ondernemingen
- Gratis proefperiode van 60 dagen beschikbaar
- Vanaf $0.04/CCU/uur
Visit WebsiteCustomer Rating:4.1/5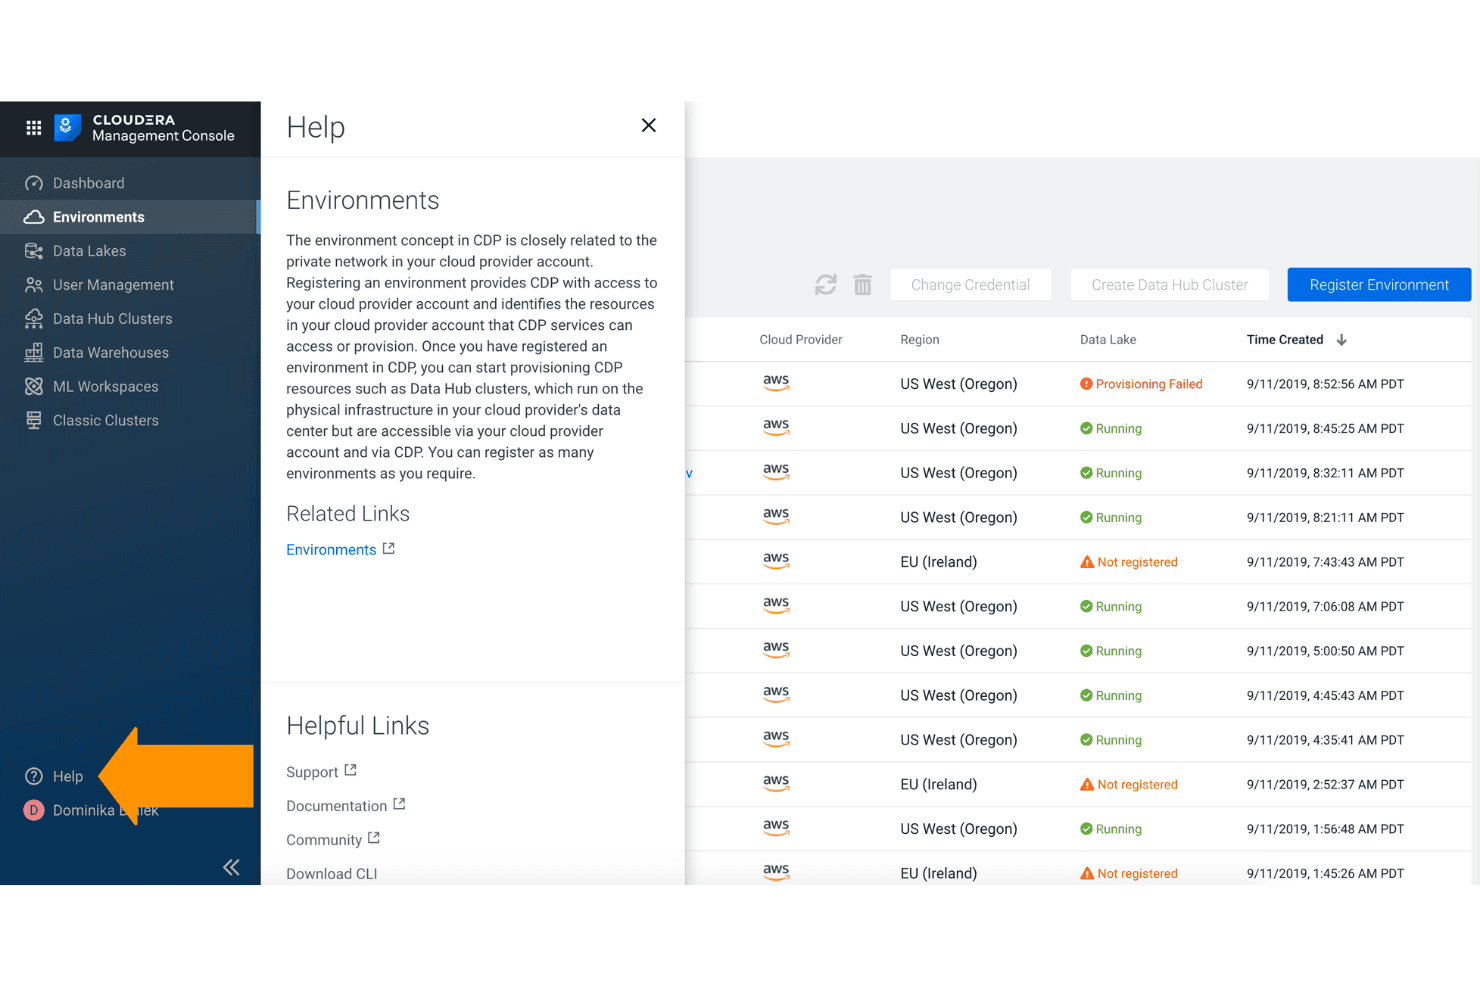
Met Cloudera kunnen gebruikers cloudomgevingen in verschillende regio's beheren en monitoren. Cloudera is een open datalakehouseplatform dat schaalbare opslag in multicloud- en on-premisesomgevingen omvat, data-inname in meerdere indelingen via meer dan 450 connectors, op Apache Iceberg gebaseerde schema-on-read en gecentraliseerde governance in hybride omgevingen.
Voor wie is Cloudera het meest geschikt?
Cloudera is zeer geschikt voor grote ondernemingen in gereguleerde sectoren—banken, overheden en telecombedrijven—die behoefte hebben aan uniforme governance in on-premises- en multicloudomgevingen.
Waarom ik Cloudera heb gekozen
Cloudera staat op mijn lijst omdat geen enkel ander platform kan tippen aan de diepgang van de governance in hybride omgevingen. Ik ben vooral onder de indruk van Cloudera SDX, dat Apache Ranger- en Apache Atlas-beleidsregels één keer toepast en overal afdwingt, ongeacht of je gegevens zich in een on-premises HDFS-cluster, Azure ADLS of AWS S3 bevinden. Banken en overheidsinstanties met een gemengde infrastructuur kunnen regels voor maskering op kolomniveau en ABAC-beleidsregels centraal definiëren, terwijl de certificeringen FedRAMP Moderate en PCI DSS 4.0 het nalevingsverhaal ondersteunen.
Belangrijkste functies van Cloudera
- Tijdreizen met Apache Iceberg: Vraag op elk gewenst moment historische momentopnamen van je gegevens op met behulp van de ingebouwde versiebeheer- en tijdreismogelijkheden van Iceberg.
- Lakehouse-optimalisatie: Automatiseert het compacteren van Iceberg-tabellen, Z-ordering en partition pruning om queryprestaties te verbeteren en computekosten te verlagen.
- Visuele pijplijnbouwer van Cloudera Data Flow (NiFi): Ontwerp en implementeer pijplijnen voor data-inname met een interface voor slepen en neerzetten, met meer dan 450 vooraf gebouwde processors en connectors.
- Gegevens delen zonder kopiëren via de Iceberg REST Catalog: Externe engines zoals Databricks, Snowflake en Athena kunnen rechtstreeks query's uitvoeren op door Cloudera beheerde Iceberg-tabellen, zonder gegevens te verplaatsen of te dupliceren.
Integraties van Cloudera
Cloudera Data Flow biedt meer dan 450 vooraf gebouwde connectors, waaronder Apache Kafka, MongoDB, Salesforce, Snowflake en Google BigQuery. Het integreert ook met AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau en Power BI via de Iceberg REST Catalog.
Pros and Cons
Pros:
- Ondersteuning voor hybride en on-premisesomgevingen is ongeëvenaard
- Governance voor ondernemingen met strenge nalevingsvereisten
- Gegevens delen zonder kopiëren tussen externe query-engines
Cons:
- Voor de initiële configuratie zijn vaak specialistische vaardigheden vereist
- Tevredenheid over metadatabeheer ligt onder het gemiddelde van concurrenten
Learn more about Cloudera: Het beste open Iceberg-lakehouse zonder afhankelijkheid van één leverancier
- 30-daagse gratis proefperiode
- Vanaf $0.20/DCU
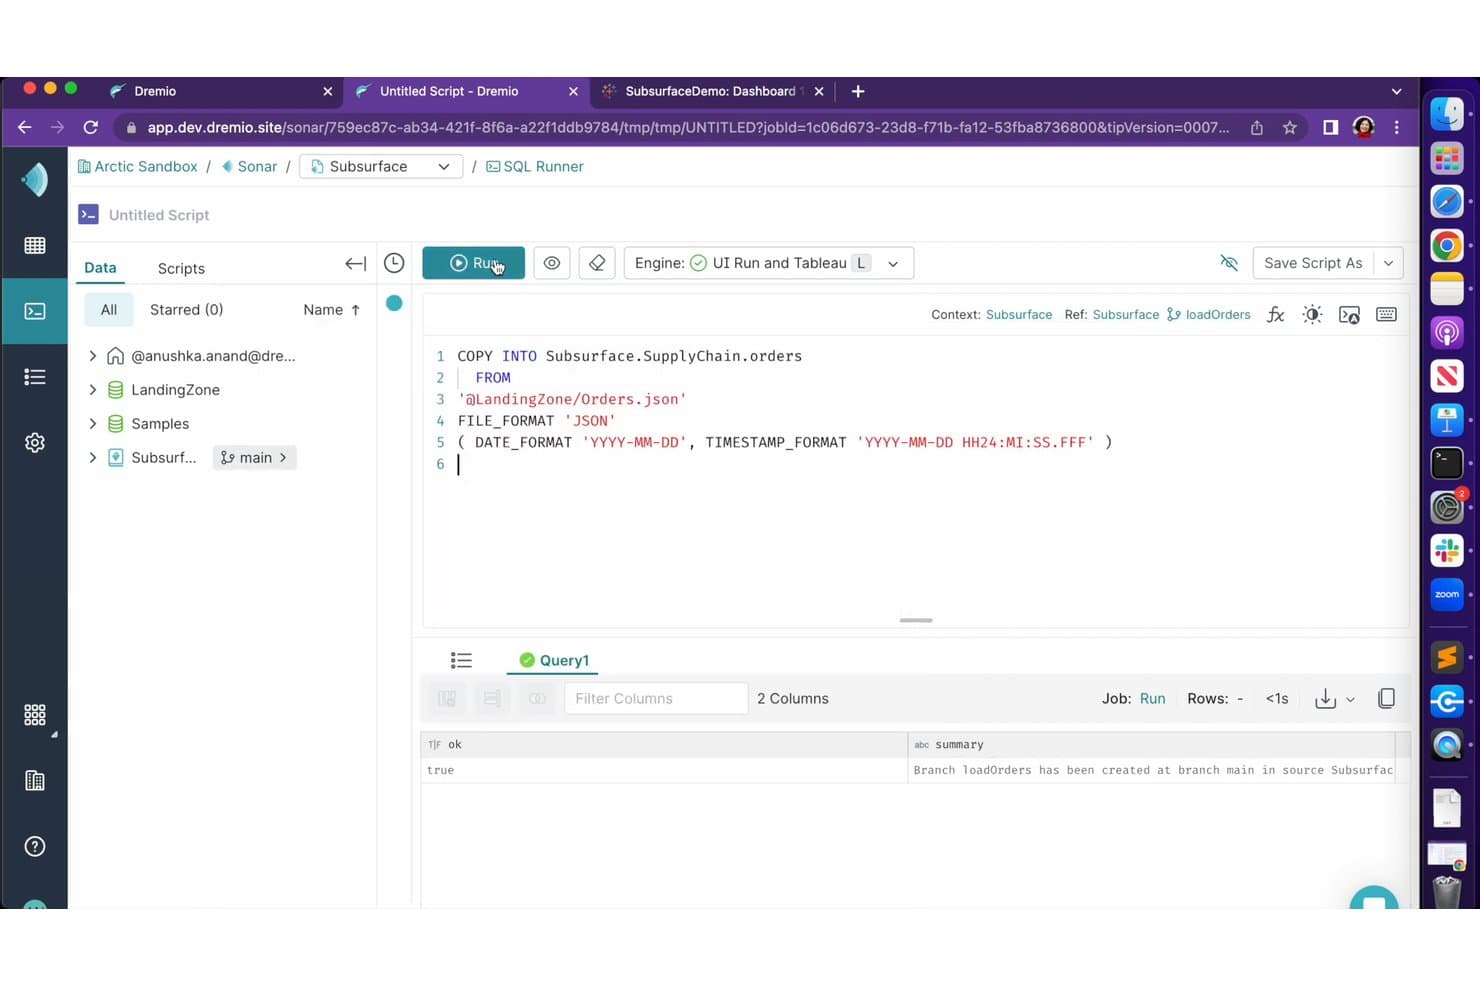
Met Dremio kunnen gebruikers JSON-data in tabellen laden met SQL-opdrachten van het type COPY INTO. Dremio is een open lakehouse-platform dat van nature is gebouwd op Apache Iceberg en Apache Arrow en een SQL-query-engine, gefedereerde gegevenstoegang, geautomatiseerde queryversnelling, Git-stijl dataversiebeheer en een open catalogus voor meerdere engines combineert.
Voor wie is Dremio het meest geschikt?
Dremio is zeer geschikt voor data-engineering- en architectuurteams die open lakehouses op Apache Iceberg bouwen en toegang tot queries vanuit meerdere engines nodig hebben, zonder vast te zitten aan een bedrijfseigen catalogus of opslagindeling.
Waarom ik Dremio heb gekozen
Dremio staat op mijn shortlist omdat het van nature is gebouwd op Apache Iceberg. Dat betekent dat je data in je eigen S3- of ADLS-buckets blijft staan en dat elke engine (Spark, Flink, Trino, DuckDB) deze via de open Polaris-catalogus kan lezen en schrijven zonder indelingsconversie. Vooral Autonomous Reflections spreekt me aan: deze functie observeert querypatronen stilletjes en materialiseert op de achtergrond versnellingen, zodat je BI-dashboards snel resultaten opleveren zonder handmatige afstemming of bedrijfseigen extracties.
Belangrijkste functies van Dremio
- Open catalogus (Apache Polaris): Een catalogus voor meerdere engines, gebouwd op Apache Polaris, waarmee Spark, Flink, Trino en DuckDB Iceberg-tabellen kunnen lezen en schrijven via een standaard-REST-API.
- Vertakkingen voor data als code: Git-stijl versiebeheer via Project Nessie maakt geïsoleerde datavertakkingen zonder gegevenskopieën mogelijk voor ontwikkeling, testen en ML-experimenten, met atomaire samenvoegingen en terugdraaiingen.
- Inname met COPY INTO: Een native SQL-opdracht die CSV-, JSON- en Parquet-bestanden vanuit objectopslag rechtstreeks in Iceberg-tabellen laadt, met schema-evolutie en partitioneringsverwerking.
- Fijnmazige toegangscontrole: Beveiliging op rijniveau en maskering van kolommen die tijdens het uitvoeren van queries wordt afgedwongen en consistent wordt toegepast op elke engine die de catalogus bevraagt.
Dremio-integraties
Dremio integreert met Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage en Google Cloud Storage. De Polaris REST Catalog-, ODBC-, JDBC- en Arrow Flight-interfaces ondersteunen verbindingen met aangepaste engines en applicaties.
Pros and Cons
Pros:
- Verwerkt Apache Iceberg van nature zonder conversie
- Git-stijl datavertakkingen voor tijdreizen
- Open REST-catalogus verbindt elke query-engine
Cons:
- Complexer beheer dan bij vergelijkbare tools
- Geen speciaal ingebouwde opslag voor ML-functies
Learn more about Dremio: Het beste voor datalakegovernance in gereguleerde sectoren
- Gratis demo beschikbaar
- Prijs op aanvraag
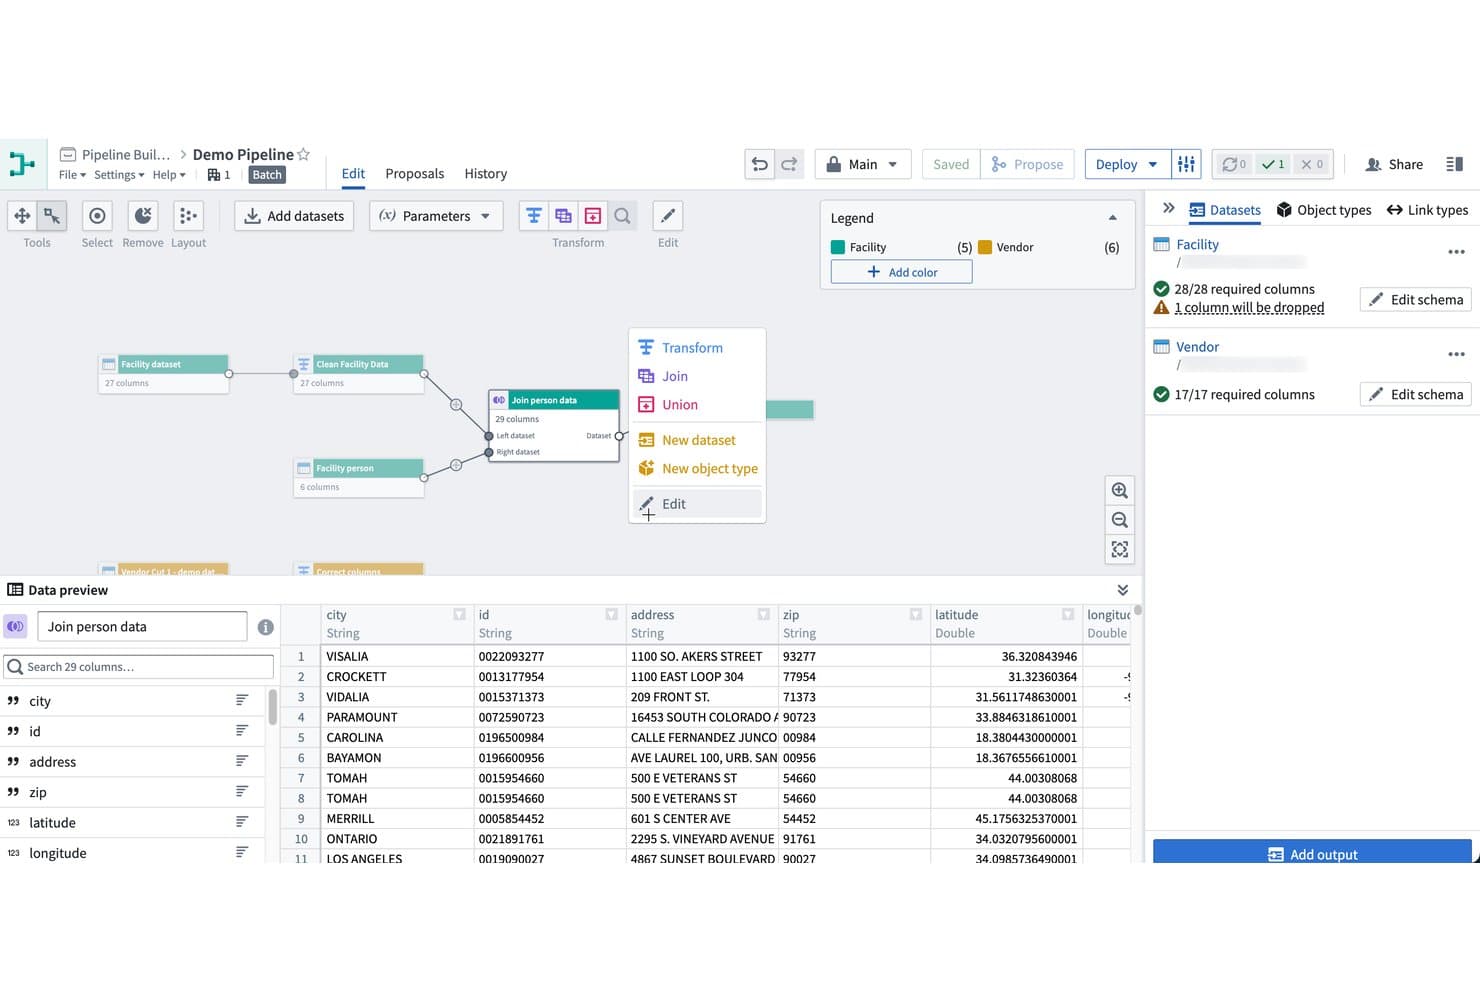
Met Palantir Foundry kunnen gebruikers visueel datasets bouwen en samenvoegen in pijplijnen. Palantir Foundry is een datalakeplatform dat data-inname in meerdere indelingen, orkestratie van pijplijnen, semantische datamodellering via de Ontologie-laag en ingebouwde governancecontroles combineert in cloud-, on-premises- en air-gappedomgevingen.
Voor wie is Palantir Foundry het meest geschikt?
Palantir Foundry is speciaal ontwikkeld voor grote ondernemingen in gereguleerde sectoren—financiën, gezondheidszorg, defensie en overheid—die behoefte hebben aan fijnmazige datagovernance in complexe omgevingen met meerdere bronnen.
Waarom ik voor Palantir Foundry heb gekozen
Ik heb voor Palantir Foundry gekozen omdat de governancearchitectuur ervan in gereguleerde sectoren werkelijk ongeëvenaard is. Het platform combineert doelgebaseerde, classificatiegebaseerde en rolgebaseerde toegangscontroles, met datamarkeringen die automatisch via de gegevensherkomst worden doorgegeven, zodat een PII-label op een brondataset de gegevens door elke daaropvolgende transformatie volgt. Combineer dat met de certificeringen FedRAMP High, HIPAA, ITAR en SOC 2 Type 2, plus de Ontologie-laag die onbewerkte datalakegegevens koppelt aan controleerbare bedrijfsobjecten, en je hebt een platform dat vanaf de basis is ontworpen voor omgevingen waarin governance geen optie maar een vereiste is.
Belangrijkste functies van Palantir Foundry
- Meer dan 200 vooraf gebouwde dataconnectoren: Maak verbinding met databases, datawarehouses, streamingplatforms, ERP-systemen, cloudopslag, IoT-bronnen en georuimtelijke tools via één opname-interface.
- Apache Iceberg REST Catalog: Maak Foundry-datasets beschikbaar voor externe, met Iceberg compatibele rekenengines—waaronder Trino, Spark, Flink, Databricks en Snowflake—zonder gegevens te dupliceren.
- Virtuele tabellen voor federatieve toegang zonder kopiëren: Bevraag externe tabellen in Databricks, Snowflake en S3-compatibele opslag rechtstreeks vanuit Foundry zonder de onderliggende gegevens op te nemen of te verplaatsen.
- AIP-modelstudio: Bouw, train, evalueer en bied ML-modellen aan binnen Foundry, met systeemeigen toegang tot LLMs en ondersteuning voor ontwikkelomgevingen in Python en R.
Integraties van Palantir Foundry
Palantir Foundry biedt meer dan 200 systeemeigen dataconnectoren, waaronder Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau en Power BI. Het ondersteunt ook aangepaste connectiviteit via de S3-compatibele API, Iceberg REST Catalog en virtuele tabellen.
Pros and Cons
Pros:
- Toonaangevende datagovernance voor naleving
- De Ontologie-laag maakt gegevenstoegang voor zakelijke gebruikers mogelijk
- Gegevens delen zonder kopiëren met virtuele tabellen
Cons:
- Hoge contractprijzen met onduidelijke totaalkosten
- Risico op platformafhankelijkheid door bedrijfseigen modellen
Learn more about Palantir Foundry: Het beste voor beheer via meerdere engines op open lake-tabellen
- Gratis proefperiode van 90 dagen
- Vanaf $0.12 per DCU-uur
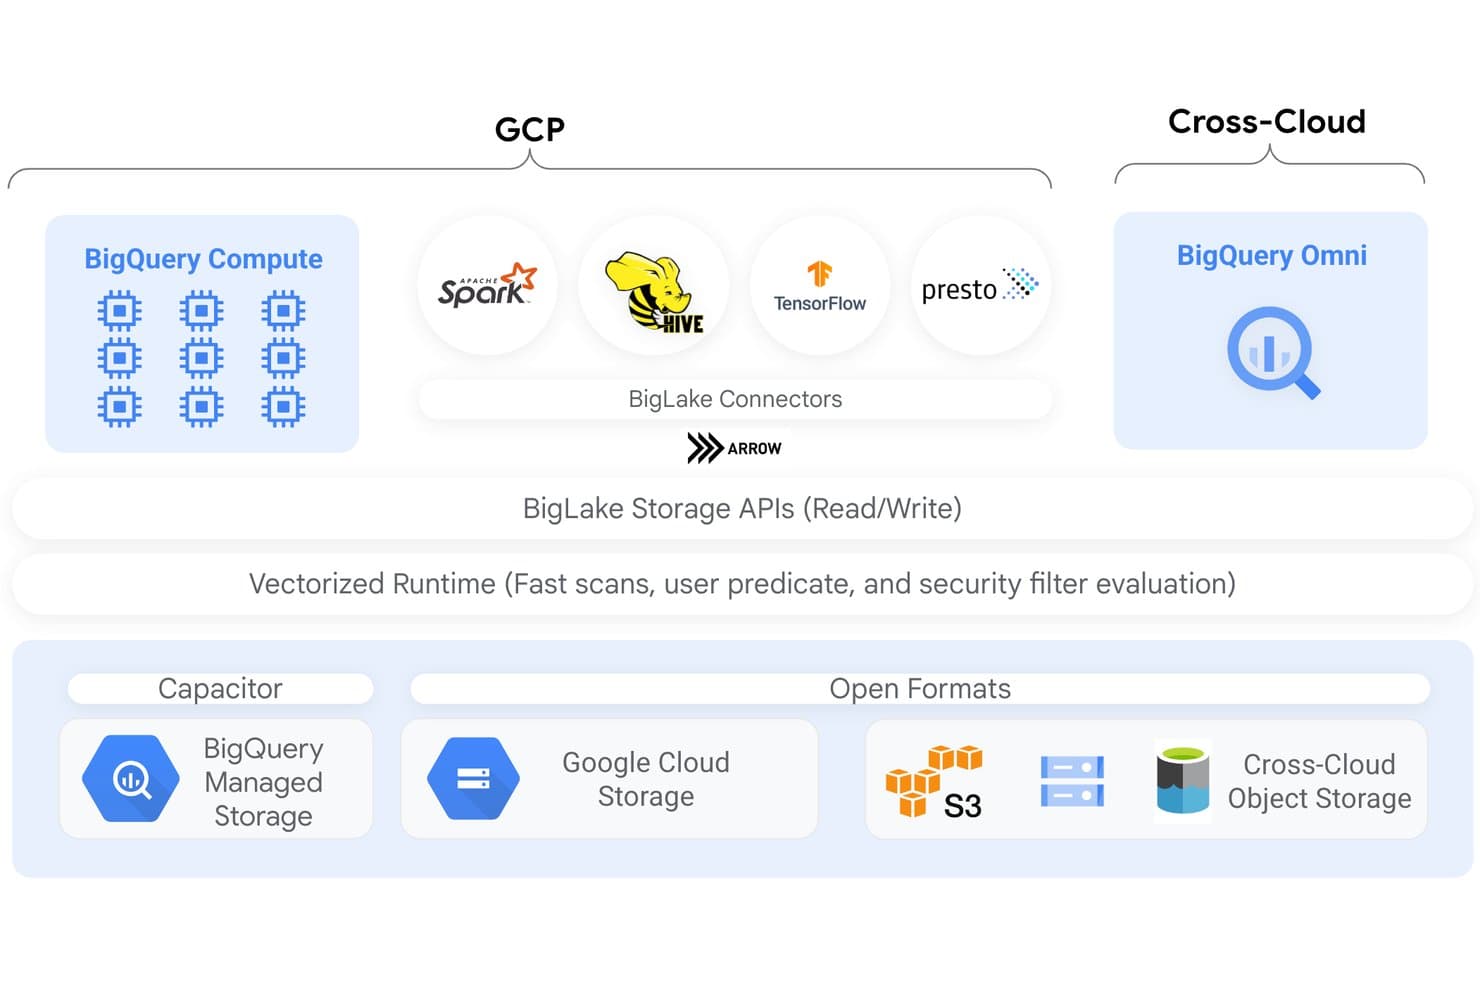
BigLake verenigt rekenkracht en opslag in GCP en omgevingen met meerdere clouds. BigLake is het lakehouseplatform van Google Cloud dat BigQuery uitbreidt met ondersteuning voor tabellen in open indelingen, querytoegang via meerdere engines, uniform metadatabeheer en fijnmazig beheer over GCS, S3 en Azure Blob Storage.
Voor wie is BigLake het meest geschikt?
BigLake is zeer geschikt voor data-engineering- en architectuurteams die al in Google Cloud investeren en behoefte hebben aan consistent beheer over meerdere query-engines en open tabelindelingen.
Waarom ik voor BigLake heb gekozen
Ik heb BigLake gekozen als een van de beste opties, omdat het het enige lakehouseplatform is dat ik heb gezien dat beleid voor toegang op rij- en kolomniveau consequent afdwingt in BigQuery, Spark, Trino en Presto, en niet alleen binnen één engine. Dat betekent dat een beleidstag die op een gevoelige kolom wordt toegepast de gegevens volgt, ongeacht via welke engine je team deze bevraagt. De REST-catalogus voor Lakehouse Iceberg maakt dit mogelijk door als één beheersbewust eindpunt te fungeren voor alle open-source-engines die dezelfde Iceberg-tabellen lezen en schrijven.
Belangrijkste functies van BigLake
- Geautomatiseerd tabelonderhoud: BigLake verzorgt automatisch bestandsverdichting, clustering, afvalverwijdering en het genereren van metagegevens voor Iceberg-tabellen die in GCS zijn opgeslagen.
- Opname in meerdere indelingen: Neem gegevens op in Parquet, ORC, Avro, CSV, JSON en open tabelindelingen zoals Apache Iceberg, Delta Lake en Apache Hudi via manifestbestanden.
- BigQuery Omni-query's in meerdere clouds: Voer BigQuery SQL-query's rechtstreeks uit op gegevens die zijn opgeslagen in Amazon S3 of Azure Data Lake Storage Gen 2, zonder deze naar GCS te verplaatsen.
- Replicatie voor het vastleggen van wijzigingen: Stream operationele gegevens rechtstreeks vanuit Cloud Spanner, AlloyDB en Cloud SQL naar BigLake-tabellen voor analyses met vrijwel realtime gegevens.
Integraties van BigLake
BigLake beschikt over eigen integraties met BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker en Vertex AI. De REST-catalogus voor Iceberg verbindt open-source-engines met gedeelde lake-tabellen.
Pros and Cons
Pros:
- Beveiliging op rij- en kolomniveau die in alle engines wordt afgedwongen
- Open tabelindelingen met volledige ondersteuning voor Iceberg
- Catalogusfederatie voor metadatabeheer in meerdere clouds
Cons:
- DML wordt niet ondersteund voor externe tabellen die geen Iceberg-tabellen zijn
- CMEK niet beschikbaar voor tabellen in S3 of Azure die in de cache zijn opgeslagen
Learn more about BigLake: Het beste voor het delen van gegevens zonder kopiëren tussen clouds
- 30 dagen gratis uitproberen
- Vanaf $2.00/credit
Visit WebsiteCustomer Rating:4.6/5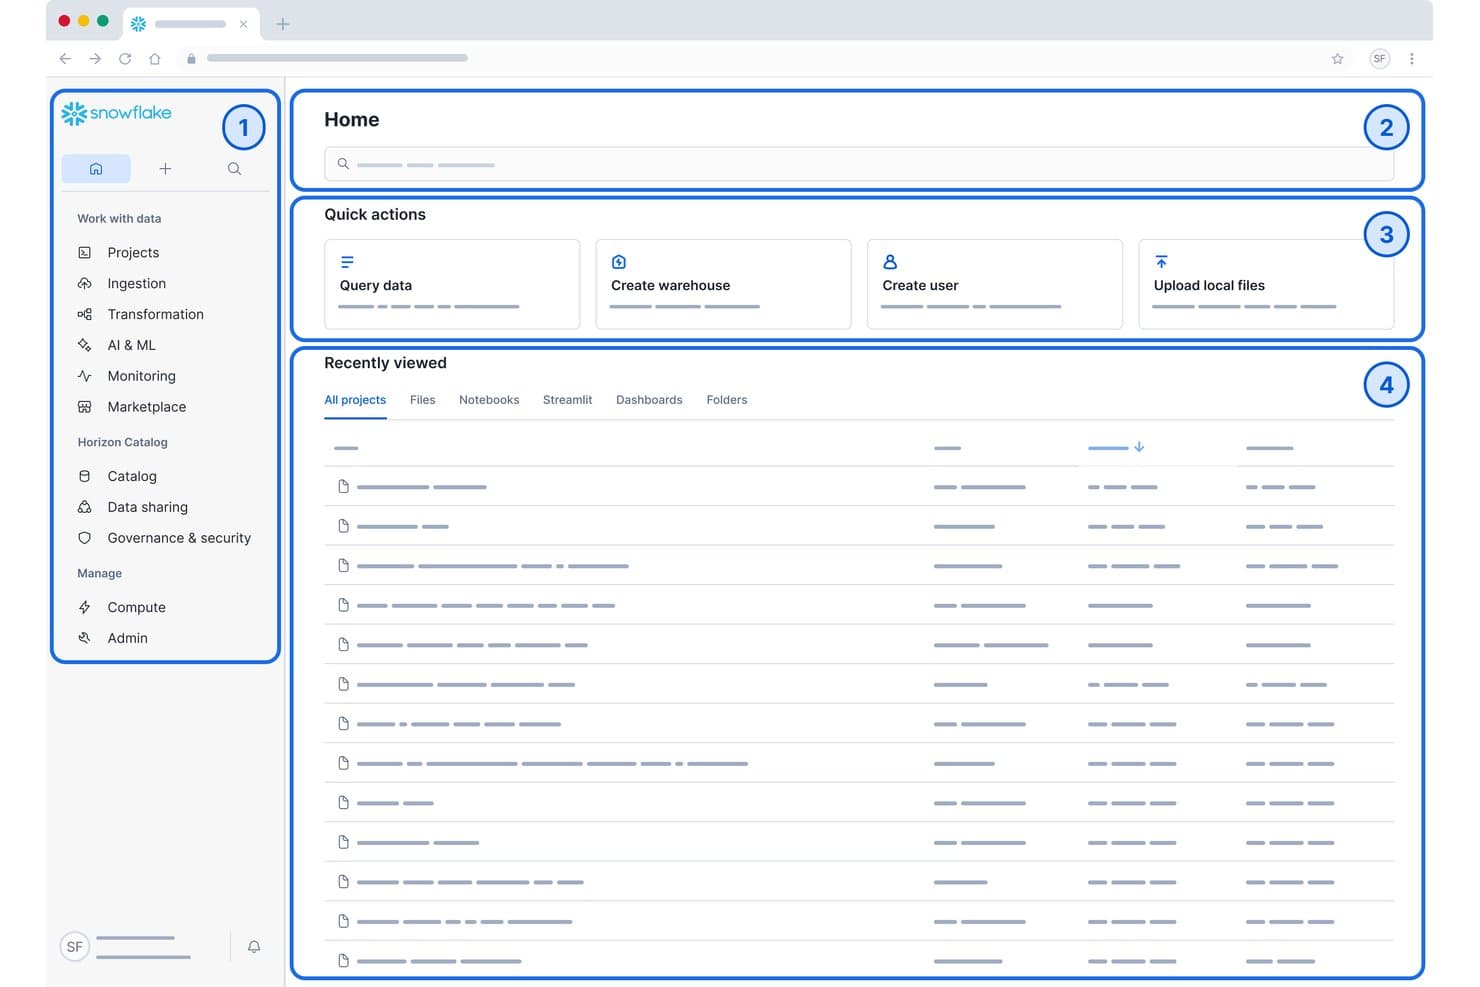
Het startdashboard van Snowflake centraliseert gegevensquery's, het aanmaken van warehouses en recente projecten. Snowflake is een cloudgebaseerd datalake- en analyseplatform dat elastische opslag, een ingebouwde SQL-query-engine, Snowpark voor Python/Java/Scala-werklasten, ondersteuning voor Apache Iceberg en het delen van gegevens zonder kopiëren tussen AWS, Azure en GCP combineert.
Voor wie is Snowflake het meest geschikt?
Snowflake is zeer geschikt voor datateams van grote organisaties die grootschalige omgevingen met meerdere clouds beheren, waarbij governance, naleving van regelgeving en het delen van gegevens tussen organisaties onmisbare vereisten zijn.
Waarom ik voor Snowflake heb gekozen
Snowflake staat op mijn shortlist omdat je met het delen van gegevens zonder kopiëren live datasets kunt delen tussen AWS-, Azure- en GCP-accounts zonder ook maar één byte te dupliceren of te verplaatsen. Ik heb gewerkt met Snowflake Marketplace, dat verbinding maakt met meer dan 820 gegevensleveranciers, en dankzij automatische levering tussen clouds verloopt het delen tussen regio's echt moeiteloos. Combineer dat met native ondersteuning voor Apache Iceberg en Snowpipe Streaming, dat meer dan 1 miljoen transacties per seconde verwerkt, en je krijgt een lakeplatform dat is gebouwd voor de schaal van grote organisaties.
Belangrijkste functies van Snowflake
- Meertalige runtime van Snowpark: Schrijf data-engineering- en ML-werklasten in Python, Java of Scala en voer ze rechtstreeks uit in de query-engine van Snowflake zonder gegevens naar buiten te verplaatsen.
- Ondersteuning voor Apache Iceberg-tabellen: Sla gegevens op en beheer ze in het open Iceberg-tabelformaat op door Snowflake beheerde opslag, met schema-evolutie, Time Travel en interoperabiliteit met Spark, Trino en Flink.
- Horizon Catalog: Een ingebouwde governancelaag met tracering van herkomst op kolomniveau, geautomatiseerde PII-classificatie, door AI ondersteunde verrijking van metagegevens en Data Metric Functions voor continue bewaking van de datakwaliteit.
- Snowpipe Streaming: Neem gegevens op rijniveau in realtime op met meer dan 1 miljoen transacties per seconde, rechtstreeks in Snowflake- of Apache Iceberg-tabellen, zonder vertragingen door batchverwerking.
Integraties van Snowflake
Snowflake biedt native integraties met Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker en Apache Airflow. Het maakt verbinding met Apache Spark, Trino, Amazon S3, Azure Blob Storage en Google Cloud Storage, met API's voor aangepaste integraties.
Pros and Cons
Pros:
- Gegevens delen zonder kopiëren tussen clouds
- Ingebouwde governance en herkomst op kolomniveau
- Elastische scheiding van opslag en rekenkracht
Cons:
- Geen ondersteuning voor implementatie op locatie
- Kosten bijhouden kan lastig zijn
Learn more about Snowflake: Het meest geschikt voor een GCP-native lakehouse met gelaagde opslag
- Gratis abonnement beschikbaar
- Vanaf $0.020/GB/maand
Visit WebsiteCustomer Rating:4.3/5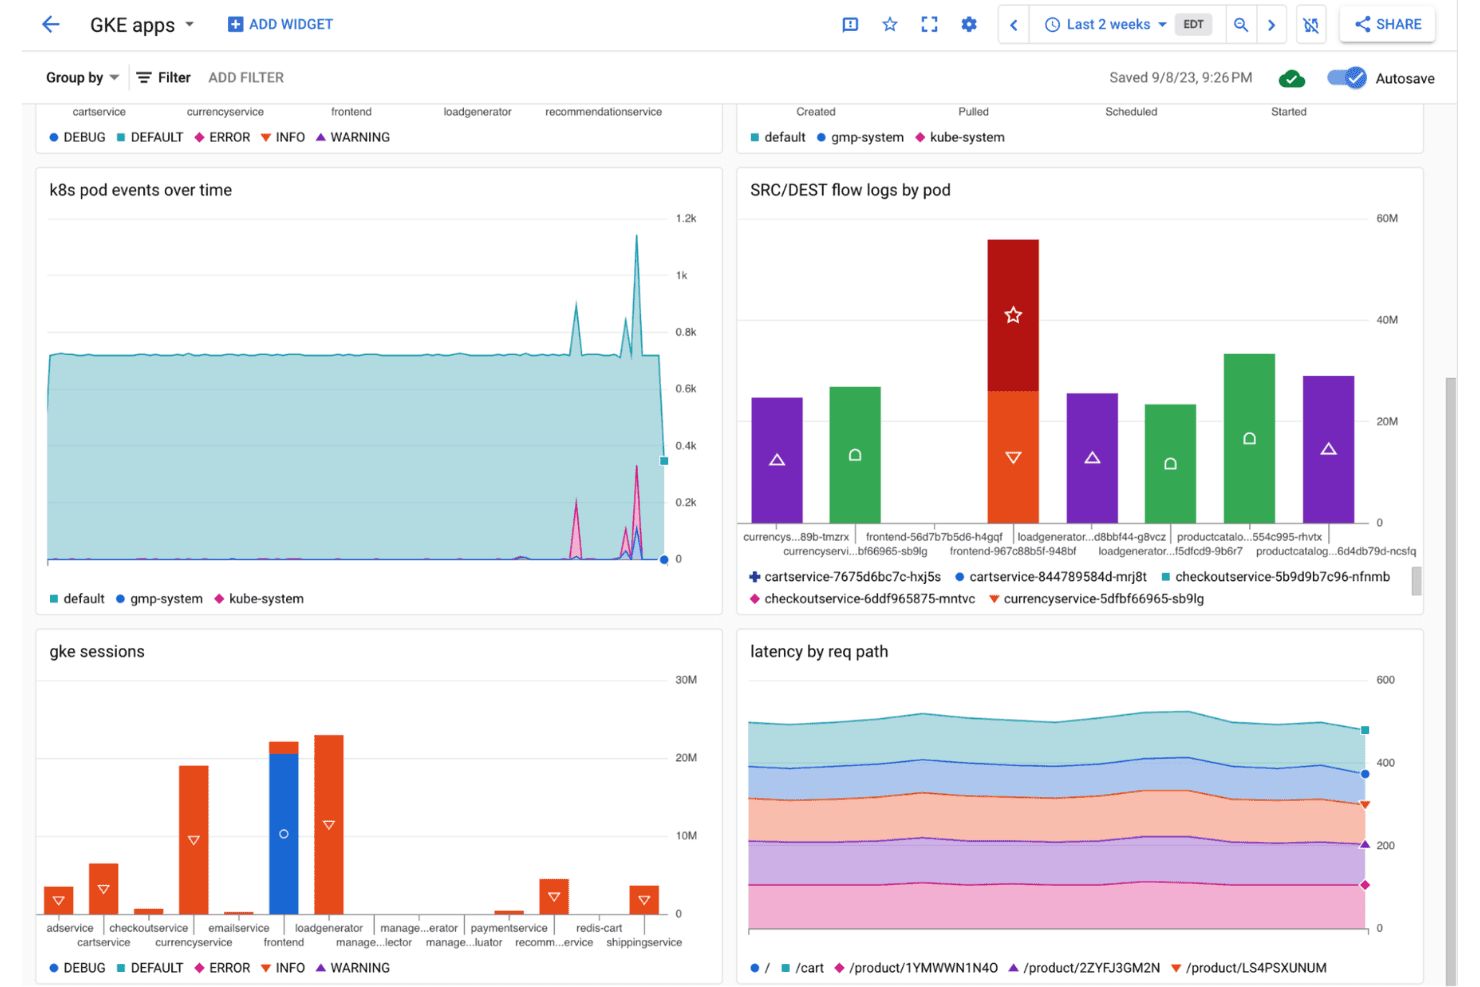
Google Cloud Storage toont dashboards voor GKE-appmonitoring met podgebeurtenissen en latentiegegevens. Google Cloud Storage is een beheerde objectopslagservice die is gebouwd voor data lake-architecturen en gelaagde opslagklassen, ondersteuning voor open tabelindelingen via Apache Iceberg en BigLake, en diepe integratie met BigQuery, Dataflow, Dataproc en Vertex AI biedt.
Voor wie is Google Cloud Storage het meest geschikt?
Google Cloud Storage is zeer geschikt voor data-engineering- en infrastructuurteams die al binnen het GCP-ecosysteem werken en een schaalbare objectopslag nodig hebben als basis van een lakehouse-architectuur.
Waarom ik voor Google Cloud Storage heb gekozen
Ik heb voor Google Cloud Storage gekozen omdat het de native basis vormt voor een op GCP gebaseerd lakehouse, met gelaagde opslagklassen (van Standard tot Archive voor $0.0012/GB/maand) en Autoclass, dat objecten automatisch tussen lagen verplaatst op basis van toegangspatronen. Wat ik overtuigend vind, is BigLake: het voegt ACID-transacties, tijdreizen en schema-evolutie rechtstreeks toe aan door GCS ondersteunde Apache Iceberg-tabellen, waardoor onbewerkte objectopslag verandert in een doorzoekbaar lakehouse zonder gegevens te verplaatsen. BigQuery voert vervolgens rechtstreeks query's uit op diezelfde Iceberg-tabellen, zonder dat export nodig is.
Belangrijkste functies van Google Cloud Storage
- Opname in meerdere indelingen: Storage Transfer Service, Dataflow, Pub/Sub en Datastream ondersteunen batch-, streaming- en CDC-opname vanuit databases zoals MySQL, PostgreSQL en Oracle naar GCS.
- Beheer en toegangscontroles: Op IAM gebaseerde machtigingen, CMEK/CSEK-versleuteling, VPC Service Controls, Cloud DLP en auditlogging handhaven de beveiliging voor alle opgeslagen gegevens.
- Metagegevensdetectie via Knowledge Catalog: Dataplex scant GCS-buckets automatisch om schema's te extraheren, bedrijfsglossaria op te bouwen en volledige gegevensherkomst in GCS en BigQuery te genereren.
- Ondersteuning voor query's met meerdere engines: Door GCS ondersteunde Iceberg-tabellen kunnen worden bevraagd door BigQuery, Serverless Spark, Trino, Flink en Presto via de Iceberg REST Catalog.
Integraties van Google Cloud Storage
Google Cloud Storage heeft native integraties met BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker en Knowledge Catalog. REST-, XML-, gRPC- en clientbibliotheek-API's ondersteunen aangepaste integraties met dataplatforms en verwerkingsengines.
Pros and Cons
Pros:
- Lakehouse-ondersteuning met Apache Iceberg-tabellen
- Analyse met meerdere engines via BigQuery en Spark
- Geautomatiseerde archivering en opties voor gelaagde opslag
Cons:
- Voor de meeste functies zijn meerdere GCP-services nodig
- Complexe facturering met afzonderlijke kosten voor bewerkingen en uitgaand verkeer
Learn more about Google Cloud Storage: Beste voor een lakehouse op basis van open tabelindelingen
- 14 dagen gratis proefversie
- Vanaf $0.22/DBU
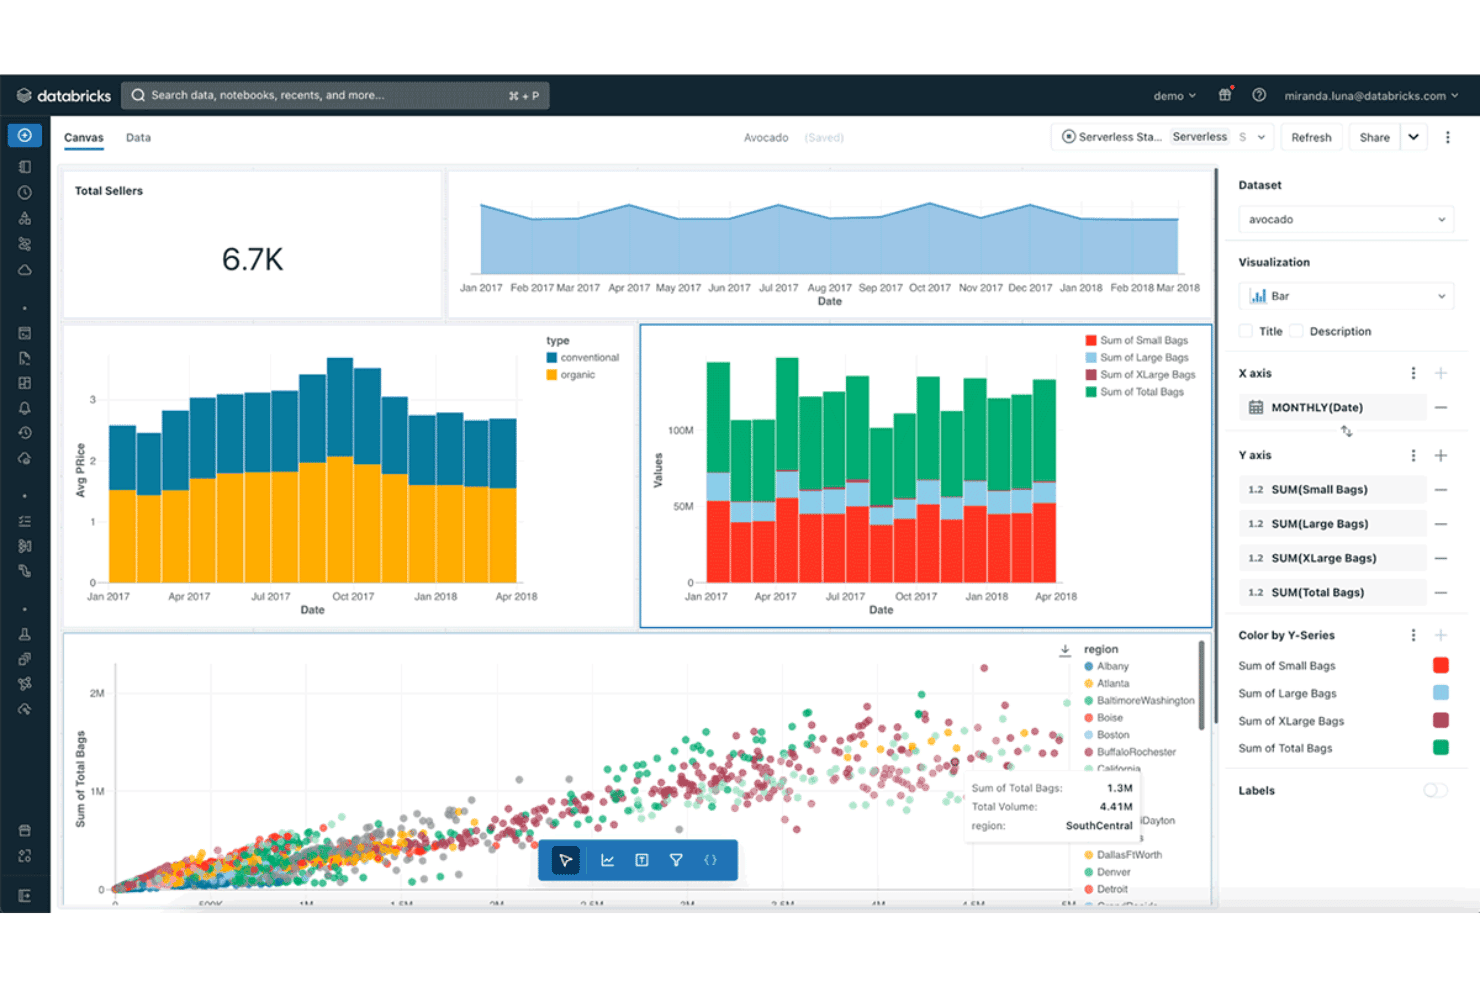
Databricks visualiseert avocadoverkoopgegevens in interactieve dashboardgrafieken. Databricks Lakehouse Platform is een cloudgebaseerd datalakehouseplatform dat gegevensengineering, SQL-analyse, machinaal leren en AI-ontwikkeling verenigt op open tabelindelingen zoals Delta Lake, Apache Iceberg en Apache Hudi.
Voor wie is Databricks Lakehouse Platform het meest geschikt?
Databricks is zeer geschikt voor teams die met ondernemingsgegevens en ML werken en die engineering-pijplijnen, SQL-analyse en ML-werklasten op één platform moeten uitvoeren zonder gegevens tussen systemen te verplaatsen.
Waarom ik voor Databricks Lakehouse Platform heb gekozen
Databricks staat op mijn shortlist omdat het het team is dat Delta Lake letterlijk heeft uitgevonden, en die ontstaansgeschiedenis is belangrijk wanneer je ondersteuning voor open tabelindelingen beoordeelt. Ik heb gewerkt met de ingebouwde ondersteuning van het platform voor Delta Lake, Iceberg en Hudi, en wat het onderscheidt, is dat ACID-transacties, tijdreizen en schema-evolutie geen toevoegingen achteraf zijn. Unity Catalog voegt daar rechtstreeks een geautomatiseerde herkomstregistratie op kolomniveau en op attributen gebaseerde toegangscontrole aan toe, zodat gegevensbeheer met de gegevens meereist tussen cloudomgevingen.
Belangrijkste functies van Databricks Lakehouse Platform
- Lakeflow Connect: Een beheerde, serverloze opnamelaag met meer dan 100 ingebouwde connectoren voor SaaS-toepassingen, databases, cloudopslag en bronnen voor gegevensstromen, waaronder Kafka, Kinesis en Event Hubs.
- Declaratieve Apache Spark-pijplijnen: Een raamwerk voor het bouwen van batch- en realtime-ETL-pijplijnen met ingebouwde, op beperkingen gebaseerde handhaving van datakwaliteit en geautomatiseerde CDC.
- Databricks SQL-warehouses: Een door Photon versnelde SQL-engine die ANSI SQL ondersteunt voor analytische workloads, met JDBC/ODBC-connectiviteit voor BI-hulpmiddelen zoals Tableau, Power BI en Looker.
- MLflow-integratie: Een beheerde MLflow-omgeving voor het bijhouden van experimenten, een modelregister en implementatie, samen met je lakegegevens en verbonden met de functieopslag en modelbediening.
Integraties van Databricks Lakehouse Platform
Databricks biedt meer dan 100 ingebouwde Lakeflow Connect-connectoren, waaronder Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive en Google Analytics. Het maakt ook verbinding met Kafka, Kinesis, Event Hubs, S3, ADLS en GCS, met JDBC/ODBC en API's voor aangepaste connectiviteit.
Pros and Cons
Pros:
- Ingebouwde ondersteuning voor Delta Lake, Iceberg en Hudi
- Geautomatiseerde herkomstregistratie op kolomniveau met Unity Catalog
- Ingebouwde MLflow en verenigd AI-platform
Cons:
- DBU- plus cloudkosten kunnen snel oplopen
- Geen optie voor implementatie op locatie beschikbaar
Learn more about Databricks Lakehouse Platform: Het beste voor objectopslag als kern van AWS-datalakes
- Niet beschikbaar
- Vanaf $0.023/GB/month
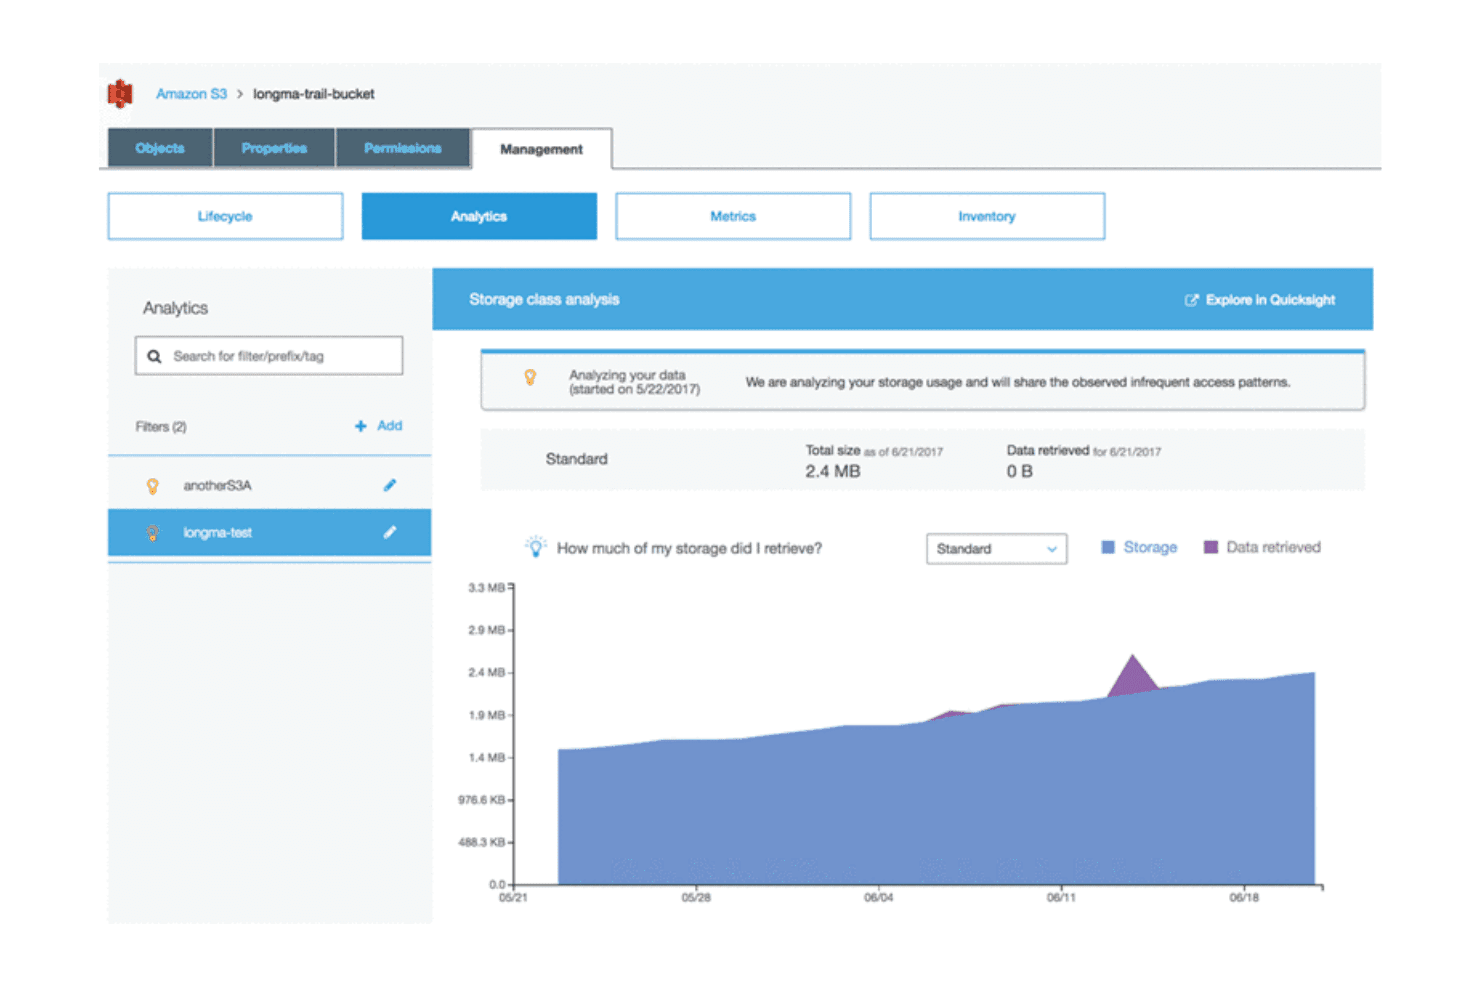
Amazon S3 analyseert patronen in opslaggebruik om de kosten voor het ophalen van gegevens te optimaliseren. Amazon S3 is de objectopslagservice van AWS die fungeert als de fundamentele opslaglaag voor datameren en elk gegevensformaat op exabyteschaal ondersteunt, met gelaagde opslagklassen, ingebouwd Apache Iceberg-tabelbeheer via S3 Tables en diepe integratie in het AWS-analyse-ecosysteem.
Voor wie is Amazon S3 het meest geschikt?
Amazon S3 is de juiste keuze voor data-engineering- en infrastructuurteams die analysepijplijnen op AWS bouwen en behoefte hebben aan een bewezen opslagfundament op exabyteschaal dat rechtstreeks aansluit op de rest van het AWS-ecosysteem.
Waarom ik voor Amazon S3 heb gekozen
Amazon S3 staat op mijn voorkeurslijst omdat het de objectopslaglaag is waarop de meeste productiedatalakes al zijn gebouwd. Ik vind het geweldig dat S3 Tables ingebouwde Apache Iceberg-ondersteuning biedt, met ingebouwde ACID-transacties, tijdreizen en automatische compactie, waarmee het probleem van kleine bestanden wordt opgelost dat de meeste lake-architecturen plaagt. Combineer dat met S3 Intelligent-Tiering, dat koude gegevens automatisch verplaatst naar $0.00099/GB/month, en je krijgt een sterke controle over opslagkosten zonder handmatige tussenkomst.
Belangrijkste functies van Amazon S3
- Inname in meerdere indelingen: S3 accepteert elk bestandstype—Parquet, ORC, Avro, JSON, CSV en ongestructureerde indelingen—via batchuploads, streaming met Kinesis en MSK of gebeurtenisgestuurde triggers met S3 Event Notifications.
- Fijnmazige toegangscontrole met Lake Formation: Dwing beleidsregels voor gegevenstoegang af op tabel-, kolom-, rij- en celniveau in je volledige op S3 gebaseerde datalake, zonder gegevens te dupliceren.
- S3 Vectors: Een native opslag- en queryservice voor vectorindexen die rechtstreeks in S3 is ingebouwd en is ontworpen voor semantisch zoeken en workloads voor retrieval-augmented generation tegen tot 90% lagere kosten dan traditionele benaderingen.
- S3 Inventory: Genereer geplande rapporten over objectkenmerken, opslagklasse, versleutelingsstatus en replicatiestatus in je buckets voor audit- en governanceprocessen.
Integraties van Amazon S3
Amazon S3 biedt ingebouwde integraties binnen AWS, waaronder AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum en Amazon SageMaker. Het maakt ook verbinding met Apache Spark, Trino, Snowflake, Databricks, Tableau en Power BI via gedocumenteerde connectors en API's.
Pros and Cons
Pros:
- Objectopslag op exabyteschaal ondersteunt elk gegevensformaat
- Ingebouwde ACID-Iceberg-tabellen met automatische compactie
- 143 compliancecertificeringen en toegangscontrole op objectniveau
Cons:
- De prijsstelling is complex en vereist nauwgezet beheer
- Voor het bouwen van een datalake moeten meerdere AWS-services worden samengesteld
Learn more about Amazon S3: Het meest geschikt voor Microsoft-eigen datalakes voor ondernemingen
- $200 tegoed voor 30 dagen (geen speciale gratis laag)
- Vanaf $0.023/GB/maand
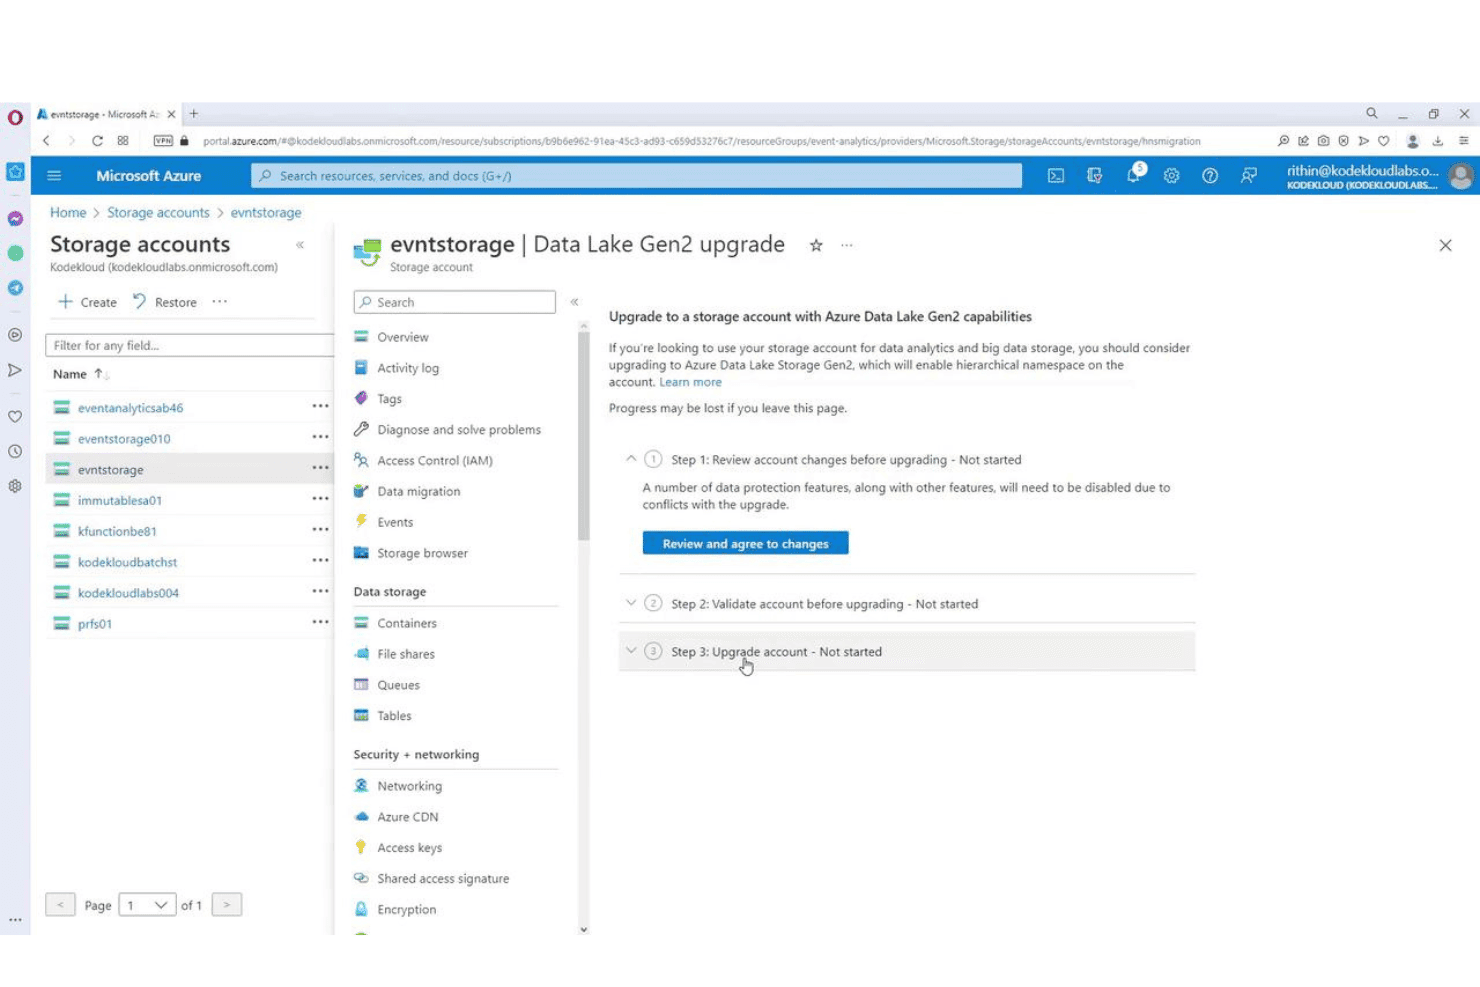
Met Azure Storage kunnen gebruikers accounts upgraden naar Data Lake Gen2-mogelijkheden. Azure Data Lake Storage Gen2 is de cloudgebaseerde datalake-opslagservice van Microsoft, gebouwd op Azure Blob Storage met een hiërarchische naamruimte, die opslag op exabyteschaal, gegevensinvoer in meerdere indelingen, POSIX-conforme toegangscontroles en ingebouwde integratie met het analyse- en ML-ecosysteem van Azure ondersteunt.
Voor wie is Azure Data Lake Storage het meest geschikt?
Azure Data Lake Storage Gen2 is de natuurlijke keuze voor IT- en datateams binnen ondernemingen die al op Microsoft Azure draaien en opslag op exabyteschaal nodig hebben die nauw is geïntegreerd met Synapse, Databricks en Microsoft Fabric.
Waarom ik voor Azure Data Lake Storage heb gekozen
Ik heb Azure Data Lake Storage Gen2 gekozen als een van de beste opties, omdat het de ingebouwde opslagbasis vormt voor de volledige Microsoft-analyse-stack en die hechte integratie op ondernemingsschaal van belang is. Wanneer je organisatie Synapse, Databricks en Microsoft Fabric gebruikt, vormt ADLS Gen2 al de onderliggende laag voor dit alles. Dat betekent dat één gegevenskopie via het ABFS-stuurprogramma door elke engine kan worden bevraagd. Ik waardeer vooral de POSIX-conforme ACL's, waarmee je lees-, schrijf- en uitvoermachtigingen kunt instellen op het niveau van individuele bestanden en mappen, en niet alleen op containerniveau.
Belangrijkste functies van Azure Data Lake Storage
- Geautomatiseerde levenscyclusindeling: Stel beleidsregels in die gegevens automatisch verplaatsen tussen de warme, koele, koude en archieflagen op basis van leeftijd of de tijd van de laatste toegang, om opslagkosten op schaal te beheren.
- Compatibiliteit met het ABFS-stuurprogramma: Het Azure Blob File System-stuurprogramma biedt Hadoop-, Spark-, Hive- en HDFS-gebaseerde werkbelastingen native lees- en schrijftoegang tot ADLS Gen2 zonder codewijzigingen.
- OneLake-snelkoppelingen: Maak liveverwijzingen naar gegevens in andere OneLake-werkruimten, Amazon S3 of Azure Blob Storage-containers zonder de onderliggende gegevens te kopiëren of te verplaatsen.
- Integratie van Azure Machine Learning-datastores: Registreer ADLS Gen2-containers rechtstreeks als datastores in Azure ML-werkruimten, zodat datawetenschappers rechtstreeks toegang krijgen tot lakegegevens voor modeltraining en experimenten.
Integraties van Azure Data Lake Storage
Azure Data Lake Storage biedt ingebouwde integraties binnen het Microsoft-ecosysteem, waaronder Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning en Azure Event Hubs. Het ondersteunt ook Apache Spark en Kafka via gedocumenteerde connectoren, plus ABFS en API's voor aangepaste gegevenstoegang.
Pros and Cons
Pros:
- Ingebouwde integratie met Microsoft-analysetools
- Hiërarchische naamruimte ondersteunt fijnmazige toegangscontrole
- Open tabelindelingen via de rekenlaag
Cons:
- Purview vereist voor geavanceerde gegevenscatalogisering
- Alleen beschikbaar op Microsoft Azure
Learn more about Azure Data Lake Storage:
Andere datalaketools
Hier zijn enkele aanvullende opties voor datalaketools die niet in mijn selectie zijn opgenomen, maar toch het bekijken waard zijn:
- 11IBM watsonx.dataHet meest geschikt voor een open lakehouse met toegang tot mainframegegevens
- 12Microsoft FabricBeste voor integratie van datalakes in de Microsoft-stack
- 13StarburstIdeaal voor gefedereerde SQL in datameren in meerdere clouds
- 14Alibaba Cloud Hybrid CloudHet meest geschikt voor hybride-cloud-datalakimplementaties in APAC
- 15Teradata VantageHet meest geschikt voor AI/ML-workloads met data lakes op petabyteschaal
- 16MinIOHet beste voor AI en on-premise lakehouse-opslag
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Een datalaketool kiezen
Welke factoren bepalen daadwerkelijk of een datalaketool de schaal, het beheer en de integratie kan bieden die uw team nodig heeft voor analysewerklasten in de praktijk?
| Als uw prioriteit ... is | Zoek dan naar ... |
|---|---|
| Als uw prioriteit ... isNaleving van regelgeving | Zoek dan naar ...Ingebouwde auditlogboekregistratie en toegangsbeleid |
| Als uw prioriteit ... isImplementatie in meerdere clouds of een hybride omgeving | Zoek dan naar ...Oorspronkelijke ondersteuning voor meerdere cloudproviders |
| Als uw prioriteit ... isOnafhankelijkheid van leveranciers | Zoek dan naar ...Compatibiliteit met open tabelindelingen |
| Als uw prioriteit ... isAnalyseprestaties op schaal | Zoek dan naar ...Gelaagde opslag en geïntegreerde ondersteuning voor query's |
| Als uw prioriteit ... isGereedheid voor AI en ML | Zoek dan naar ...Directe connectoren naar AI/ML-hulpmiddelen en verwerkingsengines |
Uw selectie beoordelen
- Controleer beheerfuncties: Vraag om schermafbeeldingen van de beheerconsole waarop op rollen gebaseerde toegangscontrole en de configuratie van auditlogboeken te zien zijn.
- Test ondersteuning voor open indelingen: Voer in een testomgeving een live-inname van Parquet- of Iceberg-bestanden uit en controleer schema-evolutie.
- Valideer claims over meerdere clouds: Vraag om openbare documentatie met implementatiestappen voor ten minste twee cloudproviders.
- Controleer de integratie met analyseplatforms: Vraag om een workflowvoorbeeld of configuratie voor Spark, Trino of Presto, met gedocumenteerde queryresultaten.
- Afweging—ondernemingssuite versus open technologieplatform: Bepaal of u behoefte hebt aan naleving en ondersteuning binnen een kant-en-klare oplossing, of dat flexibiliteit en compatibiliteit met een open technologiestack waardevoller zijn voor uw architectuur.
Wat zijn datalaketools?
Datalaketools zijn platforms en software waarmee u grote hoeveelheden gestructureerde en ongestructureerde gegevens in een centrale opslagplaats kunt opslaan, beheren en analyseren. Met deze tools kan uw team onbewerkte gegevens opnemen, indien nodig een schema toepassen en middelen organiseren voor analyse- of AI-projecten. U kunt functies verwachten die beheer, schaalbaarheid en integratie met populaire systemen voor gegevensopvraging en analyseplatforms ondersteunen.
Functies van datameertools voor datameren
Let bij het selecteren van datameertools voor datameren op de volgende belangrijke functies:
- Schaalbare objectopslag: Hiermee kunt u petabytes aan gestructureerde en ongestructureerde gegevens opslaan en beheren, met opties voor gelaagde of koude opslag om de kosten te beheersen naarmate uw opslagbehoeften groeien.
- Ondersteuning voor schema-on-read: Hiermee kunt u onbewerkte gegevens eerst opslaan en later tijdens het uitvoeren van query's een schema toepassen. Zo kunt u gemakkelijker omgaan met diverse, veranderende datasets zonder deze opnieuw te laden.
- Gegevensopname in meerdere indelingen: Ondersteunt het importeren van gegevens in verschillende indelingen, zoals Parquet, Avro, JSON, ORC en CSV, en is geschikt voor zowel batch- als streaminggegevensbronnen. Dit biedt meer flexibiliteit in de manier waarop gegevens binnenkomen.
- Integratie met query-engines: Biedt compatibiliteit met engines zoals Spark, Trino, Presto of Athena, zodat u analyses en rapportages rechtstreeks op uw datameer kunt uitvoeren zonder extra middleware.
- Beheer van metagegevens en catalogi: Omvat hulpmiddelen voor gegevenscatalogisering, het zoeken naar bedrijfsmiddelen, het volgen van herkomst en het toevoegen van tags. Zo houdt u gegevens georganiseerd en vindbaar wanneer nieuwe datasets worden toegevoegd.
- Governance en toegangsbeheer: Biedt fijnmazige machtigingen, versleuteling en auditregistratie, zodat u kunt beheren wie toegang heeft tot welke gegevens, het gebruik kunt controleren en aan wettelijke vereisten kunt voldoen.
- Gegevensversiebeheer en tijdreizen: Hiermee kunt u wijzigingen volgen, teruggaan naar eerdere versies van datasets en historische weergaven behouden. Dit is waardevol voor audits, herstel en reproduceerbaarheid.
- Integratie met orkestratietools: Maakt native verbinding met workfloworkestrators zoals Apache Airflow, zodat u gegevenspijplijnen kunt automatiseren en taken in verschillende systemen kunt coördineren.
- Hulpmiddelen voor monitoring en kostenbeheer: Biedt dashboards en waarschuwingen voor opslaggebruik, toegangspatronen en kosten, zodat u uw omgeving efficiënt en budgetvriendelijk kunt houden.
- Ondersteuning voor open tabelindelingen: Ondersteunt indelingen zoals Delta Lake of Apache Iceberg, waardoor geavanceerde functies zoals ACID-transacties en interoperabiliteit met meerdere analysetools mogelijk worden.
Veelvoorkomende AI-functies van datameertools voor datameren
Naast de hierboven genoemde standaardfuncties van datameertools voor datameren integreren veel van deze oplossingen AI met functies zoals:
- Geautomatiseerde gegevensclassificatie: Gebruikt AI-modellen om binnenkomende gegevens te scannen en te categoriseren op basis van inhoud, gevoeligheid of nalevingsvereisten. Hiermee kan uw team bedrijfsmiddelen sneller organiseren en de juiste toegangsbeheermaatregelen toepassen zonder handmatig tags toe te voegen.
- Anomaliedetectie voor gegevenskwaliteit: Past algoritmen voor machine learning toe om gegevensstromen te monitoren en ongebruikelijke patronen, ontbrekende waarden of uitschieters te signaleren. Zo kunt u problemen met gegevensintegriteit vroegtijdig opsporen en het risico op gebrekkige analyses of fouten in vervolgstappen verkleinen.
- Voorspellende optimalisatie van werklasten: Gebruikt AI om historische querypatronen en opslaggebruik te analyseren en beveelt vervolgens optimalisaties aan of past deze automatisch toe, zoals partitionering, caching of het schalen van resources. Zo kunt u de prestaties handhaven en de kosten beheersen naarmate het gebruik groeit.
- Queryinterfaces in natuurlijke taal: Integreert chat- of zoektools op basis van AI waarmee gebruikers in gewone taal vragen over gegevens kunnen stellen. Hierdoor wordt de drempel voor niet-technische gebruikers lager om datasets te verkennen en inzichten te genereren zonder SQL of code te schrijven.
- Geautomatiseerde verrijking van metagegevens: Gebruikt AI om context, relaties en bedrijfstermen uit onbewerkte gegevens te halen en vult vervolgens de gegevenscatalogus aan met uitgebreidere beschrijvingen en informatie over de herkomst. Hierdoor kunnen teams gegevensassets gemakkelijker ontdekken, vertrouwen en hergebruiken.
Voordelen van datameertools voor datameren
De implementatie van datameertools voor datameren biedt verschillende voordelen voor uw team en uw bedrijf. Hier zijn enkele voordelen waar u naar kunt uitkijken:
- Gecentraliseerd gegevensbeheer: Met datameerhulpmiddelen kunt u gestructureerde en ongestructureerde gegevens op één plek opslaan, waardoor het eenvoudiger wordt om bedrijfsmiddelen te organiseren en analyse- of AI-projecten te ondersteunen.
- Schaalbaarheid voor workloads op petabyteschaal: Deze platforms kunnen enorme gegevensvolumes verwerken en zowel opslaglagen in de cloud als on-premises ondersteunen, zodat u zich kunt aanpassen aan groeiende behoeften zonder de architectuur opnieuw te ontwerpen.
- Flexibele gegevensopname: U kunt gegevens uit een breed scala aan indelingen en bronnen opnemen en zowel batch- als realtimegegevensstromen verwerken dankzij ingebouwde connectoren en ondersteuning voor verschillende indelingen.
- Granulair beheer en toegangscontrole: Machtigingen op fijnmazig niveau, versleuteling en auditregistratie helpen u de beveiliging te handhaven en te voldoen aan standaarden zoals HIPAA, SOC 2 en GDPR.
- Integratie met analyse- en AI-hulpmiddelen: Ingebouwde compatibiliteit met query-engines zoals Spark, Trino en Presto—evenals directe connectoren naar AI/ML-hulpmiddelen—betekent dat u gegevens zonder vertragingen of extra integratiewerk kunt analyseren.
- Geautomatiseerd beheer van metagegevens en gegevenskwaliteit: Veel platforms bevatten catalogi, tracering van gegevensherkomst en AI-gestuurde hulpmiddelen die u helpen metagegevens te verrijken, gegevens te classificeren en afwijkingen te detecteren om de integriteit van gegevens te behouden.
- Ondersteuning voor open tabelformaten en geavanceerde gebruiksscenario's: Functies zoals compatibiliteit met Delta Lake of Apache Iceberg maken ACID-transacties, gegevensversiebeheer en het delen van gegevens zonder kopiëren mogelijk, ter ondersteuning van geavanceerdere analyses en multi-cloudarchitecturen.
Kosten en prijzen van datameerhulpmiddelen
Bij het selecteren van datameerhulpmiddelen is inzicht in de verschillende beschikbare prijsmodellen en abonnementen vereist. De kosten variëren op basis van functies, teamgrootte, toevoegingen en meer. De onderstaande tabel geeft een overzicht van veelgebruikte abonnementen, hun gemiddelde prijzen en de gebruikelijke functies die in oplossingen voor datameerhulpmiddelen zijn inbegrepen:
Vergelijkingstabel van abonnementen voor datameerhulpmiddelen
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Type abonnementGratis abonnement | Gemiddelde prijs$0 | Veelvoorkomende functiesBasisobjectopslag, beperkte gegevensopname, ondersteuning voor schema's bij het lezen en integratie met één query-engine. |
| Type abonnementPersoonlijk abonnement | Gemiddelde prijs$50–$300/maand | Veelvoorkomende functiesGrotere opslaglimieten, ondersteuning voor meerdere gegevensindelingen, basiscatalogisering en integratie met analysetools. |
| Type abonnementZakelijk abonnement | Gemiddelde prijs$1,000–$5,000/maand | Veelvoorkomende functiesOpslag op petabyteschaal, geavanceerde beheersingsopties, multi-cloudopties en mogelijkheden voor gegevenscatalogisering. |
| Type abonnementEnterprise-abonnement | Gemiddelde prijs$10,000+/maand | Veelvoorkomende functiesOnbeperkte opslag, volledige nalevingsfuncties, AI-gestuurde automatisering, integratie met orkestratiehulpmiddelen en premiumondersteuning. |
Veelgestelde vragen over datalaketools
Hier vindt u antwoorden op veelgestelde vragen over datalaketools:
Hoe gaan datalaketools om met beveiligings- en nalevingsvereisten?
Datalaketools passen beveiliging toe met toegangscontroles, versleuteling en auditregistratie. De meeste toonaangevende platforms ondersteunen gedetailleerde machtigingen tot op rij- of kolomniveau, plus integraties met SSO en identiteitsproviders. Zoek voor naleving naar leverancierscertificeringen zoals SOC 2, HIPAA of GDPR, en naar opties voor door de klant beheerde encryptiesleutels. Deze functies helpen u aan wettelijke vereisten te voldoen zonder extra lagen te bouwen.
Kunnen datalaketools worden geïntegreerd met bestaande analyse- of BI-platforms?
Ja, de meeste datalaketools bieden directe connectoren voor analyse- en BI-platforms. U mag standaardondersteuning verwachten voor Spark, Trino, Presto en Athena, plus integraties met Tableau en Power BI. Als uw teams gespecialiseerde tools gebruiken, controleer dan of er open API’s of ODBC/JDBC-stuurprogramma’s beschikbaar zijn waarmee u aangepaste workflows kunt verbinden.
Wat is het verschil tussen datalaketools en datawarehouses?
Datalaketools zijn gericht op het opslaan van onbewerkte, semi-gestructureerde en ongestructureerde gegevens met behulp van schema bij lezen, terwijl datawarehouses gestructureerde gegevens opslaan met vooraf gedefinieerde schema’s (schema bij schrijven). Datalakes zijn beter geschikt voor flexibele gegevensopname en AI/ML-workloads, terwijl datawarehouses geschikt zijn voor samengestelde analyses met geoptimaliseerde queryprestaties. Sommige leveranciers bieden nu lakehouse-architecturen die beide benaderingen combineren.
Ondersteunen datalaketools meerdere gegevensindelingen en opnametypen?
Ja, de meeste datalaketools accepteren een breed scala aan indelingen, zoals Parquet, Avro, JSON, ORC en CSV. U vindt ook ondersteuning voor zowel batch- als streaminggegevensbronnen, waardoor het mogelijk is om alles te verwerken, van dagelijkse opnameprocessen tot realtime gebeurtenissenstromen, met behulp van vooraf gebouwde of aangepaste connectoren.
Hoe beoordeelt u datalaketools op schaalbaarheid?
Ik kijk naar de opties voor objectopslag van elk platform, de prestaties bij belastingen op petabyteschaal en ondersteuning voor meerdere clouds. De mogelijkheid om opslag in lagen te verdelen, gegevens in verschillende regio’s te verwerken en knelpunten te vermijden met indelingen zoals Delta Lake of Iceberg is essentieel. Controleer gedocumenteerde benchmarks en verzamel referenties van klanten met vergelijkbare gegevensvolumes als die van u.
Zijn open tabelformaten zoals Delta Lake of Apache Iceberg belangrijk?
Ja, open tabelformaten zijn belangrijk als u ACID-transacties, versiebeheer en leveranciersneutraal gegevensbeheer wilt. Hiermee kunt u functies zoals tijdreizen en het delen van gegevens zonder kopiëren inschakelen. Als u streeft naar een lakehouse-model of uw architectuur toekomstbestendig wilt maken, moet u binnen uw datalaketool aandringen op compatibiliteit met open indelingen.