Så du har begynt å ta i bruk DevOps i virksomheten din. Men hvordan kan du vite om det forbedrer prosessene dine? Du må måle suksessen på en eller annen måte, og dette kan du gjøre ved å overvåke noen viktige DevOps-måltall.
Det finnes mange måter å vurdere kvaliteten på et system eller en applikasjon på, men i denne artikkelen fokuserer jeg på viktige måltall som bidrar til å evaluere kvaliteten på prosessene dine. Ved å følge disse indikatorene kan du få dypere innsikt i styrkene og svakhetene dine, forbedre beste praksis for DevOps og ta i bruk de riktige verktøyene og programvaren for kontinuerlig forbedring.
Hvorfor er DevOps-måltall viktige?
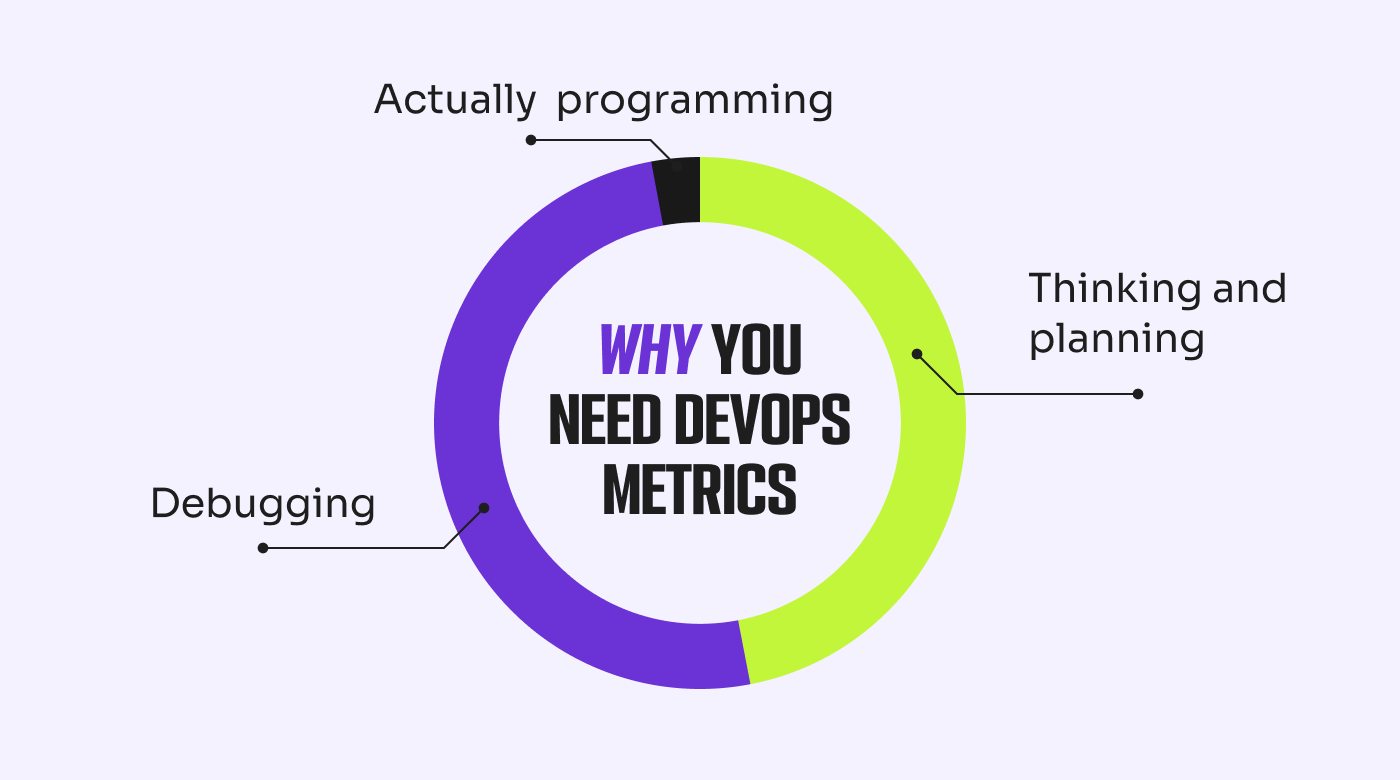
Som nevnt ovenfor kan felles mål og måltall være utfordrende for team som innfører DevOps i en virksomhet. Uten DevOps-måltall ville det ikke vært noen testing eller måling, og heller ingen forbedringer i utviklingen. Det ville bare vært gjentakelser av den samme programvaren basert på antakelser og ideer, som ble sendt ut i det tomme rom, før man prøvde noe nytt. Uten tilbakemeldinger eller måltall for produktsuksess for å forstå hvordan noe fungerer, finnes det ingen retning.
Økonomiavdelinger ønsker for eksempel å holde kostnadene så lave som mulig, mens utviklere ønsker å holde ytelsen så høy som mulig. Disse to målene er kanskje ikke forenlige med mindre risikoene er vurdert og teamene forstår hverandres mål.
Der utviklerne dine kanskje velger å levere et uferdig produkt og håndtere det senere, fører kostnadene ved denne påvirkningen til teknisk gjeld. Implementering av DevOps kan samordne målene og strategiene til begge teamene, og du kan hjelpe utviklerne dine med å forstå kostnadskonsekvensene av de tekniske beslutningene deres.
Dette er bare en liten del av DevOps og betydningen av felles måltall.
5 viktige DevOps-måltall (DORA)
Å implementere DevOps og forstå prinsippbaserte rammeverk er én ting, men det er med DevOps-måltall du virkelig begynner å se fordelene ved denne samarbeidsorienterte tilnærmingen til programvareutviklingslivssyklusen. Som med de fleste forretningsstrategier finnes det utallige måltall du kan velge å måle for å oppnå vekst, avhengig av bransjen, målgruppen og målene dine.
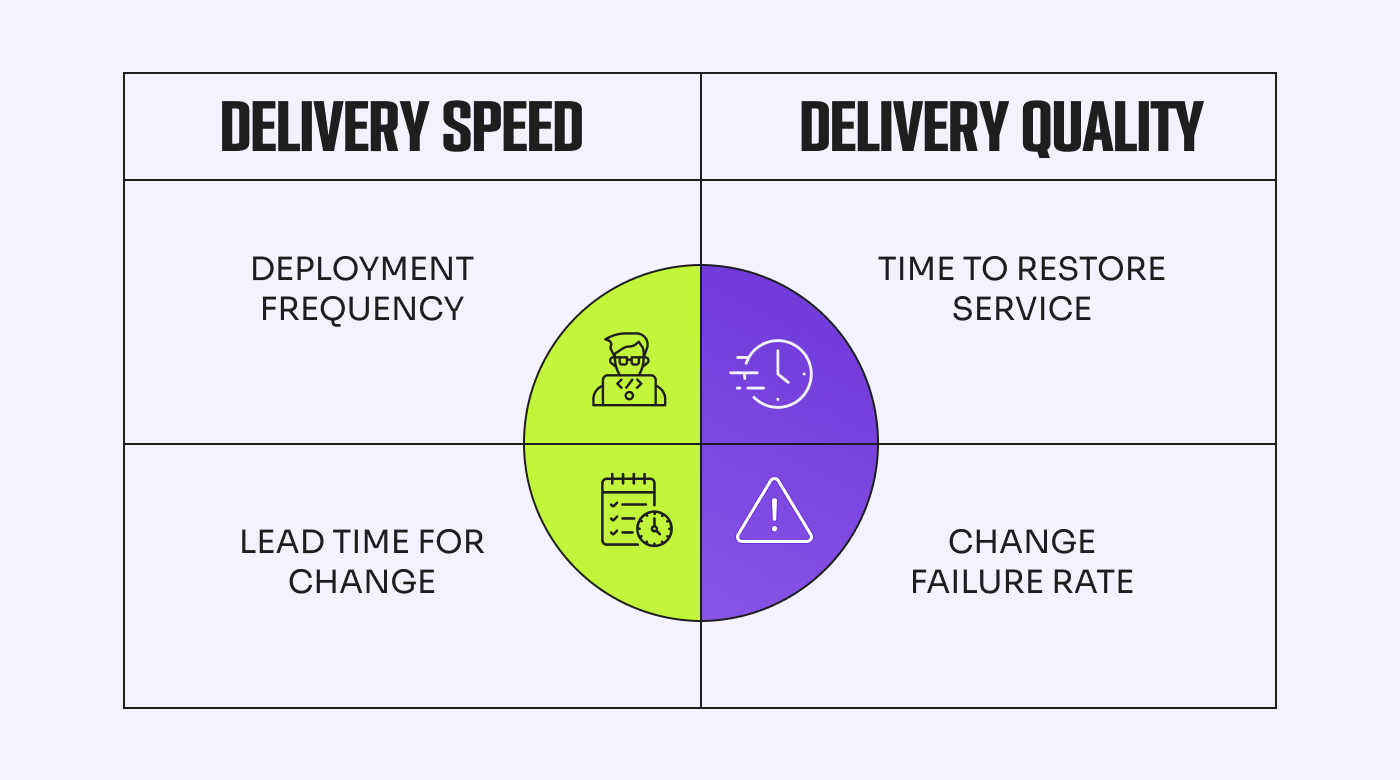
Google Clouds team for DevOps Research and Assessment (DORA) er det lengst eksisterende forskningsteamet av sitt slag. De fant opprinnelig fire viktige måltall for å måle ytelsen til de «fremragende» innen DevOps. Siden har det blitt lagt til et femte viktig måltall, og klyngeanalysen deres identifiserer bare tre nivåer av DevOps-team: høyt, middels og lavt, der «fremragende» nå er noe som hører fortiden til.
1. Distribusjonsfrekvens (DF)
DF måler hvor ofte du lykkes med å levere til produksjon. Dette måltallet handler om konsistens og er en utmerket indikasjon på måloppnåelse.
Team i kategorien «fremragende» ville konsekvent distribuere til produksjon flere ganger daglig, mens team med lav ytelse ville være nærmere én gang hver sjette måned.
Det er så enkelt å forbedre DF som å lansere flere mindre oppdateringer. Den viktigste fordelen ved å gjøre dette er at det synliggjør eventuelle prosesshindringer, flaskehalser eller komplekse prosjekter som krever oppmerksomhet. Større team foretrekker kanskje å distribuere med jevne mellomrom ved å bygge smidige lanseringstog; dette bidrar til å redusere belastningen ved et ekstremt høyt tempo og mange involverte.
2. Ledetid for endringer (LTC)
LTC viser til tiden det tar før en commit kommer i produksjon. Dette måltallet er en god indikator på teamets reaksjonsevne og smidighet, ettersom det måler hvor raskt de kan reagere på brukernes behov og krav.
Den tidligere «fremragende»-standarden hadde som mål at LTC skulle være under én dag, mens team med lavere ytelse kunne bruke mer enn seks måneder. Å prestere i den svakere enden av skalaen for LTC skyldes sannsynligvis ineffektive prosesser.
Du kan forbedre dette måltallet ved å forbedre automatiseringsprosessene, særlig testingen. Ved å forbedre prosessen for kontinuerlig integrasjon og pipelinen for kontinuerlig levering (CI/CD) kan du få oppdateringer raskere ut i produksjon. En risiko du imidlertid bør være oppmerksom på her, er bærekraft. Hvis teamet ditt ikke kan opprettholde dette forbedrede tempoet, kan du møte på en dårlig brukeropplevelse og potensielle sikkerhetssårbarheter.
3. Feilrate for endringer (CFR)
CFR er prosentandelen av utrullinger som fører til en feil i produksjon. Feilen kan være nedetid, tilbakeføringer eller redusert tjenestekvalitet. Dette måltallet viser hvor effektivt teamet ditt er når dere distribuerer endringer.
Referanseverdier for fremragende ytelse er 0–15 %, mens høy, middels og lav ytelse alle ligger innenfor 16–30 %.
Å forbedre CFR handler om kvalitet fremfor kvantitet. Bedrifter lanserer varierende antall endringer og har derfor varierende antall feil. Modifikasjoner av høyeste kvalitet vil imidlertid føre til færre feil, enten de distribuerer endringer to ganger i året eller to ganger om dagen.
4. Gjennomsnittlig tid til gjenoppretting (MTTR)
MTTR er hvor lang tid teamet ditt bruker på å gjenopprette tjenesten etter en feil eller forstyrrelse. Dette måltallet måler ikke bare hvor smidig teamet ditt er, men er også en god indikator på stabiliteten til programvaren din.
Hvis du sikter mot et «fremragende» nivå, må MTTR være på under én time. Team med lav ytelse kan bruke over seks måneder.
Du kan redusere MTTR ved å fokusere på små, raske lanseringer, slik at feil blir enklere å finne og rette. Du kan også utforske funksjonsflagg for å gi teamet ditt mer kontroll – spesielt hvis de er eksperimentelle.
Det er ett måltall til som må gjennomgås.
5. Pålitelighet
Det femte bonusmåltallet er pålitelighet. Dette måltallet ble oppdaget senere av DORA-teamet (2021), fordi tilgjengelighet tidligere ble målt som en referanseverdi for pålitelig programvare. Det ble imidlertid besluttet at pålitelighet i større grad omfatter tilgjengelighet, forsinkelse, ytelse og skalerbarhet. Det innebærer i praksis å måle driftsytelse sammen med utvikling.
Andre vanlige DevOps-måltall
Have an account? Log In
Syklustid
Syklustid er den totale tiden fra en oppgave starter til den leveres ferdig. På overflaten viser den arbeidshastigheten til teamet ditt. Du kan imidlertid gå mer i dybden på dette måltallet for å finne flaskehalser, som lange køtider og forespørsler om sammenslåing som tar lang tid.
En kortere syklustid indikerer en effektiv arbeidsflyt, reduserer flaskehalser og øker utviklingshastigheten.
Slik måler du syklustid
Syklustid beregnes ved å spore tidsstempler for commits, kodesammenslåinger og utrullinger i verktøy som GitHub, GitLab eller Jenkins.
Syklustid = Tidspunkt for utrulling – Tidspunkt for commit
For å forbedre syklustiden bør team:
- Optimalisere CI/CD-pipelines for raskere integrasjon og utrulling.
- Automatisere bygging og testing.
- Forbedre samarbeidet mellom utviklings- og driftsteam.
- Redusere avhengigheter mellom oppgaver for å minimere flaskehalser.
Gjennomsnittlig tid til oppdagelse (MTTD)
Dette er den gjennomsnittlige tiden teamet ditt bruker på å oppdage en feil. En lav MTTD indikerer effektive systemer for overvåking og varsling, noe som muliggjør rask respons på og løsning av hendelser.
Slik måler du MTTD
MTTD kan måles ved å spore den gjennomsnittlige tiden mellom når et problem oppstår og når det oppdages av overvåkingsverktøy eller rapporteres av brukere. Å redusere MTTD innebærer å forbedre automatisert overvåking, finjustere varslingsmekanismer og sørge for proaktiv oppdagelse av problemer.
Beståtte automatiserte tester
Det er bra å etterstrebe god testdekning, spesielt med automatiserte tester. Her snakker jeg om enhetstester, integrasjonstester, brukergrensesnittstester og ende-til-ende-tester. God testdekning er imidlertid ikke nok til å sikre kvaliteten på programvaren. Det som betyr noe, er prosentandelen av disse testene som består.
Målet er selvfølgelig å ha en andel beståtte tester som ligger så nær 100 % som mulig. Overvåking av dette måltallet kan også vise hvor ofte nyutvikling ødelegger eksisterende tester.
Slik måler du prosentandelen beståtte automatiserte tester
Beregningen er en enkel prosentberegning: multipliser antallet beståtte tester med 100, og divider deretter på det totale antallet tester. Du kan hente denne informasjonen fra pipeline-verktøyet som kjører byggingene (Jenkins, Azure DevOps, CircleCI osv.).
Tallet kan være en god indikator på kvaliteten til produktet. Det kan imidlertid også være misvisende hvis du har ustabile eller upålitelige tester.
Frekvens for feil som slipper gjennom
Frekvensen for feil som slipper gjennom, viser hvor mange feil som ikke oppdages under testingen og blir lansert i produksjon – altså hvor mange som har «sluppet gjennom». Denne målingen er ideell hvis du ønsker å forbedre testings- og automatiseringsprosessene.
I en utopisk verden ville alle appene våre vært feilfrie. Slik er det imidlertid sjelden. Ideelt sett oppdages feil under utviklings- og testfasene i DevOps-prosessen, ikke i produksjon.
Denne målingen bidrar til å fastslå hvor effektive testprosessene dine er, samt den overordnede kvaliteten på programmet ditt. En høy frekvens for feil som slipper gjennom, tyder på at prosedyrene må forbedres og at det er behov for mer automatisering, mens en lav frekvens (helst nær null) indikerer en applikasjon av høy kvalitet.
Slik måler du frekvensen for feil som slipper gjennom
For å måle dette kan du bruke verktøyet ditt for feilsporing og, for hver åpen feil, registrere hvor den ble oppdaget – enten i testmiljøet eller produksjonsmiljøet (eller et annet miljø du bruker, for eksempel UAT).
Kundehenvendelser
Kundetilfredshet er en drivende faktor for innovasjon, og med god grunn: En feilfri brukeropplevelse er god kundeservice og henger vanligvis sammen med økt salg. Derfor er kundehenvendelser, særlig under prosessen for eskalering av henvendelser, en god indikator på hvor godt DevOps-overgangen din går.
Kunder bør ikke fungere som kvalitetskontroll ved å rapportere feil og mangler. En nedgang i antall kundehenvendelser er derfor et godt tegn på god applikasjonsytelse.
CPU- og minnebruk
Identifiserer trender i ressursutnyttelsen.
Responstid
Måler tiden det tar før applikasjonen svarer på forespørsler.
Feilfrekvens
Følger antallet mislykkede forespørsler over tid.
Gjennomstrømning
Måler antallet forespørsler som behandles per sekund.
Forsinkelse for API-forespørsler
Måler forsinkelsen mellom det å sende en forespørsel og det å motta et svar.
Ytelse for databasespørringer
Følger med på kjøringstider for spørringer og mulige flaskehalser.
Analyse av brukeradferd
Overvåker trender i funksjonsbruk og engasjement.
Gjennomsnittlig tid mellom feil (MTBF)
MTBF måler den gjennomsnittlige tiden mellom systemfeil, nedetid eller hendelser. Denne målingen vurderer påliteligheten og stabiliteten til programvaresystemene dine og synliggjør hvor effektive strategiene dine for forebyggende vedlikehold og feilbegrensning er.
Tid til feilbegrensning (TTM)
Tiden det tar å løse et problem etter at det er oppdaget, er TTM. Denne målingen bidrar til å vurdere prosessene for hendelsesrespons og -løsning, og viser hvor effektive teamene dine er når det gjelder å håndtere og gjenopprette etter problemer.
Ledetid for endringer (CLT)
CLT gir et referansepunkt for hele prosessen med å implementere endringer, inkludert utvikling, testing, gjennomgang og distribusjon. En kortere CLT betyr raskere leveransesykluser og økt smidighet.
Slik setter du KPI-er med DevOps-målinger
Nå som du har god forståelse av målingene du kan bruke til å implementere og optimalisere DevOps i virksomheten din, vil du utforske nøkkelindikatorer (KPI-er) for å sette mål og referanseverdier for teamet ditt.
Målinger kontra KPI-er
Du lurer kanskje på hva forskjellen mellom målinger og KPI-er er. En måling er det du måler. Det er en kvantifiserbar måling som gir data om et spesifikt aspekt ved ytelsen. Ikke alle målinger er nødvendigvis knyttet til bestemte mål eller målverdier.
KPI-er er derimot en type måling som er strategisk valgt og definert for å gjenspeile de mest kritiske aspektene ved ytelse og fremdrift mot strategiske mål. KPI-er er vanligvis knyttet til målsettinger og har ofte tilknyttede målverdier, terskler eller referanseverdier som må oppnås.
Fastsette KPI-er for DevOps-teamet ditt
Det første steget for å fastsette KPI-er for DevOps-teamet ditt er å knytte DevOps-målinger til virksomhetens strategi og mål. Ved å prioritere de viktigste målingene å følge med på kan du begynne å etablere mål og referanseverdier for kontinuerlig forbedring. Når du velger de riktige målingene, må du ta hensyn til selskapets størrelse, produkt og marked. Fokuser på det som gir den mest nyttige innsikten, og unngå den vanlige fallgruven med for mange målinger.
Det er like viktig å overvåke KPI-ene som å fastsette dem. Utforsk verktøy for datavisualisering for å gi teamet sanntidsdata i intuitive dashbord. Dette sikrer full oversikt, gir ansvarlighet og lar alle samarbeide om felles mål, slik at utviklings- og driftsteamene samordnes og støtter innføringen og videreutviklingen av DevOps.

Når vi ser på de grunnleggende DORA-målingene, kan vi se referanseverdiene for hver måling basert på team med svært høy, høy, middels og lav ytelse. Denne tabellen kan hjelpe deg med å fastsette KPI-er for din egen virksomhet, avhengig av hva du anser som prioritert.
Når du fastsetter KPI-ene, er det best å vurdere teamet og virksomheten nøye uten å sammenligne dem med andre selskaper. Hvis vi bruker CFR som eksempel, er referanseverdien den samme for høy, middels og lav ytelse. Dette vil i stor grad avhenge av utrullingsfrekvensen, men kan også påvirke den motsatt vei. Hvis teamet ditt bruker all tiden på å rette feil, får de mindre tid til å utvikle og utgi oppdateringer. KPI-ene kan også endres etter hvert som DevOps-teamet ditt modnes. Robuste prosesser for automatisering og testing bør automatisk bety at du kan heve listen for målene dine.
More Articles
Slik bruker du DevOps-målinger til å skalere
Ettersom det globale DevOps-markedet forventes å nå 24.71 milliarder dollar innen 2027 (en sammensatt årlig vekstrate på 22.9 %, basert på markedsstørrelsen på 10.84 milliarder dollar i 2023), bør du se dette som et tegn dersom du ser etter det beste tidspunktet for å begynne å innføre dette i virksomheten din.
DevOps akselererer ikke bare utviklingen og reduserer tiden til markedet, men forbedrer også samarbeidet ved å fjerne siloer, øker kvaliteten gjennom kontinuerlig testing og tilbakemeldingssløyfer og utnytter ressursene effektivt, noe som sparer penger. Til slutt er det enkelt å skalere og støtter virksomhetens vekst til nye høyder, og 83 % av IT-beslutningstakere oppnådde høyere forretningsverdi ved å innføre DevOps i 2021.
Ytelsesmåling og kontinuerlig forbedring
Overvåking av ytelsen er nøkkelen til å skalere en virksomhet som bruker DevOps. Det er en hurtig arbeidsmetode med en kontinuerlig produksjonsflyt, så måling og rapportering bør være like hyppig. DevOps-målinger lar deg følge med på ytelsen til utviklings- og leveranseprosessene dine. Ved å kvantifisere viktige aspekter som utrullingsfrekvens, ledetid og feilrate for endringer kan du identifisere flaskehalser, ineffektivitet og områder som kan forbedres. Dette gjør det mulig å optimalisere arbeidsflyter og prosesser jevnlig.
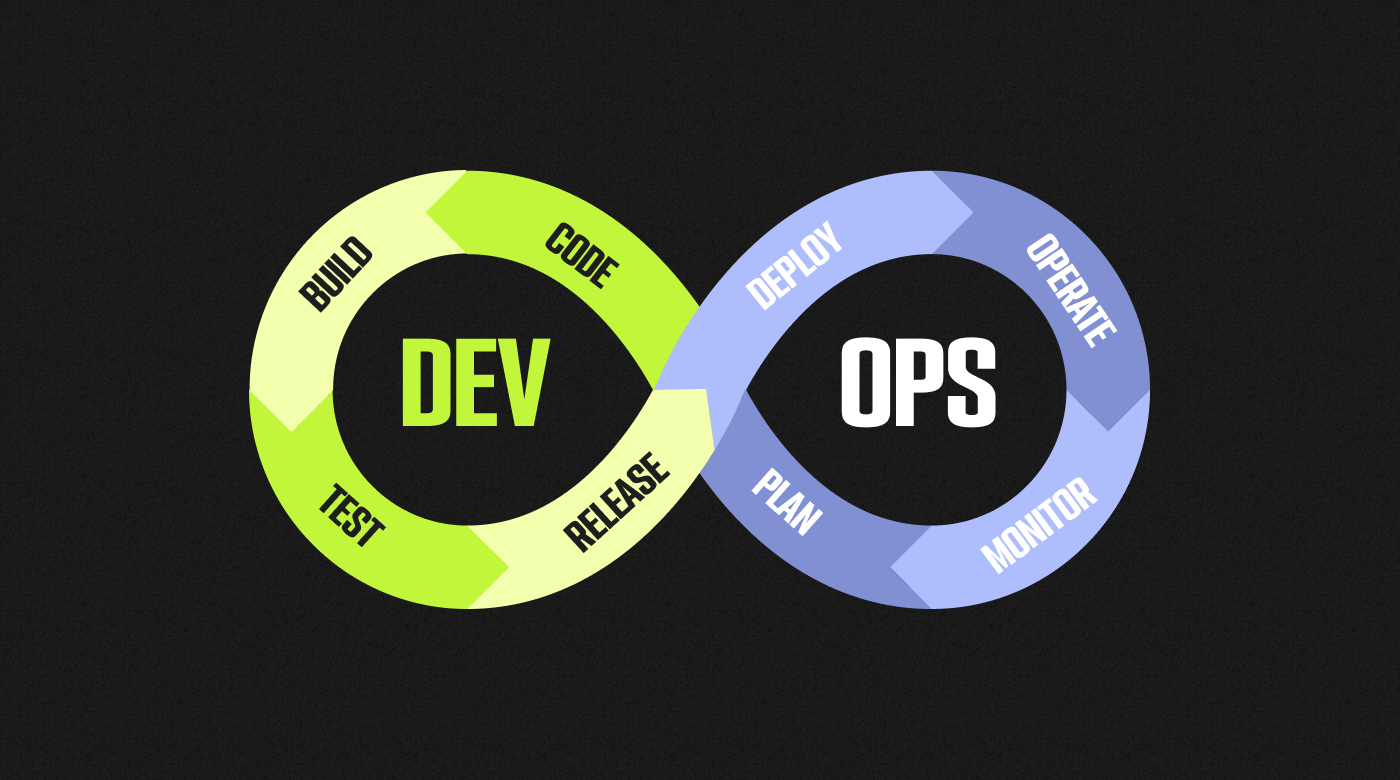
Ved å følge med på målinger som feilrate for endringer og gjennomsnittlig tid til gjenoppretting kan du identifisere trender som gjør det mulig å oppdage problemer tidlig. Denne proaktive tilnærmingen betyr at du kan iverksette korrigerende tiltak og minimere påvirkningen på kundene, noe som gir pålitelighet – en annen viktig forutsetning for å skalere med høy kvalitet.
Til slutt vil bruk av DevOps-målinger bidra til å videreutvikle DevOps-teamet ditt ved å fremme en kultur for kontinuerlig forbedring. Tilbakemeldingssløyfer fremmer læring og vekst; det må alltid være rom for å eksperimentere med ulike tilnærminger.
Hvilke DevOps-målinger støtter virksomhetens vekst?
Når du fastsetter KPI-er, bør de fleste målingene vurderes innenfor teamet ditt og posisjoneres for vekst, i stedet for å sammenlignes med andre virksomheter og grupper på ulike modenhetsnivåer.
For eksempel kan en lav LTC vise at teamet ditt er effektivt, men hvis de ikke klarer å opprettholde tempoet, er det ikke bærekraftig og kan etter hvert påvirke brukeropplevelsen. Denne målingen bør følges over tid, i stedet for å fastsette en KPI som samsvarer med et velfungerende eller til og med svært modent DevOps-team. Å fastsette KPI-er for å redusere LTC fra måned til måned, kvartalsvis eller årlig viser vekst i teamet og virksomheten din.
CFR er en verdifull måleenhet fordi ikke alle har samme antall feil eller problemer, men ved å angi dette som en prosentandel kan du måle hvor vellykkede distribusjonene dine er. Teamet ditt kan ha svært få feil hvis dere lanserer endringer sjelden, men hvis hver lansering forårsaker et problem, vil CFR være svært høy. Hvis du følger CI/CD-praksis, kan du oppleve et høyere antall feil, men hvis CFR-en din er lav, har du en fordel fordi du har hastighet og kvalitet som støtter vekst. MTTR bør også måles over tid for å sikre jevn vekst.
DORA fant at team på alle nivåer av utviklingsytelse oppnådde bedre resultater når de fokuserte på operasjonell ytelse. Dette kan innebære å sette KPI-er for hendelsesrapporter eller åpne saker, oppetid for applikasjoner og tilgjengelighet.
Et høyt antall åpne saker kan tyde på et problem med kundetilfredsheten, men å sikte mot en nedgang over tid gjenspeiler fremgang på dette området. Du kan gå mer i dybden og måle responstid og køtid for å akselerere forbedringen av denne måleenheten.
Den ene måleenheten som fullt ut kombinerer både utvikling og drift i et DevOps-team, er syklustiden. Dette åpner for å bygge en kultur for tilbakemeldinger og vekst. Etter hvert som andre måleenheter forbedres og automatiseringen modnes, bør du forvente at syklustiden reduseres. Hvis kundeservicen din er god og utviklingsfeilene få, har du funnet en vinnende kombinasjon for å skalere virksomheten.
Avsluttende tanker
Som enhver annen metodikk lykkes DevOps bare hvis det implementeres riktig. Og du kan ikke vite om det er vellykket før du vet hvordan du bruker DevOps-måleenheter.
Det å implementere DevOps-måleenheter har selvsagt sine utfordringer. Det krever en strategisk tankegang, en samarbeidskultur og en forpliktelse til kontinuerlig forbedring. Resultatet er imidlertid optimaliserte arbeidsflyter og prosesser som du kan bygge et solid grunnlag for å skalere virksomheten på.
Hvis du vil holde deg oppdatert med nyheter og artikler, abonner på nyhetsbrevet vårt!