

Databricks er kraftig, men det passer ikke alltid. Kanskje teamet ditt har støtt på problemer med prisen, hatt vansker med plattformens læringskurve eller trenger noe mer fleksibelt for oppsett med flere skyer eller lokalt installerte løsninger. Uansett årsak er du sannsynligvis på jakt etter et alternativ som tilbyr tilsvarende funksjonalitet for datasjøhus, uten ulempene.
Jeg har jobbet med datateam i både oppstartsbedrifter og større virksomheter for å evaluere og implementere plattformer som Databricks, Snowflake og andre. Jeg har sett på nært hold hva som kreves for å støtte storskalaanalyse, samle uensartede datakilder og bygge pålitelige datapipelines som faktisk blir brukt.
I denne veiledningen går jeg gjennom Databricks-alternativene som er verdt å vurdere – verktøy som gjør det enklere å lagre, transformere og utforske data, samtidig som de gir deg rom til å skalere og tilpasse deg etter hvert som teamet ditt vokser.
Hvorfor du kan stole på våre programvareanbefalinger
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Teamet vårt har testet og anmeldt programvare siden 2012. Vi er selv teknologiledere, så vi vet hvor vanskelig og hvor viktig det er å velge riktig programvare.
I denne guiden har vi vurdert verktøyene gjennom praktisk testing og uavhengig research og gitt dem poeng ut fra våre utvelgelseskriterier.
Anmeldelsene våre bygger på vår egen redaksjonelle vurdering. De er ikke et salgsargument.
Ekspertanmeldere:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabell: Databricks-konkurrenter
Denne sammenligningstabellen oppsummerer prisdetaljene for mine beste utvalgte Databricks-konkurrenter.
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Best for skybaserte datavarehus | 3.5 out of 5 | 4 | 3 | 4 | 3 | 3 | 4 | Priser på forespørsel Nei | Website |
Best for distribusjon av data på tvers av flere skyer | Not rated | 3 | 2 | 3 | 2 | Not rated | 4 | Pris på forespørsel Gratis abonnement tilgjengelig | Website |
Best for dataintegrasjonsoppgaver | Not rated | 4 | 4 | 4 | 2 | Not rated | 3 | $1,170/user/year Gratis prøveperiode tilgjengelig | Website |
Best for behandling i minnet | 2.2 out of 5 | 4 | 2 | 2 | 2 | 1 | 2 | Pris på forespørsel Gratisabonnement tilgjengelig | Website |
Best for raske SQL-spørringer | 3.5 out of 5 | 4 | 3 | 4 | 3 | 3 | 4 | $6.25/TiB behandlet Ja | Website |
Best for databasebehov i virksomheter | Not rated | 3 | Not rated | 3 | 3 | Not rated | 3 | $68/bruker/måned Gratis prøveversjon tilgjengelig | Website |
Best for SQL-analyse | 3.3 out of 5 | 4 | 4 | 3 | 2 | 3 | 4 | $30/user/month 30 dagers gratis prøveperiode | Website |
Best for Hadoop-behandling | 3.3 out of 5 | 4 | 3 | 4 | 2 | 3 | 4 | $0.007084/vCPU-time Ikke tilgjengelig | Website |
Best for administrert Spark og Hadoop | 3.3 out of 5 | 4 | 3 | 4 | 3 | 2 | 4 | $0.06/DCU-time Ikke tilgjengelig | Website |
Best for AI- og ML-løsninger | 2.7 out of 5 | 2 | 2 | 3 | 5 | 3 | 1 | Pris på forespørsel Gratis demonstrasjon tilgjengelig | Website |


Anmeldelser av de beste Databricks-konkurrentene
Nedenfor finner du mine detaljerte sammendrag av de beste Databricks-konkurrentene som kom med på kortlisten. Anmeldelsene mine gir et detaljert innblikk i de viktigste funksjonene, fordelene og ulempene, integrasjonene og de ideelle bruksområdene for hvert verktøy, slik at du kan finne det som passer best for deg.

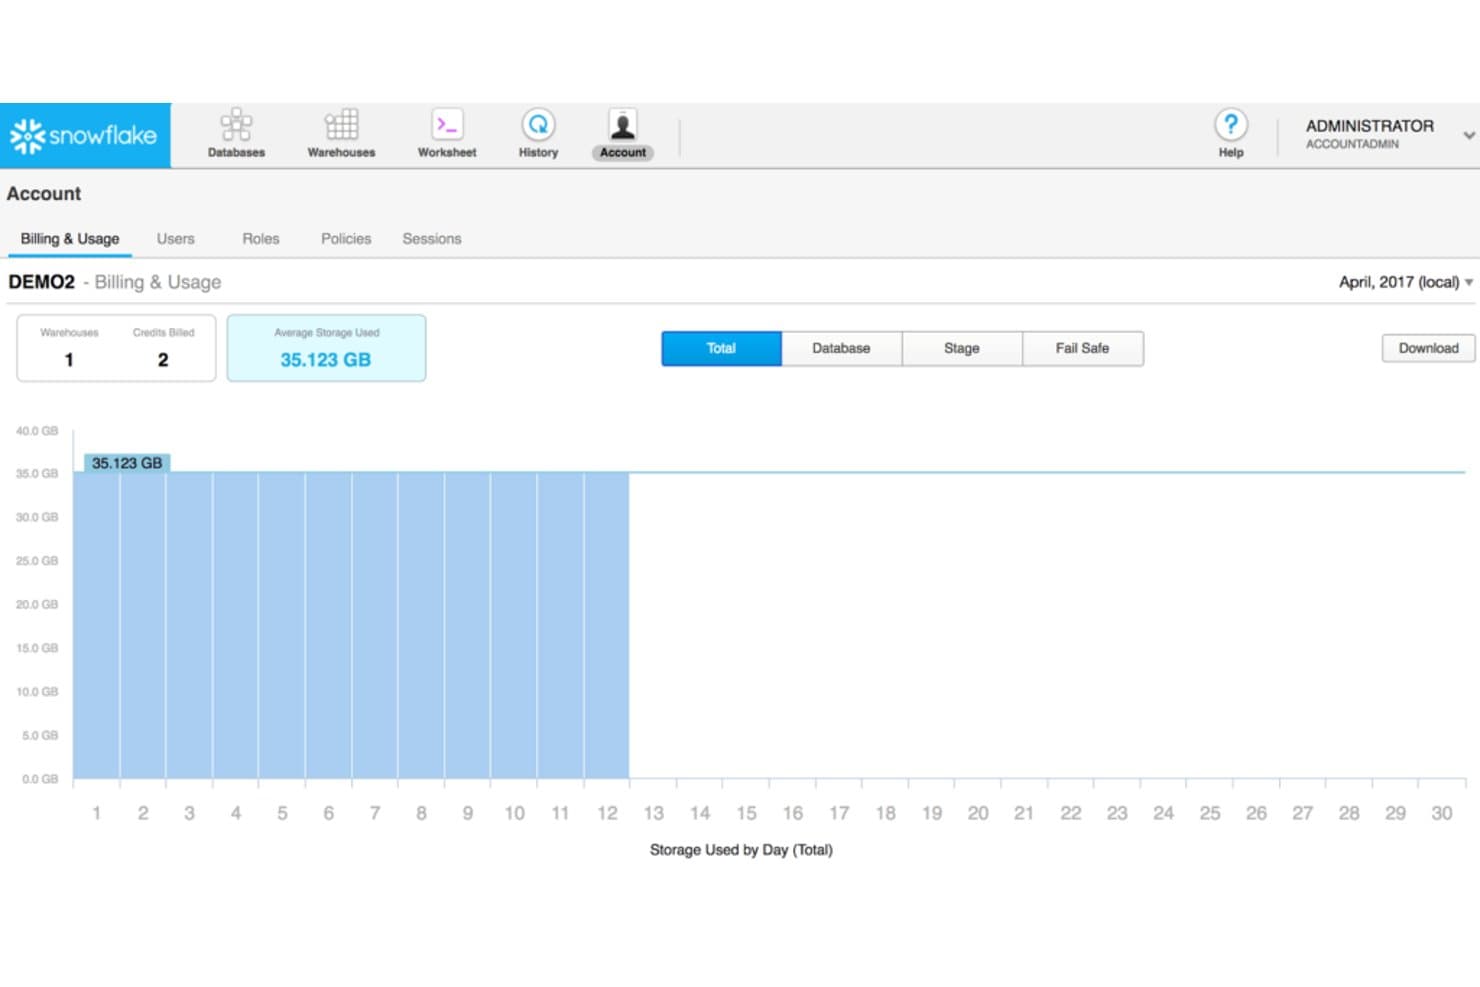
Snowflake registrerer lagrings- og kredittbruk per dag i ett dashbord. Snowflake gir IT- og analyseteam en skybasert dataplattform for å samle ulike datasett, kjøre SQL-spørringer i stor skala og gi styrt tilgang uten å administrere datavarehusinfrastruktur.
Hvem passer Snowflake best for?
Datateknikk- og analyseteam som trenger et skybasert datavarehus for å spørre etter og dele data på tvers av forretningssystemer.
Hvorfor jeg valgte Snowflake
Jeg valgte Snowflake som «Best for skybaserte datavarehus» fordi den separate lagringen og databehandlingen gjør at jeg kan skalere SQL-analyse uten å endre størrelsen på datalaget. Jeg setter også pris på den styrte datadelingen når team trenger å spørre etter datasett på tvers av forretningssystemer uten å kopiere dem til separate datavarehus.
Viktige funksjoner i Snowflake
- Dynamiske tabeller: Definer datapipelines med SQL og angi ønsket forsinkelse for oppdatering.
- Snowpipe: Last inn data fra mellomlagrede filer etter hvert som de ankommer.
- Datatilgang på tvers av tid: Spør etter, klon eller gjenopprett historiske data innenfor oppbevaringsperioden.
- Snowflake Marketplace: Oppdag og få tilgang til datasett og applikasjoner fra tredjeparter.
Snowflake-integrasjoner
Snowflake tilbyr Openflow-koblinger for Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL og Microsoft SQL Server. Plattformen tilbyr også innebygde koblinger for ServiceNow, MySQL og Kafka, samt REST API-er for tilpassede integrasjoner.
Pros and Cons
Pros:
- Uavhengig skalering av databehandling håndterer svingninger i arbeidsbelastningen
- Administrerte SQL-datavarehus reduserer behovet for infrastrukturvedlikehold
- Sikker deling unngår kopiering av datasett mellom team
Cons:
- Forbrukstopper kan gjøre kostnadene uforutsigbare
- Proprietære funksjoner kan gjøre plattformmigrering mer komplisert
Learn more about Snowflake: Best for distribusjon av data på tvers av flere skyer
- Gratis abonnement tilgjengelig
- Pris på forespørsel
Visit WebsiteCustomer Rating:4.5/5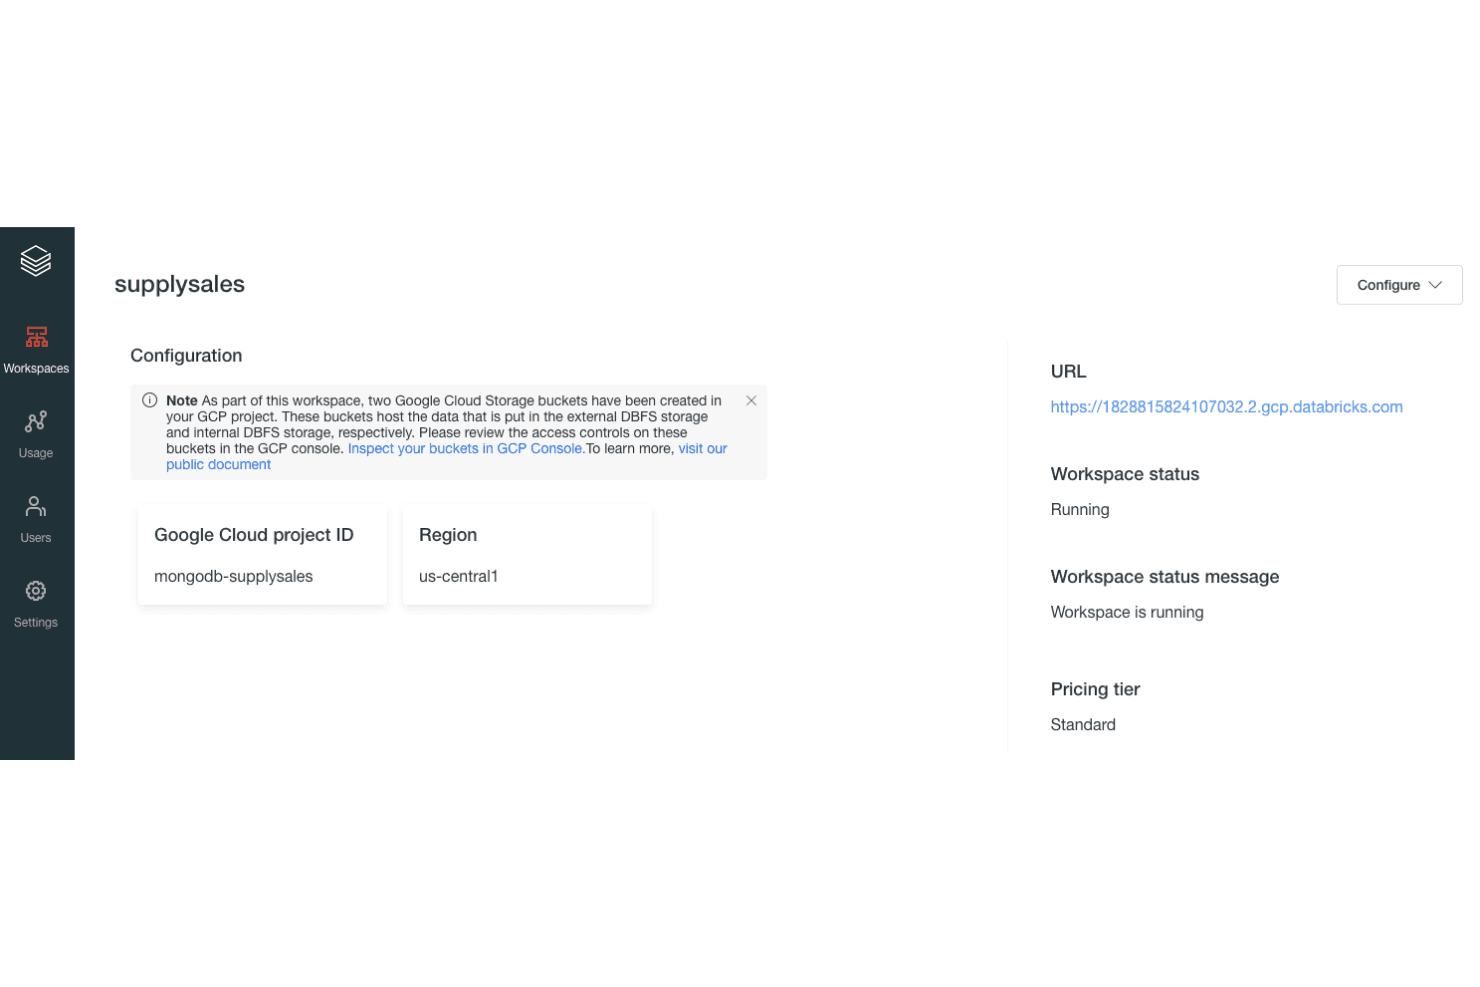
MongoDB Atlas integreres med Databricks-arbeidsområder på GCP for databehandling. MongoDB Atlas gir IT- og datateam en administrert dokumentdatabase for applikasjoner som trenger fleksible datamodeller, pålitelige spørringer og mindre databasevedlikehold.
Hvem passer MongoDB Atlas best for?
IT- og plattformteam som distribuerer applikasjoner på tvers av flere skyleverandører, vil sette pris på MongoDB Atlas’ administrerte database og fleksibilitet på tvers av skyer.
Hvorfor jeg valgte MongoDB Atlas
Jeg valgte MongoDB Atlas som et alternativ til Databricks for Best for distribusjon av data på tvers av flere skyer. Atlas støtter flerskyklynger på tvers av AWS, Azure og Google Cloud, mens aggregeringspipelinjen lar deg analysere applikasjonsdata som er lagret i MongoDB. Jeg ville brukt det til å spørre operasjonelle data nær tjenestene som kjører på tvers av ulike skyleverandører.
Viktige funksjoner i MongoDB Atlas
- Atlas-søk: Opprett fulltekstsindekser og kjør søk rangert etter relevans.
- Atlas-diagrammer: Bygg dashbord og visualiseringer fra MongoDB-data.
- Datasammenslutning: Spør etter data på tvers av Atlas-databaser og skylagring for objekter.
- Automatiserte sikkerhetskopier: Planlegg databaseøyeblikksbilder og gjenopprett fra lagrede tidspunkter.
Integrasjoner med MongoDB Atlas
MongoDB Atlas dokumenterer integrasjoner med Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta og Microsoft Entra ID. Det tilbyr også et administrasjons-API for egendefinerte integrasjoner.
Pros and Cons
Pros:
- Flerskyklynger på tvers av AWS, Azure og Google Cloud
- Fleksible dokumenter håndterer endringer i applikasjonens datamodeller
- Aggregeringspipelinjer analyserer operasjonelle data på stedet
Cons:
- Mindre egnet for omfattende analysearbeidsbelastninger i innsjøhus
- Aggregeringsytelse kan kreve nøye optimalisering av spørringer
Learn more about MongoDB Atlas: Best for dataintegrasjonsoppgaver
- Gratis prøveperiode tilgjengelig
- $1,170/user/year (fakturert årlig)
Visit WebsiteCustomer Rating:4.2/5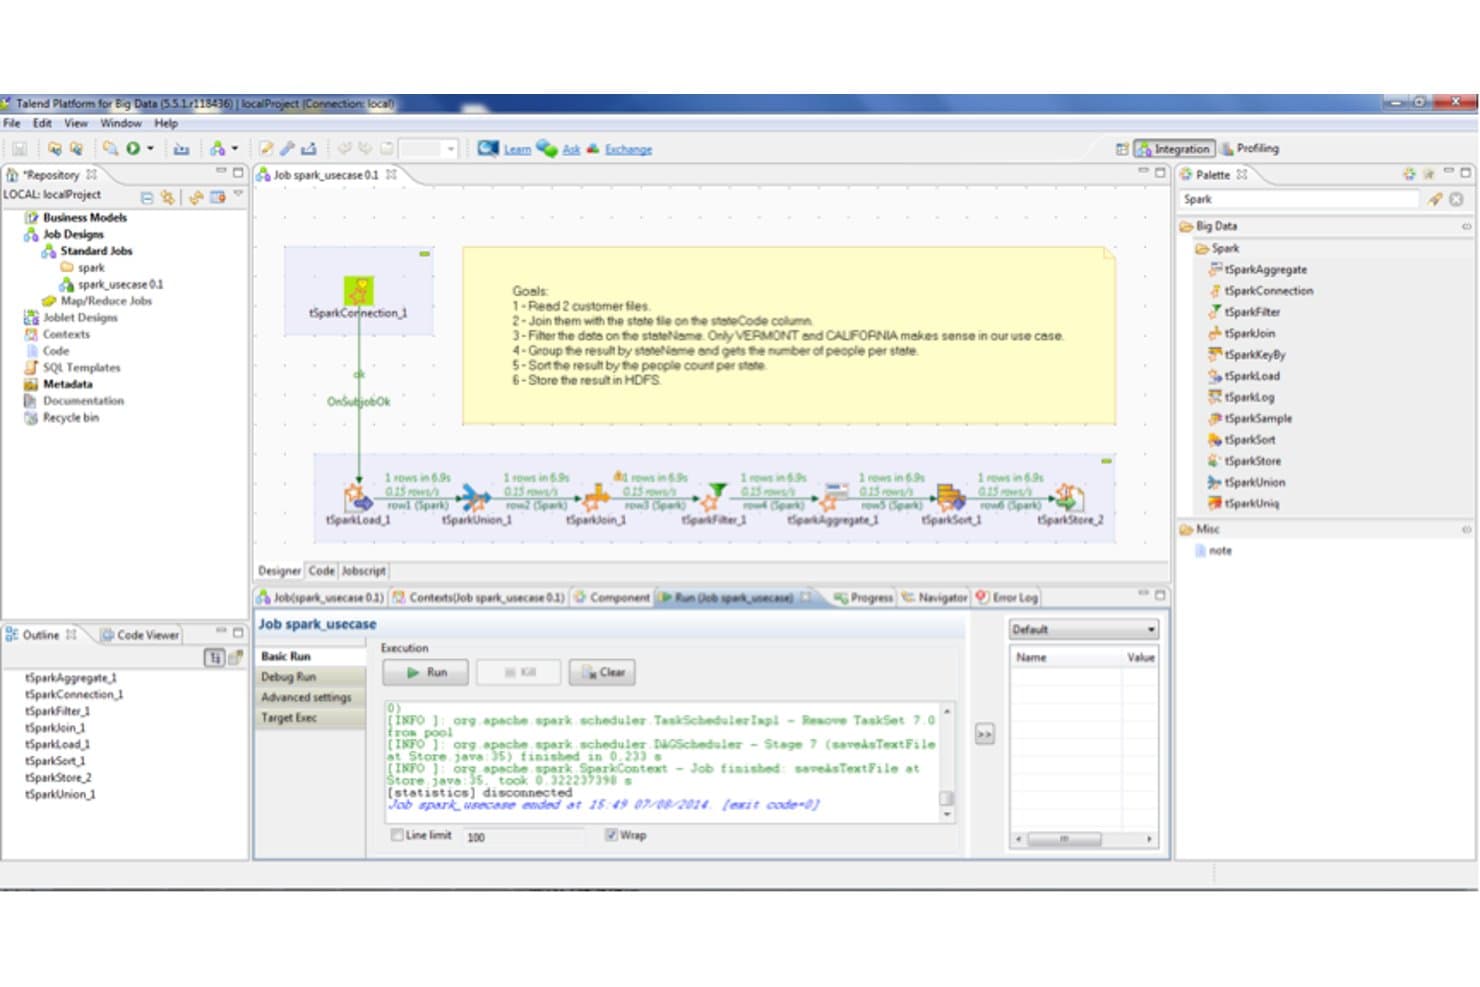
Talend lar brukere bygge og kjøre Spark-datapipelines visuelt. Talend er en dataintegrasjonsplattform for IT- og datateam som kobler sammen informasjon på tvers av systemer, noe som bidrar til å redusere datasiloer og holde datapipelines håndterbare etter hvert som miljøene vokser.
Hvem passer Talend best for?
Talend passer for IT- og datateknologiteam som trenger å koble sammen skybaserte, lokale og eldre systemer.
Hvorfor jeg valgte Talend
Jeg valgte Talend som en konkurrent til Databricks fordi «Best for dataintegrasjonsoppgaver» er akkurat området der løsningen passer. Den visuelle jobbdesigneren og tMap-transformasjonene lar meg slå sammen og omforme poster mellom en eldre database og et skybasert datavarehus. Jeg setter også pris på Talends datakvalitetskomponenter for å fange opp feilformaterte poster før de når nedstrømssystemene.
Viktige funksjoner i Talend
- Koblinger: Koble til databaser, skyapplikasjoner, filer og andre systemer gjennom ferdigbygde koblinger.
- Endringsdatafangst: Registrer databaseinnsettinger, oppdateringer og slettinger etter hvert som de skjer.
- Datastyring: Spor dataflyter fra kildesystemer gjennom jobber til destinasjonene.
- Metadatadetektering: Skann datakilder for å identifisere datasett, formater og mønstre.
Talend-integrasjoner
Talend inkluderer koblinger eller komponenter for systemer som Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle og MongoDB. Plattformen støtter også REST- og SOAP-tjenester, og Qlik Talend Data Integration tilbyr API-er for administrering av datatilkoblinger.
Pros and Cons
Pros:
- Visuelle jobber håndterer sammenføyninger og omforming
- Batch- og sanntidspipelines støtter ulike arbeidsbelastninger
- Datakvalitetsverktøy markerer feilformaterte poster
Cons:
- Store jobber kan kreve JVM-justering
- Generert Java gjør feilsøking og revisjoner mer kompliserte
Learn more about Talend: Best for behandling i minnet
- Gratisabonnement tilgjengelig
- Pris på forespørsel
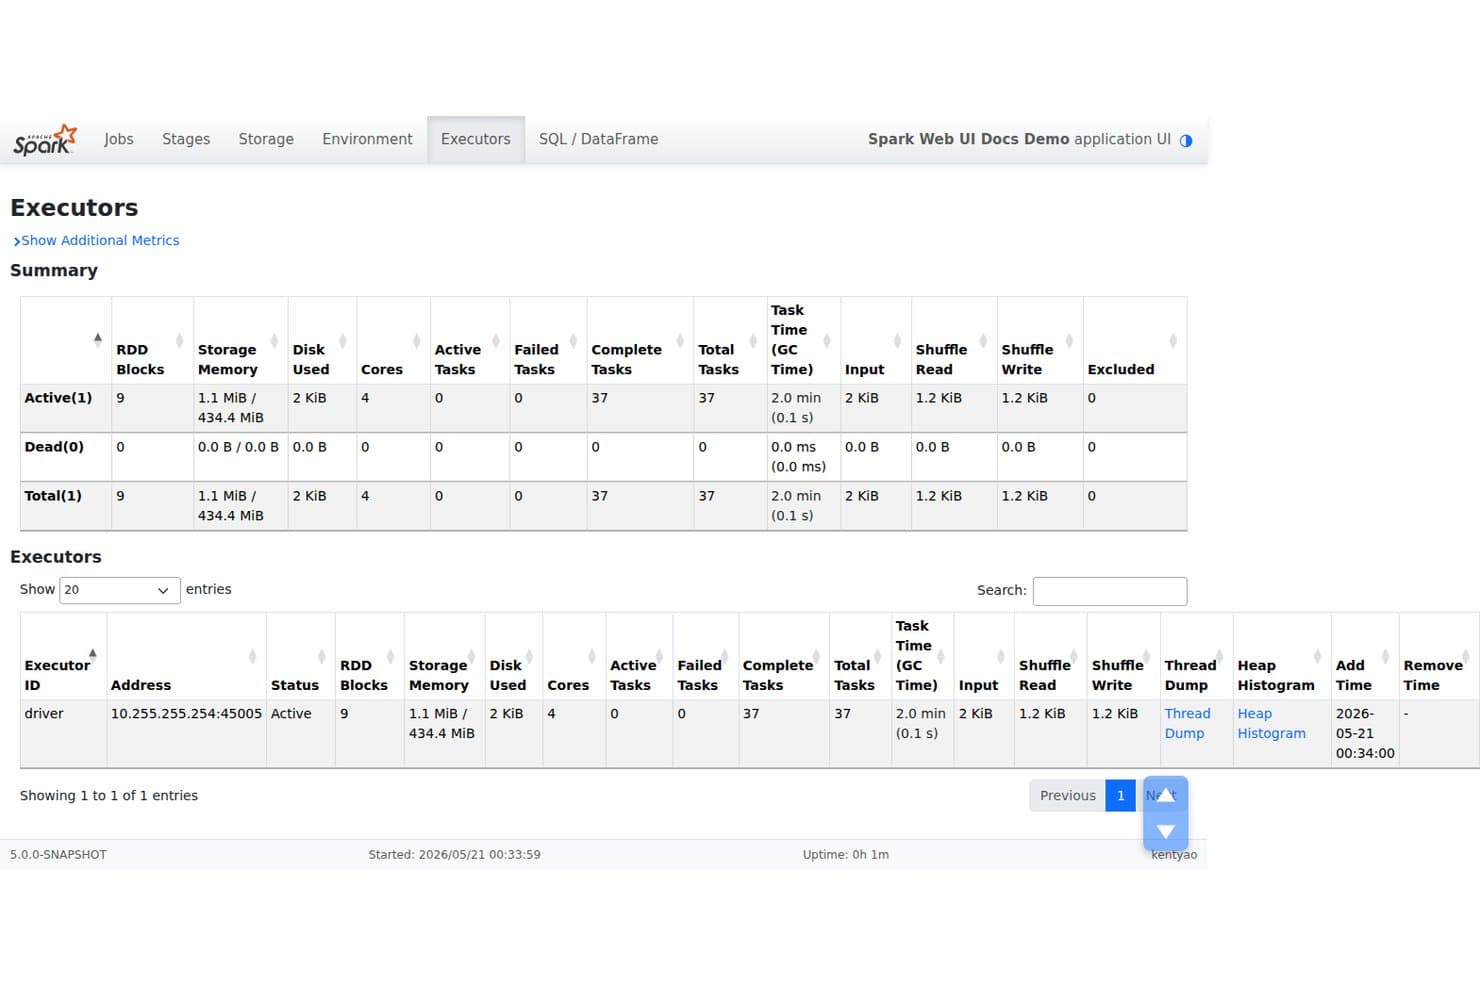
Apache Sparks nettgrensesnitt sporer utførerressurser, oppgaver og minne i sanntid. Apache Spark er en åpen kildekodebasert analysemotor for data- og infrastruktuream som trenger å behandle store datasett, kjøre distribuerte arbeidsbelastninger og bygge datapipelines på tvers av ulike miljøer.
Hvem passer Apache Spark best for?
Dataingeniør- og analyseteam som trenger rask, iterativ behandling av store datasett på tvers av klynger, passer godt for Apache Spark.
Hvorfor jeg valgte Apache Spark
Jeg valgte Apache Spark som et alternativ til Databricks fordi det er best for behandling i minnet. Spark kan hurtigbufre eller lagre RDD-er og DataFrames i minnet, slik at gjentatte spørringer og iterative beregninger unngår å lese kildedataene på nytt. Dette er nyttig når man forbedrer aggregater av store hendelsesdatasett gjennom flere analyserunder.
Viktige funksjoner i Apache Spark
- Spark SQL: Spør etter strukturerte data med SQL- og DataFrame-API-er.
- Strukturert strømming: Behandle data i sanntid med Sparks strømme-API-er.
- MLlib: Bygg arbeidsflyter for maskinlæring med skalerbare algoritmer og pipelines.
- Klyngeadministratorer: Distribuer applikasjoner på frittstående klynger, YARN eller Kubernetes.
Integrasjoner med Apache Spark
Apache Spark støtter koblinger for Apache Kafka og Apache Hive, samt JDBC-tilkoblinger til databaser som PostgreSQL, MySQL, Oracle og Microsoft SQL Server. Datakilde-API-et støtter egendefinerte koblinger; avhengigheter for Kafka-koblingen og databasespesifikke JDBC-drivere må kanskje legges til separat.
Pros and Cons
Pros:
- Bufrede datasett øker hastigheten på iterative arbeidsbelastninger
- Batchbehandling, strømming, SQL og maskinlæring deler én motor
- Kjører lokalt eller på tvers av Kubernetes- og YARN-klynger
Cons:
- Minnepress kan utløse feil på grunn av utilstrekkelig minne
- Optimalisering og feilsøking av distribuerte jobber krever ekspertise
Learn more about Apache Spark:
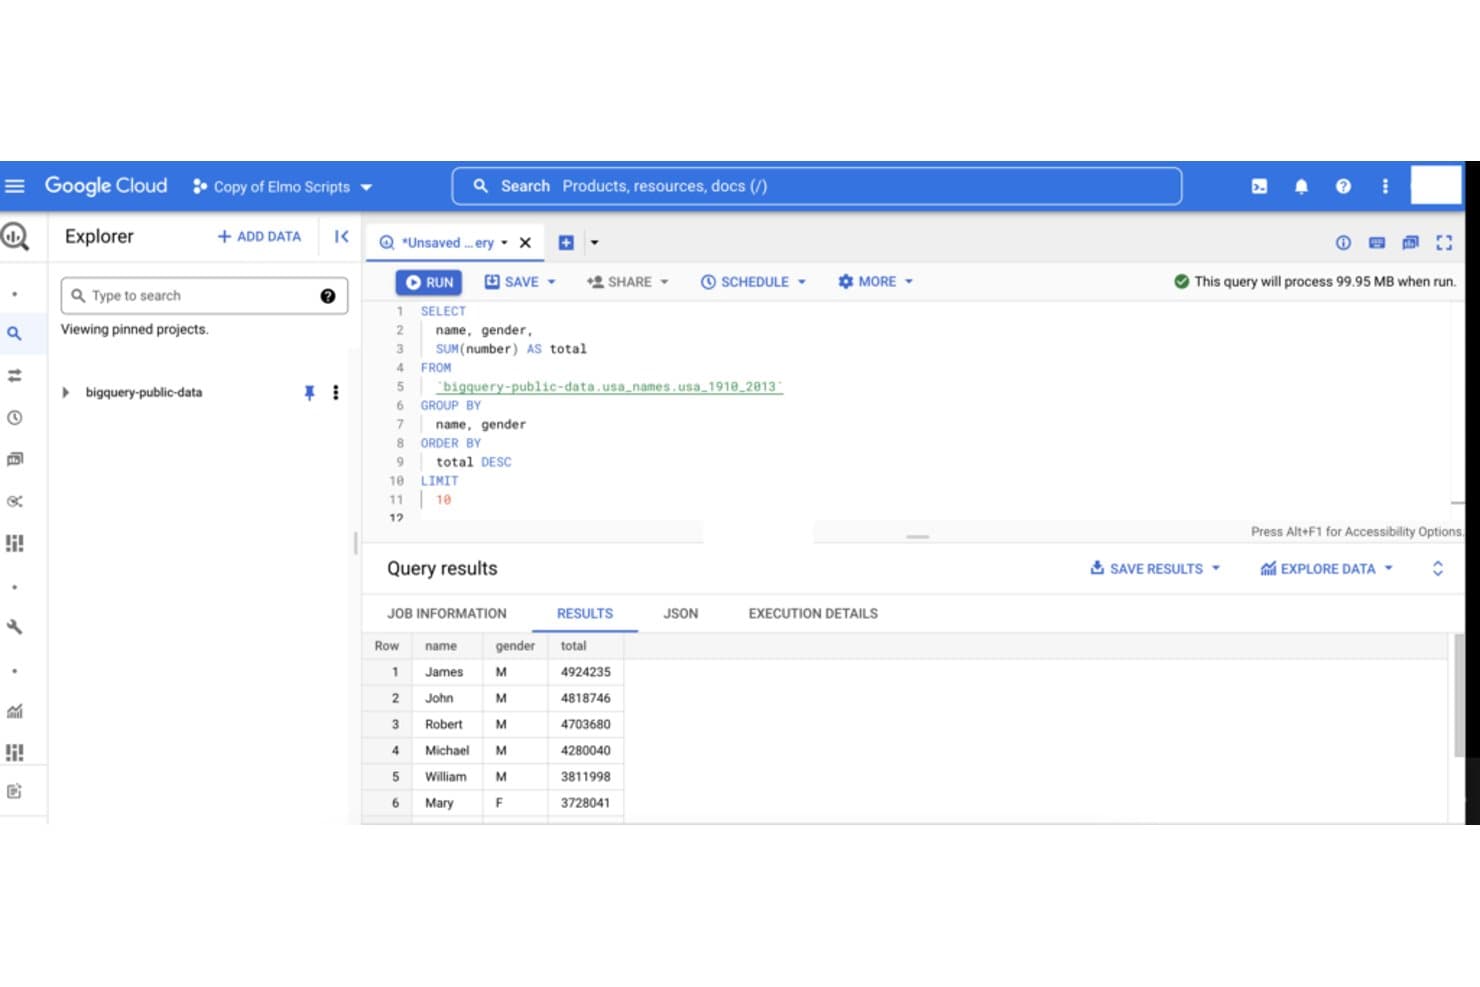
Google BigQuery lar brukere kjøre SQL-spørringer på store offentlige datasett. For IT- og datateam som trenger skalerbar analyse uten å administrere lagerinfrastruktur, er Google BigQuery et skybasert datalager for spørring mot og analyse av store datasett med SQL.
Hvem passer Google BigQuery best for?
Dataanalytikere og dataingeniører som trenger å kjøre raske SQL-spørringer på tvers av store datasett i skyen, vil finne Google BigQuery som et praktisk alternativ.
Hvorfor jeg valgte Google BigQuery
Jeg valgte Google BigQuery som mitt alternativ til Databricks for «Best for raske SQL-spørringer». Den serverløse spørringsmotoren kjører GoogleSQL på tvers av store datasett, mens tabellpartisjonering og klynging kan redusere mengden data som skannes for regelmessige rapporter. Jeg liker det for spørringer mot applikasjonslogger eller hendelsesdata uten å måtte administrere datalagerklynger.
Viktige funksjoner i Google BigQuery
- BigQuery ML: Opprett og kjør maskinlæringsmodeller med SQL.
- Planlagte spørringer: Still inn SQL-jobber til å kjøre med valgte intervaller.
- BigQuery Data Transfer Service: Planlegg dataimporter fra støttede kilder.
- Autoriserte visninger: Del spørringsresultater uten å gi tilgang til de underliggende tabellene.
Integrasjoner med Google BigQuery
Google dokumenterer direkte BigQuery-integrasjoner med Looker, Looker Studio, Vertex AI Workbench, den administrerte tjenesten for Apache Spark og Tableau. Datatilkoblinger og arbeidsflyter for innlasting støtter også Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 og Azure Blob Storage; BigQuerys REST- og Storage-API-er støtter egendefinerte integrasjoner.
Pros and Cons
Pros:
- Raske SQL-skanninger på tvers av store datasett
- Serverløs drift eliminerer behovet for klyngestyring
- Partisjonering og klynging kan redusere mengden skannede data
Cons:
- Spørringskostnadene kan øke kraftig uten begrensninger
- Utforskning for forretningsbrukere krever ofte SQL-kompetanse
Learn more about Google BigQuery: Best for databasebehov i virksomheter
- Gratis prøveversjon tilgjengelig
- $68/bruker/måned (fakturert årlig)
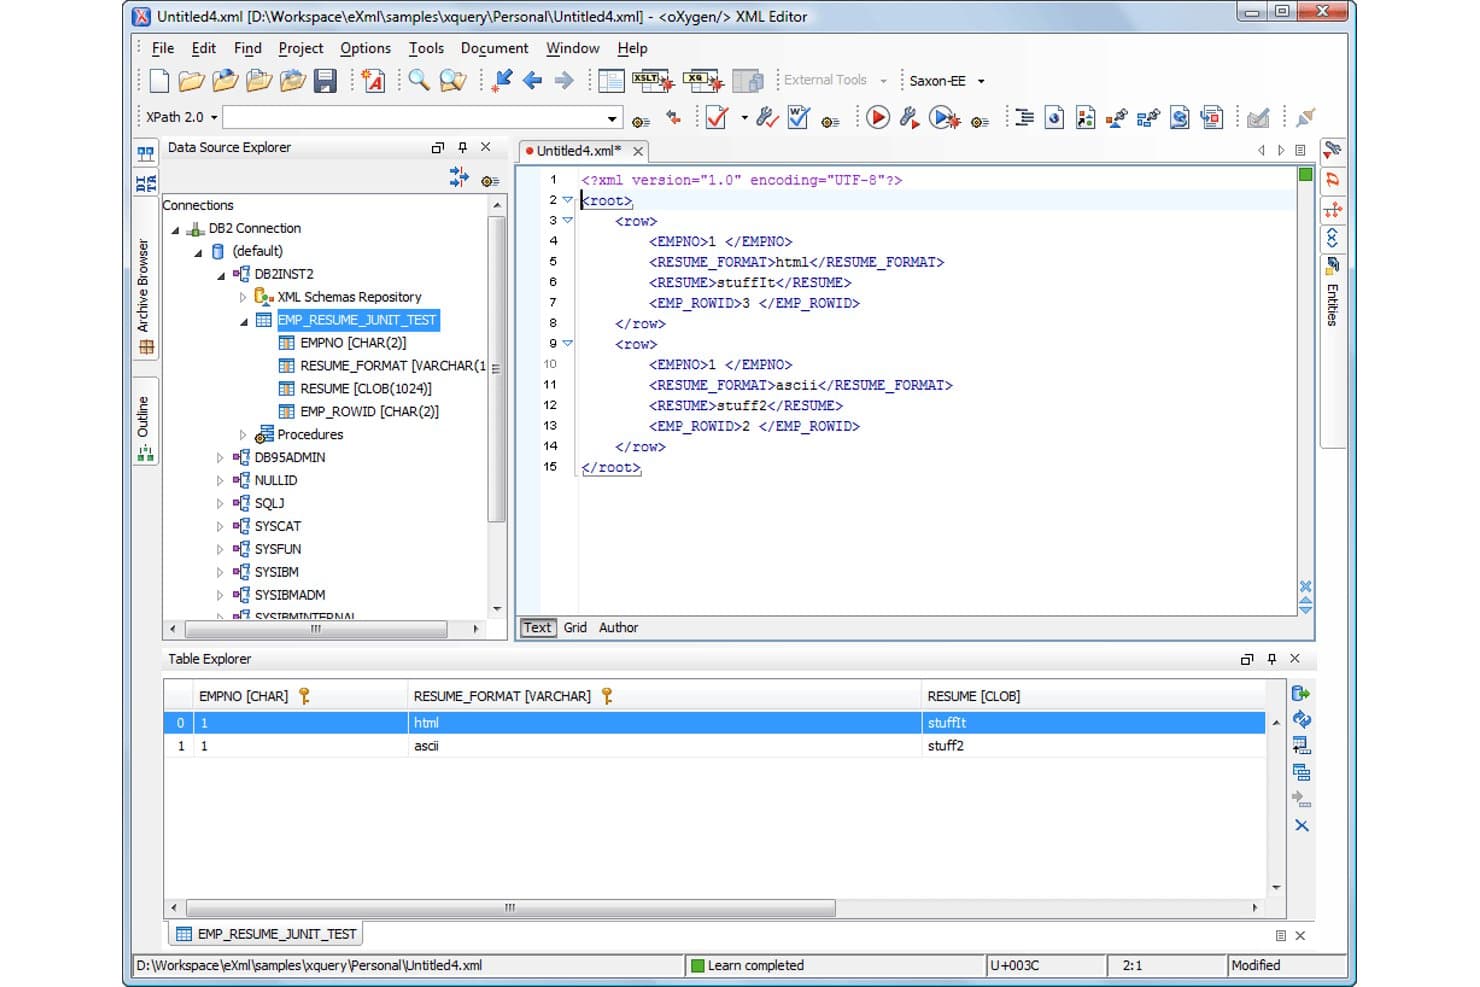
IBM Db2 lar brukere bla gjennom databaseskjemaer og spørre etter XML-data visuelt. IBM Db2 er et system for relasjonell databaseadministrasjon for organisasjoner som trenger å kjøre strukturerte dataarbeidsbelastninger på tvers av komplekse miljøer, og støtter team som administrerer virksomhetsapplikasjoner, transaksjoner og analyser.
Hvem passer IBM Db2 best for?
Databaseadministratorer og IT-team i store organisasjoner som støtter forretningsapplikasjoner med høyt volum.
Hvorfor jeg valgte IBM Db2
Jeg valgte IBM Db2, best for databasebehov i virksomheter, som et Databricks-alternativ for sentrale forretningssystemer. Det støtter transaksjonsdata, analytiske data og vektordata på én plattform, med AI-drevet optimalisering av arbeidsbelastninger for ERP, fakturering og ordrebehandling. Jeg setter pris på denne egenskapen når relasjonelle arbeidsbelastninger og analyser må dele infrastruktur.
Viktige funksjoner i IBM Db2
- Hybrid distribusjon: Kjør Db2 lokalt, i skyen eller i hybride miljøer.
- Innebygd kryptering: Krypter databasedata og administrer krypteringsnøkler gjennom et nøkkellager.
- Tabellpartisjonering: Del tabelldata inn i partisjoner basert på angitte kolonneverdier.
- Verktøy for sikkerhetskopiering og gjenoppretting: Db2 Advanced Recovery støtter sikkerhetskopiering, gjenoppretting og uttrekking av data fra databaser.
Integrasjoner med IBM Db2
Innebygde integrasjoner er ikke tydelig dokumentert. Db2 støtter føderert tilgang til datakilder som Oracle og Microsoft SQL Server, samt JDBC-, ODBC- og CLI-tilkobling for applikasjoner.
Pros and Cons
Pros:
- Rask behandling av virksomhetens transaksjonsarbeidsbelastninger
- Høy tilgjengelighet med HADR og gjenoppretting
- Partisjonering støtter store, blandede arbeidsbelastninger
Cons:
- Administrasjon og finjustering krever spesialkompetanse
- Skybasert drift ligger etter nyere plattformer
Learn more about IBM Db2: Best for SQL-analyse
- 30 dagers gratis prøveperiode
- $30/user/month (faktureres årlig)
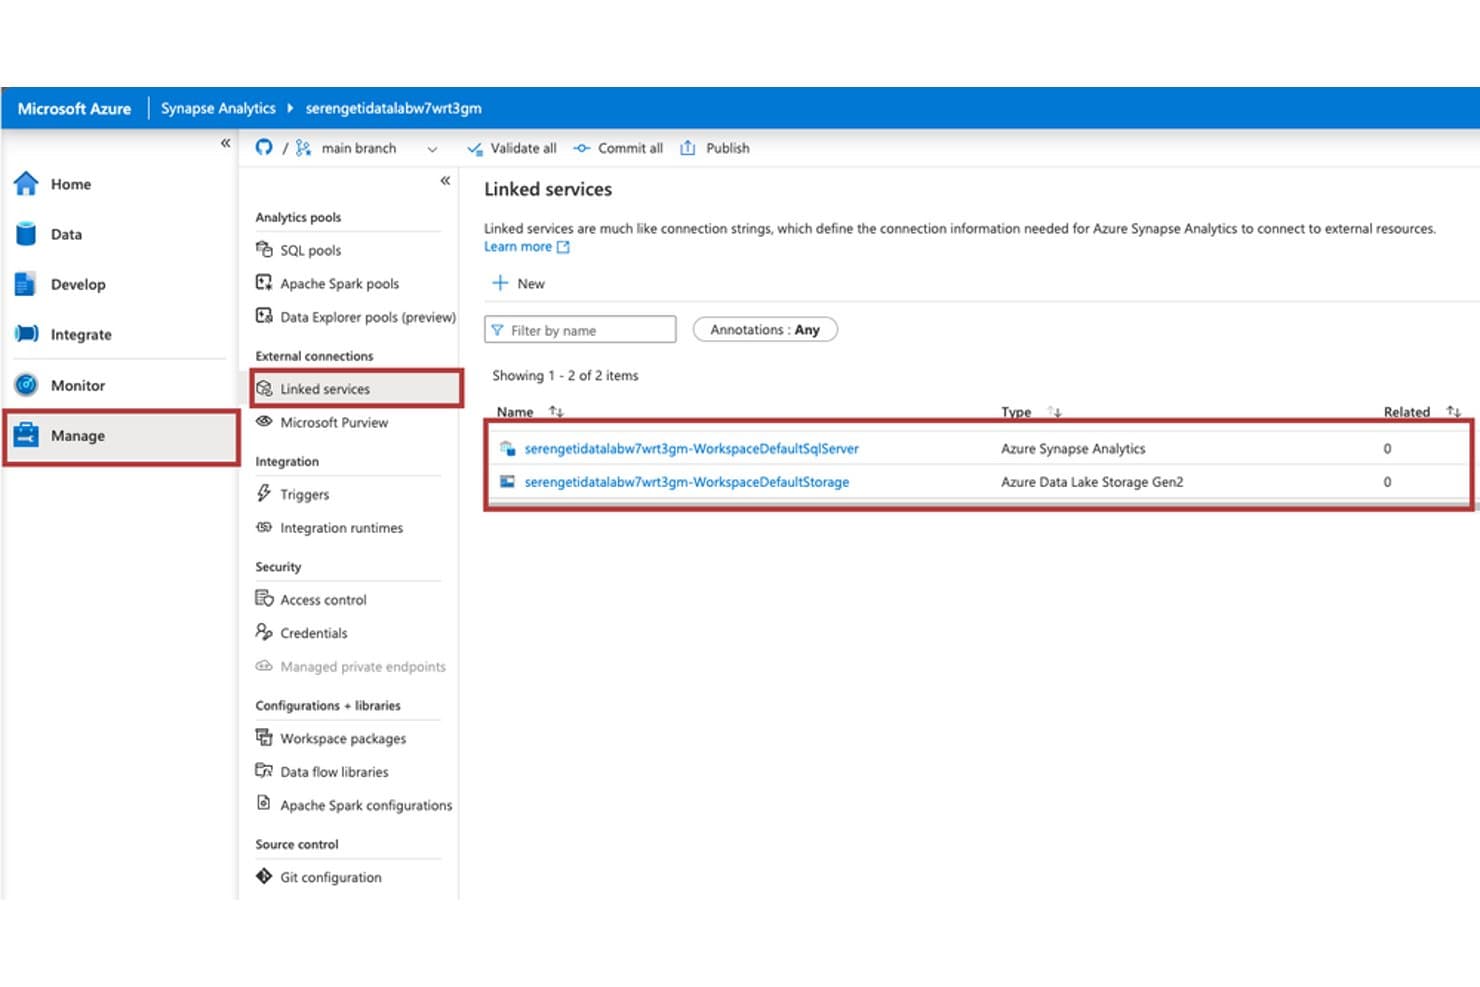
Azure Synapse Analytics administrerer eksterne tilkoblinger via tilknyttede tjenester. Azure Synapse Analytics er en skybasert analyseplattform for data- og IT-team som trenger å koble sammen virksomhetsdata, kjøre spørringer og støtte rapportering på tvers av datavarehus- og stordataarbeidsbelastninger.
Hvem passer Azure Synapse Analytics best for?
Den passer for dataingeniører og analytikere som trenger SQL-tilgang til integrerte datasett for virksomhetsrapportering og analyse.
Hvorfor jeg valgte Azure Synapse Analytics
Jeg valgte Azure Synapse Analytics for bruksområdet best for SQL-analyse: det serverløse SQL-poolen spør etter datafiler i datasjøen med T-SQL, mens dedikerte SQL-pooler støtter klargjorte datavarehusarbeidsbelastninger. Jeg liker dette skillet når jeg trenger å undersøke rådatasett og levere tilbakevendende BI-rapporter gjennom SQL.
Viktige funksjoner i Azure Synapse Analytics
- Apache Spark-pooler: Kjør Spark-jobber og notatbøker for distribuert databehandling.
- Datapipelines: Orkestrer dataflytting og transformasjon på tvers av tilkoblede kilder.
- Synapse Studio: Administrer data-, kode- og analyseressurser i et delt arbeidsområde.
- Power BI-integrasjon: Koble Synapse-data til Power BI for å opprette rapporter.
Integrasjoner med Azure Synapse Analytics
Azure Synapse Analytics har innebygde pipeline-koblinger for Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 og SAP HANA, samt en direkte Power BI-tilkobling gjennom Synapse Studio. Den tilbyr også REST-API-er for tilpassede integrasjoner.
Pros and Cons
Pros:
- Serverløse T-SQL-spørringer leser filer fra datasjøen
- Dedikerte MPP-pooler håndterer datavarehusarbeidsbelastninger
- Kombinerer SQL-spørringer med Spark-behandling
Cons:
- Optimalisering av SQL-pooler krever praktisk ekspertise
- Feilsøking og overvåking av datapipelines kan være begrenset
Learn more about Azure Synapse Analytics:
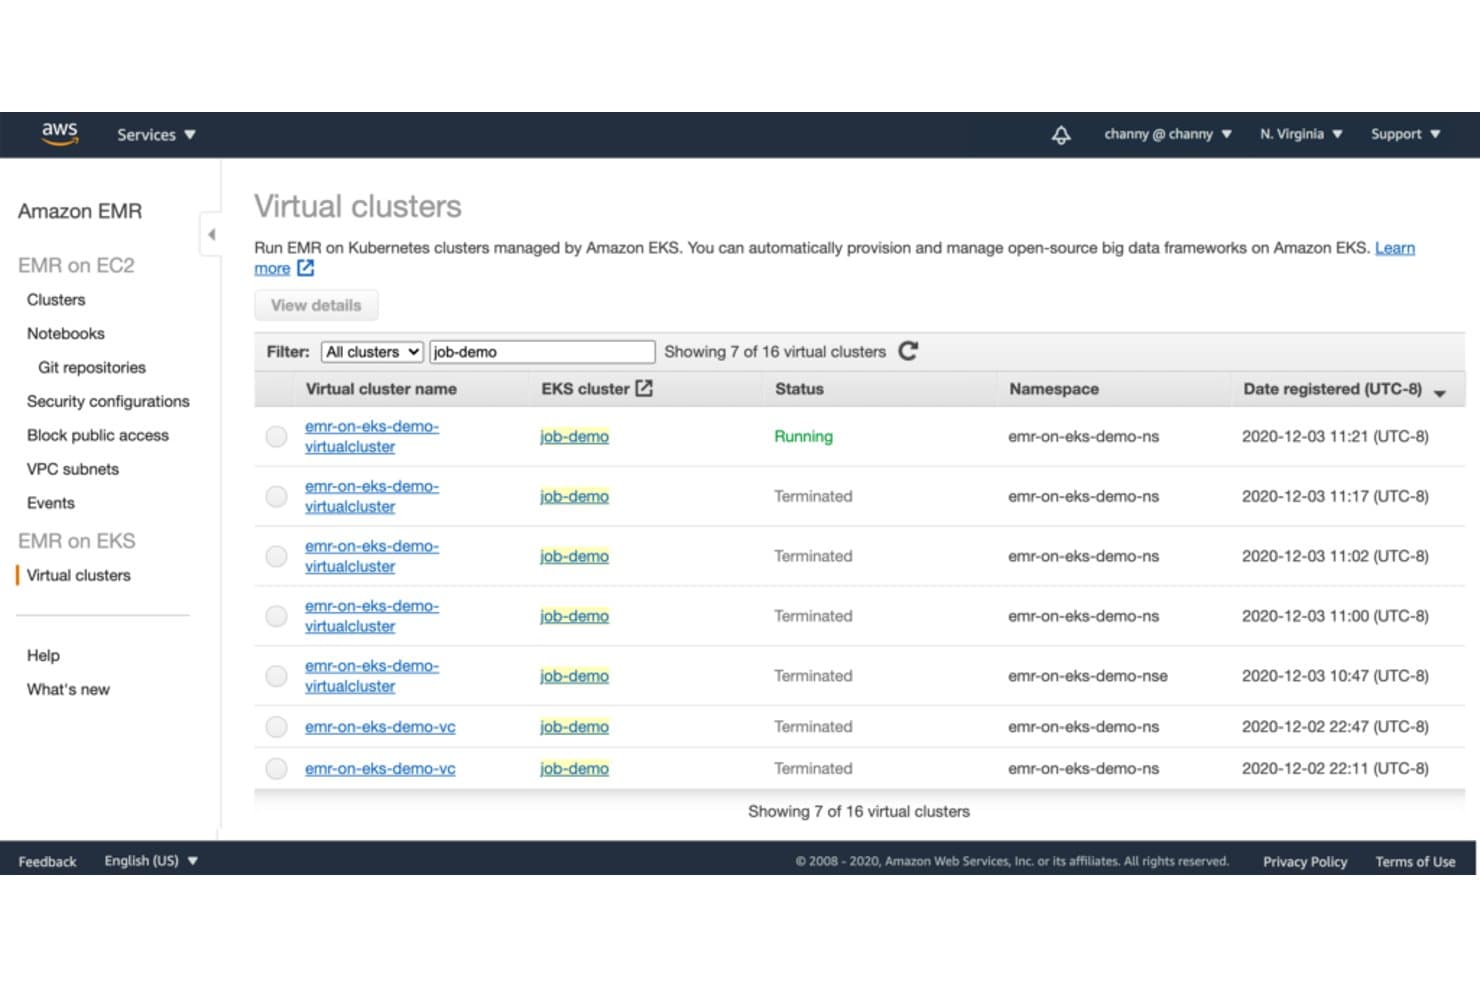
Amazon EMR lar brukere administrere virtuelle klynger som kjører på Amazon EKS. Amazon EMR er AWS’ administrerte plattform for stordata for dataingeniør- og analyseteam som trenger å behandle store datasett, skalere distribuerte arbeidsbelastninger og redusere arbeidet med å drifte dataklynger.
Hvem passer Amazon EMR best for?
Amazon EMR passer for dataingeniørteam som kjører Hadoop- eller Spark-jobber for å behandle store datasett på tvers av distribuerte klynger.
Hvorfor jeg valgte Amazon EMR
Jeg valgte Amazon EMR som et alternativ til Databricks av én grunn: Best for Hadoop-behandling. De administrerte klyngene kjører Apache Hadoop og Spark, så jeg kan bruke MapReduce til å behandle arkiverte applikasjonslogger og Spark til å analysere resultatene.
Viktige funksjoner i Amazon EMR
- EMR Serverless: Kjør dataapplikasjoner uten å klargjøre eller administrere klynger.
- Automatisk skalering: Juster klyngekapasiteten basert på arbeidsbelastningens behov.
- EMR på EKS: Kjør EMR-arbeidsbelastninger på Amazon EKS-klynger.
- AWS Glue Data Catalog: Bruk en delt katalog for tabellmetadata.
Integrasjoner med Amazon EMR
Amazon EMR har dokumenterte integrasjoner med AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 og Amazon CloudWatch. Det tilbyr også et API for programmatisk tilgang og tilpassede integrasjoner.
Pros and Cons
Pros:
- Kjører etablerte Hadoop- og Spark-arbeidsbelastninger
- Støtter distribusjon med klynger, serverløst og EKS
- Behandler store datasett på tvers av ulike arbeidsbelastninger
Cons:
- Langsom automatisk skalering kan føre til at jobber får for få ressurser
- Klyngeskalering krever noen ganger manuell justering
Learn more about Amazon EMR: Best for administrert Spark og Hadoop
- Ikke tilgjengelig
- Fra $0.06/DCU-time
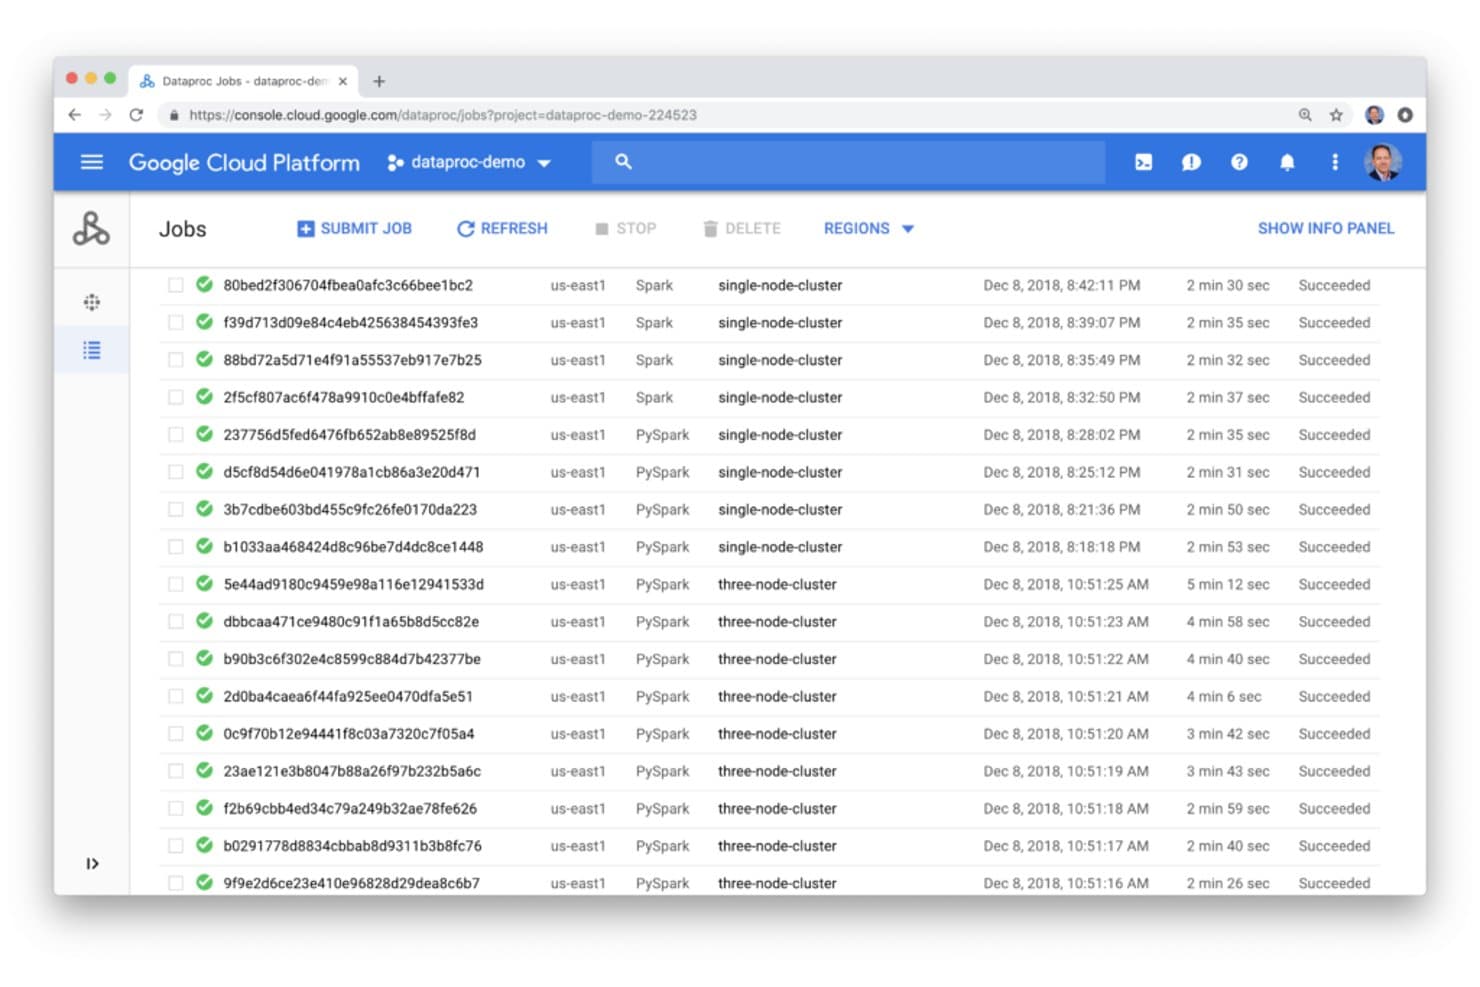
Google Cloud Dataproc lar brukere overvåke og administrere Spark-jobber med et øyekast. Google Cloud Dataproc gir dataingeniør- og IT-team en administrert skyplattform for storskala analysearbeidsbelastninger, noe som bidrar til å redusere klyngeadministrasjon og støtte datapipelines på tvers av Google Cloud.
Hvem passer Google Cloud Dataproc best for?
Dataingeniørteam som kjører Spark- eller Hadoop-jobber på Google Cloud, kan bruke Dataproc til å administrere klyngeoperasjoner.
Hvorfor jeg valgte Google Cloud Dataproc
Jeg valgte Google Cloud Dataproc for arbeidsbelastninger der «best for administrert Spark og Hadoop» er prioritert. Administrerte klynger og regler for automatisk skalering bidrar til å håndtere batchjobber med varierende ressursbehov, mens Dataproc Serverless kjører Spark-batcher uten klargjøring av klynger. Du kan for eksempel behandle hendelseslogger over natten med Spark og unngå å la en klynge stå ubrukt mellom kjøringene.
Viktige funksjoner i Google Cloud Dataproc
- Lightning-motoren: Akselererer Spark-kjøring med vektoriserte prosesser, hurtigbufring og optimalisert stokking.
- Støtte for Apache Iceberg: Fungerer med åpne tabellformater i Google Cloud Storage.
- GPU-akselerasjon: Støtter NVIDIA RAPIDS for GPU-aktivert databehandling.
- Sikkerhetskontroller: Integreres med IAM, VPC Service Controls og Kerberos.
Integrasjoner med Google Cloud Dataproc
Google Cloud Dataproc har innebygde integrasjoner med BigQuery, Cloud Storage, Bigtable, Cloud Logging og Cloud Monitoring. Det tilbyr også et REST API og Cloud SDK for administrasjon av klynger og jobber.
Pros and Cons
Pros:
- Kjører eksisterende Spark-jobber med minimale omskrivinger
- Rask oppretting og avvikling av klynger
- Serverløse batchjobber eliminerer behovet for klyngeadministrasjon
Cons:
- Optimalisering av klynger krever fortsatt infrastrukturkompetanse
- Kostnadene kan oppleves som høye for vedvarende arbeidsbelastninger
Learn more about Google Cloud Dataproc:
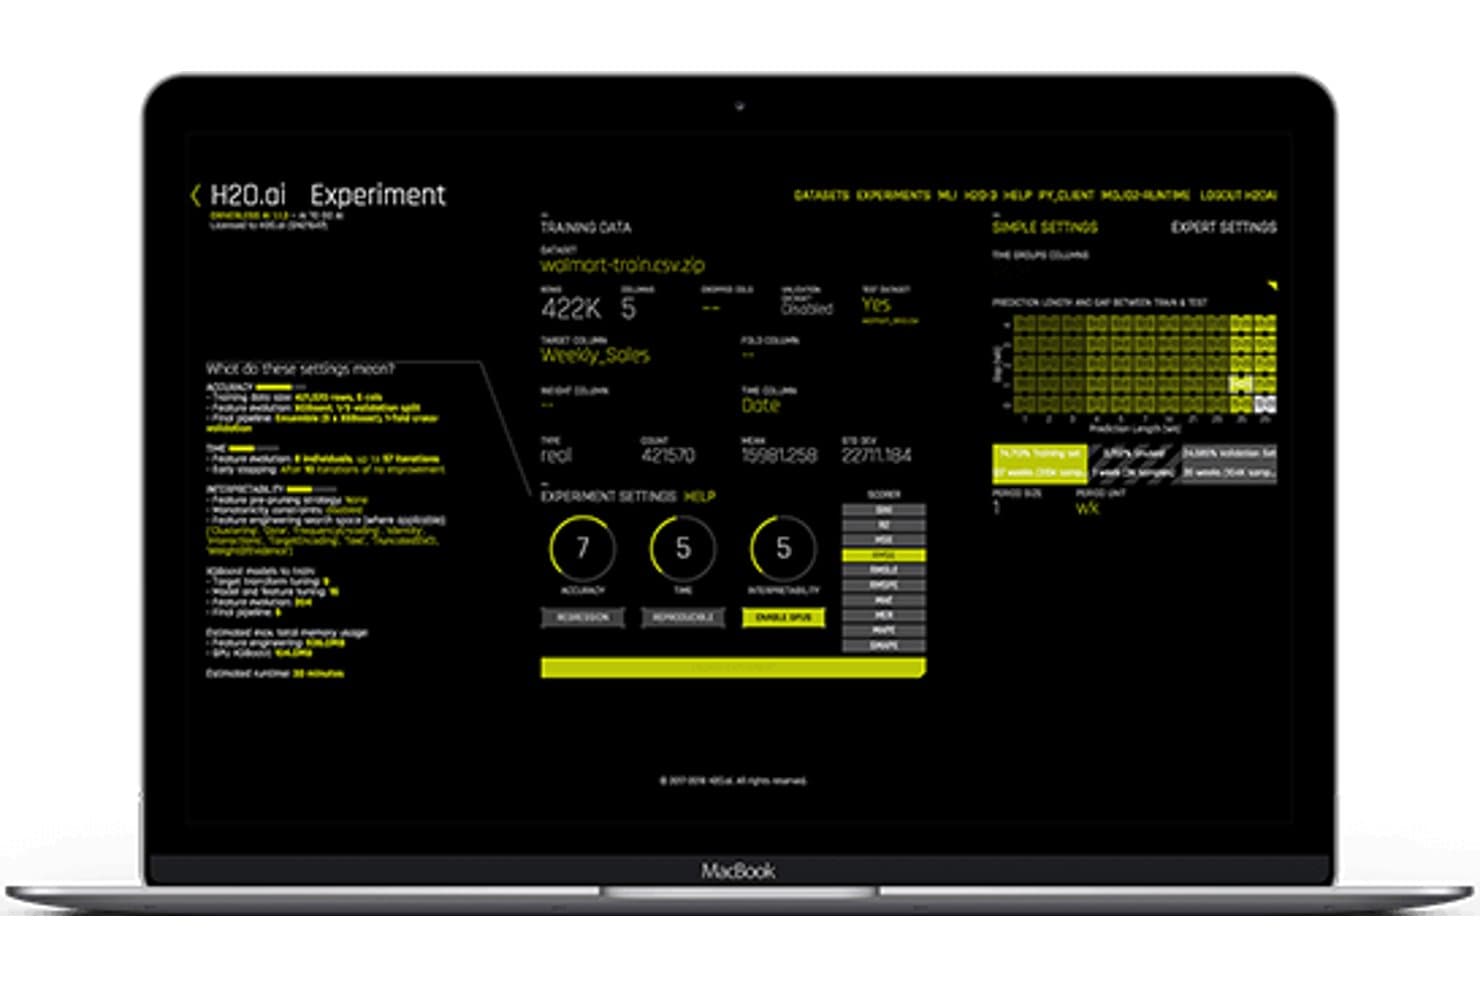
H2O.ai lar brukere konfigurere og kjøre AutoML-eksperimenter visuelt. For team som vurderer alternativer til Databricks, tilbyr H2O.ai en plattform for kunstig intelligens og maskinlæring som hjelper data- og IT-team med å bygge prediktive modeller fra store datasett og ta analyser i bruk.
Hvem passer H2O.ai best for?
H2O.ai passer for dataforskere og maskinlæringsingeniører som er ansvarlige for å utvikle AI-modeller og sette dem i produksjon.
Hvorfor valgte jeg H2O.ai?
Jeg valgte H2O.ai som mitt alternativ til Databricks, «best for AI- og ML-løsninger», fordi plattformen fokuserer på å bygge prediktive modeller fra store datasett. H2O-3 distribuerer maskinlæring i minnet på tvers av klynger, mens AutoML tester algoritmer og rangerer modeller på en ledertavle. Jeg liker denne løsningen når jeg trenger å sammenligne modeller før jeg setter én av dem i produksjon.
Viktige funksjoner i H2O.ai
- Fleksibel distribusjon: Kjør plattformen lokalt, i en privat sky, i skyen eller i miljøer uten nettverkstilkobling.
- Modelluavhengig støtte: Velg, bytt ut eller finjuster modeller og store språkmodeller.
- Forklarbarhet: Gå gjennom forklaringer på AI-drevne beslutninger.
- Revisjonsspor: Spor plattformaktivitet med revisjonsklare spor.
Integrasjoner med H2O.ai
H2O Driverless AI tilbyr datakoblinger for Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, JDBC-kilder og Delta Tables. Disse koblingene lar team spørre etter eller importere data fra eksisterende plattformer for arbeidsflyter innen maskinlæring.
Pros and Cons
Pros:
- AutoML gjør modellsammenligning og prototyping raskere
- Distribuert trening i minnet skalerer på tvers av klynger
- Distribusjon uten nettverkstilkobling støtter kontrollerte miljøer
Cons:
- Alternativene for datamanipulering er begrensede
- Et tungvint brukergrensesnitt kan gjøre arbeidsflytene langsommere
Learn more about H2O.ai:
Andre Databricks-konkurrenter
Her er noen flere alternativer til Databricks som ikke kom med på kortlisten min, men som likevel er verdt å undersøke:
- 11DremioBest for selvbetjent analyse
- 12QuboleBest for arbeidsbelastninger med store datamengder
- 13Azure DatabricksBest egnet for samarbeidende dataanalyse
Slik evaluerer jeg konkurrenter til Databricks
Enten teamet ditt kjører Spark-datapipeliner i stor skala eller administrerer en livssyklus for maskinlæring, evaluerer jeg hvert alternativ i to lag: først kravene til kjernearkitekturen for datasjøhus og databehandling, deretter forskjellene mellom løsningene.
Kjernefunksjonalitet (grunnleggende krav for denne listen)
Når jeg velger verktøy til listen min, rangerer jeg hvert av dem på en skala fra 0 (tilbyr ikke funksjonaliteten) til 5 (utmerker seg på dette området) for hver av kjernefunksjonene nedenfor. Deretter beregner jeg verktøyets totalscore som en prosentandel. Hvert verktøy må oppnå en samlet minimumsscore på 65 % for å bli vurdert for inkludering.
- Forent datasjø- og datavarehusarkitektur: Jeg undersøker om en plattform kan håndtere både strukturerte datavarehusspørringer og ustrukturert lagring i datasjøer, med støtte for åpne tabellformater som Delta, Iceberg eller Hudi.
- Distribuert databehandling: Arbeidsbelastninger for batchkjøring og strømming i stor skala trenger en distribuert motor som skalerer automatisk, så jeg evaluerer databehandlingsalternativene og hvordan plattformen håndterer jobber som ETL-kjøringer på flere terabyte.
- Integrerte arbeidsflyter for maskinlæring og KI: Jeg ser etter støtte for hele livssyklusen til maskinlæringsmodeller, fra eksperimentsporing og modellregister til utrulling og kjøring, i stedet for bare en notatblokk som kan kjøre treningsskript.
- Samarbeidsbasert notatblokk-miljø: Team med dataingeniører, analytikere og maskinlæringsingeniører trenger delte notatblokker med støtte for flere språk, så jeg evaluerer samarbeid i sanntid, versjonskontroll og språkstøtte på tvers av SQL, Python, Scala og R.
- Datastyring og sikkerhet: En samlet datakatalog, finkornede tilgangskontroller og sporing av dataopphav er viktig her. Jeg ser på hvordan hver plattform administrerer tillatelser for tabeller, kolonner og KI-ressurser på ett sted.
- Flersky og åpne integrasjoner: Leverandørbinding er en reell bekymring, så jeg evaluerer om hvert verktøy kjører på tvers av AWS, Azure og GCP, og hvor godt det kobler seg til orkestreringsverktøy som Airflow, BI-verktøy som Tableau og inntakslag som dbt.
Når jeg har en liste over verktøy som oppfyller disse kriteriene, vurderer jeg hva som skiller hver plattform fra de andre.
Faktorer som skiller løsningene (det som skiller leverandørene)
Slik sammenligner jeg ulike leverandører:
Fremtredende funksjoner
Serverløs databehandling er en viktig forskjell. Jeg evaluerer om en plattform lar team kjøre spørringer og jobber uten å administrere klynger, noe som reduserer belastningen for grupper med uforutsigbare arbeidsbelastninger. Verktøy for generativ KI blir viktigere hvert år, særlig for team som bygger RAG-datapipeliner eller finjusterer LLM-er direkte i dataplattformen sin. Jeg ser også på kostnadsoptimaliseringskontroller som sporing av forbruk per arbeidsbelastning og automatiserte klyngepolicyer, siden kostnadene for skybasert databehandling raskt kan løpe løpsk i store ingeniørteam.
Mer enn funksjoner
Totale eierkostnader er noe av det første jeg evaluerer. Forbruksbasert prising kan se attraktiv ut helt til kostnader for datautgang og premium-nivåer for kundestøtte blåser opp regningen. Økosystemets bredde er også viktig – jeg undersøker hvor godt hver plattform kobler seg til verktøy som Airflow, dbt og Tableau, siden de fleste team ikke erstatter hele teknologistakken sin. Implementering og tid til verdiskaping fullfører evalueringen min. Migreringsverktøy fra eldre systemer som Hadoop eller Redshift kan redusere en overgang med flere uker, og god dokumentasjon gjør det langt mindre krevende å lære opp nye ingeniører.
Slik velger du en Databricks-konkurrent
Det er lett å gå seg vill i lange funksjonslister og kompliserte prismodeller. For å hjelpe deg med å holde fokus mens du arbeider deg gjennom din unike prosess for valg av programvare, får du her en sjekkliste over faktorer du bør ha i tankene:
| Faktor | Hva bør vurderes |
| Skalerbarhet | Kontroller at løsningen kan håndtere dataveksten din uten redusert ytelse. Sjekk om den støtter både horisontal og vertikal skalering for større fleksibilitet. |
| Integrasjoner | Se etter kompatibilitet med de eksisterende verktøyene dine, for eksempel datasjøer eller BI-verktøy, for å sikre god dataflyt og unngå isolerte prosesser. |
| Tilpasningsmuligheter | Vurder plattformens evne til å tilpasse seg teamets spesifikke arbeidsflyter og prosesser. Tilpassbare kontrollpaneler kan dekke ulike behov i teamet. |
| Brukervennlighet | Ta hensyn til læringskurven og hvor intuitivt grensesnittet er for teamet ditt. En brukervennlig plattform kan redusere opplæringstiden og øke bruken. |
| Budsjett | Sammenlign prismodeller og kontroller at de passer innenfor budsjettet ditt. Ta hensyn til skjulte kostnader som lagring eller ekstra brukeravgifter, som kan påvirke beslutningen din. |
| Sikkerhetstiltak | Vurder plattformens sikkerhetsfunksjoner, for eksempel datakryptering og samsvar med bransjestandarder, for å beskytte sensitive data. |
| Kundestøtte | Kontroller hvilke alternativer for kundestøtte som er tilgjengelige, inkludert direktechat og forum for brukere, slik at teamet ditt kan få hjelp når det trenger det. |
| Ytelse | Undersøk hvordan plattformen håndterer store datasett og sanntidsbehandling, for å sikre at den oppfyller teamets forventninger til ytelse. |
Trender blant Databricks-konkurrenter
I undersøkelsen min hentet jeg inn utallige produktoppdateringer, pressemeldinger og lanseringslogger fra ulike leverandører som konkurrerer med Databricks. Her er noen av de nye trendene jeg følger med på:
- Sanntidsanalyse: Virksomheter etterspør i økende grad sanntidsinnsikt fra data. Leverandører forbedrer plattformene sine for å behandle og analysere data i sanntid, slik at brukerne kan ta umiddelbare beslutninger. Løsninger som Google BigQuery innlemmer funksjoner som støtter strømming av data i sanntid.
- Utvidet analyse: Denne trenden innebærer bruk av kunstig intelligens og maskinlæring for å forbedre analyseprosesser. Den blir stadig mer populær fordi den hjelper brukerne med å oppdage innsikt uten manuelt arbeid. IBM Watson Studio er et eksempel som tilbyr funksjoner for utvidet analyse for å automatisere dataanalysen.
- Demokratisering av data: Flere plattformer fokuserer på å gjøre data tilgjengelig for ikke-tekniske brukere. Denne trenden er avgjørende for å fremme en datadrevet kultur i organisasjoner. Det utvikles verktøy med intuitive grensesnitt og selvbetjeningsfunksjoner, slik som i Alteryx.
- Datastyring: Etter hvert som personvernreglene blir strengere, blir funksjoner for datastyring stadig viktigere. Leverandører integrerer styringsverktøy for å hjelpe brukerne med å overholde regelverk og håndtere data på en ansvarlig måte. Azure Synapse Analytics tilbyr for eksempel innebygde funksjoner for datastyring.
- Støtte for hybrid sky: Mange virksomheter ønsker fleksibilitet i skystrategiene sine. Støtte for hybrid sky blir stadig mer utbredt, slik at brukerne kan administrere data på tvers av både lokale miljøer og skyen. Cloudera leder an i denne trenden ved å tilby løsninger som støtter hybride skyimplementeringer.
Hva er en Databricks-konkurrent?
Databricks-konkurrenter er programvareløsninger som er utviklet for å tilby funksjoner for databehandling, analyse og maskinlæring. Disse verktøyene brukes vanligvis av dataforskere, ingeniører og analytikere for å få innsikt og legge grunnlaget for forretningsbeslutninger.
Funksjoner for sanntidsanalyse, utvidet analyse og datastyring bidrar til effektiv behandling av data, oppdagelse av innsikt og ansvarlig håndtering av data. Samlet sett gir disse verktøyene virksomheter mulighet til å utnytte dataene sine for bedre beslutningstaking og strategisk planlegging.
Funksjoner i en Databricks-konkurrent
Når du velger en Databricks-konkurrent, bør du se etter følgende viktige funksjoner:
- Sanntidsanalyse: Muliggjør umiddelbar databehandling og innsikt, slik at du kan ta raske forretningsbeslutninger.
- Utvidet analyse: Bruker kunstig intelligens til å automatisere dataanalyse og bidrar til å avdekke innsikt uten manuelt arbeid.
- Datastyring: Sikrer overholdelse av personvernregler og ansvarlig datahåndtering.
- Støtte for hybrid sky: Gjør det mulig å administrere data på tvers av både lokale miljøer og skyen for økt fleksibilitet.
- Interaktivt samarbeid: Legger til rette for teamarbeid ved å tilby delte arbeidsområder og verktøy for felles dataanalyse.
- Automatisk skalering: Justerer ressursene basert på arbeidsbelastningen og optimaliserer ytelsen uten manuell inngripen.
- Integrasjon av maskinlæring: Tilbyr innebygde maskinlæringsfunksjoner for avanserte dataprediksjoner og innsikt.
- Tilpasningsmuligheter: Gjør det mulig å tilpasse arbeidsflyter og kontrollpaneler til bestemte teambehov og prosesser.
- Sikkerhetstiltak: Tilbyr kryptering og funksjoner for overholdelse av regelverk for å beskytte sensitive data.
- Brukervennlig grensesnitt: Sikrer enkel bruk, reduserer læringskurven og øker bruken i teamet ditt.
Fordeler med en Databricks-konkurrent
Implementering av en Databricks-konkurrent gir flere fordeler for teamet og virksomheten din. Her er noen av fordelene du kan se frem til:
- Bedre beslutningstaking: Sanntidsanalyse og utvidet analyse gir umiddelbar innsikt og forbedrer teamets evne til å ta beslutninger.
- Økt samarbeid: Funksjoner for interaktivt samarbeid gjør det mulig for teamet å arbeide effektivt sammen, noe som fører til mer helhetlige dataprosjekter.
- Skalerbarhet: Automatisk skalering gjør at systemet kan håndtere datavekst effektivt uten manuelle justeringer.
- Kostnadseffektivitet: Prismodeller basert på betaling etter bruk sikrer at du bare betaler for ressursene du bruker, og optimaliserer budsjettstyringen.
- Forbedret sikkerhet: Innebygde sikkerhetstiltak beskytter dataene dine og sikrer overholdelse av bransjestandarder.
- Fleksibilitet: Støtte for hybrid sky gir fleksibilitet til å administrere data i ulike miljøer og tilpasse seg virksomhetens behov.
- Tilpasning: Tilpasningsbare funksjoner lar deg skreddersy arbeidsflyter og kontrollpaneler etter dine spesifikke krav, noe som øker produktiviteten.
Kostnader og priser for en Databricks-konkurrent
For å velge en Databricks-konkurrent må du forstå de ulike prismodellene og tilgjengelige abonnementene. Kostnadene varierer basert på funksjoner, teamstørrelse, tillegg og mer. Tabellen nedenfor oppsummerer vanlige abonnementer, gjennomsnittsprisene deres og typiske funksjoner som er inkludert i Databricks-konkurrentløsninger:
Sammenligningstabell for abonnementer hos en Databricks-konkurrent
| Abonnementstype | Gjennomsnittspris | Vanlige funksjoner |
| Gratisabonnement | $0 | Grunnleggende databehandling, begrenset lagringsplass og brukerstøtte fra fellesskapet. |
| Personlig abonnement | $10-$30 /bruker /måned | Forbedret dataanalyse, personlige kontrollpaneler og kundestøtte via e-post. |
| Bedriftsabonnement | $50-$100 /bruker /måned | Avanserte analyseverktøy, funksjoner for teamsamarbeid og prioritert brukerstøtte. |
| Storbedriftsabonnement | $150-$300/bruker /måned | Tilpassede integrasjoner, dedikert kontoadministrasjon og sikkerhet på bedriftsnivå. |
Vanlige spørsmål om Databricks-konkurrenter
Her er noen svar på vanlige spørsmål om konkurrenter til Databricks:
Hvem er Databricks' største konkurrent?
Snowflake regnes ofte som Databricks’ største konkurrent på grunn av de lignende, skybaserte dataplattformfunksjonene. Begge tilbyr omfattende funksjoner for databehandling og analyse, men Snowflake er kjent for sine styrker innen datavarehus. Avhengig av dine spesifikke behov kan begge være gode valg.
Hva vil erstatte Databricks?
Selv om ingen enkeltverktøy er satt til å erstatte Databricks, tilbyr alternativer som SQL Server overbevisende funksjoner. SQL Server integreres godt med dataanalyseverktøy som Power BI og tilbyr et robust system for administrasjon av relasjonsdatabaser. Valget ditt vil avhenge av dine spesifikke krav til databehandling.
Hvilke begrensninger har Databricks?
Databricks har enkelte begrensninger, for eksempel begrensninger på antallet widgeter i en notatbok og tegnbegrensninger for widgetnavn og inndata. Disse begrensningene kan påvirke hvordan du utformer og samhandler med data i notatbøker, så planlegg deretter hvis disse grensene påvirker arbeidsflytene dine.
Hvem er konkurrentene til Amazon Databricks?
Amazon Databricks møter konkurranse fra plattformer som Snowflake, som tilbyr lignende funksjoner for databehandling. Snowflake tilbyr en skybasert datavarehusløsning som er bredt anerkjent for skalerbarheten og brukervennligheten, noe som gjør den til en sterk konkurrent i markedet.
Hvordan er prisene for Databricks sammenlignet med konkurrentenes?
Prisene for Databricks kan variere betydelig basert på bruk og funksjoner. Det er viktig å sammenligne dem med konkurrenter som Snowflake og Google BigQuery, med tanke på faktorer som datalagring, behandlingskostnader og tilleggsfunksjoner. Evaluer prisstrukturen til hver plattform for å finne den som passer best til budsjettet ditt.
Hvilke funksjoner bør jeg se etter hos en Databricks-konkurrent?
Når du vurderer Databricks-konkurrenter, bør du se etter funksjoner som sanntidsanalyse, integrasjon med maskinlæring og datastyring. Disse funksjonene forbedrer databehandlingen og analysen din og skaper verdi for teamet ditt. Ta hensyn til virksomhetens spesifikke behov for å finne ut hvilke funksjoner som er viktigst.