Le directeur de l’ingénierie des données infonuagiques explique comment il utilise les GPT personnalisés pour autonomiser les ingénieurs
Subash D'Souza
Directeur de l’ingénierie des données infonuagiques à la California State University
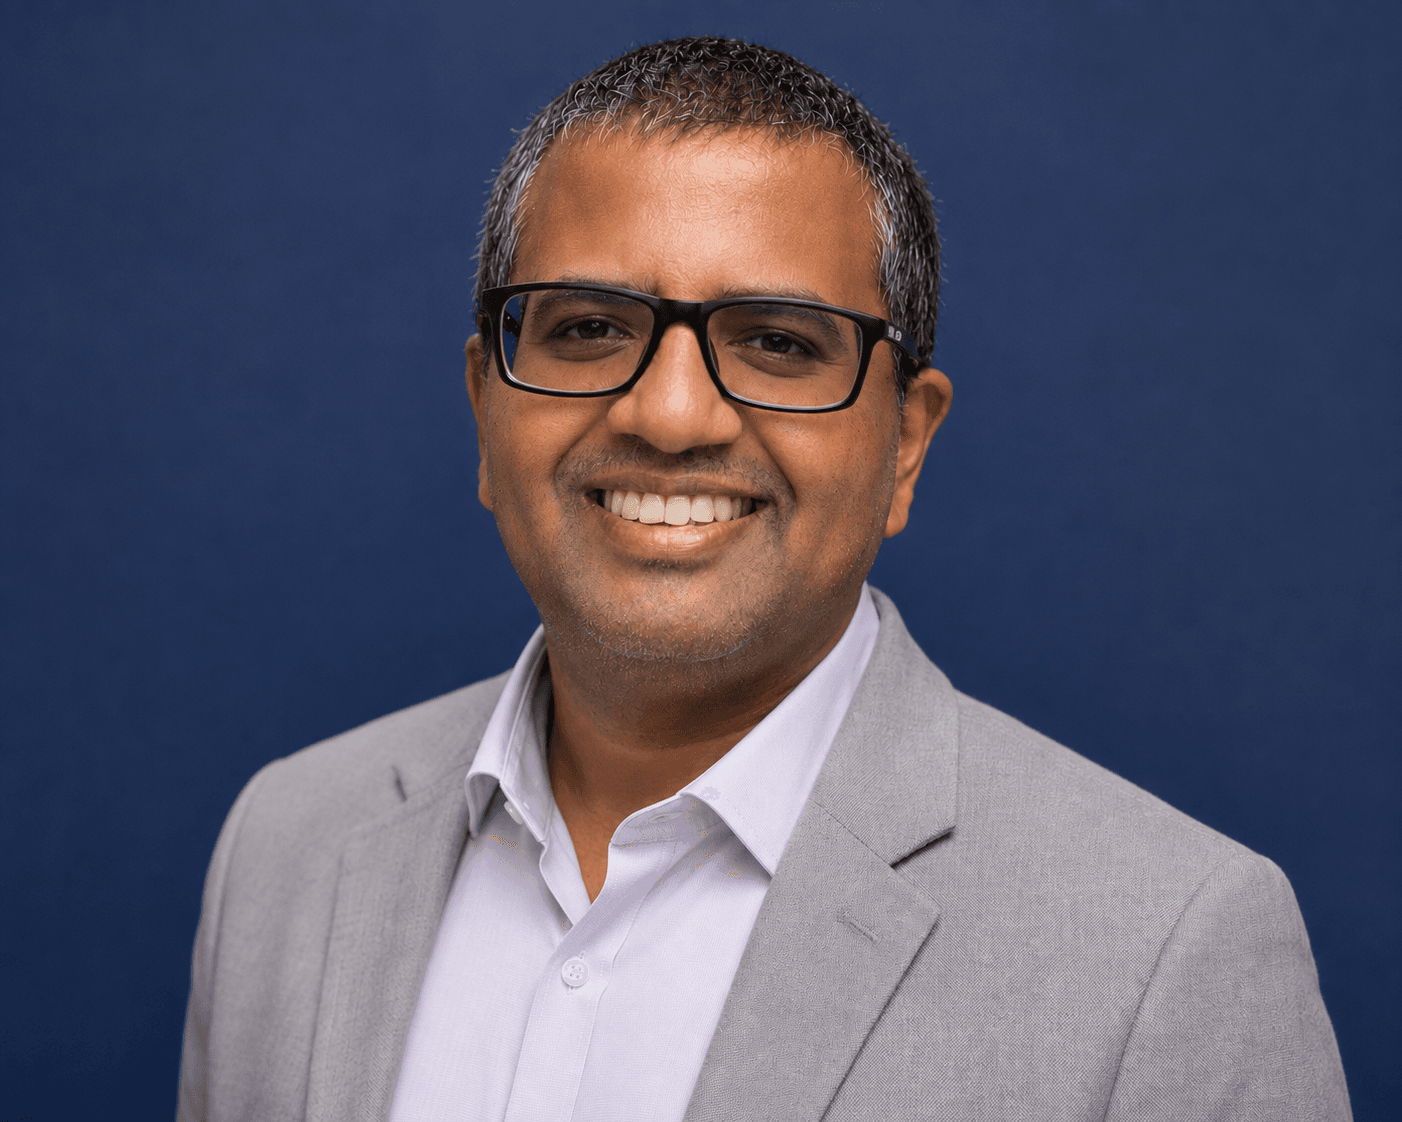
Subash D'Souza explique comment les GPT personnalisés aident les ingénieurs à accéder aux connaissances techniques, à résoudre les problèmes plus rapidement et à améliorer leur productivité, tout en maintenant une supervision et une gouvernance humaines.
Key Takeaways
Gouvernance: L’adoption de l’IA réussit lorsque les organisations établissent des connaissances fiables, des limites claires et une responsabilité humaine avant le déploiement.
Autonomisation: Un mentor en IA propre à la CSU fournit aux ingénieurs des conseils plus rapides, un soutien au dépannage et un accès cohérent aux pratiques de développement établies.
Responsabilité: Les humains demeurent responsables de l’architecture, de la sécurité, des approbations, des tests et des décisions de mise en production malgré l’ingénierie assistée par l’IA.
Mise à l’échelle: Les équipes d’ingénierie des données infonuagiques peuvent déployer des solutions partagées à l’échelle de plusieurs campus tout en permettant aux équipes locales de créer des produits gouvernés.
Stratégie: Les directeurs de la technologie devraient associer des cas d’utilisation pratiques de l’IA au perfectionnement des employés, à la collaboration, à la rigueur en ingénierie et à des résultats commerciaux mesurables.
Subash D'Souza est directeur de l’ingénierie des données infonuagiques à la California State University. Il est également le fondateur de Data Con LA et de Data 4 Good. Il a aussi occupé des postes de direction chez Headspace et Warner Bros.
Nous nous sommes entretenus avec Subash pour découvrir comment il permet aux ingénieurs d’être autonomes tout en maintenant des processus de gouvernance et de revue. Voici ce qu’il nous a dit.
Une carrière dans les données
Je suis le fondateur de Data Con LA et de Data 4 Good, un groupe de réflexion à but non lucratif public-privé qui collabore avec des organisations pour s’attaquer aux problèmes sociaux à l’aide des données, notamment des enjeux tels que l’itinérance et l’équité numérique, tout en faisant progresser l’innovation technologique, les données et l’analytique, ainsi que les partenariats public-privé.
Je suis également actuellement directeur de l’ingénierie des données infonuagiques au Bureau du chancelier de la California State University. Je siège à la Linux Foundation en tant que membre du comité de gestion de programme sur la gouvernance des données. Auparavant, j’étais responsable de l’ingénierie des données chez Headspace et directeur des mégadonnées et des opérations chez Warner Bros.
More Articles
Diriger l’ingénierie des données et l’IA
Je dirige l’organisation d’ingénierie des données et d’IA/ML au sein du Bureau du chancelier de la California State University, en soutenant les initiatives liées aux données dans l’ensemble du système CSU.
Nous étudions comment l’IA pourrait améliorer le parcours étudiant, de la candidature jusqu’à l’obtention du diplôme. En nous appuyant sur notre plateforme de données existante et sur les données relatives aux étudiants, nous cherchons à utiliser l’IA pour identifier des tendances qui améliorent la conversion des candidatures, repérer les étudiants ayant besoin d’un accompagnement plus précoce et, à terme, améliorer les taux de rétention et d’obtention du diplôme. Nous passons ainsi du simple compte rendu de ce qui s’est produit à une utilisation proactive des données et de l’IA pour aider nos campus à prendre de meilleures décisions plus tôt, afin de favoriser la réussite des étudiants.
Notre architecture infonuagique utilise AWS, Databricks, Snowflake et des plateformes d’analytique pour créer des pipelines et des produits de données évolutifs. Mon équipe accompagne un environnement complexe composé de plusieurs campus, dans lequel nous développons des solutions partagées, établissons des normes d’ingénierie et permettons aux campus de créer et de déployer leurs propres produits de données grâce à notre modèle de centre d’excellence des données.
Comment l’IA peut autonomiser les ingénieurs tout en maintenant la revue et la gouvernance
J’ai intégré directement l’IA à notre modèle d’accompagnement des ingénieurs grâce au CustomGPT du COE des données de la CSU.
Auparavant, les développeurs s’appuyaient principalement sur la documentation et les responsables de l’ingénierie pour obtenir des conseils et résoudre les problèmes. Nous avons créé un mentor IA propre à la CSU, fondé sur nos pratiques et notre documentation en matière d’ingénierie des données, afin d’aider les développeurs à comprendre notre architecture, nos normes de développement et nos flux de travail.
Il aide de trois façons :
- Pour les connaissances, le CustomGPT fournit aux ingénieurs un accès immédiat à des conseils propres à la CSU sur notre architecture, nos normes et nos processus de développement, au lieu de les obliger à parcourir la documentation ou à attendre l’intervention d’un expert.
- Pour le développement, il aide les ingénieurs à comprendre les modèles établis et à naviguer dans nos flux de travail Databricks, Git, de test et de déploiement.
- Pour le dépannage, les ingénieurs peuvent décrire une erreur ou un problème et utiliser l’IA pour identifier les causes probables et les prochaines étapes possibles.
Les équipes ont ainsi bénéficié plus rapidement de conseils techniques cohérents, leur dépendance à l’égard d’experts individuels a diminué et nous avons pu étendre les connaissances en ingénierie des données à l’ensemble des campus de la CSU, tout en maintenant nos processus établis de revue et de gouvernance.
Auparavant, les développeurs s’appuyaient principalement sur la documentation et les responsables de l’ingénierie pour obtenir des conseils et résoudre les problèmes. Nous avons créé un mentor IA propre à la CSU, fondé sur nos pratiques et notre documentation en matière d’ingénierie des données, afin d’aider les développeurs à comprendre notre architecture, nos normes de développement et nos flux de travail.
Pourquoi l’IA accélère les processus tandis que les humains restent responsables
Nous utilisons donc de plus en plus l’IA pour soutenir des activités telles que le développement de code, le dépannage, la documentation, les conseils en matière de tests et pour aider les ingénieurs à s’orienter dans nos normes d’ingénierie des données de CSU grâce à des outils comme le CustomGPT que j’ai mentionné plus haut.
Cependant, l’IA n’a pas encore remplacé le jugement humain dans les décisions complexes liées à l’architecture, à la sécurité ou à la production. Nous avons également constaté que l’IA éprouve des difficultés avec les questions qui dépendent d’un contexte très spécifique ou d’une documentation technique qui évolue rapidement.
Par exemple, elle peut suggérer une approche techniquement valide pour un problème de déploiement ou de sécurité sans bien comprendre nos exigences spécifiques en matière d’AWS, de Databricks, de Snowflake, de contrôle des accès ou d’approbation.
C’est pourquoi les décisions d’architecture, les déploiements en production, les décisions relatives à la sécurité et aux accès, ainsi que les revues finales du code restent explicitement humaines. Notre processus de développement exige une revue par les pairs, des tests, une validation de bout en bout et des approbations définies avant que le code ne progresse vers la production.
Nous utilisons l’IA pour accélérer l’ingénierie et améliorer la cohérence, tandis que les humains restent responsables des décisions qui affectent la sécurité, l’architecture, la gouvernance et les systèmes de production.
Pourquoi les CTO doivent mettre en place une gouvernance avant d’intégrer l’IA
Chaque CTO doit comprendre que la transformation par l’IA n’est pas principalement un problème technologique — c’est un problème lié aux personnes, aux connaissances et à la gouvernance.
L’IA peut accélérer considérablement la manière dont les équipes apprennent, développent et résolvent les problèmes, mais sa valeur dépend de connaissances organisationnelles fiables et d’une responsabilité humaine clairement définie.
Honnêtement, j’aurais aimé comprendre plus tôt que la valeur de l’IA dépend fortement de la qualité et de l’organisation des connaissances qui la sous-tendent. Par exemple, avec notre CustomGPT, nous aurions pu éviter certaines expérimentations initiales en nous concentrant plus tôt sur la sélection des connaissances pertinentes, la définition des domaines dans lesquels l’IA devait ou ne devait pas être considérée comme fiable, ainsi que la mise en place de points de contrôle humains clairs.
La principale leçon que j’en ai tirée est qu’il ne faut pas simplement déployer un outil d’IA. Il faut d’abord constituer les connaissances, la gouvernance et la responsabilité humaine qui l’entourent.
Pourquoi les CTO doivent investir à la fois dans l’IA et dans leurs équipes
Je conseille aux CTO de considérer l’IA comme un accélérateur, et non comme une stratégie de remplacement.
Commencez par des cas d’utilisation pratiques dans lesquels l’IA réduit les frictions, améliore la productivité des développeurs et rend les connaissances organisationnelles plus accessibles. Mais veillez à ce que les humains restent responsables des décisions liées à l’architecture, à la sécurité et à la production.
Tout aussi important, investissez dans vos équipes. Notre expérience avec le CSU Data COE montre que l’association de l’IA avec un apprentissage pratique et une collaboration entre équipes permet de renforcer les compétences techniques.
Les organisations qui réussiront avec l’IA associeront l’expérimentation rapide à une solide discipline d’ingénierie, à une gouvernance rigoureuse et à des résultats mesurables.
Suivez l’actualité
Vous pouvez suivre les travaux de Subash D'Souza sur LinkedIn. Découvrez également Data Con LA et Data 4 Good.
D’autres entretiens avec des experts seront bientôt disponibles sur The CTO Club !