

Oikean testidatan hallintatyökalun löytäminen voi olla haastavaa. Saatavilla on niin paljon vaihtoehtoja, että on vaikea määrittää, mikä niistä todella vastaa tarpeitasi tuhlaamatta arvokasta aikaa tai resursseja. Jos olet kohdannut ongelmia työkalujen kanssa, jotka ovat liian monimutkaisia, eivät mukaudu projektiesi kasvuun tai eivät noudata tietosuojasäännöksiä, et ole yksin. Hyvän testidatan hallintatyökalun pitäisi tehostaa tietojoukkojesi luomista, hallintaa ja suojausta sekä integroitua saumattomasti testaustyönkulkuihisi.
Ohjelmistotestauksen ammattilaisena olen käyttänyt käytännössä kymmeniä työkaluja ja kohdannut sekä ratkaissut samoja haasteita, joita sinä kohtaat. Siksi olen laatinut tämän oppaan: helpottamaan hakuasi ja tarjoamaan kuratoidun luettelon parhaista nykyisin saatavilla olevista testidatan hallintatyökaluista. Asetatpa etusijalle automaation, vaatimustenmukaisuuden tai skaalautuvuuden, tämä artikkeli auttaa sinua tekemään perustellun päätöksen.
Miksi luottaa ohjelmistosuosituksiimme
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Tiimimme on testannut ja arvioinut ohjelmistoja vuodesta 2012 lähtien. Teknologiajohtajina tiedämme itse, kuinka vaikeaa — ja tärkeää — oikean ohjelmiston valitseminen on.
Tätä opasta varten arvioimme työkaluja käytännön testauksen ja itsenäisen tutkimuksen avulla, pisteyttäen työkalut valintakriteeriemme perusteella.
Arvostelumme perustuvat inhimilliseen toimitukselliseen harkintaamme, eivät myyntipuheeseen.
Asiantuntija-arvioijat:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Testidatan hallintatyökalujen vertailutaulukko
Alla olevassa taulukossa verrataan parhaiksi arvioimieni testidatan hallintatyökalujen hinnoittelutietoja.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Paras vaatimustenmukaisuuteen kohdistettuun maskaukseen ja automaattiseen osajoukotukseen | 14 päivän maksuton kokeilujakso | Hinta pyynnöstä | Website | |
| 2 | Paras CI/CD-käyttöön tarkoitetun synteettisen testidatan tuottamiseen | Ilmainen esittely saatavilla | Hinta pyynnöstä | Website | |
| 3 | Sopii parhaiten erilaisten testiympäristöjen hallintaan keskitetystä sijainnista | 14 päivän maksuton kokeilujakso | Alkaen 15 000 €/käyttäjä/vuosi (laskutetaan vuosittain) | Website | |
| 4 | Paras koko elinkaaren TDM:ään tietokantojen kloonauksella | Ilmainen esittely saatavilla | Hinnoittelu pyynnöstä | Website | |
| 5 | Sopii parhaiten keskustietokoneympäristöt sisältävään testidatan peittämiseen | Ei saatavilla | Hinnoittelu pyynnöstä | Website | |
| 6 | Sopii parhaiten yrityksille, joilla on monimutkaisia ympäristöjä | Saatavilla 30 päivän ilmainen kokeilujakso | Hinta pyydettäessä | Website | |
| 7 | Parhaat tietokantojen väliset osajoukot säännellyillä toimialoilla | Ilmainen esittely saatavilla | Hinta pyynnöstä | Website | |
| 8 | Paras peittämiseen useita tietokantoja sisältävissä putkissa | Ilmainen esittely saatavilla | Hinta pyynnöstä | Website | |
| 9 | Paras visuaaliseen, kattavuuslähtöiseen datan suunnitteluun | 14 päivän ilmainen kokeilujakso | Hinta pyynnöstä | Website | |
| 10 | Paras Git-tyyliseen tietokantojen kloonaukseen viidellä tietokantamoottorilla | Ilmainen esittely saatavilla | Hinta pyynnöstä | Website |




Parhaiden testidatan hallintatyökalujen arviot
Alla ovat yksityiskohtaiset yhteenvedot parhaista testidatan hallintatyökaluista, jotka pääsivät ehdokaslistalleni. Arvioni tarjoavat yksityiskohtaisen katsauksen kunkin työkalun tärkeimpiin ominaisuuksiin, etuihin & haittoihin, integraatioihin ja ihanteellisiin käyttötapauksiin, jotta löydät itsellesi parhaiten sopivan vaihtoehdon.
 Paras vaatimustenmukaisuuteen kohdistettuun maskaukseen ja automaattiseen osajoukotukseen
- 14 päivän maksuton kokeilujakso
- Hinta pyynnöstä
Visit WebsiteCustomer Rating:4.3/5
Tonic maskaa arkaluonteiset tietokantasarakkeet ja poistaa niistä tunnistetiedot turvallista testidataa varten. Tonic Structural on testidatan hallinta-alusta, joka maskaa, muodostaa osajoukkoja ja toimittaa tuotantodataa tuotantoon kuulumattomiin ympäristöihin. Se tukee relaatiotietokantoja, NoSQL-tietokantoja, tietovarastoja ja tiedostolähteitä.
Kenelle Tonic sopii parhaiten?
Tonic Structural sopii erityisesti vaatimustenmukaisuuteen keskittyville terveydenhuollon ja rahoitusalan tiimeille, joiden on maskattava ja muodostettava tuotantodatasta osajoukkoja säilyttäen samalla auditointivalmis tietosuojadokumentaatio.
Miksi valitsin Tonicin
Tonic päätyi suosikkieni joukkoon, koska sen maskaus- ja osajoukotusominaisuudet on yhdistetty tiiviisti tavalla, jota näen harvoin. Pidän siitä, miten Privacy Hub merkitsee jokaisen sarakkeen tilaksi Riskialtis, Suojattu tai Ei arkaluonteinen, minkä jälkeen generaattoreita voi käyttää joukkona ja koko tietosuojaraportin voi viedä auditointia varten. Patentoitu osajoukkojen muodostaja käsittelee virtuaaliset viiteavaimet ja kehämäiset riippuvuudet automaattisesti, joten maskattu osajoukkosi säilyy viite-eheänä myös monimutkaisissa, usean taulun skeemoissa.
Tonicin tärkeimmät ominaisuudet
- Structural Agent: Sovellukseen sisäänrakennettu tekoälypohjainen chat-avustaja, joka tiivistää arkaluonteisuustarkistusten tulokset, suosittelee generaattoreita ja käyttää niitä automaattisesti sarakkeisiin.
- Differentiaalisen tietosuojan hallinta: Kategoriset ja jatkuvat generaattorit tukevat differentiaalista tietosuojaa, ja määritettävän tietosuojabudjetin avulla voidaan rajoittaa muunnetuista tiedoista tehtävää tilastollista päättelyä.
- Konttitallennusulostulo: Structural kirjoittaa maskatut ja osajoukotetut tiedot suoraan PostgreSQL-, MySQL- ja SQL Server -konttien taltioksi, joten eristettyjä tietokantoja voi käynnistää tarvittaessa.
- Versiohistoria: Tallentaa kaikki työtilan kokoonpanon muutokset — generaattorit, osajoukotussäännöt, taulutilat ja työn jälkeiset komentosarjat — muutoksen tekijätietoineen ja mahdollistaa aiempien versioiden palauttamisen.
Tonicin integraatiot
Tonic tarjoaa suorat integraatiot PostgreSQL:ään, MySQL:ään, SQL Serveriin, Oracleen, MongoDB:hen, Snowflakeen, BigQueryyn, Redshiftiin, Databricksiin ja Amazon S3:een. Se tukee myös REST APIa, GitHub Actionsia, Kubernetesia, Helmiä sekä Amazon ECR:n, Google Artifact Registryn ja Azure Container Registryn kaltaisia konttirekistereitä.
Pros and Cons
Pros:
- Säilyttää liitokset monimutkaisissa skeemoissa
- Privacy Hub kartoittaa arkaluonteiset sarakkeet auditointeja varten
- Tuotantomaiset tiedot säilyttävät tilastolliset suhteet
Cons:
- Alusta alkaen tehtävä synteesi edellyttää erillistä Fabricate-tuotetta
- Kontitetut tietokannat edellyttävät Kubernetes-käyttöönottoa
Learn more about Tonic: Paras CI/CD-käyttöön tarkoitetun synteettisen testidatan tuottamiseen
- Ilmainen esittely saatavilla
- Hinta pyynnöstä
Visit WebsiteCustomer Rating:4.6/5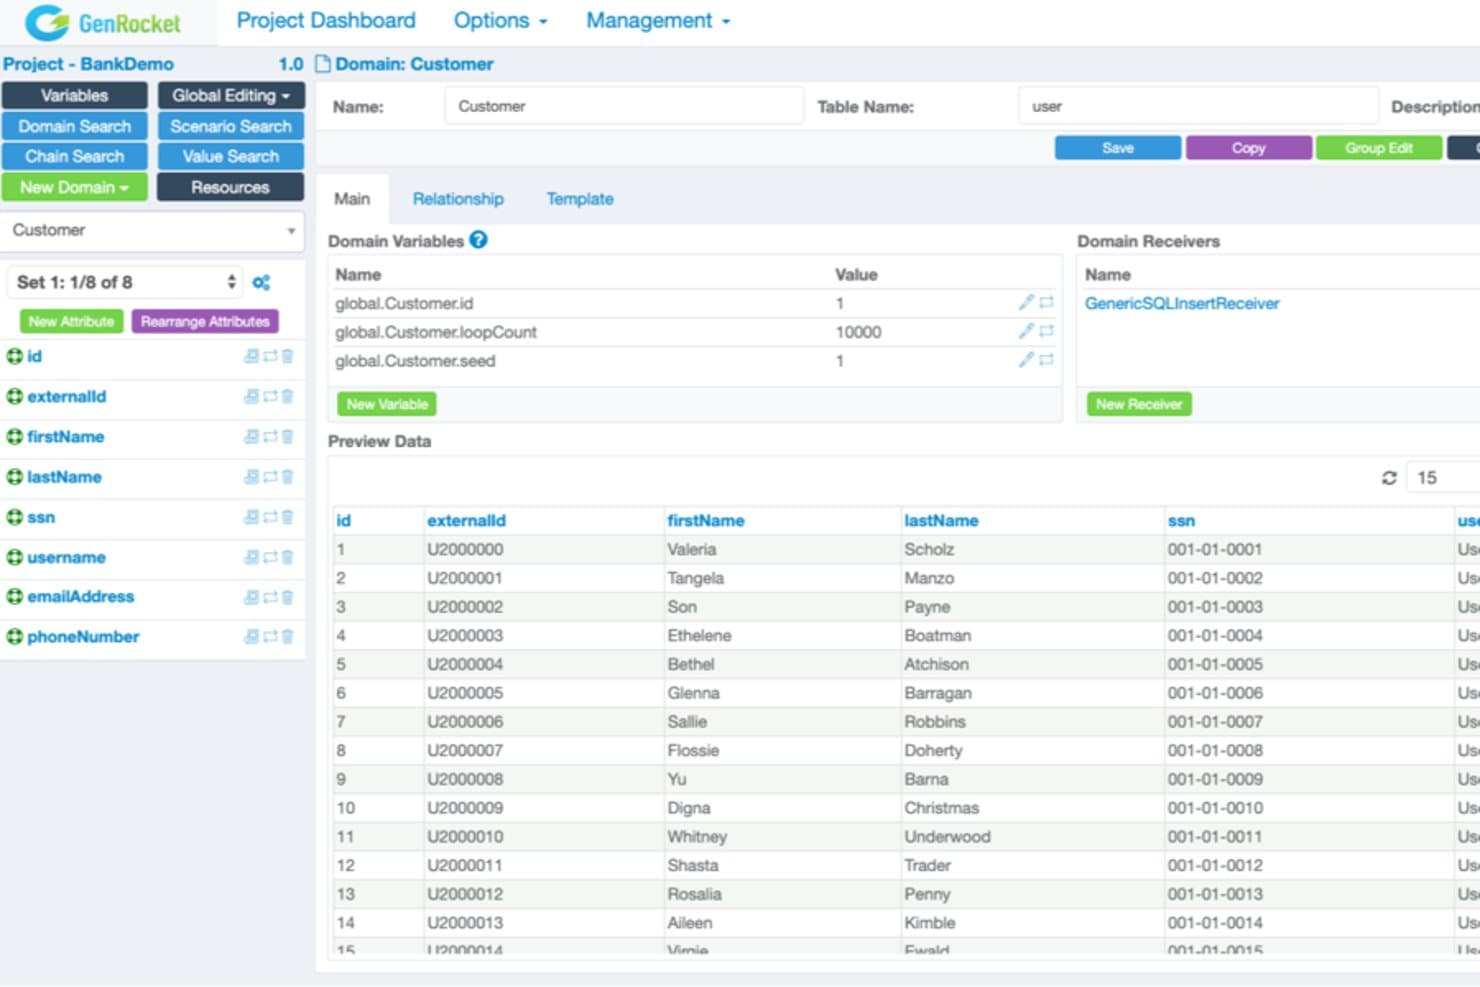
GenRocketin avulla käyttäjät voivat esikatsella ja määrittää testidatatoimialueita visuaalisesti. GenRocket on synteettisen testidatan hallinta-alusta, joka tuottaa dataa reaaliaikaisesti metatietojen ja skeemojen perusteella. Se kattaa datan peittämisen, älykkään osajoukon muodostamisen, monimuotoisen tulostuksen ja itsepalveluna tapahtuvan käyttöönoton CI/CD-putkissa.
Kenelle GenRocket sopii parhaiten?
GenRocket sopii erinomaisesti QA- ja DevOps-tiimeille, jotka tarvitsevat pyynnöstä tuotettua synteettistä testidataa suoraan CI/CD-putkiin ilman, että tuotantodataan tarvitsee koskaan koskea.
Miksi valitsin GenRocketin
GenRocket pääsi suosikkieni joukkoon, koska se on ainoa näkemäni testidata-alusta, joka on suunniteltu nimenomaan tuottamaan synteettistä dataa reaaliaikaisesti suoraan CI/CD-putkessa ilman, että tuotantodataan tarvitsee koskaan koskea. Sen patentoitu viite-eheyden moottori pitää datan yhdenmukaisena useissa skeemoissa ja tietokannoissa samanaikaisesti, mikä on aidosti harvinaista. Pidän myös siitä, että kunkin testitapauksen aineisto tuotetaan parhaimmillaan vain 100 millisekunnissa, joten putken suoritus ei pysähdy odottamaan datan käyttöönottoa.
GenRocketin keskeiset ominaisuudet
- G-Delta-skeemamuutosten tunnistus: Tunnistaa automaattisesti MySQL-, MS SQL-, Oracle- ja PostgreSQL-tietokantojen skeemamuutokset ja käynnistää sen jälkeen G-Refactorin päivittämään kaikki muutosten kohteena olevat testidatatapaukset.
- Paikallaan tapahtuva peittäminen: Korvaa Oracle-, MS SQL Server-, IBM DB2-, PostgreSQL- ja MySQL-tietokantojen arkaluonteiset kentät synteettisesti tuotetuilla vastaavilla arvoilla lukematta koskaan todellisia tuotantoarvoja.
- G-Portal-itsepalveluportaali: Tarjoaa kehittäjille ja testaajille roolipohjaisen käyttöliittymän testidatatapausten hakemiseen, pyytämiseen, seurantaan ja lataamiseen ilman, että jokaista pyyntöä varten tarvitaan keskitetyn datatiimin apua.
- Yli 750 älykästä datageneraattoria: Kattaa käytännössä minkä tahansa tietotyypin, toimialan tai liiketoimintasäännön, mukaan lukien ehdollisen logiikan, kenttien väliset riippuvuudet ja säännöllisten lausekkeiden rajoitteet.
GenRocket-integraatiot
GenRocket integroituu Jenkinsin, Azure DevOpsin, TeamCityn, CircleCI:n, GitHubin, Cucumberin, Seleniumin, JUnitin, JMeterin ja LoadRunnerin kanssa. Se tukee myös REST-rajapintaa, JDBC:tä, SOAPia, TCP/IP-pistokkeita ja Docker-käyttöönottoa mukautettuja CI/CD-työnkulkuja varten.
Pros and Cons
Pros:
- Synteettinen datan generointi säilyttää viite-eheyden
- Reaaliaikainen datan käyttöönotto CI/CD-putkia varten
- Rajaton datamäärä ilman päivitysjaksoja
Cons:
- Ei muodon säilyttävää tai palautettavaa peittämistä
- Henkilötietojen tunnistus ei ole täysin saatavilla ennen vuotta {{year}}
Learn more about GenRocket: Sopii parhaiten erilaisten testiympäristöjen hallintaan keskitetystä sijainnista
- 14 päivän maksuton kokeilujakso
- Alkaen 15 000 €/käyttäjä/vuosi (laskutetaan vuosittain)
Visit WebsiteCustomer Rating:4.5/5
Tietojen peittäminen auttaa pitämään arkaluonteiset asiakastiedot yksityisinä. DATPROF on testidatan hallinta-alusta, joka yhdistää tietojen peittämisen, osajoukkojen muodostamisen, synteettisen datan luonnin, henkilötietojen löytämisen, tietokantojen virtualisoinnin ja keskitetyn käyttöönoton relaatiotietolähteissä, NoSQL-tietolähteissä ja pilvipalveluissa.
Kenelle DATPROF sopii parhaiten?
DATPROF sopii erityisen hyvin keskisuurten ja suurten yritysten data-asiantuntijoille ja tietokantojen ylläpitäjille, jotka hallinnoivat monimutkaisia, useiden tietokantojen ympäristöjä, joissa viite-eheys ja vaatimustenmukaisuus ovat ehdottomia.
Miksi valitsin DATPROFin
Valitsin DATPROFin yhdeksi parhaista vaihtoehdoista, koska sen datamäärästä riippumaton lisenssimalli erottaa sen aidosti muista: lisenssikustannuksesi pysyvät samoina riippumatta siitä, peitätkö 500 gigatavua vai 100 teratavua dataa. Tämä on merkittävää, kun tuotantotietokannasta muodostetaan osajoukko, kuten Heinekenin 23 teratavun tietokannasta, jonka se pienensi 130 gigatavuun. DATPROF Subsetin patentoitu vierasavainten syklien tunnistus käsittelee monimutkaisia, tuhansien taulujen rakenteita säilyttäen samalla järjestelmien välisen viite-eheyden. Kun tähän yhdistetään Runtime-portaalin keskitetty orkestrointi, jokainen tiimin jäsen voi ottaa käyttöön oman päivitetyn ympäristönsä odottamatta tietokannan ylläpitäjää.
DATPROFin tärkeimmät ominaisuudet
- Deterministinen järjestelmien välinen tietojen peittäminen: Käyttää samoille syötetiedoille yhdenmukaisia peitettyjä arvoja samanaikaisesti useissa tietokannoissa ja säilyttää viite-eheyden päästä päähän ulottuvaa testien jäljitettävyyttä varten.
- Henkilötietojen löytäminen ja profilointi: Skannaa tietokannat tunnistaakseen automaattisesti, missä arkaluonteiset tiedot sijaitsevat. Mukana on tuki mukautetuille tunnistussäännöille, joissa käytetään säännöllisiä lausekkeita tai luettelopohjaisia lausekkeita.
- Omatoiminen käyttöönottoportaali: Antaa testaajille ja kehittäjille mahdollisuuden kirjautua DATPROF Runtimeen ja päivittää omat testiympäristönsä itsenäisesti ilman, että heidän tarvitsee odottaa tietokannan ylläpitäjää.
- Kirjoituksenaikaiseen kopiointiin perustuva tietokantojen kloonaus: DATPROF Virtualize käynnistää täysikokoisia virtuaalisia tietokantaympäristöjä kuluttamatta ylimääräistä tallennustilaa, ja tilannevedoksen palautus valmistuu alle 20 sekunnissa.
DATPROFin integraatiot
DATPROF tukee CI/CD-integraatioita Jenkinsin, Azure DevOpsin, GitLabin ja Bamboon kanssa sekä testiautomaation integraatioita Parasoftin ja Toscan kanssa. Sen REST-rajapinta tukee mukautettuja integraatioita, ja markkinapaikkalistaukset ovat saatavilla Azure Marketplacessa ja AWS Marketplacessa.
Pros and Cons
Pros:
- Tietojen peittäminen säilyttää tietokantojen välisen viite-eheyden
- Osajoukkojen muodostaminen pienentää tehokkaasti valtavia tuotantodatan kokonaisuuksia
- Roolipohjainen verkkoportaali omatoimisiin päivityksiin
Cons:
- Rajallinen natiivituki SaaS-tietolähteille
- Ei keskustietokoneiden tai laajempien NoSQL-tietokantojen kattavuutta
Learn more about DATPROF: Paras koko elinkaaren TDM:ään tietokantojen kloonauksella
- Ilmainen esittely saatavilla
- Hinnoittelu pyynnöstä

Enov8 tarjoaa johdolle yhdellä silmäyksellä näkyvyyden henkilötietoihin eri tietolähteissä. Enov8 on testidatan hallinta-alusta, joka kattaa koko TDM-elinkaaren, mukaan lukien tekoälypohjaisen tietojen profiloinnin, peittämisen, osajoukkojen muodostamisen, synteettisen datan luonnin ja tietokantojen virtualisoinnin vME-kloonausmoottorinsa avulla.
Kenelle Enov8 sopii parhaiten?
Enov8 sopii erinomaisesti säänneltyjen toimialojen DevOps- ja QA-tiimeille, jotka tarvitsevat yhden alustan peittämisen, osajoukkojen muodostamisen, synteettisen datan ja tietokantojen virtualisoinnin käsittelyyn yhdessä.
Miksi valitsin Enov8:n
Valitsin Enov8:n yhdeksi parhaista, koska se on listani ainoa työkalu, jossa koko elinkaaren TDM yhdistyy vME-tietokantojen kloonausmoottoriin. Moottori käynnistää tuotantoa realistisesti jäljitteleviä tietokantakopioita noin 40 megatavun kokoisina kloonia kohden lähteen koosta riippumatta. Pidän erityisesti siitä, että peittäminen, osajoukkojen muodostaminen ja synteettisen datan luonti syötetään suoraan virtualisointikerrokseen, joten kloonit ovat jo tietosuojaturvallisia ennen testiympäristöön siirtämistä.
Enov8:n tärkeimmät ominaisuudet
- Tekoälypohjainen henkilötietojen etsintä: Koneoppimista hyödyntävä profilointimoottori skannaa yhdistetyt tietolähteet automaattisesti, luokittelee arkaluonteiset kentät ja merkitsee sääntelyriskiä sisältävät sarakkeet ennen peittämisen aloittamista.
- Testidatavaraukset: Sisäänrakennetun varausjärjestelmän avulla tiimit voivat varata ja hallita tietojoukkoja keskitetysti, mikä estää samanaikaisten käyttäjien ja ympäristöjen väliset ristiriidat.
- Peittämisen jälkeinen validointiskannaus: Koneoppimista hyödyntävä validointiajo vahvistaa peittämisen tehokkuuden jokaisen suojauskierroksen jälkeen ja tuottaa auditointiin soveltuvat vaatimustenmukaisuustodisteet.
- DevOps-hallinnan integraatiokeskus: Kieliriippumaton orkestrointikerros, joka sisältää Python-, Bash-, Ansible-, Java- ja muilla kielillä kirjoitettuja automaatioskriptejä ja yhdistää Enov8:n Jenkinsin, GitLab CI/CD:n ja Azure DevOpsin kaltaisten alustojen CI/CD-putkiin.
Enov8:n integraatiot
Enov8 tukee yli sataa integraatiota, mukaan lukien Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy ja Ansible. Sen REST-rajapinta, webhookit, ajastin ja DevOps Manager tukevat mukautettuja CI/CD-työnkulkuja.
Pros and Cons
Pros:
- Tietokantojen virtualisointi pienillä 40 megatavun klooneilla
- Tekoälypohjainen henkilötietojen etsintä ja peittämisen validointi
- Keskitetyt testidatavaraukset estävät allokointiristiriidat
Cons:
- Julkisten arvioiden määrä on suhteellisen rajallinen
- Kolmansien osapuolten vaatimustenmukaisuustodistuksia ei ole lueteltu
Learn more about Enov8: Sopii parhaiten keskustietokoneympäristöt sisältävään testidatan peittämiseen
- Ei saatavilla
- Hinnoittelu pyynnöstä

Broadcom Test Data Manager seuraa tuontitehtävien tiloja yhdessä näkymässä. Broadcom Test Data Manager on yritystason testidatan hallinta-alusta, joka yhdistää tietojen peittämisen, synteettisen datan luonnin, osajoukkojen muodostamisen, henkilötietojen löytämisen, tietokantojen virtualisoinnin ja itsepalvelun mukaisen tietojen käyttöönoton – sekä tarjoaa erityisen tuen keskustietokoneympäristöille nykyaikaisten hajautettujen ja pilvitietokantojen rinnalla.
Kenelle Broadcom Test Data Manager sopii parhaiten?
Alustasta hyötyvät eniten suuret yritykset, jotka käyttävät keskustietokoneympäristöjä yhdessä nykyaikaisten hajautettujen järjestelmien kanssa.
Miksi valitsin Broadcom Test Data Managerin
Olen sisällyttänyt Broadcom Test Data Managerin kärkivalintoihini, koska se on ainoa näkemäni alusta, joka käsittelee keskustietokoneympäristöjä ensiluokkaisesti nykyaikaisten hajautettujen järjestelmien rinnalla. Sen keskustietokoneympäristöille tarkoitettu CA TDM for Mainframe -moduuli mahdollistaa tietojen peittämisen ja osajoukkojen muodostamisen z/OS-, VSAM- ja IMS-ympäristöissä saman käyttöliittymän kautta, jota käytät SQL Serverille tai Oraclen tietokannoille. Automatisoitu henkilötietojen lämpökartta tarkistaa kokonaiset keskustietokantojen skeemat ja merkitsee arkaluonteiset kentät ennen yhdenkin peittosäännön soveltamista, mikä vähentää manuaalista yhdistämistyötä, joka yleensä kuormittaa vaatimustenmukaisuustiimejä.
Broadcom Test Data Managerin tärkeimmät ominaisuudet
- Itsepalvelun tietopalvelu: Keskitetty luettelo, jossa testaajat voivat pyytää, varata ja vapauttaa testidataa tarpeen mukaan dynaamisten lomakkeiden avulla ilman tietokannan ylläpitäjien odottamista.
- DAVE-tietokantojen virtualisointi: Kirjoitushetkellä kopioiva kloonausmoottori, joka luo jaettuun peruskuvaan perustuvia itsenäisiä tietokantaklooneja muutamassa minuutissa ja käyttää vain vähän ylimääräistä tallennustilaa.
- Javelin-työnkulkujen automatisointi: Sisäänrakennettu visuaalinen automaatiomoottori, joka orkestroi tietojen peittämis-, osajoukkojen muodostamis- ja käyttöönottotehtäviä ja jonka voi käynnistää REST-ohjelmointirajapinnan tai CI/CD-putkien kautta.
- Viite-eheyden säilyttäminen: Peittämis- ja osajoukkojen muodostamistoiminnot säilyttävät taulujen väliset suhteet, joten testiaineistot pysyvät toiminnallisesti yhtenäisinä päästä päähän -testausta varten.
Broadcom Test Data Manager -integraatiot
Dokumentoituihin integraatioihin kuuluvat Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM ja CA Agile Central. REST-ohjelmointirajapinnat tukevat mukautettuja CI/CD-työnkulkuja, ja Docker sekä Kubernetes tukevat konttipohjaisia käyttöönottoja.
Pros and Cons
Pros:
- Keskustietokoneympäristöt sisältävä testidatan peittäminen
- Automatisoitu henkilötietojen löytäminen ja lämpökartat
- Kirjoitushetkellä kopioiva tietokantojen virtualisointi (DAVE)
Cons:
- SaaS-käyttöönottovaihtoehtoa ei ole saatavilla
- Käyttöliittymä tuntuu vanhentuneelta ja monimutkaiselta
Learn more about Broadcom Test Data Manager: Sopii parhaiten yrityksille, joilla on monimutkaisia ympäristöjä
- Saatavilla 30 päivän ilmainen kokeilujakso
- Hinta pyydettäessä
Visit WebsiteCustomer Rating:4.5/5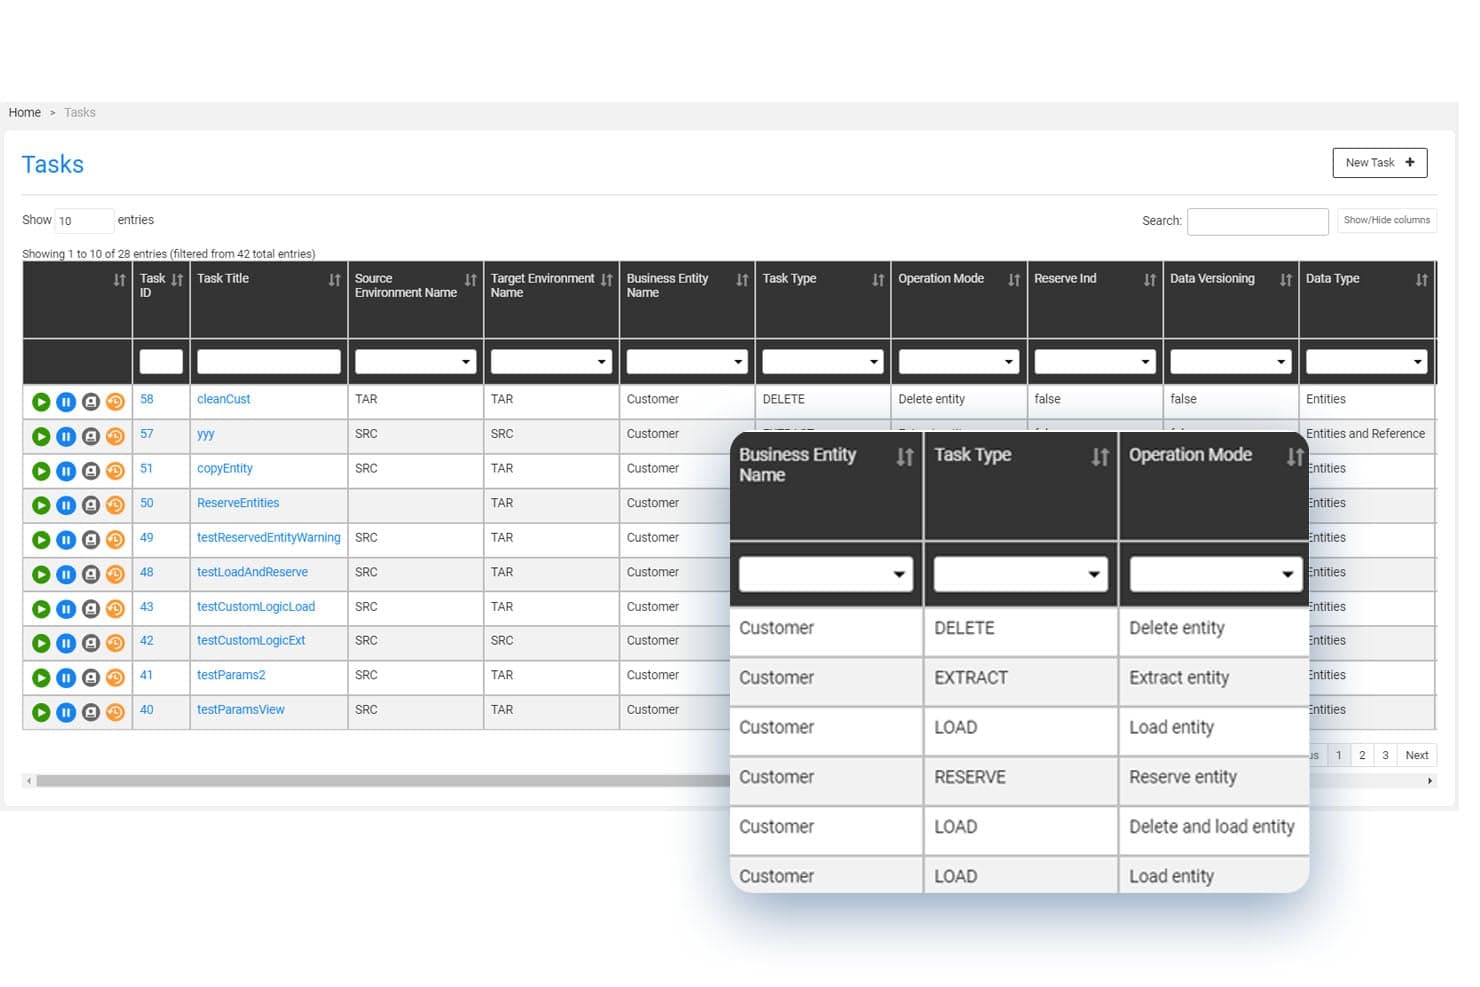
K2View Test Data Managementin avulla käyttäjät voivat hallita ja suodattaa tietotehtäviä tyypin ja toimintatilan mukaan. K2View Test Data Management on yritystason TDM-alusta, joka yhdistää tietojen peittämisen, synteettisten tietojen luonnin, osajoukkojen muodostamisen ja itsepalvelupohjaisen tietojen käyttöönoton relaatiotietokantojen, NoSQL-tietolähteiden, keskuskoneiden ja pilvitietolähteiden välillä patentoidun Micro-Database™-arkkitehtuurin avulla.
Kenelle K2View Test Data Management sopii parhaiten?
K2View on suunniteltu suurille yrityksille, jotka hallitsevat testitietoja samanaikaisesti sekalaisissa ympäristöissä – keskuskoneissa, pilvessä, NoSQL- ja relaatiotietokannoissa.
Miksi valitsin K2View Test Data Managementin
K2View pääsi suosituslistalleni, koska sen patentoitu Micro-Database™-arkkitehtuuri ratkaisee ongelman, jonka useimmat TDM-työkalut sivuuttavat: viite-eheyden ylläpitämisen samanaikaisesti keskuskonelähteissä, NoSQL-lähteissä ja pilvilähteissä. Erityisen vaikuttunut olen lennonaikaisesta peittämisestä, jossa henkilötiedot peitetään jo poimintavaiheessa eivätkä ne koskaan päädy peittämättöminä testiympäristöön. Entiteettikeskeisen osajoukon muodostamisen avulla tiimit voivat poimia täydellisen asiakastietueen, joka kattaa Oraclen, Kafkan ja MongoDB:n, yhdellä toiminnolla ilman manuaalisia liitossääntöjä.
K2View Test Data Managementin tärkeimmät ominaisuudet
- Itsepalvelupohjainen TDM-portaali: Verkkopohjainen käyttöliittymä, jonka avulla testaajat voivat pyytää, varata ja palauttaa testitietoja ilman data- tai tietokantatiimien osallistumista.
- Aikakoneen tilannevedos ja palautus: Tallentaa tietyt testitietojen tilat milloin tahansa, jotta testaajat voivat palauttaa ympäristöt välittömästi tunnettuun kokoonpanoon.
- Automaattinen henkilötietojen etsintä: Sisäänrakennetut luokittelijat tarkistavat kaikki yhdistetyt lähteet, merkitsevät arkaluonteiset kentät ja suosittelevat tai soveltavat peittokäytäntöjä automaattisesti.
- Agenttipohjainen TDM: Tekoälyohjattu toiminto, joka lukee testitapaukset ja kokoaa itsenäisesti vaatimustenmukaiset, käyttöönottoon valmiit tietoaineistot ilman manuaalista määritystä.
K2View Test Data Management -integraatiot
K2View tarjoaa sisäänrakennetut liittimet Oraclelle, SQL Serverille, PostgreSQL:lle, DB2:lle, MongoDB:lle, Snowflakelle, Salesforcelle, Amazon S3:lle, Kafkalle ja keskuskonejärjestelmille. REST-, JDBC- ja ODBC-yhteydet tukevat mukautettuja integraatioita sekä CI/CD-työnkulkuja Jenkinsin, GitHub Actionsin ja Azure DevOpsin kanssa.
Pros and Cons
Pros:
- Lennonaikainen peittäminen estää peittämättömien henkilötietojen paljastumisen
- Entiteettikeskeinen osajoukkojen muodostaminen kattaa keskuskoneet ja pilven
- Alustaan sisäänrakennettu automaattinen henkilötietojen etsintä
Cons:
- Ei suunniteltu pienille tiimeille
- Ohjelmointirajapintapohjainen CI/CD-integraatio edellyttää määrityksiä
Learn more about K2View Test Data Management: Parhaat tietokantojen väliset osajoukot säännellyillä toimialoilla
- Ilmainen esittely saatavilla
- Hinta pyynnöstä

IBM InfoSphere Optim auttaa luomaan testitietoja nopeasti. IBM:n testidatan hallinta on yritystason testidatan hallintaratkaisu, joka kattaa tietojen peittämisen, tietokantojen välisen osajoukon muodostamisen sekä tietojen tarpeen mukaan tapahtuvan toimittamisen useista relaatio- ja keskuskonelähteistä.
Kenelle IBM:n testidatan hallinta sopii parhaiten?
IBM:n testidatan hallinta sopii erityisesti suurille säännellyillä toimialoilla — rahoituspalveluissa, terveydenhuollossa ja vakuutusalalla — toimiville yrityksille, joiden monimutkaisissa ympäristöissä käytetään useita tietokantoja tai keskuskoneita ja joissa tietojen peittäminen sekä tietokantojen välisten osajoukkojen muodostaminen ovat vaatimustenmukaisuuden edellytyksiä.
Miksi valitsin IBM:n testidatan hallinnan
IBM:n testidatan hallinta päätyi suosikkilistalleni erityisesti siksi, miten se käsittelee tietokantojen välisten osajoukkojen muodostamista liiketoimintaobjektien tasolla ja kokoaa viite-eheät osajoukot useista samanaikaisesti yhdistetyistä tietokannoista. Olen erityisen vaikuttunut sen yhdistetystä poimintaominaisuudesta, jonka ansiosta tiimit voivat työskennellä heterogeenisissä tietoympäristöissä, kuten VSAM- ja IMS-keskuskonejärjestelmissä, joissa lähes mikään kilpaileva työkalu ei toimi. Yli 40 ennalta määritettyä peittämissääntöä ja muodon säilyttävä tulostus tekevät siitä aidosti hyödyllisen GDPR- ja HIPAA-säännellyissä ympäristöissä.
IBM:n testidatan hallinnan tärkeimmät ominaisuudet
- Governance Catalog -integraatio: Vedä ja pudota tietojen luokittelusäännöt suoraan sarakekarttoihin, jolloin peittämisrutiinit määritetään automaattisesti keskitetystä käytäntöluettelosta.
- Apache Spark -suoritusympäristö: Sisäänrakennettu Spark-moottori käsittelee suuria tietomääriä automaattisissa osajoukkojen muodostamis- ja peittämistyönkuluissa.
- Roolipohjainen käyttöoikeuksien hallinta: Keycloak-pohjainen RBAC, joka tukee LDAP:tä, SAML:ää, OIDC:tä ja Kerberosta, hallitsee sitä, kuka voi käyttää, pyytää ja päivittää testitietoaineistoja.
- Vaatimustenmukaisuusraportointi: Sisäänrakennettu raportointi varmistaa tietosuojakäytäntöjen toteutumisen GDPR- ja HIPAA-säännellyissä ympäristöissä.
IBM:n testidatan hallinnan integraatiot
Dokumentoituihin integraatioihin kuuluvat IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark sekä tietokannat, kuten Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza ja rajoitetusti MongoDB. Sen OpenAPI 2.0 -rajapinta tukee mukautettua orkestrointia ja CI/CD-työnkulkuja, kun taas z/OS-versio muodostaa yhteyden VSAM- ja IMS-järjestelmiin.
Pros and Cons
Pros:
- Säilyttää viite-eheyden tietokantojen välillä
- Muodon säilyttävä peittäminen tukee säänneltyjä tietoja
- Käsittelee VSAM- ja IMS-osajoukkoja
Cons:
- Ei natiivia synteettisen datan luontia
- Fyysiset kopiot korvaavat virtuaalisen kloonauksen
Learn more about IBM Test Data Management: Paras peittämiseen useita tietokantoja sisältävissä putkissa
- Ilmainen esittely saatavilla
- Hinta pyynnöstä

Tonic.ai:n avulla käyttäjät voivat hallita tietokantataulujen datan peittosääntöjä. Tonic.ai on testidatan hallinta-alusta, joka kattaa jäsennellyn datan peittämisen ja osajoukkojen muodostamisen, jäsentämättömän datan sensuroinnin sekä täysin synteettisen datan luonnin relaatiotietokannoissa, NoSQL-tietovarastoissa ja pilvipohjaisissa tietovarastoratkaisuissa.
Kenelle Tonic.ai sopii parhaiten?
Tonic.ai sopii erinomaisesti data-insinööreille ja DBA-asiantuntijoille, jotka hallitsevat testidataa monimutkaisissa, useita tietokantoja sisältävissä ympäristöissä, joissa käytetään relaatiotietokantoja, NoSQL-tietovarastoja ja pilvipohjaisia tietovarastoratkaisuja.
Miksi valitsin Tonic.ai:n
Valitsin Tonic.ai:n yhdeksi parhaista vaihtoehdoista, koska sen deterministinen peittomoottori käyttää samoille syötteille yhdenmukaisia peitettyjä arvoja samanaikaisesti PostgreSQL:ssä, MongoDB:ssä, Snowflakessa ja kaikissa muissa putken lähteissä. Tämä tarkoittaa, että relaatiotietokannassa peitetty asiakastunnus vastaa samaa peitettyä arvoa tietovarastossa ja dokumenttivarastossa, joten liitokset säilyvät järjestelmien välillä. Sen patentoitu osajoukkomoottori vahvistaa tätä poimimalla viite-eheydeltään johdonmukaisia osia, minkä ansiosta eBay pienensi 8PB:n tietojoukon siistiksi 1GB:n testiympäristöksi rikkomatta yhtäkään taulujen välistä suhdetta.
Tonic.ai:n tärkeimmät ominaisuudet
- PII/PHI-tietojen automaattinen löytäminen: Tarkistaa yhdistetyt tietolähteet, havaitsee arkaluonteiset kentät ja suosittelee peittomuunnoksia ilman manuaalista sarakekohtaista määritystä.
- Tonic Ephemeral: Käynnistää tarvittaessa eristettyjä tietokantoja CI/CD-putkissa suorien DNS-yhteyksien avulla ja poistaa ne automaattisesti testauksen jälkeen.
- Skeeman muutosten tunnistus: Tunnistaa uudet tai muokatut sarakkeet ja voi estää datan luonnin automaattisesti, jotta PII-tietoja ei päädy vahingossa testiympäristöihin.
- Generaattorin esiasetukset: Mahdollistaa nimettyjen peitto- ja muunnossääntöjen tallentamisen ja uudelleenkäytön yleisesti työtiloissa, mikä pitää peittokäytännöt yhdenmukaisina suuressa mittakaavassa.
Tonic.ai:n integraatiot
Tonic.ai tarjoaa natiivin GitHub Actions -integraation sekä REST API -yhteyden Jenkinsille ja GitLab CI:lle. Se yhdistyy PostgreSQL:ään, MySQL:ään, SQL Serveriin, Oracleen, MongoDB:hen, DynamoDB:hen, Snowflakeen, BigQueryyn, Redshiftiin ja Databricksiin.
Pros and Cons
Pros:
- Patentoitu osajoukkomoottori säilyttää viite-eheyden
- Deterministinen peittäminen useilla tietokanta-alustoilla
- PII-tietojen automaattinen löytäminen tekoälyn suosituksilla
Cons:
- Natiivin keskustietokoneen tietolähdetuen puuttuminen
- Käyttöönotto voi aluksi olla monimutkaista suuryrityksissä
Learn more about Tonic.ai: Paras visuaaliseen, kattavuuslähtöiseen datan suunnitteluun
- 14 päivän ilmainen kokeilujakso
- Hinta pyynnöstä

Curiosity Software visualisoi datasuhteet säteittäisen osituskaavion avulla. Curiosity Software on testidatan hallinta-alusta, joka yhdistää tietojen peittämisen, synteettisen datan luonnin, osajoukkojen muodostamisen, virtualisoinnin ja itsepalvelupohjaisen käyttöönoton yli 250 lähdeintegraatiossa – mukaan lukien VSAM:n, IMS:n ja CICS:n kaltaiset keskusjärjestelmät.
Kenelle Curiosity Software sopii parhaiten?
Curiosity Software sopii yritysten laadunvarmistustiimeille ja data-insinööreille, jotka työskentelevät monimutkaisissa usean lähteen ympäristöissä – erityisesti niille, jotka tukevat keskusjärjestelmiä tai hallitsevat vaatimustenmukaisuuteen perustuvaa testidataa laajassa mittakaavassa.
Miksi valitsin Curiosity Softwaren
Valitsin Curiosity Softwaren yhdeksi parhaista vaihtoehdoista, koska sen kattavuuslähtöinen lähestymistapa datan suunnitteluun erottaa sen aidosti muista. Sen sijaan, että testidatan sääntöjä kirjoitettaisiin manuaalisesti komentosarjoina, rakennat visuaalisia datavirtamalleja, jotka sisältävät liiketoimintalogiikan ja rajoitteet, ja alusta tunnistaa automaattisesti kattavuusaukot sekä luo niiden täyttämiseksi synteettistä dataa. Etsi ja luo -toiminto on mielestäni erityisen hyödyllinen: se etsii testiesi tarvitsemaa olemassa olevaa dataa ja luo kohdennettuja synteettisiä tietueita vain sinne, missä aukkoja on vielä jäljellä, joten et koskaan varaa liikaa resursseja etkä työskentele ilman riittäviä tietoja.
Curiosity Softwaren tärkeimmät ominaisuudet
- Henkilötietojen automaattinen etsintä: Skannaa yhdistetyt tietolähteet ja etsii sekä merkitsee arkaluonteiset kentät automaattisesti ennen datan käyttöönottoa tuotantoon kuulumattomissa ympäristöissä.
- Itsepalvelupohjainen käyttöönottoportaali: Verkkopohjaisen portaalin avulla tiimit voivat pyytää ja ottaa testidataa käyttöön tarpeen mukaan parametroitujen, uudelleenkäytettävien töiden avulla ilman testidatatiimin osallistumista.
- CI/CD-putkien integrointi: Testidatatöitä voidaan käynnistää dynaamisesti rajapinnan kautta Jenkinsissä, GitLabissa, GitHubissa, Azure DevOpsissa ja Bitbucketissa oikea-aikaista datan toimitusta varten.
- Graafipohjainen datan alkuperä: Tallentaa jäljitettävyys- ja lähteiden väliset suhdetiedot Neo4j:n avulla ja tuottaa visuaalisia putkiesityksiä, jotka tuovat näkyviin viiteavaimet, liitokset ja orpoviittaukset.
Curiosity Softwaren integraatiot
Curiosity Software tarjoaa yli 250 integraatiota, mukaan lukien Oracle, SQL Server, Snowflake, Salesforce, VSAM, IMS, Jenkins, GitHub, GitLab ja Azure DevOps. Sen rajapinnat tukevat mukautettuja integraatioita sekä CI/CD:n käynnistämää oikea-aikaista testidatan toimitusta pilvi-, paikallisissa ja hybridiympäristöissä.
Pros and Cons
Pros:
- Visuaalinen mallipohjainen testidatan suunnittelu
- Keskusjärjestelmien tietojen peittäminen ja osajoukkojen muodostaminen sisältyvät
- Henkilötietojen automaattinen etsintä ja vaatimustenmukaisuuteen perustuvat ominaisuudet
Cons:
- Osajoukkojen muodostamisen vaihtoehtoja kuvataan dokumentaatiossa puutteellisesti
- Julkaistuja SOC 2- tai ISO 27001 -sertifiointeja ei ole
Learn more about Curiosity Software: Paras Git-tyyliseen tietokantojen kloonaukseen viidellä tietokantamoottorilla
- Ilmainen esittely saatavilla
- Hinta pyynnöstä

Redgate SQL Provisionin avulla käyttäjät voivat hallita tietokantojen klooneja useissa SQL-instansseissa. Redgate SQL Provision on testidatan hallintatyökalu, joka kattaa tietojen peittämisen, osajoukkojen muodostamisen ja Git-tyylisen tietokantojen kloonauksen SQL Serverissä, PostgreSQL:ssä, MySQL:ssä, MariaDB:ssä ja Oraclessa.
Kenelle Redgate SQL Provision sopii parhaiten?
Redgate SQL Provision sopii erinomaisesti tietokannan ylläpitäjille ja laadunvarmistusinsinööreille, jotka tarvitsevat nopeaa ja versiohallittua tietokantojen kloonausta ja peittämistä useilla relaatiotietokantamoottoreilla.
Miksi valitsin Redgate SQL Provisionin
Valitsin Redgate SQL Provisionin yhdeksi parhaista vaihtoehdoista, koska sen Git-tyylinen tietokantojen kloonaus on aidosti jotain aivan muuta kuin mikään, mitä olen nähnyt näissä viidessä tietokantamoottorissa. Redgate Clone käynnistää toimivan datakontin sekunneissa tietokannan koosta riippumatta, joten 5 teratavun SQL Server -tietokanta valmistellaan yhtä nopeasti kuin 128 megatavun tietokanta. Voit luoda haaroja, palauttaa tilan ja tallentaa versioita Git-työnkulun tapaan, joten jokaiselle testaajalle on helppo antaa oma eristetty ympäristö ilman tallennustilan monistamista.
Redgate SQL Provisionin tärkeimmät ominaisuudet
- Anonymize CLI (
rganonymize): Kolmivaiheinen komentorivityökalu, joka luokittelee henkilötietoja sisältävät sarakkeet, yhdistää peittosäännöt sarakkeisiin ja korvaa oikeat arvot SQL Serverissä, PostgreSQL:ssä, MySQL:ssä, MariaDB:ssä ja Oraclessa. - Deterministinen peittäminen: Peittää saman syötearvon aina samalla tulosarvolla kiinteän siemenen avulla ja säilyttää peitettyjen tietojen yhdenmukaisuuden toisiinsa liittyvissä tauluissa.
- Tietojen osajoukon muodostaminen:
rgsubset-CLI poimii lähdetietokannastasi määritettävissä olevan osan — oletusarvoisesti 10 % — ja seuraa viiteavaimia viite-eheyden säilyttämiseksi. - Tekoälyn mukautetut tietojoukot: Voit kuvailla tarvitsemasi arvot vapaalla kielellä, minkä jälkeen työkalu luo tarkistettavan, enintään 1 000 arvon luettelon käytettäväksi peittämisen korvausarvoina.
Redgate SQL Provisionin integraatiot
Redgate SQL Provision integroituu SQL Serveriin, PostgreSQL:ään, MySQL:ään, MariaDB:hen, Oracleen, Dockeriin, AWS CloudFormationiin, Azure Kubernetes Serviceen, SQL Data Catalogiin, PowerShelliin ja dbatools-ohjelmistoon. Sen CLI-työkalut tukevat skriptattuja CI/CD-työnkulkuja, mutta natiivisia Jenkins-, Azure DevOps- ja GitHub Actions -laajennuksia ei ole dokumentoitu.
Pros and Cons
Pros:
- Git-tyylinen haarauttaminen päivittää testitietokannat nopeasti
- Deterministinen peittäminen säilyttää taulujen välisen yhdenmukaisuuden
- Viiteavaimet huomioiva osajoukkojen muodostaminen suojaa relaatiotietojen eheyttä
Cons:
- Synteettisten tietojen luominen rajoittuu arvoluetteloihin
- Tuotteen asemointi aiheuttaa epävarmuutta ostajissa
Learn more about Redgate SQL Provision:
Muut testidatan hallintatyökalut
Tässä on joitakin muita testidatan hallintatyökaluja, jotka eivät päässeet ehdokaslistalleni mutta joihin kannattaa silti tutustua:
- 11Perforce DelphixSopii parhaiten kokonaisten tuotantotietokantojen kloonien virtualisointiin
- 12SynthesizedSopii parhaiten SAP-natiiviseen testidatan peittämiseen
- 13Tricentis ToscaParas tekoälypohjaiseen testaukseen
- 14InformaticaParas yritysten testaukseen
- 15BMC CompuwareParas välittömään testaukseen
- 16Rocket Data ExpressParas testiresurssien säästämiseen
- 17Accelario Continuous DataOps PlatformParas CI/CD:n käynnistämään tietokantavirtualisointiin
- 18Avo Test Data ManagementParas nopeaan ja luotettavaan testidatan luomiseen
- 19SynthoParas yksityisyyttä ensisijaisesti huomioivaan synteettisen datan generointiin
- 20IRI VoracityParas jäsennellyn ja pimeän datan samanaikaiseen peittämiseen
Miten arvioin testidatan hallintatyökaluja
Jaan arvioinnin kolmeen osaan ja painotan eniten keskeisiä tarpeita: arkaluonteisten tietojen peittäminen, realististen synteettisten tietueiden luominen ja osajoukkojen välisten yhteyksien säilyttäminen. Seuraavaksi etsin erottavia ominaisuuksia, kuten arkaluonteisten tietojen etsintää ja versioituja testitietoja. Lopuksi tarkastelen käyttöönottoa, tukea, käyttöönottoympäristön sopivuutta ja hinnoittelua.
Keskeiset toiminnot (tämän luettelon perusvaatimukset)
Kun valitsen työkaluja luettelooni, annan jokaiselle työkalulle arvosanan asteikolla 0 (ei tarjoa toimintoa)–5 (on erinomainen tällä alueella) jokaisen alla luetellun keskeisen toiminnon osalta. Muutan sitten kokonaispistemäärän prosenttiosuudeksi, jotta voin arvioida kunkin työkalun yleistä sopivuutta, ja annan erityispainon toiminnoille, jotka olen määritellyt välttämättömiksi.
- Tietojen peittäminen (välttämätön): Etsin määritettävissä olevaa ja yhdenmukaista eri tietotyypeissä toimivaa peittämistä, jotta tiimit voivat jakaa tuotantoa vastaavia tietueita paljastamatta asiakkaiden tietoja.
- Synteettinen data (välttämätön): Arvioin, vastaavatko luodut tietueet todellisten tietojen rakenteita ja jakaumia, mukaan lukien luotettavaan sovellustestaukseen tarvittavat poikkeustapaukset.
- Tietojen osajoukon muodostaminen: Tarkistan, voivatko tiimit poimia pienempiä tietojoukkoja säilyttäen samalla toisiinsa liittyvät tietueet, kuten tilaukset ja niihin liittyvät asiakkaat.
- Ympäristöjen käyttöönotto: Arvioin, miten tiimit kloonaavat tai päivittävät testiympäristöjä ja voivatko ne toistaa nämä vaiheet kehitys- ja laadunvarmistusympäristöissä.
- Viite-eheys: Arvioin, miten työkalu säilyttää taulukoiden ja järjestelmien väliset suhteet peittämisen, tietojen luonnin ja osajoukko-operaatioiden aikana.
- Putkien integrointi: Etsin tapoja käynnistää tietojen käyttöönotto CI/CD- tai testiautomaation työnkuluista, esimerkiksi valmistella uusi tietojoukko jokaista testiajoa varten.
Kun minulla on luettelo kriteerit täyttävistä työkaluista, tarkastelen, mikä erottaa kunkin alustan muista.
Erottavat tekijät (mikä erottaa toimittajat toisistaan)
Näin vertailen eri toimittajia:
Erottuvat ominaisuudet
Etsin tekoälypohjaista tietojen luontia, joka oppii tuotantoympäristön malleista ja tuottaa synteettisiä tietojoukkoja ilman sääntöjen manuaalista määrittämistä – tämä on hyödyllistä, kun laadunvarmistustiimi tarvitsee realistisia poikkeustapauksia kymmenissä taulukoissa. Arkaluonteisten tietojen etsintä on yhtä tärkeää; tarkistan, luokitteleeko työkalu henkilötiedot automaattisesti eri lähteistä koostuvissa tietoaineistoissa, sillä manuaalinen merkitseminen hidastaa käyttöönottoa ja aiheuttaa vaatimustenmukaisuuteen liittyviä puutteita. Arvioin myös versionhallittuja testitietoja, joissa tiimit voivat ottaa tietojoukoista tilannevedoksia, luoda niistä haaroja ja palauttaa niitä aiempaan tilaan samalla tavoin kuin ne hallitsevat koodia, mikä pitää testisyklit toistettavina skeemamuutosten jälkeen.
Ominaisuuksia laajemmat tekijät
Käyttöönoton joustavuus on tärkeää, koska jotkin tiimit tarvitsevat tietoja palomuurien takana, kun taas toiset käyttävät pilvipohjaisia putkia. Tarkistan, tarjoaako toimittaja paikallisen, pilvipohjaisen ja hybridikäyttöönoton vaihtoehdot, jotta tietojen sijaintia koskevat käytännöt eivät jää jälkikäteen huomioitaviksi. Skaalautuvuus on yhtä tärkeää – arvioin, miten kukin työkalu käsittelee useiden teratavujen tietojoukkoja peittämisen tai osajoukkojen muodostamisen aikana, sillä hidas käyttöönotto hidastaa CI/CD-syklejä. Tarkastelen myös lisensointimalleja selvittääkseni, skaalautuuko hinnoittelu tietomäärän, ympäristöjen vai käyttäjäpaikkojen mukaan, sillä tämä vaikuttaa pitkäaikaiseen käyttöönottoon useissa tuotetiimeissä.
Näin valitset testidatan hallintatyökalun
On helppo juuttua pitkiin ominaisuusluetteloihin ja monimutkaisiin hinnoittelurakenteisiin. Jotta pystyt keskittymään olennaiseen käydessäsi läpi yksilöllistä ohjelmistonvalintaprosessiasi, tässä on luettelo huomioon otettavista tekijöistä:
| Tekijä | Huomioitavaa |
|---|---|
| TekijäSkaalautuvuus | HuomioitavaaKasvaako työkalu tiimisi mukana? Huomioi tuleva tietomäärä ja käyttäjämäärän kasvu. Etsi joustavia suunnitelmia, jotka mahdollistavat skaalautumisen ilman merkittäviä kustannusten nousuja. |
| TekijäIntegraatiot | HuomioitavaaToimiiko se nykyisten järjestelmiesi kanssa? Tarkista yhteensopivuus nykyisten testaustyökalujesi, tietokantojesi ja työnkulkujesi kanssa häiriöiden välttämiseksi. |
| TekijäMuokattavuus | HuomioitavaaVoitko mukauttaa työkalun tarpeisiisi? Arvioi, mahdollistaako työkalu mukautettujen tietomallien ja työnkulkujen käytön prosessiesi mukaisesti. |
| TekijäHelppokäyttöisyys | HuomioitavaaOnko se tiimillesi helppokäyttöinen? Huomioi oppimiskäyrä ja se, pystyvätkö teknistä osaamista vailla olevat työntekijät käyttämään työkalua helposti ilman laajaa koulutusta. |
| TekijäKäyttöönotto ja perehdytys | HuomioitavaaKuinka nopeasti pääset alkuun? Etsi työkaluja, jotka tarjoavat nopean käyttöönoton, koulutusmateriaaleja ja tukea sujuvan siirtymän varmistamiseksi. |
| TekijäKustannukset | HuomioitavaaSopiiko se budjettiisi? Vertaile hinnoittelumalleja ja varmista, ettei piilokuluja ole. Tarkista, onko saatavilla maksuton kokeilujakso tai esittelyversio, jolla voit testata työkalua ennen sitoutumista. |
| TekijäTurvallisuustoimet | HuomioitavaaMiten se suojaa tietojasi? Varmista, että työkalu noudattaa tietoturvastandardeja ja tarjoaa salauksen sekä käyttöoikeuksien hallinnan arkaluonteisten tietojen suojaamiseksi. |
| TekijäVaatimustenmukaisuusvaatimukset | HuomioitavaaTäyttääkö se sääntelyvaatimukset? Varmista, että työkalu tukee toimialasi vaatimusten mukaan sovellettavien tietosuojasäännösten, kuten GDPR:n tai HIPAA:n, noudattamista. |
Mitä testidatan hallintatyökalut ovat?
Testidatan hallintatyökalut ovat ohjelmistoja, joita käytetään tietojen luomiseen, hallintaan ja ylläpitoon ohjelmistotestausta varten. Ne käsittelevät testidatan luomista ja muokkaamista varmistaen, että tiedot ovat tarkkoja, turvallisia ja soveltuvat monenlaisiin testaustilanteisiin.
Näillä työkaluilla on tärkeä rooli tietojen järjestämisessä ja valmistelussa toiminnallista, suorituskyky- ja regressiotestausta varten ohjelmistokehityksessä. Ne toimivat usein yhdessä tietokantojen testaustyökalujen kanssa kattavan tietojen validoinnin varmistamiseksi.
Ominaisuudet
Kun valitset testitietojen hallintatyökaluja, kiinnitä huomiota seuraaviin tärkeisiin ominaisuuksiin:
- Tietojen peittäminen: Suojaa arkaluonteisia tietoja korvaamalla ne kuvitteellisilla tiedoilla ja varmistaa tietosuojavaatimusten noudattamisen.
- Tietojen osajoukkojen muodostaminen: Poimii suurista tietoaineistoista tietojen osajoukon, mikä tekee testaamisesta hallittavampaa ja tehokkaampaa.
- Integrointimahdollisuudet: Yhdistää olemassa oleviin testaustyökaluihin ja tietokantoihin, mikä helpottaa sujuvia työnkulkuja.
- Mukautetut tietomallit: Mahdollistaa käyttäjille omiin testaustarpeisiin mukautettujen mallien luomisen ja lisää joustavuutta.
- Tekoälypohjainen tietojen generointi: Käyttää tekoälyä realististen testitietojen luomiseen ja parantaa testien tarkkuutta.
- Reaaliaikainen tietojen valmistelu: Tarjoaa välittömän pääsyn tarvittaviin testitietoihin ja vähentää testausprosessin viivästyksiä.
- Monipilvituki: Mahdollistaa työkalun käytön eri pilviympäristöissä ja tarjoaa joustavuutta käyttöönottoon.
- Salaus ja käyttöoikeuksien hallinta: Varmistaa tietoturvan salaamalla tiedot ja määrittämällä käyttäjien käyttöoikeudet.
- Koulutusresurssit: Tarjoaa oppaita, webinaareja ja muuta oppimateriaalia käyttäjien perehdyttämisen ja työkalun käyttöönoton tueksi.
- Vaatimustenmukaisuuden tuki: Auttaa varmistamaan, että tietojen käsittely täyttää alan standardit ja säädökset, kuten GDPR:n tai HIPAA:n, vaatimukset.
Hyödyt
Testitietojen hallintatyökalujen käyttöönotto tarjoaa tiimillesi ja yrityksellesi useita hyötyjä. Tässä muutamia etuja, joita voit odottaa:
- Parantunut tietosuoja: Tietojen peittämisominaisuudet auttavat suojaamaan arkaluonteisia tietoja ja varmistavat tietosuojasäännösten noudattamisen.
- Tehokkaampi testaus: Reaaliaikainen tietojen valmistelu vähentää viivästyksiä ja mahdollistaa nopeammat testauskierrokset.
- Parempi tietojen tarkkuus: Tekoälypohjainen tietojen generointi luo realistisia testitietoja ja parantaa testitulosten luotettavuutta.
- Kustannussäästöt: Tietojen osajoukkojen muodostaminen poimii vain tarvittavat tiedot ja vähentää tallennus- ja käsittelykustannuksia.
- Joustava käyttöönotto: Monipilvituki mahdollistaa työkalun toiminnan eri ympäristöissä ja mukautumisen infrastruktuurisi tarpeisiin.
- Käyttäjäystävällinen perehdytys: Koulutusresurssien ja oppaiden saatavuus tukee työkalun nopeaa käyttöönottoa ja tehokasta käyttöä.
- Sääntelyn noudattaminen: Vaatimustenmukaisuuden tukitoiminnot auttavat täyttämään alan standardit ja vähentävät oikeudellisten ongelmien riskiä.
Kustannukset ja hinnoittelu
Testitietojen hallintatyökalujen valinta edellyttää saatavilla olevien hinnoittelumallien ja tilausten ymmärtämistä. Kustannukset vaihtelevat ominaisuuksien, tiimin koon, lisäosien ja muiden tekijöiden mukaan. Alla olevassa taulukossa esitetään testitietojen hallintatyökaluratkaisujen yleisiä tilauksia, niiden keskimääräisiä hintoja ja tyypillisiä ominaisuuksia:
Testitietojen hallintatyökalujen tilausten vertailutaulukko
| Tilauksen tyyppi | Keskimääräinen hinta | Yleiset ominaisuudet |
|---|---|---|
| Tilauksen tyyppiIlmainen tilaus | Keskimääräinen hinta$0 | Yleiset ominaisuudetPerustason tietojen peittäminen, rajoitettu tietojen osajoukkojen muodostaminen ja rajalliset integrointimahdollisuudet. |
| Tilauksen tyyppiHenkilökohtainen tilaus | Keskimääräinen hinta$5-$25/käyttäjä/kuukausi | Yleiset ominaisuudetParannettu tietosuoja, tekoälypohjainen tietojen generointi ja perustason tuki. |
| Tilauksen tyyppiYritystilaus | Keskimääräinen hinta$30-$75/käyttäjä/kuukausi | Yleiset ominaisuudetEdistynyt tietojen osajoukkojen muodostaminen, monipilvituki ja koulutusresurssien käyttömahdollisuus. |
| Tilauksen tyyppiYritystason tilaus | Keskimääräinen hinta$100+/käyttäjä/kuukausi | Yleiset ominaisuudetMukautetut tietomallit, kattava vaatimustenmukaisuuden tuki, ensiluokkainen asiakastuki ja täydet integrointimahdollisuudet. |
Testidatan hallintatyökalujen usein kysytyt kysymykset
Tässä on vastauksia yleisiin testidatan hallintatyökaluja koskeviin kysymyksiin:
Pitäisikö sinun valita peittämis- vai synteettisen datan ominaisuudet?
Tietojen peittäminen suojaa todellisia tietoja piilottamalla henkilötiedot. Synteettistä dataa tuottava ohjelmisto luo väärennettyjä mutta realistisia tietojoukkoja. Valitse peittäminen, jos käytät tuotantodataa; synteettinen data sopii, jos haluat turvallisempia, kokonaan luotuja testiaineistoja.
Jos olet yhä vaiheessa, jossa “tarvitset lisää testidataa”, kokeile: 10 parasta käytettävyystestauksen työkalua todellisten käyttäjäpalautteiden keräämiseen.
Miksi tietoturva on tärkeää testidatan hallintatyökaluissa?
Testidatan hallintaohjelmisto käsittelee usein arkaluonteisia tuotantotietoja. Ilman asianmukaista peittämistä tai salausta vaarana ovat tietovuodot tai vaatimustenmukaisuusongelmat. Valitse aina työkalu, joka tukee salausta, anonymisointia ja käyttöoikeuksien hallintaa.
Mitä integraatioita testidatan hallintatyökalun pitäisi tukea?
Sen pitäisi toimia CI/CD-työkalujesi, kuten Jenkinsin, GitLabin tai Azure DevOpsin, kanssa. Integraatio tärkeimpien tietokantojen (Oracle, SQL Server, PostgreSQL) ja pilvialustojen kanssa on myös olennaista sujuvan automaation kannalta.
Miten testidatan hallintatyökalua testataan ennen ostamista?
Toteuta pieni konseptitodistus. Kokeile tietojen kloonaamista, peittämistä ja päivittämistä todellisessa ympäristössäsi. Selvitä, kuinka nopeasti työkalu toimii ja sopiiko se nykyiseen työnkulkuusi.
Miten testidatan hallintatyökalut voivat auttaa vaatimustenmukaisuudessa?
Hyvät työkalut seuraavat jokaista tietomuutosta, säilyttävät tarkastuslokit ja varmistavat, että peitetyt tiedot pysyvät yhdenmukaisina. Tämä auttaa tiimiäsi noudattamaan säädöksiä, kuten GDPR:ää, HIPAA:ta tai CCPA:ta.