

Supervisar tu red con una plataforma de supervisión todo en uno puede ser complicado, especialmente cuando tus herramientas actuales no satisfacen del todo tus necesidades. Es posible que estés utilizando PRTG y descubras que no se adapta a los requisitos específicos de tu equipo o que carece de ciertas funciones.
Según mi experiencia, encontrar la solución de supervisión de redes adecuada puede aliviar considerablemente tu carga de trabajo, reducir el tiempo de inactividad y mejorar el rendimiento general. Por eso he investigado y probado varias alternativas a PRTG para ayudarte a encontrar la opción que mejor se adapte a tu empresa.
En este artículo encontrarás reseñas imparciales de las principales alternativas, centradas en sus características y ventajas únicas. Tanto si buscas una mejor escalabilidad como un cumplimiento normativo específico del sector o una experiencia de usuario mejorada, te guiaré por las distintas opciones. Encontremos el software de supervisión de redes que mejor respalde a tu equipo.
¿Qué es PRTG?
Paessler Router Traffic Grapher (PRTG), conocido a menudo como PRTG Network Monitor, es una herramienta de supervisión diseñada para ayudarte a realizar un seguimiento del estado y el rendimiento de tu red. Los profesionales de la supervisión informática y los administradores de redes suelen utilizar PRTG por su capacidad para proporcionar información detallada sobre el tráfico de red y el tiempo de actividad de los sistemas. Funciones como la supervisión en tiempo real, las alertas personalizables y los informes detallados responden a tu necesidad de gestionar la red de forma eficiente. PRTG puede proporcionar información valiosa que ayudará a que tus sistemas funcionen correctamente, pero existen alternativas.
Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

Tabla comparativa de alternativas a PRTG
Esta tabla comparativa resume los detalles de precios de mis principales alternativas a PRTG:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Ideal para informes detallados de SLA | 4.0 out of 5 | 4 | 4 | 4 | 4 | 4 | 4 | $1,400/año Plan gratuito + prueba gratuita de 60 días disponible | Website |
Ideal para la gestión remota de TI | 2.7 out of 5 | 3 | 4 | 2 | 2 | 2 | 3 | Precio bajo solicitud Demostración gratuita disponible | Website |
La mejor opción para la escalabilidad de código abierto | 4.2 out of 5 | 4 | 5 | 4 | 4 | 4 | 4 | $325/mes Plan gratuito + prueba gratuita de 5 días + demostración gratuita disponible | Website |
La mejor opción para la observabilidad basada en la nube | 3.5 out of 5 | 4 | 4 | 3 | 3 | 3 | 4 | Desde 0,60 $/mes Plan gratuito + prueba gratuita de 14 días + demostración gratuita disponible | Website |
Ideal para paneles personalizables | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $2,595, pago único Plan gratuito + prueba de 30 días + demostración disponible | Website |
La mejor para la visibilidad de las rutas de Internet | 3.2 out of 5 | 4 | 3 | 2 | 3 | 3 | 4 | Precios bajo solicitud Prueba gratuita de 15 días + demostración disponible | Website |
Ideal para la gestión unificada de dispositivos finales | 3.3 out of 5 | 4 | 4 | 4 | 3 | 2 | 3 | $3.75/mes Prueba gratuita de 14 días + demostración gratuita disponible | Website |
Ideal para el descubrimiento automático de redes | 3.3 out of 5 | 4 | 4 | 4 | 3 | 3 | 2 | Precios bajo solicitud Plan gratuito + demostración gratuita disponible | Website |
Ideal para la monitorización de redes mediante tráfico sintético | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $249/mes Plan gratuito + prueba de 14 días + demostración gratuita disponible | Website |
Ideal para el mapeo automatizado de redes | 3.8 out of 5 | 4 | 4 | 5 | 4 | 4 | 2 | Precios bajo solicitud Prueba gratuita de 14 días + demostración disponible | Website |


Reseñas de las mejores alternativas a PRTG
\u003cspan style=\u0022font-weight: 400;\u0022\u003eA continuación se incluyen mis resúmenes detallados de las mejores alternativas a PRTG que formaron parte de mi selección. En mis reseñas analizo en detalle las características principales, las ventajas y desventajas, las integraciones y los casos de uso ideales de cada herramienta para ayudarte a encontrar la mejor opción para ti.\u003c/span\u003e
 Ideal para informes detallados de SLA
- Plan gratuito + prueba gratuita de 60 días disponible
- Desde $1,400/año (facturado anualmente)
Visit WebsiteCustomer Rating:4.7/5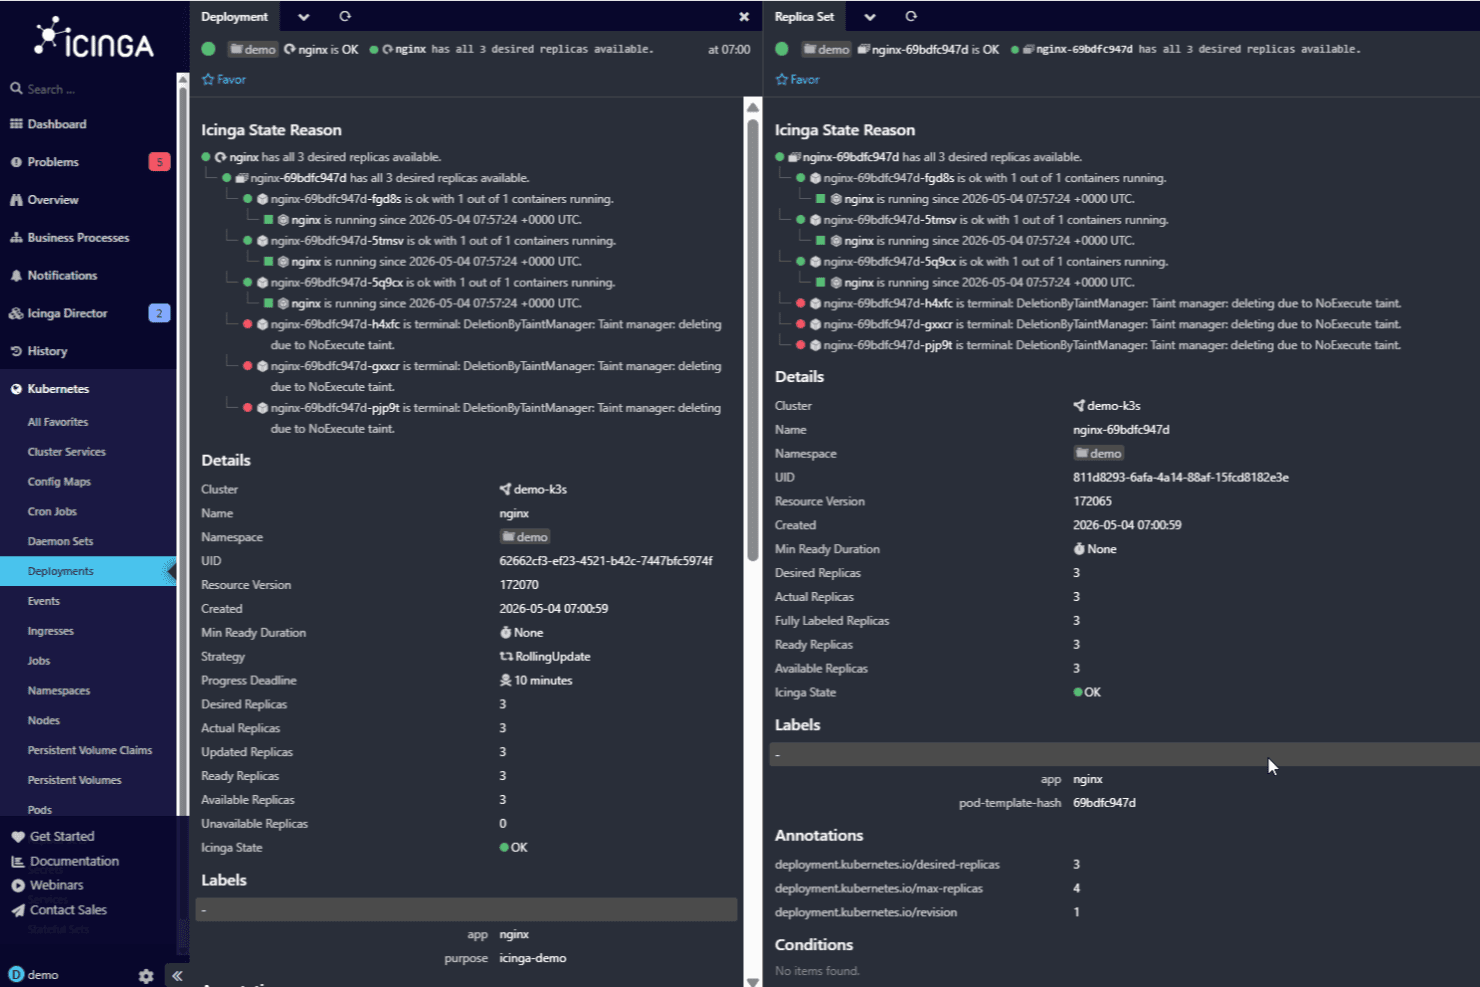
Icinga registra todas las implementaciones en un solo panel con etiquetas, detalles y anotaciones. Icinga es una plataforma de monitoreo de infraestructura de código abierto que resulta atractiva para ingenieros de sistemas, administradores de redes y proveedores de servicios administrados (MSP) que necesitan monitorear un número ilimitado de hosts, métodos de comprobación flexibles e informes detallados de SLA sin las restricciones de licencias por sensor.
¿Para quién es más adecuado Icinga?
Icinga es una excelente opción para ingenieros de sistemas y técnicos de MSP que necesitan monitorear infraestructuras grandes y distribuidas sin que los costos de licencia por host los limiten.
Por qué elegí Icinga
Elegí Icinga como una de las mejores opciones porque sus informes de SLA ofrecen más profundidad que la mayoría de las herramientas de monitoreo con las que he trabajado. Icinga DB mantiene tablas independientes del historial de SLA que conservan exactamente los datos necesarios para calcular la disponibilidad, y el historial no se elimina de forma predeterminada. Puedes generar informes de disponibilidad de hosts y servicios, previsualizarlos en Icinga Web, exportarlos como archivos PDF y programarlos para que se envíen automáticamente a intervalos regulares.
Características principales de Icinga
- Arquitectura distribuida de maestro/satélite/agente: Implementa el monitoreo en varios sitios mediante nodos principales y secundarios que continúan realizando comprobaciones y recopilando datos durante las interrupciones de red.
- Edición gratuita para siempre con hosts ilimitados: Monitorea un número ilimitado de hosts y servicios sin costo, sin restricciones de licencia por sensor o dispositivo.
- Gestión de configuración basada en API: Utiliza una API REST para crear, modificar y eliminar dinámicamente hosts, servicios y objetos de configuración, con compatibilidad con configuraciones versionadas y reversión.
- Compatibilidad con comprobaciones de múltiples protocolos: Monitorea dispositivos y servicios mediante SNMP, SSH, ICMP, comprobaciones basadas en agentes, NSClient++ y resultados pasivos enviados a través de la API REST.
Integraciones de Icinga
Icinga cuenta con integraciones documentadas con Grafana, Elasticsearch, NetBox, Graphite, InfluxDB, Prometheus, Ansible, Puppet y Terraform. Su API REST admite integraciones personalizadas, automatización de la configuración, flujos de eventos y conexiones con procesos de gestión de tickets.
Pros and Cons
Pros:
- Informes detallados de disponibilidad de SLA
- Las comprobaciones distribuidas continúan durante las interrupciones
- Las comprobaciones personalizadas cubren infraestructuras mixtas
Cons:
- La configuración requiere un trabajo manual considerable
- El análisis de tendencias a largo plazo requiere herramientas independientes
Learn more about Icinga: Ideal para la gestión remota de TI
- Demostración gratuita disponible
- Precio bajo solicitud
Visit WebsiteCustomer Rating:4.7/5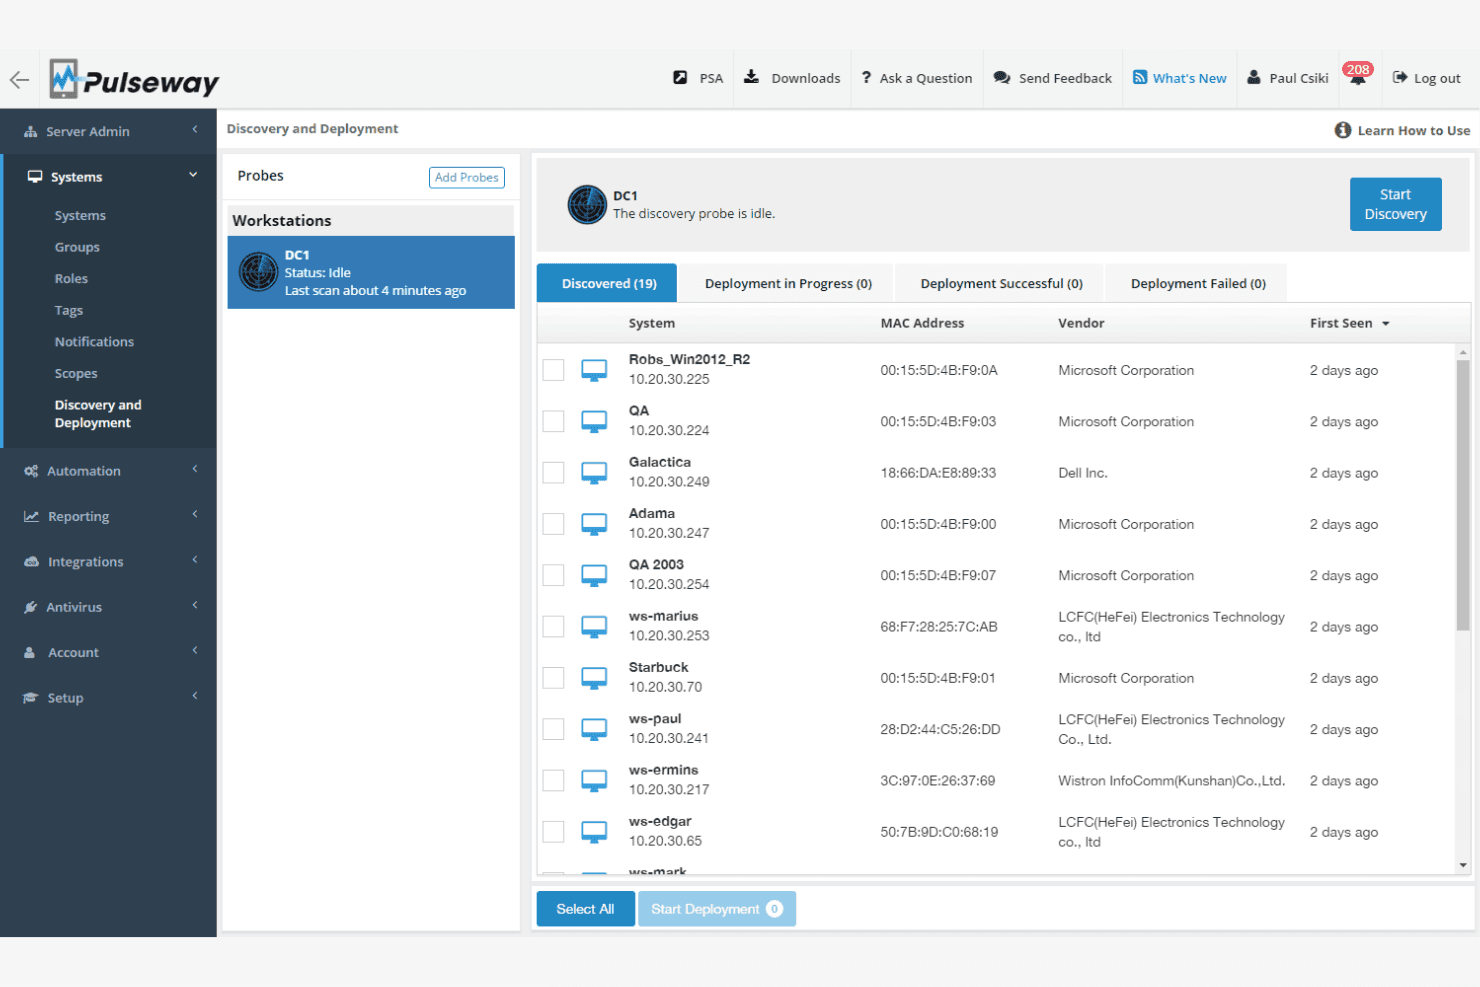
La pantalla de descubrimiento y despliegue de Pulseway encuentra dispositivos en la red y realiza un seguimiento de su estado de despliegue. Pulseway es una plataforma de gestión y monitorización remota (RMM) diseñada para proveedores de servicios gestionados (MSP) y equipos de TI que necesitan supervisar, gestionar y solucionar problemas en terminales, servidores y dispositivos de red, con un fuerte enfoque en el acceso remoto prioritario desde dispositivos móviles y la respuesta a alertas.
¿Para quién es más adecuado Pulseway?
Pulseway es una opción excelente para técnicos de proveedores de servicios gestionados (MSP) que necesitan supervisar y gestionar terminales de clientes de forma remota, especialmente desde un dispositivo móvil.
Por qué elegí Pulseway
Elegí Pulseway como una de las mejores opciones porque su gestión remota prioritaria desde dispositivos móviles lo diferencia de herramientas como PRTG, que te limita a una consola de escritorio. Puedo responder a una alerta crítica del servidor, ejecutar un script de corrección y reiniciar un servicio directamente desde mi teléfono antes de que alguien note una interrupción. Sus alertas condicionales basadas en SNMP se integran con flujos de trabajo de automatización, por lo que la respuesta no es solo una notificación, sino una solución que ya está en marcha.
Características principales de Pulseway
- Mapas de topología de red: Genera automáticamente mapas de topología personalizables con tipos de dispositivos editables, agrupaciones lógicas y relaciones de red.
- Gestión de parches: Automatiza la aplicación de parches del sistema operativo y de aplicaciones de terceros en Windows, Mac y Linux mediante políticas y programaciones configurables.
- Grabación de sesiones de control remoto: Graba manual o automáticamente las sesiones de control remoto de agentes de Windows, tanto las sesiones compartidas como las privadas.
- Flujos de trabajo de automatización activados por alertas: Ejecuta scripts y flujos de trabajo en respuesta a alertas para resolver automáticamente problemas de TI sin intervención manual.
Integraciones de Pulseway
Pulseway ofrece integraciones nativas con PagerDuty, Slack, ConnectWise Manage, Autotask, Zendesk e IT Glue. También proporciona API REST, de cliente y en la nube, además de complementos para conectividad personalizada.
Pros and Cons
Pros:
- Las alertas móviles permiten responder rápidamente de forma remota
- Los scripts activados por alertas reducen la resolución de problemas repetitiva
- Los mapas de topología aclaran las relaciones entre los dispositivos detectados
Cons:
- La configuración de SNMP puede ser complicada
- Los informes ofrecen una personalización y un nivel de detalle limitados
Learn more about Pulseway: La mejor opción para la escalabilidad de código abierto
- Plan gratuito + prueba gratuita de 5 días + demostración gratuita disponible
- Desde $325/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5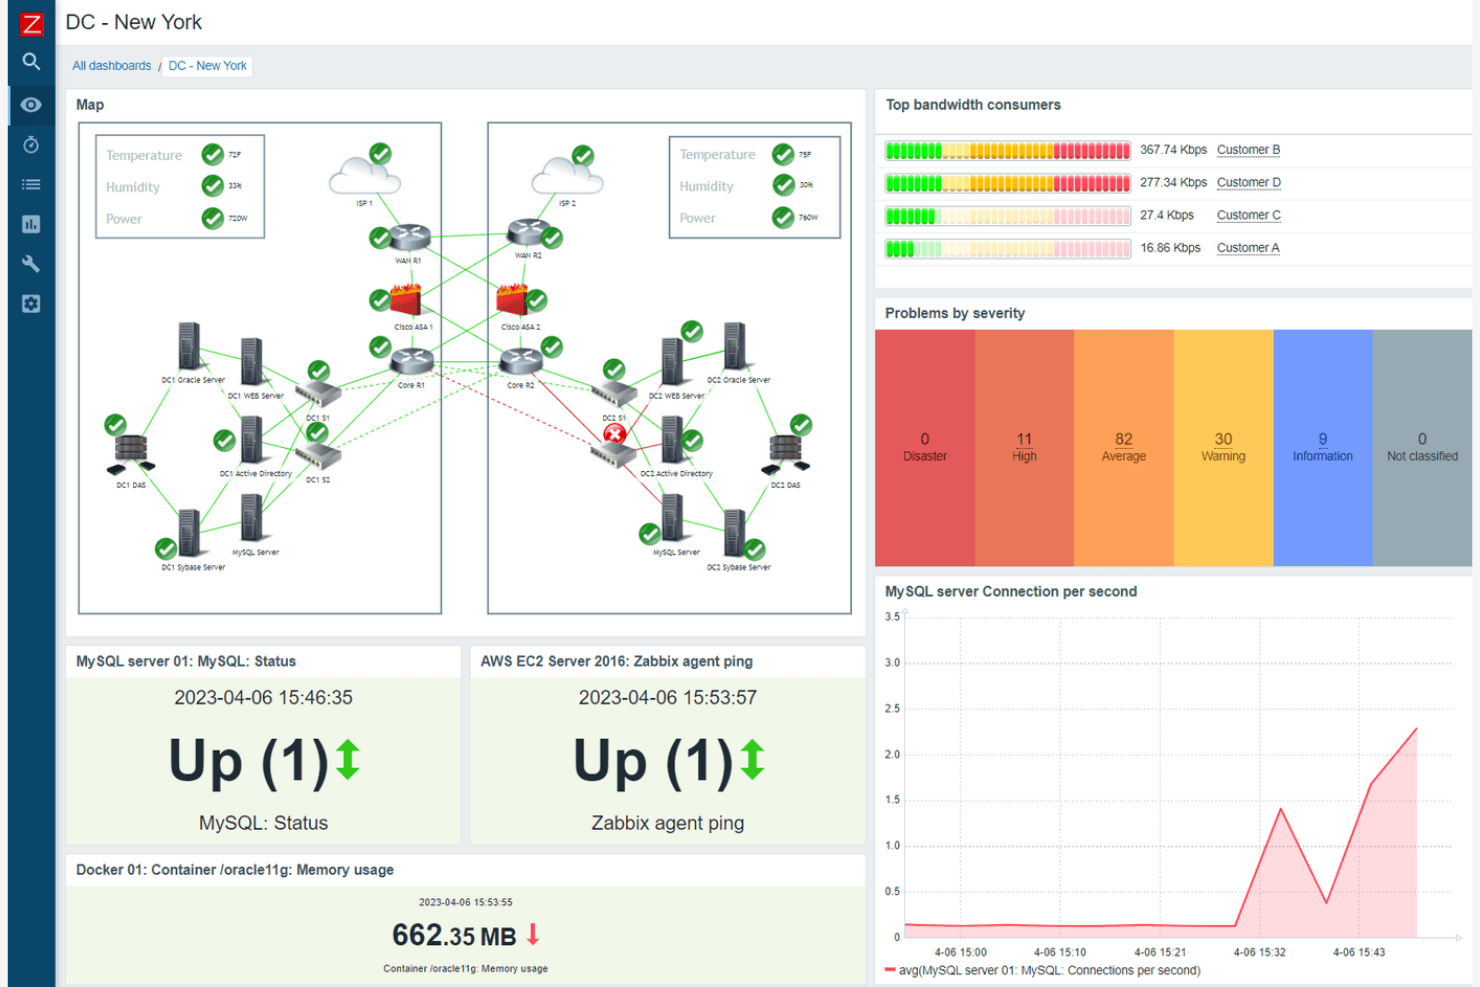
Panel de Zabbix que muestra un mapa de red de un centro de datos, el uso del ancho de banda y los problemas por gravedad. Zabbix es una plataforma de monitorización de código abierto que permite a los equipos de infraestructura y operaciones supervisar servidores, dispositivos de red, recursos en la nube y aplicaciones sin pagar por sensor ni por dispositivo.
¿Para quién es más adecuado Zabbix?
Zabbix es una opción excelente para los equipos de infraestructura y operaciones que necesitan supervisar entornos grandes y complejos sin el coste de las licencias por dispositivo o por sensor.
Por qué elegí Zabbix
Zabbix ocupa un lugar en mi lista de opciones porque es una de las pocas plataformas de monitorización que realmente escala hasta millones de métricas sin cobrar por dispositivo ni por sensor. Aprecio que su arquitectura basada en proxies me permita distribuir la recopilación entre sitios remotos, DMZ y cortafuegos, de modo que un único servidor de Zabbix pueda cubrir de forma realista una infraestructura extensa con múltiples sitios. La licencia de código abierto significa que no hay un límite de sensores al estilo de PRTG esperando silenciosamente para sorprenderte a medida que crece tu entorno.
Características principales de Zabbix
- Monitorización sin agente y multiprotocolo: Supervisa dispositivos de red, servidores y servicios mediante SNMP, IPMI, SSH/Telnet, ICMP/TCP, Prometheus, Modbus y MQTT sin implementar un agente.
- Flujos de trabajo de escalado: Configura escalados de alertas de varios pasos con retrasos, notificaciones repetidas, enrutamiento a grupos de usuarios y ejecución automatizada de comandos remotos.
- Árboles de servicios empresariales: Define jerarquías de servicios, calcula el estado de los servicios mediante algoritmos configurables y mide la disponibilidad con respecto a los objetivos de los SLA.
- API JSON-RPC: Accede a más de 200 métodos de API para automatizar la configuración, recuperar datos históricos e integrar herramientas de terceros con Zabbix.
Integraciones de Zabbix
Zabbix ofrece integraciones nativas con ServiceNow, Jira ServiceDesk, Slack, Microsoft Teams, PagerDuty, AWS, Microsoft Azure, Google Cloud, Kubernetes y VMware. Su API JSON-RPC proporciona más de 200 métodos para integraciones personalizadas, con transmisión a Kafka, RabbitMQ, Amazon SQS y Amazon Kinesis.
Pros and Cons
Pros:
- El sondeo basado en proxies almacena en búfer los datos de sitios remotos
- La monitorización sin agente y basada en agentes cubre diversos sistemas
- Sin límite de licencias basado en sensores
Cons:
- La configuración inicial de hosts y activadores requiere esfuerzo
- Es necesario ajustar los umbrales de alerta para reducir el ruido
 La mejor opción para la observabilidad basada en la nube
- Plan gratuito + prueba gratuita de 14 días + demostración gratuita disponible
- Desde 0,60 $/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5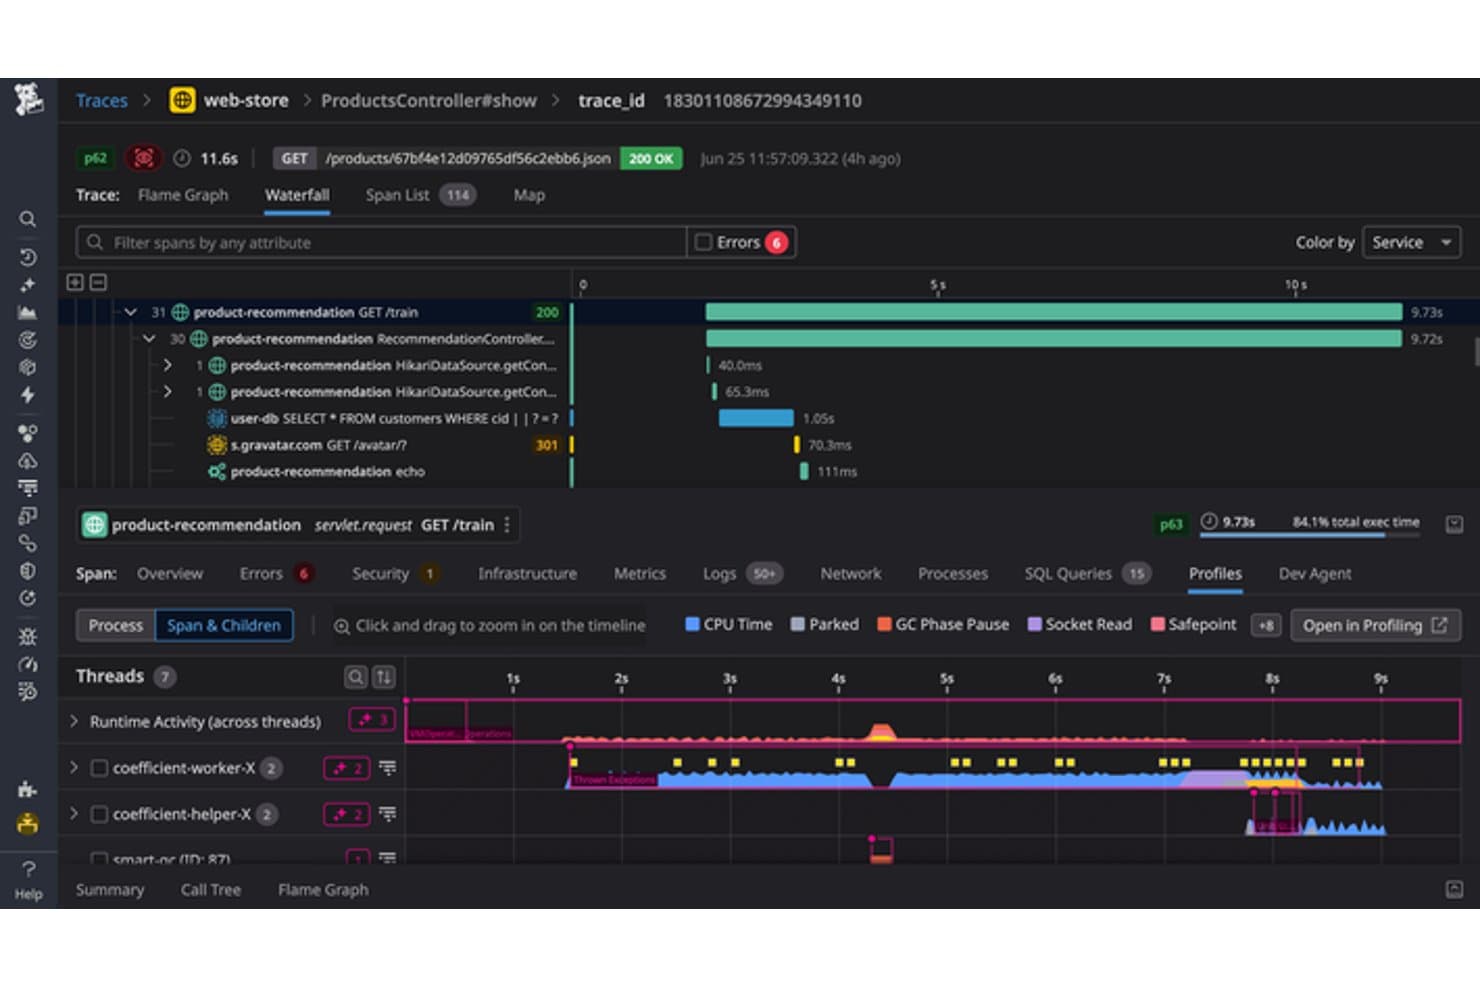
Cascada de trazas de APM de Datadog con vista de perfilado para una solicitud a un servicio de recomendación de productos. Datadog es una plataforma de supervisión nativa de la nube que unifica la visibilidad de la red, la infraestructura y las aplicaciones en entornos multinube e híbridos, lo que la convierte en una opción sólida para los equipos de operaciones de TI que necesitan información correlacionada y entre distintas capas sin gestionar varias herramientas.
¿Para quién es más adecuado Datadog?
Datadog es adecuado para equipos de operaciones de TI que gestionan entornos multinube e híbridos y necesitan tener los datos de la red, la infraestructura y las aplicaciones en un solo lugar.
Por qué elegí Datadog
Elegí Datadog como una de las mejores alternativas a PRTG porque aporta observabilidad nativa de la nube a la supervisión de redes de una forma que las herramientas NMS tradicionales sencillamente no ofrecen. Me gusta especialmente cómo la supervisión de redes en la nube correlaciona el tráfico entre microservicios, puntos de conexión en la nube e infraestructura local en una sola vista, de modo que mi equipo puede pasar de una anomalía de red a la aplicación o el host que la provoca sin cambiar de herramienta. La función Ruta de red añade visibilidad de la latencia salto a salto y la pérdida de paquetes entre VPC, WAN y proveedores de SaaS, lo que hace realmente práctico rastrear rutas degradadas en entornos híbridos.
Características principales de Datadog
- Supervisión de dispositivos de red: Detecta dispositivos físicos y virtuales mediante SNMP (v1–v3), traps, NetFlow y syslog, con paneles de dispositivos e interfaces generados automáticamente.
- Mapa de topología de dispositivos: Visualiza automáticamente las conexiones de red físicas y las dependencias ascendentes y descendentes en todo el inventario de dispositivos.
- Supervisión de NetFlow: Recopila datos de NetFlow v5/v9, IPFIX, sFlow y jFlow para identificar los principales emisores, los protocolos y las tendencias de uso del ancho de banda.
- Gestión de cuentas de varias organizaciones: Separa los datos de los clientes en organizaciones secundarias aisladas, con visibilidad del uso a nivel de la organización principal y configuración programática mediante API o Terraform.
Integraciones de Datadog
Datadog incluye más de 1.000 integraciones integradas en toda la plataforma, entre ellas Arista, Aruba, Cisco, Cisco Meraki, F5 y Juniper. También ofrece una integración con PRTG Marketplace, enriquecimiento de CMDB de ServiceNow y una API REST HTTP para integraciones personalizadas.
Pros and Cons
Pros:
- Correlaciona problemas de red, infraestructura y aplicaciones
- Mapea la latencia salto a salto y la pérdida de paquetes
- Los paneles ayudan a los equipos a detectar problemas de estado del sistema
Cons:
- La configuración de SNMP puede requerir mucho trabajo
- La retención de datos de red queda por detrás de la de las herramientas NMS especializadas
 Ideal para paneles personalizables
- Plan gratuito + prueba de 30 días + demostración disponible
- Desde $2,595, pago único
Visit WebsiteCustomer Rating:4.6/5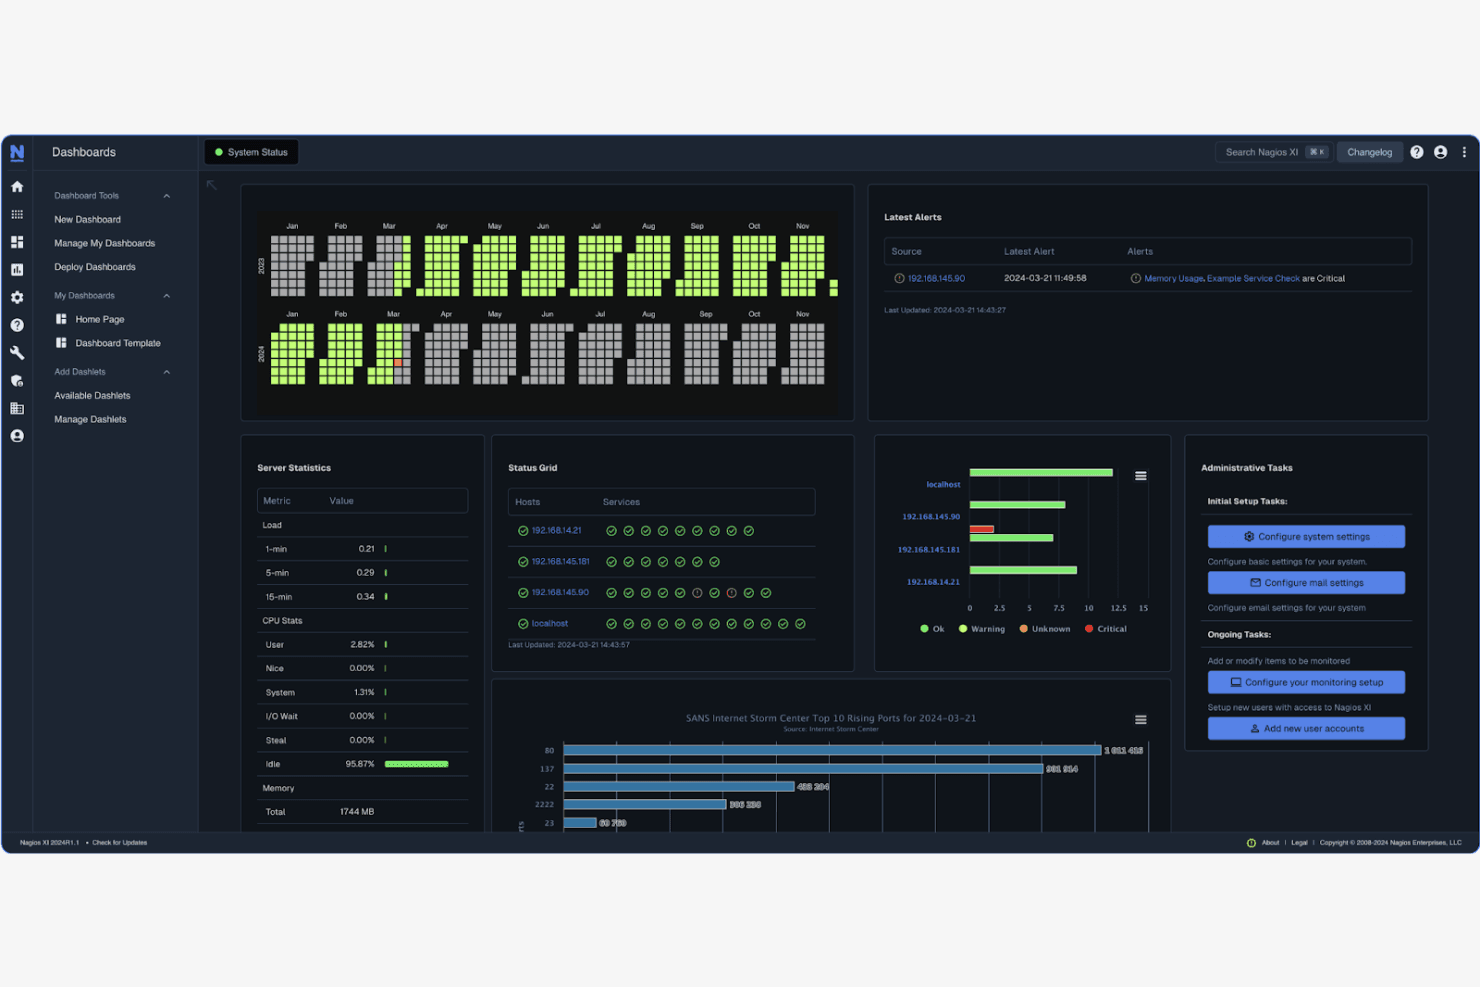
El panel de Nagios XI resume las alertas, el estado de los hosts y servicios, las estadísticas del servidor y las tareas administrativas. Nagios XI es una plataforma de monitorización de infraestructuras autoalojada diseñada para administradores de redes y equipos de operaciones de TI que necesitan un control granular sobre cómo monitorizan servidores, dispositivos de red y aplicaciones, sin las limitaciones de precios por sensor que acompañan a PRTG.
¿Para quién es más adecuado Nagios XI?
Nagios XI es una opción adecuada para administradores de redes e ingenieros de sistemas que necesitan un control profundo sobre un entorno de monitorización autoalojado sin las limitaciones de las licencias basadas en sensores.
Por qué elegí Nagios XI
Elegí Nagios XI como uno de los mejores porque la personalización de sus paneles va más allá que la de la mayoría de las alternativas autoalojadas. Cada usuario crea su propia vista táctica a partir de miniaplicaciones que incluyen gráficos, resúmenes de estado, mapas de red y medidores, y la edición empresarial permite a los administradores distribuir esos paneles a otros usuarios o sincronizarlos con una vista de administración principal. También valoro que se puedan programar paneles como archivos adjuntos PDF enviados por correo electrónico de forma periódica, lo que facilita mantener informadas a las partes interesadas sin realizar tareas manuales de elaboración de informes.
Características principales de Nagios XI
- Licencias por nodo: XI utiliza licencias por nodo monitorizado en lugar de por sensor o comprobación, sin un límite declarado en el número de comprobaciones que se pueden ejecutar por dispositivo.
- Políticas de escalado de notificaciones: Se pueden configurar escalados para que, después de un número determinado de notificaciones, las alertas se envíen automáticamente a un grupo de contactos diferente.
- Reversión de la configuración: Los administradores pueden revertir los errores de configuración a una instantánea conocida como correcta, reduciendo el riesgo de que una configuración incorrecta interrumpa la monitorización.
- Planificación de la capacidad: La edición empresarial visualiza el rendimiento futuro previsto y puede avisar cuando todo indica que se superarán los umbrales.
Integraciones de Nagios XI
Nagios XI ofrece integraciones documentadas con Microsoft Azure AD para SSO y Slack para las notificaciones. También proporciona una API REST para integraciones personalizadas y admite conectividad mediante trampas SNMP.
Pros and Cons
Pros:
- Las licencias por dispositivo evitan los límites de cantidad de sensores
- Las miniaplicaciones adaptan las vistas de infraestructura a cada operador
- Los trabajadores distribuidos amplían la cobertura de comprobaciones remotas
Cons:
- La integración inicial de dispositivos puede requerir un esfuerzo considerable
- Las plantillas de informes ofrecen una flexibilidad limitada
Learn more about Nagios XI: La mejor para la visibilidad de las rutas de Internet
- Prueba gratuita de 15 días + demostración disponible
- Precios bajo solicitud
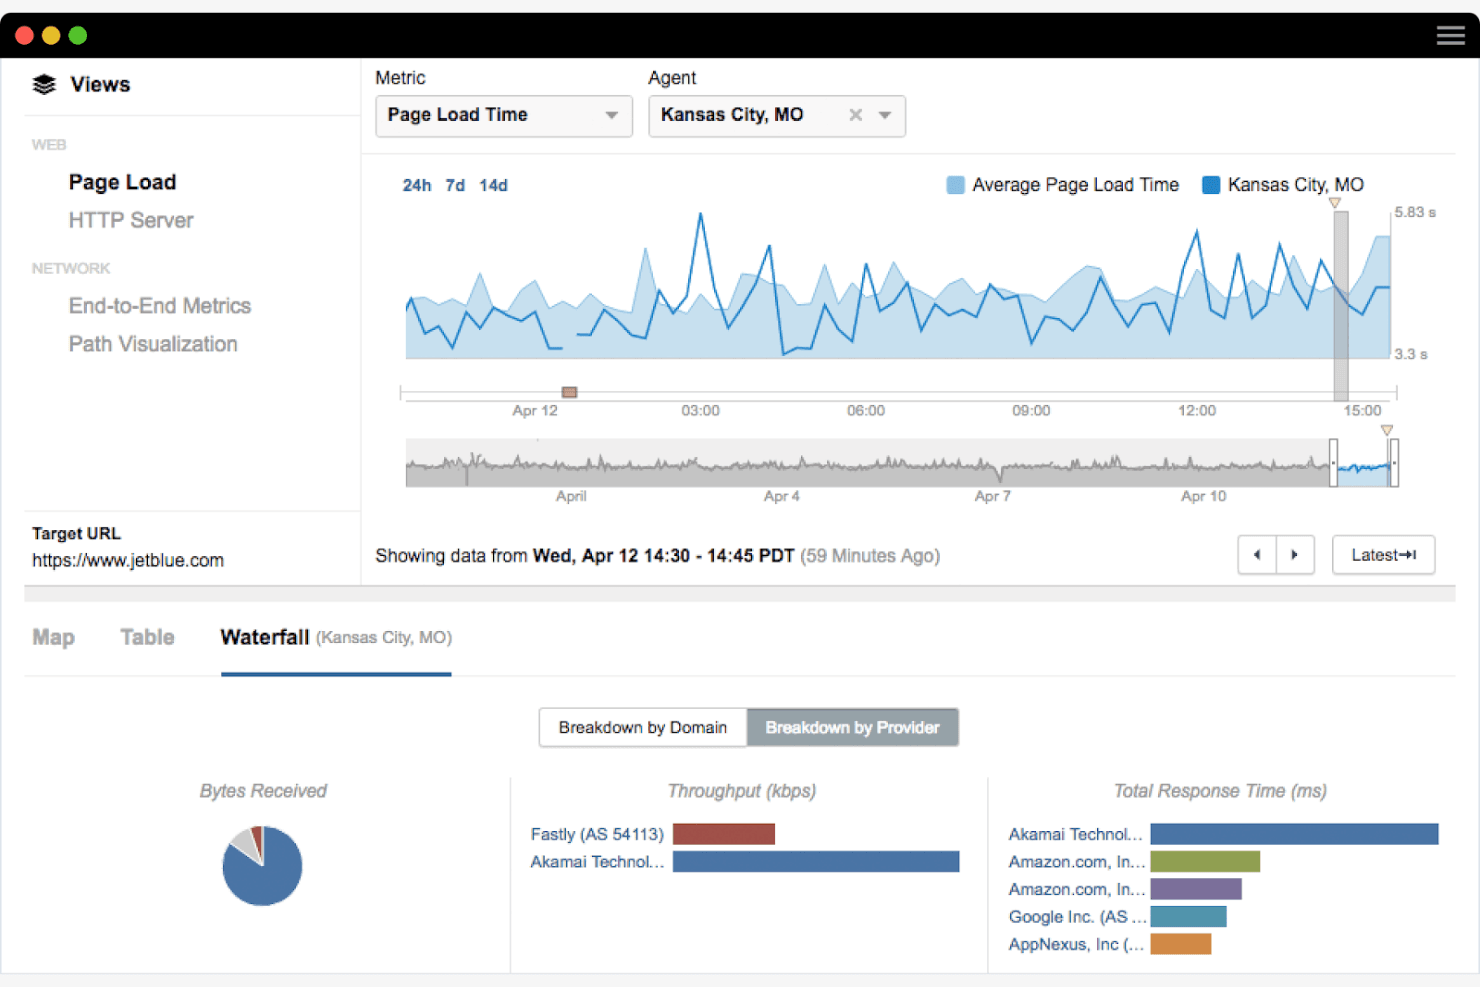
Vista de carga de página de ThousandEyes que registra los tiempos de carga desde un agente de Kansas City, con desgloses por proveedor. ThousandEyes es una plataforma de monitorización de redes respaldada por Cisco que proporciona a los equipos de TI visibilidad integral de cómo se desplaza el tráfico por Internet, los servicios en la nube y las aplicaciones SaaS, lo que la hace especialmente útil cuando se necesita determinar si un problema de rendimiento se encuentra dentro de la red o en algún punto más allá de ella.
¿Para quién es más adecuada ThousandEyes?
ThousandEyes es una buena opción para los equipos de operaciones de TI y redes de empresas medianas y grandes que dependen en gran medida de servicios en la nube, aplicaciones SaaS o entornos de sucursales distribuidas donde la visibilidad de las rutas de Internet es prioritaria.
Por qué elegí ThousandEyes
Elegí ThousandEyes como una de las mejores opciones porque hace algo que las configuraciones tradicionales de PRTG sencillamente no pueden hacer: muestra exactamente en qué punto de la ruta de Internet se encuentra un problema. Cuando una aplicación SaaS como Salesforce empieza a comportarse de forma anómala, la visualización de rutas de red de ThousandEyes rastrea cada salto entre los usuarios y ese servicio, por lo que puedo determinar de inmediato si el fallo está dentro de mi red, en un ISP o en la infraestructura del proveedor de la nube. Sus agentes de nube abarcan 276 ciudades en 71 países, lo que me proporciona una visibilidad desde el exterior que ningún sensor local puede replicar.
Funciones principales de ThousandEyes
- Tipos de pruebas sintéticas: Ejecuta pruebas de monitorización HTTP, FTP, de navegador, DNS, de rutas BGP, VoIP y UCaaS desde agentes de nube y empresariales.
- Monitorización de la capa de dispositivos mediante SNMP: Consulta dispositivos de red mediante SNMPv2c o SNMPv3 a través de agentes empresariales implementados, con análisis de descubrimiento manuales o programados.
- Pruebas de API de varios pasos: Emula interacciones del servidor con puntos de conexión de API, valida el contenido de las respuestas y admite aserciones para comprobar la integridad de los datos y casos límite.
- Configuración de reglas de alerta: Admite reglas de alerta manuales y adaptativas, con distribución de notificaciones a PagerDuty, Slack, ServiceNow o webhooks personalizados.
Integraciones de ThousandEyes
ThousandEyes ofrece integraciones documentadas con PagerDuty, Slack, ServiceNow, Splunk Observability Cloud, AppDynamics, OpenTelemetry y CyberArk Secrets Manager. También proporciona una API REST y webhooks personalizados para integraciones adicionales.
Pros and Cons
Pros:
- Localiza fallos en rutas de red externas
- Revela problemas de latencia, pérdida de paquetes y conectividad con aplicaciones SaaS
- Compara el rendimiento desde puntos de observación de redes globales
Cons:
- Telemetría local limitada para switches y servidores
- La consulta de dispositivos abarca menos protocolos que PRTG
Learn more about ThousandEyes: Ideal para la gestión unificada de dispositivos finales
- Prueba gratuita de 14 días + demostración gratuita disponible
- Desde $3.75/mes
Visit WebsiteCustomer Rating:5/5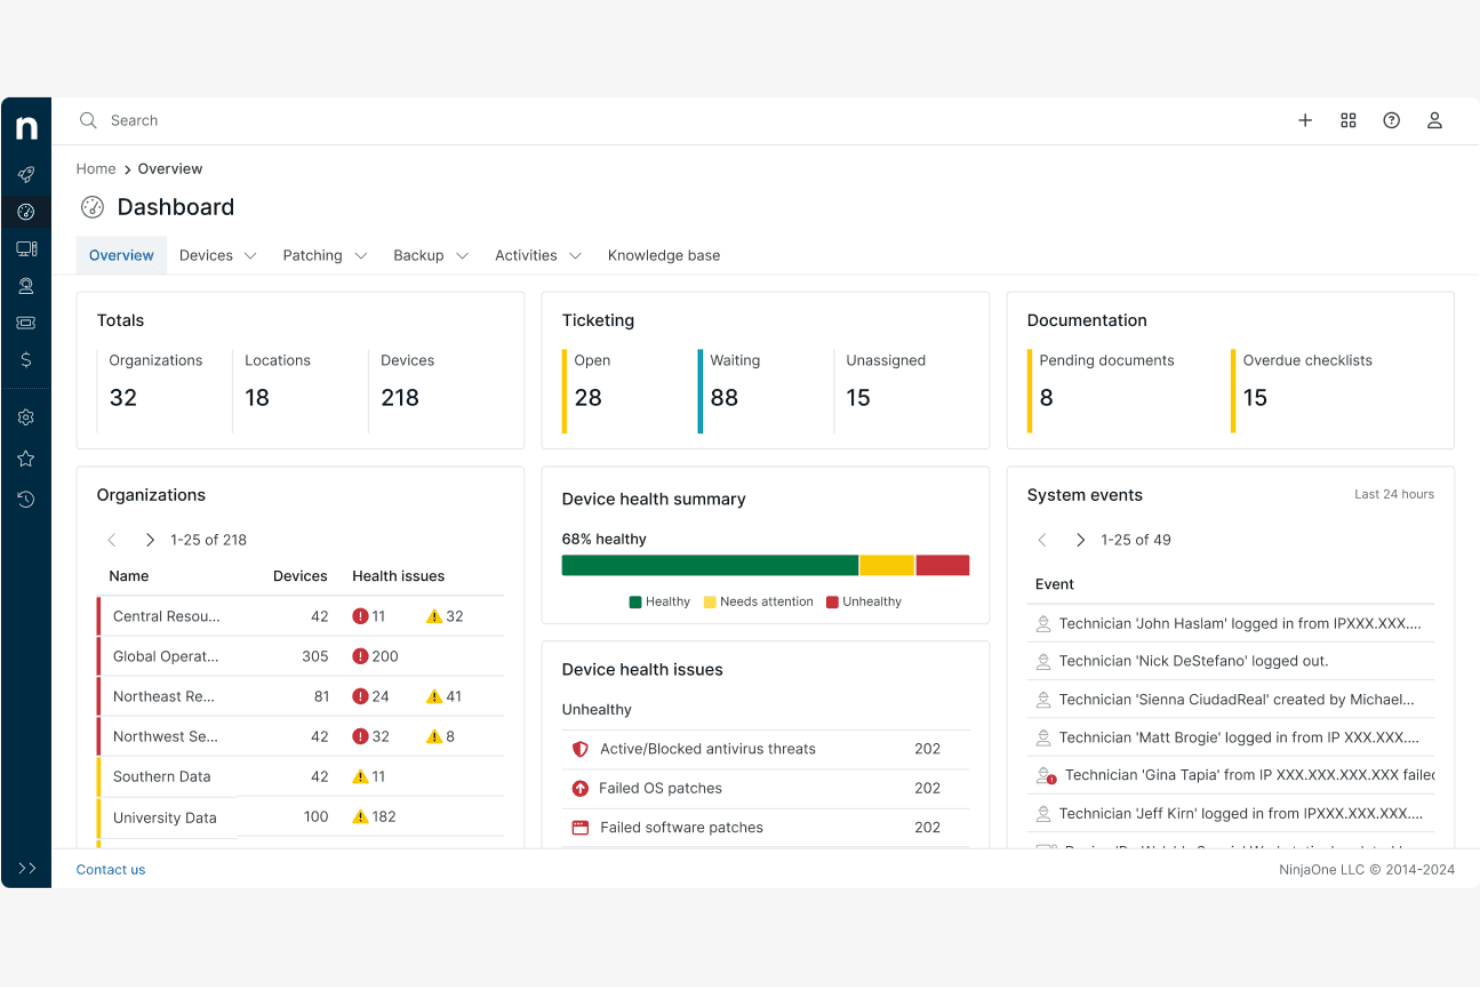
Descripción general del panel de NinjaOne, que resume en una sola vista los dispositivos, las organizaciones, los tickets, el estado de los dispositivos y los eventos del sistema. NinjaOne RMM es una plataforma de supervisión de dispositivos finales y redes diseñada para MSP y equipos de TI que necesitan visibilidad centralizada de dispositivos finales, dispositivos de red e infraestructura en la nube, con herramientas integradas de aplicación de parches, alertas y gestión remota para reducir el trabajo manual.
¿Para quién es más adecuado NinjaOne?
NinjaOne es una opción muy adecuada para técnicos de MSP y equipos de operaciones de TI que gestionan dispositivos finales en varios entornos de clientes desde una única consola.
Por qué elegí NinjaOne
Elegí NinjaOne como una de las mejores alternativas a PRTG porque reúne la supervisión de dispositivos finales, la visibilidad de los dispositivos de red y la corrección automatizada en una única consola, exactamente lo que necesitan los técnicos de MSP que gestionan varios entornos de clientes. Me gusta que NMS esté integrado directamente en el RMM, de modo que mi equipo pueda supervisar enrutadores, conmutadores y cortafuegos junto con dispositivos finales Windows, macOS y Linux sin cambiar de herramienta. Las condiciones basadas en políticas me permiten establecer umbrales para la CPU, la memoria, el tráfico de los adaptadores y la latencia de ping, y después activar correcciones automáticas cuando se superan esos umbrales.
Características principales de NinjaOne
- Alertas multicanal: Configura canales de notificación, como correo electrónico, SMS, Slack, PagerDuty, Microsoft Teams y webhooks, para enviar alertas basadas en umbrales a tu equipo.
- Corrección automática basada en condiciones: Define flujos de trabajo con scripts que detecten y resuelvan automáticamente problemas de los dispositivos finales, como servicios detenidos, puertos abiertos o reinicios pendientes, sin la intervención de un técnico.
- Compatibilidad con la supervisión de flujos: Recopila y analiza datos de NetFlow, JFlow, sFlow e IPFIX procedentes de dispositivos de red compatibles para obtener visibilidad sobre los patrones de tráfico.
- API pública y webhooks: Accede a los datos de NinjaOne y activa acciones mediante programación utilizando una API OAuth 2.0 con compatibilidad total con los métodos POST, GET, PATCH, DELETE y PUT.
Integraciones de NinjaOne
NinjaOne incluye integraciones con ServiceNow, Autotask, ConnectWise Manage, HaloPSA, Slack, PagerDuty, Microsoft Azure y AWS. Su API pública OAuth 2.0 y sus webhooks admiten integraciones personalizadas y flujos de trabajo de supervisión.
Pros and Cons
Pros:
- Centraliza la visibilidad de dispositivos finales y redes entre clientes
- La automatización basada en políticas ayuda a reducir el trabajo rutinario de respuesta
- Supervisa los datos de flujo junto con las métricas del estado de los dispositivos
Cons:
- La supervisión de redes puede requerir la asignación manual de OID
- Información documentada limitada sobre la retención del historial de rendimiento
Learn more about NinjaOne: Ideal para el descubrimiento automático de redes
- Plan gratuito + demostración gratuita disponible
- Precios bajo solicitud
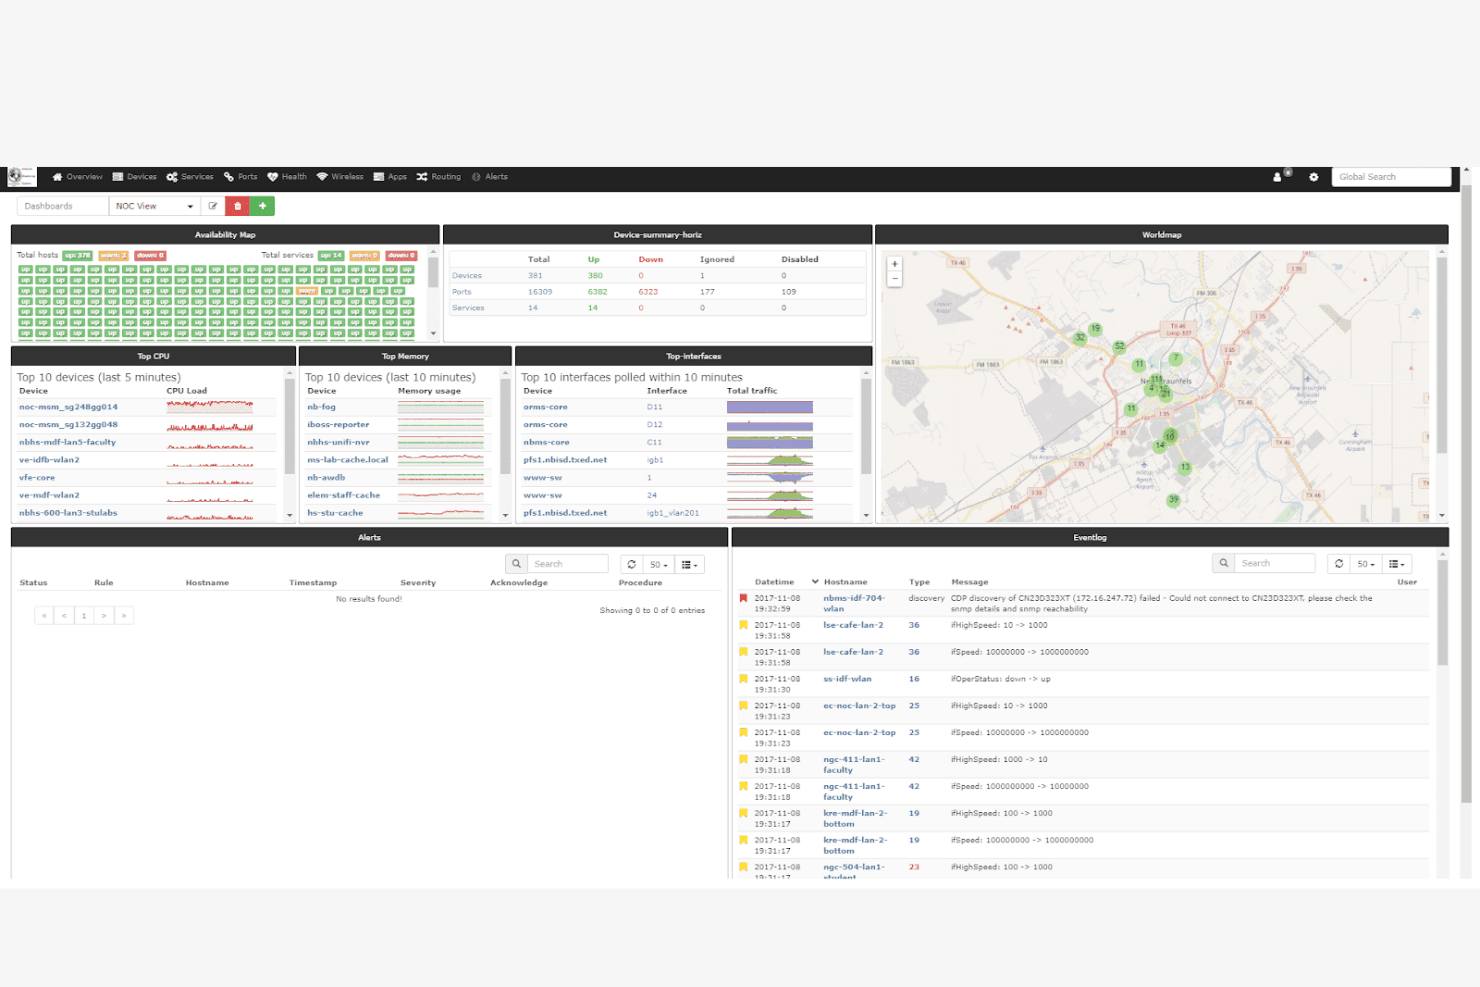
Panel NOC de LibreNMS que muestra la disponibilidad de los dispositivos, el mayor uso de CPU y memoria, el tráfico de las interfaces y un registro de eventos en tiempo real. LibreNMS es un sistema gratuito y de código abierto para la supervisión de redes que resulta atractivo para ingenieros de sistemas y administradores de redes que necesitan un amplio descubrimiento de dispositivos y visibilidad de la infraestructura sin el costo ni las restricciones de licencia de las herramientas comerciales.
¿Para quién es más adecuado LibreNMS?
LibreNMS es una opción sólida para ingenieros de sistemas y administradores de redes que desean un amplio descubrimiento de dispositivos y visibilidad de la infraestructura sin costos de licencia basados en sensores.
Por qué elegí LibreNMS
Elegí LibreNMS como una de las mejores opciones porque su descubrimiento automático de redes es realmente impresionante: utiliza CDP, LLDP, OSPF, BGP, SNMP y ARP para encontrar dispositivos en la red sin intervención manual. He visto cómo incorpora rápidamente enrutadores, conmutadores y puntos de acceso después de la configuración, exactamente lo que se necesita al reemplazar una herramienta limitada por sensores como PRTG. Las comprobaciones integradas de disponibilidad mediante ICMP y la supervisión de aplicaciones para servicios como NGINX, MySQL y Docker completan la visibilidad que se obtiene desde el primer día.
Características principales de LibreNMS
- Operaciones de alertas personalizables: Configure flujos de trabajo de notificaciones de varios pasos con segmentos temporizados que escalen a través de canales como Slack, correo electrónico y Telegram hasta que una alerta se resuelva o se confirme.
- Sistema de facturación de ancho de banda: Genere facturas para los puertos de red basadas directamente en el uso real o en el volumen de transferencia de datos dentro de la plataforma.
- Consulta distribuida: Distribuya las tareas de consulta y descubrimiento entre varios servidores mediante la asignación de dispositivos a grupos de consulta a medida que crece la red.
- Supervisión de aplicaciones con varios protocolos: Recopile estadísticas de aplicaciones de servicios como MySQL, NGINX, Docker y PostgreSQL mediante conexión directa, extensión SNMP o el agente Check_MK.
Integraciones de LibreNMS
Entre las integraciones documentadas se incluyen NfSen, collectd, SmokePing, RANCID y Oxidized. LibreNMS también proporciona una API HTTP con respuestas JSON y PNG para integraciones personalizadas, gestión de dispositivos, generación de gráficos y recuperación de datos.
Pros and Cons
Pros:
- Amplio descubrimiento automático de dispositivos
- Alertas escalables entre canales de notificación
- Realiza un seguimiento del tiempo de actividad y el rendimiento de la red
Cons:
- Opciones limitadas de generación de informes nativos
- La consulta distribuida no está diseñada para sitios remotos
Learn more about LibreNMS: Ideal para la monitorización de redes mediante tráfico sintético
- Plan gratuito + prueba de 14 días + demostración gratuita disponible
- Desde $249/mes
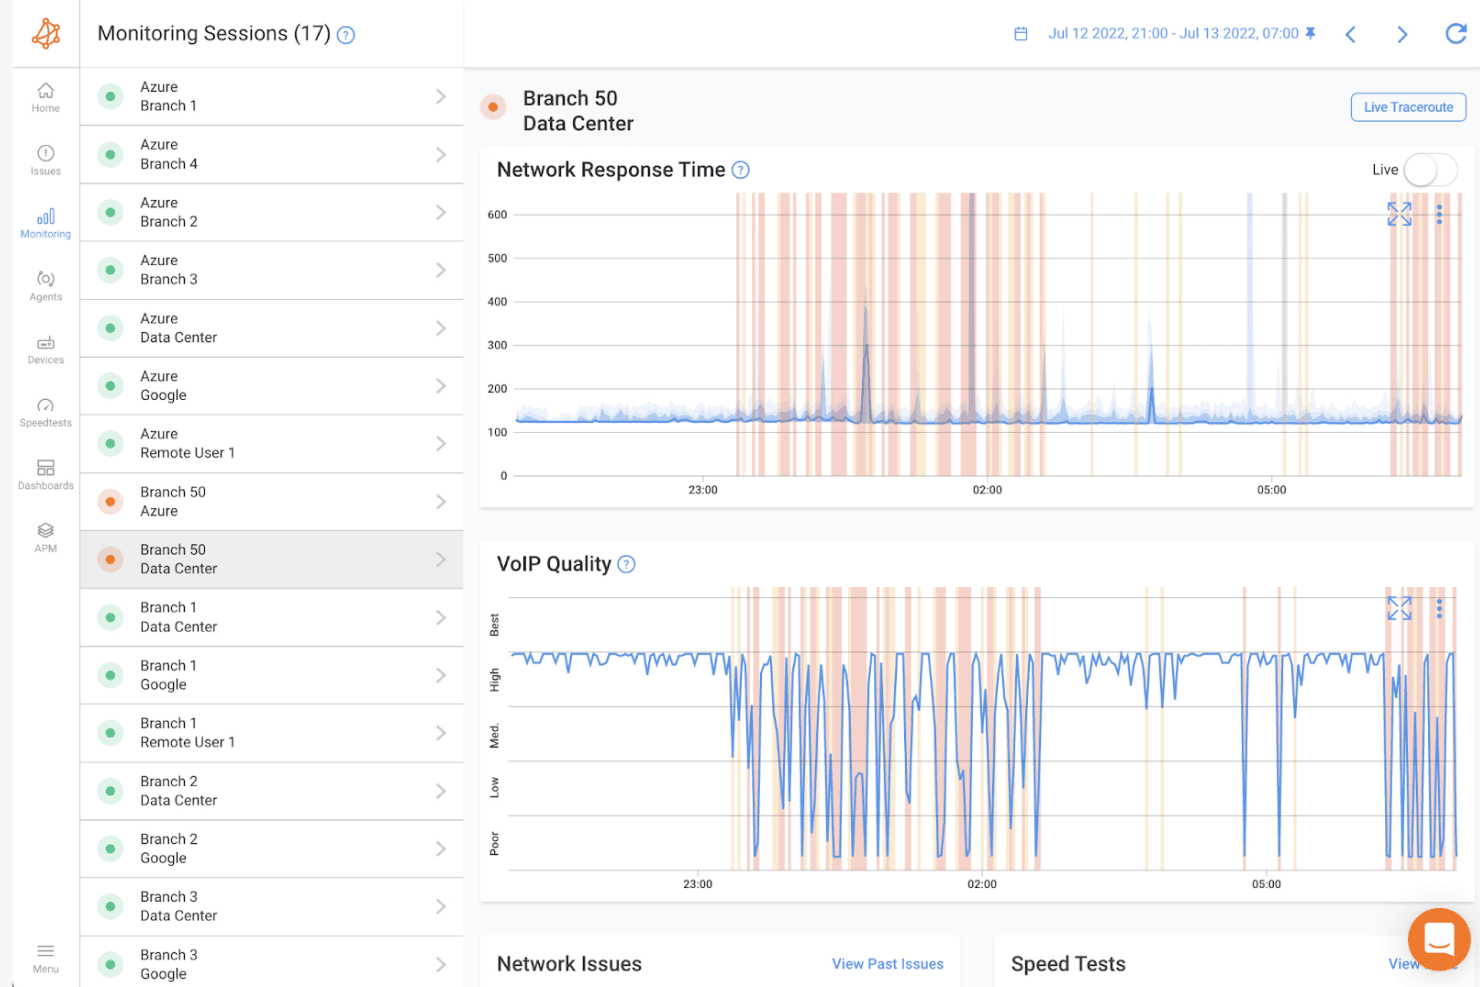
Panel de monitorización de Obkio que realiza un seguimiento del tiempo de respuesta de la red y de la calidad de VoIP en sesiones de sucursales y centros de datos. Obkio es una herramienta de monitorización del rendimiento de la red basada en la nube que utiliza tráfico sintético entre agentes distribuidos para ayudar a los administradores de red y a los MSP a detectar, diagnosticar y solucionar problemas de latencia, pérdida de paquetes y conectividad en entornos multisede.
¿Para quién es más adecuado Obkio?
Obkio es una opción adecuada para administradores de red y técnicos de MSP que necesitan monitorizar el rendimiento en entornos distribuidos y multisede mediante tráfico sintético.
Por qué elegí Obkio
Obkio ocupa un lugar en mi lista de opciones destacadas por la forma en que aborda la monitorización de redes de manera diferente a PRTG: en lugar de consultar los dispositivos desde un único punto, implementa agentes en cada sitio e intercambia continuamente tráfico UDP sintético entre ellos cada 500 milisegundos. Me gusta especialmente el diagrama de acordes, que ofrece una vista bidireccional y en tiempo real del estado de las conexiones en todas las ubicaciones. La función Obkio Insights también correlaciona automáticamente los datos de rendimiento, las métricas SNMP y los resultados de traceroute para mostrar una causa raíz probable sin necesidad de realizar búsquedas manuales.
Funciones principales de Obkio
- Monitorización de dispositivos SNMP: Monitoriza routers, switches, firewalls y puntos de acceso Wi-Fi, recopilando automáticamente el uso de la CPU, la utilización del ancho de banda, los errores de interfaz y la disponibilidad mediante SNMP v1, v2c o v3.
- Traceroutes visuales: Ejecuta traceroutes continuos y automáticos junto con las sesiones de monitorización y muestra la latencia por salto, la pérdida de paquetes y la fluctuación en mapas de rutas interactivos y codificados por colores.
- Alertas multicanal: Envía notificaciones basadas en umbrales por correo electrónico, Slack, Microsoft Teams, PagerDuty, ServiceNow o webhooks HTTP, con niveles de gravedad configurables y agrupación inteligente de eventos.
- Informes programados: Genera automáticamente informes en Excel, PDF o JSON con una periodicidad diaria, semanal o mensual, y los envía por correo electrónico a destinatarios que no necesitan una cuenta de Obkio.
Integraciones de Obkio
Obkio ofrece cuatro integraciones nativas documentadas: Microsoft Teams, PagerDuty, ServiceNow y Slack. También admite webhooks HTTP para notificaciones e informes completados, pero no se documentó una API pública general.
Pros and Cons
Pros:
- Visibilidad bidireccional en sitios distribuidos
- Las sondas sintéticas detectan breves degradaciones de la WAN
- Los usuarios valoran las visualizaciones claras del estado de la red
Cons:
- La consulta de dispositivos depende de agentes recopiladores locales
- Los usuarios desean mejores opciones para exportar informes históricos
Learn more about Obkio: 10Ideal para el mapeo automatizado de redes
Auvik
- Prueba gratuita de 14 días + demostración disponible
- Precios bajo solicitud
Visit WebsiteCustomer Rating:4.7/5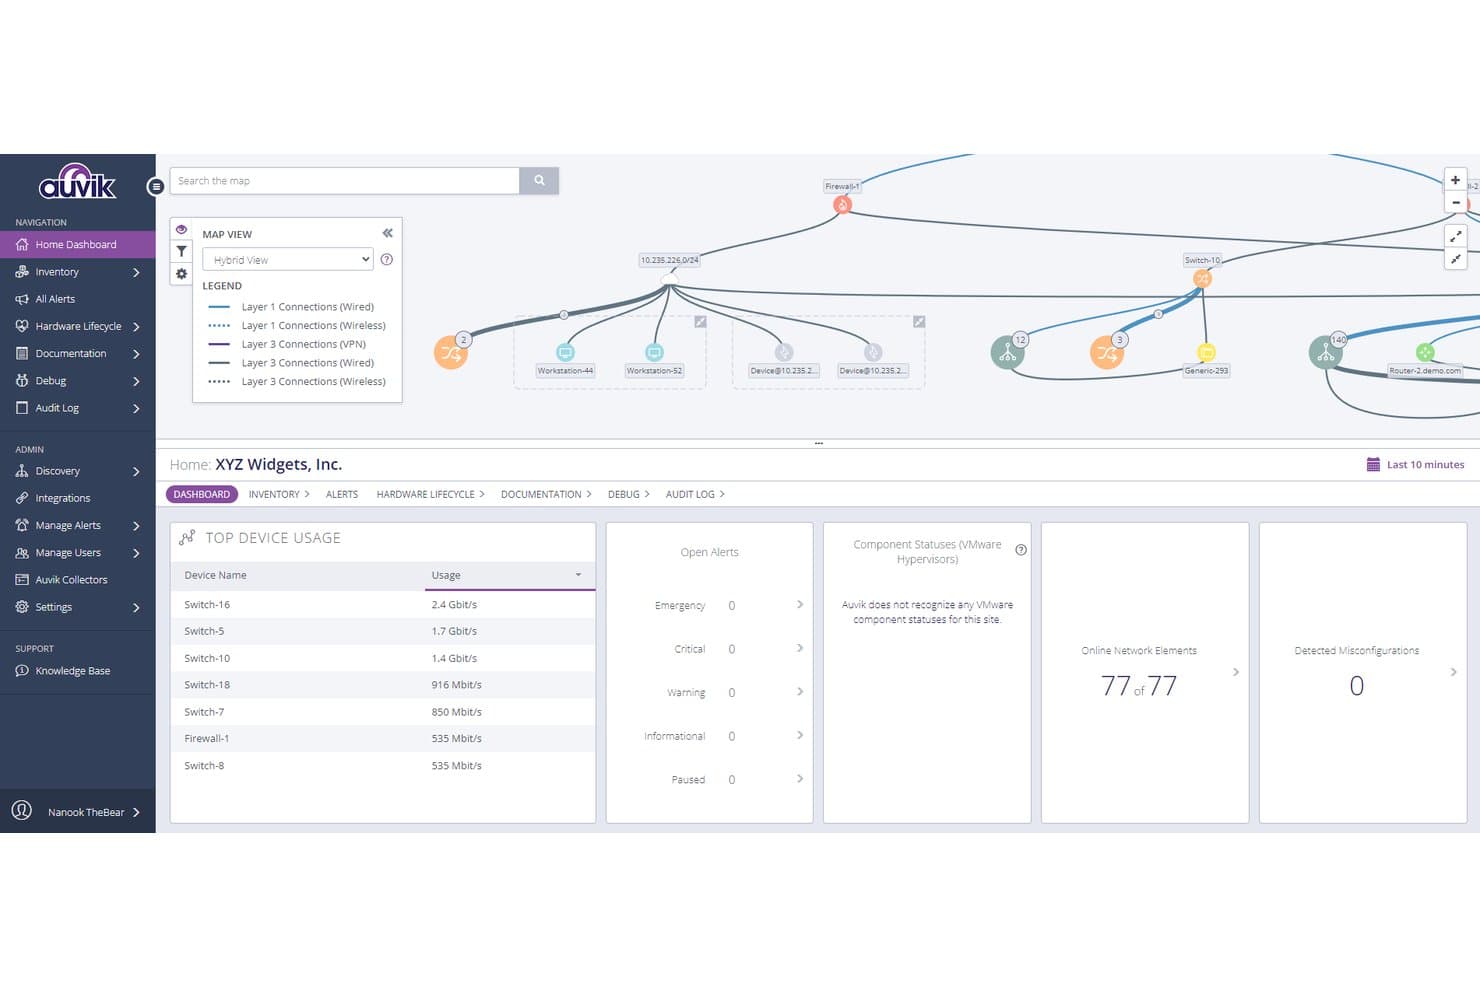
El panel de inicio de Auvik combina un mapa de red en tiempo real con resúmenes del uso de los dispositivos y las alertas. Auvik es una plataforma de gestión de redes basada en la nube, diseñada para equipos de TI y MSP que necesitan descubrimiento automatizado de dispositivos, mapeo de topología en tiempo real y visibilidad de múltiples sitios sin la carga manual de documentar y mantener registros de red.
¿Para quién es más adecuado Auvik?
Auvik es una opción natural para técnicos de MSP y administradores de redes que necesitan supervisar y documentar entornos de clientes con múltiples sitios sin dedicar horas al descubrimiento y mapeo manuales.
Por qué elegí Auvik
Elegí Auvik como una de las mejores opciones porque el mapeo automatizado de redes es el área en la que realmente supera lo que PRTG ofrece de forma predeterminada. En cuanto se implementa un recopilador, Auvik descubre todos los dispositivos conectados mediante IP y representa un mapa de topología en tiempo real en las capas 1, 2 y 3, que se actualiza continuamente a medida que cambia la red. Me gusta especialmente que conserve instantáneas históricas de la topología, así que puedo ver exactamente cómo era la red antes de que ocurriera un incidente.
Características principales de Auvik
- Análisis del tráfico en varias capas: Auvik incorpora datos de NetFlow v5/v9, J-Flow, IPFIX y sFlow para mostrar los principales generadores de tráfico, las aplicaciones que consumen más ancho de banda y los desgloses del tráfico a nivel de protocolo en toda la red.
- Copias de seguridad automatizadas de configuraciones: Auvik realiza continuamente copias de seguridad de las configuraciones de los dispositivos, registra el historial de versiones y permite comparar los cambios lado a lado con fines de auditoría y resolución de problemas.
- Biblioteca de alertas preconfiguradas: Auvik incluye más de 50 alertas listas para usar que abarcan el estado de los dispositivos, la utilización de interfaces, los errores de paquetes, la latencia, la fluctuación y los eventos de syslog, con umbrales personalizables.
- Integraciones con herramientas para MSP: Auvik se conecta de forma nativa con ConnectWise Manage, Datto Autotask e IT Glue para sincronizar el inventario de dispositivos y gestionar tickets bidireccionalmente en los entornos de los clientes.
Integraciones de Auvik
Auvik cuenta con integraciones nativas con ConnectWise Manage, Datto Autotask, ServiceNow, PagerDuty, Slack, Microsoft Teams y Opsgenie. También proporciona API y webhooks para integraciones personalizadas, incluido un webhook entrante genérico.
Pros and Cons
Pros:
- Los mapas de topología automatizados agilizan la resolución de problemas
- Las vistas centralizadas abarcan varios sitios de clientes
- El historial de configuraciones ayuda a rastrear los cambios de red
Cons:
- Algunos mapas requieren limpieza manual
- Las alertas predeterminadas pueden generar falsos positivos molestos
Learn more about Auvik:
Otras alternativas a PRTG
Estas son algunas alternativas adicionales a PRTG que no llegaron a formar parte de mi selección, pero que aún merece la pena conocer:
Related Reviews
Wie ich PRTG-Alternativen bewerte
Meine Bewertung unterteile ich in zwei Ebenen: die grundlegenden Funktionen – wie die Überwachung von SNMP-Geräten und Schwellenwert-Benachrichtigungen – die ein Tool zwingend bieten muss, um PRTG zu ersetzen, sowie die Unterscheidungsmerkmale, die die Optionen voneinander abheben.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jedes einzelne auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (übertrifft in diesem Bereich) für jede der unten aufgeführten Kernfunktionen. Anschließend berechne ich die Gesamtpunktzahl des Tools als Prozentsatz. Jedes Tool muss mindestens eine Gesamtpunktzahl von 65% erreichen, um für die Aufnahme in Betracht gezogen zu werden.
- Netzwerkgeräte-Überwachung: Ich prüfe die Unterstützung mehrerer Protokolle (SNMP, ICMP, NetFlow) und vorgefertigte Vorlagen für Router, Switches, Firewalls und Wireless Access Points namhafter Hersteller.
- Server- & Infrastruktur-Überwachung: Das jeweilige Tool sollte OS-Metriken für Windows und Linux erfassen und zusätzlich VMware, Hyper-V, Container sowie Cloud-Anbieter wie AWS und Azure unterstützen.
- Alarmierungs- & Benachrichtigungssystem: Ich bewerte die Komplexität der Schwellenwertkonfiguration und die Möglichkeiten der Mehrkanal-Benachrichtigung – einschließlich Integration in Systeme wie PagerDuty, Slack oder Teams.
- Dashboards & Visualisierung: An dieser Stelle sind Echtzeit-Dashboards mit Topologiekarten und Drilldown-Ansichten wichtig, insbesondere für NOC-Teams, die den Status von Hunderten von Geräten auf einen Blick erfassen müssen.
- Historische Berichte & Analysen: Ich beurteile die Flexibilität bei der Datenaufbewahrung, die Möglichkeit, SLA- und Verfügbarkeitsberichte zu generieren, und ob Kapazitätsprognosen für Präsentationen gegenüber Stakeholdern einfach abrufbar sind.
- Auto-Discovery & Skalierbarkeit: Das Tool sollte Assets automatisch scannen und abbilden können. Ich achte besonders darauf, wie das Lizenzmodell und die Architektur Wachstum an verteilten Standorten ermöglichen.
Sobald ich eine Liste von Tools habe, die diese Kriterien erfüllen, betrachte ich die Besonderheiten jeder Plattform.
Unterscheidungsmerkmale (Was Anbieter unterscheidet)
So vergleiche und kontrastiere ich die unterschiedlichen Anbieter:
Herausragende Funktionen
KI-gestützte Anomalie-Erkennung ist ein großes Unterscheidungsmerkmal. Tools, die Normalwerte im Netzwerkverkehr automatisch erfassen und Abweichungen melden, erkennen Probleme, die bei statischen Schwellwerten völlig untergehen – etwa einen schleichenden Speicherverlust auf einem Produktionsserver. Ebenso achte ich auf integriertes Log-Management, da das Korrelation von Syslog-Daten mit Performance-Metriken bei einem Ausfall deutlich Zeit spart, verglichen mit dem Wechsel zwischen separaten Tools. Für MSP-Teams sind Mandantenfähigkeit samt Mandantentrennung und anpassbaren White-Label-Dashboards entscheidend, um Kundenszenarien skalieren zu können.
Mehr als reine Funktionen
Die Lizenzstruktur ist besonders wichtig, wenn man von PRTG wechselt. Ich prüfe, ob sich die Kosten mit jeder hinzugefügten Komponente vorhersagbar skalieren lassen – denn Modelle mit Abrechnung pro Sensor werden in einer Umgebung mit 1.000 Knoten schnell teuer. Ein weiterer Faktor ist die Flexibilität der Bereitstellung, denn manche Teams benötigen On-Premise-Installationen für isolierte Netzwerke, während andere SaaS bevorzugen. Außerdem schaue ich auf das Integrations-Ökosystem, insbesondere auf native Anbindungen an ITSM-Tools wie ServiceNow oder Jira, da Monitoring-Daten am meisten Nutzen bringen, wenn sie direkt in Incident-Response-Workflows eingespeist werden.
¿Por qué buscar una alternativa a PRTG?
Aunque PRTG es una buena opción entre las herramientas de supervisión, hay varias razones por las que algunos usuarios buscan soluciones alternativas. Es posible que estés buscando una alternativa a PRTG porque…
- Necesitas una mejor escalabilidad para redes en crecimiento
- Buscas más opciones de personalización
- Tu equipo necesita una integración más sencilla con los servicios en la nube
- Necesitas funciones de análisis más avanzadas
- Buscas una interfaz de usuario más intuitiva
Si alguna de estas situaciones te resulta familiar, has llegado al lugar adecuado. Mi lista incluye varias opciones de herramientas de supervisión más adecuadas para los equipos que se enfrentan a estos desafíos con PRTG y buscan soluciones alternativas rentables.
Características principales de PRTG
Estas son algunas de las características principales de PRTG que te ayudarán a contrastar y comparar lo que ofrecen las soluciones alternativas:
- Monitorización de redes y servidores: Proporciona monitorización en tiempo real de routers, switches, firewalls y mucho más, garantizando que tu red funcione correctamente.
- Monitorización del ancho de banda: Realiza un seguimiento del uso del ancho de banda para ayudarte a comprender los patrones de tráfico de la red y evitar cuellos de botella.
- Paneles personalizables: Ofrece mapas y paneles en tiempo real que puedes adaptar para mostrar las métricas más importantes para tu equipo.
- Alertas y notificaciones: Envía alertas personalizables por correo electrónico, SMS o notificaciones push para mantenerte informado de cualquier problema.
- Monitorización distribuida: Permite la monitorización centralizada de varias ubicaciones remotas y centros de datos, proporcionando una visión completa de toda tu red.
- Informes personalizados: Te permite crear informes adaptados para comunicar eficazmente el estado de tu infraestructura de TI.
- Monitorización mediante SNMP: Admite SNMP para monitorizar diversos dispositivos de red, garantizando la compatibilidad con una amplia variedad de hardware.
- Monitorización de Wi-Fi: Monitoriza las redes Wi-Fi para garantizar una conectividad y un rendimiento fiables en toda tu infraestructura inalámbrica.