Wo Coding-Agenten helfen und wo sie scheitern
Pedro Alves
Technischer Leiter bei Thoth AI
Pedro Alves erklärt, wo KI-Coding-Agenten die Entwicklung beschleunigen, wo sie verborgene Risiken einführen und warum erfahrene Entwickler unverzichtbar bleiben.
Key Takeaways
Coding-Agenten: Coding-Agenten können die Umsetzung beschleunigen, aber menschliches Urteilsvermögen muss Architektur, Qualität und Entscheidungen für den Produktionseinsatz leiten.
Verborgene Fehler: Von KI erzeugter Code läuft oft erfolgreich, während er logische Fehler verbirgt, die nur erfahrene Prüfer erkennen können.
Kreative Lücken: Modelle bewältigen klar definierte Übersetzungsaufgaben gut, aber Menschen müssen unkonventionelle Erkenntnisse, Verbindungen und grundlegende Entscheidungen beisteuern.
Hebelwirkung des Teams: Organisationen profitieren stärker davon, erfahrene Fachkräfte mit KI zu unterstützen, als zu versuchen, unerfahrene Teams aufzuwerten.
Zentrale Steuerung: Ein kleines, auf KI fokussiertes Team kann wiederverwendbare Arbeitsabläufe schaffen, doppelte Experimente reduzieren und die Einführung in verschiedenen Abteilungen verbessern.
Pedro Alves arbeitet seit 25 Jahren intensiv mit KI. Derzeit ist er CTO bei Thoth AI und der Schöpfer von Last Week in AI.
Wir haben uns mit Pedro zusammengesetzt, um über Programmieragenten zu sprechen – und darüber, warum es so wichtig ist zu wissen, was sie können und was nicht. Das hat er uns erzählt.
Bevor „KI“ etwas war, das man auf Folien präsentierte
Ich bin Pedro, CTO von Thoth AI. Ich habe bereits mit KI gearbeitet, bevor sie etwas war, das man auf Folien präsentierte – damals im Jahr 2001, als ich als Informatikstudent eine kleine simulierte Welt voller Agenten entwickelte und sie lernen ließ, sich gegenseitig zu übertrumpfen – eine Art digitales Spiel des Lebens, bei dem es vor allem darum ging, ihnen beim Besserwerden zuzusehen. Das ist 25 Jahre her, und ich beschäftige mich immer noch mit derselben Frage: Wie bringt man ein System dazu, sich zu verbessern?
Als die Zeit für ein Graduiertenstudium kam, gingen alle davon aus, dass ich in maschinellem Lernen promovieren würde. Das tat ich nicht. Es fühlte sich zu eng und zu theoretisch an. Ich wollte das Handwerk anhand der reichhaltigsten und chaotischsten Daten erlernen, die ich finden konnte, also wandte ich mich der Computerbiologie zu: Proteomik für meinen Master, Genomik für meine Promotion. Maschinelles Lernen, Statistik und Datenwissenschaft eignete ich mir an, indem ich sie auf Probleme anwendete, bei denen Fehler Konsequenzen hatten – auf Gen-Gen-Interaktionsnetzwerke, Merkmalsentwicklung, neuronale Netze und Ensemblemethoden.
Dort lernte ich die Lektion, die seither alles geprägt hat. In der Medizin entwickelte ich Modelle zur Krankheitsprogression, und die standardmäßige Bewertungskennzahl – die Gesamtgenauigkeit – war nutzlos. Ein nach diesem Maßstab „gutes“ Modell bestätigte lediglich die Fälle erneut, die Ärzte bereits kannten, obwohl der gesamte Wert in den Fällen lag, die es übersehen würde. Anstatt also die Genauigkeit zu optimieren, optimierte ich die partielle AUC – im Wesentlichen die Fähigkeit des Modells bei den Fällen, auf die es ankam. Die Kennzahl, die man dir vorgibt, ist fast nie das eigentliche Ziel.
Von dort aus lernte ich verschiedene Branchen kennen: diese medizinischen Modelle, eine Zeit als Berater für einen Profifußballverein, anschließend das Silicon Valley und viele Jahre im Bereich Computer Vision – damals, als man noch Innovationen darin entwickeln musste, wie man ein Netzwerk trainierte und sogar seine Gewichte initialisierte, damit Erkennung und Klassifizierung überhaupt funktionierten. Ich arbeitete mit Daten aus sozialen Netzwerken, dem Einzelhandel, der Modebranche und dem Videobereich. Ein Jahr lang entwickelte ich Handelsalgorithmen mit genetischen Algorithmen und Partikelschwarmoptimierung – nichtparametrischen Optimierungsmethoden, über die ich im Graduiertenstudium wissenschaftliche Arbeiten geschrieben hatte. Schließlich gründete ich mein eigenes Unternehmen und entwickelte KI-Tools für Menschen, die keine Datenwissenschaftler waren.
Die Breite verbindet all das. Nach einem Dutzend Fachgebieten sehe ich immer wieder dasselbe Problem in unterschiedlichen Verkleidungen – ein in der Genomik offensichtlicher Kniff erweist sich als der entscheidende Durchbruch in der Computer Vision. Mir ist wichtiger, wie ein Problem formuliert wird, als wie es gelöst wird, denn in der Formulierung verbirgt sich der größte Hebel.
Das führt mich zu Thoth. Auf dem Papier sind wir ein Unternehmen für Datenannotation. Aber ich glaube, dass die gesamte Branche das falsche Problem löst. Niemand will annotierte Daten – Daten sind nur der Zwischenschritt. Die Menschen wollen ein besseres Modell. Deshalb arbeite ich auf eine Zukunft hin, in der ein System herausfindet, welche Daten dein Modell zur Verbesserung benötigt, und diesen Teil für dich übernimmt, damit du dich auf das Modell statt auf die Kennzeichnung konzentrieren kannst.
More Articles
Zwei Seiten des Unternehmens
Strukturell hat Thoth AI zwei Seiten. Die eine ist die Datenverarbeitungsplattform, die international und in großem Maßstab betrieben wird. Sie ist größer als ein typisches Start-up, aber immer noch deutlich kleiner als die Branchengiganten, daher würde ich sie als mittelgroß bezeichnen. Die andere Seite – der Teil, den ich aufbaue – ist ein völlig neues Forschungs- und Innovationsteam hier in der Bay Area: derzeit sind wir fünf Personen, in den nächsten Monaten kommen weitere hinzu. Dort verfolgen wir den restlichen Teil der Modellverbesserung: alles, was über die Kennzeichnung hinausgeht.
Unsere Forschung konzentriert sich auf zwei Hauptbereiche. Der erste ist Robotik: verkörperte Daten zu generieren, sie zu bewerten und aktives Lernen zu nutzen, um automatisch die bestmöglichen Trainingsdaten zu erzeugen, damit Roboter ihre Aufgaben mit möglichst wenigen Daten erlernen können. Der größte Teil davon nutzt egozentrische Daten (im Wesentlichen Aufnahmen aus der Ich-Perspektive), und wir konzentrieren einen großen Teil unserer Arbeit darauf, die hochwertigsten egozentrischen Daten zu erzeugen. Der zweite Bereich ist die Zuverlässigkeit und Effizienz von Sprachmodellen: Wir versuchen zu verstehen, was Halluzinationen verursacht und wie sie aussehen. Auf der Effizienzseite erkennen wir, wann ein kleineres Modell eine Anfrage bearbeiten kann, und formulieren sie dann neu oder teilen sie in Einzelteile auf, damit ein einfacheres, kostengünstigeres Modell sie beantworten kann. All das ist heute noch Forschung und zielt auf Produkte ab, die wir aus diesem Team heraus auf den Markt bringen werden.
Was Entwicklungsphase und Größe betrifft: Die Datenseite ist ein etabliertes, mittelgroßes internationales Unternehmen, während das US-Forschungsteam bewusst noch am Anfang steht. Derzeit sind wir fünf Personen in unserem Büro in San Mateo, und in den nächsten Monaten kommen ein oder zwei weitere Einstellungen hinzu. Das ist unser aktueller Stand.
Wie umfangreiche Tests zuverlässige Ergebnisse schaffen
Pedro teilt
Die Vorbereitung läuft inzwischen größtenteils von selbst. Aber das ist nicht der eigentliche Gewinn. Die größere Verbesserung liegt in der Qualität: Das Meeting ist präziser und fokussierter, und die richtigen Themen erreichen zuverlässig den CEO.
Viele versuchen, jede Aufgabe und Funktion mit KI zu automatisieren, aber ich bin vorsichtig. Mit KI ist es trivial, eine Demo zu erstellen. Etwas Zuverlässiges für den täglichen Einsatz zu entwickeln, ist etwas anderes. Wenn man diese Tools wirklich verwendet, stößt man auf Sonder- und Grenzfälle, in denen die Automatisierung fast funktioniert, aber eben nicht ganz. Deshalb teste ich gründlich, bevor ich irgendetwas in einem echten Arbeitsablauf einsetze.
In diesem Jahr habe ich KI-Tools für unser wöchentliches CEO-Review-Meeting entwickelt, die diese Hürde genommen haben. Sie versenden E-Mails an die Verantwortlichen der einzelnen Bereiche, um Aktualisierungen einzuholen, fassen die Antworten automatisch zusammen, erstellen Entwürfe für Berichte, Zusammenfassungen und die Agenda und verfolgen die Ergebnisse im Zeitverlauf.
Früher war all das manuell. Jemand musste den Leuten wegen Aktualisierungen hinterherlaufen, Antworten manuell zusammenführen, Zusammenfassungen und die Agenda verfassen und die Ergebnisse von Woche zu Woche nachverfolgen. Es funktionierte, war aber langsam, und die Agenda richtete sich leicht nach dem, was gerade am aktuellsten war, statt nach dem, was am wichtigsten war.
Die Vorbereitung läuft inzwischen größtenteils von selbst. Aber das ist nicht der eigentliche Gewinn. Die größere Verbesserung liegt in der Qualität: Das Meeting ist präziser und fokussierter, und die richtigen Themen erreichen zuverlässig den CEO. Es geht also weniger um die eingesparte Zeit als darum, die Aufmerksamkeit des CEOs auf die wirklich wichtigen Entscheidungen zu lenken.
Warum Urteilsvermögen menschlich bleibt, während KI das Programmieren beschleunigt
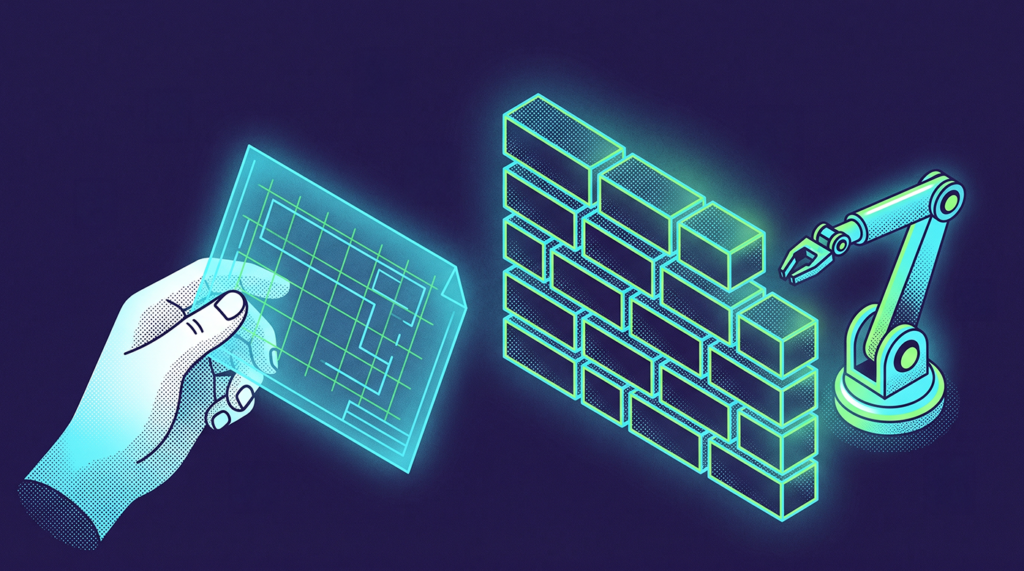
KI treibt inzwischen das Programmieren selbst voran, und zwar fast überall. Meine Forschenden, die Ingenieure, die unsere Arbeit für den produktiven Einsatz umsetzen, und ich verwenden alle KI-Programmierwerkzeuge. Menschliches Urteilsvermögen, nicht eine bestimmte Aufgabenkategorie, bestimmt, wie Code entwickelt wird, und dieser Maßstab verschiebt sich je nach Tragweite.
Auf der Forschungsseite besteht das Ziel normalerweise darin, etwas zum Laufen zu bringen, oft indem ein GitHub-Repository eingerichtet wird, um die Machbarkeit einer Idee zu testen. Nichts davon geht in den produktiven Einsatz, daher bin ich bei der Ausarbeitung nachsichtig. Wenn es funktioniert und die Frage beantwortet, reicht das aus.
Im produktiven Einsatz ist das anders. Wie wir etwas entwickeln, ist genauso wichtig wie die Frage, ob es läuft, deshalb setzen wir KI sorgfältiger ein. Erfahrene Ingenieure tragen die Verantwortung für Architektur, Qualität und Prüfungen. KI beschleunigt sie, trifft diese Entscheidungen aber nicht. Diese Grenze bleibt menschlich.
Die Erfahrung des Teams hilft dabei. Die Mitglieder nutzen KI anders als weniger erfahrene Personen. Sie wissen bereits, wie gute Arbeit aussieht, sodass das Modell ihr vorhandenes Urteilsvermögen verstärkt, statt das Urteilsvermögen zu ersetzen, das sie noch entwickeln. Es macht sie schneller, ohne den wesentlichen Teil zu ersetzen.
Wie man Programmieragenten effektiv einsetzt
Fast jedes Projekt hat eine einzigartige Anforderung: eine nicht offensichtliche Erkenntnis oder Entscheidung, die das Problem verlangt … Der Teil, der ein Projekt zum Funktionieren bringt, ist normalerweise nicht durchschnittlich, und die KI kann ihn nicht von sich aus erreichen. Dieses Element muss ich finden. Danach entwickelt die KI alles, was darauf aufbaut, schneller und besser, als ich es allein könnte.
Insgesamt ergibt sich die Effektivität von Programmieragenten daraus, dass ich mich bei der Technologie diszipliniert mit ihren Stärken und Schwächen auseinandersetze.
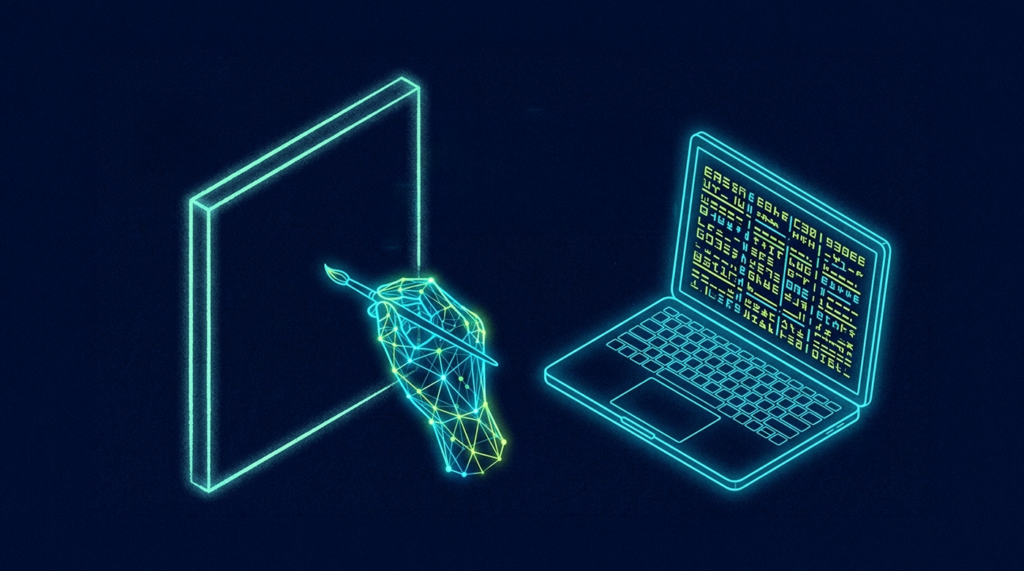
Ich stelle es mir wie das Malen auf einer Leinwand vor. Das Ziel ist immer dasselbe: das Bild in meinem Kopf zu klären und dann KI zu nutzen, um diese Absicht so schnell wie möglich in funktionierenden Code zu übersetzen. Der Erfolg hängt von einer Variable ab: wie viel kreative Arbeit ich selbst behalte und wie viel ich abgebe.
In der ersten Stufe glänzt KI. Ich sehe das gesamte Gemälde und setze breite Pinselstriche, während die KI die Details ergänzt. Ich weiß genau, was entwickelt werden muss, und die Übersetzung der Absicht in Code ist im Wesentlichen formelhaft. Hier ist KI ein echter Multiplikator, und der größte Teil meiner täglichen Arbeit fällt in diese Kategorie.
Die zweite Stufe ist nützlich, weist aber größere Schwankungen auf. Sie ist ähnlich, doch ich lasse absichtlich einige Bereiche der Leinwand frei und sage dem Modell, es soll dort etwas malen. Das erfordert ein gewisses Maß an Kreativität, aber meine Vorgaben setzen weiterhin den Rahmen. Ich behandle dieses Ergebnis als Entwurf, nicht als Antwort.
Bei der dritten Stufe rate ich zur Vorsicht. Dabei überlässt man der KI den kreativen Kern: die Projektdefinition oder wichtige Designentscheidungen. Für jemanden, der nicht tief in diesem Fachgebiet steckt, wirkt das beeindruckend, aber es funktioniert weitaus häufiger nicht, als dass es gelingt, weil das Modell eine Lücke füllt, die ich hätte füllen sollen.
Diese Lücke ist der springende Punkt. Fast jedes Projekt hat eine einzigartige Anforderung: eine nicht offensichtliche Erkenntnis oder Entscheidung, die das Problem verlangt. Standardmäßig liefert das Modell die durchschnittliche Lösung, das häufigste Muster aus seinen Trainingsdaten. Der Teil, der ein Projekt zum Funktionieren bringt, ist normalerweise nicht durchschnittlich, und die KI kann nicht selbstständig darauf kommen. Diesen Teil muss ich finden. Danach baut die KI alles, was darauf folgt, schneller und besser auf, als ich es allein könnte.
Wie Programmieragenten schwer auffindbare Fehler verursachen
Pedro teilt
Das klarste gute Ergebnis von Coding-Agenten ist die Geschwindigkeit. Das Programmieren geht schneller, wodurch unsere Bereitstellungshäufigkeit steigt, und es geht nicht nur um reine Geschwindigkeit. Dinge, deren Einrichtung kompliziert war, sind jetzt viel einfacher. Dieser Teil ist real und wichtig.
Das klarste gute Ergebnis von Coding-Agenten ist die Geschwindigkeit. Das Programmieren geht schneller, wodurch unsere Bereitstellungshäufigkeit steigt, und es geht nicht nur um reine Geschwindigkeit. Dinge, deren Einrichtung kompliziert war, sind jetzt viel einfacher. Dieser Teil ist real und wichtig.
Ein interessanteres Ergebnis ist, wie sich unsere Fehler verändert haben. Die Fehlerquote ist nicht gestiegen, aber die Arten von Fehlern haben sich verändert. KI stellt sicher, dass der Code ausgeführt wird. Das prüft sie fast immer, bevor sie ihn an dich zurückgibt. Daher treten die einfachsten Fehler – solche, die lediglich einen Fehler auslösen oder verhindern, dass der Code ausgeführt wird – viel seltener auf. Was bleibt, sind logische Fehler und Fälle, die das Modell nicht vollständig durchdacht hat. Sie sind gerade deshalb schwerer zu erkennen, weil der Code problemlos läuft.
Hier liegt der Nachteil. Diese Fehler sind besser verborgen. Wenn jemand Erfahrung fehlt oder sich zu stark auf das Werkzeug verlässt, sieht er den laufenden Code und nimmt an, er sei korrekt, obwohl er es nicht ist. Die Gefahr besteht nicht in mehr Fehlern, sondern in falscher Zuversicht. Man braucht jemanden, der weiß, worauf er achten muss, um Dinge zu erkennen, die den Test „es läuft“ bestehen, aber trotzdem falsch sind.
Warum KI genutzt werden sollte, um erfahrene Mitarbeiter zu vervielfachen, statt schwache Mitarbeiter zu verbessern
Am meisten überraschte mich, wo der Hebel ansetzt. Intuitiv könnte man denken, dass KI die Erfahrungsschwelle senkt, sodass man günstigere, weniger erfahrene Teams einsetzen und die Werkzeuge sie auf ein höheres Niveau bringen lassen kann. Das Gegenteil hat sich bewahrheitet. Erfahrung ist jetzt wichtiger, nicht weniger wichtig.
Es läuft auf Zuverlässigkeit hinaus. Einen erfahrenen Entwickler mithilfe von KI in fünf erfahrene Entwickler zu verwandeln, ist weitaus zuverlässiger, als einen Junior-Entwickler in einen erfahrenen Entwickler zu verwandeln. KI vervielfacht das Urteilsvermögen, das bereits vorhanden ist; sie erzeugt kein Urteilsvermögen, das fehlt.
Deshalb skaliere ich meine stärksten Mitarbeiter nach außen; ich versuche nicht, meine schwächsten Mitarbeiter nach oben zu skalieren. Einige erfahrene Mitarbeiter, die jeweils ein Mehrfaches ihrer früheren Leistung erbringen, schlagen jedes Mal ein größeres gemischtes Team.
Warum Menschen die Kreativität einbringen müssen – nicht die KI
KI hat die kreativen und verbindenden Aspekte der Forschung eindeutig nicht erfüllt. Wenn ich technische Arbeit mit Unterstützung von KI erledige, muss ein Mensch weiterhin die Zusammenhänge herstellen: herauszufinden, wie sich die Arbeit eines anderen erweitern lässt, zwei Veröffentlichungen sinnvoll miteinander zu verknüpfen und die logischen Schlussfolgerungen zu ziehen, die man normalerweise als selbstverständlich ansehen würde. Dieser Teil erfordert weiterhin einen Menschen.
Das ist nicht überraschend, wenn man sich daran erinnert, was diese Modelle sind. Sie sind Wahrscheinlichkeitsmaschinen. Sie geben den Text aus, der den Leser am wahrscheinlichsten zufriedenstellt. Wir werden besser darin, sie auf andere Arten von Aufgaben zu trainieren, aber es wird wirklich schwierig, wenn man versucht, ihnen Kreativität selbst beizubringen, weil es schwer ist, das entsprechende Trainingssignal zu erzeugen.
Betrachten wir Datensätze. Ein Datensatz dazu, wie ein Hund aussieht, ist einfach. Man sammelt viele Bilder von Hunden. Ein Datensatz für Kreativität beim Zeichnen von Hunden stellt ein anderes Problem dar. Nehmen wir zum Beispiel jemanden, der einem Hund Flügel hinzufügt. Der Kern dieses Beispiels sind nicht die Flügel. Es geht um die abstrakte Handlung dahinter: etwas, das nicht dazugehört, an einer Stelle einzufügen, an der man es nicht erwartet. Damit ein Modell das versteht, braucht man eine riesige Zahl an Beispielen, damit es lernt, dass die Flügel keine Rolle spielen, sondern die kreative Geste.
Selbst wenn es so weit kommt, stößt man auf die nächste Hürde. Nimm dieselbe Kreativität und wende sie auf eine mathematische Gleichung oder einen Codeabschnitt aus einer Veröffentlichung an, um damit den Algorithmus eines anderen zu erweitern. Bei dieser Art der Übertragung bricht es zusammen.
Menschen verlassen sich gerade auf Maschinen bei dem Teil, in dem diese am schwächsten sind. Die Ironie besteht darin, dass die Lösung kostengünstig ist. Ein wenig menschliche Kreativität bewirkt sehr viel. Verlass dich bei diesem Teil nicht zu stark auf die Maschine, und du kommst bemerkenswert weit.
Warum CTOs neu gestalten müssen, wie sich KI-Fähigkeiten durch Unternehmen bewegen
Das wird momentan nicht der beliebteste Ratschlag sein, aber ich halte ihn für den vernünftigsten und am wahrscheinlichsten erfolgversprechenden: Gehen Sie bedachter vor, als es der Moment von Ihnen verlangt.
Momentan geben Unternehmen enorme Summen für eine einfache Annahme aus: Jeder kann einen Teil seiner Arbeit mit KI automatisieren. Also ergeht die Anweisung an alle. Ingenieure, Datenexperten, Vertrieb, Marketing, das gesamte Unternehmen. Erstellen Sie ein Konto, automatisieren Sie etwas, entwickeln Sie Ihre eigenen Tools, los geht's. Das Ergebnis ist eine enorme Menge an verschwendetem Aufwand: doppelte Arbeit, Projekte, die nirgendwohin führen, und Tools, die niemand nutzt. Unternehmen verbrennen viel Geld für Aufwand, Zeit und Tokens, die nichts Dauerhaftes hervorbringen.
Schaffen Sie einen echten Prozess dafür. Zentralisieren Sie ihn. Richten Sie ein kleines zentrales Team ein, dessen Aufgabe es ist, jedes andere Team mit KI besser zu machen. Es entwickelt Workflows, wiederverwendbaren Kontext, Standards und effektive Muster und gibt sie anschließend weiter, damit nicht jeder einzelne Ingenieur die Kosten der Entdeckung tragen muss. Das ist die strukturelle Version dessen, was ich zuvor über die Konzentration von Hebelwirkung auf Ihre stärksten Mitarbeiter gesagt habe: Einige wenige KI-erfahrene Ingenieure bringen die gesamte Organisation voran.
Das führt gleichzeitig zu zwei Ergebnissen. Die Auslastung steigt, weil Teams bewährte Muster verwenden, anstatt zu raten. Und Sie holen einen großen Teil der Zeit zurück, die still durch Experimente verloren geht, die nie mehr als einmal hätten durchgeführt werden müssen.
Das wird momentan nicht der beliebteste Ratschlag sein, aber ich halte ihn für den vernünftigsten und am wahrscheinlichsten erfolgversprechenden: Gehen Sie bedachter vor, als es der Moment von Ihnen verlangt…Schaffen Sie einen echten Prozess dafür. Zentralisieren Sie ihn. Richten Sie ein kleines zentrales Team ein, dessen Aufgabe es ist, jedes andere Team mit KI besser zu machen.
Auf dem Laufenden bleiben
Sie können die Arbeit von Pedro Alves auf LinkedIn verfolgen oder seinen Newsletter Letzte Woche in der KI abonnieren. Sehen Sie sich auch Thoth AI an.
Weitere Experteninterviews folgen im The CTO Club!