


Virksomheder er afhængige af problemfri integration af oplysninger fra forskellige kilder. Det er her, ETL (Extract, Transform, Load) kommer ind i billedet, da det er afgørende for opbygningen af et samlet datafundament. ETL-processen er dog ikke uden udfordringer.
Denne artikel gennemgår fem almindelige ETL-udfordringer, som du kan støde på, og undersøger de bedste ETL-værktøjer, der kan hjælpe dig med at overvinde dem, så du sikrer en problemfri og effektiv dataintegrationsproces.
5 almindelige ETL-udfordringer
Selvom ETL-processer er afgørende for flytning og integration af data fra flere kilder, indebærer de adskillige udfordringer, som en udvikler skal håndtere.
Data af dårlig kvalitet
En af de største udfordringer i ETL-processer er dataintegritet. Inkonsekvente data kan føre til forkerte resultater, der underminerer nøjagtigheden og pålideligheden af dataanalysen. ETL-processen kræver, at data fra forskellige kilder er kompatible og ensartede, for at informationsintegrationen kan lykkes, men variationer i disse kilder med hensyn til format, struktur og værdier kan forsinke eller endda afspore processen. Data kan indeholde manglende værdier, duplikerede oplysninger eller endda modstridende detaljer. Det kræver betydelig tid og indsats at løse disse problemer ved at rense og standardisere dataene til ét samlet format.
Have an account? Log In
Flaskehalse
Flaskehalse i databehandlingen er en anden almindelig ETL-udfordring. Efterhånden som datamængderne vokser, bliver det vanskeligt for systemerne at behandle dem rettidigt. Det kan føre til langsomme dataopdateringer og gøre data forældede, før de overhovedet bliver brugt.
Ydeevneproblemer
Håndtering af enorme datamængder fra forskellige kilder kan være en krævende opgave og udgør en væsentlig barriere i ETL-processer. Det er afgørende at optimere disse procedurer for at sikre effektiv udtrækning, transformation og indlæsning.
Desuden sker der en eksponentiel vækst i realtidsdata, efterhånden som virksomheder bliver mere datadrevne. ETL-processer skal derfor kunne håndtere disse arbejdsbelastninger med store datamængder og rettidig opdatering af data uden at medføre væsentlige ydeevneomkostninger.
Kompleksiteten af ETL-kode
ETL-kode er ofte manuelt skrevet, hvilket gør vedligeholdelse og opgraderinger vanskelige. Selv mindre ændringer i kilde- eller destinationsdatastrukturen kan kræve en fuldstændig gennemskrivning af denne kode. Fejlfinding i denne komplekse kode er en krævende opgave, der kan optage mange udviklingsressourcer.
Databeskyttelse og sikkerhed
Dette er en væsentlig bekymring under ETL-operationer. Når data udtrækkes fra forskellige kilder og flyttes på tværs af systemer, findes der flere sårbarhedspunkter, hvor databrud kan forekomme. Det bliver yderligere kompliceret, efterhånden som regler for databeskyttelse (GDPR og HIPAA) og krav til overholdelse, der regulerer datahåndtering, bliver stadig strengere.
På trods af disse udfordringer er ETL fortsat en integreret del af mange forretningsaktiviteter. Med de rette strategier og effektive værktøjer kan disse hindringer håndteres effektivt, og ETL-processernes fulde potentiale kan realiseres.
Bedste praksisser til at overvinde ETL-udfordringer
Det kræver strategiske løsninger og overholdelse af bedste praksisser at overvinde ETL-udfordringer.
- Infrastrukturen bør være skalerbar og fleksibel for at håndtere svingende datamængder. Cloudbaserede løsninger kan hjælpe med at administrere lagerplads og infrastrukturproblemer effektivt og omkostningseffektivt.
- En veldefineret datapolitik kan forenkle processen med datakortlægning og -verificering. Det er vigtigt at udføre trinvise indlæsninger i stedet for masseindlæsninger for at reducere indlæsningstiden og mindske risikoen for datatab. Der bør udføres regelmæssige revisioner for at opretholde datakvaliteten og -integriteten. Implementering af solide cybersikkerhedsforanstaltninger er afgørende for at beskytte følsomme data under hele ETL-processen og sikre, at der ikke sker brud eller lækager.
- Brug ETL-værktøjer af høj kvalitet, der ikke blot understøtter forskellige datatyper, men også reducerer behovet for kodning. Disse værktøjer kan håndtere hele ETL-processen på en struktureret måde og dermed minimere fejl.
ETL-testværktøjer
ETL-testværktøjer validerer, verificerer og kvalificerer data, samtidig med at de forhindrer duplikering og datatab. Disse værktøjer spiller en afgørende rolle i forbedringen af ETL-processens effektivitet, hastighed og virkning. De er udviklet til at sikre, at dataoverførslen fra flere kilder til et datalager er nøjagtig og følger ensartede mønstre.
Brug af ETL-testværktøjer kan reducere den manuelle indsats, der kræves til datatest, betydeligt og dermed i sidste ende mindske risikoen for menneskeskabte fejl.
| Informatica Data Validation | QuerySurge | TestBench |
|---|---|---|
| Informatica Data ValidationDette værktøj tilbyder omfattende ETL-test og test af dataintegration. Det identificerer og håndterer ubesværet dataafvigelser og uregelmæssigheder, hvilket forbedrer dataintegriteten. Informatica Data Validation er kendt for sin brugervenlige grafiske grænseflade, som hjælper med at oprette, administrere og udføre ETL-testcases og kræver minimal viden om kodning. | QuerySurgeQuerySurge er markedsførende inden for fuldcyklustest af big data, ETL og datavarehuse. QuerySurge sikrer, at de udtrukne data fra kildefiler forbliver intakte på destinationen ved at analysere og identificere eventuelle afvigelser i de enorme datamængder. Det tilbyder ende-til-ende-test, så data kan valideres fra kilde til mål. Løsningen tilbyder realtidsanalyse, som hjælper med hurtig beslutningstagning baseret på nøjagtige resultater. QuerySurge er især kendt for sin evne til at automatisere ETL-testprocessen, hvilket sparer betydelig tid og eliminerer menneskelige fejl. | TestBenchTag højde for størrelsen og kompleksiteten af de data, der skal håndteres. Værktøjer som TestBench håndterer kompleksitet og tilbyder integrerede testprocesser, hvilket gør dem ideelle til komplekse dataarkitekturer eller projekter. Derudover kan de generere syntetiske testdata, som ikke overtræder databeskyttelsesreglerne – en yderst nyttig funktion, når der arbejdes med følsomme oplysninger. |
Trods de avancerede funktioner i moderne automatiseringsværktøjer til ETL-test er der stadig udfordringer. Forskellige kundebehov kræver forskellige testværktøjer. Skalerbarhed kan blive et problem, hvis datamængden vokser eksponentielt. Derfor er det afgørende at tage højde for selve værktøjets skalerbarhed.
More Articles
ETL-problemscenarie
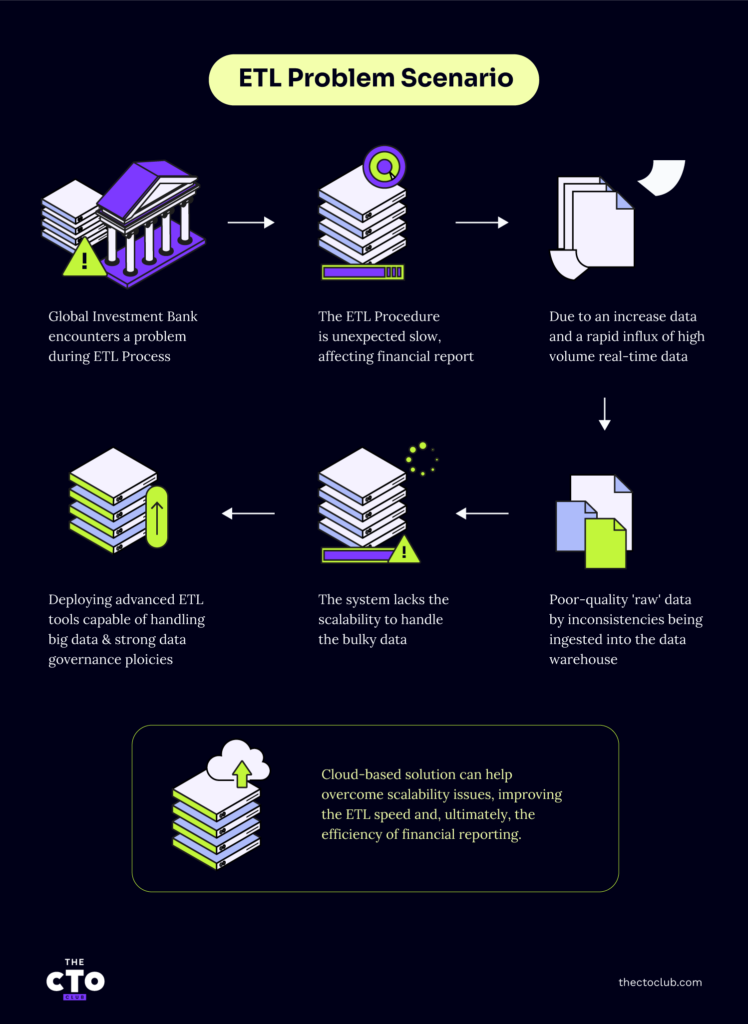
Forestil dig, at en global investeringsbank støder på et betydeligt problem under sin ETL-proces. Finansinstitutionen håndterer enorme mængder daglige transaktionsdata, og ETL-proceduren er uventet langsom, hvilket i sidste ende påvirker effektiviteten af dens finansielle rapporter. Det skyldes en stigning i ustrukturerede data og en hurtig tilstrømning af store mængder realtidsdata, som overbelaster den traditionelle ETL-procesinfrastruktur.
Efterfølgende datauoverensstemmelser og unøjagtigheder skyldtes de 'rå' data af dårlig kvalitet, som blev indlæst i datavarehuset. På grund af begrænsninger i den lokale infrastruktur mangler systemet desuden skalerbarhed til at håndtere store datamængder.
Løsningen er at implementere avancerede ETL-værktøjer, der kan håndtere store datamængder, kombineret med stærke politikker for datastyring for at sikre datakvaliteten ved kilden. I dette scenarie kan en cloudbaseret løsning hjælpe med at overvinde skaleringsproblemer, forbedre ETL-hastigheden og i sidste ende øge effektiviteten af den finansielle rapportering.
Fremtiden for ETL
Forvent et betydeligt skift mod cloudbaserede ETL-værktøjer, efterhånden som virksomheder udnytter cloudteknologier til datahåndtering og -lagring.
Integration af kunstig intelligens og maskinlæring i ETL-processer vil revolutionere dataudtræk og -behandling og resultere i mere effektive og nøjagtige dataindsigter. Tilføjelsen af ETL-funktioner i realtid vil også blive mere udbredt og muliggøre øjeblikkeligt dataudtræk og analyse til beslutningstagning i realtid.
I de kommende år vil der være fokus på at løse vedvarende ETL-udfordringer såsom håndtering af store datamængder, effektivisering af komplekse transformationer samt sikring af datasikkerhed og privatliv.
Efterhånden som datamængden vokser, og virksomheder i stigende grad er afhængige af datadrevet beslutningstagning, skal ETL-processer blive mere agile, sikre og effektive. Derfor kan vi forvente, at der opstår mere avancerede ETL-værktøjer og -metoder, som kan imødekomme disse krav.
Hvis du vil vide mere om ETL-udfordringer, testværktøjer og meget mere, så tilmeld dig The CTO Clubs nyhedsbrev.


