

Datalagerværktøjer giver dig mulighed for at gemme, organisere og analysere enorme mængder strukturerede og ustrukturerede data på tværs af din virksomhed. Hvis du sammenligner de bedste datalagerværktøjer, har du ikke råd til at gætte – hvilken platform holder dit team i kontrol over omkostninger, overholdelse af regler og ydeevne, efterhånden som dine data vokser?
I denne guide gennemgår jeg gennemprøvede muligheder, der hjælper IT-ledere med at levere styring, skalerbarhed, integration og fremtidssikring, så du trygt kan vælge det rigtige fundament til analyse- og AI-arbejdsbelastninger i 2026.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel for datalagerværktøjer
Denne sammenligningstabel opsummerer prisoplysninger for mine udvalg af de bedste datalagerværktøjer:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til automatisk optimerede Apache Iceberg-datasøer | Gratis prøveperiode tilgængelig | Fra $300/måned (faktureres årligt) | Website | |
| 2 | Bedst til datastyring i hybride datasøer i regulerede virksomheder | 60-dages gratis prøveperiode tilgængelig | Fra $0.04/CCU/time | Website | |
| 3 | Bedst til åbent Iceberg-lakehouse uden leverandørbinding | 30-dages gratis prøveperiode | Fra $0.20/DCU | Website | |
| 4 | Bedst til styring af datasødata i regulerede brancher | Gratis demo tilgængelig | Pris oplyses på forespørgsel | Website | |
| 5 | Bedst til styring på tværs af motorer i åbne datasøtabeller | 90 dages gratis prøveperiode | Fra $0.12 pr. DCU-time | Website | |
| 6 | Bedst til GCP-native arkitektur for datasø og datavarehus med lagring i niveauer | Gratis abonnement tilgængeligt | Fra $0.020/GB/måned | Website | |
| 7 | Bedst til deling af data uden kopiering på tværs af cloudplatforme | 30 dages gratis prøveperiode | Fra $2.00/kredit | Website | |
| 8 | Bedst til lakehouse baseret på åbne tabelformater | 14 dages gratis prøveperiode | Fra $0.22/DBU | Website | |
| 9 | Bedst til objektlagring i kernen af AWS-datasøer | Ikke tilgængelig | Fra $0.023/GB/måned | Website | |
| 10 | Bedst til virksomhedsbaserede datasøer med Microsoft-teknologi | $200 i kredit i 30 dage (intet dedikeret gratis niveau) | Fra $0.023/GB/måned | Website |




Anmeldelser af datalagerværktøjer
Nedenfor finder du mine detaljerede opsummeringer af de bedste datalagerværktøjer, der kom med på min kortliste. Mine anmeldelser giver et detaljeret indblik i funktionerne, mulighederne og de bedste anvendelsesområder for hver platform, så du kan finde den bedste løsning til dig.
 1Bedst til automatisk optimerede Apache Iceberg-datasøer
Qlik
- Gratis prøveperiode tilgængelig
- Fra $300/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.4/5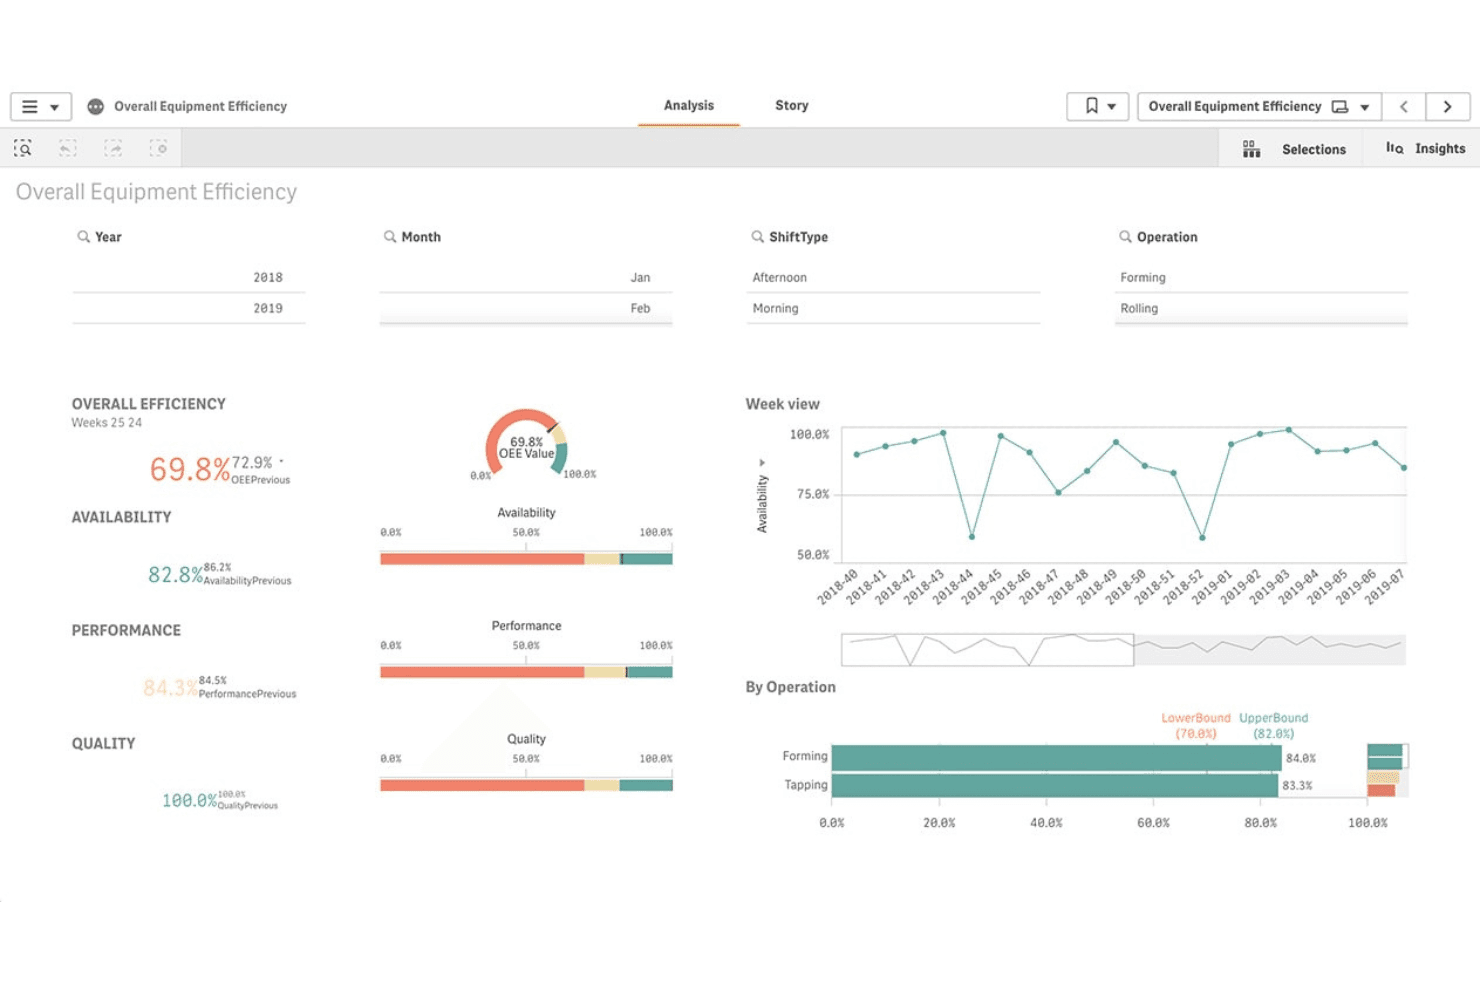
Qlik sporer den samlede udstyrseffektivitet med direkte KPI-oversigter. Qlik er en data- og datasøplatform, der er bygget nativt på Apache Iceberg, og som kombinerer CDC-baseret indlæsning, automatiseret skemaudvikling, datapipelines i flere formater og indbygget styring på tværs af cloudbaserede objektlagringsmiljøer.
Hvem er Qlik bedst egnet til?
Qlik er velegnet til store virksomheder i regulerede brancher, der har brug for administration af data og datasøer fra ende til anden på én enkelt platform.
Hvorfor jeg valgte Qlik
Jeg valgte Qlik, fordi deres Adaptive Iceberg Optimizer adskiller platformen fra konkurrenterne: Den kører løbende komprimering, indeksering og oprydning i snapshots på dine Iceberg-tabeller uden behov for manuel finjustering, hvilket giver 2,5-5 gange hurtigere forespørgsler og op til 50 % lavere lageromkostninger. Jeg benytter mig også af deres spejling uden datakopiering til at overføre aktive Iceberg-tabeller direkte til Snowflake uden at duplikere data eller gøre pipelines mere komplekse.
Vigtige funktioner i Qlik
- Logbaseret CDC-replikering: Qlik Replicate registrerer ændringer direkte fra databasens transaktionslogs uden behov for agenter, så data i datalageret holdes opdaterede uden at påvirke kildesystemets ydeevne.
- Pipeline til indlæsning i flere formater: Indlæs data i Parquet, Avro, ORC, JSON og CSV fra mere end 200 kilder – herunder databaser, SaaS-apps, SAP, stormaskiner og streamingplatforme som Kafka og Kinesis.
- Dataafstamning på kolonneniveau og konsekvensanalyse: Spor data fra kilde til anvendelse på kolonneniveau, så du får et tydeligt revisionsspor til styring og compliance-rapportering.
- Automatiseret administration af bronze-, sølv- og guldzoner: Qlik Compose for Data Lakes automatiserer skemagenerering, oprettelse af Hive-kataloger og løbende zoneopdateringer via CDC – og eliminerer dermed manuel pipeline-kodning til datasøarkitekturer i flere niveauer.
Qlik-integrationer
Qlik understøtter mere end 200 kilder til indlæsning, herunder Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP og Salesforce. Deres Iceberg-tabeller integreres med Spark, Amazon Athena, Trino, Presto, Databricks, Dremio og Tableau.
Pros and Cons
Pros:
- Automatisk optimeret administration af Apache Iceberg-tabeller
- Avanceret logbaseret CDC-replikering i realtid
- Omfattende compliance- og styringskontroller til virksomheder
Cons:
- Kompleks platform med høje tekniske krav
- Uigennemsigtig licensering og proces til estimering af omkostninger
Learn more about Qlik: Bedst til datastyring i hybride datasøer i regulerede virksomheder
- 60-dages gratis prøveperiode tilgængelig
- Fra $0.04/CCU/time
Visit WebsiteCustomer Rating:4.1/5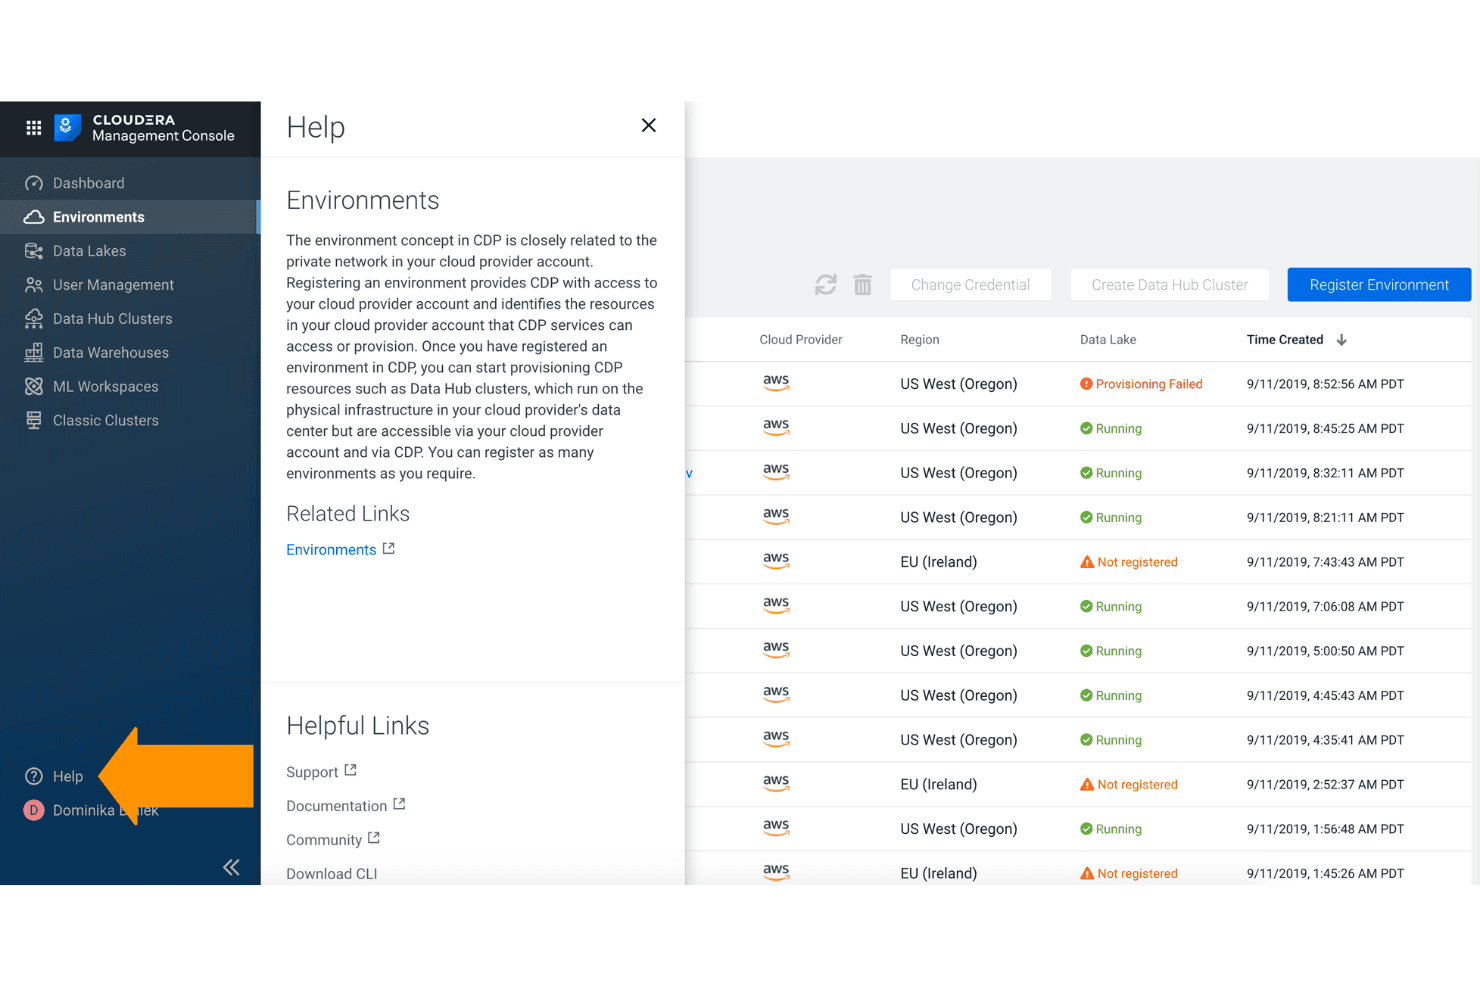
Cloudera giver brugerne mulighed for at administrere og overvåge skymiljøer på tværs af regioner. Cloudera er en åben datasøhusplatform, der dækker skalerbar lagring i flere skyer og lokalt, dataindlæsning i flere formater via over 450 forbindelser, Apache Iceberg-baseret skemalæsning ved forespørgsel samt centraliseret styring på tværs af hybride miljøer.
Hvem passer Cloudera bedst til?
Cloudera er særligt velegnet til store virksomheder i regulerede brancher – bankvæsen, offentlige myndigheder og telekommunikation – der har brug for samlet styring på tværs af lokale miljøer og flere skyer.
Hvorfor valgte jeg Cloudera?
Cloudera indtager en plads på min liste over favoritter, fordi ingen anden platform matcher dens dybde inden for styring på tværs af hybride miljøer. Jeg er især imponeret af Cloudera SDX, som anvender politikker fra Apache Ranger og Apache Atlas én gang og håndhæver dem overalt, uanset om dine data ligger i en lokal HDFS-klynge, Azure ADLS eller AWS S3. Banker og offentlige myndigheder, der driver blandet infrastruktur, kan centralt definere maskeringsregler på kolonneniveau og ABAC-politikker, mens certificeringer i FedRAMP Moderate og PCI DSS 4.0 understøtter overholdelsen af kravene.
Vigtige funktioner i Cloudera
- Apache Iceberg-tidsrejse: Forespørg på historiske øjebliksbilleder af dine data på et hvilket som helst tidspunkt ved hjælp af Icebergs indbyggede versionsstyring og tidsrejsefunktioner.
- Lakehouse Optimizer: Automatiserer komprimering af Iceberg-tabeller, Z-sortering og partitionbeskæring for at forbedre forespørgselsydelsen og reducere beregningsomkostningerne.
- Visuel pipelinebygger til Cloudera Data Flow (NiFi): Design og implementer dataindlæsningspipelines med en træk-og-slip-grænseflade med over 450 forudbyggede processorer og forbindelser.
- Datadeling uden kopiering via Iceberg REST Catalog: Eksterne motorer som Databricks, Snowflake og Athena kan forespørge direkte på Cloudera-administrerede Iceberg-tabeller uden flytning eller duplikering af data.
Cloudera-integrationer
Cloudera Data Flow indeholder over 450 forudbyggede forbindelser, herunder Apache Kafka, MongoDB, Salesforce, Snowflake og Google BigQuery. Det integreres også med AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau og Power BI via Iceberg REST Catalog.
Pros and Cons
Pros:
- Understøttelsen af hybride og lokale miljøer er uovertruffen
- Virksomhedsstyring til strenge krav om overholdelse
- Deling uden kopiering på tværs af eksterne forespørgselsmotorer
Cons:
- Den indledende konfiguration kræver ofte ekspertkundskaber
- Tilfredsheden med metadataadministration ligger under konkurrenternes gennemsnit
Learn more about Cloudera: Bedst til åbent Iceberg-lakehouse uden leverandørbinding
- 30-dages gratis prøveperiode
- Fra $0.20/DCU
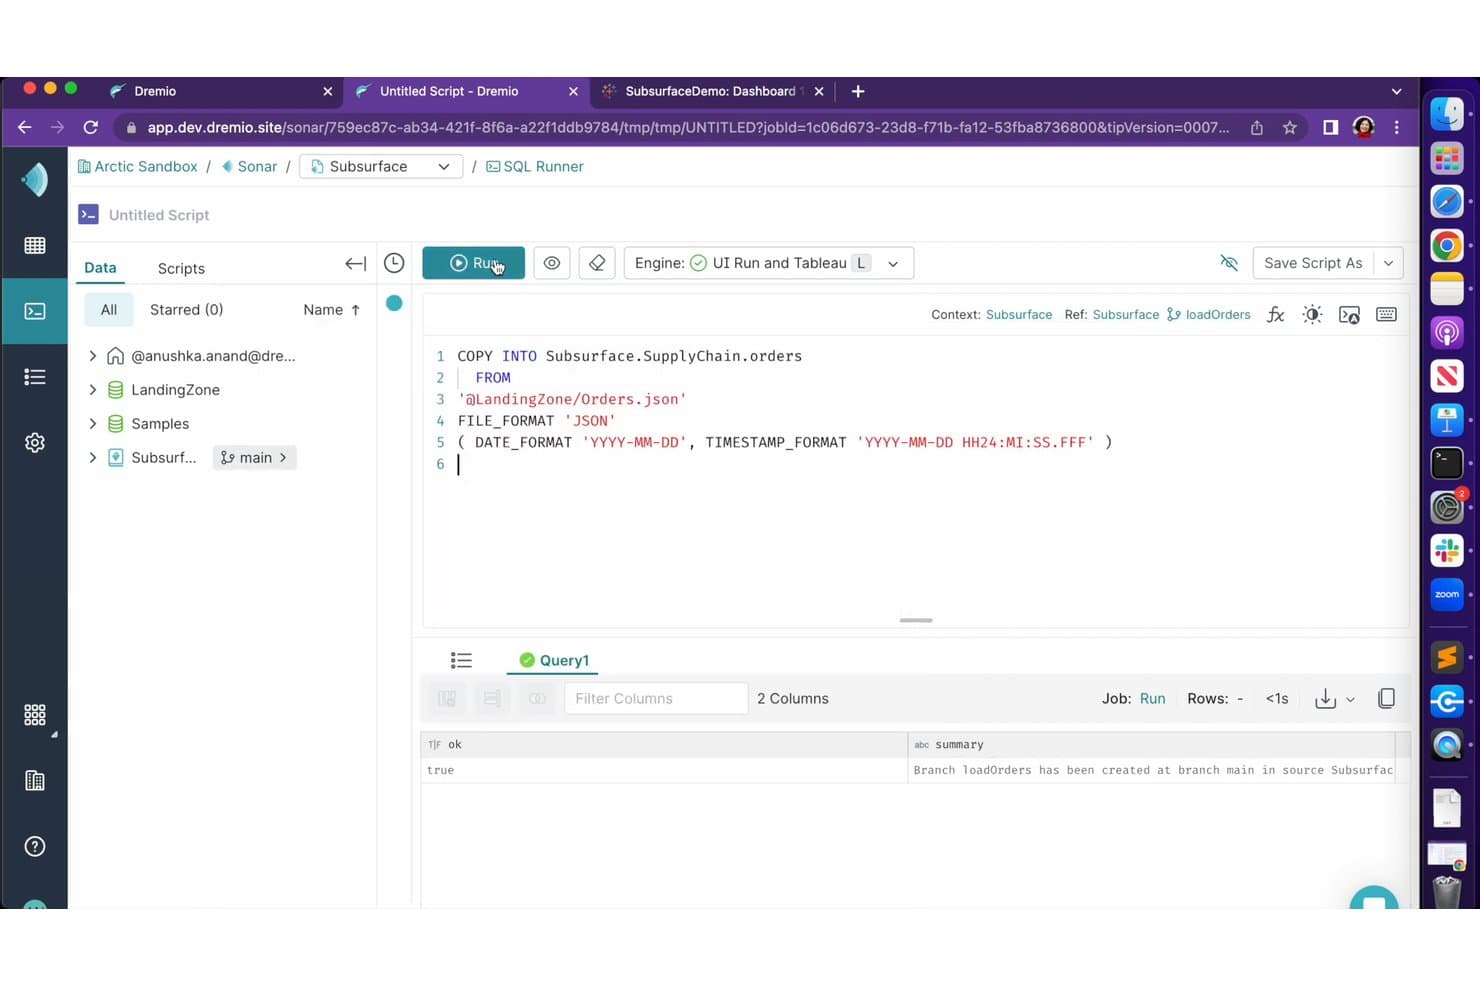
Dremio lader brugere indlæse JSON-data i tabeller ved hjælp af SQL-kommandoer med COPY INTO. Dremio er en åben lakehouse-platform, der oprindeligt er bygget på Apache Iceberg og Apache Arrow og kombinerer en SQL-forespørgselsmotor, fødereret dataadgang, automatiseret forespørgselsacceleration, Git-lignende dataversionsstyring og et åbent katalog til flere motorer.
Hvem er Dremio bedst til?
Dremio er velegnet til dataingeniør- og arkitekturteams, der bygger åbne lakehouses på Apache Iceberg og har brug for forespørgselsadgang fra flere motorer uden at være låst til et proprietært katalog eller lagringsformat.
Hvorfor jeg valgte Dremio
Dremio er på min udvalgte liste, fordi det oprindeligt er bygget på Apache Iceberg, hvilket betyder, at dine data forbliver i dine egne S3- eller ADLS-buckets, og at enhver motor (Spark, Flink, Trino, DuckDB) kan læse og skrive dem gennem det åbne Polaris-katalog uden formatkonvertering. Jeg kan især godt lide autonome refleksioner, som ubemærket observerer forespørgselsmønstre og materialiserer accelerationer i baggrunden, så dine BI-dashboards giver hurtige resultater uden manuel tuning eller proprietære ekstrakter.
Dremios vigtigste funktioner
- Åbent katalog (Apache Polaris): Et katalog til flere motorer, der er bygget på Apache Polaris, og som lader Spark, Flink, Trino og DuckDB læse og skrive Iceberg-tabeller gennem en standardiseret REST-API.
- Data som kode-forgrening: Git-lignende versionsstyring via Project Nessie opretter isolerede dataforgreninger uden kopiering til udvikling, test og ML-eksperimenter med atomiske sammenfletninger og tilbagerulninger.
- Indlæsning med COPY INTO: En indbygget SQL-kommando, der masseindlæser CSV-, JSON- og Parquet-filer fra objektlagring direkte i Iceberg-tabeller med skemamigrering og partitionshåndtering.
- Detaljeret adgangskontrol: Sikkerhed på rækkeniveau og maskering af kolonner håndhæves på forespørgselstidspunktet og anvendes konsekvent på tværs af alle motorer, der forespørger kataloget.
Dremio-integrationer
Dremio integrerer med Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage og Google Cloud Storage. Dets Polaris REST-katalog samt ODBC-, JDBC- og Arrow Flight-grænseflader understøtter forbindelser til brugerdefinerede motorer og applikationer.
Pros and Cons
Pros:
- Behandler Apache Iceberg oprindeligt uden konvertering
- Git-lignende dataforgrening til tidsrejser
- Åbent REST-katalog forbinder enhver forespørgselsmotor
Cons:
- Mere kompleks administration end sammenlignelige værktøjer
- Ingen dedikeret indbygget ML-funktionslager
Learn more about Dremio: Bedst til styring af datasødata i regulerede brancher
- Gratis demo tilgængelig
- Pris oplyses på forespørgsel
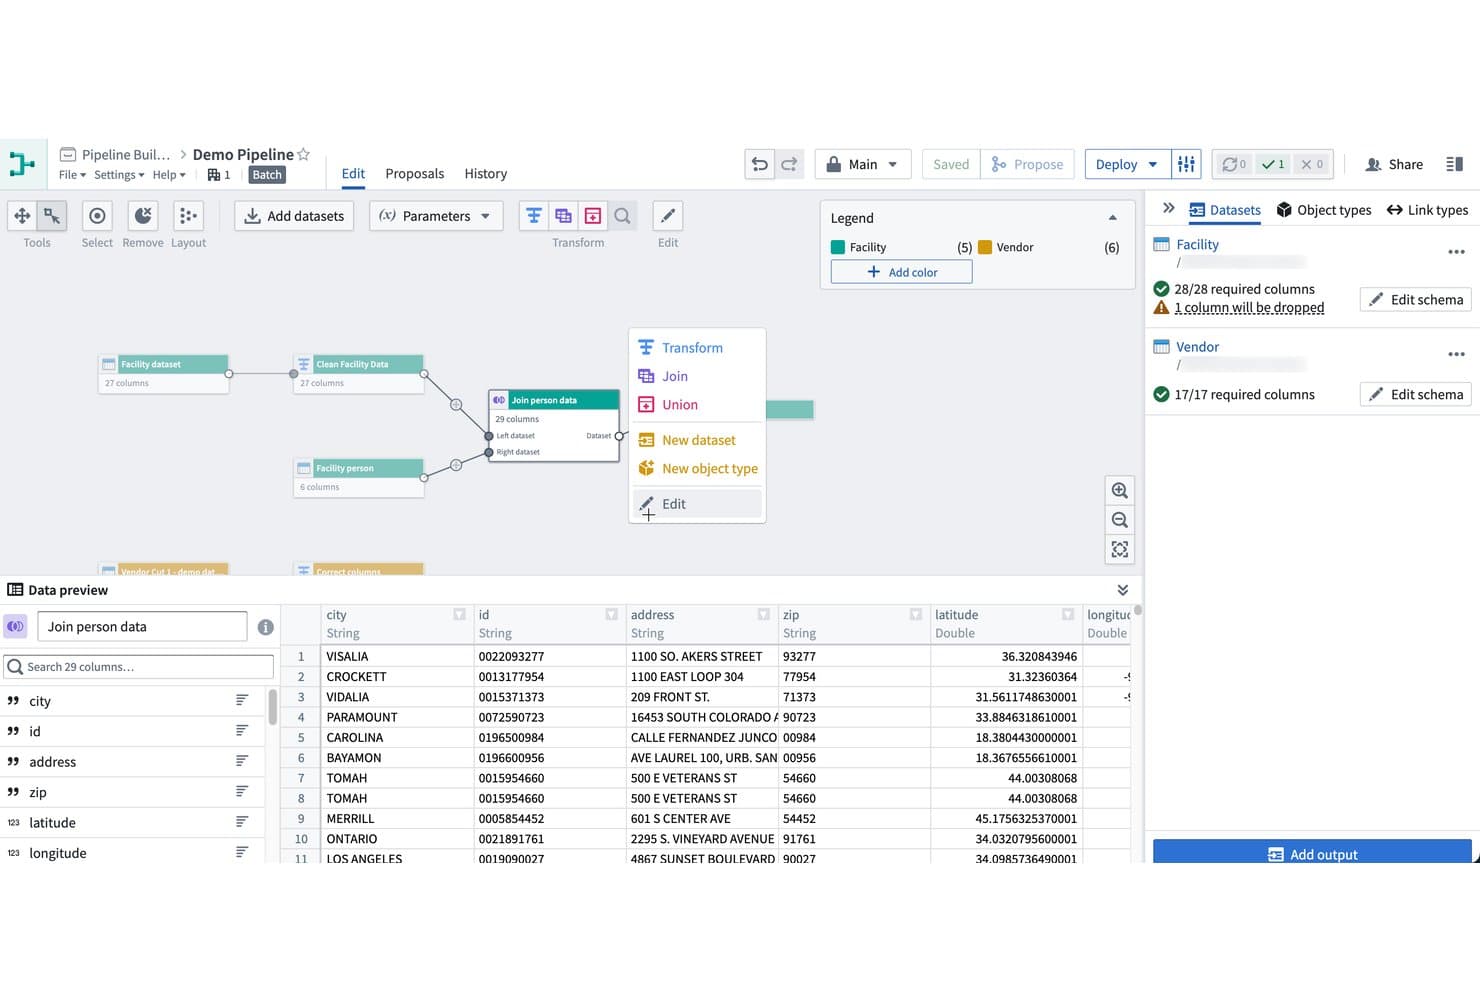
Palantir Foundry lader brugere opbygge og sammenkoble datasæt visuelt i pipelines. Palantir Foundry er en datasøplatform, der kombinerer indlæsning i flere formater, pipelineorkestrering, semantisk datamodellering via sit ontologilag og indbyggede styringskontroller på tværs af cloud-, lokale og luftgabte miljøer.
Hvem er Palantir Foundry bedst egnet til?
Palantir Foundry er specifikt udviklet til store virksomheder i regulerede brancher—finans, sundhedsvæsen, forsvar og offentlige myndigheder—der har brug for detaljeret datastyring på tværs af komplekse miljøer med flere datakilder.
Hvorfor valgte jeg Palantir Foundry?
Jeg valgte Palantir Foundry, fordi platformens styringsarkitektur reelt ikke har nogen konkurrent inden for regulerede brancher. Platformen kombinerer formålsbaserede, klassifikationsbaserede og rollebaserede adgangskontroller med datamærkninger, der automatisk videreføres gennem dataets oprindelse, så et PII-mærke på et kildedatasæt følger dataene gennem hver eneste efterfølgende transformation. Kombinerer man dette med certificeringer som FedRAMP High, HIPAA, ITAR og SOC 2 Type 2 samt ontologilaget, der kortlægger rå datasødata til revisionssporbare forretningsobjekter, får man en platform, der fra bunden er bygget til miljøer, hvor styring ikke er valgfri.
Vigtige funktioner i Palantir Foundry
- Over 200 forudbyggede datakonnektorer: Opret forbindelse til databaser, datavarehuse, streamingplatforme, ERP-systemer, cloudlagring, IoT-kilder og geospatiale værktøjer via én enkelt grænseflade til dataindlæsning.
- Apache Iceberg REST-katalog: Gør Foundry-datasæt tilgængelige for eksterne Iceberg-kompatible beregningsmotorer—herunder Trino, Spark, Flink, Databricks og Snowflake—uden at duplikere data.
- Virtuelle tabeller til dataforbund uden kopiering: Forespørg direkte på eksterne tabeller i Databricks, Snowflake og S3-kompatible lagre fra Foundry uden at indlæse eller flytte de underliggende data.
- AIP-modelstudio: Opbyg, træn, evaluer og lever ML-modeller i Foundry med indbygget adgang til LLM'er og understøttelse af udviklingsmiljøer i Python og R.
Integrationer til Palantir Foundry
Palantir Foundry tilbyder over 200 indbyggede datakonnektorer, herunder Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau og Power BI. Platformen understøtter også tilpasset forbindelse via sin S3-kompatible API, Iceberg REST-katalog og virtuelle tabeller.
Pros and Cons
Pros:
- Førende datastyring til overholdelse af regler
- Ontologilaget giver forretningsbrugere adgang til data
- Deling af data uden kopiering med virtuelle tabeller
Cons:
- Høje kontraktpriser med uklare totaler
- Risiko for platformslåsning på grund af proprietære modeller
Learn more about Palantir Foundry: Bedst til styring på tværs af motorer i åbne datasøtabeller
- 90 dages gratis prøveperiode
- Fra $0.12 pr. DCU-time
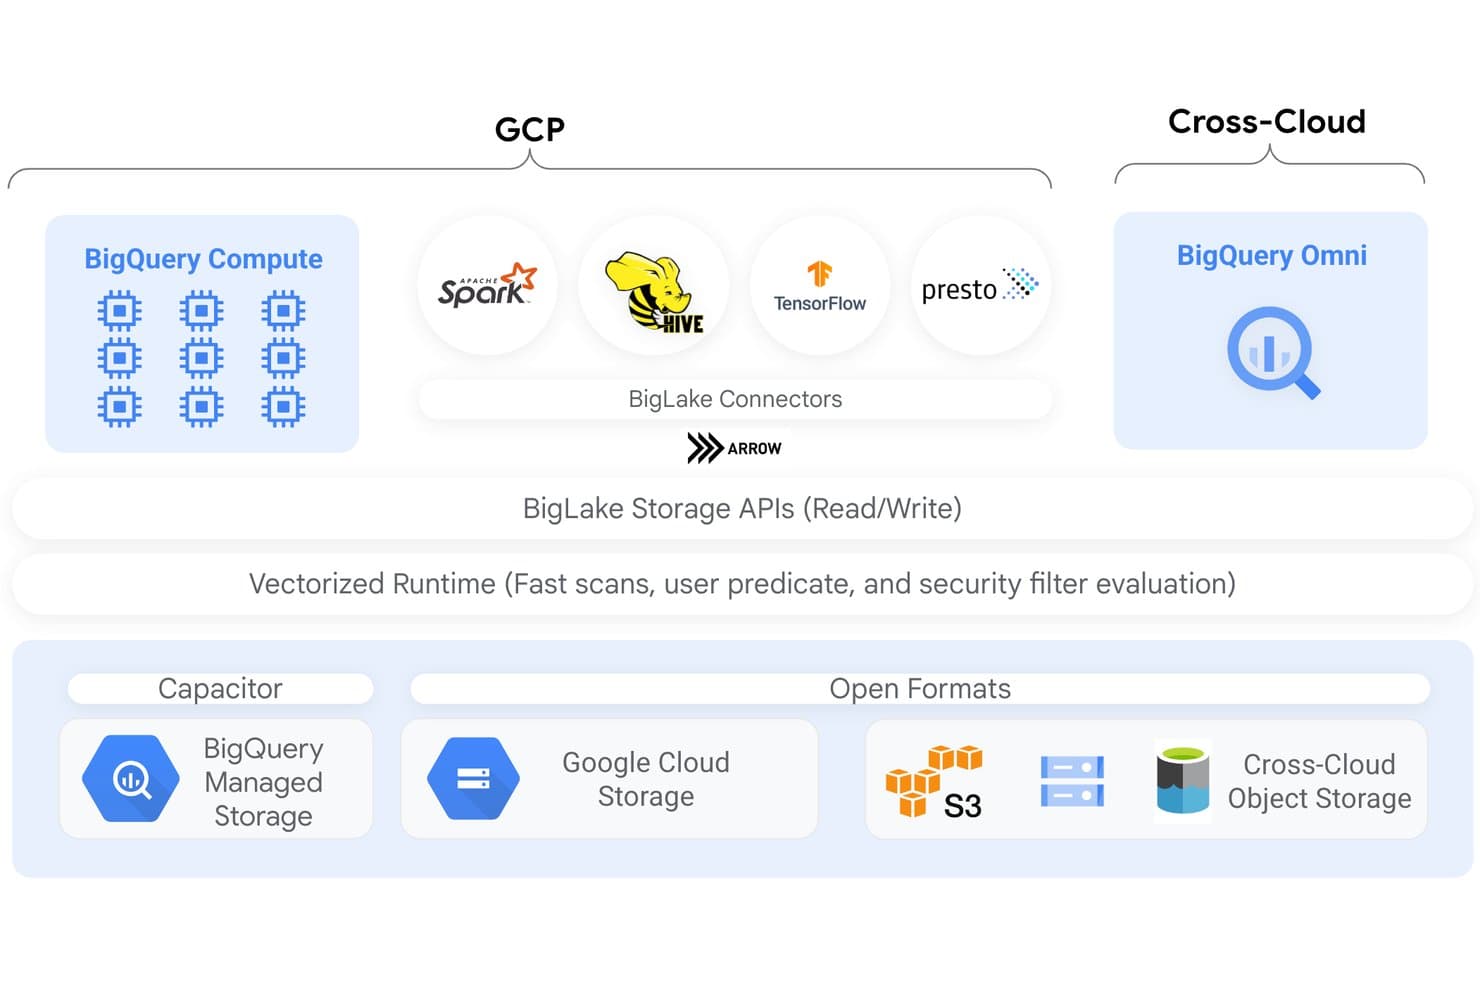
BigLake samler beregning og lagring på tværs af GCP- og skymiljøer. BigLake er Googles cloudplatform til datasøhuse, som udvider BigQuery med understøttelse af tabeller i åbne formater, forespørgselsadgang på tværs af motorer, samlet metadatastyring og detaljeret styring på tværs af GCS, S3 og Azure Blob Storage.
Hvem er BigLake bedst egnet til?
BigLake er et stærkt valg for dataingeniør- og arkitekturteams, der allerede bruger Google Cloud, og som har brug for ensartet styring på tværs af flere forespørgselsmotorer og åbne tabelformater.
Hvorfor jeg valgte BigLake
Jeg valgte BigLake som en af de bedste, fordi det er den eneste datasøhus-platform, jeg har set, der håndhæver adgangspolitikker på række- og kolonneniveau ensartet på tværs af BigQuery, Spark, Trino og Presto – ikke kun i én enkelt motor. Det betyder, at et politikmærke, der anvendes på en følsom kolonne, følger dataene, uanset hvilken motor dit team bruger til at forespørge i dem. Lakehouse Iceberg REST-kataloget gør dette muligt ved at fungere som ét styringsbevidst slutpunkt for alle motorer med åben kildekode, der læser og skriver i de samme Iceberg-tabeller.
Vigtige BigLake-funktioner
- Automatisk tabelvedligeholdelse: BigLake håndterer automatisk filkomprimering, klyngedannelse, oprydning og generering af metadata for Iceberg-tabeller, der er gemt i GCS.
- Indlæsning i flere formater: Indlæs data i Parquet, ORC, Avro, CSV, JSON og åbne tabelformater som Apache Iceberg, Delta Lake og Apache Hudi via manifestfiler.
- BigQuery Omni-forespørgsler på tværs af skyer: Kør BigQuery SQL-forespørgsler direkte mod data, der er gemt i Amazon S3 eller Azure Data Lake Storage Gen 2, uden at flytte dem til GCS.
- Replikering med ændringsdatafangst: Stream driftsdata fra Cloud Spanner, AlloyDB og Cloud SQL direkte til BigLake-tabeller for analyser tæt på realtid.
BigLake-integrationer
BigLake har indbyggede integrationer med BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker og Vertex AI. Dets Iceberg REST-katalog forbinder motorer med åben kildekode med delte datasøtabeller.
Pros and Cons
Pros:
- Sikkerhed på række- og kolonneniveau håndhæves på tværs af motorer
- Åbne tabelformater med fuld Iceberg-understøttelse
- Katalogføderation til styring af metadata i flere skyer
Cons:
- DML understøttes ikke for eksterne tabeller, der ikke er Iceberg-tabeller
- CMEK er ikke tilgængelig for cachelagrede S3- eller Azure-tabeller
Learn more about BigLake: Bedst til GCP-native arkitektur for datasø og datavarehus med lagring i niveauer
- Gratis abonnement tilgængeligt
- Fra $0.020/GB/måned
Visit WebsiteCustomer Rating:4.7/5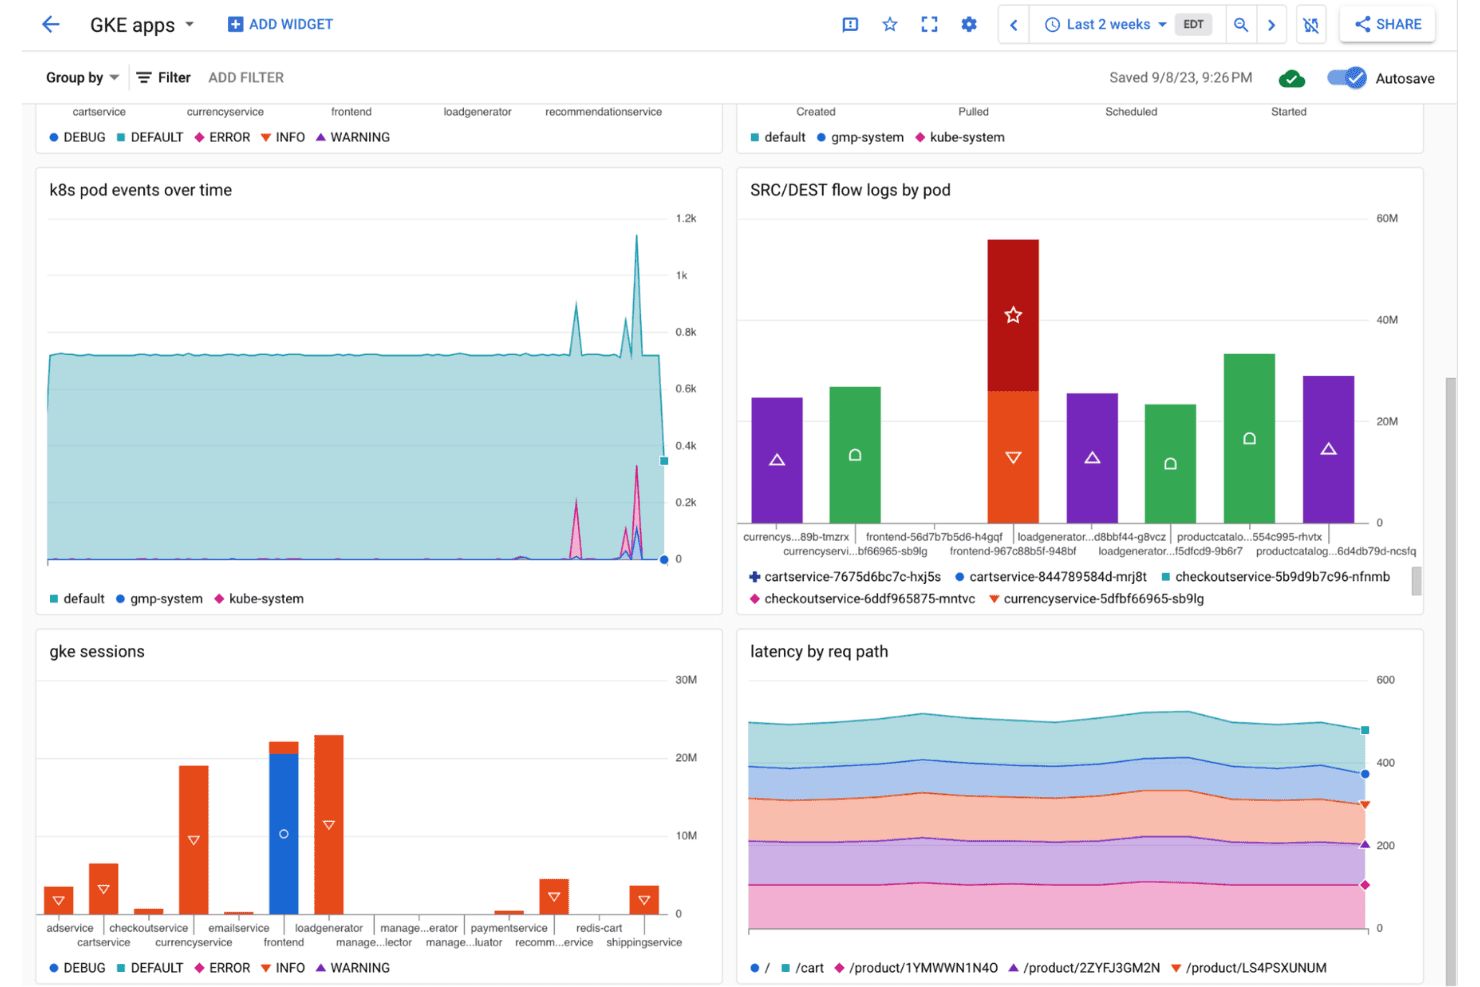
Google Cloud Storage viser overvågningsdashboards for GKE-apps med podhændelser og latenstal. Google Cloud Storage er en administreret objektlagringstjeneste, der er bygget til datasøarkitekturer og tilbyder lagringsklasser i niveauer, understøttelse af åbne tabelformater via Apache Iceberg og BigLake samt dyb integration med BigQuery, Dataflow, Dataproc og Vertex AI.
Hvem er Google Cloud Storage bedst egnet til?
Google Cloud Storage er velegnet til dataingeniør- og infrastrukturteams, der allerede arbejder i GCP-økosystemet, og som har brug for et skalerbart objektlager som fundament for en kombineret datasø- og datavarehusarkitektur.
Hvorfor valgte jeg Google Cloud Storage?
Jeg valgte Google Cloud Storage, fordi det er det naturlige fundament for en GCP-baseret kombineret datasø- og datavarehusarkitektur med lagringsklasser i niveauer (fra Standard til Archive til $0.0012/GB/måned) og Autoclass, der automatisk flytter objekter mellem niveauer baseret på adgangsmønstre. Det, jeg finder særligt overbevisende, er BigLake: Det tilføjer ACID-transaktioner, tidsrejser og skemaudvikling direkte til Apache Iceberg-tabeller, der er understøttet af GCS, og omdanner dermed rå objektlagring til et forespørgselsbart system for datasøer og datavarehuse uden at flytte data. BigQuery kan derefter forespørge i de samme Iceberg-tabeller på stedet uden behov for eksport.
Vigtige funktioner i Google Cloud Storage
- Indlæsning i flere formater: Storage Transfer Service, Dataflow, Pub/Sub og Datastream understøtter batch-, datastrøms- og CDC-indlæsning fra databaser som MySQL, PostgreSQL og Oracle til GCS.
- Styring og adgangskontroller: IAM-baserede tilladelser, CMEK/CSEK-kryptering, VPC Service Controls, Cloud DLP og revisionslogning håndhæver sikkerheden for alle lagrede data.
- Opdagelse af metadata via Knowledge Catalog: Dataplex scanner automatisk GCS-buckets for at udtrække skemaer, opbygge forretningsordbøger og generere komplet dataafstamning på tværs af GCS og BigQuery.
- Understøttelse af forespørgsler fra flere motorer: Iceberg-tabeller, der er understøttet af GCS, kan forespørges af BigQuery, Serverless Spark, Trino, Flink og Presto via Iceberg REST Catalog.
Integrationer med Google Cloud Storage
Google Cloud Storage har indbyggede integrationer med BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker og Knowledge Catalog. REST-, XML-, gRPC- og klientbiblioteks-API'er understøtter brugerdefinerede integrationer med dataplatforme og behandlingsmotorer.
Pros and Cons
Pros:
- Understøttelse af kombinerede datasø- og datavarehusarkitekturer med Apache Iceberg-tabeller
- Analyse med flere motorer via BigQuery og Spark
- Automatiserede muligheder for arkivering og lagring i niveauer
Cons:
- De fleste funktioner kræver flere GCP-tjenester
- Kompleks fakturering med separate gebyrer for handlinger og udgående trafik
Learn more about Google Cloud Storage: Bedst til deling af data uden kopiering på tværs af cloudplatforme
- 30 dages gratis prøveperiode
- Fra $2.00/kredit
Visit WebsiteCustomer Rating:4.6/5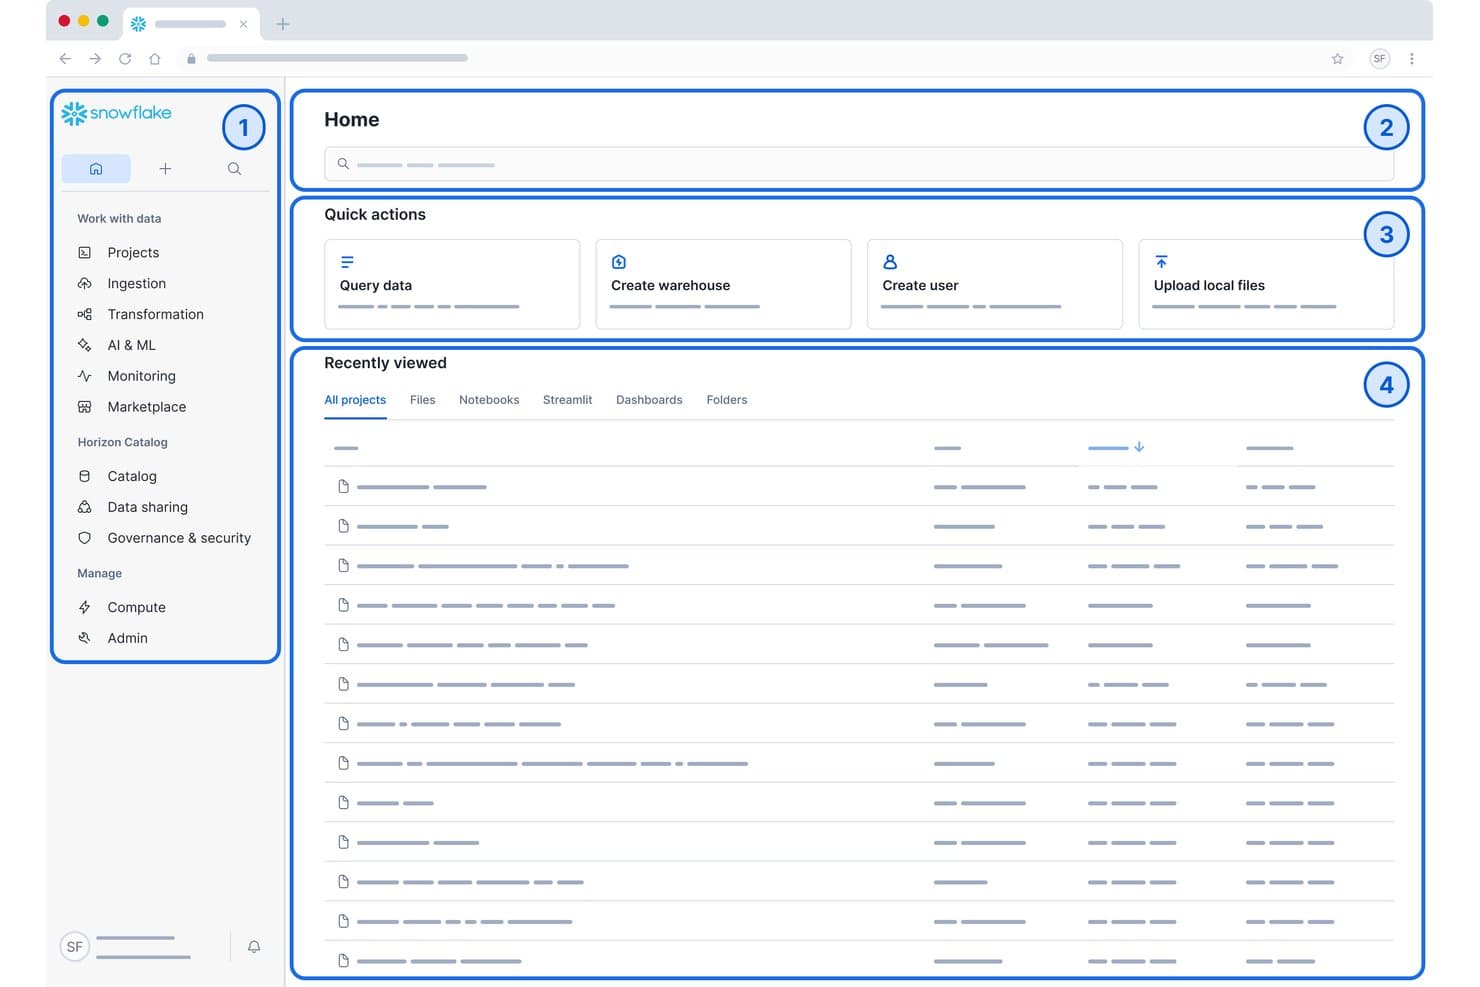
Snowflakes startdashboard samler dataforespørgsler, oprettelse af datalagre og nylige projekter ét sted. Snowflake er en cloudbaseret datasø- og analyseplatform, der kombinerer elastisk lagring, en indbygget SQL-forespørgselsmotor, Snowpark til Python/Java/Scala-arbejdsbelastninger, understøttelse af Apache Iceberg og deling af data uden kopiering på tværs af AWS, Azure og GCP.
Hvem er Snowflake bedst egnet til?
Snowflake er et stærkt valg for virksomhedsdatateams, der administrerer store miljøer på tværs af flere cloudplatforme, hvor styring, compliance og datadeling på tværs af organisationer er ufravigelige krav.
Hvorfor valgte jeg Snowflake?
Snowflake kommer på min kortliste, fordi deling af data uden kopiering gør det muligt at dele live-datasæt på tværs af AWS-, Azure- og GCP-konti uden at duplikere eller flytte en eneste byte. Jeg har arbejdet med Snowflake Marketplace, som forbinder til over 820 dataleverandører, og den automatiske opfyldelse på tværs af cloudplatforme gør deling på tværs af regioner virkelig problemfri. Kombineret med indbygget understøttelse af Apache Iceberg og Snowpipe Streaming, der håndterer over 1M TPS, får du en søplatform, der er bygget til reel virksomhedsskala.
Vigtige funktioner i Snowflake
- Snowpark-kørselsmiljø til flere sprog: Skriv arbejdsbelastninger inden for datateknik og ML i Python, Java eller Scala, og kør dem direkte inde i Snowflakes forespørgselsmotor uden at flytte data ud.
- Understøttelse af Apache Iceberg-tabeller: Gem og administrer data i det åbne Iceberg-tabelformat på Snowflake-administreret lager med skemaudvikling, Time Travel og interoperabilitet med Spark, Trino og Flink.
- Horizon Catalog: Et indbygget styringslag med sporing af dataoprindelse på kolonneniveau, automatiseret PII-klassificering, AI-assisteret berigelse af metadata og Data Metric Functions til løbende overvågning af datakvaliteten.
- Snowpipe Streaming: Indlæs data på rækkeniveau i realtid med over 1M transaktioner pr. sekund direkte i Snowflake- eller Apache Iceberg-tabeller uden forsinkelser fra batchbehandling.
Snowflake-integrationer
Snowflake tilbyder indbyggede integrationer med Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker og Apache Airflow. Det forbinder til Apache Spark, Trino, Amazon S3, Azure Blob Storage og Google Cloud Storage med API'er til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Deling af data uden kopiering på tværs af cloudplatforme
- Indbygget styring og dataoprindelse på kolonneniveau
- Elastisk adskillelse af lager og beregning
Cons:
- Understøtter ikke implementering lokalt
- Det kan være udfordrende at holde styr på omkostningerne
Learn more about Snowflake: Bedst til lakehouse baseret på åbne tabelformater
- 14 dages gratis prøveperiode
- Fra $0.22/DBU
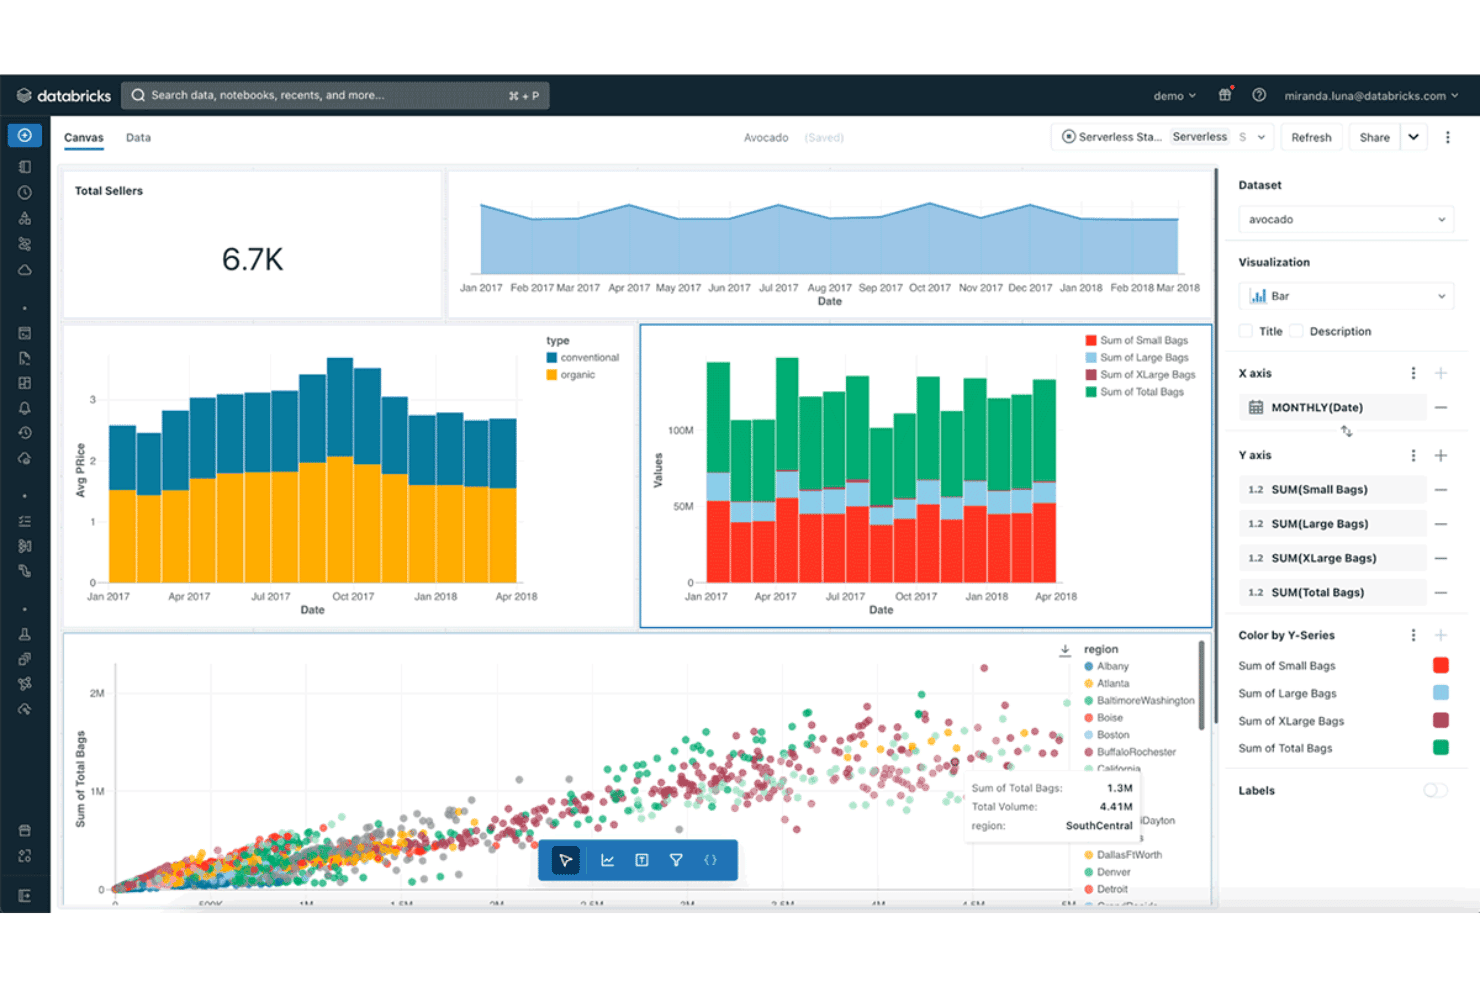
Databricks visualiserer avocadosalgsdata på tværs af interaktive diagrammer i et dashboard. Databricks Lakehouse-platformen er en cloudbaseret lakehouse-platform til data, der samler data engineering, SQL-analyse, maskinlæring og AI-udvikling på åbne tabelformater som Delta Lake, Apache Iceberg og Apache Hudi.
Hvem er Databricks Lakehouse-platformen bedst til?
Databricks er et stærkt valg for virksomheders data- og ML-teams, der har brug for at køre engineering-pipelines, SQL-analyse og AI-arbejdsbelastninger på én platform uden at flytte data mellem systemer.
Hvorfor jeg valgte Databricks Lakehouse-platformen
Databricks kommer med på min shortlist, fordi det er teamet, der bogstaveligt talt opfandt Delta Lake, og den oprindelseshistorie betyder noget, når man vurderer understøttelse af åbne tabelformater. Jeg har arbejdet med platformens indbyggede understøttelse af Delta Lake, Iceberg og Hudi, og det, der adskiller den, er, at ACID-transaktioner, tidsrejser og skemaudvikling ikke er eftermonterede tilføjelser. Unity Catalog tilføjer automatiseret datasporing på kolonneniveau og attributbaseret adgangskontrol direkte ovenpå, så styringen følger dataene på tværs af cloudmiljøer.
Vigtige funktioner i Databricks Lakehouse-platformen
- Lakeflow Connect: Et administreret, serverløst indtagslag med over 100 indbyggede forbindelser til SaaS-apps, databaser, cloudlager og streamingkilder, herunder Kafka, Kinesis og Event Hubs.
- Deklarative Apache Spark-pipelines: En ramme til opbygning af batch- og realtidsstreaming-ETL-pipelines med indbygget håndhævelse af datakvalitet baseret på begrænsninger og automatiseret CDC.
- Databricks SQL-lagerhuse: En Photon-accelereret SQL-motor, der understøtter ANSI SQL til analysearbejdsbelastninger, med JDBC/ODBC-forbindelse til BI-værktøjer som Tableau, Power BI og Looker.
- MLflow-integration: Et administreret MLflow-miljø til eksperimentregistrering, modelregister og implementering, placeret sammen med dine lake-data og forbundet med funktionslageret og modelbetjening.
Integrationer til Databricks Lakehouse-platformen
Databricks tilbyder over 100 indbyggede Lakeflow Connect-forbindelser, herunder Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive og Google Analytics. Den opretter også forbindelse til Kafka, Kinesis, Event Hubs, S3, ADLS og GCS med JDBC/ODBC og API'er til tilpassede forbindelser.
Pros and Cons
Pros:
- Indbygget understøttelse af Delta Lake, Iceberg og Hudi
- Automatiseret datasporing på kolonneniveau med Unity Catalog
- Indbygget MLflow og samlet AI-platform
Cons:
- DBU- og cloudomkostninger kan hurtigt stige
- Ingen mulighed for installation lokalt
Learn more about Databricks Lakehouse Platform: Bedst til objektlagring i kernen af AWS-datasøer
- Ikke tilgængelig
- Fra $0.023/GB/måned
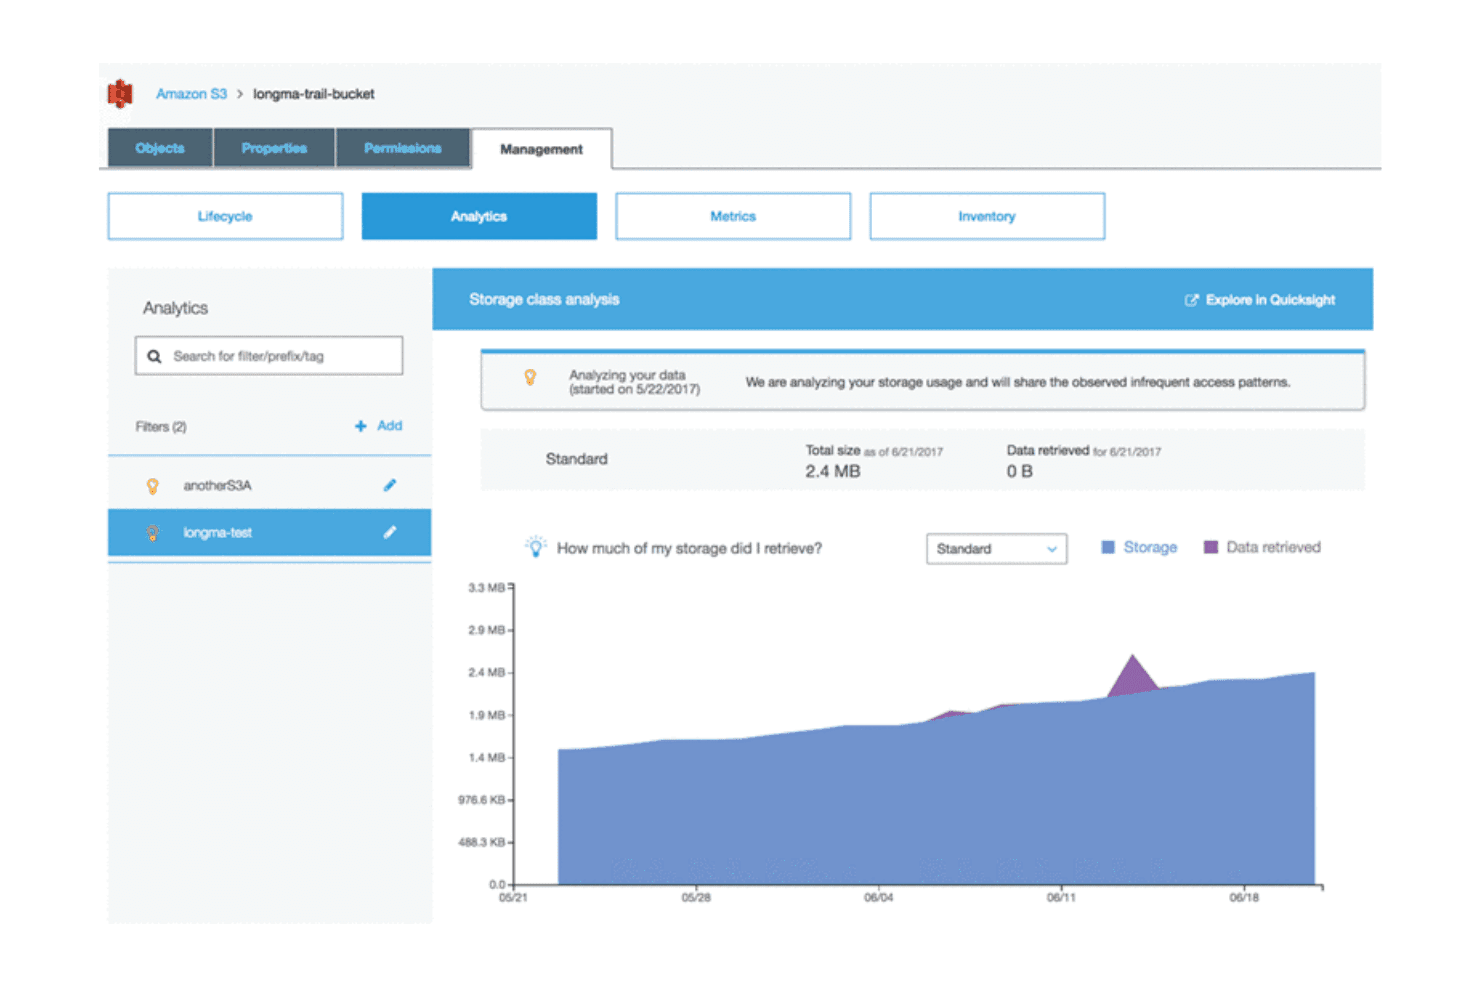
Amazon S3 analyserer mønstre i lagerforbruget for at optimere omkostningerne ved datahentning. Amazon S3 er AWS' objektlagringstjeneste, der fungerer som det grundlæggende lagringslag for datasøer og understøtter alle dataformater i exabyte-skala med niveaudelte lagerklasser, indbygget Apache Iceberg-tabeladministration via S3 Tables og dyb integration på tværs af AWS' analyseøkosystem.
Hvem egner Amazon S3 sig bedst til?
Amazon S3 er det rette valg for datateknik- og infrastrukturteams, der opbygger analysepipelines på AWS og har brug for et gennemprøvet lagringsfundament i exabyte-skala, som har direkte forbindelse til resten af AWS-økosystemet.
Hvorfor jeg valgte Amazon S3
Amazon S3 kommer med på min udvalgte liste, fordi det er det objektlagringslag, som de fleste produktionsdatasøer allerede er bygget på. Jeg er begejstret for, at S3 Tables leverer indbygget Apache Iceberg-understøttelse med ACID-transaktioner, tidsrejser og automatisk komprimering, hvilket løser problemet med små filer, der plager de fleste datasøarkitekturer. Kombineret med S3 Intelligent-Tiering, der automatisk flytter kolde data ned til $0.00099/GB/måned, får du effektiv kontrol over lageromkostningerne uden manuel indgriben.
Vigtige funktioner i Amazon S3
- Indlæsning i flere formater: S3 accepterer alle filtyper—Parquet, ORC, Avro, JSON, CSV og ustrukturerede formater—via batchuploads, streaming gennem Kinesis og MSK eller hændelsesdrevne udløsere ved hjælp af S3 Event Notifications.
- Finkornet adgangskontrol med Lake Formation: Håndhæv datapolitikker på tabel-, kolonne-, række- og celleniveau på tværs af hele din S3-baserede datasø uden at duplikere data.
- S3 Vectors: En indbygget tjeneste til lagring og forespørgsler på vektorindekser, der er bygget direkte ind i S3 og designet til semantisk søgning og arbejdsbelastninger med generering baseret på informationssøgning til op til 90 % lavere omkostninger end traditionelle metoder.
- S3 Inventory: Generér planlagte rapporter om objektattributter, lagerklasse, krypteringsstatus og replikeringsstatus på tværs af dine lagerbeholdere til arbejdsgange for revision og styring.
Integrationer med Amazon S3
Amazon S3 tilbyder indbyggede integrationer på tværs af AWS, herunder AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum og Amazon SageMaker. Det kan også forbindes med Apache Spark, Trino, Snowflake, Databricks, Tableau og Power BI via dokumenterede forbindelser og API'er.
Pros and Cons
Pros:
- Objektlagring i exabyte-skala understøtter alle dataformater
- Indbyggede ACID Iceberg-tabeller med automatisk komprimering
- 143 certificeringer for overholdelse af regler og adgangskontrol på objektniveau
Cons:
- Prisfastsættelsen er kompleks og kræver tæt styring
- Opbygning af datasøer kræver sammensætning af flere AWS-tjenester
Learn more about Amazon S3: Bedst til virksomhedsbaserede datasøer med Microsoft-teknologi
- $200 i kredit i 30 dage (intet dedikeret gratis niveau)
- Fra $0.023/GB/måned
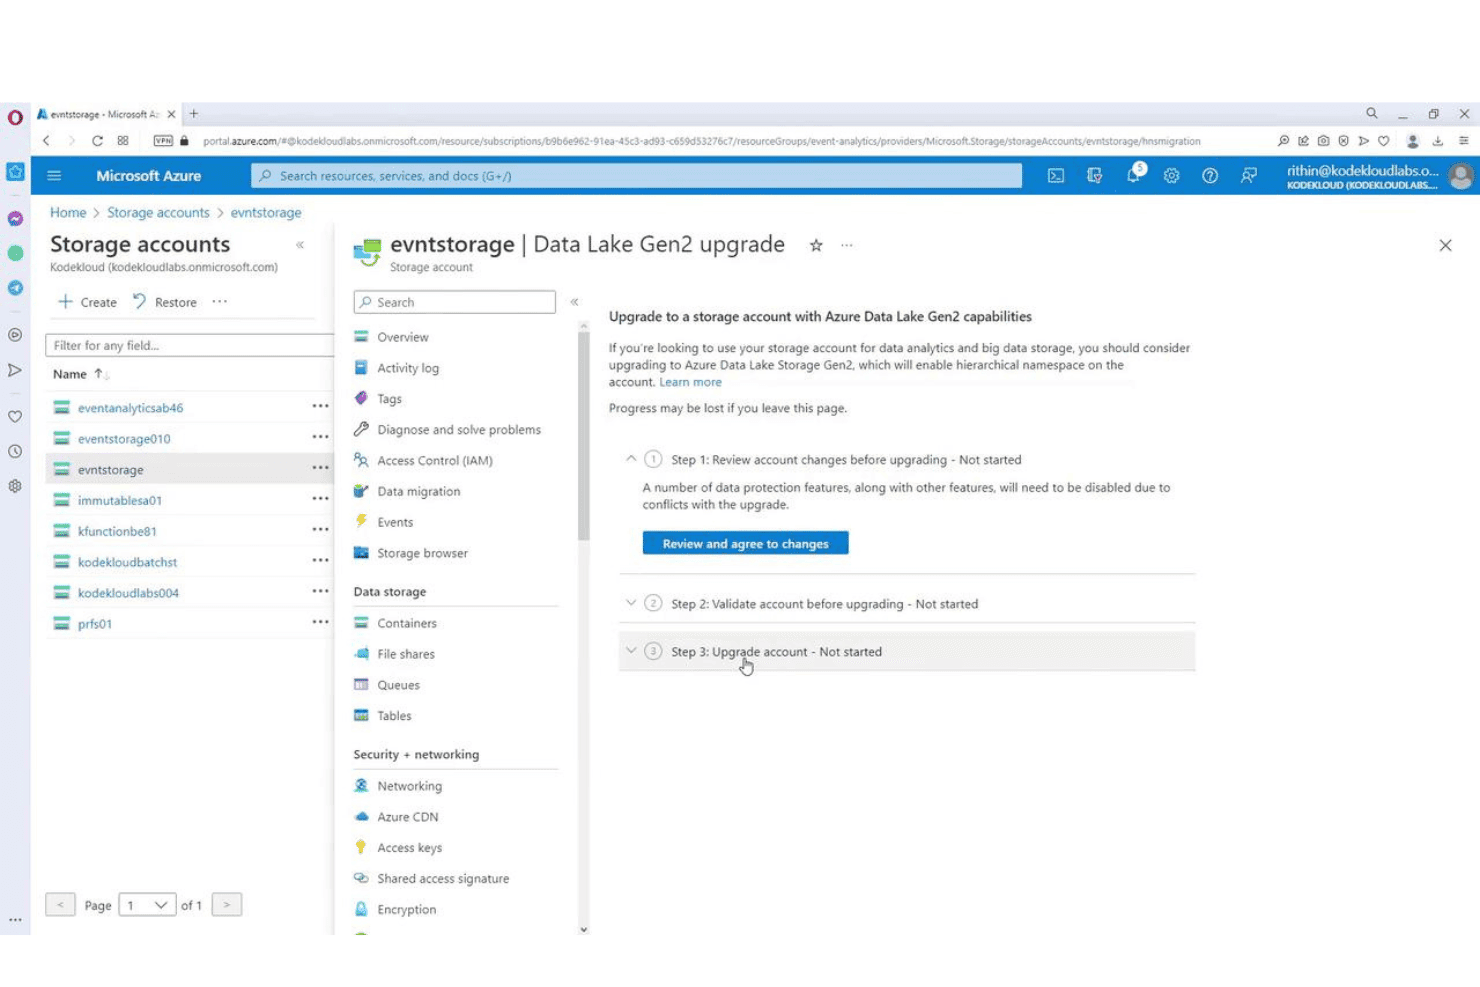
Azure Storage giver brugerne mulighed for at opgradere konti til Data Lake Gen2-funktioner. Azure Data Lake Storage Gen2 er Microsofts cloudbaserede datalagringstjeneste til datasøer, bygget på Azure Blob Storage med et hierarkisk navnerum, som understøtter lagring i exabyte-skala, dataindlæsning i flere formater, POSIX-kompatible adgangskontroller og indbygget integration med Azures økosystem for analyse og maskinlæring.
Hvem er Azure Data Lake Storage bedst til?
Azure Data Lake Storage Gen2 er det naturlige valg for virksomheds-it- og datateams, der allerede kører på Microsoft Azure, og som har brug for lagring i exabyte-skala, der er tæt integreret med Synapse, Databricks og Microsoft Fabric.
Hvorfor valgte jeg Azure Data Lake Storage?
Jeg valgte Azure Data Lake Storage Gen2 som en af de bedste løsninger, fordi det er det indbyggede lagringsgrundlag for hele Microsofts analysestak, og denne tætte integration er vigtig i virksomhedsskala. Når din organisation bruger Synapse, Databricks og Microsoft Fabric, er ADLS Gen2 allerede det underliggende lag for det hele, hvilket betyder, at én kopi af data kan forespørges af alle motorer via ABFS-driveren. Jeg sætter især pris på de POSIX-kompatible ACL'er, som gør det muligt at angive læse-, skrive- og udførelsestilladelser på individuelt fil- og mappeniveau og ikke kun for containeren.
Vigtige funktioner i Azure Data Lake Storage
- Automatiseret livscyklusbaseret lagdeling: Indstil politikker, der automatisk flytter data mellem Hot-, Cool-, Cold- og Archive-lagene baseret på alder eller seneste adgangstidspunkt for at styre lageromkostningerne i stor skala.
- Kompatibilitet med ABFS-driveren: Azure Blob File System-driveren giver Hadoop-, Spark-, Hive- og HDFS-baserede arbejdsbelastninger indbygget læse- og skriveadgang til ADLS Gen2 uden kodeændringer.
- OneLake-genveje: Opret direkte referencer til data i andre OneLake-arbejdsområder, Amazon S3 eller Azure Blob Storage-containere uden at kopiere eller flytte de underliggende data.
- Integration med Azure Machine Learnings datalager: Registrer ADLS Gen2-containere direkte som datalagre i Azure ML-arbejdsområder, så dataforskere får direkte adgang til datasøens data til modeltræning og eksperimentering.
Integrationer med Azure Data Lake Storage
Azure Data Lake Storage har indbyggede integrationer på tværs af Microsofts økosystem, herunder Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning og Azure Event Hubs. Det understøtter også Apache Spark og Kafka via dokumenterede forbindelser samt ABFS og API'er til tilpasset dataadgang.
Pros and Cons
Pros:
- Indbygget integration på tværs af Microsofts analyseværktøjer
- Hierarkisk navnerum understøtter detaljeret adgangskontrol
- Åbne tabelformater via beregningslaget
Cons:
- Kræver Purview til avanceret datakatalogisering
- Kun tilgængelig på Microsoft Azure
Learn more about Azure Data Lake Storage:
Andre datalagerværktøjer
Her er nogle yderligere muligheder for datalagerværktøjer, som ikke kom med på min kortliste, men som stadig er værd at undersøge:
- 11IBM watsonx.dataBedst til åbent datasøhus med adgang til mainframedata
- 12Microsoft FabricBedst til datalake-integration i Microsoft-stakken
- 13StarburstBedst til fødereret SQL på tværs af datasøer i flere skyer
- 14Alibaba Cloud Hybrid CloudBedst til implementeringer af hybride cloud-datasøer i APAC
- 15Teradata VantageBedst til AI/ML-arbejdsbelastninger på datasødata i petabyte-skala
- 16MinIOBedst til AI og lokal lakehouse-lagring
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Sådan vælger du datalagerværktøjer
Hvilke faktorer har faktisk betydning for, om et datalagerværktøj kan levere den skala, styring og integration, som dit team har brug for til analysearbejdsbelastninger i den virkelige verden?
| Hvis din prioritet er... | Se efter... |
|---|---|
| Hvis din prioritet er...Overholdelse af lovgivning | Se efter...Indbygget revisionslogning og adgangspolitikker |
| Hvis din prioritet er...Implementering i flere cloudmiljøer eller hybridmiljøer | Se efter...Indbygget understøttelse af flere cloududbydere |
| Hvis din prioritet er...Uafhængighed af leverandører | Se efter...Kompatibilitet med åbne tabelformater |
| Hvis din prioritet er...Analyseydeevne i stor skala | Se efter...Lagopdelt lagring og indbygget forespørgselsintegration |
| Hvis din prioritet er...Parathed til AI og ML | Se efter...Direkte forbindelser til AI/ML-værktøjer og -motorer |
Sådan vurderer du din kortliste
- Bekræft styringsfunktionerne: Bed om skærmbilleder af administrationskonsollen, der viser rollebaseret adgangskontrol og opsætning af revisionslogge.
- Test understøttelse af åbne formater: Kør en liveindlæsning af Parquet- eller Iceberg-filer, og kontrollér skemaudviklingen i et testmiljø.
- Validér påstande om flere cloudmiljøer: Bed om offentlig dokumentation, der viser implementeringstrin hos mindst to cloududbydere.
- Kontrollér analysetilpasningen: Bed om et arbejdsgangseksempel eller en konfiguration til Spark, Trino eller Presto med dokumenterede forespørgselsresultater.
- Afvejning – virksomhedspakke kontra åbent lakehouse: Afgør, om du har brug for en komplet pakke med overholdelse af regler og support, eller om fleksibilitet og kompatibilitet med en åben stak er mere værdifuldt for din arkitektur.
Hvad er datalagerværktøjer?
Datalagerværktøjer er platforme og software, der hjælper dig med at gemme, administrere og analysere store mængder strukturerede og ustrukturerede data i et centralt lager. Disse værktøjer giver dit team mulighed for at indlæse rådata, anvende et skema efter behov og organisere aktiver til analyse- eller AI-projekter. Du kan forvente funktioner, der understøtter styring, skalerbarhed og integration med populære forespørgselsmotorer og analyseplatforme.
Funktioner i datasøværktøjer
Ved valg af datasøværktøjer bør du holde øje med følgende vigtige funktioner:
- Skalerbar objektlagring: Giver dig mulighed for at gemme og administrere petabytes af strukturerede og ustrukturerede data med muligheder for lagdelt lagring eller kold lagring, så du kan styre omkostningerne, efterhånden som dit lagerbehov vokser.
- Understøttelse af skema ved læsning: Gør det muligt først at indlæse rå data og anvende et skema senere på forespørgselstidspunktet, hvilket gør det nemmere at håndtere forskellige datasæt i udvikling uden at genindlæse dem.
- Dataindlæsning i flere formater: Understøtter import af data i forskellige formater som Parquet, Avro, JSON, ORC og CSV og kan håndtere både batch- og streamingdatakilder, hvilket giver større fleksibilitet i måden, data ankommer på.
- Integration med forespørgselsmotorer: Giver kompatibilitet med motorer som Spark, Trino, Presto eller Athena, så du kan køre analyse- og rapporteringsarbejdsbelastninger direkte mod din datasø uden ekstra mellemliggende software.
- Administration af metadata og kataloger: Indeholder værktøjer til datakatalogisering, søgning efter aktiver, sporing af dataoprindelse og tagging, så du kan holde data organiseret og søgbare, efterhånden som nye datasæt tilføjes.
- Styring og adgangskontroller: Tilbyder detaljerede tilladelser, kryptering og revisionslogning, så du kan kontrollere, hvem der har adgang til hvilke data, overvåge brugen og overholde lovgivningsmæssige krav.
- Data-versionering og tidsrejser: Giver dig mulighed for at spore ændringer, rulle tilbage til tidligere versioner af datasæt og vedligeholde historiske visninger, hvilket er værdifuldt i forbindelse med revision, gendannelse og reproducerbarhed.
- Integration med orkestreringsværktøjer: Opretter forbindelse direkte til arbejdsprocesorkestratorer som Apache Airflow, så du kan automatisere datapipelines og koordinere opgaver på tværs af systemer.
- Værktøjer til overvågning og omkostningsstyring: Giver dashboards og advarsler om lagerforbrug, adgangsmønstre og omkostninger, så du kan holde dit miljø effektivt og budgetvenligt.
- Understøttelse af åbne tabelformater: Kan håndtere formater som Delta Lake eller Apache Iceberg, hvilket muliggør avancerede funktioner som ACID-transaktioner og interoperabilitet med flere analyseværktøjer.
Almindelige AI-funktioner i datasøværktøjer
Ud over de almindelige funktioner i datasøværktøjer, der er nævnt ovenfor, integrerer mange af disse løsninger AI med funktioner som:
- Automatisk dataklassificering: Bruger AI-modeller til at scanne og kategorisere indkommende data baseret på indhold, følsomhed eller krav til overholdelse. Det hjælper dit team med hurtigere at organisere aktiver og anvende de rigtige adgangskontroller uden manuel tagging.
- Afvigelsesregistrering for datakvalitet: Anvender maskinlæringsalgoritmer til at overvåge datastrømme og markere usædvanlige mønstre, manglende værdier eller afvigende observationer. Det gør det muligt at opdage problemer med dataintegriteten tidligt og reducere risikoen for fejlagtige analyser eller efterfølgende fejl.
- Forudsigende optimering af arbejdsbelastninger: Bruger AI til at analysere historiske forespørgselsmønstre og lagerforbrug og anbefaler eller anvender derefter automatisk optimeringer som partitionering, caching eller skalering af ressourcer. Det hjælper dig med at opretholde ydeevnen og styre omkostningerne, efterhånden som brugen vokser.
- Forespørgselsgrænseflader på naturligt sprog: Integrerer AI-drevne chat- eller søgeværktøjer, der lader brugere stille spørgsmål om data på almindeligt sprog. Det gør det nemmere for ikke-tekniske brugere at udforske datasæt og skabe indsigt uden at skrive SQL eller kode.
- Automatisk berigelse af metadata: Bruger AI til at udtrække kontekst, relationer og forretningsbegreber fra rå data og udfylder derefter datakataloget med mere detaljerede beskrivelser og oplysninger om dataoprindelse. Det gør det nemmere for teams at opdage, have tillid til og genbruge dataaktiver.
Fordele ved datasøværktøjer
Implementering af datasøværktøjer giver flere fordele for dit team og din virksomhed. Her er nogle af dem, du kan se frem til:
- Centraliseret datastyring: Datasøværktøjer giver dig mulighed for at gemme strukturerede og ustrukturerede data ét sted, hvilket gør det nemmere at organisere aktiver og understøtte analyse- eller AI-projekter.
- Skalerbarhed til arbejdsbelastninger i petabyte-skala: Disse platforme kan håndtere enorme datamængder og understøtte både cloud- og lokalbaserede lagringsniveauer, så du kan tilpasse dig voksende behov uden at skulle redesigne arkitekturen.
- Fleksibel dataindlæsning: Du kan indlæse data fra en lang række formater og kilder samt håndtere både batch- og datastrømme i realtid takket være indbyggede forbindelser og formatunderstøttelse.
- Detaljeret styring og adgangskontrol: Finkornede tilladelser, kryptering og revisionslogning hjælper dig med at opretholde sikkerhed og overholdelse af standarder som HIPAA, SOC 2 og GDPR.
- Integration med analyse- og AI-værktøjer: Indbygget kompatibilitet med forespørgselsmotorer som Spark, Trino og Presto—samt direkte forbindelser til AI/ML-værktøjer—betyder, at du kan analysere data uden forsinkelser eller ekstra integrationsarbejde.
- Automatiseret håndtering af metadata og datakvalitet: Mange platforme omfatter kataloger, sporing af dataoprindelse og AI-drevne værktøjer, der hjælper dig med at berige metadata, klassificere data og opdage uregelmæssigheder for at opretholde dataintegriteten.
- Understøttelse af åbne tabelformater og avancerede anvendelser: Funktioner som kompatibilitet med Delta Lake eller Apache Iceberg muliggør ACID-transaktioner, dataversionsstyring og datadeling uden kopiering for at understøtte mere avancerede analyser og multi-cloud-arkitekturer.
Omkostninger og priser på datasøværktøjer
Valg af datasøværktøjer kræver en forståelse af de forskellige prismodeller og abonnementer, der er tilgængelige. Omkostningerne varierer afhængigt af funktioner, teamstørrelse, tilføjelser med mere. Tabellen nedenfor opsummerer almindelige abonnementer, deres gennemsnitlige priser og typiske funktioner, der er inkluderet i løsninger med datasøværktøjer:
Sammenligningstabel for abonnementer på datasøværktøjer
| Abonnementstype | Gennemsnitlig pris | Almindelige funktioner |
|---|---|---|
| AbonnementstypeGratis abonnement | Gennemsnitlig pris$0 | Almindelige funktionerGrundlæggende objektlagring, begrænset dataindlæsning, understøttelse af skema ved læsning og integration med én forespørgselsmotor. |
| AbonnementstypePersonligt abonnement | Gennemsnitlig pris$50–$300/måned | Almindelige funktionerStørre lagergrænser, understøttelse af flere dataformater, grundlæggende katalogisering og integration med analyseværktøjer. |
| AbonnementstypeVirksomhedsabonnement | Gennemsnitlig pris$1,000–$5,000/måned | Almindelige funktionerLagring i petabyte-skala, avancerede styringskontroller, muligheder for flere cloudmiljøer og funktioner til datakatalogisering. |
| AbonnementstypeAbonnement til store virksomheder | Gennemsnitlig pris$10,000+/måned | Almindelige funktionerUbegrænset lagring, fulde funktioner til overholdelse af krav, AI-drevet automatisering, integration med orkestreringsværktøjer og førsteklasses support. |
Ofte stillede spørgsmål om datalakeværktøjer
Her er nogle svar på almindelige spørgsmål om datalakeværktøjer:
Hvordan håndterer datalakeværktøjer krav til sikkerhed og overholdelse af regler?
Datalakeværktøjer anvender sikkerhed gennem adgangskontroller, kryptering og revisionslogning. De fleste førende platforme understøtter detaljerede tilladelser helt ned på række- eller kolonneniveau samt integrationer med SSO- og identitetsudbydere. Når det gælder overholdelse af regler, bør du se efter leverandørcertificeringer som SOC 2, HIPAA eller GDPR samt muligheder for krypteringsnøgler, der administreres af kunden. Disse funktioner hjælper dig med at opfylde lovgivningsmæssige krav uden at skulle opbygge ekstra lag.
Kan datalakeværktøjer integreres med eksisterende analyse- eller BI-platforme?
Ja, de fleste datalakeværktøjer tilbyder direkte forbindelser til analyse- og BI-platforme. Du kan forvente indbygget understøttelse af Spark, Trino, Presto og Athena samt integrationer med Tableau og Power BI. Hvis dine teams bruger specialiserede værktøjer, bør du undersøge, om der findes åbne API’er eller ODBC/JDBC-drivere, som gør det muligt at forbinde tilpassede arbejdsgange.
Hvad er forskellen på datalakeværktøjer og datalagre?
Datalakeværktøjer fokuserer på lagring af rå, semistrukturerede og ustrukturerede data ved hjælp af skema ved læsning, mens datalagre gemmer strukturerede data med foruddefinerede skemaer (skema ved skrivning). Datalakes er bedre til fleksibel dataindlæsning og AI/ML-arbejdsbelastninger, mens datalagre egner sig til kurateret analyse med optimeret forespørgselsydeevne. Nogle leverandører tilbyder nu lakehouse-arkitekturer, der kombinerer begge tilgange.
Understøtter datalakeværktøjer flere dataformater og typer af dataindlæsning?
Ja, de fleste datalakeværktøjer accepterer en lang række formater såsom Parquet, Avro, JSON, ORC og CSV. Du finder også understøttelse af både batch- og streamingdatakilder, hvilket gør det muligt at håndtere alt fra daglige indlæsningsjob til hændelsesstrømme i realtid ved hjælp af forudbyggede eller tilpassede forbindelser.
Hvordan vurderer man datalakeværktøjer med hensyn til skalerbarhed?
Jeg ser på hver platforms muligheder for objektlagring, ydeevne ved belastninger i petabyteskala og understøttelse af flere cloudmiljøer. Muligheden for at inddele lagring i niveauer, behandle data på tværs af regioner og undgå flaskehalse med formater som Delta Lake eller Iceberg er afgørende. Sørg for at kontrollere dokumenterede benchmarks og indhente referencer fra kunder med datamængder, der ligner dine.
Er åbne tabelformater som Delta Lake eller Apache Iceberg vigtige?
Ja, åbne tabelformater er vigtige, hvis du ønsker ACID-transaktioner, versionsstyring og leverandøruafhængig datahåndtering. De gør det muligt at aktivere funktioner som tidsrejse og datadeling uden kopiering. Hvis du sigter mod en lakehouse-model eller ønsker at fremtidssikre din arkitektur, bør du insistere på kompatibilitet med åbne formater i dit datalakeværktøj.