

Databricks er effektiv, men det er ikke altid den rette løsning. Måske er dit team stødt på en mur på grund af priserne, har haft svært ved at lære platformen at kende eller har brug for noget mere fleksibelt til opsætninger på tværs af flere cloudmiljøer eller lokalt. Uanset hvad er du sandsynligvis på udkig efter et alternativ, der tilbyder lignende lakehouse-funktionalitet uden kompromiserne.
Jeg har arbejdet sammen med datateams i både startups og større virksomheder for at evaluere og implementere platforme som Databricks, Snowflake og andre. Jeg har på egen hånd set, hvad der skal til for at understøtte analyser i stor skala, samle rodede datakilder og opbygge pålidelige datapipelines, der rent faktisk bliver brugt.
I denne guide gennemgår jeg de Databricks-alternativer, der er værd at overveje – værktøjer, som hjælper dig med at lagre, transformere og udforske data på en mere intuitiv måde, samtidig med at du får plads til at skalere og tilpasse dig, efterhånden som dit team vokser.
Hvorfor du kan stole på vores softwareanbefalinger
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vores team har testet og anmeldt software siden 2012. Vi er selv teknologiledere, så vi ved, hvor svært og hvor vigtigt det er at vælge den rigtige software.
Til denne guide har vi vurderet værktøjerne gennem praktisk afprøvning og uafhængig research og givet dem point ud fra vores udvælgelseskriterier.
Vores anmeldelser bygger på vores egen redaktionelle vurdering. De er ikke et salgsargument.
Ekspertanmeldere:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel: Konkurrenter til Databricks
Denne sammenligningstabel opsummerer prisoplysningerne for mine bedste udvalgte konkurrenter til Databricks.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til cloud-datavarehuse | Nej | Priser oplyses efter anmodning | Website | |
| 2 | Bedst til datadistribution på tværs af flere cloudmiljøer | Gratis abonnement tilgængeligt | Priser oplyses efter forespørgsel | Website | |
| 3 | Bedst til dataintegrationsopgaver | Gratis prøveperiode tilgængelig | $1,170/bruger/år (faktureres årligt) | Website | |
| 4 | Bedst til behandling i hukommelsen | Gratis abonnement er tilgængeligt | Priser oplyses efter anmodning | Website | |
| 5 | Bedst til hurtige SQL-forespørgsler | Ja | Fra $6.25/TiB behandlet | Website | |
| 6 | Bedst til virksomheders databasebehov | Gratis prøveperiode tilgængelig | $68/bruger/måned (faktureret årligt) | Website | |
| 7 | Bedst til SQL-analyse | 30-dages gratis prøveperiode | $30/bruger/måned (faktureres årligt) | Website | |
| 8 | Bedst til Hadoop-behandling | Ikke tilgængelig | Fra $0.007084/vCPU-time | Website | |
| 9 | Bedst til administreret Spark og Hadoop | Ikke tilgængelig | Fra $0.06/DCU-hour | Website | |
| 10 | Bedst til AI- og ML-løsninger | Gratis demo tilgængelig | Priser oplyses efter forespørgsel | Website |


Anmeldelser af de bedste konkurrenter til Databricks
Nedenfor finder du mine detaljerede opsummeringer af de bedste konkurrenter til Databricks, som kom med på min korte liste. Mine anmeldelser giver et detaljeret indblik i de vigtigste funktioner, fordele & ulemper, integrationer og ideelle anvendelsesområder for hvert værktøj, så du kan finde det bedste til dig.

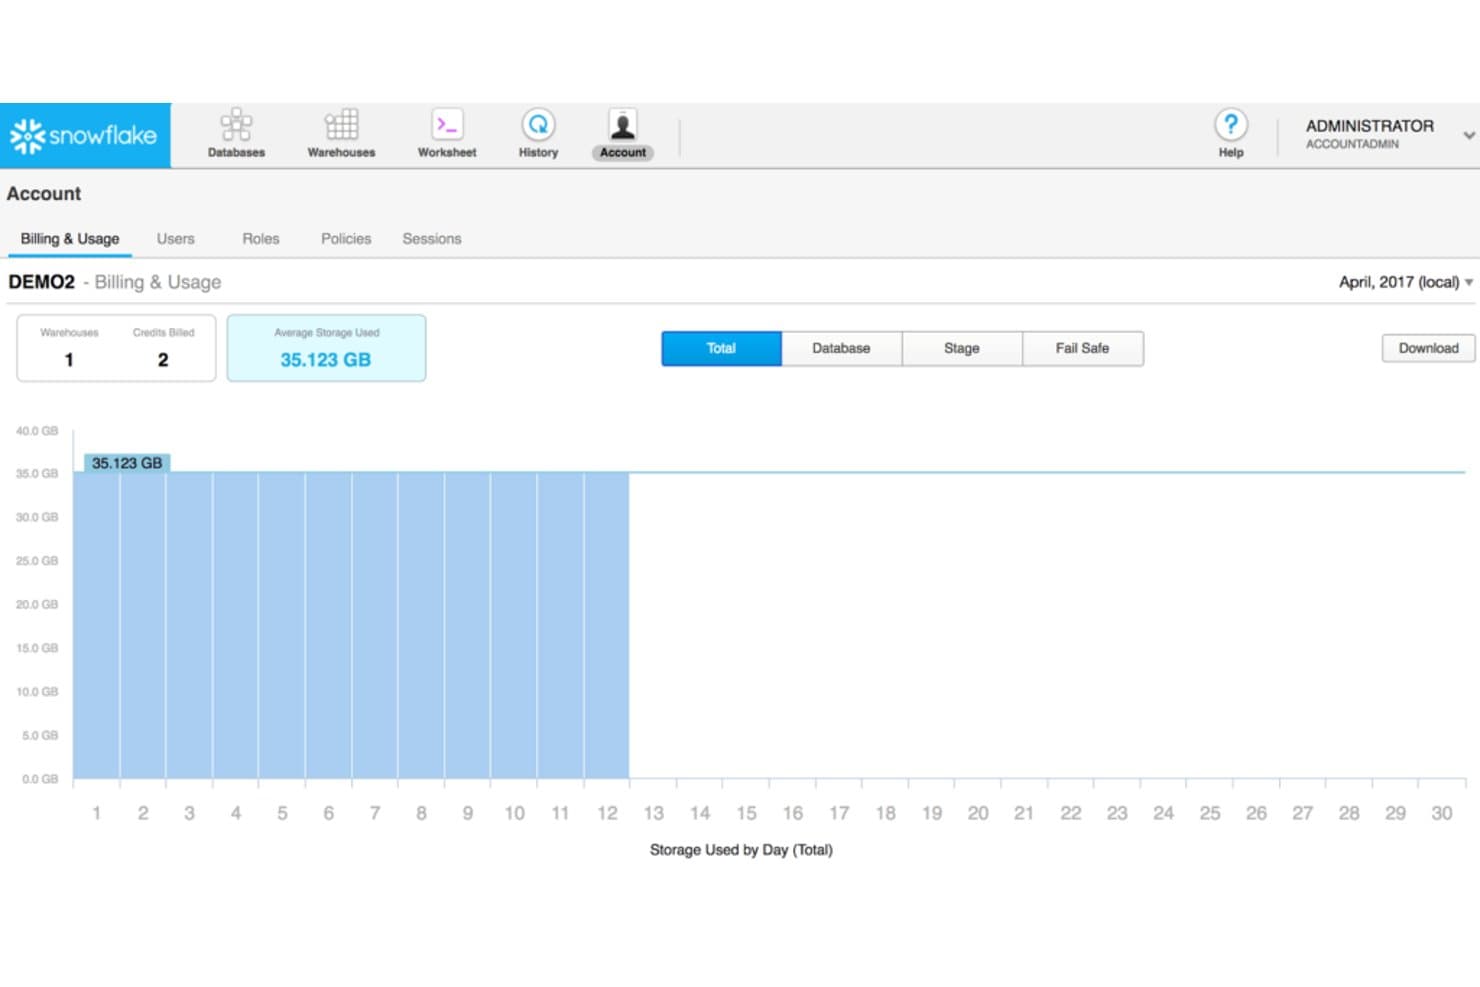
Snowflake registrerer lager- og kreditforbrug pr. dag i ét dashboard. Snowflake giver it- og analyseteams en clouddataplatform til at samle forskellige datasæt, køre SQL-forespørgsler i stor skala og give styret adgang uden at administrere lagerinfrastruktur.
Hvem er Snowflake bedst til?
Datateknik- og analyseteams, der har brug for et cloud-datavarehus til at forespørge på og dele data på tværs af forretningssystemer.
Hvorfor valgte jeg Snowflake?
Jeg valgte Snowflake som “Bedst til cloud-datavarehuse”, fordi den separate lagring og beregning gør det muligt for mig at skalere SQL-analyser uden at ændre størrelsen på datalaget. Jeg sætter også pris på den styrede datadeling, når teams har brug for at forespørge på datasæt på tværs af forretningssystemer uden at kopiere dem til separate datavarehuse.
Vigtige funktioner i Snowflake
- Dynamiske tabeller: Definer datapipelines med SQL, og angiv den ønskede opdateringsforsinkelse.
- Snowpipe: Indlæs data fra klargjorte filer, efterhånden som de ankommer.
- Tidsrejse: Forespørg på, klon eller gendan historiske data inden for opbevaringsperioden.
- Snowflake-markedspladsen: Find og få adgang til tredjepartsdatasæt og -applikationer.
Snowflake-integrationer
Snowflake tilbyder Openflow-forbindelser til Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL og Microsoft SQL Server. Den tilbyder også indbyggede forbindelser til ServiceNow, MySQL og Kafka samt REST API'er til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Uafhængig skalering af beregningskapaciteten håndterer udsving i arbejdsbelastningen
- Administrerede SQL-datavarehuse reducerer behovet for vedligeholdelse af infrastrukturen
- Sikker deling undgår kopiering af datasæt mellem teams
Cons:
- Forbrugsspidser kan gøre omkostningerne uforudsigelige
- Proprietære funktioner kan vanskeliggøre migrering af platformen
Learn more about Snowflake: Bedst til datadistribution på tværs af flere cloudmiljøer
- Gratis abonnement tilgængeligt
- Priser oplyses efter forespørgsel
Visit WebsiteCustomer Rating:4.5/5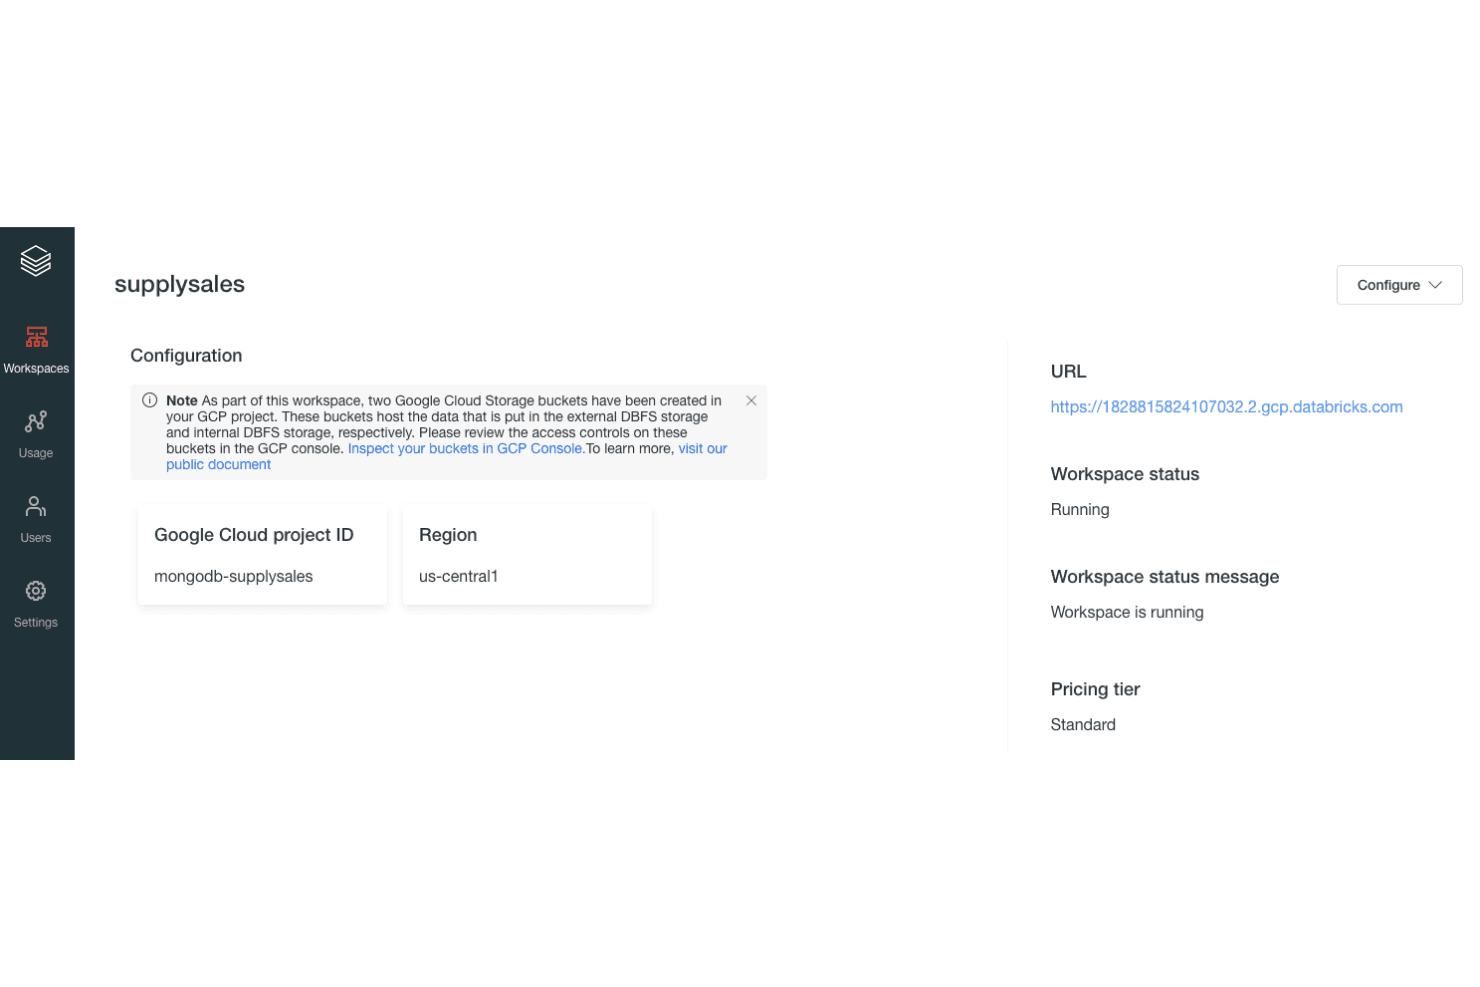
MongoDB Atlas integreres med Databricks-arbejdsområder på GCP til databehandling. MongoDB Atlas giver IT- og datateams en administreret dokumentdatabase til applikationer, der har brug for fleksible datamodeller, pålidelige forespørgsler og mindre databasevedligeholdelse.
Hvem er MongoDB Atlas bedst til?
IT- og platformteams, der implementerer applikationer på tværs af flere cloududbydere, vil sætte pris på MongoDB Atlas’ administrerede database og fleksibilitet på tværs af flere cloudmiljøer.
Hvorfor jeg valgte MongoDB Atlas
Jeg valgte MongoDB Atlas som et alternativ til Databricks til Bedst til datadistribution på tværs af flere cloudmiljøer. Atlas understøtter multi-cloud-klynger på tværs af AWS, Azure og Google Cloud, mens dens aggregeringspipeline lader dig analysere applikationsdata, der er gemt i MongoDB. Jeg ville bruge den til at forespørge på operationelle data tæt på tjenester, der kører på tværs af forskellige cloududbydere.
Vigtige funktioner i MongoDB Atlas
- Atlas-søgning: Opret fuldtekstindekser, og kør søgninger rangeret efter relevans.
- Atlas-diagrammer: Opret dashboards og visualiseringer ud fra MongoDB-data.
- Dataføderation: Forespørg på data på tværs af Atlas-databaser og cloudbaseret objektlagring.
- Automatiserede sikkerhedskopier: Planlæg databaseøjebliksbilleder, og gendan fra gemte punkter.
Integrationer med MongoDB Atlas
MongoDB Atlas dokumenterer integrationer med Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta og Microsoft Entra ID. Det tilbyder også en administrations-API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Multi-cloud-klynger på tværs af AWS, Azure og Google Cloud
- Fleksible dokumenter understøtter skiftende applikationsdatamodeller
- Aggregeringspipelines analyserer operationelle data på stedet
Cons:
- Mindre velegnet til brede lakehouse-analysearbejdsbelastninger
- Aggregeringsydelsen kan kræve omhyggelig optimering af forespørgsler
Learn more about MongoDB Atlas: Bedst til dataintegrationsopgaver
- Gratis prøveperiode tilgængelig
- $1,170/bruger/år (faktureres årligt)
Visit WebsiteCustomer Rating:4.2/5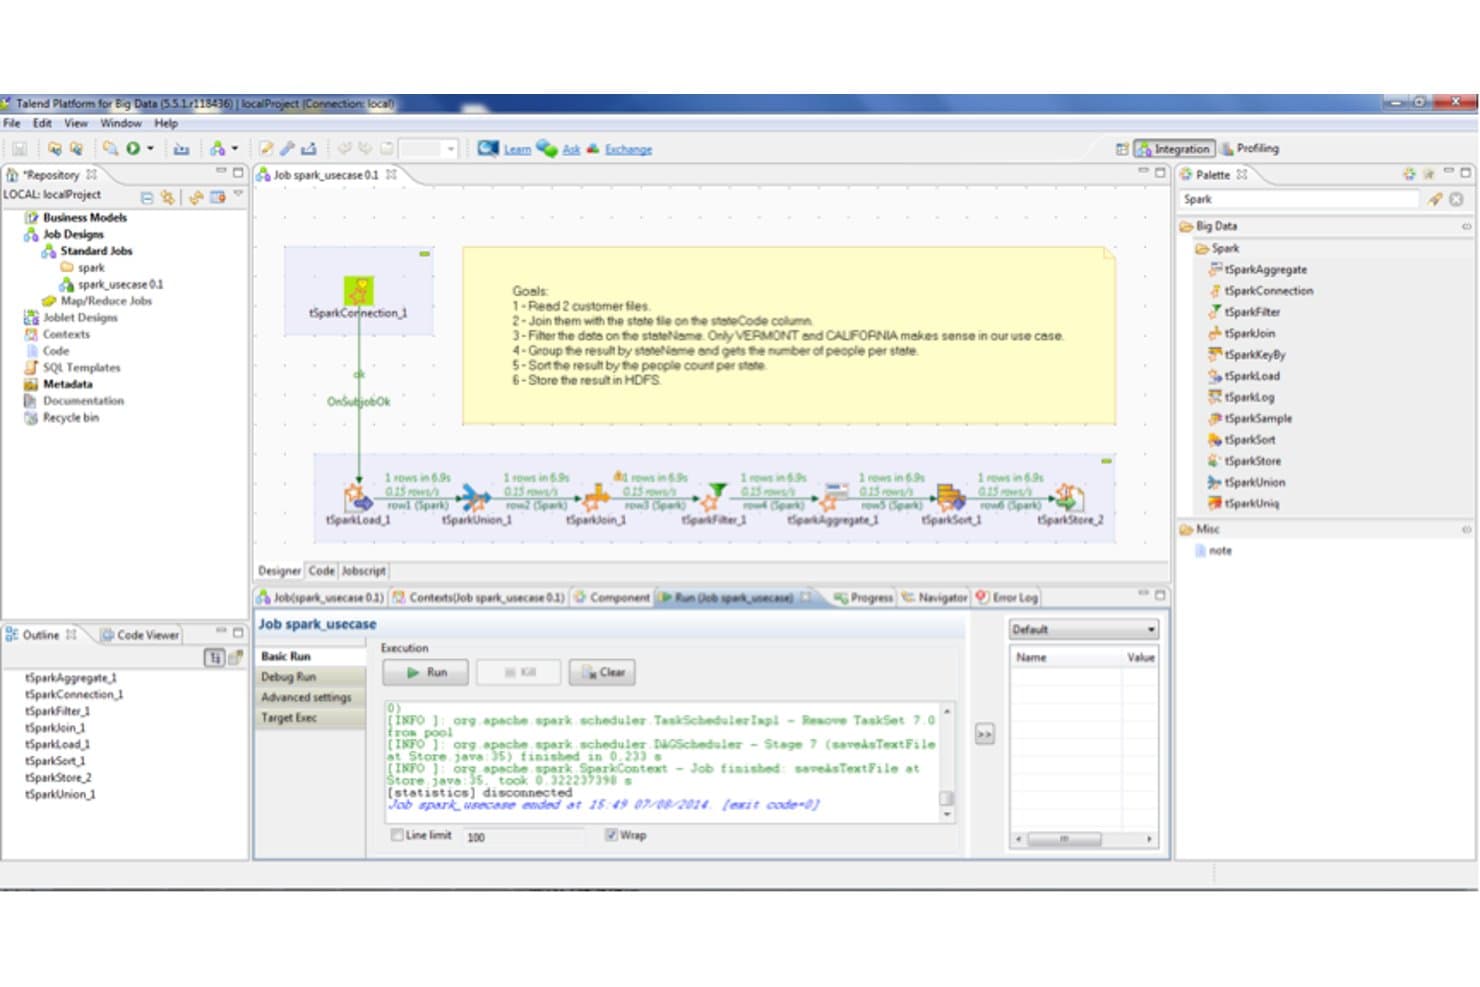
Talend lader brugere opbygge og køre Spark-datapipelines visuelt. Talend er en dataintegrationsplatform for it- og datateams, der forbinder oplysninger på tværs af systemer og hjælper med at reducere siloer og holde datapipelines håndterbare, efterhånden som miljøerne vokser.
Hvem er Talend bedst til?
Talend er velegnet til it- og datateknikteams, der har brug for at forbinde skybaserede, lokale og ældre systemer.
Hvorfor jeg valgte Talend
Jeg valgte Talend som en konkurrent til Databricks, fordi “Bedst til dataintegrationsopgaver” præcis beskriver, hvor det passer ind. Den visuelle jobdesigner og tMap-transformationerne lader mig sammenføje og omforme poster mellem en ældre database og et skybaseret datavarehus. Jeg sætter også pris på Talends datakvalitetskomponenter til at fange fejlformaterede poster, før de når de efterfølgende systemer.
Talends vigtigste funktioner
- Forbindelser: Forbind databaser, skyapplikationer, filer og andre systemer via forudbyggede forbindelser.
- Registrering af dataændringer: Registrer databaseindsættelser, -opdateringer og -sletninger, efterhånden som de sker.
- Datasporbarhed: Spor dataflows fra kildesystemer gennem jobs til deres destinationer.
- Metadatasøgning: Scan datakilder for at identificere datasæt, formater og mønstre.
Talend-integrationer
Talend omfatter forbindelser eller komponenter til systemer som Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle og MongoDB. Det understøtter også REST- og SOAP-tjenester, og Qlik Talend Data Integration leverer API'er til administration af dataforbindelser.
Pros and Cons
Pros:
- Visuelle jobs håndterer sammenføjninger og omformning
- Batch- og realtidspipelines understøtter forskellige arbejdsbelastninger
- Datakvalitetsværktøjer markerer fejlformaterede poster
Cons:
- Store jobs kan kræve justering af JVM
- Genereret Java gør fejlfinding og revisioner mere komplekse
Learn more about Talend: Bedst til behandling i hukommelsen
- Gratis abonnement er tilgængeligt
- Priser oplyses efter anmodning
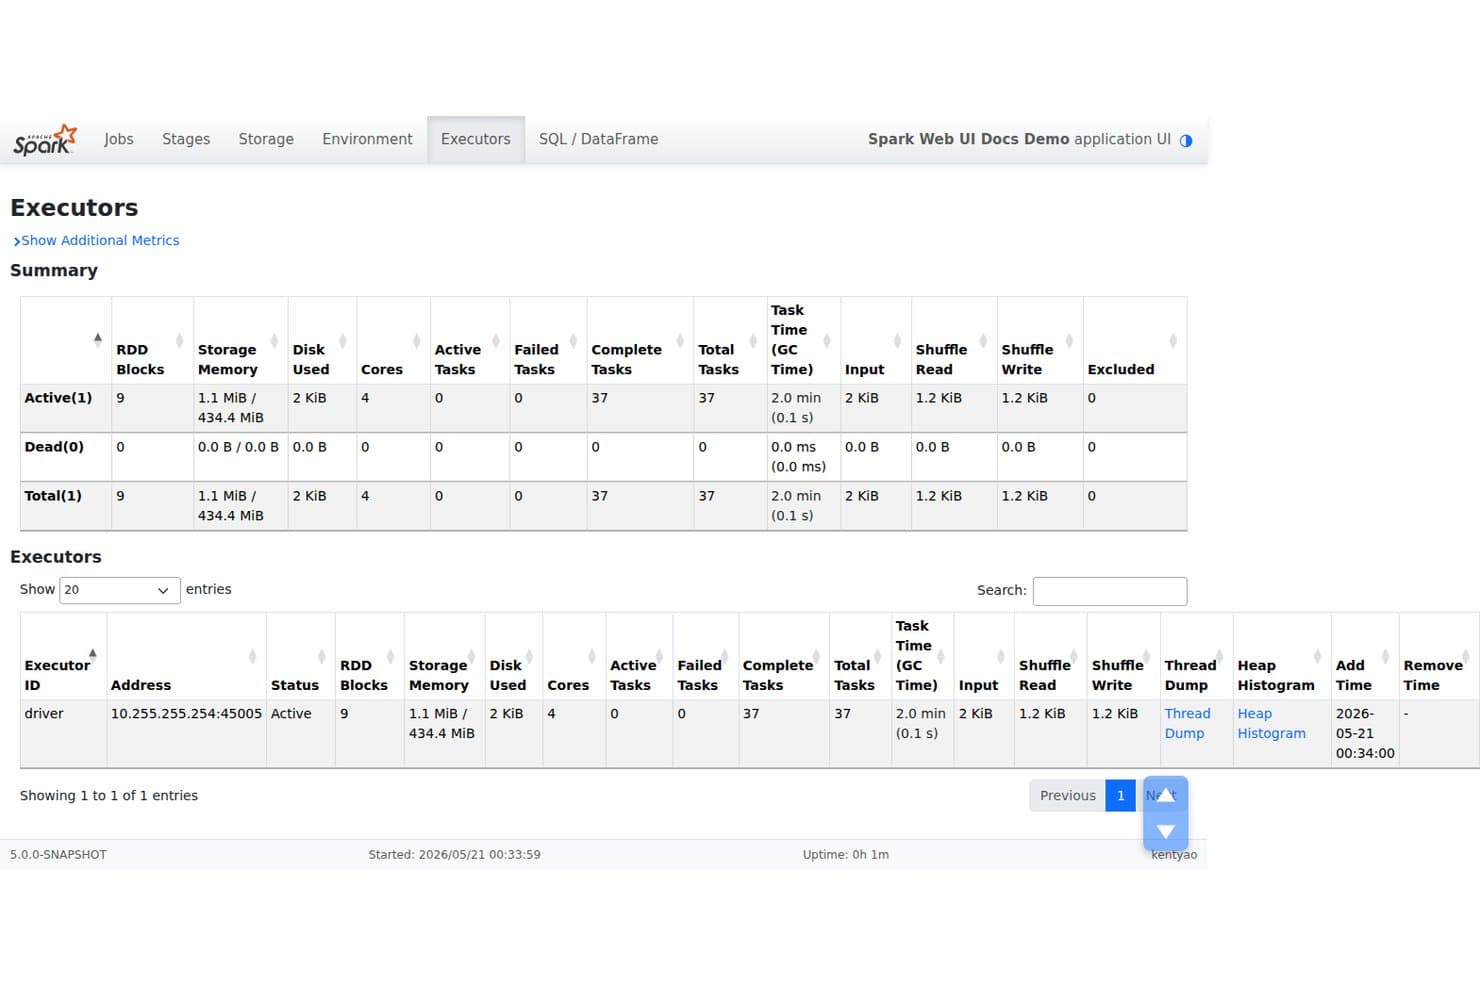
Apache Spark sporer eksekveringsressourcer, opgaver og hukommelse i realtid. Apache Spark er en open source-analysemotor til datateknik- og infrastrukturteams, der har brug for at behandle store datasæt, køre distribuerede arbejdsbelastninger og opbygge datapipelines på tværs af forskellige miljøer.
Hvem er Apache Spark bedst egnet til?
Datateknik- og analyseteams, der har brug for hurtig, iterativ behandling af store datasæt på tværs af klynger, passer godt til Apache Spark.
Hvorfor valgte jeg Apache Spark?
Jeg valgte Apache Spark som et alternativ til Databricks, fordi det er bedst til behandling i hukommelsen. Spark kan cache eller persistere RDD'er og DataFrames i hukommelsen, så gentagne forespørgsler og iterative beregninger undgår at læse kildedata igen. Det er nyttigt ved finjustering af store aggregater af hændelsesdata på tværs af flere analysegennemgange.
Apache Sparks vigtigste funktioner
- Spark SQL: Forespørg på strukturerede data med SQL- og DataFrame-API'er.
- Structured Streaming: Behandl live-data med Sparks streaming-API'er.
- MLlib: Opbyg maskinlæringsarbejdsgange med skalerbare algoritmer og pipelines.
- Klyngemanagere: Implementer applikationer på selvstændige klynger, YARN eller Kubernetes.
Apache Spark-integrationer
Apache Spark understøtter forbindelser til Apache Kafka og Apache Hive samt JDBC-forbindelser til databaser som PostgreSQL, MySQL, Oracle og Microsoft SQL Server. Dets datakilde-API understøtter brugerdefinerede forbindelser; afhængigheder til Kafka-forbindelsen og databasespecifikke JDBC-drivere skal muligvis tilføjes separat.
Pros and Cons
Pros:
- Cachede datasæt gør iterative arbejdsbelastninger hurtigere
- Batchbehandling, streaming, SQL og maskinlæring deler én motor
- Kører lokalt eller på tværs af Kubernetes- og YARN-klynger
Cons:
- Hukommelsespres kan udløse fejl på grund af utilstrækkelig hukommelse
- Finjustering og fejlfinding af distribuerede job kræver ekspertise
Learn more about Apache Spark:
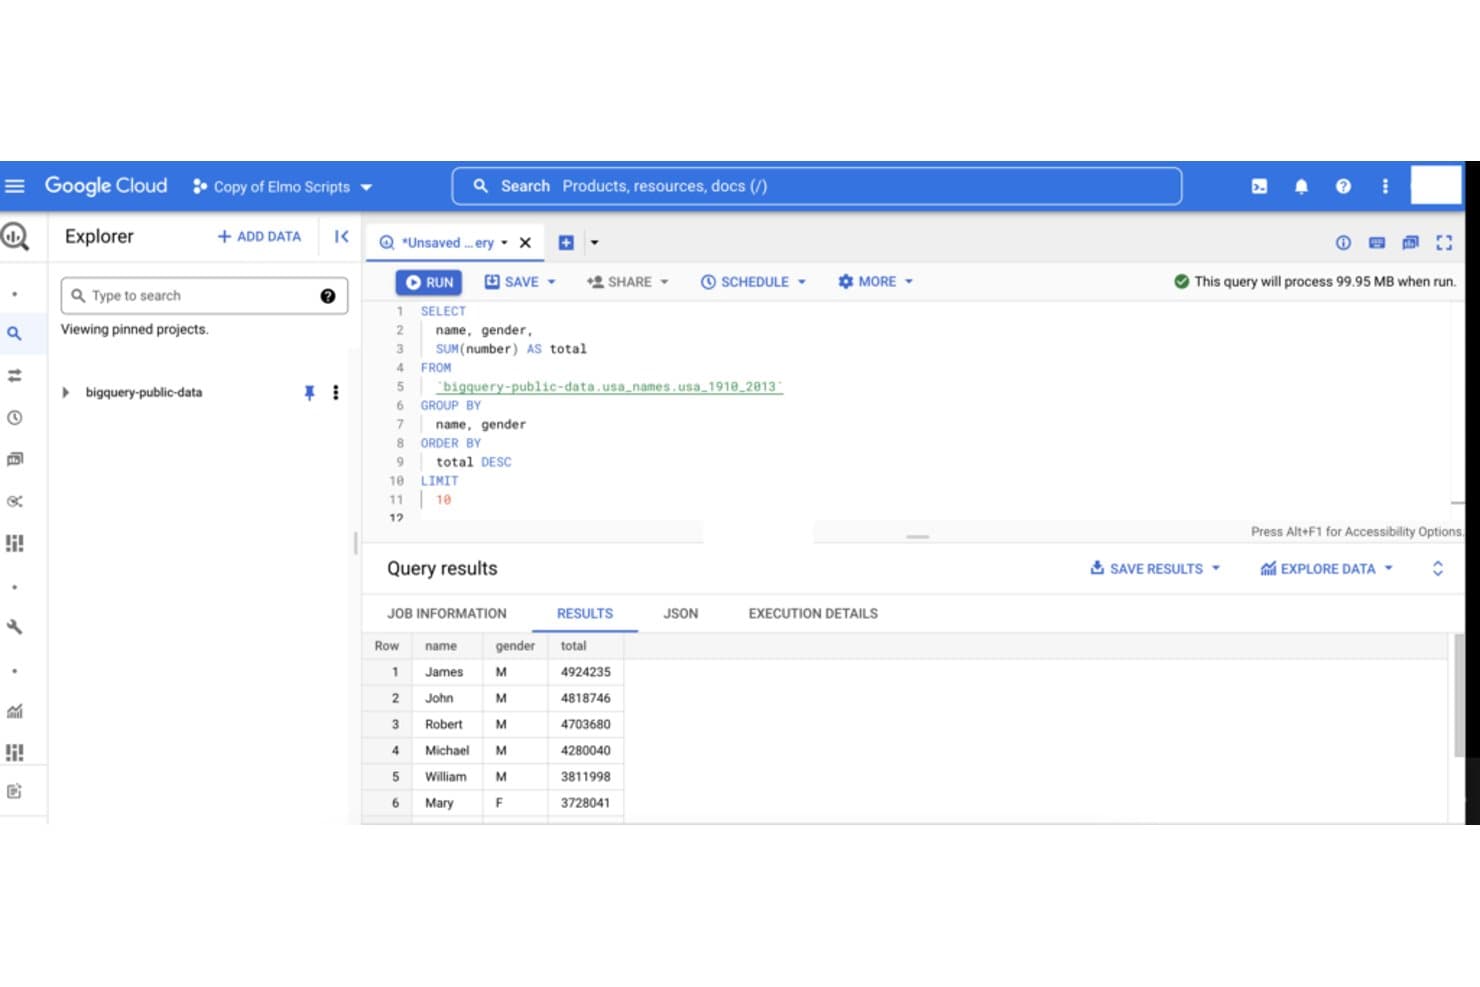
Google BigQuery giver brugerne mulighed for at køre SQL-forespørgsler på store offentlige datasæt. For IT- og datateams, der har brug for skalerbare analyser uden at administrere lagerinfrastruktur, er Google BigQuery et cloud-datavarehus til forespørgsler på og analyse af store datasæt ved hjælp af SQL.
Hvem er Google BigQuery bedst til?
Dataanalytikere og -ingeniører, der har brug for at køre hurtige SQL-forespørgsler på tværs af store cloud-datasæt, vil finde Google BigQuery velegnet.
Hvorfor valgte jeg Google BigQuery?
Jeg valgte Google BigQuery som mit alternativ til Databricks, der er “Bedst til hurtige SQL-forespørgsler”. Dets serverløse forespørgselsmotor kører GoogleSQL på tværs af store datasæt, mens tabelpartitionering og klyngedannelse kan reducere mængden af data, der scannes, for tilbagevendende rapporter. Jeg kan godt lide det til forespørgsler på applikationslogge eller hændelsesdata uden at skulle administrere datavarehusklynger.
Vigtigste funktioner i Google BigQuery
- BigQuery ML: Opret og kør maskinlæringsmodeller med SQL.
- Planlagte forespørgsler: Indstil SQL-job til at køre med valgte intervaller.
- BigQuery-tjenesten til dataoverførsel: Planlæg dataimporter fra understøttede kilder.
- Autoriserede visninger: Del forespørgselsresultater uden at give adgang til de underliggende tabeller.
Integrationer med Google BigQuery
Google dokumenterer direkte BigQuery-integrationer med Looker, Looker Studio, Vertex AI Workbench, Administreret tjeneste til Apache Spark og Tableau. Dataforbindelser og indlæsningsarbejdsgange understøtter også Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 og Azure Blob Storage; BigQuerys REST- og Storage-API'er understøtter brugerdefinerede integrationer.
Pros and Cons
Pros:
- Hurtige SQL-scanninger på tværs af store datasæt
- Serverløs drift eliminerer klyngestyring
- Partitionering og klyngedannelse kan reducere mængden af scannede data
Cons:
- Forespørgselsomkostningerne kan stige kraftigt uden kontrolforanstaltninger
- Udforskning for forretningsbrugere kræver ofte ekspertise i SQL
Learn more about Google BigQuery: Bedst til virksomheders databasebehov
- Gratis prøveperiode tilgængelig
- $68/bruger/måned (faktureret årligt)
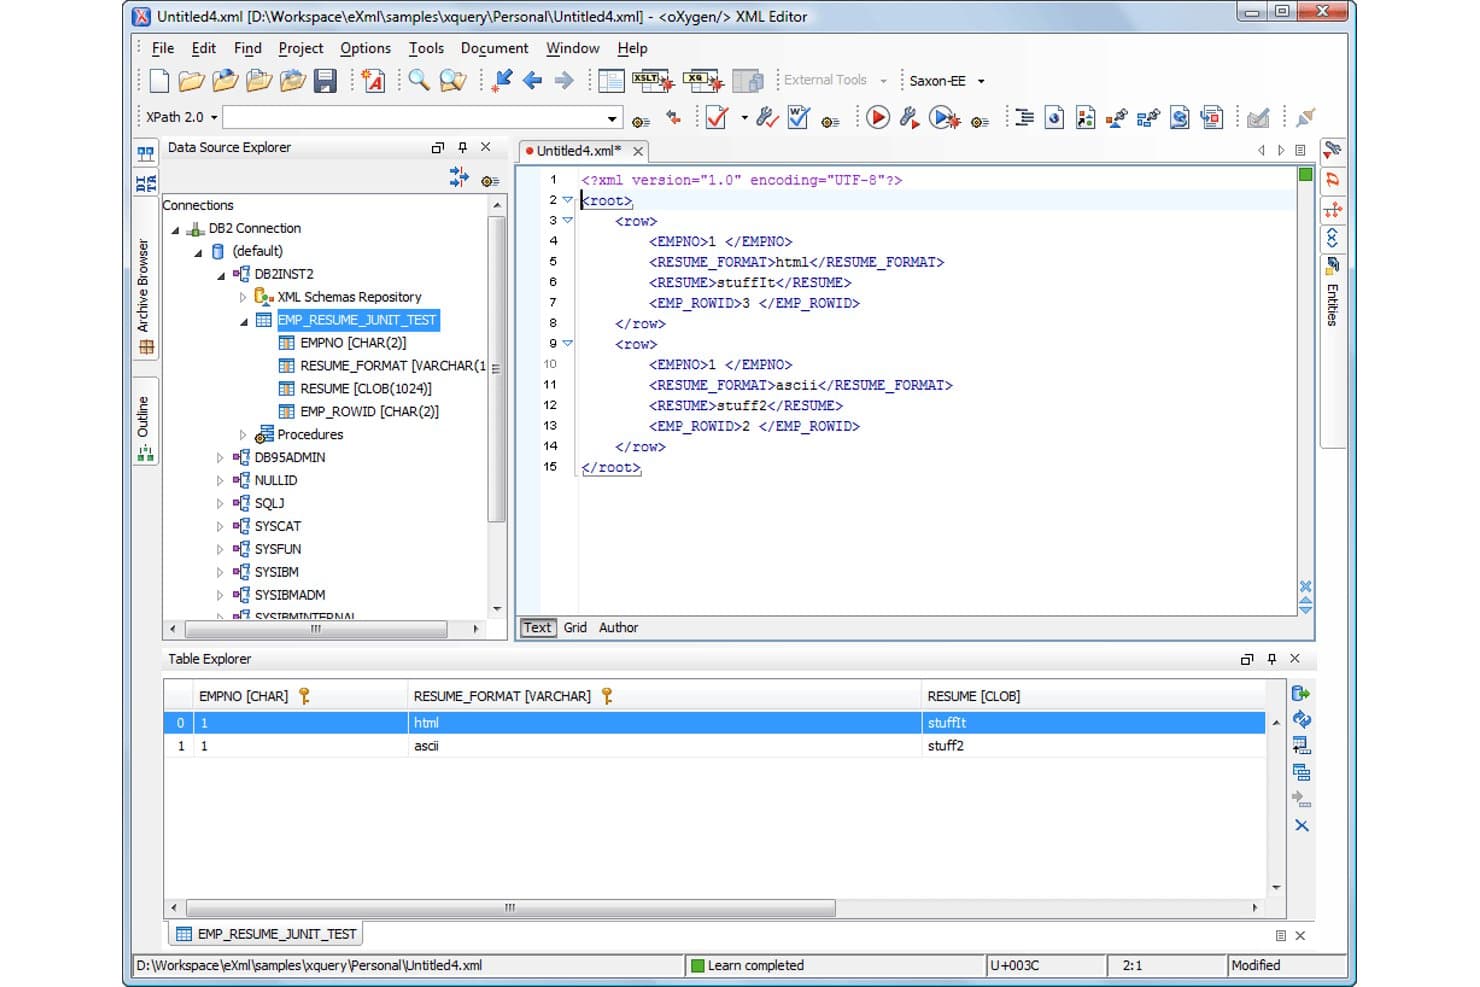
IBM Db2 giver brugerne mulighed for visuelt at gennemse databaseskemaer og forespørge XML-data. IBM Db2 er et relationsdatabasestyringssystem til organisationer, der har behov for at køre arbejdsbelastninger med strukturerede data på tværs af komplekse miljøer og understøtter teams, der administrerer virksomhedsapplikationer, transaktioner og analyser.
Hvem er IBM Db2 bedst egnet til?
Databaseadministratorer og it-teams i store organisationer, der understøtter forretningsapplikationer med store datamængder.
Hvorfor jeg valgte IBM Db2
Jeg valgte IBM Db2, der er bedst egnet til virksomheders databasebehov, som et alternativ til Databricks til centrale forretningssystemer. Det understøtter transaktionsdata, analytiske data og vektordata på én platform med AI-drevet optimering af arbejdsbelastninger til ERP, fakturering og ordrebehandling. Jeg værdsætter denne egenskab, når relationelle arbejdsbelastninger og analyser skal dele infrastruktur.
Vigtige funktioner i IBM Db2
- Hybrid implementering: Kør Db2 lokalt, i skyen eller i hybride miljøer.
- Indbygget kryptering: Krypter data i databasen, og administrer krypteringsnøgler via et nøglelager.
- Tabelpartitionering: Opdel tabeldata i partitioner baseret på angivne kolonneværdier.
- Værktøjer til sikkerhedskopiering og gendannelse: Db2 Advanced Recovery understøtter sikkerhedskopiering, gendannelse og dataudtræk fra databaser.
IBM Db2-integrationer
Indbyggede integrationer er ikke tydeligt dokumenteret. Db2 understøtter fødereret adgang til datakilder som Oracle og Microsoft SQL Server samt JDBC-, ODBC- og CLI-forbindelser til applikationer.
Pros and Cons
Pros:
- Hurtig behandling af virksomheders transaktionsarbejdsbelastninger
- Høj tilgængelighed med HADR og gendannelse
- Partitionering understøtter store, blandede arbejdsbelastninger
Cons:
- Administration og optimering kræver specialiseret ekspertise
- Cloudbaseret drift halter efter nyere platforme
Learn more about IBM Db2: Bedst til SQL-analyse
- 30-dages gratis prøveperiode
- $30/bruger/måned (faktureres årligt)
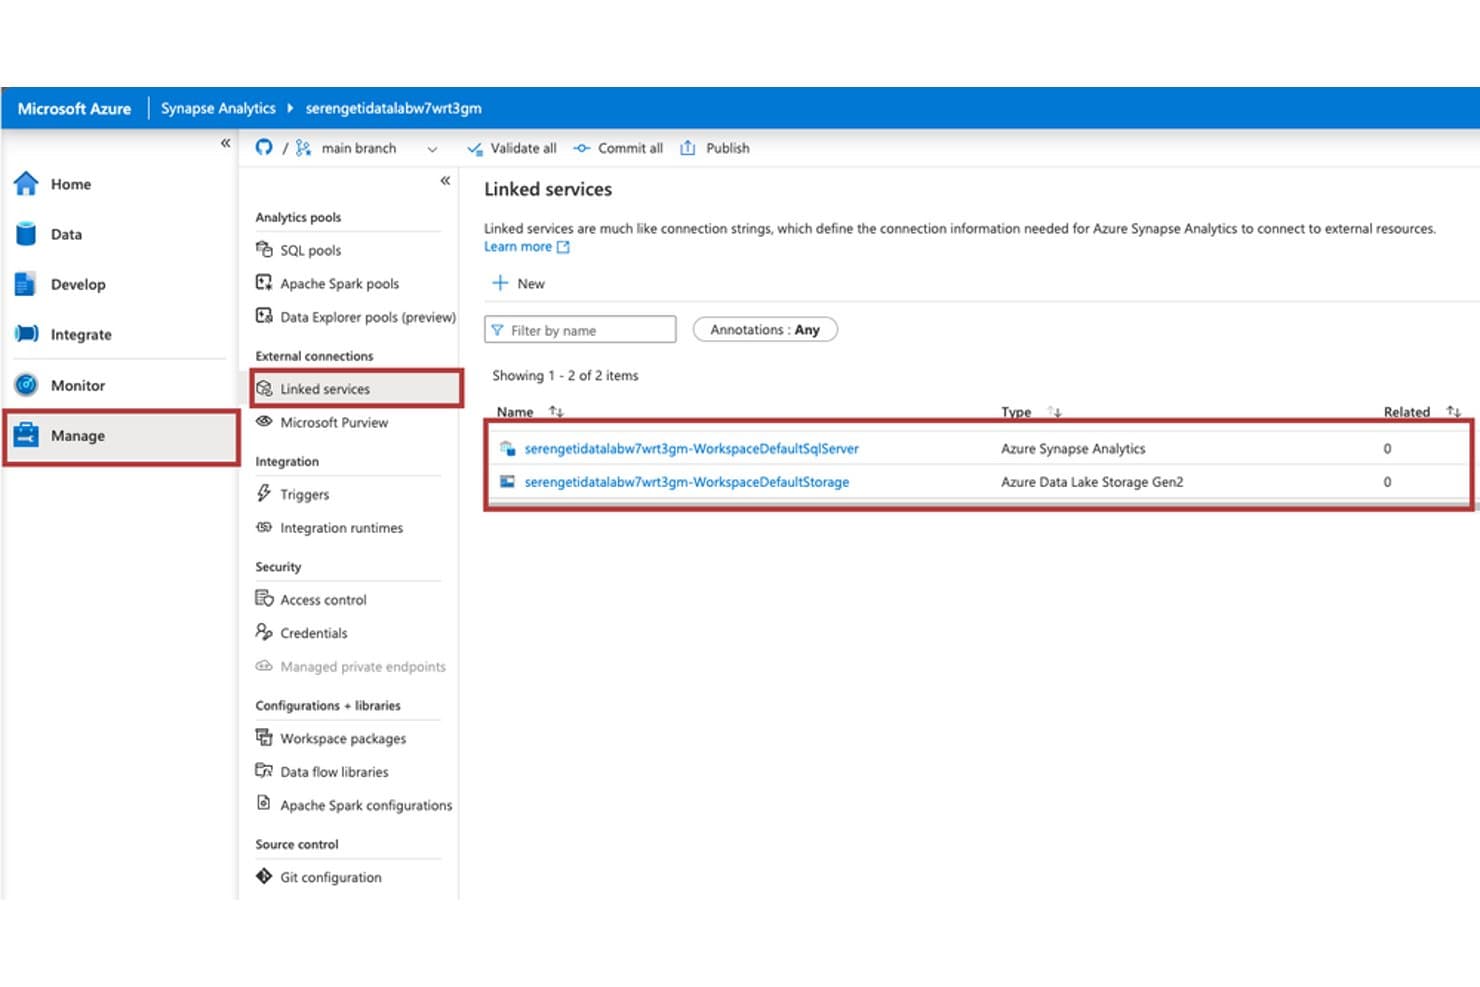
Azure Synapse Analytics administrerer eksterne forbindelser via forbundne tjenester. Azure Synapse Analytics er en cloudbaseret analyseplatform til data- og IT-teams, der har brug for at forbinde virksomhedsdata, køre forespørgsler og understøtte rapportering på tværs af datalager- og big data-arbejdsbelastninger.
Hvem er Azure Synapse Analytics bedst til?
Den er velegnet til dataingeniører og analytikere, der har brug for SQL-adgang til integrerede datasæt til virksomhedsrapportering og -analyse.
Hvorfor jeg valgte Azure Synapse Analytics
Jeg valgte Azure Synapse Analytics til anvendelsesområdet Bedst til SQL-analyse: Den serverløse SQL-pulje forespørger datasøfiler med T-SQL, mens dedikerede SQL-puljer understøtter klargjorte datalagerarbejdsbelastninger. Jeg kan godt lide denne opdeling, når jeg har brug for at undersøge rå datasæt og levere tilbagevendende BI-rapporter via SQL.
Vigtige funktioner i Azure Synapse Analytics
- Apache Spark-puljer: Kør Spark-job og notesbøger til distribueret databehandling.
- Datapipelines: Orkestrér dataflytning og -transformation på tværs af forbundne kilder.
- Synapse Studio: Administrer data-, kode- og analyseressourcer i et delt arbejdsområde.
- Power BI-integration: Forbind Synapse-data med Power BI for at oprette rapporter.
Integrationer med Azure Synapse Analytics
Azure Synapse Analytics har indbyggede pipelineforbindelser til Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 og SAP HANA samt en direkte Power BI-forbindelse via Synapse Studio. Det tilbyder også REST-API'er til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Serverløse T-SQL-forespørgsler læser datasøfiler
- Dedikerede MPP-puljer håndterer datalagerarbejdsbelastninger
- Kombinerer SQL-forespørgsler med Spark-behandling
Cons:
- Optimering af SQL-puljer kræver praktisk ekspertise
- Fejlfinding og overvågning af datapipelines kan være begrænset
Learn more about Azure Synapse Analytics:
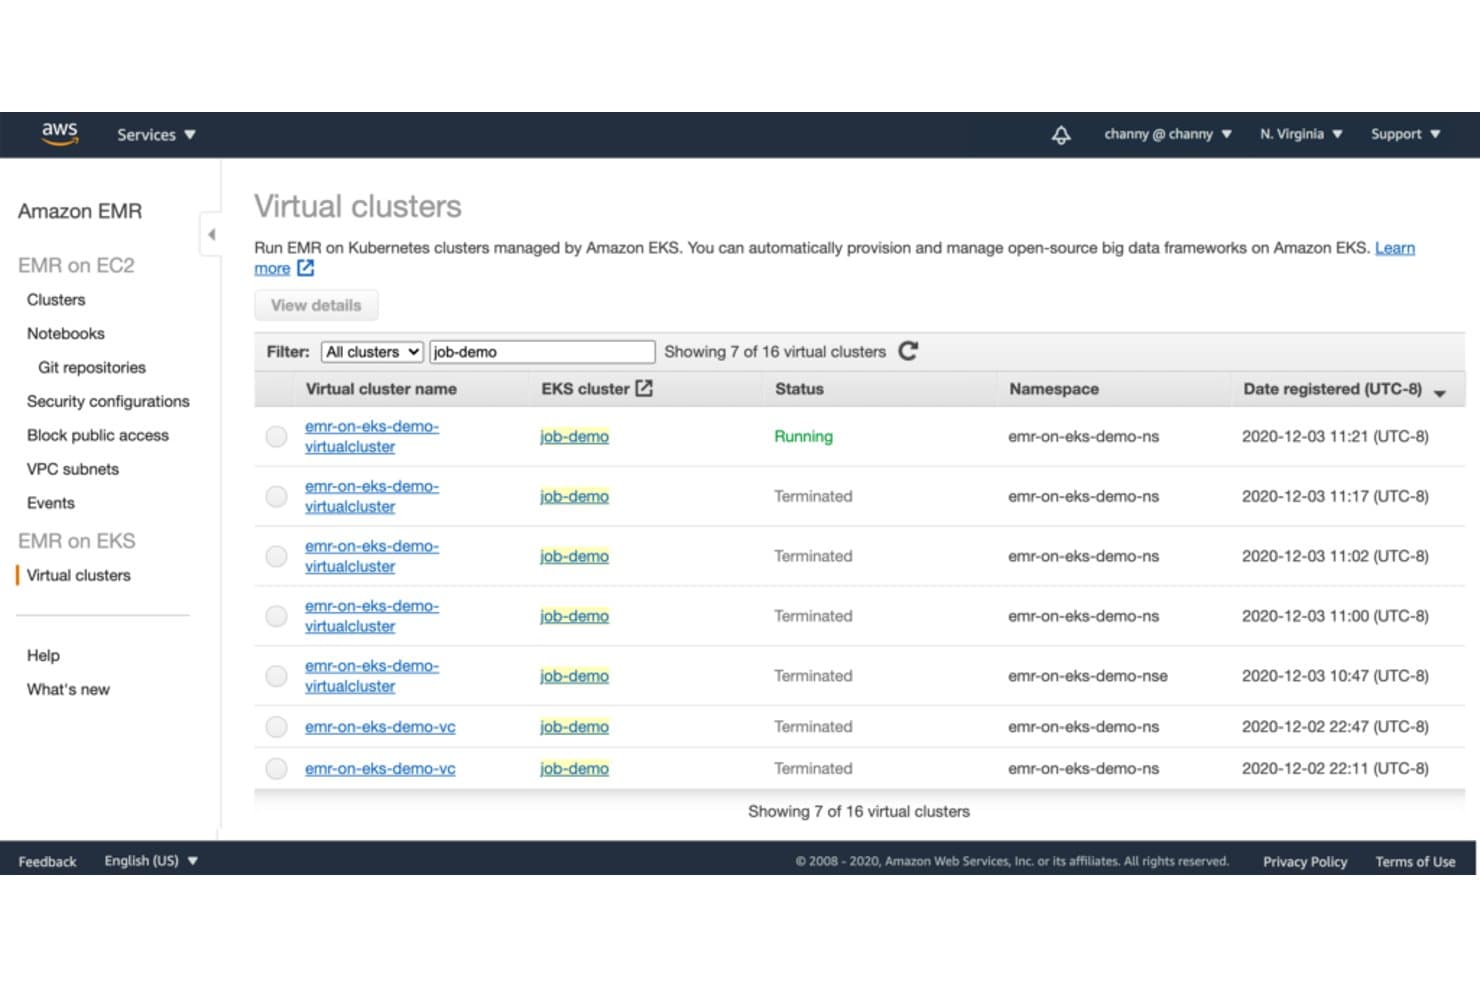
Amazon EMR giver brugerne mulighed for at administrere virtuelle klynger, der kører på Amazon EKS. Amazon EMR er AWS' administrerede stordataplatform til datateknik- og analyseteams, der har brug for at behandle store datasæt, skalere distribuerede arbejdsbelastninger og reducere arbejdet med at drifte beregningsklynger.
Hvem er Amazon EMR bedst egnet til?
Amazon EMR er velegnet til datateknikteams, der kører Hadoop- eller Spark-job for at behandle store datasæt på tværs af distribuerede klynger.
Hvorfor jeg valgte Amazon EMR
Jeg valgte Amazon EMR som et alternativ til Databricks af én grund: Bedst til Hadoop-behandling. Dets administrerede klynger kører Apache Hadoop og Spark, så jeg kan bruge MapReduce til at behandle arkiverede applikationslogge og Spark til at analysere resultaterne.
Vigtige funktioner i Amazon EMR
- EMR Serverless: Kør dataapplikationer uden at klargøre eller administrere klynger.
- Automatisk skalering: Juster klyngens kapacitet baseret på arbejdsbelastningens behov.
- EMR på EKS: Kør EMR-arbejdsbelastninger på Amazon EKS-klynger.
- AWS Glue Data Catalog: Brug et delt katalog til tabelmetadata.
Integrationer med Amazon EMR
Amazon EMR har dokumenterede integrationer med AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 og Amazon CloudWatch. Det tilbyder også en API til programmatisk adgang og tilpassede integrationer.
Pros and Cons
Pros:
- Kører etablerede Hadoop- og Spark-arbejdsbelastninger
- Understøtter klynge-, serverløs- og EKS-implementering
- Behandler store datasæt på tværs af forskellige arbejdsbelastninger
Cons:
- Langsom automatisk skalering kan efterlade job med utilstrækkelige ressourcer
- Klynges skalering kræver nogle gange manuel finjustering
Learn more about Amazon EMR: Bedst til administreret Spark og Hadoop
- Ikke tilgængelig
- Fra $0.06/DCU-hour
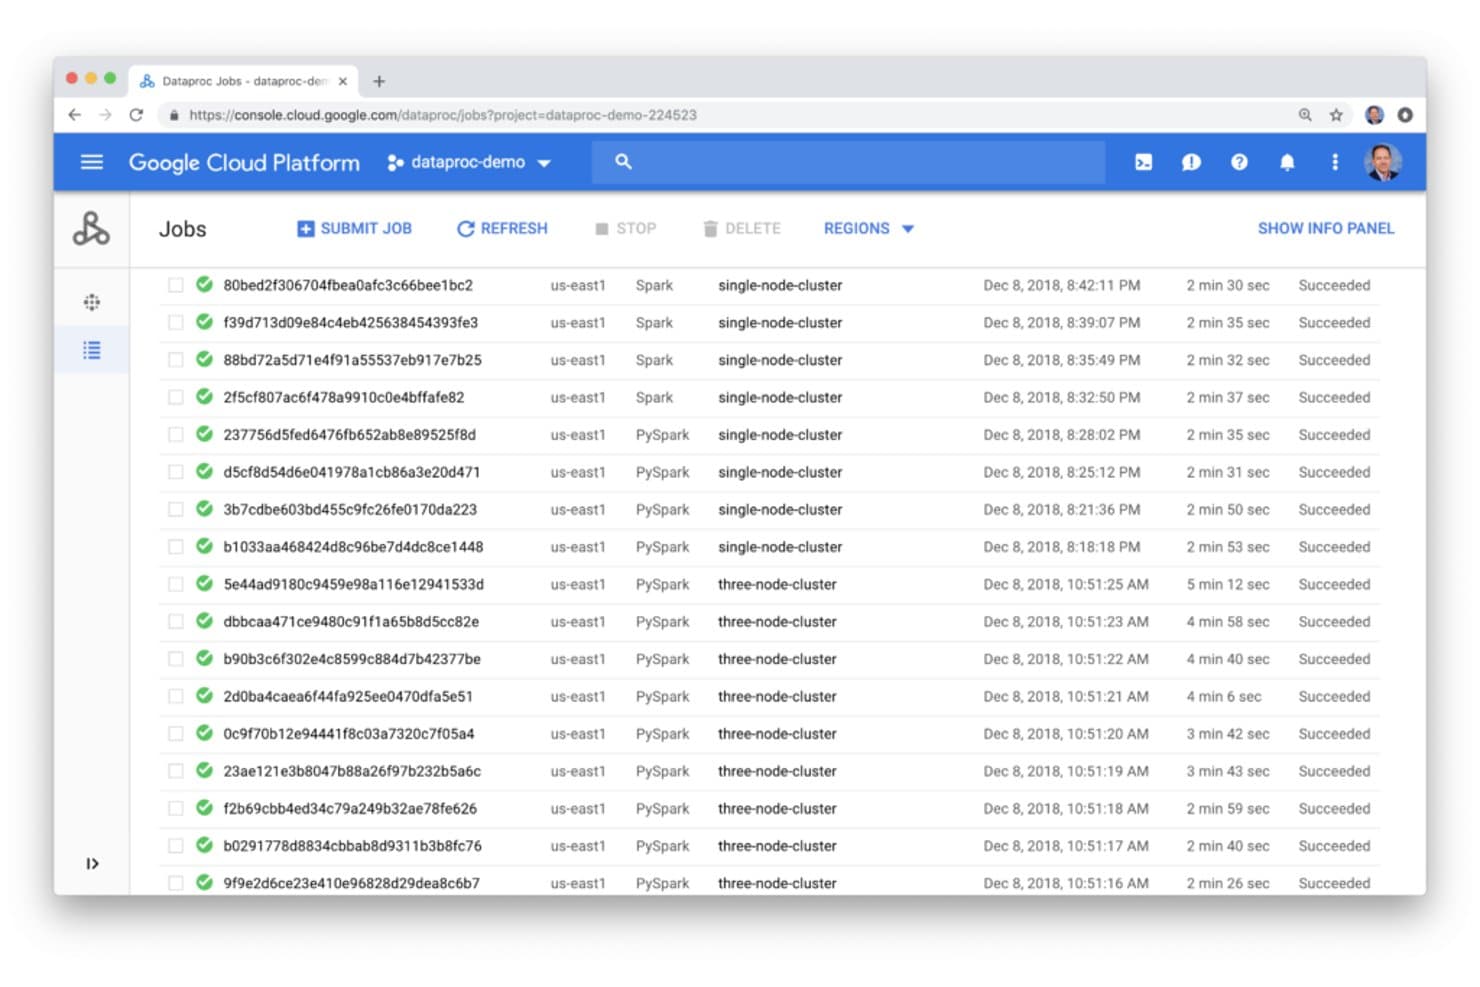
Google Cloud Dataproc giver brugerne mulighed for hurtigt at overvåge og administrere Spark-job. Google Cloud Dataproc giver datateknik- og IT-teams en administreret cloudplatform til analysearbejdsbelastninger i stor skala, hvilket hjælper med at reducere klyngeadministration og understøtte datapipelines på tværs af Google Cloud.
Hvem er Google Cloud Dataproc bedst til?
Datateknikteams, der kører Spark- eller Hadoop-job på Google Cloud, kan bruge Dataproc til at administrere klyngeoperationer.
Hvorfor valgte jeg Google Cloud Dataproc?
Jeg valgte Google Cloud Dataproc til arbejdsbelastninger, hvor “Bedst til administreret Spark og Hadoop” er prioriteten. Administrerede klynger og politikker for automatisk skalering hjælper med at håndtere batchjob med skiftende ressourcebehov, mens Dataproc Serverless kører Spark-batchjob uden klargøring af klynger. Du kan f.eks. behandle natlige hændelseslogge med Spark og undgå at lade en klynge stå inaktiv mellem kørsler.
Vigtige funktioner i Google Cloud Dataproc
- Lightning-motoren: Accelererer Spark-kørsel med vektoriseret behandling, caching og optimeret dataomfordeling.
- Understøttelse af Apache Iceberg: Fungerer med åbne tabelformater på Google Cloud Storage.
- GPU-acceleration: Understøtter NVIDIA RAPIDS til GPU-aktiveret databehandling.
- Sikkerhedskontroller: Integreres med IAM, VPC Service Controls og Kerberos.
Integrationer med Google Cloud Dataproc
Google Cloud Dataproc har indbyggede integrationer med BigQuery, Cloud Storage, Bigtable, Cloud Logging og Cloud Monitoring. Det tilbyder også en REST API og Cloud SDK til administration af klynger og job.
Pros and Cons
Pros:
- Kører eksisterende Spark-job med minimale omskrivninger
- Hurtig oprettelse og nedlukning af klynger
- Serverløse batchkørsler eliminerer klyngeadministration
Cons:
- Optimering af klynger kræver stadig ekspertise inden for infrastruktur
- Omkostningerne kan føles høje ved vedvarende arbejdsbelastninger
Learn more about Google Cloud Dataproc:
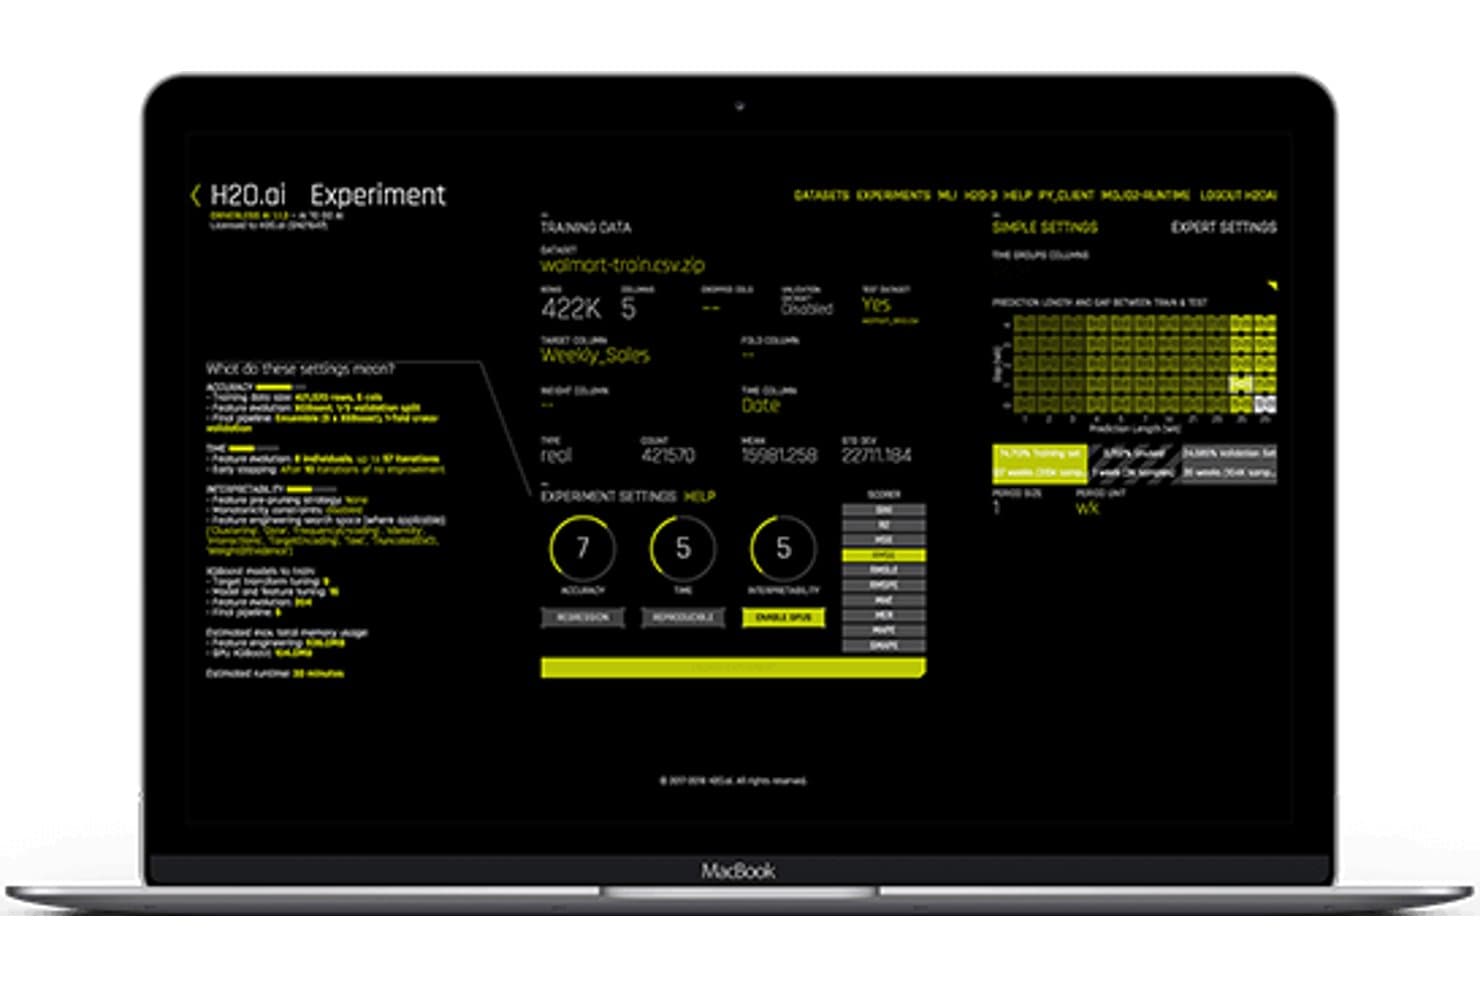
H2O.ai lader brugere konfigurere og køre AutoML-eksperimenter visuelt. For teams, der evaluerer alternativer til Databricks, tilbyder H2O.ai en AI- og maskinlæringsplatform, der hjælper data- og IT-teams med at opbygge prædiktive modeller ud fra store datasæt og omsætte analyser til praksis.
Hvem egner H2O.ai sig bedst til?
H2O.ai egner sig til data scientists og maskinlæringsingeniører, der er ansvarlige for at udvikle AI-modeller og sætte dem i produktion.
Hvorfor valgte jeg H2O.ai?
Jeg valgte H2O.ai som mit alternativ til Databricks, der er “Bedst til AI- og ML-løsninger”, fordi platformen fokuserer på at opbygge prædiktive modeller ud fra store datasæt. H2O-3 distribuerer maskinlæring i hukommelsen på tværs af klynger, mens AutoML tester algoritmer og rangerer modeller på en rangliste. Jeg kan godt lide denne løsning, når jeg har brug for at sammenligne modeller, før jeg sætter en af dem i produktion.
Vigtige funktioner i H2O.ai
- Fleksibel implementering: Kør platformen lokalt, i en privat sky, i skyen eller i isolerede netværksmiljøer.
- Modeluafhængig understøttelse: Vælg, udskift eller finjuster modeller og store sprogmodeller.
- Forklarbarhed: Gennemgå forklaringer på AI-drevne beslutninger.
- Revisionsspor: Følg platformens aktiviteter med revisionsklare spor.
Integrationer med H2O.ai
H2O Driverless AI tilbyder dataforbindelser til Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, JDBC-kilder og Delta-tabeller. Disse forbindelser gør det muligt for teams at forespørge på eller importere data fra eksisterende platforme til maskinlæringsarbejdsgange.
Pros and Cons
Pros:
- AutoML gør modelsammenligning og prototyping hurtigere
- Distribueret træning i hukommelsen kan skaleres på tværs af klynger
- Implementering i isolerede netværk understøtter kontrollerede miljøer
Cons:
- Mulighederne for datamanipulation er begrænsede
- En besværlig brugerflade kan gøre arbejdsgange langsommere
Learn more about H2O.ai:
Andre konkurrenter til Databricks
Her er nogle yderligere alternativer til Databricks, som ikke kom med på min korte liste, men som stadig er værd at undersøge:
- 11DremioBedst til selvbetjeningsanalyse
- 12QuboleBedst til arbejdsbelastninger med store datamængder
- 13Azure DatabricksBedst til kollaborativ analyse
Sådan evaluerer jeg alternativer til Databricks
Uanset om dit team kører Spark-pipelines i stor skala eller administrerer en ML-livscyklus, evaluerer jeg hvert alternativ i to lag: først de grundlæggende krav til lakehouse og beregning, derefter de differentierende faktorer.
Grundlæggende funktionalitet (forudsætninger for denne liste)
Når jeg udvælger værktøjer til min liste, vurderer jeg hvert af dem på en skala fra 0 (tilbyder ikke funktionaliteten) til 5 (udmærker sig på området) for hver af de grundlæggende funktioner, der er angivet nedenfor. Derefter omregner jeg værktøjets samlede score til en procentdel. Hvert værktøj skal opnå en samlet minimumsscore på 65 % for at komme i betragtning.
- Samlet lakehouse-arkitektur: Jeg undersøger, om en platform kan håndtere både strukturerede forespørgsler i datavarehuse og ustruktureret lagring i datasøer med understøttelse af åbne tabelformater som Delta, Iceberg eller Hudi.
- Distribueret databehandling: Arbejdsbelastninger med batch- og streamingdata i stor skala kræver en distribueret motor, der automatisk skalerer, så jeg evaluerer beregningsmulighederne og ser på, hvordan platformen håndterer opgaver som ETL-kørsler med flere terabyte.
- Integrerede ML/AI-arbejdsgange: Jeg ser efter understøttelse af hele ML-livscyklussen, fra sporing af eksperimenter og modelregister til implementering og betjening, frem for blot en notesbog, der kan køre træningsscripts.
- Samarbejdsbaseret notesbogsmiljø: Dataingeniører, analytikere og ML-ingeniører har brug for delte notesbøger med flere sprog, så jeg evaluerer samarbejde i realtid, versionsstyring og sprogunderstøttelse på tværs af SQL, Python, Scala og R.
- Datastyring & sikkerhed: Et samlet datakatalog, detaljerede adgangskontroller og sporing af dataafstamning er vigtige her. Jeg ser på, hvordan hver platform administrerer tilladelser for tabeller, kolonner og AI-aktiver ét sted.
- Flere cloudmiljøer & åben integration: Leverandørlåsning er en reel bekymring, så jeg evaluerer, om hvert værktøj fungerer på tværs af AWS, Azure og GCP, og hvor godt det forbindes med orkestratorer som Airflow, BI-værktøjer som Tableau og indtagslag som dbt.
Når jeg har en liste over værktøjer, der opfylder disse kriterier, ser jeg på, hvad der adskiller de enkelte platforme.
Differentierende faktorer (det, der adskiller leverandørerne)
Sådan sammenligner jeg forskellige leverandører:
Fremtrædende funktioner
Serverløs beregning er en vigtig differentierende faktor. Jeg evaluerer, om en platform lader teams køre forespørgsler og job uden at administrere klynger, hvilket reducerer overhead for grupper med uforudsigelige arbejdsbelastninger. Indbyggede GenAI-værktøjer bliver vigtigere hvert år, især for teams, der bygger RAG-pipelines eller finjusterer LLM'er direkte i deres dataplatform. Jeg ser også på funktioner til omkostningsoptimering, såsom sporing af forbrug pr. arbejdsbelastning og automatiserede klyngepolitikker, eftersom omkostningerne til cloud-beregning hurtigt kan løbe løbsk på tværs af store ingeniørteams.
Ud over funktionerne
De samlede ejeromkostninger er noget af det første, jeg evaluerer. Forbrugsbaseret prissætning kan se attraktiv ud, indtil gebyrer for dataudtræk og premium-supportniveauer får regningen til at vokse. Økosystemets bredde er også vigtig – jeg undersøger, hvor godt hver platform forbindes med værktøjer som Airflow, dbt og Tableau, eftersom de fleste teams ikke udskifter hele deres teknologistak. Implementering og tid til værdi fuldender min evaluering. Migreringsværktøjer fra ældre systemer som Hadoop eller Redshift kan forkorte en overgang med flere uger, og god dokumentation gør det langt mindre besværligt at onboarde nye ingeniører.
Sådan vælger du en konkurrent til Databricks
Det er nemt at fare vild i lange lister over funktioner og komplekse prisstrukturer. For at hjælpe dig med at holde fokus, mens du arbejder dig gennem din unikke proces for valg af software, får du her en tjekliste over faktorer, du bør have i tankerne:
| Faktor | Hvad du skal overveje |
| Skalerbarhed | Sørg for, at løsningen kan håndtere din datavækst uden tab af ydeevne. Kontrollér, om den understøtter både horisontal og vertikal skalering for at sikre fleksibilitet. |
| Integrationer | Se efter kompatibilitet med dine eksisterende værktøjer, såsom datasøer eller BI-værktøjer, for at sikre et problemfrit dataflow og undgå siloopdelte processer. |
| Tilpasningsmuligheder | Vurder platformens evne til at tilpasse sig dit teams specifikke arbejdsgange og processer. Tilpasningsbare dashboards kan imødekomme forskellige teambehov. |
| Brugervenlighed | Overvej læringskurven, og hvor intuitiv grænsefladen er for dit team. En brugervenlig platform kan reducere oplæringstiden og øge anvendelsen. |
| Budget | Sammenlign prismodeller, og sørg for, at de passer inden for dit budget. Overvej skjulte omkostninger som lagerplads eller ekstra brugerafgifter, der kan påvirke din beslutning. |
| Sikkerhedsforanstaltninger | Vurder platformens sikkerhedsfunktioner, såsom datakryptering og overholdelse af branchestandarder, for at beskytte følsomme data. |
| Support | Kontrollér tilgængeligheden af kundesupportmuligheder, herunder livechat og fællesskabsfora, for at sikre, at dit team kan få hjælp, når der er brug for det. |
| Ydeevne | Undersøg, hvordan platformen håndterer store datasæt og behandling i realtid, for at sikre, at den lever op til dit teams forventninger til ydeevne. |
Tendenser blandt Databricks-konkurrenter
I min undersøgelse indsamlede jeg utallige produktopdateringer, pressemeddelelser og versionslogge fra forskellige leverandører, der konkurrerer med Databricks. Her er nogle af de nye tendenser, jeg holder øje med:
- Analyser i realtid: Virksomheder efterspørger i stigende grad dataindsigt i realtid. Leverandørerne forbedrer deres platforme, så de kan behandle og analysere data i realtid, hvilket giver brugerne mulighed for at træffe øjeblikkelige beslutninger. Løsninger som Google BigQuery integrerer funktioner, der understøtter datastrømning i realtid.
- Augmenteret analyse: Denne tendens indebærer brug af AI og maskinlæring til at forbedre dataanalyseprocesser. Den bliver stadig mere populær, fordi den hjælper brugerne med at opdage indsigter uden manuel indsats. IBM Watson Studio er et eksempel, der tilbyder funktioner til augmenteret analyse for at automatisere dataanalysen.
- Demokratisering af data: Flere platforme fokuserer på at gøre data tilgængelige for ikke-tekniske brugere. Denne tendens er afgørende for at fremme en datadrevet kultur i organisationer. Der udvikles værktøjer med intuitive grænseflader og selvbetjeningsfunktioner, som dem man ser i Alteryx.
- Datastyring: Efterhånden som reglerne om databeskyttelse bliver skærpet, bliver funktioner til datastyring vigtigere. Leverandørerne integrerer styringsværktøjer for at hjælpe brugerne med at overholde reglerne og håndtere data ansvarligt. Azure Synapse Analytics tilbyder for eksempel indbyggede funktioner til datastyring.
- Understøttelse af hybridcloud: Mange virksomheder ønsker fleksibilitet i deres cloudstrategier. Understøttelse af hybridcloud bliver stadig mere udbredt, så brugerne kan administrere data på tværs af både lokale miljøer og cloudmiljøer. Cloudera fører an i denne tendens med løsninger, der understøtter hybridcloud-implementeringer.
Hvad er en Databricks-konkurrent?
Databricks-konkurrenter er softwareløsninger, der er udviklet til at tilbyde funktioner til databehandling, analyse og maskinlæring. Disse værktøjer bruges generelt af dataforskere, ingeniører og analytikere til at opnå indsigt og træffe forretningsbeslutninger.
Analyser i realtid, augmenteret analyse og funktioner til datastyring hjælper med at behandle data effektivt, opdage indsigter og håndtere data ansvarligt. Samlet set giver disse værktøjer virksomheder mulighed for at udnytte deres data til bedre beslutningstagning og strategisk planlægning.
Funktioner hos en Databricks-konkurrent
Når du vælger en Databricks-konkurrent, bør du holde øje med følgende vigtige funktioner:
- Analyse i realtid: Muliggør øjeblikkelig databehandling og indsigt, så du kan træffe hurtige forretningsbeslutninger.
- Augmenteret analyse: Anvender AI til at automatisere dataanalyse og hjælper med at afdække indsigter uden manuelt arbejde.
- Datastyring: Sikrer overholdelse af regler for databeskyttelse og ansvarlig datahåndtering.
- Understøttelse af hybrid cloud: Gør det muligt at administrere data på tværs af både lokale installationer og cloudmiljøer for større fleksibilitet.
- Interaktivt samarbejde: Understøtter teamwork ved at tilbyde delte arbejdsområder og værktøjer til fælles dataanalyse.
- Automatisk skalering: Justerer ressourcer baseret på arbejdsbelastningen og optimerer ydeevnen uden manuel indgriben.
- Integration af maskinlæring: Tilbyder indbyggede maskinlæringsfunktioner til avancerede dataforudsigelser og indsigter.
- Tilpasningsmuligheder: Gør det muligt at tilpasse arbejdsgange og dashboards, så de passer til specifikke teambehov og processer.
- Sikkerhedsforanstaltninger: Tilbyder kryptering og funktioner til overholdelse af regler for at beskytte følsomme data.
- Brugervenlig grænseflade: Sikrer nem anvendelse, reducerer indlæringskurven og øger udbredelsen i dit team.
Fordele ved en Databricks-konkurrent
Implementering af en Databricks-konkurrent giver flere fordele for dit team og din virksomhed. Her er nogle af de fordele, du kan se frem til:
- Bedre beslutningstagning: Analyse i realtid og augmenteret analyse giver øjeblikkelig indsigt og forbedrer dit teams evne til at træffe beslutninger.
- Øget samarbejde: Funktioner til interaktivt samarbejde gør det muligt for dit team at arbejde effektivt sammen, hvilket fører til mere sammenhængende dataprojekter.
- Skalerbarhed: Automatisk skalering gør det muligt for dit system at håndtere datavækst effektivt uden manuelle justeringer.
- Omkostningseffektivitet: Betal-efter-forbrug-prismodeller sikrer, at du kun betaler for de ressourcer, du bruger, og optimerer budgetstyringen.
- Forbedret sikkerhed: Indbyggede sikkerhedsforanstaltninger beskytter dine data og sikrer overholdelse af branchestandarder.
- Fleksibilitet: Understøttelse af hybrid cloud giver fleksibilitet til at administrere data i forskellige miljøer og tilpasse løsningen til virksomhedens behov.
- Tilpasning: Tilpasningsmulighederne lader dig skræddersy arbejdsgange og dashboards, så de passer til dine specifikke krav og øger produktiviteten.
Omkostninger og priser for en Databricks-konkurrent
Valg af en Databricks-konkurrent kræver en forståelse af de forskellige prismodeller og tilgængelige abonnementer. Omkostningerne varierer afhængigt af funktioner, teamstørrelse, tilføjelser og meget mere. Tabellen nedenfor opsummerer almindelige abonnementer, deres gennemsnitlige priser og typiske funktioner, der er inkluderet i Databricks-konkurrentløsninger:
Sammenligningstabel for abonnementer hos en Databricks-konkurrent
| Abonnementstype | Gennemsnitspris | Almindelige funktioner |
| Gratis abonnement | $0 | Grundlæggende databehandling, begrænset lagerplads og support fra fællesskabet. |
| Personligt abonnement | $10-$30 /bruger /måned | Udvidet dataanalyse, personlige dashboards og e-mailsupport. |
| Virksomhedsabonnement | $50-$100 /bruger /måned | Avancerede analyseværktøjer, funktioner til teamsamarbejde og prioriteret support. |
| Virksomhedsabonnement | $150-$300/bruger /måned | Tilpassede integrationer, dedikeret kontoadministration og sikkerhed på virksomhedsniveau. |
Ofte stillede spørgsmål om Databricks-konkurrenter
Her er nogle svar på almindelige spørgsmål om Databricks-konkurrenter:
Hvem er Databricks' største konkurrent?
Snowflake betragtes ofte som Databricks’ største konkurrent på grund af platformens lignende cloudbaserede datafunktioner. Begge tilbyder omfattende funktioner til databehandling og analyse, men Snowflake er kendt for sine styrker inden for datalagring. Afhængigt af dine specifikke behov kan begge være et godt valg.
Hvad vil erstatte Databricks?
Selvom der ikke er ét enkelt værktøj, der står til at erstatte Databricks, tilbyder alternativer som SQL Server overbevisende funktioner. SQL Server integreres godt med dataanalyseværktøjer som Power BI og tilbyder et robust relationelt databasestyringssystem. Dit valg afhænger af dine specifikke krav til databehandling.
Hvilke begrænsninger har Databricks?
Databricks har nogle begrænsninger, såsom restriktioner på antallet af widgets i en notesbog samt tegnbegrænsninger for widgetnavne og input. Disse begrænsninger kan påvirke, hvordan du designer og arbejder med data i notesbøger, så planlæg derefter, hvis disse begrænsninger påvirker dine arbejdsgange.
Hvem er Amazon Databricks' konkurrenter?
Amazon Databricks konkurrerer med platforme som Snowflake, der tilbyder lignende databehandlingsfunktioner. Snowflake leverer en cloudbaseret datalagerløsning, der er bredt anerkendt for sin skalerbarhed og brugervenlighed, hvilket gør den til en stærk konkurrent på markedet.
Hvordan sammenlignes Databricks' priser med konkurrenternes?
Prisen på Databricks kan variere betydeligt afhængigt af brug og funktioner. Det er vigtigt at sammenligne platformen med konkurrenter som Snowflake og Google BigQuery under hensyntagen til faktorer som datalagring, behandlingsomkostninger og yderligere funktioner. Vurder hver platforms prisstruktur for at finde den løsning, der passer bedst til dit budget.
Hvilke funktioner bør jeg se efter hos en Databricks-konkurrent?
Når du vurderer Databricks-konkurrenter, bør du se efter funktioner som realtidsanalyse, integration af maskinlæring og datastyring. Disse funktioner forbedrer din databehandling og analyse og skaber værdi for dit team. Overvej dine specifikke forretningsbehov for at afgøre, hvilke funktioner der er mest afgørende.