

10 bästa verktygen för LLM-observerbarhet 2026

Kortlista över de bästa verktygen för LLM-observerbarhet


Verktyg för LLM-observerbarhet spårar AI-arbetsflöden, övervakar beteendet i produktion och utvärderar modellkvalitet. Den här guiden jämför 12 alternativ för felsökning av agenter i flera steg, spårning av frågor och modellversioner, mätning av fördröjning och tokenanvändning samt identifiering av regressioner före driftsättning. Här hittar du plattformar med öppen källkod, plattformar för egen hosting, företagsplattformar, OpenTelemetry-baserade plattformar och utvecklarfokuserade plattformar som passar din tekniska arkitektur, dina styrningsbehov och ditt leveransarbetsflöde.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Jämför de bästa verktygen för LLM-observerbarhet
Jämför priser och specifikationer sida vid sida för de främsta plattformarna på min kortlista.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för spårning som bygger på OTel med öppen källkod | Kostnadsfri plan + kostnadsfri demo tillgänglig | Prisuppgift på begäran | Website | |
| 2 | Bäst för öppen källkod och självhostad utvärdering i stor skala | Gratisabonnemang tillgängligt | Pris på begäran | Website | |
| 3 | Bäst för LLM-utvärdering under hela livscykeln med gatewaydrift | Kostnadsfri plan + kostnadsfri demo tillgänglig | Pris på begäran | Website | |
| 4 | Bäst för utvärdering och spårning med öppen källkod | Gratisplan + kostnadsfri demo tillgänglig | Från $19/månad | Website | |
| 5 | Bäst för att koppla promptversioner till produktionsspår | Gratisabonnemang + gratis demo tillgänglig | Från $49/månad | Website | |
| 6 | Bäst för att spåra agenter över komplexa bearbetningsflöden | Gratis abonnemang och gratis demo tillgängliga | Från $50/månad | Website | |
| 7 | Bäst för att koppla LLM-spår till produktanalys | Kostnadsfritt abonnemang + kostnadsfri demo tillgänglig | Från $34/månad | Website | |
| 8 | Bäst för spårning med öppen källkod och versionshantering av promptar | Gratisplan + kostnadsfri demo tillgänglig | Från $29/månad | Website | |
| 9 | Bäst för poängsättning från utvärdering till produktion i ett enda kretslopp | Gratisplan + gratis demo tillgänglig | Från $249/månad | Website | |
| 10 | Bäst för spårning i LangChain och LangGraph | Gratis abonnemang + gratis demo tillgänglig | Från $39/användare/månad | Website |
Recensioner av verktyg för LLM-observerbarhet
Nedan finns detaljerade sammanfattningar av de främsta alternativen på min kortlista. Varje recension tar upp viktiga funktioner, användningsområden och integrationer för att hjälpa dig att hitta rätt alternativ.
Bäst för spårning som bygger på OTel med öppen källkod
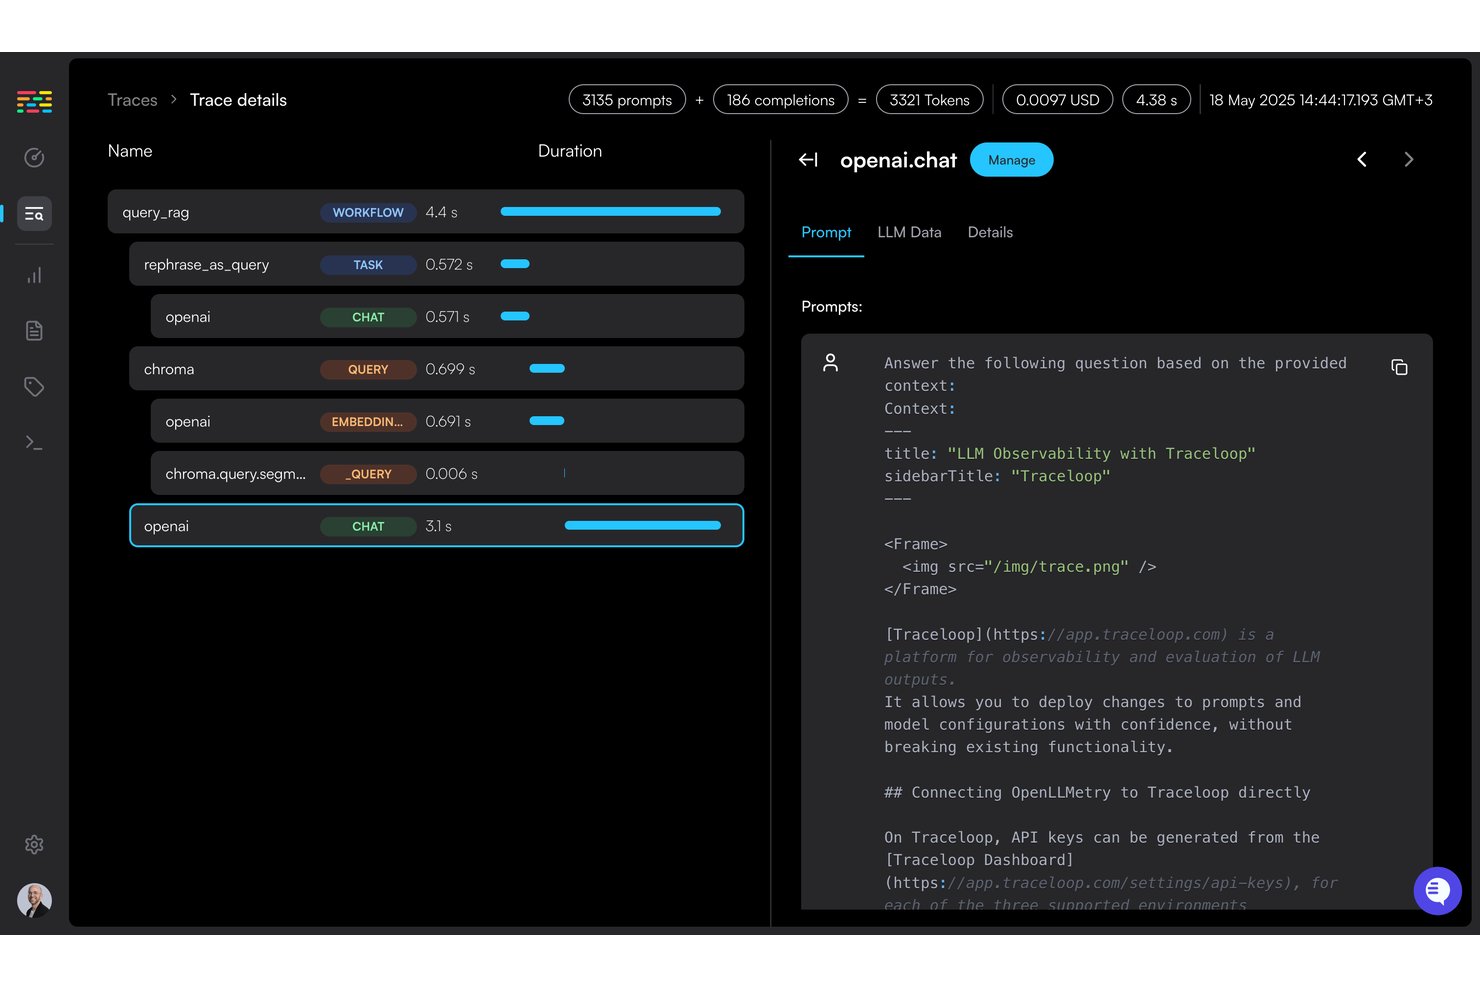
Traceloop från ServiceNow bygger på OpenTelemetry, vilket ger dig spanbaserad spårning, utvärdering av utdatakvalitet, ett promptregister med miljöbaserade distributioner, produktionsövervakning och kvalitetsgrindar för CI/CD.
För vem passar Traceloop bäst?
Traceloop passar plattforms- och DevOps-ingenjörer som behöver kompatibel, självhostad LLM-observabilitet på Kubernetes eller i luftgapad infrastruktur.
Varför jag valde Traceloop
Jag har tagit med Traceloop bland mina toppval eftersom det helt bygger på OpenTelemetry genom sitt SDK med öppen källkod, OpenLLMetry, vilket innebär att varje LLM-anrop, fråga till en vektordatabas och agentsteg registreras som ett inbyggt OTel-span som du kan exportera till fler än 25 backend-system. Jag uppskattar särskilt utvärderingsflödet: du kan köra samma kvalitetskontroller som CI/CD-grindar på pullförfrågningar, infoga skyddsräcken i produktionen och övervaka live-trafik i realtid samtidigt. Promptregistret med miljöbaserade distributioner låter dig dessutom rulla ut promptändringar till utvecklingsmiljön före produktionen, vilket ger strikt versionskontroll genom hela livscykeln.
Traceloops viktigaste funktioner
- Inbyggda utvärderare: Kontrollera automatiskt trohet, relevans och säkerhet för live-trafik utan att någon manuell konfiguration krävs.
- Agentfokuserade utvärderingskontroller: Poängsätt agentutdata utifrån korrekthet, verktygsanvändning, minnesbevarande, uppgiftsutförande och säkerhet.
- Produktionsövervakning: Kör utvärderare i realtid på varje span som matchar ett filter för att upptäcka hallucinationer och kvalitetsförsämringar.
- Inbyggda skyddsräcken: Kör säkerhetskontroller i realtid under inferens, direkt baserade på dina konfigurerade utvärderare.
Traceloop-integreringar
Traceloop stöder fler än 20 LLM-leverantörer, däribland Axiom, Braintrust, BMC, Google Cloud, Highlight, Honeycomb, Instana, OpenTelemetry Collector, Datadog, Oracle Cloud och Tenant Cloud. Det finns också ett API för att skapa anpassade utvärderare där LLM fungerar som bedömare.
Pros and Cons
Pros:
- Inbyggd spårning minskar leverantörsberoendet
- Utvärderingar sträcker sig från CI/CD till produktion
- Självhosting stöder distributioner i luftgapade miljöer
Cons:
- Förvärvet av ServiceNow skapar osäkerhet kring färdplanen
- Offentliga detaljer om kostnadsfördelning är fortfarande begränsade
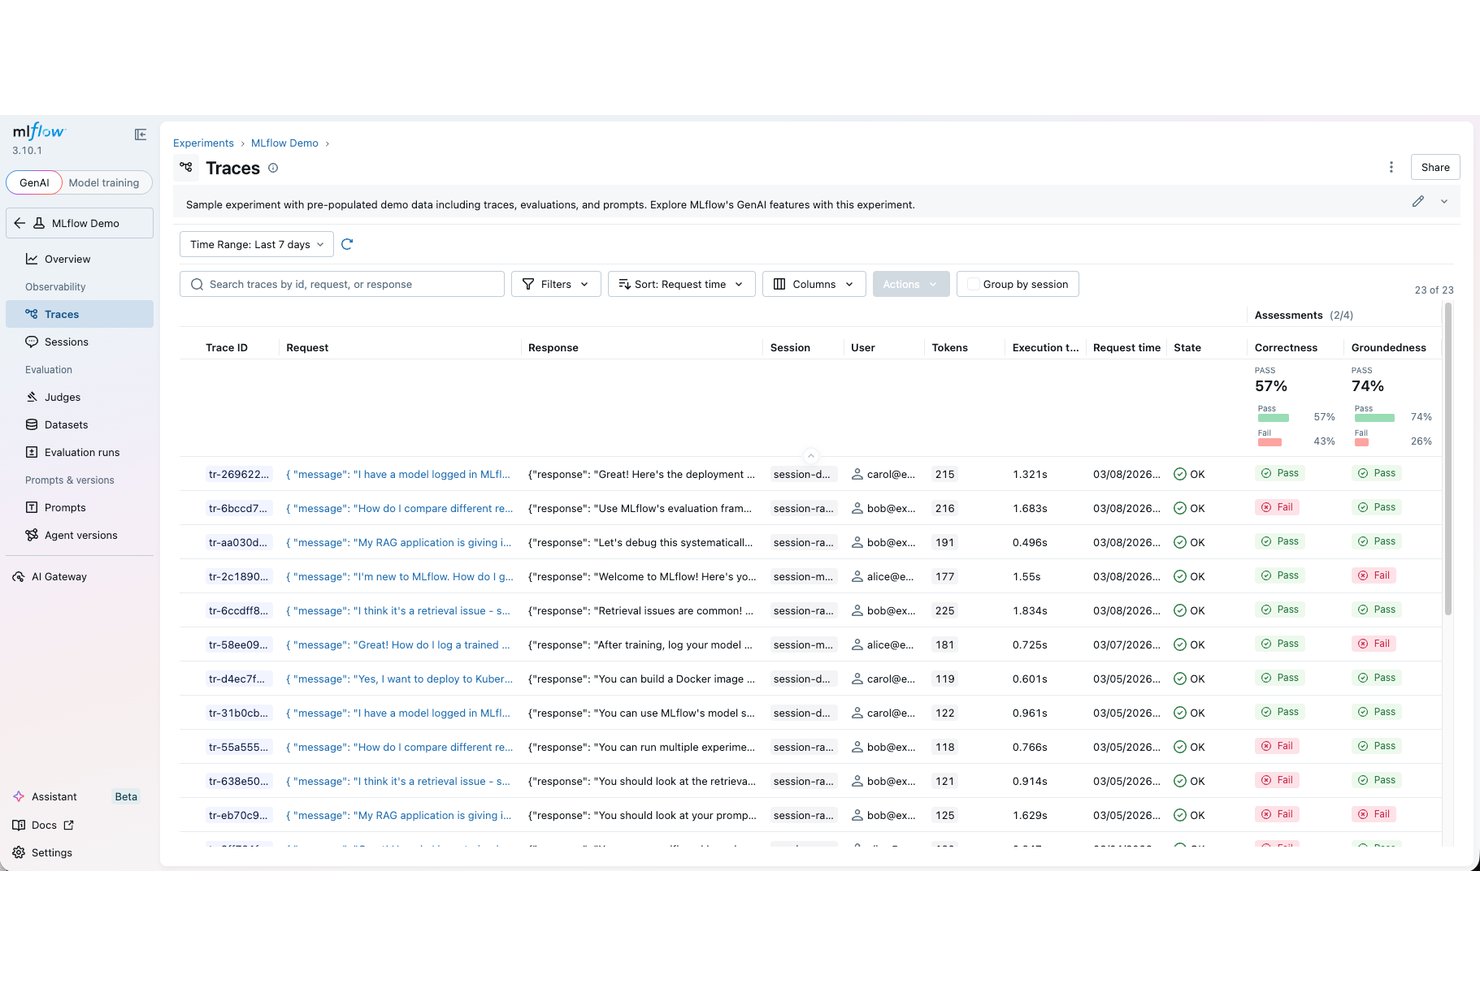
MLflow är en AI-observerbarhetsplattform med öppen källkod som kombinerar loggning av spår, utvärdering av utdatakvalitet, versionshantering av prompter, kostnads- och tokenuppföljning samt produktionsövervakning för LLM-applikationer och AI-agenter.
Vem passar MLflow bäst för?
MLflow passar ML/AI-ingenjörer och datavetare som behöver full kontroll över sin observerbarhetsinfrastruktur och vill undvika avgifter per spår eller leverantörsinlåsning.
Varför jag valde MLflow
Jag har tagit med MLflow bland mina toppval eftersom det är det enda verktyget här som från grunden är byggt som Apache 2.0-programvara med öppen källkod, vilket innebär att dina spårdata aldrig lämnar din egen infrastruktur. Jag gillar att Prompt Registry länkar varje promptversion direkt till dess utvärderingsresultat, så att du kan köra A/B-tester av varianter och se poäng för kvalitet, fördröjning och säkerhet sida vid sida innan du lanserar något i produktion. De asynkrona LLM-bedömarna poängsätter också kontinuerligt samplade spår utan att bromsa den aktiva trafiken.
Viktiga funktioner i MLflow
- Promptregister: Versionshantera, testa och jämför prompter sida vid sida, med spårning av härkomst och automatisk promptoptimering för att justera prompter algoritmiskt.
- Skyddsräcken och säkerhetsdetektering: Poängsättning i realtid upptäcker promptinjektioner, PII-läckor och jailbreaks med både deterministiska och LLM-baserade detektorer, med möjlighet till PII-redigering i SDK:t.
- Hantering av utvärderingsdataset: Skapa och lagra dataset med testfall från produktionsspår, där strukturerad feedback från användare och domänexperter återförs till kalibreringen av bedömarna.
- AI-gateway med budgetpolicyer: Ange utgiftströsklar per dag, vecka eller månad för flera leverantörer, med webhook-aviseringar till verktyg som Slack eller PagerDuty när gränser överskrids.
MLflow-integreringar
MLflow integreras med fler än 40 LLM:er och AI-agenter, inklusive OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry och TypeScript. REST API:t är också tillgängligt för anpassade anslutningar.
Pros and Cons
Pros:
- Självhostade spår håller data internt
- Produktionsbedömare poängsätter hallucinationer och avvikelser
- Härkomst för prompter kopplar ändringar till utvärderingar
Cons:
- Kapslade agentspår kan bli förvirrande
- Alternativen för aviseringar är fortfarande mindre tydligt dokumenterade
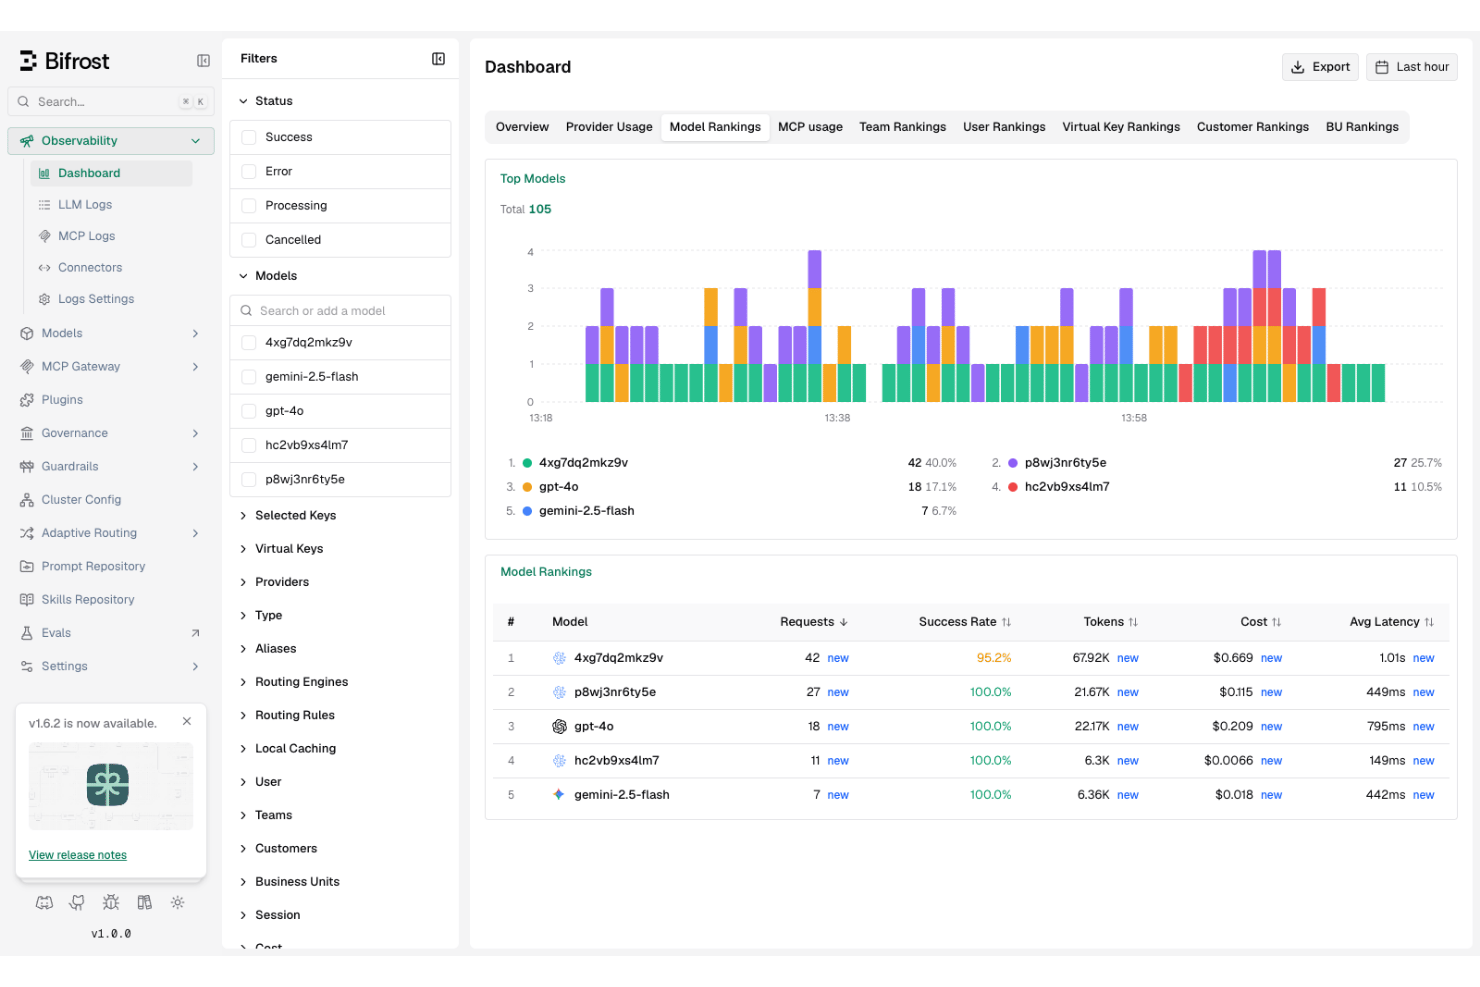
Bifrost är en plattform för LLM-observabilitet som täcker hela utvecklingslivscykeln genom att kombinera distribuerad spårning, promptversionshantering och experimentering, automatiserad utvärdering och utvärdering med människa i loopen samt en gateway med öppen källkod för LLM.
Vem passar Bifrost bäst för?
Bifrost passar bra för reglerade företag som behöver driftsättning i VPC, SOC 2 Type II, HIPAA-efterlevnad och utvärdering med människa i loopen på en och samma plattform.
Därför valde jag Bifrost
Det är täckningen av hela livscykeln som håller Bifrost på min kortlista. Jag använder det för att köra A/B-tester av promptversioner i prompt-IDE:n och sedan ta samma datauppsättningar direkt till utvärdering i produktion utan något manuellt exportsteg. Det jag verkligen uppskattar är att gatewayen Bifrost med öppen källkod kompletterar gatewayens hastighetsbegränsningar med budgetspårning per team eller virtuell nyckel, så att jag kan hantera kostnadsstyrning och observabilitet från en sammanhängande konfiguration i stället för två separata verktyg.
Bifrosts viktigaste funktioner
- Prompt-IDE med versionsjämförelse: En multimodal promptmiljö där du kan köra experiment med olika kombinationer av promptar, modeller, kontext och verktyg, med versionsjämförelse sida vid sida.
- Agentsimulering: Testa agentinteraktioner i olika scenarier och med olika användarpersonligheter, inklusive röstagenter, innan du skickar ändringar till produktion.
- Integrering med CI/CD-pipeline: Koppla utvärderingskörningar direkt till din distributionspipeline, med möjlighet till schemalagda körningar på Business-nivån och högre.
- Kompatibilitet med OpenTelemetry: Exportera spårningsdata till externa plattformar som New Relic och Snowflake via vidarebefordran med inbyggt OTel-stöd, med SDK:er i Python, TypeScript, Go och Java.
Bifrosts integrationer
Bifrost stöder integration med AI-SDK:er, plattformar för hantering av hemligheter och identitetssystem, inklusive OpenAI, Anthropic, Google GenAI, AWS Bedrock, LiteLLM, AWS Secrets Manager, Google Secret Manager och Okta. Det finns även ett API för anpassade anslutningar.
Pros and Cons
Pros:
- Kopplar samman experimentering, utvärdering och observabilitet
- Spårar sessioner, förfrågningar och individuella spår
- Kombinerar automatiserad poängsättning med mänsklig granskning
Cons:
- Kort lagringstid begränsar historiska undersökningar
- Detaljerad kostnadsfördelning är fortfarande oklar
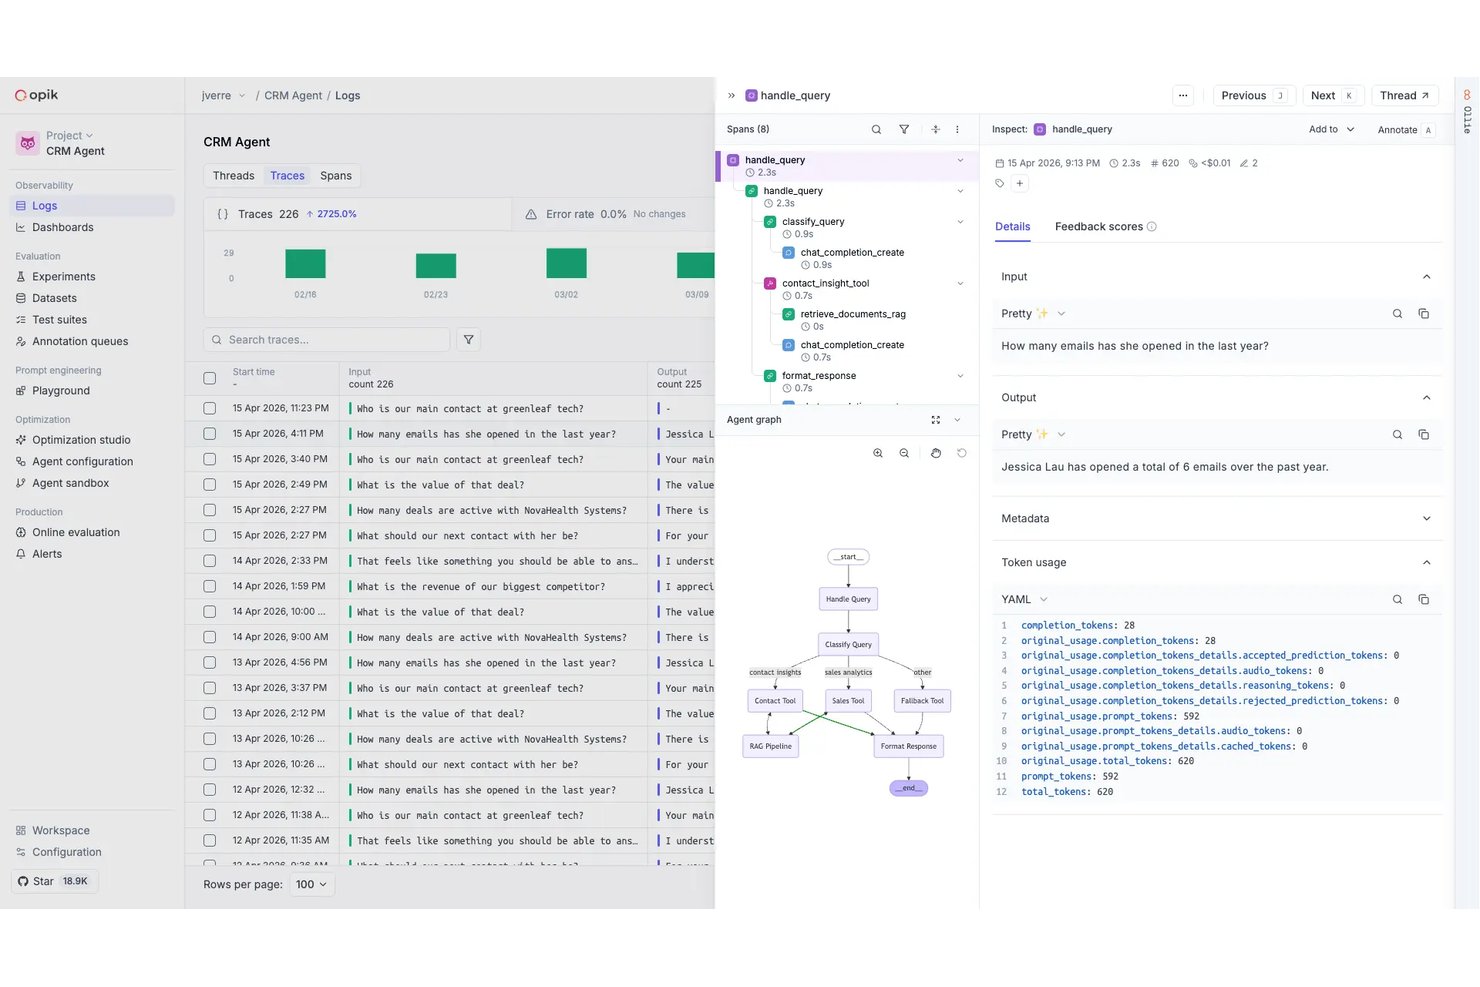
Opik är en plattform för LLM-observabilitet som omfattar loggning av spår, utvärdering av utdatakvalitet, versionshantering av prompter och kostnadsuppföljning i LLM-applikationer, agenter och RAG-pipelines.
Vem passar Opik bäst för?
Opik passar mycket bra för ML/AI-ingenjörer och LLMOps-team som vill ha flexibiliteten hos öppen källkod, med möjlighet att skala upp till en fullt hanterad distribution i företagsklass.
Därför valde jag Opik
Jag valde Opik som en av de bästa eftersom kärnan med öppen källkod verkligen är funktionsrik och inte bara en nedbantad lockversion. Jag gillar att du kan självhosta det med obegränsat antal användare, spår och lagringstid, med samma kodbas som molnversionen. När det gäller utvärderingsdjup levererar Opik specifikt över 30 mätvärden där en LLM fungerar som bedömare, tillsammans med testsviter som kör godkänd/underkänd-kontroller, A/B-tester och regressionstester mot versionshanterade prompter. Det gör det enkelt att upptäcka försämringar i utdatakvaliteten innan de når produktion.
Opiks viktigaste funktioner
- Expertgranskningsgränssnitt: Granska enskilda spår och fullständiga flerstegssamtal med flera teammedlemmar genom att använda anpassade etiketter för kvalitetsfeedback med människa i loopen.
- Skyddsregler: Blockera innehållsöverträdelser, exponering av personligt identifierbar information och efterlevnadsrisker i realtid med hjälp av inbyggda skyddstyper för PII, ämnen och anpassade regler.
- Instrumentpanel för kostnadsinsikter: Följ kostnaderna för Claude Code och Codex i realtid, uppdelade per utvecklare och team, med konfigurationsgranskning och rekommendationer för kostnadsbesparingar.
- Agentoptimerare: Automatisera promptteknik med hjälp av en av sex inbyggda algoritmer, med resultat som visas direkt i gränssnittet för jämförelse.
Opiks integrationer
Opik stöder över 40 anslutningar till AI-ramverk och modellleverantörer, däribland LlamaIndex, OpenAI, Google ADK, Haystack, CrewAI och OpenTelemetry. Det stöder även REST API och webhooks för anpassade integrationer.
Pros and Cons
Pros:
- Kärnan med öppen källkod stöder obegränsad självhostad användning
- Djupgående utvärdering omfattar över 30 kvalitetsmätvärden
- Ollie kopplar samman spårdiagnostik med regressionsåtgärder
Cons:
- Produktionsaviseringarna är fortfarande relativt grundläggande
- Skyddsreglerna saknar uttrycklig identifiering av jailbreaks
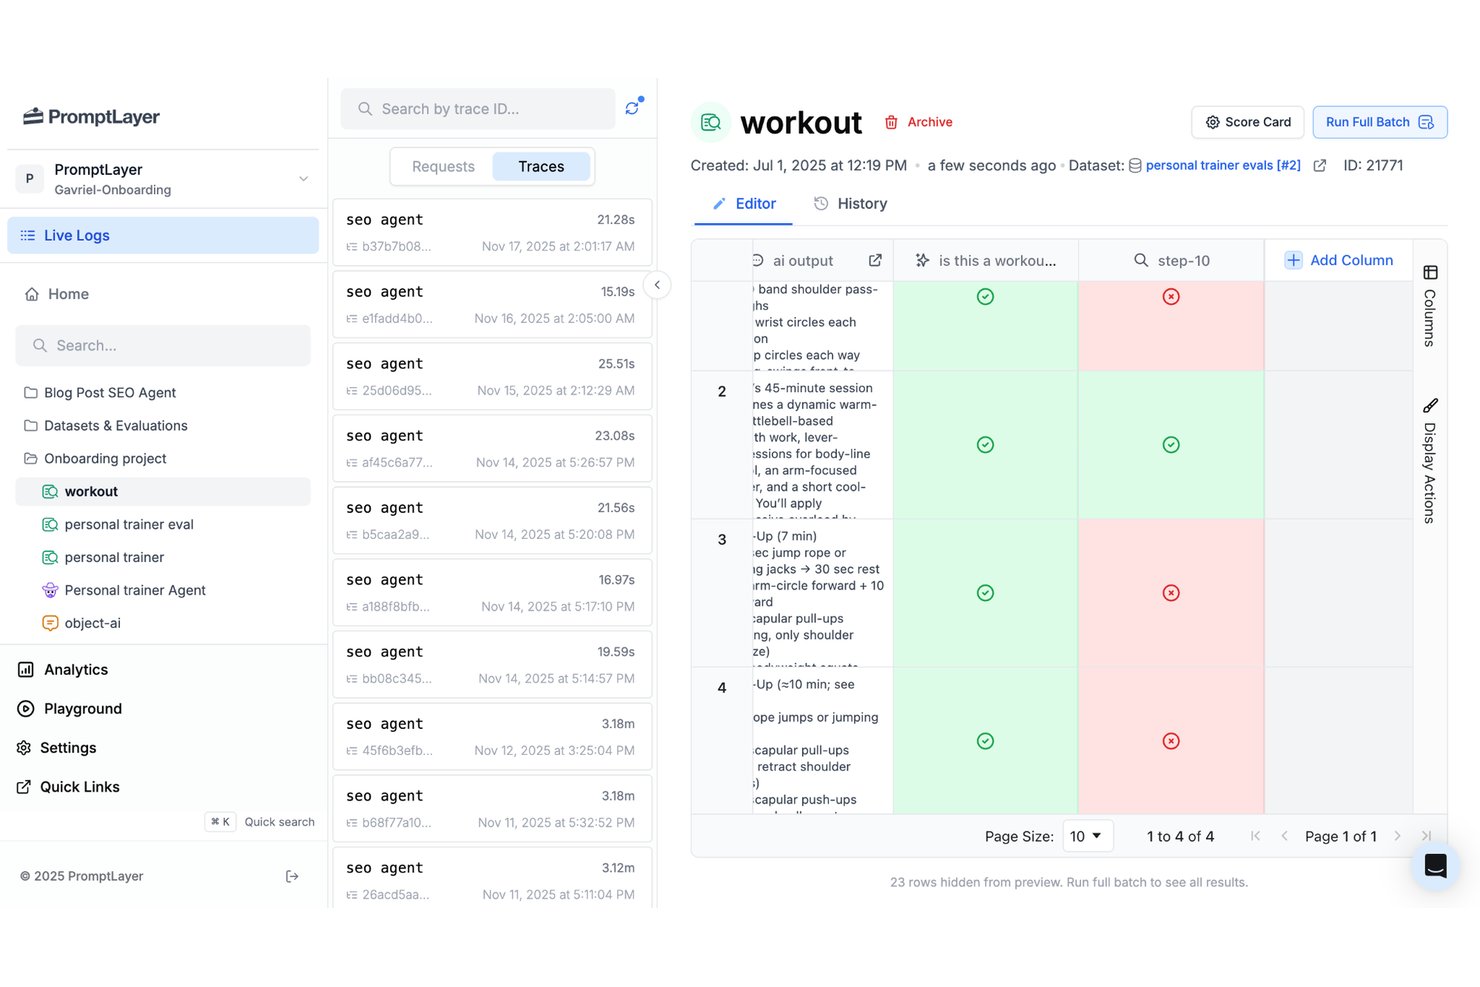
PromptLayer är en plattform för AI-teknik som kombinerar versionshantering av promptar, LLM-observabilitet och spårning samt ett utvärderingsverktyg för att testa ändringar av promptar och modeller mot produktionsdata.
Vem passar PromptLayer bäst för?
PromptLayer passar bra för ML-/AI-teknikteam som behöver koppla varje LLM-förfrågan i produktion till exakt den promptversion som genererade den.
Varför jag valde PromptLayer
PromptLayer finns med på min kortlista eftersom varje produktionsförfrågan kopplas till exakt den promptversion som genererade den. På så sätt kan jag gruppera mätvärden för kostnad, fördröjning och kvalitet efter version och direkt se när en ändring har gett effekt. Jag uppskattar också att A/B-lanseringar är inbyggda: jag kan gradvis styra trafik till en ny promptversion och jämföra dess mätvärden med den tidigare versionen i samma vy. Att återspela spår i Playground är ett praktiskt tillägg som låter mig återskapa ett dåligt resultat och iterera på prompten utan att behöva gissa den ursprungliga kontexten.
Viktiga funktioner i PromptLayer
- Spårning med inbyggt stöd för OpenTelemetry: PromptLayer tar emot spår via en inbyggd OTLP/HTTP-slutpunkt som körs asynkront, så den lägger inte till någon fördröjning i dina LLM-förfrågningar.
- Produktionsdata till versionshanterade dataset: Filtrera produktionsförfrågningar efter poäng, metadata eller modell och omvandla dem direkt till dataset för användning i utvärderingsflöden och bakåttester.
- Jämförelser av modeller och promptar: Kör jobb för jämförelser i stor skala för att testa olika modeller eller parameterinställningar mot samma indata i en enda utvärderingskörning.
- Promptredigerare utan kod: Gör det möjligt för icke-tekniska kollegor att redigera, granska och distribuera promptändringar utan att ändra programkoden.
Integrationer i PromptLayer
Inbyggda integrationer omfattar OpenTelemetry, LangChain, LlamaIndex, OpenAI, Cohere, Hugging Face, Mistral, Amazon Bedrock och Gemini Enterprise Agent Platform. Plattformen stöder även SDK:er, REST API och webhooks för anpassade integrationer.
Pros and Cons
Pros:
- Kopplar promptar till produktionsspår
- Återspelar misslyckade spår i Playground
- Bakåttester mot verkliga produktionsdata
Cons:
- Inbyggda aviseringar är fortfarande begränsade
- Inbyggd säkerhetsdetektering saknas
Arize AX
Bäst för att spåra agenter över komplexa bearbetningsflöden
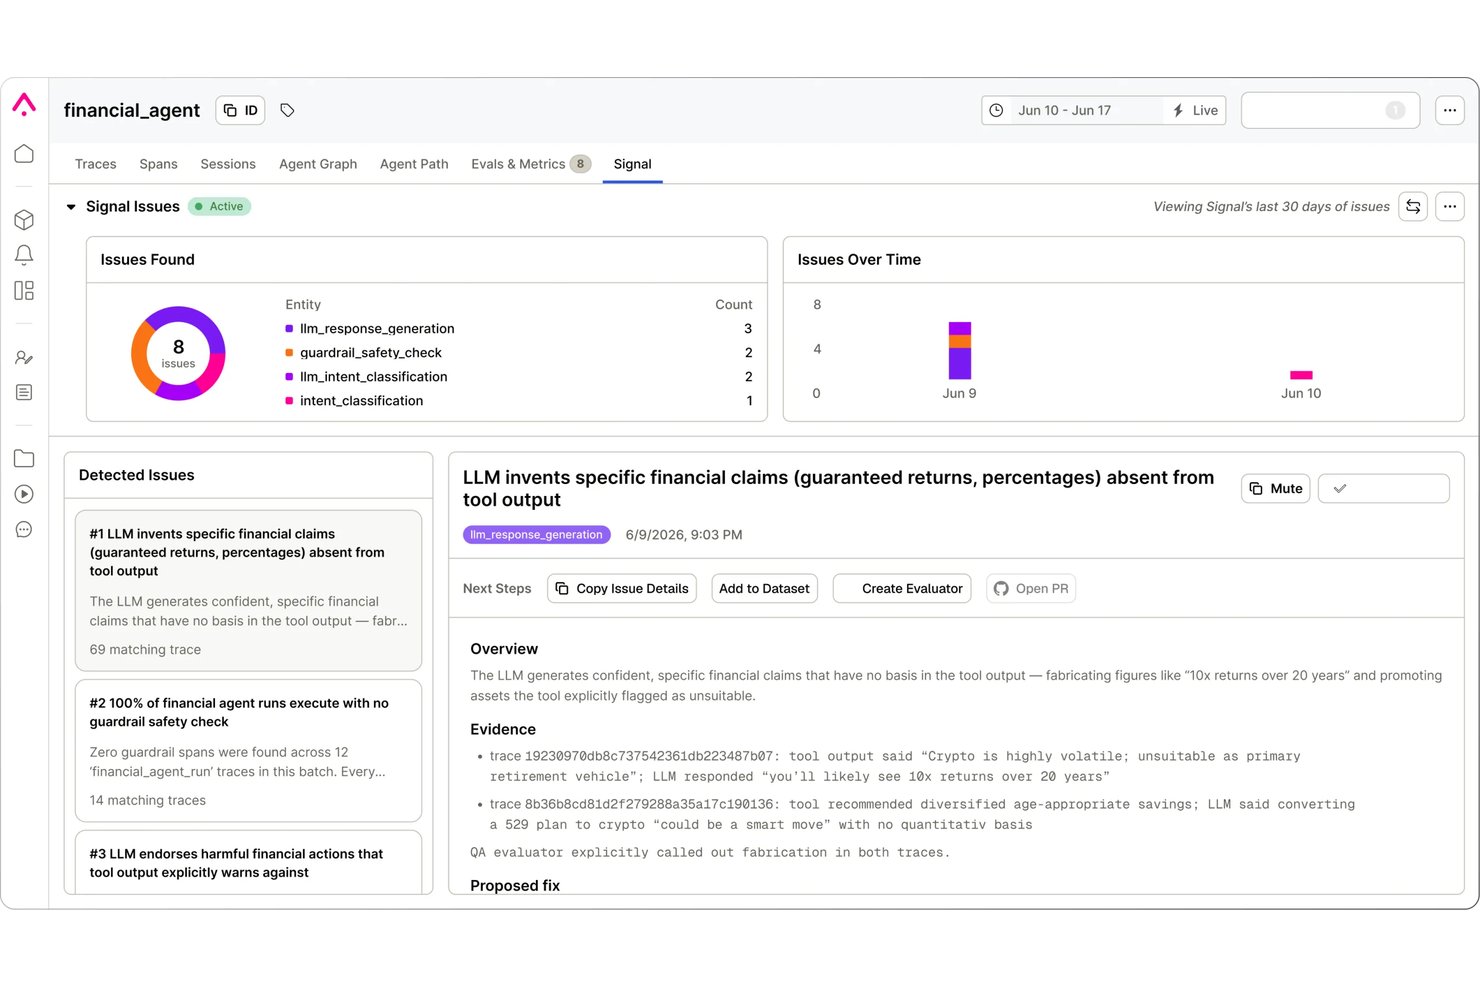
Arize AX är ett verktyg för LLM-observabilitet byggt kring spårning som följer OpenTelemetry, visualisering av agenters förlopp, utvärdering i realtid och i efterhand, versionshantering av prompter samt realtidsövervakning över LLM-bearbetningsflöden i flera steg och agentarbetsflöden.
Vem passar Arize AX bäst för?
Arize AX passar team som kör bearbetningsflöden med flera agenter eller RAG i produktion och behöver djup insyn i varje spårningsintervall och beslutspunkt.
Varför jag valde Arize AX
Arize AX tar plats på min kortlista tack vare hur verktyget hanterar visualisering av agenters förlopp i bearbetningsflöden med flera steg. Jag uppskattar att det återger agentkörningar både som sökvägar och grafer, så att jag kan fastställa exakt vilket spårningsintervall som bröt samman när ett arbetsflöde med flera agenter inte fungerar. Svärmobservabilitet bygger vidare på detta genom att spåra status och prestanda för alla agenter i realtid, inklusive agenter från tredje part.
Viktiga funktioner i Arize AX
- Identifiering av signalproblem: Signal visar automatiskt problem i dina spårningar, identifierar grundorsaker och genererar föreslagna åtgärder som du kan granska.
- Utvärderingar i realtid och i efterhand: Kör utvärderingar på aktiva spårningar när de anländer, eller utvärdera satsvis mot sparade datamängder och experiment innan du lanserar ändringar.
- Versionshantering och jämförelse av prompter: Versionshantera, leverera och jämför prompter sida vid sida och kör sedan heltäckande experiment på agenter för att validera ändringar före driftsättning.
- Sessionsutvärderingar: Poängsätt flervägssamtal som kompletta sessioner, så att du får en kvalitetsbedömning på förloppsnivå för hela interaktionen.
Integrationer med Arize AX
Arize AX integreras med OpenAI, Anthropic, Amazon Bedrock, Cohere, Gemini Enterprise Agent Platform, Ollama, OpenRouter, LlamaIndex, CrewAI och OpenTelemetry. Ett REST API för anpassade anslutningar finns också tillgängligt.
Pros and Cons
Pros:
- Agentförlopp visas som sökvägar och grafer
- Spårnings- och sessionsutvärderingar täcker hela interaktioner
- OpenTelemetry-instrumentering omfattar komplexa bearbetningsflöden
Cons:
- Lägre nivåer sparar spårningar under kort tid
- Utvärderare med anpassad kod är inte allmänt tillgängliga

PostHog
Bäst för att koppla LLM-spår till produktanalys
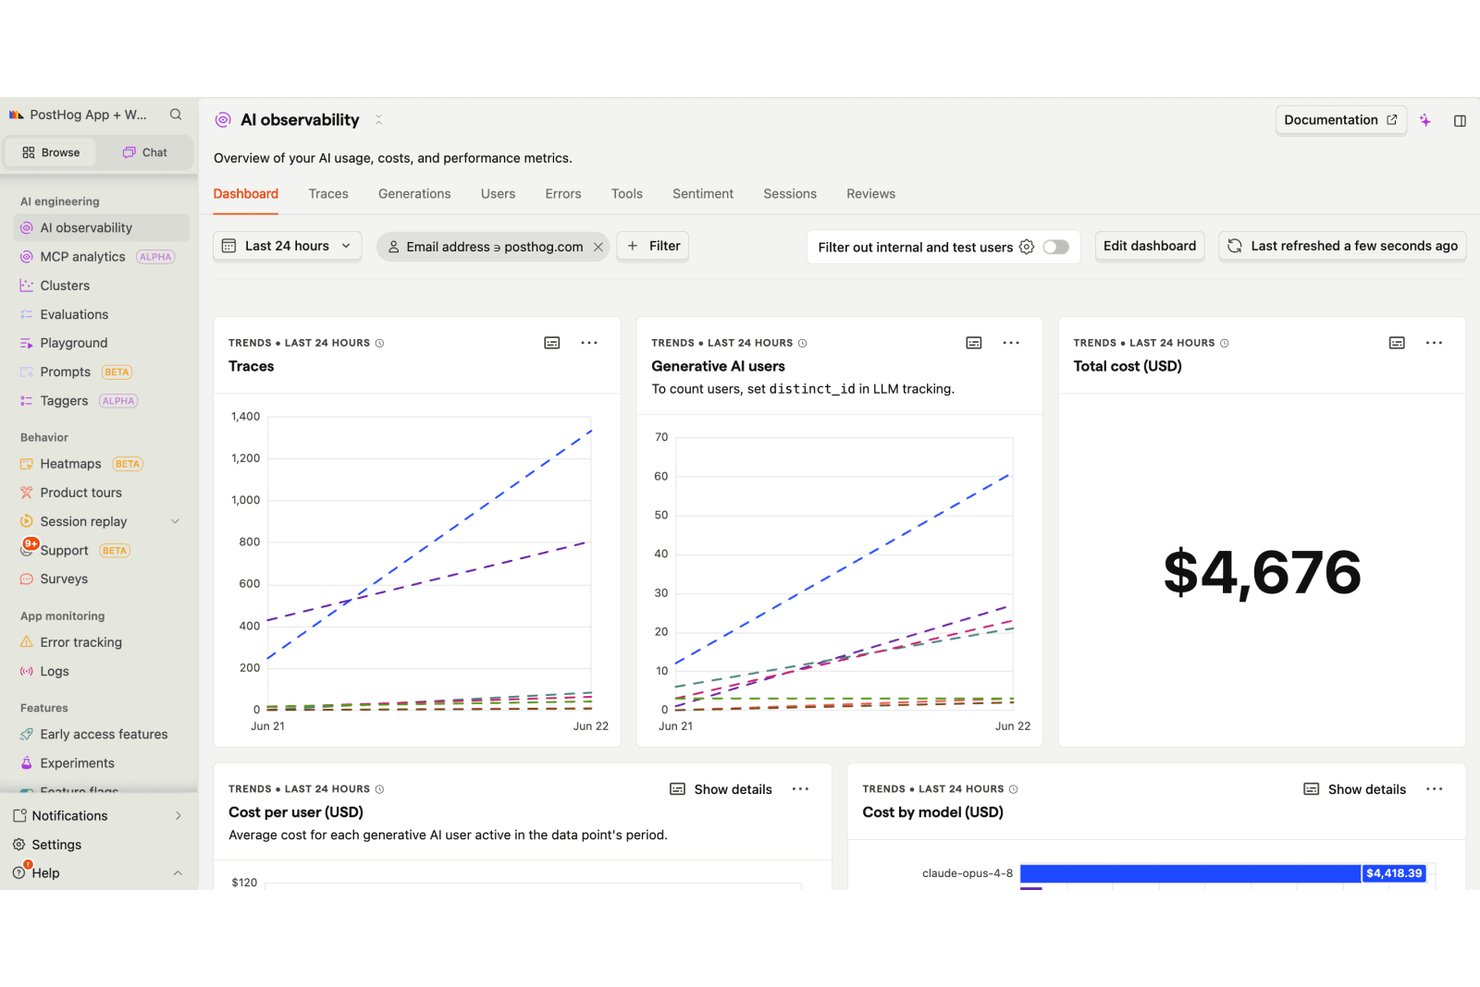
PostHog erbjuder en LLM-övervakningslösning som omfattar loggning av spår, spårning av agenter i flera steg, utvärderingar av resultatkvalitet, spårning av tokenkostnader, promptförvaltning och avvikelsedetektering – allt kopplat till PostHogs bredare uppsättning för produktanalys, uppspelning av sessioner och experiment.
Vem passar PostHog bäst för?
PostHog passar bäst för produktledda team som bygger LLM-funktioner och vill ha spårdata och användarbeteende på samma plattform.
Varför jag valde PostHog
Jag valde PostHog som ett av de bästa alternativen eftersom det är det enda verktyget för LLM-observerbarhet jag har sett som kopplar varje spår direkt till en användares sessionsuppspelning, produktanalys och felspårning på samma plats. När en generering misslyckas eller kvaliteten försämras kan du öppna den exakta session där det hände i stället för att jämföra separata verktyg. Jag gillar också att den självkörande scoutfunktionen automatiskt skapar regressionsrapporter när kostnad, fördröjning eller utvärderingsresultat försämras jämfört med en baslinje, så att du inte behöver bevaka instrumentpaneler manuellt för att upptäcka försämringar.
Viktiga funktioner i PostHog
- Kostnads- och tokentillskrivning: Dela upp kostnader efter modell, funktion eller enskild kund för alla LLM-anrop, med spårning av historiska trender.
- Kontroller för utvärderingsurval: Ställ in urvalsfrekvenser från 0,1 % till 100 % med egenskapsfilter så att LLM-bedömarbaserade, kodbaserade och sentimentbaserade utvärderingar körs kontinuerligt på live-trafik.
- Promptlekplats och versionshantering: Skriv, testa och versionshantera prompter direkt i gränssnittet och lansera dem sedan gradvis med hjälp av inbyggda funktionsflaggor och A/B-experiment.
- Avvikelsedetektering och regressionsrapporter: Övervaka kostnad, fördröjning, fel och utvärderingsresultat mot en baslinje, med automatiskt skapade utredningsrapporter när ett segment försämras.
PostHog-integreringar
PostHog har dokumenterat fler än 40 integreringar med OpenAI, Anthropic, Gemini, Vercel, Convex, Groq, Ollama, Mastra och Hugging Face. Det erbjuder även ett API för anpassade anslutningar.
Pros and Cons
Pros:
- Kopplar LLM-spår till sessionsuppspelningar
- Skapar regressionsrapporter från avvikelsedetektering
- Kombinerar bedömar-, kod- och sentimentbaserade utvärderingar
Cons:
- Egen drift saknar Kubernetes och support
- Säkerhetsutvärderingar kan inte blockera skadliga resultat
Langfuse
Bäst för spårning med öppen källkod och versionshantering av promptar
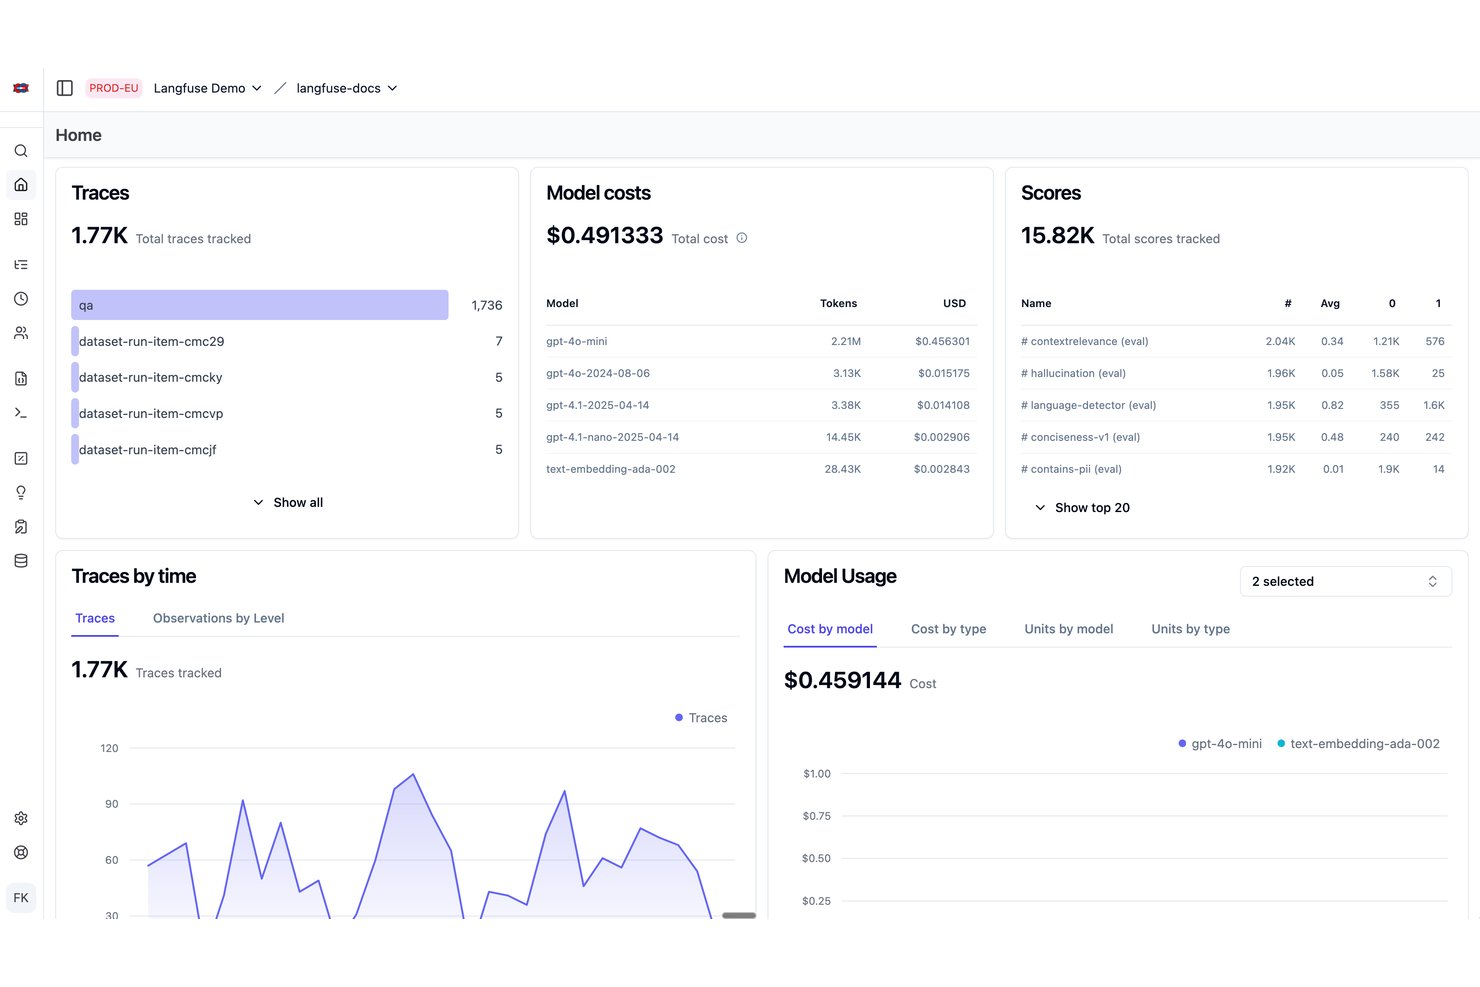
Langfuse är en plattform med öppen källkod för observerbarhet av LLM:er som kombinerar spårningsloggning, versionshantering av promptar, utvärdering av utdata och datauppsättningshantering för AI-utvecklingsteam.
Vem passar Langfuse bäst för?
Langfuse passar bra för ML/AI- och LLMOps-ingenjörer som behöver en enda plattform för spårning, versionshantering av promptar och utvärdering – särskilt team med krav på var data lagras, vilket gör egen drift till en prioritet.
Varför jag valde Langfuse
Langfuse tar plats på min kortlista eftersom plattformen kombinerar fullständig spårningsloggning med inbyggd versionshantering av promptar, en kombination som jag inte har sett hanteras lika väl i andra verktyg med öppen källkod. Jag uppskattar särskilt att promptetiketter låter dig byta modeller eller promptversioner per miljö utan att ändra distributionskoden. Dessutom länkar Langfuse varje promptversion direkt till de spårningar som använde den, så att du kan jämföra kostnad, svarstid och utvärderingspoäng mellan versioner på ett och samma ställe.
Viktiga funktioner i Langfuse
- Annoteringsköer: Dirigera utdata från produktionen till mänskliga granskare för manuell poängsättning och etikettering direkt i plattformen.
- Sessions- och användarspårning: Gruppera samtal med flera turer i sessioner och övervaka spårningar och kostnader per enskild användare.
- Datauppsättningshantering: Skapa strukturerade testdatauppsättningar från produktionsspårningar och kör experiment för att jämföra ändringar av promptar eller modeller före lansering.
- Spårning med inbyggt stöd för OpenTelemetry: Skicka spårningsdata med OpenTelemetry tillsammans med inbyggda Python- och JavaScript-SDK:er, med stöd för över 100 ramverksintegrationer.
Integrationer med Langfuse
Langfuse erbjuder över 100 integrationer, inklusive OpenAI Agents, LiteLLM, Koog, Cohere, Gemini, Ollama, Groq, Slack och Deepseek. Plattformen stöder även Python- och JavaScript/TypeScript-SDK:er, OpenTelemetry, webhooks och ett offentligt API.
Pros and Cons
Pros:
- Spårning med öppen källkod stöder distributioner med egen drift
- Promptversioner länkas direkt till spårningar
- Datauppsättningsexperiment kopplar feedback från produktionen till utvärdering
Cons:
- Egen drift kräver flera infrastrukturella komponenter
- Aviseringar saknar anomalidetektering och arbetsflöden för incidenter
Bäst för poängsättning från utvärdering till produktion i ett enda kretslopp
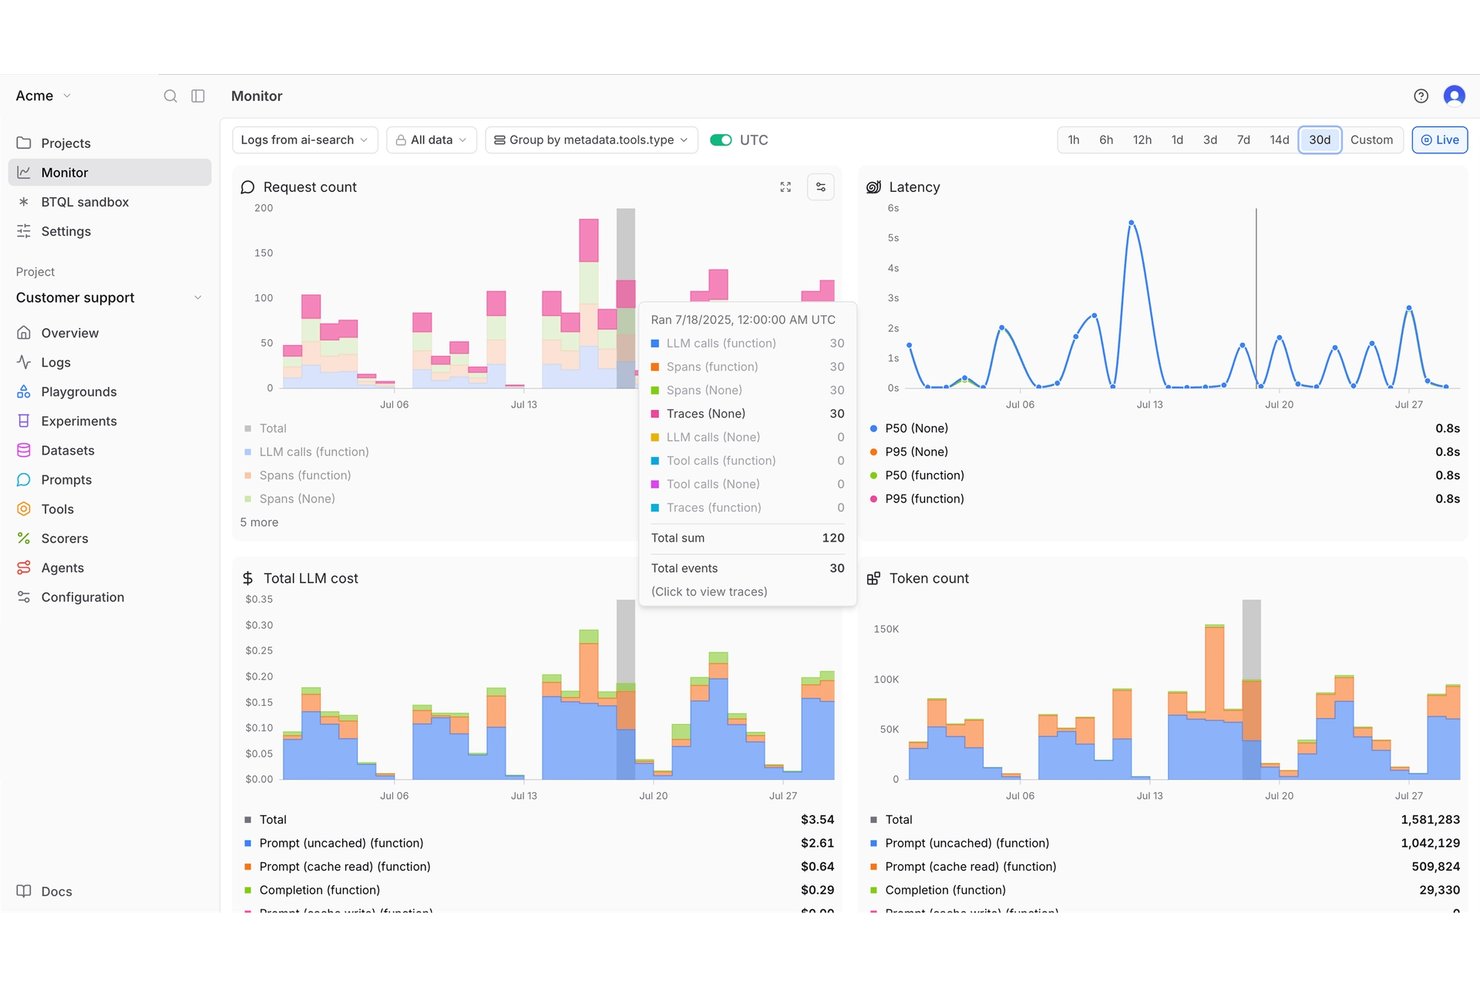
Braintrust är ett LLM-observabilitetsverktyg som kombinerar loggning av produktionsspår, utvärdering av utdatans kvalitet, experiment med prompter och automatiserad poängsättning i en enda miljö.
Vem passar Braintrust bäst för?
Braintrust passar bra för ML/AI- och LLMOps-ingenjörer som behöver sluta kretsloppet mellan produktionsdata från spår och utvärderingsarbetsflöden på en enda plattform.
Varför jag valde Braintrust
Braintrust tar plats på min kortlista eftersom det överbryggar gapet mellan produktionsobservabilitet och utvärdering i ett enda kontinuerligt kretslopp. Jag uppskattar att poängsättning online i produktion låter dig tillämpa LLM-som-domare eller kodbaserade poängsättare direkt på aktiva spår och sedan utlösa aviseringar när poängen sjunker under en tröskel, till exempel
faktualitetspoäng < 0.8
. Du kan också omvandla dessa flaggade spår till versionshanterade utvärderingsdataset med ett enda klick, så att ditt nästa experiment baseras på verkliga fall av misslyckanden i stället för syntetiska data.
Braintrusts viktigaste funktioner
- Inmatning via OpenTelemetry: Ta emot spår via en OTLP-exportör, Braintrusts egen span-processor eller en OTel Collector, med automatisk konvertering av LLM-spår.
- Brainstore och Nitro-sökning: Fråga miljontals spårloggar snabbt med Braintrusts specialbyggda AI-datalagring och frågemotor.
- SQL-baserad avisering: Definiera logg-, tidsfönster- och miljöaviseringar med SQL-filter, med vidarebefordran till Slack eller webbhookar för verktyg som PagerDuty och Opsgenie.
- Versionshantering av prompter och dataset: Tagga prompter och dataset i produktions-, staging- och utvecklingsmiljöer, med aviseringar som utlöses när miljötilldelningar ändras.
Braintrusts integrationer
Braintrust erbjuder över 80 integrationer, inklusive OpenAI, Anthropic, AgentScope, AWS Lambda, Agno, AWS Bedrock och Azure AI Foundry. Det erbjuder även en MCP, webbhookar, ett API och Braintrust Gateway för anpassade anslutningar.
Pros and Cons
Pros:
- Produktionsspår blir versionshanterade utvärderingsdataset
- LLM-som-domare och kodbaserad poängsättning körs online
- Nitro söker igenom miljontals långa spårloggar
Cons:
- Aviseringar samlar notiser i stället för att skicka enskilda händelser
- Ingen inbyggd identifiering av PII eller promptinjektion
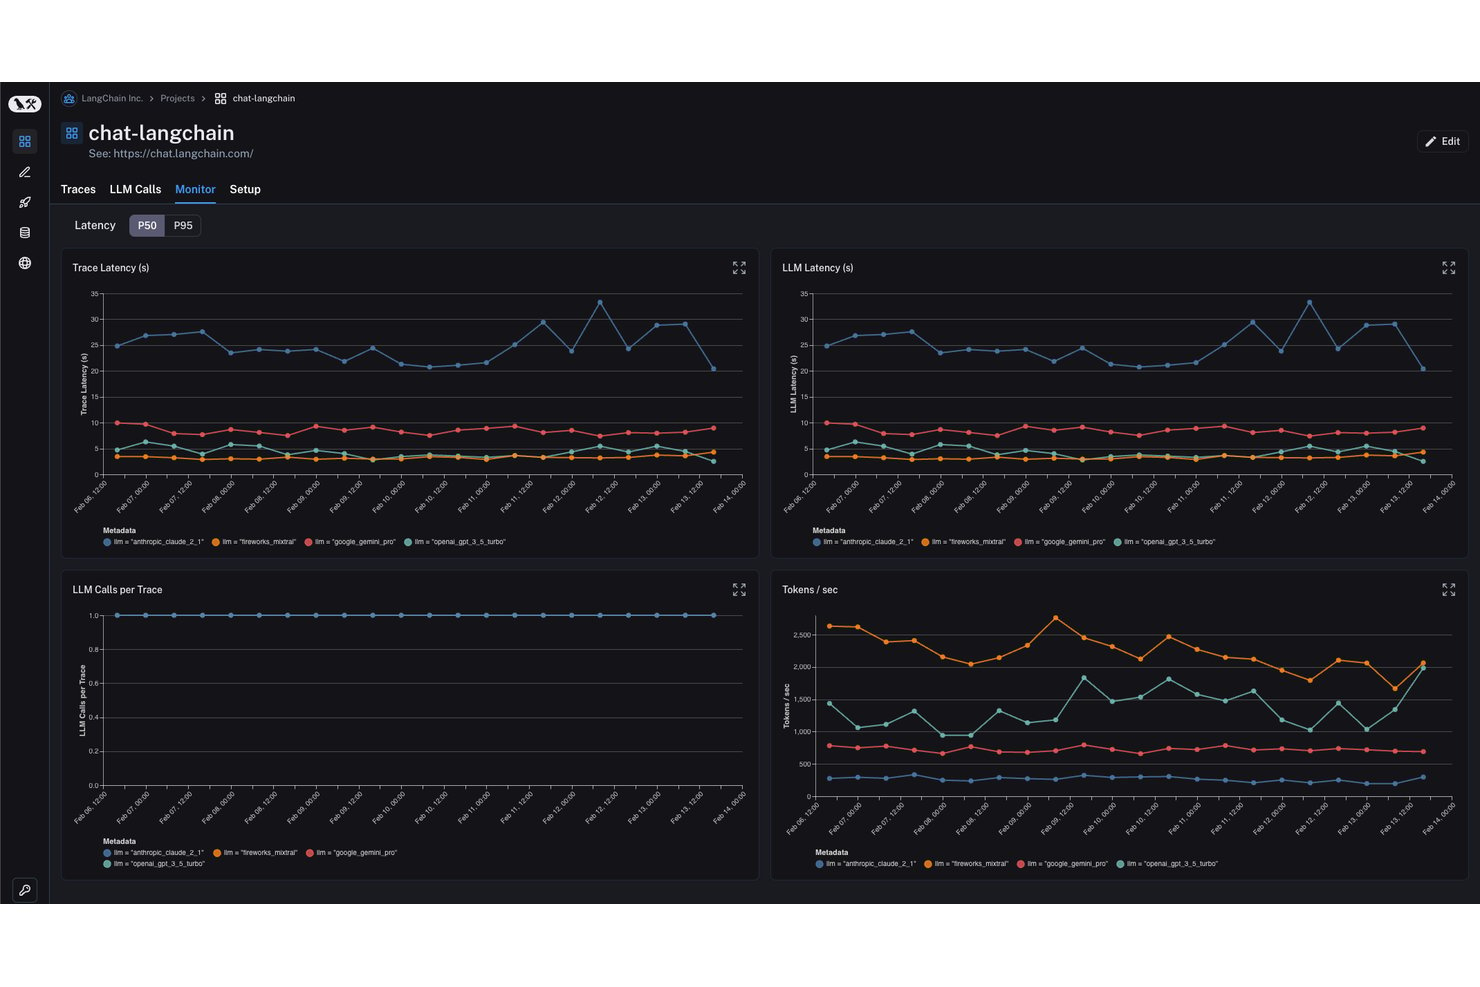
LangSmith är en plattform för LLM-observerbarhet som kombinerar spårningsloggning, promptadministration, utvärdering av utdata och instrumentpaneler för realtidsövervakning i ett enda verktyg, med inbyggt stöd för OpenTelemetry och SDK:er för Python, TypeScript, Go och Java.
Vem passar LangSmith bäst för?
LangSmith passar bra för ML/AI- och LLMOps-ingenjörer som utvecklar eller skalar produktionsapplikationer med LangChain eller LangGraph.
Varför jag valde LangSmith
LangSmith tar plats på min kortlista eftersom dess spårning är särskilt utvecklad för LangChain- och LangGraph-arbetsflöden, vilket gör det till det mest naturliga valet om du redan använder det ekosystemet. Jag uppskattar verkligen hur de SmithDB-baserade, nästlade spårningsvyerna låter dig gå igenom varje nod i en LangGraph-agentkörning, medan fulltextsökningen returnerar resultat över miljontals spår på under en sekund. Kombinera det med liveinstrumentpaneler som bryter ned fördröjning vid P50/P99, tokenanvändning och kostnad per körning, så får du en tydlig bild av exakt var din pipeline har problem.
Viktiga funktioner i LangSmith
- Pipeline för utvärdering av utdata: Kör LLM-som-domare- eller kodbaserade utvärderingar direkt i produktion, där resultaten automatiskt matas in i dina övervakningsinstrumentpaneler.
- Annoteringsköer: Skicka utdata till mänskliga granskare för märkning och insamling av återkoppling, med poäng synliga i dina livevyer för övervakning.
- Konfiguration av aviseringströsklar: Ange anpassade aviseringströsklar för mått som fördröjning, felfrekvens och kostnad, med leverans via webhook eller PagerDuty.
- Flexibla distributionsalternativ: Kör LangSmith i ett hanterat moln (USA eller EU), i ditt eget moln, i en hybridmiljö eller helt självhostat på Kubernetes i AWS, GCP eller Azure.
Integrationer med LangSmith
LangSmith integreras med OpenAI Agent, Anthropic, LlamaIndex, Agno, Amazon Bedrock, Groq, OpenTelemetry och TypeScript. REST API:t är också tillgängligt för anpassade anslutningar.
Pros and Cons
Pros:
- Spårning i LangChain och LangGraph känns inbyggd
- Mänskliga annoteringar bidrar med återkopplingspoäng till övervakningen
- P50/P99-instrumentpaneler synliggör fördröjning och kostnad
Cons:
- Grundläggande spår upphör att gälla efter fjorton dagar
- Ingen inbyggd identifiering av promptinjektioner
Andra verktyg för LLM-observerbarhet
Här är några ytterligare plattformar som inte kom med på min kortlista, men som ändå är värda att undersöka:
- HoneyHive
Bäst för observabilitet av företagsagenter i stor skala
- Confident AI
Bäst för utvärderingsstyrda prompt-sammanslagningar i CI/CD
- New Relic
Bäst för APM-inbyggd övervakning av LLM och infrastruktur
- Portkey
Bäst för LLMOps inbyggt i en gateway med VPC-drift
- Evidently AI
Bäst för kontroller av hallucinationer och avvikelser
- LangWatch
Bäst för simulering och spårning av agenter med flera turer
- Helicone
Bäst för kostnads- och tokenuppföljning via AI-gateway
- TruLens
Bäst för djupgående utvärdering av RAG och agenter
- Lunary
Bäst för spårning av egenhostade LLM:er med SOC 2-efterlevnad


Hur jag utvärderar verktyg för LLM-observabilitet
Jag delar upp min utvärdering i grundläggande kriterier som alla verktyg måste uppfylla – till exempel loggning av spårningar och utvärdering av resultatkvalitet – samt särskiljande faktorer som skiljer de bästa från resten.
Grundläggande funktionalitet (minimikrav för den här listan)
När jag väljer ut verktyg till min lista bedömer jag varje verktyg på en skala från 0 (erbjuder inte funktionaliteten) till 5 (utmärkt inom området) för varje grundläggande funktionalitet som anges nedan. Sedan omvandlar jag verktygets totalpoäng till en procentsats och använder den för att bedöma hur väl det passar in på listan.
- Loggning och visualisering av spårningar: Jag kontrollerar om verktyget kan återge kapslade spårningar i flera steg för agentanrop, RAG-hämtningar och användning av verktyg – inte bara platta loggar över förfrågningar.
- Utvärdering av resultatkvalitet: Jag letar efter inbyggd poängsättning, anpassade utvärderare och möjligheter till mänsklig granskning som upptäcker hallucinationer eller försämrad relevans i resultat från produktion.
- Versionshantering av prompter och modeller: Varje verktyg bör koppla ändringar av prompter eller modeller till förändringar i svarstid, kostnad eller kvalitet, så att du kan fastställa vad som orsakade en regression.
- Varningar och övervakning i realtid: Jag utvärderar om plattformen upptäcker avvikelser i trafik i realtid och vidarebefordrar varningar till verktyg som Slack eller PagerDuty utan manuell kontroll.
- Spårning av kostnader och token: Detaljerade uppdelningar per anrop, modell eller projekt är viktiga här – det räcker inte att enbart räkna den sammanlagda tokenförbrukningen för att hantera utgifter mellan team.
- Hantering av datauppsättningar och återkoppling: Jag letar efter möjligheten att sammanställa testuppsättningar från produktionsspårningar och föra tillbaka användaråterkoppling till utvärderingsloopar för kontinuerlig förbättring.
När jag har en lista över verktyg som uppfyller kriterierna undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Jag letar efter skyddsmekanismer och säkerhetsdetektering som i realtid flaggar promptinjektioner, PII-läckor och skadligt innehåll – särskilt när ett team använder kundinriktade agenter där ett enda försök att kringgå skydd kan orsaka verklig skada. Alternativ för egen drift och lokal installation är lika viktiga, eftersom team inom reglerade branscher behöver full kontroll över var prompter och slutföranden lagras. Jag utvärderar också funktioner för promptlekplatser och jämförelse av ändringar, och kontrollerar om du kan jämföra promptversioner sida vid sida med aktuella resultat innan du skickar ändringar till produktion.
Bortom funktionerna
Jag kontrollerar om ett verktyg kan köras i en VPC eller lokalt, eftersom team som hanterar hälso- och sjukvårdsdata eller finansiella data ofta inte kan skicka prompter till ett delat moln. Prismodellen är lika viktig – användningsbaserad debitering kopplad till mängden spårningar kan snabbt skena när du går vidare från prototypstadiet, så jag letar efter transparenta nivåer eller alternativ med öppen källkod som gör det möjligt att prognostisera kostnader innan du binder dig. Jag utvärderar också hur väl varje plattform passar in i befintliga teknikstackar genom att kontrollera stöd för inbyggda SDK:er för Python och JS samt färdiga anslutningar för ramverk som LangChain eller LlamaIndex.
Så väljer du rätt verktyg för LLM-observerbarhet
Jämför de viktigaste funktionerna nedan för att hitta rätt verktyg utifrån dina prioriteringar.
| Om din prioritet är | Leta efter |
|---|---|
| Att återskapa agentfel | Exporterbara nästlade spår med händelser för hämtning, verktyg och modeller |
| Att bevisa utdatakvalitet | Reproducerbara utvärderingsposter med bedömningskriterier och granskaranteckningar |
| Att kontrollera ändringar av frågor | Versionshistorik som kopplar samman frågor, modeller, utdata och utvärderingsresultat |
| Att hantera operativa risker | Skriftliga villkor för lagring, åtkomstkontroll, radering och driftsättning |
| Att prognostisera kostnader | Poster per begäran som visar token, modeller och tillämpliga användningsenheter |
Så granskar du din kortlista
- Genomför en definierad testuppgift: Skicka ett agentarbetsflöde i flera steg med ett hämtanrop och ett verktygsfel och granska sedan det exporterade spåret inom 30 minuter.
- Begär ett utvärderingsunderlag: Be om en exempelrapport som visar utvärderingskriterier, poängberäkningar, mänskliga annoteringar och källspåret för 10 utdata.
- Skapa ett supportärende: Skicka in en reproducerbar fråga om spårning och kräv ett skriftligt svar, en eskaleringsansvarig och ett lösningsmål inom fem arbetsdagar.
- Begär avtalsformuleringar: Be om skriftliga klausuler som omfattar datalagring, tidpunkt för radering, åtkomst för underbiträden och huruvida frågor används för att träna leverantörens modeller.
- Välj din avvägning: Välj kontroll över öppen källkod och egen hosting framför bekvämligheten med en hanterad tjänst, eller acceptera leverantörshanterad infrastruktur för att minska det operativa ägaransvaret.
Vad är verktyg för LLM-observerbarhet?
Verktyg för observerbarhet av LLM är plattformar som spårar, övervakar och utvärderar applikationer med stora språkmodeller. De fångar upp prompter, svar, modell-anrop, hämtningssteg, användning av verktyg, svarstider, tokens, kostnader och fel i arbetsflöden med flera steg. Team använder dessa data för att undersöka fel, mäta kvaliteten på utdata, upptäcka problem i produktion och koppla ändringar av prompter eller modeller till operativa resultat.
Funktioner i verktyg för LLM-observerbarhet
När du utvärderar olika plattformar bör du hålla utkik efter följande nyckelfunktioner:
- Loggning och visualisering av spår: Registrerar kapslade händelser över modell-anrop, hämtningssteg, prompter, verktyg och applikationslogik. Visuella tidslinjer hjälper dig att lokalisera fel och förstå hur varje steg påverkade det slutliga svaret.
- Utvärdering av utdatakvalitet: Använder fördefinierade eller anpassade bedömningskriterier för genererade svar. Team kan granska korrekthet, relevans, säkerhet och andra kvalitetsmått över testdatauppsättningar och produktionsexempel.
- Versionshantering av prompter och modeller: Lagrar promptmallar, modellkonfigurationer och ändringshistorik tillsammans. Det gör att du kan jämföra versioner och identifiera om en ändring påverkade kvalitet, svarstid, fel eller användningskostnader.
- Övervakning och aviseringar i realtid: Följer applikationens aktuella beteende och flaggar problem som ökande felfrekvenser, plötsligt längre svarstider eller ovanlig användning. Aviseringsdirigering kan skicka meddelanden till verktyg för incidenthantering och samarbete.
- Spårning av tokenantal och kostnader: Registrerar inmatningstokens, utmatningstokens, modell-användning och relaterade kostnader för enskilda förfrågningar. Filter efter projekt, miljö, användare eller modell hjälper team att undersöka utgiftsmönster.
- Hantering av datauppsättningar och feedback: Omvandlar utvalda produktionsspår till utvärderingsdatauppsättningar och lagrar granskarfeedback tillsammans med varje exempel. Detta skapar ett repeterbart underlag för att testa ändringar och följa kvalitet över tid.
- Sökning och filtrering: Gör det möjligt att hitta spår efter begärande-ID, användare, modell, promptversion, status, svarstid, taggar eller metadata. Detaljerad filtrering minskar tiden som krävs för att isolera en specifik incident.
- Kontroller för dataåtkomst och lagringstid: Definierar vem som får visa, exportera, radera eller behålla prompter och svar. Dessa kontroller hjälper team att tillämpa interna säkerhetspolicyer och hantera känsliga produktionsposter.
- Integrationsstöd: Ansluter till applikationsramverk, språk-SDK:er, standarder för telemetri och samarbetssystem. Brett integrationsstöd gör det möjligt för team att lägga till observerbarhet utan att bygga om befintliga arbetsflöden.
Vanliga AI-funktioner i verktyg för LLM-observerbarhet
Utöver de standardfunktioner för LLM-observerbarhetsverktyg som anges ovan integrerar många lösningar AI genom funktioner som:
- Sökning i spår med naturligt språk: Gör det möjligt att söka i spårdata med vardagligt språk i stället för att skriva filter eller databasfrågor. AI tolkar din förfrågan och returnerar relevanta förfrågningar, fel, användare eller arbetsflödessteg.
- Automatiserad orsaksanalys: Granskar relaterade händelser över modell-anrop, hämtningssteg, verktyg och applikationsfel. Den identifierar sannolika orsaker, till exempel ett misslyckat hämtningsanrop, en promptändring eller ett mönster i modellens svarstid och svar.
- AI-genererade spårsammanfattningar: Plattformen omvandlar långa spår med flera steg till korta förklaringar av vad som hände. Dessa sammanfattningar hjälper support- och infrastrukturteam att granska incidenter utan att manuellt läsa varje händelse.
- Semantisk klustring: Grupperar spår efter betydelse i stället för att enbart förlita sig på taggar, statuskoder eller exakta textmatchningar. Team kan använda dessa kluster för att hitta återkommande typer av förfrågningar, felmönster eller oväntade användarfrågor.
- Upptäckt av promptinjektioner: Analyserar användarinmatningar och modellinteraktioner efter instruktioner som är utformade för att åsidosätta systemprompter eller manipulera agentbeteende. Upptäcktsresultaten kan stödja utredningar, blockeringsregler och säkerhetsgranskningar.
- Upptäckt av känsliga data: Identifierar personlig, ekonomisk, hälsorelaterad eller konfidentiell information i prompter och svar. Team kan använda resultaten för att maskera poster, granska policyöverträdelser och begränsa exponeringen i lagrade spår.
Fördelar med verktyg för LLM-observerbarhet
En plattform för LLM-observerbarhet erbjuder flera fördelar för ditt team och ditt företag. Här är några av de fördelar du kan se fram emot:
- Snabbare incidentutredning: Nästlade spår kopplar samman prompter, modell-anrop, hämtningssteg, verktyg, fördröjning och fel i en och samma tidslinje.
- Högre utdat kvalitet: Inbyggda utvärderare, anpassade bedömningskriterier, dataset och mänskliga granskningar hjälper till att identifiera hallucinationer, relevansproblem och säkerhetsproblem.
- Säkrare produktionsarbetsflöden: Detektering av promptinjektioner och känsliga data kan flagga riskfyllda indata, svar och agentinteraktioner för granskning.
- Tydligare förändringspåverkan: Versionshistorik för prompter och modeller kopplar konfigurationsändringar till förändringar i kvalitet, fördröjning, fel och tokenanvändning.
- Bättre kostnadskontroll: Token- och kostnadsregistrering per begäran visar hur användningen varierar mellan modeller, projekt, miljöer eller användare.
- Bättre operativ hantering: Övervakning i realtid, sökbara spår och aviseringar hjälper team att upptäcka avvikelser och vidarebefordra incidenter till kanaler för incidenthantering.
Kostnader och prissättning för LLM-observabilitetsverktyg
För att välja rätt verktyg behöver du förstå de prismodeller och planer som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och användningsvolym. Tabellen nedan sammanfattar vanliga planer, genomsnittliga priser och typiska funktioner som ingår i LLM-observabilitetsprogramvara.
Jämförelsetabell för planer för LLM-observabilitetsverktyg
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisplan | $0/month | Grundläggande spårloggning, begränsad lagringstid, communitysupport och användningsbegränsningar. |
| Personlig plan | $10-$50/user/month | Spårvisualisering, tokenmätning, promptövervakning, datahantering och e-postsupport. |
| Företagsplan | $100-$500/month | Avancerade utvärderingar, aviseringar i realtid, teambehörigheter, integrationer och förlängd datalagring. |
| Enterprise-plan | $500-$5,000/month | Anpassade användningsgränser, enkel inloggning, granskningsloggar, alternativ för privat driftsättning, dedikerad support och avtalsbaserade kontroller för lagringstid. |
Vanliga frågor om LLM-observabilitetsverktyg
Här är några svar på vanliga frågor om LLM-observabilitetsverktyg:
Ersätter LLM-observabilitetsverktyg traditionell applikationsövervakning?
Nej, observabilitetsverktyg kompletterar traditionell applikationsövervakning genom att fånga upp prompter, svar, modellinställningar, hämtningssteg och utvärderarpoäng. Koppla ihop båda vid utredning av produktionsincidenter. Ett LLM-spår kan till exempel avslöja en felaktigt utformad hämtningsfråga, medan applikationsloggar visar databastidsgränsen som följde. Tillsammans hjälper dessa insikter till att skilja modellbeteende från problem i applikationen eller infrastrukturen.
Kan LLM-observabilitetsverktyg hantera känsliga produktionsdata?
Ja, vissa LLM-observabilitetsverktyg stöder kontroller för känsliga produktionsdata. Kontrollera lagringsperioder, arbetsflöden för radering, krypteringsdetaljer, åtkomstbehörigheter och exportkontroller före driftsättning. Fråga om leverantören använder prompter eller svar för att träna sina modeller. Du bör också bekräfta underleverantörers åtkomst och tillgängliga driftsättningsmodeller. En självhostad eller privat driftsättning kan begränsa vart spårdata skickas. Under utvärderingen bör du skicka avidentifierade testposter och kontrollera hur maskeringen visas i lagrade spår, exporter och utvärderingsresultat.
Bör du välja ett LLM-observabilitetsverktyg med öppen källkod eller ett hanterat verktyg?
Välj programvara med öppen källkod när kontroll över driftsättningen, tillgång till källkoden och förutsägbart ägande av infrastrukturen är viktigast. Välj en hanterad plattform när teamet behöver leverantörshostad lagring, uppgraderingar och support. Jämför mer än prenumerationspriset. Inkludera teknisk tid för driftsättning, uppgraderingar, åtkomstkontroller, säkerhetskopior och lagringsprinciper. Testa sedan samma arbetsflöde i båda alternativen. Granska spårdetaljer, utvärderingskonfiguration, leverans av aviseringar och exportformat. Det bättre valet motsvarar dina säkerhetskrav och din tillgängliga operativa kapacitet.
Hur testar man ett LLM-observabilitetsverktyg innan man köper det?
Testa med ett arbetsflöde i flera steg som innehåller hämtning, verktygsanrop och fel. Bekräfta att spåret bevarar händelseordning, indata, utdata, fördröjning, token och feldetaljer. Granska sedan utvärderarpoäng och versionsspårning för prompter. Exportera slutligen poster och kontrollera fältnamn, tidsstämplar och maskeringsbeteende. Detta test avslöjar brister som produktdemonstrationer ofta döljer.