

Ett starkt alternativ till dbt ger ditt team tillförlitlig SQL-baserad datatransformering, versionshantering och automatisering av arbetsflöden—utan att låsa er vid ett enda arbetssätt eller ekosystem. Om du letar efter alternativ till dbt Core eller dbt Cloud väger du sannolikt in flexibilitet, integrationsmöjligheter och om du föredrar ett kodcentrerat arbetsflöde med GitHub-baserad versionshantering.
Med så många plattformar under utveckling är det svårt att veta vilka lösningar som kan hantera dina behov av datamodellering, testning, orkestrering och kollaborativ utveckling. Den här listan hjälper dig att jämföra de främsta alternativen till dbt för 2026, så att du tryggt kan välja rätt verktyg för ditt teams utmaningar inom analysutveckling.
Vad är dbt?
dbt är ett verktyg för analysutveckling som låter team transformera, testa och dokumentera data i datalagret med hjälp av SQL. Det används vanligtvis i ELT-arbetsflöden, där rådata läses in i datalagret och transformeras därefter. dbt möjliggör kodcentrerade arbetsflöden med versionshantering, CI/CD-integration, modulär datamodellering och automatiserad testning, vilket gör det enklare att hantera komplexa analysdatapipelines.
Även om dbt i sig inte är ett GUI-baserat ETL-verktyg använder det YAML för konfiguration och fungerar tillsammans med ETL-verktyg i moderna datastackar. Det integreras också med molnplattformar som GCP och andra större datalager. dbt används i stor utsträckning av dataingenjörer och analytiker som vill bygga tillförlitliga och underhållbara datatransformeringar direkt i sin datalagermiljö.
Jämförelsetabell över alternativ till dbt
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av alternativ till dbt:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bäst för avancerad analys utan kod | 3.0 out of 5 | 2 | 3 | 4 | 2 | 4 | 3 | $250/användare/månad 30 dagars kostnadsfri provperiod | Website |
Bäst för omfattande stöd för anslutningsbibliotek | Not rated | Not rated | 2 | 5 | 2 | 4 | 2 | Pris på begäran Inte tillgängligt | Website |
Bäst för serverlös ETL-automatisering | 3.0 out of 5 | 2 | 3 | 4 | 2 | 4 | 3 | $0.29/DPU-hour Gratisabonnemang tillgängligt | Website |
Bäst för skalbarhet i arbetsbelastningar på företagsnivå | Not rated | 2 | 2 | 4 | Not rated | 2 | 3 | Prisuppgift på begäran 30 dagars kostnadsfri provperiod + demo tillgänglig | Website |
Bäst för byggande av pipelines med lite kod | 2.8 out of 5 | 2 | 2 | 4 | 3 | 3 | 3 | Prisuppgift på begäran 14 dagars kostnadsfri provperiod + demo tillgänglig | Website |
Bäst för dynamiska datavalideringsregler | 2.7 out of 5 | 3 | 3 | 4 | 2 | 2 | 2 | Pris på begäran Gratis demo tillgänglig | Website |
Bäst för samarbetsbaserad analys i notebook-miljö | 3.7 out of 5 | 4 | 3 | 3 | 4 | 4 | 4 | Prisuppgift på begäran Två veckors kostnadsfri provperiod + kostnadsfri demonstration tillgänglig | Website |
Bäst för visualisering av datalinjering på kolumnnivå | 3.8 out of 5 | 4 | 4 | 4 | 4 | 3 | 4 | $150/användare/månad Kostnadsfri plan tillgänglig | Website |
Bäst för versionshanterade SQL-arbetsflöden | 3.7 out of 5 | 4 | 3 | 5 | 4 | 2 | 4 | Prisuppgift på begäran Gratis abonnemang tillgängligt | Website |
Bäst för hanterade utvecklingsmiljöer | 3.7 out of 5 | 3 | 3 | 4 | 4 | 4 | 4 | Pris på begäran 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Website |


Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Recensioner av alternativ till dbt
Nedan hittar du mina detaljerade sammanfattningar av de alternativ till dbt som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över funktionerna, de bästa användningsområdena och integrationerna för varje plattform, så att du kan hitta den bästa lösningen för dina behov inom analysutveckling.
 Bäst för avancerad analys utan kod
- 30 dagars kostnadsfri provperiod
- Från $250/användare/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.6/5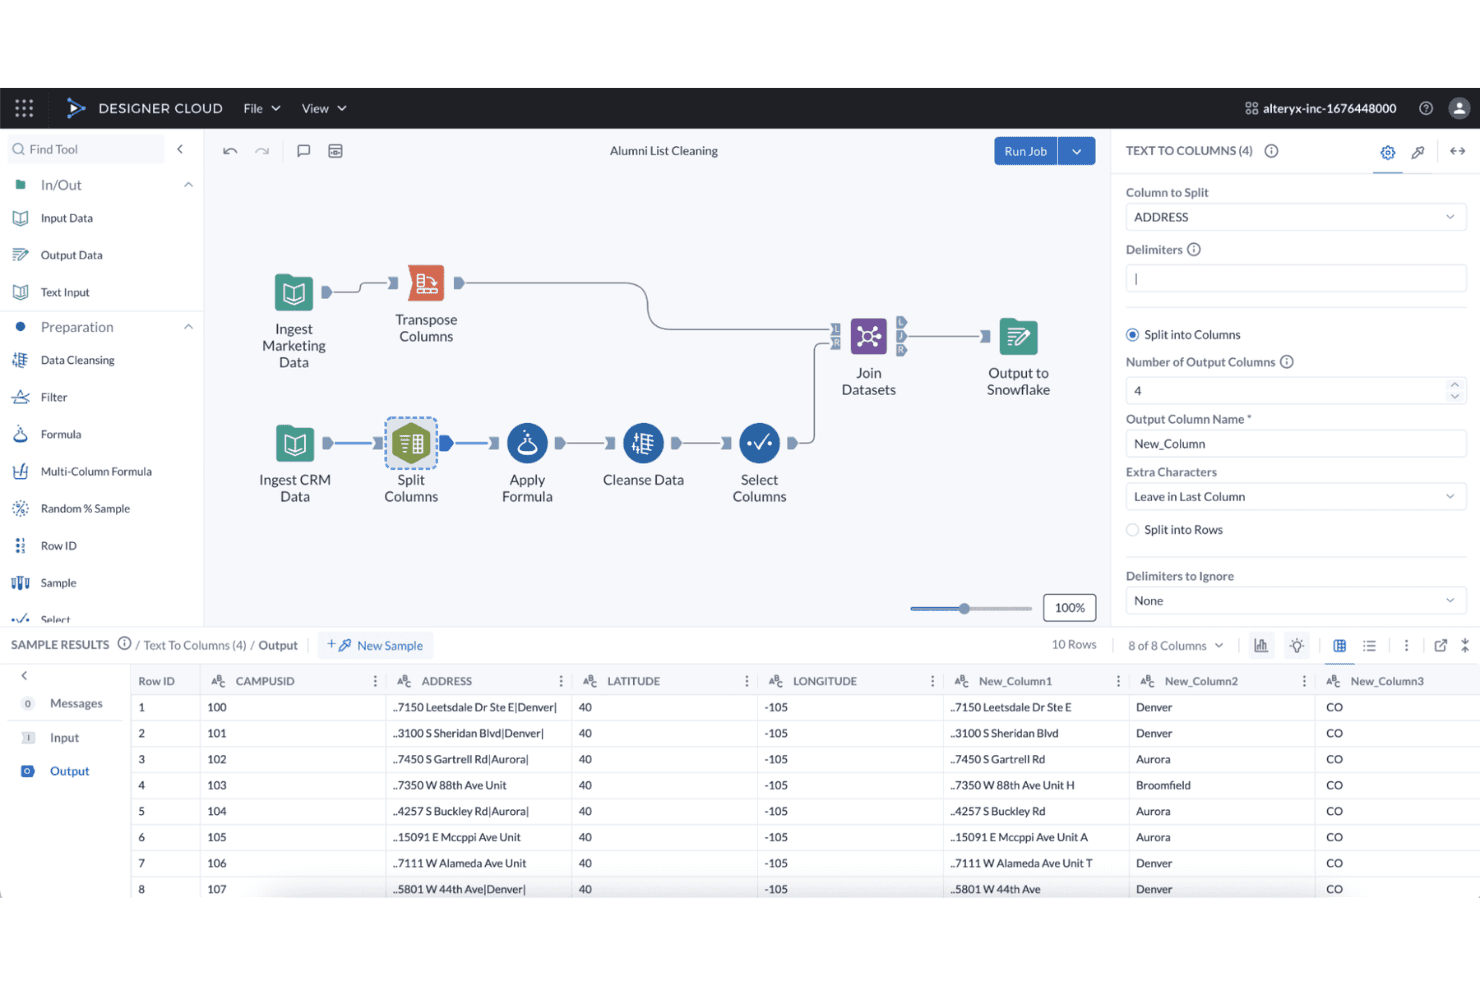
Alteryx Designer Cloud-arbetsflöde som delar upp adressfält i separata kolumner under rensning av alumnidata. Alteryx är en lågkodsanalysplattform som låter data- och analysteam rensa, kombinera och automatisera dataarbetsflöden utan att skriva SQL, vilket gör den till ett praktiskt alternativ för organisationer som vill omvandla och orkestrera datapipelines från fler än 100 källor utan en kodcentrerad verktygskedja.
Vem passar Alteryx bäst för?
Alteryx passar bra för analysteam och BI-chefer som behöver kombinera, rensa och automatisera dataarbetsflöden från många källor utan att skriva SQL.
Varför jag valde Alteryx
Jag valde Alteryx som ett av de bästa alternativen eftersom det låter analysteam ersätta manuella SQL-pipelines med dra-och-släpp-arbetsflöden som rensar, kombinerar och sammanfogar data från fler än 100 källor, utan att någon kod krävs. Jag tycker särskilt om hur arbetsytan för visuella arbetsflöden gör det enkelt att granska data i varje transformationssteg, vilket snabbar upp felsökningen på sätt som ett vanligt SQL-skript aldrig gör. Schemaläggning och API-utlöst automatisering i Enterprise-nivån innebär att jag kan köra dessa arbetsflöden automatiskt enligt ett schema.
Viktiga funktioner i Alteryx
- Validering av schema: Kontrollerar källscheman i början av jobbkörningen och kan stoppa ett arbetsflöde när det aktuella schemat skiljer sig från den lagrade versionen.
- Händelsegenerering för OpenLineage: Skickar händelser om arbetsflödets datahärkomst vid körning, inklusive metadata om relationer på kolumnnivå, till externa katalogverktyg som Collibra och Atlan.
- Python-verktyg med scikit-learn och pandas: Tillhandahåller en inbäddad Python-miljö med en utvald uppsättning paket för att skriva prediktiv logik direkt i ett arbetsflöde.
- Rollbaserade åtkomstkontroller: Låter administratörer skapa anpassade roller med detaljerade behörigheter på appnivå för enskilda användare eller användargrupper i olika arbetsytor.
Integrationer med Alteryx
Alteryx erbjuder fler än 100 inbyggda integrationer, bland annat Snowflake, Google BigQuery, Databricks, Amazon Redshift, Microsoft Azure Synapse Analytics, Tableau och Qlik Cloud. Plattformen tillhandahåller även ett API för anpassade integrationer.
Pros and Cons
Pros:
- Granskningsbara visuella arbetsflöden underlättar felsökning
- Automatiserar återkommande förberedelser och rapportering
- Villkorade abonnemang samordnar beroende arbetsflöden
Cons:
- Inget återanvändbart SQL-modelleringsramverk i dbt-stil
- Git-arbetsflöden är beroende av externa verktyg
Learn more about Alteryx: Bäst för omfattande stöd för anslutningsbibliotek
- Inte tillgängligt
- Pris på begäran
Visit WebsiteCustomer Rating:4.3/5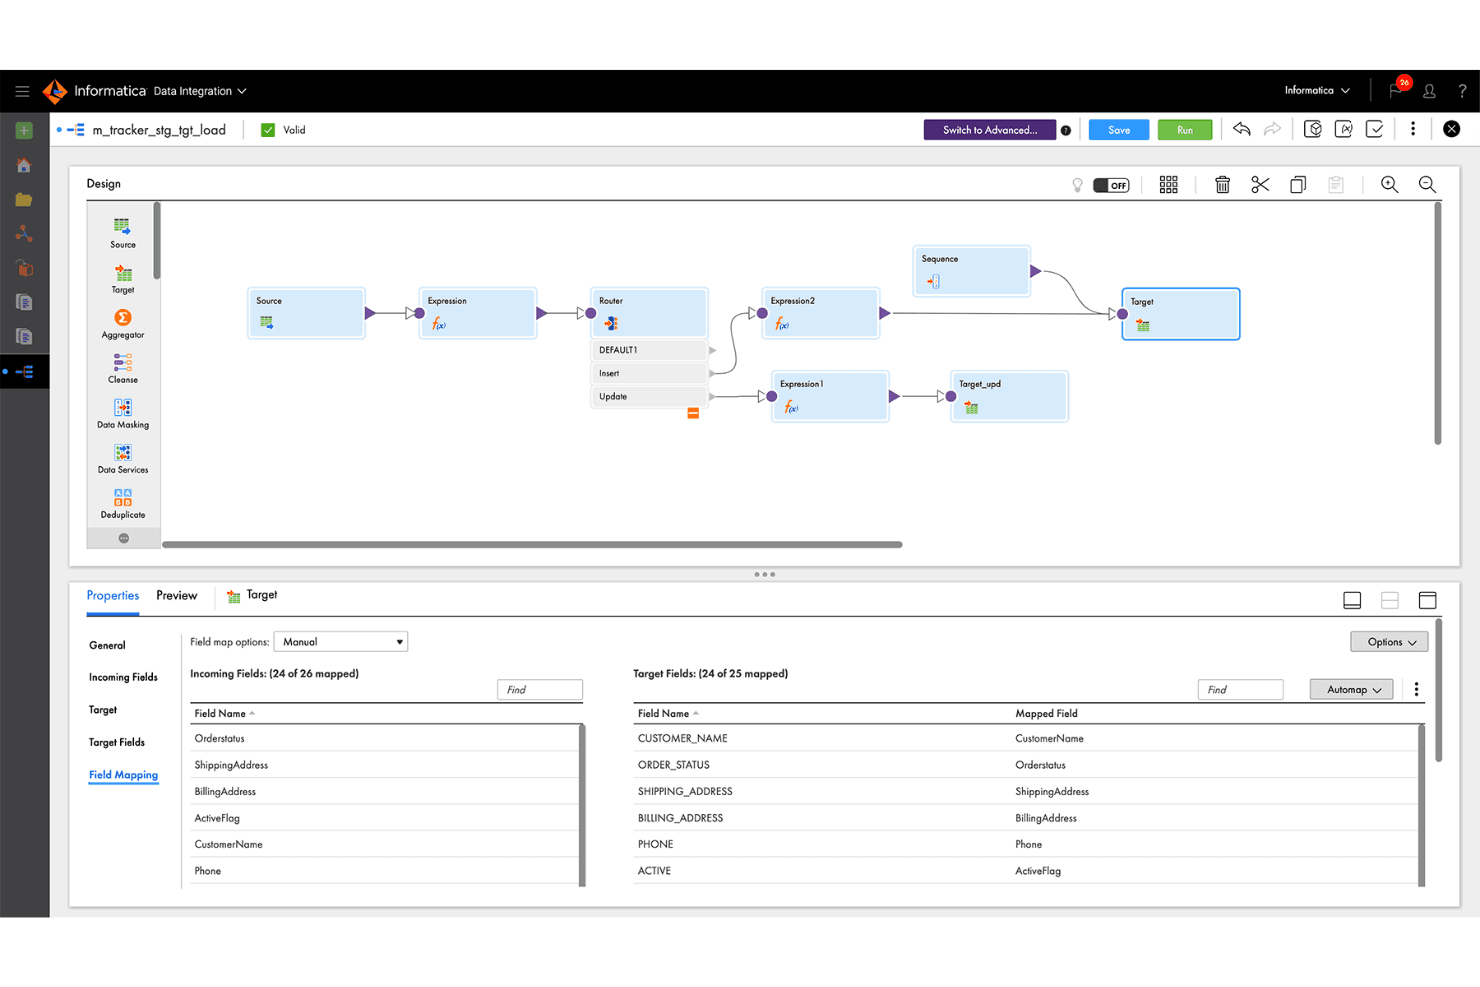
Mappningsarbetsyta i Informatica Data Integration som visar käll-, router-, uttrycks- och måltransformeringar i ett arbetsflöde för datainläsning. Informatica Data Integration är en molnbaserad datapipelineplattform för dataingenjörer som behöver ansluta, flytta och automatisera data mellan ett stort antal källor och mål utan att skriva varje integration från grunden.
Vem passar Informatica bäst för?
Informatica Data Integration passar bra för datateknikteam som behöver ansluta ett stort antal olika källor och mål utan att bygga anpassade anslutningar från grunden.
Varför jag valde Informatica
Jag valde Informatica som ett av de bästa alternativen till dbt eftersom dess bibliotek med anslutningar verkligen tillhör en egen liga. Med hundratals anslutningar utan kod för molnbaserade datalager, lokala databaser och ERP-plattformar kan jag ansluta det till nästan vilken kombination av källa och mål som helst utan att skriva anpassad integrationskod. Dess mönster för ETL, ELT, CDC och replikering innebär att mitt team kan överföra data till Snowflake, Databricks eller ett datalagerhus med den flyttmetod som passar pipelinen bäst, medan CLAIRE Copilot hanterar generering av pipelines och felsökning av körningsloggar för att minska behovet av manuell felsökning.
Viktiga funktioner i Informatica
- Datavalidering: Jämför replikerade måltabeller med källtabeller för att kontrollera datas riktighet och fullständighet efter inläsning.
- Python-transformering: Gör det möjligt att skriva och köra Python-skript i CDI-Elastic-mappningar för statistik-, ML- och NLP-uppgifter.
- Orkestrering av arbetsflöden: Stöder enkel och komplex utformning av arbetsflöden med schemaläggning och REST-anrop för körning av arbetsbelastningar.
- Git-baserad versionskontroll: Ansluter IDMC-projekt och tillgångar till ett Git-arkiv så att teamet kan spåra och hantera pipelineändringar över tid.
Integrationer i Informatica
Informatica dokumenterar hundratals anslutningar utan kod, även om tillgängligheten varierar beroende på tjänst, utgåva och anslutningsnivå. Ett REST-API stöder anpassade integrationer.
Pros and Cons
Pros:
- Schemalagda arbetsflöden minskar det manuella pipelinearbetet
- AI-assisterade loggar hjälper till att diagnostisera fel
- Mappningar stöder datarensning och validering
Cons:
- Komplexa SQL-transformeringar kan misslyckas
- Git-arbetsflödet saknar sammanslagning och förgrening
Learn more about Informatica: Bäst för serverlös ETL-automatisering
- Gratisabonnemang tillgängligt
- Från $0.29/DPU-hour
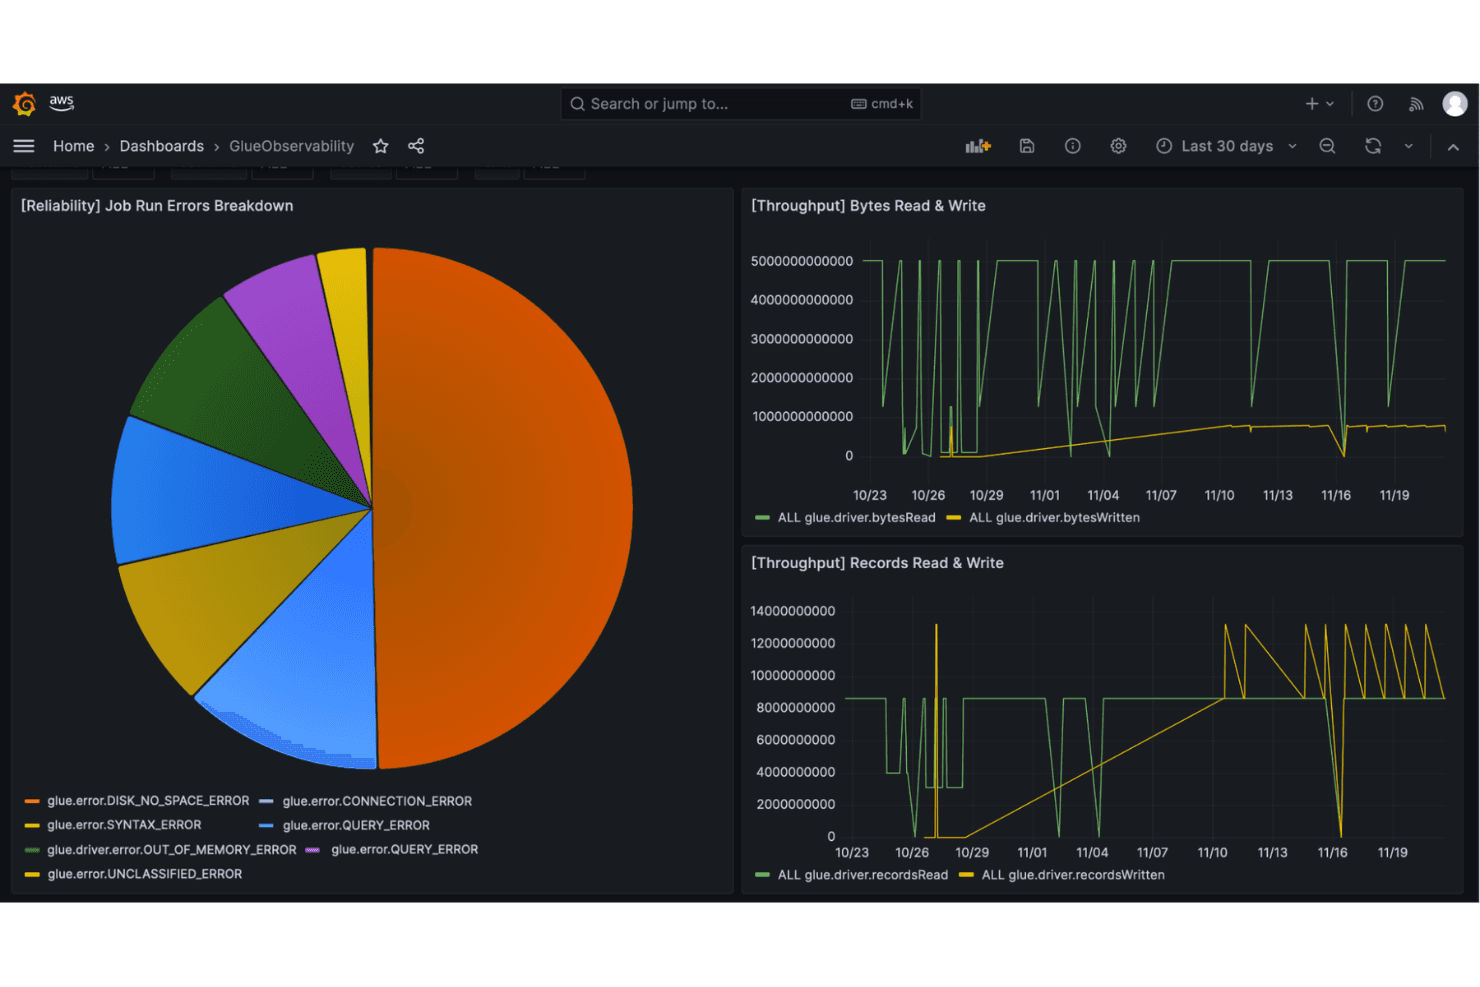
AWS Glue-instrumentpanel för jobbövervakning som visar fördelningen av körfel samt läs- och skrivgenomströmning under 30 dagar. AWS Glue är Amazons serverlösa dataintegreringstjänst som tilltalar dataingenjörer som redan arbetar i AWS-ekosystemet och behöver automatisera ETL-pipelines, orkestrera komplexa arbetsflöden och ansluta till ett stort antal datakällor utan att hantera infrastrukturen.
Vem passar AWS Glue bäst för?
AWS Glue passar bra för dataingenjörsteam som redan kör arbetsbelastningar i AWS och behöver serverlös ETL-automatisering utan att hantera Spark-infrastruktur.
Varför jag valde AWS Glue
Jag har inkluderat AWS Glue bland mina toppval eftersom det är det starkaste serverlösa ETL-alternativet för dataingenjörsteam som redan kör arbetsbelastningar i AWS. Jag uppskattar hur Glue-arbetsflöden låter dig samordna jobb, genomsökare och utlösare med schemalagd, händelsebaserad eller behovsbaserad körning, så att återkommande pipelineautomatisering kräver nästan ingen infrastrukturövervakning. Visuell ETL-redigering i AWS Glue Studio genererar Spark-kod automatiskt, och zero-ETL-integreringar flyttar data från källor som DynamoDB eller Salesforce direkt till Redshift utan anpassad pipelinekod.
Viktiga funktioner i AWS Glue
- Git-baserad versionshantering: Synkroniserar visuella jobb och skriptjobb med GitHub, GitLab, Bitbucket och AWS CodeCommit med hjälp av grenbaserade arbetsflöden för hämtning och pushning.
- Regler för Glue Data Quality: Tillämpar ett bibliotek med fler än 25 DQDL-regler på datamängder och kontroller i pipelinen, med möjlighet att stoppa en pipeline när kvalitetströsklar överskrids.
- Dataintegrering med Amazon Q: Genererar anpassningsbar Apache Spark-ETL-kod från beskrivningar på naturligt språk av dina transformationskrav.
- Datakatalog med genomsökare: Upptäcker automatiskt källscheman och lagrar tabelldefinitioner, jobbdefinitioner och historik över schemaversioner för anslutna datakällor.
Integreringar med AWS Glue
AWS Glue erbjuder inbyggda integreringar med Amazon S3, Amazon Redshift, Snowflake, Google BigQuery, GitHub, GitLab, Bitbucket och AWS CodeCommit, med fler än 100 dokumenterade datakällor. Tjänsten stöder även Marketplace-anslutningar och ett AWS Glue Web API för anpassade integreringar.
Pros and Cons
Pros:
- Automatiserar beroenden mellan jobb, genomsökare och utlösare
- Flaggar låg datakvalitet i pipelines
- Upptäcker scheman och katalogiserar datamängder automatiskt
Cons:
- Spark SQL saknar modulär modellering av dbt-typ
- Git exkluderar notebook-filer och kräver upprepad konfiguration
Learn more about AWS Glue: Bäst för skalbarhet i arbetsbelastningar på företagsnivå
- 30 dagars kostnadsfri provperiod + demo tillgänglig
- Prisuppgift på begäran
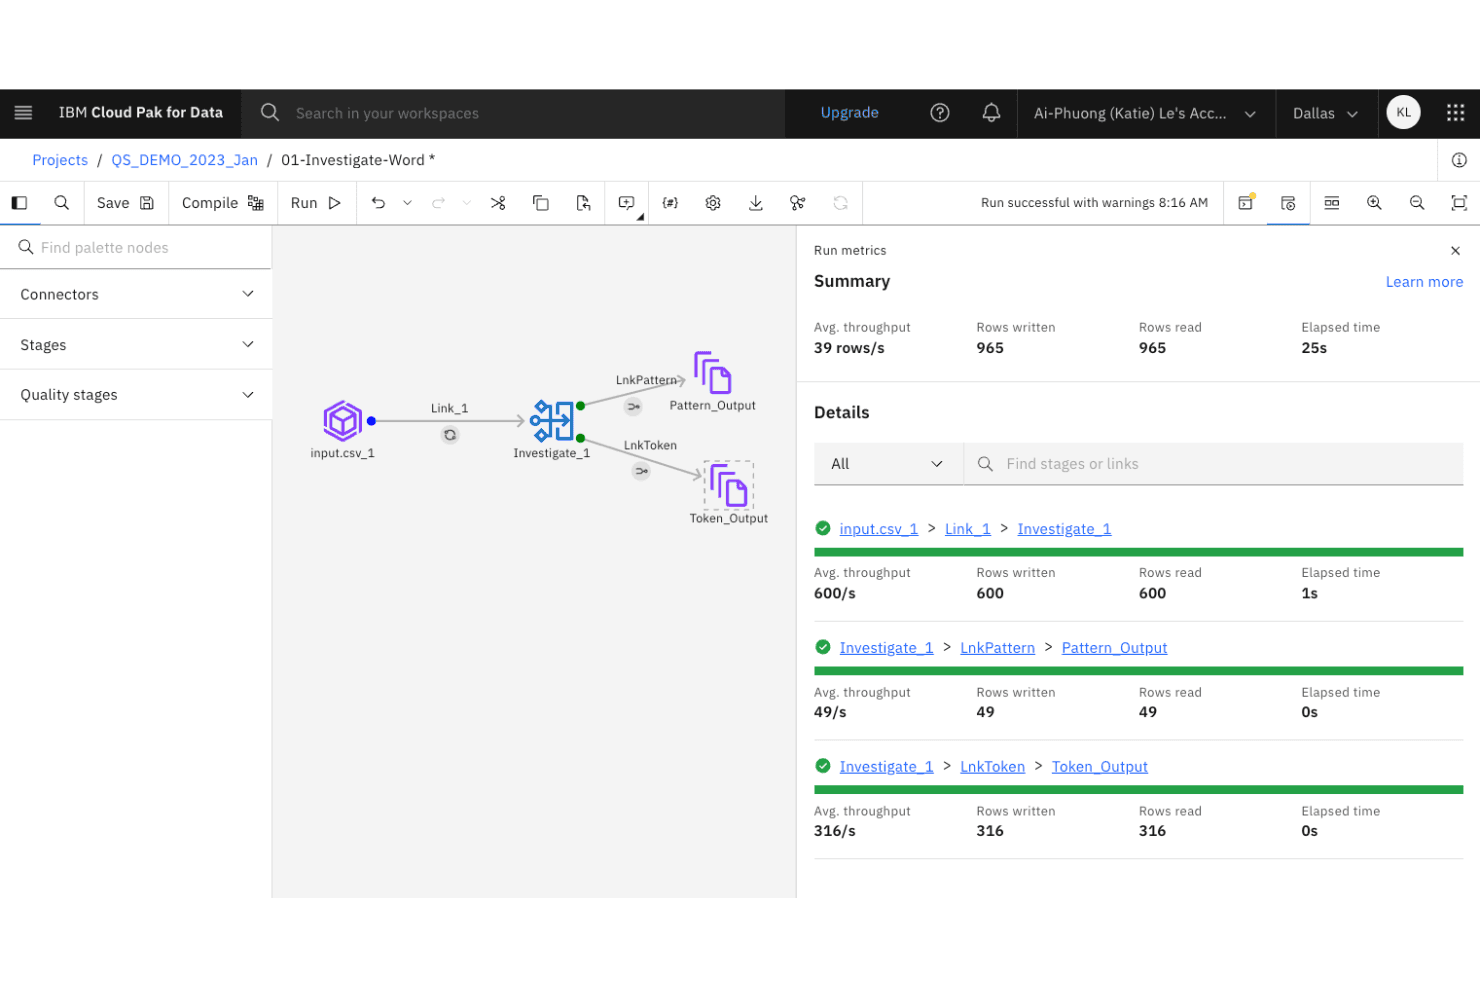
IBM DataStage-jobbcanvas med ett granskningssteg och körningsvärden som visar lästa och skrivna rader. IBM watsonx.data integration (tidigare IBM DataStage) är en plattform för företagsdataintegration, byggd för dataingenjörer som behöver flytta, transformera och förbereda strukturerade och ostrukturerade data över batch-, dataströmnings- och replikeringspipelines i hybrida miljöer och multicloudmiljöer.
För vem passar IBM DataStage bäst?
IBM watsonx.data integration passar stora företag som kör ETL/ELT-arbetsbelastningar med stora datamängder i hybrida miljöer och multicloudmiljöer och behöver en beprövad, skalbar pipelineplattform.
Varför jag valde IBM DataStage
Jag valde IBM DataStage som en av de bästa lösningarna eftersom den parallella bearbetningsmotorn delar upp stora batcharbetsbelastningar i samtidiga operationer, vilket gör att dataingenjörsteam kan hantera ETL/ELT-volymer på företagsnivå utan att behöva utforma om pipelines när datamängderna växer. Jag uppskattar också stödet för automatisk skalning via OpenShift Horizontal Pod Autoscaler, vilket innebär att kapaciteten anpassas efter arbetsbelastningens behov i stället för att kräva manuella åtgärder under perioder med hög bearbetningsbelastning. Arkitekturen med fjärrmotor separerar designens styrplan från körningen, så att pipelines körs där data faktiskt finns i hybrida miljöer och multicloudmiljöer.
Viktiga funktioner i IBM DataStage
- Enhetligt Python-SDK: Skapa, hantera och kör både batch- och realtidsbaserade dataströmningspipelines i Python, med stöd för versionshantering i Git och automatisering av CI/CD.
- Varningar för dataobserverbarhet: Konfigurera tröskelbaserade varningar för jobbets varaktighet, jobbstatus och pipelinevärden som antal lästa och skrivna rader, med vidarebefordran till Slack eller PagerDuty.
- Bearbetning av ostrukturerade data: Läs in och transformera ostrukturerade filer med dra-och-släpp-operatorer för textextrahering, borttagning av personligt identifierbar information, uppdelning i delar och generering av inbäddningar.
- Projektöverföring mellan miljöer: Flytta pipeline-resurser mellan utvecklings-, test- och produktionsprojekt med hjälp av
cpdctleller kommandoradsgränssnittetdsjob.
IBM DataStage-integreringar
IBM DataStage har dokumenterade anslutningar till Amazon Redshift, Google BigQuery, Snowflake, IBM watsonx.data Presto, Apache Flink på Confluent Platform, LangChain och Milvus. Plattformen tillhandahåller även API:er och ett Python-SDK för anpassade integreringar.
Pros and Cons
Pros:
- Granskare berömmer parallell bearbetning i stor skala
- Visuell ETL omfattar batchbearbetning och dataströmning
- Stöd för Python-pipelines med Git-baserad överföring
Cons:
- Ingen SQL-baserad modellering för dbt-arbetsflöden
- Granskare uppger att det är svårt att migrera proprietär logik
Learn more about IBM DataStage: Bäst för byggande av pipelines med lite kod
- 14 dagars kostnadsfri provperiod + demo tillgänglig
- Prisuppgift på begäran
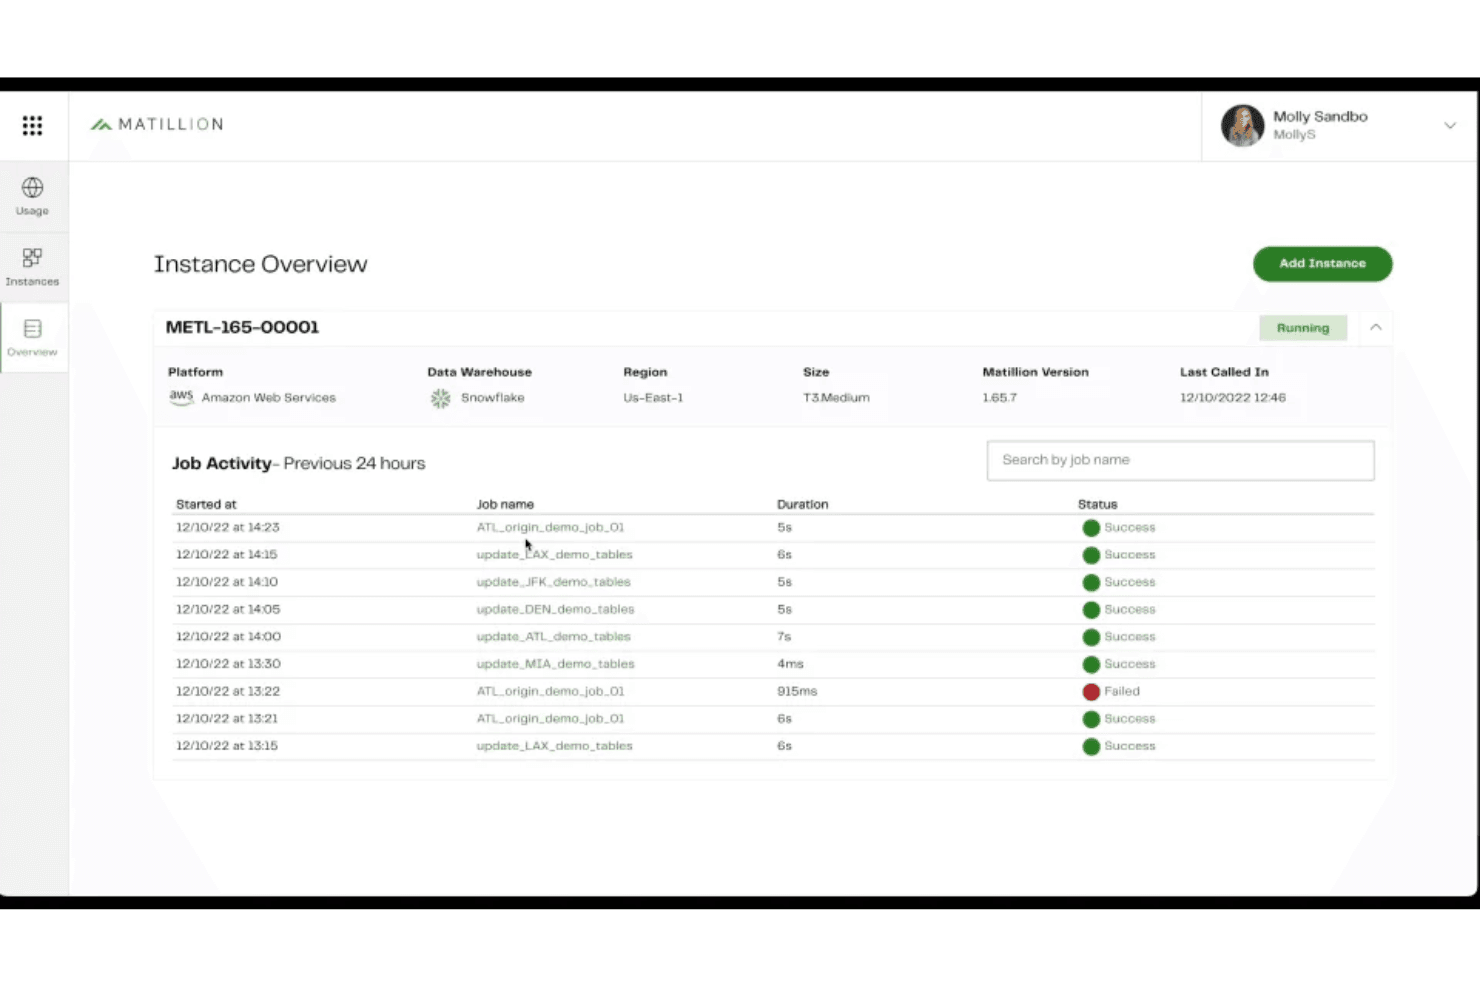
Matillions instansöversikt håller reda på aktiva instanser och aktuell jobbaktivitet, med status för varje pipelinekörning. Matillion ETL är en molnbaserad dataintegrationsplattform som låter data- och analysteam läsa in, transformera och orkestrera pipelines med hjälp av ett visuellt dra-och-släpp-gränssnitt tillsammans med SQL och Python, vilket gör den till ett praktiskt alternativ för team som tycker att dbt:s kodcentrerade arbetssätt är för brant att lära sig.
Vem passar Matillion bäst för?
Matillion ETL passar bra för BI- och analysteam som vill bygga och automatisera datapipelines utan att skriva kod från grunden.
Varför jag valde Matillion
Jag valde Matillion som ett av de bästa alternativen till dbt eftersom dess visuella dra-och-släpp-verktyg för pipelinebyggande låter BI- och analysteam skapa transformeringslogik utan att skriva SQL från grunden. Jag gillar särskilt att du kan bygga ett komplett ELT-jobb med komponenter som körs direkt i Snowflake, Redshift eller BigQuery, och sedan lägga till ett dbt Core-kommandosteg om du behöver logik på modellagret. Den visuella jobböversikten genererar också dokumentation automatiskt, vilket tar bort ett steg som kodcentrerade team ofta hoppar över.
Viktiga funktioner i Matillion ETL
- SQL-transformeringar som körs i dataplattformen: Kör transformeringslogik direkt i din molnbaserade dataplattform – Snowflake, Redshift, BigQuery eller Azure Synapse – i stället för att flytta ut data för bearbetning.
- Inbyggd schemaläggare: Automatiserar orkestreringsjobb med fördefinierade intervall, med konfiguration per schema för projektversion, miljö och tidszon.
- Utdata-komponenter för omvänd ETL: Skickar transformerade lagerdata tillbaka till operativa system som Salesforce, Intercom och Oracle med hjälp av inbyggda komponenter för utdataanslutningar.
- REST API: Tillhandahåller ett v1-API som stöder GET-, POST- och DELETE-operationer, så att du kan utlösa och hantera jobb programmatiskt från externa verktyg eller skript.
Matillion-integrationer
Matillion erbjuder över 80 färdiga anslutningar, inklusive Snowflake, Databricks, Amazon Redshift, Google BigQuery, Azure Synapse, Salesforce, Intercom och Oracle. Det stöder GitHub-, AWS CodeCommit- och Bitbucket-databaser samt ett REST API för anpassade integrationer.
Pros and Cons
Pros:
- Visuella jobb gör transformeringar enklare att granska
- Bearbetning i datalagret håller arbetet i lagret
- En vy kombinerar inläsning och orkestrering
Cons:
- Git-arbetsflöden saknar dokumenterad CI/CD-befordran
- Datakontroller kräver logik som byggs av användaren
Learn more about Matillion: Bäst för dynamiska datavalideringsregler
- Gratis demo tillgänglig
- Pris på begäran
Visit WebsiteCustomer Rating:4.9/5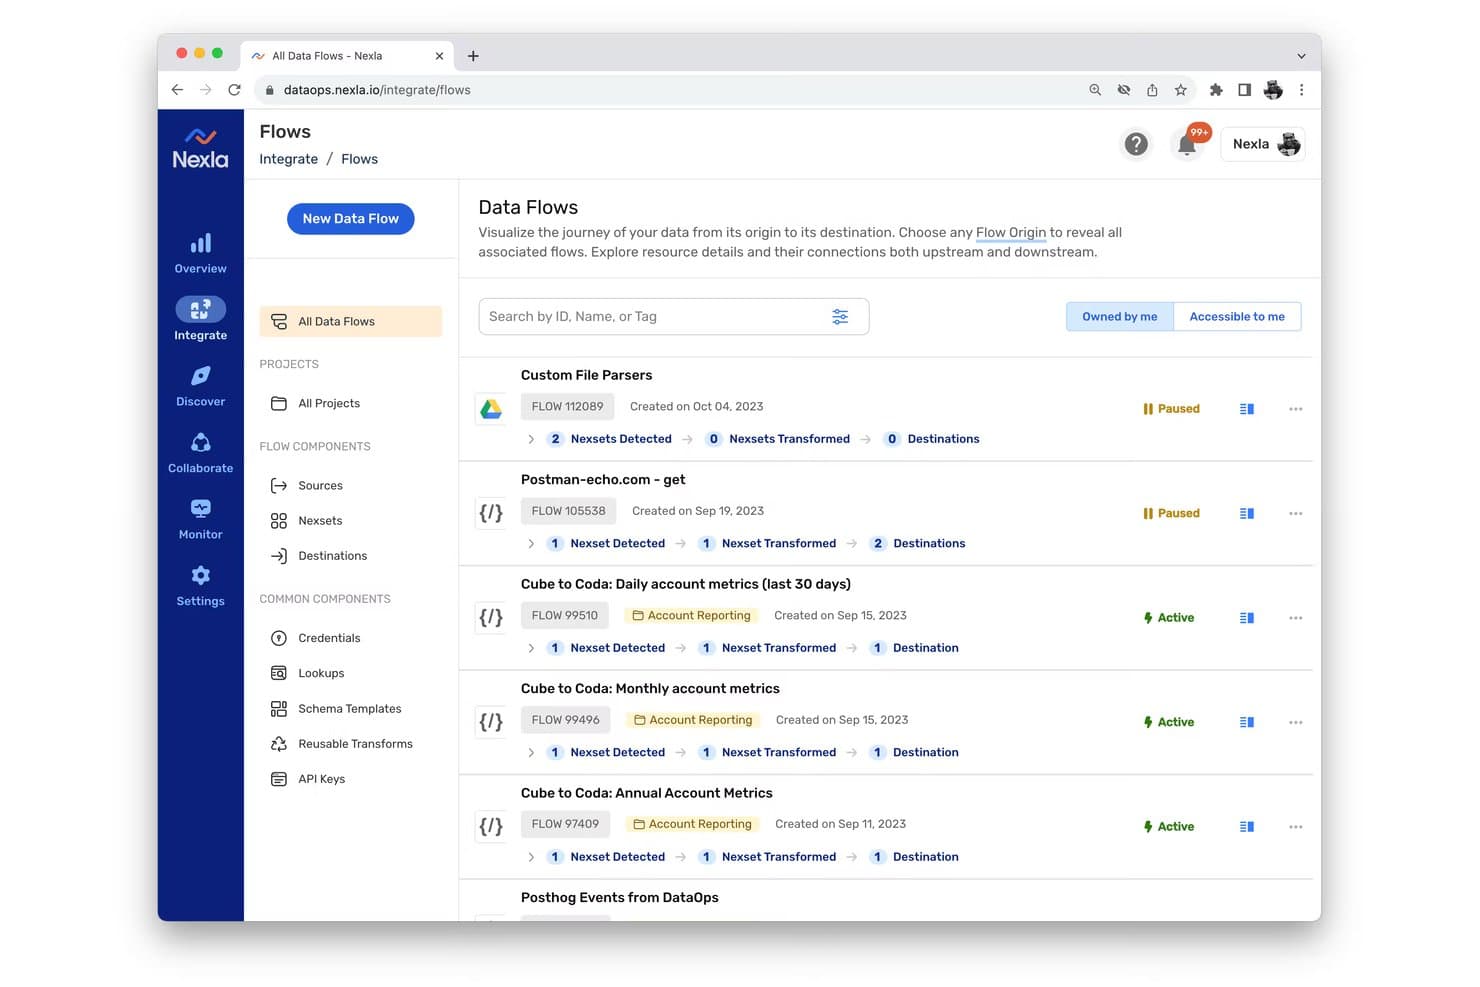
Nexlas omdesignade avsnitt Integrera visar dataflöden med deras status, källor, transformationer och destinationer. Nexla är en dataintegrationsplattform byggd för dataingenjörer som behöver ansluta, transformera och styra data från ett stort antal källor – med hantering av ETL-, CDC-, streaming- och API-pipelines samt validering och spårning av datahärkomst innan data någonsin når sin destination.
Vem passar Nexla bäst för?
Nexla passar bra för dataingenjörer på företag som hanterar komplexa pipelines med flera källor och behöver validera, styra och leverera data innan den når nedströmsystem.
Varför jag valde Nexla
Jag har tagit med Nexla bland mina främsta val eftersom dess dynamiska datavalideringsregler ger dataingenjörer en kontroll över inkommande data som de flesta pipelineverktyg inte kan mäta sig med. Du kan definiera regler på postnivå som kontrollerar att fält finns, reguljära uttryck, datatyper och tillåtna värden. När schemaförändringar sker mitt i en pipeline upptäcker Nexla dem automatiskt och dirigerar problematiska poster till en felkarantän med fullständig diagnostik. Jag uppskattar särskilt att valideringen körs innan data hamnar på destinationen, så att felaktiga poster inte i tysthet förstör nedströmsdataset.
Viktiga funktioner i Nexla
- Kodfria funktioner för databeredning: Ett Excel-liknande funktionsbibliotek låter dig filtrera, mappa, sammanfoga och omforma poster utan att skriva anpassad kod.
- Automatiserad felkarantän: Misslyckade poster isoleras automatiskt med fullständig diagnostik för varje post, så att du kan granska och lösa problem utan att manuellt leta igenom loggar.
- CLI-baserad import och export av flöden: Flödesspecifikationer kan exporteras till JSON och importeras till separata konton eller miljöer, vilket stöder migrering, versionshantering och befordran från utveckling till produktion.
- Anpassade transformationer i Python och JavaScript: En komplett IDE med testmiljö låter dig skriva, testa och dela återanvändbar anpassad transformationslogik utöver det som täcks av kodfria funktioner.
Nexlas integrationer
Nexla tillhandahåller över 1 000 inbyggda anslutningar, inklusive dbt, Snowflake, Google BigQuery, Databricks, Amazon Redshift och Teradata. Plattformen erbjuder även REST-, SOAP-, data-, synkroniserings- och administrations-API:er för anpassade integrationer.
Pros and Cons
Pros:
- Regler på postnivå upptäcker schemaförändringar tidigt
- Recensenter uppskattar aviseringar om pipelineproblem
- Kodfria transformationer kombineras med återanvändbara skript
Cons:
- Inget återanvändbart ramverk för SQL-modellering
- Ingen inbyggd Git-förgrening eller CI/CD
Learn more about Nexla: Bäst för samarbetsbaserad analys i notebook-miljö
- Två veckors kostnadsfri provperiod + kostnadsfri demonstration tillgänglig
- Prisuppgift på begäran
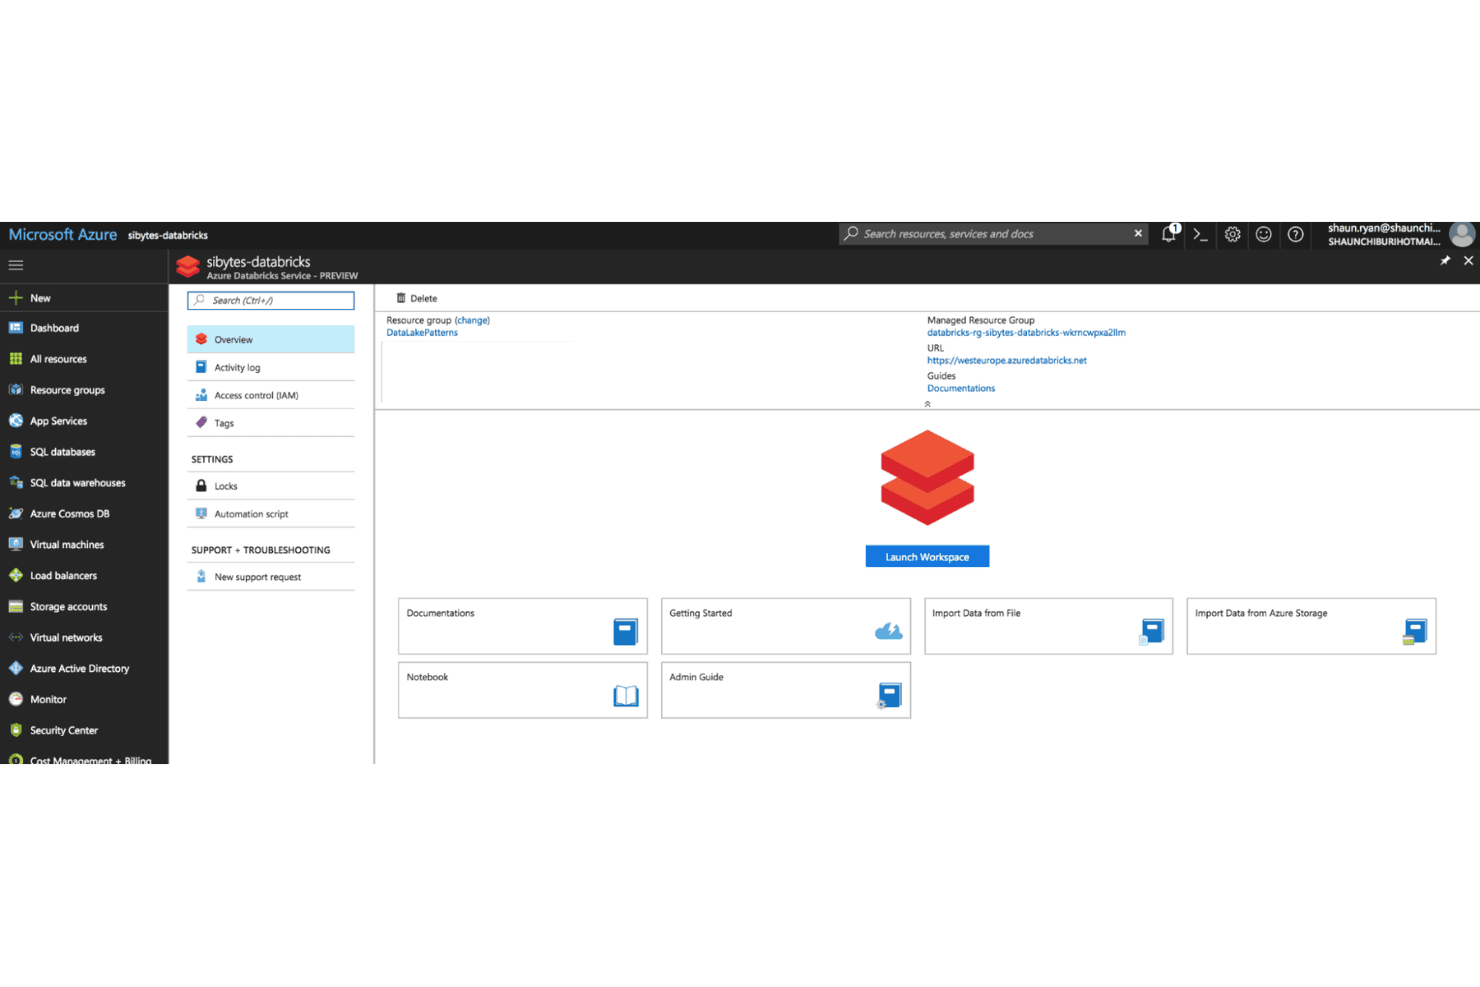
Översikten för Azure Databricks-tjänsten i Azure-portalen, med knappen Starta arbetsyta för att öppna arbetsytan. Azure Databricks är en datasjöplattform som gemensamt har utvecklats av Databricks och Microsoft och som samlar datateknik, SQL-transformering och samarbetsbaserad analys i notebook-miljö i en och samma Azure-inbyggda miljö.
För vem passar Azure Databricks bäst?
Azure Databricks passar särskilt bra för datateknikteam som redan arbetar i Microsoft Azure-ekosystemet och behöver SQL-, Python- och visuella arbetsflöden på en och samma datasjöplattform.
Varför jag valde Azure Databricks
Jag har tagit med Azure Databricks bland mina främsta val eftersom den samarbetsbaserade notebook-miljön låter datatekniker och analytiker arbeta i SQL, Python eller på en visuell arbetsyta utan att någonsin lämna plattformen. Jag uppskattar särskilt Lakeflow Designer, som genererar Git-versionshanterbar kod från transformationer med dra-och-släpp, så att pipeline-logiken är granskningsbar och schemaläggningsbar redan från början. Unity Catalog knyter sedan ihop allt genom att automatiskt spåra datahärkomst på kolumnnivå för varje fråga som teamet kör.
Viktiga funktioner i Azure Databricks
- Pipelineförväntningar: Definiera SQL-booleska begränsningar för strömmande tabeller och materialiserade vyer för att behålla, ta bort eller underkänna poster som bryter mot regler för datakvalitet.
- Datahärkomst i Unity Catalog: Fångar automatiskt datahärkomst på kolumnnivå för alla Databricks-frågor och sammanställer den över arbetsytor för konsekvensanalys uppströms och nedströms.
- Orkestrering med Lakeflow Jobs: Skapar DAG-baserade arbetsflöden med händelseutlöst schemaläggning, aktivitetsberoenden, villkorsstyrda grenar, nya försök och aviseringar om körningar.
- Datainläsning med Lakeflow Connect: Tillhandahåller över 100 inbyggda anslutningar för företagsappar, databaser och filkällor med serverlösa, inkrementellt inlästa pipelines som styrs av Unity Catalog.
Azure Databricks-integreringar
Azure Databricks erbjuder över 100 inbyggda Lakeflow Connect-anslutningar, bland annat för Salesforce, SQL Server, Google Analytics, ServiceNow, SharePoint, Workday, Amazon S3 och Google Cloud Storage. Plattformen integreras även direkt med Microsoft Azure-tjänster och tillhandahåller REST-, SDK- och CLI-API:er för anpassade anslutningar.
Pros and Cons
Pros:
- Samarbetsbaserade notebook-miljöer förenar teknik och analys
- SQL och PySpark delar transformationsarbetsflöden
- Visuella pipelines genererar Git-versionshanterbar kod
Cons:
- Beräkningskostnaderna kan bli oförutsägbara
- Pipelineförväntningar stöder ett begränsat antal objekttyper
Learn more about Azure Databricks: Bäst för visualisering av datalinjering på kolumnnivå
- Kostnadsfri plan tillgänglig
- Från $150/användare/månad (debiteras årsvis)
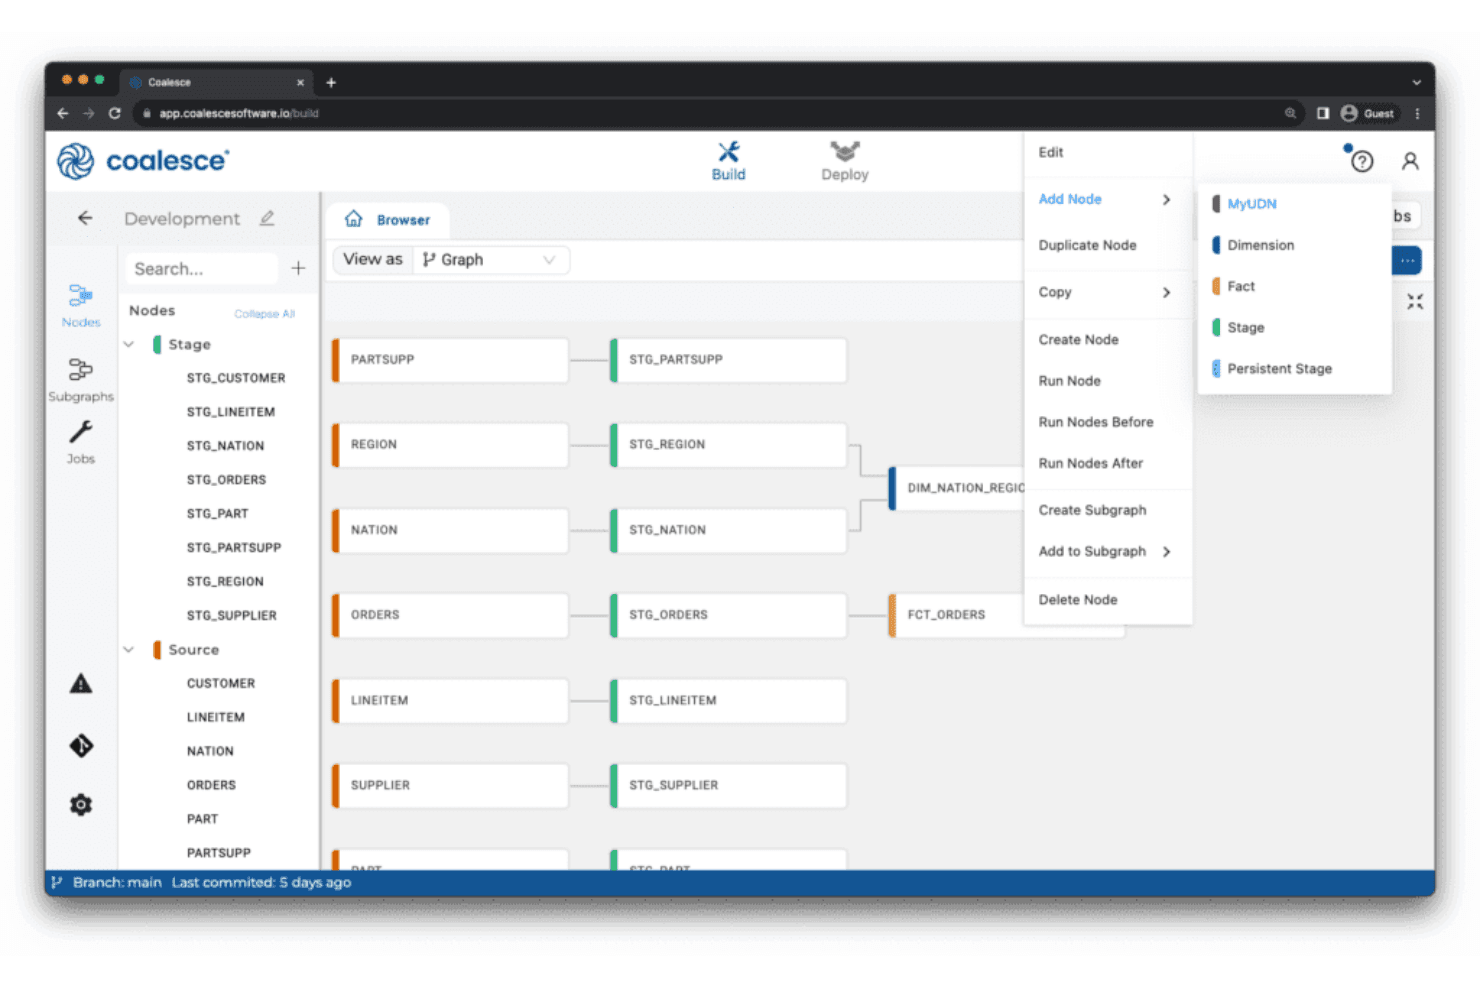
Coalesces arbetsyta Bygg kartlägger källnoder via mellanstegstabeller till dimensions- och faktanoder. Coalesce är en plattform för datatransformering som är byggd för analysingenjörer och datateam som vill ha ett visuellt lågkodsalternativ till ren SQL-utveckling – med pipelinebyggande, datakatalogisering och kvalitetsövervakning i en enda miljö.
Vem passar Coalesce bäst för?
Coalesce passar bra för team inom analysingenjörskonst som behöver spåra dataförändringar på kolumnnivå genom pipelines och BI-verktyg.
Varför jag valde Coalesce
Jag valde Coalesce som ett av de bästa alternativen eftersom datalinjering på kolumnnivå verkligen är där plattformen visar sitt värde. När en kolumn läggs till eller tas bort uppströms vidarebefordrar Coalesce automatiskt ändringen genom noderna nedströms. Jag använder också dess katalog för att spåra en datas resa från en rå datalagertabell hela vägen till en Power BI-instrumentpanel, fält för fält, vilket gör konsekvensanalys till något jag faktiskt kan göra på minuter i stället för timmar.
Coalesces viktigaste funktioner
- Git-ansluten arbetsyta: Lagra alla pipelinefiler i ett anslutet Git-arkiv med stöd för GitHub, Bitbucket, GitLab och Azure DevOps Git.
- Nodtyper och återanvändbara mönster: Definiera standardiserade byggblock som styr hur noder producerar DDL, DML och tester i olika pipelines.
- Automatiserad avvikelsedetektering: Övervaka förändringar i schema, volym, aktualitet och distribution med aviseringar som tar hänsyn till datalinjering samt inbyggda arbetsflöden för incidenter.
- SQL-migrering med Copilot: Konvertera lagrade procedurer, CTE-baserade skript, kompilerad dbt-SQL och äldre ETL-SQL till Coalesce-noder genom ett guidat migreringsarbetsflöde.
Coalesce-integrationer
Coalesce erbjuder inbyggda integrationer med Snowflake, Databricks, BigQuery, Amazon Redshift, Microsoft Fabric, dbt, Apache Airflow, Power BI, Tableau och Looker. Git-anslutna arbetsflöden stöder GitHub, GitLab, Bitbucket och Azure DevOps Git, med åtkomst via API, MCP och CLI för anpassade arbetsflöden.
Pros and Cons
Pros:
- Datalinjering på kolumnnivå spårar påverkan nedströms
- Återanvändbara noder standardiserar visuella SQL-pipelines
- Inbyggda kontroller flaggar schema- och aktualitetsavvikelser
Cons:
- Befintliga dbt-projekt kräver manuell SQL-konvertering
- Stora grafer kan kännas röriga och långsamma
Learn more about Coalesce: Bäst för versionshanterade SQL-arbetsflöden
- Gratis abonnemang tillgängligt
- Prisuppgift på begäran
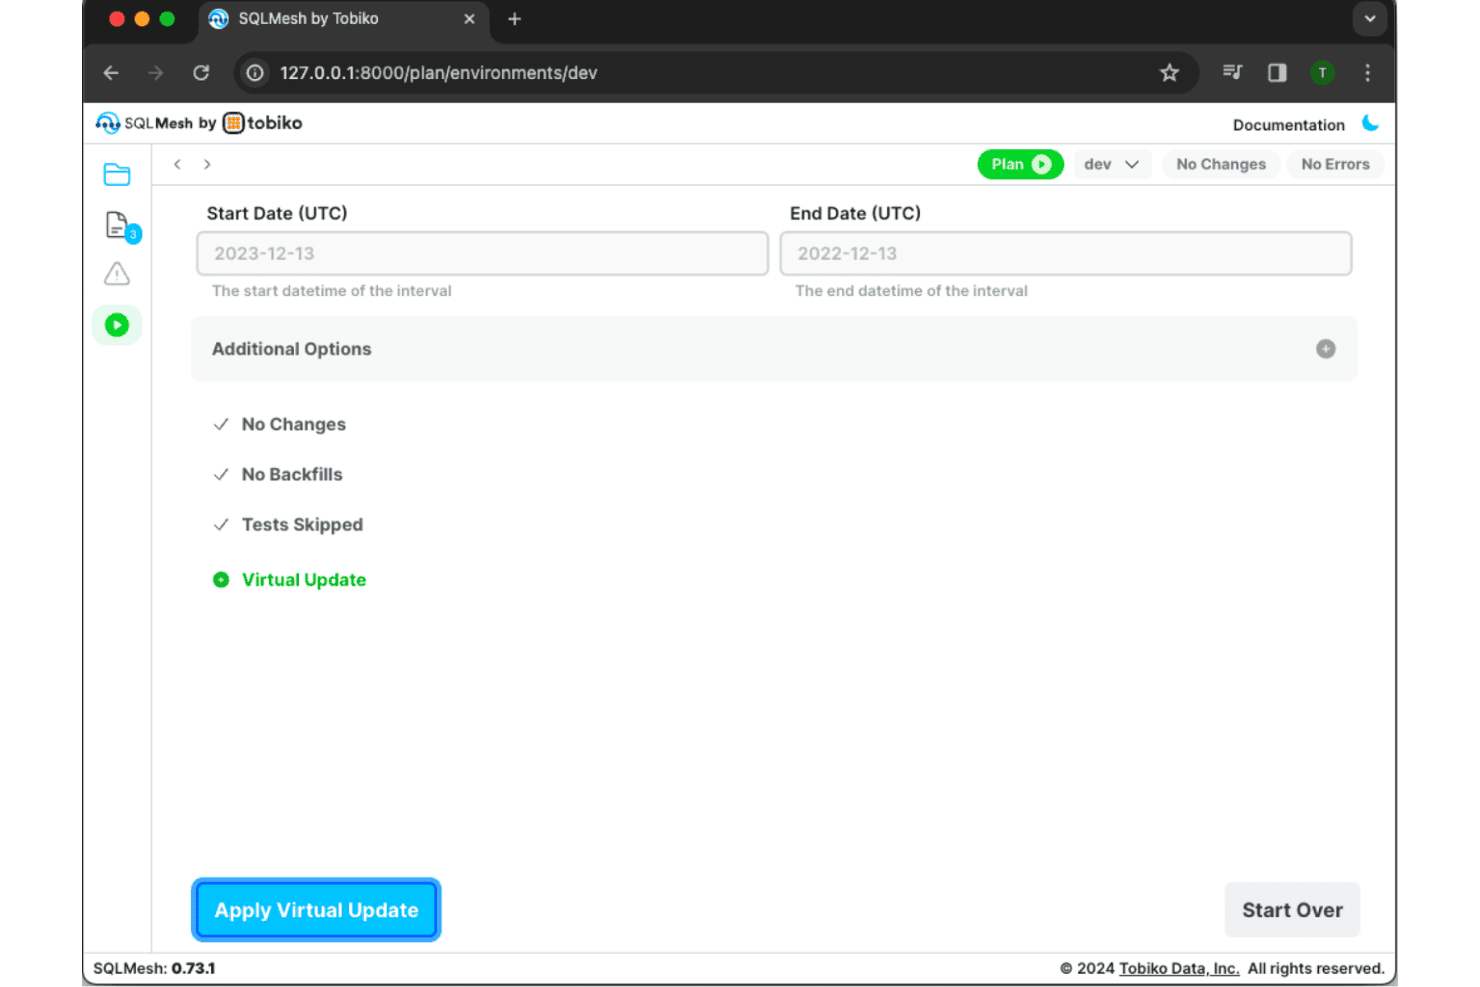
SQLMeshs planvy för utvecklingsmiljön, där team granskar ändringar och tillämpar virtuella uppdateringar. SQLMesh är ett ramverk med öppen källkod för datatransformering som låter dataingenjörer bygga, testa och distribuera SQL- och Python-modeller med isolerade virtuella miljöer, automatiskt dataflöde på kolumnnivå och ett arbetsflöde där man planerar före tillämpning och ser exakt vilka ändringar som kommer att göras innan något körs i datalagret.
Vem passar SQLMesh bäst för?
SQLMesh passar bra för dataingenjörer som vill ha ett kodcentrerat ramverk för datatransformering med inbyggd miljöisolering och ett granskningsarbetsflöde där man planerar före tillämpning.
Varför jag valde SQLMesh
Jag valde SQLMesh som ett av de bästa alternativen eftersom arbetsflödet med planering före tillämpning verkligen förändrar hur det känns att utveckla versionshanterad SQL. Innan något körs i datalagret kan jag se exakt vilka modeller som påverkas av en ändring och automatiskt spåra påverkan ned till kolumnnivå, utan någon manuell annotering. Den typen av inbyggd insyn i ändringar, tillsammans med virtuella utvecklingsmiljöer som isolerar arbetet utan att duplicera data, är det som gör att SQLMesh utmärker sig specifikt för versionshanterade SQL-arbetsflöden.
Viktiga funktioner i SQLMesh
- Transpilering av SQL-dialekter: SQLMesh konverterar automatiskt SQL som skrivits i en dialekt till den syntax som krävs av målplattformens körningsmotor innan någon fråga körs.
- Flera modelltyper: Definiera vy-, fullständiga, inkrementella, seed-, externa och SCD Type 2-modeller för att anpassa hur varje dataset behöver materialiseras.
- Ramverk för enhetstester: Skriv enhetstester mot enskilda modeller eller CTE:er på toppnivå med indata från YAML, CSV eller SQL-genererade källor för att validera resultat före distribution.
- CI/CD-bot för GitHub Actions: Automatisera projektkontroller, skapande av miljöer för förfrågningar om kodändringar och distributioner direkt genom en inbyggd integration med GitHub Actions.
SQLMesh-integrationer
SQLMesh stöder 16 inbyggda körningsmotorer, däribland BigQuery, Snowflake, Databricks, Spark, Postgres, Redshift, Trino och DuckDB. Det integreras även med dbt, GitHub Actions, dlt och Airflow samt erbjuder gränssnitt via Python-API, CLI och interaktiva kodanteckningsböcker.
Pros and Cons
Pros:
- Förhandsvisningar av planer visar påverkan på nedströmsändringar
- Virtuella miljöer undviker dubbla utvecklingstabeller
- Automatiskt dataflöde på kolumnnivå minskar behovet av manuella annoteringar
Cons:
- Schemaläggaren behöver en extern periodisk utlösare
- Migreringar från dbt kan kräva stegvisa justeringar av modeller
Learn more about SQLMesh: Bäst för hanterade utvecklingsmiljöer
- 14 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Pris på begäran
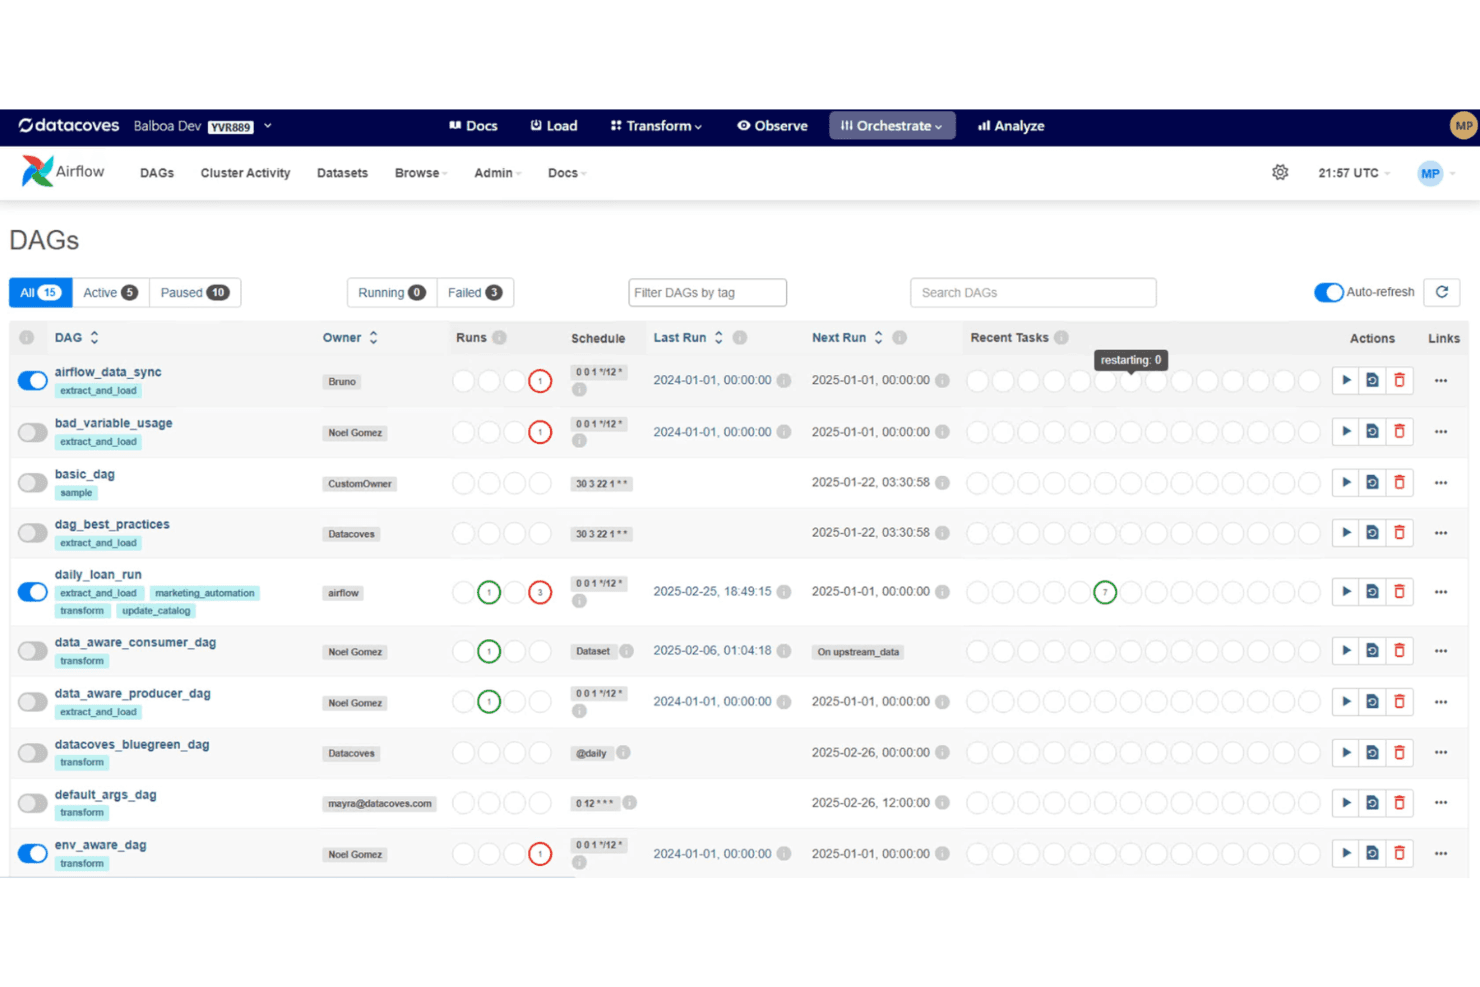
Datacoves Orchestrate-modul, som visar Airflow-DAG-scheman, körstatus och aktivitetshistorik i en och samma vy. Datacoves är en hanterad dbt- och Airflow-plattform som ger dataingenjörer och analysingenjörer en webbläsarbaserad VS Code-miljö med inbyggt Git, CI/CD och pipelineorkestrering – vilket eliminerar den infrastrukturella overheaden med att köra dessa verktyg själv.
Vem passar Datacoves bäst för?
Datacoves passar bra för datateknikteam som vill ha en fullt hanterad dbt- och Airflow-miljö utan den overhead som det innebär att själva bygga och underhålla infrastrukturen.
Varför jag valde Datacoves
Jag har tagit med Datacoves bland mina främsta val eftersom det är det enda verktyget här som levereras med en fullt hanterad, webbläsarbaserad VS Code-miljö där dbt och Airflow redan är sammankopplade. Jag gillar att varje utvecklare i teamet får en enhetlig arbetsyta med Git, virtuella Python-miljöer och tillägget Datacoves Power User förkonfigurerade, så att det inte uppstår någon skillnad i den lokala konfigurationen. När ett team skickar upp en ny DAG hämtar Airflow den från Git inom en minut, och VS Code-panelen för dataflödeslinjer visar beroenden mellan överordnade och underordnade modeller direkt i utvecklingsmiljön.
Datacoves viktigaste funktioner
- Skiktad modelleringsstruktur: Datacoves organiserar dbt-projekt i lager för inmatning, mellanlagring och analys, vilket separerar råa transformationer, återanvändbara dataprodukter och analysklara resultat.
- Hanterad Airbyte-inhämtning: Team kan köra hanterad Airbyte direkt i plattformen eller använda egna verktyg som Fivetran eller dlt och utlösa dem via Airflow.
- Projektmall för dbt-coves: Ett installationskommando genererar en anpassningsbar arkivstruktur med adapterspecifika lösningar för datalager, CI/CD-arbetsflöden, lintning, testramverk och dokumentationsstandarder.
- Hanterad DataHub-katalog: Datacoves inkluderar hanterad DataHub för metadataorganisering och dataupptäckbarhet i teamets dbt-projekt.
Datacoves-integrationer
Datacoves integreras med GitHub, GitLab, Bitbucket, Azure DevOps, Snowflake, BigQuery, Databricks, Redshift, DuckDB/MotherDuck och Airbyte. Plattformen har även stöd för Fivetran, Azure Data Factory, Amazon Glue, dlt, Streamsets, Informatica och API-integrationer.
Pros and Cons
Pros:
- Enhetliga webbläsarbaserade utvecklingsmiljöer
- Praktiskt stöd vid introduktion och felsökning
- Modellinjer synliga i VS Code
Cons:
- Airflow-sandlådan skiljer sig från produktionsbeteendet
- Vissa CI/CD-arbetsflöden kräver extra implementering
Learn more about Datacoves:
Fler alternativ till dbt
Här är ytterligare några alternativ till dbt som inte kom med på min kortlista, men som ändå är värda att ta en titt på:
- 115XBäst för orkestrering av datastackar i flera moln
- 12Snowflake Native AppsBäst för datatransformering i plattformen
- 13Qlik Talend CloudBäst för enhetlig dataintegration och datastyrning
Hur jag utvärderar alternativ till dbt
Jag delar upp min utvärdering i kärnkrav som varje verktyg måste uppfylla – DAG-baserad modellering, inbyggda tester, Git-integration – och de särskiljande faktorer som gör det rätta valet för just din stack.
Kärnfunktionalitet (grundkrav för den här listan)
När jag väljer verktyg till min lista rankar jag varje verktyg på en skala från 0 (erbjuder inte funktionaliteten) till 5 (utmärker sig inom området) för varje kärnfunktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- SQL-baserade datatransformeringar: Jag kontrollerar om varje verktyg har stöd för SQL- och/eller Python-baserad transformationslogik som körs direkt i ditt datalager, inklusive mallar och parametrisering för återanvändbara frågor.
- Modulär modellutveckling: Varje verktyg bör låta dig bygga beroende modeller med hjälp av referenser eller motsvarande mönster, så att din DAG återspeglar verkliga beroenden – exempelvis lager för förberedelse, mellanliggande bearbetning och datamartser.
- Git-baserad versionshantering: Jag letar efter inbyggd Git-integration med stöd för grenar, kodgranskningsbegäranden och CI/CD-kopplingar, eftersom analysingenjörer behöver samma arbetsflöden för kodgranskning som de skulle använda i vilket programvaruprojekt som helst.
- Automatiserade tester & datakvalitet: Inbyggda testdefinitioner är viktiga här – exempelvis kontroller av unikhet, NOT NULL-begränsningar och anpassade assertioner som du kan köra mot modellernas resultat innan de når produktion.
- Generering av dataflöden & dokumentation: Verktyget bör automatiskt generera dataflödesgrafer och sökbar dokumentation från din kodbas, så att du kan följa hur ett intäktsmått flödar från rå inläsning hela vägen till en BI-instrumentpanel.
- Anslutning till datalager och lakehouse: Jag utvärderar vilka plattformar varje verktyg ansluter till inbyggt – Snowflake, BigQuery, Redshift, Databricks, Postgres – eftersom brister här kan utesluta ett annars starkt alternativ för din stack.
När jag har en lista över verktyg som uppfyller dessa kriterier överväger jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Inbyggd orkestrering är en viktig särskiljande faktor – verktyg som inkluderar inbyggd schemaläggning och logik för nya försök gör att du slipper sätta ihop en separat Airflow- eller Dagster-installation bara för att köra dina modeller enligt ett schema. Jag utvärderar också om ett verktyg erbjuder ett semantiskt lager, eftersom det minskar antalet motstridiga siffror mellan team att definiera mått som MRR eller kundbortfallsgrad en gång och exponera dem konsekvent i Looker, Tableau eller Power BI. En visuell pipelinebyggare är också viktig, särskilt för team där analytiker behöver bidra med transformationer utan att skriva rå SQL.
Utöver funktionerna
Pristransparens är viktig när man jämför alternativ till dbt – vissa tar betalt per användare, andra efter beräkningskapacitet, och skillnaden påverkar den totala kostnaden när teamet växer. Jag utvärderar också hur väl verktyget passar in i ekosystemet, särskilt om det kan ansluta till ditt befintliga inläsningslager (Fivetran, Airbyte) och dina BI-verktyg utan anpassad integrationskod. Flexibilitet vid driftsättning är ytterligare en viktig faktor, eftersom team i reglerade miljöer ofta behöver VPC- eller egen drift i stället för en delad SaaS-instans.
Varför leta efter ett alternativ till dbt?
Även om dbt är ett bra val av verktyg för analysutveckling finns det flera anledningar till att vissa användare söker alternativa lösningar. Du kanske letar efter ett alternativ till dbt eftersom …
- Du behöver en kodfri eller lågkodad arbetsflödesbyggare för analys
- Ditt team saknar avancerade SQL- eller ingenjörskunskaper
- Du vill ha inbyggda verktyg för maskininlärning eller prediktiv analys
- Du behöver realtids- eller strömmande databearbetning
- Du behöver mer detaljerad spårbarhet för dataflöden och granskningsspår
- Din organisation föredrar ett visuellt gränssnitt för att utforma pipelines
Om något av detta stämmer in på dig har du kommit rätt. Min lista innehåller flera alternativ av verktyg för analysutveckling som passar bättre för team som står inför dessa utmaningar med dbt och söker alternativa lösningar.
dbt – viktiga funktioner
Här är några av dbt:s viktigaste funktioner, som hjälper dig att jämföra vad alternativa lösningar erbjuder:
- SQL-baserad datatransformering och datamodellering
- Versionshanteringsintegration med Git
- Automatiserade tester och kontroller av datakvalitet
- Modulär projektstruktur för återanvändbar kod
- Dokumentationsgenerering för modeller och arbetsflöden
- Hantering av beroenden och visualisering av DAG:er
- Stöd för större molnbaserade datalager
- Inkrementell modelluppbyggnad för effektiv bearbetning
- Kommandoradsgränssnitt och API-åtkomst
- Miljöhantering för utveckling och produktion