

As ferramentas de extração de dados da Web são aplicações que automatizam a extração de dados de sites, tornando simples a recolha de informações sem copiar e colar manualmente. Se está à procura das melhores ferramentas de extração de dados da Web, provavelmente precisa de recolher grandes volumes de dados da Web de forma fiável — sem enfrentar obstáculos como defesas anti-bot ou estruturas de sites em constante mudança.
Com tantas opções disponíveis no mercado, é difícil saber qual a ferramenta que se adapta realmente à sua pilha tecnológica, consegue lidar com os sites pretendidos e acompanhar as suas necessidades. Este guia analisa as principais ferramentas para que possa comparar funcionalidades e abordagens e encontrar exatamente o que funciona para os seus projetos de TI.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela comparativa: ferramentas de extração de dados da Web
Esta tabela comparativa resume os detalhes de preços das minhas principais escolhas de ferramentas de extração de dados da Web.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Best for built-in headless browser control | Free plan available | From $30/month | Website | |
| 2 | Best for stealth scraping and bypassing detection | 14-day free trial | From $69/month | Website | |
| 3 | Best for handling dynamic JavaScript websites | Free plan available | From $189/month | Website | |
| 4 | Best for direct pipeline integration | 30-day free trial | From $199/month (billed annually) | Website | |
| 5 | Best for prebuilt robot automation templates | Free plan available | From $19/month (billed annually) | Website | |
| 6 | Best for point-and-click interface users | Free plan available | From $69/month (billed annually) | Website | |
| 7 | Best for managed anti-bot data collection | Free trial available | From $0.5/1,000 records | Website | |
| 8 | Best for enterprise-scale proxy infrastructure | Free plan available | From $1.5/1,000 records/month | Website | |
| 9 | Best for automatic data schema detection | 30-day free trial | From $0.13/1,000 requests | Website | |
| 10 | Best for simple API-driven scraping workflows | Free plan available | From $49/month | Website |


Avaliações das melhores ferramentas de extração de dados da Web
Apresentamos abaixo os meus resumos detalhados das melhores ferramentas de extração de dados da Web que entraram na minha lista restrita. As minhas avaliações oferecem uma análise detalhada das funcionalidades, integrações e melhores casos de utilização de cada ferramenta, para o ajudar a encontrar a melhor opção para si.
 Best for built-in headless browser control
- Free plan available
- From $30/month
Visit WebsiteCustomer Rating:4.9/5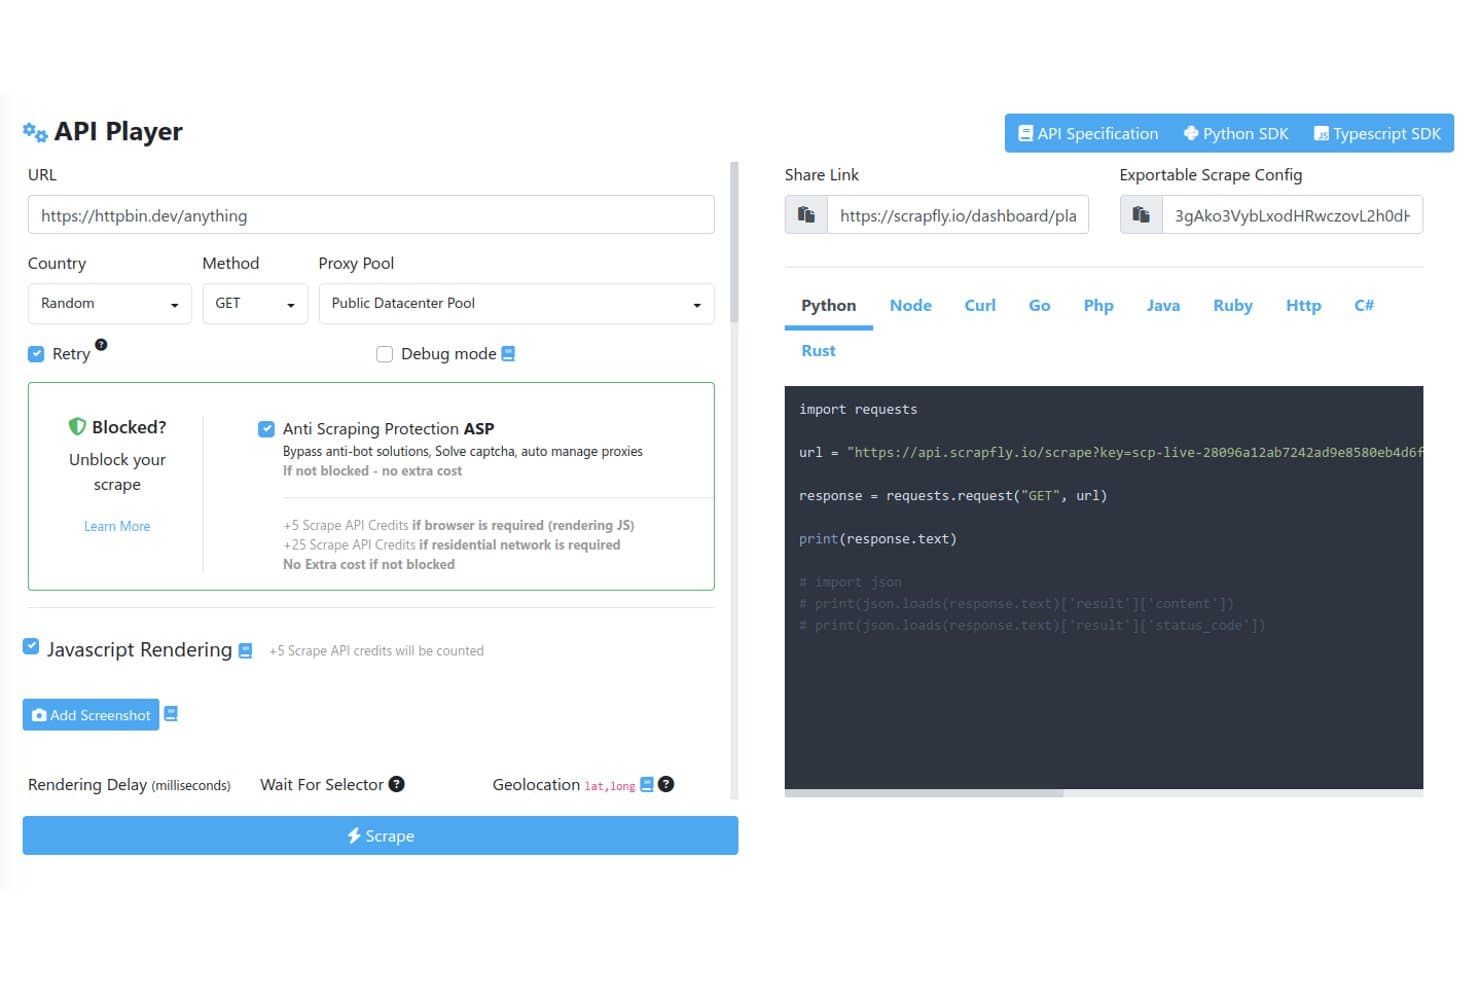
Scrapfly offers an interactive API Player with configurable scraping options including proxy pools, anti-scraping protection bypass, JavaScript rendering, and auto-generated code snippets in multiple languages. Scrapfly is a web scraping API that combines proxy rotation, anti-bot bypass, headless browser rendering, site crawling, screenshot capture, and LLM-powered data extraction under a single API key.
Who Is Scrapfly Best For?
Scrapfly is a strong fit for developers and data engineers who want a code-first scraping API with SDKs in Python, TypeScript, Go, and Rust.
Why I Picked Scrapfly
I picked Scrapfly because its dual-engine browser architecture is unlike anything else I've tested. Curlium handles byte-perfect Chrome JA4 fingerprinting for speed, while Scrapium runs stealth Chromium over CDP with matching fingerprints so sessions can swap mid-crawl without triggering detection. I also like that Scrapium is fully compatible with Playwright and Puppeteer, meaning I can write custom JS Scenarios and wait-for rules without touching my existing browser automation code.
Scrapfly Key Features
- Multi-method extraction API: Extracts structured data using CSS, XPath, regex, JSON schema, and LLM-powered templates.
- Integrated proxy pools: Provides managed datacenter and residential proxies with geo-targeting and BYO proxy support.
- Crawler API: Traverses entire sites with control over crawl depth, rate limits, and project partitioning.
- Native scheduling integrations: Supports Zapier, Make, and n8n for automated workflows, recurring jobs, and webhook triggers.
Scrapfly Integrations
Scrapfly offers native integrations with Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI, and OpenClaw. It also provides SDKs for Python, TypeScript, Go, and Rust. An API is available for custom integrations.
Pros and Cons
Pros:
- Extraction templates for common site types
- Bypasses Cloudflare, DataDome, and Imperva
- Dual stealth browser engines
Cons:
- Not suited for non-technical users
- No native in-product job scheduler
Learn more about Scrapfly: Best for stealth scraping and bypassing detection
- 14-day free trial
- From $69/month
Visit WebsiteCustomer Rating:4.7/5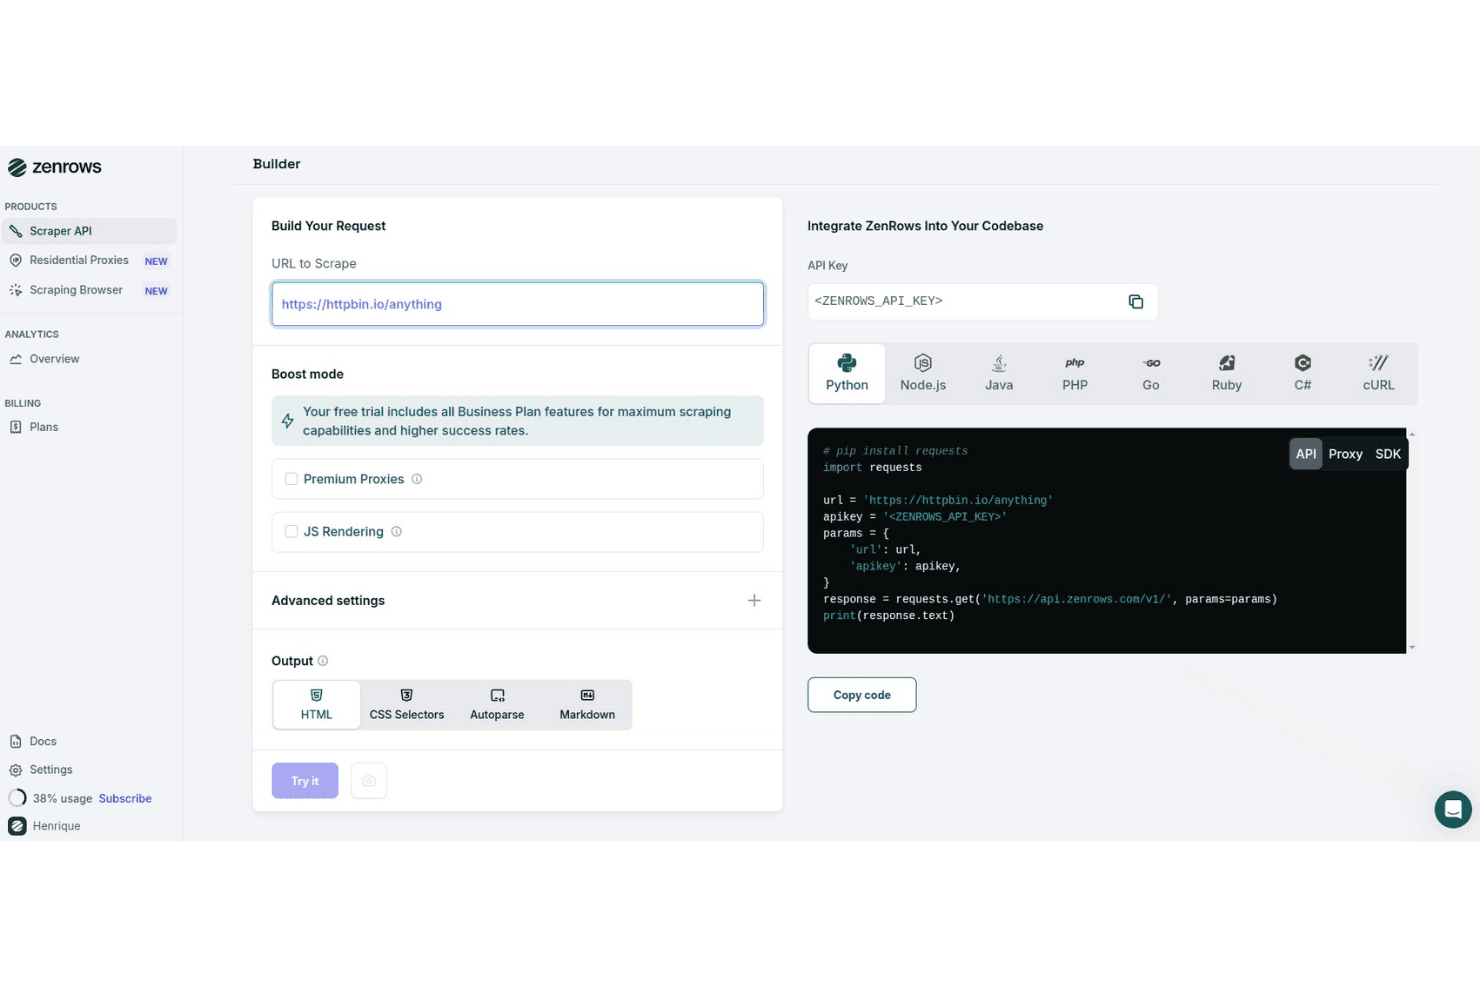
ZenRows offers a visual request builder with multi-language code generation, boost mode options, and output format selection for web scraping. ZenRows is a web scraping API and cloud browser platform that combines anti-bot bypass, residential proxy rotation, JavaScript rendering, and structured data extraction into a single developer-facing toolkit.
Who Is ZenRows Best For?
ZenRows is a strong fit for developers and data engineers who need to scrape sites with aggressive anti-bot protection at scale.
Why I Picked ZenRows
ZenRows earns its spot on my shortlist because of how it handles anti-bot protection. I've scraped Cloudflare-protected sites where standard tools consistently fail, and ZenRows gets through using fingerprinting bypass and automatic CAPTCHA solving without any manual configuration. The Scraping Browser goes further, running full Chromium sessions with stealth headers that closely mimic real user behavior to avoid detection on sites using DataDome or PerimeterX.
ZenRows Key Features
- Universal Scraper API: Make requests using a single endpoint that adapts to different site structures and scraping requirements.
- Residential proxy infrastructure: Choose from a pool of over 55 million residential IPs across 185+ countries for geo-targeted crawling.
- Auto-parsing for structured output: Extract and receive data in JSON, HTML, or Markdown automatically with built-in parsing for popular sites.
- Multi-language SDKs: Access official SDKs for Python, Node.js, Go, PHP, Ruby, Java, and C# to integrate with development workflows.
ZenRows Integrations
ZenRows offers native integrations with Playwright, Puppeteer, n8n, Make, Clay, and Zapier. An API is available for custom integrations.
Pros and Cons
Pros:
- Full headless browser sessions with stealth mode
- High success rate on protected pages
- Bypasses Cloudflare and DataDome reliably
Cons:
- Costs escalate quickly at high request volumes
- No native scheduling or job orchestration
Learn more about ZenRows: Best for handling dynamic JavaScript websites
- Free plan available
- From $189/month
Visit WebsiteCustomer Rating:4.4/5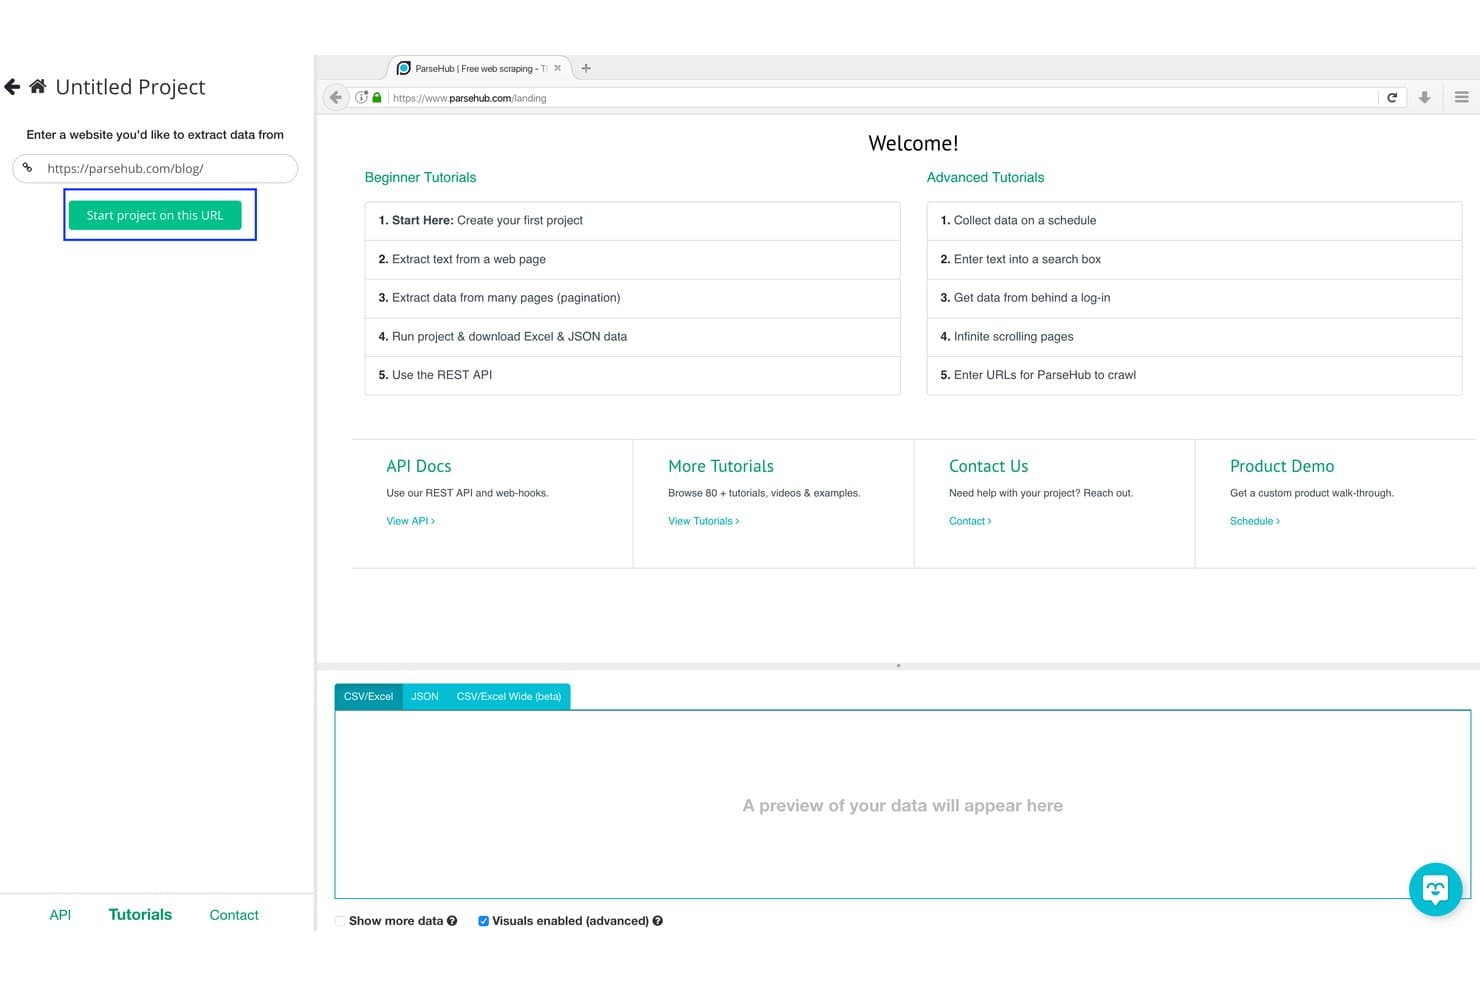
ParseHub offers a visual project setup interface where users enter a URL and click 'Start project on this URL' to begin scraping data from websites. ParseHub is a visual web scraping tool that extracts data from dynamic websites using a click-based interface, with support for JavaScript, AJAX, infinite scroll, form inputs, and scheduled cloud-based runs.
Who Is ParseHub Best For?
ParseHub is a good fit for competitive intelligence analysts and non-technical researchers who need to collect data from JavaScript-heavy sites without writing code.
Why I Picked ParseHub
ParseHub earns its spot as one of the best on my shortlist because it handles the JavaScript rendering challenges that break most no-code scrapers. I've used it to extract data from pages with infinite scroll and dropdown-triggered content, where static HTML scrapers return empty results. Its machine learning engine detects page structure automatically, which means I can build a working scraper for an AJAX-heavy product catalog without writing a single line of XPath.
ParseHub Key Features
- Point-and-click visual builder: Select and extract page elements without manual selector coding.
- Cloud-based scheduling: Schedule recurring scraping tasks on ParseHub's cloud infrastructure.
- REST API access: Manage, trigger, and download scrape results programmatically using the API.
- Automatic IP rotation: Reduce blocking by rotating outbound IPs on cloud-based runs.
ParseHub Integrations
ParseHub offers native integrations with Google Sheets, Tableau, Dropbox, and AWS S3. An API is available for custom integrations and workflow automation.
Pros and Cons
Pros:
- Scrapes run automatically on cloud infrastructure
- Visual builder requires no selector coding
- Handles JavaScript, AJAX, and infinite scroll natively
Cons:
- No built-in CAPTCHA solving
- Caps out on large concurrent scraping jobs
Learn more about ParseHub: Best for direct pipeline integration
- 30-day free trial
- From $199/month (billed annually)
Visit WebsiteCustomer Rating:4.2/5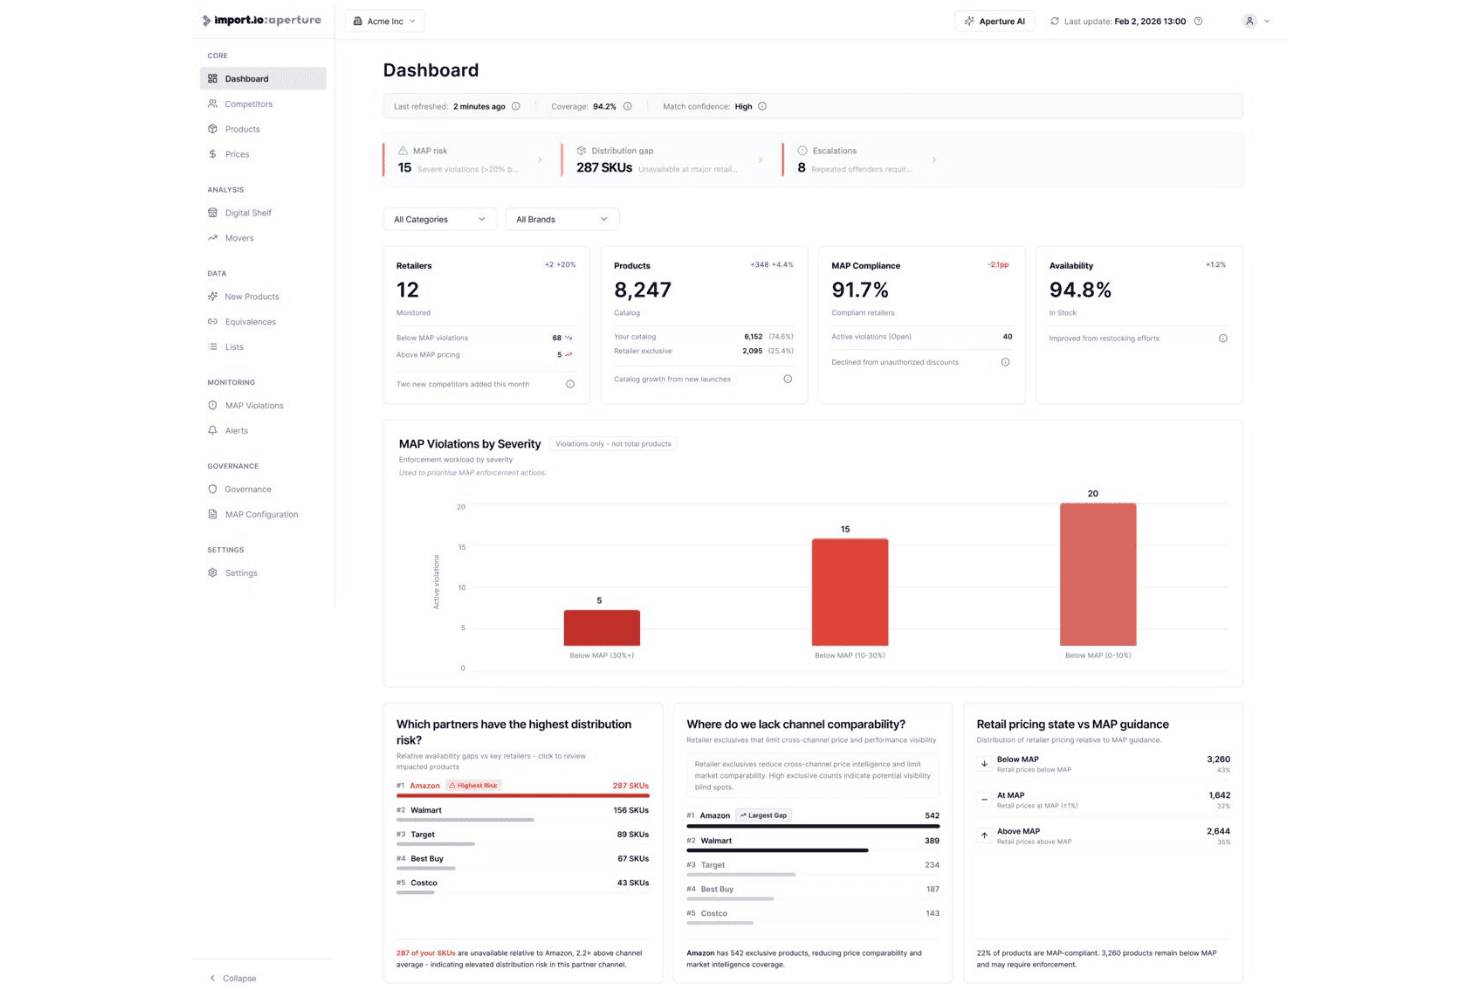
Import.io's Aperture platform offers a dashboard displaying MAP compliance, product availability, retailer distribution gaps, and pricing violations. Import.io is an AI-native, managed web scraping platform that extracts structured data from websites at enterprise scale, handling JavaScript-rendered pages, protected sources, and direct delivery into data pipelines and analytics systems.
Who Is Import.io Best For?
Import.io suits data engineering and competitive intelligence teams at mid-to-large enterprises that need maintained data pipelines without building or managing scrapers in-house.
Why I Picked Import.io
Import.io earns its spot on my shortlist because structured data moves directly from the web into your warehouse, dashboard, or API endpoint without a manual export step in between. I like that webhooks and API delivery are native to the platform, not an afterthought. What I find most valuable are the self-healing pipelines: they automatically adapt when target sites restructure, so I don't have to rebuild extractors every time a retailer updates their page layout.
Import.io Key Features
- AI-assisted extraction models: Automatically detect page structures and adapt schema as websites change.
- Enterprise proxy management: Supports premium and residential proxies for scraping protected or geo-restricted sites.
- Point-and-click visual builder: Select and extract data from complex web pages without writing code.
- Automatic PII masking: Identifies and removes personally identifiable information within scraped datasets for compliance.
Import.io Integrations
Import.io offers native integrations with Google Sheets, Power BI, Tableau, and Excel, and provides an API for custom integrations and webhooks into other systems.
Pros and Cons
Pros:
- Managed extraction reduces in-house engineering workload
- Handles heavily protected and login-walled sites
- Self-healing pipelines auto-adapt to site changes
Cons:
- Limited suitability for small-scale scraping tasks
- Limited transparency on underlying scraping infrastructure
Learn more about Import.io: Best for prebuilt robot automation templates
- Free plan available
- From $19/month (billed annually)
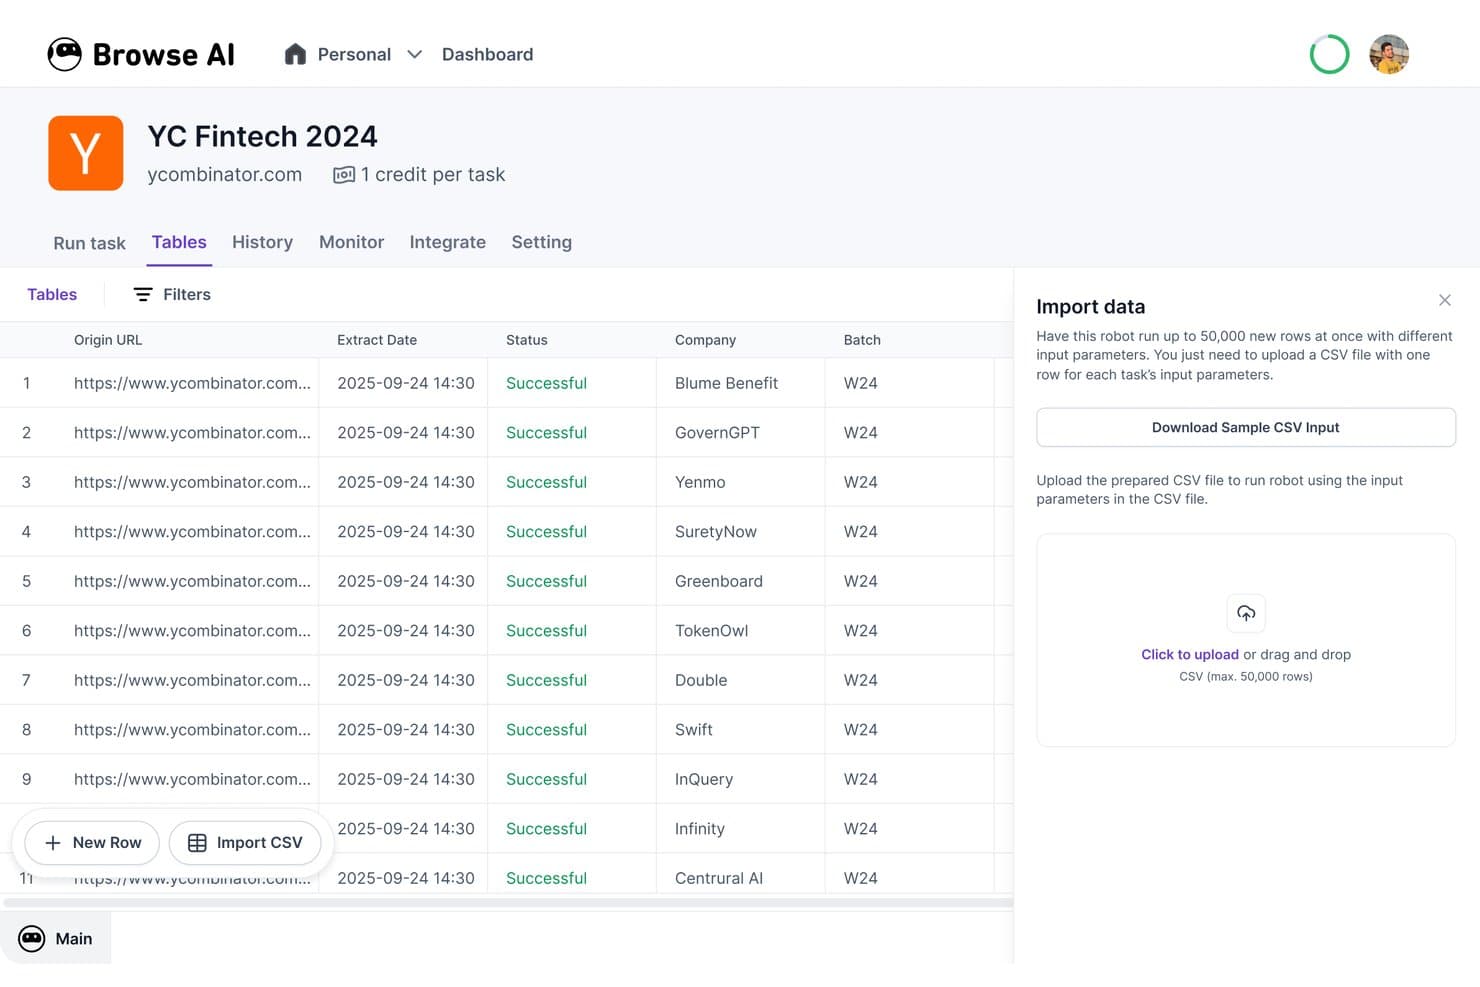
Browse AI offers a no-code web scraping dashboard where users can extract structured data from websites like Y Combinator and export results as CSV files. Browse AI is a no-code web scraping and website monitoring platform that combines a visual point-and-click data extractor with 250+ prebuilt robot templates for automated, scheduled data collection from websites.
Who Is Browse AI Best For?
Browse AI is a strong fit for competitive intelligence analysts and non-technical teams who need to collect structured web data without writing code.
Why I Picked Browse AI
Browse AI earns its spot on my shortlist because of how far ahead its prebuilt robot library is. I can pull structured listings from Amazon, Google Maps, or Indeed without building a scraper from scratch, and each robot already handles pagination and dynamic content for that specific site. What I also appreciate is the AI-powered layout adaptation, which automatically updates a robot when a target site changes its page structure, so scrapes don't silently break mid-pipeline.
Browse AI Key Features
- JavaScript rendering: Automates extraction from modern, JavaScript-heavy websites and single-page applications.
- Residential proxy support: Rotates residential IPs automatically to bypass anti-bot systems without manual proxy setup.
- Webhooks and API access: Allows programmatic submission of scraping tasks and retrieval of data for integration with internal systems.
- Automated change detection: Monitors websites for visual or content changes and sends alerts when updates are detected.
Browse AI Integrations
Browse AI offers native integrations with Google Sheets, Airtable, AWS S3, Zapier, and Make.com. API and webhook access are available for custom integrations.
Pros and Cons
Pros:
- Handles CAPTCHAs and dynamic pages natively
- Auto-adapts when target site layouts change
- 250+ prebuilt robots ready to deploy
Cons:
- Credit costs scale quickly at high volume
- Limited selector-level control for developers
Learn more about Browse AI: Best for point-and-click interface users
- Free plan available
- From $69/month (billed annually)
Visit WebsiteCustomer Rating:4.7/5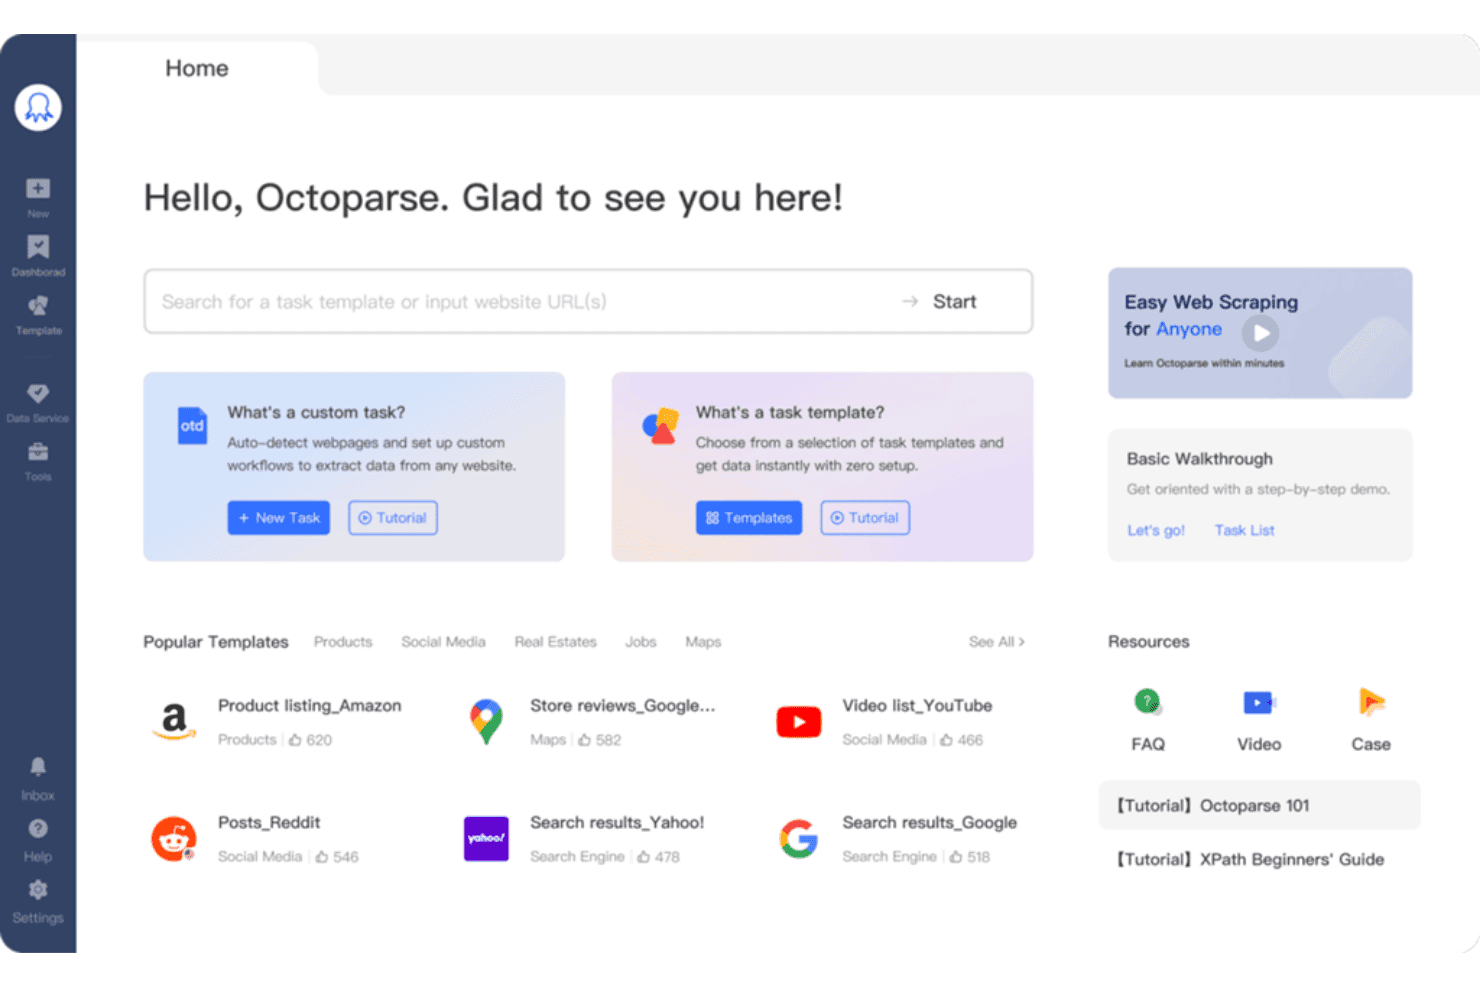
Octoparse offers a home dashboard with popular scraping templates, custom task creation, and quick-start resources for web data extraction. Octoparse is a no-code web scraping tool that combines a visual workflow builder, AI-powered auto-detection, cloud-based extraction, and support for JavaScript-rendered pages to collect structured data from websites.
Who Is Octoparse Best For?
Octoparse is a strong fit for competitive intelligence analysts and business users who need to collect web data regularly but don't have a coding background.
Why I Picked Octoparse
Octoparse earns its spot on my shortlist because the point-and-click workflow builder genuinely removes the technical barrier to web scraping. I like that the AI Auto-detect feature drafts a full extraction workflow by analyzing the target page automatically, so I'm not manually mapping selectors from scratch. The 500+ preset templates for sites like Amazon or Google Maps mean I can get a working scraper running in minutes on the most common targets.
Octoparse Key Features
- Cloud-based concurrent runs: Execute up to 20 scraping tasks in parallel using Octoparse’s cloud engine for faster data collection.
- IP rotation and residential proxies: Rotate IP addresses automatically and access residential proxies to reduce blocking and bypass anti-bot measures.
- Database and cloud exports: Export extracted data directly to MySQL, SQL Server, PostgreSQL, Oracle, Google Sheets, Dropbox, Amazon S3, or via API.
- Automatic CAPTCHA solving: Solve common CAPTCHAs during scraping tasks to maintain scraping continuity and minimize manual intervention.
Octoparse Integrations
Octoparse offers native integrations with Google Sheets, Google Drive, Dropbox, Amazon S3, MySQL, SQL Server, PostgreSQL, and Oracle. It also connects with Zapier and provides an API for custom integrations.
Pros and Cons
Pros:
- Handles infinite scroll, Ajax, and dynamic pages
- AI auto-detects and extracts drafts
- 500+ pre-built templates for common websites
Cons:
- Capped at 20 concurrent cloud processes
- Desktop client runs on Windows only
Learn more about Octoparse: Best for managed anti-bot data collection
- Free trial available
- From $0.5/1,000 records
Visit WebsiteCustomer Rating:4.5/5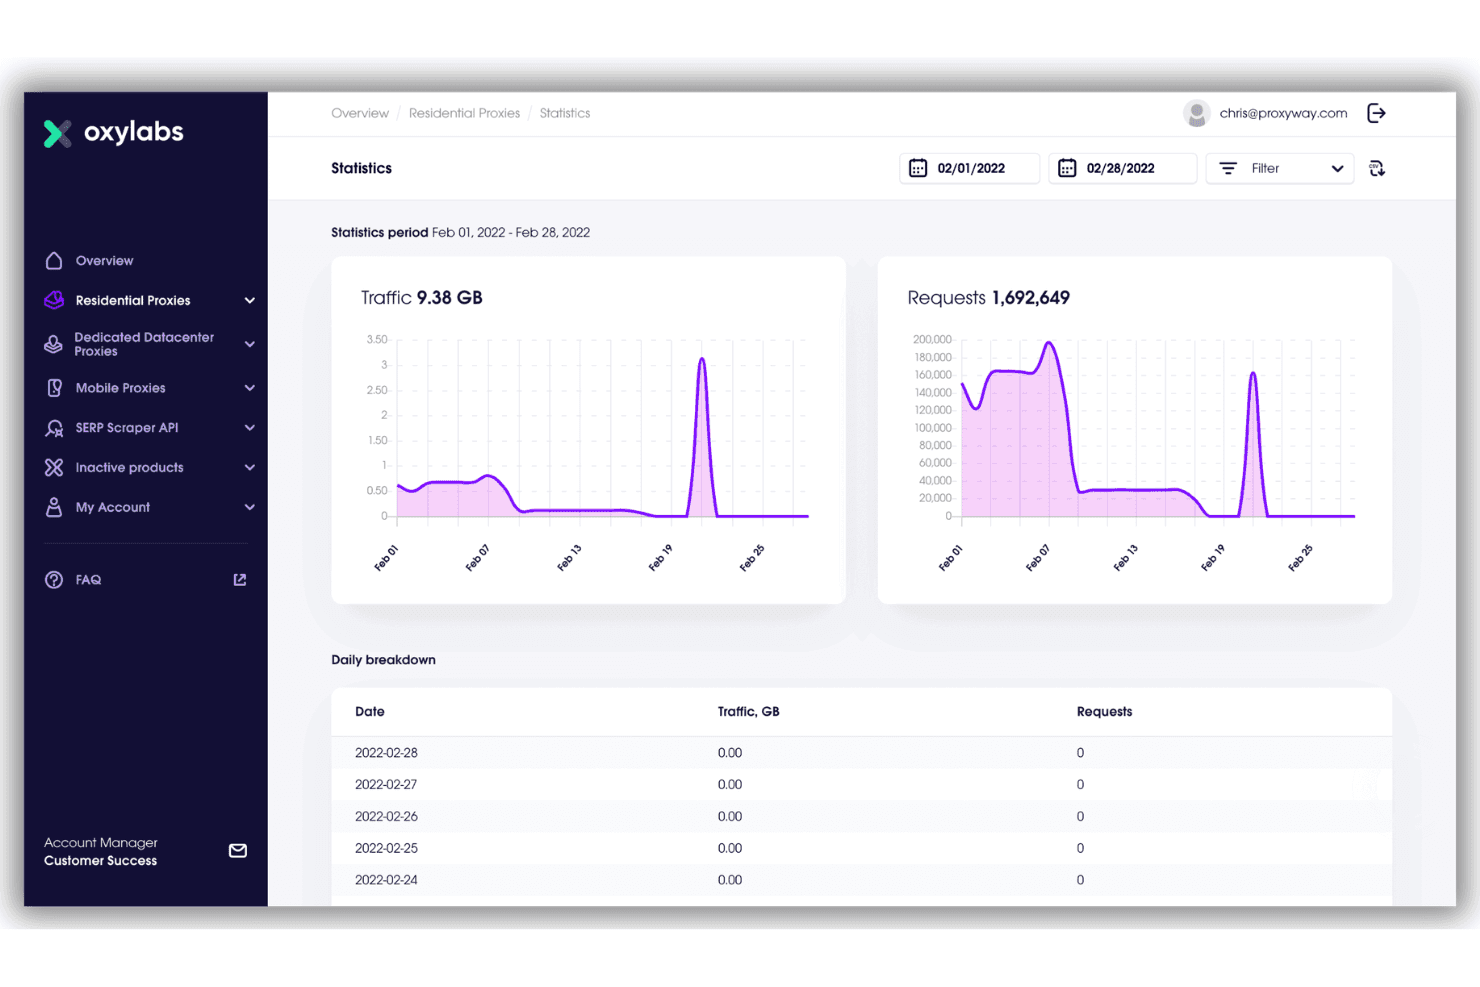
Oxylabs offers a detailed statistics dashboard for residential proxies, showing traffic and request metrics over a selected date range in February 2022. Oxylabs is a web scraper API that handles proxy management, CAPTCHA solving, JavaScript rendering, and structured data extraction across 50+ pre-configured website targets.
Who Is Oxylabs Best For?
Data engineers and backend developers running large-scale, mission-critical scraping pipelines who need enterprise-grade infrastructure and anti-bot reliability.
Why I Picked Oxylabs
Oxylabs earns its spot on my shortlist because of how it handles the hardest part of web scraping: getting past bot detection without managing it yourself. The API handles CAPTCHA solving, proxy rotation across 177M+ residential IPs, and automatic retries without any custom error-handling logic on my end. I also like the success-based pricing model, where only 2xx and 4xx responses count against your quota, so system-side failures don't burn through your results.
Oxylabs Key Features
- Custom parser: Define CSS or XPath selectors to extract precisely structured data from page content.
- OxyCopilot AI assistant: Generate scraping instructions and parse logic using natural language prompts.
- Pre-built target connectors: Use dedicated endpoints for Amazon, Google, eBay, Walmart, Zillow, and other major sites.
- Cloud storage integrations: Export results directly to AWS S3 and Google Cloud Storage for use in data pipelines.
Oxylabs Integrations
Oxylabs offers native integrations with AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com, and Zapier. An API and SDKs for Python and Go are available for custom integrations.
Pros and Cons
Pros:
- Pre-built endpoints for 50+ major sites
- Success-based pricing avoids wasted request quota
- 177M+ residential IPs across 195 countries
Cons:
- No visual, no-code scraper interface available
- Higher cost than self-managed scraping tools
Learn more about Oxylabs: Best for enterprise-scale proxy infrastructure
- Free plan available
- From $1.5/1,000 records/month
Visit WebsiteCustomer Rating:4.7/5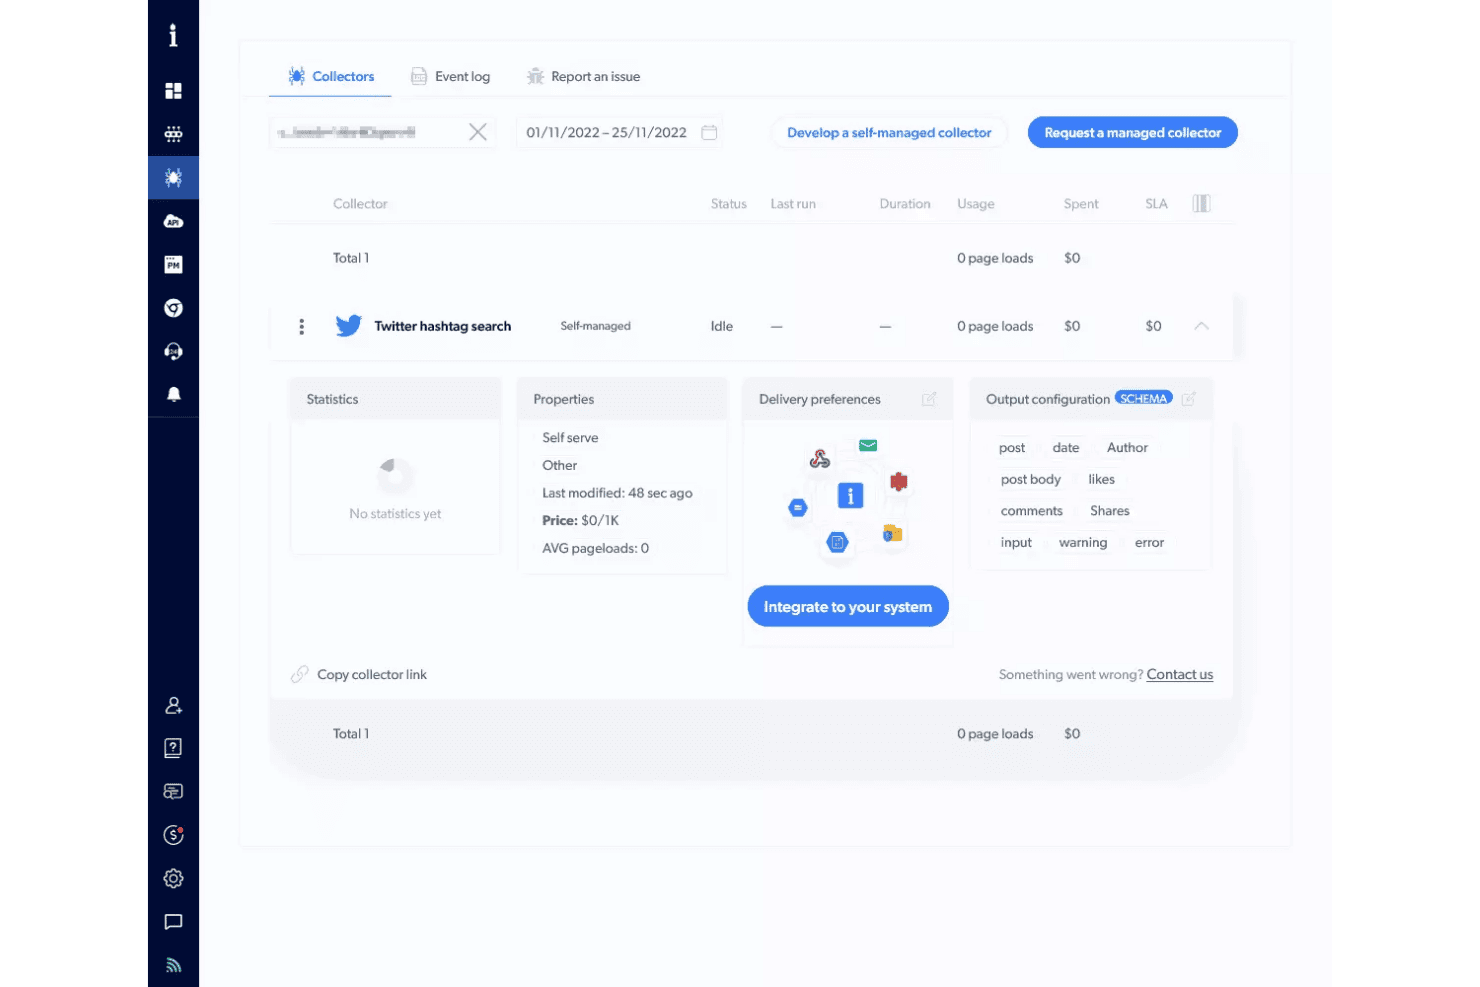
Bright Data's Collectors dashboard offers a Twitter hashtag search collector with self-managed status, output configuration, and system integration options. Bright Data is a web scraping API and no-code scraper platform that combines proxy management, JavaScript rendering, CAPTCHA solving, and structured data delivery across 1,278+ pre-built scrapers for popular websites.
Who Is Bright Data Best For?
Data engineers and backend developers at mid-to-large organizations who need to collect structured web data at scale without managing proxy infrastructure themselves.
Why I Picked Bright Data
Bright Data earns its spot on my shortlist because of the sheer scale of its proxy network: 400M+ residential IPs across 195 countries, with automatic rotation, CAPTCHA solving, and Web Unlocker built to defeat Cloudflare, Akamai, and DataDome without any configuration. I've scraped LinkedIn Sales Navigator and Amazon at volume using Bright Data and hit zero blocks across thousands of requests. The AI Scraper Studio also lets me generate a working scraper API for any new domain in minutes.
Bright Data Key Features
- Pre-built scraper templates: Over 1,200 ready-made scrapers are available for quick deployment across major platforms like LinkedIn, Amazon, and YouTube.
- AI-powered schema detection: AI Scraper Studio generates custom output schemas and automates data mapping from new domains.
- Job management APIs: Provides batch scheduling, recurring runs, and webhook triggers for integrating with workflow automation tools.
- Direct data delivery: Supports exporting data to JSON, NDJSON, CSV, XLSX, or directly pushing to S3, Snowflake, GCS, PubSub, or SFTP.
Bright Data Integrations
Bright Data offers native integrations with Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake, and Pub/Sub, and provides an API for custom integrations.
Pros and Cons
Pros:
- Web Unlocker bypasses Cloudflare and DataDome
- Pre-built scrapers for 1,200+ popular websites
- 400M+ residential IPs across 195 countries
Cons:
- Overly complex for non-developer buyers
- Users report billing disputes on failed scrapes
Learn more about Bright Data: Best for automatic data schema detection
- 30-day free trial
- From $0.13/1,000 requests
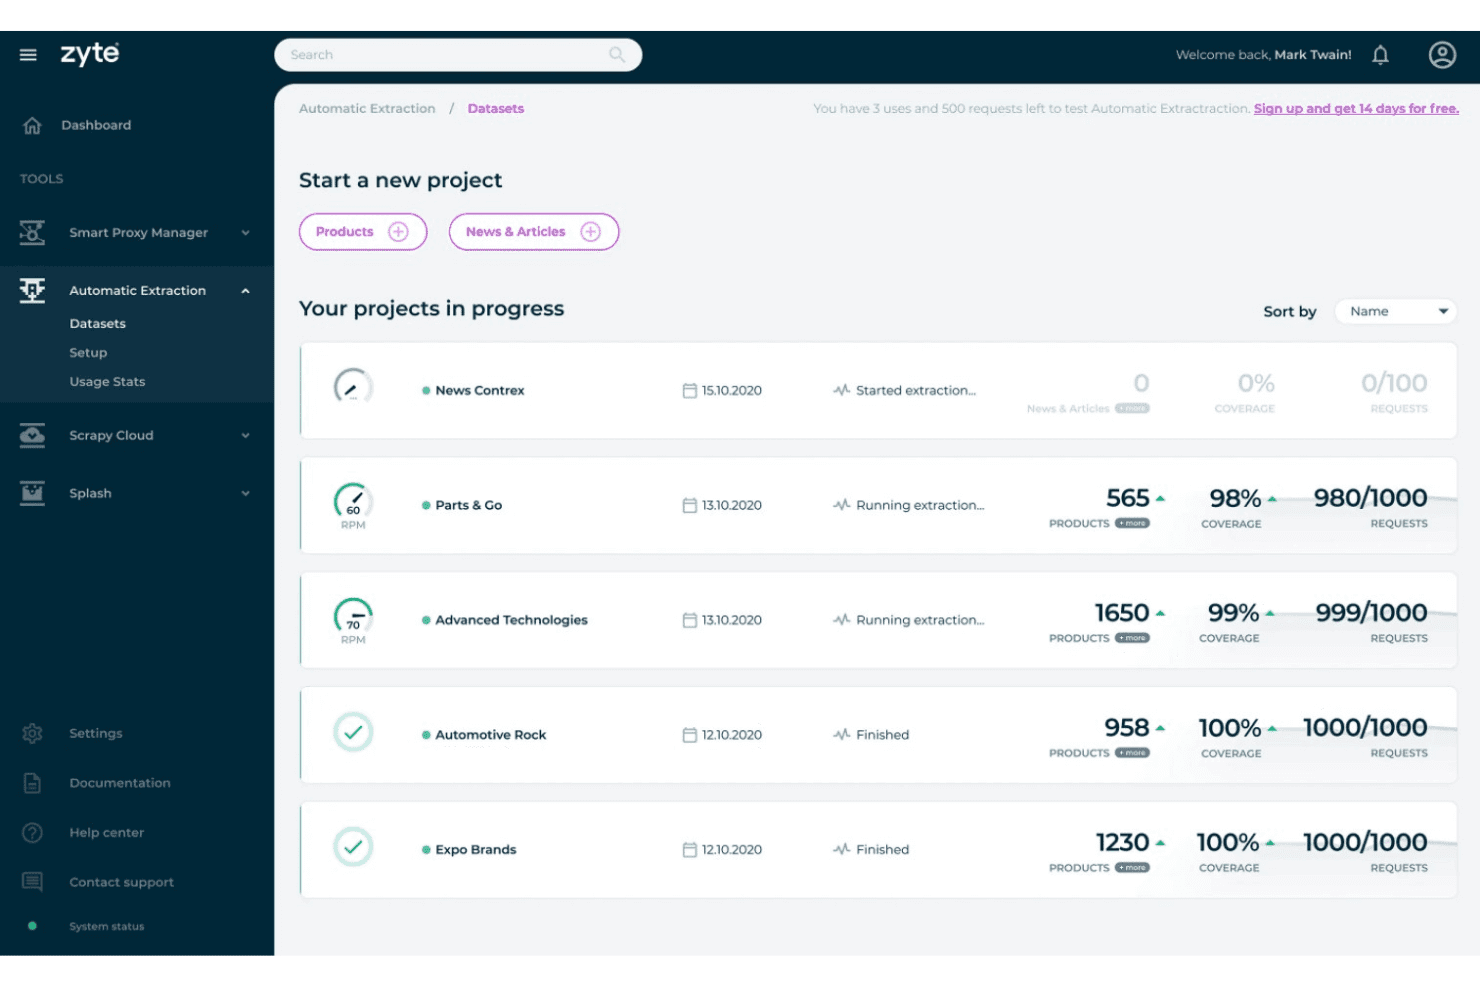
Zyte's Automatic Extraction feature offers ongoing and completed data extraction projects with coverage, product counts, and request usage metrics. Zyte API is a web scraping API that combines headless browser rendering, automatic proxy rotation, CAPTCHA solving, and AI-powered data extraction into a single endpoint.
Who Is Zyte API Best For?
Zyte API is a strong fit for data engineers and Python developers building production-scale scraping pipelines that feed ML models or analytics systems.
Why I Picked Zyte API
Zyte API earns its spot on my shortlist because of how it handles automatic schema detection. Point it at a product page or article, and its LLM-powered extraction layer returns typed, structured JSON without a single CSS selector or XPath expression on my end. When a site updates its layout, the AI adapts, which means I'm not constantly patching parsers every time a competitor redesigns their catalog page.
Zyte API Key Features
- Instant browser rendering: Zyte API spins up pre-warmed headless browsers to load dynamic sites on demand.
- Full proxy infrastructure: Rotates residential, datacenter, and mobile IP addresses automatically with every request.
- Session management: Maintains persistent cookies and user sessions for workflows that require authentication or multi-step actions.
- Cloud delivery integrations: Pushes scraped data directly to destinations like AWS S3, Google Cloud, or Azure for further processing.
Zyte API Integrations
Zyte API offers native integrations with Scrapy, Scrapy Cloud, and Python SDKs, and provides an API for custom integrations. It also supports cloud delivery to AWS S3, Google Cloud, and Azure.
Pros and Cons
Pros:
- Pre-warmed browsers eliminate cold start delays
- Bypasses anti-bot protections without extra configuration
- AI auto-detects schemas without manual selectors
Cons:
- Requires coding knowledge to implement
- Recurring job scheduling needs external tooling
Learn more about Zyte API: Best for simple API-driven scraping workflows
- Free plan available
- From $49/month
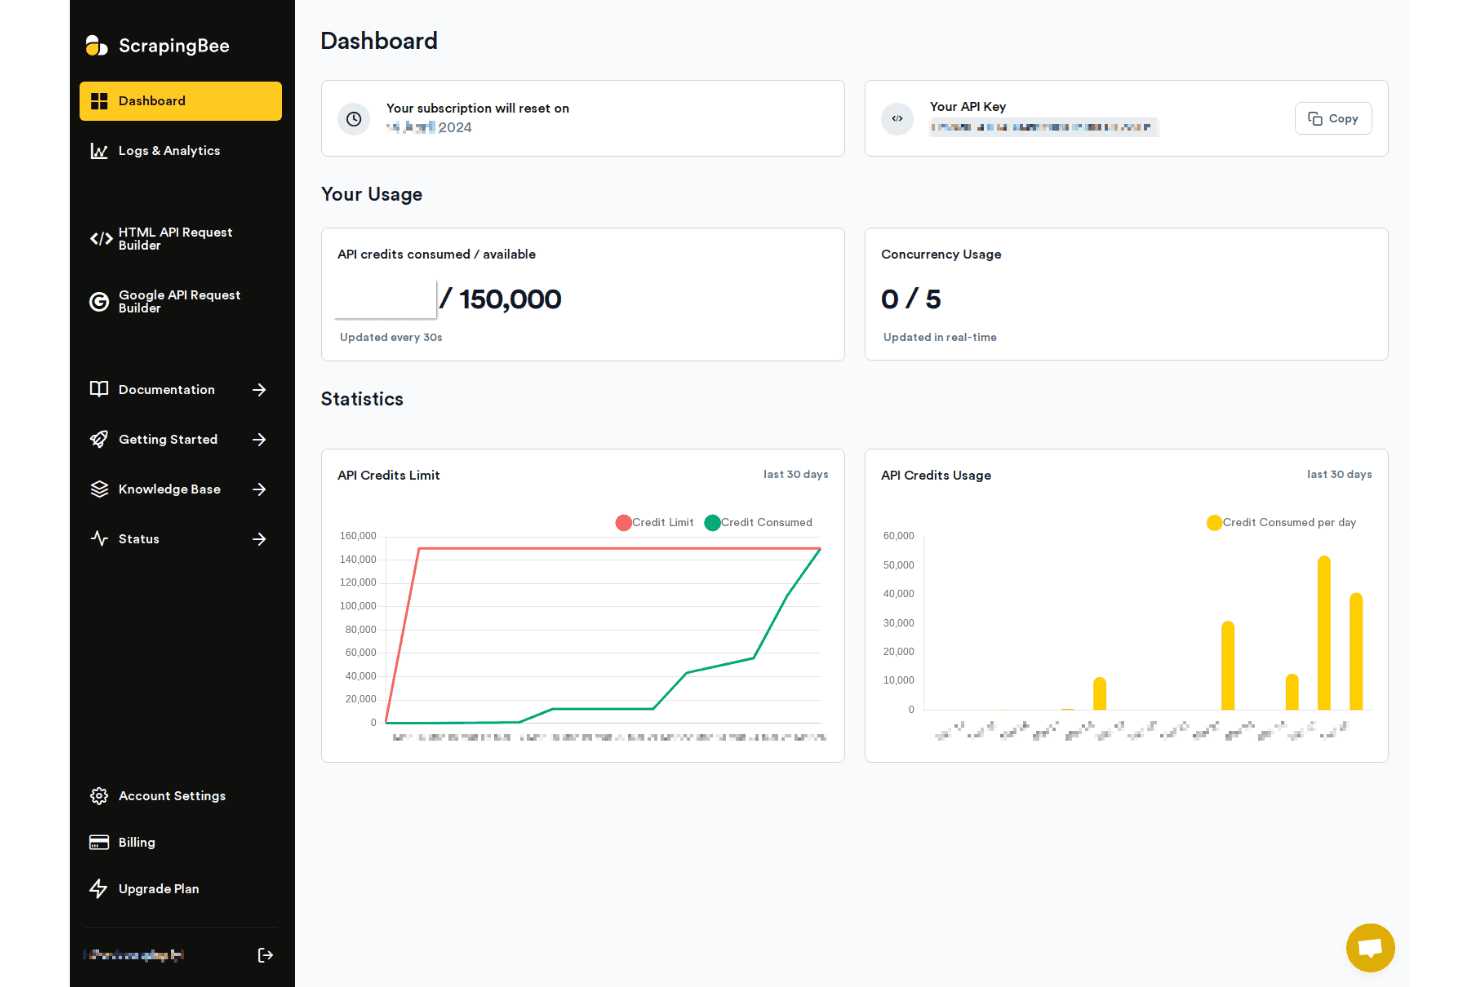
ScrapingBee offers a dashboard with API credit usage, concurrency stats, and 30-day usage charts for monitoring scraping activity. ScrapingBee is a web scraping API that handles headless Chrome rendering, proxy rotation, and anti-bot bypassing, with dedicated extraction APIs for platforms like Google, Amazon, and Walmart.
Who Is ScrapingBee Best For?
ScrapingBee is a strong fit for developers and data engineers who need a reliable, code-first API for extracting web data without building proxy or browser infrastructure from scratch.
Why I Picked ScrapingBee
ScrapingBee earns its spot on my shortlist because of how cleanly its API abstracts away the complexity of modern web scraping. A single request handles headless Chrome rendering, stealth proxy rotation, and JavaScript execution, so I'm not writing browser management code or configuring proxy pools separately. I also like the AI Query feature, which lets me describe what to extract in plain language rather than writing CSS or XPath selectors for every new site I target.
ScrapingBee Key Features
- Dedicated scraping APIs: Choose pre-built endpoints for platforms like Amazon, Walmart, and Google Search to simplify common data collection tasks.
- AI Query extraction: Describe what data to extract in plain language and generate structured results automatically.
- Markdown scraper: Convert any webpage into Markdown or plain text for fast ingestion by downstream AI models or databases.
- No-code integrations: Connect with Make, n8n, and Zapier to automate workflows without writing custom scheduling scripts.
ScrapingBee Integrations
ScrapingBee offers native integrations with Make, n8n, and Zapier, and provides an API for custom integrations.
Pros and Cons
Pros:
- Dedicated APIs for Amazon and Google
- Handles headless Chrome without extra setup
- Only charges for successful requests
Cons:
- Credit costs rise fast at scale
- No native built-in job scheduler
Learn more about ScrapingBee:
Outras ferramentas de extração de dados da Web
Eis algumas opções adicionais de ferramentas de extração de dados da Web que não entraram na minha lista restrita, mas que ainda vale a pena consultar:
- 11ScraperAPIBest for hassle-free IP rotation at scale
- 12CrawlbaseBest for API access to global data sources
- 13ScrapyBest for customizable Python scraping frameworks
- 14ScrapingdogBest for rapid deployment with minimal setup
How I Evaluate Web Scraping Tools
I split my evaluation into two layers: the baseline a tool needs to handle real-world scraping—JS rendering, proxy rotation, scheduled jobs—and the differentiators that set the best options apart.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score into a percentage. Each tool needs to achieve a minimum total score of 65% to be considered for inclusion.
- Data Extraction Engine: I evaluate whether a tool supports multiple selector methods like CSS, XPath, and regex, or offers a visual builder for teams that prefer point-and-click setup.
- JavaScript Rendering: Sites built on React, Vue, or Angular need headless browser support. I check for reliable rendering with configurable wait conditions.
- Proxy & Anti-Bot Handling: I look for built-in proxy rotation, CAPTCHA solving, and bypass mechanisms that handle protections like Cloudflare or DataDome without extra setup.
- Scheduling & Automation: Recurring scrapes should run unattended. I evaluate whether the tool supports cron-style scheduling, webhook triggers, and failure retry logic.
- Structured Data Export: I check what output formats are available and whether the tool can push data directly to destinations like S3, Google Sheets, databases, or APIs.
- Scalability & Concurrency: Large jobs across thousands of pages need parallel requests. I look at concurrency limits and whether the tool supports distributed crawling.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
Anti-bot bypass is where I see the biggest gap between tools. I look for built-in CAPTCHA solving and browser fingerprinting that handles protections like Cloudflare or DataDome without requiring you to source third-party proxy services. Auto-detection templates also matter a lot—tools like Bright Data and Zyte offer prebuilt scrapers for common targets like Amazon or Google SERPs, which saves hours of manual selector configuration. I also evaluate scheduling and monitoring capabilities, especially failure alerts and automatic retries that keep data pipelines running when target sites change their layouts overnight.
Beyond Features
Pricing models vary widely in this space—some vendors bill per API request, others by bandwidth or successful pages returned. I evaluate whether costs stay predictable when you scale into millions of pages per month. Proxy infrastructure is another key differentiator. I check whether a tool includes residential and datacenter proxy pools with city-level geo-targeting built in, since sourcing separate proxy contracts adds cost and complexity. Compliance posture also matters, especially for teams scraping in regulated industries where GDPR and robots.txt handling need to be clearly documented.
Como escolher ferramentas de extração de dados da Web
É fácil ficar atolado em listas intermináveis de funcionalidades e estruturas de preços complexas. Para o ajudar a manter o foco enquanto percorre o seu processo específico de seleção de software, apresentamos uma lista de verificação dos fatores a ter em conta:
| Fator | O que considerar |
|---|---|
| FatorEscalabilidade | O que considerarA ferramenta consegue lidar com os aumentos de volume previstos e com rastreios paralelos sem grandes aumentos de custos ou limites de frequência? |
| FatorIntegrações | O que considerarA ferramenta irá enviar os dados diretamente para os seus sistemas de destino (armazenamento na nuvem, bases de dados, fluxos de trabalho) ou serão necessários passos manuais? |
| FatorPersonalização | O que considerarÉ possível adaptar a lógica de extração a estruturas de sites específicas ou está limitado a modelos e regras predefinidos? |
| FatorFacilidade de utilização | O que considerarTanto os utilizadores técnicos como os não técnicos conseguem gerir as extrações ou será necessária a participação contínua de programadores para efetuar alterações? |
| FatorImplementação e integração inicial | O que considerarCom que rapidez pode a sua equipa configurar o primeiro fluxo de dados e que apoio ou documentação estão disponíveis caso surjam dificuldades? |
| FatorCusto | O que considerarOs preços são previsíveis à medida que a utilização aumenta? Seja realista quanto a picos, lógica de novas tentativas e falsos positivos na sua carga de trabalho. |
| FatorMedidas de segurança | O que considerarA ferramenta expõe a sua empresa ou fluxo de trabalho a riscos de conformidade, fugas de dados ou pontos de acesso não autorizados? |
| FatorRequisitos de conformidade | O que considerarA abordagem do fornecedor está alinhada com as suas regras internas e regionais (por exemplo, RGPD, cumprimento do robots.txt e tratamento de informações de identificação pessoal (PII))? |
O que são ferramentas de extração de dados da Web?
As ferramentas de extração de dados da Web são plataformas de software que automatizam a recolha e a extração de dados estruturados de sites. Estas ferramentas permitem captar informações de páginas — incluindo conteúdo dinâmico e gerado por JavaScript — para utilização em análises, relatórios ou integração com bases de dados internas. A maioria oferece opções para configurar regras de extração e exportar dados em formatos adequados para programadores.
Funcionalidades das ferramentas de extração de dados da Web
Ao selecionar ferramentas de recolha de dados da web, esteja atento às seguintes funcionalidades essenciais:
- Motor de extração de dados: Permite definir como o conteúdo é recolhido dos sites através de seletores CSS, XPath ou interfaces de apontar e clicar, para obter resultados estruturados.
- Processamento de JavaScript: Carrega aplicações dinâmicas ou de página única através da execução de JavaScript, garantindo a captura de dados que não aparecem no HTML estático.
- Gestão de proxies: Alterna entre endereços IP, frequentemente utilizando serviços de proxy residenciais, para contornar bloqueios geográficos, limites de pedidos ou proteção contra robôs, permitindo recolher dados de sites de forma fiável e em grande escala.
- Gestão de CAPTCHAs: Deteta e resolve ou contorna automaticamente desafios CAPTCHA, mantendo os processos de dados em funcionamento quando são ativadas medidas antirrobô.
- Agendamento e automatização: Define recolhas recorrentes ou aciona tarefas com base em intervalos específicos, permitindo o funcionamento sem supervisão e a integração em processos de dados.
- Exportação de dados estruturados: Suporta a exportação para JSON, CSV, XML ou o envio direto para armazenamento na nuvem, APIs ou bases de dados, eliminando as etapas de conversão e carregamento manuais.
- Deteção de alterações e alertas: Monitoriza sites-alvo à procura de atualizações de conteúdo, alterações de preços ou novos anúncios, notificando-o se os resultados forem diferentes dos obtidos em execuções anteriores.
- Controlos de simultaneidade: Gere vários pedidos em paralelo para acelerar as sessões de recolha de dados e permite acomodar tarefas de rastreio em grande escala em milhares de páginas.
- Gestão de erros e registos: Regista extrações falhadas, interrupções de ligação ou alterações nos sites, fornecendo registos de erros detalhados para diagnosticar e corrigir rapidamente problemas de recolha de dados.
- Controlos de acesso dos utilizadores: Restringe quem pode editar projetos, gerir tarefas ou consultar exportações, de modo a manter a segurança e impedir alterações acidentais ou não autorizadas.
Funcionalidades de IA comuns nas ferramentas de recolha de dados da web
Para além das funcionalidades padrão das ferramentas de recolha de dados da web apresentadas acima, muitas destas soluções estão a incorporar IA com funcionalidades como:
- Deteção automática de campos de dados: Utiliza IA para identificar e mapear automaticamente campos de dados relevantes em páginas web complexas ou desconhecidas, reduzindo a configuração manual de seletores.
- Reconhecimento adaptativo da estrutura dos sites: Aprende e adapta-se a alterações nos esquemas dos sites, minimizando o tempo de inatividade e a manutenção quando os sites-alvo atualizam o seu design.
- Contorno inteligente de medidas antirrobô: Aplica IA para imitar padrões de navegação humana e adaptar as estratégias de recolha de dados em tempo real, ajudando a contornar sistemas avançados de deteção de robôs.
- Análise de conteúdo em linguagem natural: Utiliza IA para extrair, resumir ou categorizar texto não estruturado, facilitando a análise de avaliações, artigos ou publicações em fóruns.
- Geração automática de modelos: Cria modelos reutilizáveis de recolha de dados para sites semelhantes, analisando a estrutura das páginas e os padrões de conteúdo com aprendizagem automática.
- Correção inteligente de erros: Deteta e resolve erros ou anomalias comuns de extração através de diagnósticos baseados em IA, reduzindo a necessidade de resolução manual de problemas.
Benefícios das ferramentas de recolha de dados da web
A implementação de ferramentas de recolha de dados da web proporciona vários benefícios à sua equipa e à sua empresa. Eis alguns dos benefícios que pode esperar:
- Recolha de dados em grande escala: Automatiza a extração de informações de muitos sites e páginas, disponibilizando grandes conjuntos de dados para análise ou aprendizagem automática.
- Informações de mercado em tempo real: Monitoriza instantaneamente os preços dos concorrentes, os catálogos de produtos e as alterações nos sites através de funcionalidades de agendamento, deteção de alterações e alertas.
- Eficiência dos recursos: Agenda e automatiza tarefas, reduzindo o esforço manual e permitindo que os programadores se concentrem em projetos de maior valor.
- Qualidade consistente dos dados: Exporta dados estruturados em formatos fiáveis, como JSON ou CSV, minimizando o trabalho moroso de limpeza e integração dos dados.
- Contorno de obstáculos antirrobô: Utiliza a rotação de proxies integrada ou serviços externos de proxies rotativos, juntamente com a gestão de CAPTCHAs e o contorno de medidas antirrobô, para aceder a conteúdos que outras soluções não conseguem alcançar.
- Adaptabilidade às alterações dos sites: Recorre a uma gestão inteligente de erros e, no caso das ferramentas com IA, à extração com adaptação automática quando os esquemas ou as estruturas dos sites são alterados.
- Acesso seguro e conformidade: Protege os processos de dados com permissões de utilizadores, registos de auditoria e alinhamento com quadros de conformidade ou regulamentações de privacidade.
Custos e preços das ferramentas de recolha de dados da web
A seleção de ferramentas de extração de dados da Web exige uma compreensão dos vários modelos de preços e planos disponíveis. Os custos variam consoante as funcionalidades, a dimensão da equipa, os complementos e outros fatores. A tabela abaixo resume os planos comuns, os respetivos preços médios e as funcionalidades normalmente incluídas nas soluções de ferramentas de extração de dados da Web:
Tabela de comparação de planos para ferramentas de extração de dados da Web
| Tipo de plano | Preço médio | Funcionalidades comuns |
|---|---|---|
| Tipo de planoPlano gratuito | Preço médio$0-$10/mês | Funcionalidades comunsExecuções de extração limitadas, agendamento básico, suporte da comunidade e formatos iniciais de exportação de dados. |
| Tipo de planoPlano pessoal | Preço médio$15-$40/mês | Funcionalidades comunsMais créditos de extração, processamento de JavaScript, acesso à API e tratamento básico de erros. |
| Tipo de planoPlano empresarial | Preço médio$55-$150/mês | Funcionalidades comunsMaior simultaneidade, rotação de proxies, agendamento avançado, ferramentas de colaboração em equipa e suporte prioritário. |
| Tipo de planoPlano empresarial personalizado | Preço médio$250+/mês | Funcionalidades comunsIntegrações personalizadas, garantias de SLA, proxies direcionados geograficamente, integração assistida e gestão dedicada da conta. |
Perguntas frequentes sobre ferramentas de extração de dados da Web
Eis algumas respostas a perguntas comuns sobre ferramentas de extração de dados da Web:
Preciso de conhecimentos de programação para utilizar ferramentas de extração de dados da Web?
Não, não precisa necessariamente de conhecimentos de programação. Muitas ferramentas visuais oferecem uma solução sem código, como uma extensão do Chrome baseada em apontar e clicar, que permite aos utilizadores sem conhecimentos técnicos criar visualmente rotinas de extração e navegar pelo mapa do site para recolher registos para tarefas como a geração de potenciais clientes.
No entanto, a lógica personalizada, os fluxos de dados complexos ou a extração de dados em grande volume dependem normalmente de ferramentas de programação:
- Python: Uma biblioteca Python tradicional, como a BeautifulSoup, é ideal para analisar documentos HTML estáticos de forma organizada.
- JavaScript: Uma biblioteca especializada de Node.js, como o Puppeteer ou o Playwright, permite aos programadores interagir programaticamente com elementos Web dinâmicos.
As ferramentas de extração de dados da Web conseguem lidar com sites dinâmicos e com elevada utilização de JavaScript?
Sim, a maioria das ferramentas modernas disponibiliza motores de processamento de JavaScript para extrair conteúdo dinâmico de aplicações de página única (SPAs) e sites interativos.
Como é que as ferramentas de extração de dados da Web lidam com as medidas anti-bot dos sites?
Para ultrapassar as proteções anti-bot, as ferramentas sofisticadas implementam várias estratégias de evasão:
- Rotação de proxies: Distribuição dos pedidos por grandes conjuntos de endereços IP (de centros de dados e residenciais) para evitar limites de frequência ou bloqueios de IP.
- Resolução automática de CAPTCHAs: Resolução ou contorno de desafios visuais e comportamentais.
- Mascaramento da impressão digital do navegador: Modificação dos cabeçalhos do navegador, das impressões digitais do canvas e dos agentes de utilizador em motores como o WebKit ou o Chromium, para imitar interações humanas nos principais navegadores, como o Firefox ou o Chrome.
A extração de dados da Web é legal?
A legalidade da extração de dados da Web depende dos dados que recolhe, da forma como os utiliza e dos termos de serviço do site. Consulte sempre as orientações legais e os requisitos de conformidade antes de avançar.
Como recebo e armazeno os dados extraídos?
Normalmente, pode exportar dados para formatos como CSV, JSON ou Excel, ou enviá-los diretamente para armazenamento na nuvem, webhooks ou bases de dados, consoante as opções de integração da ferramenta.