

A więc zaczęliście wdrażać DevOps w swojej firmie. Ale skąd wiadomo, czy usprawnia to wasze procesy? Trzeba w jakiś sposób mierzyć sukces, a można to osiągnąć, monitorując kilka kluczowych wskaźników DevOps.
Istnieje wiele sposobów oceny jakości systemu lub aplikacji, ale w tym artykule skupię się na kluczowych wskaźnikach, które pomagają ocenić jakość procesów. Śledząc te wskaźniki, możesz uzyskać głębszy wgląd w swoje mocne i słabe strony, udoskonalić najlepsze praktyki DevOps i wykorzystać odpowiednie narzędzia i oprogramowanie do ciągłego doskonalenia.
Dlaczego wskaźniki DevOps są ważne?
Jak wspomniano powyżej, wspólne cele i wskaźniki mogą stanowić wyzwanie dla zespołów wdrażających DevOps w firmie. Bez wskaźników DevOps nie byłoby testowania ani pomiarów, a także nie byłoby usprawnień w procesie tworzenia oprogramowania. Byłyby tylko kolejne iteracje tego samego oprogramowania oparte na przeczuciach i pomysłach, wysyłane w otchłań, a następnie zastępowane czymś nowym. Bez informacji zwrotnych lub wskaźników sukcesu produktu pozwalających zrozumieć, jak coś działa, nie ma żadnego kierunku.
Na przykład działy finansowe chcą utrzymywać koszty na możliwie niskim poziomie, podczas gdy programiści chcą utrzymywać wydajność na możliwie wysokim poziomie. Te dwa cele mogą nie być ze sobą zgodne, chyba że wcześniej oceniono ryzyko, a zespoły rozumieją wzajemne założenia.
Gdy programiści mogą zdecydować się na wdrożenie niekompletnego produktu i zajęcie się nim później, koszt tego wpływu prowadzi do powstania długu technicznego. Wdrożenie DevOps może ujednolicić cele i strategie obu zespołów, a także pomóc programistom zrozumieć wpływ kosztowy ich decyzji technicznych.
To tylko niewielka część DevOps i znaczenia wspólnych wskaźników.
5 kluczowych wskaźników DevOps (DORA)
Wdrożenie DevOps i zrozumienie struktur opartych na zasadach to jedno, ale to właśnie wskaźniki DevOps pozwalają naprawdę dostrzec korzyści płynące z tego opartego na współpracy podejścia do cyklu życia oprogramowania. Podobnie jak w przypadku większości strategii biznesowych, istnieje nieskończenie wiele wskaźników, które można wybrać do pomiaru wzrostu, w zależności od branży, odbiorców i celów.
Zespół Google Cloud ds. badań i oceny DevOps (DORA) jest najdłużej działającym zespołem badawczym tego typu. Początkowo zidentyfikował cztery kluczowe wskaźniki do pomiaru wydajności „elitarnych” zespołów DevOps. Od tego czasu do zestawu dodano piąty kluczowy wskaźnik, a analiza skupień rozpoznaje obecnie tylko trzy poziomy zespołów DevOps: wysoki, średni i niski, przy czym poziom „elitarny” należy już do przeszłości.
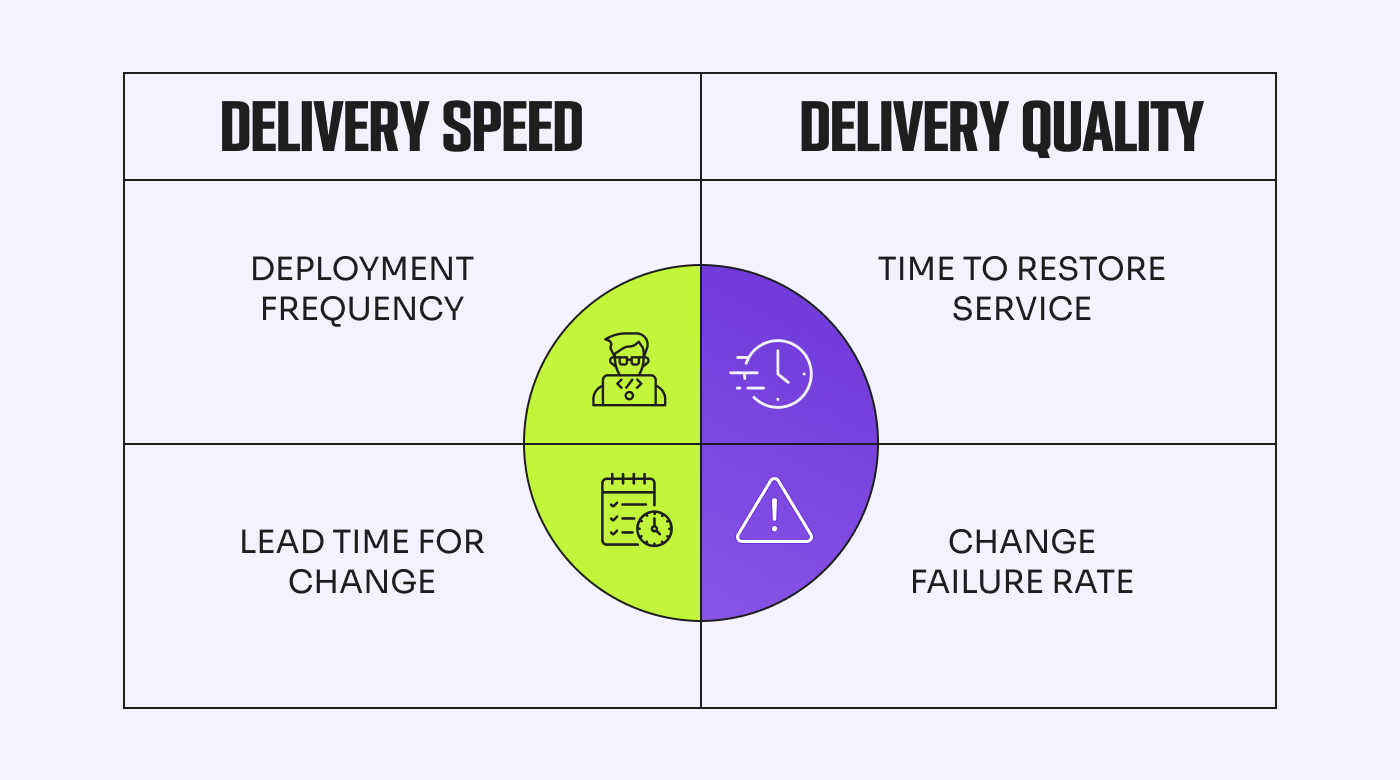
1. Częstotliwość wdrożeń (DF)
DF mierzy, jak często pomyślnie wdrażasz zmiany na produkcji. Ten wskaźnik dotyczy spójności i jest doskonałym wyznacznikiem realizacji celów.
Zespoły zaliczane do kategorii „elitarnej” konsekwentnie wdrażały zmiany na produkcji kilka razy dziennie, podczas gdy zespoły osiągające słabe wyniki robiły to mniej więcej raz na sześć miesięcy.
Poprawa DF jest tak prosta, jak wydawanie kilku mniejszych aktualizacji. Główną korzyścią takiego podejścia jest wskazanie wszelkich blokad procesowych, wąskich gardeł lub złożonych projektów wymagających uwagi. Większe zespoły mogą preferować wdrażanie w regularnych odstępach poprzez tworzenie pociągów wydań Agile; pomoże to ograniczyć przeciążenie wynikające z ekstremalnego tempa i dużej liczby osób.
2. Czas realizacji zmian (LTC)
LTC oznacza czas potrzebny na wprowadzenie zatwierdzonej zmiany na produkcję. Ten wskaźnik dobrze pokazuje responsywność i elastyczność zespołu, ponieważ mierzy, jak szybko może on reagować na potrzeby i wymagania użytkowników.
Dawny standard „elitarny” zakładał, że LTC powinien wynosić mniej niż jeden dzień, podczas gdy zespoły osiągające słabsze wyniki mogły potrzebować ponad sześciu miesięcy. Wyniki z dolnego końca skali LTC prawdopodobnie wynikają z nieefektywnych procesów.
Możesz poprawić ten wskaźnik, usprawniając procesy automatyzacji, zwłaszcza testowanie. Udoskonalając swój potok ciągłej integracji i ciągłego dostarczania (CI/CD), możesz szybciej przekazywać aktualizacje na produkcję. Należy jednak zwrócić uwagę na jedno ryzyko: zrównoważony rozwój. Jeśli Twój zespół nie będzie w stanie utrzymać zwiększonego tempa, możesz napotkać problemy z doświadczeniem użytkownika oraz potencjalne luki w zabezpieczeniach.
3. Wskaźnik nieudanych zmian (CFR)
CFR to odsetek wdrożeń powodujących awarię w środowisku produkcyjnym. Awarią może być przestój, wycofanie zmian lub pogorszenie jakości usługi. Ta metryka pokazuje skuteczność zespołu podczas wdrażania zmian.
Elitarne wyniki referencyjne wynoszą 0–15%, natomiast wysoka wydajność mieści się w przedziale 16–30%.
Poprawa CFR polega na stawianiu jakości ponad ilość. Firmy wdrażają różne liczby zmian, a zatem doświadczają różnej liczby awarii. Jednak modyfikacje najwyższej jakości skutkują mniejszą liczbą awarii, niezależnie od tego, czy zmiany są wdrażane dwa razy w roku, czy dwa razy dziennie.
4. Średni czas przywracania działania (MTTR)
MTTR to czas potrzebny zespołowi na przywrócenie działania usługi po awarii lub zakłóceniu. Ta metryka nie tylko mierzy zwinność zespołu, ale także dobrze wskazuje stabilność oprogramowania.
Jeśli dążysz do poziomu „elitarnego”, MTTR powinien wynosić mniej niż godzinę. Zespołom o niskiej wydajności przywrócenie działania może zająć ponad sześć miesięcy.
Możesz skrócić MTTR, koncentrując się na niewielkich, szybkich wydaniach, dzięki czemu awarie będą łatwiejsze do znalezienia i usunięcia. Możesz także rozważyć flagi funkcji aby zapewnić zespołowi większą kontrolę — szczególnie w przypadku funkcji eksperymentalnych.
Pozostała jeszcze jedna metryka do omówienia.
5. Niezawodność
Piątą dodatkową metryką jest niezawodność. Metryka ta została później zidentyfikowana przez zespół DORA (w 2021 roku), ponieważ wcześniej dostępność była mierzona jako punkt odniesienia dla niezawodnego oprogramowania. Uznano jednak, że niezawodność lepiej obejmuje dostępność, opóźnienia, wydajność i skalowalność. Zasadniczo oznacza to uwzględnienie pomiaru wydajności operacyjnej obok procesu tworzenia oprogramowania.
Inne popularne metryki DevOps
Have an account? Log In
Czas cyklu
Czas cyklu to całkowity czas od rozpoczęcia zadania do jego ostatecznego dostarczenia. Na pierwszy rzut oka mierzy tempo pracy zespołu. Możesz jednak dokładniej przeanalizować tę metrykę, aby znaleźć wąskie gardła, takie jak długi czas oczekiwania w kolejce i długo trwające żądania scalenia.
Krótszy czas cyklu wskazuje na sprawny przepływ pracy, ogranicza wąskie gardła i zwiększa szybkość tworzenia oprogramowania.
Jak mierzyć czas cyklu
Czas cyklu oblicza się, śledząc znaczniki czasu zatwierdzeń, scalania kodu i wdrożeń w narzędziach takich jak GitHub, GitLab lub Jenkins.
Czas cyklu = czas wdrożenia − czas zatwierdzenia
Aby poprawić czas cyklu, zespoły powinny:
- Optymalizować potoki CI/CD pod kątem szybszej integracji i wdrażania.
- Automatyzować kompilowanie i testowanie.
- Usprawniać współpracę między zespołami programistycznymi i operacyjnymi.
- Ograniczać zależności między zadaniami, aby minimalizować wąskie gardła.
Średni czas wykrycia (MTTD)
Jest to średni czas potrzebny zespołowi na potwierdzenie wystąpienia awarii. Niska wartość MTTD wskazuje na wydajne systemy monitorowania i alertowania, umożliwiające szybką reakcję na incydenty i ich rozwiązanie.
Jak mierzyć MTTD
MTTD można mierzyć, śledząc średni czas między wystąpieniem problemu a jego wykryciem przez narzędzia monitorujące lub zgłoszeniem przez użytkowników. Obniżenie MTTD wymaga usprawnienia automatycznego monitorowania, udoskonalenia mechanizmów alertów oraz zapewnienia proaktywnego wykrywania problemów.
Pomyślnie zakończone testy automatyczne
Warto dążyć do dobrego pokrycia testami, zwłaszcza testami automatycznymi. Mam tu na myśli testy jednostkowe, integracyjne, interfejsu użytkownika oraz kompleksowe. Dobre pokrycie nie wystarczy jednak do zapewnienia jakości oprogramowania. Liczy się odsetek tych testów, które kończą się pomyślnie.
Oczywiście celem jest osiągnięcie odsetka pomyślnie zakończonych testów możliwie bliskiego 100%. Monitorowanie tej metryki może również ujawnić, jak często nowe zmiany powodują niepowodzenie istniejących testów.
Jak mierzyć odsetek pomyślnie zakończonych testów automatycznych
Obliczenie jest proste: pomnóż liczbę pomyślnie zakończonych testów przez 100, a następnie podziel wynik przez całkowitą liczbę testów. Informacje te możesz uzyskać z narzędzia do obsługi potoków, które uruchamia kompilacje (Jenkins, Azure DevOps, CircleCI itd.).
Liczba ta może być dobrym wskaźnikiem jakości produktu. Może jednak również wprowadzać w błąd, jeśli testy są niestabilne lub niewiarygodne.
Wskaźnik błędów, które przedostały się do produkcji
Wskaźnik błędów, które przedostały się do produkcji, określa liczbę błędów pominiętych podczas testowania i wprowadzonych do środowiska produkcyjnego — czyli takich, które „uciekły”. Wskaźnik ten doskonale nadaje się do monitorowania, jeśli chcesz usprawnić procesy testowania i automatyzacji.
W idealnym świecie wszystkie nasze aplikacje byłyby wolne od błędów. Rzadko jednak tak się zdarza. W idealnej sytuacji błędy są wykrywane podczas faz rozwoju i testowania procesu DevOps, a nie w środowisku produkcyjnym.
Wskaźnik ten pomaga określić skuteczność procesów testowania oraz ogólną jakość programu. Wysoki wskaźnik błędów, które przedostały się do produkcji, sugeruje konieczność usprawnienia procedur i zastosowania większej automatyzacji, natomiast niski wskaźnik (najlepiej bliski zeru) wskazuje na wysoką jakość aplikacji.
Jak mierzyć wskaźnik błędów, które przedostały się do produkcji
Aby go zmierzyć, możesz użyć narzędzia do śledzenia błędów i dla każdego otwartego błędu monitorować, gdzie został wykryty — w środowisku testowym czy produkcyjnym (lub w dowolnym innym środowisku, którego używasz, takim jak UAT).
Zgłoszenia klientów
Zadowolenie klientów jest czynnikiem napędzającym innowacje i nie bez powodu: bezproblemowe doświadczenia użytkownika są oznaką dobrej obsługi klienta i zazwyczaj przekładają się na wzrost sprzedaży. W rezultacie zgłoszenia klientów, zwłaszcza podczas procesu eskalacji zgłoszeń, są dobrym wskaźnikiem tego, jak przebiega transformacja DevOps.
Klienci nie powinni pełnić funkcji kontroli jakości, zgłaszając wady i błędy. Dlatego spadek liczby zgłoszeń klientów jest dobrym sygnałem wskazującym na prawidłowe działanie aplikacji.
Wykorzystanie procesora i pamięci
Identyfikuje trendy wykorzystania zasobów.
Czas odpowiedzi
Mierzy czas potrzebny aplikacji na odpowiedź na żądania.
Wskaźnik błędów
Śledzi liczbę nieudanych żądań w czasie.
Przepustowość
Mierzy liczbę żądań przetwarzanych na sekundę.
Opóźnienie żądań API
Mierzy opóźnienie między wysłaniem żądania a otrzymaniem odpowiedzi.
Wydajność zapytań do bazy danych
Śledzi czas wykonywania zapytań i potencjalne wąskie gardła.
Analityka zachowań użytkowników
Monitoruje trendy dotyczące korzystania z funkcji i zaangażowania.
Średni czas między awariami (MTBF)
MTBF mierzy średni czas, jaki upływa między awariami systemu, przestojami lub incydentami. Wskaźnik ten ocenia niezawodność i stabilność systemów oprogramowania, wskazując skuteczność strategii konserwacji zapobiegawczej i ograniczania skutków błędów.
Czas ograniczenia skutków (TTM)
Czas potrzebny na usunięcie problemu po jego wykryciu to TTM. Wskaźnik ten pomaga ocenić procesy reagowania na incydenty i ich rozwiązywania, wskazując efektywność zespołów w zakresie rozwiązywania problemów i przywracania sprawności po ich wystąpieniu.
Czas realizacji zmiany (CLT)
CLT stanowi punkt odniesienia dla kompleksowego procesu wdrażania zmian, obejmującego tworzenie, testowanie, przegląd i wdrażanie. Krótszy CLT oznacza szybsze cykle dostarczania i większą elastyczność.
Jak ustalać KPI za pomocą wskaźników DevOps
Teraz, gdy dobrze rozumiesz wskaźniki, których możesz użyć do wdrożenia i optymalizacji DevOps w swojej firmie, warto poznać kluczowe wskaźniki efektywności (KPI), aby wyznaczyć cele i wartości referencyjne dla swojego zespołu.
Wskaźniki a KPI
Być może zastanawiasz się, jaka jest różnica między wskaźnikami a KPI. Wskaźnik to to, co mierzysz. Jest to mierzalna wartość dostarczająca danych na temat określonego aspektu wydajności. Nie wszystkie wskaźniki muszą być powiązane z konkretnymi celami lub wartościami docelowymi.
Z kolei KPI to rodzaj wskaźnika strategicznie wybranego i zdefiniowanego w celu odzwierciedlenia najważniejszych aspektów wydajności i postępów w realizacji celów strategicznych. KPI są zazwyczaj powiązane z celami i często mają przypisane wartości docelowe, progi lub wartości referencyjne, które należy osiągnąć.
Ustalanie KPI dla zespołu DevOps
Pierwszym krokiem do ustalenia KPI dla zespołu DevOps jest powiązanie metryk DevOps ze strategią i celami biznesowymi. Ustalając priorytety najważniejszych metryk do śledzenia, możesz zacząć wyznaczać cele i punkty odniesienia na potrzeby ciągłego doskonalenia. Wybór odpowiednich metryk wymaga uwzględnienia wielkości firmy, produktu i rynku. Skoncentruj się na tym, co dostarczy najbardziej praktycznych informacji, unikając typowego problemu przeciążenia metrykami.
Monitorowanie KPI jest równie ważne jak ich ustalanie. Poznaj narzędzia do wizualizacji danych , aby zapewnić zespołowi dane w czasie rzeczywistym na intuicyjnych pulpitach. Gwarantuje to pełną widoczność, zapewnia odpowiedzialność i pozwala wszystkim wspólnie pracować nad celami, dopasowując zespoły programistyczne i operacyjne oraz wspierając wdrażanie i dojrzewanie DevOps.

Analizując podstawowe metryki DORA, możemy zobaczyć wartości referencyjne dla każdej metryki w przypadku zespołów o najwyższej, wysokiej, średniej i niskiej wydajności. Ta tabela może pomóc w ustaleniu KPI dla własnej firmy, zależnie od tego, co uznasz za priorytet.
Podczas ustalania KPI najlepiej dokładnie przeanalizować swój zespół i firmę, bez porównywania ich z innymi przedsiębiorstwami. Weźmy CFR jako przykład: wartość referencyjna jest taka sama dla wysokiej, średniej i niskiej wydajności. Będzie to w dużej mierze zależeć od częstotliwości wdrożeń, ale może również działać w odwrotnym kierunku. Jeśli zespół poświęca cały swój czas na naprawianie błędów, ma mniej czasu na opracowywanie i wydawanie aktualizacji. KPI mogą również zmieniać się wraz z dojrzewaniem zespołu DevOps. Niezawodne procesy automatyzacji i testowania powinny automatycznie oznaczać możliwość podniesienia poprzeczki w zakresie wyznaczonych celów.
More Articles
Jak wykorzystywać metryki DevOps do skalowania
Przy prognozie, że globalny rynek DevOps osiągnie 24,71 miliarda do 2027 roku (złożona roczna stopa wzrostu wynosząca 22,9%, na podstawie wartości rynku na poziomie 10,84 miliarda dolarów w 2023 roku), potraktuj to jako sygnał, jeśli zastanawiasz się, kiedy najlepiej rozpocząć wdrażanie DevOps w swojej firmie.
DevOps nie tylko przyspiesza rozwój, skracając czas wprowadzenia produktu na rynek, ale także usprawnia współpracę poprzez eliminowanie silosów, podnosi jakość dzięki ciągłemu testowaniu i pętlom informacji zwrotnych oraz efektywnie wykorzystuje zasoby, co pozwala oszczędzać pieniądze. Wreszcie łatwo go skalować, co wspiera rozwój firmy i pozwala przekraczać nowe granice, a 83% osób decyzyjnych w branży IT uzyskało większą wartość biznesową dzięki wdrożeniu DevOps w 2021 roku.
Pomiar wydajności i ciągłe doskonalenie
Monitorowanie wydajności jest kluczem do skalowania firmy korzystającej z DevOps. To podejście realizowane w szybkim tempie, ze stałym przepływem produkcji, dlatego pomiary i raportowanie powinny odbywać się równie często. Metryki DevOps pozwalają śledzić wydajność procesów programistycznych i procesów dostarczania. Kwantyfikując kluczowe aspekty, takie jak częstotliwość wdrożeń, czas realizacji i wskaźnik nieudanych zmian, możesz identyfikować wąskie gardła, nieefektywności i obszary wymagające poprawy. Umożliwia to częstą optymalizację przepływów pracy i procesów.
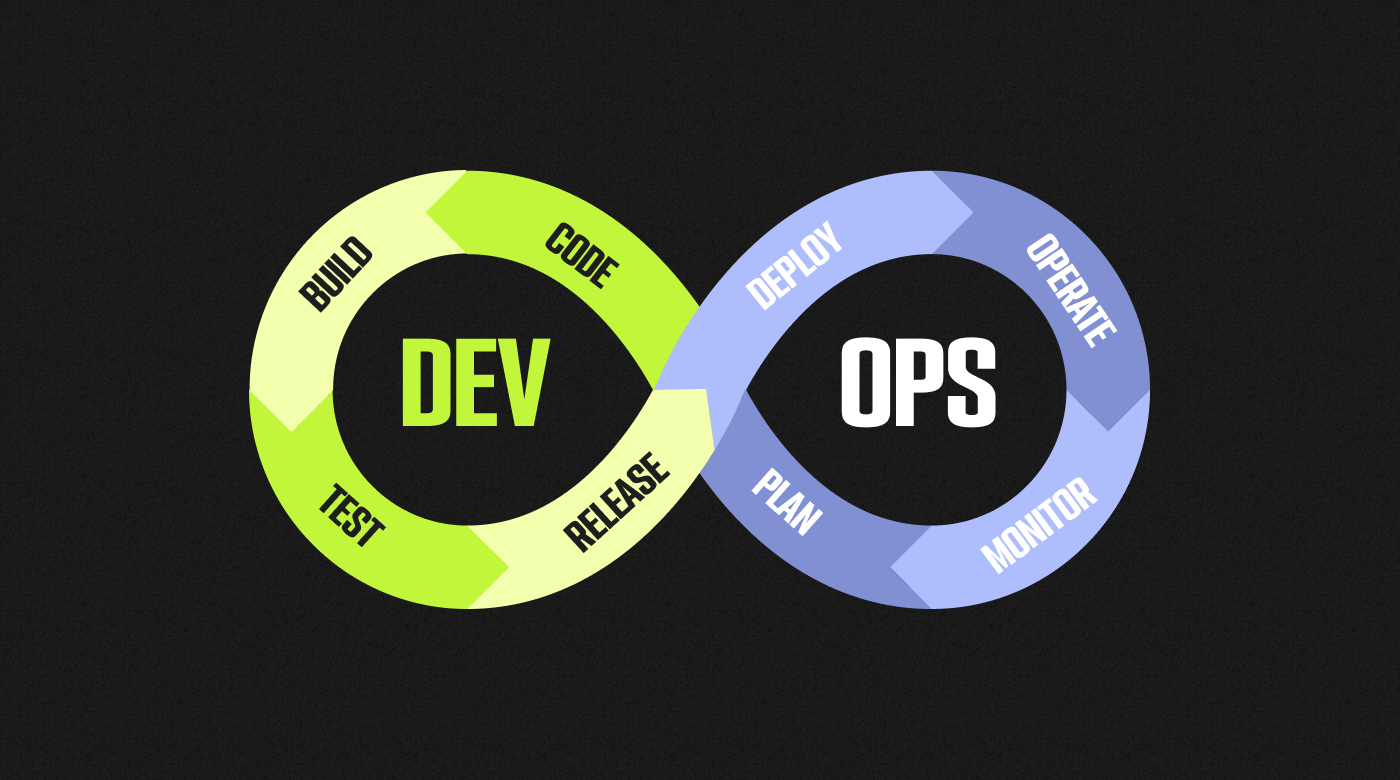
Śledzenie metryk, takich jak wskaźnik nieudanych zmian i średni czas przywrócenia działania, pomaga identyfikować trendy umożliwiające wczesne wykrywanie problemów. Takie proaktywne podejście oznacza możliwość podjęcia działań naprawczych i zminimalizowania wpływu na klientów, zapewniając niezawodność — kolejny istotny składnik skalowania przy zachowaniu wysokiej jakości.
Wreszcie korzystanie z metryk DevOps pomoże zespołowi DevOps osiągnąć większą dojrzałość poprzez budowanie kultury ciągłego doskonalenia. Pętle informacji zwrotnych wspierają naukę i rozwój; zawsze musi istnieć przestrzeń do eksperymentowania z różnymi podejściami.
Które metryki DevOps wspierają rozwój firmy?
Podczas ustalania KPI większość metryk należy rozpatrywać w kontekście własnego zespołu i ukierunkowywać na rozwój, zamiast porównywać je z innymi firmami i grupami znajdującymi się na różnych poziomach dojrzałości.
Na przykład niski LTC może wskazywać, że zespół jest efektywny, ale jeśli nie jest w stanie utrzymać tempa, nie jest ono zrównoważone i ostatecznie może wpłynąć na doświadczenia użytkowników. Tę metrykę należy mierzyć w czasie, zamiast ustalać KPI odpowiadające wynikom dojrzałego zespołu DevOps o wysokiej, a nawet najwyższej wydajności. Ustalanie KPI mających na celu zmniejszanie LTC z miesiąca na miesiąc, w ujęciu kwartalnym lub rocznym pokazuje rozwój zespołu i firmy.
CFR jest wartościowym wskaźnikiem, ponieważ nie każdy ma taką samą liczbę awarii lub problemów, ale przypisanie temu wartości procentowej pozwala zmierzyć skuteczność wdrożeń. Twój zespół może mieć bardzo niewiele awarii, jeśli rzadko wdraża zmiany, ale jeśli każde wdrożenie powoduje problem, CFR będzie bardzo wysoki. Jeśli stosujesz praktyki CI/CD, możesz zaobserwować większą liczbę awarii, ale jeśli CFR jest niski, zyskujesz przewagę, ponieważ szybkość i jakość wspierają rozwój. MTTR również należy mierzyć w czasie, aby zapewnić stały rozwój.
DORA ustaliła, że zespoły o każdym poziomie wydajności deweloperskiej osiągały lepsze wyniki, koncentrując się na wydajności operacyjnej. Może to oznaczać ustalenie wskaźników KPI dla raportów dotyczących incydentów lub otwartych zgłoszeń, czasu działania aplikacji i dostępności.
Duża liczba otwartych zgłoszeń może wskazywać na problem z satysfakcją klientów, ale dążenie do jej zmniejszania w czasie odzwierciedla rozwój w tym obszarze. Możesz przeanalizować ten aspekt dokładniej i mierzyć czas reakcji oraz oczekiwania w kolejce, aby przyspieszyć poprawę tego wskaźnika.
Jedynym wskaźnikiem, który w pełni łączy rozwój i operacje w ramach zespołu DevOps, jest czas cyklu. Otwiera to możliwość budowania kultury informacji zwrotnej i rozwoju. W miarę poprawy innych wskaźników i dojrzewania automatyzacji należy oczekiwać skrócenia czasu cyklu. Jeśli obsługa klienta stoi na wysokim poziomie, a liczba awarii w procesie rozwoju jest niska, oznacza to zwycięską kombinację umożliwiającą skalowanie firmy.
Końcowe przemyślenia
Podobnie jak każda inna metodologia, DevOps odnosi sukces tylko wtedy, gdy zostanie prawidłowo wdrożony. Nie można jednak ocenić skuteczności, dopóki nie wiadomo, jak korzystać ze wskaźników DevOps.
Oczywiście wdrażanie wskaźników DevOps wiąże się z pewnymi wyzwaniami. Wymaga strategicznego podejścia, kultury współpracy i zaangażowania w ciągłe doskonalenie. Rezultatem są jednak zoptymalizowane przepływy pracy i procesy, na których można zbudować solidne podstawy skalowania firmy.
Jeśli chcesz być na bieżąco z wiadomościami i artykułami, zapisz się do naszego biuletynu!

