

Witajcie w kolejnym rozdziale serii Leadership In Test. W tym tygodniu przyjrzymy się testowaniu usług dla aplikacji internetowych. Omówimy:
- Czym jest testowanie usług?
- Czym jest testowanie wydajności?
- Testowanie niezawodności i przełączania awaryjnego
- Testowanie zarządzania usługami
Zacznijmy.
Czym jest testowanie usług?
Jakość usług zapewnianych przez aplikację internetową można zdefiniować jako obejmującą wszystkie jej atrybuty, takie jak funkcjonalność, wydajność, niezawodność, użyteczność, bezpieczeństwo i tak dalej.
Na potrzeby tego artykułu wyodrębniamy jednak trzy konkretne cele usług, które podlegają analizie w ramach tego, co nazywamy „testowaniem usług”. Cele te to:
- Wydajność: usługa musi szybko reagować na działania użytkowników, obsługując jednocześnie nakładane na nią obciążenia.
- Niezawodność: jeśli została zaprojektowana tak, aby była odporna na awarie, usługa musi być niezawodna i/lub nadal świadczyć usługi nawet w przypadku wystąpienia awarii.
- Zarządzalność: usługa musi umożliwiać zarządzanie, konfigurowanie lub modyfikowanie bez zauważalnego dla użytkowników końcowych pogorszenia jakości działania. Zarządzalność, czyli testowanie operacyjne, ma na celu wykazanie, że procedury administracji systemem, zarządzania nim oraz tworzenia kopii zapasowych i odzyskiwania danych działają skutecznie.
We wszystkich trzech przypadkach musimy zasymulować obciążenie generowane przez użytkowników, aby skutecznie przeprowadzić testy. Cele związane z wydajnością, niezawodnością i zarządzalnością istnieją w kontekście rzeczywistych klientów korzystających z witryny w celach biznesowych.
Responsywność witryny (w tym przypadku czas potrzebny jednemu węzłowi systemu na odpowiedź na żądanie innego węzła) jest bezpośrednio związana z zasobami dostępnymi w ramach architektury technicznej.
Im więcej klientów korzysta z usługi, tym mniej zasobów technicznych jest dostępnych do obsługi żądań każdego użytkownika, a czasy odpowiedzi ulegają pogorszeniu.
Oczywiście usługa o niewielkim obciążeniu jest mniej podatna na awarie. Znaczna część złożoności oprogramowania i sprzętu wynika z konieczności zaspokojenia zapotrzebowania na zasoby w architekturze technicznej, gdy witryna jest mocno obciążona.
Gdy witryna jest obciążona (lub przeciążona), sprzeczne żądania dotyczące zasobów muszą być obsługiwane przez różne komponenty infrastruktury, takie jak systemy operacyjne serwerów i sieci, systemy zarządzania bazami danych, produkty serwerów internetowych, pośrednicy żądań obiektowych, oprogramowanie pośredniczące i inne.
Te komponenty infrastruktury są zwykle bardziej niezawodne niż niestandardowy kod aplikacji, który żąda zasobów, ale awarie mogą wystąpić w obu przypadkach:
- Komponenty infrastruktury ulegają awarii, ponieważ kod aplikacji (w wyniku niewłaściwego projektu lub implementacji) nakłada nadmierne wymagania na zasoby.
- Komponenty aplikacji mogą ulec awarii, ponieważ wymagane przez nie zasoby nie zawsze są dostępne (na czas).
Symulując typowe i nietypowe obciążenia produkcyjne przez dłuższy czas, testerzy mogą ujawnić wady projektu lub implementacji systemu. Po usunięciu tych wad te same testy wykażą, że system jest odporny. Zespoły QA mogą korzystać z narzędzi do testowania obciążenia, aby wykonywać wiele z opisanych poniżej procesów.
W przypadku wszystkich usług zwykle istnieje szereg krytycznych procesów zarządzania, które należy wykonywać, aby usługa działała sprawnie. Możliwe, że w celu przeprowadzenia rutynowej konserwacji da się wyłączyć usługę poza normalnymi godzinami pracy, jednak większość usług internetowych działa przez całą dobę.
Dzień roboczy usługi nigdy się nie kończy. Procedury zarządzania muszą być nieuchronnie wykonywane wtedy, gdy usługa działa, a użytkownicy są zalogowani do systemu. Procedury te należy testować przy obciążonym systemie, aby upewnić się, że nie wpływają negatywnie na działanie aktywnej usługi — czyli przeprowadzać testowanie wydajności.
Have an account? Log In
Czym są testy wydajności?
Testowanie wydajności jest kluczowym elementem testowania usług. Polega na sprawdzaniu, jak system działa pod względem responsywności i stabilności przy określonym obciążeniu. Oto przegląd tego procesu:
- Testowanie wydajności obejmuje szereg testów przy różnym obciążeniu, podczas których system osiąga stan ustalony (obciążenie i czasy odpowiedzi utrzymują się na stałym poziomie).
- Mierzymy obciążenie i czasy odpowiedzi dla każdego poziomu obciążenia symulowanego przez 15-30 minut, aby uzyskać statystycznie istotną liczbę pomiarów.
- Monitorujemy i rejestrujemy kluczowe parametry dla każdego symulowanego obciążenia. Są to różne zasoby naszego systemu, np. użycie procesora i pamięci, przepustowość sieci, szybkości operacji wejścia/wyjścia itd.
Tworzymy wykres przedstawiający różne poziomy obciążenia w odniesieniu do czasów odpowiedzi doświadczanych przez naszych „wirtualnych” użytkowników. Po naniesieniu danych wykres wygląda mniej więcej tak jak na poniższej ilustracji.
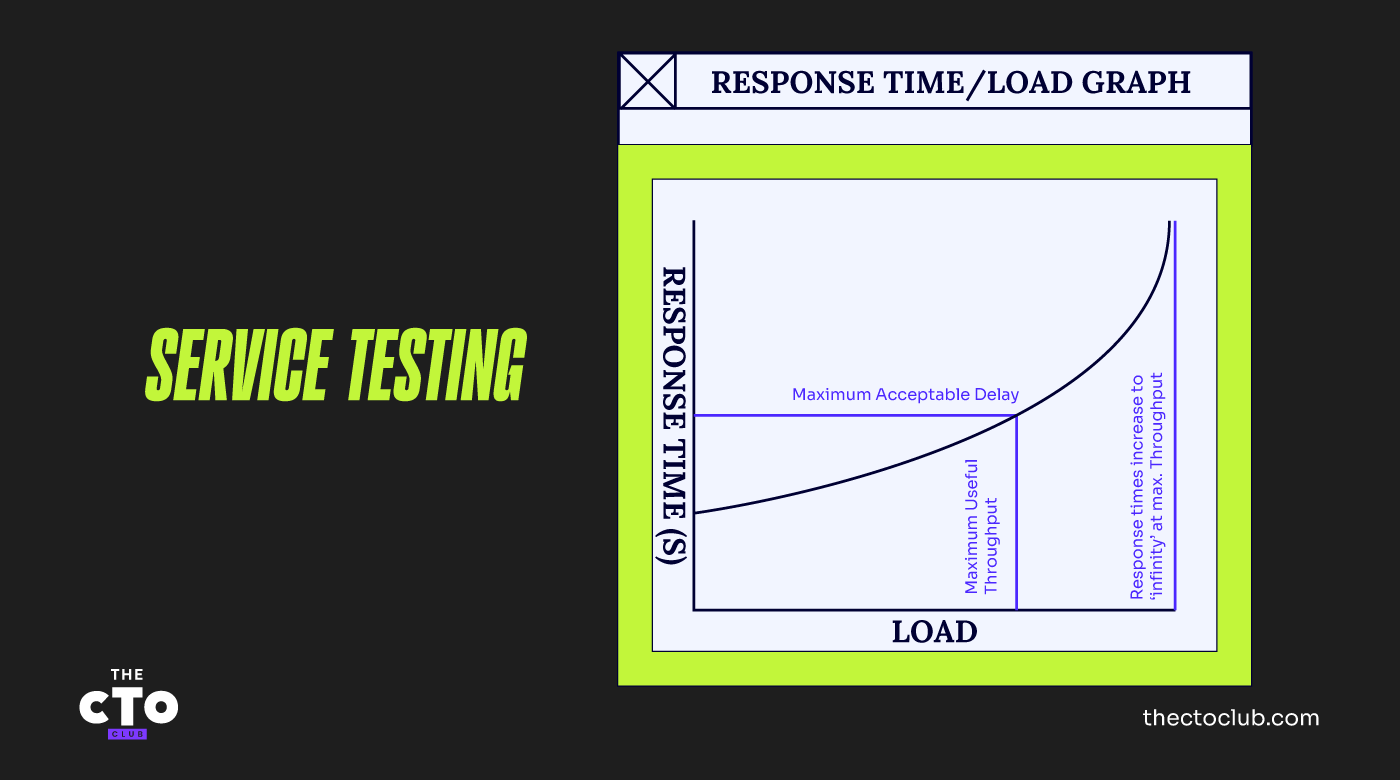
Przy zerowym obciążeniu, gdy w systemie znajduje się tylko jeden użytkownik, ma on do dyspozycji cały zasób, a czasy odpowiedzi są krótkie. W miarę zwiększania obciążenia i mierzenia czasów odpowiedzi ulegają one stopniowemu pogorszeniu, aż system osiągnie maksymalną wydajność.
W tym momencie czas odpowiedzi dla naszych transakcji testowych jest teoretycznie nieskończony, ponieważ jeden z kluczowych zasobów systemu został całkowicie wykorzystany i nie można przetwarzać kolejnych transakcji.
W miarę zwiększania obciążenia od zera do wartości maksymalnej monitorujemy również użycie różnych typów zasobów, np. użycie procesora serwera, pamięci, przepustowość sieci, blokady bazy danych itd.
Przy maksymalnym obciążeniu jeden z tych zasobów jest wykorzystywany w 100%. Jest to zasób ograniczający, ponieważ wyczerpuje się jako pierwszy. Oczywiście w tym momencie czasy odpowiedzi pogorszyły się do poziomu, przy którym są prawdopodobnie znacznie dłuższe, niż byłoby to akceptowalne.
Poniższy wykres przedstawia wykorzystanie/dostępność kilku zasobów w odniesieniu do obciążenia.
Aby zwiększyć przepustowość i/lub skrócić czasy odpowiedzi systemu, musimy wykonać jedną z następujących czynności:
- Zmniejszyć zapotrzebowanie na zasób, zazwyczaj poprzez zwiększenie wydajności oprogramowania korzystającego z tego zasobu (jest to zwykle zadanie zespołu programistycznego).
- Zoptymalizować wykorzystanie zasobu sprzętowego w ramach architektury technicznej, na przykład konfigurując DBMS tak, aby buforował więcej danych w pamięci, lub nadając niektórym procesom wyższy priorytet niż innym na serwerze aplikacji.
- Udostępnić większą ilość zasobu. Zwykle poprzez dodanie procesorów, pamięci lub przepustowości sieci itd.
Jak zapewne już zauważasz, testowanie wydajności wymaga zaangażowania zespołu osób wspierających testerów. Są to architekci techniczni, administratorzy serwerów, administratorzy sieci, programiści oraz projektanci i administratorzy baz danych. Ci eksperci techniczni mają kwalifikacje do analizowania statystyk generowanych przez narzędzia do monitorowania zasobów oraz oceny, jak najlepiej dostosować aplikację, dostroić system lub przeprowadzić jego modernizację.
Jeśli jesteś testerem, a nie jesteś samodzielnie szczególnym ekspertem w tych dziedzinach, nie ulegaj pokusie udawania, że potrafisz interpretować te statystyki oraz podejmować decyzje dotyczące dostrajania i optymalizacji. Musisz zaangażować tych ekspertów na wczesnym etapie projektu, aby uzyskać ich porady i poparcie, a następnie podczas testów, aby zapewnić identyfikację i usunięcie wąskich gardeł.
Wypatruj kolejnego artykułu, w którym dokładniej omówimy zarządzanie testowaniem wydajności.
Testowanie niezawodności/przełączania awaryjnego
Zapewnienie ciągłej dostępności usługi jest prawdopodobnie jednym z kluczowych celów Twojego projektu. Testowanie niezawodności pomaga ujawnić trudne do wykrycia usterki powodujące nieoczekiwane awarie. Testowanie przełączania awaryjnego pomaga upewnić się, że wbudowane mechanizmy przełączania awaryjnego dla przewidywanych awarii rzeczywiście działają.
Testowanie przełączania awaryjnego
W przypadku witryn, od których wymaga się odporności i/lub niezawodności, są one zazwyczaj projektowane z użyciem niezawodnych komponentów systemu, wyposażonych we wbudowaną nadmiarowość i funkcje przełączania awaryjnego uruchamiane w razie wystąpienia awarii.
Funkcje te mogą obejmować zróżnicowane trasowanie sieci, wiele serwerów skonfigurowanych w klastry, technologie oprogramowania pośredniczącego i usług rozproszonych obsługujące równoważenie obciążenia oraz przekierowywanie ruchu w przypadku awarii.
Celem testowania przełączania awaryjnego jest zbadanie zachowania systemu w wybranych scenariuszach awarii przed wdrożeniem. Zwykle obejmuje ono następujące czynności:
- Identyfikacja komponentów, które mogą ulec awarii i spowodować utratę usługi (analiza awarii od wewnątrz na zewnątrz).
- Identyfikacja zagrożeń, które mogą spowodować awarię i utratę usługi (analiza zagrożeń od zewnątrz do wewnątrz).
- Analiza trybów awarii lub scenariuszy, które mogą wystąpić, w przypadku których potrzebna jest pewność, że środek naprawczy zadziała.
- Automatyczny test, którego można użyć do obciążenia systemu i zbadania jego zachowania przez dłuższy czas.
- Ten sam automatyczny test można również wykorzystać do obciążenia testowanego systemu i monitorowania jego zachowania w warunkach awarii.
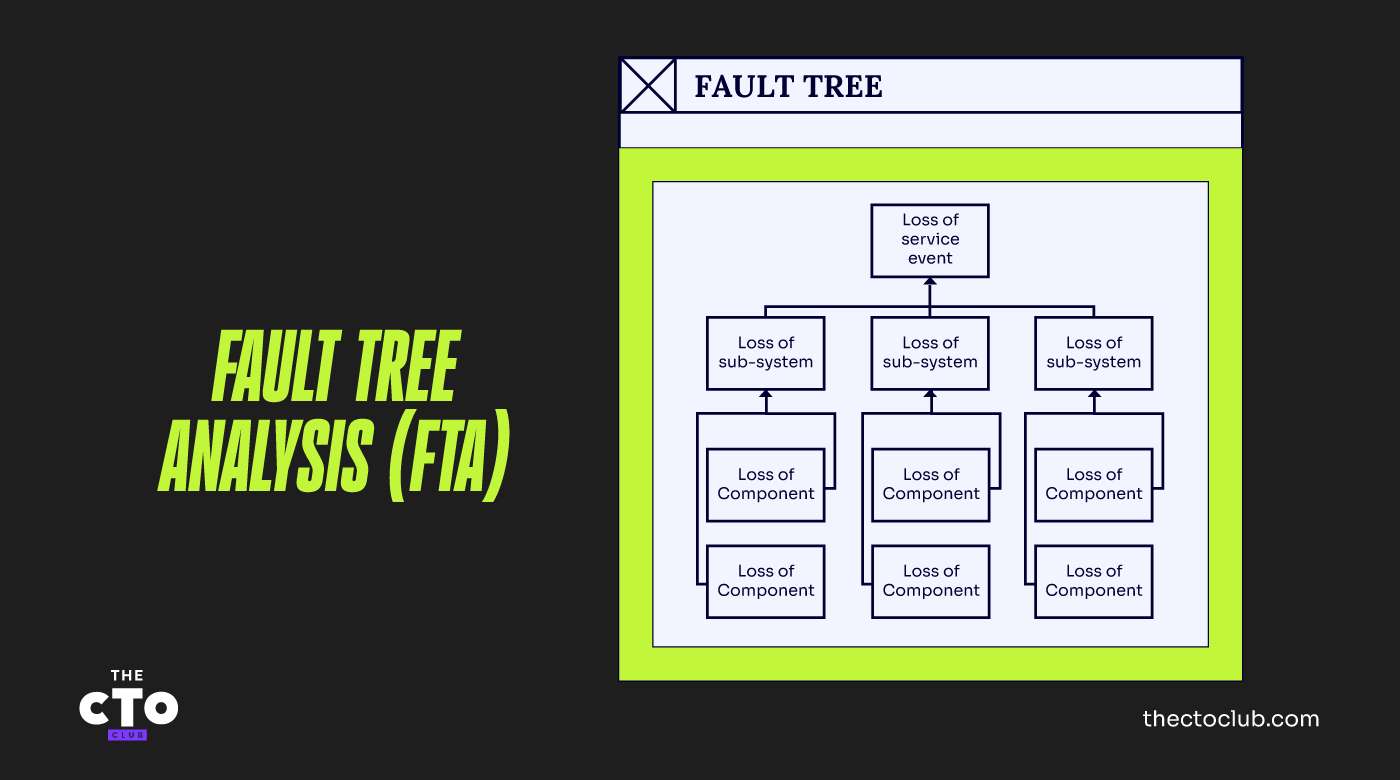
Technika zwana analizą drzewa błędów (FTA) może pomóc w zrozumieniu zależności usługi od jej podstawowych komponentów. Analiza drzewa błędów i diagramy drzewa błędów stanowią logiczne odwzorowanie systemu lub usługi oraz sposobów, w jakie może ona ulec awarii.
Prosty schemat poniżej pokazuje zależność między podstawowymi zdarzeniami awarii komponentów, pośrednimi zdarzeniami awarii podsystemów oraz zdarzeniem awarii usługi znajdującym się na najwyższym poziomie. Oczywiście możliwe jest zidentyfikowanie więcej niż trzech poziomów zdarzeń awarii.
Testy te należy przeprowadzać z użyciem automatycznego obciążenia, aby zbadać zachowanie systemu w warunkach produkcyjnych i uzyskać pewność, że zaprojektowane środki naprawcze zadziałają. W szczególności należy sprawdzić:
- Jak architektura zachowuje się w sytuacjach awaryjnych?
- Czy mechanizmy równoważenia obciążenia działają prawidłowo?
- Czy funkcje przełączania awaryjnego przejmują obciążenie w przypadku awarii komponentu?
- Czy automatyczne odzyskiwanie działa? Czy ponownie uruchomione systemy „nadążają”?
Ostatecznie testy koncentrują się na ustaleniu, czy usługa dla użytkowników końcowych jest utrzymywana oraz czy użytkownicy faktycznie zauważają wystąpienie awarii.
Testowanie niezawodności (lub testowanie długotrwałe)
Celem testowania niezawodności jest sprawdzenie, czy pod obciążeniem nie występują awarie.
Większość komponentów sprzętowych jest niezawodna w takim stopniu, że ich średni czas między awariami można mierzyć w latach. Testy niezawodności wymagają użycia (lub ponownego użycia) testów automatycznych na dwa sposoby, aby symulować:
- Ekstremalne obciążenia określonych komponentów lub zasobów w architekturze technicznej.
- Długotrwałe okresy normalnego (lub ekstremalnego) obciążenia całego systemu.
Koncentrując się na konkretnych komponentach, staramy się obciążyć komponent, poddając go nieracjonalnie dużej liczbie żądań wykonania zaprojektowanej dla niego funkcji. Często prościej jest najpierw przeprowadzić testy obciążeniowe krytycznych komponentów w izolacji, przy użyciu dużej liczby prostych żądań, a dopiero potem zastosować znacznie bardziej złożony test do całej infrastruktury. Dostępne są również specjalnie zaprojektowane narzędzia do testów obciążeniowych, które ułatwiają zespołom QA przeprowadzanie tego procesu.
Testy długotrwałe to testy, podczas których system jest poddawany obciążeniu przez dłuższy czas — na przykład 24, 48 godzin lub dłużej — w celu wykrycia (zwykle) nieoczywistych problemów. Nieoczywiste usterki często ujawniają się dopiero po dłuższym okresie użytkowania.
Test automatyczny nie musi być koniecznie zwiększany do ekstremalnych obciążeń (obejmują to testy obciążeniowe). Szczególnie interesuje nas jednak zdolność systemu do nieprzerwanego wykonywania szerokiej gamy transakcji testowych, aby wykryć ewentualne nieoczywiste wycieki pamięci, blokady lub warunki wyścigu.
More Articles
Testowanie zarządzania usługą
Na koniec kilka słów o testowaniu zarządzania usługą.
Po wdrożeniu usługi na produkcji trzeba nią zarządzać. Utrzymanie usługi w działaniu wymaga jej monitorowania, aktualizowania, tworzenia kopii zapasowych oraz szybkiego naprawiania, gdy coś pójdzie nie tak.
Procedury używane przez menedżerów usług do przeprowadzania aktualizacji, tworzenia kopii zapasowych, wydań i przywracania działania po awariach mają kluczowe znaczenie dla zapewnienia niezawodnej usługi, dlatego wymagają testowania, szczególnie jeśli po wdrożeniu usługa będzie szybko się zmieniać.
Problemy, które należy rozwiązać, to:
- Procedury nie przynoszą oczekiwanego efektu.
- Procedury są niewykonalne lub niemożliwe do zastosowania.
- Procedury zakłócają działanie usługi produkcyjnej.
Testy powinny być przeprowadzane, w miarę możliwości, w sposób jak najbardziej realistyczny.
Materiał do przemyślenia
Niektóre systemy są podatne na ekstremalne obciążenia, gdy wystąpi określone zdarzenie. Na przykład firma internetowa spodziewałaby się szczytowego obciążenia tuż po zareklamowaniu ofert w telewizji, a ogólnokrajowy serwis informacyjny może zostać przeciążony, gdy pojawi się ważna wiadomość.
Rozważ system, który dobrze znasz i który został dotknięty nieplanowanymi incydentami w Twojej firmie lub w ogólnokrajowych mediach.
Jakie incydenty lub zdarzenia mogłyby wywołać nadmierne obciążenia w Twoim systemie?
Czy możesz (lub czy mógłbyś) przechwytywać dane z dzienników systemowych, które podają liczbę wykonanych transakcji? Czy możesz ekstrapolować takie zdarzenie, aby przewidzieć zdarzenie krytyczne występujące raz na 100 lat lub raz na 1000 lat?
Jakie środki można zastosować (lub już zastosowano), aby zmniejszyć prawdopodobieństwo wystąpienia szczytów, ich skalę lub całkowicie je wyeliminować?
Zapisz się do biuletynu The QA Lead, aby otrzymywać powiadomienia o publikacji nowych części serii. Te artykuły są fragmentami kursu Leadership In Test Paula, który gorąco polecamy, aby dokładniej zgłębić ten i inne tematy. Jeśli to zrobisz, użyj naszego ekskluzywnego kodu kuponu QALEADOFFER, aby uzyskać zniżkę w wysokości $60 od pełnej ceny kursu!
Polecana lektura: 10 NAJLEPSZYCH NARZĘDZI O OTWARTYM KODZIE ŹRÓDŁOWYM DO ZARZĄDZANIA TESTAMI

