

Databricks to potężne narzędzie, ale nie zawsze jest odpowiednim wyborem. Być może Twój zespół napotkał problemy z cenami, miał trudności z opanowaniem platformy albo potrzebuje większej elastyczności w środowiskach wielochmurowych lub lokalnych. Niezależnie od przyczyny, skoro tu jesteś, prawdopodobnie szukasz alternatywy oferującej podobne funkcje architektury łączącej jezioro danych i hurtownię danych, ale bez związanych z nią kompromisów.
Współpracowałem z zespołami zajmującymi się danymi w startupach i dużych przedsiębiorstwach, oceniając i wdrażając platformy takie jak Databricks, Snowflake i inne. Na własne oczy przekonałem się, czego potrzeba, aby obsługiwać analitykę na dużą skalę, ujednolicać nieuporządkowane źródła danych i tworzyć niezawodne potoki danych, które faktycznie są wykorzystywane.
W tym przewodniku omówię alternatywy dla Databricks, które warto rozważyć — narzędzia pomagające intuicyjniej przechowywać, przekształcać i analizować dane, a jednocześnie zapewniające możliwość skalowania i dostosowywania się do rozwoju zespołu.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza: konkurenci Databricks
Ta tabela porównawcza podsumowuje informacje dotyczące cen wybranych przeze mnie najlepszych konkurentów Databricks.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepsze rozwiązanie do hurtowni danych w chmurze | Nie | Wycena na życzenie | Website | |
| 2 | Najlepsze rozwiązanie do wdrażania danych w wielu chmurach | Dostępny bezpłatny plan | Ceny na żądanie | Website | |
| 3 | Najlepszy do zadań związanych z integracją danych | Dostępna bezpłatna wersja próbna | $1,170/użytkownika/rok (rozliczane rocznie) | Website | |
| 4 | Najlepszy do przetwarzania w pamięci | Dostępny bezpłatny plan | Ceny na żądanie | Website | |
| 5 | Najlepsze do szybkich zapytań SQL | Tak | Od $6.25/TiB przetworzonych danych | Website | |
| 6 | Najlepszy do obsługi potrzeb korporacyjnych baz danych | Dostępna bezpłatna wersja próbna | $68/user/month (rozliczane rocznie) | Website | |
| 7 | Najlepsze rozwiązanie do analityki SQL | 30-dniowy bezpłatny okres próbny | $30/użytkownik/miesiąc (rozliczane rocznie) | Website | |
| 8 | Najlepszy wybór do przetwarzania danych za pomocą Hadoop | Niedostępne | Od $0.007084/vCPU-hour | Website | |
| 9 | Najlepsze rozwiązanie do zarządzanego środowiska Spark i Hadoop | Niedostępne | Od $0.06 za godzinę DCU | Website | |
| 10 | Najlepsze rozwiązanie do zastosowań AI i ML | Dostępna bezpłatna prezentacja | Ceny ustalane na życzenie | Website |


Przegląd najlepszych konkurentów Databricks
Poniżej znajdują się moje szczegółowe podsumowania najlepszych konkurentów Databricks, którzy trafili na moją listę. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety i wady, integracje oraz idealne zastosowania każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Najlepsze rozwiązanie do hurtowni danych w chmurze
- Nie
- Wycena na życzenie
Visit WebsiteCustomer Rating:4.6/5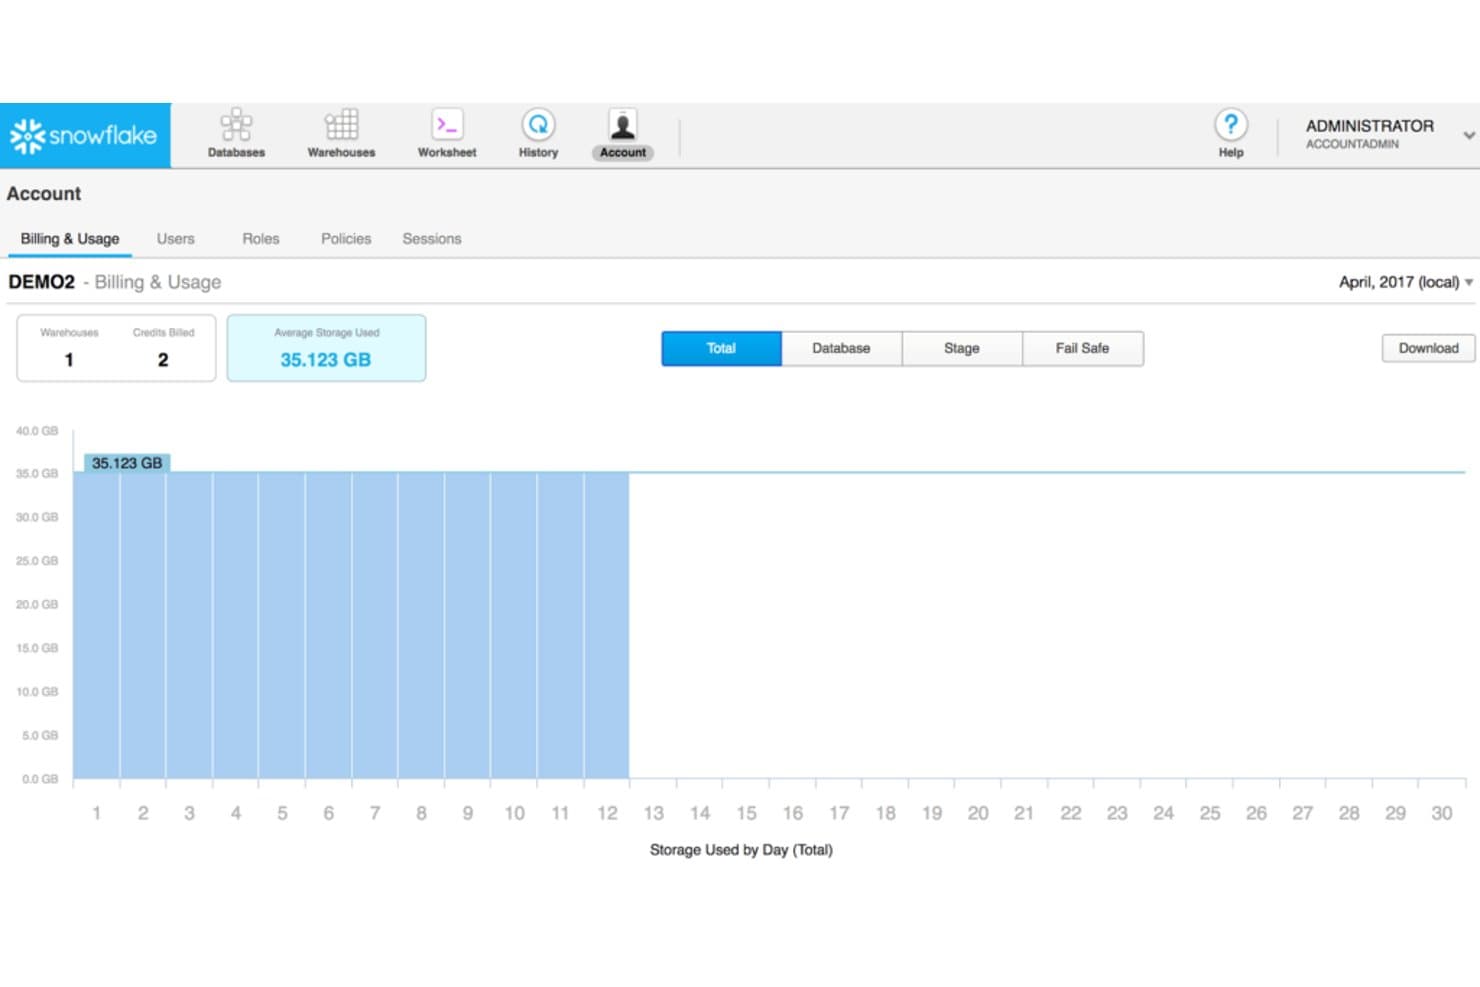
Snowflake śledzi dzienne zużycie przestrzeni dyskowej i kredytów na jednym pulpicie nawigacyjnym. Snowflake zapewnia zespołom IT i analityki chmurową platformę danych do łączenia odmiennych zbiorów danych, wykonywania zapytań SQL na dużą skalę oraz zapewniania kontrolowanego dostępu bez konieczności zarządzania infrastrukturą hurtowni danych.
Dla kogo Snowflake jest najlepszym wyborem?
Zespoły inżynierii danych i analityki, które potrzebują chmurowej hurtowni danych do wyszukiwania informacji i udostępniania ich w różnych systemach biznesowych.
Dlaczego wybrałem Snowflake
Wybrałem Snowflake jako „najlepsze rozwiązanie do hurtowni danych w chmurze”, ponieważ oddzielne warstwy przechowywania i obliczeń pozwalają mi skalować analitykę SQL bez zmiany rozmiaru warstwy danych. Doceniam również kontrolowane udostępnianie danych, gdy zespoły muszą wyszukiwać informacje w różnych systemach biznesowych bez kopiowania ich do oddzielnych hurtowni.
Najważniejsze funkcje Snowflake
- Tabele dynamiczne: Definiowanie potoków danych za pomocą SQL i ustawianie docelowego opóźnienia odświeżania.
- Snowpipe: Ładowanie danych z przygotowanych plików w miarę ich napływania.
- Podróż w czasie: Wyszukiwanie, klonowanie lub przywracanie danych historycznych w okresie przechowywania.
- Giełda Snowflake: Wyszukiwanie i uzyskiwanie dostępu do zbiorów danych oraz aplikacji innych firm.
Integracje Snowflake
Snowflake oferuje łączniki Openflow dla Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL i Microsoft SQL Server. Zapewnia również natywne łączniki dla ServiceNow, MySQL i Kafka, a także interfejsy API REST do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Niezależne skalowanie mocy obliczeniowej obsługuje zmienne obciążenia
- Zarządzane hurtownie SQL ograniczają nakłady na utrzymanie infrastruktury
- Bezpieczne udostępnianie eliminuje konieczność kopiowania zbiorów danych między zespołami
Cons:
- Skoki zużycia mogą sprawić, że wydatki będą trudne do przewidzenia
- Własnościowe funkcje mogą komplikować migrację platformy
Learn more about Snowflake: Najlepsze rozwiązanie do wdrażania danych w wielu chmurach
- Dostępny bezpłatny plan
- Ceny na żądanie
Visit WebsiteCustomer Rating:4.5/5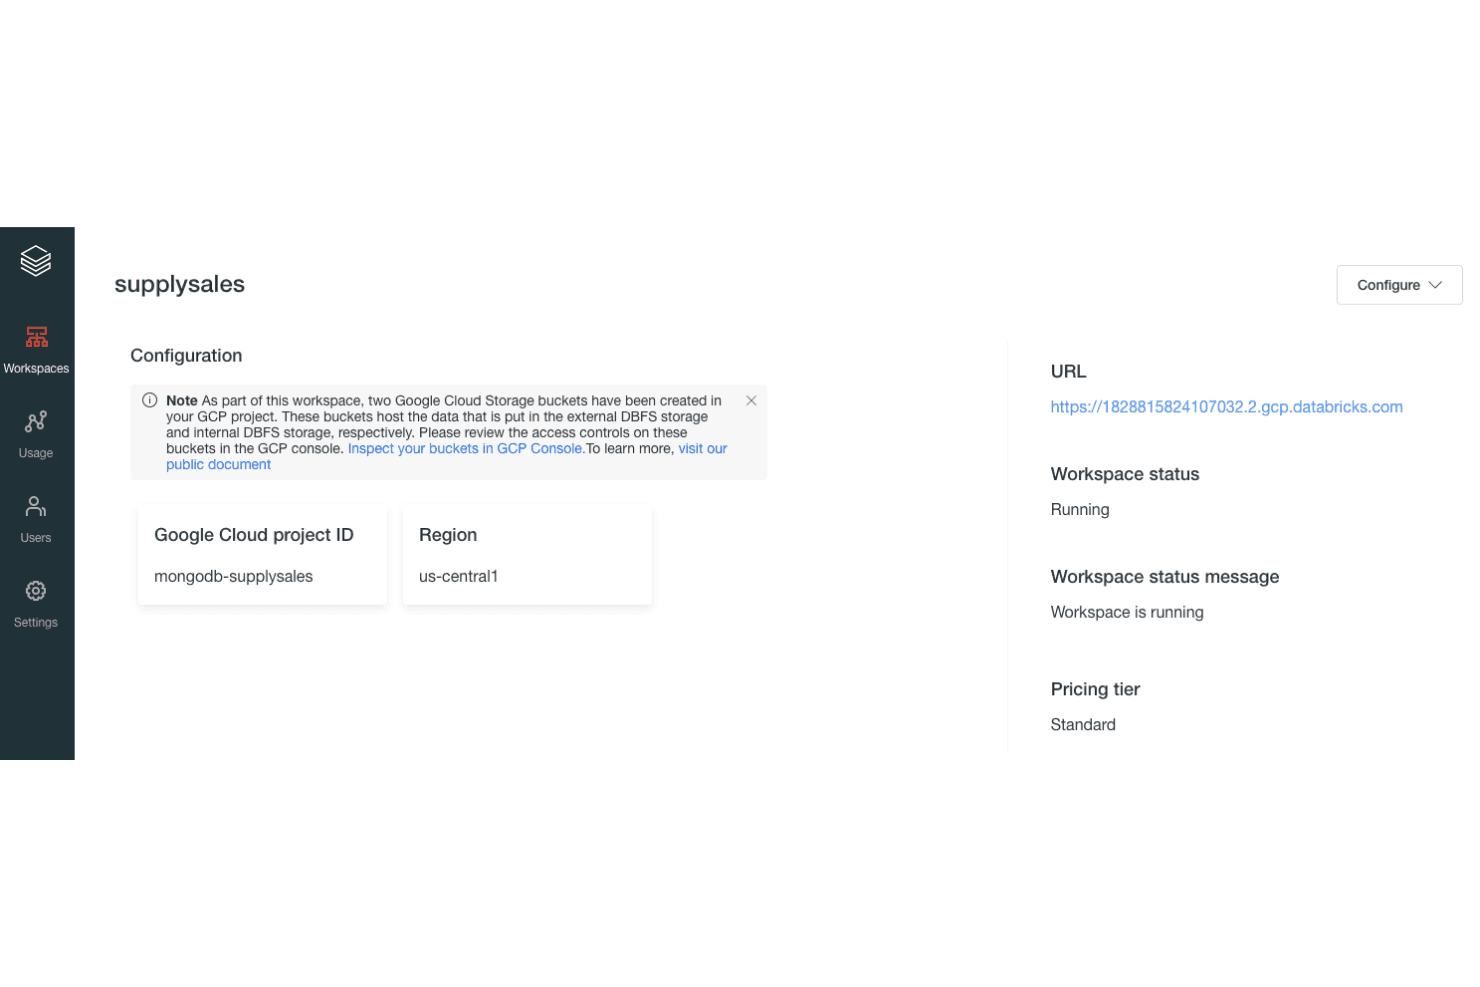
MongoDB Atlas integruje się z obszarami roboczymi Databricks w GCP na potrzeby przetwarzania danych. MongoDB Atlas zapewnia zespołom IT i zespołom ds. danych zarządzaną dokumentową bazę danych dla aplikacji, które wymagają elastycznych modeli danych, niezawodnych zapytań i mniejszego nakładu pracy związanej z utrzymaniem bazy danych.
Dla kogo MongoDB Atlas jest najlepszym wyborem?
Zespoły IT i zespoły platformowe wdrażające aplikacje u wielu dostawców chmury docenią zarządzaną bazę danych MongoDB Atlas i elastyczność obsługi wielu chmur.
Dlaczego wybrałem MongoDB Atlas
Wybrałem MongoDB Atlas jako alternatywę dla Databricks dla kategorii Najlepsze rozwiązanie do wdrażania danych w wielu chmurach. Atlas obsługuje klastry obejmujące wiele chmur w AWS, Azure i Google Cloud, a jego potok agregacji umożliwia analizowanie danych aplikacji przechowywanych w MongoDB. Wykorzystałbym go do wykonywania zapytań dotyczących danych operacyjnych znajdujących się blisko usług działających u różnych dostawców chmury.
Najważniejsze funkcje MongoDB Atlas
- Atlas Search: Twórz indeksy pełnotekstowe i uruchamiaj wyszukiwanie z wynikami uporządkowanymi według trafności.
- Atlas Charts: Twórz pulpity nawigacyjne i wizualizacje na podstawie danych MongoDB.
- Federacja danych: Wykonuj zapytania dotyczące danych w bazach Atlas i w chmurowej pamięci obiektowej.
- Automatyczne kopie zapasowe: Planuj migawki baz danych i przywracaj dane z zapisanych punktów.
Integracje MongoDB Atlas
MongoDB Atlas dokumentuje integracje z Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta i Microsoft Entra ID. Udostępnia również interfejs API administracji do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Klastry obejmujące wiele chmur w AWS, Azure i Google Cloud
- Elastyczne dokumenty dostosowują się do zmieniających się modeli danych aplikacji
- Potoki agregacji analizują dane operacyjne na miejscu
Cons:
- Mniejsze dopasowanie do szerokich obciążeń analitycznych typu jezioro danych
- Wydajność agregacji może wymagać starannego dostrajania zapytań
Learn more about MongoDB Atlas: Najlepszy do zadań związanych z integracją danych
- Dostępna bezpłatna wersja próbna
- $1,170/użytkownika/rok (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.2/5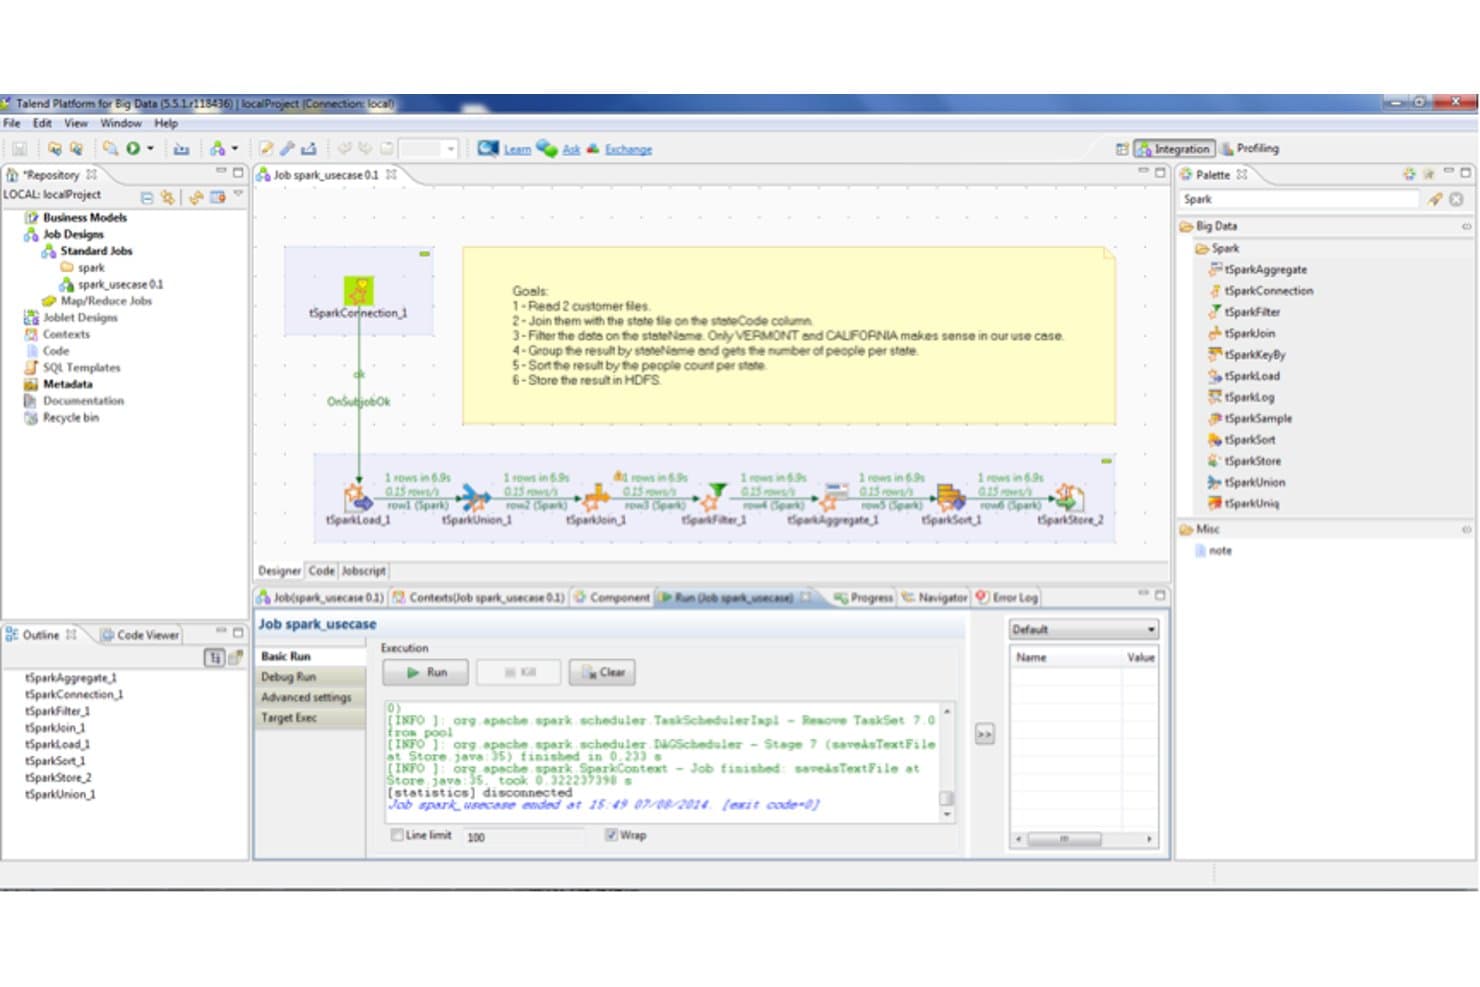
Talend pozwala użytkownikom wizualnie tworzyć i uruchamiać potoki danych Spark. Talend to platforma integracji danych dla zespołów IT i zespołów zajmujących się danymi, która łączy informacje między systemami, pomagając ograniczyć silosy i utrzymać łatwe w zarządzaniu potoki danych w miarę rozwoju środowisk.
Dla kogo Talend jest najlepszym wyborem?
Talend sprawdzi się w zespołach IT i zespołach inżynierii danych, które muszą łączyć systemy chmurowe, lokalne i starsze.
Dlaczego wybrałem Talend
Wybrałem Talend jako konkurenta Databricks, ponieważ „najlepszy do zadań związanych z integracją danych” dokładnie opisuje jego zastosowanie. Jego wizualny projektant zadań i transformacje tMap pozwalają mi łączyć i przekształcać rekordy między starszą bazą danych a hurtownią danych w chmurze. Cenię również komponenty jakości danych Talend za wykrywanie nieprawidłowo sformatowanych rekordów, zanim trafią do systemów podrzędnych.
Najważniejsze funkcje Talend
- Łączniki: Łącz bazy danych, aplikacje chmurowe, pliki i inne systemy za pomocą gotowych łączników.
- Przechwytywanie zmian danych: Przechwytuj wstawienia, aktualizacje i usunięcia w bazie danych w momencie ich wystąpienia.
- Pochodzenie danych: Śledź przepływy danych od systemów źródłowych, przez zadania, aż do miejsc docelowych.
- Odkrywanie metadanych: Skanuj źródła danych, aby identyfikować zestawy danych, formaty i wzorce.
Integracje Talend
Talend zawiera łączniki lub komponenty dla systemów takich jak Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle i MongoDB. Obsługuje również usługi REST i SOAP, a Qlik Talend Data Integration udostępnia interfejsy API do zarządzania połączeniami danych.
Pros and Cons
Pros:
- Wizualne zadania obsługują łączenie i przekształcanie danych
- Potoki wsadowe i działające w czasie rzeczywistym obsługują różnorodne obciążenia
- Narzędzia jakości danych oznaczają nieprawidłowo sformatowane rekordy
Cons:
- Duże zadania mogą wymagać dostrajania JVM
- Generowany kod Java komplikuje debugowanie i audyty
Learn more about Talend: Najlepszy do przetwarzania w pamięci
- Dostępny bezpłatny plan
- Ceny na żądanie
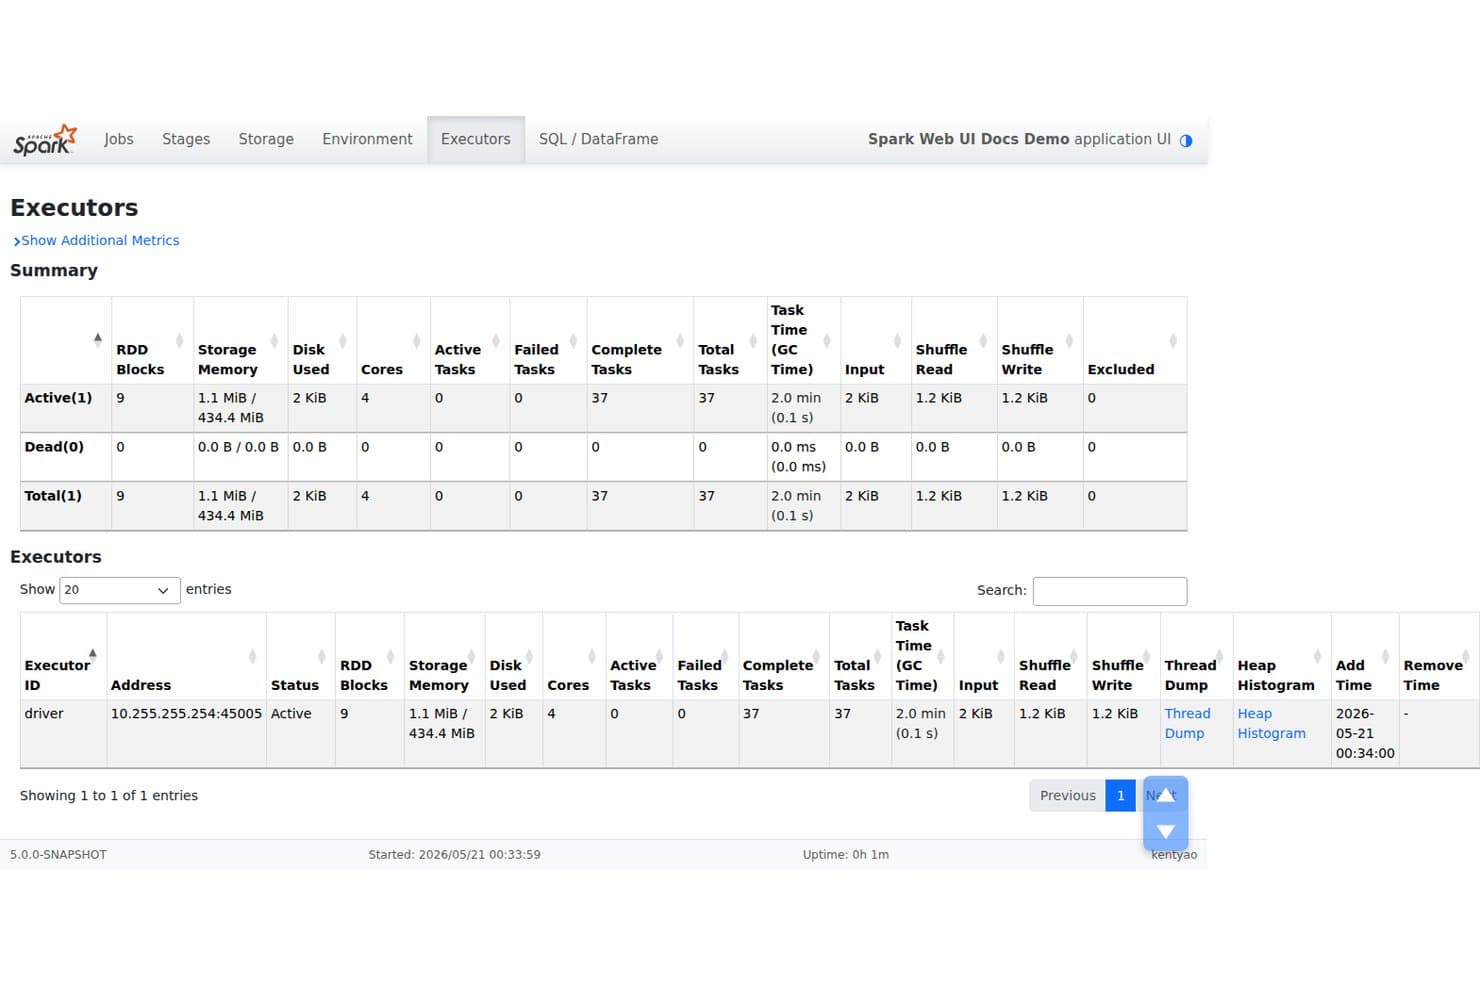
Apache Spark śledzi zasoby wykonawców, zadania i pamięć w czasie rzeczywistym. Apache Spark to silnik analityczny o otwartym kodzie źródłowym dla zespołów zajmujących się danymi i infrastrukturą, które potrzebują przetwarzać duże zbiory danych, uruchamiać rozproszone obciążenia oraz tworzyć potoki danych w różnych środowiskach.
Dla kogo Apache Spark jest najlepszym wyborem?
Apache Spark sprawdzi się w zespołach zajmujących się inżynierią danych i analityką, które potrzebują szybkiego, iteracyjnego przetwarzania dużych zbiorów danych w klastrach.
Dlaczego wybrałem Apache Spark
Wybrałem Apache Spark jako alternatywę dla Databricks, ponieważ najlepiej sprawdza się w przetwarzaniu w pamięci. Spark może buforować lub utrwalać RDD i ramki danych w pamięci, dzięki czemu powtarzane zapytania i iteracyjne obliczenia nie wymagają ponownego odczytywania danych źródłowych. Jest to pomocne podczas udoskonalania agregatów dużych zbiorów danych o zdarzeniach w wielu etapach analizy.
Najważniejsze funkcje Apache Spark
- Spark SQL: Wysyłaj zapytania do danych strukturalnych za pomocą SQL i interfejsów API ramek danych.
- Przetwarzanie strumieni strukturalnych: Przetwarzaj dane na żywo za pomocą interfejsów API strumieniowania Spark.
- MLlib: Twórz przepływy pracy uczenia maszynowego za pomocą skalowalnych algorytmów i potoków.
- Menedżery klastrów: Wdrażaj aplikacje w klastrach autonomicznych, YARN lub Kubernetes.
Integracje Apache Spark
Apache Spark obsługuje konektory do Apache Kafka i Apache Hive, a także połączenia JDBC z bazami danych, takimi jak PostgreSQL, MySQL, Oracle i Microsoft SQL Server. Jego interfejs API źródeł danych obsługuje niestandardowe konektory; zależności konektora Kafka i sterowniki JDBC właściwe dla poszczególnych baz danych mogą wymagać dodania osobno.
Pros and Cons
Pros:
- Buforowane zbiory danych przyspieszają iteracyjne obciążenia
- Przetwarzanie wsadowe, strumieniowe, SQL i ML korzysta z jednego silnika
- Działa lokalnie lub w klastrach Kubernetes i YARN
Cons:
- Presja na pamięć może powodować błędy braku pamięci
- Dostrajanie i debugowanie rozproszonych zadań wymaga specjalistycznej wiedzy
Learn more about Apache Spark:
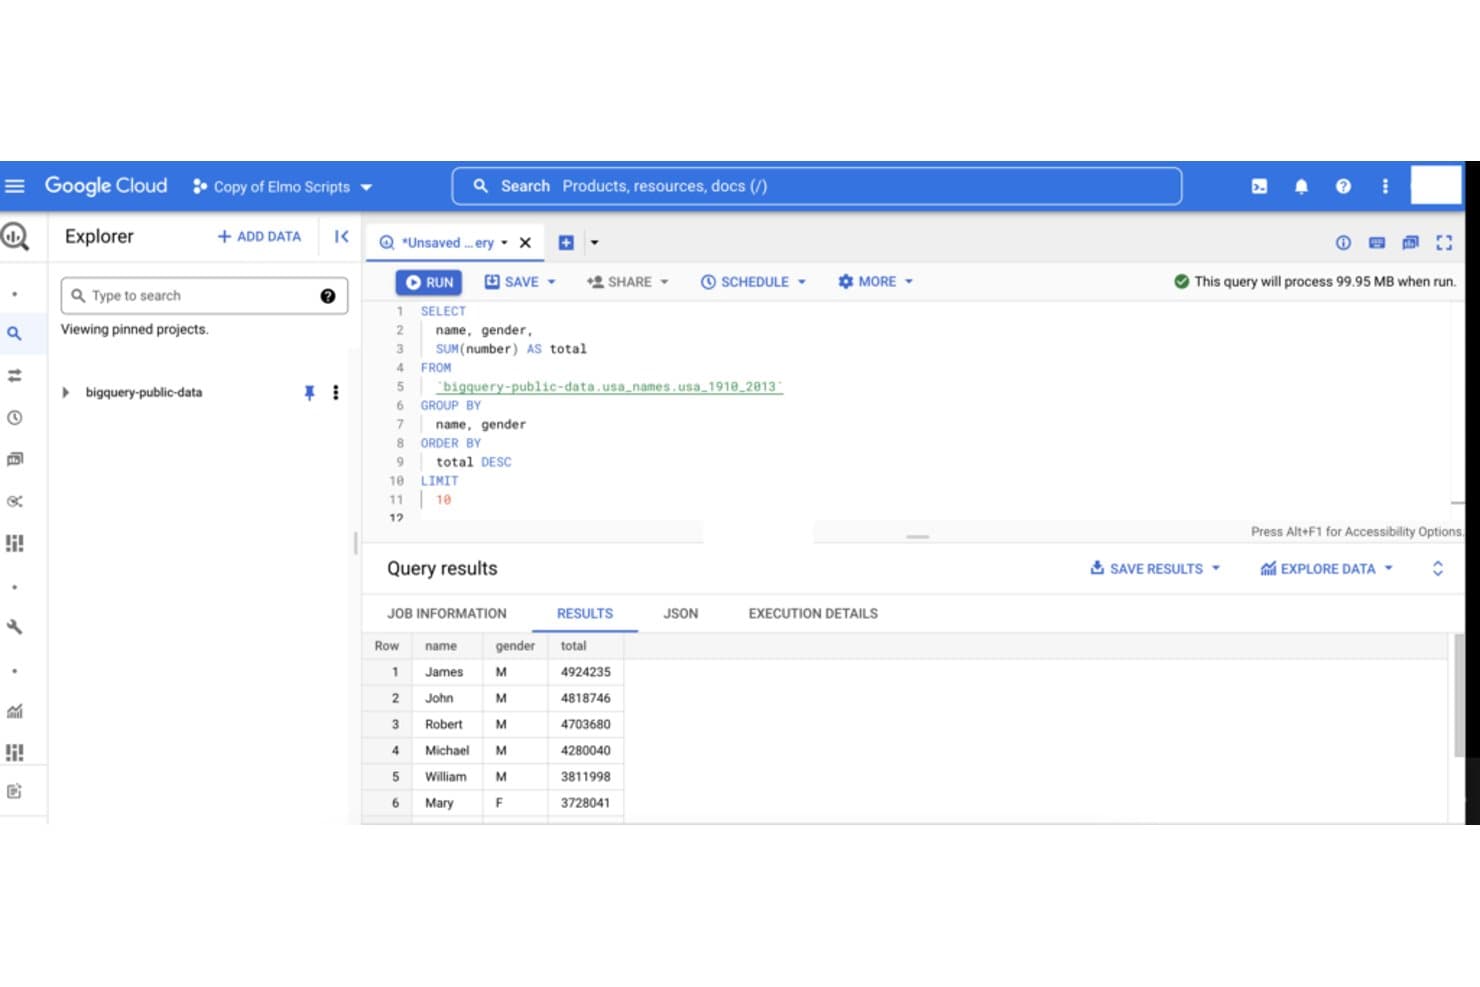
Google BigQuery umożliwia użytkownikom wykonywanie zapytań SQL na dużych publicznych zbiorach danych. Dla zespołów IT i zespołów ds. danych, które potrzebują skalowalnej analityki bez zarządzania infrastrukturą hurtowni, Google BigQuery to chmurowa hurtownia danych służąca do wykonywania zapytań i analizowania dużych zbiorów danych za pomocą SQL.
Dla kogo Google BigQuery jest najlepszym wyborem?
Analitycy danych i inżynierowie, którzy potrzebują szybko wykonywać zapytania SQL w dużych chmurowych zbiorach danych, uznają Google BigQuery za praktyczne rozwiązanie.
Dlaczego wybrałem Google BigQuery
Wybrałem Google BigQuery jako alternatywę dla Databricks „najlepszą do szybkich zapytań SQL”. Jego bezserwerowy silnik zapytań wykonuje zapytania w GoogleSQL na dużych zbiorach danych, a partycjonowanie i klastrowanie tabel może ograniczyć ilość danych skanowanych podczas cyklicznie tworzonych raportów. Podoba mi się możliwość wysyłania zapytań dotyczących dzienników aplikacji lub danych o zdarzeniach bez zarządzania klastrami hurtowni.
Najważniejsze funkcje Google BigQuery
- BigQuery ML: Tworzenie i uruchamianie modeli uczenia maszynowego za pomocą SQL.
- Zaplanowane zapytania: Ustawianie zadań SQL tak, aby były uruchamiane w wybranych odstępach czasu.
- Usługa transferu danych BigQuery: Planowanie importu danych z obsługiwanych źródeł.
- Autoryzowane widoki: Udostępnianie wyników zapytań bez przyznawania dostępu do bazowych tabel.
Integracje Google BigQuery
Google dokumentuje bezpośrednie integracje BigQuery z Looker, Looker Studio, Vertex AI Workbench, zarządzaną usługą Apache Spark i Tableau. Połączenia z danymi oraz procesy ich ładowania obsługują również Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 i Azure Blob Storage; interfejsy API REST i Storage BigQuery umożliwiają tworzenie niestandardowych integracji.
Pros and Cons
Pros:
- Szybkie skanowanie dużych zbiorów danych za pomocą SQL
- Działanie bez serwera eliminuje konieczność zarządzania klastrami
- Partycjonowanie i klastrowanie mogą ograniczyć ilość skanowanych danych
Cons:
- Koszty zapytań mogą gwałtownie wzrosnąć bez odpowiednich ograniczeń
- Eksploracja danych przez użytkowników biznesowych często wymaga znajomości SQL
Learn more about Google BigQuery: Najlepszy do obsługi potrzeb korporacyjnych baz danych
- Dostępna bezpłatna wersja próbna
- $68/user/month (rozliczane rocznie)
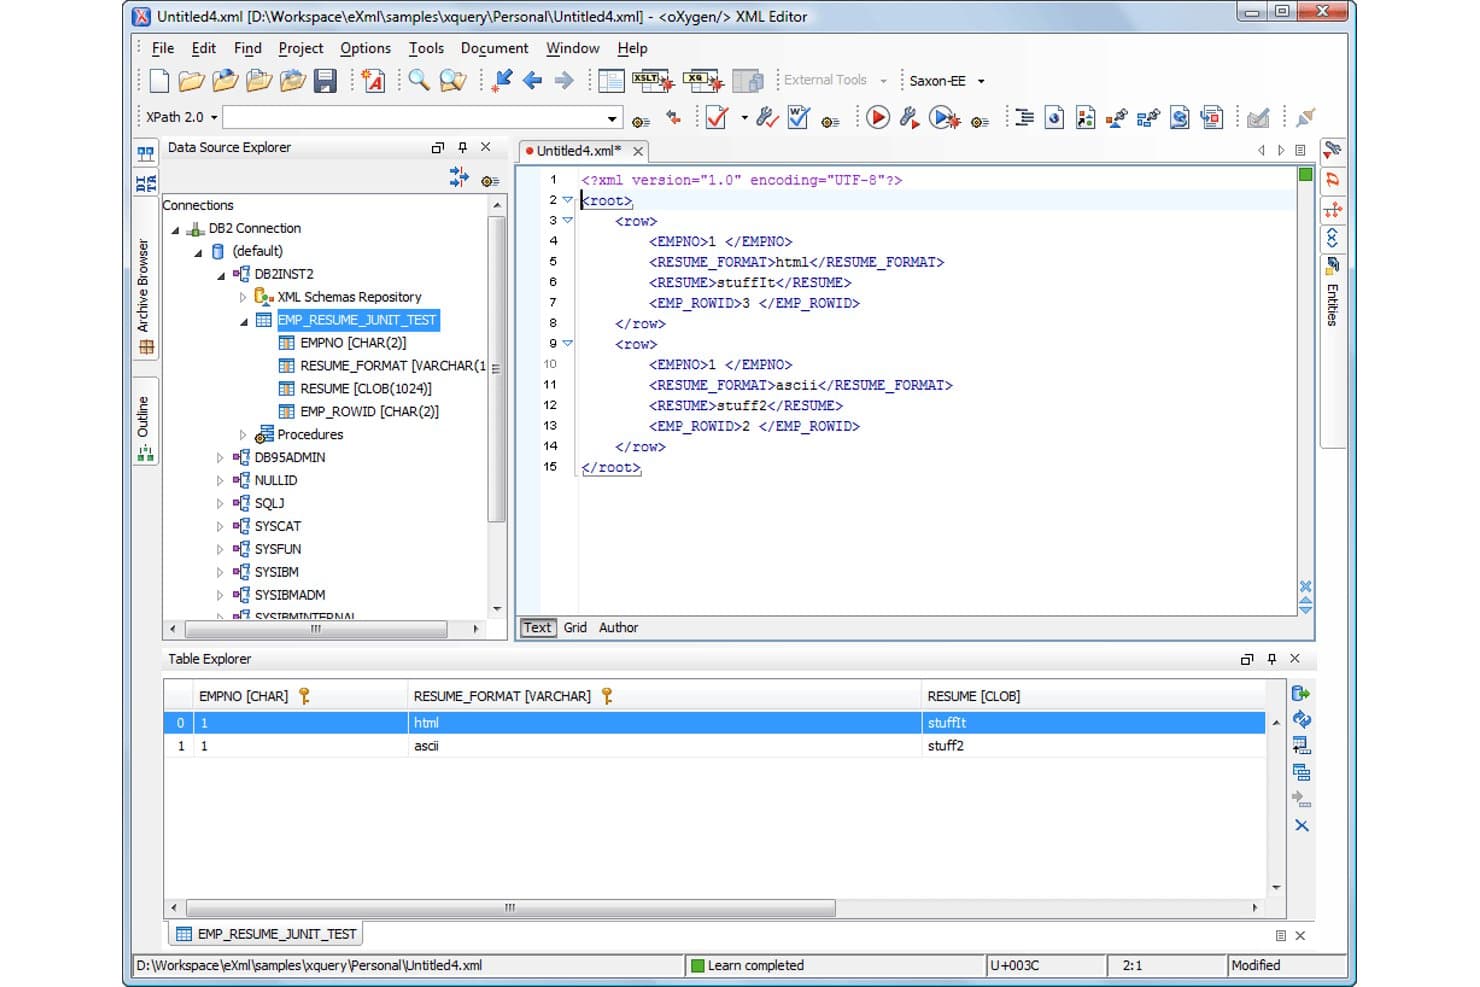
IBM Db2 umożliwia użytkownikom przeglądanie schematów baz danych i wizualne wykonywanie zapytań do danych XML. IBM Db2 to relacyjny system zarządzania bazami danych dla organizacji, które muszą obsługiwać obciążenia związane z uporządkowanymi danymi w złożonych środowiskach, zapewniając wsparcie zespołom zarządzającym aplikacjami korporacyjnymi, transakcjami i analizami.
Dla kogo IBM Db2 jest najlepszy?
Administratorzy baz danych i zespoły IT w dużych organizacjach, które obsługują aplikacje biznesowe o dużej liczbie operacji.
Dlaczego wybrałem IBM Db2
Wybrałem IBM Db2, najlepszy do obsługi potrzeb korporacyjnych baz danych, jako alternatywę dla Databricks dla podstawowych systemów biznesowych. Obsługuje dane transakcyjne, analityczne i wektorowe na jednej platformie, zapewniając optymalizację obciążeń opartą na sztucznej inteligencji na potrzeby systemów ERP, rozliczeń i przetwarzania zamówień. Doceniam to dopasowanie, gdy obciążenia relacyjne i analizy muszą współdzielić infrastrukturę.
Najważniejsze funkcje IBM Db2
- Wdrożenie hybrydowe: Uruchamiaj Db2 lokalnie, w chmurze lub w środowiskach hybrydowych.
- Natywne szyfrowanie: Szyfruj dane bazy danych i zarządzaj kluczami szyfrowania za pośrednictwem magazynu kluczy.
- Partycjonowanie tabel: Dziel dane tabel na partycje na podstawie określonych wartości kolumn.
- Narzędzia do tworzenia kopii zapasowych i odzyskiwania: Db2 Advanced Recovery obsługuje tworzenie kopii zapasowych baz danych, odzyskiwanie danych i ich ekstrakcję.
Integracje IBM Db2
Natywne integracje nie są jasno udokumentowane. Db2 obsługuje sfederowany dostęp do źródeł danych, takich jak Oracle i Microsoft SQL Server, a także łączność JDBC, ODBC i CLI na potrzeby aplikacji.
Pros and Cons
Pros:
- Szybkie przetwarzanie obciążeń związanych z transakcjami korporacyjnymi
- Wysoka dostępność dzięki HADR i funkcjom odzyskiwania
- Partycjonowanie obsługuje duże i zróżnicowane obciążenia
Cons:
- Administracja i dostrajanie wymagają specjalistycznej wiedzy
- Operacje natywne dla chmury pozostają w tyle za nowszymi platformami
Learn more about IBM Db2: Najlepsze rozwiązanie do analityki SQL
- 30-dniowy bezpłatny okres próbny
- $30/użytkownik/miesiąc (rozliczane rocznie)
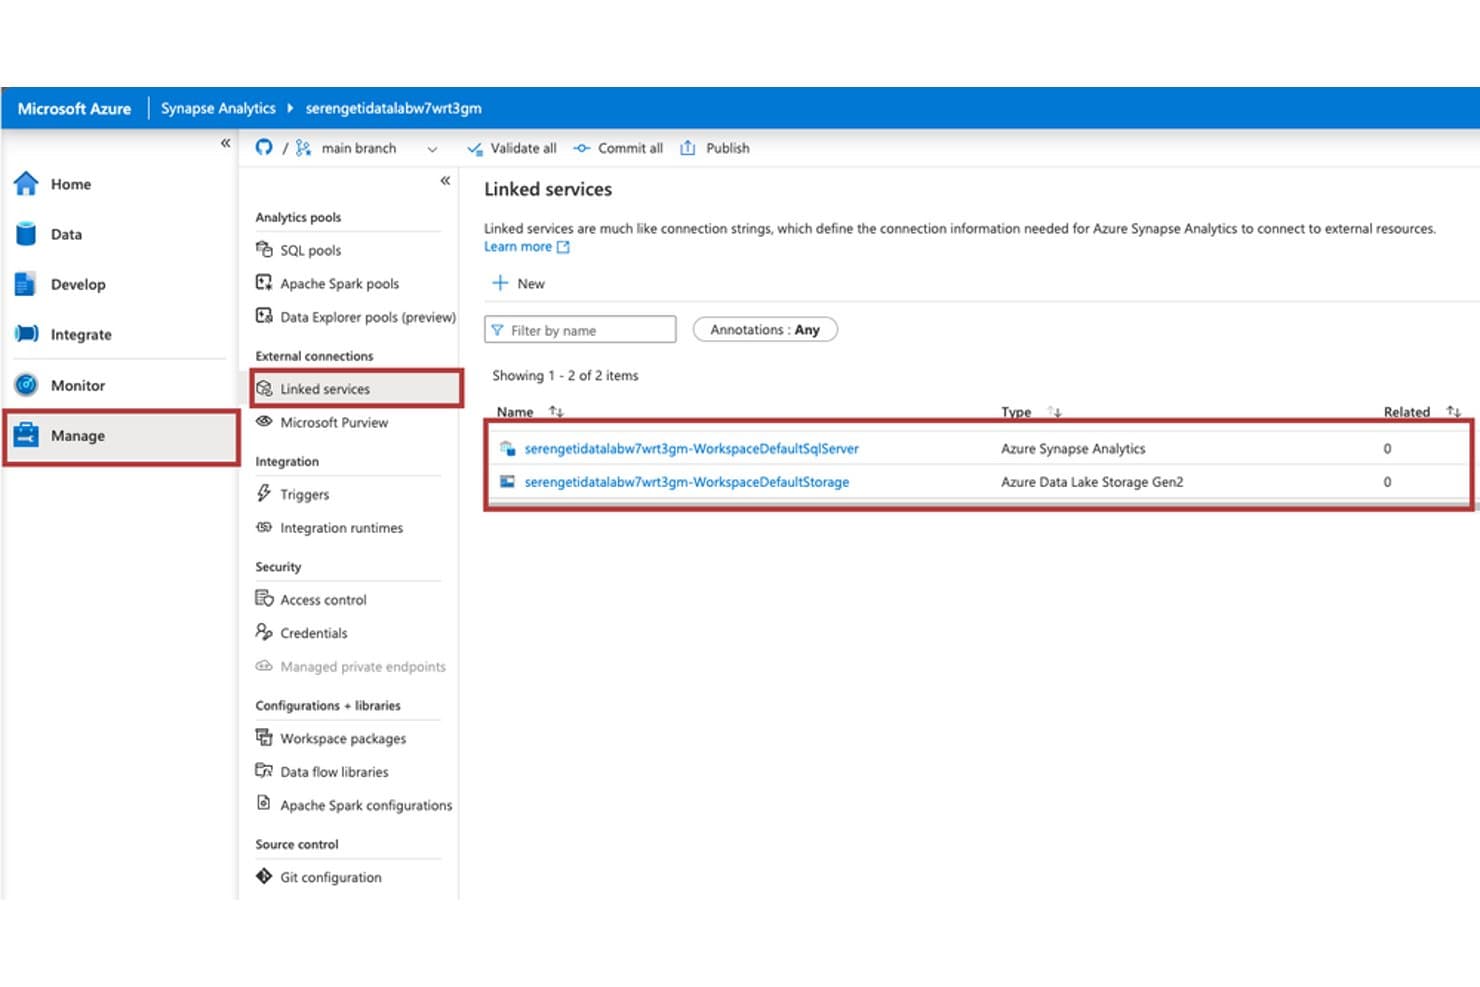
Azure Synapse Analytics zarządza połączeniami zewnętrznymi za pośrednictwem połączonych usług. Azure Synapse Analytics to chmurowa platforma analityczna dla zespołów zajmujących się danymi i IT, które muszą łączyć dane przedsiębiorstwa, uruchamiać zapytania oraz obsługiwać raportowanie w ramach hurtowni danych i obciążeń związanych z dużymi zbiorami danych.
Dla kogo Azure Synapse Analytics jest najlepszym rozwiązaniem?
Platforma jest odpowiednia dla inżynierów danych i analityków, którzy potrzebują dostępu SQL do zintegrowanych zbiorów danych na potrzeby raportowania i analityki przedsiębiorstwa.
Dlaczego wybrałem Azure Synapse Analytics
Wybrałem Azure Synapse Analytics jako najlepsze rozwiązanie do analityki SQL, ponieważ bezserwerowa pula SQL wykonuje zapytania do plików w jeziorze danych za pomocą języka T-SQL, podczas gdy dedykowane pule SQL obsługują aprowizowane obciążenia hurtowni danych. Podoba mi się ten podział, gdy muszę analizować surowe zbiory danych i dostarczać cykliczne raporty BI za pośrednictwem SQL.
Najważniejsze funkcje Azure Synapse Analytics
- Pule Apache Spark: Uruchamianie zadań i notesów Spark na potrzeby rozproszonego przetwarzania danych.
- Potoki: Orkiestracja przenoszenia i transformacji danych między połączonymi źródłami.
- Synapse Studio: Zarządzanie danymi, kodem i zasobami analitycznymi we wspólnym obszarze roboczym.
- Integracja z Power BI: Łączenie danych Synapse z Power BI w celu tworzenia raportów.
Integracje Azure Synapse Analytics
Azure Synapse Analytics ma wbudowane konektory potoków do usług Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 i SAP HANA, a także bezpośrednie połączenie z Power BI za pośrednictwem Synapse Studio. Zapewnia również interfejsy API REST na potrzeby niestandardowych integracji.
Pros and Cons
Pros:
- Bezserwerowe zapytania T-SQL odczytują pliki z jeziora danych
- Dedykowane pule MPP obsługują obciążenia hurtowni danych
- Łączy zapytania SQL z przetwarzaniem Spark
Cons:
- Dostrajanie puli SQL wymaga praktycznej wiedzy
- Możliwości debugowania i monitorowania potoków mogą być ograniczone
Learn more about Azure Synapse Analytics: Najlepszy wybór do przetwarzania danych za pomocą Hadoop
- Niedostępne
- Od $0.007084/vCPU-hour
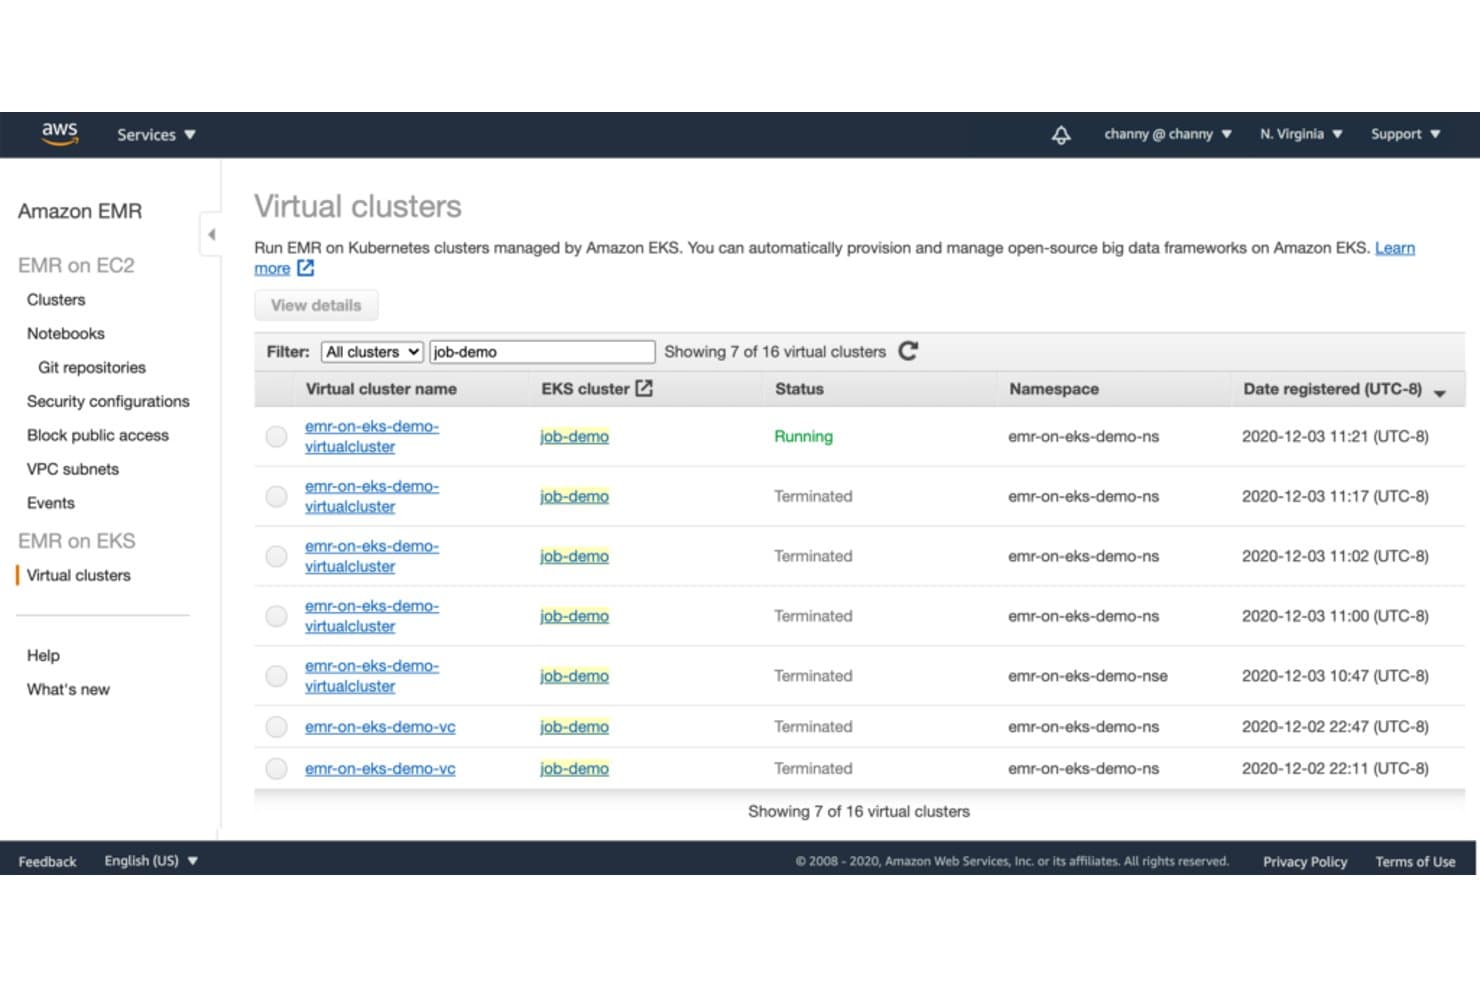
Amazon EMR umożliwia użytkownikom zarządzanie klastrami wirtualnymi działającymi w Amazon EKS. Amazon EMR to zarządzana przez AWS platforma do obsługi dużych zbiorów danych, przeznaczona dla zespołów zajmujących się inżynierią danych i analityką, które muszą przetwarzać duże zbiory danych, skalować rozproszone obciążenia i ograniczać nakład pracy związany z obsługą klastrów obliczeniowych.
Dla kogo Amazon EMR jest najlepszym wyborem?
Amazon EMR jest odpowiedni dla zespołów inżynierii danych, które uruchamiają zadania Hadoop lub Spark w celu przetwarzania dużych zbiorów danych w rozproszonych klastrach.
Dlaczego wybrałem Amazon EMR
Wybrałem Amazon EMR jako alternatywę dla Databricks z jednego powodu: najlepszy wybór do przetwarzania danych za pomocą Hadoop. Zarządzane klastry uruchamiają Apache Hadoop i Spark, dzięki czemu mogę używać MapReduce do przetwarzania zarchiwizowanych dzienników aplikacji oraz Spark do analizowania wyników.
Najważniejsze funkcje Amazon EMR
- EMR Serverless: Uruchamiaj aplikacje do obsługi danych bez aprowizowania i zarządzania klastrami.
- Automatyczne skalowanie: Dostosowuj pojemność klastra do zapotrzebowania wynikającego z obciążenia.
- EMR w EKS: Uruchamiaj obciążenia EMR w klastrach Amazon EKS.
- Katalog danych AWS Glue: Korzystaj ze współdzielonego katalogu metadanych tabel.
Integracje Amazon EMR
Amazon EMR ma udokumentowane integracje z AWS Glue Data Catalog, AWS Lake Formation, Amazon S3 i Amazon CloudWatch. Udostępnia również interfejs API umożliwiający dostęp programistyczny i tworzenie niestandardowych integracji.
Pros and Cons
Pros:
- Uruchamia sprawdzone obciążenia Hadoop i Spark
- Obsługuje wdrożenia klastrowe, bezserwerowe i EKS
- Przetwarza duże zbiory danych w ramach różnorodnych obciążeń
Cons:
- Powolne automatyczne skalowanie może powodować niedostateczne zasoby dla zadań
- Skalowanie klastra czasami wymaga ręcznego dostrajania
Learn more about Amazon EMR: Najlepsze rozwiązanie do zarządzanego środowiska Spark i Hadoop
- Niedostępne
- Od $0.06 za godzinę DCU
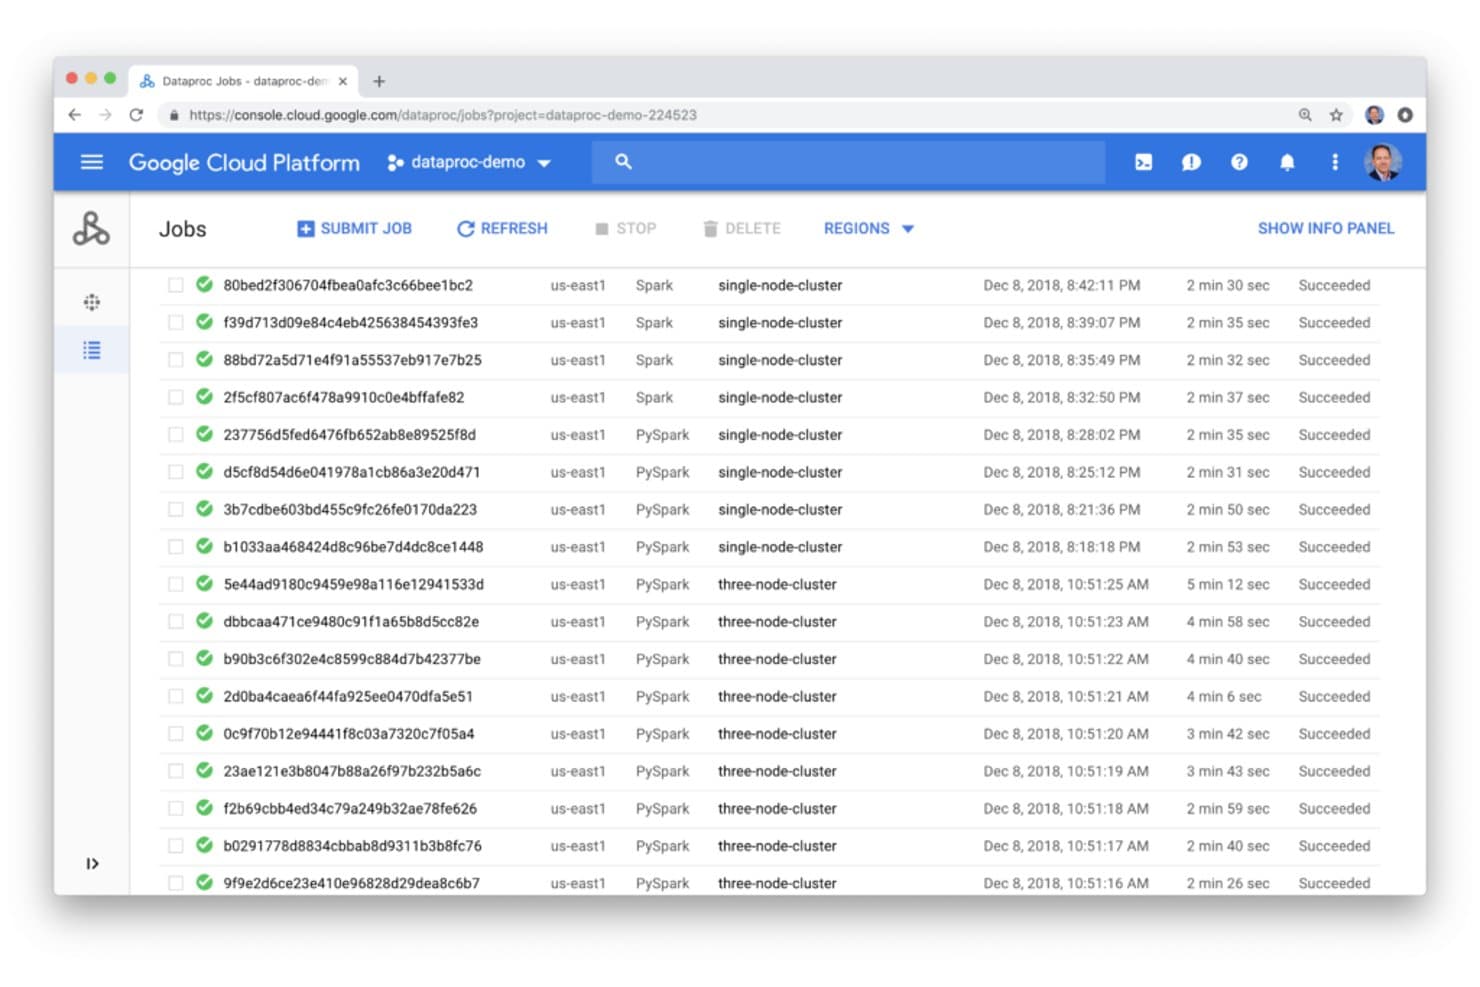
Google Cloud Dataproc umożliwia użytkownikom szybkie monitorowanie zadań Spark i zarządzanie nimi. Google Cloud Dataproc zapewnia zespołom inżynierii danych i IT zarządzaną platformę chmurową do obsługi analiz na dużą skalę, pomagając ograniczyć administrację klastrami i obsługiwać potoki danych w Google Cloud.
Dla kogo Google Cloud Dataproc jest najlepszym rozwiązaniem?
Zespoły inżynierii danych, które uruchamiają zadania Spark lub Hadoop w Google Cloud, mogą używać Dataproc do zarządzania operacjami klastra.
Dlaczego wybrałem Google Cloud Dataproc
Wybrałem Google Cloud Dataproc do obciążeń, w przypadku których priorytetem jest „najlepsze rozwiązanie do zarządzanego środowiska Spark i Hadoop”. Zarządzane klastry i zasady automatycznego skalowania pomagają obsługiwać zadania wsadowe o zmiennych wymaganiach dotyczących zasobów, a Dataproc Serverless uruchamia zadania wsadowe Spark bez konieczności aprowizowania klastra. Można na przykład przetwarzać nocne dzienniki zdarzeń za pomocą Spark i unikać pozostawiania bezczynnego klastra między kolejnymi uruchomieniami.
Najważniejsze funkcje Google Cloud Dataproc
- Silnik Lightning: Przyspiesza wykonywanie zadań Spark dzięki przetwarzaniu wektorowemu, buforowaniu i zoptymalizowanemu tasowaniu danych.
- Obsługa Apache Iceberg: Działa z otwartymi formatami tabel w Google Cloud Storage.
- Akceleracja GPU: Obsługuje NVIDIA RAPIDS na potrzeby przetwarzania danych z użyciem GPU.
- Mechanizmy kontroli bezpieczeństwa: Integruje się z IAM, VPC Service Controls i Kerberos.
Integracje Google Cloud Dataproc
Google Cloud Dataproc ma wbudowane integracje z BigQuery, Cloud Storage, Bigtable, Cloud Logging i Cloud Monitoring. Udostępnia także interfejs REST API oraz Cloud SDK do zarządzania klastrami i zadaniami.
Pros and Cons
Pros:
- Uruchamianie istniejących zadań Spark przy minimalnej konieczności ich przepisywania
- Szybkie tworzenie i usuwanie klastrów
- Zadania bezserwerowe eliminują konieczność administracji klastrami
Cons:
- Dostrajanie klastra nadal wymaga specjalistycznej wiedzy z zakresu infrastruktury
- Koszty mogą wydawać się wysokie w przypadku stałych obciążeń
Learn more about Google Cloud Dataproc: 10Najlepsze rozwiązanie do zastosowań AI i ML
H2O.ai
- Dostępna bezpłatna prezentacja
- Ceny ustalane na życzenie
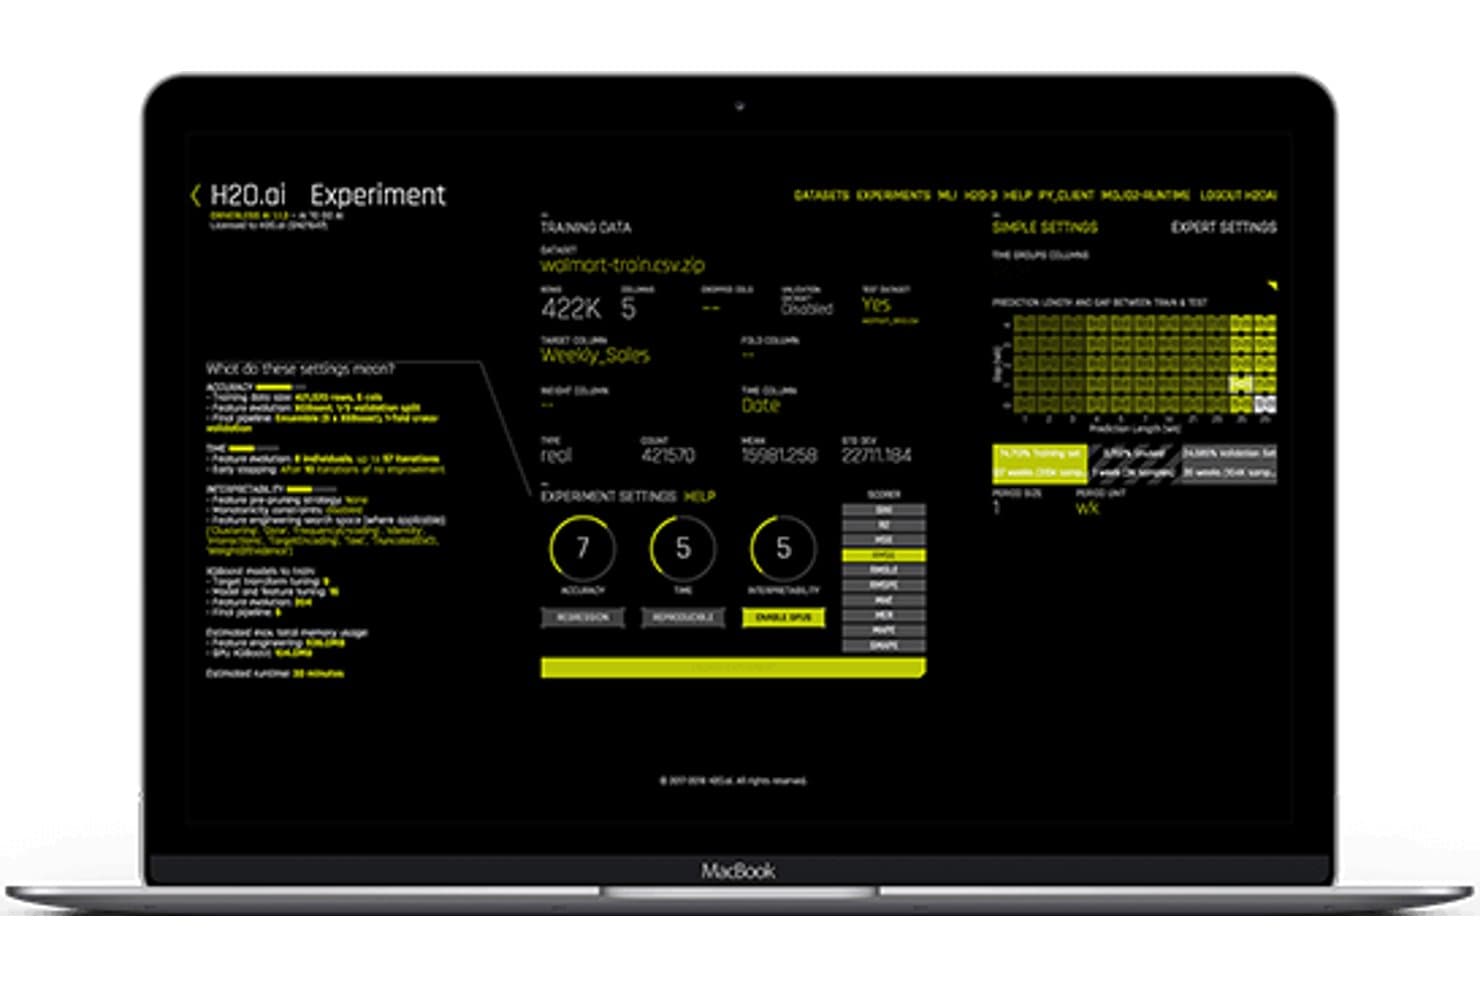
H2O.ai umożliwia użytkownikom wizualne konfigurowanie i uruchamianie eksperymentów AutoML. Dla zespołów oceniających alternatywy dla Databricks platforma H2O.ai zapewnia platformę sztucznej inteligencji i uczenia maszynowego, która pomaga zespołom ds. danych i IT tworzyć modele predykcyjne na podstawie dużych zbiorów danych oraz wykorzystywać analitykę w praktyce.
Dla kogo H2O.ai jest najlepszym wyborem?
H2O.ai jest odpowiednia dla analityków danych i inżynierów uczenia maszynowego odpowiedzialnych za opracowywanie modeli AI i wdrażanie ich do środowiska produkcyjnego.
Dlaczego wybrałem H2O.ai
Wybrałem H2O.ai jako alternatywę dla Databricks „najlepszą do zastosowań AI i ML”, ponieważ koncentruje się na tworzeniu modeli predykcyjnych na podstawie dużych zbiorów danych. H2O-3 rozdziela uczenie maszynowe w pamięci operacyjnej między klastry, a AutoML testuje algorytmy i szereguje modele w tabeli wyników. Podoba mi się to rozwiązanie, gdy muszę porównać modele przed wdrożeniem jednego z nich do środowiska produkcyjnego.
Najważniejsze funkcje H2O.ai
- Elastyczne wdrażanie: Uruchamiaj platformę lokalnie, w chmurze prywatnej, w chmurze lub w środowiskach odizolowanych od sieci.
- Obsługa niezależna od modelu: Wybieraj, wymieniaj lub dostrajaj modele i duże modele językowe.
- Wyjaśnialność: Przeglądaj wyjaśnienia dotyczące decyzji podejmowanych przez AI.
- Ścieżki audytu: Śledź aktywność na platformie za pomocą ścieżek gotowych do audytu.
Integracje H2O.ai
H2O Driverless AI zapewnia złącza danych dla Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, źródeł JDBC i tabel Delta. Złącza te umożliwiają zespołom wykonywanie zapytań dotyczących danych lub importowanie danych z istniejących platform na potrzeby procesów uczenia maszynowego.
Pros and Cons
Pros:
- AutoML przyspiesza porównywanie modeli i prototypowanie
- Rozproszone uczenie w pamięci operacyjnej skaluje się między klastrami
- Wdrażanie w środowiskach odizolowanych od sieci obsługuje kontrolowane środowiska
Cons:
- Możliwości manipulowania danymi są ograniczone
- Mało intuicyjny interfejs może spowalniać pracę
Learn more about H2O.ai:
Inne alternatywy dla Databricks
Oto kilka dodatkowych alternatyw dla Databricks, które nie trafiły na moją listę, ale nadal warto się nimi zainteresować:
- 11DremioNajlepsze rozwiązanie do samoobsługowej analityki
- 12QuboleNajlepsze do obciążeń związanych z dużymi zbiorami danych
- 13Azure DatabricksNajlepsze rozwiązanie do wspólnej analityki
Jak oceniam konkurentów Databricks
Niezależnie od tego, czy Twój zespół uruchamia potoki Spark na dużą skalę, czy zarządza cyklem życia modeli ML, oceniam każdą alternatywę na dwóch poziomach: najpierw podstawowe wymagania dotyczące jeziora danych i mocy obliczeniowej, a następnie elementy wyróżniające.
Podstawowa funkcjonalność (wymagania dla tej listy)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcjonalności) do 5 (doskonale sprawdza się w tym obszarze) pod kątem każdej z wymienionych poniżej podstawowych funkcjonalności. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi uzyskać łączny wynik na poziomie co najmniej 65%, aby zostać uwzględnione na liście.
- Ujednolicona architektura jeziora danych i hurtowni: Sprawdzam, czy platforma może obsługiwać zarówno zapytania do ustrukturyzowanych hurtowni, jak i przechowywanie nieustrukturyzowanych danych w jeziorze danych, z obsługą otwartych formatów tabel, takich jak Delta, Iceberg czy Hudi.
- Rozproszone przetwarzanie danych: Obciążenia wsadowe i strumieniowe na dużą skalę wymagają rozproszonego silnika, który automatycznie skaluje zasoby, dlatego oceniam dostępne opcje obliczeniowe oraz sposób obsługi zadań, takich jak przebiegi ETL obejmujące wiele terabajtów danych.
- Zintegrowane przepływy pracy ML/AI: Szukam kompleksowej obsługi cyklu życia ML — od śledzenia eksperymentów i rejestru modeli po wdrażanie i udostępnianie — zamiast samego notatnika, który może uruchamiać skrypty treningowe.
- Współdzielone środowisko notatników: Zespoły inżynierów danych, analityków i inżynierów ML potrzebują współdzielonych notatników obsługujących wiele języków, dlatego oceniam współpracę w czasie rzeczywistym, kontrolę wersji oraz obsługę języków SQL, Python, Scala i R.
- Ład danych i bezpieczeństwo: Ujednolicony katalog danych, szczegółowa kontrola dostępu i śledzenie pochodzenia danych mają tutaj istotne znaczenie. Sprawdzam, jak każda platforma zarządza uprawnieniami do tabel, kolumn i zasobów AI w jednym miejscu.
- Wiele chmur i otwarta integracja: Uzależnienie od jednego dostawcy stanowi realny problem, dlatego oceniam, czy każde narzędzie działa w AWS, Azure i GCP oraz jak dobrze łączy się z orkiestratorami, takimi jak Airflow, narzędziami BI, takimi jak Tableau, oraz warstwami pozyskiwania danych, takimi jak dbt.
Gdy mam już listę narzędzi spełniających te kryteria, sprawdzam, co wyróżnia każdą platformę.
Czynniki wyróżniające (co odróżnia dostawców)
Oto jak porównuję różnych dostawców:
Najważniejsze funkcje
Obliczenia bezserwerowe są istotnym czynnikiem wyróżniającym. Oceniam, czy platforma pozwala zespołom uruchamiać zapytania i zadania bez zarządzania klastrami, co zmniejsza obciążenie zespołów pracujących z nieprzewidywalnymi obciążeniami. Natywne narzędzia generatywnej AI z każdym rokiem zyskują na znaczeniu, szczególnie dla zespołów tworzących potoki RAG lub dostrajających modele LLM bezpośrednio w ramach swojej platformy danych. Analizuję również mechanizmy optymalizacji kosztów, takie jak śledzenie wydatków według obciążenia i automatyczne zasady dotyczące klastrów, ponieważ koszty obliczeń w chmurze mogą szybko wymknąć się spod kontroli w dużych zespołach inżynieryjnych.
Nie tylko funkcje
Całkowity koszt posiadania jest jedną z pierwszych rzeczy, które oceniam. Ceny oparte na zużyciu mogą wyglądać atrakcyjnie, dopóki opłaty za transfer danych i wyższe poziomy wsparcia nie podniosą rachunku. Znaczenie ma również rozbudowany ekosystem — sprawdzam, jak dobrze każda platforma łączy się z narzędziami takimi jak Airflow, dbt i Tableau, ponieważ większość zespołów nie zastępuje całego swojego stosu technologicznego. Dopełnieniem oceny są wdrożenie i czas osiągnięcia wartości. Narzędzia do migracji ze starszych systemów, takich jak Hadoop czy Redshift, mogą skrócić przejście o całe tygodnie, a rzetelna dokumentacja znacznie ułatwia wdrażanie nowych inżynierów.
Jak wybrać konkurenta Databricks
Łatwo ugrzęznąć w długich listach funkcji i złożonych strukturach cenowych. Aby pomóc Ci zachować koncentrację podczas wyboru oprogramowania dopasowanego do Twoich potrzeb, przygotowałem listę czynników, które warto wziąć pod uwagę:
| Czynnik | Co uwzględnić |
| Skalowalność | Upewnij się, że rozwiązanie poradzi sobie ze wzrostem ilości danych bez utraty wydajności. Sprawdź, czy obsługuje zarówno skalowanie horyzontalne, jak i wertykalne, aby zapewnić elastyczność. |
| Integracje | Poszukaj zgodności z używanymi już narzędziami, takimi jak jeziora danych lub narzędzia BI, aby zapewnić płynny przepływ danych i uniknąć procesów działających w odizolowanych silosach. |
| Możliwość dostosowania | Oceń zdolność platformy do dostosowania się do konkretnych przepływów pracy i procesów Twojego zespołu. Konfigurowalne pulpity mogą odpowiadać na różne potrzeby zespołu. |
| Łatwość obsługi | Weź pod uwagę krzywą uczenia się oraz to, jak intuicyjny jest interfejs dla Twojego zespołu. Przyjazna dla użytkownika platforma może skrócić czas szkoleń i zwiększyć poziom wdrożenia. |
| Budżet | Porównaj modele cenowe i upewnij się, że mieszczą się w Twoim budżecie. Weź pod uwagę ukryte koszty, takie jak opłaty za przechowywanie danych lub dodatkowych użytkowników, które mogą wpłynąć na Twoją decyzję. |
| Zabezpieczenia | Oceń funkcje bezpieczeństwa platformy, takie jak szyfrowanie danych i zgodność ze standardami branżowymi, aby chronić wrażliwe dane. |
| Wsparcie | Sprawdź dostępność opcji obsługi klienta, w tym czatu na żywo i forów społecznościowych, aby mieć pewność, że Twój zespół otrzyma pomoc, gdy będzie jej potrzebować. |
| Wydajność | Sprawdź, jak platforma obsługuje duże zbiory danych i przetwarzanie w czasie rzeczywistym, aby upewnić się, że spełnia oczekiwania Twojego zespołu dotyczące wydajności. |
Trendy wśród konkurentów Databricks
W ramach moich badań zebrałem niezliczone aktualizacje produktów, informacje prasowe i dzienniki wydań od różnych dostawców konkurencyjnych wobec Databricks. Oto niektóre z pojawiających się trendów, które obserwuję:
- Analityka w czasie rzeczywistym: Firmy coraz częściej oczekują wglądu w dane w czasie rzeczywistym. Dostawcy ulepszają swoje platformy, aby przetwarzać i analizować dane w czasie rzeczywistym, umożliwiając użytkownikom podejmowanie natychmiastowych decyzji. Rozwiązania takie jak Google BigQuery wprowadzają funkcje obsługujące strumieniowanie danych w czasie rzeczywistym.
- Analityka rozszerzona: Ten trend obejmuje wykorzystanie sztucznej inteligencji i uczenia maszynowego do usprawniania procesów analizy danych. Zyskuje popularność, ponieważ pomaga użytkownikom odkrywać wnioski bez konieczności wykonywania pracy ręcznej. Przykładem jest IBM Watson Studio, oferujące możliwości analityki rozszerzonej w celu automatyzacji analizy danych.
- Demokratyzacja danych: Coraz więcej platform koncentruje się na udostępnianiu danych użytkownikom nietechnicznym. Trend ten ma kluczowe znaczenie dla budowania kultury opartej na danych w organizacjach. Opracowywane są narzędzia z intuicyjnymi interfejsami i funkcjami samoobsługowymi, takimi jak te dostępne w Alteryx.
- Ład danych: Wraz z zaostrzaniem przepisów dotyczących prywatności danych funkcje zarządzania danymi zyskują na znaczeniu. Dostawcy integrują narzędzia do zarządzania danymi, aby pomagać użytkownikom w przestrzeganiu przepisów i odpowiedzialnym zarządzaniu danymi. Przykładowo Azure Synapse Analytics oferuje wbudowane funkcje zarządzania danymi.
- Obsługa chmury hybrydowej: Wiele firm chce zachować elastyczność w strategiach chmurowych. Obsługa chmury hybrydowej zyskuje na popularności, umożliwiając użytkownikom zarządzanie danymi zarówno w środowiskach lokalnych, jak i chmurowych. Cloudera przewodzi temu trendowi, oferując rozwiązania obsługujące wdrożenia w chmurze hybrydowej.
Czym jest konkurent Databricks?
Konkurenci Databricks to rozwiązania programowe zaprojektowane do przetwarzania danych oraz zapewniania możliwości analitycznych i uczenia maszynowego. Z narzędzi tych korzystają zazwyczaj analitycy danych, inżynierowie i analitycy, aby uzyskiwać wnioski oraz wspierać podejmowanie decyzji biznesowych.
Funkcje analityki w czasie rzeczywistym, analityki rozszerzonej i zarządzania danymi pomagają w wydajnym przetwarzaniu danych, odkrywaniu wniosków i odpowiedzialnym zarządzaniu danymi. Ogólnie rzecz biorąc, narzędzia te umożliwiają firmom wykorzystywanie danych w celu usprawnienia podejmowania decyzji i planowania strategicznego.
Funkcje konkurenta Databricks
Wybierając konkurenta Databricks, zwróć uwagę na następujące kluczowe funkcje:
- Analiza w czasie rzeczywistym: Umożliwia natychmiastowe przetwarzanie danych i uzyskiwanie wniosków, pozwalając szybko podejmować decyzje biznesowe.
- Analiza rozszerzona: Wykorzystuje sztuczną inteligencję do automatyzacji analizy danych, pomagając odkrywać wnioski bez ręcznego wysiłku.
- Zarządzanie danymi: Zapewnia zgodność z przepisami dotyczącymi prywatności danych i odpowiedzialne zarządzanie danymi.
- Obsługa chmury hybrydowej: Umożliwia zarządzanie danymi zarówno w środowiskach lokalnych, jak i chmurowych, zapewniając elastyczność.
- Interaktywna współpraca: Ułatwia pracę zespołową, zapewniając współdzielone obszary robocze i narzędzia do wspólnej analizy danych.
- Automatyczne skalowanie: Dostosowuje zasoby do obciążenia, optymalizując wydajność bez konieczności ręcznej ingerencji.
- Integracja uczenia maszynowego: Oferuje wbudowane funkcje uczenia maszynowego umożliwiające zaawansowane prognozy i uzyskiwanie wniosków na podstawie danych.
- Możliwość dostosowania: Umożliwia personalizację przepływów pracy i pulpitów nawigacyjnych zgodnie z konkretnymi potrzebami i procesami zespołu.
- Zabezpieczenia: Zapewnia funkcje szyfrowania i zgodności z przepisami w celu ochrony poufnych danych.
- Przyjazny dla użytkownika interfejs: Zapewnia łatwość obsługi, skracając czas nauki i zwiększając wdrożenie rozwiązania w zespole.
Korzyści z rozwiązania konkurencyjnego wobec Databricks
Wdrożenie rozwiązania konkurencyjnego wobec Databricks zapewnia zespołowi i firmie wiele korzyści. Oto kilka z nich:
- Lepsze podejmowanie decyzji: Analiza w czasie rzeczywistym i analiza rozszerzona zapewniają natychmiastowe wnioski, poprawiając zdolność zespołu do podejmowania decyzji.
- Lepsza współpraca: Funkcje interaktywnej współpracy umożliwiają zespołowi skuteczną wspólną pracę, prowadząc do bardziej spójnych projektów związanych z danymi.
- Skalowalność: Automatyczne skalowanie pozwala systemowi efektywnie obsługiwać wzrost ilości danych bez ręcznych zmian.
- Efektywność kosztowa: Modele cenowe oparte na płatności za wykorzystanie zapewniają, że płacisz tylko za używane zasoby, optymalizując zarządzanie budżetem.
- Lepsze bezpieczeństwo: Wbudowane zabezpieczenia chronią dane i zapewniają zgodność ze standardami branżowymi.
- Elastyczność: Obsługa chmury hybrydowej zapewnia elastyczność zarządzania danymi w różnych środowiskach, dostosowując się do potrzeb firmy.
- Dostosowanie: Możliwość dostosowania funkcji pozwala dopasować przepływy pracy i pulpity nawigacyjne do konkretnych wymagań, zwiększając produktywność.
Koszty i ceny rozwiązania konkurencyjnego wobec Databricks
Wybór rozwiązania konkurencyjnego wobec Databricks wymaga zrozumienia różnych dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i innych czynników. Poniższa tabela zawiera podsumowanie typowych planów, ich średnich cen oraz standardowych funkcji uwzględnianych w rozwiązaniach konkurencyjnych wobec Databricks:
Tabela porównawcza planów rozwiązania konkurencyjnego wobec Databricks
| Rodzaj planu | Średnia cena | Typowe funkcje |
| Plan bezpłatny | $0 | Podstawowe przetwarzanie danych, ograniczona przestrzeń dyskowa i wsparcie społeczności. |
| Plan osobisty | $10-$30 /użytkownik /miesiąc | Rozszerzona analityka danych, osobiste pulpity nawigacyjne i wsparcie przez pocztę elektroniczną. |
| Plan biznesowy | $50-$100 /użytkownik /miesiąc | Zaawansowane narzędzia analityczne, funkcje współpracy zespołowej i priorytetowe wsparcie. |
| Plan dla przedsiębiorstw | $150-$300/użytkownik /miesiąc | Niestandardowe integracje, dedykowane zarządzanie kontem i zabezpieczenia klasy korporacyjnej. |
Najczęściej zadawane pytania dotyczące konkurentów Databricks
Oto odpowiedzi na często zadawane pytania dotyczące konkurenta Databricks:
Kto jest największym konkurentem Databricks?
Snowflake jest często uznawany za największego konkurenta Databricks ze względu na podobne możliwości chmurowej platformy danych. Oba rozwiązania oferują rozbudowane funkcje przetwarzania i analizy danych, ale Snowflake jest znany ze swoich mocnych stron w zakresie hurtowni danych. W zależności od konkretnych potrzeb każde z tych rozwiązań może być dobrym wyborem.
Co zastąpi Databricks?
Chociaż żadne pojedyncze narzędzie nie jest przeznaczone do zastąpienia Databricks, alternatywy takie jak SQL Server oferują atrakcyjne funkcje. SQL Server dobrze integruje się z narzędziami do analizy danych, takimi jak Power BI, zapewniając solidny system zarządzania relacyjnymi bazami danych. Wybór będzie zależeć od konkretnych wymagań dotyczących przetwarzania danych.
Jakie są ograniczenia Databricks?
Databricks ma pewne ograniczenia, takie jak limity liczby widżetów w notesie oraz liczby znaków w nazwach i danych wejściowych widżetów. Ograniczenia te mogą wpływać na sposób projektowania notesów i interakcji z danymi, dlatego należy je uwzględnić, jeśli mają wpływ na przepływy pracy.
Kim są konkurenci Amazon Databricks?
Amazon Databricks konkuruje z platformami takimi jak Snowflake, które oferują podobne możliwości przetwarzania danych. Snowflake zapewnia chmurowe rozwiązanie hurtowni danych, powszechnie cenione za skalowalność i łatwość obsługi, dzięki czemu jest silnym konkurentem na rynku.
Jak ceny Databricks wypadają na tle konkurencji?
Ceny Databricks mogą znacznie się różnić w zależności od sposobu użytkowania i dostępnych funkcji. Ważne jest porównanie ich z cenami konkurentów, takich jak Snowflake i Google BigQuery, z uwzględnieniem czynników takich jak przechowywanie danych, koszty przetwarzania i dodatkowe funkcje. Oceń strukturę cenową każdej platformy, aby znaleźć rozwiązanie najlepiej dopasowane do swojego budżetu.
Jakich funkcji należy szukać u konkurenta Databricks?
Oceniając konkurentów Databricks, szukaj funkcji takich jak analiza w czasie rzeczywistym, integracja z uczeniem maszynowym i zarządzanie danymi. Możliwości te usprawniają przetwarzanie i analizę danych, zapewniając wartość Twojemu zespołowi. Uwzględnij konkretne potrzeby biznesowe, aby określić, które funkcje mają największe znaczenie.