

Znalezienie odpowiedniego narzędzia do zarządzania danymi testowymi może być trudnym zadaniem. Przy tak wielu dostępnych opcjach trudno określić, które z nich rzeczywiście spełnia Twoje potrzeby, bez marnowania cennego czasu lub zasobów. Jeśli napotykasz problemy z narzędziami, które są zbyt skomplikowane, nie skalują się wraz z rozwojem projektów lub nie spełniają wymogów dotyczących prywatności danych, nie jesteś sam. Dobre narzędzie do zarządzania danymi testowymi powinno usprawniać tworzenie, zarządzanie i zabezpieczanie zbiorów danych, a jednocześnie bezproblemowo integrować się z procesami testowania.
Jako specjalista ds. testowania oprogramowania z praktycznym doświadczeniem w pracy z dziesiątkami narzędzi spotkałem się z tymi samymi wyzwaniami, przed którymi stoisz, i udało mi się je przezwyciężyć. Dlatego stworzyłem ten przewodnik: aby uprościć proces wyszukiwania i przedstawić wyselekcjonowaną listę najlepszych dostępnych obecnie narzędzi do zarządzania danymi testowymi. Niezależnie od tego, czy najważniejsze są dla Ciebie automatyzacja, zgodność z przepisami czy skalowalność, ten wpis pomoże Ci podjąć świadomą decyzję.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza narzędzi do zarządzania danymi testowymi
Poniższa tabela porównuje szczegóły cenowe moich najlepszych narzędzi do zarządzania danymi testowymi.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para la trazabilidad del ciclo de vida dirigida por ingeniería | Prueba gratuita + demostración gratuita disponibles | Precios bajo solicitud | Website | |
| 2 | Najlepszy wybór do syntetycznych danych testowych natywnie obsługujących CI/CD | Dostępna bezpłatna wersja demonstracyjna | Ceny dostępne na żądanie | Website | |
| 3 | Najlepszy wybór w przypadku scentralizowanego zarządzania danymi testowymi niezależnego od wolumenu | Bezpłatny 14-dniowy okres próbny | Od €15,000/użytkownika/roku (rozliczane rocznie) | Website | |
| 4 | Najlepsze rozwiązanie do zarządzania danymi testowymi w całym cyklu życia z klonowaniem baz danych | Dostępna jest bezpłatna demonstracja | Ceny dostępne na życzenie | Website | |
| 5 | Najlepszy do maskowania danych testowych obejmującego środowiska mainframe | Niedostępne | Ceny dostępne na żądanie | Website | |
| 6 | Najlepsze tworzenie podzbiorów z wielu baz danych w regulowanych branżach | Dostępna bezpłatna prezentacja | Cena ustalana na żądanie | Website | |
| 7 | Najlepsze do klonowania baz danych w stylu Git w pięciu silnikach | Dostępne bezpłatne demo | Cena na zapytanie | Website | |
| 8 | Najlepsze rozwiązanie do wirtualizacji kompletnych klonów produkcyjnych baz danych | Dostępna bezpłatna prezentacja | Od 36 000 $ za TB rocznie (rozliczane rocznie) | Website | |
| 9 | Najlepsze rozwiązanie do natywnego dla SAP maskowania danych testowych | 14-dniowy bezpłatny okres próbny | Od $12.00 za godzinę korzystania z kontenera | Website | |
| 10 | Najlepsze rozwiązanie do testowania z wykorzystaniem sztucznej inteligencji | 14-dniowy bezpłatny okres próbny + bezpłatna prezentacja | Ceny na życzenie | Website |




Recenzje najlepszych narzędzi do zarządzania danymi testowymi
Poniżej znajdziesz moje szczegółowe podsumowania najlepszych narzędzi do zarządzania danymi testowymi, które znalazły się na mojej krótkiej liście. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety & wady, integracje i idealne przypadki użycia każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Ideal para la trazabilidad del ciclo de vida dirigida por ingeniería
- Prueba gratuita + demostración gratuita disponibles
- Precios bajo solicitud
Visit WebsiteCustomer Rating:4.3/5
Cradle visualiza el impacto de la trazabilidad de los requisitos en los elementos vinculados. Cradle es una herramienta de gestión de requisitos e ingeniería de sistemas que abarca la documentación de requisitos, la trazabilidad del ciclo de vida, el modelado, la gestión de pruebas y el seguimiento de defectos en una única base de datos.
¿Para quién es más adecuado Cradle?
Cradle es una opción sólida para ingenieros de sistemas y responsables de ingeniería del sector aeroespacial, de defensa y gubernamental que necesitan una trazabilidad rigurosa del ciclo de vida, desde los requisitos hasta las pruebas y la entrega.
Por qué elegí Cradle
He incluido Cradle entre mis principales opciones porque gestiona la trazabilidad del ciclo de vida de forma más exhaustiva que casi cualquier otra herramienta de esta categoría. Sus enlaces transitivos bidireccionales conectan los requisitos con las pruebas, los riesgos, los modelos y los registros de defectos en una única base de datos, de modo que los responsables de ingeniería pueden ver en tiempo real el impacto de cualquier cambio en un requisito en toda la jerarquía del proyecto. Me gusta especialmente cómo su Cargador de documentos incorpora archivos de Word y Excel como jerarquías de requisitos estructuradas, lo que resulta práctico para los equipos que heredan documentación antigua de programas aeroespaciales o de defensa.
Características principales de Cradle
- Cargador de documentos: Incorpora archivos de Word y Excel y los convierte en conjuntos de requisitos estructurados y jerárquicos, conservando figuras, tablas y texto enriquecido.
- Esquema definido por el usuario: Permite configurar sus propios tipos de elementos, atributos y relaciones mediante una interfaz de apuntar y hacer clic, sin necesidad de programación.
- Paneles de control Cradle-DASH: Muestra métricas de KPI como tablas visuales y diales, incluidas métricas de riesgo, para que los responsables de ingeniería puedan supervisar el estado del proyecto de un vistazo.
- Procesos configurables de revisión y cambio: Configura flujos de trabajo formales de aprobación con notificaciones por correo electrónico y acceso basado en roles para cada grupo de partes interesadas.
Integraciones de Cradle
Cradle admite integraciones documentadas con Microsoft Word, Microsoft Excel y Microsoft Project, además de la importación y exportación mediante CSV, XML y ReqIF. Sus API, interfaces de comandos y mecanismos de eventos permiten realizar integraciones personalizadas.
Pros and Cons
Pros:
- Trazabilidad del ciclo de vida entre requisitos y pruebas
- Las líneas base y los registros de auditoría respaldan los cambios regulados
- Los esquemas personalizados se adaptan a los flujos de trabajo de ingeniería
Cons:
- El bloqueo asíncrono limita los comentarios del equipo
- El enfoque en la ingeniería de sistemas puede resultar abrumador para los responsables de proyectos
Learn more about Tonic: Najlepszy wybór do syntetycznych danych testowych natywnie obsługujących CI/CD
- Dostępna bezpłatna wersja demonstracyjna
- Ceny dostępne na żądanie
Visit WebsiteCustomer Rating:4.6/5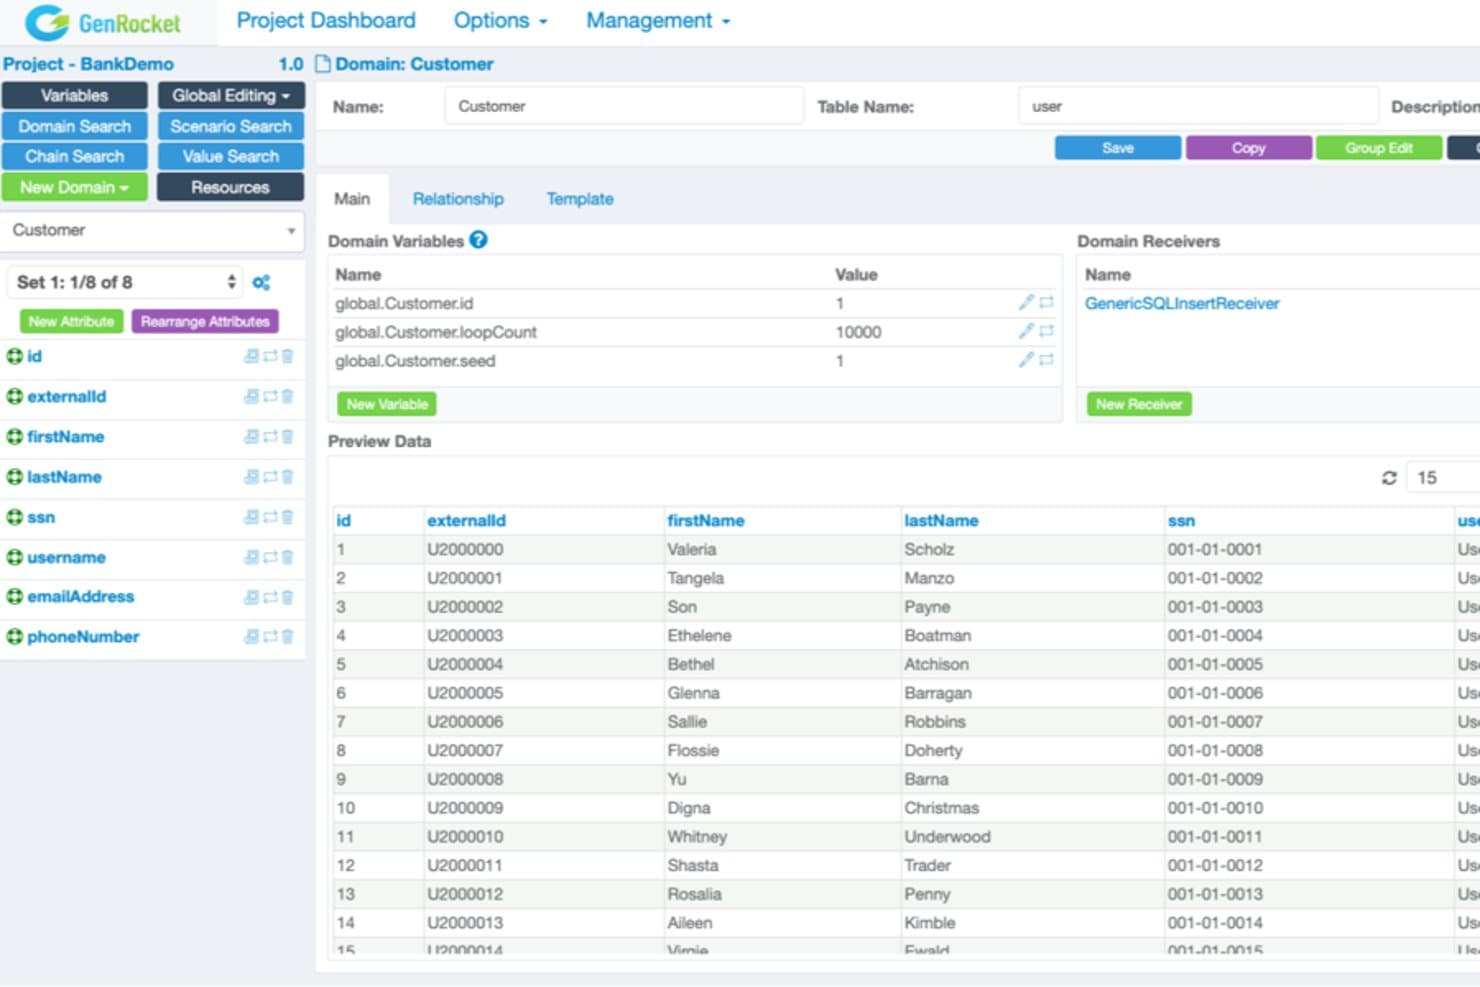
GenRocket pozwala użytkownikom wizualnie wyświetlać podgląd domen danych testowych i je konfigurować. GenRocket to platforma do zarządzania syntetycznymi danymi testowymi, która generuje dane w czasie rzeczywistym na podstawie metadanych i schematów, obejmując maskowanie danych, inteligentne podzbiory danych, wyjście w wielu formatach oraz samoobsługowe udostępnianie danych w potokach CI/CD.
Dla kogo GenRocket jest najlepszym wyborem?
GenRocket doskonale sprawdzi się w zespołach QA i DevOps, które potrzebują generowanych na żądanie syntetycznych danych testowych bezpośrednio w potokach CI/CD, bez konieczności dotykania danych produkcyjnych.
Dlaczego wybrałem GenRocket
GenRocket znalazł się na mojej krótkiej liście, ponieważ jest jedyną znaną mi platformą danych testowych stworzoną specjalnie do generowania syntetycznych danych w czasie rzeczywistym, bezpośrednio w potoku CI/CD i bez konieczności dotykania danych produkcyjnych. Jej opatentowany silnik integralności referencyjnej zapewnia spójność danych w wielu schematach i bazach danych jednocześnie, co jest naprawdę rzadko spotykane. Podoba mi się również to, że każdy zestaw danych dla przypadku testowego jest generowany w czasie zaledwie 100 milisekund, dzięki czemu wykonanie potoku nie zatrzymuje się w oczekiwaniu na udostępnienie danych.
Najważniejsze funkcje GenRocket
- Wykrywanie zmian schematu G-Delta: Automatycznie identyfikuje zmiany schematów baz danych MySQL, MS SQL, Oracle i PostgreSQL, a następnie uruchamia G-Refactor w celu zaktualizowania wszystkich powiązanych przypadków danych testowych.
- Maskowanie w miejscu: Zastępuje wrażliwe pola w bazach danych Oracle, MS SQL Server, IBM DB2, PostgreSQL i MySQL syntetycznie wygenerowanymi odpowiednikami, bez odczytywania rzeczywistych wartości produkcyjnych.
- Portal samoobsługowy G-Portal: Zapewnia deweloperom i testerom interfejs oparty na rolach, który umożliwia wyszukiwanie, zamawianie, śledzenie i pobieranie przypadków danych testowych bez angażowania centralnego zespołu danych przy każdym żądaniu.
- 750+ inteligentnych generatorów danych: Obejmuje praktycznie każdy typ danych, domenę lub regułę biznesową, w tym logikę warunkową, zależności między polami i ograniczenia wyrażeń regularnych.
Integracje GenRocket
GenRocket integruje się z Jenkins, Azure DevOps, TeamCity, CircleCI, GitHub, Cucumber, Selenium, JUnit, JMeter i LoadRunner. Obsługuje również REST API, JDBC, SOAP, gniazda TCP/IP oraz wdrażanie za pomocą Dockera na potrzeby niestandardowych przepływów pracy CI/CD.
Pros and Cons
Pros:
- Generowanie syntetycznych danych zachowuje integralność referencyjną
- Udostępnianie danych w czasie rzeczywistym na potrzeby potoków CI/CD
- Nieograniczona ilość danych bez cykli odświeżania
Cons:
- Brak maskowania zachowującego format ani odwracalnego
- Wykrywanie PII nie będzie w pełni dostępne do {{year}}
Learn more about GenRocket: Najlepszy wybór w przypadku scentralizowanego zarządzania danymi testowymi niezależnego od wolumenu
- Bezpłatny 14-dniowy okres próbny
- Od €15,000/użytkownika/roku (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5
Maskowanie danych pomaga chronić prywatność poufnych informacji klientów. DATPROF to platforma do zarządzania danymi testowymi, która łączy maskowanie danych, podzbiory danych, generowanie danych syntetycznych, wykrywanie danych PII, wirtualizację baz danych oraz scentralizowane udostępnianie danych z relacyjnych, nierelacyjnych i chmurowych źródeł danych.
Dla kogo DATPROF jest najlepszy?
DATPROF doskonale sprawdzi się w przypadku inżynierów danych i administratorów baz danych w średnich i dużych przedsiębiorstwach, którzy zarządzają złożonymi środowiskami obejmującymi wiele baz danych, gdzie integralność referencyjna i zgodność z przepisami są niepodlegającymi negocjacjom wymogami.
Dlaczego wybrałem DATPROF
Wybrałem DATPROF jako jedno z najlepszych rozwiązań, ponieważ jego model licencjonowania niezależny od wolumenu naprawdę wyróżnia go na tle konkurencji: koszt licencji pozostaje stały niezależnie od tego, czy maskujesz 500 GB, czy 100 TB, co ma znaczenie podczas tworzenia podzbioru produkcyjnej bazy danych, takiej jak baza o rozmiarze 23 TB, którą firma Heineken zmniejszyła do 130 GB. Opatentowane wykrywanie cykli kluczy obcych w DATPROF Subset obsługuje złożone schematy obejmujące wiele tysięcy tabel, zachowując integralność referencyjną między systemami. W połączeniu ze scentralizowaną orkiestracją za pośrednictwem portalu Runtime każdy członek zespołu może udostępnić sobie odświeżone środowisko bez oczekiwania na administratora bazy danych.
Najważniejsze funkcje DATPROF
- Deterministyczne maskowanie między systemami: Stosuje spójne zamaskowane wartości dla tych samych danych wejściowych jednocześnie w wielu bazach danych, zachowując integralność referencyjną na potrzeby kompleksowego śledzenia testów.
- Wykrywanie i profilowanie danych PII: Skanuje bazy danych w celu automatycznego identyfikowania miejsc przechowywania danych wrażliwych, oferując obsługę niestandardowych reguł wykrywania opartych na wyrażeniach regularnych lub wyrażeniach wykorzystujących listy.
- Portal samoobsługowego udostępniania: Umożliwia testerom i programistom logowanie się do DATPROF Runtime i samodzielne odświeżanie własnych środowisk testowych bez oczekiwania na administratora bazy danych.
- Klonowanie baz danych z kopiowaniem przy zapisie: DATPROF Virtualize uruchamia wirtualne środowiska baz danych o pełnym rozmiarze bez zużywania dodatkowej przestrzeni dyskowej, a przywracanie migawek jest kończone w czasie krótszym niż 20 sekund.
Integracje DATPROF
DATPROF obsługuje integracje CI/CD z Jenkins, Azure DevOps, GitLab i Bamboo, a także integracje z narzędziami do automatyzacji testów Parasoft i Tosca. Jego interfejs API REST obsługuje niestandardowe integracje, a oferty w marketplace są dostępne za pośrednictwem Azure Marketplace i AWS Marketplace.
Pros and Cons
Pros:
- Maskowanie zachowuje integralność referencyjną między bazami danych
- Tworzenie podzbiorów skutecznie zmniejsza ogromne produkcyjne zbiory danych
- Portal internetowy oparty na rolach do samoobsługowego odświeżania
Cons:
- Ograniczona natywna obsługa źródeł danych SaaS
- Brak obsługi komputerów mainframe i szerszej gamy nierelacyjnych baz danych
Learn more about DATPROF: Najlepsze rozwiązanie do zarządzania danymi testowymi w całym cyklu życia z klonowaniem baz danych
- Dostępna jest bezpłatna demonstracja
- Ceny dostępne na życzenie

Enov8 zapewnia kadrze kierowniczej szybki wgląd w dane osobowe we wszystkich źródłach danych. Enov8 to platforma do zarządzania danymi testowymi, która obejmuje cały cykl życia TDM, w tym profilowanie danych oparte na sztucznej inteligencji, maskowanie, podzbiory, generowanie danych syntetycznych oraz wirtualizację baz danych za pośrednictwem silnika klonowania vME.
Dla kogo Enov8 jest najlepszym rozwiązaniem?
Enov8 doskonale sprawdzi się w zespołach DevOps i QA działających w branżach regulowanych, które potrzebują jednej platformy do jednoczesnej obsługi maskowania, podzbiorów, danych syntetycznych i wirtualizacji baz danych.
Dlaczego wybrałem Enov8
Wybrałem Enov8 jako jedno z najlepszych rozwiązań, ponieważ jest to jedyne narzędzie na mojej liście, które łączy kompleksowe zarządzanie danymi testowymi w całym cyklu życia z silnikiem klonowania baz danych vME. Silnik ten tworzy realistyczne kopie baz produkcyjnych o rozmiarze około 40 MB na klon, niezależnie od rozmiaru źródła. Podoba mi się, że maskowanie, tworzenie podzbiorów i generowanie danych syntetycznych są bezpośrednio zintegrowane z warstwą wirtualizacji, dzięki czemu klony są już bezpieczne pod względem prywatności, zanim trafią do środowiska testowego.
Najważniejsze funkcje Enov8
- Wykrywanie danych osobowych oparte na sztucznej inteligencji: Silnik profilowania wykorzystujący uczenie maszynowe automatycznie skanuje podłączone źródła danych, aby klasyfikować wrażliwe pola i oznaczać kolumny wiążące się z ryzykiem regulacyjnym przed rozpoczęciem maskowania.
- Rezerwowanie danych testowych: Wbudowany system rezerwacji umożliwia zespołom centralne rezerwowanie zbiorów danych i zarządzanie nimi, zapobiegając konfliktom między jednoczesnymi użytkownikami i środowiskami.
- Skan walidacyjny po maskowaniu: Walidacja oparta na uczeniu maszynowym potwierdza skuteczność maskowania po każdym przebiegu zabezpieczania i generuje gotowe do audytu dowody zgodności.
- Centrum integracji DevOps Manager: Niezależna od języka warstwa orkiestracji, w której przechowywane są skrypty automatyzacji w Pythonie, Bashu, Ansible, Javie i innych językach, łącząca Enov8 z potokami CI/CD w Jenkins, GitLab CI/CD i Azure DevOps.
Integracje Enov8
Enov8 obsługuje ponad 100 integracji, w tym Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy i Ansible. Jego interfejs REST API, webhooki, harmonogram oraz DevOps Manager umożliwiają tworzenie niestandardowych przepływów pracy CI/CD.
Pros and Cons
Pros:
- Wirtualizacja baz danych z niewielkimi klonami o rozmiarze 40 MB
- Wykrywanie danych osobowych i walidacja maskowania oparte na sztucznej inteligencji
- Centralna rezerwacja danych testowych zapobiega konfliktom przydziałów
Cons:
- Liczba publicznych recenzji jest stosunkowo niewielka
- Nie wymieniono zaświadczeń dotyczących zgodności wydanych przez podmioty zewnętrzne
Learn more about Enov8: Najlepszy do maskowania danych testowych obejmującego środowiska mainframe
- Niedostępne
- Ceny dostępne na żądanie

Broadcom Test Data Manager śledzi statusy zadań importu w jednym widoku. Broadcom Test Data Manager to korporacyjna platforma do zarządzania danymi testowymi, która łączy maskowanie danych, generowanie danych syntetycznych, podzbiory danych, wykrywanie danych PII, wirtualizację baz danych i samoobsługowe udostępnianie — z dedykowaną obsługą środowisk mainframe obok nowoczesnych rozproszonych i chmurowych baz danych.
Dla kogo najlepiej nadaje się Broadcom Test Data Manager?
Z platformy najwięcej korzyści odniosą duże przedsiębiorstwa, które korzystają ze środowisk mainframe wraz z nowoczesnymi systemami rozproszonymi.
Dlaczego wybrałem Broadcom Test Data Manager
Broadcom Test Data Manager znalazł się wśród moich najlepszych propozycji, ponieważ jest to jedyna znana mi platforma, która traktuje środowiska mainframe jako pełnoprawny element obok nowoczesnych systemów rozproszonych. Dedykowany moduł CA TDM for Mainframe umożliwia maskowanie i tworzenie podzbiorów danych w systemach z/OS, VSAM i IMS za pomocą tego samego interfejsu, którego używa się w przypadku SQL Server lub Oracle. Zautomatyzowana mapa cieplna PII skanuje całe schematy mainframe i oznacza pola wrażliwe, zanim zastosujesz choćby jedną regułę maskowania, co ogranicza ręczne mapowanie, które zwykle spowalnia pracę zespołów ds. zgodności.
Najważniejsze funkcje Broadcom Test Data Manager
- Samoobsługowy portal danych: Scentralizowany katalog, w którym testerzy mogą na żądanie za pomocą dynamicznych formularzy zamawiać, rezerwować i zwalniać dane testowe bez oczekiwania na administratorów baz danych.
- Wirtualizacja baz danych DAVE: Mechanizm klonowania oparty na kopiowaniu przy zapisie, który w ciągu kilku minut tworzy niezależne klony baz danych ze współdzielonego obrazu bazowego przy minimalnym narzucie pamięci masowej.
- Automatyzacja procesów Javelin: Wbudowany wizualny silnik automatyzacji, który koordynuje zadania maskowania, tworzenia podzbiorów i udostępniania oraz może być uruchamiany za pośrednictwem interfejsu REST API lub potoków CI/CD.
- Zachowanie integralności referencyjnej: Operacje maskowania i tworzenia podzbiorów zachowują relacje między tabelami, dzięki czemu zestawy danych testowych pozostają spójne funkcjonalnie na potrzeby testów kompleksowych.
Integracje Broadcom Test Data Manager
Udokumentowane integracje obejmują Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM i CA Agile Central. Interfejsy REST API obsługują niestandardowe przepływy pracy CI/CD, a Docker i Kubernetes umożliwiają wdrażanie w kontenerach.
Pros and Cons
Pros:
- Maskowanie danych testowych obejmujące środowiska mainframe
- Zautomatyzowane wykrywanie PII i mapy cieplne
- Wirtualizacja baz danych oparta na kopiowaniu przy zapisie (DAVE)
Cons:
- Brak dostępnej opcji wdrożenia SaaS
- Interfejs użytkownika sprawia wrażenie przestarzałego i złożonego
Learn more about Broadcom Test Data Manager: Najlepsze tworzenie podzbiorów z wielu baz danych w regulowanych branżach
- Dostępna bezpłatna prezentacja
- Cena ustalana na żądanie

IBM InfoSphere Optim pomaga szybko tworzyć dane testowe. IBM Test Data Management to korporacyjne rozwiązanie do zarządzania danymi testowymi, obejmujące maskowanie danych, tworzenie podzbiorów danych z wielu baz danych oraz udostępnianie danych na żądanie z szerokiego zakresu relacyjnych i mainframe'owych źródeł danych.
Dla kogo IBM Test Data Management jest najlepszym rozwiązaniem?
IBM Test Data Management to doskonały wybór dla dużych przedsiębiorstw z regulowanych branż — usług finansowych, ochrony zdrowia i ubezpieczeń — działających w złożonych środowiskach obejmujących wiele baz danych lub systemy mainframe, w których maskowanie danych i tworzenie podzbiorów z wielu baz danych są wymogami zgodności.
Dlaczego wybrałem IBM Test Data Management
IBM Test Data Management znalazł się na mojej krótkiej liście ze względu na sposób, w jaki obsługuje tworzenie podzbiorów z wielu baz danych na poziomie obiektów biznesowych, pobierając jednocześnie podzbiory zachowujące integralność referencyjną z wielu połączonych baz danych. Szczególnie imponują mi jego możliwości federacyjnego pozyskiwania danych, które pozwalają zespołom pracować w heterogenicznych środowiskach danych, w tym ze źródłami mainframe, takimi jak VSAM i IMS, gdzie niemal żadne konkurencyjne narzędzie nie działa. Ponad 40 wstępnie zdefiniowanych reguł maskowania z zachowaniem formatu sprawia, że rozwiązanie to jest naprawdę użyteczne w środowiskach podlegających regulacjom GDPR i HIPAA.
Najważniejsze funkcje IBM Test Data Management
- Integracja z Governance Catalog: Reguły klasyfikacji danych można przeciągać i upuszczać bezpośrednio na mapy kolumn, aby automatycznie przypisywać procedury maskowania z centralnego katalogu zasad.
- Środowisko uruchomieniowe Apache Spark: Wbudowany silnik Spark obsługuje przetwarzanie danych na dużą skalę w ramach zautomatyzowanych przepływów pracy związanych z tworzeniem podzbiorów i maskowaniem.
- Kontrola dostępu oparta na rolach: Mechanizm RBAC oparty na Keycloak, z obsługą LDAP, SAML, OIDC i Kerberos, kontroluje, kto może uzyskiwać dostęp do testowych zbiorów danych, żądać ich oraz je odświeżać.
- Raportowanie zgodności: Wbudowane raporty weryfikują egzekwowanie zasad ochrony prywatności danych w środowiskach podlegających regulacjom GDPR i HIPAA.
Integracje IBM Test Data Management
Udokumentowane integracje obejmują IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark oraz bazy danych, takie jak Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza i ograniczoną obsługę MongoDB. Jego interfejs API REST OpenAPI 2.0 obsługuje niestandardową orkiestrację i przepływy pracy CI/CD, a edycja z/OS łączy się z VSAM i IMS.
Pros and Cons
Pros:
- Zachowuje integralność referencyjną między bazami danych
- Maskowanie z zachowaniem formatu obsługuje dane podlegające regulacjom
- Obsługuje podzbiory VSAM i IMS
Cons:
- Brak natywnego generowania danych syntetycznych
- Kopie fizyczne zastępują klonowanie wirtualne
Learn more about IBM Test Data Management: Najlepsze do klonowania baz danych w stylu Git w pięciu silnikach
- Dostępne bezpłatne demo
- Cena na zapytanie

Redgate SQL Provision umożliwia użytkownikom zarządzanie klonami baz danych w wielu instancjach SQL. Redgate SQL Provision to narzędzie do zarządzania danymi testowymi, obejmujące maskowanie danych, tworzenie podzbiorów oraz klonowanie baz danych w stylu Git dla SQL Server, PostgreSQL, MySQL, MariaDB i Oracle.
Dla kogo Redgate SQL Provision jest najlepszym wyborem?
Redgate SQL Provision to dobre rozwiązanie dla administratorów baz danych i inżynierów kontroli jakości, którzy potrzebują szybkiego klonowania i maskowania baz danych w wielu relacyjnych silnikach, z kontrolą wersji.
Dlaczego wybrałem Redgate SQL Provision
Wybrałem Redgate SQL Provision jako jedno z najlepszych rozwiązań, ponieważ jego klonowanie baz danych w stylu Git naprawdę różni się od wszystkiego, co widziałem w przypadku pięciu silników. Redgate Clone uruchamia kontener z aktywnymi danymi w ciągu kilku sekund, niezależnie od rozmiaru bazy danych, dzięki czemu baza SQL Server o rozmiarze 5 TB jest udostępniana równie szybko jak baza o rozmiarze 128 MB. Możesz tworzyć gałęzie, resetować je i zapisywać wersje tak jak w procesie pracy z Gitem, co ułatwia zapewnienie każdemu testerowi własnego odizolowanego środowiska bez powielania pamięci masowej.
Najważniejsze funkcje Redgate SQL Provision
- Narzędzie Anonymize w wierszu poleceń (
rganonymize): Trzystopniowe narzędzie wiersza poleceń, które klasyfikuje kolumny zawierające dane osobowe, mapuje reguły maskowania i zastępuje rzeczywiste wartości w SQL Server, PostgreSQL, MySQL, MariaDB i Oracle. - Deterministyczne maskowanie: Maskuje tę samą wartość wejściową do tej samej wartości wyjściowej za każdym razem, używając stałego ziarna, dzięki czemu zamaskowane dane pozostają spójne w powiązanych tabelach.
- Tworzenie podzbiorów danych: Interfejs wiersza poleceń
rgsubsetpobiera konfigurowalną część źródłowej bazy danych — domyślnie 10% — i uwzględnia klucze obce, aby zachować integralność referencyjną. - Niestandardowe zestawy danych AI: Umożliwiają opisanie potrzebnych wartości w języku naturalnym i generują możliwą do sprawdzenia listę obejmującą do 1 000 wartości do wykorzystania przy podstawianiu podczas maskowania.
Integracje Redgate SQL Provision
Redgate SQL Provision integruje się z SQL Server, PostgreSQL, MySQL, MariaDB, Oracle, Docker, AWS CloudFormation, Azure Kubernetes Service, SQL Data Catalog, PowerShell i dbatools. Jego interfejsy wiersza poleceń obsługują skryptowane procesy CI/CD, ale natywne wtyczki Jenkins, Azure DevOps i GitHub Actions nie są udokumentowane.
Pros and Cons
Pros:
- Rozgałęzianie w stylu Git szybko odświeża bazy danych testowych
- Deterministyczne maskowanie zachowuje spójność między tabelami
- Tworzenie podzbiorów z uwzględnieniem kluczy obcych chroni integralność relacyjną
Cons:
- Generowanie danych syntetycznych kończy się na listach wartości
- Pozycjonowanie produktu powoduje niepewność kupujących
Learn more about Redgate SQL Provision: Najlepsze rozwiązanie do wirtualizacji kompletnych klonów produkcyjnych baz danych
- Dostępna bezpłatna prezentacja
- Od 36 000 $ za TB rocznie (rozliczane rocznie)
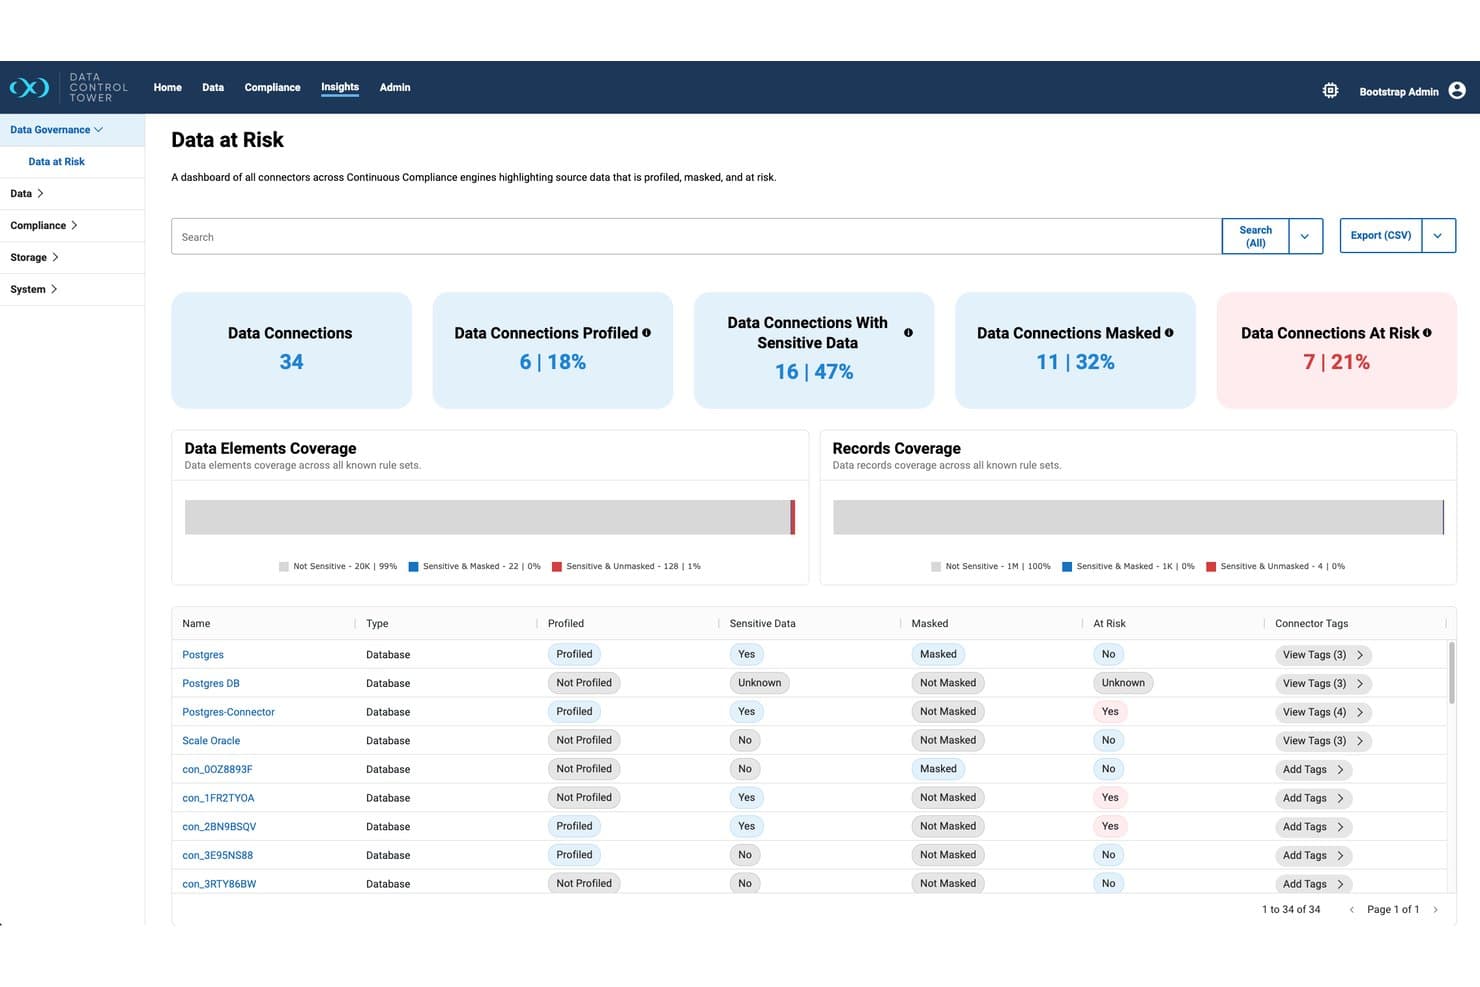
Perforce Delphix umożliwia szybkie śledzenie ryzyka związanego z danymi we wszystkich podłączonych źródłach. Perforce Delphix to platforma do zarządzania danymi testowymi, która łączy wirtualizację danych, automatyczne maskowanie, generowanie syntetycznych danych wspomagane przez sztuczną inteligencję oraz samoobsługowe udostępnianie danych z ponad 170 źródeł danych.
Dla kogo Perforce Delphix jest najlepszym wyborem?
Perforce Delphix to dobre rozwiązanie dla dużych przedsiębiorstw korzystających ze złożonych, wieloźródłowych środowisk baz danych, w których udostępnianie danych testowych przypominających dane produkcyjne na dużą skalę jest codzienną potrzebą operacyjną.
Dlaczego wybrałem Perforce Delphix
Perforce Delphix znalazł się na mojej krótkiej liście, ponieważ jego wirtualizacja danych oparta na mechanizmie kopiowania przy zapisie uruchamia kompletne klony baz danych identyczne z produkcyjnymi w ciągu kilku minut zamiast kilku dni — bez proporcjonalnego zwiększania zajętości pamięci masowej. Podoba mi się, że zespoły mogą wersjonować te wirtualne kopie tak jak kod, korzystając z Data Control Tower do tworzenia zakładek, cofania i rozgałęziania zbiorów danych między środowiskami na żądanie. W przypadku maskowania na dużą skalę funkcja Hyperscale Compliance przetwarza zadania równolegle w miliardach wierszy, zachowując integralność referencyjną między źródłami.
Najważniejsze funkcje Perforce Delphix
- Automatyczne wykrywanie danych wrażliwych: ASDD skanuje podłączone źródła i generuje inwentarz maskowania wraz ze wskaźnikami pewności oraz sugerowanymi algorytmami maskowania dla każdego zidentyfikowanego pola.
- Hyperscale Compliance: Równolegle przetwarza zadania maskowania w miliardach wierszy przy użyciu kontenerowego wykonywania, z myślą o bazach danych Oracle i SQL Server działających w skali przedsiębiorstwa.
- Szablony zasad zgodności: Gotowe profile dla RODO, HIPAA, PCI-DSS i CCPA pozwalają zespołom stosować reguły maskowania bez tworzenia zasad od podstaw.
- Integracja z potokami CI/CD: Natywna wtyczka Jenkins, dostawca Terraform i platforma automatyzacji o otwartym kodzie źródłowym łączą dostarczanie danych testowych bezpośrednio z istniejącymi potokami wdrażania.
Integracje Perforce Delphix
Perforce Delphix obsługuje ponad 170 źródeł danych, w tym Oracle, SQL Server, PostgreSQL, Salesforce, SAP HANA, AWS, Azure i Google Cloud. Oferuje natywne integracje z Jenkins i Terraform, łączność z Azure Data Factory i Azure Synapse, obsługę OpenShift, interfejsy API REST oraz platformę automatyzacji o otwartym kodzie źródłowym.
Pros and Cons
Pros:
- Natychmiast uruchamia pełnowymiarowe klony wirtualne
- Zachowuje integralność referencyjną podczas maskowania
- Scentralizowana samoobsługa i zarządzanie danymi
Cons:
- Brak podzbiorów na poziomie wierszy lub tabel
- Początkowa konfiguracja wymaga zaawansowanej wiedzy technicznej
Learn more about Perforce Delphix: Najlepsze rozwiązanie do natywnego dla SAP maskowania danych testowych
- 14-dniowy bezpłatny okres próbny
- Od $12.00 za godzinę korzystania z kontenera
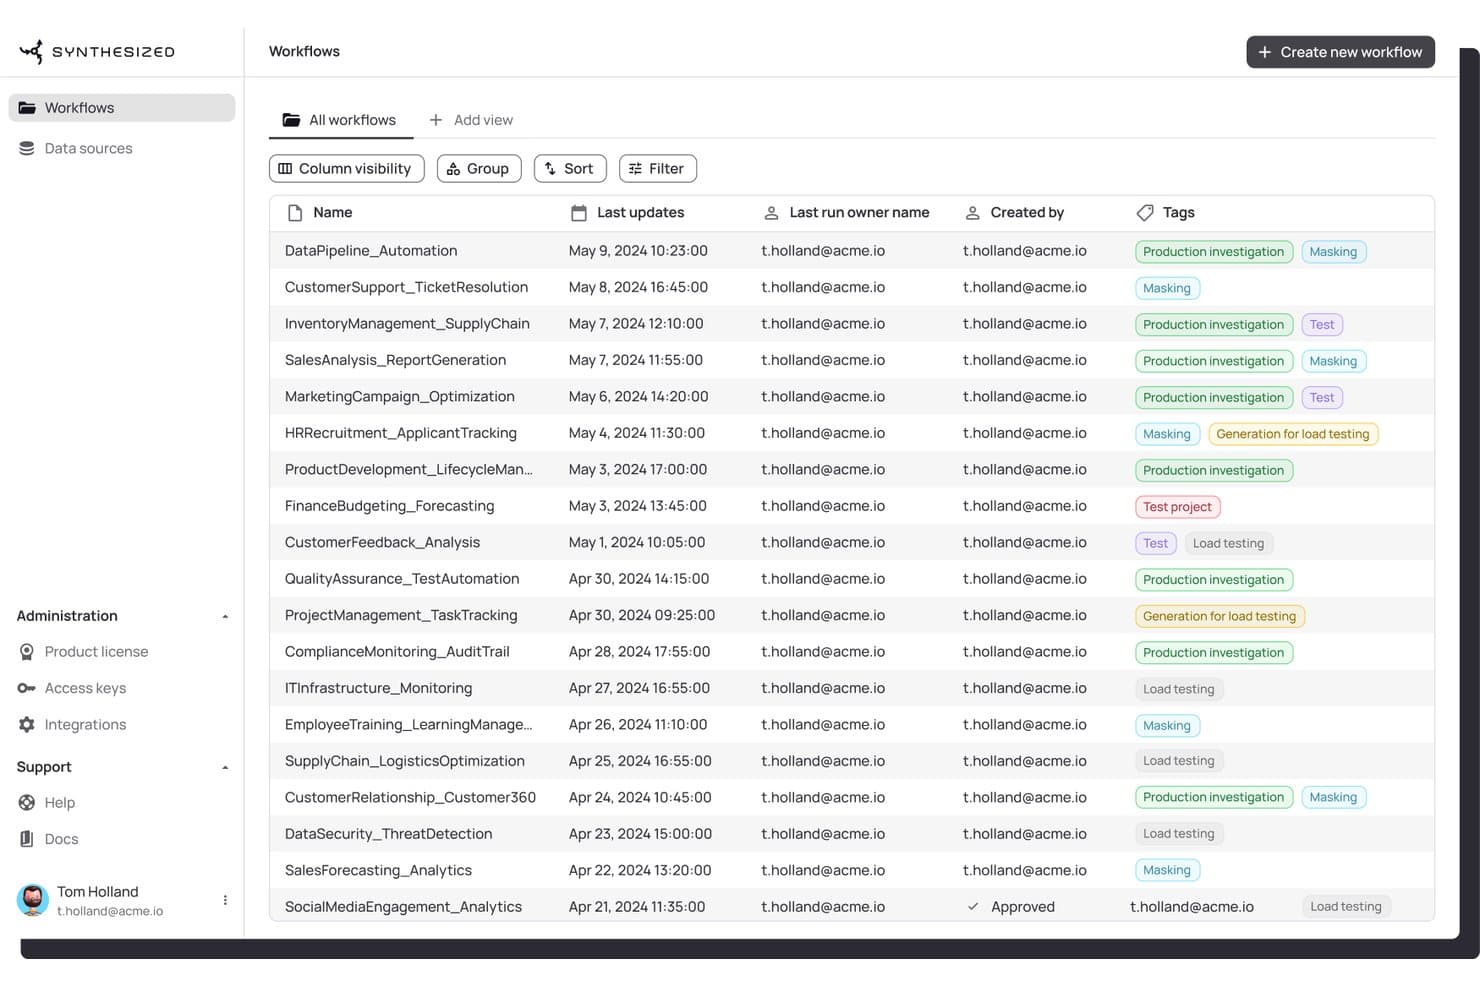
Synthesized organizuje przepływy pracy dotyczące danych testowych za pomocą znaczników i historii uruchomień. Synthesized to platforma zarządzania danymi testowymi przeznaczona dla środowisk korporacyjnych, oferująca maskowanie danych, wykrywanie danych osobowych (PII), generowanie danych syntetycznych, tworzenie podzbiorów danych oraz samoobsługowe udostępnianie danych w relacyjnych bazach danych i środowiskach aplikacyjnych SAP.
Dla kogo Synthesized jest najlepszym wyborem?
Synthesized to doskonałe rozwiązanie dla zespołów korporacyjnych korzystających ze środowisk SAP, które potrzebują zgodnych z przepisami danych testowych wiernie odwzorowujących środowisko produkcyjne w złożonych, wielomodułowych środowiskach.
Dlaczego wybrałem Synthesized
Synthesized znalazło się na mojej krótkiej liście ze względu na głębokie zrozumienie wewnętrznego modelu danych SAP. Większość narzędzi TDM traktuje SAP jak każdą inną bazę danych, ale Synthesized automatycznie mapuje wirtualne klucze obce między modułami SAP, co oznacza, że tworzenie podzbioru danych procesu od zamówienia do zapłaty nie pozostawia osieroconych rekordów, które zakłócałyby działanie zestawu testów regresji. Podoba mi się również to, że narzędzie zawiera gotowe szablony maskowania dla modułów charakterystycznych dla SAP, takich jak Ariba i SuccessFactors, dzięki czemu nie trzeba tworzyć zasad dotyczących danych osobowych od podstaw.
Najważniejsze funkcje Synthesized
- Automatyczne skanowanie danych osobowych (PII): Wbudowany skaner wykrywa dane wrażliwe w 28 kategoriach — w tym identyfikatory finansowe, dane uwierzytelniające i dane lokalizacyjne — za pomocą dopasowywania wzorców oraz algorytmów walidacyjnych.
- Konfiguracja „Dane jako kod”: Przepływy pracy dotyczące danych testowych definiuje się w języku YAML lub za pomocą języka DSL dla języka Python, co umożliwia kontrolę wersji opartą na Git oraz powtarzalne, możliwe do przeprowadzenia audytu udostępnianie zestawów danych w różnych środowiskach.
- Tworzenie podzbiorów na podstawie wartości procentowej: Użytkownicy mogą wyodrębniać wycinki danych produkcyjnych obejmujące 10%, 25% lub 50% danych, filtrowane według daty, identyfikatora lub niestandardowych warunków, przy zachowaniu pełnej integralności referencyjnej.
- Natywny dla Kubernetes skonteneryzowany silnik: Platforma jest wdrażana za pomocą wykresu Helm, Docker Compose, ECS lub EKS i obsługuje tworzenie efemerycznych podów z danymi testowymi w potokach opartych na kontenerach.
Integracje Synthesized
Synthesized oferuje natywne integracje z GitHub Actions, GitLab CI, Jenkins, Azure DevOps, Tricentis Tosca, UiPath Test Suite, Testcontainers, Apache Airflow i Prefect. Udostępnia również interfejs REST API oraz konektory do SAP HANA, PostgreSQL, Oracle, Snowflake, Salesforce, Workday i ServiceNow.
Pros and Cons
Pros:
- Natywne dla SAP przepływy pracy maskowania danych uwzględniające moduły
- Automatyczne skanowanie danych osobowych (PII) z możliwością dostosowywania kategorii
- Deterministyczne maskowanie zachowuje relacje między danymi
Cons:
- Brak obsługi baz NoSQL i komputerów mainframe
- Niezwykle ograniczona liczba publicznych opinii użytkowników
Learn more about Synthesized: Najlepsze rozwiązanie do testowania z wykorzystaniem sztucznej inteligencji
- 14-dniowy bezpłatny okres próbny + bezpłatna prezentacja
- Ceny na życzenie
Visit WebsiteCustomer Rating:4.2/5
Wykonuj zrzuty ekranu aplikacji mobilnych, aby rejestrować wyniki testów. Moduł qTest firmy Tricentis został zaprojektowany do centralizacji i organizowania testów oprogramowania w całym cyklu życia oprogramowania. Narzędzie pozwala osiągnąć wskaźnik automatyzacji na poziomie 90% od początku do końca, uwalniając część czasu zespołu przeznaczanego na testowanie. Tricentis można łatwo wdrożyć w ramach istniejącego procesu pracy, a firma oferuje kursy online ułatwiające szkolenie zespołu. Tricentis umożliwia tworzenie automatycznych przypadków testowych bez konieczności pisania skryptów, dzięki czemu każdy członek zespołu może je tworzyć. Narzędzie służy zarówno do automatyzacji interfejsu użytkownika, jak i interfejsów API, co oznacza, że obejmuje wszystkie aspekty cyklu życia oprogramowania. Tricentris obsługuje CI/CD oraz zapewnia wsparcie dla wielu przeglądarek. Tricentris integruje się z narzędziami takimi jak Azure, Jenkins, Jira i Cucumber. Tricentris oferuje niestandardowe ceny na życzenie. Narzędzie udostępnia również bezpłatny okres próbny.
Learn more about Tricentis Tosca:
Inne narzędzia do zarządzania danymi testowymi
Oto kilka dodatkowych narzędzi do zarządzania danymi testowymi, które nie znalazły się na mojej krótkiej liście, ale nadal warto się z nimi zapoznać:
- 11InformaticaNajlepsza do testowania w przedsiębiorstwach
- 12BMC CompuwareNajlepsze rozwiązanie do natychmiastowego testowania
- 13Rocket Data ExpressNajlepsze do oszczędzania zasobów testowych
- 14Accelario Continuous DataOps PlatformNajlepsze do wirtualizacji baz danych wyzwalanej przez CI/CD
- 15Avo Test Data ManagementNajlepsze rozwiązanie do szybkiego i niezawodnego generowania danych testowych
- 16Avo Test Data ManagementNajlepsze rozwiązanie do szybkiego i niezawodnego generowania danych testowych
- 17SynthoNajlepsze do generowania danych syntetycznych z myślą o prywatności
- 18IRI VoracityNajlepszy wybór do jednoczesnego maskowania danych ustrukturyzowanych i ciemnych danych
Jak oceniam narzędzia do zarządzania danymi testowymi
Ocenę dzielę na trzy części, nadając największą wagę kluczowym potrzebom: maskowaniu danych wrażliwych, generowaniu realistycznych rekordów syntetycznych oraz zachowywaniu powiązań podzbiorów. Następnie szukam wyróżników, takich jak wykrywanie danych wrażliwych i wersjonowane dane testowe. Na koniec biorę pod uwagę wdrażanie, wsparcie, dopasowanie do modelu wdrożenia oraz ceny.
Podstawowe funkcje (wymagania uwzględniane na tej liście)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcji) do 5 (doskonale sprawdza się w tym obszarze) dla każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam sumę na wartość procentową, aby pomóc ocenić ogólne dopasowanie każdego narzędzia, nadając dodatkową wagę funkcjom, które uznałem za niezbędne.
- Maskowanie danych (niezbędne): Szukam konfigurowalnego i spójnego maskowania różnych typów danych, aby zespoły mogły udostępniać rekordy przypominające dane produkcyjne bez ujawniania informacji o klientach.
- Dane syntetyczne (niezbędne): Oceniam, czy generowane rekordy odzwierciedlają rzeczywiste struktury i rozkłady danych, w tym przypadki brzegowe potrzebne do wiarygodnego testowania aplikacji.
- Tworzenie podzbiorów danych: Sprawdzam, czy zespoły mogą wyodrębniać mniejsze zbiory danych przy jednoczesnym zachowaniu powiązanych rekordów, takich jak zamówienia i przypisani do nich klienci.
- Udostępnianie środowisk: Biorę pod uwagę sposób klonowania lub odświeżania środowisk testowych przez zespoły oraz to, czy mogą powtarzać te czynności w środowiskach programistycznych i QA.
- Integralność referencyjna: Oceniam, jak narzędzie zachowuje relacje między tabelami i systemami podczas maskowania, generowania oraz operacji na podzbiorach.
- Integracja z potokami: Szukam sposobów wyzwalania udostępniania danych z przepływów CI/CD lub automatyzacji testów, na przykład w celu przygotowania świeżego zbioru danych dla każdego uruchomienia testów.
Gdy mam już listę narzędzi spełniających kryteria, analizuję, co wyróżnia poszczególne platformy.
Czynniki różnicujące (co wyróżnia dostawców)
Oto sposób, w jaki porównuję różnych dostawców:
Najważniejsze funkcje
Szukam generowania danych opartego na AI, które uczy się wzorców produkcyjnych i tworzy syntetyczne zbiory danych bez konieczności ręcznego definiowania reguł — jest to przydatne, gdy zespół QA potrzebuje realistycznych przypadków brzegowych obejmujących dziesiątki tabel. Równie istotne jest wykrywanie danych wrażliwych; sprawdzam, czy narzędzie automatycznie klasyfikuje dane osobowe w różnych źródłach, ponieważ ręczne oznaczanie spowalnia wdrażanie i prowadzi do luk w zakresie zgodności. Oceniam również wersjonowane dane testowe, dzięki którym zespoły mogą tworzyć migawki, rozgałęziać zbiory danych i przywracać ich wcześniejsze wersje tak, jak zarządzają kodem, utrzymując powtarzalność cykli testowych po zmianach schematu.
Więcej niż funkcje
Elastyczność wdrożenia ma znaczenie, ponieważ niektóre zespoły potrzebują przechowywać dane za zaporami sieciowymi, podczas gdy inne korzystają z natywnych dla chmury potoków. Sprawdzam, czy dostawca oferuje opcje lokalne, chmurowe i hybrydowe, aby zasady dotyczące rezydencji danych nie były traktowane jako kwestia drugorzędna. Równie ważna jest skalowalność — oceniam, jak każde narzędzie radzi sobie ze zbiorami danych o rozmiarze wielu terabajtów podczas maskowania lub tworzenia podzbiorów, ponieważ wolne udostępnianie danych wstrzymuje cykle CI/CD. Analizuję również modele licencjonowania, aby ustalić, czy ceny zależą od ilości danych, liczby środowisk czy liczby użytkowników, co wpływa na długoterminowe wdrażanie rozwiązania w wielu zespołach produktowych.
Jak wybrać narzędzie do zarządzania danymi testowymi
Łatwo zagubić się w długich listach funkcji i złożonych strukturach cenowych. Aby pomóc Ci zachować koncentrację podczas wyboru oprogramowania dopasowanego do Twoich potrzeb, przygotowałem listę czynników, które warto wziąć pod uwagę:
| Czynnik | Na co zwrócić uwagę |
|---|---|
| CzynnikSkalowalność | Na co zwrócić uwagęCzy narzędzie będzie rozwijać się wraz z Twoim zespołem? Weź pod uwagę przyszłą ilość danych i wzrost liczby użytkowników. Poszukaj elastycznych planów, które umożliwiają skalowanie bez znacznego wzrostu kosztów. |
| CzynnikIntegracje | Na co zwrócić uwagęCzy narzędzie współpracuje z używanymi przez Ciebie systemami? Sprawdź zgodność z obecnymi narzędziami testowymi, bazami danych i procesami pracy, aby uniknąć zakłóceń. |
| CzynnikMożliwość dostosowania | Na co zwrócić uwagęCzy możesz dostosować narzędzie do swoich potrzeb? Sprawdź, czy umożliwia tworzenie niestandardowych szablonów danych i procesów pracy dopasowanych do Twoich procedur. |
| CzynnikŁatwość obsługi | Na co zwrócić uwagęCzy narzędzie jest przyjazne dla użytkownika i zespołu? Weź pod uwagę krzywą uczenia się oraz to, czy pracownicy nietechniczni mogą z łatwością korzystać z narzędzia bez rozbudowanych szkoleń. |
| CzynnikWdrożenie i rozpoczęcie pracy | Na co zwrócić uwagęJak szybko możesz rozpocząć pracę? Poszukaj narzędzi oferujących szybką konfigurację, materiały szkoleniowe i pomoc, aby zapewnić płynne przejście. |
| CzynnikKoszt | Na co zwrócić uwagęCzy narzędzie mieści się w Twoim budżecie? Porównaj modele cenowe i upewnij się, że nie ma ukrytych opłat. Sprawdź, czy dostępna jest bezpłatna wersja próbna lub demonstracja, aby przetestować narzędzie przed podjęciem decyzji. |
| CzynnikZabezpieczenia | Na co zwrócić uwagęW jaki sposób narzędzie chroni dane? Upewnij się, że spełnia standardy bezpieczeństwa danych oraz oferuje szyfrowanie i kontrolę dostępu w celu ochrony poufnych informacji. |
| CzynnikWymogi zgodności | Na co zwrócić uwagęCzy narzędzie spełnia wymogi prawne? Sprawdź, czy obsługuje zgodność z odpowiednimi przepisami dotyczącymi ochrony danych, takimi jak RODO lub HIPAA, zależnie od wymagań obowiązujących w Twojej branży. |
Czym są narzędzia do zarządzania danymi testowymi?
Narzędzia do zarządzania danymi testowymi to oprogramowanie służące do generowania danych na potrzeby testów oprogramowania, zarządzania nimi i ich utrzymywania. Obsługują tworzenie danych testowych i manipulowanie nimi, zapewniając ich dokładność, bezpieczeństwo oraz przydatność w różnych scenariuszach testowych.
Narzędzia te odgrywają kluczową rolę w organizowaniu i udostępnianiu danych na potrzeby testów funkcjonalnych, wydajnościowych i regresyjnych w procesie tworzenia oprogramowania, często współpracując z narzędziami do testowania baz danych, aby zapewnić kompleksową walidację danych.
Funkcje
Wybierając narzędzia do zarządzania danymi testowymi, zwróć uwagę na następujące kluczowe funkcje:
- Maskowanie danych: Chroni poufne informacje, zastępując je fikcyjnymi danymi i zapewniając zgodność z wymogami ochrony prywatności.
- Podzbiory danych: Wyodrębnia podzbiór danych z dużych zbiorów danych, dzięki czemu testowanie jest łatwiejsze i bardziej wydajne.
- Możliwości integracji: Łączy się z istniejącymi narzędziami testowymi i bazami danych, ułatwiając płynny przebieg pracy.
- Niestandardowe szablony danych: Umożliwia użytkownikom tworzenie szablonów dostosowanych do konkretnych potrzeb testowych, zwiększając elastyczność.
- Generowanie danych oparte na AI: Wykorzystuje sztuczną inteligencję do generowania realistycznych danych testowych, zwiększając dokładność testów.
- Udostępnianie danych w czasie rzeczywistym: Zapewnia natychmiastowy dostęp do wymaganych danych testowych, ograniczając opóźnienia w procesie testowania.
- Obsługa wielu chmur: Umożliwia działanie narzędzia w różnych środowiskach chmurowych, zapewniając elastyczność wdrażania.
- Szyfrowanie i kontrola dostępu: Zapewnia bezpieczeństwo danych poprzez ich szyfrowanie i ustawianie uprawnień dostępu użytkowników.
- Materiały szkoleniowe: Oferuje samouczki, webinaria i inne materiały edukacyjne wspierające wdrażanie użytkowników i upowszechnianie narzędzia.
- Obsługa zgodności: Pomaga zapewnić, że przetwarzanie danych spełnia standardy branżowe i przepisy, takie jak GDPR lub HIPAA.
Korzyści
Wdrożenie narzędzi do zarządzania danymi testowymi przynosi zespołowi i firmie wiele korzyści. Oto kilka z nich:
- Lepsza ochrona prywatności danych: Funkcje maskowania danych pomagają chronić poufne informacje, zapewniając zgodność z przepisami dotyczącymi prywatności.
- Większa wydajność testowania: Udostępnianie danych w czasie rzeczywistym ogranicza opóźnienia, umożliwiając szybsze cykle testowe.
- Większa dokładność danych: Generowanie danych oparte na AI tworzy realistyczne dane testowe, zwiększając wiarygodność wyników testów.
- Oszczędność kosztów: Podzbiory danych wyodrębniają tylko niezbędne dane, ograniczając koszty przechowywania i przetwarzania.
- Elastyczność wdrażania: Obsługa wielu chmur umożliwia działanie narzędzia w różnych środowiskach, dostosowując je do potrzeb infrastruktury.
- Przyjazne dla użytkownika wdrażanie: Dostęp do materiałów szkoleniowych i samouczków wspiera szybkie rozpoczęcie korzystania z narzędzia i jego efektywne użytkowanie.
- Zgodność z przepisami: Funkcje obsługi zgodności pomagają spełniać standardy branżowe, ograniczając ryzyko problemów prawnych.
Koszty i ceny
Wybór narzędzi do zarządzania danymi testowymi wymaga zrozumienia różnych dostępnych modeli cenowych i planów. Koszty różnią się w zależności od funkcji, wielkości zespołu, dodatków i innych czynników. Poniższa tabela podsumowuje typowe plany, ich średnie ceny oraz typowe funkcje zawarte w rozwiązaniach do zarządzania danymi testowymi:
Tabela porównawcza planów dla narzędzi do zarządzania danymi testowymi
| Rodzaj planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Rodzaj planuPlan bezpłatny | Średnia cena$0 | Typowe funkcjePodstawowe maskowanie danych, ograniczone możliwości tworzenia podzbiorów danych oraz ograniczone możliwości integracji. |
| Rodzaj planuPlan osobisty | Średnia cena$5-$25/użytkownika/miesiąc | Typowe funkcjeUlepszona ochrona prywatności danych, generowanie danych oparte na AI oraz podstawowa pomoc techniczna. |
| Rodzaj planuPlan biznesowy | Średnia cena$30-$75/użytkownika/miesiąc | Typowe funkcjeZaawansowane tworzenie podzbiorów danych, obsługa wielu chmur oraz dostęp do materiałów szkoleniowych. |
| Rodzaj planuPlan dla przedsiębiorstw | Średnia cena$100+/użytkownika/miesiąc | Typowe funkcjeNiestandardowe szablony danych, kompleksowa obsługa zgodności, pomoc techniczna dla klientów klasy premium oraz pełne możliwości integracji. |
Najczęściej zadawane pytania dotyczące narzędzi do zarządzania danymi testowymi
Oto odpowiedzi na często zadawane pytania dotyczące narzędzi do zarządzania danymi testowymi:
Czy należy wybrać funkcje maskowania czy dane syntetyczne?
Maskowanie chroni rzeczywiste dane, ukrywając dane osobowe. Oprogramowanie generujące dane syntetyczne tworzy fikcyjne, ale realistyczne zestawy danych. Wybierz maskowanie, jeśli korzystasz z danych produkcyjnych; dane syntetyczne — jeśli chcesz bezpieczniejszych, w pełni wygenerowanych zestawów testowych.
Jeśli nadal jesteś na etapie “potrzebuję zebrać więcej danych testowych”, wypróbuj: 10 najlepszych narzędzi do testowania użyteczności w celu uzyskania opinii rzeczywistych użytkowników.
Dlaczego bezpieczeństwo danych jest ważne w narzędziach TDM?
Oprogramowanie TDM często obsługuje wrażliwe dane produkcyjne. Bez odpowiedniego maskowania lub szyfrowania istnieje ryzyko wycieków danych lub problemów ze zgodnością. Zawsze wybieraj narzędzie obsługujące szyfrowanie, anonimizację i mechanizmy kontroli dostępu.
Jakie integracje powinno obsługiwać narzędzie TDM?
Powinno współpracować z narzędziami CI/CD, takimi jak Jenkins, GitLab lub Azure DevOps. Integracja z najważniejszymi bazami danych (Oracle, SQL Server, PostgreSQL) i platformami chmurowymi jest również kluczowa dla sprawnej automatyzacji.
Jak przetestować narzędzie TDM przed zakupem?
Przeprowadź niewielki test weryfikujący koncepcję. Spróbuj klonować, maskować i odświeżać dane w swoim rzeczywistym środowisku. Sprawdź szybkość działania oraz to, czy narzędzie pasuje do istniejącego przepływu pracy.
Jak narzędzia TDM mogą pomóc w zapewnieniu zgodności?
Dobre narzędzia śledzą każdą zmianę danych, przechowują dzienniki audytowe i zapewniają spójność zamaskowanych danych. Pomaga to zespołowi zachować zgodność z przepisami, takimi jak GDPR, HIPAA czy CCPA.