

Tools voor webscraping zijn toepassingen die het extraheren van gegevens van websites automatiseren, waardoor het eenvoudig wordt om informatie te verzamelen zonder handmatig te kopiëren en plakken. Als je op zoek bent naar de beste tools voor webscraping, moet je waarschijnlijk op betrouwbare wijze grote hoeveelheden webgegevens verzamelen—zonder tegen obstakels aan te lopen zoals antibotbeveiliging of veranderende sitestructuren.
Met zoveel opties op de markt is het lastig om te weten welke tool echt bij je technologiestack past, je doelsites aankan en met je behoeften kan meegroeien. In deze gids zetten we de beste tools op een rij, zodat je functies en benaderingen kunt vergelijken en precies kunt vinden wat werkt voor je IT-projecten.
Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Vergelijkingstabel: tools voor webscraping
Deze vergelijkingstabel vat de prijsdetails samen van mijn beste keuzes voor tools voor webscraping.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Beste voor ingebouwde besturing van browsers zonder grafische interface | Gratis abonnement beschikbaar | Vanaf $30/maand | Website | |
| 2 | Het beste voor onopvallend scrapen en het omzeilen van detectie | 14 dagen gratis proberen | Vanaf $69/maand | Website | |
| 3 | Het meest geschikt voor het verwerken van dynamische JavaScript-websites | Gratis abonnement beschikbaar | Vanaf $189/maand | Website | |
| 4 | Beste voor directe pipeline-integratie | 30 dagen gratis proefperiode | Vanaf $199/maand (jaarlijks gefactureerd) | Website | |
| 5 | Beste voor vooraf gebouwde automatiseringssjablonen voor robots | Gratis abonnement beschikbaar | Vanaf $19/maand (jaarlijks gefactureerd) | Website | |
| 6 | Het meest geschikt voor beheerde gegevensverzameling met antibotbescherming | Gratis proefversie beschikbaar | Vanaf $0.5/1,000 gegevensrecords | Website | |
| 7 | Het beste voor proxy-infrastructuur op ondernemingsschaal | Gratis abonnement beschikbaar | Vanaf $1.5/1,000 gegevensrecords/maand | Website | |
| 8 | Beste voor automatische schemadetectie | 30 dagen gratis uitproberen | Vanaf $0.13/1.000 verzoeken | Website | |
| 9 | Ideaal voor eenvoudige, API-gestuurde scrapingworkflows | Gratis abonnement beschikbaar | Vanaf $49/maand | Website | |
| 10 | Ideaal voor probleemloze IP-rotatie op grote schaal | Gratis proefperiode van 7 dagen | Vanaf $49/maand | Website |


Reviews van de beste tools voor webscraping
Hieronder vind je mijn uitgebreide samenvattingen van de beste tools voor webscraping die op mijn shortlist zijn beland. In mijn reviews bespreek ik de functies, integraties en beste gebruiksscenario’s van elke tool in detail, zodat je de beste optie voor jouw situatie kunt vinden.
 Beste voor ingebouwde besturing van browsers zonder grafische interface
- Gratis abonnement beschikbaar
- Vanaf $30/maand
Visit WebsiteCustomer Rating:4.9/5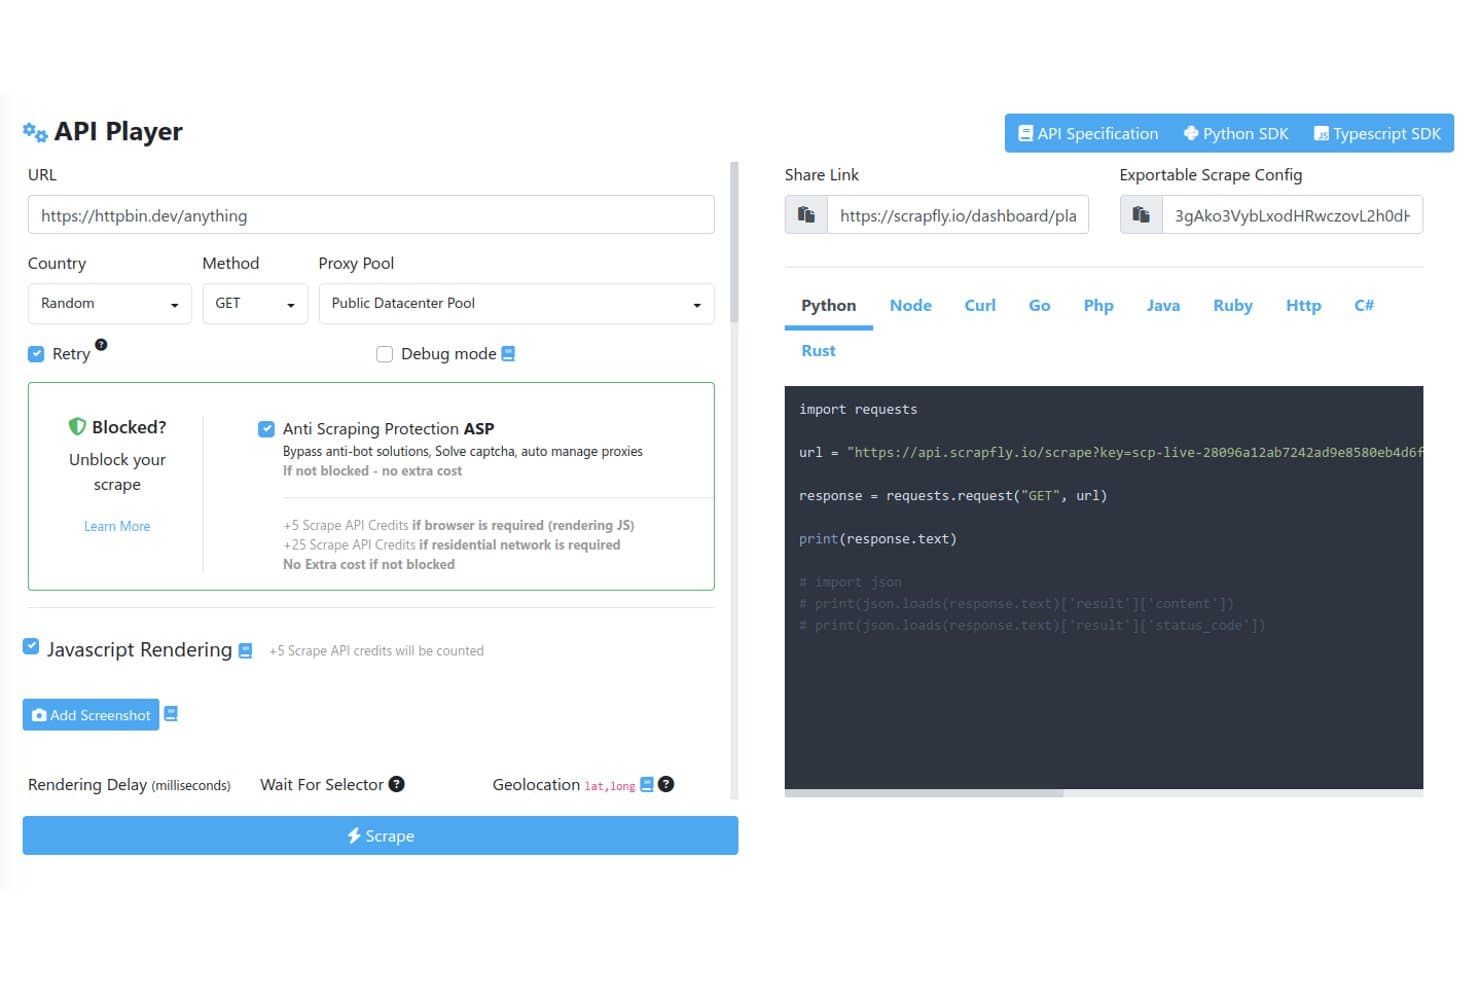
Scrapfly biedt een interactieve API-speler met configureerbare scrapingopties, waaronder proxypools, het omzeilen van antibotsystemen, JavaScript-rendering en automatisch gegenereerde codefragmenten in meerdere talen. Scrapfly is een API voor webscraping die proxydraaiing, het omzeilen van antibotmaatregelen, rendering met een browser zonder grafische interface, sitecrawling, het maken van schermafbeeldingen en gegevensextractie met behulp van LLM's combineert onder één API-sleutel.
Voor wie is Scrapfly het meest geschikt?
Scrapfly is zeer geschikt voor ontwikkelaars en data-engineers die een codegerichte scraping-API willen met SDK's voor Python, TypeScript, Go en Rust.
Waarom ik voor Scrapfly koos
Ik koos voor Scrapfly omdat de architectuur met twee browserengines anders is dan alles wat ik tot nu toe heb getest. Curlium verzorgt byte-perfecte Chrome-JA4-vingerafdrukken voor snelheid, terwijl Scrapium Chromium in stealthmodus uitvoert via CDP met overeenkomende vingerafdrukken, zodat sessies halverwege een crawl kunnen wisselen zonder detectie te activeren. Ik vind het ook prettig dat Scrapium volledig compatibel is met Playwright en Puppeteer, wat betekent dat ik aangepaste JS-scenario's en wachtregels kan schrijven zonder mijn bestaande code voor browserautomatisering aan te passen.
Belangrijkste functies van Scrapfly
- API voor extractie met meerdere methoden: Extraheert gestructureerde gegevens met CSS, XPath, reguliere expressies, JSON-schema's en LLM-aangedreven sjablonen.
- Geïntegreerde proxypools: Biedt beheerde datacenter- en residentiële proxy's met geotargeting en ondersteuning voor eigen proxy's.
- Crawler-API: Doorzoekt volledige sites met controle over crawldiepte, snelheidslimieten en projectpartitionering.
- Ingebouwde integraties voor planning: Ondersteunt Zapier, Make en n8n voor geautomatiseerde workflows, terugkerende taken en webhook-triggers.
Integraties van Scrapfly
Scrapfly biedt ingebouwde integraties met Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI en OpenClaw. Het biedt ook SDK's voor Python, TypeScript, Go en Rust. Er is een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Twee stealth-browserengines
- Omzeilt Cloudflare, DataDome en Imperva
- Extractiesjablonen voor veelvoorkomende sitetypen
Cons:
- Geen ingebouwde taakplanner in het product
- Niet geschikt voor niet-technische gebruikers
Learn more about Scrapfly: Het beste voor onopvallend scrapen en het omzeilen van detectie
- 14 dagen gratis proberen
- Vanaf $69/maand
Visit WebsiteCustomer Rating:4.7/5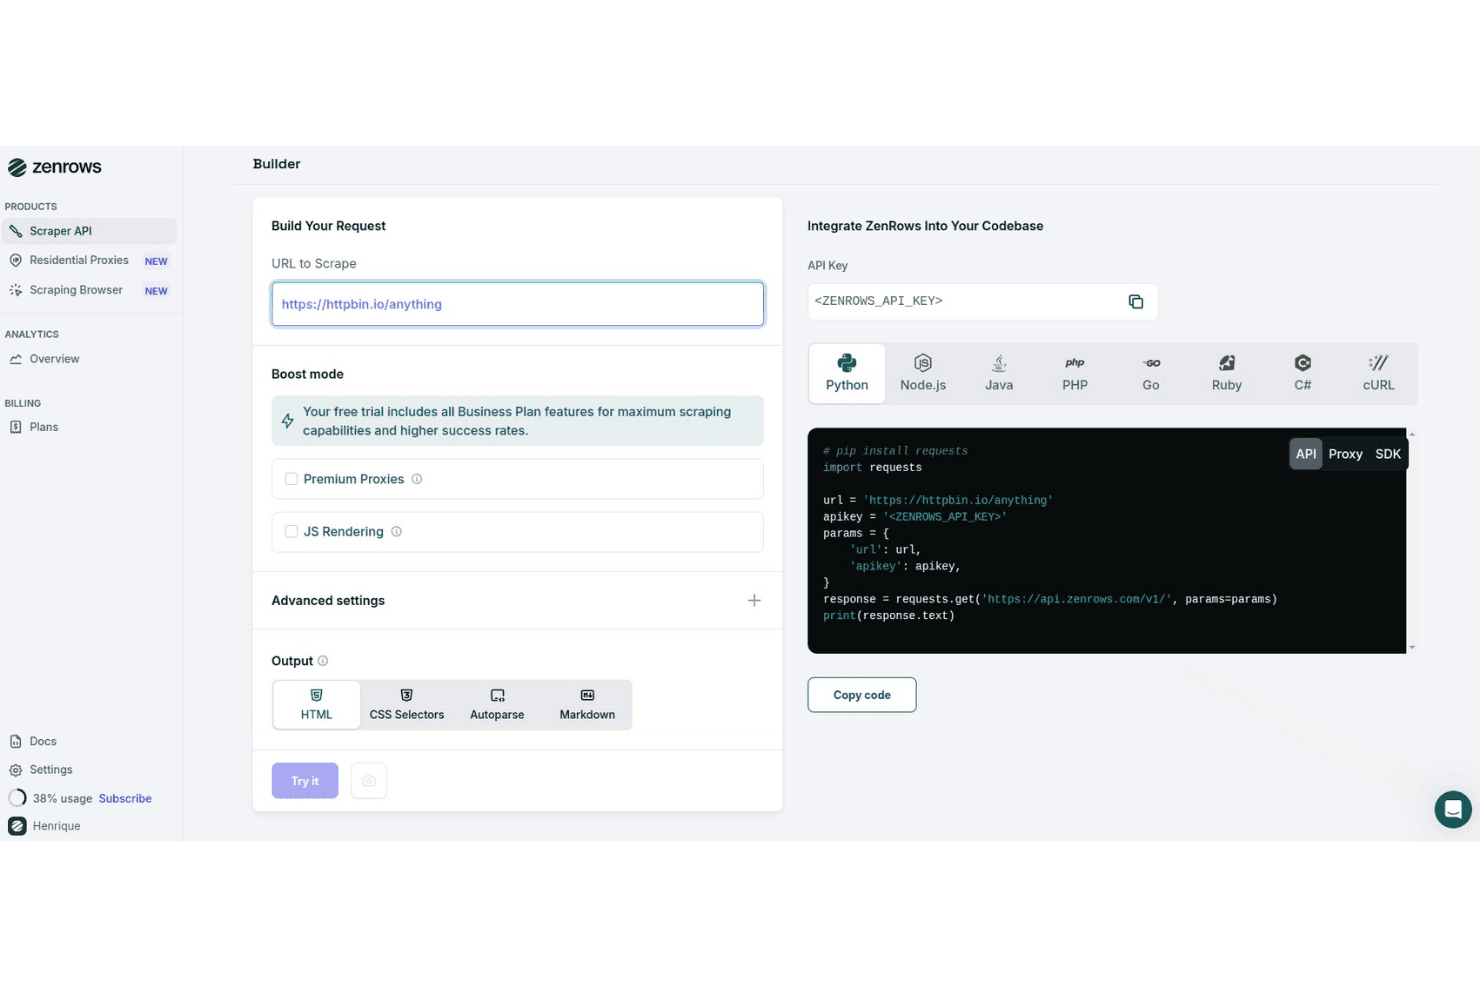
ZenRows biedt een visuele aanvraagbouwer met codegeneratie voor meerdere programmeertalen, opties voor de boostmodus en selectie van het uitvoerformaat voor webscraping. ZenRows is een API voor webscraping en een cloudbrowserplatform dat het omzeilen van anti-botbescherming, rotatie van residentiële proxy's, JavaScript-rendering en het extraheren van gestructureerde gegevens combineert in één toolkit voor ontwikkelaars.
Voor wie is ZenRows het meest geschikt?
ZenRows is een goede keuze voor ontwikkelaars en data-engineers die op grote schaal websites moeten scrapen met agressieve anti-botbescherming.
Waarom ik voor ZenRows heb gekozen
ZenRows staat op mijn shortlist vanwege de manier waarop het anti-botbescherming aanpakt. Ik heb websites met Cloudflare-bescherming gescrapet waarop standaardtools steeds mislukken, en ZenRows komt erdoorheen dankzij het omzeilen van browserfingerprinting en het automatisch oplossen van CAPTCHA's, zonder handmatige configuratie. De browser voor webscraping gaat nog verder en voert volledige Chromium-sessies uit met onopvallende headers die het gedrag van echte gebruikers nauwkeurig nabootsen om detectie te vermijden op websites die DataDome of PerimeterX gebruiken.
Belangrijkste functies van ZenRows
- Universele scraping-API: Verstuur verzoeken via één eindpunt dat zich aanpast aan verschillende websitestructuren en vereisten voor webscraping.
- Infrastructuur met residentiële proxy's: Kies uit een pool van meer dan 55 miljoen residentiële IP-adressen in meer dan 185 landen voor geografisch gerichte webcrawls.
- Automatische ontleding voor gestructureerde uitvoer: Extraheer en ontvang automatisch gegevens in JSON, HTML of Markdown, met ingebouwde ontleding voor populaire websites.
- SDK's voor meerdere programmeertalen: Gebruik officiële SDK's voor Python, Node.js, Go, PHP, Ruby, Java en C# om te integreren met ontwikkelworkflows.
Integraties van ZenRows
ZenRows biedt ingebouwde integraties met Playwright, Puppeteer, n8n, Make, Clay en Zapier. Er is een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Omzeilt Cloudflare en DataDome betrouwbaar
- Hoog slagingspercentage op beschermde pagina's
- Volledige browsersessies zonder gebruikersinterface met onopvallende modus
Cons:
- Geen ingebouwde planning of taakorkestratie
- De kosten lopen snel op bij grote aantallen verzoeken
Learn more about ZenRows: Het meest geschikt voor het verwerken van dynamische JavaScript-websites
- Gratis abonnement beschikbaar
- Vanaf $189/maand
Visit WebsiteCustomer Rating:4.4/5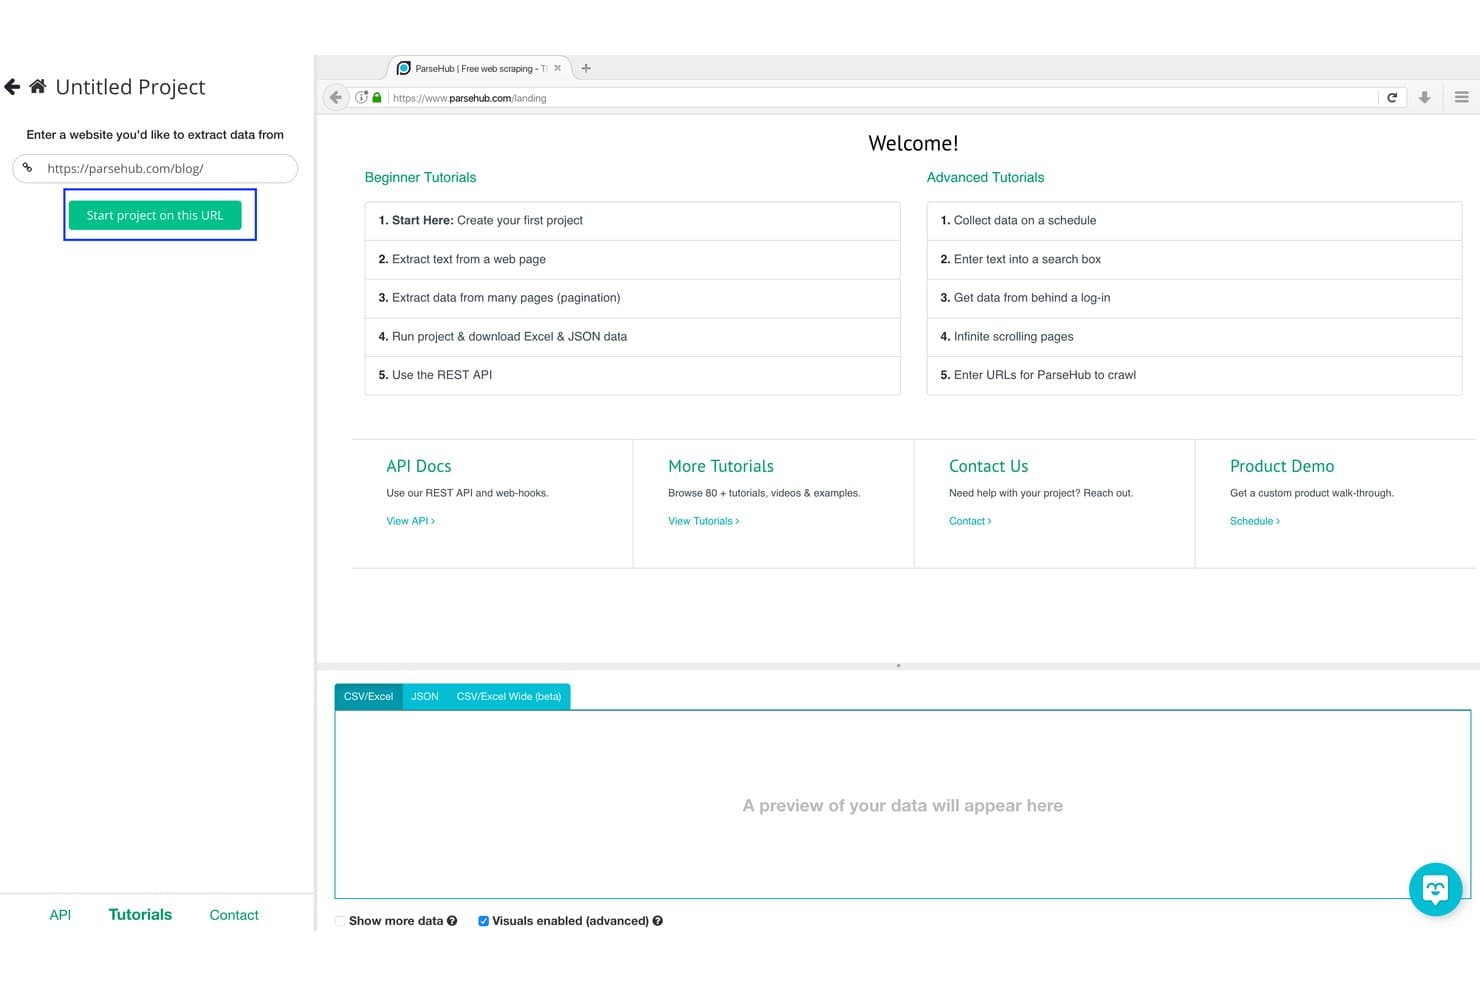
ParseHub biedt een visuele interface voor het instellen van projecten, waarin gebruikers een URL invoeren en op 'Project op deze URL starten' klikken om te beginnen met het scrapen van gegevens van websites. ParseHub is een visuele webscrapingtool die gegevens uit dynamische websites haalt via een interface op basis van klikken, met ondersteuning voor JavaScript, AJAX, oneindig scrollen, formulierinvoer en geplande cloudgebaseerde uitvoeringen.
Voor wie is ParseHub het meest geschikt?
ParseHub is geschikt voor analisten op het gebied van concurrentie-informatie en niet-technische onderzoekers die gegevens willen verzamelen van websites die sterk afhankelijk zijn van JavaScript, zonder code te schrijven.
Waarom ik voor ParseHub koos
ParseHub verdient een plek als een van de beste tools op mijn shortlist omdat het omgaat met de uitdagingen van JavaScript-rendering die de meeste scrapers zonder code laten falen. Ik heb het gebruikt om gegevens te halen uit pagina's met oneindig scrollen en inhoud die door vervolgkeuzemenu's wordt geactiveerd, waarbij scrapers voor statische HTML lege resultaten opleveren. De machinelearningengine detecteert automatisch de paginastructuur, waardoor ik een werkende scraper voor een productcatalogus die sterk afhankelijk is van AJAX kan bouwen zonder ook maar één regel XPath te schrijven.
Belangrijkste functies van ParseHub
- Visuele bouwer met aanwijzen en klikken: Selecteer en haal pagina-elementen op zonder handmatige codering van selectors.
- Cloudgebaseerde planning: Plan terugkerende scrapingtaken op de cloudinfrastructuur van ParseHub.
- REST API-toegang: Beheer, start en download scrapingresultaten programmatisch met behulp van de API.
- Automatische IP-rotatie: Beperk blokkeringen door uitgaande IP-adressen te roteren tijdens cloudgebaseerde uitvoeringen.
ParseHub-integraties
ParseHub biedt ingebouwde integraties met Google Sheets, Tableau, Dropbox en AWS S3. Er is een API beschikbaar voor aangepaste integraties en workflowautomatisering.
Pros and Cons
Pros:
- Verwerkt JavaScript, AJAX en oneindig scrollen standaard
- Voor de visuele bouwer is geen codering van selectors nodig
- Scrapingtaken worden automatisch uitgevoerd op cloudinfrastructuur
Cons:
- Beperkt grote gelijktijdige scrapingtaken
- Geen ingebouwde oplossing voor CAPTCHA's
Learn more about ParseHub: Beste voor directe pipeline-integratie
- 30 dagen gratis proefperiode
- Vanaf $199/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.2/5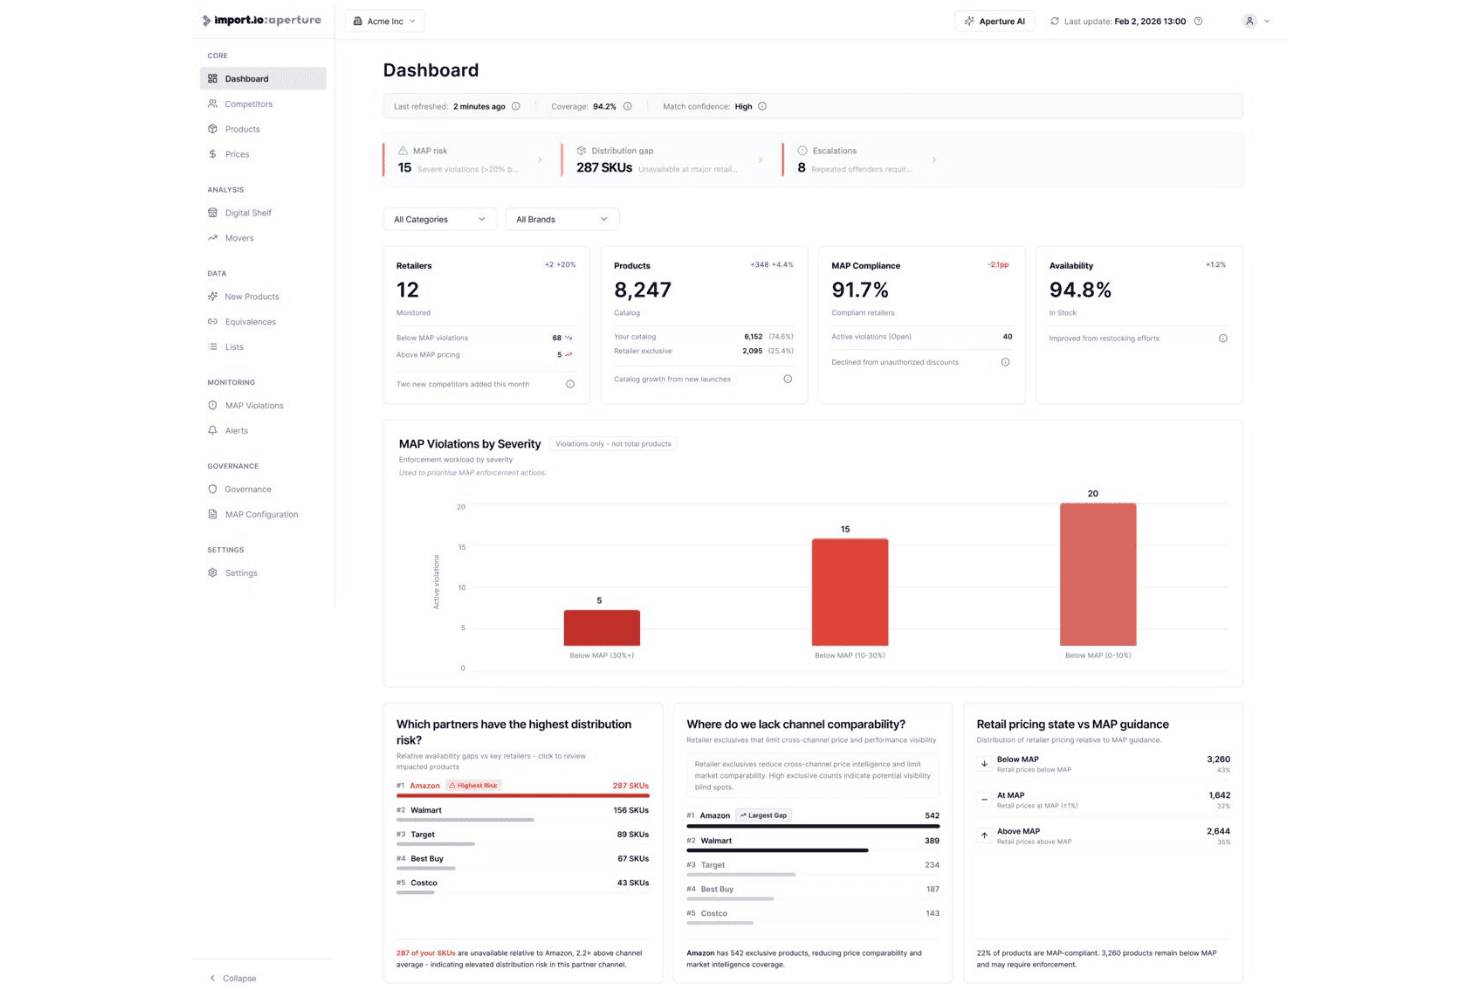
Het Aperture-platform van Import.io biedt een dashboard met een overzicht van MAP-naleving, productbeschikbaarheid, distributietekorten bij retailers en prijsovertredingen. Import.io is een AI-native, beheerd webscrapingplatform dat gestructureerde gegevens uit websites haalt op ondernemingsschaal en daarbij JavaScript-gerenderde pagina's en afgeschermde bronnen verwerkt, met directe levering aan datapijplijnen en analysesystemen.
Voor wie is Import.io het meest geschikt?
Import.io is geschikt voor teams voor data-engineering en concurrentie-informatie binnen middelgrote tot grote ondernemingen die onderhouden datapijplijnen nodig hebben zonder zelf scrapers te bouwen of te beheren.
Waarom ik voor Import.io heb gekozen
Import.io staat op mijn shortlist omdat gestructureerde gegevens rechtstreeks van het web naar je datawarehouse, dashboard of API-eindpunt worden verplaatst, zonder tussenliggende handmatige exportstap. Ik vind het prettig dat webhooks en API-levering standaard onderdeel zijn van het platform en geen achteraf toegevoegde functies. Wat ik het meest waardevol vind, zijn de zelfherstellende pijplijnen: ze passen zich automatisch aan wanneer doelsites hun structuur wijzigen, zodat ik extractors niet telkens opnieuw hoef op te bouwen wanneer een retailer de paginalay-out bijwerkt.
Belangrijkste functies van Import.io
- AI-ondersteunde extractiemodellen: Detecteren automatisch paginstructuren en passen het schema aan wanneer websites veranderen.
- Beheer van enterprise-proxy's: Ondersteunt premium- en residentiële proxy's voor het scrapen van afgeschermde of geografisch beperkte sites.
- Visuele bouwer met aanwijzen en klikken: Selecteer en haal gegevens uit complexe webpagina's zonder code te schrijven.
- Automatische maskering van persoonlijk identificeerbare informatie: Identificeert en verwijdert persoonlijk identificeerbare informatie binnen gescrapete datasets voor naleving van regelgeving.
Integraties van Import.io
Import.io biedt native integraties met Google Sheets, Power BI, Tableau en Excel, en voorziet in een API voor aangepaste integraties en webhooks naar andere systemen.
Pros and Cons
Pros:
- Zelfherstellende pijplijnen passen zich automatisch aan veranderingen op sites aan
- Verwerkt sterk afgeschermde sites en sites met verplichte login
- Beheerde extractie vermindert de werklast voor interne engineeringteams
Cons:
- Beperkte transparantie over de onderliggende scrapinginfrastructuur
- Beperkt geschikt voor scrapingtaken op kleine schaal
Learn more about Import.io: Beste voor vooraf gebouwde automatiseringssjablonen voor robots
- Gratis abonnement beschikbaar
- Vanaf $19/maand (jaarlijks gefactureerd)
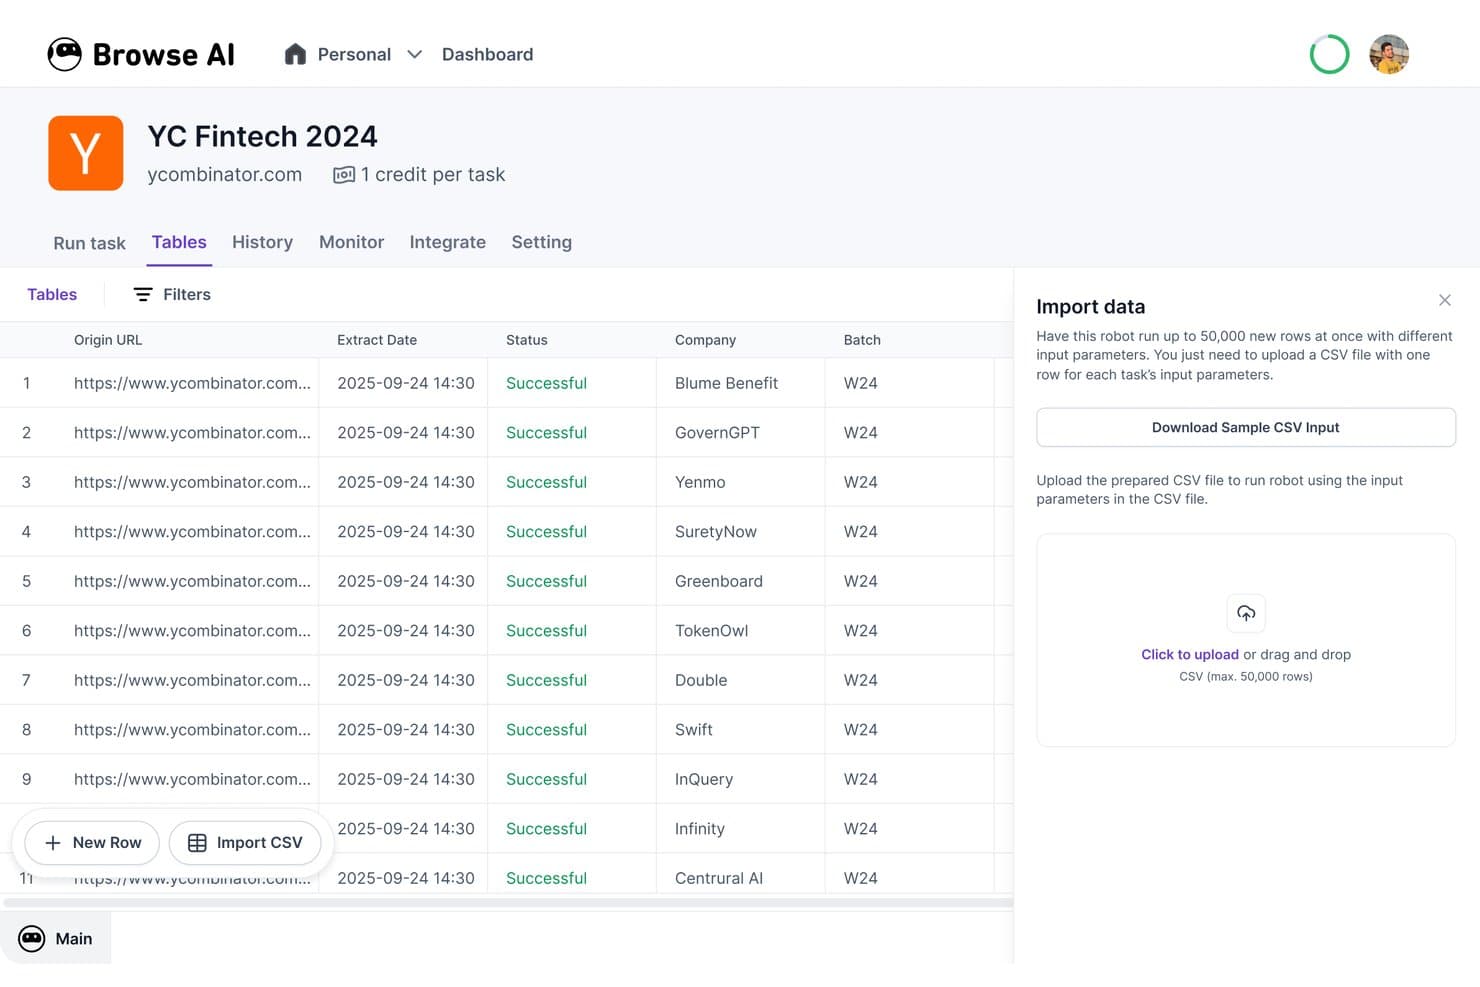
Browse AI biedt een dashboard voor webscraping zonder code, waarin gebruikers gestructureerde gegevens van websites zoals Y Combinator kunnen extraheren en resultaten als CSV-bestanden kunnen exporteren. Browse AI is een webscraping- en websitebewakingsplatform zonder code dat een visuele data-extractor met aanwijzen-en-klikken combineert met meer dan 250 vooraf gebouwde robotsjablonen voor geautomatiseerde, geplande gegevensverzameling van websites.
Voor wie is Browse AI het meest geschikt?
Browse AI is zeer geschikt voor analisten op het gebied van concurrentie-informatie en niet-technische teams die gestructureerde webgegevens moeten verzamelen zonder code te schrijven.
Waarom ik voor Browse AI heb gekozen
Browse AI staat op mijn favorietenlijst vanwege de voorsprong van de bibliotheek met vooraf gebouwde robots. Ik kan gestructureerde vermeldingen uit Amazon, Google Maps of Indeed ophalen zonder helemaal opnieuw een scraper te bouwen, en elke robot ondersteunt paginering en dynamische inhoud al voor die specifieke website. Wat ik ook waardeer, is de door AI aangestuurde aanpassing aan de lay-out. Deze werkt een robot automatisch bij wanneer een doelsite de structuur van zijn pagina's wijzigt, zodat gegevensverzamelingen niet halverwege de gegevensverwerkingsketen ongemerkt mislukken.
Belangrijkste functies van Browse AI
- JavaScript-rendering: Automatiseert het extraheren van gegevens uit moderne, JavaScript-zware websites en toepassingen met één pagina.
- Ondersteuning voor residentiële proxy's: Wisselt automatisch tussen residentiële IP-adressen om anti-botsystemen te omzeilen zonder handmatige proxyconfiguratie.
- Webhooks en API-toegang: Maakt het mogelijk om scrapingtaken programmatisch in te dienen en gegevens op te halen voor integratie met interne systemen.
- Geautomatiseerde wijzigingsdetectie: Controleert websites op visuele wijzigingen of inhoudswijzigingen en verstuurt waarschuwingen wanneer updates worden gedetecteerd.
Integraties van Browse AI
Browse AI biedt standaardintegraties met Google Sheets, Airtable, AWS S3, Zapier en Make.com. API- en webhooktoegang zijn beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Meer dan 250 vooraf gebouwde robots klaar voor gebruik
- Past zich automatisch aan wanneer de lay-outs van doelsites wijzigen
- Verwerkt CAPTCHAs en dynamische pagina's standaard
Cons:
- Beperkte controle op selectorniveau voor ontwikkelaars
- Kredietkosten lopen bij grote volumes snel op
Learn more about Browse AI: Het meest geschikt voor beheerde gegevensverzameling met antibotbescherming
- Gratis proefversie beschikbaar
- Vanaf $0.5/1,000 gegevensrecords
Visit WebsiteCustomer Rating:4.5/5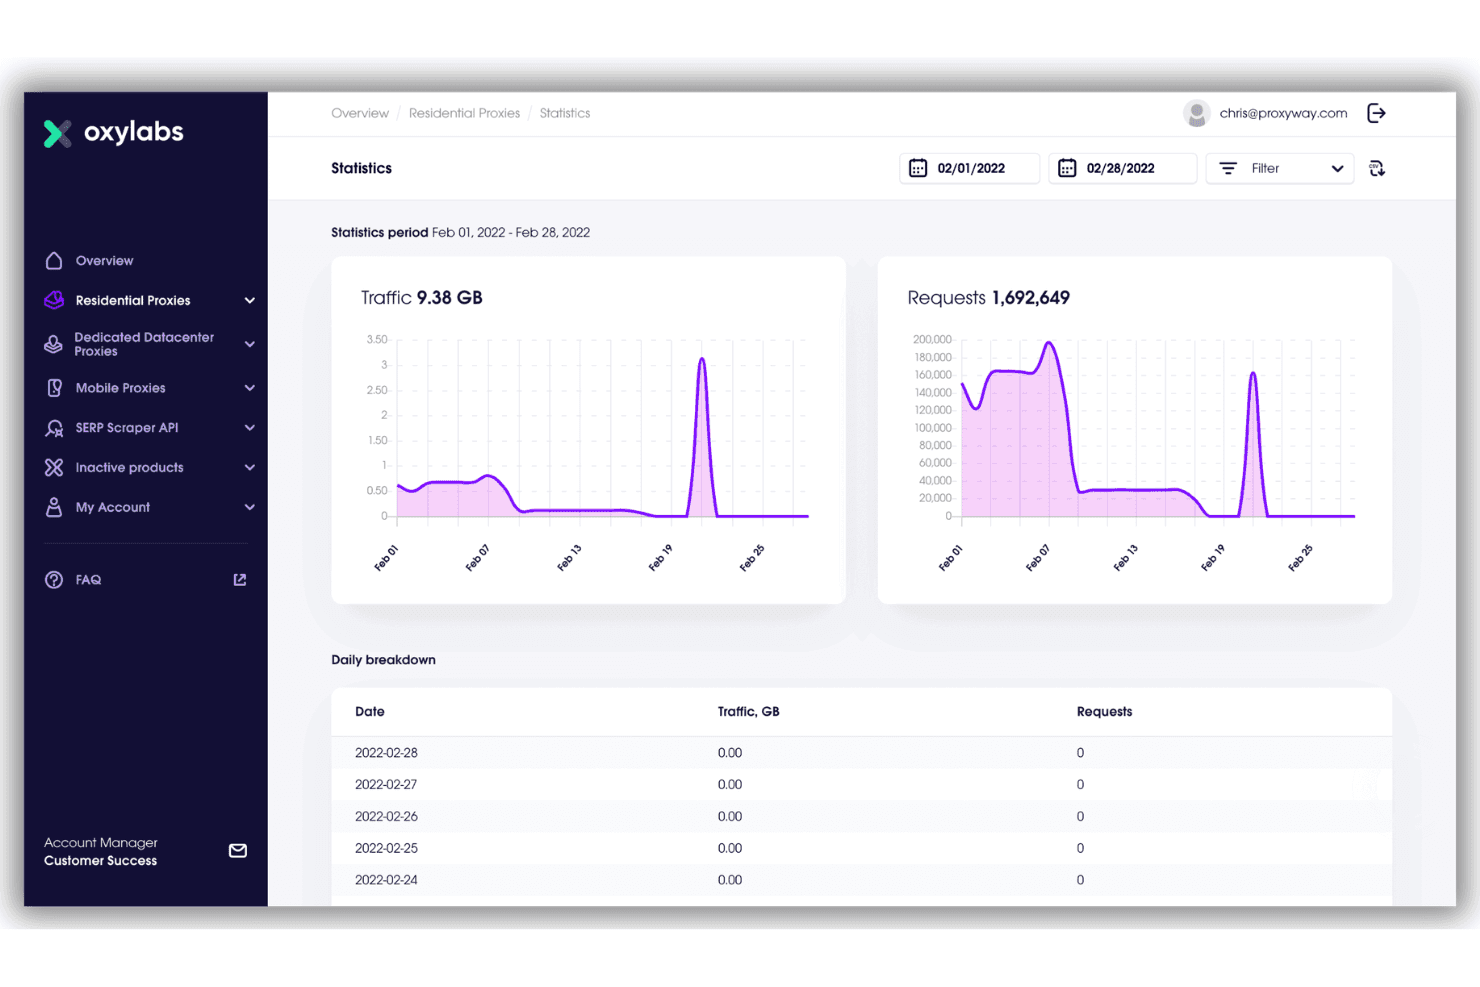
Oxylabs biedt een gedetailleerd statistiekdashboard voor residentiële proxy's, met verkeers- en aanvraagstatistieken over een geselecteerd datumbereik in februari 2022. Oxylabs is een API voor webscraping die proxybeheer, CAPTCHA-oplossing, JavaScript-rendering en extractie van gestructureerde gegevens voor meer dan 50 vooraf geconfigureerde websitedoelen afhandelt.
Voor wie is Oxylabs het meest geschikt?
Data-engineers en backendontwikkelaars die grootschalige, bedrijfskritieke scrapingpijplijnen uitvoeren en infrastructuur van ondernemingsniveau en betrouwbaarheid tegen antibotsystemen nodig hebben.
Waarom ik voor Oxylabs heb gekozen
Oxylabs verdient een plek op mijn shortlist vanwege de manier waarop het omgaat met het moeilijkste onderdeel van webscraping: botdetectie omzeilen zonder dit zelf te hoeven beheren. De API verzorgt CAPTCHA-oplossing, proxyrotatie over 177M+ residentiële IP-adressen en automatische nieuwe pogingen zonder dat ik zelf aangepaste logica voor foutafhandeling hoef te schrijven. Ik waardeer ook het prijsmodel op basis van succesvolle resultaten, waarbij alleen 2xx- en 4xx-reacties van je quotum worden afgetrokken, zodat fouten aan de systeemzijde je resultaten niet opgebruiken.
Belangrijkste functies van Oxylabs
- Aangepaste parser: Definieer CSS- of XPath-selectors om nauwkeurig gestructureerde gegevens uit pagina-inhoud te extraheren.
- OxyCopilot AI-assistent: Genereer scrapinginstructies en parserlogica met behulp van prompts in natuurlijke taal.
- Vooraf gebouwde doelconnectoren: Gebruik speciale eindpunten voor Amazon, Google, eBay, Walmart, Zillow en andere grote websites.
- Integraties voor cloudopslag: Exporteer resultaten rechtstreeks naar AWS S3 en Google Cloud Storage voor gebruik in datapijplijnen.
Integraties van Oxylabs
Oxylabs biedt native integraties met AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com en Zapier. Er zijn een API en SDK's voor Python en Go beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Meer dan 177 miljoen residentiële IP-adressen in 195 landen
- Prijs op basis van succesvolle resultaten voorkomt verspilling van het aanvraagquotum
- Vooraf gebouwde eindpunten voor meer dan 50 grote websites
Cons:
- Hogere kosten dan scrapingtools die je zelf beheert
- Geen visuele scraperinterface zonder code beschikbaar
Learn more about Oxylabs: Het beste voor proxy-infrastructuur op ondernemingsschaal
- Gratis abonnement beschikbaar
- Vanaf $1.5/1,000 gegevensrecords/maand
Visit WebsiteCustomer Rating:4.7/5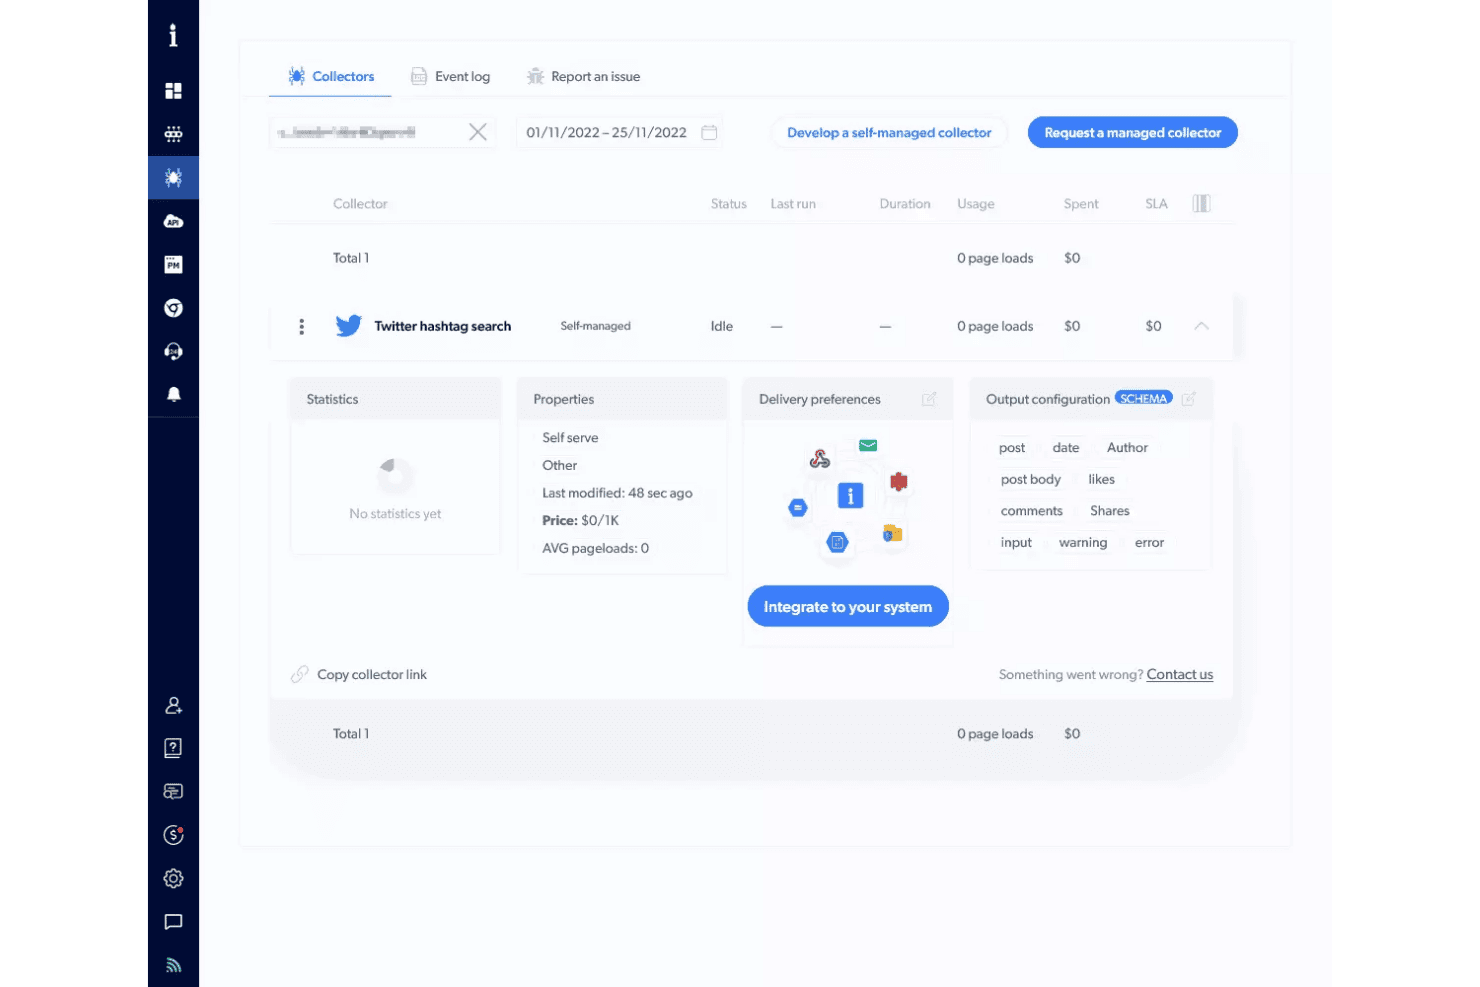
Het dashboard van Bright Data Collectors biedt een gegevensverzamelaar voor het zoeken naar Twitter-hashtags met zelfbeheerde status, uitvoerconfiguratie en opties voor systeemintegratie. Bright Data is een API voor webscraping en een scraperplatform zonder code dat proxiebeheer, JavaScript-rendering, CAPTCHA-oplossing en gestructureerde gegevenslevering combineert voor meer dan 1.278 kant-en-klare scrapers voor populaire websites.
Voor wie is Bright Data het meest geschikt?
Data-engineers en backendontwikkelaars bij middelgrote tot grote organisaties die op grote schaal gestructureerde webgegevens moeten verzamelen zonder zelf proxy-infrastructuur te beheren.
Waarom ik voor Bright Data heb gekozen
Bright Data staat op mijn shortlist vanwege de enorme omvang van zijn proxynetwerk: meer dan 400 miljoen residentiële IP-adressen in 195 landen, met automatische rotatie, CAPTCHA-oplossing en Web Unlocker, ontworpen om Cloudflare, Akamai en DataDome zonder configuratie te omzeilen. Ik heb met Bright Data op grote schaal gegevens verzameld uit LinkedIn Sales Navigator en Amazon en bij duizenden verzoeken geen enkele blokkade ondervonden. Met AI Scraper Studio kan ik bovendien binnen enkele minuten een werkende scraper-API voor elk nieuw domein genereren.
Belangrijkste functies van Bright Data
- Kant-en-klare scrapermodellen: Er zijn meer dan 1.200 kant-en-klare scrapers beschikbaar voor snelle implementatie op grote platforms zoals LinkedIn, Amazon en YouTube.
- AI-aangedreven schemadetectie: AI Scraper Studio genereert aangepaste uitvoerschema's en automatiseert het in kaart brengen van gegevens uit nieuwe domeinen.
- API's voor taakbeheer: Biedt batchplanning, terugkerende uitvoeringen en webhook-triggers voor integratie met tools voor workflowautomatisering.
- Directe gegevenslevering: Ondersteunt het exporteren van gegevens naar JSON, NDJSON, CSV en XLSX, of het rechtstreeks doorsturen naar S3, Snowflake, GCS, PubSub of SFTP.
Integraties van Bright Data
Bright Data biedt native integraties met Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake en Pub/Sub, en levert een API voor aangepaste integraties.
Pros and Cons
Pros:
- Meer dan 400 miljoen residentiële IP-adressen in 195 landen
- Kant-en-klare scrapers voor meer dan 1.200 populaire websites
- Web Unlocker omzeilt Cloudflare en DataDome
Cons:
- Gebruikers melden factureringsgeschillen bij mislukte scrapingopdrachten
- Te complex voor kopers zonder ontwikkelervaring
Learn more about Bright Data: Beste voor automatische schemadetectie
- 30 dagen gratis uitproberen
- Vanaf $0.13/1.000 verzoeken
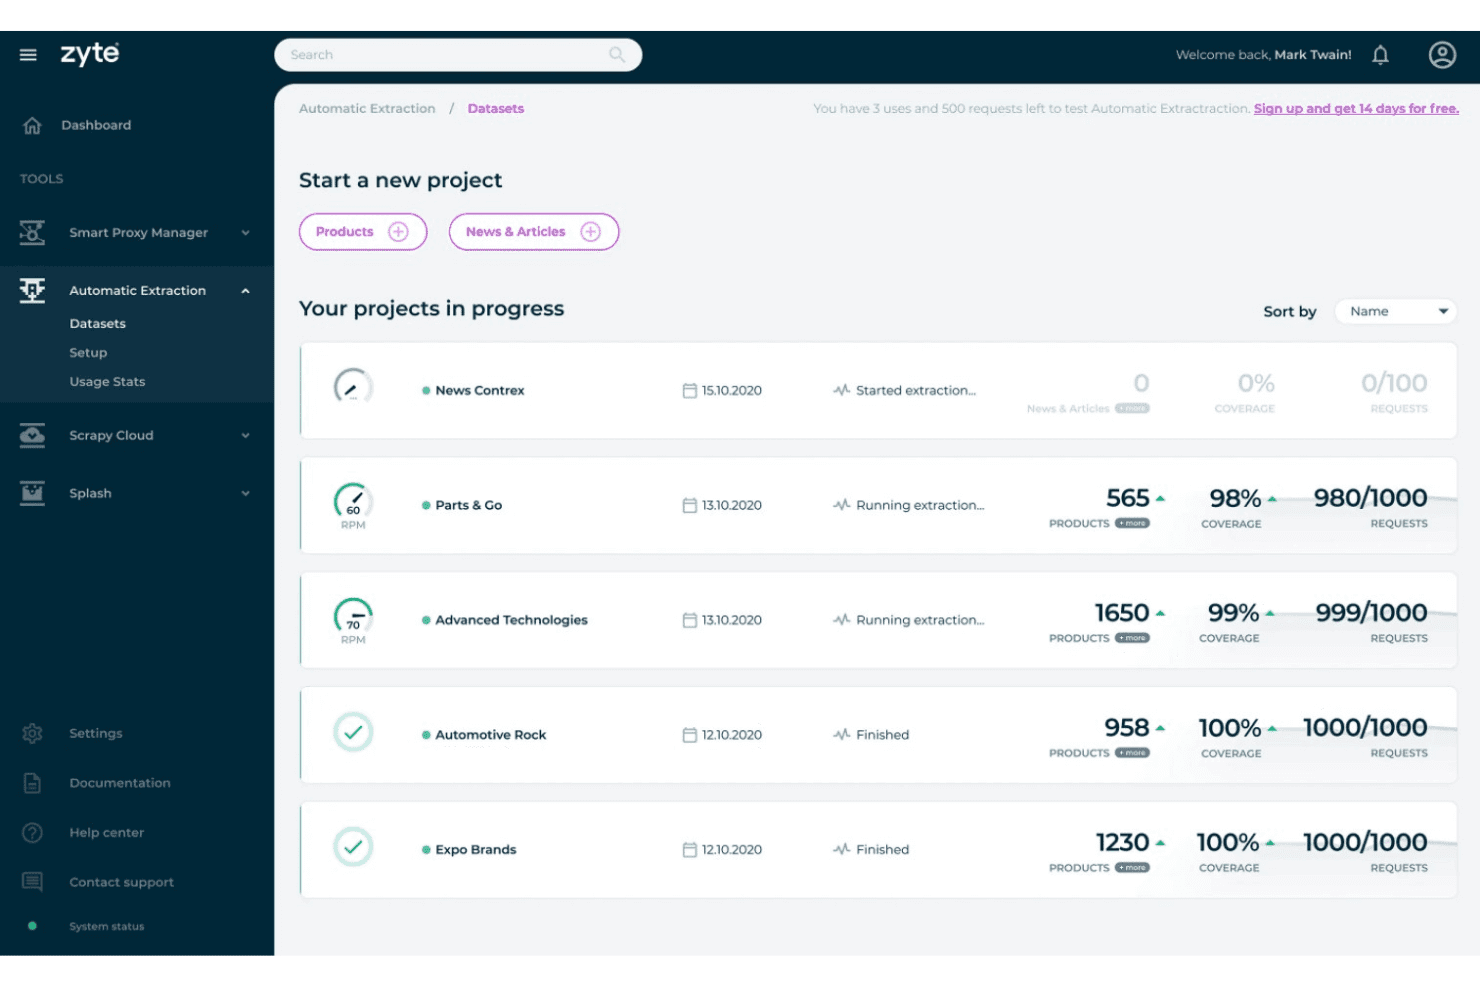
De functie voor automatische extractie van Zyte biedt lopende en voltooide gegevensextractieprojecten met statistieken over dekking, productaantallen en verzoekgebruik. Zyte API is een webscraping-API die de weergave van websites in browsers zonder grafische interface, automatische proxydraaiing, CAPTCHA-oplossing en door AI aangedreven gegevensextractie combineert in één eindpunt.
Voor wie is Zyte API het meest geschikt?
Zyte API is zeer geschikt voor data-engineers en Python-ontwikkelaars die scrapingpijplijnen op productieschaal bouwen voor ML-modellen of analysesystemen.
Waarom ik voor Zyte API heb gekozen
Zyte API staat op mijn voorkeurslijst vanwege de manier waarop het automatische schemadetectie afhandelt. Richt het op een productpagina of artikel en de door een LLM aangedreven extractielaag retourneert getypeerde, gestructureerde JSON zonder dat ik ook maar één CSS-selector of XPath-expressie hoef te gebruiken. Wanneer een website zijn lay-out bijwerkt, past de AI zich aan. Dat betekent dat ik parsers niet voortdurend hoef aan te passen telkens wanneer een concurrent zijn cataloguspagina opnieuw ontwerpt.
Belangrijkste functies van Zyte API
- Directe browserweergave: Zyte API start voorverwarmde browsers zonder grafische interface om dynamische websites op aanvraag te laden.
- Volledige proxy-infrastructuur: Wisselt bij elk verzoek automatisch tussen residentiële, datacenter- en mobiele IP-adressen.
- Sessiebeheer: Behoudt permanente cookies en gebruikerssessies voor werkstromen waarvoor authenticatie of acties in meerdere stappen nodig zijn.
- Integraties voor cloudlevering: Stuurt geëxtraheerde gegevens rechtstreeks naar bestemmingen zoals AWS S3, Google Cloud of Azure voor verdere verwerking.
Zyte API-integraties
Zyte API biedt ingebouwde integraties met Scrapy, Scrapy Cloud en Python-SDK's, en levert een API voor aangepaste integraties. Het ondersteunt ook cloudlevering aan AWS S3, Google Cloud en Azure.
Pros and Cons
Pros:
- AI detecteert schema's automatisch zonder handmatige selectors
- Omzeilt antibotbescherming zonder extra configuratie
- Voorverwarmde browsers elimineren vertragingen bij het opstarten
Cons:
- Voor het plannen van terugkerende taken zijn externe hulpmiddelen nodig
- Vereist programmeerkennis voor de implementatie
Learn more about Zyte API: Ideaal voor eenvoudige, API-gestuurde scrapingworkflows
- Gratis abonnement beschikbaar
- Vanaf $49/maand
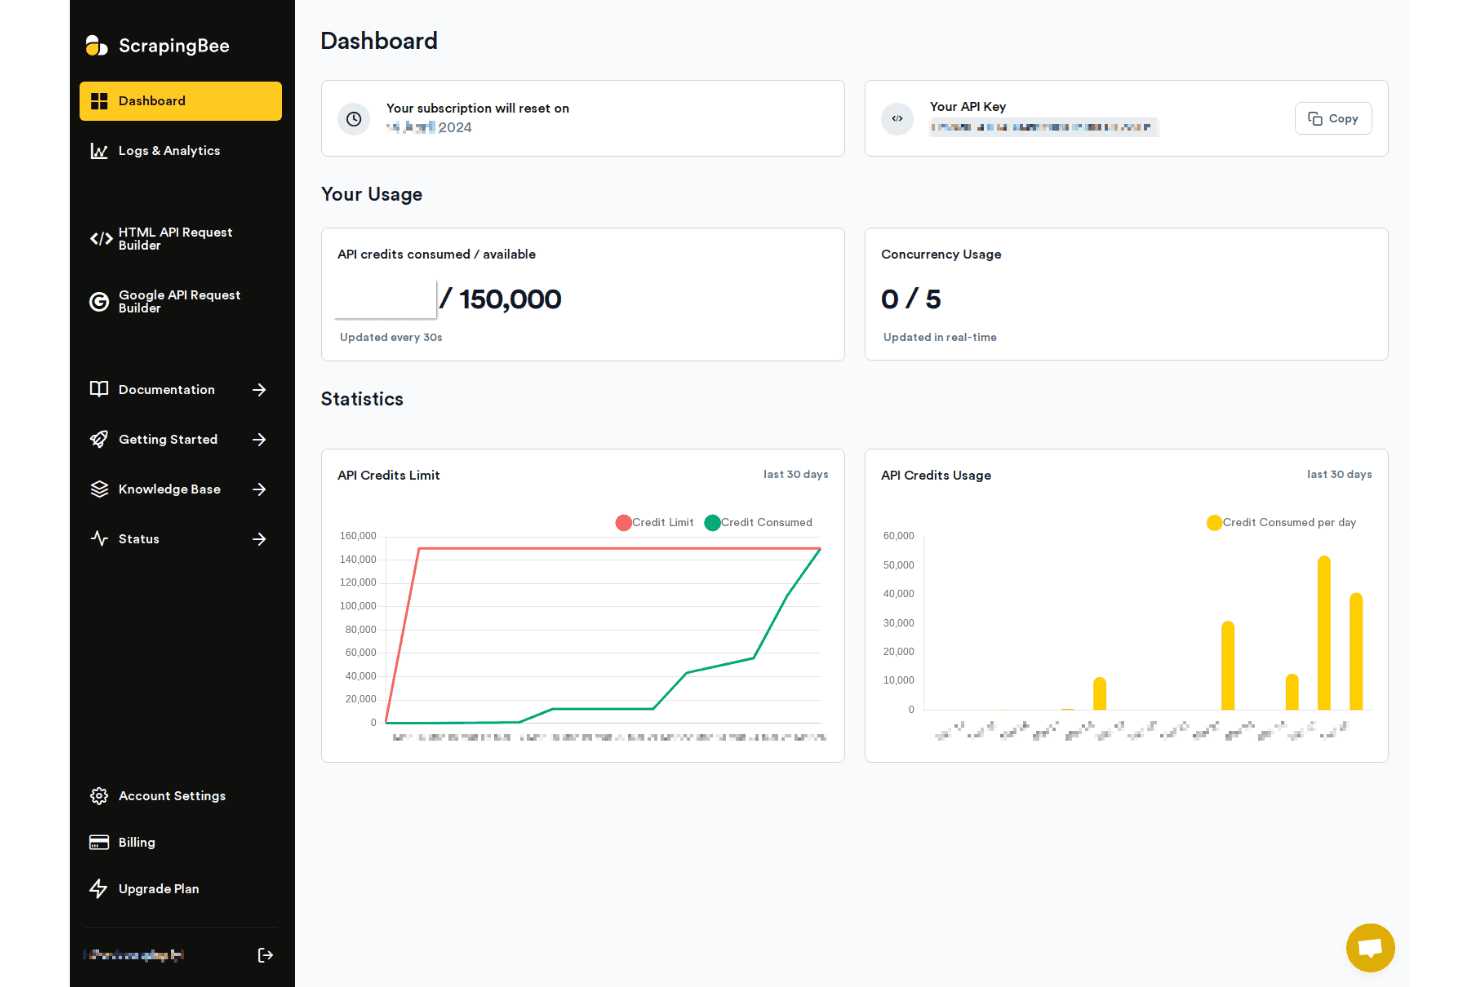
Het ScrapingBee-dashboard biedt een overzicht van API-kredietgebruik, statistieken over gelijktijdige processen en gebruiksgrafieken over 30 dagen om scrapingactiviteiten te monitoren. ScrapingBee is een webscraping-API die rendering met headless Chrome, proxyrotatie en het omzeilen van antibotsystemen afhandelt, met speciale extractie-API's voor platforms zoals Google, Amazon en Walmart.
Voor wie is ScrapingBee het meest geschikt?
ScrapingBee is zeer geschikt voor ontwikkelaars en data-engineers die een betrouwbare, op code gebaseerde API nodig hebben om webgegevens te extraheren zonder zelf proxy- of browserinfrastructuur vanaf nul te bouwen.
Waarom ik voor ScrapingBee koos
ScrapingBee staat op mijn shortlist vanwege de manier waarop de API de complexiteit van modern webscrapen op elegante wijze abstraheert. Eén verzoek handelt rendering met headless Chrome, heimelijke proxyrotatie en JavaScript-uitvoering af, waardoor ik geen browserbeheercode hoef te schrijven of proxygroepen afzonderlijk hoef te configureren. Ik ben ook enthousiast over de AI-queryfunctie, waarmee ik in gewone taal kan beschrijven wat ik wil extraheren in plaats van voor elke nieuwe site die ik benader CSS- of XPath-selectors te schrijven.
Belangrijkste functies van ScrapingBee
- Speciale scraping-API's: Kies vooraf gebouwde eindpunten voor platforms zoals Amazon, Walmart en Google Zoeken om veelvoorkomende taken voor gegevensverzameling te vereenvoudigen.
- Extractie met AI-query: Beschrijf in gewone taal welke gegevens je wilt extraheren en genereer automatisch gestructureerde resultaten.
- Markdown-extractor: Zet elke webpagina om naar Markdown of platte tekst voor snelle verwerking door vervolg-AI-modellen of databases.
- Integraties zonder code: Maak verbinding met Make, n8n en Zapier om workflows te automatiseren zonder aangepaste scripts voor planning te schrijven.
Integraties van ScrapingBee
ScrapingBee biedt oorspronkelijke integraties met Make, n8n en Zapier en stelt een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Brengt alleen kosten in rekening voor geslaagde verzoeken
- Handelt headless Chrome af zonder extra configuratie
- Speciale API's voor Amazon en Google
Cons:
- Geen ingebouwde oorspronkelijke taakplanner
- Kredietkosten stijgen snel op grote schaal
Learn more about ScrapingBee: Ideaal voor probleemloze IP-rotatie op grote schaal
- Gratis proefperiode van 7 dagen
- Vanaf $49/maand
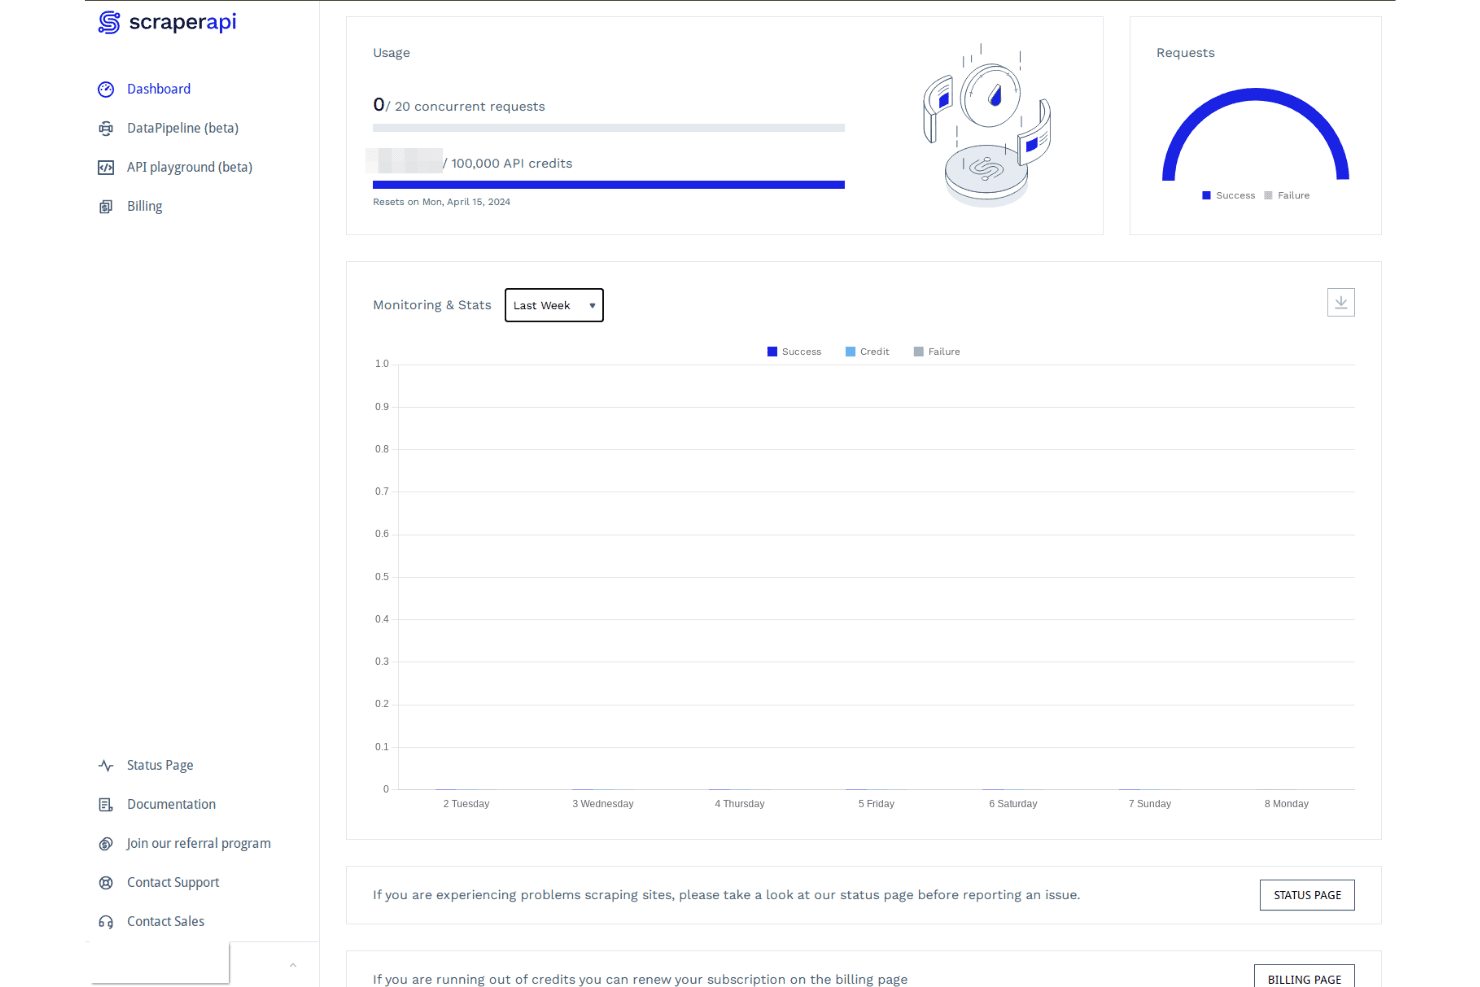
Het dashboard van ScraperAPI biedt gebruiksstatistieken, API-tegoed, gelijktijdige verzoeken en een wekelijkse monitoringgrafiek om de scrapingprestaties te volgen. ScraperAPI is een webscraping-API die proxydraaiing, JavaScript-rendering, CAPTCHA-omzeiling en gestructureerde gegevensextractie afhandelt, met vooraf gebouwde eindpunten voor belangrijke e-commerce- en zoekplatforms.
Voor wie is ScraperAPI het meest geschikt?
ScraperAPI is zeer geschikt voor backendontwikkelaars en data-engineers die op grote schaal gegevens moeten verzamelen van sites die worden beschermd tegen bots of intensief gebruikmaken van JavaScript.
Waarom ik voor ScraperAPI heb gekozen
ScraperAPI staat op mijn shortlist vanwege de manier waarop het proxiebeheer achter de schermen afhandelt. Wanneer ik op grote schaal prijsgegevens van producten uit Amazon of Google Shopping ophaal, hoef ik zelf geen proxypool te configureren of te onderhouden. ScraperAPI leidt elk verzoek via zijn proxynetwerk van meer dan 40 miljoen IP-adressen en probeert verzoeken bij fouten automatisch opnieuw. Ik waardeer ook het premium proxyniveau, dat wordt ingeschakeld voor sites die worden beschermd door Cloudflare of Datadome, zonder dat ik aan mijn kant extra configuratie hoef uit te voeren.
Belangrijkste functies van ScraperAPI
- Eindpunten voor gestructureerde gegevens: Vooraf gebouwde API's leveren geparseerde JSON van Amazon, Google Search, Walmart en vergelijkbare sites voor veelgebruikte scrapingdoelen.
- Sessiepersistentie: Ondersteunt sessies met een vast IP-adres om indien nodig hetzelfde IP-adres voor meerdere verzoeken te behouden.
- Ondersteuning voor asynchroon scrapen: Maakt asynchrone gegevensverzameling mogelijk voor het efficiënt verwerken van miljoenen gelijktijdige verzoeken.
- Wereldwijd proxynetwerk: Krijg toegang tot meer dan 40 miljoen IP-adressen in meer dan 50 landen om scraping op grote schaal op geografische doelen af te stemmen.
Integraties van ScraperAPI
ScraperAPI biedt SDK's voor Python, Node.js, PHP, Ruby, Java en cURL, en biedt een LangChain-integratie voor AI-werkstromen. Er is een API beschikbaar voor aangepaste integraties. Ingebouwde integraties zijn niet duidelijk gedocumenteerd.
Pros and Cons
Pros:
- Alleen kosten voor geslaagde verzoeken
- Vooraf gebouwde JSON-eindpunten voor Amazon, Google en Walmart
- Geotargeting in meer dan 50 landen
Cons:
- Tegoed wordt niet meegenomen naar volgende factureringscycli
- JavaScript-rendering en premiumproxy's kunnen de kosten snel laten oplopen
Learn more about ScraperAPI:
Andere tools voor webscraping
Hier zijn enkele aanvullende opties voor tools voor webscraping die mijn shortlist niet hebben gehaald, maar die toch het bekijken waard zijn:
- 11CrawlbaseIdeaal voor API-toegang tot wereldwijde gegevensbronnen
- 12ScrapyIdeaal voor aanpasbare Python-frameworks voor webscraping
- 13ScrapingdogIdeaal voor snelle implementatie met minimale configuratie
Hoe ik tools voor webscraping evalueer
Ik splits mijn evaluatie op in twee lagen: het basisniveau dat een tool nodig heeft om realistische scraping aan te kunnen—JS-rendering, proxyrotatie, geplande taken—en de onderscheidende factoren die de beste opties onderscheiden.
Basisfunctionaliteit (basisvereisten voor deze lijst)
Wanneer ik tools voor mijn lijst selecteer, beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde kernfunctionaliteit. Vervolgens bereken ik de totaalscore van de tool als percentage. Elke tool moet een minimale totaalscore van 65% behalen om in aanmerking te komen voor opname.
- Engine voor gegevensextractie: Ik beoordeel of een tool meerdere selectormethoden ondersteunt, zoals CSS, XPath en regex, of een visuele bouwer biedt voor teams die de voorkeur geven aan een configuratie waarbij ze punten aanklikken.
- JavaScript-rendering: Sites die zijn gebouwd met React, Vue of Angular hebben ondersteuning voor browsers zonder grafische interface nodig. Ik controleer of de rendering betrouwbaar is en of configureerbare wachtvoorwaarden beschikbaar zijn.
- Proxy- en anti-botafhandeling: Ik zoek naar ingebouwde proxyrotatie, CAPTCHA-oplossing en omzeilingsmechanismen die bescherming zoals Cloudflare of DataDome zonder extra configuratie kunnen afhandelen.
- Planning & automatisering: Terugkerende scrapetaken moeten zonder toezicht kunnen worden uitgevoerd. Ik beoordeel of de tool planning in cronstijl, webhooktriggers en logica voor het opnieuw proberen na fouten ondersteunt.
- Export van gestructureerde gegevens: Ik controleer welke uitvoerindelingen beschikbaar zijn en of de tool gegevens rechtstreeks kan doorsturen naar bestemmingen zoals S3, Google Sheets, databases of API's.
- Schaalbaarheid & gelijktijdigheid: Grote taken over duizenden pagina's vereisen parallelle verzoeken. Ik kijk naar limieten voor gelijktijdigheid en of de tool gedistribueerd crawlen ondersteunt.
Nadat ik een lijst heb samengesteld van tools die aan de criteria voldoen, bekijk ik wat elk platform onderscheidt.
Onderscheidende factoren (wat aanbieders van elkaar onderscheidt)
Zo vergelijk ik verschillende aanbieders met elkaar:
Onderscheidende functies
Bij het omzeilen van maatregelen tegen bots zie ik het grootste verschil tussen tools. Ik zoek naar ingebouwde CAPTCHA-oplossing en browservingerafdrukken die bescherming zoals Cloudflare of DataDome kunnen afhandelen zonder dat je externe proxydiensten hoeft te zoeken. Sjablonen voor automatische detectie zijn ook erg belangrijk—tools zoals Bright Data en Zyte bieden vooraf gebouwde scrapers voor veelgebruikte doelen zoals Amazon of Google SERP's, wat uren handmatige configuratie van selectors bespaart. Ik beoordeel ook de mogelijkheden voor planning en monitoring, met name foutmeldingen en automatische nieuwe pogingen die datapijplijnen draaiende houden wanneer doelwebsites hun indeling 's nachts wijzigen.
Meer dan alleen functies
Prijsmodellen lopen in deze sector sterk uiteen—sommige aanbieders rekenen per API-verzoek, andere op basis van bandbreedte of succesvol geretourneerde pagina's. Ik beoordeel of de kosten voorspelbaar blijven wanneer je opschaalt naar miljoenen pagina's per maand. Proxy-infrastructuur is een andere belangrijke onderscheidende factor. Ik controleer of een tool residentiële en datacenterproxies bevat met ingebouwde geotargeting op stadsniveau, aangezien het afsluiten van afzonderlijke proxycontracten extra kosten en complexiteit met zich meebrengt. Ook de nalevingsaanpak is belangrijk, vooral voor teams die scrapen in gereguleerde sectoren, waar de omgang met GDPR en robots.txt duidelijk moet zijn gedocumenteerd.
Zo kies je tools voor webscraping
Het is gemakkelijk om verstrikt te raken in lange lijsten met functies en ingewikkelde prijsstructuren. Om je te helpen gefocust te blijven tijdens je unieke selectieproces voor software, volgt hier een checklist met factoren om rekening mee te houden:
| Factor | Waar je op moet letten |
|---|---|
| FactorSchaalbaarheid | Waar je op moet lettenKan de tool de verwachte volumetoename en parallelle crawls aan zonder grote kostenstijgingen of snelheidslimieten? |
| FactorIntegraties | Waar je op moet lettenLevert de tool gegevens rechtstreeks aan je doelsystemen (cloudopslag, databases, workflows) of zijn handmatige stappen nodig? |
| FactorAanpasbaarheid | Waar je op moet lettenKun je de extractielogica afstemmen op unieke sitestructuren, of ben je beperkt tot vooraf ingestelde sjablonen en regels? |
| FactorGebruiksgemak | Waar je op moet lettenKunnen zowel technische als niet-technische gebruikers scrapes beheren, of heb je voortdurend hulp van ontwikkelaars nodig om wijzigingen door te voeren? |
| FactorImplementatie en onboarding | Waar je op moet lettenHoe snel kan je team een eerste gegevenspijplijn opzetten en welke ondersteuning of documentatie is beschikbaar als je vastloopt? |
| FactorKosten | Waar je op moet lettenZijn de prijzen voorspelbaar wanneer het gebruik toeneemt? Wees realistisch over pieken, logica voor nieuwe pogingen en fout-positieven in je werklast. |
| FactorBeveiligingsmaatregelen | Waar je op moet lettenStelt de tool je bedrijf of workflow bloot aan compliance-risico's, datalekken of punten voor onbevoegde toegang? |
| FactorCompliancevereisten | Waar je op moet lettenSluit de aanpak van de leverancier aan bij je interne en regionale regels (bijv. GDPR, naleving van robots.txt en verwerking van persoonsgegevens)? |
Wat zijn tools voor webscraping?
Tools voor webscraping zijn softwareplatforms die het ophalen en extraheren van gestructureerde gegevens van websites automatiseren. Met deze tools kun je informatie van pagina's vastleggen—inclusief dynamische en door JavaScript gegenereerde inhoud—voor gebruik in analyses, rapportages of integratie met interne databases. De meeste bieden opties om extractieregels te configureren en gegevens te exporteren in formaten die geschikt zijn voor ontwikkelaars.
Functies van tools voor webscraping
Let bij het selecteren van tools voor webscraping op de volgende belangrijke functies:
- Gegevensverzamelingsengine: Hiermee definieer je hoe inhoud van websites wordt verzameld met CSS-selectors, XPath of interfaces met aanwijzen en klikken, voor gestructureerde resultaten.
- JavaScript-rendering: Laadt dynamische apps of apps met één pagina door JavaScript uit te voeren, zodat gegevens die niet in de statische HTML verschijnen toch worden vastgelegd.
- Proxybeheer: Roteert IP-adressen, vaak met behulp van residentiële proxydiensten, om geografische blokkades, snelheidslimieten of botbescherming te omzeilen, zodat je op betrouwbare wijze op grote schaal websites kunt scrapen.
- CAPTCHA-verwerking: Detecteert en lost CAPTCHA-uitdagingen automatisch op of omzeilt deze, zodat gegevenspijplijnen blijven draaien wanneer antibotmaatregelen worden geactiveerd.
- Planning en automatisering: Plant terugkerende scrapetaken of activeert taken op basis van specifieke intervallen, waardoor onbewaakte werking en integratie in gegevenspijplijnen mogelijk zijn.
- Export van gestructureerde gegevens: Ondersteunt uitvoer naar JSON, CSV, XML of rechtstreekse levering aan cloudopslag, API's of databases, waardoor handmatige conversie- en uploadstappen overbodig worden.
- Wijzigingsdetectie en waarschuwingen: Houdt doelwebsites in de gaten voor inhoudsupdates, prijswijzigingen of nieuwe vermeldingen en waarschuwt je als de resultaten verschillen van eerdere uitvoeringen.
- Beheer van gelijktijdige processen: Beheert meerdere parallelle verzoeken voor snellere scrapsessies en ondersteunt grootschalige crawltaken over duizenden pagina's.
- Foutafhandeling en logboekregistratie: Houdt mislukte gegevensverzamelingen, verbroken verbindingen of wijzigingen aan websites bij en levert gedetailleerde foutenlogboeken om problemen met scraping snel te diagnosticeren en op te lossen.
- Toegangsbeheer voor gebruikers: Beperkt wie projecten mag bewerken, taken mag beheren of exports mag bekijken, om de beveiliging te handhaven en onopzettelijke of onbevoegde wijzigingen te voorkomen.
Veelvoorkomende AI-functies van tools voor webscraping
Naast de hierboven genoemde standaardfuncties van tools voor webscraping integreren veel van deze oplossingen AI met functies zoals:
- Automatische detectie van gegevensvelden: Gebruikt AI om relevante gegevensvelden op complexe of onbekende webpagina's automatisch te identificeren en in kaart te brengen, waardoor handmatige configuratie van selectors minder nodig is.
- Adaptieve herkenning van websitestructuren: Leert van wijzigingen in websitelay-outs en past zich daaraan aan, waardoor uitvaltijd en onderhoud worden beperkt wanneer doelwebsites hun ontwerp wijzigen.
- Intelligente omzeiling van antibotmaatregelen: Gebruikt AI om menselijke browsepatronen na te bootsen en scrapingstrategieën in realtime aan te passen, zodat geavanceerde botdetectiesystemen kunnen worden omzeild.
- Inhoudsanalyse in natuurlijke taal: Gebruikt AI om ongestructureerde tekst te extraheren, samen te vatten of te categoriseren, waardoor beoordelingen, artikelen of forumberichten eenvoudiger kunnen worden geanalyseerd.
- Automatische sjabloongeneratie: Bouwt herbruikbare scrapsjablonen voor vergelijkbare websites door de paginavormgeving en inhoudspatronen met machine learning te analyseren.
- Intelligente foutcorrectie: Detecteert en verhelpt veelvoorkomende fouten of afwijkingen bij het verzamelen van gegevens met AI-gestuurde diagnostiek, waardoor handmatige probleemoplossing minder nodig is.
Voordelen van tools voor webscraping
Het implementeren van tools voor webscraping biedt verschillende voordelen voor je team en je bedrijf. Hier zijn enkele voordelen waar je naar kunt uitkijken:
- Gegevensverzameling op grote schaal: Automatiseert het extraheren van informatie uit veel websites en pagina's, waardoor grote gegevensverzamelingen beschikbaar komen voor analyse of machine learning.
- Realtime marktinzichten: Houd concurrentieprijzen, productcatalogi en wijzigingen aan websites direct in de gaten met plannings-, wijzigingsdetectie- en waarschuwingsfuncties.
- Efficiënt gebruik van middelen: Plant en automatiseert taken, waardoor handmatig werk wordt verminderd en ontwikkelaars zich kunnen richten op projecten met een hogere waarde.
- Consistente gegevenskwaliteit: Exporteert gestructureerde gegevens in betrouwbare indelingen zoals JSON of CSV, waardoor tijdrovend opschonen en integreren van gegevens tot een minimum wordt beperkt.
- Antibotblokkades omzeilen: Gebruikt ingebouwde proxyrotatie of externe roterende proxydiensten, samen met CAPTCHA-verwerking en het omzeilen van antibotmaatregelen, om toegang te krijgen tot inhoud die andere oplossingen niet kunnen bereiken.
- Aanpasbaarheid aan wijzigingen op websites: Vertrouwt op intelligente foutafhandeling en (voor tools met AI) automatisch aangepaste gegevensverzameling wanneer websitelay-outs of -structuren veranderen.
- Veilige toegang en naleving: Beschermt gegevenspijplijnen met gebruikersrechten, auditlogboeken en afstemming op nalevingskaders of privacyregelgeving.
Kosten en prijzen van tools voor webscraping
Bij het selecteren van tools voor webscraping is inzicht in de verschillende beschikbare prijsmodellen en abonnementen vereist. De kosten variëren op basis van functies, teamgrootte, uitbreidingen en meer. De onderstaande tabel geeft een overzicht van veelvoorkomende abonnementen, hun gemiddelde prijzen en de functies die doorgaans zijn inbegrepen in oplossingen voor tools voor webscraping:
Vergelijkingstabel van abonnementen voor tools voor webscraping
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Type abonnementGratis abonnement | Gemiddelde prijs$0-$10/maand | Veelvoorkomende functiesBeperkte extractieruns, eenvoudige planning, communityondersteuning en basisindelingen voor gegevensexport. |
| Type abonnementPersoonlijk abonnement | Gemiddelde prijs$15-$40/maand | Veelvoorkomende functiesMeer extractietegoed, JavaScript-rendering, API-toegang en eenvoudige foutafhandeling. |
| Type abonnementZakelijk abonnement | Gemiddelde prijs$55-$150/maand | Veelvoorkomende functiesHogere gelijktijdigheid, proxyrotatie, geavanceerde planning, tools voor teamsamenwerking en prioriteitsondersteuning. |
| Type abonnementEnterprise-abonnement | Gemiddelde prijs$250+/maand | Veelvoorkomende functiesAangepaste integraties, SLA-garanties, geogerichte proxy's, begeleide onboarding en toegewijd accountbeheer. |
Veelgestelde vragen over tools voor webscraping
Hier volgen enkele antwoorden op veelgestelde vragen over tools voor webscraping:
Heb ik programmeerkennis nodig om tools voor webscraping te gebruiken?
Nee, programmeerkennis is niet per se vereist. Veel visuele tools bieden een oplossing zonder code, zoals een Chrome-extensie met aanwijzen en klikken, waarmee niet-technische gebruikers visueel extractieroutines kunnen bouwen en door de sitemap van een site kunnen navigeren om gegevens te verzamelen voor taken zoals leadgeneratie.
Voor aangepaste logica, complexe datapijplijnen of scraping op grote schaal wordt doorgaans gebruikgemaakt van programmeertools:
- Python: Een traditionele Python-bibliotheek zoals BeautifulSoup is ideaal om statische HTML-documenten netjes te parseren.
- JavaScript: Een gespecialiseerde Node.js-bibliotheek (zoals Puppeteer of Playwright) stelt ontwikkelaars in staat programmatisch te communiceren met dynamische webelementen.
Kunnen tools voor webscraping dynamische websites en websites met veel JavaScript verwerken?
Ja, de meeste moderne tools bieden JavaScript-renderingengines om dynamische inhoud van singlepage-applicaties (SPA’s) en interactieve sites te scrapen.
Hoe gaan tools voor webscraping om met antibotmaatregelen van websites?
Om antibotbescherming te omzeilen, zetten geavanceerde tools verschillende ontwijkingsstrategieën in:
- Roterende proxy’s: Verzoeken verdelen over grote IP-pools (datacenter- en residentiële IP’s) om snelheidslimieten of IP-blokkades te voorkomen.
- Geautomatiseerde CAPTCHA-oplossers: Visuele en gedragsmatige uitdagingen oplossen of omzeilen.
- Maskering van browserfingerprints: Browserheaders, canvas-fingerprints en gebruikersagenten in engines (zoals WebKit of Chromium) aanpassen om menselijke interacties in grote browsers zoals Firefox of Chrome na te bootsen.
Is webscraping legaal?
De legaliteit van webscraping hangt af van welke gegevens u verzamelt, hoe u deze gebruikt en wat er in de servicevoorwaarden van de website staat. Controleer altijd de wettelijke richtlijnen en nalevingsvereisten voordat u doorgaat.
Hoe ontvang en bewaar ik de gescrapete gegevens?
U kunt gegevens doorgaans exporteren naar indelingen zoals CSV, JSON en Excel, of ze rechtstreeks doorsturen naar cloudopslag, webhooks of databases, afhankelijk van de integratieopties van de tool.