

10 beste tools voor chaos-engineering in 2026

10 Shortlist van de beste chaos-engineeringtools


Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Samenvatting van de beste chaos-engineeringtools
Deze vergelijkingsgrafiek vat de prijsgegevens van mijn selectie van de beste chaos-engineeringtools samen, zodat je de beste optie voor je budget en bedrijfsbehoeften kunt vinden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Het beste voor dynamische risicoanalyse binnen systemen | 30 dagen gratis uitproberen + gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 2 | Het meest geschikt voor aanpasbare foutscenario's in Linux | Voor altijd gratis (open source) | Gratis te gebruiken | Website | |
| 3 | Het beste voor geautomatiseerde veerkrachtworkflows | Voor altijd gratis (open source) | Gratis te gebruiken | Website | |
| 4 | Beste voor geautomatiseerde beëindiging van instanties | Voor altijd gratis (open source) | Gratis te gebruiken | Website | |
| 5 | Het beste voor risicovalidatie met omgevingsscans | Gratis proefperiode van 30 dagen + gratis demo beschikbaar | Prijzen op aanvraag | Website | |
| 6 | Het meest geschikt voor nauwkeurige foutinjectie op grote schaal | 14 dagen gratis proberen + gratis demo beschikbaar | Prijs op aanvraag | Website | |
| 7 | Ideaal voor geïntegreerde tests van weerbaarheid | Gratis proefversie + gratis demo beschikbaar | Prijzen op aanvraag | Website | |
| 8 | Beste voor native verstoringen van de AWS-cloud | Gratis abonnement beschikbaar | Vanaf $0.10/action-minute | Website | |
| 9 | Het beste voor chaos-experimenten voor Azure-gebruikers | Een gratis proefperiode van 30 dagen beschikbaar | Vanaf $0.10/actieminuut | Website | |
| 10 | Het beste voor Kubernetes-native chaosorkestratie | Voor altijd gratis (open source) | Gratis te gebruiken | Website |
Beoordelingen van de beste chaos-engineeringtools
Hieronder vind je mijn uitgebreide samenvattingen van de beste chaos-engineeringtools die op mijn shortlist zijn beland. In mijn beoordelingen bespreek ik de functies, gebruiksscenario’s en integraties van elke tool in detail, zodat je de beste optie voor jou kunt vinden.

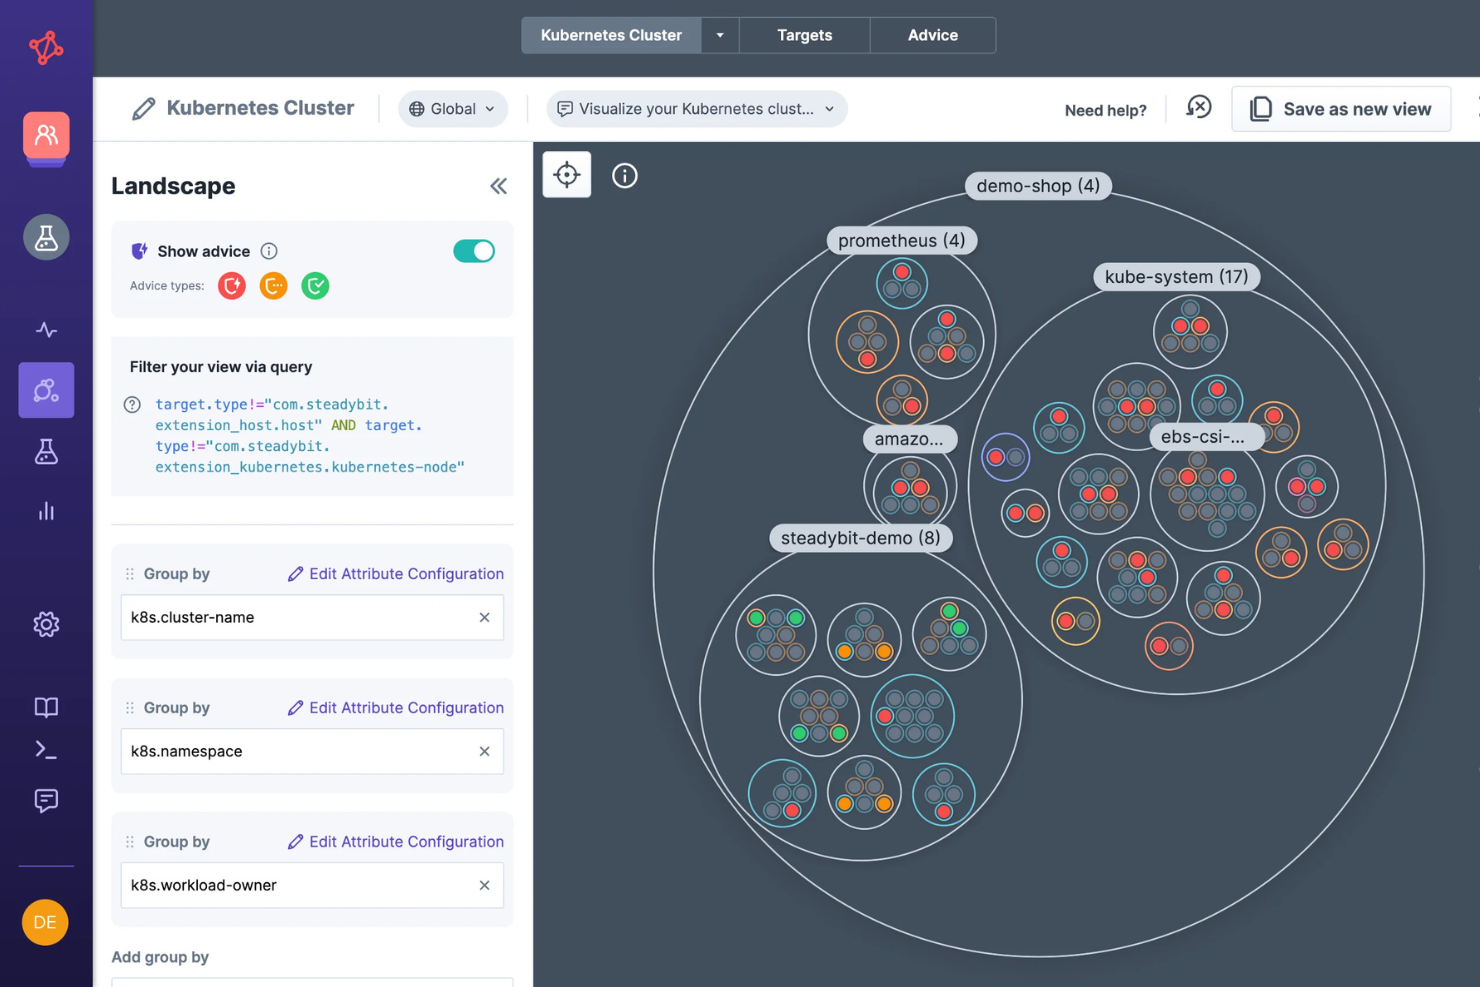
Steadybit is een platform voor chaostechniek dat geautomatiseerde opsporing van kwetsbaarheden, experimenteerontwerp zonder code en betrouwbaarheidscontroles voor Kubernetes combineert om voortdurend zwakke plekken in systemen aan het licht te brengen en te valideren voordat ze incidenten veroorzaken.
Voor wie is Steadybit het meest geschikt?
Steadybit is zeer geschikt voor platformengineering- en SRE-teams die cloudgebaseerde omgevingen op basis van Kubernetes beheren en behoefte hebben aan voortdurende betrouwbaarheidsvalidatie binnen gedistribueerde systemen.
Waarom ik voor Steadybit koos
Ik koos Steadybit als een van de beste oplossingen omdat de functie voor betrouwbaarheidsadvies anders is dan alles wat ik in andere tools heb gezien. De functie controleert voortdurend je actieve doelen aan de hand van 13 beste praktijken voor Kubernetes en brengt de hiaten automatisch aan het licht en prioriteert ze. Ik vind het prettig dat ik aangepaste adviesregels kan toevoegen die aansluiten bij interne standaarden, zodat de risicoanalyse mijn daadwerkelijke omgeving weerspiegelt en niet alleen algemene benchmarks. In de verkenningsweergave kan ik die doelen vervolgens groeperen en filteren op beschikbaarheidszone en regio, zodat ik precies kan zien waar de risico's zich binnen gedistribueerde systemen concentreren.
Belangrijkste functies van Steadybit
- Experimenteditor zonder code: Ontwerp en voer chaos-experimenten uit met een interface voor slepen en neerzetten, zonder scripts te schrijven.
- Vooraf gebouwde experimenteersjablonen: Kies uit kant-en-klare sjablonen voor veelvoorkomende storingsscenario's om het opzetten van experimenten te versnellen.
- Controle over de impactradius: Stel grenzen voor experimenten vast om de reikwijdte van foutinjectie te beperken en kritieke systeemonderdelen te beschermen.
- Automatisering via API en CLI: Start en plan experimenten automatisch met behulp van de API of opdrachtregelinterface van Steadybit.
Integraties van Steadybit
Steadybit biedt meer dan 20 open-source-integraties, waaronder AWS, Azure, GCP, Kubernetes, Datadog, Dynatrace, New Relic, Prometheus, Grafana en Slack. Je kunt ook aangepaste uitbreidingen bouwen met de open-source-uitbreidingskits van Steadybit en ze via Jenkins en GitHub verbinden met CI/CD-werkstromen.
Pros and Cons
Pros:
- Geautomatiseerde opsporing van risico's voordat experimenten worden uitgevoerd
- Open-source-uitbreidingskits voor aanpassing
- Implementatieopties als SaaS en op locatie
Cons:
- Voornamelijk op Kubernetes gerichte opsporing van doelen
- Kleinere gemeenschap dan open-sourcealternatieven

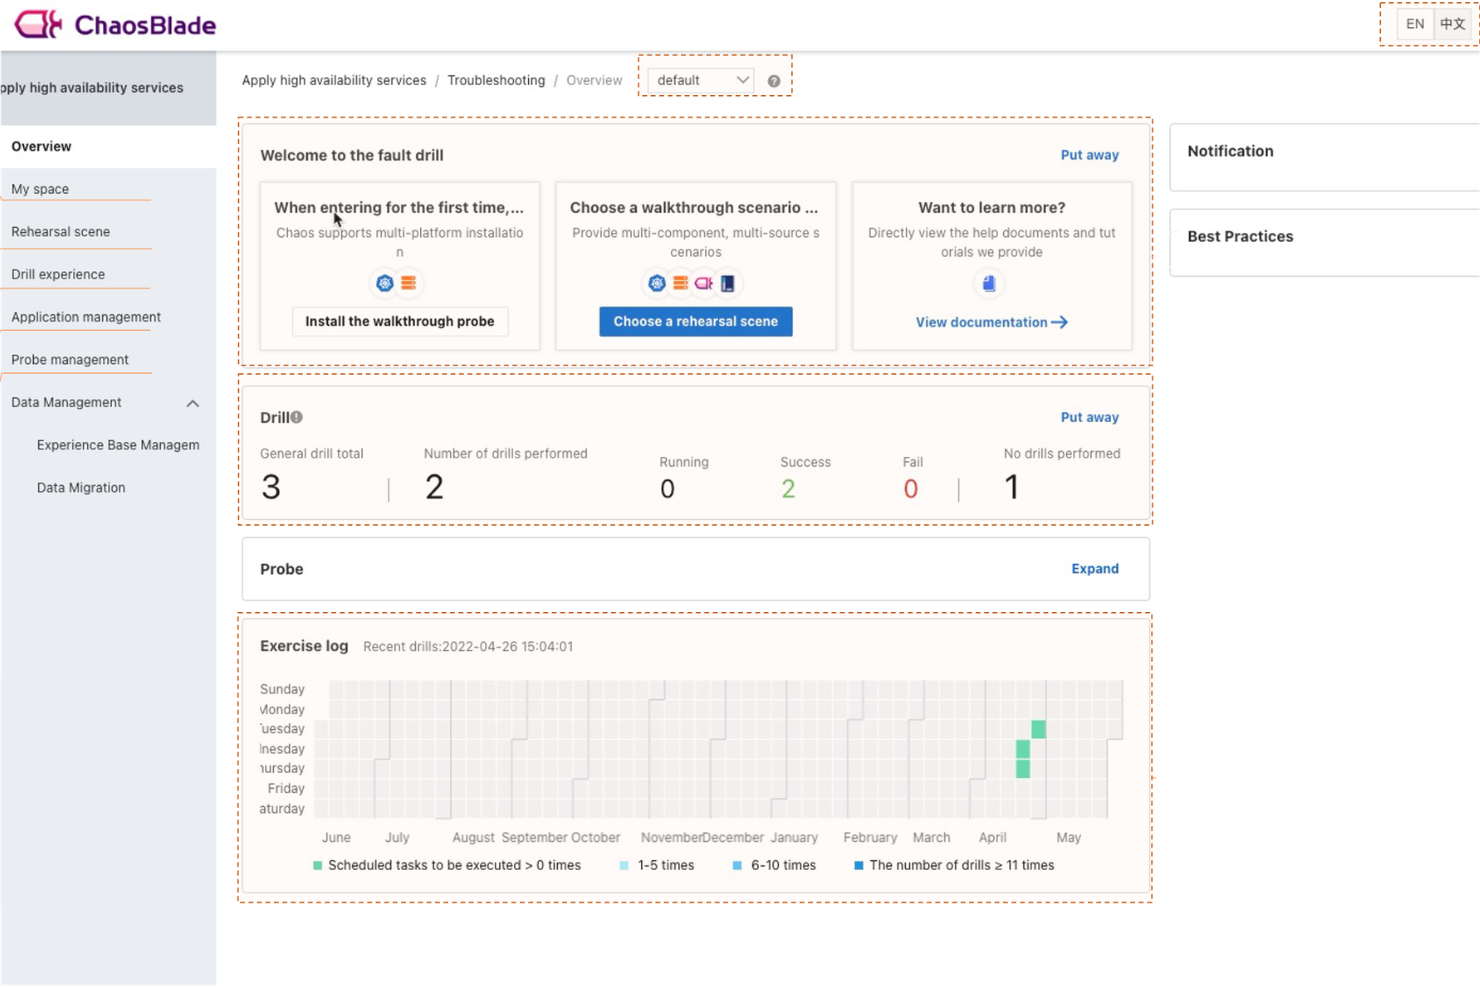
Chaos Toolkit is een open-sourceframework voor chaos engineering dat declaratieve, in JSON of YAML gedefinieerde experimenten uitvoert om de veerkracht van systemen in cloud-, container- en applicatieomgevingen te testen.
Voor wie is Chaos Toolkit het meest geschikt?
Chaos Toolkit is zeer geschikt voor DevOps-engineers en SRE's die veerkrachtexperimenten als code willen definiëren en in versiebeheer willen opnemen binnen bestaande CI/CD-pijplijnen.
Waarom ik Chaos Toolkit heb gekozen
Ik heb Chaos Toolkit opgenomen in mijn topkeuzes omdat het model waarbij experimenten als code worden vastgelegd echt is ontwikkeld voor geautomatiseerde veerkrachtworkflows. Elk experiment is één JSON- of YAML-bestand met een gedefinieerde hypothese over de stabiele toestand, een methodeblok met probes en acties en stappen voor terugdraaien, zodat ik het in Git kan versiebeheren en rechtstreeks vanuit een GitHub Actions- of GitLab CI-pijplijn kan starten. Ik vind het ook prettig dat de hypothese over de stabiele toestand zowel vóór als na de foutinjectie wordt uitgevoerd. Daardoor krijg ik een duidelijk, gestructureerd geslaagd/mislukt-signaal zonder handmatige vergelijking.
Belangrijkste functies van Chaos Toolkit
- Bibliotheek met extensiestuurprogramma's: Richt zich via speciaal ontwikkelde extensiepakketten op AWS, Azure, Google Cloud Platform, Kubernetes, Kafka, Istio en ToxiProxy, zodat je foutinjectie nauwkeurig kunt afstemmen op je omgeving.
- Besturingselementen: Voegt operationele hooks toe rond de uitvoering van experimenten, zodat je externe acties, zoals logboekregistratie of meldingen, vóór of na elke activiteit kunt starten zonder het kernbestand van het experiment aan te passen.
- De opdracht “Chaos discover”: Inspecteert een geïnstalleerde extensie en genereert een lijst met beschikbare activiteiten, zodat je kunt verkennen welke foutacties en probes worden ondersteund voordat je een experiment opstelt.
- Experimentplanning: Voert experimenten volgens een vast schema uit via de CLI, waardoor herhaaldelijk, onbemand testen van de veerkracht mogelijk wordt zonder een externe orkestratielaag.
Integraties van Chaos Toolkit
Chaos Toolkit biedt ongeveer 20 extensies, waaronder AWS, Azure, Google Cloud Platform, Kubernetes, Istio, Kafka, Prometheus, Datadog, Dynatrace en Slack. Het ondersteunt ook implementatie in CI/CD-workflows via GitHub Actions en GitLab, en met de Python-, HTTP- en procesproviders kun je aangepaste integraties bouwen.
Pros and Cons
Pros:
- Declaratieve YAML-experimenten opgeslagen in versiebeheer
- Native mechanisme voor terugdraaien om de stabiele toestand te herstellen
- Ontdekt automatisch services en stelt experimenten voor
Cons:
- Aanvallen op meerdere doelen vereisen een aangepaste stuurprogramma-instelling
- De frameworkgerichte opzet vereist handmatige samenstelling


Chaos Toolkit is een open-sourceframework voor chaosengineering dat declaratieve, in JSON of YAML gedefinieerde experimenten uitvoert om de veerkracht van systemen te testen in cloud-, container- en applicatieomgevingen.
Voor wie is Chaos Toolkit het meest geschikt?
Chaos Toolkit is een natuurlijke keuze voor DevOps-engineers en SRE's die veerkrachtexperimenten als code willen definiëren en versiebeheer willen toepassen binnen bestaande CI/CD-pijplijnen.
Waarom ik voor Chaos Toolkit heb gekozen
Ik heb Chaos Toolkit opgenomen in mijn topkeuzes omdat het model van experimenten als code echt is gebouwd voor geautomatiseerde veerkrachtworkflows. Elk experiment is één JSON- of YAML-bestand met een gedefinieerde hypothese over de stabiele toestand, een methodeblok met probes en acties en stappen voor terugdraaien, zodat ik het in Git kan beheren en rechtstreeks vanuit een GitHub Actions- of GitLab CI-pijplijn kan activeren. Ik vind het ook prettig dat de hypothese over de stabiele toestand zowel vóór als na de foutinjectie wordt uitgevoerd. Daardoor krijg ik een duidelijk, gestructureerd geslaagd/mislukt-signaal zonder handmatige vergelijking.
Belangrijkste functies van Chaos Toolkit
- Bibliotheek met extensiestuurprogramma's: Richt zich via speciaal ontwikkelde extensiepakketten op AWS, Azure, Google Cloud Platform, Kubernetes, Kafka, Istio en ToxiProxy, zodat je foutinjectie precies kunt afstemmen op je omgeving.
- Besturingselementen: Voegt operationele hooks toe rond de uitvoering van experimenten, zodat je externe acties, zoals logboekregistratie of meldingen, vóór of na elke activiteit kunt activeren zonder het kernbestand van het experiment aan te passen.
- De opdracht “Chaos discover”: Inspecteert een geïnstalleerde extensie en genereert een lijst met beschikbare activiteiten, zodat je kunt verkennen welke foutacties en probes worden ondersteund voordat je een experiment opstelt.
- Experimentplanning: Voert experimenten volgens een vast schema uit via de CLI, waardoor herhaaldelijk, onbemand testen van de veerkracht mogelijk wordt zonder een externe orkestratielaag.
Integraties van Chaos Toolkit
Chaos Toolkit biedt ongeveer 20 extensies, waaronder AWS, Azure, Google Cloud Platform, Kubernetes, Istio, Kafka, Prometheus, Datadog, Dynatrace en Slack. Het ondersteunt ook implementatie in CI/CD-workflows via GitHub Actions en GitLab, en met de Python-, HTTP- en procesproviders kun je aangepaste integraties bouwen.
Pros and Cons
Pros:
- Declaratieve YAML-experimenten opgeslagen in versiebeheer
- Ingebouwd terugdraaimechanisme voor herstel van de stabiele toestand
- Ontdekt automatisch services en stelt experimenten voor
Cons:
- Aanvallen op meerdere doelen vereisen een aangepaste configuratie van het stuurprogramma
- De frameworkgerichte opzet vereist handmatige samenstelling

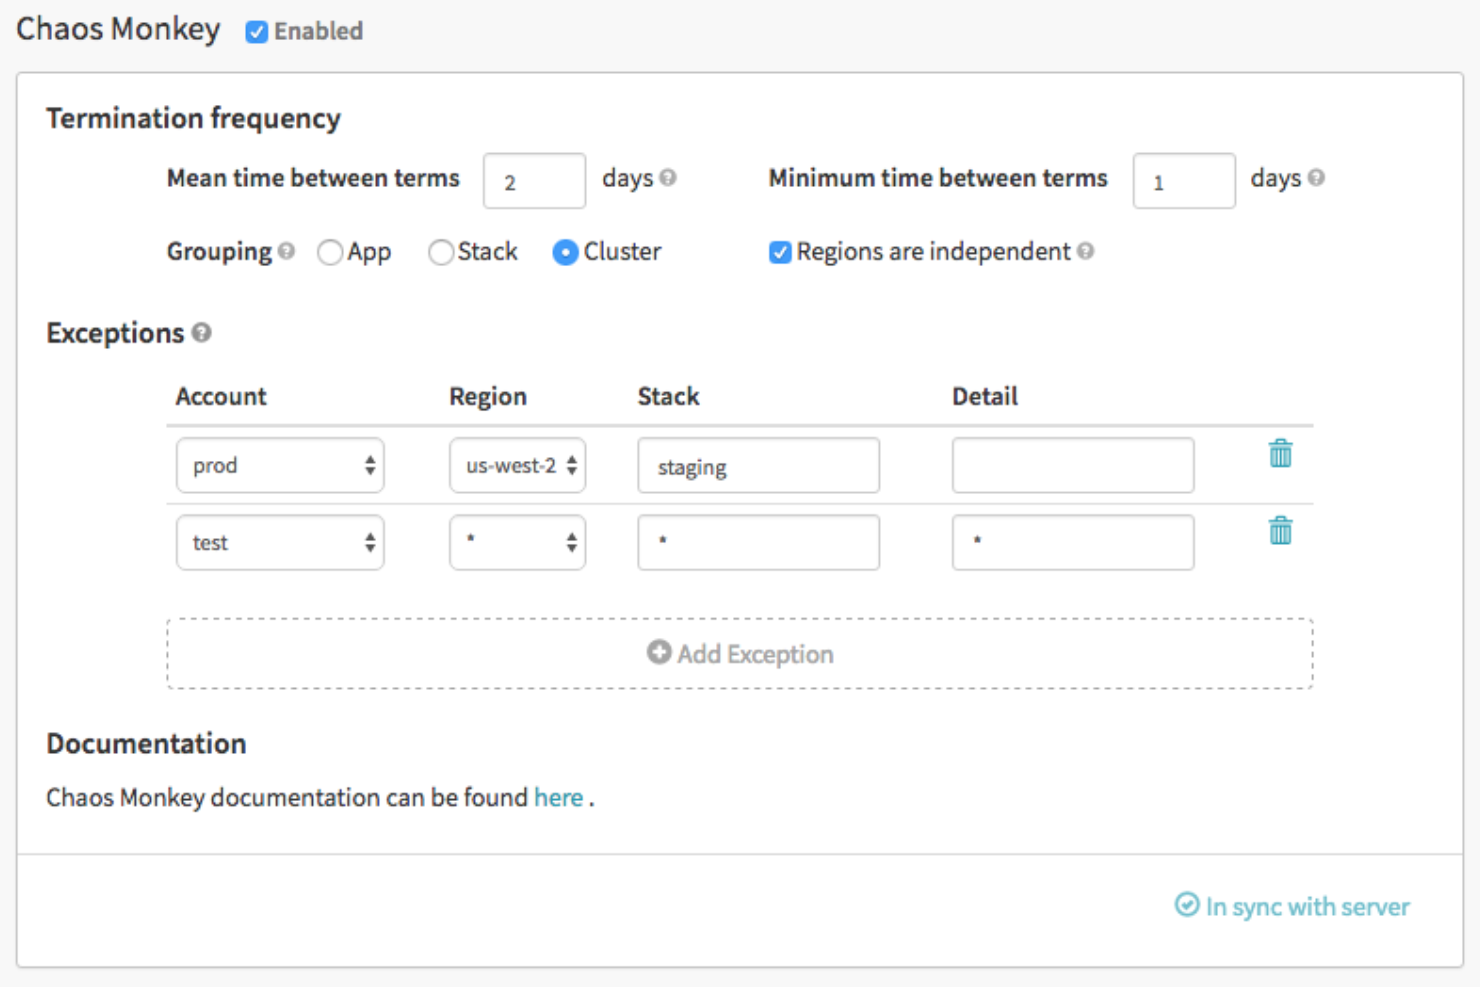
Chaos Monkey is een opensourcetool voor chaos-engineering, gebouwd door Netflix, die virtuele machine-instanties en containers die in uw productieomgeving draaien willekeurig beëindigt.
Voor wie is Chaos Monkey het meest geschikt?
Chaos Monkey is geschikt voor engineers voor de betrouwbaarheid van sites bij grootschalige technologiebedrijven die geplande, geautomatiseerde fouttests in hun cloudinfrastructuur nodig hebben.
Waarom ik voor Chaos Monkey heb gekozen
Ik heb Chaos Monkey opgenomen in mijn topkeuzes omdat het een van de weinige tools voor chaos-engineering is die specifiek is gebouwd rond het geautomatiseerd beëindigen van instanties in live productieomgevingen. Ik vind het prettig dat de planning met gewogen muntworpen op weekdagen tussen 9.00 en 15.00 uur willekeurige beëindigingen activeert, waardoor tests realistisch blijven zonder handmatige configuratie. U kunt groepering ook configureren op app-, stack- of clusterniveau en uitzonderingsregels instellen om specifieke accounts of regio's tegen beëindiging te beschermen.
Belangrijkste functies van Chaos Monkey
- Spinnaker-integratie: Chaos Monkey maakt verbinding met Spinnaker om instantiegroepen te detecteren en beëindigingen in uw implementatiepijplijn te beheren.
- Configureerbaar beëindigingsvenster: Beperk beëindigingen tot kantooruren, zodat uw oproepteam beschikbaar is wanneer instanties uitvallen.
- Uitsluitingslijst: Markeer specifieke apps of clusters als vrijgesteld, zodat Chaos Monkey ze tijdens een beëindigingscyclus volledig overslaat.
- Bijhouden van beëindigingen: Elke beëindigde instantie wordt geregistreerd in een MySQL-database, zodat u in de loop der tijd een volledig auditspoor van chaosgebeurtenissen hebt.
Integraties van Chaos Monkey
Chaos Monkey heeft een kleine set native integraties. Spinnaker is vereist als kernafhankelijkheid voor appdetectie en beëindigingsbeheer, en MySQL als backenddatabase. Het ondersteunt ook dynamische configuratie via etcd of Consul.
Pros and Cons
Pros:
- Volledig opensource zonder licentiekosten
- Bewezen in productie op de schaal van Netflix
- Configureerbare beëindigingsschema's en -frequentie
Cons:
- Injecteert alleen fouten door instanties te beëindigen
- Vereist Spinnaker voor implementatiebeheer


Mitigant is een cloudbeveiligingsplatform voor chaos-engineering dat adversariële blootstellingsvalidatie, aanvalsemulatie in AWS, Azure en GCP, omgevingsscans op verkeerde configuraties en continue compliance-monitoring in Kubernetes- en multicloudomgevingen combineert.
Voor wie is Mitigant het meest geschikt?
Mitigant is zeer geschikt voor cloudbeveiligings- en SRE-teams in middelgrote tot grote organisaties die hun beveiligingspositie en veerkracht in multicloudomgevingen tegelijkertijd moeten valideren.
Waarom ik voor Mitigant heb gekozen
Ik heb Mitigant gekozen als een van de beste oplossingen omdat de omgevingsscan verder gaat dan passieve detectie. Het voert actief meer dan 500 vooraf gebouwde aanvalsscenario's uit die zijn gekoppeld aan MITRE ATT&CK in AWS, Azure en GCP, om zichtbaar te maken wat daadwerkelijk exploiteerbaar is en niet alleen wat verkeerd is geconfigureerd. Ik vind het ook goed dat de AI-analyse van de beveiligingspositie de aanvalsresultaten vertaalt naar geprioriteerde herstelstappen, waaronder de specifieke Sigma-detectieregels die je SIEM nodig heeft om elke techniek voortaan te detecteren.
Belangrijkste functies van Mitigant
- Aanvalsbouwer: Bouw en voer aangepaste aanvalsscenario's uit met Mitigants Cloud Attack Language om verder te gaan dan vooraf gebouwde experimenten en omgevingsspecifieke aanvalspaden te testen.
- Validatie van detectie: Voer gecontroleerde aanvallen uit om te bevestigen of je SIEM-, CDR- en clouddetectiemechanismen elke techniek daadwerkelijk detecteren voordat een echte aanvaller dat doet.
- Continue compliance-monitoring: Scan cloud- en Kubernetesomgevingen aan de hand van CIS Benchmarks, NIS2, DORA, PCI-DSS, SOC 2 en andere raamwerken, met voortdurende tracking van afwijkingen.
- AI-red teaming: Test AI-workloads die in cloudomgevingen draaien tegen geavanceerde aanvalstactieken die zijn gekoppeld aan MITRE ATLAS.
Integraties van Mitigant
Mitigant integreert met AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, Wiz, Prowler, Slack, Microsoft Teams, Jira en DefectDojo om bevindingen naar bestaande workflows te routeren. Aanvullende ondersteuning voor omgevingen omvat Alibaba Cloud, OpenShift, Docker, Hetzner, Exoscale, Open Telekom Cloud, SysEleven, Quay en Minikube. Er is een API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Aanvallen die aan MITRE ATT&CK zijn gekoppeld in multicloudomgevingen
- Veilige experimenten in productie met automatische terugdraaiing
- Ingebouwde compliance-monitoring voor meerdere raamwerken
Cons:
- Focus uitsluitend op de cloud sluit infrastructuur op locatie uit
- Kleinere community vergeleken met opensourcealternatieven

Gremlin
Het meest geschikt voor nauwkeurige foutinjectie op grote schaal
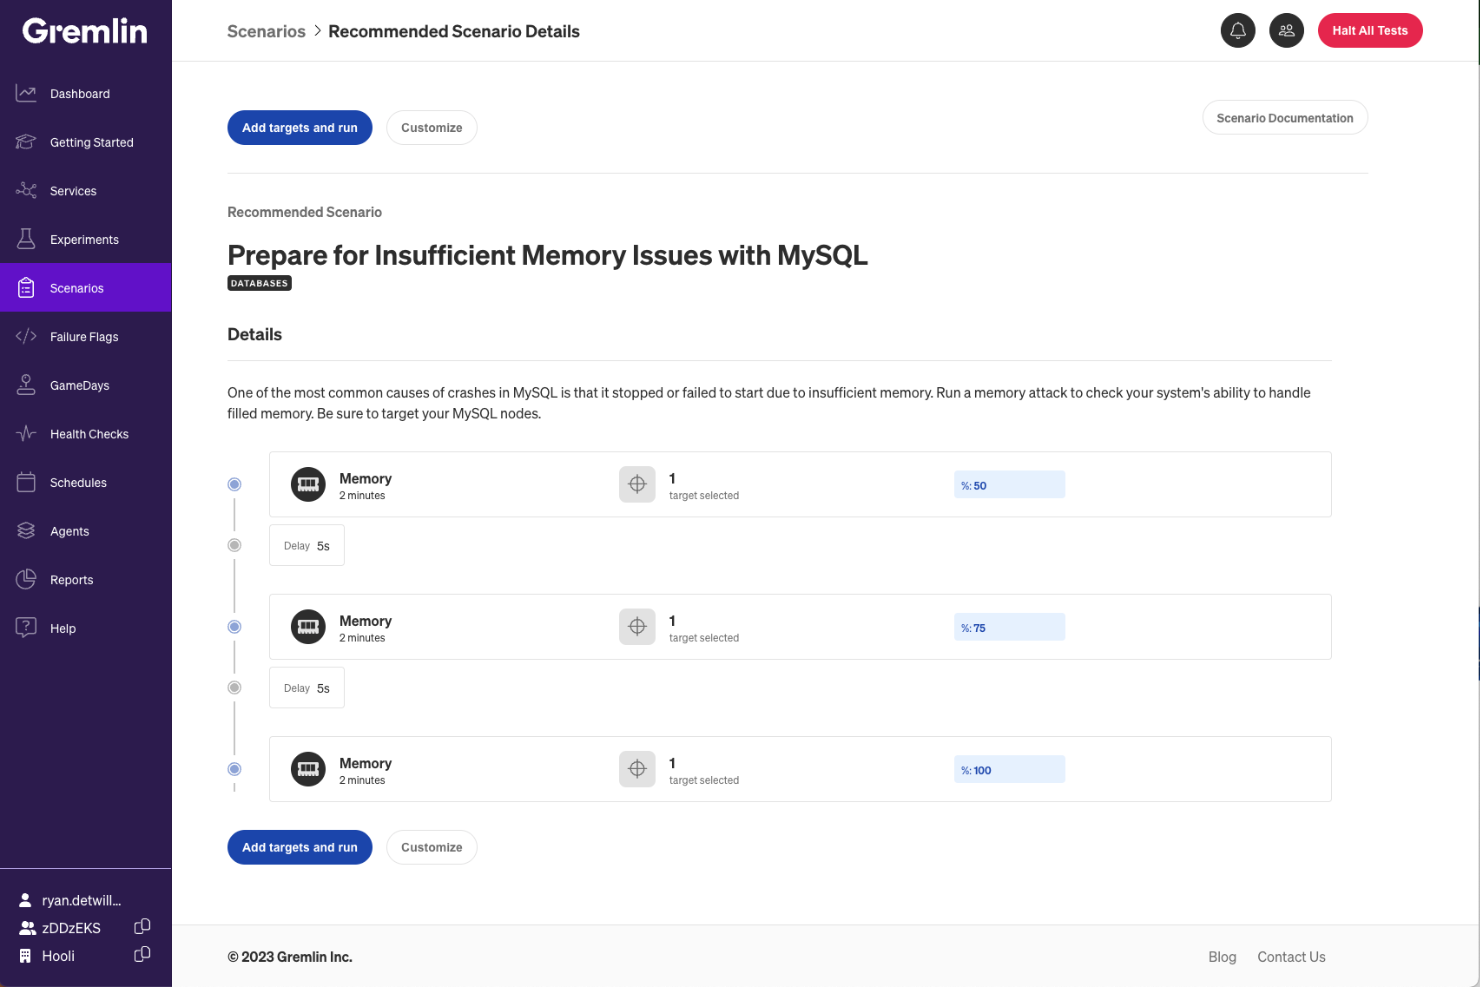
Gremlin is een betrouwbaarheidsplatform voor ondernemingen dat foutinjectie, chaos-engineering, afhankelijkheidsdetectie en testen van noodherstel combineert om je team een toekomstgerichte kijk op de veerkracht van systemen te bieden.
Voor wie is Gremlin het meest geschikt?
Gremlin is zeer geschikt voor engineering- en SRE-teams binnen ondernemingen die grootschalige, gedistribueerde systemen beheren, waarbij ongeplande uitvaltijd aanzienlijke operationele risico's met zich meebrengt.
Waarom ik voor Gremlin heb gekozen
Ik heb Gremlin opgenomen in mijn topkeuzes omdat de mogelijkheden voor foutinjectie veel verder gaan dan eenvoudige chaostests. Ik vind het prettig dat ik dankzij het beheer van de impactradius en stopvoorwaarden gerichte experimenten in live productieomgevingen kan uitvoeren zonder een echte storing te riskeren. De functie Afhankelijkheidsdetectie brengt verborgen serviceafhankelijkheden automatisch in kaart, zodat ik foutpaden kan testen waarvan ik niet eens wist dat ze bestonden. De laag voor betrouwbaarheidsscores brengt dit vervolgens allemaal samen door afzonderlijke resultaten van foutinjecties om te zetten in meetbare, traceerbare gegevens voor elke service in een grote omgeving.
Belangrijkste functies van Gremlin
- Storingsvlaggen: Test de veerkracht van applicatiecode en serverloze functies door fouten rechtstreeks op functieniveau te injecteren.
- Manager voor oefendagen: Plan en organiseer gecoördineerde betrouwbaarheidsbijeenkomsten voor teams met gedeelde rapportage en gestructureerde workflows voor experimenten.
- Gedetecteerde risico's: Houd services voortdurend in de gaten voor bekende betrouwbaarheidsrisico's en breng deze aan het licht voordat ze een incident veroorzaken.
- Vooraf gebouwde betrouwbaarheidstests: Voer gestandaardiseerde, direct bruikbare testscenario's uit om veelvoorkomende beschikbaarheidsproblemen te identificeren zonder experimenten vanaf nul op te bouwen.
Integraties van Gremlin
Gremlin biedt rechtstreekse integraties met Kubernetes, AWS, Azure en Google Cloud, Datadog, New Relic, Prometheus en Grafana, PagerDuty en Slack, maakt verbinding met Jenkins voor CI/CD-pijplijnen en ondersteunt Jira en Grafana Cloud K6 voor belastingtests. Er zijn een API en aangepaste webhooks beschikbaar voor aanvullende integraties.
Pros and Cons
Pros:
- Een breed scala aan aanvalstypen voor foutinjectie
- Gecontroleerde impactradius isoleert specifieke doelen
- Minimale installatie met uitgebreide documentatie
Cons:
- Beperkte ondersteuning voor chaosinjectie op locatie
- Geen open-sourceversie beschikbaar


Weerbaarheidstesten van Harness is een platform voor het testen van weerbaarheid dat chaosengineering, belasting- en noodhersteltests combineert in één suite, met geautomatiseerde foutinjectie, het in kaart brengen van applicatieafhankelijkheden en integratie met CI/CD-pijplijnen.
Voor wie is Harness.io het meest geschikt?
Weerbaarheidstesten van Harness is zeer geschikt voor QA-technici, prestatietechnici en SRE's bij middelgrote tot grote ondernemingen die chaos-, belasting- en noodhersteltests binnen één platform willen beheren, naast hun bestaande CI/CD-workflows.
Waarom ik voor Harness.io heb gekozen
Ik heb Harness.io opgenomen in mijn topkeuzes omdat het chaos-, belasting- en DR-tests onder één dak samenbrengt op een manier die ik bij andere tools niet heb gezien. Wat ik het prettigst vind, is de geautomatiseerde integratie met pijplijnen: chaostests worden voor en na elke implementatie uitgevoerd, zodat de gereedheid voor terugdraaien wordt gevalideerd zonder handmatige configuratie. Ik maak ook gebruik van het in kaart brengen van applicatieafhankelijkheden, waarmee automatisch microservices, API's en hiaten in de infrastructuur zichtbaar worden. Zo weet ik precies waar de dekking van de weerbaarheid beperkt is voordat ik ook maar één experiment uitvoer.
Belangrijkste functies van Harness.io
- ChaosGuard: Een laag voor beleidsafdwinging die beveiligingskaders definieert om ongeautoriseerde of risicovolle foutinjecties te blokkeren voordat experimenten worden uitgevoerd.
- Bijhouden van weerbaarheidsscores: Berekent automatisch een kwantitatieve weerbaarheidsscore voor elke service op basis van de resultaten van experimenten in de loop der tijd.
- Chaos-hubs: Een bibliotheek met vooraf gebouwde foutscenario's, ingedeeld op infrastructuurtype, voor het sneller opzetten van experimenten.
- Planning van weerbaarheidsoefeningen: Hiermee kunt u gestructureerde weerbaarheidsoefeningen voor meerdere teams plannen, inroosteren en uitvoeren, met een vastgestelde scope en goedkeuringsworkflows.
Integraties van Harness.io
Weerbaarheidstesten van Harness integreert met Prometheus, Grafana, Dynatrace en Keptn, en ondersteunt automatisering van CI/CD-pijplijnen via Jenkins, GitHub Actions, GitLab en Harness CI/CD. Het biedt ook een API voor aangepaste integraties.
Pros and Cons
Pros:
- Combineert chaos-, belasting- en DR-tests
- Gebouwd op het opensourceproject LitmusChaos
- Ondersteunt foutinjectiedoelen in meerdere clouds
Cons:
- Complex platform voor afzonderlijke chaosbehoeften
- Ondoorzichtige prijzen vereisen overleg met de leverancier

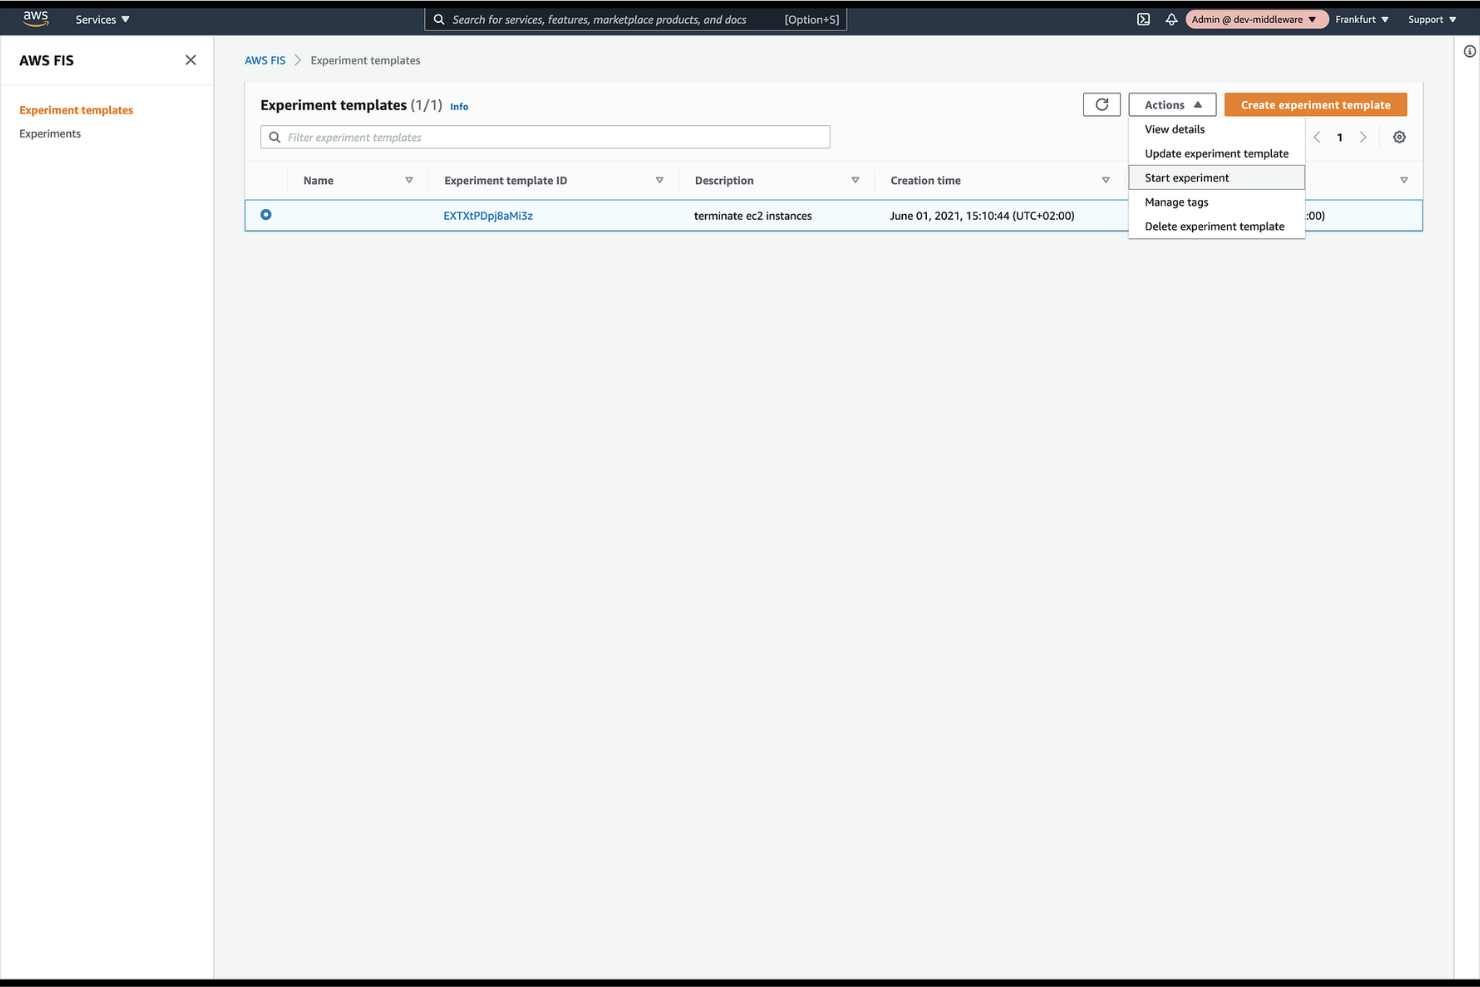
AWS Fault Injection Service (FIS) is een beheerde chaos-engineeringservice die gecontroleerde foutinjectie-experimenten rechtstreeks uitvoert op AWS-infrastructuur, -services en -workloads met behulp van vooraf gebouwde en aangepaste experimentsjablonen.
Voor wie is AWS Fault Injection Service het meest geschikt?
AWS FIS is zeer geschikt voor SRE's en platformengineers bij organisaties die al productie-workloads op AWS uitvoeren en behoefte hebben aan chaos-experimenten die rechtstreeks integreren met hun bestaande cloudinfrastructuur.
Waarom ik AWS Fault Injection Service heb gekozen
Ik heb AWS FIS gekozen omdat het de enige tool voor chaos-engineering is met een configuratie zonder agents voor oorspronkelijke AWS-doelen. Ik kan een API Gateway afknijpen, een failover van een RDS-instantie uitvoeren of een beschikbaarheidszone verstoren met behulp van vooraf gebouwde scenario's uit de FIS-scenariobibliotheek, zonder aangepaste foutscripts te schrijven. Dankzij het met IAM geïntegreerde beveiligingsmodel bepaal ik precies welke resources experimenten mogen beïnvloeden, en door op CloudWatch-alarmen gebaseerde stopvoorwaarden wordt een experiment automatisch gestopt als een gemonitorde metriek een gedefinieerde drempel overschrijdt.
Belangrijkste functies van AWS Fault Injection Service
- Doelgericht werken met meerdere accounts en regio's: Voer één experiment gelijktijdig uit in meerdere AWS-accounts en -regio's om de veerkracht van gedistribueerde systemen op schaal te testen.
- Experimentlogboeken: Stuur gedetailleerde logboeken van experimentgebeurtenissen naar Amazon CloudWatch Logs of Amazon S3 voor analyse na het experiment en audittrajecten.
- Doelgericht werken op basis van resourcetags: Beperk foutinjectie tot specifieke subsets van resources met behulp van AWS-resourcetags, zodat de impact beperkt blijft tot getagde instances of services.
- Parallelle en sequentiële uitvoering van acties: Structureer experimenten met acties die parallel of in vooraf bepaalde reeksen worden uitgevoerd om realistische, meerfasige foutsituaties te simuleren.
Integraties van AWS Fault Injection Service
AWS Fault Injection Service werkt rechtstreeks binnen het AWS-ecosysteem, met ingebouwde foutinjectieacties voor Amazon EC2, Amazon ECS, Amazon EKS, Amazon RDS, Amazon S3, Amazon DynamoDB, AWS Lambda en meer. Er zijn een HTTPS-API, AWS CLI en AWS SDK's beschikbaar voor programmatische toegang en automatisering van CI/CD-pijplijnen.
Pros and Cons
Pros:
- Configuratie zonder agents op AWS-resources
- Vooraf gebouwde scenariobibliotheek voor AZ-storingen
- Gedetailleerde IAM-toegangscontroles voor experimenten
Cons:
- Beperkt tot infrastructuurdoelen die uitsluitend AWS gebruiken
- Geen ingebouwde foutinjectie op applicatieniveau


Azure Chaos Studio is de beheerde chaos-engineeringservice van Microsoft waarmee je foutinjectie-experimenten tegen Azure-resources, -services en -applicaties kunt ontwerpen, uitvoeren en analyseren.
Voor wie is Azure Chaos Studio het meest geschikt?
Azure Chaos Studio is een natuurlijke keuze voor platformengineers en SRE's bij organisaties die productiewerklasten op Azure uitvoeren en ingebouwde foutinjectie nodig hebben zonder externe tooling te beheren.
Waarom ik Azure Chaos Studio heb gekozen
Ik heb Azure Chaos Studio gekozen omdat het servicegerichte fouten rechtstreeks tegen Azure-resources uitvoert zonder dat er op elk doel een agent hoeft te worden beheerd. Daardoor kan ik rechtstreeks via Azure Resource Manager storingen injecteren in Azure Cosmos DB, Azure Kubernetes Service of Azure App Service. Ik waardeer ook de experimentontwerper, waarin ik vertakkende foutreeksen met meerdere stappen visueel kan samenstellen en stopvoorwaarden van Azure Monitor kan instellen om experimenten automatisch te stoppen. Deze twee eigenschappen samen maken het veel eenvoudiger om gecontroleerde, herhaalbare chaos-experimenten binnen een bestaande Azure-omgeving te beheren.
Belangrijkste functies van Azure Chaos Studio
- Foutbibliotheek: Krijg toegang tot een vooraf samengestelde verzameling agentgebaseerde en servicegerichte fouten voor netwerk-, CPU-, geheugen- en schijfproblemen, evenals servicespecifieke fouttypen.
- Model voor chaostargets en mogelijkheden: Neem specifieke Azure-resources op als chaostargets en schakel alleen de gewenste foutmogelijkheden in, zodat je de omvang van experimenten op resourceniveau beperkt.
- Ondersteuning voor ARM-sjablonen: Definieer en implementeer experimenten als Azure Resource Manager-sjablonen voor versiebeheer en een herhaalbare experimentconfiguratie.
- Integratie met Azure DevOps-pipelines: Start chaos-experimenten rechtstreeks binnen CI/CD-pipelines om de veerkracht van applicaties te testen als onderdeel van geautomatiseerde releaseworkflows.
Integraties van Azure Chaos Studio
Azure Chaos Studio werkt van nature binnen het Azure-ecosysteem, met ingebouwde ondersteuning voor foutinjectie in Azure Virtual Machines, Virtual Machine Scale Sets, Azure Kubernetes Service (AKS), Azure Cosmos DB, Azure App Service, Azure Key Vault en meer. Er is een Azure REST API beschikbaar voor aangepaste integraties.
Pros and Cons
Pros:
- Vooraf samengestelde scenariobibliotheek voor veelvoorkomende storingen
- Betalen per gebruik met prijzen per actieminuut
- AI-invoegtoepassing voor het instellen van experimenten in natuurlijke taal
Cons:
- Richt zich alleen op resources die op Azure worden gehost
- Geen speciale Java-SDK beschikbaar

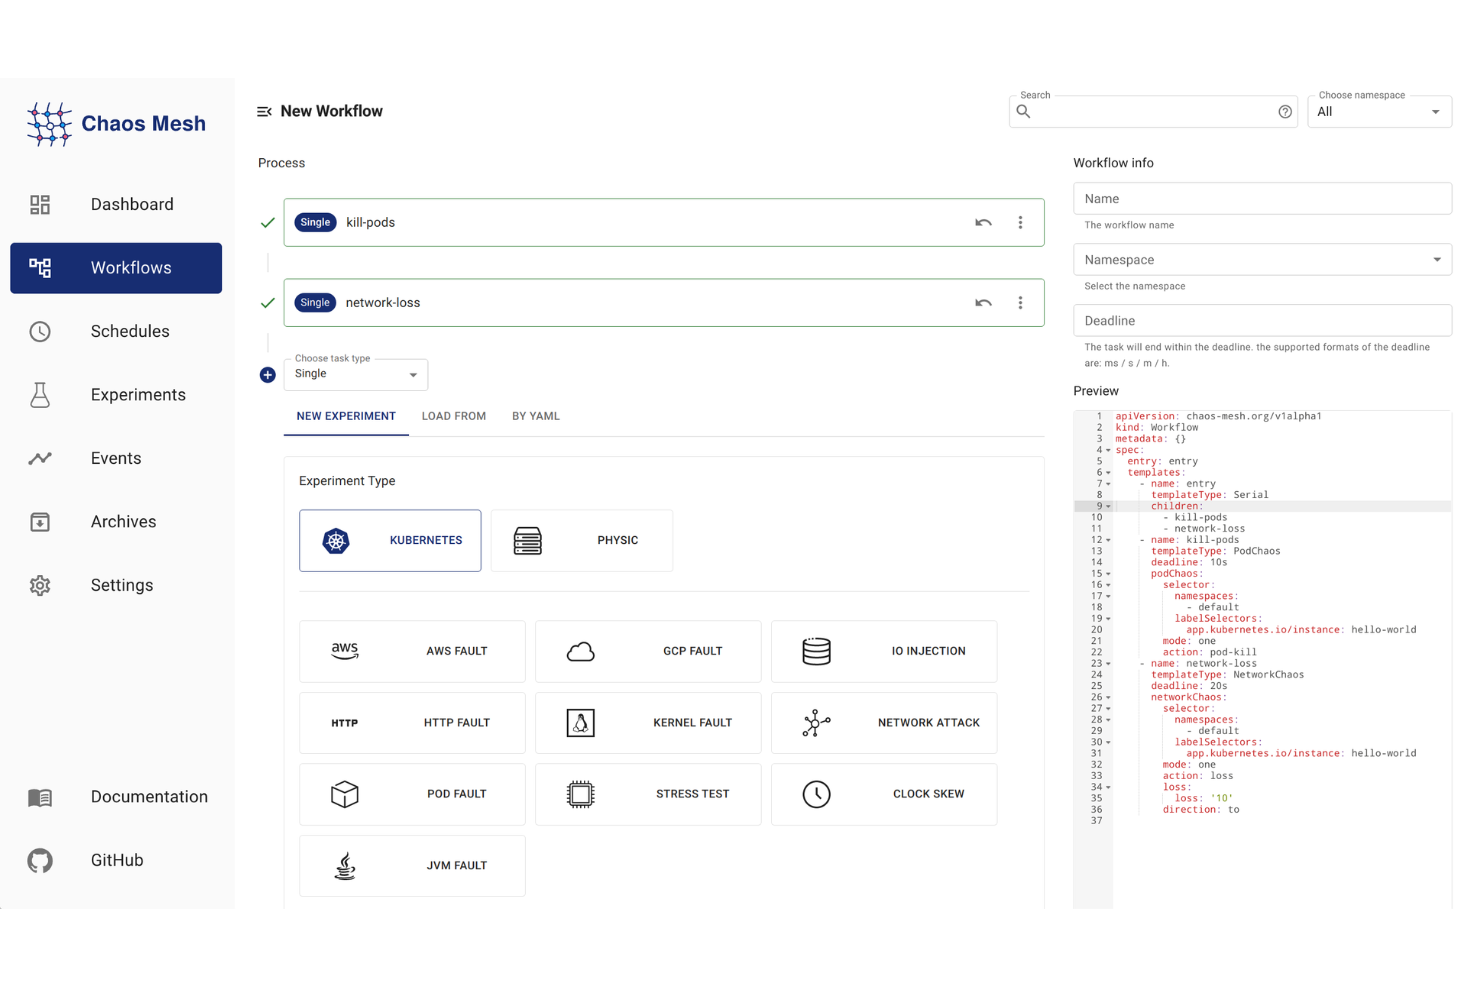
Chaos Mesh is een open-source, Kubernetes-native platform voor chaos-engineering dat CustomResourceDefinitions (CRD's) gebruikt om podstoringen, netwerkvertragingen, stresscondities en fouten in bestandssystemen rechtstreeks in Kubernetes-clusters te injecteren.
Voor wie is Chaos Mesh het meest geschikt?
Chaos Mesh is zeer geschikt voor platformengineers en SRE's die Kubernetes-workloads uitvoeren en op CRD's gebaseerde foutinjectie willen zonder commerciële licentiekosten.
Waarom ik voor Chaos Mesh heb gekozen
Chaos Mesh staat op mijn shortlist omdat alles wordt gedefinieerd als een native Kubernetes-resource met behulp van CRD's, zodat ik een NetworkChaos- of PodChaos-manifest kan schrijven op dezelfde manier als elk ander Kubernetes-object. Ik vind het prettig dat doelselectie op basis van selectors me in staat stelt experimenten af te bakenen tot specifieke namespaces, labels of annotaties, waardoor de impact voorspelbaar blijft. Met de ingebouwde workflowengine kan ik seriële en parallelle foutstappen bovendien combineren, zodat ik realistische scenario's met meerdere fouten kan modelleren in plaats van afzonderlijke geïsoleerde fouten.
Belangrijkste functies van Chaos Mesh
- Chaos-dashboard: Een webgebaseerde interface voor het ontwerpen, uitvoeren en monitoren van chaos-experimenten zonder rechtstreeks YAML te schrijven.
- HTTPChaos: Injecteert fouten in HTTP-aanvraag- en antwoordstromen, waaronder vertragingen, afbrekingen en wijzigingen aan headers en de inhoud.
- JVMChaos: Richt zich op JVM-gebaseerde applicaties om uitzonderingen, latentie en manipulatie van retourwaarden op methodeniveau te simuleren.
- Op RBAC gebaseerd toestemmingsmodel: Bepaalt wie experimenten kan aanmaken of activeren binnen specifieke namespaces met behulp van native Kubernetes-rolbindingen.
Integraties van Chaos Mesh
Chaos Mesh kan worden geïntegreerd met pijplijnsystemen zoals Argo, Jenkins, GitHub Actions en Spanner. Het beschikt ook over een speciale gegevensbronplug-in voor Grafana en werkt native met Prometheus voor het verzamelen van experimentmetriek. Er is een REST API beschikbaar voor aangepaste integraties en automatisering van CI/CD-pijplijnen.
Pros and Cons
Pros:
- Inclusief TimeChaos voor het injecteren van klokafwijkingen
- CRD-experimenten passen bij versiebeheer volgens GitOps
- CNCF-project in incubatie met actief bestuur
Cons:
- Geen ondersteuning voor beheer van meerdere clusters
- Foutinjectie op fysieke servers is beperkt
Andere chaos-engineeringtools
Hier zijn enkele aanvullende chaos-engineeringtools die mijn shortlist niet hebben gehaald, maar die nog steeds het bekijken waard zijn:
- LitmusChaos
E voor cloud-native opensource-experimenten
- Tricentis
Ideaal voor automatisering van kwaliteitsengineering
- Chaoskube
Ideaal voor willekeurige beëindigingen van Kubernetes-pods


How I Evaluate Chaos Engineering Tools
I evaluate chaos engineering tools across two layers: baseline criteria like fault injection coverage and blast radius control, and differentiators like GameDay orchestration and SLO-aware safeguards.
Core Functionality (Table Stakes for This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score as a percentage. Each tool needs to achieve a minimum total score of 65% to be considered for inclusion.
- Fault injection library: I look for a broad set of pre-built failure scenarios covering compute, network, and application layers. A tool that only offers pod kills but can't simulate DNS failures or memory pressure leaves too many blind spots untested.
- Blast radius control: Scoping matters. I evaluate whether a tool lets you target experiments by service, region, tag, or traffic percentage so you can safely test a single availability zone without risking an entire cluster.
- Experiment orchestration: The ability to chain faults into multi-step workflows with steady-state hypotheses and rollback conditions is what separates a real experiment from just breaking things. I check for scheduling and CI/CD pipeline support too.
- Cloud and Kubernetes targeting: I consider how well each tool covers major cloud providers and container orchestrators. Tools like Gremlin and Litmus approach this differently, but both should let you target resources across multi-cloud and Kubernetes environments.
- Automated safeguards: Health-check-driven abort conditions are what I look for here. If a chaos experiment degrades response times past a defined threshold, the tool should automatically halt and roll back without waiting for a human to intervene.
- Observability integration: Correlating experiment timelines with live metrics is how you validate hypotheses. I check for connections to monitoring platforms so you can see exactly how system behavior shifts during each fault injection.
Once I have a list of tools that meet this criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
GameDay orchestration is a big differentiator. Tools that let you chain faults into multi-step scenarios—like simulating a region failover during peak traffic—reveal resilience gaps that single-fault tests miss. I also evaluate multi-cloud and hybrid support, since most teams run workloads across providers and need one control plane to target all of them. Automated safety guardrails tied to SLOs round this out by giving teams confidence to run experiments in production.
Beyond Features
Deployment model matters more than people expect. Agent-based tools add overhead to production workloads, while agentless options trade off depth of fault injection. I evaluate which approach fits the team's risk tolerance. Security and governance are equally important—RBAC, SSO, and audit logging determine whether you can actually run experiments in regulated environments without a lengthy change advisory board review. Team maturity also shapes the right pick. Smaller SRE teams often get more value from open-source projects with strong community support, while larger orgs need managed SaaS with dedicated onboarding and GameDay facilitation.
Zo kies je chaos-engineeringtools
Het is gemakkelijk om te verdwalen in lange functielijsten en ingewikkelde prijsstructuren. Om je te helpen gefocust te blijven tijdens je unieke softwareselectieproces, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waar je op moet letten |
|---|---|
| Schaalbaarheid | Kan de tool meegroeien wanneer je systemen en het aantal experimenten zich over meerdere clouds uitbreiden? |
| Integraties | Maakt de tool rechtstreeks verbinding met je monitoring-, CI/CD- en incidentresponsstack? |
| Aanpasbaarheid | Kun je chaos-experimenten afstemmen op je unieke architectuur, inclusief aangepaste fouttypen? |
| Gebruiksgemak | Kunnen je SRE- of DevOps-teams snel aan de slag, of is er sprake van een steile leercurve en veel insteltijd? |
| Implementatie en ingebruikname | Welke interne vaardigheden en middelen zijn nodig om het platform te implementeren en te onderhouden? |
| Kosten | Zijn prijsmodellen transparant en sluit de investering aan bij je verwachte gebruiksscenario's? |
| Beveiligingsmaatregelen | Biedt de tool RBAC, SSO en audittrails om aan de beveiligingsnormen van je organisatie te voldoen? |
| Beschikbaarheid van ondersteuning | Is er responsieve, deskundige ondersteuning van de leverancier beschikbaar als je hulp nodig hebt bij probleemoplossing of GameDays? |
Wat zijn chaos-engineeringtools?
Chaos-engineeringtools zijn gespecialiseerde platforms of hulpprogramma's waarmee je storingen in live- of testomgevingen kunt simuleren om zwakke plekken in systemen bloot te leggen. Deze tools helpen teams om proactief fouten te injecteren, de impact te monitoren en strategieën voor veerkracht te valideren—vooral in complexe, gedistribueerde cloud-native architecturen. Door gecontroleerde experimenten uit te voeren, kunnen engineering- en operationele teams tekortkomingen in redundantie, failover en incidentrespons identificeren voordat zich echte storingen voordoen.
Functies
Let bij het selecteren van chaos-engineeringtools op de volgende belangrijke functies:
- Bibliotheek voor foutinjectie: Biedt een reeks vooraf gebouwde scenario's voor het simuleren van storingen, zoals CPU-pieken, netwerklatentie of het beëindigen van processen, om de veerkracht van systemen te testen.
- Beheer van de impactstraal: Hiermee kunt u de reikwijdte van experimenten beperken op basis van host, service, regio of verkeerspercentage om risico's tijdens tests in productie te verminderen.
- Orkestratie van experimenten: Maakt planning en automatisering mogelijk van meerstaps-chaosexperimenten met vastgelegde hypothesen, controles van de stabiele toestand en terugdraaiprocedures.
- Doelgericht gebruik in de cloud en Kubernetes: Biedt integratiemogelijkheden voor het uitvoeren van foutinjecties in openbare clouds, containerorkestrators en hybride omgevingen.
- Geautomatiseerde beveiligingen: Bewaakt de gezondheid en systeemstatistieken tijdens experimenten en draait tests terug of stopt deze als drempelwaarden worden overschreden of de impact te groot wordt.
- Integraties voor observeerbaarheid: Maakt verbinding met monitoring- en APM-hulpmiddelen, zodat u gebeurtenissen uit experimenten kunt correleren met prestatiegegevens en de systeemstatus.
- Aangepaste samenstelling van experimenten: Hiermee kunt u unieke foutinjecties ontwerpen en scripten die verder gaan dan standaardstoringsscenario's, zodat ze aansluiten bij uw specifieke werklast of architectuur.
- Op rollen gebaseerde toegangscontroles: Biedt gedetailleerde machtigingen en audittrails om te beheren wie chaosexperimenten in productie kan uitvoeren, wijzigen of bekijken.
- Experimenttemplates: Biedt kant-en-klare configuraties voor veelvoorkomende testsituaties, zodat teams snel nieuwe experimenten kunnen starten zonder helemaal opnieuw te beginnen.
Oplossingen voor chaos-engineeringtools bevatten doorgaans geen AI als onderdeel van hun functies.
Voordelen
Het implementeren van chaos-engineeringtools biedt verschillende voordelen voor uw team en uw bedrijf. Hier zijn enkele voordelen waar u naar kunt uitkijken:
- Validatie van veerkracht: Simuleer storingen uit de praktijk en bevestig dat uw systemen verstoringen kunnen opvangen zonder grote uitval.
- Snellere incidentrespons: Oefen en meet responsprocedures, waardoor de gemiddelde hersteltijd (MTTR) wordt verkort door gecontroleerde experimenten en oefendagscenario's.
- Proactieve ontdekking van risico's: Breng onbekende zwakke plekken aan het licht voordat ze gevolgen hebben voor productie door op een veilige, herhaalbare manier fouten te injecteren.
- Continue verbetering: Integreer met CI/CD-processen voor doorlopende tests van de veerkracht en het opsporen van regressies tijdens elke implementatiecyclus.
- Weloverwogen wijzigingen in productie: Gebruik geautomatiseerde beveiligingen en controles van de impactstraal om veilig te experimenteren en vertrouwen op te bouwen in wijzigingen aan de infrastructuur.
- Zichtbaarheid voor belanghebbenden: Correleer storingen met monitoringgegevens, zodat het eenvoudiger wordt om lessen te delen en de betrouwbaarheidsstatus te communiceren met technische en zakelijke teams.
- Gereedheid voor naleving: Voldoe aan eisen voor veerkrachtstests en audits met platformfuncties zoals RBAC, auditlogging en beleidsgestuurde goedkeuringen van experimenten.
Kosten en prijzen
Bij het selecteren van chaos-engineeringtools is inzicht nodig in de verschillende beschikbare prijsmodellen en abonnementen. De kosten variëren op basis van functies, teamgrootte, add-ons en meer. De onderstaande tabel geeft een overzicht van veelvoorkomende abonnementen, hun gemiddelde prijzen en de gebruikelijke functies die in chaos-engineeringoplossingen zijn opgenomen:
Vergelijkingstabel van abonnementen voor chaos-engineeringtools
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Gratis abonnement | $0 | Basisfoutinjectie, een beperkt aantal experimenttemplates, toegang voor één gebruiker en ondersteuning door de community. |
| Persoonlijk abonnement | $10-$50/gebruiker/maand | Uitgebreidere foutbibliotheek, basisintegraties, planningsmogelijkheden en ondersteuning per e-mail. |
| Zakelijk abonnement | $50-$150/gebruiker/maand | Beheer van meerdere gebruikers, geavanceerde orkestratie, auditlogboeken, integraties voor observeerbaarheid en RBAC. |
| Ondernemingsabonnement | $150+/gebruiker/maand | Aangepaste SLA's, implementatie op locatie, SSO/SAML, gedetailleerde machtigingen, nalevingsfuncties en prioriteitsondersteuning. |
Veelgestelde vragen over tools voor chaosengineering
Hier vindt u antwoorden op veelgestelde vragen over tools voor chaosengineering:
Werken tools voor chaosengineering in productieomgevingen?
Ja, de meeste tools voor chaosengineering zijn ontworpen voor veilig gebruik in productie. Ze bieden functies zoals het afbakenen van het impactbereik, stopvoorwaarden en automatische terugdraaiacties om risico’s tijdens live foutinjectie te beperken.
Hoe weet ik of mijn team klaar is om tools voor chaosengineering te gebruiken?
Als uw team de systeemgezondheid al monitort, duidelijke processen voor incidentrespons heeft en vertrouwd is met het automatiseren van tests of experimenten, is het waarschijnlijk klaar om tools voor chaosengineering te gaan gebruiken. Teams die nog weinig ervaring hebben met betrouwbaarheidswerk kunnen het beste beginnen in een stagingomgeving voordat ze overstappen naar productie.
Vereisen deze tools codewijzigingen in mijn applicaties?
Nee, de meeste tools injecteren fouten op infrastructuur- of platformniveau zonder dat u applicatiecode hoeft aan te passen. Voor aangepaste experimentscripts of nauwkeurige targeting van workloads kan echter minimale configuratie nodig zijn.
Wat is het verschil tussen implementatie op basis van agents en implementatie zonder agents?
Tools op basis van agents installeren lichtgewicht agents op uw workloads om een breder scala aan foutinjecties mogelijk te maken. Benaderingen zonder agents verminderen de operationele overhead, maar bieden mogelijk minder dekking voor fouten of vereisen aanvullende machtigingen.
Kunnen tools voor chaosengineering helpen bij nalevingsvereisten?
Ja, geavanceerde tools voor chaosengineering bevatten vaak audittrailregistratie, op rollen gebaseerde toegangscontroles en functies voor beleidsbeheer ter ondersteuning van naleving en governance in gereguleerde omgevingen.
Hoe moeilijk is het om tools voor chaosengineering te integreren in CI/CD-pijplijnen?
De meeste moderne tools voor chaosengineering bieden kant-en-klare plug-ins of API’s voor integratie met Jenkins, GitHub Actions en andere CI/CD-platforms. Hierdoor kunnen geautomatiseerde controles van de veerkracht onderdeel worden van uw implementatieworkflow.