Hei, og velkommen til et nytt kapittel i serien Ledelse innen testing. Denne uken ser vi på tjenestetesting for nettapplikasjoner. Vi skal dekke:
- Hva er tjenestetesting?
- Hva er ytelsestesting?
- Pålitelighets- og feilovertakelsestesting
- Testing av tjenesteforvaltning
La oss begynne.
Hva er tjenestetesting?
Kvaliteten på tjenesten som en nettapplikasjon leverer, kan defineres som alle egenskapene dens, for eksempel funksjonalitet, ytelse, pålitelighet, brukervennlighet, sikkerhet og så videre.
Her skiller vi imidlertid ut tre bestemte tjenestemål som faller inn under det vi kaller «tjenestetesting». Disse målene er:
- Ytelse: Tjenesten må svare raskt på brukernes forespørsler samtidig som den håndterer belastningen den utsettes for.
- Pålitelighet: Hvis tjenesten er utformet for å tåle feil, må den være pålitelig og/eller fortsette å levere en tjeneste selv når det oppstår en feil.
- Håndterbarhet: Tjenesten må kunne administreres, konfigureres eller endres uten at sluttbrukerne merker en forringelse av tjenesten. Håndterbarhet, eller driftstesting, har som mål å vise at systemets administrative prosedyrer, forvaltningsprosedyrer og prosedyrer for sikkerhetskopiering og gjenoppretting fungerer effektivt.
I alle tre tilfellene må vi simulere brukerbelastning for å gjennomføre testene effektivt. Målene for ytelse, pålitelighet og håndterbarhet eksisterer i en kontekst der faktiske kunder bruker nettstedet til å utføre oppgaver.
Hvor raskt et nettsted svarer (i dette tilfellet tiden det tar for én systemnode å svare på forespørselen fra en annen), er direkte knyttet til ressursene som er tilgjengelige i den tekniske arkitekturen.
Når flere kunder bruker tjenesten, blir færre tekniske ressurser tilgjengelige for å betjene hver brukers forespørsler, og svartidene blir dårligere.
En tjeneste med liten belastning har åpenbart mindre sannsynlighet for å svikte. Mye av kompleksiteten i programvare og maskinvare eksisterer for å håndtere ressursbehovene i den tekniske arkitekturen når et nettsted er tungt belastet.
Når et nettsted er belastet (eller overbelastet), må motstridende forespørsler om ressurser håndteres av ulike infrastrukturelementer, for eksempel server- og nettverksoperativsystemer, databasehåndteringssystemer, webserverprodukter, objektforespørselsmeglere, mellomvare og så videre.
Disse infrastrukturelementene er vanligvis mer pålitelige enn den spesialutviklede applikasjonskoden som krever ressursen, men feil kan oppstå i begge:
- Infrastrukturelementer svikter fordi applikasjonskoden (på grunn av dårlig utforming eller implementering) stiller for store krav til ressursene.
- Applikasjonskomponentene kan svikte fordi ressursene de trenger, ikke alltid er tilgjengelige (i tide).
Ved å simulere typiske og uvanlige produksjonsbelastninger over en lengre periode kan testere avdekke feil i systemets utforming eller implementering. Når disse feilene er løst, vil de samme testene vise at systemet er motstandsdyktig. QA-team kan benytte seg av verktøy for belastningstesting til å utføre mange av prosessene som er definert nedenfor.
På alle tjenester finnes det vanligvis en rekke kritiske forvaltningsprosesser som må utføres for å holde tjenesten i gang uten problemer. Det kan være mulig å stenge ned en tjeneste for rutinemessig vedlikehold utenfor normal arbeidstid, men de fleste nettbaserte tjenester er i drift 24 timer i døgnet.
Tjenestens arbeidsdag tar aldri slutt. Forvaltningsprosedyrer må uunngåelig utføres mens tjenesten er i drift og brukerne er på systemet. Disse prosedyrene må testes mens systemet er belastet, for å sikre at de ikke påvirker den aktive tjenesten negativt, altså ytelsestesting.
Have an account? Log In
Hva er ytelsestesting?
Ytelsestesting er en viktig del av tjenestetesting. Det er en måte å teste hvordan et system fungerer med hensyn til responstid og stabilitet under en bestemt arbeidsbelastning. Her er en oversikt over hvordan det fungerer:
- Ytelsestesting består av en rekke tester med varierende belastning, der systemet når en stabil tilstand (belastning og responstid på konstante nivåer).
- Vi måler belastning og responstid for hver belastning, simulert over en periode på 15–30 minutter, for å få et statistisk signifikant antall målinger.
- Vi overvåker og registrerer de viktigste måleverdiene for hver simulerte belastning. Dette er de ulike ressursene i systemet vårt, for eksempel CPU- og minnebruk, nettverksbåndbredde, I/O-hastigheter og så videre.
Vi lager en graf over disse varierende belastningene sammenholdt med responstidene som våre «virtuelle» brukere opplever. Når grafen er tegnet, ser den omtrent ut som figuren nedenfor.
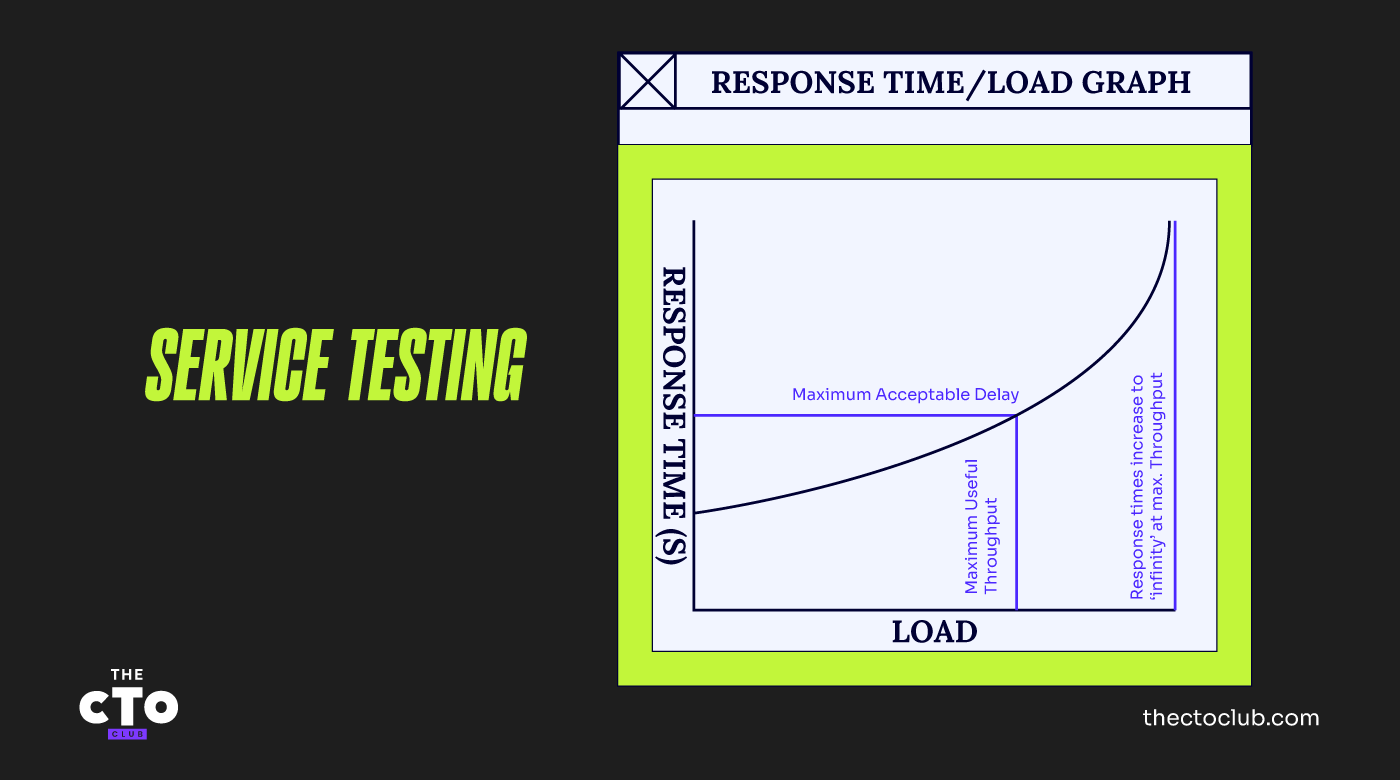
Ved null belastning, når det bare er én bruker på systemet, har brukeren hele ressursen for seg selv, og responstidene er korte. Når vi innfører økende belastning og måler responstidene, blir de gradvis dårligere, helt til vi når et punkt der systemet kjører med maksimal kapasitet.
På dette tidspunktet er responstiden for testtransaksjonene våre teoretisk uendelig, fordi én av systemets viktigste ressurser er fullstendig oppbrukt, og ingen flere transaksjoner kan behandles.
Når vi øker belastningen fra null til maksimum, overvåker vi også bruken av ulike ressurstyper, for eksempel serverprosessorbruk, minnebruk, nettverksbåndbredde, databaselåser og så videre.
Ved maksimal belastning er én av disse ressursene utnyttet 100 %. Denne ressursen er den begrensende ressursen fordi den går tom først. På dette tidspunktet har responstidene naturligvis blitt så dårlige at de sannsynligvis er langt tregere enn det som ville vært akseptabelt.
Grafen nedenfor viser bruken/tilgjengeligheten til flere ressurser sammenholdt med belastningen.
For å øke gjennomstrømningskapasiteten og/eller redusere responstidene for et system må vi gjøre ett av følgende:
- Redusere etterspørselen etter ressursen, vanligvis ved å gjøre programvaren som bruker ressursen, mer effektiv (dette er vanligvis utviklernes ansvar).
- Optimalisere bruken av maskinvareressursen i den tekniske arkitekturen, for eksempel ved å konfigurere DBMS-et til å hurtigbufre mer data i minnet eller ved å prioritere enkelte prosesser foran andre på applikasjonsserveren.
- Gjøre mer av en ressurs tilgjengelig. Normalt ved å legge til prosessorer, minne eller nettverksbåndbredde og så videre.
Som du sikkert allerede begynner å innse, trenger ytelsestesting et team av personer som kan hjelpe testerne. Dette er tekniske arkitekter, serveradministratorer, nettverksadministratorer, utviklere og databaseutformere/-administratorer. Disse tekniske ekspertene er kvalifisert til å analysere statistikken som genereres av ressursmonitoreringsverktøyene, og vurdere hvordan applikasjonen best kan justeres, eller hvordan systemet kan finjusteres eller oppgraderes.
Hvis du er testeren, bør du, med mindre du selv er spesielt ekspert på disse områdene, ikke la deg friste til å late som om du kan tolke denne statistikken og ta beslutninger om finjustering og optimalisering. Du må involvere disse ekspertene tidlig i prosjektet for å få råd og støtte, og senere under testingen for å sikre at flaskehalser identifiseres og løses.
Følg med på neste artikkel, der vi går dypere inn i hvordan ytelsestesting kan håndteres.
Testing av pålitelighet/overgang ved feil
Å sikre kontinuerlig tilgjengelighet for en tjeneste er sannsynligvis et viktig mål for prosjektet ditt. Pålitelighetstesting bidrar til å avdekke obskure feil som forårsaker uventede svikt. Testing av overgang ved feil bidrar til å sikre at de innebygde tiltakene for overgang ved forventede feil faktisk fungerer.
Testing av overgang ved feil
Når nettsteder må være robuste og/eller pålitelige, utformes de vanligvis med pålitelige systemkomponenter med innebygd redundans og funksjoner for overgang ved feil som trer i kraft når feil oppstår.
Disse funksjonene kan omfatte mangfoldig nettverksruting, flere servere konfigurert som klynger, mellomvare og distribuert tjenesteteknologi som håndterer belastningsfordeling, samt omdirigering av trafikk i feilsituasjoner.
Testing av overgang ved feil har som mål å undersøke systemets oppførsel under utvalgte feilsituasjoner før utrulling, og omfatter normalt følgende:
- Identifisering av komponentene som kan svikte og føre til tjenestetap (ved å se på feil innenfra og ut).
- Identifisering av farene som kan føre til en feil og et tjenestetap (ved å se på trusler utenfra og inn).
- En analyse av feilmodusene eller scenarioene som kan oppstå, der du trenger visshet om at gjenopprettingstiltaket vil fungere.
- En automatisert test som kan brukes til å laste systemet og undersøke systemets atferd over en lengre periode.
- Den samme automatiserte testen kan også brukes til å belaste systemet som testes og overvåke systemets atferd under feilforhold.
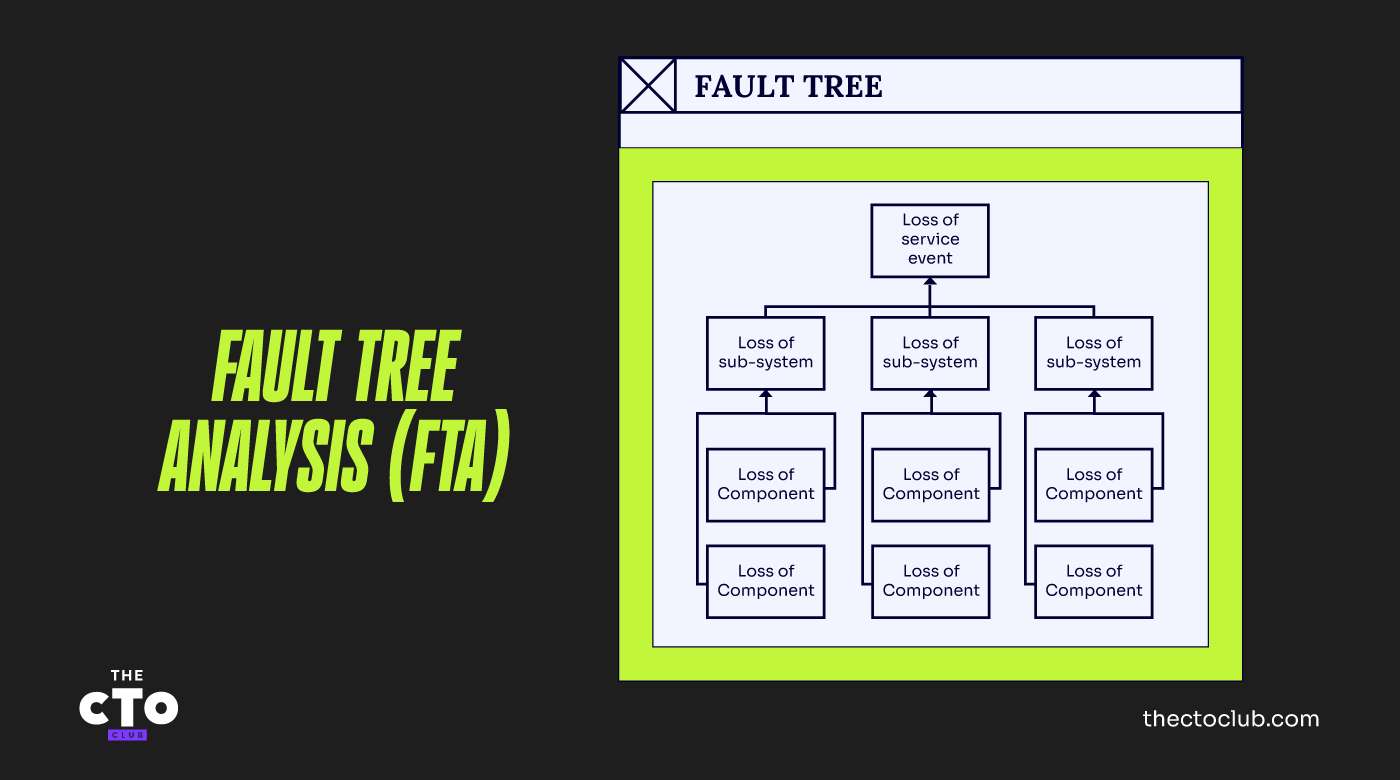
En teknikk kalt feiltresanalyse (FTA) kan hjelpe deg med å forstå tjenestens avhengigheter av de underliggende komponentene. Feiltresanalyse og feiltrediagrammer er en logisk representasjon av et system eller en tjeneste og måtene den kan svikte på.
Det enkle skjematiske diagrammet nedenfor viser forholdet mellom grunnleggende komponentfeil, mellomliggende feil i delsystemer og den øverste tjenestefeilen. Det kan selvsagt være mulig å identifisere mer enn tre nivåer av en feil.
Disse testene må kjøres med en automatisert belastning for å undersøke systemets atferd i produksjonssituasjoner og oppnå tillit til de innebygde gjenopprettingstiltakene. Du ønsker spesielt å vite:
- Hvordan oppfører arkitekturen seg i feilsituasjoner?
- Fungerer lastbalanseringsfasilitetene som de skal?
- Tar omkoblingsfunksjonene over belastningen når en komponent svikter?
- Fungerer den automatiske gjenopprettingen? «Tar de omstartede systemene igjen»?
Til syvende og sist fokuserer testene på å fastslå om tjenesten opprettholdes for sluttbrukerne, og om brukerne faktisk merker at feilen oppstår.
Pålitelighetstesting (eller utholdenhetstesting)
Pålitelighetstesting har som mål å kontrollere at feil ikke oppstår under belastning.
De fleste maskinvarekomponenter er så pålitelige at gjennomsnittlig tid mellom feil kan måles i år. Pålitelighetstester krever bruk (eller gjenbruk) av automatiserte tester på to måter for å simulere:
- Ekstreme belastninger på bestemte komponenter eller ressurser i den tekniske arkitekturen.
- Forlengede perioder med normal (eller ekstrem) belastning på hele systemet.
Når vi fokuserer på bestemte komponenter, ønsker vi å stressteste komponenten ved å utsette den for et urimelig stort antall forespørsler om å utføre den tiltenkte funksjonen. Det er ofte enklere å stressteste kritiske komponenter isolert med store mengder enkle forespørsler først, før man gjennomfører en langt mer kompleks test av hele infrastrukturen. Det finnes også spesialutviklede verktøy for stresstesting som gjør det enklere for QA-team å gjennomføre prosessen.
Utholdenhetstester er tester som utsetter et system for belastning over en lengre periode, kanskje 24 eller 48 timer eller mer, for å avdekke (vanligvis) obskure problemer. Obskure feil viser seg ofte først etter lang tids bruk.
Den automatiserte testen trenger ikke nødvendigvis å trappes opp til ekstreme belastninger (det dekkes av stresstesting). Men vi er spesielt interessert i systemets evne til å tåle kontinuerlig kjøring av et bredt utvalg av testtransaksjoner for å finne ut om det finnes obskure minnelekkasjer, låsinger eller kappløpssituasjoner.
More Articles
Testing av tjenesteforvaltning
Til slutt noen ord om testing av tjenesteforvaltning.
Når tjenesten er satt i produksjon, må den forvaltes. For å holde en tjeneste oppe og kjørende må den overvåkes, oppgraderes, sikkerhetskopieres og raskt utbedres når noe går galt.
Prosedyrene som tjenesteforvaltere bruker til å gjennomføre oppgraderinger, sikkerhetskopieringer, utgivelser og gjenopprettinger etter feil, er avgjørende for å levere en pålitelig tjeneste. Derfor må de testes, særlig hvis tjenesten vil gjennomgå raske endringer etter utrulling.
De konkrete problemene som må håndteres, er:
- Prosedyrene oppnår ikke ønsket effekt.
- Prosedyrene er upraktiske eller ubrukelige.
- Prosedyrene forstyrrer den aktive tjenesten.
Testene bør så langt som mulig gjennomføres på en så realistisk måte som mulig.
Noe å tenke over
Noen systemer er utsatt for ekstreme belastninger når en bestemt hendelse inntreffer. En nettbasert virksomhet vil for eksempel forvente maksimal belastning rett etter at den annonserer tilbud på TV, eller en nasjonal nyhetsnettside kan bli overbelastet når en stor nyhetssak bryter ut.
Tenk på et system du kjenner godt, som ble påvirket av uplanlagte hendelser i virksomheten din eller i nasjonale nyheter.
Hvilke hendelser eller situasjoner kan utløse overbelastning i systemet ditt?
Kan (eller kunne) du hente data fra systemlogger som viser antallet transaksjoner som er gjennomført? Kan du skalere denne hendelsen for å forutsi en kritisk hendelse som statistisk inntreffer én gang hvert 100. år eller én gang hvert 1000. år?
Hvilke tiltak kan du iverksette (eller har du iverksatt) for enten å redusere sannsynligheten for toppbelastninger, redusere omfanget av toppbelastninger eller eliminere dem fullstendig?
Meld deg på nyhetsbrevet til The QA Lead for å få beskjed når nye deler av serien publiseres. Disse innleggene er utdrag fra Pauls kurs i ledelse innen testing, som vi på det varmeste anbefaler hvis du ønsker en dypere gjennomgang av dette og andre emner. Hvis du gjør det, bruk vår eksklusive kupongkode QALEADOFFER for å få $60 rabatt på full kurspris!
Anbefalt lesning: 10 BESTE VERKTØY FOR TESTHÅNDTERING MED ÅPEN KILDEKODE