


Kvalitetssikring krever en kombinasjon av proaktive tiltak og effektive reaktive protokoller. Med riktig balanse kan du tilby brukerne utmerket service og funksjonalitet på en server som er tilgjengelig året rundt. Den eneste måten å oppnå denne balansen på er å identifisere de mest relevante måleverdiene for serverovervåking.
Men hvilke kan det være? Det avhenger av egenskapene du ønsker, inkludert de som er beskrevet i kvalitetsmodellen, og overvåkingsmålene dine. Likevel finnes det noen måleverdier for helse og ytelse som QA-ingeniører alltid bør følge med på, uansett hva.
Ved å velge de ideelle måleverdiene for serverovervåking fra starten av kan du etablere en ytelsesbaseline som referanse når helse- og ytelsesproblemer uunngåelig oppstår.
I denne korte veiledningen skal vi se nærmere på hvorfor du bør følge med på disse nøkkelmåleverdiene. I tillegg får du mer innsikt i hvorfor de er relevante, og hvordan du kan følge med på dem.
1. CPU-bruk
En av de viktigste grunnene til å overvåke servere er å følge med på infrastrukturens helse og serverens grunnleggende ytelse. En kritisk del av dette er proaktiv diagnostisering og begrensning av potensielle ytelsesproblemer. Måling av CPU- og diskbruk står sentralt i dette arbeidet. Derfor er CPU-bruk en av de mest grunnleggende og vanligst overvåkede ytelsesmåleverdiene.
Denne måleverdien regnes som «vertsbasert», siden den registrerer en enkelt maskins evne til å fungere og forbli stabil. Når det er sagt, innebærer overvåking av CPU-bruk en kombinasjon av passiv og aktiv overvåking. Sistnevnte er spesielt nyttig ved kontrollert belastningstesting, mens førstnevnte samler inn målinger fra målet under reell trafikk.
Slik måler du CPU-utnyttelse
Før du setter i gang, må du:
- Velge de bestemte stasjonene du vil overvåke.
- Fastslå hvor disse stasjonene befinner seg.
- Sørge for at datainnsamleren har tilgang til prosessene på datamaskinen din.
Når alt dette er satt opp, må du fastsette målefrekvensen du vil bruke for å følge med på disse måleverdiene. Du kan for eksempel måle CPU-bruken hvert 30. sekund eller hvert minutt.
Det finnes flere måter å følge med på CPU-bruken på, for eksempel ved å bruke oppgavebehandlingen eller en kommando som wmic CPU get load percentage på Windows-systemer. Når du derimot prøver å få et helhetsbilde av serveren, er det best å vise disse dataene i et kontrollpanel.
Husk: CPU-ytelsen påvirkes av maskinvareforhold, som CPU-temperatur og viftehastighet. Det kan være lurt å overvåke disse faktorene sammen med utnyttelsen (angitt som en prosentandel) i disse to tilstandene, mens inaktivitet ignoreres.
To viktige ting du bør følge nøye med på, er Privilegert tid og Brukertid, ettersom summen av disse to gir Prosessortid. De er definert slik:
- Privilegert tid: Prosentandelen av tiden prosessorene bruker på å kjøre prosesser som ikke tilhører brukeren (det vil si kjerneprosesser)
- Brukertid: Prosentandelen av tiden prosessorene bruker på å kjøre brukerprosesser (for eksempel kommandoskall, e-postserver og kompilator)
- Prosessortid: Den totale tiden CPU-en var opptatt
Vær oppmerksom på at overskridelse av 100 % ikke alltid betyr at et system er overbelastet. Hvis du for eksempel har et system med flere prosessorer, betyr dette bare at summen av de to eller flere CPU-ene er større enn 100 % (for eksempel 50 % og 60 %). Følg med på ytelsen til hver enkelt for å opprettholde systemets helse.
I tillegg til CPU- og disku tnyttelse regnes ventetider også som viktige ved overvåking av infrastrukturens helse og ytelse.
Have an account? Log In
Ventetider
Ventetider gir deg informasjon om hvor effektivt oppgaver utføres, og varsler deg om mulige flaskehalser. Men det hjelper deg ikke å vite ventetidene alene. Du må undersøke nærmere for å identifisere det nøyaktige ytelsesproblemet.
Høye ventetider er greit i korte perioder fordi du kan ha intensive oppgaver som kjører, men alt utover dette er vanligvis grunn til bekymring.
2. Serverens oppetid
Serveren din er ubrukelig hvis den ikke er tilgjengelig for brukerne. Derfor er overvåking av serverens oppetid ufravikelig. Når serverens tilgjengelighet faller under 99,999 % (standarden som kalles «de fem ni-erne»), har du et alvorlig problem.
Bruk formlene nedenfor for å få forståelig og handlingsrettet innsikt fra overvåkingen.
Slik måler du serverens oppetid
Her er noen grunnleggende konsepter du bør kjenne til når du overvåker serverens oppetid:
- Oppetid: Tiden tjenesten eller applikasjonen din er aktiv og tilgjengelig for brukerne. Formel: (Total tid - Nedetid)/Total tid
- Gjennomsnittlig tid mellom feil (MTBF): Den gjennomsnittlige tiden mellom hendelser med nedetid. Formel: (Total tid - Nedetid)/Antall hendelser med nedetid
- Gjennomsnittlig tid til løsning (MTTR): Den gjennomsnittlige tiden det tar å løse et avbrudd. Formel: Total nedetid/Antall hendelser med nedetid
- Gjennomsnittlig tid til bekreftelse (MTTA): Den gjennomsnittlige tiden det tar å bekrefte et pågående avbrudd. Formel: Total tid til bekreftelse/Antall hendelser med nedetid
Alle disse måleverdiene bidrar til å danne et helhetlig bilde av infrastrukturens pålitelighet og teamets responstid.
Det er for eksempel bra å ha en god MTTR og MTTA. Men hvis du også har en høy MTBF, må du undersøke de underliggende årsakene til serverens nedetid nærmere. Ellers står selskapet fortsatt i fare for betydelige økonomiske tap og svekket brukertillit.
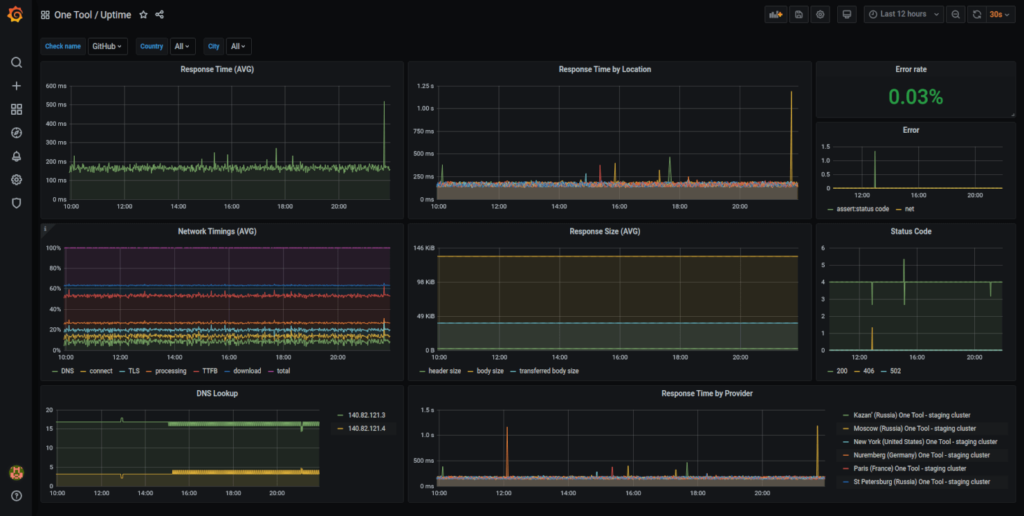
Til syvende og sist må du etterstrebe «fem niere», altså holde nedetiden på maksimalt omtrent fem minutter per år. Serverovervåkingsprogramvaren Grafana og Prometheus anbefales ofte som brukervennlige og lett tilgjengelige verktøy for denne delen av ytelsesovervåkingen.
3. Transaksjoner (og feilrater)
Du trenger et tydelig bilde av hvor mye trafikk infrastrukturen din støtter til enhver tid. Derfor er det viktig å følge med på transaksjonene – eller antallet forespørsler per sekund – og den tilhørende gjennomsnittlige svartiden. Denne informasjonen kan hjelpe deg med å fastslå hvor mye ressurser og kapasitet som trengs for å kjøre serveren uten problemer.
Samtidig kan sporing av feilraten, altså prosentandelen mislykkede forespørsler sammenlignet med det totale antallet mottatte forespørsler, gi ytterligere innsikt i tjenestens belastningskapasitet. For å maksimere verdien av denne måleverdien er det best å etablere en grunnlinje over tid gjennom passiv overvåking.
Dette er avgjørende for evnen din til å overvåke trender. Hvis du kan se tilbake og fastslå den maksimale kapasiteten og ressursene som kreves for problemfri drift, kan du handle proaktivt ved å tildele disse nødvendighetene og finne infrastrukturproblemer for å redusere observerte feilrater og optimalisere den gjennomsnittlige svartiden.
Slik overvåker du transaksjoner og feilrater
Følgende er pålitelige verktøy for passive ytelsesovervåkingsteknikker:
- Sniffere: Disse er utviklet for å samle inn målinger på et «mikroskopisk nivå» ved å «avlytte» trafikkflyten i kablede og trådløse nettverk. Wireshark er en av de mest anerkjente standardene og samler inn data om attributter som tidsstempel, MAC- og IP-adresse, levetid og mer. Disse kan brukes på nett eller uten nett.
- Loggføringsfunksjoner: Disse er vanligvis integrert i operativsystemene og applikasjonene. De samler hovedsakelig inn informasjon om aktivitetene og hendelsene som genereres av applikasjoner, for bruk uten nett.
Monitis er et av de ti beste verktøyene for overvåking av webservere og er spesielt godt egnet til å overvåke transaksjoner. Det er et alt-i-ett-overvåkingssystem for servere, nettsteder og applikasjoner. Det fungerer godt for både Windows- og Linux-systemer og er ideelt for å dekke det grunnleggende, inkludert oppetid.
Formålet med og målet for overvåkingsarbeidet vil påvirke de nøyaktige målingene og bruken av disse teknikkene.
More Articles
Andre måleverdier som bør overvåkes sammen med transaksjoner
Svartid og det totale antallet tråder er direkte knyttet til transaksjoner. Disse forteller deg hvor lang tid serveren bruker på å svare på en forespørsel, og hvor mange tråder (som får transaksjonene til å skje) som brukes til å håndtere alle disse forespørslene.
Hver tråd bruker CPU-tid og RAM. For mange tråder kan føre til dårlig ytelse. Det er ganske mye å overvåke med disse, blant annet:
- Det totale antallet tråder i en webserver eller beholderpool, inkludert disse typene:
- Aktive
- Inaktive
- Fastlåste
- Ventende
- Ventende brukerforespørsler og kølengde
Du kan vanligvis måle serverens responstid som tid til første byte (TTFB). Dette er antallet millisekunder det tar før en nettleser mottar den første byten i et serversvar. Generelt er alt over fem sekunder kritisk.
Velge de riktige måleverdiene for overvåking av serverytelse
Det finnes en lang liste over måleverdier du kan overvåke når du følger med på serverens tilstand og ytelse, men de spesifikke målene avhenger først og fremst av formålet med overvåkingen.
Mens noen er best egnet til å gi innsikt i belastningskapasiteten til maskinvaren og operativsystemet, er andre ideelle for å observere brukeraktivitet. Uansett er CPU, oppetid og transaksjoner grunnleggende måleverdier som ikke kan overses.
Etter hvert som du utvikler deg som QA-leder og målene dine uunngåelig endrer seg, vil du utvilsomt legge til flere måleverdier for serverovervåking i oversikten din. Hvis du vil ha flere ekspertinnsikter om hvilke måleverdier dette bør være, og hvordan du håndterer dem, kan du abonnere på nyhetsbrevet.




