Où les agents de codage sont utiles et où ils échouent
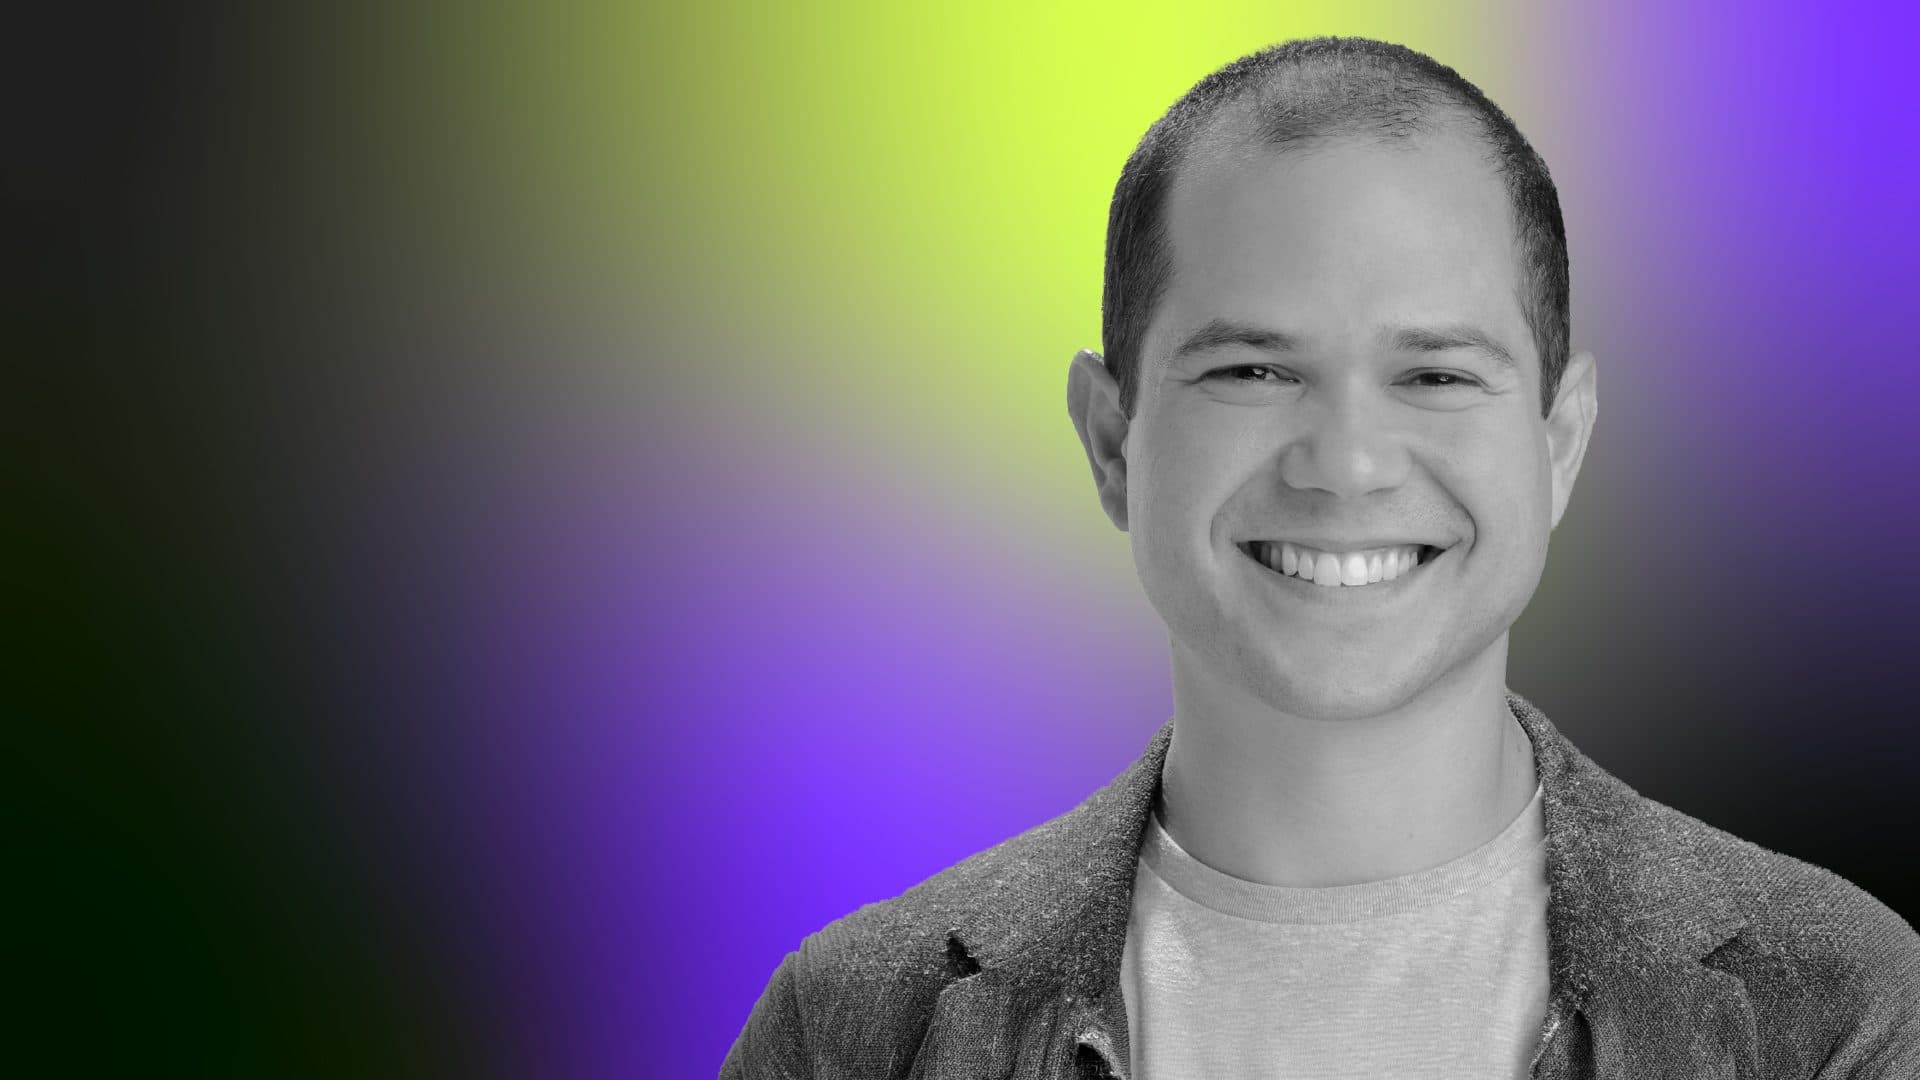
Pedro Alves
Directeur technique chez Thoth AI
Pedro Alves explique où les agents de codage dotés d’IA accélèrent l’ingénierie, où ils introduisent des risques cachés et pourquoi les développeurs expérimentés restent essentiels.
Key Takeaways
Agents de codage: Les agents de codage peuvent accélérer la mise en œuvre, mais le jugement humain doit guider l’architecture, la qualité et les décisions de mise en production.
Bugs cachés: Le code généré par l’IA s’exécute souvent correctement tout en dissimulant des défauts logiques que seuls des réviseurs expérimentés peuvent détecter.
Lacunes créatives: Les modèles traitent bien les tâches de traduction clairement définies, mais les humains doivent apporter des idées originales, établir des liens inattendus et prendre les décisions fondamentales.
Effet de levier de l’équipe: Les organisations obtiennent davantage en augmentant les capacités de professionnels expérimentés grâce à l’IA qu’en essayant de faire progresser des équipes inexpérimentées.
Contrôle centralisé: Une petite équipe spécialisée en IA peut créer des flux de travail réutilisables, réduire la duplication des expérimentations et améliorer l’adoption dans tous les services.
Pedro Alves travaille beaucoup avec l’IA depuis 25 ans. Il est actuellement directeur technique chez Thoth AI et le créateur de Last Week in AI.
Nous nous sommes entretenus avec Pedro pour discuter des agents de codage — et de l’importance de savoir ce qu’ils peuvent et ne peuvent pas faire. Voici ce qu’il nous a expliqué.
Avant que l’« IA » ne soit quelque chose que l’on mette sur des diapositives
Je m’appelle Pedro, et je suis directeur technique chez Thoth AI. Je travaillais avec l’IA avant que ce soit quelque chose que l’on mette sur des diapositives — en 2001, alors que j’étais étudiant en informatique, j’ai construit un petit monde rempli d’agents simulé et je les ai laissés apprendre à se surpasser les uns les autres, une sorte de jeu de la vie numérique dont le but était simplement de les regarder progresser. C’était il y a 25 ans, et je poursuis toujours la même question : comment faire progresser un système ?
Lorsque les études supérieures sont arrivées, tout le monde pensait que je ferais un doctorat en apprentissage automatique. Je ne l’ai pas fait. Cela me semblait trop étroit, trop théorique. Je voulais apprendre le métier en travaillant sur les données les plus riches et les plus désordonnées que je puisse trouver, alors je me suis tourné vers la biologie computationnelle : la protéomique pour mon master, la génomique pour mon doctorat. J’ai appris l’apprentissage automatique, les statistiques et la science des données en les appliquant — réseaux d’interactions entre gènes, ingénierie des caractéristiques, réseaux neuronaux et méthodes d’ensemble — à des problèmes où l’erreur avait un coût.
C’est là que j’ai appris la leçon qui a façonné tout ce qui a suivi. En médecine, j’ai construit des modèles de progression des maladies, et l’indicateur standard — la précision globale — était inutile. Un modèle « bon » selon cette mesure ne faisait que reconfirmer les cas que les médecins connaissaient déjà, alors que toute sa valeur résidait dans les cas qu’il manquerait. Ainsi, au lieu d’optimiser la précision, j’ai optimisé l’AUC partielle — essentiellement la capacité du modèle à traiter les cas qui comptaient. L’indicateur que l’on vous donne est presque toujours différent de l’objectif réel.
À partir de là, j’ai exploré différents secteurs : ces modèles médicaux, une période de conseil pour une équipe de football professionnelle, puis la Silicon Valley et des années consacrées à la vision par ordinateur — à une époque où il fallait encore innover dans la manière d’entraîner un réseau et même d’initialiser ses poids pour parvenir à faire fonctionner la détection et la classification. J’ai travaillé avec des données issues des réseaux sociaux, du commerce de détail, de la mode et de la vidéo. J’ai passé un an à construire des algorithmes de trading avec des algorithmes génétiques et l’optimisation par essaim particulaire — des méthodes d’optimisation non paramétriques sur lesquelles j’avais publié des articles pendant mes études supérieures. J’ai finalement créé ma propre entreprise, en développant des outils d’IA pour des personnes qui n’étaient pas des spécialistes des données.
La largeur de vue relie tout cela. Après avoir travaillé dans une douzaine de domaines, je continue de voir le même problème sous des apparences différentes — une astuce évidente en génomique s’avère être la clé en vision par ordinateur. La manière dont un problème est formulé m’importe davantage que la manière dont il est résolu, car c’est dans la formulation que se trouve le véritable levier.
C’est ce qui m’a conduit chez Thoth. Sur le papier, nous sommes une entreprise d’annotation de données. Mais je pense que le problème auquel répond tout ce secteur n’est pas le bon. Personne ne veut de données annotées — les données ne sont qu’une étape intermédiaire. Les gens veulent un meilleur modèle. Je m’efforce donc de contribuer à un avenir où un système détermine de quelles données votre modèle a besoin pour s’améliorer et s’en charge pour vous, afin que vous puissiez vous concentrer sur le modèle plutôt que sur l’étiquetage.
More Articles
Les deux facettes de l’entreprise
Sur le plan structurel, Thoth AI comporte deux volets. Le premier est le moteur des opérations liées aux données, qui fonctionne à l’international et à grande échelle. Il est plus important qu’une start-up classique, mais reste bien plus petit que les géants du secteur ; je le qualifierais donc de taille moyenne. L’autre volet, celui que je construis, est une toute nouvelle équipe de recherche et d’innovation implantée dans la baie de San Francisco — nous sommes actuellement cinq, et d’autres personnes nous rejoindront au cours des prochains mois. Nous y poursuivons le reste de l’amélioration des modèles : tout ce qui va au-delà de l’étiquetage.
Nos recherches s’articulent autour de deux axes principaux. Le premier est la robotique : générer des données incarnées, les évaluer et utiliser l’apprentissage actif pour générer automatiquement les meilleures données d’entraînement possibles, afin que les robots puissent apprendre leurs tâches avec le moins de données possible. La majeure partie de ce travail utilise des données égocentriques (essentiellement des séquences filmées à la première personne), et nous concentrons une grande partie de nos efforts sur la production des données égocentriques de la meilleure qualité possible. Le second axe concerne la fiabilité et l’efficacité des modèles de langage : comprendre ce qui provoque les hallucinations et à quoi elles ressemblent ; et, du côté de l’efficacité, déterminer quand un modèle plus petit peut traiter une requête, puis la reformuler ou la découper en plusieurs éléments afin qu’un modèle plus simple et moins coûteux puisse y répondre. Tout cela relève aujourd’hui de la recherche et vise des produits que nous lancerons depuis cette équipe.
En ce qui concerne le stade de développement et la taille : le volet lié aux données est une activité internationale établie et de taille moyenne, tandis que l’équipe de recherche américaine est volontairement encore à ses débuts. Nous sommes actuellement cinq dans notre bureau de San Mateo, et une ou deux personnes supplémentaires nous rejoindront au cours des prochains mois. Voilà où nous en sommes aujourd’hui.
Comment des tests intensifs produisent des résultats fiables
Pedro partage
La préparation se fait désormais en grande partie toute seule. Mais ce n’est pas là le véritable gain. L’amélioration la plus importante concerne la qualité : la réunion est plus ciblée et plus pertinente, et les bons sujets parviennent systématiquement au PDG.
Nombreux sont ceux qui se précipitent pour automatiser chaque tâche et chaque fonction avec l’IA, mais je reste prudent. L’IA rend la création d’une démonstration triviale. Concevoir quelque chose de fiable pour une utilisation quotidienne est une autre affaire. Lorsque vous utilisez réellement ces outils, vous rencontrez des cas limites et des cas particuliers dans lesquels l’automatisation fonctionne presque, mais pas tout à fait. Je procède donc à de nombreux tests avant de faire confiance à quoi que ce soit dans un véritable flux de travail.
Cette année, j’ai développé des outils d’IA pour notre réunion hebdomadaire d’examen avec le PDG, et ils ont franchi ce seuil. Ils envoient des e-mails aux responsables de chaque domaine pour recueillir leurs mises à jour, compilent automatiquement les réponses, rédigent les rapports, les synthèses et l’ordre du jour, et suivent les résultats au fil du temps.
Auparavant, tout cela était manuel. Quelqu’un relançait les personnes pour obtenir leurs mises à jour, assemblait manuellement les réponses, rédigeait les synthèses et l’ordre du jour, et suivait les résultats d’une semaine à l’autre. Cela fonctionnait, mais c’était lent, et l’ordre du jour dérivait facilement vers les sujets les plus récents plutôt que vers ceux qui comptaient le plus.
La préparation se fait désormais en grande partie toute seule. Mais ce n’est pas là le véritable gain. L’amélioration la plus importante concerne la qualité : la réunion est plus ciblée et plus pertinente, et les bons sujets parviennent systématiquement au PDG. Il s’agit donc moins de gagner du temps que d’orienter l’attention du PDG vers les décisions qui comptent réellement.
Pourquoi le jugement reste humain tandis que l’IA accélère le développement
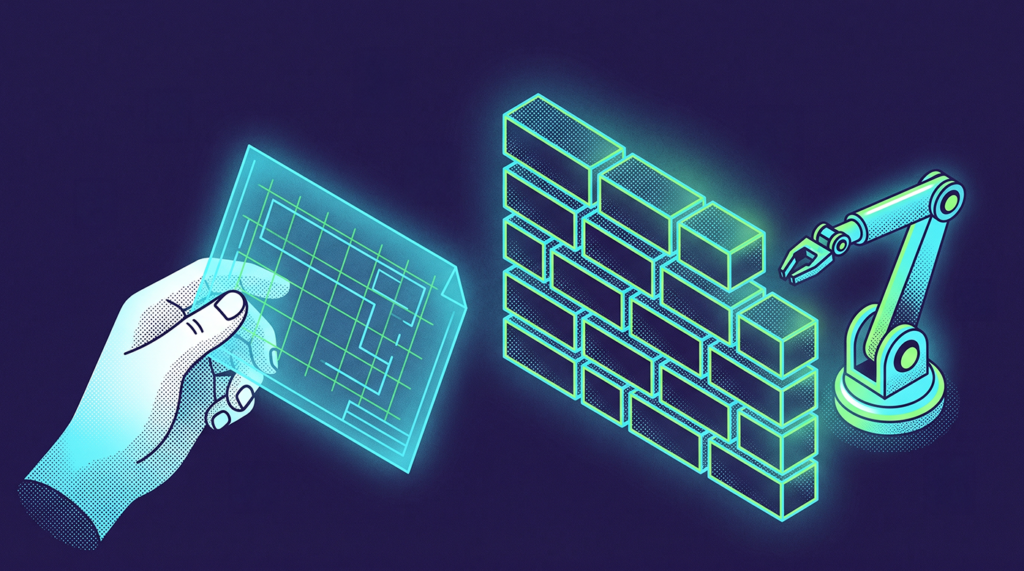
L’IA alimente désormais le développement lui-même, presque partout. Mes chercheurs, les ingénieurs qui mettent nos travaux en production et moi-même utilisons tous des outils de développement assisté par l’IA. C’est le jugement humain, et non une catégorie de tâches particulière, qui détermine la manière dont le code est développé, et ce niveau d’exigence évolue en fonction des enjeux.
Du côté de la recherche, l’objectif est généralement de faire fonctionner quelque chose, souvent en configurant un dépôt GitHub pour tester la viabilité d’une idée. Rien n’est destiné à la production, je suis donc indulgent quant à la qualité de sa rédaction. Si cela fonctionne et répond à la question, c’est suffisant.
La production est différente. La manière dont nous construisons quelque chose compte autant que le fait que cela fonctionne, et nous utilisons donc l’IA avec davantage de précautions. Les ingénieurs seniors sont responsables de l’architecture, de la qualité et des revues. L’IA les accélère, mais elle ne prend pas ces décisions. Cette part reste humaine.
L’ancienneté de l’équipe est utile. Ses membres utilisent l’IA différemment des personnes moins expérimentées. Ils savent déjà à quoi ressemble un travail de qualité, et le modèle amplifie donc leur jugement plutôt que de se substituer au jugement qu’ils sont encore en train de développer. Il les fait aller plus vite sans remplacer l’élément essentiel.
Comment utiliser efficacement les agents de développement
Presque tous les projets ont besoin d’un élément unique : une intuition ou une décision non évidente qu’exige le problème… La partie qui permet généralement à un projet de fonctionner n’est pas moyenne, et l’IA ne peut pas y parvenir seule. C’est à moi de la trouver. Ensuite, l’IA construit tout ce qui en découle plus rapidement et mieux que je ne pourrais le faire seul.
Globalement, l’efficacité des agents de développement repose sur la discipline avec laquelle je prends en compte les forces et les faiblesses de la technologie.
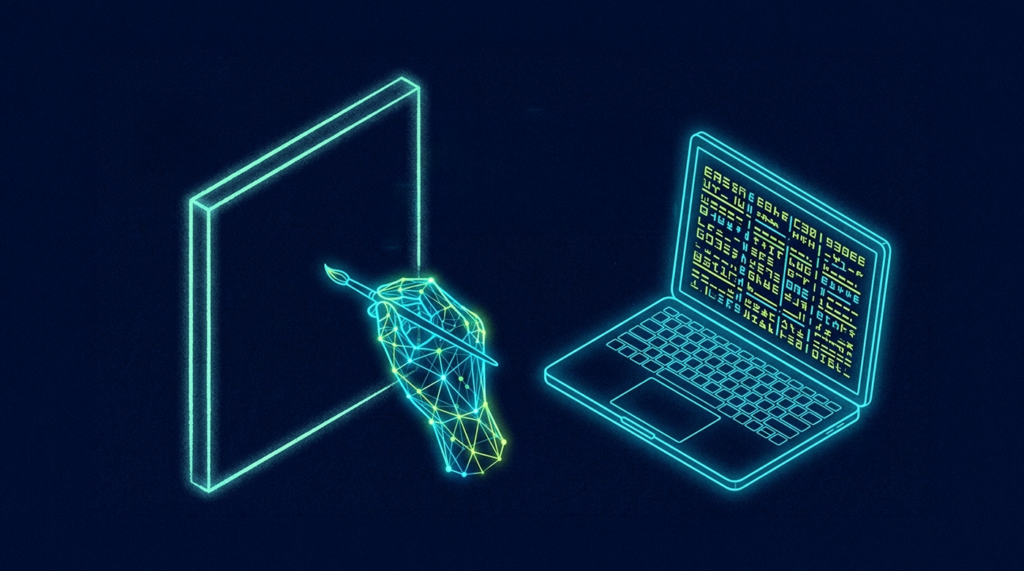
Je vois les choses comme si je peignais une toile. L’objectif est toujours le même : clarifier l’image que j’ai en tête, puis utiliser l’IA pour traduire cette intention en code fonctionnel aussi rapidement que possible. Sa réussite dépend d’une variable : la quantité de travail créatif que je conserve par rapport à celle que je délègue.
L’IA excelle au premier niveau. Je peux voir l’ensemble du tableau et en poser les grandes lignes, tandis que l’IA ajoute les détails. Je sais exactement ce qui doit être construit, et traduire une intention en code est essentiellement une opération systématique. C’est là que l’IA constitue un véritable multiplicateur de force, et c’est ici que se situe la majeure partie de mon travail quotidien.
Le deuxième niveau est utile, mais présente une variance plus importante. C’est similaire, mais je laisse volontairement quelques zones de la toile ouvertes et je demande au modèle d’y peindre quelque chose. Cela demande une certaine créativité, mais mes indications continuent de délimiter son champ d’action. Je considère ce résultat comme une ébauche, et non comme une réponse.
Je mets les gens en garde contre le troisième niveau. Il consiste à confier à l’IA le cœur créatif : la définition du projet ou les décisions clés de conception. Cela semble impressionnant pour une personne qui ne maîtrise pas le domaine en profondeur, mais le résultat est bien plus souvent insuffisant qu’il n’est réussi, car le modèle comble une lacune que j’aurais dû combler moi-même.
Cet écart est précisément l'essentiel. Presque chaque projet comporte un élément unique dont il a besoin : une idée ou une décision peu évidente qu'exige le problème. Par défaut, le modèle fournit la solution moyenne, le schéma le plus courant issu de son entraînement. Ce qui permet généralement à un projet de fonctionner n'est pas moyen, et l'IA ne peut pas y parvenir seule. C'est à moi de trouver cet élément. Ensuite, l'IA construit tout ce qui en découle plus rapidement et mieux que je ne pourrais le faire seul.
Comment les agents de programmation créent des bogues difficiles à détecter
Pedro partage
Le résultat positif le plus évident des agents de programmation est la rapidité. La programmation est plus rapide, ce qui augmente la fréquence de nos déploiements, et il ne s’agit pas seulement de vitesse brute. Les choses qui étaient compliquées à configurer sont désormais beaucoup plus faciles. Cet aspect est bien réel et il compte.
Le résultat positif le plus évident des agents de programmation est la rapidité. La programmation est plus rapide, ce qui augmente la fréquence de nos déploiements, et il ne s'agit pas seulement de vitesse brute. Les choses qui étaient compliquées à configurer sont désormais beaucoup plus faciles. Cet aspect est bien réel et il compte.
Un résultat plus intéressant concerne l'évolution de nos bogues. Le taux de défauts n'a pas augmenté, mais les types de défauts ont changé. L'IA s'assure que le code s'exécute. Elle vérifie presque toujours ce point avant de vous le remettre. Ainsi, les bogues les plus simples — ceux qui génèrent simplement une erreur ou qui refusent de s'exécuter — apparaissent beaucoup moins souvent. Ce qui reste, ce sont des bogues logiques, des cas que le modèle n'a pas examinés jusqu'au bout, et ils sont plus difficiles à détecter précisément parce que le code s'exécute correctement.
C'est là que se trouve le revers de la médaille. Ces bogues se dissimulent mieux. Si quelqu'un manque d'expérience ou s'appuie trop fortement sur l'outil, il voit le code s'exécuter et suppose qu'il est correct alors qu'il ne l'est pas. Le danger ne réside pas dans un plus grand nombre de bogues, mais dans une fausse confiance. Il faut quelqu'un qui sache quoi rechercher pour détecter les problèmes qui passent le test « ça fonctionne », tout en étant erronés.
Pourquoi l'IA doit servir à amplifier les personnes expérimentées plutôt qu'à améliorer les personnes moins compétentes
Ce qui m'a le plus surpris, c'est l'origine de cet effet de levier. Intuitivement, on pourrait penser que l'IA abaisse le niveau d'expérience requis, ce qui permettrait de constituer des équipes moins coûteuses et plus juniors, puis de les faire progresser grâce aux outils. C'est l'inverse qui s'est vérifié. L'expérience compte davantage désormais, et non moins.
Tout se résume à la fiabilité. Utiliser l'IA pour transformer un ingénieur senior en cinq ingénieurs seniors est bien plus fiable que de transformer un ingénieur junior en ingénieur senior. L'IA multiplie le jugement que vous possédez déjà ; elle ne fabrique pas celui qui vous fait défaut.
Ainsi, je développe les capacités de mes personnes les plus compétentes ; je n'essaie pas de faire progresser mes personnes les moins compétentes. Quelques personnes expérimentées, chacune produisant plusieurs fois plus qu'auparavant, surpassent à chaque fois une équipe mixte plus importante.
Pourquoi les humains doivent apporter la créativité — et non l'IA
Il est clair que l'IA n'a pas répondu aux attentes concernant les aspects créatifs et relationnels de la recherche. Lorsque je réalise un travail technique avec l'aide de l'IA, un humain doit toujours relier les éléments : comprendre comment prolonger le travail de quelqu'un d'autre, relier deux articles d'une manière cohérente et effectuer les bonds logiques qui vous paraîtraient évidents. Cette partie nécessite toujours une personne.
Ce n'est pas surprenant lorsqu'on se rappelle ce que sont ces modèles. Ce sont des machines à probabilités. Ils produisent le texte le plus susceptible de plaire au lecteur. Nous progressons dans leur entraînement sur d'autres types de tâches, mais cela devient réellement difficile lorsqu'on essaie de leur enseigner la créativité elle-même, car construire le signal d'entraînement est complexe.
Prenons les jeux de données. Un jeu de données représentant l'apparence d'un chien est facile à constituer. Il suffit de rassembler de nombreuses photos de chiens. Un jeu de données sur la créativité dans le dessin de chiens pose un problème différent. Prenons par exemple quelqu'un qui ajoute des ailes à un chien. L'intérêt de cet exemple ne réside pas dans les ailes. Il réside dans le geste abstrait qui les sous-tend : prendre quelque chose qui n'a rien à faire là et le placer là où on ne s'y attend pas. Pour qu'un modèle le comprenne, il faut un très grand nombre d'exemples afin qu'il apprenne que les ailes n'ont pas d'importance ; c'est le geste créatif qui en a.
Même s'il y parvient, vous vous heurtez au mur suivant. Prenez maintenant cette même créativité et appliquez-la à une équation mathématique ou à un extrait de code issu d'un article, pour l'utiliser afin de prolonger l'algorithme de quelqu'un. C'est dans ce type de transfert qu'il échoue.
Les gens s'appuient sur les machines précisément pour la partie dans laquelle elles sont les plus faibles. L'ironie, c'est que la solution ne coûte presque rien. Une pincée de créativité humaine suffit à aller très loin. Ne vous reposez pas trop sur la machine pour cet aspect, et vous progresserez remarquablement.
Pourquoi les CTO doivent repenser la manière dont les capacités de l'IA circulent dans les organisations
Ce ne sera probablement pas le conseil le plus populaire en ce moment, mais je pense que c'est le plus prudent et celui qui a le plus de chances de porter ses fruits : soyez plus délibéré que ne vous y pousse le moment.
En ce moment, les entreprises dépensent des sommes considérables en partant d'une hypothèse simple : chacun peut automatiser une partie de son travail grâce à l'IA. La directive est donc adressée à tout le monde. Les ingénieurs, les spécialistes des données, les équipes commerciales, le marketing, toute l'entreprise. Créez un compte, automatisez quelque chose, développez vos propres outils, allez-y. Le résultat est une énorme quantité d'efforts gaspillés : travail en double, projets qui n'aboutissent à rien, outils que personne n'utilise. Les entreprises dépensent beaucoup d'argent en efforts, en temps et en jetons qui ne produisent rien de durable.
Mettez en place un véritable processus autour de cela. Centralisez-le. Constituez une petite équipe centrale dont le rôle est d'améliorer, grâce à l'IA, les performances de toutes les autres équipes. Elle élabore des flux de travail, un contexte réutilisable, des normes et des modèles efficaces, puis les diffuse afin que chaque ingénieur n'ait pas à supporter individuellement le coût de la découverte. Il s'agit de la version structurelle de ce que j'ai dit précédemment à propos de la concentration de l'effet de levier entre les mains de vos collaborateurs les plus performants : quelques ingénieurs à l'aise avec l'IA qui font progresser toute l'organisation.
Cela produit deux résultats simultanément. L'utilisation augmente parce que les équipes appliquent des modèles éprouvés au lieu de tâtonner. Et vous récupérez une grande quantité de temps discrètement perdue dans des expérimentations qui n'avaient jamais besoin d'être réalisées plus d'une fois.
Ce ne sera probablement pas le conseil le plus populaire en ce moment, mais je pense que c’est le plus prudent et celui qui a le plus de chances de porter ses fruits : soyez plus délibéré que ne vous y pousse le moment… Mettez en place un véritable processus autour de cela. Centralisez-le. Constituez une petite équipe centrale dont le rôle est d’améliorer, grâce à l’IA, les performances de toutes les autres équipes.
Suivez son travail
Vous pouvez suivre le travail de Pedro Alves sur LinkedIn ou vous abonner à sa newsletter, La semaine dernière dans l'IA. Découvrez également Thoth AI.
D'autres entretiens avec des experts seront bientôt disponibles sur The CTO Club !