

ML-kokeiden seurantatyökalut auttavat kirjaamaan, järjestämään ja vertailemaan koneoppimiskokeita, jotta voit hallita tuloksia ja toistaa havainnot luottavaisin mielin. Jos etsit käytännöllisiä tapoja seurata kokeita, jakaa edistymistä tiimisi kanssa tai pitää mallisi ja aineistosi järjestyksessä, oikealla työkalulla voi olla suuri merkitys.
Tästä luettelosta löydät eri teknisille ympäristöille ja työnkuluille räätälöityjä ratkaisuja, joiden avulla voit vähentää kitkaa, yksinkertaistaa raportointia ja keskittyä luotettavaan koneoppimiskokeiden hallintaan.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Parhaiden ML-kokeiden seurantatyökalujen yhteenveto
Tässä vertailutaulukossa tiivistetään parhaiksi valitsemieni ML-kokeiden seurantatyökalujen hinnoittelutiedot, jotta löydät budjettiisi ja liiketoimintasi tarpeisiin parhaiten sopivan vaihtoehdon.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Paras reaaliaikaiseen kokeiden vertailuun | Maksuton paketti saatavilla | Alkaen $19/käyttäjä/kuukausi | Website | |
| 2 | Sopii parhaiten mukautettaviin visualisointikoontinäyttöihin | Ilmainen paketti saatavilla | Alkaen $60/kuukausi | Website | |
| 3 | Paras vaihtoehto putkien automaattiseen versiointiin | 14 päivän ilmainen kokeilu saatavilla | Hinta pyynnöstä | Website | |
| 4 | Paras automaattiseen putkien orkestrointiin | Ilmainen tilaus saatavilla | Alkaen $15/käyttäjä/kuukausi | Website | |
| 5 | Paras avoimen lähdekoodin mallin elinkaaren hallintaan | Ilmainen demo saatavilla | Hinta pyynnöstä | Website | |
| 6 | Sopii parhaiten integraatioon syväoppimiskehysten kanssa | Ikuisesti maksuton paketti saatavilla | Maksuton ikuisesti (avoin lähdekoodi) | Website | |
| 7 | Paras Kubernetes-natiiviseen työnkulkujen hallintaan | Maksuton palvelupaketti saatavilla | Maksuton ja avoimen lähdekoodin | Website | |
| 8 | Paras integraatioon AWS-pilviekosysteemin kanssa | Ilmainen sopimus saatavilla | Alkaen $0.204/tunti | Website | |
| 9 | Paras valinta laajennettavuutta tarjoavaa liitännäisarkkitehtuuria varten | Ilmainen paketti saatavilla | Alkaen $399/kuukausi | Website | |
| 10 | Sopii parhaiten hybridi- ja paikalliseen käyttöönottoon | Ilmainen paketti + ilmainen esittely saatavilla | Alkaen $450/month (laskutetaan vuosittain) | Website |


Parhaiden ML-kokeiden seurantatyökalujen arviot
Alla ovat yksityiskohtaiset yhteenvetoni parhaista ML-kokeiden seurantatyökaluista, jotka pääsivät listalleni. Arvioni tarjoavat yksityiskohtaisen katsauksen kunkin alustan ominaisuuksiin, integraatioihin ja parhaisiin käyttötapauksiin, jotta löydät itsellesi parhaiten sopivan vaihtoehdon.
 Paras reaaliaikaiseen kokeiden vertailuun
- Maksuton paketti saatavilla
- Alkaen $19/käyttäjä/kuukausi
Visit WebsiteCustomer Rating:4.4/5This rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.
Seuraa ML-kokeita, mallien suorituskykyä ja LLM-arviointia. Comet on ML-kokeiden seuranta- ja mallien arviointialusta, joka kirjaa harjoitusajojen mittarit, hyperparametrit ja artefaktit sekä laajentaa toimintaansa LLM-järjestelmien havainnointiin ja agenttipohjaisen tekoälyn arviointiin Opik-tuotteensa kautta.
Kenelle Comet sopii parhaiten?
Comet sopii erinomaisesti kasvuvaiheen tai yritystason ML- ja AI-tiimeille, jotka suorittavat suuria määriä kokeita ja tarvitsevat reaaliaikaisen näkyvyyden harjoitusajoihin.
Miksi valitsin Cometin
Valitsin Cometin yhdeksi parhaista vaihtoehdoista, koska sen reaaliaikainen kokeiden seurantanäkymä päivittää mittareita harjoitusajojen edetessä, joten tiimini voi havaita poikkeavan häviökäyrän ja lopettaa huonon ajon ennen kuin se tuhlaa laskentaresursseja. Käytän myös sen rinnakkaista kokeiden vertailunäkymää suodattaakseni kymmeniä ajoja hyperparametriarvon perusteella ja selvittääkseni heti, mikä kokoonpano tuotti parhaan validointitarkkuuden. Perinteisen MLOpsin lisäksi Comet laajentaa nyt toimintaansa LLM-arviointiin Opikin kautta, joten minun ei tarvitse vaihtaa työkalua siirtyessäni mallien koulutuksesta tuotannossa olevien agenttien valvontaan.
Cometin tärkeimmät ominaisuudet
- Mallirekisteri: Tallenna, versioi ja hallitse koulutettuja malleja keskitetysti mallirekisterissä, jossa on vaihemerkinnät, kuten esivaihe ja tuotanto.
- Artefaktien kirjaus: Kirjaa ja versioi tietoaineistoja, kuvia, sekaannusmatriiseja ja äänitiedostoja suoraan kokeiden ajojen yhteydessä.
- Mukautetut paneelit: Luo mukautettuja visualisointeja Cometin käyttöliittymään JavaScriptillä ja ylitä oletusmittarikaavioiden rajoitukset.
- Järjestelmämittareiden seuranta: GPU:n käyttöaste, suorittimen kuormitus ja muistin käyttö tallennetaan automaattisesti jokaisesta ajosta ilman lisämittarointia.
Cometin integraatiot
Comet tarjoaa yli 30 natiivista integraatiota, kuten PyTorchin, TensorFlow'n, Kerasin, Scikit-learnin, XGBoostin, Hugging Face Transformersin, Rayn, Kubeflown, Snowflaken ja Vertex AIn. Se on saatavilla Zapierissa ja tarjoaa REST-rajapinnan sekä Python-, Java-, JavaScript- ja R-SDK:t mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Mittareiden automaattinen kirjaus vähäisellä koodimäärällä
- Harjoitusajojen reaaliaikainen visualisointi
- Seuraa sekä ML-kokeita että LLM-järjestelmiä
Cons:
- Pro-paketti rajoittaa tiimit 10 käyttäjään
- Käyttöliittymän mukautusmahdollisuudet ovat rajalliset
Learn more about Comet: Sopii parhaiten mukautettaviin visualisointikoontinäyttöihin
- Ilmainen paketti saatavilla
- Alkaen $60/kuukausi

Weights & Biases seuraa koneoppimiskokeita ja metriikoita sekä vertailee mallien ajokertoja. Weights & Biases on koneoppimisen kokeiden seuranta-alusta, joka kirjaa metriikat, hyperparametrit ja mallien tarkistuspisteet sekä mahdollistaa ajokertojen visualisoinnin ja vertailun interaktiivisten koontinäyttöjen avulla.
Kenelle Weights & Biases sopii parhaiten?
Weights & Biases sopii erityisesti datatieteilijöille ja koneoppimisinsinööreille, jotka suorittavat usein kokeita ja tarvitsevat yksityiskohtaisia ajokertojen vertailuja suurissa tiimeissä.
Miksi valitsin Weights & Biasesin
Weights & Biases on yksi suosikkivalinnoistani, koska pidän siitä, miten pitkälle sen mukautettavat visualisointikoontinäytöt ulottuvat. Voin tuoda suorittimen reaaliaikaisen käyttöasteen, häviökäyrät ja näyte-ennusteet yhteen interaktiiviseen koontinäyttöön koulutuksen aikana, mikä nopeuttaa pullonkaulojen havaitsemista. Sweeps-ominaisuuden avulla voin visualisoida hyperparametrien haun tulokset suoraan kokeeni metriikoiden rinnalla, joten voin verrata kaikkea samassa näkymässä. Raporttien avulla tiimini voi myös lisätä koontinäyttöihin huomautuksia ja jakaa ne poistumatta alustalta.
Weights & Biasesin tärkeimmät ominaisuudet
- Artefaktit: Versioi ja seuraa tietoaineistoja, malleja ja arviointituloksia kokeiden eri ajokerroilla.
- Mallirekisteri: Keskittää koulutetut mallit ja yhdistää ne suoraan kokeisiin, joissa ne tuotettiin.
- Ajokertojen ryhmittely: Järjestää toisiinsa liittyvät ajokerrat ryhmiksi, jotta tuloksia voidaan verrata eri koulutusasetuksissa.
- Hälytykset: Määrittää automaattiset ilmoitukset metriikkakynnyksille, ajokertojen epäonnistumisille tai työtehtävien valmistumiselle.
Weights & Biases -integraatiot
Weights & Biases tarjoaa natiiviset integraatiot PyTorchin, Kerasin, TensorFlow'n, Scikit-learnin, XGBoostin, Hugging Face Transformersin ja PyTorch Lightningin kanssa sekä LLM-työkalujen, kuten LangChainin ja LlamaIndexin, kanssa. Se integroituu myös Kubeflow'hun, Jenkinsiin, Airflow'hun, GitHub Actionsiin, AWS SageMakeriin ja Google Vertex AI:hin. Mukautettuja integraatioita varten on saatavilla API ja Python SDK.
Pros and Cons
Pros:
- Metriikoiden reaaliaikainen suoratoisto live-koontinäyttöihin
- Git-commitien ja asetusten automaattinen kirjaus
- Monipuoliset yhteistyöraportit upotetuilla kaavioilla
Cons:
- Verkkokäyttöliittymä hidastuu useiden rinnakkaisten ajokertojen yhteydessä
- Perustoimintojen dokumentaatiossa on puutteita
Learn more about Weights & Biases: Paras vaihtoehto putkien automaattiseen versiointiin
- 14 päivän ilmainen kokeilu saatavilla
- Hinta pyynnöstä

Valohai tarjoaa koneoppimisalustan kokeilujen seurantaan ja mallien kouluttamiseen. Valohai on koneoppimisalusta, joka yhdistää kokeilujen automaattisen seurannan, tietoaineistojen versioinnin, mallien alkuperäseurannan ja pilvilaskennan orkestroinnin tiimeille, jotka rakentavat ja kouluttavat malleja suuressa mittakaavassa.
Kenelle Valohai sopii parhaiten?
Valohai sopii erityisen hyvin keskisuurten ja suurten yritysten koneoppimisen suunnittelutiimeille, jotka suorittavat usein koulutustöitä useissa pilviympäristöissä.
Miksi valitsin Valohain
Valitsin Valohain yhdeksi parhaista vaihtoehdoista, koska automaattinen versiointi on aidosti sisäänrakennettu jokaiseen ajoon. Mittarit, metatiedot, lokit ja hyperparametrit versioidaan ilman manuaalisia tunnisteita, joten minun ei koskaan tarvitse selvittää jälkikäteen, mitä milloinkin ajettiin. Pidän myös siitä, että Valohai seuraa tietoaineistojen ja mallien koko alkuperäketjua, joten voin jäljittää tarkasti, mikä tietoaineiston versio tuotti minkäkin mallin. Jokainen ajo on suunniteltu toistettavaksi, mikä poistaa arvailun, joka tekee kokeilujen tarkastuksista hankalia.
Valohain tärkeimmät ominaisuudet
- Kokeilujen vertailunäkymä: Näyttää useita ajoja rinnakkain, joten voit vertailla hyperparametreja, mittareita ja tuloksia eri kokeilujen välillä yhdessä taulukossa.
- Putkien rakennustyökalu: Visuaalinen editori monivaiheisten koneoppimisputkien rakentamiseen, jossa jokainen solmu vastaa versioitua suoritusvaihetta.
- Pilvilaskennan orkestrointi: Varaa ja lopettaa pilvi-instanssit automaattisesti AWS:ssä, GCP:ssä tai Azuressa jokaista koulutusajoa varten.
- Käyttöönoton käynnistimet: Siirtää koulutetut mallit suoraan palvelupäätepisteeseen samasta alustasta, jota käytetään koulutukseen.
Valohain integraatiot
Valohai tarjoaa Ecosystem-kirjastonsa kautta pienen joukon valmiita integraatioita, kuten liitännät Snowflakeen, BigQueryyn ja Redshiftiin, Hugging Face -mallin sekä integraatiot Slurmiin ja OVHcloudiin. Se toimii AWS:ssä, GCP:ssä, Azuressa ja Oracle Cloud Infrastructure -ympäristössä sekä tarjoaa REST-ohjelmointirajapinnan mukautettujen integraatioiden rakentamiseen.
Pros and Cons
Pros:
- Kirjaa tulostetun JSON-tiedoston mittarit automaattisesti
- Toimii missä tahansa pilvessä tai paikallisessa laitteistossa
- Täysi alkuperäketju mallista tietoaineistoon
Cons:
- Komentosarjojen muuntaminen Valohai-muotoon vaatii työtä
- Kokeilujen päänäkymä vaikuttaa visuaalisesti vaisulta
Learn more about Valohai: Paras automaattiseen putkien orkestrointiin
- Ilmainen tilaus saatavilla
- Alkaen $15/käyttäjä/kuukausi

Avoimen lähdekoodin MLOps-alusta koneoppimisen seurannalle, putkille ja mallien hallintaan. ClearML on avoimen lähdekoodin MLOps-alusta, joka kattaa kokeiden seurannan, tietojoukkojen versioinnin, mallien hallinnan ja putkien orkestroinnin koko koneoppimisen elinkaaren ajan.
Kenelle ClearML sopii parhaiten?
ClearML sopii hyvin koneoppimisinsinööreille ja datatieteilijöille organisaatioissa, jotka ylläpitävät itse MLOps-infrastruktuuriaan ja tarvitsevat täyden hallinnan putkistoistaan.
Miksi valitsin ClearML:n
ClearML päätyi suosikkieni joukkoon, koska sen automaattinen putkien orkestrointi on todella vaivatonta. Kun lisään työn jonoon, ClearML paketoi sen säilöön koko ympäristönsä kanssa ja hoitaa kaiken ajoituksen sekä resurssienhallinnan automaattisesti. Minun ei tarvitse kirjoittaa koodia uudelleen siirtyäkseni paikallisesta ympäristöstä pilveen tai HPC-klustereihin. Pidän myös siitä, että välimuistissa olevien putkikomponenttien ansiosta voin ohittaa tarpeettomat vaiheet uudelleenajoissa, mikä lyhentää iteratiivisten koulutustyönkulkujen läpimenoaikaa merkittävästi.
ClearML:n tärkeimmät ominaisuudet
- Kokeiden automaattinen kirjaus: Kaappaa automaattisesti jokaisesta koulutusajosta metriikat, hyperparametrit, konsolitulosteen ja lähdekoodin ilman lisäinstrumentointia.
- ClearML Data -versiointi: Versioi ja hallitse tietojoukkoja täydellisen alkuperän seurannan avulla ja yhdistä kukin tietojoukon versio suoraan kokeisiin, joissa sitä käytettiin.
- Mallirekisteri: Tallenna, nimeä ja hae koulutettuja malleja versionhallinnan ja vaihemerkintöjen avulla koko kehityksen elinkaaren ajan.
- Hyperparametrien optimointi: Suorita automaattisia HPO-hakuja kokeiden välillä käyttämällä sisäänrakennettuja hakustrategioita, kuten bayesilaista optimointia ja satunnaishakua.
ClearML-integraatiot
ClearML tarjoaa natiivit integraatiot PyTorchin, TensorFlow'n, Kerasin, Scikit-learnin, XGBoostin, Hugging Face Transformersin, FastAI:n, Optunan ja Hydran kanssa sekä visualisointityökaluihin, kuten Matplotlibiin ja TensorBoardiin. Mukautettuja integraatioita varten on saatavilla API ja Python SDK.
Pros and Cons
Pros:
- Itse ylläpidettävä avoimen lähdekoodin palvelin poistaa tilausmaksut
- Kirjaa koodin, tietojoukot ja hyperparametrit automaattisesti ilman instrumentointia
- Modulaarisen rakenteen ansiosta voit ottaa käyttöön yksittäisiä komponentteja
Cons:
- Dokumentaation puutteet hidastavat uusien käyttäjien perehdytystä
- Moduulien välinen navigointi tuntuu suurissa ympäristöissä hajanaiselta
Learn more about ClearML: Paras avoimen lähdekoodin mallin elinkaaren hallintaan
- Ilmainen demo saatavilla
- Hinta pyynnöstä

MLflow seuraa ML-kokeita, malliversioita ja käyttöönottoa. MLflow on avoimen lähdekoodin ML-kokeiden seurantajärjestelmä, joka kattaa koko mallin elinkaaren kokeiden kirjaamisesta ja ajojen vertailusta mallien paketointiin, versiointiin ja käyttöönottoon.
Kenelle MLflow sopii parhaiten?
MLflow sopii luontevasti ML-insinööreille ja datatieteilijöille organisaatioissa, jotka ylläpitävät työkalunsa itse ja haluavat täyden hallinnan kokeiden seurannan infrastruktuurista ilman toimittajalukkiutumista.
Miksi valitsin MLflow'n
MLflow päätyi suosikkilistalleni, koska se kattaa koko mallin elinkaaren yhdessä avoimen lähdekoodin kehyksessä. Käytän MLflow-seuranta-APIa parametrien, metriikoiden ja artefaktien kirjaamiseen eri ajoista ja sen jälkeen mallirekisteriä mallien versiointiin sekä niiden siirtämiseen kehityksestä tuotantoon. Arvostan erityisesti sitä, että voin paketoida mallit MLflow'n vakiomuodossa ja ottaa ne käyttöön missä tahansa kohteessa ilman palvelukoodin uudelleenkirjoittamista.
MLflow'n keskeiset ominaisuudet
- Automaattinen lokiin kirjaus: Kaappaa automaattisesti parametrit, metriikat ja artefaktit tuetuista kirjastoista, kuten Scikit-learn-, XGBoost- ja PyTorch-kirjastoista, ilman manuaalisia kirjauskutsuja.
- Ajojen vertailukäyttöliittymä: Visualisoi ja vertailee useiden koulutusajojen metriikoita rinnakkain MLflow'n sisäänrakennetussa verkkokäyttöliittymässä.
- MLflow-projektit: Paketoi ML-koodin riippuvuuksineen ja aloituspisteineen, jotta mikä tahansa ajo voidaan toistaa täsmälleen samanlaisena millä tahansa koneella.
- Laajennusjärjestelmä: Laajentaa MLflow'n seuranta-, tallennus- ja käyttöönottotoimintoja yhteisön rakentamilla laajennuksilla ilman ydinkoodin muokkaamista.
MLflow-integraatiot
MLflow tarjoaa yli 60 sisäänrakennettua integraatiota, kuten PyTorchin, TensorFlow'n, Scikit-learnin, XGBoostin, LightGBM:n, Hugging Face Transformersin, LangChainin, LlamaIndexin ja OpenAI:n integraatiot. Se tukee myös AWS SageMakeria, Azure ML:ää, Databricksia ja OpenTelemetryä. Mukautettuja integraatioita varten saatavilla ovat REST-rajapinta ja Python SDK.
Pros and Cons
Pros:
- Kehyksistä riippumaton kirjaus eri ML-kirjastoissa
- Täydellinen mallien versiointi vaiheiden siirtymineen
- Voidaan ylläpitää itse missä tahansa infrastruktuurissa
Cons:
- Tuotantokäyttöönotto edellyttää DevOps-työtä
- Rajoitetut sisäänrakennetun laitteistoprofiloinnin visualisoinnit
Learn more about MLflow: Sopii parhaiten integraatioon syväoppimiskehysten kanssa
- Ikuisesti maksuton paketti saatavilla
- Maksuton ikuisesti (avoin lähdekoodi)
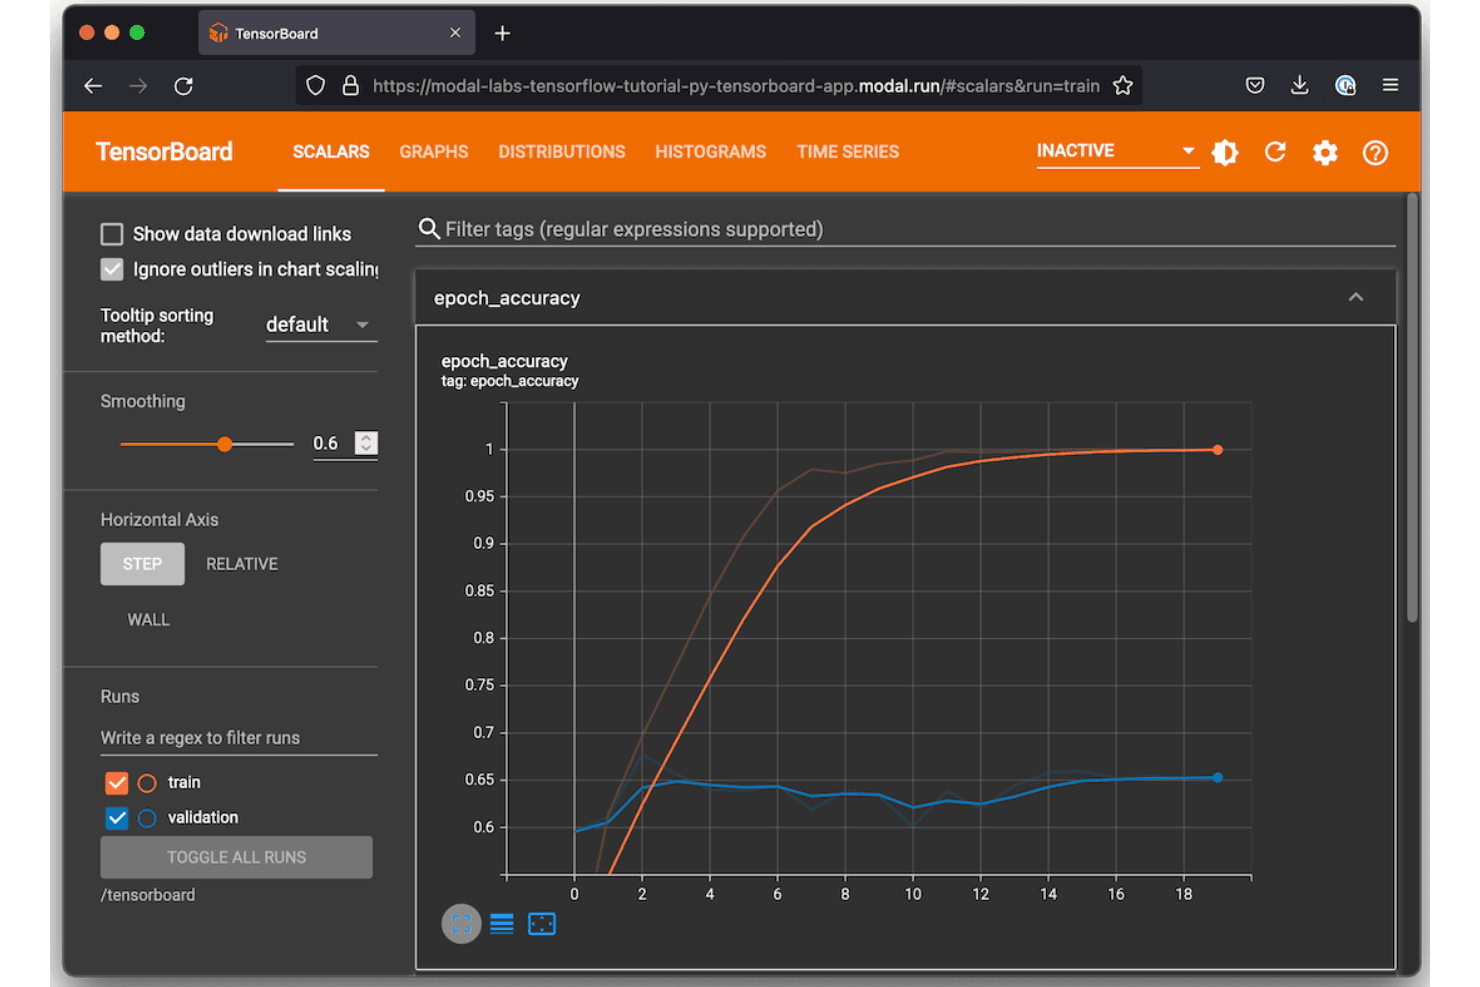
TensorFlow (Googlen avoimen lähdekoodin kehys) tarjoaa tekoälymallien kehityksen. TensorFlow on Googlen avoimen lähdekoodin koneoppimiskehys, joka kattaa mallien suunnittelun, koulutuksen, arvioinnin ja käyttöönoton syväoppimisen ja neuroverkkojen työnkuluissa.
Kenelle TensorFlow sopii parhaiten?
TensorFlow sopii erityisesti tutkimusryhmille ja ML-insinööreille, jotka rakentavat ja kouluttavat syväoppimismalleja suuressa mittakaavassa, erityisesti tuotantoympäristöissä.
Miksi valitsin TensorFlow'n
Olen sisällyttänyt TensorFlow'n kärkivalintoihini, koska sen natiivin Keras-ohjelmointirajapinnan avulla voin rakentaa ja kehittää syväoppimisarkkitehtuureja vaihtamatta kontekstia tai kehystä. Hyödynnän myös TensorBoardia suoraan TensorFlow'ssa koulutusmittareiden seurantaan, laskentakaavioiden visualisointiin ja ajokertojen vertaamiseen rinnakkain. TensorFlow Hub tarjoaa käyttööni esikoulutettuja malleja, joita voin hienosäätää, mikä lyhentää merkittävästi siirto-oppimiskokeiden koulutusaikaa.
TensorFlow'n tärkeimmät ominaisuudet
- TensorFlow Extended (TFX): Tuotantokäyttöön tarkoitettu ML-putkistokehys, jolla organisoidaan datan validointi-, muunnos-, koulutus- ja mallien arviointivaiheet.
- tf.data API: Luo skaalautuvia syöteputkistoja aineistojen lataamiseen, esikäsittelyyn ja eräajoon mallien koulutuksen aikana.
- TensorFlow Serving: Ottaa koulutetut mallit käyttöön tuotannossa REST- tai gRPC-päätepisteiden kautta ilman mallikoodin muokkaamista.
- SavedModel-muoto: Sarjallistaa koulutetut mallit täydellisine laskentakaavioineen ja painoineen, jotta ne voidaan ladata uudelleen ja jakaa toistettavasti.
TensorFlow'n integraatiot
TensorFlow on avoimen lähdekoodin kehys eikä SaaS-alusta, joten se ei tarjoa perinteisiä natiiveja integraatioita kolmannen osapuolen työkaluihin. Sen ekosysteemiin kuuluu sen sijaan sisäänrakennettuja kirjastoja, kuten TensorBoard, TFX, TensorFlow.js, TensorFlow Serving, Keras ja ML Metadata, jotka huolehtivat kokeiden seurannasta, putkistojen organisoinnista ja mallien käyttöönotosta itse kehyksen sisällä. Kolmannen osapuolen kokeenseurannan työkalut, kuten MLflow ja Weights & Biases, tarjoavat omat TensorFlow-integraationsa, ja mukautettuja laajennuksia varten on saatavilla Python-ohjelmointirajapinta.
Pros and Cons
Pros:
- Koulutusmittareiden ja kaavioiden reaaliaikainen visualisointi
- Sisäänrakennetut hyperparametrien virityksen ja optimoinnin työkalut
- Käyttöönotto suorittimilla, grafiikkasuorittimilla ja TPU:illa
Cons:
- TensorBoard hidastuu useiden kokeiden yhteydessä
- Tallentaa tiedot paikallisesti ilman sisäänrakennettua yhteistyötä
Learn more about TensorFlow: Paras Kubernetes-natiiviseen työnkulkujen hallintaan
- Maksuton palvelupaketti saatavilla
- Maksuton ja avoimen lähdekoodin

Kubeflow tarjoaa avoimen lähdekoodin ML-alustan Kubernetes-työnkuluille. Kubeflow on Kubernetesiin rakennettu avoimen lähdekoodin ML-alusta, joka kattaa putkien orkestroinnin, kokeiden seurannan, mallien koulutuksen ja hyperparametrien virityksen natiivisti kontitetussa infrastruktuurissa.
Kenelle Kubeflow sopii parhaiten?
Kubeflow sopii luontevasti ML-suunnittelutiimeille, jotka käyttävät jo työkuormia Kubernetesissa ja haluavat pitää kokeiden seurannan infrastruktuurin samalla alustalla.
Miksi valitsin Kubeflow'n
Kubeflow pääsi suosikkieni joukkoon, koska se yhdistää jokaisen putken vaiheen suoraan Kubernetes-podiin, jolloin kokeiden ajot saavat samat resurssien hallintatoiminnot kuin kaikki muutkin klusterin työkuormat. Käytän Kubeflow Pipelinesia koulutusajojen versiointiin ja uudelleen suorittamiseen poistumatta Kubernetes-ympäristöstä. Sen Katib-komponentti suorittaa rinnakkaisia hyperparametrien virityskokeita natiiveina Kubernetes-töinä ilman erillistä infrastruktuuria.
Kubeflown tärkeimmät ominaisuudet
- Nimiavaruuksien eristys useille käyttäjille: Erottaa kokeet ja putket tiimin tai projektin mukaan käyttämällä Kubernetesin nimiavaruustason käyttöoikeusvalvontaa.
- Kubeflow-muistikirjat: Käynnistää Jupyter-muistikirjapalvelimet suoraan klusterissa, jolloin tietojen tutkiminen tapahtuu samassa ympäristössä kuin koulutusajot.
- Artefaktien alkuperän seuranta: Tallentaa jokaisen putken vaiheen syötteet, tulosteet ja metatiedot sekä yhdistää tietojoukot ja mallit tiettyihin ajoihin.
- Koulutusoperaattori: Hallinnoi hajautettuja koulutustöitä PyTorchin, TensorFlow'n ja XGBoostin kaltaisilla kehyksillä natiiveina Kubernetesin mukautettuina resursseina.
Kubeflow-integraatiot
Kubeflow ei tarjoa perinteisiä natiiveja integraatioita, vaan toimii Kubernetes-ekosysteemissä ja tukee ML-kehyksiä, kuten TensorFlow'ta, PyTorchia, JAXia, XGBoostia, HuggingFacea ja Apache Sparkia aliprojektiensa operaattorien kautta. Sen voi myös ottaa käyttöön AWS:n, Google Cloudin, Microsoft Azuren ja Red Hat OpenShiftin hallinnoiduissa Kubernetes-palveluissa.
Pros and Cons
Pros:
- Suorittaa kokeet suoraan Kubernetes-podeissa
- Putkien versiointi seuraa jokaista koulutusajoa
- Rinnakkainen hyperparametrien viritys Katib-komponentin avulla
Cons:
- Klusterin määritys edellyttää syvällistä Kubernetes-osaamista
- Käyttöliittymä vaikuttaa vanhentuneelta kaupallisiin vaihtoehtoihin verrattuna
Learn more about Kubeflow: Paras integraatioon AWS-pilviekosysteemin kanssa
- Ilmainen sopimus saatavilla
- Alkaen $0.204/tunti

Amazon SageMaker hallinnoi koneoppimisen koulutusta, viritystä ja käyttöönottoa. Amazon SageMaker on täysin hallinnoitu koneoppimisen alusta AWS:ssä. Se kattaa kokeiden seurannan, mallien koulutuksen, hyperparametrien virityksen, mallirekisterin ja käyttöönoton koko koneoppimisen elinkaaren ajan.
Kenelle Amazon SageMaker sopii parhaiten?
Amazon SageMaker sopii luontevasti datatieteen ja koneoppimisen suunnittelutiimeille, jotka käyttävät jo AWS-infrastruktuurissa toimivia työkuormia.
Miksi valitsin Amazon SageMakerin
Sisällytin Amazon SageMakerin kärkivalintoihini, koska sen kokeiden seuranta on yhdistetty suoraan AWS-ekosysteemiin tavoilla, joita muut työkalut eivät pysty jäljittelemään. SageMaker Experiments kirjaa ajot, parametrit ja mittarit natiivisti S3-artefaktien tallennuksen ja IAM-hallittujen käyttöoikeuksien rinnalla, joten erillistä hallittavaa infrastruktuuria ei tarvita. Tiimini käyttää myös SageMaker Pipelinesia koulutustöiden, arviointien ja mallien rekisteröinnin ketjuttamiseen yhdeksi tarkastettavaksi työnkuluksi ilman AWS-ympäristöstä poistumista.
Amazon SageMakerin tärkeimmät ominaisuudet
- SageMaker-mallirekisteri: Versioi, hyväksy ja siirrä koulutettuja malleja eri vaiheisiin sekä seuraa metatietoja mallin koko elinkaaren ajan.
- Automaattinen mallin viritys: Suorita hyperparametrien optimointitöitä Bayesilaisilla, satunnaisilla tai ruudukkohakustrategioilla laajassa mittakaavassa.
- SageMaker Debugger: Valvo koulutustöitä reaaliajassa ja havaitse ongelmat, kuten häviävät gradientit tai ylisovittaminen, niiden tapahtuessa.
- SageMaker Feature Store: Tallenna, jaa ja hae koneoppimisominaisuuksia koulutus- ja päättelytyökuormia varten keskitetystä tietovarastosta.
Amazon SageMaker -integraatiot
Amazon SageMaker integroituu natiivisti AWS-ekosysteemiin, mukaan lukien Amazon S3, Amazon Redshift, AWS Glue, Amazon EMR, Amazon Athena, Amazon ECR, AWS Lambda, Amazon CloudWatch ja MLflow. Mukautettuja integraatioita varten on saatavilla ohjelmointirajapinta.
Pros and Cons
Pros:
- Seuraa parametreja, dataa ja koodiversioita ajokohtaisesti
- Automaattinen tarkistuspisteiden luonti pitkien koulutustöiden aikana
- Sisäänrakennettu mallien valvonta kokeiden lokien rinnalla
Cons:
- Käyttämättömät resurssit voivat huomaamatta kerryttää laskutettavia kustannuksia
- Malliartefaktit käyttävät AWS-kohtaisia formaatteja, mikä rajoittaa siirrettävyyttä
Learn more about Amazon SageMaker: Paras valinta laajennettavuutta tarjoavaa liitännäisarkkitehtuuria varten
- Ilmainen paketti saatavilla
- Alkaen $399/kuukausi

Avoimen lähdekoodin ML-putkistojen orkestrointi seurannalla ja mallien alkuperätiedoilla. ZenML on avoimen lähdekoodin ML-putkistojen orkestrointialusta, joka hallinnoi työnkulkujen orkestrointia, artefaktien versiointia, mallien alkuperätietoja ja kokeilujen seurantaa missä tahansa pilvi-infrastruktuurissa tai ML-pinossa.
Kenelle ZenML sopii parhaiten?
ZenML sopii erinomaisesti ML-insinööreille ja datatiederyhmille, jotka tarvitsevat ML-putkistojen standardointia ja skaalausta useissa pilviympäristöissä tai infrastruktuuripinoissa.
Miksi valitsin ZenML:n
ZenML pääsi suosikkilistalleni, koska sen pinokomponenttiarkkitehtuurin ansiosta voin vaihtaa minkä tahansa ML-infrastruktuurini osan kirjoittamatta putkiston koodia uudelleen. Voin liittää MLflown tai Weights & Biasesin kokeilujen seurantaan, vaihtaa artefaktivaraston paikallisesta S3:een ja muuttaa orkestroijaksi Kubeflown vaihtamalla vain aktiivista pinoa. Käytän myös ZenML:n mukautettuja komponenttimalleja omien seurantaintegraatioiden rakentamiseen, jotta ne sopivat suoraan samaan putkistoabstraktioon.
ZenML:n tärkeimmät ominaisuudet
- Putkiston vaiheiden välimuisti: Tallentaa aiemmin suoritettujen vaiheiden tulokset automaattisesti välimuistiin, joten muuttumattomia vaiheita ei suoriteta uudelleen iteratiivisten kokeilujen aikana.
- Artefaktien versiointi: Seuraa jokaista putkiston suorituksen tuottamaa artefaktia, mukaan lukien aineistot, mallit ja mittarit, sekä niiden täydellisiä alkuperätietoja aina lähtökohtana olevaan vaiheeseen asti.
- Mallirekisteri: Tallentaa koulutetut mallit ja niiden versiot sekä niihin liittyvät metatiedot, putkistojen suoritukset ja käyttöönottohistorian keskitettyyn rekisteriin.
- ZenML-kojelauta: Tarjoaa verkkokäyttöliittymän putkistojen suoritusten selaamiseen, kokeilujen tulosten vertailemiseen ja artefaktien metatietojen tarkasteluun eri pinoissa.
ZenML-integraatiot
ZenML tarjoaa 66 natiivia integraatiota ML-ekosysteemissä, mukaan lukien MLflow, Weights & Biases, Neptune, Comet ja TensorBoard, sekä orkestroijia, kuten Kubeflow, Apache Airflow, Kubernetes ja Databricks, ja pilvi-infrastruktuuria AWS:lle, Google Cloudille ja Microsoft Azurelle. Mukautettuja integraatioita varten on saatavilla ohjelmointirajapinta.
Pros and Cons
Pros:
- Infrastruktuurin vaihtaminen ilman putkiston koodin uudelleenkirjoittamista
- Pilvipalvelusta riippumaton pino estää toimittajalukkiutumisen
- Artefaktien automaattinen versiointi putkistojen suoritusten välillä
Cons:
- Kokeilujen visualisointi perustuu kolmansien osapuolten työkaluihin
- Pinon alkuperäinen määritys vaatii huomattavan paljon valmistelutyötä
Learn more about ZenML: 10Sopii parhaiten hybridi- ja paikalliseen käyttöönottoon
Polyaxon
- Ilmainen paketti + ilmainen esittely saatavilla
- Alkaen $450/month (laskutetaan vuosittain)

Polyaxon seuraa ML-kokeiluja, putkia ja malleja pilviympäristöissä. Polyaxon on ML-kokeilujen seurantaan ja putkien orkestrointiin tarkoitettu alusta, joka kattaa kokeilujen seurannan, hyperparametrien optimoinnin, artefaktien versioinnin, mallirekisterin sekä hajautettujen töiden ajoituksen pilvi- ja paikallisessa infrastruktuurissa.
Kenelle Polyaxon sopii parhaiten?
Polyaxon sopii hyvin suurten organisaatioiden ML-insinööreille, jotka toimivat tiukkojen tiedonhallintavaatimusten alaisina tai tarvitsevat työkuormien suorittamista yksityisessä infrastruktuurissa.
Miksi valitsin Polyaxonin
Olen sisällyttänyt Polyaxonin kärkivalintoihini, koska se on yksi harvoista ML-kokeilujen seurantaan tarkoitetuista alustoista, jotka on suunniteltu alusta alkaen toimimaan kokonaan omassa infrastruktuurissasi. Käytän sitä yksityisessä Kubernetes-klusterissa, ja kaikki kokeilulokit, artefaktit ja mallit pysyvät verkkomme sisällä. Sen agenttipohjaisen arkkitehtuurin ansiosta voin yhdistää eristetyt paikalliset ympäristöt keskitettyyn ohjaustasoon paljastamatta raakadataa ulkopuolisille, mikä on todellinen vaatimus säännellyillä toimialoilla.
Polyaxonin tärkeimmät ominaisuudet
- Hyperparametrien haku ja optimointi: Suorita kokeiluryhmiä rinnakkain hajautettujen hakustrategioiden avulla löytääksesi optimaaliset mallikokoonpanot.
- Komponenttikeskus: Määritä uudelleenkäytettäviä moduuleja, joissa on tyypitetyt syötteet ja tulosteet ja joita voidaan jakaa ja versioida tiimisi putkissa.
- Tehokas haku: Suodata ajoja nimen, kuvauksen, säännöllisen lausekkeen, tiettyjen kenttien, metriikoiden tai kokoonpanojen perusteella löytääksesi kokeilut nopeasti.
- SLA-vaatimusten valvonta: Sovella TTL-, aikakatkaisu- ja uudelleenyrityskäytäntöjä yksittäisiin toimintoihin pitääksesi putket käynnissä määritettyjen rajojen puitteissa.
Polyaxon-integraatiot
Polyaxon tarjoaa laajan valikoiman natiivi-integraatioita ML-seurantaan, orkestrointiin ja infrastruktuuriin, mukaan lukien TensorBoard, PyTorch, TensorFlow, Keras, XGBoost, Hugging Face, Kubeflow, Slack, GitHub ja Jenkins. Se yhdistyy myös Zapieriin ja tarjoaa API-rajapinnan mukautettuja integraatioita ja CI/CD-automaatiota varten.
Pros and Cons
Pros:
- Kubernetes-natiivi hajautettujen koulutustöiden ajoitus
- Sisäänrakennettu moniasiakkuus tarkkoine käyttöoikeusvalvontoineen
- Tukee paikallisia, pilvi- ja hybridikäyttöönottoja
Cons:
- Käyttö edellyttää syvällistä Kubernetes-osaamista
- Pienempi yhteisö kuin MLflowlla tai W&B:llä
Learn more about Polyaxon:
Muita ML-kokeiden seurantatyökaluja
Tässä on muutamia muita ML-kokeiden seurantatyökaluja, jotka eivät päässeet listalleni mutta joihin kannattaa silti tutustua:
- 11DatabricksParas tiimien yhtenäiseen analytiikan työtilaan
- 12Domino Data LabParas keskitettyyn hallintaan yhteistyöhön perustuvassa tutkimuksessa
- 13iguazioSopii parhaiten reaaliaikaiseen mallien valvontaan suuressa mittakaavassa
- 14DagsterParas ohjelmalliseen tietoputkien luomiseen
Miten arvioin koneoppimiskokeiden seurannan työkaluja
Jaan arviointini kahteen tasoon: siihen, mitä jokaisen työkalun on tehtävä (kuten PyTorch-ajojen automaattinen lokikirjaus), ja siihen, mikä erottaa parhaat työkalut muista.
Ydintoiminnot (tämän luettelon perusvaatimukset)
Kun valitsen työkaluja luettelooni, arvioin jokaisen työkalun asteikolla 0 (ei tarjoa toimintoa)–5 (erinomainen tällä osa-alueella) kunkin alla luetellun ydintoiminnon osalta. Sen jälkeen lasken työkalun kokonaispistemäärän prosenttiosuutena. Työkalun on saavutettava vähintään 65 prosentin kokonaispistemäärä, jotta sitä voidaan harkita mukaan otettavaksi.
- Kokeiden lokikirjaus: Tarkistan, kerääkö työkalu automaattisesti mittarit, hyperparametrit ja järjestelmätason telemetriatiedot koulutusajoista vai edellyttääkö se manuaalista SDK-instrumentointia jokaiselle tietopisteelle.
- Ajojen vertailu ja visualisointi: Rinnakkaiset ajotaulukot ovat lähtökohta, mutta etsin interaktiivisia kaavioita, kuten rinnakkaiskoordinaattikaavioita, jotka auttavat havaitsemaan malleja kymmenien ajojen joukosta koneoppimisprojekteissasi.
- Artefaktien ja mallien versiointi: Arvioin, miten kukin työkalu versioi aineistoja, mallien tarkistuspisteitä ja tuloksia sekä yhdistääkö se artefaktit takaisin täsmälliseen ajoon, jossa ne tuotettiin.
- Koneoppimiskehysten tuki: Työkalun pitäisi kattaa kehykset, joita tiimisi todella käyttää, PyTorchista ja TensorFlow'sta Hugging Face Transformersiin ja XGBoostiin, mahdollisimman vähäisellä käärekoodilla.
- Toistettavuus ja alkuperätiedot: Etsin työkaluja, jotka tallentavat koodin toimitukset, riippuvuuksien tilannevedokset ja aineiston tilan yhdessä, jotta voit ajaa kuusi kuukautta sitten tehdyn kokeen uudelleen ja saada saman tuloksen.
- Yhteistyö ja jakaminen: Eri aikavyöhykkeillä työskentelevät tiimit tarvitsevat jaettuja työtiloja, roolipohjaisen käyttöoikeuksien hallinnan sekä mahdollisuuden kommentoida tiettyjä ajoja tai jakaa niitä ilman CSV-tiedostojen jatkuvaa vientiä ja tuontia.
Kun minulla on luettelo näiden kriteerien täyttävistä työkaluista, tarkastelen sitä, mikä erottaa kunkin alustan muista.
Erottavat tekijät (mikä erottaa toimittajat toisistaan)
Näin vertailen ja asetan eri toimittajia vastakkain:
Erottuvat ominaisuudet
Hyperparametrien optimointi on keskeinen erottava tekijä. Etsin sisäänrakennettua pyyhkäisytoimintoa, joka automatisoi haun hajautettujen ajojen yli ja visualisoi suorituskyvyn eri kokoonpanoissa yhdessä näkymässä. Myös resurssien reaaliaikainen seuranta tuottaa todellista lisäarvoa – kun voit seurata grafiikkasuorittimen ja muistin käyttöä koulutuksen aikana, havaitset pullonkaulat ennen kuin ajo tuhlaa tunteja laskenta-aikaa. Yhteistyötä tukeva raportointi täydentää kokonaisuuden suuremmissa tiimeissä, joissa jaettavat koontinäytöt korvaavat manuaaliset laskentataulukot ja antavat datatieteilijöille mahdollisuuden keskustella tuloksista sidosryhmien kanssa ilman työkalun vaihtamista.
Ominaisuuksia pidemmälle
Käyttöönoton joustavuus on tärkeämpää kuin monet tiimit odottavat. Arvioin, tukeeko työkalu itse isännöityjä tai verkkoyhteydestä eristettyjä ympäristöjä tiimeille, jotka käsittelevät arkaluonteista immateriaalioikeutta tai säänneltyä dataa. Skaalautuvuus on toinen tarkistamani tekijä – tuhansien samanaikaisten ajojen lokikirjauksen ei pitäisi heikentää kyselysuorituskykyä tai aiheuttaa ennakoimattomia kustannuspiikkejä. Myös käyttöönoton sujuvuus erottaa työkaluja toisistaan: hyvät pika-aloitusohjeet ja aktiiviset yhteisöfoorumit tarkoittavat, että tiimisi instrumentoi koulutusskriptit tunneissa, ei viikoissa.
Kuinka valita ML-kokeiden seurantatyökalut
On helppoa juuttua pitkiin ominaisuusluetteloihin ja monimutkaisiin hinnoittelurakenteisiin. Jotta pysyt keskittyneenä edetessäsi oman ohjelmistonvalintaprosessisi parissa, tässä on tarkistuslista huomioon otettavista tekijöistä:
| Tekijä | Mitä tulee ottaa huomioon |
|---|---|
| TekijäSkaalautuvuus | Mitä tulee ottaa huomioonPystyykö työkalu käsittelemään odottamasi kokeiden määrän ja tiheyden tiimisi ja datasi kasvaessa? |
| TekijäIntegraatiot | Mitä tulee ottaa huomioonYhdistyykö se suoraan suosimiisi ML-kehyksiin, orkestrointityökaluihin ja käyttöönottoratkaisuihin? |
| TekijäMukautettavuus | Mitä tulee ottaa huomioonVoitko mukauttaa metatietokenttiä, työnkulun vaiheita ja raportointia tiimisi yksilöllisten vaatimusten mukaisiksi? |
| TekijäHelppokäyttöisyys | Mitä tulee ottaa huomioonVaikuttaako käyttöliittymä tutkijoista ja insinööreistä intuitiiviselta vai onko sen oppimiskäyrä jyrkkä? |
| TekijäKäyttöönotto ja perehdytys | Mitä tulee ottaa huomioonKuinka nopeasti voit siirtyä hankinnasta ensimmäisen kokeesi seurantaan? Mitä resursseja käyttöönottoon tarvitaan? |
| TekijäKustannukset | Mitä tulee ottaa huomioonOvatko käyttöperusteinen hinnoittelu, tallennusmaksut tai tarvittavat lisäosat selkeitä ja ennakoitavia suhteessa arvioituihin tarpeisiisi? |
| TekijäTurvallisuustoimet | Mitä tulee ottaa huomioonTukeeko työkalu salausta, yksityiskohtaisia käyttöoikeuksia ja todennusta arkaluonteisten tietojen suojaamiseksi? |
| TekijäVaatimustenmukaisuusvaatimukset | Mitä tulee ottaa huomioonAuttaako työkalu sinua täyttämään toimialan, asiakkaiden tai maantieteellisen alueen asettamat sääntelyvaatimukset (SOC 2, ISO 27001, GDPR)? |
Mitä ML-kokeiden seurantatyökalut ovat?
ML-kokeiden seurantatyökalut ovat ohjelmistoalustoja, jotka kirjaavat, järjestävät ja versioivat koneoppimismallien kokeita, mukaan lukien niiden parametrit, koodin, aineistot ja mittarit. Nämä työkalut auttavat tiimiäsi tallentamaan kokeiden historian, vertailemaan tuloksia ja toistamaan aiemmat ajot täysin, mikä helpottaa yhteistyötä ja auditointia projektien työnkulkujen monimutkaistuessa.
Ominaisuudet
Kun valitset koneoppimiskokeiden seurannan työkaluja, kiinnitä huomiota seuraaviin keskeisiin ominaisuuksiin:
- Kokeiden kirjaaminen: Tallentaa jokaisen koulutusajon parametrit, määritykset, lähdekoodiviittaukset ja mittarit selkeän tarkastusketjun säilyttämiseksi.
- Ajojen vertailu: Mahdollistaa useiden kokeiden tarkastelun ja analysoinnin rinnakkain, jotta ymmärrät, miten eri asetukset tai muutokset vaikuttavat tuloksiin.
- Tuotosten versiointi: Versioi tietojoukot, versioidut koneoppimismallit ja muut tuotokset automaattisesti, joten voit aina toistaa aiemman työn tai rakentaa sen pohjalta.
- Kehysintegraatiot: Yhdistää työkalun suoraan suosittuihin koneoppimiskehyksiin, joten seurannan aloittaminen onnistuu helposti työnkulkuun tehtävillä vähäisillä muutoksilla.
- Alkuperäketjun seuranta: Kuvaa koko ketjun raakadatan käsittelystä lopulliseen malliin ja tukee toistettavuutta sekä sääntelyn noudattamista.
- Yhteistyötyökalut: Mahdollistaa useiden käyttäjien kommentoinnin, havaintojen dokumentoinnin ja tulosten jakamisen tiimin kesken.
- Mukautetut metatiedot: Mahdollistaa projektikohtaisten kenttien tai tunnisteiden lisäämisen, joten voit luokitella kokeet työnkulkusi vaatimalla tavalla.
- Roolipohjainen käyttöoikeuksien hallinta: Rajoittaa pääsyä arkaluonteisiin tietoihin ja toimintoihin sekä tukee organisaatiotason hallintaa ja tietoturvastandardeja.
- Koontinäytöt ja visualisoinnit: Luo mukautettavia raportteja ja tietovisualisointeja, joiden avulla kokeiden tiedoissa esiintyvät trendit ja poikkeamat voidaan tuoda nopeasti esiin.
- Haku ja suodatus: Auttaa tiimiä löytämään helposti olennaiset kokeet, ajot ja tuotokset parametrin, päivämäärän tai muiden ehtojen perusteella, mikä säästää aikaa projektin kasvaessa.
Yleisten koneoppimiskokeiden seurannan työkalujen tekoälyominaisuudet
Edellä lueteltujen koneoppimiskokeiden seurannan työkalujen vakiotoimintojen lisäksi monet näistä ratkaisuista sisältävät tekoälyä seuraavien kaltaisilla ominaisuuksilla:
- Automaattinen poikkeamien tunnistus: Tekoäly valvoo kokeiden mittareita ja merkitsee epätavalliset mallit tai poikkeavat arvot, mikä auttaa tiimejä havaitsemaan datan muuttumisen tai mallin odottamattoman toiminnan varhaisessa vaiheessa.
- Älykkäät hyperparametriehdotukset: Koneoppimisen avulla suositellaan optimaalisia hyperparametriarvoja aiempien kokeiden tietojen perusteella, mikä vähentää manuaalista arvailua ja nopeuttaa mallin säätämistä.
- Kokeiden kyselyt luonnollisella kielellä: Käyttäjät voivat hakea ja suodattaa kokeita keskustelukielellä, mikä helpottaa ei-teknisten sidosryhmien pääsyä kokeiden tuloksiin ja niiden ymmärtämistä.
- Ennakoiva resurssien kohdentaminen: Tekoäly ennustaa tulevien ajojen laskenta- ja muistitarpeet, mikä auttaa tiimejä suunnittelemaan resursseja ja välttämään pullonkauloja.
- Kokeiden automaattinen yhteenveto: Tekoälyn avulla luodaan tiiviitä yhteenvetoja kokeiden tuloksista ja tuodaan keskeiset havainnot sekä trendit esiin nopeampaa raportointia ja päätöksentekoa varten.
Hyödyt
Koneoppimiskokeiden seurannan työkalujen käyttöönotto tarjoaa tiimillesi ja yrityksellesi useita hyötyjä. Tässä muutamia etuja, joita voit odottaa:
- Kokeiden toistettavuus: Seuraa parametreja, tietojoukkoja ja ympäristön tietoja, jotta aiemmat kokeet voidaan helposti luoda uudelleen ja validoida.
- Sujuvampi yhteistyö: Jaetut koontinäytöt, kommentointi ja projektin dokumentointi auttavat tiimejä työskentelemään yhdessä ja viestimään tuloksista tehokkaasti.
- Nopeampi mallien kehittäminen: Ajojen rinnakkainen vertailu ja tuotosten automaattinen versiointi nopeuttavat kokeilukierroksia ja päätöksentekoa.
- Keskitetty tietämyksen hallinta: Kaikki projektin historia ja kokeiden metatiedot tallennetaan yhteen paikkaan, mikä säilyttää organisaation tietämyksen tiimien kasvaessa.
- Parantunut vaatimustenmukaisuus ja tarkastettavuus: Sisäänrakennettu alkuperäketjun seuranta ja tarkastuslokit tukevat sääntelyvaatimuksia ja yritystason hallintastandardeja.
- Resurssikustannusten hallinta: Resurssien reaaliaikainen seuranta ja ennakoivan kohdentamisen ominaisuudet auttavat tiimejä optimoimaan laitteiston käyttöä ja estämään tarpeettomia kuluja.
- Mukautettavan työnkulun tuki: Joustavat metatietokentät ja työnkulkuvaihtoehdot mukautuvat tiimisi nykyisiin prosesseihin ja mieltymyksiin.
Kustannukset ja hinnoittelu
Koneoppimiskokeiden seurannan työkalujen valitseminen edellyttää saatavilla olevien hinnoittelumallien ja tilausten ymmärtämistä. Kustannukset vaihtelevat ominaisuuksien, tiimin koon, lisäosien ja muiden tekijöiden perusteella. Alla olevassa taulukossa esitetään yhteenveto koneoppimiskokeiden seurannan työkaluratkaisujen yleisistä tilauksista, niiden keskimääräisistä hinnoista ja tyypillisistä ominaisuuksista:
Koneoppimiskokeiden seurannan työkalujen tilausten vertailutaulukko
| Suunnitelmatyyppi | Keskimääräinen hinta | Yleiset ominaisuudet |
|---|---|---|
| SuunnitelmatyyppiIlmainen suunnitelma | Keskimääräinen hinta$0 | Yleiset ominaisuudetKokeiden perustason seuranta, rajoitettu määrä käyttäjiä, yhteisön tuki ja julkiset projektit. |
| SuunnitelmatyyppiHenkilökohtainen suunnitelma | Keskimääräinen hinta$5-$25/käyttäjä/kuukausi | Yleiset ominaisuudetRajattomasti kokeita, suurempi tallennustila, yksityiset projektit ja perustason integraatiot. |
| SuunnitelmatyyppiYrityssuunnitelma | Keskimääräinen hinta$30-$70/käyttäjä/kuukausi | Yleiset ominaisuudetTiimityökalut, roolipohjainen käyttöoikeuksien hallinta, edistyneet integraatiot, parempi tietoturva ja tarkastuslokit. |
| SuunnitelmatyyppiSuuryrityssuunnitelma | Keskimääräinen hinta$80-$150/käyttäjä/kuukausi | Yleiset ominaisuudetMukautetut käyttöönottovaihtoehdot, SSO/SAML, vaatimustenmukaisuustyökalut, ensiluokkainen tuki ja edistyneet mukautusmahdollisuudet. |
ML-kokeiden seurantatyökalujen usein kysytyt kysymykset
Tässä on vastauksia yleisiin ML-kokeiden seurantatyökaluja koskeviin kysymyksiin:
Edellyttävätkö nämä työkalut paljon käyttöönottoa tai koodimuutoksia?
Eivät. Useimmat työkalut tarjoavat kevyet SDK:t tai liitännäiset, joiden avulla kokeiden kirjaamisen voi aloittaa vähäisillä koodimuutoksilla. Seurannan voi yleensä integroida komentosarjoihin vain muutamalla koodirivillä.
Miten nämä työkalut auttavat tiimin vaatimustenmukaisuudessa ja auditoinneissa?
Ne kirjaavat jokaisen ajon parametrit, koodin ja tulokset, luovat jäljitettävät kokeiden historiatiedot ja ylläpitävät tarkastusjälkiä. Näin vaatimustenmukaisuuden dokumentointi ja todisteiden jakaminen tarkastusten tai auditointien aikana helpottuu.
Toimivatko nämä ratkaisut Jupyter-muistikirjojen kanssa?
Kyllä. Useimmat ML-kokeiden seurantatyökalut on suunniteltu toimimaan suoraan Jupyter-muistikirjoissa sekä komentosarjojen ja käsittelyputkien kanssa, joten työnkulkua ei tarvitse muuttaa.
Mitä tapahtuu, jos tiimini kasvaa ilmaisen suunnitelman ulkopuolelle?
Voit päivittää maksulliseen tasoon, joka tarjoaa enemmän käyttäjiä, suuremmat tallennusrajat, edistyneet integraatiot ja yritystason ominaisuudet. Tutustu hinnoitteluun huolellisesti, jotta siirtymä ei aiheuta yllätyksiä.
Voinko tallentaa arkaluonteisia tai omistusoikeudellisia tietoja näillä työkaluilla?
Kyllä, mutta sinun kannattaa tutustua palveluntarjoajan tietoturvatoimiin, kuten salaukseen, käyttöoikeuksien hallintaan ja vaatimustenmukaisuustodistuksiin, jotta tietosi pysyvät suojattuina. Paikallisesti asennetut tai yksityisen pilven vaihtoehdot voivat tarjota vielä paremman hallinnan.