

Vahva dbt-vaihtoehto tarjoaa tiimillesi luotettavan SQL-pohjaisen datan muunnoksen, versionhallinnan ja työnkulkujen automatisoinnin sitomatta teitä yhteen lähestymistapaan tai ekosysteemiin. Jos etsit vaihtoehtoja dbt Corelle tai dbt Cloudille, punnitset todennäköisesti joustavuutta, integraatiovaihtoehtoja sekä sitä, haluatko koodikeskeisen työnkulun GitHub-pohjaisella versionhallinnalla.
Kun niin monet alustat kehittyvät jatkuvasti, on vaikea tietää, mitkä ratkaisut pystyvät vastaamaan datan mallintamisen, testaamisen, orkestroinnin ja yhteistyöhön perustuvan kehityksen tarpeisiisi. Tämä luettelo auttaa sinua vertailemaan vuoden 2026 parhaita dbt-vaihtoehtoja, jotta voit valita luottavaisin mielin oikean työkalun tiimisi analytiikan suunnittelun haasteisiin.
Mikä dbt on?
dbt on analytiikan suunnitteluun tarkoitettu työkalu, jonka avulla tiimit voivat muuntaa, testata ja dokumentoida dataa tietovarastossa SQL:n avulla. Sitä käytetään yleisesti ELT-työnkuluissa, joissa raakadata ladataan tietovarastoon ja muunnetaan vasta sen jälkeen. dbt mahdollistaa versionhallitut, koodikeskeiset työnkulut CI/CD-integraatiolla, modulaarisen datan mallintamisen ja automatisoidun testauksen, mikä helpottaa monimutkaisten analytiikkaputkien hallintaa.
Vaikka dbt ei itsessään ole graafiseen käyttöliittymään perustuva ETL-työkalu, se käyttää YAML:ia määrityksiin ja toimii yhdessä nykyaikaisten data-alustojen ETL-työkalujen kanssa. Se integroituu myös pilvialustoihin, kuten GCP:hen, ja muihin merkittäviin tietovarastoihin. Data-insinöörit ja analyytikot käyttävät dbt:tä laajasti, kun he haluavat rakentaa luotettavia ja ylläpidettäviä datan muunnoksia suoraan tietovarastoympäristössään.
dbt-vaihtoehtojen vertailutaulukko
Tässä vertailutaulukossa esitetään yhteenveto parhaiksi arvioimieni dbt-vaihtoehtojen hinnoittelutiedoista:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Sopii parhaiten edistyneeseen koodittomaan analytiikkaan | 3.0 out of 5 | 2 | 3 | 4 | 2 | 4 | 3 | Alkaen 250 $/käyttäjä/kuukausi 30 päivän maksuton kokeilu | Website |
Paras laajan liitinkirjaston tuen ansiosta | Not rated | Not rated | 2 | 5 | 2 | 4 | 2 | Hinta pyydettäessä Ei saatavilla | Website |
Paras palvelimettomaan ETL-automaatioon | 3.0 out of 5 | 2 | 3 | 4 | 2 | 4 | 3 | $0.29/DPU-hour Maksuton palvelupaketti saatavilla | Website |
Sopii parhaiten yritystason työkuormien skaalautuvuuteen | Not rated | 2 | 2 | 4 | Not rated | 2 | 3 | Hinta pyydettäessä 30 päivän ilmainen kokeilu + demo saatavilla | Website |
Paras vähäkoodiseen putkien rakentamiseen | 2.8 out of 5 | 2 | 2 | 4 | 3 | 3 | 3 | Hinnoittelu pyynnöstä 14 päivän maksuton kokeilu + demo saatavilla | Website |
Parhaimmillaan dynaamisissa tietojen validointisäännöissä | 2.7 out of 5 | 3 | 3 | 4 | 2 | 2 | 2 | Hinnoittelu pyynnöstä Ilmainen esittely saatavilla | Website |
Sopii parhaiten yhteistyöhön perustuvaan muistikirja-analytiikkaan | 3.7 out of 5 | 4 | 3 | 3 | 4 | 4 | 4 | Hinnoittelu pyynnöstä Kahden viikon ilmainen kokeilu + ilmainen esittely saatavilla | Website |
Paras saraketason datan alkuperän visualisointiin | 3.8 out of 5 | 4 | 4 | 4 | 4 | 3 | 4 | $150/käyttäjä/kk Ilmainen paketti saatavilla | Website |
Paras versionhallittuihin SQL-työnkulkuihin | 3.7 out of 5 | 4 | 3 | 5 | 4 | 2 | 4 | Hinnoittelu pyynnöstä Maksuton palvelupaketti saatavilla | Website |
Paras hallinnoituihin kehitysympäristöihin | 3.7 out of 5 | 3 | 3 | 4 | 4 | 4 | 4 | Hinnoittelu pyynnöstä 14 päivän ilmainen kokeilujakso + ilmainen esittely saatavilla | Website |


Miksi luottaa ohjelmistosuosituksiimme
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Tiimimme on testannut ja arvioinut ohjelmistoja vuodesta 2012 lähtien. Teknologiajohtajina tiedämme itse, kuinka vaikeaa — ja tärkeää — oikean ohjelmiston valitseminen on.
Tätä opasta varten arvioimme työkaluja käytännön testauksen ja itsenäisen tutkimuksen avulla, pisteyttäen työkalut valintakriteeriemme perusteella.
Arvostelumme perustuvat inhimilliseen toimitukselliseen harkintaamme, eivät myyntipuheeseen.
Asiantuntija-arvioijat:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

dbt-vaihtoehtojen arvostelut
Alla ovat yksityiskohtaiset yhteenvetoni dbt-vaihtoehdoista, jotka pääsivät esivalintaani. Arvosteluissani tarkastellaan yksityiskohtaisesti kunkin alustan ominaisuuksia, parhaita käyttötapauksia ja integraatioita, jotta löydät parhaiten analytiikan suunnittelun tarpeisiisi sopivan vaihtoehdon.
 Sopii parhaiten edistyneeseen koodittomaan analytiikkaan
- 30 päivän maksuton kokeilu
- Alkaen 250 $/käyttäjä/kuukausi (laskutetaan vuosittain)
Visit WebsiteCustomer Rating:4.6/5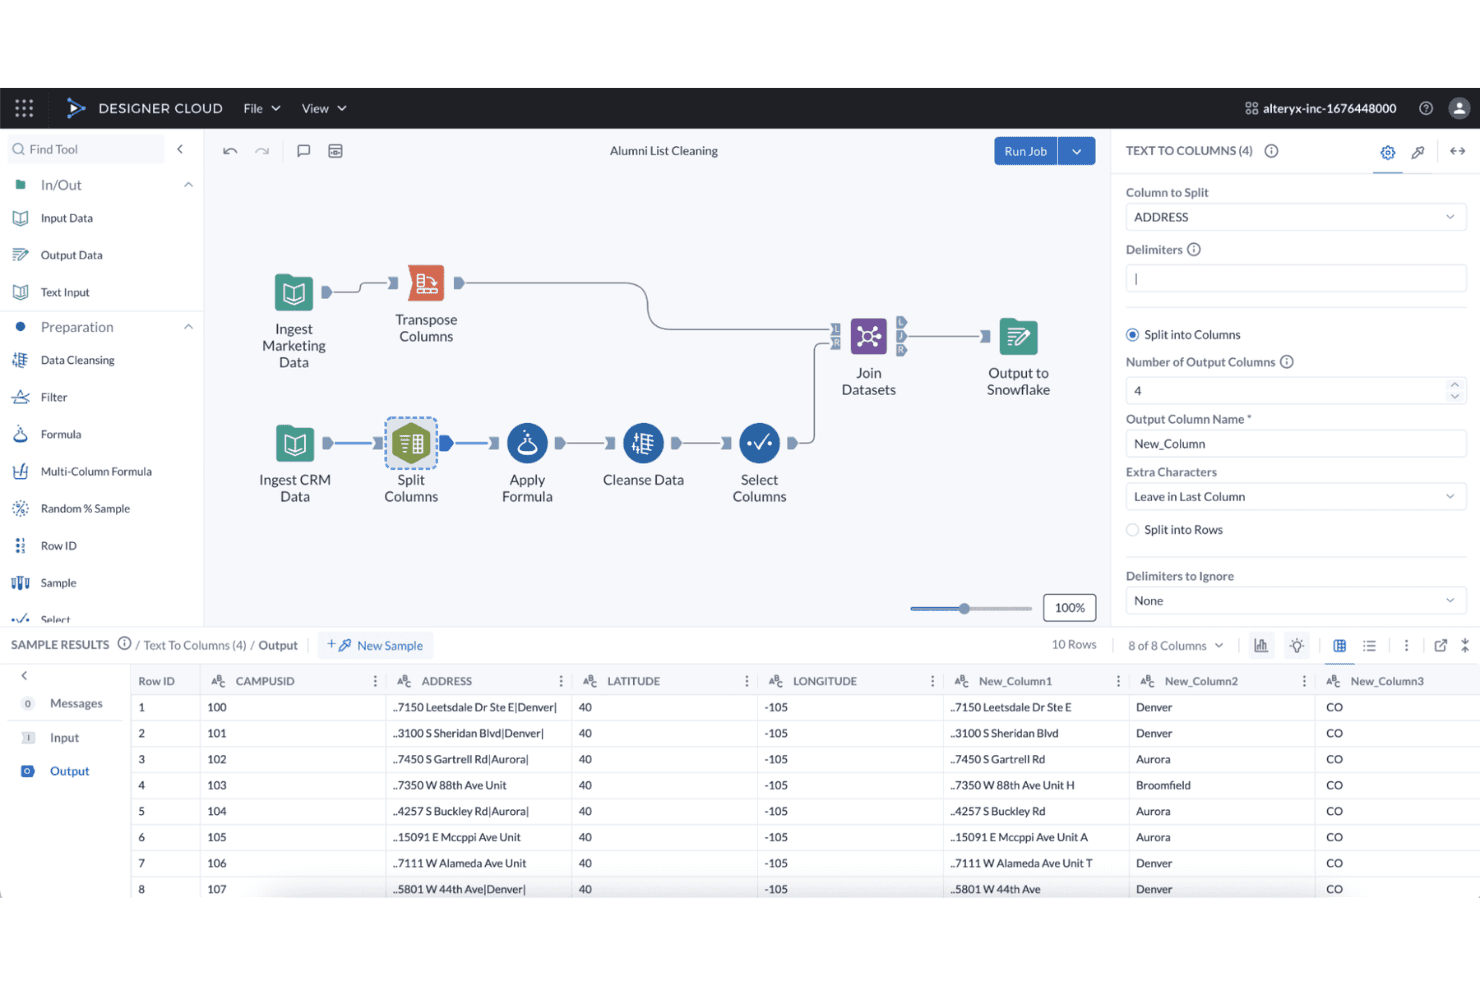
Alteryx Designer Cloud -työnkulku, jossa osoitekentät jaetaan erillisiksi sarakkeiksi alumnidatan puhdistuksen aikana. Alteryx on vähäkoodinen analytiikka-alusta, jonka avulla data- ja analytiikkatiimit voivat puhdistaa, yhdistellä ja automatisoida datatyönkulkuja ilman SQL:n kirjoittamista. Se on käytännöllinen vaihtoehto organisaatioille, jotka haluavat muuntaa ja orkestroida tietoputkia yli 100 lähteestä ilman koodikeskeistä työkaluketjua.
Kenelle Alteryx sopii parhaiten?
Alteryx sopii erinomaisesti analytiikkatiimeille ja BI-johtajille, joiden on yhdisteltävä, puhdistettava ja automatisoitava datatyönkulkuja monista lähteistä ilman SQL:n kirjoittamista.
Miksi valitsin Alteryxin
Valitsin Alteryxin yhdeksi parhaista vaihtoehdoista, koska sen avulla analytiikkatiimit voivat korvata manuaaliset SQL-putket vedä ja pudota -työnkuluilla, jotka puhdistavat, yhdistävät ja liittävät dataa yli 100 lähteestä ilman koodausta. Pidän erityisesti siitä, miten visuaalisen työnkulkupohjan avulla on helppo tarkastella dataa jokaisessa muunnosvaiheessa, mikä nopeuttaa virheenkorjausta tavoilla, joihin pelkkä SQL-komentosarja ei pysty. Enterprise-tason ajastus ja ohjelmointirajapinnan käynnistämä automaatio tarkoittavat, että voin suorittaa nämä työnkulut automaattisesti määritetyin väliajoin.
Alteryxin tärkeimmät ominaisuudet
- Rakenteen validointi: Tarkistaa lähteiden rakenteet työn suorittamisen alussa ja voi pysäyttää työnkulun, jos nykyinen rakenne poikkeaa tallennetusta versiosta.
- OpenLineage-tapahtumien lähetys: Lähettää työnkulkujen suoritusten alkuperätapahtumia, mukaan lukien saraketason suhteiden metatiedot, ulkoisiin luettelotyökaluihin, kuten Collibraan ja Atlaniin.
- Python-työkalu scikit-learnilla ja pandasilla: Tarjoaa sisäänrakennetun Python-ympäristön, jossa on kuratoitu pakettivalikoima ennakoivan logiikan ohjelmointiin suoraan työnkulun sisällä.
- Roolipohjaiset käyttöoikeudet: Antaa järjestelmänvalvojien luoda mukautettuja rooleja, joilla on yksityiskohtaiset sovellustason käyttöoikeudet yksittäisille käyttäjille tai käyttäjäryhmille työtiloissa.
Alteryxin integraatiot
Alteryx tarjoaa yli 100 natiivista integraatiota, mukaan lukien Snowflake, Google BigQuery, Databricks, Amazon Redshift, Microsoft Azure Synapse Analytics, Tableau ja Qlik Cloud. Se tarjoaa myös ohjelmointirajapinnan mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Tarkasteltavat visuaaliset työnkulut helpottavat virheenkorjausta
- Automatisoi toistuvan valmistelun ja raportoinnin
- Ehdolliset suunnitelmat koordinoivat toisistaan riippuvia työnkulkuja
Cons:
- Ei uudelleenkäytettävää dbt-tyylistä SQL-mallinnuskehystä
- Git-työnkulut perustuvat ulkoisiin työkaluihin
Learn more about Alteryx: Paras laajan liitinkirjaston tuen ansiosta
- Ei saatavilla
- Hinta pyydettäessä
Visit WebsiteCustomer Rating:4.3/5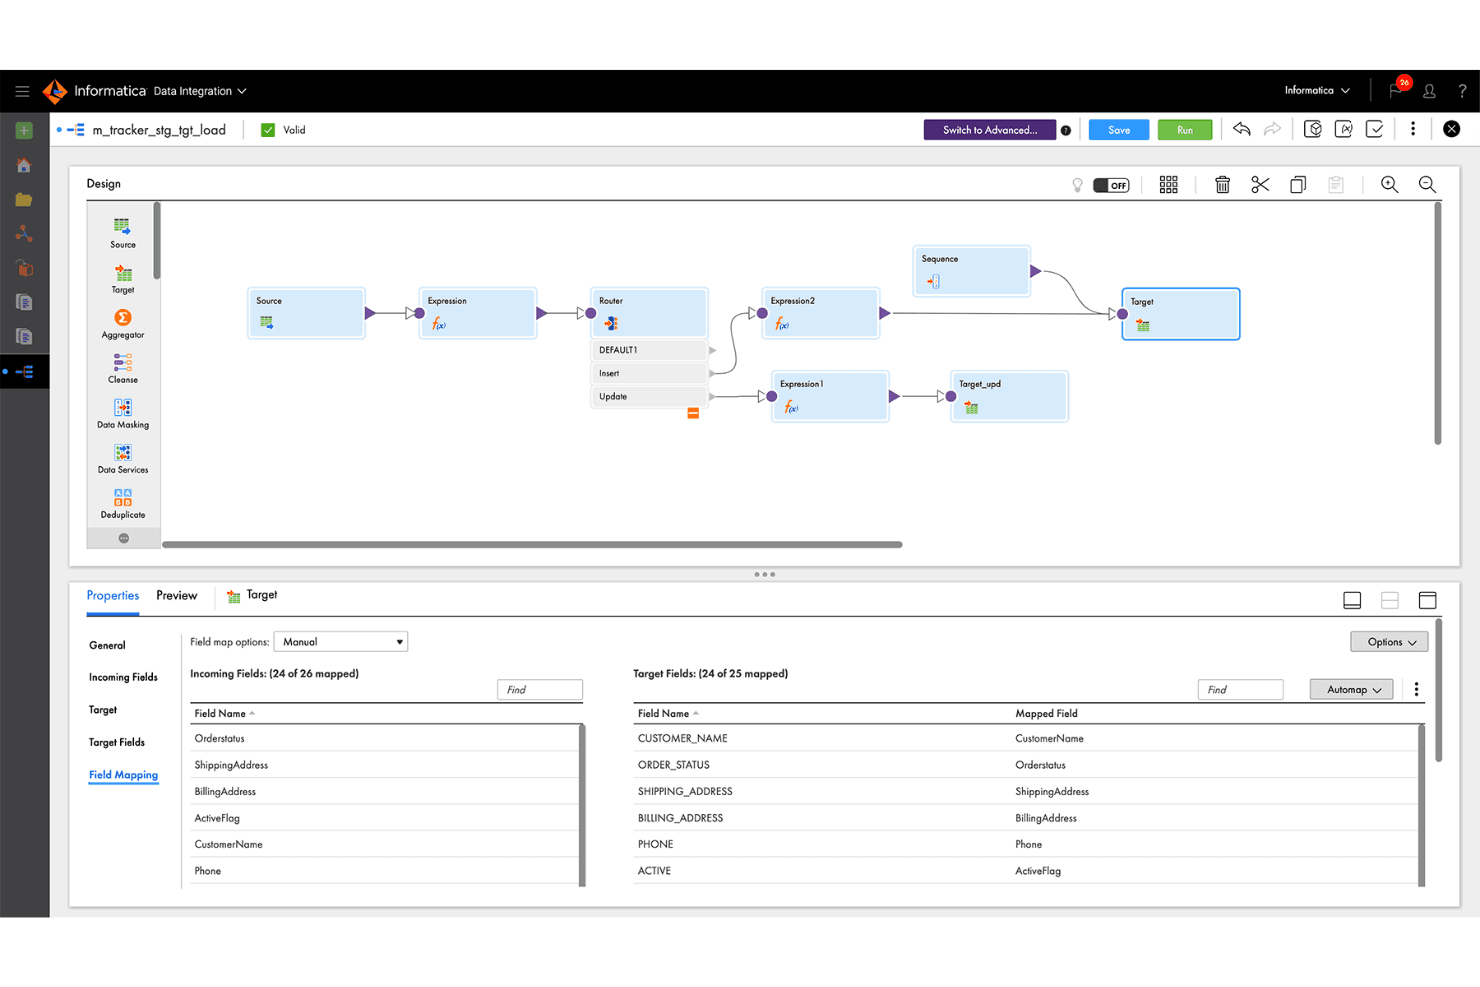
Informatica Data Integration -kuvauspohja, jossa näkyvät lähde-, reititin-, lauseke- ja kohdemuunnokset tietojen latauksen työnkulussa. Informatica Data Integration on pilvipohjainen tietoputkialusta, joka on suunniteltu data-analytiikan insinööreille, joiden on yhdistettävä, siirrettävä ja automatisoitava tietoja useista eri lähteistä ja kohteista ilman, että jokaista integraatiota tarvitsee rakentaa alusta alkaen.
Kenelle Informatica sopii parhaiten?
Informatica Data Integration sopii hyvin data-analytiikan insinööritiimeille, joiden on yhdistettävä suuri määrä erilaisia lähteitä ja kohteita ilman mukautettujen liittimien rakentamista alusta alkaen.
Miksi valitsin Informatican
Valitsin Informatican yhdeksi parhaista dbt-vaihtoehdoista, koska sen liitinkirjasto on aidosti omaa luokkaansa. Satojen koodittomien liittimien ansiosta, jotka kattavat pilvipohjaiset tietovarastot, paikalliset tietokannat ja ERP-alustat, voin yhdistää lähes minkä tahansa lähde-kohde-yhdistelmän ilman mukautetun integraatiokoodin kirjoittamista. Sen ETL-, ELT-, CDC- ja replikointimallit tarkoittavat, että tiimini voi viedä tiedot Snowflakeen, Databricksiin tai datajärvitaloon käyttäen putkeen parhaiten sopivaa siirtomallia, ja CLAIRE Copilot hoitaa putkien luonnin sekä ajonaikaisten lokien vianmäärityksen vähentäen manuaalisen virheenkorjauksen tarvetta.
Informatican tärkeimmät ominaisuudet
- Tietojen validointi: Vertaa replikoituja kohdetauluja lähdetauluihin tarkistaakseen tietojen tarkkuuden ja täydellisyyden käsittelyn jälkeen.
- Python-muunnokset: Mahdollistaa Python-komentosarjojen kirjoittamisen ja suorittamisen CDI-Elastic-kuvauksissa tilastollisia, koneoppimiseen ja luonnollisen kielen käsittelyyn liittyviä tehtäviä varten.
- Tehtäväkulkujen orkestrointi: Tukee yksinkertaisten ja monimutkaisten tehtäväkulkujen suunnittelua sekä työkuormien suoritusten ajoitusta ja REST-kutsuja.
- Git-pohjainen versionhallinta: Yhdistää IDMC-projektit ja resurssit Git-arkistoon, jotta tiimisi voi seurata ja hallita putkien muutoksia ajan mittaan.
Informatican integraatiot
Informatica dokumentoi satoja koodittomia liittimiä, mutta saatavuus vaihtelee palvelun, version ja liitintason mukaan. REST-sovellusliittymä tukee mukautettuja integraatioita.
Pros and Cons
Pros:
- Ajoitetut työnkulut vähentävät manuaalista putkityötä
- Tekoälyavusteiset lokit auttavat diagnosoimaan virheitä
- Kuvaukset tukevat tietojen puhdistusta ja validointia
Cons:
- Monimutkaiset SQL-muunnokset voivat epäonnistua
- Git-työnkulusta puuttuvat yhdistäminen ja haarautuminen
Learn more about Informatica: Paras palvelimettomaan ETL-automaatioon
- Maksuton palvelupaketti saatavilla
- Alkaen $0.29/DPU-hour
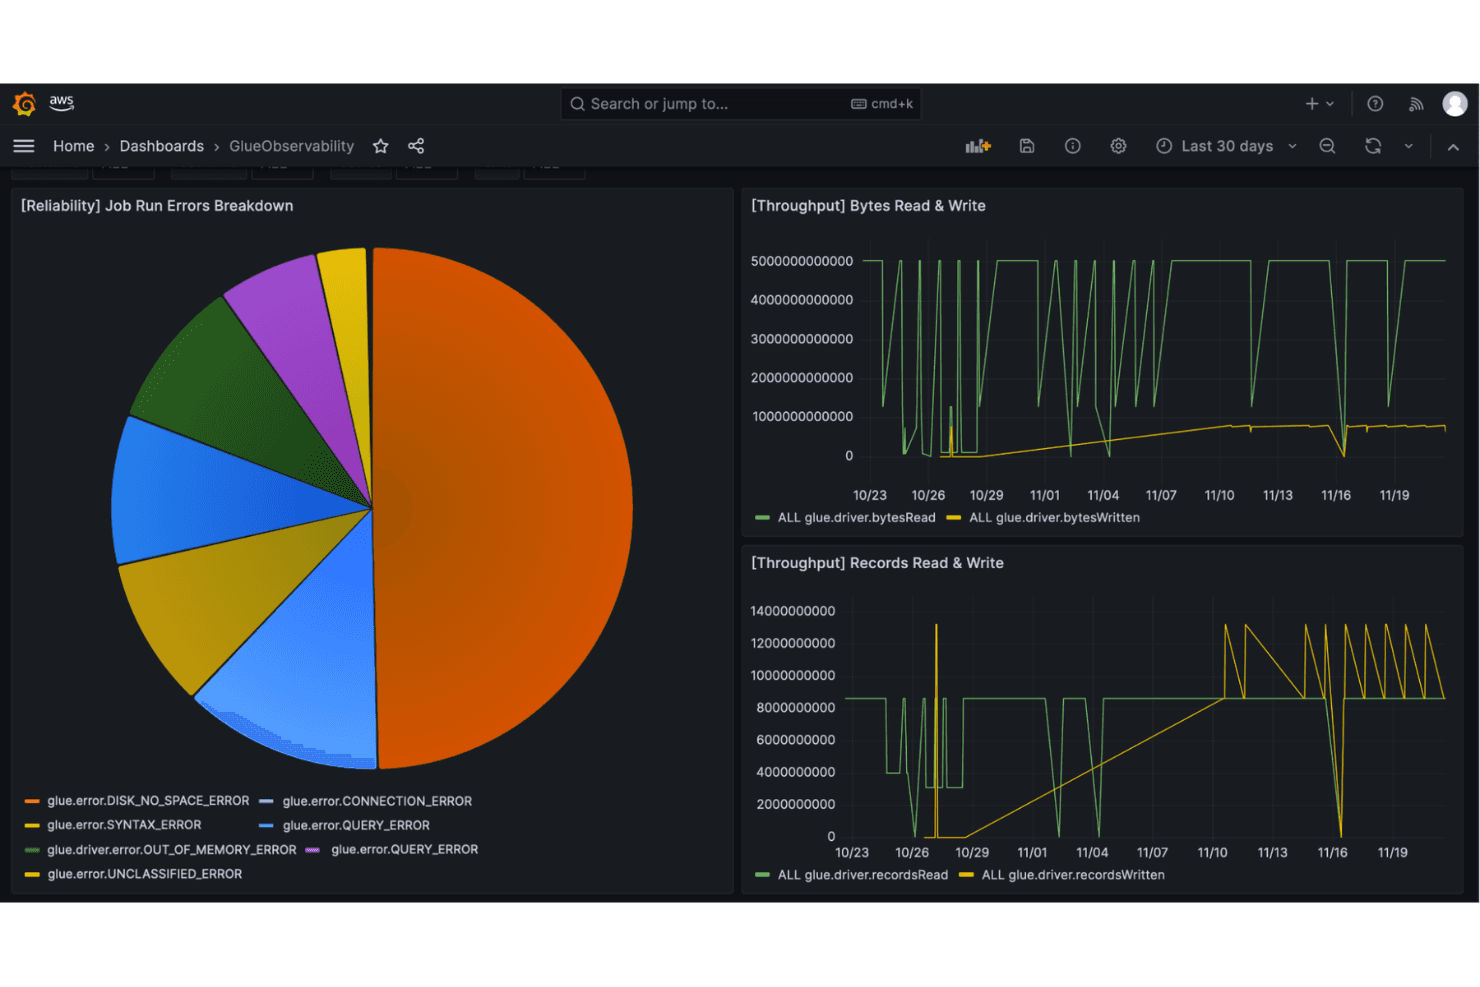
AWS Gluen töiden havainnointikoontinäyttö, joka näyttää suoritusten virhetyyppien jakauman sekä luku- ja kirjoitusnopeudet 30 päivän ajalta. AWS Glue on Amazonin palvelimeton tietojen integrointipalvelu, joka vetoaa AWS-ekosysteemiin jo integroituneisiin data-insinööreihin, jotka tarvitsevat ETL-putkien automatisointia, monimutkaisten työnkulkujen orkestrointia ja yhteyksiä monenlaisiin tietolähteisiin ilman infrastruktuurin hallintaa.
Kenelle AWS Glue sopii parhaiten?
AWS Glue sopii hyvin data-tekniikkatiimeille, jotka suorittavat jo työkuormia AWS:ssä ja tarvitsevat palvelimetonta ETL-automaatiota ilman Spark-infrastruktuurin hallintaa.
Miksi valitsin AWS Gluen
Sisällytin AWS Gluen parhaiden vaihtoehtojeni joukkoon, koska se on vahvin palvelimeton ETL-vaihtoehto data-tekniikkatiimeille, jotka suorittavat jo työkuormia AWS:ssä. Pidän siitä, että Gluen työnkulkujen avulla voi koordinoida töitä, indeksointitoimintoja ja laukaisimia ajastetulla, tapahtuma- tai tarvittaessa käynnistettävällä suorituksella, joten toistuvien putkien automatisointi vaatii lähes olematonta infrastruktuurin valvontaa. AWS Glue Studion visuaalinen ETL-tekijä luo Spark-koodin automaattisesti, ja nolla-ETL-integraatiot siirtävät tietoja esimerkiksi DynamoDB:stä tai Salesforcesta suoraan Redshiftiin ilman mukautettua putkikoodia.
AWS Gluen tärkeimmät ominaisuudet
- Git-pohjainen versionhallinta: Synkronoi visuaaliset työt ja komentosarjatyöt GitHubin, GitLabin, Bitbucketin ja AWS CodeCommitin kanssa haarapohjaisia pull- ja push-työnkulkuja käyttäen.
- Gluen tietojen laatua koskevat säännöt: Soveltaa yli 25 DQDL-säännön kirjastoa tietojoukoissa ja putkien sisäisissä tarkistuksissa sekä tarjoaa mahdollisuuden pysäyttää putki, kun laatukynnykset ylittyvät.
- Amazon Q -tietojen integrointi: Luo mukautettavaa Apache Spark -ETL-koodia muunnosvaatimusten luonnollisen kielen kuvausten perusteella.
- Tietoluettelo indeksointitoiminnoilla: Tunnistaa lähdejärjestelmien skeemat automaattisesti ja tallentaa taulukoiden määritykset, töiden määritykset ja skeemaversioiden historian yhdistetyistä tietolähteistä.
AWS Gluen integraatiot
AWS Glue tarjoaa natiivin integraation Amazon S3:n, Amazon Redshiftin, Snowflaken, Google BigQueryn, GitHubin, GitLabin, Bitbucketin ja AWS CodeCommitin kanssa sekä yli 100 dokumentoitua tietolähdettä. Se tukee myös Marketplace-liittimiä ja mukautettuja integraatioita varten tarkoitettua AWS Glue Web APIa.
Pros and Cons
Pros:
- Automatisoi töiden, indeksointitoimintojen ja laukaisimien riippuvuudet
- Havaitsee tietojen heikon laadun putkien sisällä
- Tunnistaa skeemat ja luetteloi tietojoukot automaattisesti
Cons:
- Spark SQL:stä puuttuu dbt-tyylinen modulaarinen mallinnus
- Git ei kata muistikirjoja ja edellyttää toistuvaa käyttöönottoa
Learn more about AWS Glue: Sopii parhaiten yritystason työkuormien skaalautuvuuteen
- 30 päivän ilmainen kokeilu + demo saatavilla
- Hinta pyydettäessä
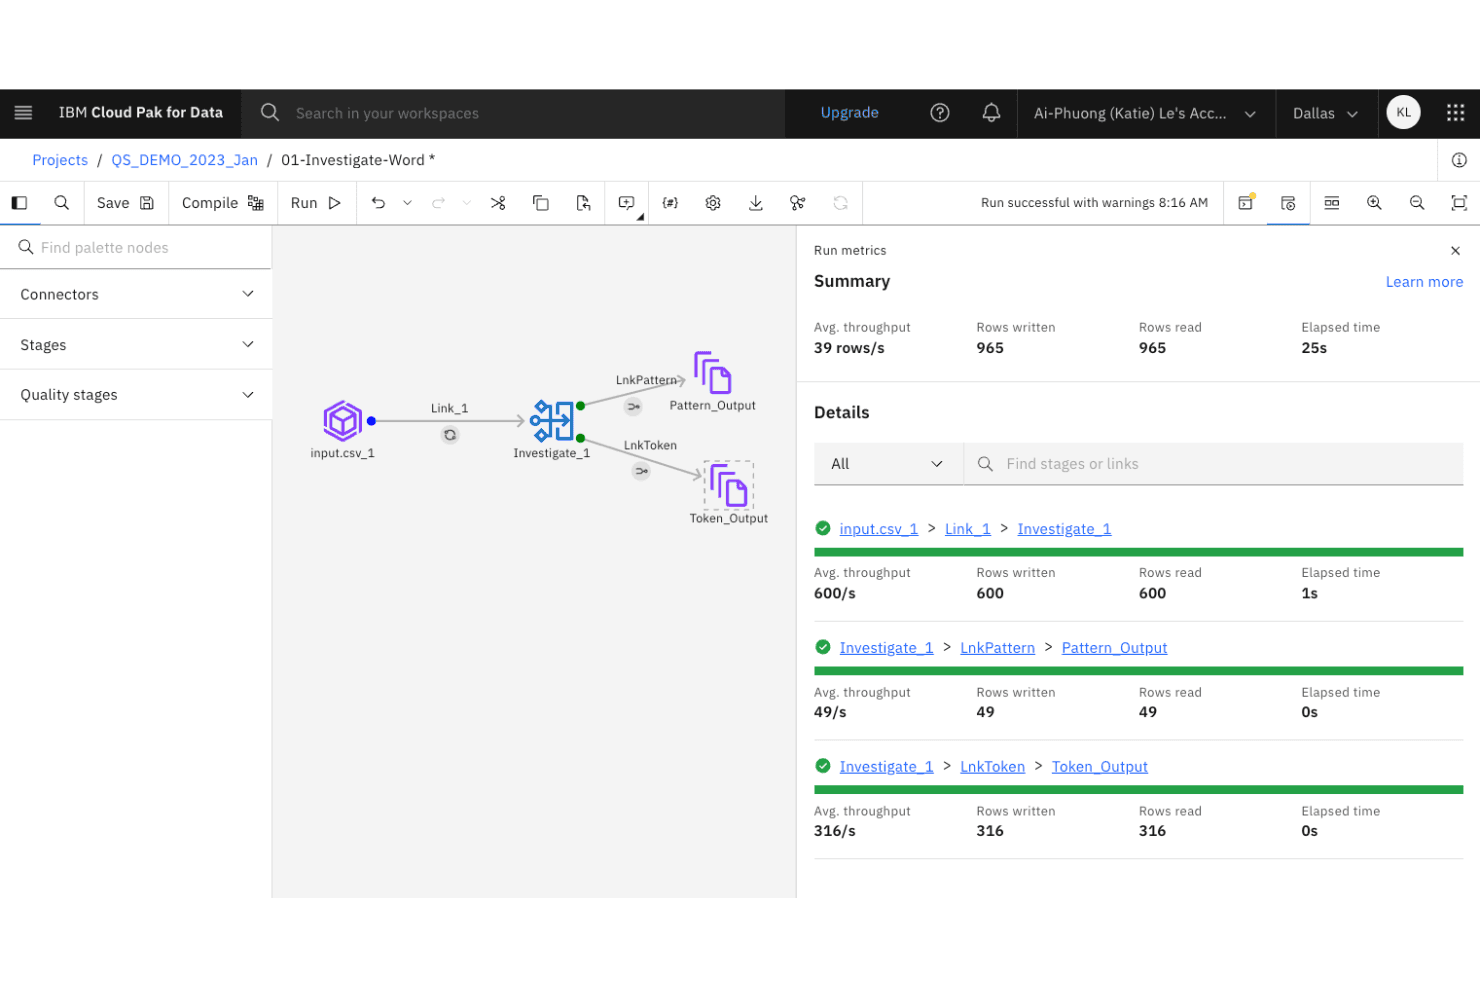
IBM DataStagen työkanvas, jossa on Tutki-vaihe ja suoritusmittareita, jotka näyttävät luettujen ja kirjoitettujen rivien määrät. IBM watsonx.data integration (aiemmin IBM DataStage) on yritystason dataintegraatioalusta data-insinööreille, joiden on siirrettävä, muunnettava ja valmisteltava rakenteista ja rakenteistamatonta dataa eräajo-, suoratoisto- ja replikointiputkissa hybridi- ja monipilviympäristöissä.
Kenelle IBM DataStage sopii parhaiten?
IBM watsonx.data integration sopii suurille yrityksille, jotka suorittavat suuren volyymin ETL/ELT-kuormia hybridi- ja monipilviympäristöissä ja tarvitsevat hyväksi todetun, skaalautuvan putkialustan.
Miksi valitsin IBM DataStagen
Valitsin IBM DataStagen yhdeksi parhaista vaihtoehdoista, koska sen rinnakkaiskäsittelymoottori jakaa suuret eräkuormat samanaikaisesti suoritettaviksi toiminnoiksi. Näin data-insinööritiimit voivat käsitellä yritystason ETL/ELT-volyymeja ilman putkien uudelleensuunnittelua datamäärien kasvaessa. Arvostan myös OpenShift Horizontal Pod Autoscalerin tarjoamaa automaattista skaalausta, jonka ansiosta kapasiteetti mukautuu työkuorman tarpeeseen eikä huippukäsittelyjaksojen aikana tarvita manuaalisia toimenpiteitä. Etämoottoriarkkitehtuuri erottaa suunnittelun ohjaustason suorittamisesta, joten putket suoritetaan siellä, missä data tosiasiassa sijaitsee hybridi- ja monipilviympäristöissä.
IBM DataStagen tärkeimmät ominaisuudet
- Yhtenäinen Python SDK: Luo, hallitse ja suorita sekä eräajo- että reaaliaikaisia suoratoistoputkia Pythonilla Git-versioinnin ja CI/CD-automaation tuella.
- Datan havainnointihälytykset: Määritä kynnysarvoihin perustuvia hälytyksiä työn kestolle, työn tilalle ja putkimittareille, kuten luettujen ja kirjoitettujen rivien määrälle, ja ohjaa ne Slackiin tai PagerDutyyn.
- Rakenteistamattoman datan käsittely: Tuo ja muunna rakenteistamattomia tiedostoja vedä ja pudota -operaattoreilla tekstin poimintaa, henkilötietojen poistamista, pilkkomista ja upotusten luomista varten.
- Projektien siirto ympäristöjen välillä: Siirrä putkiresursseja kehitys-, testaus- ja tuotantoprojektien välillä käyttämällä
cpdctl- taidsjob-komentoliittymää.
IBM DataStagen integraatiot
IBM DataStage tarjoaa dokumentoidut yhteydet Amazon Redshiftiin, Google BigQueryyn, Snowflakeen, IBM watsonx.data Prestoon, Confluent Platformin Apache Flinkiin, LangChainiin ja Milvukseen. Se tarjoaa myös rajapintoja ja Python SDK:n mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Arvioijat kiittävät rinnakkaiskäsittelyn skaalautuvuutta
- Visuaalinen ETL kattaa eräajot ja suoratoiston
- Python-putket tukevat Git-pohjaista siirtoa
Cons:
- Ei SQL-natiivista mallinnusta dbt-työnkulkuihin
- Arvioijien mukaan omistusoikeudellisen logiikan siirtäminen on vaikeaa
Learn more about IBM DataStage: Paras vähäkoodiseen putkien rakentamiseen
- 14 päivän maksuton kokeilu + demo saatavilla
- Hinnoittelu pyynnöstä
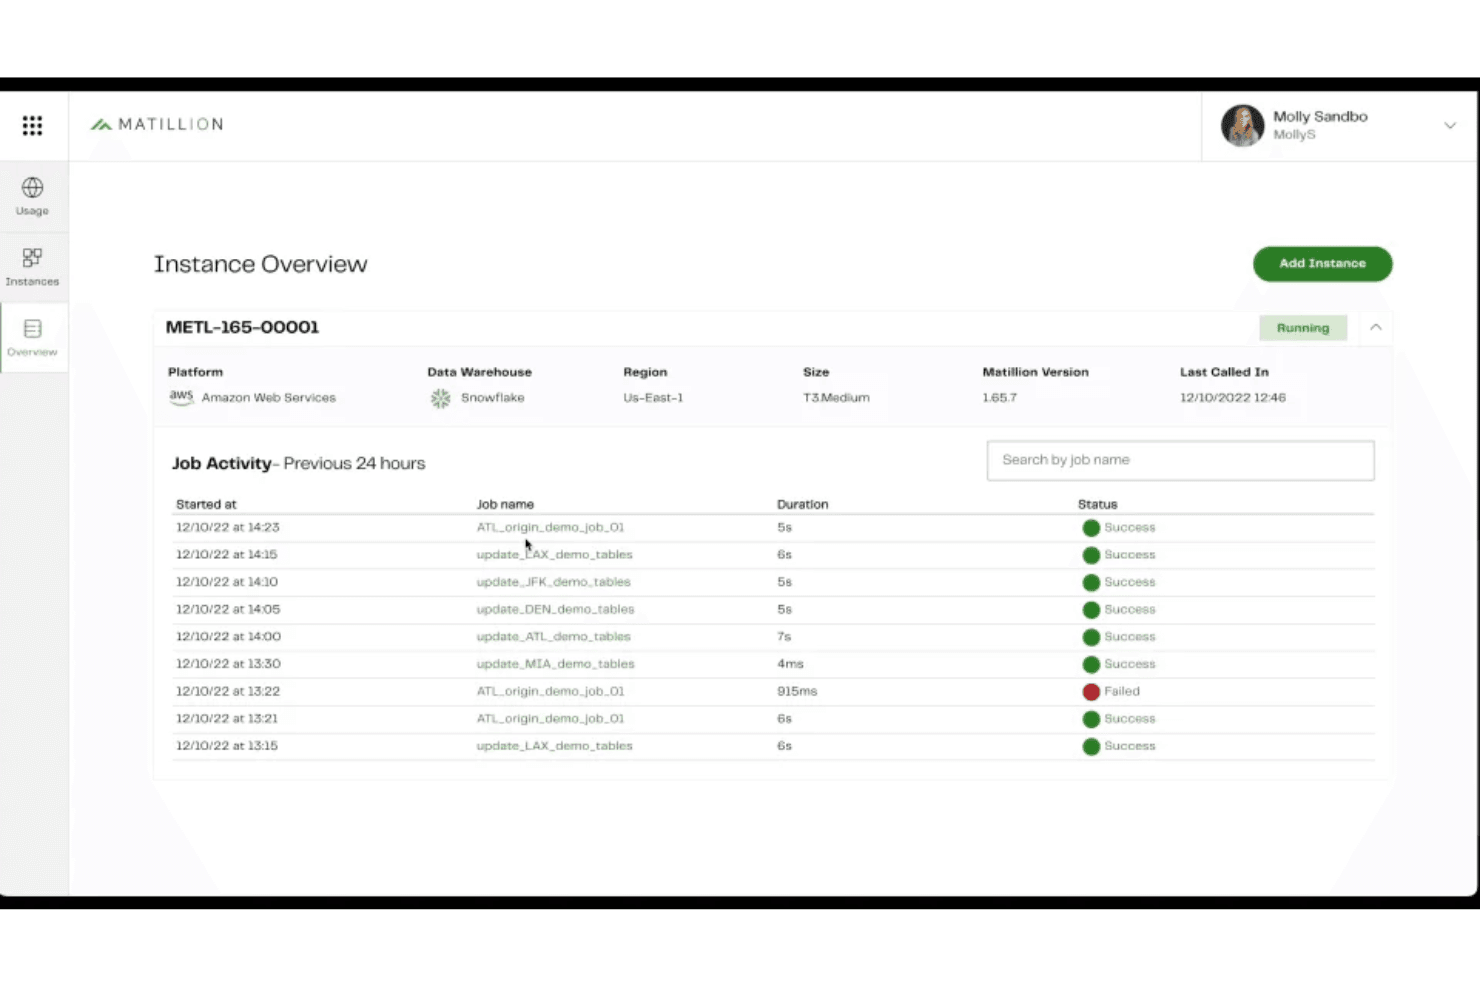
Matillionin instanssin yleiskatsaus seuraa käynnissä olevia instansseja ja viimeaikaista työaktiivisuutta sekä näyttää kunkin putkiajon tilan. Matillion ETL on pilvipohjainen tietojen integrointialusta, jonka avulla data- ja analytiikkatiimit voivat ladata, muuntaa ja orkestroida putkia visuaalisen vedä ja pudota -käyttöliittymän sekä SQL:n ja Pythonin avulla. Se sopii erityisen hyvin tiimeille, joiden mielestä dbt:n koodikeskeinen lähestymistapa on liian jyrkkä oppimiskäyrä.
Kenelle Matillion sopii parhaiten?
Matillion ETL sopii erinomaisesti BI- ja analytiikkatiimeille, jotka haluavat rakentaa ja automatisoida tietoputkia kirjoittamatta kaikkea koodia alusta alkaen.
Miksi valitsin Matillionin
Valitsin Matillionin yhdeksi parhaista dbt-vaihtoehdoista, koska sen visuaalisen vedä ja pudota -putkirakentajan avulla BI- ja analytiikkatiimit voivat rakentaa muunnoslogiikkaa kirjoittamatta SQL:ää alusta alkaen. Pidän erityisesti siitä, että voit rakentaa kokonaisen ELT-työn push-down-komponenttien avulla suoraan Snowflakea, Redshiftia tai BigQuerya vasten ja lisätä tarvittaessa dbt Coren komentovaiheen mallikerroksen logiikkaa varten. Visuaalinen työalusta luo myös dokumentaation automaattisesti, mikä poistaa yhden vaiheen, jonka koodikeskeiset tiimit usein ohittavat.
Matillion ETL:n tärkeimmät ominaisuudet
- Push-down-SQL-muunnokset: Suorittaa muunnoslogiikan suoraan pilvidata-alustallasi — Snowflakessa, Redshiftissä, BigQueryssa tai Azure Synapsessa — sen sijaan, että data siirrettäisiin käsiteltäväksi muualle.
- Sisäänrakennettu ajastin: Automatisoi orkestrointityöt ennalta määritetyin väliajoin. Jokaiselle ajastukselle voidaan määrittää erikseen projektiversio, ympäristö ja aikavyöhyke.
- Reverse ETL -tulostuskomponentit: Siirtää muunnetut tietovarastossa olevat tiedot takaisin operatiivisiin järjestelmiin, kuten Salesforceen, Intercomiin ja Oracleen, natiivien tulostusliitinkomponenttien avulla.
- REST API: Tarjoaa v1-rajapinnan, joka tukee GET-, POST- ja DELETE-toimintoja, joten voit käynnistää ja hallita töitä ohjelmallisesti ulkoisista työkaluista tai komentosarjoista.
Matillion-integraatiot
Matillion tarjoaa yli 80 valmista liitintä, mukaan lukien Snowflake, Databricks, Amazon Redshift, Google BigQuery, Azure Synapse, Salesforce, Intercom ja Oracle. Se tukee GitHub-, AWS CodeCommit- ja Bitbucket-tietovarastoja sekä REST APIa mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Visuaaliset työt helpottavat muunnosten tarkastelua
- Pushdown-käsittely pitää työn tietovarastossa
- Yhdellä työalustalla yhdistyvät lataaminen ja orkestrointi
Cons:
- Git-työnkulkujen CI/CD-promootio on puutteellisesti dokumentoitu
- Tietojen tarkistukset edellyttävät käyttäjän rakentamaa logiikkaa
Learn more about Matillion: Parhaimmillaan dynaamisissa tietojen validointisäännöissä
- Ilmainen esittely saatavilla
- Hinnoittelu pyynnöstä
Visit WebsiteCustomer Rating:4.9/5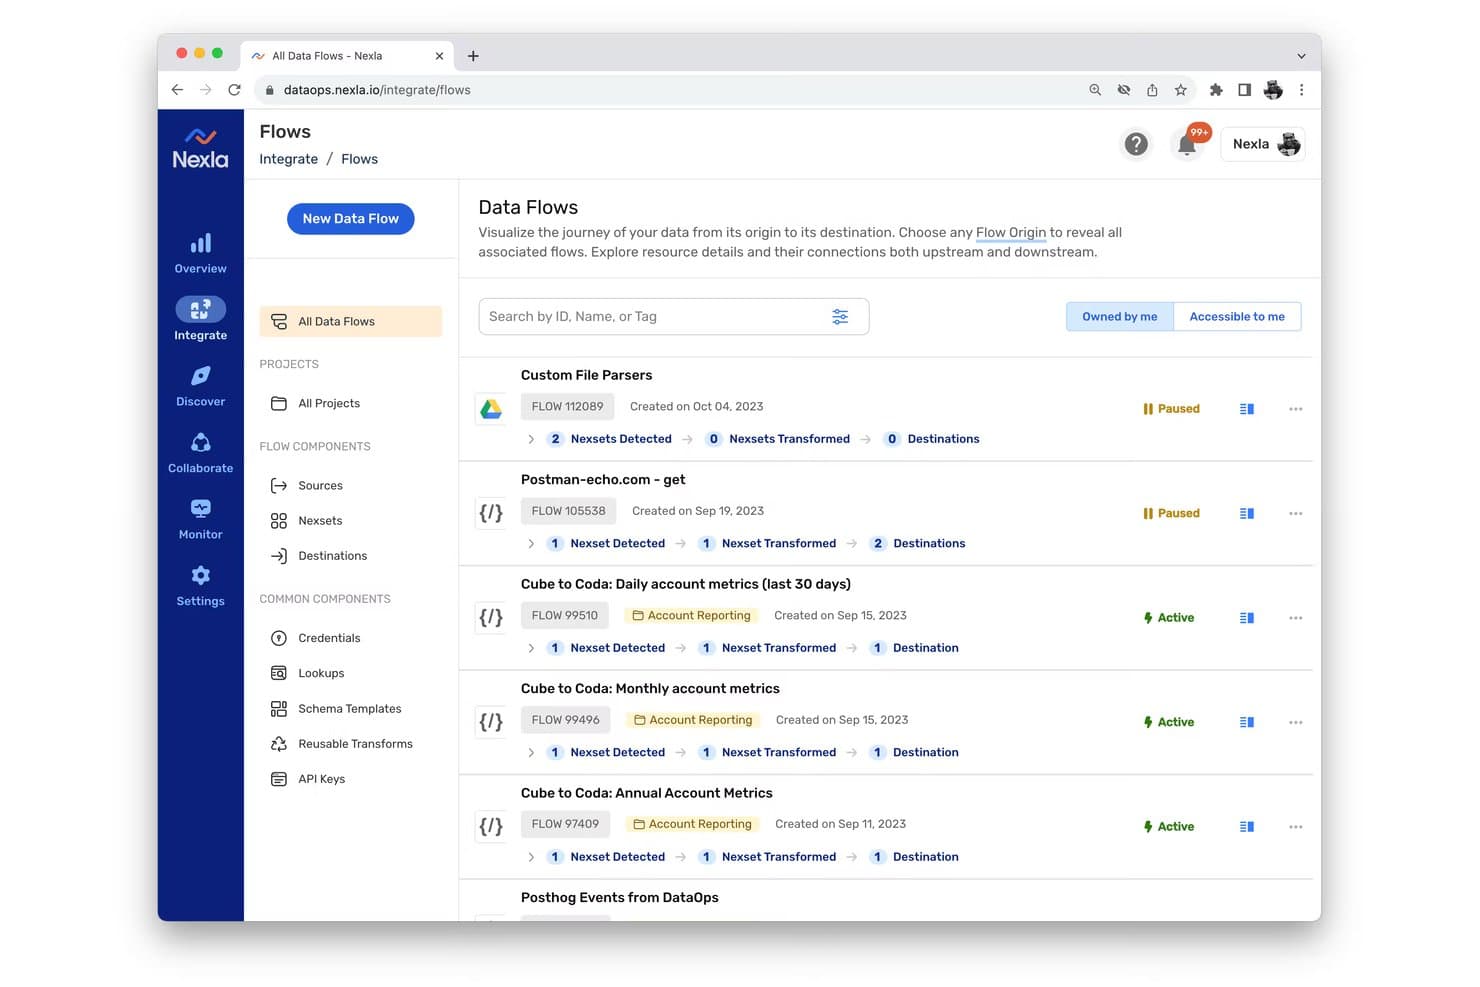
Nexlan uudistetussa Integroi-osiossa luetellaan tietovirrat sekä niiden tila, lähteet, muunnokset ja määränpäät. Nexla on data-integraatioalusta, joka on suunniteltu data-asiantuntijoille, joiden on yhdistettävä, muunnettava ja hallittava tietoja useista eri lähteistä. Se käsittelee ETL-, CDC-, suoratoisto- ja API-putkia sekä soveltaa tietojen validointia ja alkuperän seurantaa ennen kuin tiedot koskaan saavuttavat määränpäänsä.
Kenelle Nexla sopii parhaiten?
Nexla sopii erinomaisesti suuryritysten data-asiantuntijoille, jotka hallinnoivat monimutkaisia, useista lähteistä koostuvia putkia ja joiden on validoitava, hallittava ja toimitettava tiedot ennen niiden siirtymistä jatkokäsittelyjärjestelmiin.
Miksi valitsin Nexlan
Sisällytin Nexlan kärkivalintoihini, koska sen dynaamiset tietojen validointisäännöt antavat data-asiantuntijoille paremman hallinnan saapuviin tietoihin kuin useimmat putkityökalut tarjoavat. Voit määrittää tietuekohtaisia sääntöjä, joilla tarkistetaan kenttien olemassaolo, säännölliset lausekkeet, tietotyypit ja sallitut arvot. Kun skeeman muutoksia tapahtuu putken aikana, Nexla havaitsee ne automaattisesti ja reitittää ongelmalliset tietueet virheiden karanteeniin, joka sisältää täydelliset diagnostiikkatiedot. Pidän erityisesti siitä, että validointi suoritetaan ennen tietojen päätymistä määränpäähän, joten virheelliset tietueet eivät pääse huomaamatta turmelemaan jatkokäsittelyn tietoaineistoja.
Nexlan tärkeimmät ominaisuudet
- Koodittomat tietojen valmistelutoiminnot: Excelin kaltainen funktiokirjasto mahdollistaa tietueiden suodattamisen, yhdistämisen, liittämisen ja muotoilun ilman mukautetun koodin kirjoittamista.
- Automaattinen virheiden karanteeni: Epäonnistuneet tietueet eristetään automaattisesti, ja jokaisesta tietueesta tarjotaan täydelliset diagnostiikkatiedot, joten voit tarkastella ja ratkaista ongelmia ilman lokien manuaalista läpikäyntiä.
- Komentorivipohjainen työnkulkujen tuonti ja vienti: Työnkulkujen määritykset voidaan viedä JSON-muotoon ja tuoda erillisiin tileihin tai ympäristöihin, mikä tukee siirtoja, versiointia ja kehityksestä tuotantoon siirtämistä.
- Mukautetut Python- ja JavaScript-muunnokset: Täydellisen IDE-ympäristön ja testikehyksen avulla voit kirjoittaa, testata ja jakaa uudelleenkäytettävää mukautettua muunnoslogiikkaa, joka laajentaa koodittomien toimintojen mahdollisuuksia.
Nexlan integraatiot
Nexla tarjoaa yli 1 000 alkuperäistä liitintä, mukaan lukien dbt, Snowflake, Google BigQuery, Databricks, Amazon Redshift ja Teradata. Se tarjoaa myös REST-, SOAP-, Data-, Sync- ja Admin-rajapinnat mukautettuja integraatioita varten.
Pros and Cons
Pros:
- Tietuekohtaiset säännöt havaitsevat skeeman muutokset varhaisessa vaiheessa
- Arvostelijat kehuvat putkiongelmista ilmoittavia hälytyksiä
- Koodittomat muunnokset toimivat yhdessä uudelleenkäytettävien komentosarjojen kanssa
Cons:
- Ei uudelleenkäytettävää SQL-mallinnuskehystä
- Ei alkuperäistä Git-haarautumista tai CI/CD-tukea
Learn more about Nexla: Sopii parhaiten yhteistyöhön perustuvaan muistikirja-analytiikkaan
- Kahden viikon ilmainen kokeilu + ilmainen esittely saatavilla
- Hinnoittelu pyynnöstä
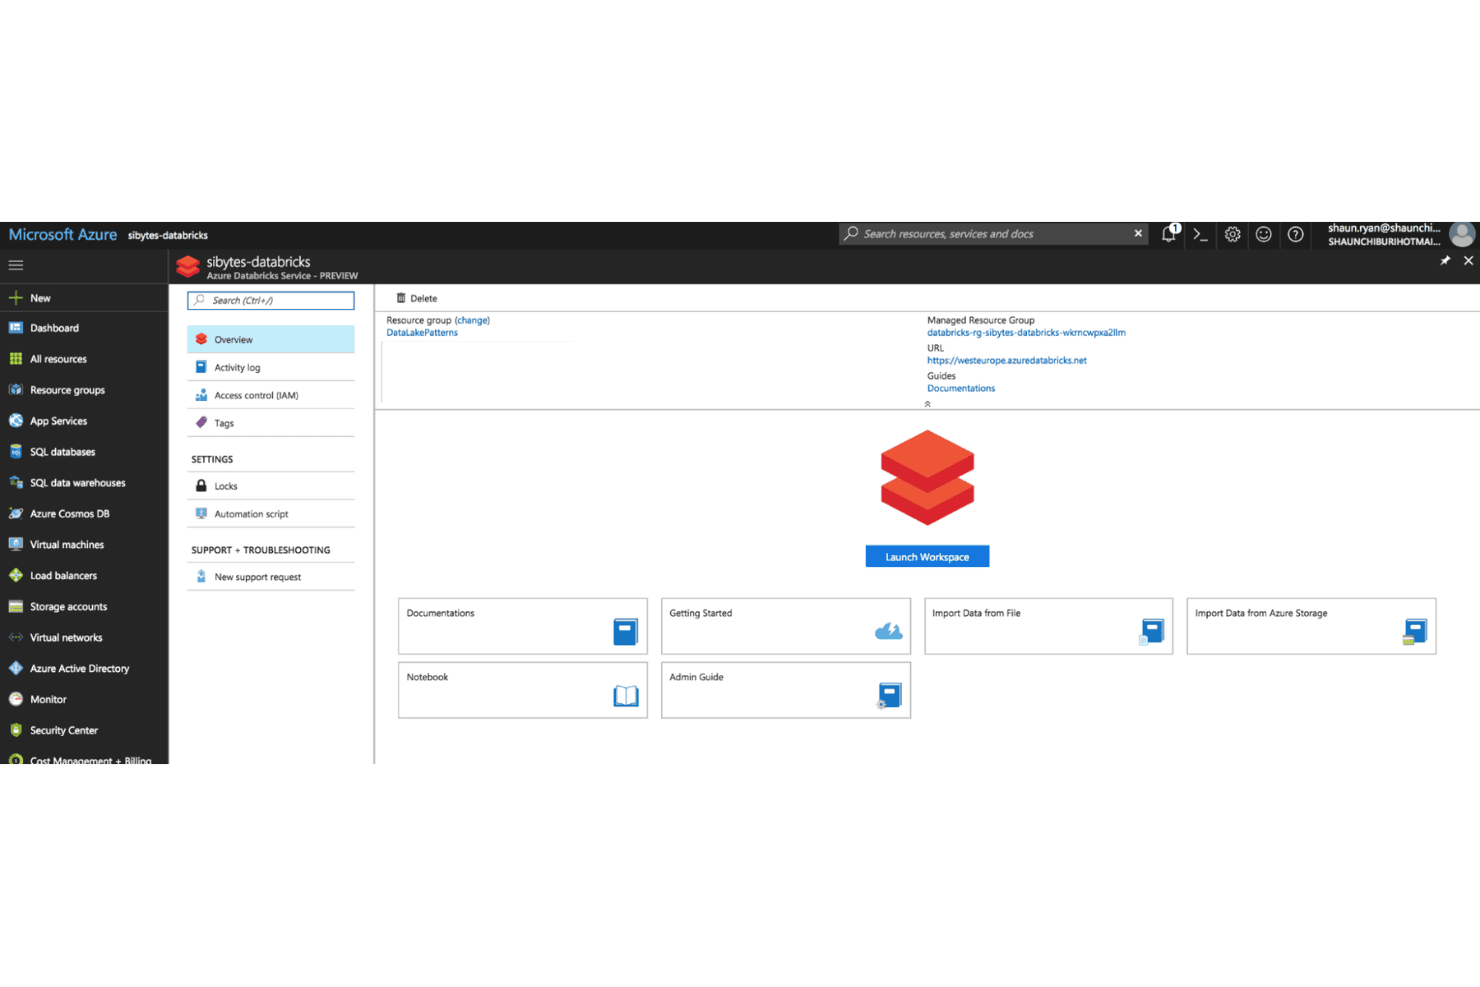
Azure Databricks -palvelun yleisnäkymä Azure-portaalissa; Käynnistä työtila -painikkeella työtila avataan. Azure Databricks on Databricksin ja Microsoftin yhdessä kehittämä lakehouse-alusta, joka yhdistää tietotekniikan, SQL-muunnokset ja yhteistyöhön perustuvan muistikirja-analytiikan yhteen Azure-natiiviseen ympäristöön.
Kenelle Azure Databricks sopii parhaiten?
Azure Databricks sopii erinomaisesti tietotekniikkatiimeille, jotka toimivat jo Microsoft Azure -ekosysteemissä ja tarvitsevat SQL-, Python- ja visuaalisia työnkulkuja yhdellä lakehouse-alustalla.
Miksi valitsin Azure Databricksin
Otin Azure Databricksin mukaan parhaiden vaihtoehtojeni joukkoon, koska sen yhteistyöhön perustuvassa muistikirjaympäristössä tietotekniikan ammattilaiset ja analyytikot voivat työskennellä SQL:llä, Pythonilla tai visuaalisella piirtoalustalla poistumatta alustalta. Pidän erityisesti Lakeflow Designerista, joka luo vedä ja pudota -muunnoksista Git-versionhallittavaa koodia, joten putkistologiikka pysyy tarkastettavana ja ajoitettavana heti alusta alkaen. Unity Catalog yhdistää kokonaisuuden tallentamalla automaattisesti saraketasoiset tietovirrat jokaisesta tiimisi suorittamasta kyselystä.
Azure Databricksin tärkeimmät ominaisuudet
- Putkistojen laatukriteerit: Määritä suoratoistotauluille ja materialisoiduille näkymille SQL-totuusarvorajoitteita, joiden avulla tietojen laatukriteerejä rikkovat tietueet säilytetään, poistetaan tai hylätään.
- Unity Catalog -tietovirrat: Tallentaa automaattisesti saraketasoisen tietovirran kaikista Databricks-kyselyistä ja kokoaa tiedot työtilojen välillä ylä- ja alavirran vaikutusanalyysia varten.
- Lakeflow Jobs -orkestrointi: Luo DAG-pohjaisia työnkulkuja tapahtumakäynnisteisellä ajoituksella, tehtäväriippuvuuksilla, ehdollisilla haarautumisilla, uudelleenyrityksillä ja suoritusilmoituksilla.
- Lakeflow Connect -tietojen nouto: Tarjoaa yli 100 sisäänrakennettua liitintä yrityssovelluksille, tietokannoille ja tiedostolähteille sekä palvelimettomia, vaiheittain ladattavia putkistoja, joita hallitaan Unity Catalogilla.
Azure Databricks -integraatiot
Azure Databricks tarjoaa yli 100 sisäänrakennettua Lakeflow Connect -liitintä, kuten Salesforce, SQL Server, Google Analytics, ServiceNow, SharePoint, Workday, Amazon S3 ja Google Cloud Storage. Se integroituu myös natiivisti Microsoft Azure -palveluihin ja tarjoaa REST-, SDK- ja CLI-rajapinnat mukautettuja yhteyksiä varten.
Pros and Cons
Pros:
- Yhteistyöhön perustuvat muistikirjat yhdistävät tietotekniikan ja analytiikan
- SQL ja PySpark jakavat muunnosten työnkulut
- Visuaaliset putkistot luovat Git-versionhallittavaa koodia
Cons:
- Laskentakustannukset voivat muuttua ennakoimattomiksi
- Putkistojen laatukriteerit tukevat vain rajallista määrää objektityyppejä
Learn more about Azure Databricks: Paras saraketason datan alkuperän visualisointiin
- Ilmainen paketti saatavilla
- Alkaen $150/käyttäjä/kk (laskutetaan vuosittain)
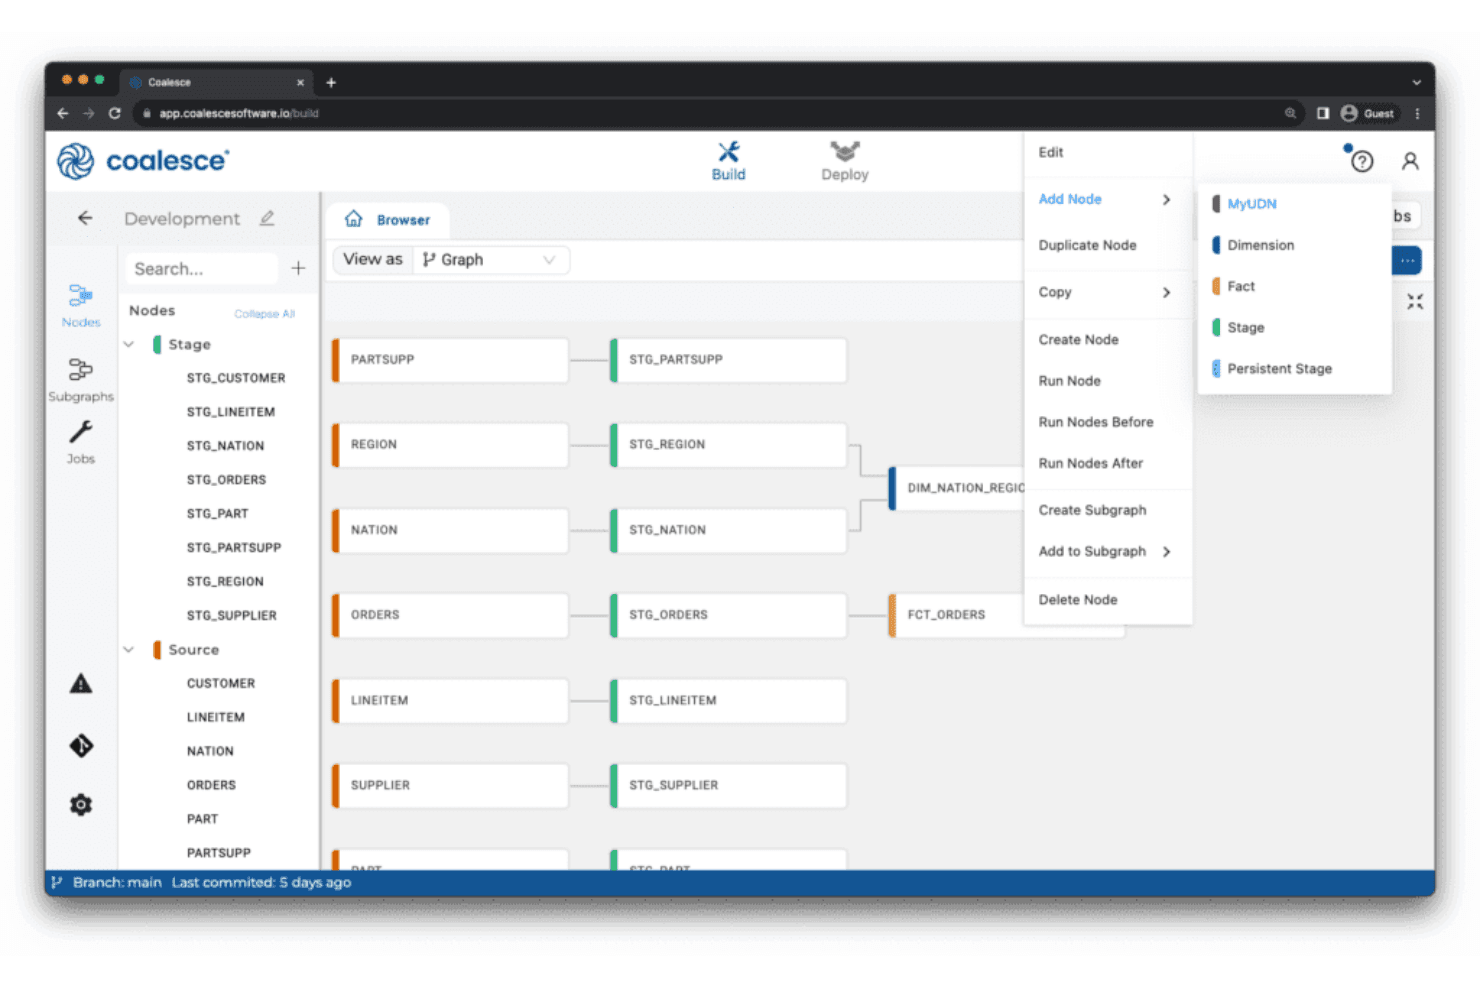
Coalescen koontikanvas yhdistää lähdesolmut välitystaulujen kautta dimensio- ja faktasolmuihin. Coalesce on tietojen muunnosalusta, joka on suunniteltu analytiikkainsinööreille ja datatiimeille, jotka haluavat visuaalisen, vähäkoodisen vaihtoehdon pelkkään SQL-kehitykseen — yhdistäen tietoputkien rakentamisen, datan luetteloinnin ja laadun valvonnan yhteen ympäristöön.
Kenelle Coalesce sopii parhaiten?
Coalesce sopii erinomaisesti analytiikan suunnittelutiimeille, joiden on seurattava datan muutoksia saraketasolla tietoputkien ja BI-työkalujen välillä.
Miksi valitsin Coalescen
Valitsin Coalescen yhdeksi parhaista vaihtoehdoista, koska saraketason datan alkuperäseuranta on ominaisuus, jonka ansiosta se todella ansaitsee paikkansa. Kun sarake lisätään ylävirtaan tai poistetaan sieltä, Coalesce välittää muutoksen automaattisesti alavirran solmuihin. Hyödynnän myös sen luettelo-ominaisuutta datan kulun jäljittämiseen raakatietovaraston taulusta aina Power BI -koontinäyttöön asti kenttä kentältä. Näin vaikutusanalyysin voi tehdä minuuteissa tuntien sijaan.
Coalescen tärkeimmät ominaisuudet
- Git-pohjainen työtila: Tallenna kaikki tietoputkitiedostot yhdistettyyn Git-tietovarastoon, joka tukee GitHubia, Bitbucketia, GitLabia ja Azure DevOps Gitiä.
- Solmutyypit ja uudelleenkäytettävät mallit: Määritä standardoidut rakennuspalikat, jotka hallitsevat sitä, miten solmut tuottavat DDL:ää, DML:ää ja testejä tietoputkissa.
- Automaattinen poikkeamien tunnistus: Seuraa skeeman, tietomäärän, ajantasaisuuden ja jakauman muutoksia datan alkuperätiedot huomioivilla hälytyksillä ja sisäänrakennetuilla häiriötilanteiden työnkuluilla.
- SQL-siirto Copilotin avulla: Muunna tallennetut proseduurit, CTE-pohjaiset komentosarjat, käännetty dbt-SQL ja vanhat ETL-SQL-komentosarjat Coalesce-solmuiksi ohjatun siirtotyönkulun avulla.
Coalescen integraatiot
Coalesce tarjoaa natiivisti integroidut yhteydet Snowflaken, Databricksin, BigQueryn, Amazon Redshiftin, Microsoft Fabricin, dbt:n, Apache Airflow'n, Power BI:n, Tableau'n ja Lookerin kanssa. Git-pohjaiset työnkulut tukevat GitHubia, GitLabia, Bitbucketia ja Azure DevOps Gitiä, ja mukautettuja työnkulkuja varten on käytettävissä API-, MCP- ja CLI-yhteys.
Pros and Cons
Pros:
- Saraketason datan alkuperäseuranta näyttää alavirran vaikutukset
- Uudelleenkäytettävät solmut standardoivat visuaaliset SQL-tietoputket
- Sisäänrakennetut tarkistukset ilmoittavat skeeman ja ajantasaisuuden poikkeamista
Cons:
- Olemassa olevat dbt-projektit edellyttävät SQL:n manuaalista muuntamista
- Suuret kaaviot voivat tuntua sekavilta ja hitailta
Learn more about Coalesce: Paras versionhallittuihin SQL-työnkulkuihin
- Maksuton palvelupaketti saatavilla
- Hinnoittelu pyynnöstä
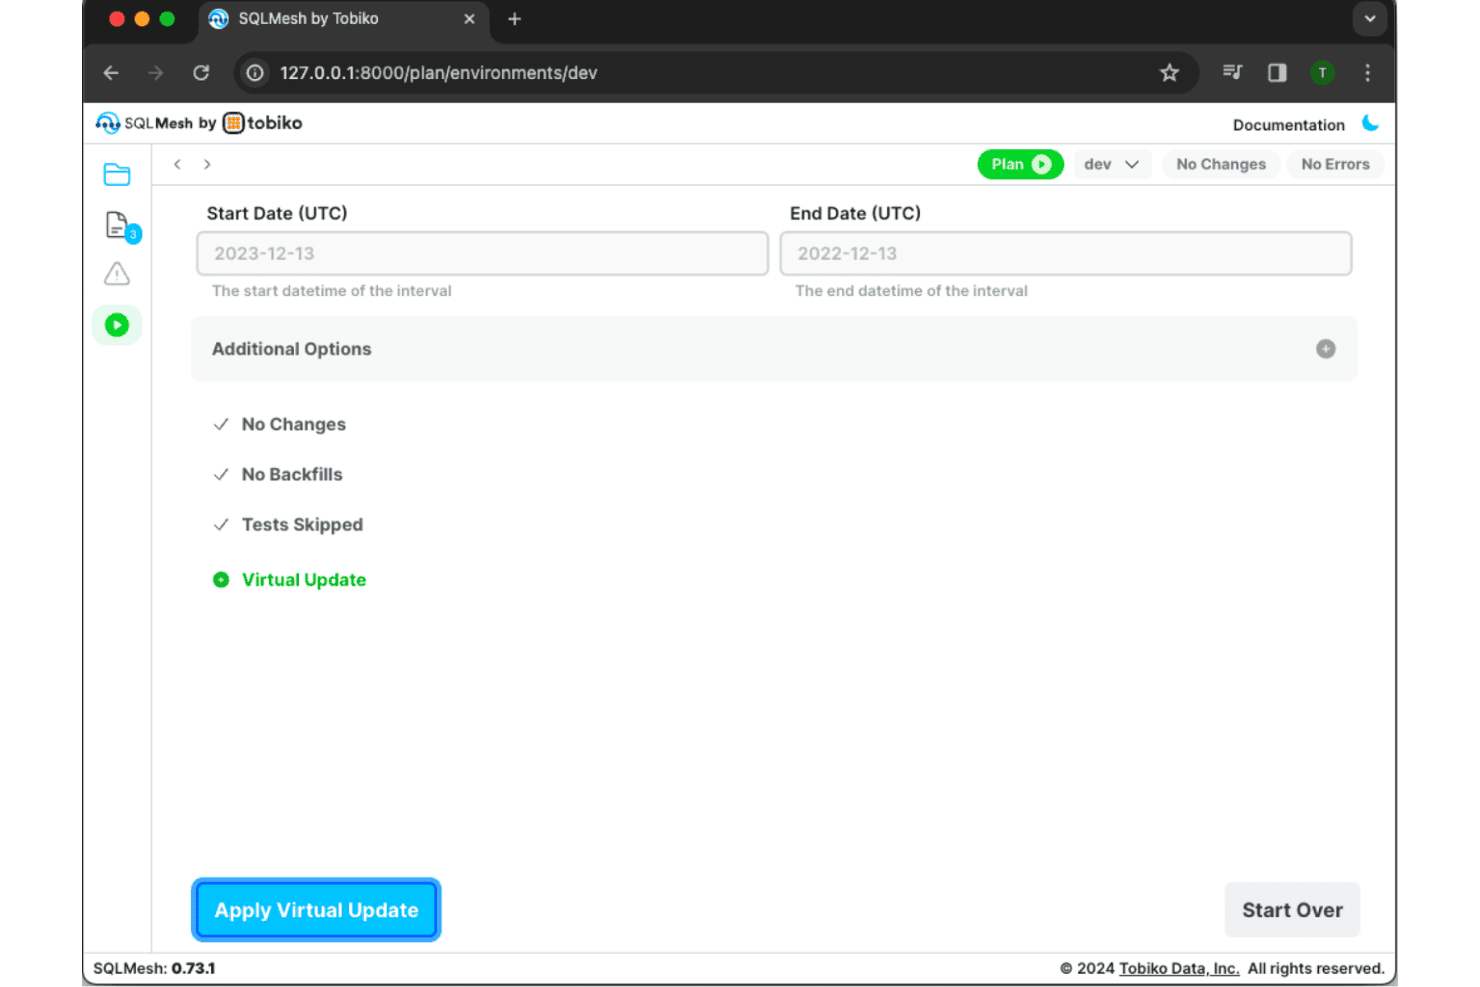
SQLMeshin suunnitelmanäkymä kehitysympäristölle, jossa tiimit tarkistavat muutokset ja ottavat käyttöön virtuaalisia päivityksiä. SQLMesh on avoimen lähdekoodin tietomuunnoskehys, jonka avulla data-asiantuntijat voivat rakentaa, testata ja ottaa käyttöön SQL- ja Python-malleja eristetyissä virtuaaliympäristöissä, automaattisella saraketasoisella tietolinjauksella ja ennen käyttöönottoa tehtävällä suunnittelutyönkululla, joka näyttää tarkalleen, mitä muutoksia tehdään ennen minkään suorittamista tietovarastossa.
Kenelle SQLMesh sopii parhaiten?
SQLMesh sopii erinomaisesti data-asiantuntijoille, jotka haluavat koodikeskeisen tietomuunnoskehyksen, jossa on sisäänrakennettu ympäristöjen eristys ja ennen käyttöönottoa tehtävä tarkistustyönkulku.
Miksi valitsin SQLMeshin
Valitsin SQLMeshin yhdeksi parhaista vaihtoehdoista, koska sen ennen käyttöönottoa tehtävä suunnittelutyönkulku muuttaa aidosti sitä, miltä versionhallittu SQL-kehitys tuntuu. Ennen kuin mitään suoritetaan tietovarastossa, näen tarkalleen, mihin malleihin muutos vaikuttaa, ja voin seurata vaikutusta automaattisesti aina saraketasolle asti ilman manuaalisia merkintöjä. Tällainen sisäänrakennettu muutosten näkyvyys yhdistettynä virtuaalisiin kehitysympäristöihin, jotka eristävät työn monistamatta dataa, erottaa SQLMeshin erityisesti versionhallittuihin SQL-työnkulkuihin tarkoitetuista ratkaisuista.
SQLMeshin tärkeimmät ominaisuudet
- SQL-murretranspilointi: SQLMesh muuntaa yhdellä murteella kirjoitetun SQL:n automaattisesti kohdesuoritusmoottorin vaatimaan syntaksiin ennen kyselyn suorittamista.
- Useita mallityyppejä: Määritä näkymä-, täysiä, inkrementaalisia, siemen-, ulkoisia ja SCD-tyypin 2 -malleja sen mukaan, miten kukin tietojoukko täytyy materialisoida.
- Yksikkötestauskehys: Kirjoita yksikkötestejä yksittäisille malleille tai ylimmän tason CTE-lausekkeille YAML-, CSV- tai SQL-luoduilla syötteillä tulosten validoimiseksi ennen käyttöönottoa.
- GitHub Actions CI/CD -botti: Automatisoi projektin tarkistukset, pull request -ympäristöjen luonnin ja käyttöönotot suoraan alkuperäisen GitHub Actions -integraation kautta.
SQLMeshin integraatiot
SQLMesh tukee 16 alkuperäistä suoritusmoottoria, kuten BigQuerya, Snowflakea, Databricksia, Sparkia, PostgreSQL:ää, Redshiftiä, Trinoa ja DuckDB:tä. Se integroituu myös dbt:n, GitHub Actionsin, dlt:n ja Airflow'n kanssa, ja tarjoaa Python-rajapinnan, komentorivikäyttöliittymän sekä muistikirjaliittymät.
Pros and Cons
Pros:
- Suunnitelmien esikatselut paljastavat muutosten vaikutukset riippuvaisiin kohteisiin
- Virtuaaliympäristöt välttävät päällekkäisten kehitystaulujen luonnin
- Automaattinen saraketason tietolinjaus vähentää manuaalisia merkintöjä
Cons:
- Ajastin tarvitsee ulkoisen säännöllisen käynnistimen
- dbt-siirrot voivat edellyttää inkrementaalisten mallien mukauttamista
Learn more about SQLMesh: Paras hallinnoituihin kehitysympäristöihin
- 14 päivän ilmainen kokeilujakso + ilmainen esittely saatavilla
- Hinnoittelu pyynnöstä
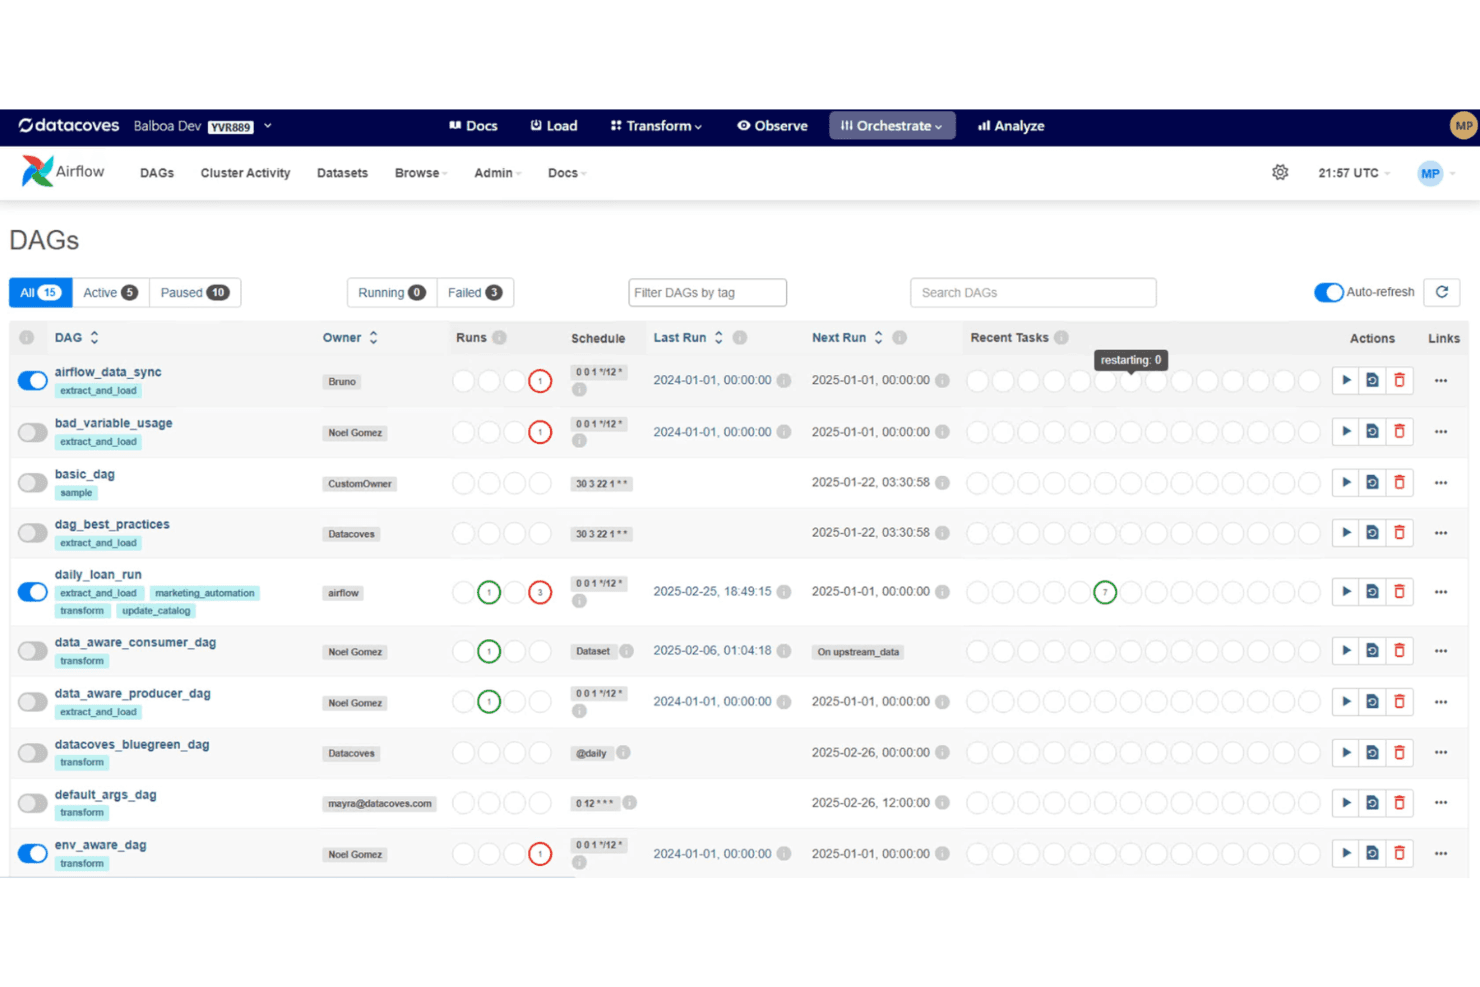
Datacovesin Orchestrate-moduuli, jossa Airflow'n DAG-aikataulut, ajon tila ja tehtävähistoria näkyvät yhdessä näkymässä. Datacoves on hallinnoitu dbt- ja Airflow-alusta, joka tarjoaa data- ja analytiikkainsinööreille selainpohjaisen VS Code -ympäristön, jossa on sisäänrakennettu Git, CI/CD ja putkien orkestrointi – joten näiden työkalujen oman infrastruktuurin ylläpidosta aiheutuva kuormitus poistuu.
Kenelle Datacoves sopii parhaiten?
Datacoves sopii hyvin datatekniikan tiimeille, jotka haluavat täysin hallinnoidun dbt- ja Airflow-ympäristön ilman itse rakennettavan ja ylläpidettävän infrastruktuurin aiheuttamaa kuormitusta.
Miksi valitsin Datacovesin
Otin Datacovesin mukaan kärkivalintoihini, koska se on ainoa tässä esitelty työkalu, joka tarjoaa täysin hallinnoidun selainpohjaisen VS Code -ympäristön, jossa dbt ja Airflow on yhdistetty valmiiksi. Pidän siitä, että jokainen tiimin kehittäjä saa yhtenäisen työtilan, jossa Git, Pythonin virtuaaliympäristöt ja Datacovesin tehokäyttäjälaajennus on määritetty valmiiksi, joten paikallisten asetusten välillä ei synny eroja. Kun tiimi vie uuden DAG:n, Airflow poimii sen Gitistä minuutin kuluessa, ja VS Coden linjauspaneeli näyttää ylä- ja alavirran malliriippuvuudet suoraan IDE:ssä.
Datacovesin tärkeimmät ominaisuudet
- Kerrostettu mallinnusrakenne: Datacoves järjestää dbt-projektit Inlets-, Bays- ja Coves-kerroksiin, jotka erottavat toisistaan raakamuunnokset, uudelleenkäytettävät datatuotteet ja analytiikkaan valmiit tuotokset.
- Hallinnoitu Airbyte-tiedonsiirto: Tiimit voivat käyttää hallinnoitua Airbytea suoraan alustalla tai tuoda omat työkalunsa, kuten Fivetranin tai dlt:n, ja käynnistää ne Airflow'n kautta.
- dbt-coves-projektirunko: Asennuskomento luo mukautettavan repositoriorakenteen, joka sisältää varastokohtaiset sovittimet, CI/CD-työnkulut, linttauksen, testauskehykset ja dokumentointistandardit.
- Hallinnoitu DataHub-luettelo: Datacoves sisältää hallinnoidun DataHubin metatietojen järjestämiseen ja datan löydettävyyden parantamiseen tiimin dbt-projekteissa.
Datacovesin integraatiot
Datacoves integroituu GitHubiin, GitLabiin, Bitbucketiin, Azure DevOpsiin, Snowflakeen, BigQueryyn, Databricksiin, Redshiftiin, DuckDB:hen/MotherDuckiin ja Airbyteen. Se tukee myös Fivetrania, Azure Data Factorya, Amazon Gluea, dlt:tä, Streamsetsia, Informatic aa ja API-integraatioita.
Pros and Cons
Pros:
- Yhtenäiset selainpohjaiset kehitysympäristöt
- Käytännönläheinen käyttöönotto- ja vianmääritystuki
- Mallien linjaus näkyy VS Codessa
Cons:
- Airflow-hiekkalaatikko toimii eri tavalla kuin tuotantoympäristö
- Jotkin CI/CD-työnkulut edellyttävät lisätoteutusta
Learn more about Datacoves:
Muut dbt-vaihtoehdot
Tässä on muutamia dbt-vaihtoehtoja, jotka eivät päässeet esivalintaani, mutta joihin kannattaa silti tutustua:
- 115XSopii parhaiten usean pilven datapinon orkestrointiin
- 12Snowflake Native AppsParas alustan sisäiseen datan muuntamiseen
- 13Qlik Talend CloudParas yhtenäiseen dataintegraatioon ja datahallintaan
Miten arvioin dbt-vaihtoehtoja
Jaan arviointini ydintarpeisiin, jotka jokaisen työkalun on täytettävä – DAG-ohjattuun mallinnukseen, sisäänrakennettuun testaukseen ja Git-integraatioon – sekä erottaviin tekijöihin, jotka auttavat valitsemaan työkalupinoosi sopivan vaihtoehdon.
Ydintoiminnot (tämän luettelon perusvaatimukset)
Kun valitsen työkaluja luettelooni, arvioin jokaisen työkalun asteikolla 0 (toiminnallisuutta ei ole tarjolla)–5 (työkalu on tällä osa-alueella erinomainen) jokaisen alla luetellun ydintoiminnon osalta. Sen jälkeen muunnan työkalun kokonaispistemäärän prosenttiosuudeksi. Työkalun on saavutettava vähintään 65 prosentin kokonaispistemäärä, jotta se voidaan ottaa mukaan.
- SQL-pohjaiset tietomuunnokset: Tarkistan, tukeeko kukin työkalu SQL- ja/tai Python-muunnoslogiikkaa, joka suoritetaan suoraan tietovarastossa, mukaan lukien uudelleenkäytettävien kyselyjen mallipohjat ja parametrien käyttö.
- Modulaarinen mallien kehitys: Jokaisen työkalun pitäisi mahdollistaa toisistaan riippuvaisten mallien rakentaminen viittausten tai vastaavien menetelmien avulla, jotta DAG kuvaa todelliset riippuvuudet – kuten esikäsittely-, väli- ja tietomallikerrokset.
- Git-pohjainen versionhallinta: Etsin natiivia Git-integraatiota, joka tukee haaroja, vetopyyntöjä ja CI/CD-kytkentöjä, sillä analytiikkainsinöörit tarvitsevat samat koodintarkastuksen työnkulut kuin missä tahansa ohjelmistoprojektissa.
- Automaattinen testaus ja tietojen laatu: Sisäänrakennetut testimääritykset ovat tässä tärkeitä – esimerkiksi yksilöllisyyden tarkistukset, ei-tyhjien arvojen rajoitteet ja mukautetut väitteet, jotka voidaan suorittaa mallien tuloksille ennen niiden siirtämistä tuotantoon.
- Riippuvuuksien ja dokumentaation luonti: Työkalun pitäisi luoda automaattisesti riippuvuuskaaviot ja haettavissa oleva dokumentaatio koodikannasta, jotta voit jäljittää, miten liikevaihtomittari kulkee raakadatasta BI-koontinäyttöön.
- Tietovarasto- ja data-alustayhteydet: Arvioin, mihin alustoihin kukin työkalu yhdistyy natiivisti – Snowflake, BigQuery, Redshift, Databricks, Postgres – sillä puutteet tässä voivat sulkea muuten vahvan vaihtoehdon työkalupinosi ulkopuolelle.
Kun olen koonnut luettelon työkaluihin, jotka täyttävät nämä kriteerit, tarkastelen, mikä erottaa kunkin alustan muista.
Erottavat tekijät (mikä erottaa palveluntarjoajat toisistaan)
Näin vertailen eri palveluntarjoajia:
Erottuvat ominaisuudet
Natiivi orkestrointi on merkittävä erottava tekijä – työkalut, jotka sisältävät sisäänrakennetun ajoituksen ja uudelleenyrityslogiikan, säästävät sinut erillisen Airflow- tai Dagster-kokoonpanon rakentamiselta vain mallien suorittamista varten aikataulun mukaisesti. Arvioin myös, tarjoaako työkalu semanttisen kerroksen, sillä mittareiden, kuten MRR:n tai vaihtuvuusasteen, määrittäminen kerran ja niiden yhdenmukainen julkaiseminen Lookeriin, Tableaulle tai Power BI:hin vähentää ristiriitaisia lukuja tiimien välillä. Visuaalinen työnkulun rakennustyökalu on myös tärkeä erityisesti tiimeille, joissa analyytikoiden on osallistuttava muunnosten tekemiseen kirjoittamatta raakaa SQL:ää.
Ominaisuuksia laajemmat tekijät
Hinnoittelun läpinäkyvyydellä on merkitystä dbt-vaihtoehtoja verrattaessa – jotkin palvelut veloittavat käyttäjäkohtaisesti, toiset laskentakapasiteetin perusteella, ja ero vaikuttaa kokonaiskustannuksiisi tiimin kasvaessa. Arvioin myös sopivuutta ekosysteemiin, erityisesti sitä, yhdistyykö työkalu olemassa olevaan tiedonsiirtokerrokseesi (Fivetran, Airbyte) ja BI-työkaluihin ilman mukautettua yhdistämiskoodia. Käyttöönoton joustavuus on toinen keskeinen tekijä, sillä säännellyillä toimialoilla toimivat tiimit tarvitsevat usein VPC- tai itse ylläpidettäviä vaihtoehtoja jaetun SaaS-instanssin sijaan.
Miksi etsiä dbt-vaihtoehtoa?
Vaikka dbt on hyvä analytiikan suunnittelun työkalu, on useita syitä, joiden vuoksi jotkut käyttäjät etsivät vaihtoehtoisia ratkaisuja. Saatat etsiä dbt-vaihtoehtoa, koska…
- Tarvitset ilman koodia toimivan tai vähäkoodisen analytiikan työnkulkujen rakennustyökalun
- Tiimiltäsi puuttuu edistyneet SQL- tai insinööritaidot
- Haluat sisäänrakennettuja koneoppimis- tai ennakoivan analytiikan työkaluja
- Tarvitset reaaliaikaista tai suoratoistodatan käsittelyä
- Tarvitset yksityiskohtaisemmat datan alkuperä- ja jäljitettävyystiedot sekä auditointipolut
- Organisaatiosi suosii visuaalista käyttöliittymää putkien suunnitteluun
Jos jokin näistä kuulostaa tutulta, olet tullut oikeaan paikkaan. Luettelossani on useita analytiikan suunnittelun työkaluvaihtoehtoja, jotka sopivat paremmin tiimeille, jotka kohtaavat näitä dbt:hen liittyviä haasteita ja etsivät vaihtoehtoisia ratkaisuja.
dbt:n keskeiset ominaisuudet
Seuraavassa on joitakin dbt:n keskeisiä ominaisuuksia, joiden avulla voit vertailla ja arvioida vaihtoehtoisten ratkaisujen tarjontaa:
- SQL-pohjainen tietojen muunnos ja mallintaminen
- Git-versionhallinnan integrointi
- Automaattinen testaus ja tietojen laadun tarkistukset
- Modulaarinen projektirakenne uudelleenkäytettävää koodia varten
- Mallien ja työnkulkujen dokumentaation luominen
- Riippuvuuksien hallinta ja suunnattujen asyklisten graafien visualisointi
- Tuki tärkeimmille pilvipohjaisille tietovarastoille
- Inkrementaalinen mallien rakentaminen tehokasta käsittelyä varten
- Komentorivikäyttöliittymä ja pääsy ohjelmointirajapinnan kautta
- Kehitys- ja tuotantoympäristöjen hallinta