

Databricks vai Cloudera: vertailu ja arviot vuodelle 2026
Databricksin ja Clouderan välillä valitseminen riippuu siitä, miten tiimisi hallinnoi dataa pilvi- ja hybridiympäristöissä. Vertailen niiden vahvuuksia, kompromisseja ja parhaiten sopivia käyttötapauksia.

We review tools independently, and commissions help fund our testing. See our transparency policy, our methodology, or suggest a tool.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
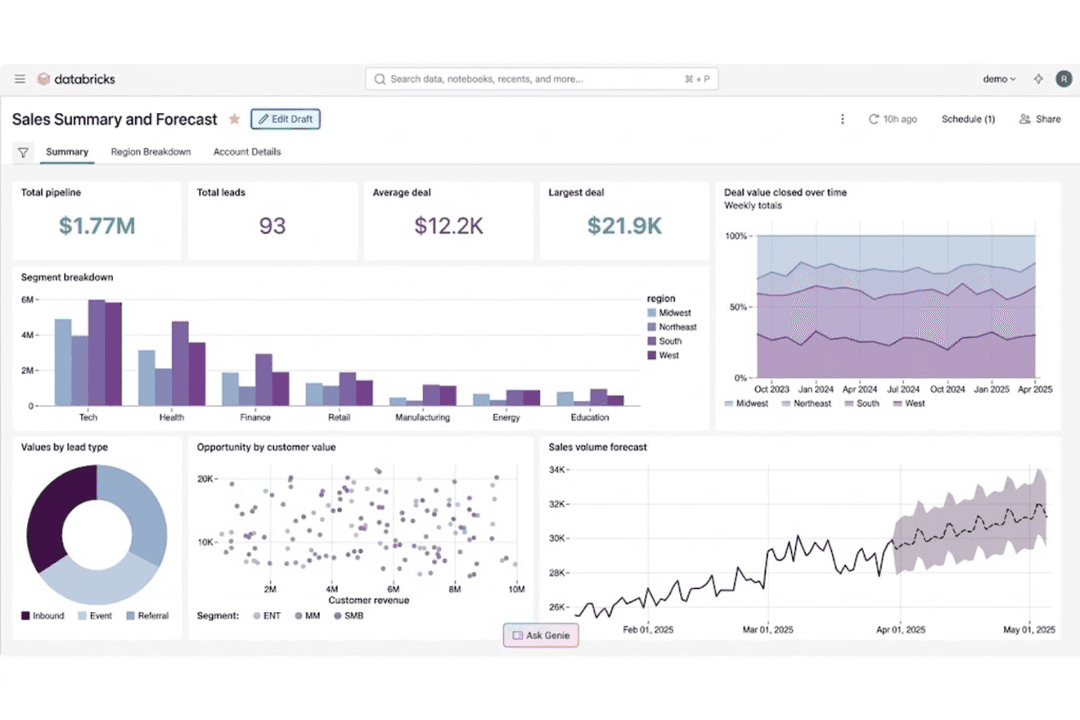
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
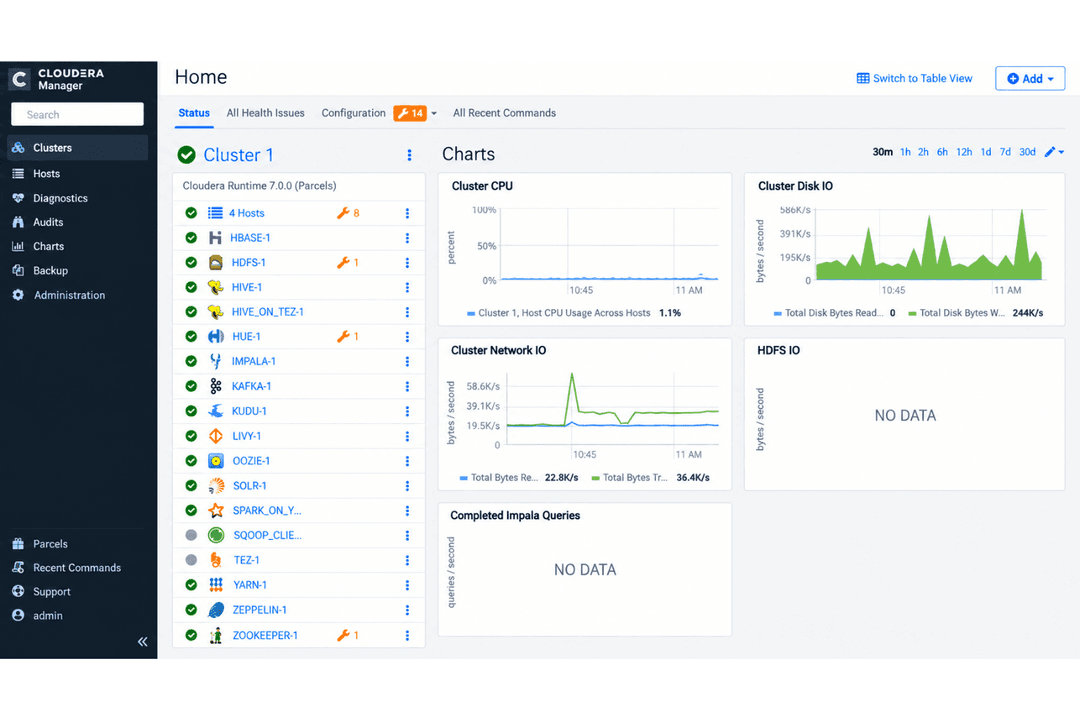
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Databricksin ja Clouderan hinnoittelu ja piilokustannukset
Databricks käyttää kulutukseen perustuvaa hinnoittelua datan käsittelyssä, tietovarastoinnissa, tekoälyssä ja muissa työkuormissa. Kustannuksiin vaikuttavat laskentatehon käytön lisäksi pilvi-infrastruktuuri, tallennus, verkkoyhteydet ja tuki. Cloudera käyttää hybridimallia: sen pilvipalvelut laskutetaan kulutuksen perusteella Cloudera Compute Units (CCU) -yksiköillä, kun taas paikalliset käyttöönotot perustuvat vuosittaisiin tilauksiin. Molemmissa tapauksissa infrastruktuuri ja verkkoyhteydet voivat kasvattaa kokonaiskustannuksia alustamaksujen lisäksi.
Kun vertailet näitä kahta, kannattaa katsoa otsikkohinnoittelua pidemmälle ja selvittää, missä työkuormasi suoritetaan ja kuinka usein putkistoja, suoratoistotöitä ja muunnoksia suoritetaan. Databricksin kohdalla tehoton tai pitkään jatkuva laskenta ja tiedonsiirto voivat kasvattaa kustannuksia. Cloudera puolestaan voi aiheuttaa lisäkustannuksia infrastruktuurista, verkkoyhteyksistä, Private Linkistä, havainnoinnista sekä Data Flow- tai Lakehouse Optimizer -palveluista. Käyttöönottomallin, työkuormien määrän, tuen ja skaalautuvuustarpeiden huomioiminen antaa realistisemman kuvan pitkän aikavälin kustannuksista.
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Integraatio | Databricks | Cloudera |
|---|---|---|
| IntegraatioMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntegraatioAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntegraatioGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntegraatioTableau | Databricks✅ | Cloudera✅ |
| IntegraatioInformatica | Databricks✅ | Cloudera✅ |
| IntegraatioSalesforce | Databricks✅ | Cloudera✅ |
| IntegraatioQlik | Databricks✅ | Cloudera✅ |
| IntegraatioOracle Database | Databricks✅ | Cloudera✅ |
| IntegraatioMongoDB | Databricks✅ | Cloudera✅ |
| IntegraatioAPI | Databricks✅ | Cloudera✅ |
| IntegraatioZapier | Databricks✅ | Cloudera❌ |
Sekä Databricks että Cloudera tukevat laajoja ekosysteemejä, joihin kuuluu pilvialustoja, tietokantoja, BI-työkaluja, rajapintoja ja datapalveluja. Databricks yhdistää nämä yhteydet Lakeflow'hun, Partner Connectiin ja hallittuihin datankäsittelyn työnkulkuihin, kun taas Cloudera painottaa yhteyksiä pilvi-, paikallis- ja hybridiympäristöissä.
| Tekijä | Databricks | Cloudera |
|---|---|---|
| TekijäSalaus | DatabricksSalaa levossa ja siirron aikana olevat tiedot sekä tukee asiakkaan hallinnoimia avaimia, pilvipohjaista avaintenhallintaa ja hallittujen data- ja tekoälyresurssien yksityiskohtaista suojausta. | ClouderaTukee levossa ja siirron aikana olevien tietojen salausta, avaintenhallintaa ja suojausmekanismeja pilvi- ja paikallisissa ympäristöissä. |
| TekijäKäyttöoikeuksien hallinta | DatabricksUnity Catalog keskittää yksityiskohtaiset käyttöoikeuskäytännöt datalle, malleille, sovelluksille ja tekoälyresursseille sekä tarjoaa kertakirjautumisen, identiteetti-integraatiot, rivi- ja saraketason hallinnan ja työtilaohjaukset. | ClouderaKäyttää Apache Rangeria, Knoxia ja identiteetti-integraatioita todennuksen, valtuutuksen, kertakirjautumisen ja yksityiskohtaisten käyttöoikeuksien hallintaan hybridiympäristöissä. |
| TekijäSääntelyn vaatimustenmukaisuus | DatabricksTäyttää SOC 1 Type II-, SOC 2 Type II-, ISO 27001-, ISO 27017- ja ISO 27018 -sertifiointivaatimukset sekä tukee HIPAA-, PCI DSS-, HITRUST- ja FedRAMP Moderate- ja High -vaatimustenmukaisuutta pilvestä, alueesta ja määrityksistä riippuen. | ClouderaYlläpitää sertifiointeja ja ohjelmia, kuten SOC 2 Type II-, ISO 27001-, PCI DSS- ja FedRAMP Moderate -vaatimustenmukaisuutta tukevissa Cloudera-ympäristöissä. |
| TekijäLuotettavuus | DatabricksTukee automaattista skaalausta, palvelimetonta ja hallinnoitua laskentaa, työkuormien eristämistä sekä pilvipohjaista käytettävyyttä AWS-, Azure- ja Google Cloud -ympäristöissä. Palautumisstrategiat määritetään työkuormien vaatimusten mukaan. | ClouderaTukee monialueisia käyttöönottoja, redundanttia infrastruktuuria, vikasietoista vaihtoa ja palautumista katastrofeista pilvi- ja hybridiympäristöissä. |
| TekijäDatan hallinta | DatabricksUnity Catalog tarjoaa keskitetyn auditoinnin, löytämisen, luokittelun ja automaattisen tietovirran jäljitettävyyden lähdedatasta muistikirjoihin, töihin, malleihin, palveluihin ja koontinäyttöihin. | ClouderaSDX yhdistää Apache Rangerin ja Atlaksen käytäntöjen, auditoinnin, metatietojen hallinnan, luokittelun ja tietovirran jäljitettävyyden toteuttamiseksi pilvi- ja paikallisessa datassa. |
Molemmat alustat tarjoavat yritystason turvallisuutta ja hallintaa, mutta niiden painotukset eroavat toisistaan. Databricks yhdistää käyttöoikeuksien hallinnan, auditoinnin, luokittelun ja tietovirran jäljitettävyyden Unity Catalogin avulla data- ja tekoälytyökuormissa, kun taas Cloudera laajentaa keskitetyn hallinnan hybridi- ja paikallisiin ympäristöihin SDX:n, Rangerin ja Atlaksen avulla.
| Tekijä | Databricks | Cloudera |
|---|---|---|
| TekijäKäyttöliittymä | DatabricksYhdistää yhteistyöhön tarkoitetut muistikirjat, SQL-työkalut, koontinäytöt ja visuaaliset työnkulut yhteen työtilaan suunnittelua, analytiikkaa ja tekoälyä käyttäville tiimeille. | ClouderaKäyttää hallintakonsolia ja palvelukohtaisia käyttöliittymiä datan ja hybridi-infrastruktuurin hallintaan. |
| TekijäKäyttöönotto | DatabricksPilvityötilat voidaan ottaa nopeasti käyttöön, ja palvelimeton sekä hallinnoitu laskenta vähentävät infrastruktuurin määritystarpeita yleisissä työkuormissa. | ClouderaKäyttöönotto riippuu käyttöönottomallista, ja hybridi- sekä paikalliset ympäristöt edellyttävät lisämäärityksiä. |
| TekijäPerehdytys | DatabricksTarjoaa ohjatun käyttöönoton, esimerkkimuistikirjoja, koulutusta ja hallinnoituja palveluja, jotka auttavat tiimejä siirtymään alkuvaiheen kokeiluista hallittuihin tuotantotyönkulkuihin. | ClouderaEdellyttää laajemman ekosysteemin tuntemusta erityisesti silloin, kun tiimit työskentelevät NiFin, Sparkin, Rangerin ja hybridi-infrastruktuurin kaltaisten teknologioiden parissa. |
| TekijäDokumentaatio | DatabricksTarjoaa kattavaa dokumentaatiota, opetusohjelmia, käyttöönotto-ohjeita ja koulutusta data-analytiikan, hallinnan, analytiikan ja tekoälyn alueilta. | ClouderaTarjoaa teknistä dokumentaatiota pilvi- ja paikallisista ympäristöistä, turvallisuudesta ja alustan hallinnasta. |
| TekijäTuen saatavuus | DatabricksTarjoaa julkisia resursseja ja porrastettua maksullista tukea, johon kuuluu teknisiä yhteyshenkilöitä, eskalointipolkuja ja kriittisten ongelmien kattavuus yrityskäyttöönottoihin. | ClouderaSisältää yritystason tuen ja teknisiä resursseja pilvi- ja paikallisiin tarjontoihin. |
Helppokäyttöisyyden näkökulmasta Databricks yhdistää teknisen kehitysympäristön hallinnoituihin palveluihin, jotka vähentävät infrastruktuurityötä putkissa, analytiikassa ja tekoälyssä. Cloudera tukee pilvi-, paikallisia ja hybridiympäristöjä, mikä tuo mukanaan lisähuomioita käyttöönottoon. Pilvipainotteisille datatiimeille Databricks tarjoaa yhtenäisen työnkulun kehityksestä tuotantoon, kun taas Cloudera sopii organisaatioille, joiden on toimittava erilaisissa infrastruktuuriympäristöissä.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
Kenen kannattaa käyttää Databricksia ja kenen Clouderaa?
Jos etsit DataOps-alustaa, joka yhdistää data-analytiikan, analytiikan, hallinnan ja tekoälyn samaan pilvipainotteiseen ympäristöön, Databricks on todennäköisesti parempi vaihtoehto. Se on erityisen hyödyllinen tiimeille, jotka haluavat hallinnoituja putkia, yhteistyöhön tarkoitettuja muistikirjoja, suoratoiston tukea ja keskitetyn hallinnan ilman, että niiden tarvitsee hallita yhtä paljon infrastruktuuria manuaalisesti.
Jos sen sijaan sinun on suoritettava datatyönkulkuja pilvi-, paikallis- ja hybridiympäristöissä, Cloudera saattaa sopia infrastruktuurillesi paremmin. Se on hyvä valinta organisaatioille, joilla on tiukat vaatimukset säännösten noudattamiselle tai datan sijainnille, vakiintuneet avoimen lähdekoodin ekosysteemit sekä tiimit, jotka hallinnoivat hajautettuja data-alustoja useissa ympäristöissä.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |