

10 alternativas a Elasticsearch seleccionadas para 2026

Alternativas a Elasticsearch: lista corta


Una buena alternativa a Elasticsearch ofrece búsquedas rápidas y escalables, indexación de datos flexible y análisis fiables sin obligarte a depender de un único ecosistema. Si buscas opciones más allá de Elasticsearch, probablemente estés sopesando factores como la flexibilidad del código abierto, el coste, la facilidad de implementación o las funciones avanzadas de IA.
Con tantas plataformas de búsqueda y análisis disponibles, es difícil saber cuál se ajustará a tus requisitos técnicos y objetivos empresariales. Esta lista te ayudará a comparar las mejores alternativas a Elasticsearch para 2026, para que puedas elegir con confianza la solución adecuada para las necesidades de tu equipo.
¿Qué es Elasticsearch?
Elasticsearch es un motor de búsqueda y análisis de código abierto y alto rendimiento basado en Apache Lucene, diseñado para realizar búsquedas escalables y en tiempo real en datos estructurados y no estructurados. Almacena los datos como documentos JSON y admite búsquedas de texto completo, registros y casos de uso de análisis. Utilizado a menudo dentro de la pila ELK, funciona como una potente alternativa para equipos que necesitan búsquedas distribuidas y procesamiento de datos rápidos.
Tabla comparativa de alternativas a Elasticsearch
Esta tabla comparativa resume los detalles de precios de mis principales alternativas a Elasticsearch:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para un ajuste avanzado de la relevancia | Plan gratuito + demostración gratuita disponible | Precio bajo solicitud | Website | |
| 2 | Ideal para la optimización de la búsqueda en el sitio de minoristas | Demostración gratuita disponible | Precios disponibles previa solicitud | Website | |
| 3 | Ideal para obtener información de documentos impulsada por IA | Prueba gratuita de 30 días disponible | Desde $500/mes | Website | |
| 4 | Ideal para la extensibilidad de código abierto | Plan gratuito disponible | Gratuito y de código abierto, con precios opcionales para servicios administrados de proveedores de nube | Website | |
| 5 | Ideal para el análisis unificado de registros y métricas | Versión de código abierto disponible (autoalojada) | Modelo de precios de pago por uso | Website | |
| 6 | Ideal para implementaciones de búsqueda ultrarrápidas | Versión de código abierto disponible | Desde $30/mes | Website | |
| 7 | Ideal para API fáciles de usar para desarrolladores | Versión de código abierto + demostración gratuita disponible | Modelo de precios de pago por uso (basado en recursos) | Website | |
| 8 | Ideal para la escalabilidad de nivel empresarial | Not available | Gratuito y de código abierto | Website | |
| 9 | Ideal para el procesamiento de macrodatos en tiempo real | Not available | Gratuito y de código abierto, con opciones de alojamiento gestionado de pago | Website | |
| 10 | Ideal para obtener información de documentos basada en IA | Prueba gratuita de 30 días disponible | Desde $500/mes | Website |
Por qué confiar en nuestras reseñas de software
Llevamos probando y revisando software desde 2023. Como líderes tecnológicos, sabemos lo crítico y difícil que es tomar la decisión correcta al seleccionar software.
Invertimos en una investigación profunda para ayudar a nuestra audiencia a tomar mejores decisiones de compra de software. Hemos probado más de 2,000 herramientas para diferentes casos de uso tecnológicos y escrito más de 1,000 reseñas de software exhaustivas. Descubre cómo mantenemos la transparencia y nuestra metodología de revisión de software.
Reseñas de las mejores alternativas a Elasticsearch
A continuación encontrarás mis resúmenes detallados de las mejores alternativas a Elasticsearch que llegaron a mi lista corta. En mis reseñas analizo en detalle las funciones, los mejores casos de uso y las integraciones de cada plataforma para ayudarte a encontrar la más adecuada para ti.
Algolia
Ideal para un ajuste avanzado de la relevancia
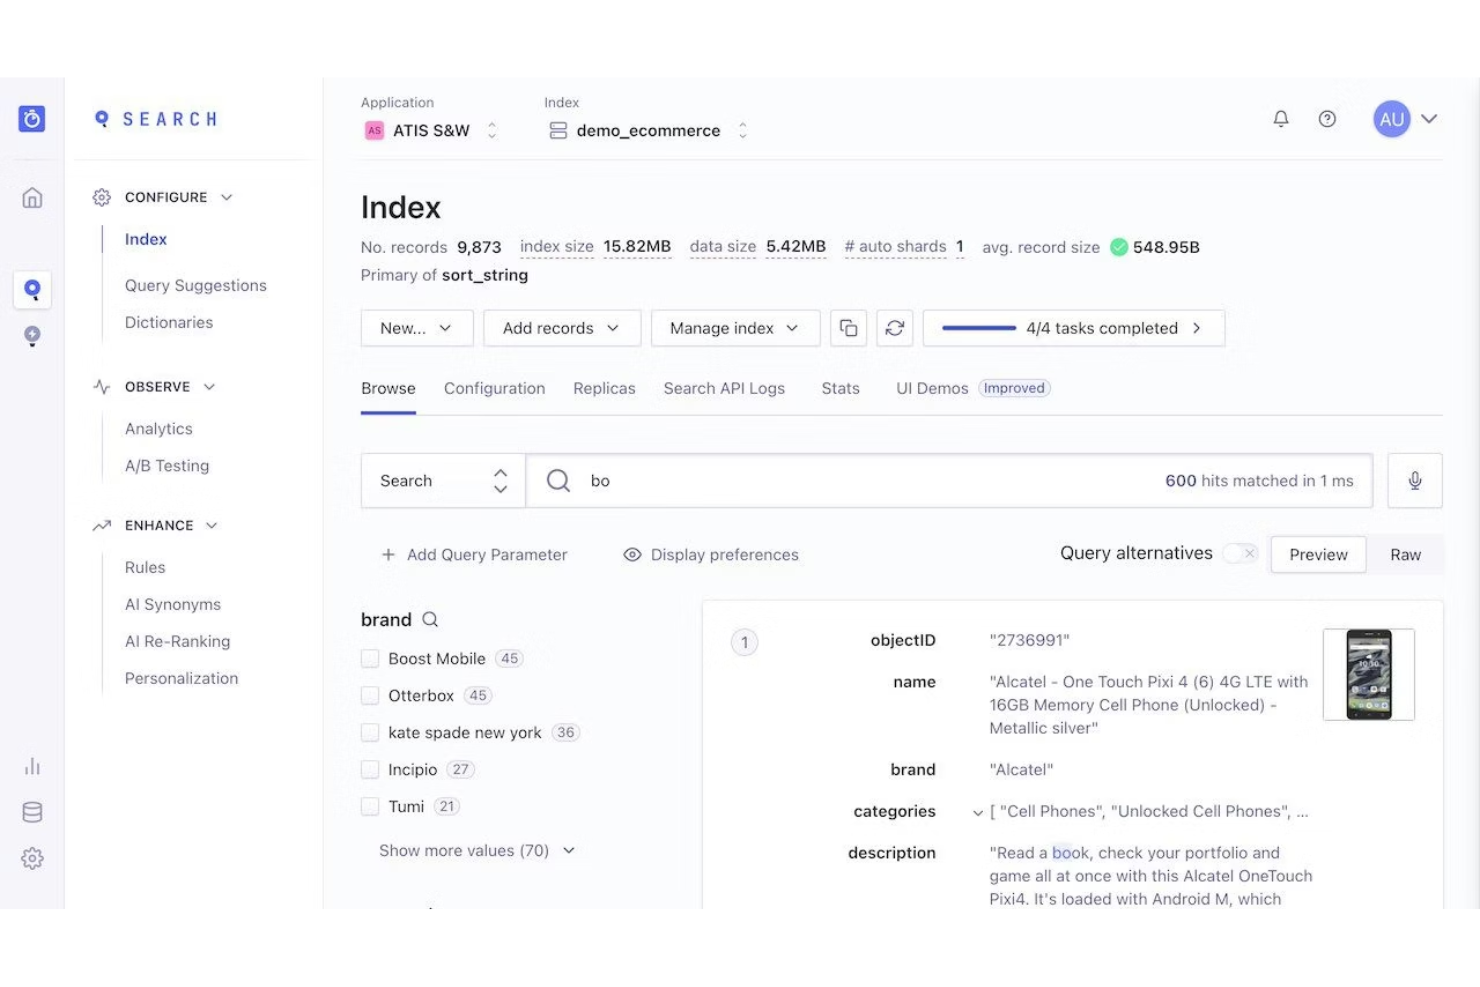
Si necesitas un control granular sobre la relevancia de las búsquedas, Algolia está hecho para ti. Esta plataforma de búsqueda basada en la nube resulta atractiva para equipos de producto, empresas de comercio electrónico y proveedores de SaaS que desean ajustar con precisión la clasificación y ofrecer resultados altamente personalizados. A diferencia de Elasticsearch, Algolia destaca por su ajuste avanzado de la relevancia y sus capacidades de indexación en tiempo real.
Por qué Algolia es una buena alternativa a Elasticsearch
Para los equipos que necesitan un ajuste avanzado de la relevancia, Algolia ofrece un nivel de control que va más allá de lo que Elasticsearch proporciona de forma predeterminada. Elegí Algolia porque permite ajustar con precisión la clasificación mediante reglas personalizadas, lógica empresarial y señales del comportamiento de los usuarios.
Su fórmula de clasificación dinámica y sus funciones de relevancia impulsadas por AI ayudan a ofrecer resultados de búsqueda que coinciden más estrechamente con la intención del usuario. Estas capacidades convierten a Algolia en una opción sólida para empresas en las que la precisión y la personalización de las búsquedas son prioridades principales.
Características principales de Algolia
Algunas otras características de Algolia lo convierten en una opción flexible para una variedad de aplicaciones basadas en búsquedas:
- Búsqueda geográfica: Algolia admite búsquedas basadas en la ubicación, lo que permite filtrar y clasificar los resultados según la proximidad geográfica.
- Búsqueda multiíndice: Puedes consultar varios índices en una sola solicitud de búsqueda para satisfacer necesidades de datos más complejas.
- Facetas y filtrado: La plataforma ofrece facetas y filtrado integrados para ayudar a los usuarios a acotar los resultados de búsqueda según distintos atributos.
- Panel de análisis: Algolia incluye un panel de análisis en tiempo real para supervisar el rendimiento de las búsquedas y el comportamiento de los usuarios.
Integraciones de Algolia
Las integraciones nativas incluyen Android, acceso a la API, Supabase, Meteor, Adobe Commerce, Bubble, WordPress, Adobe, Gatsby, Zendesk, BigCommerce, Netlify, Salesforce Commerce Cloud y muchas más.
Pros and Cons
Pros:
- El ajuste avanzado de la relevancia permite un control granular sobre la clasificación de las búsquedas
- La indexación en tiempo real permite actualizar al instante los resultados de búsqueda
- Tolerancia integrada a errores tipográficos y compatibilidad con idiomas para audiencias globales
Cons:
- El precio puede aumentar rápidamente con volúmenes de uso elevados
- Compatibilidad limitada con agregaciones complejas en comparación con Elasticsearch
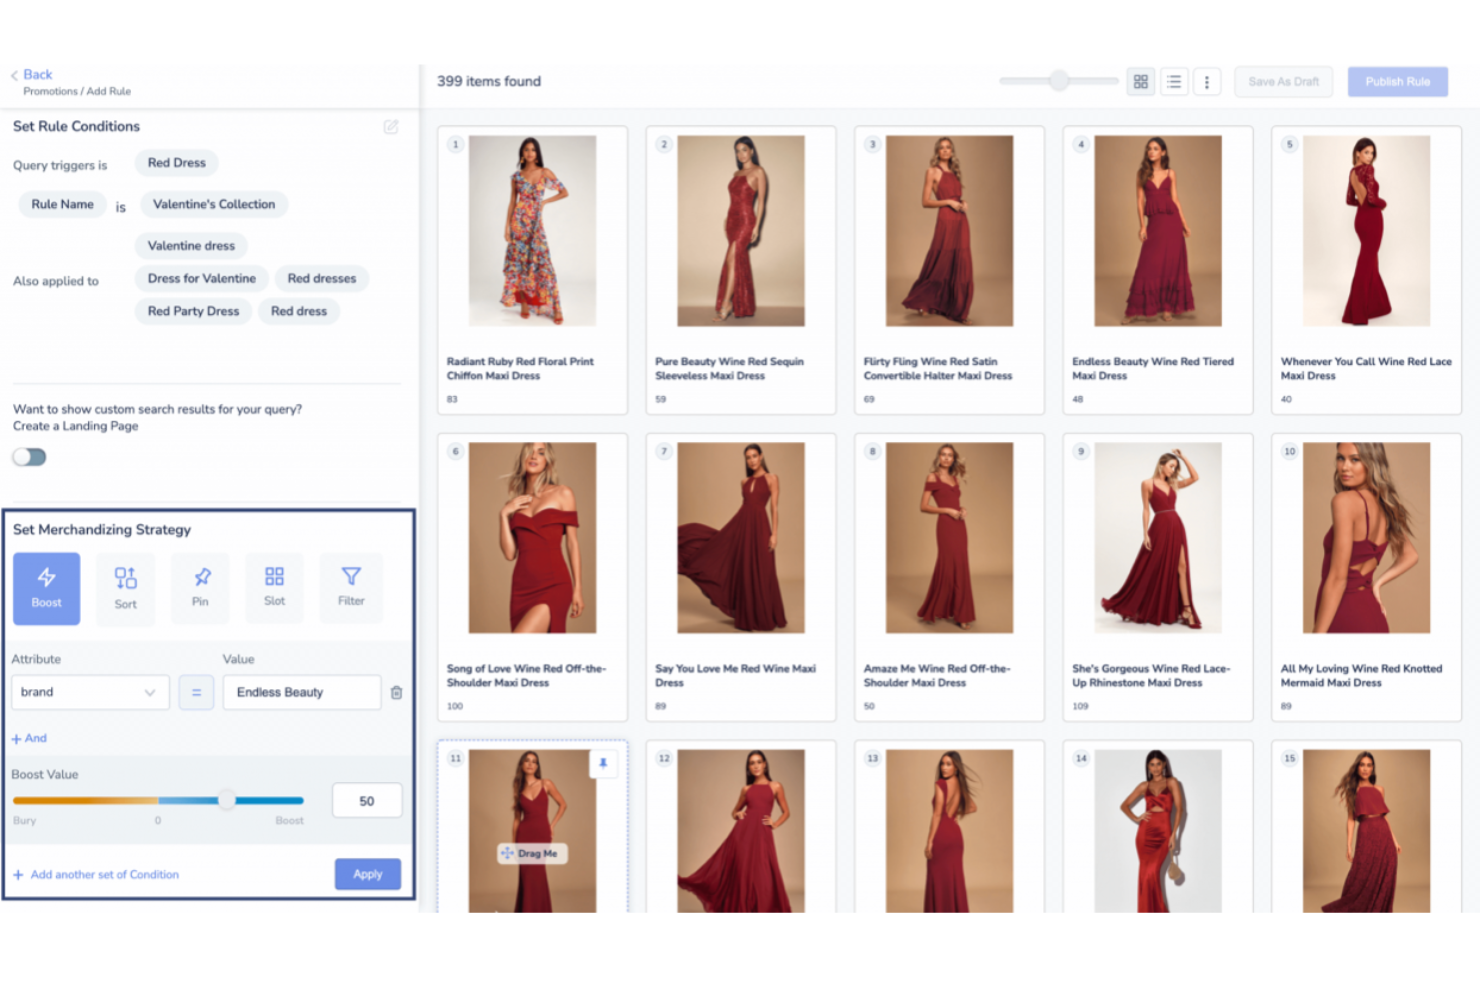
Los minoristas que buscan aumentar el descubrimiento de productos y las tasas de conversión pueden considerar Netcore Unbxd para sus necesidades de búsqueda en el sitio. Esta plataforma está diseñada específicamente para el comercio electrónico y ofrece comercialización basada en inteligencia artificial y experiencias de búsqueda personalizadas que van más allá de lo que Elasticsearch suele proporcionar de forma predeterminada. Netcore Unbxd ayuda a los equipos minoristas a abordar desafíos como el ajuste de la relevancia, las recomendaciones dinámicas y las actualizaciones de inventario en tiempo real.
Por qué Netcore Unbxd es una buena alternativa a Elasticsearch
Para las empresas minoristas centradas en optimizar la búsqueda en el sitio para el comercio electrónico, Netcore Unbxd ofrece capacidades especializadas que lo diferencian de Elasticsearch. Elegí Netcore Unbxd porque proporciona recomendaciones de productos impulsadas por inteligencia artificial y herramientas de comercialización adaptadas a las tiendas en línea.
Funciones como la navegación facetada dinámica y la búsqueda en tiempo real con conocimiento del inventario ayudan a los minoristas a ofrecer resultados más relevantes y aumentar las conversiones. Si necesitas una solución de búsqueda creada específicamente para el comercio minorista, esta plataforma aborda desafíos que los motores de búsqueda genéricos suelen pasar por alto.
Funciones principales de Netcore Unbxd
Otras funciones que hacen atractivo a Netcore Unbxd para los equipos de comercio electrónico incluyen:
- Búsqueda visual: Permite a los compradores buscar productos mediante imágenes en lugar de palabras clave.
- Pruebas A/B para la búsqueda: Permite realizar experimentos con algoritmos y configuraciones de búsqueda para medir el impacto en el comportamiento de los usuarios.
- Autocompletado y corrección ortográfica: Proporciona sugerencias en tiempo real y corrige errores tipográficos mientras los usuarios escriben en la barra de búsqueda.
- Panel de análisis: Permite acceder a informes detallados sobre el rendimiento de la búsqueda, las consultas de los usuarios y las métricas de conversión.
Integraciones de Netcore Unbxd
Actualmente, Netcore Unbxd no incluye una lista de integraciones nativas.
Pros and Cons
Pros:
- Las recomendaciones de productos impulsadas por inteligencia artificial se adaptan al comportamiento de los compradores en tiempo real
- La búsqueda visual permite descubrir productos mediante imágenes en sitios de comercio electrónico
- El panel de análisis integrado realiza un seguimiento del rendimiento de la búsqueda y las tasas de conversión
Cons:
- Algunas funciones avanzadas requieren configuración manual o asistencia del proveedor
- La documentación y los recursos de soporte pueden ser difíciles de consultar
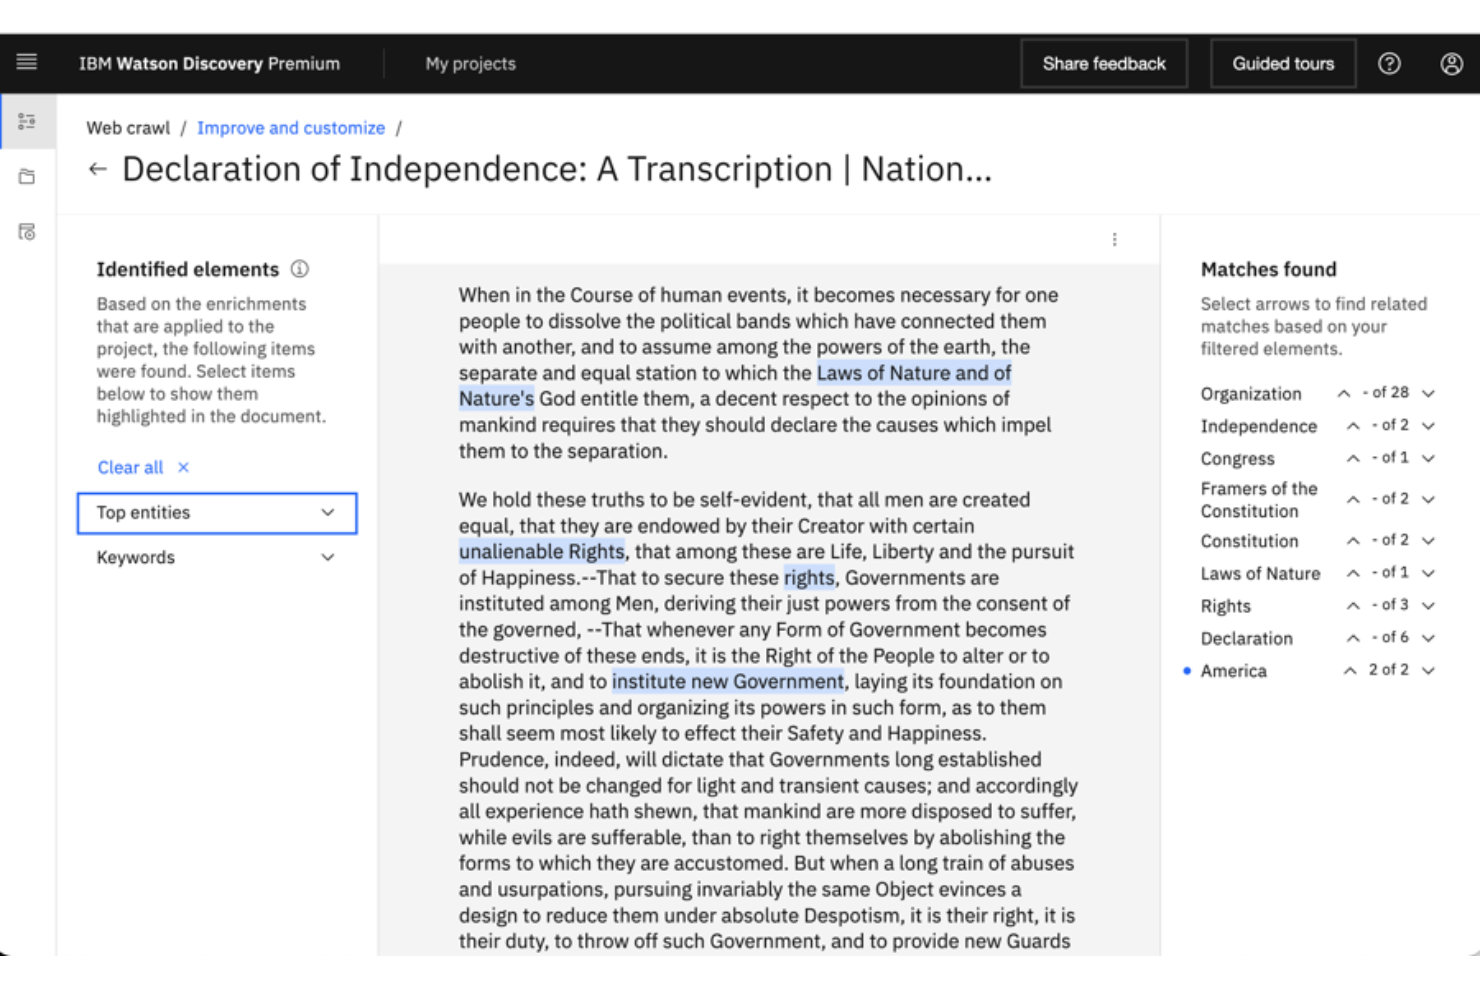
Para los equipos que necesitan extraer información valiosa de grandes volúmenes de documentos no estructurados, IBM Watson Discovery ofrece búsqueda y análisis avanzados impulsados por IA. Es una opción adecuada para empresas, organizaciones de investigación e industrias reguladas que necesitan encontrar información relevante en fuentes de datos complejas.
A diferencia de Elasticsearch, Watson Discovery utiliza el procesamiento del lenguaje natural y el aprendizaje automático para comprender el contexto y ofrecer respuestas más precisas a partir de sus documentos.
Por qué IBM Watson Discovery es una buena alternativa a Elasticsearch
Lo que distingue a IBM Watson Discovery es su enfoque en la obtención de información de documentos impulsada por IA, que va más allá de la búsqueda tradicional por palabras clave. Elegí esta herramienta porque utiliza el procesamiento del lenguaje natural para extraer significado y contexto de los datos no estructurados, lo que facilita encontrar respuestas relevantes en documentos complejos.
Funciones como la recuperación de pasajes y la extracción avanzada de entidades ayudan a los usuarios a encontrar información precisa que los motores de búsqueda estándar podrían pasar por alto. Si su equipo necesita analizar y comprender grandes conjuntos de documentos, Watson Discovery ofrece capacidades difíciles de igualar únicamente con Elasticsearch.
Características principales de IBM Watson Discovery
Otras características de IBM Watson Discovery lo convierten en una opción versátil para la búsqueda y el análisis de documentos:
- Conectores de datos personalizados: Conéctese a una variedad de fuentes de datos, incluido el almacenamiento en la nube y los repositorios de contenido empresarial.
- Enriquecimiento inteligente de documentos: Etiquete y enriquezca automáticamente los documentos con metadatos para mejorar su capacidad de búsqueda.
- Entrenamiento de relevancia: Ajuste los resultados de búsqueda entrenando el sistema según lo que más importa a su organización.
- Panel de análisis integrado: Visualice tendencias y patrones en sus datos con herramientas de análisis integradas.
Integraciones de IBM Watson Discovery
IBM Watson Discovery no incluye actualmente una lista de integraciones nativas.
Pros and Cons
Pros:
- El procesamiento avanzado del lenguaje natural ofrece resultados de búsqueda que tienen en cuenta el contexto
- Los modelos de IA preentrenados extraen entidades y relaciones de los documentos
- Admite la ingesta desde múltiples fuentes de datos, incluidos repositorios en la nube
Cons:
- La configuración inicial y la preparación de datos pueden requerir mucho tiempo en conjuntos de datos grandes
- La personalización de los modelos de IA puede requerir conocimientos especializados

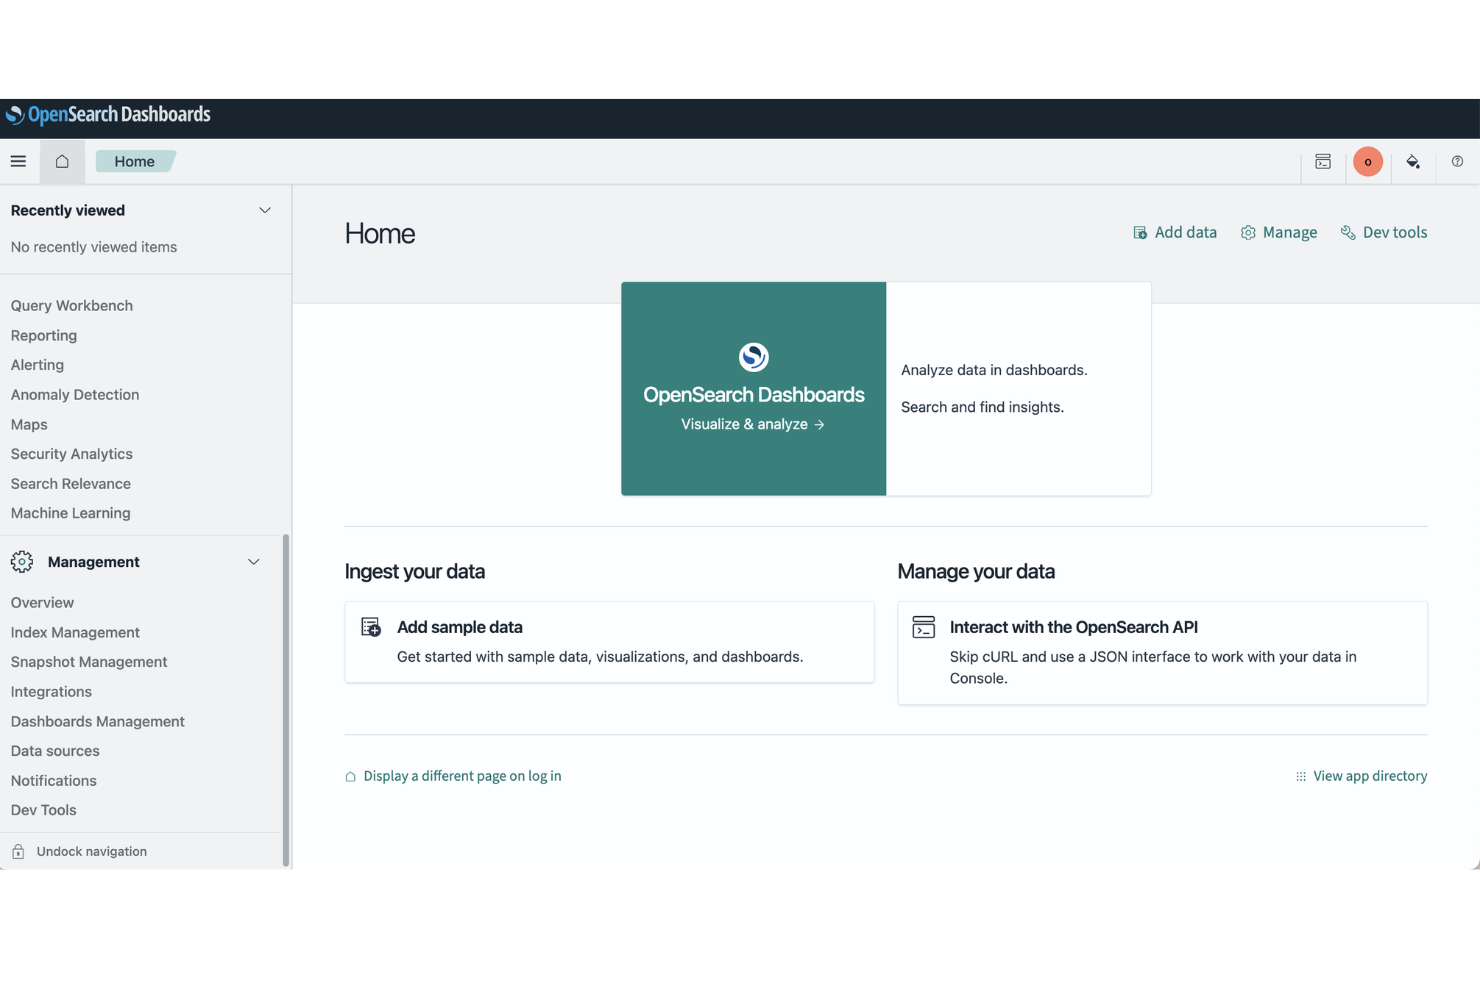
Si buscas un conjunto de herramientas de código abierto para búsqueda y análisis con una gran capacidad de extensibilidad, OpenSearch destaca entre las alternativas a Elasticsearch. Está diseñado para equipos de TI y desarrolladores que desean tener un control total sobre su plataforma de búsqueda, con la flexibilidad necesaria para crear complementos personalizados y adaptar la plataforma a requisitos únicos.
OpenSearch resulta atractivo para las organizaciones que priorizan la transparencia, el desarrollo impulsado por la comunidad y la posibilidad de adaptar las funciones sin depender de un proveedor.
Por qué OpenSearch es una buena alternativa a Elasticsearch
OpenSearch es una opción sólida si deseas que la extensibilidad de código abierto sea el núcleo de tu plataforma de búsqueda. Elegí OpenSearch porque es completamente de código abierto, con un proceso de desarrollo transparente y una arquitectura compatible con complementos que te permite crear o modificar funciones para adaptarlas a tus necesidades.
La plataforma admite complementos personalizados, mejoras impulsadas por la comunidad y acceso directo al código fuente para realizar una personalización profunda. Estas cualidades hacen que OpenSearch resulte especialmente atractivo para los equipos que desean evitar la dependencia de un proveedor y mantener el control total sobre su infraestructura de búsqueda.
Funciones principales de OpenSearch
Algunas otras funciones de OpenSearch lo convierten en una opción flexible para proyectos de búsqueda y análisis:
- Paneles integrados: OpenSearch Dashboards proporciona herramientas de visualización para supervisar y analizar los datos de búsqueda.
- Marco de alertas: La plataforma incluye alertas integradas para notificar a los equipos sobre anomalías o incumplimientos de umbrales.
- Detección de anomalías: La detección de anomalías basada en aprendizaje automático ayuda a identificar patrones inusuales en tus flujos de datos.
- Control de acceso detallado: Puedes establecer permisos y roles detallados para gestionar el acceso de los usuarios y la seguridad de los datos.
Integraciones de OpenSearch
Compatible con las API de Elasticsearch, admite complementos, paneles e integraciones mediante herramientas de un ecosistema abierto.
Pros and Cons
Pros:
- La licencia completamente de código abierto permite un uso y una modificación sin restricciones
- El desarrollo activo de la comunidad impulsa actualizaciones frecuentes y nuevas funciones
- Los paneles integrados proporcionan visualización y supervisión sin herramientas adicionales
Cons:
- Menos integraciones nativas en comparación con las plataformas de búsqueda comerciales
- La documentación puede quedar rezagada con respecto a las nuevas versiones y los complementos de la comunidad


Si buscas una única plataforma para gestionar tanto registros como métricas, OpenObserve ofrece análisis unificado. Está diseñada para equipos de TI, ingenieros de DevOps y SREs que quieren consolidar los datos de observabilidad sin gestionar herramientas independientes. OpenObserve se diferencia de las alternativas a Elasticsearch al ofrecer compatibilidad nativa con la ingestión, el almacenamiento y las consultas de registros y métricas en un mismo sistema.
Por qué OpenObserve es una buena alternativa a Elasticsearch
OpenObserve adopta un enfoque diferente al combinar el análisis de registros y métricas en una sola plataforma, algo que considero especialmente valioso para la observabilidad unificada. A diferencia de Elasticsearch, que a menudo requiere herramientas o complementos independientes para las métricas, OpenObserve ingiere, almacena y consulta ambos tipos de datos de forma nativa y conjunta.
Este modelo unificado ayuda a los equipos de TI y a los SREs a correlacionar eventos y datos de rendimiento sin cambiar de sistema. Si quieres simplificar tu pila de observabilidad y reducir la carga operativa, OpenObserve ofrece una alternativa especializada.
Características clave de OpenObserve
Algunas otras características de OpenObserve la convierten en una opción flexible para la observabilidad y el análisis:
- Lenguaje de consulta similar a SQL: Consulta tus datos utilizando una sintaxis SQL familiar tanto para registros como para métricas.
- Control de acceso basado en roles: Gestiona los permisos de los usuarios y el acceso a los datos con RBAC integrado.
- Políticas de retención de datos: Establece períodos de retención personalizados para diferentes flujos de datos con el fin de optimizar el almacenamiento.
- Compatibilidad con almacenamiento de objetos compatible con S3: Almacena los datos en S3 o en sistemas de almacenamiento de objetos compatibles para obtener escalabilidad y durabilidad.
Integraciones de OpenObserve
OpenObserve ofrece consultas basadas en API y SQL, con integraciones centradas en las canalizaciones de observabilidad y los sistemas de almacenamiento de objetos.
Pros and Cons
Pros:
- La plataforma unificada gestiona de forma nativa el análisis de registros y métricas
- El lenguaje de consulta similar a SQL simplifica las búsquedas en los datos de observabilidad
- La compatibilidad con almacenamiento S3 permite una retención de datos rentable
Cons:
- Tiene menos integraciones nativas en comparación con las plataformas de observabilidad consolidadas
- Las opciones de visualización son menos amplias que en Grafana o Kibana
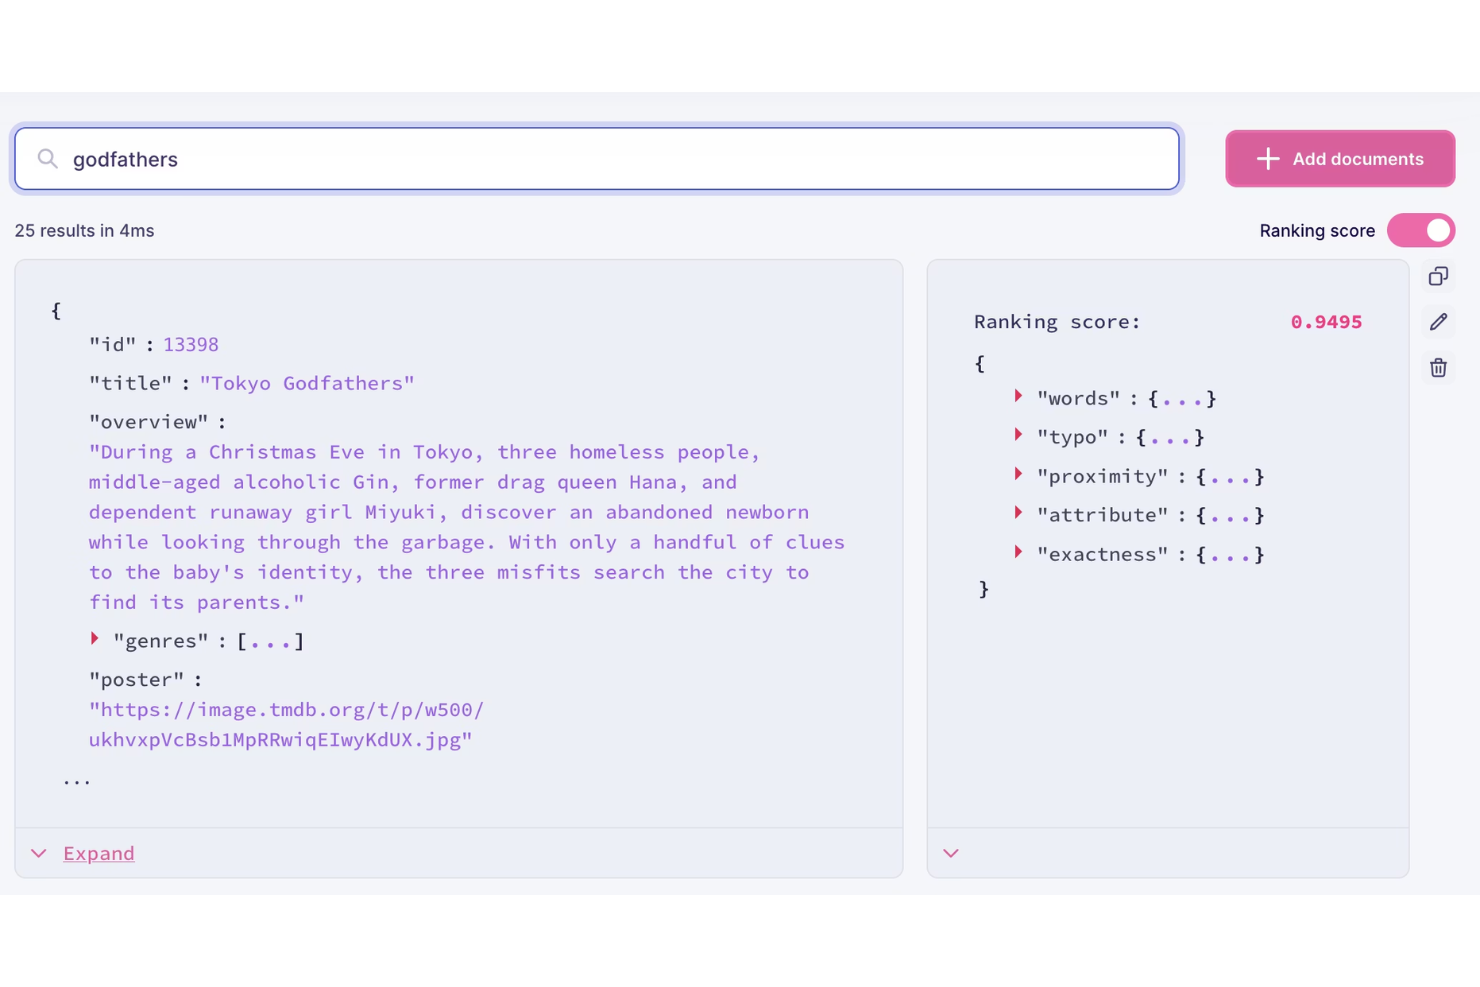
Meilisearch ofrece un motor de búsqueda ligero y de código abierto diseñado para equipos que necesitan una funcionalidad de búsqueda rápida y fácil de implementar. Su configuración sencilla y sus resultados de búsqueda instantáneos lo convierten en una opción ideal para desarrolladores que crean aplicaciones orientadas a los usuarios o herramientas internas. Si buscas una solución que priorice la velocidad y la facilidad de uso por encima de las configuraciones complejas, Meilisearch destaca frente a Elasticsearch y otras alternativas.
Por qué Meilisearch es una buena alternativa a Elasticsearch
Lo que distingue a Meilisearch como alternativa a Elasticsearch es su enfoque en ofrecer implementaciones de búsqueda ultrarrápidas. Lo elijo para equipos que necesitan resultados de búsqueda instantáneos gracias a su índice en memoria y sus actualizaciones en tiempo real. Meilisearch admite la tolerancia a errores tipográficos y reglas de clasificación personalizables desde el primer momento, lo que ayuda a los usuarios a obtener rápidamente resultados relevantes. Estas características lo hacen especialmente atractivo para proyectos en los que la velocidad y la capacidad de respuesta son prioridades principales.
Características principales de Meilisearch
Otras características de Meilisearch lo convierten en una opción flexible para distintas necesidades de búsqueda:
- API RESTful: Meilisearch proporciona una API RESTful sencilla para facilitar la integración con aplicaciones web y móviles.
- Búsqueda facetada: La plataforma admite el filtrado facetado, lo que permite a los usuarios refinar los resultados de búsqueda por categorías o atributos.
- Compatibilidad con varios idiomas: Meilisearch gestiona varios idiomas, por lo que resulta adecuada para aplicaciones globales.
- Gestión de sinónimos: Puedes definir sinónimos personalizados para mejorar la relevancia de las búsquedas y la experiencia del usuario.
Integraciones de Meilisearch
Las integraciones nativas incluyen SDK para .NET, Dart, Go, Java, JavaScript, PHP, Python, Ruby, Rust y Swift.
Pros and Cons
Pros:
- Proporciona resultados de búsqueda extremadamente rápidos para conjuntos de datos pequeños y medianos
- Ofrece tolerancia a errores tipográficos y compatibilidad con sinónimos desde el primer momento
- Proceso de implementación sencillo que requiere una configuración mínima
Cons:
- Carece de las funciones avanzadas de análisis y agregación disponibles en Elasticsearch
- No admite agrupación distribuida para implementaciones a gran escala

Los desarrolladores que buscan un motor de búsqueda sencillo y centrado en API suelen recurrir a Typesense. Esta solución de código abierto está diseñada para equipos que quieren una configuración rápida, un escalado sencillo y una carga operativa mínima en comparación con Elasticsearch. Typesense destaca por sus API intuitivas y su indexación en tiempo real, lo que lo convierte en una opción sólida para proyectos en los que la experiencia del desarrollador y la implementación rápida son prioritarias.
Por qué Typesense es una buena alternativa a Elasticsearch
Si quieres un motor de búsqueda con API fáciles de usar para desarrolladores, vale la pena considerar Typesense. Elegí Typesense porque sus API basadas en REST y JSON facilitan la integración y la gestión de la funcionalidad de búsqueda sin configuraciones complejas.
La plataforma también ofrece indexación instantánea de búsquedas y tolerancia automática a errores tipográficos, lo que ayuda a los equipos a ofrecer resultados rápidos y relevantes con una configuración mínima. Estas características convierten a Typesense en una opción sólida para proyectos en los que la productividad de los desarrolladores y una implementación sencilla son prioridades.
Características principales de Typesense
Otras características de Typesense lo convierten en una opción flexible para equipos que desarrollan aplicaciones basadas en búsquedas:
- Búsqueda facetada: Typesense admite búsquedas facetadas, lo que permite a los usuarios filtrar los resultados por múltiples atributos.
- Gestión de sinónimos: Puedes definir sinónimos personalizados para mejorar la precisión de las búsquedas y la experiencia del usuario.
- Alta disponibilidad integrada: La plataforma ofrece replicación y conmutación por error integradas para garantizar la fiabilidad.
- Licencia de código abierto: Typesense está disponible bajo una licencia de código abierto, lo que permite el alojamiento propio y la personalización.
Integraciones de Typesense
Entre las integraciones se incluyen Laravel, Symfony, Gatsby, Firebase, Twilio, Adobe Commerce, WooCommerce, Prepr y muchas más.
Pros and Cons
Pros:
- El diseño de la API es sencillo y coherente para una integración rápida
- La indexación en tiempo real permite actualizaciones instantáneas de los datos de búsqueda
- La tolerancia a errores tipográficos integrada mejora la precisión de las búsquedas para los usuarios
Cons:
- Carece de funciones nativas avanzadas de análisis y creación de paneles
- No ofrece compatibilidad integrada con agregaciones complejas ni consultas anidadas
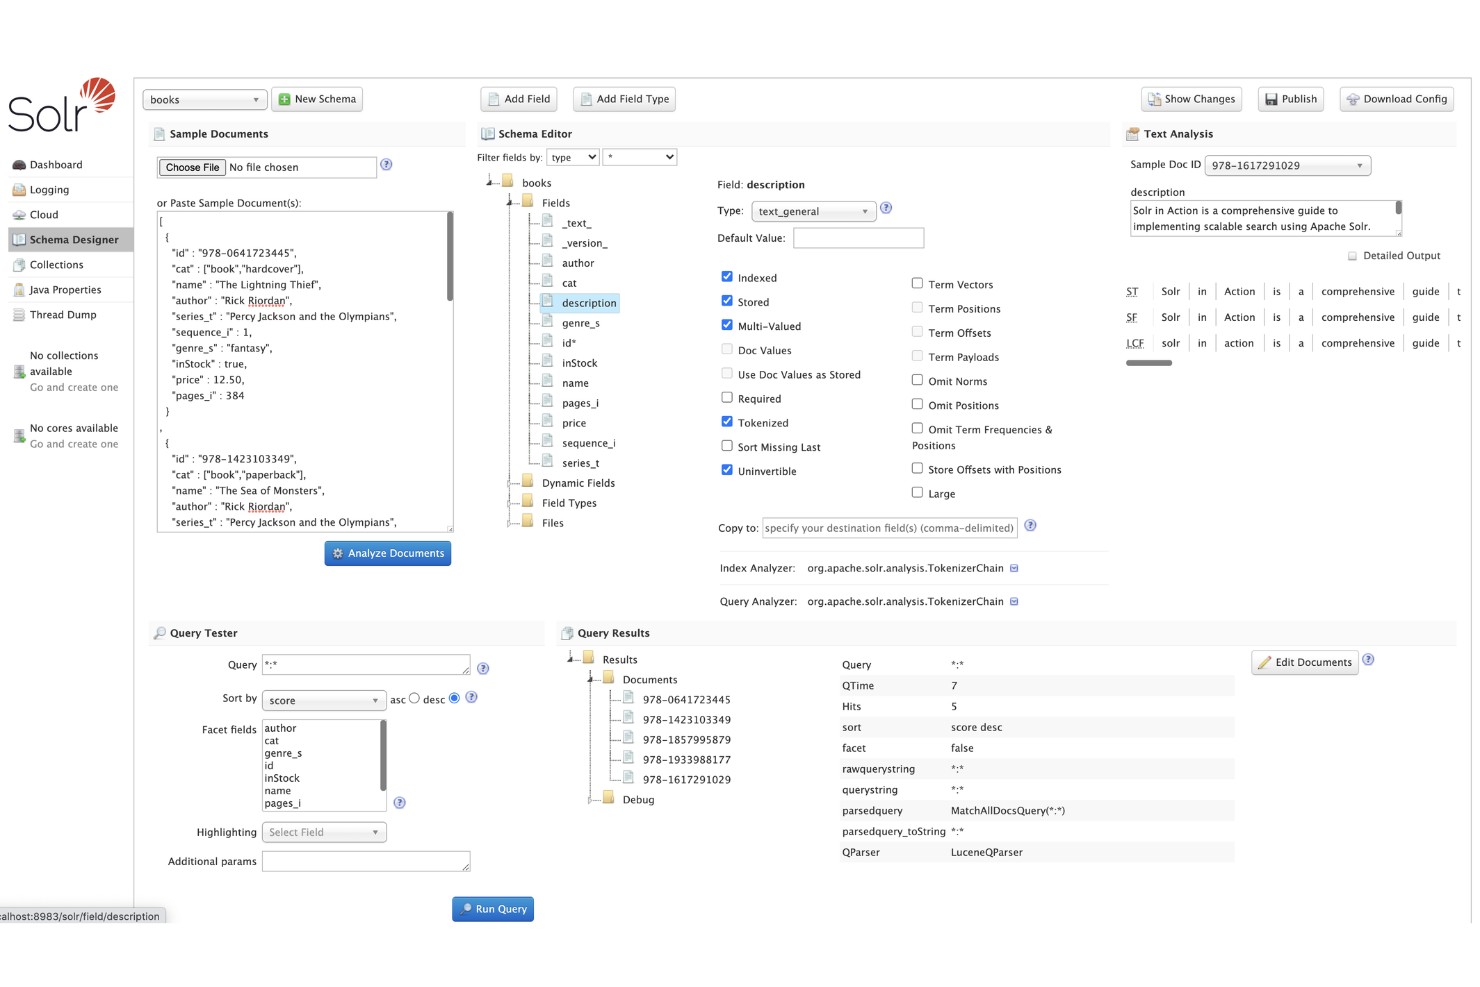
Las organizaciones con grandes necesidades de escalabilidad y fiabilidad suelen considerar Apache Solr para su infraestructura de búsqueda empresarial. Solr está diseñado para implementaciones a gran escala y ofrece indexación distribuida, fragmentación y replicación que permiten una alta disponibilidad y gestionar volúmenes masivos de datos.
Su arquitectura flexible y su ecosistema maduro lo convierten en una opción sólida para los equipos de TI que gestionan entornos de búsqueda complejos y críticos para la misión, más allá de lo que Elasticsearch suele ofrecer de forma predeterminada.
Por qué Apache Solr es una buena alternativa a Elasticsearch
Para los equipos que priorizan la escalabilidad de nivel empresarial, Apache Solr ofrece una arquitectura probada para gestionar cargas de trabajo de búsqueda masivas. Elegí Solr porque sus funciones de indexación distribuida, fragmentación y replicación están diseñadas para admitir una alta disponibilidad y un escalado horizontal en grandes clústeres.
La gestión flexible de esquemas y las opciones avanzadas de almacenamiento en caché de Solr también ayudan a los equipos de TI a ajustar el rendimiento en entornos complejos con gran cantidad de datos. Estas capacidades hacen de Solr una opción adecuada para las organizaciones que necesitan búsquedas fiables a gran escala, más allá de lo que Elasticsearch puede ofrecer de forma predeterminada.
Características principales de Apache Solr
Otras características de Solr lo convierten en una opción versátil para proyectos de búsqueda empresarial:
- Capacidades de búsqueda de texto completo: Solr admite análisis de texto avanzado, tokenización y derivación para obtener resultados de búsqueda precisos.
- Arquitectura de complementos extensible: Puedes añadir complementos personalizados para ampliar la funcionalidad principal de Solr en casos de uso especializados.
- Búsqueda geoespacial: Solr incluye compatibilidad integrada con consultas basadas en la ubicación y la indexación de datos espaciales.
- Gestión avanzada de documentos: La plataforma puede indexar y buscar una amplia variedad de formatos de documentos, incluidos archivos XML, JSON y de texto enriquecido.
Integraciones de Apache
Integración basada en API mediante API similares a REST, con complementos y conectores desarrollados a través de su ecosistema y mediante desarrollo personalizado.
Pros and Cons
Pros:
- La arquitectura distribuida admite una alta disponibilidad y despliegues a gran escala
- El diseño flexible de esquemas permite trabajar con modelos de datos complejos y en evolución
- El análisis de texto avanzado y la tokenización mejoran la precisión de las búsquedas
Cons:
- La documentación puede estar fragmentada entre distintas versiones y fuentes de la comunidad
- Actualizar entre versiones principales puede requerir un esfuerzo considerable de migración
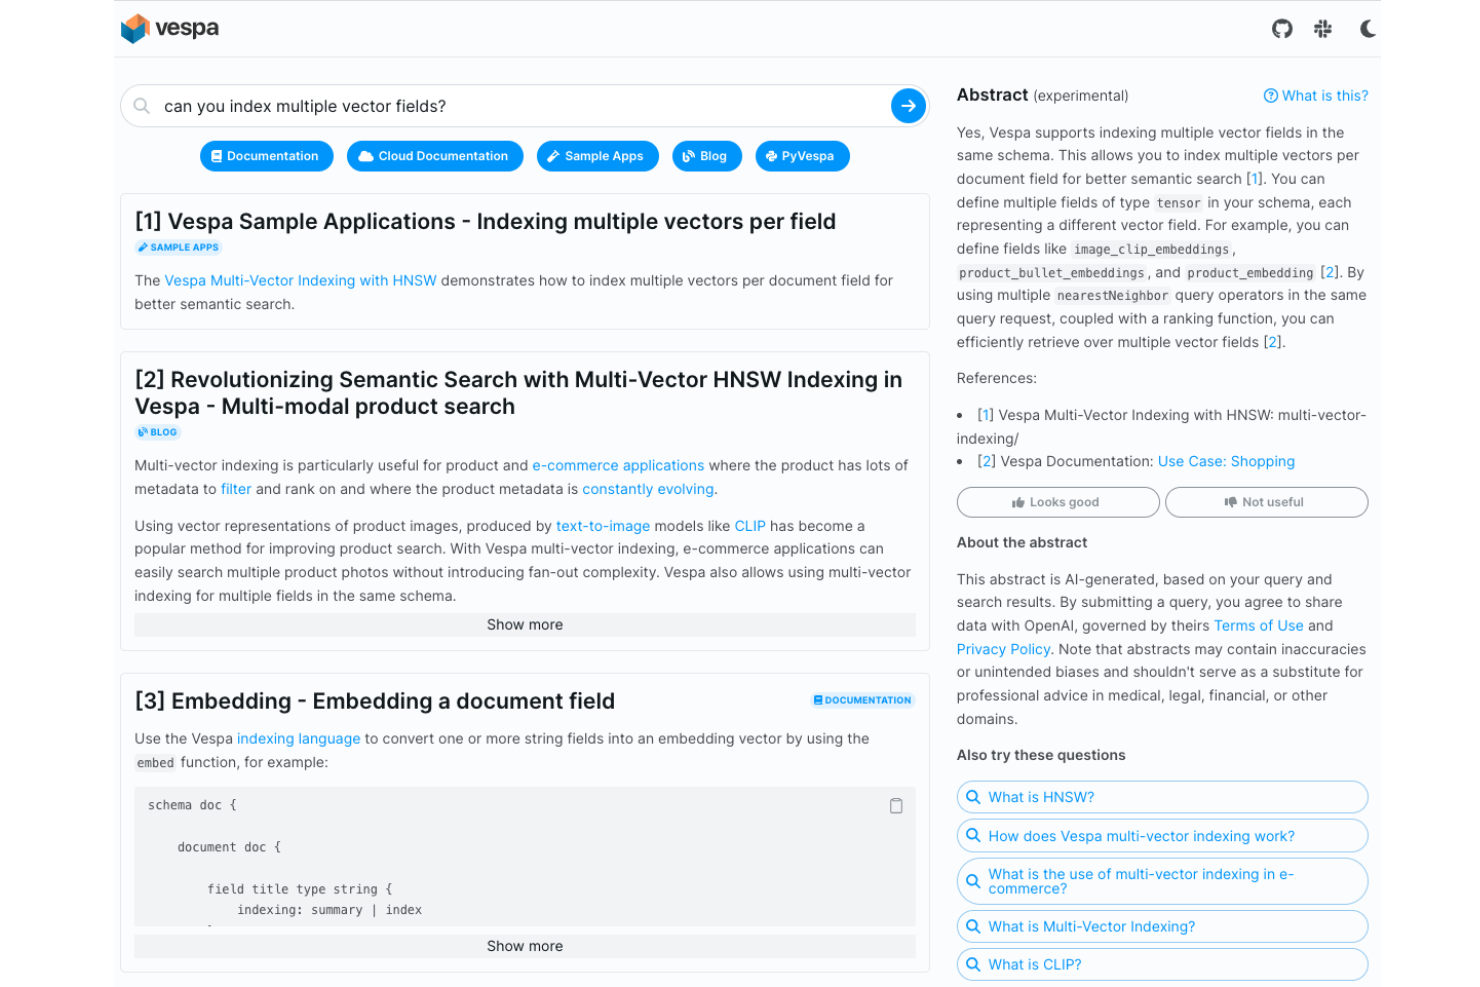
Para los equipos que gestionan conjuntos de datos masivos y que cambian rápidamente, Vespa ofrece un motor de procesamiento de macrodatos en tiempo real que va más allá de la búsqueda tradicional. Está diseñado para especialistas en TI e ingenieros de datos que necesitan combinar búsqueda, recomendaciones y análisis sobre datos activos a gran escala. Vespa se diferencia de las alternativas a Elasticsearch al admitir un procesamiento de baja latencia y alto rendimiento para consultas complejas y modelos de aprendizaje automático directamente sobre datos en transmisión.
Por qué Vespa es una buena alternativa a Elasticsearch
Vespa destaca por su procesamiento de macrodatos en tiempo real, una necesidad clave para las organizaciones que trabajan con conjuntos de datos de gran volumen y alta velocidad. Elegí Vespa porque puede ejecutar consultas complejas, recomendaciones e inferencias de aprendizaje automático directamente sobre datos activos a medida que llegan.
La arquitectura de la plataforma está diseñada para operaciones de baja latencia y alto rendimiento, lo que la hace adecuada para casos de uso como la personalización, la detección de fraudes y la búsqueda a gran escala. Estas capacidades convierten a Vespa en una sólida alternativa a Elasticsearch cuando se necesita algo más que búsqueda: análisis y toma de decisiones en tiempo real sobre datos actualizados.
Características principales de Vespa
Otras características de Vespa la convierten en una opción versátil para entornos de datos exigentes:
- Compatibilidad nativa con tensores: Vespa procesa y almacena estructuras de datos tensoriales para casos de uso avanzados de clasificación e inferencia de aprendizaje automático.
- Canalizaciones de procesamiento de documentos: La plataforma incluye canalizaciones integradas para incorporar, transformar e indexar documentos.
- Gestión flexible de esquemas: Puede definir y actualizar esquemas de datos dinámicamente sin tiempo de inactividad.
- Control de acceso integrado: Vespa proporciona un control de acceso basado en roles para gestionar los permisos de los usuarios y la seguridad de los datos.
Integraciones de Vespa
Las integraciones se basan en un enfoque centrado en las API y son compatibles con aplicaciones personalizadas, canalizaciones de datos e integraciones de aprendizaje automático.
Pros and Cons
Pros:
- El procesamiento en tiempo real permite análisis de baja latencia sobre datos en transmisión
- La compatibilidad nativa con tensores permite realizar inferencias avanzadas de aprendizaje automático
- La licencia de código abierto proporciona acceso completo al código fuente
Cons:
- Requiere una infraestructura considerable para lograr un rendimiento óptimo a gran escala
- La configuración inicial puede ser compleja para los usuarios nuevos
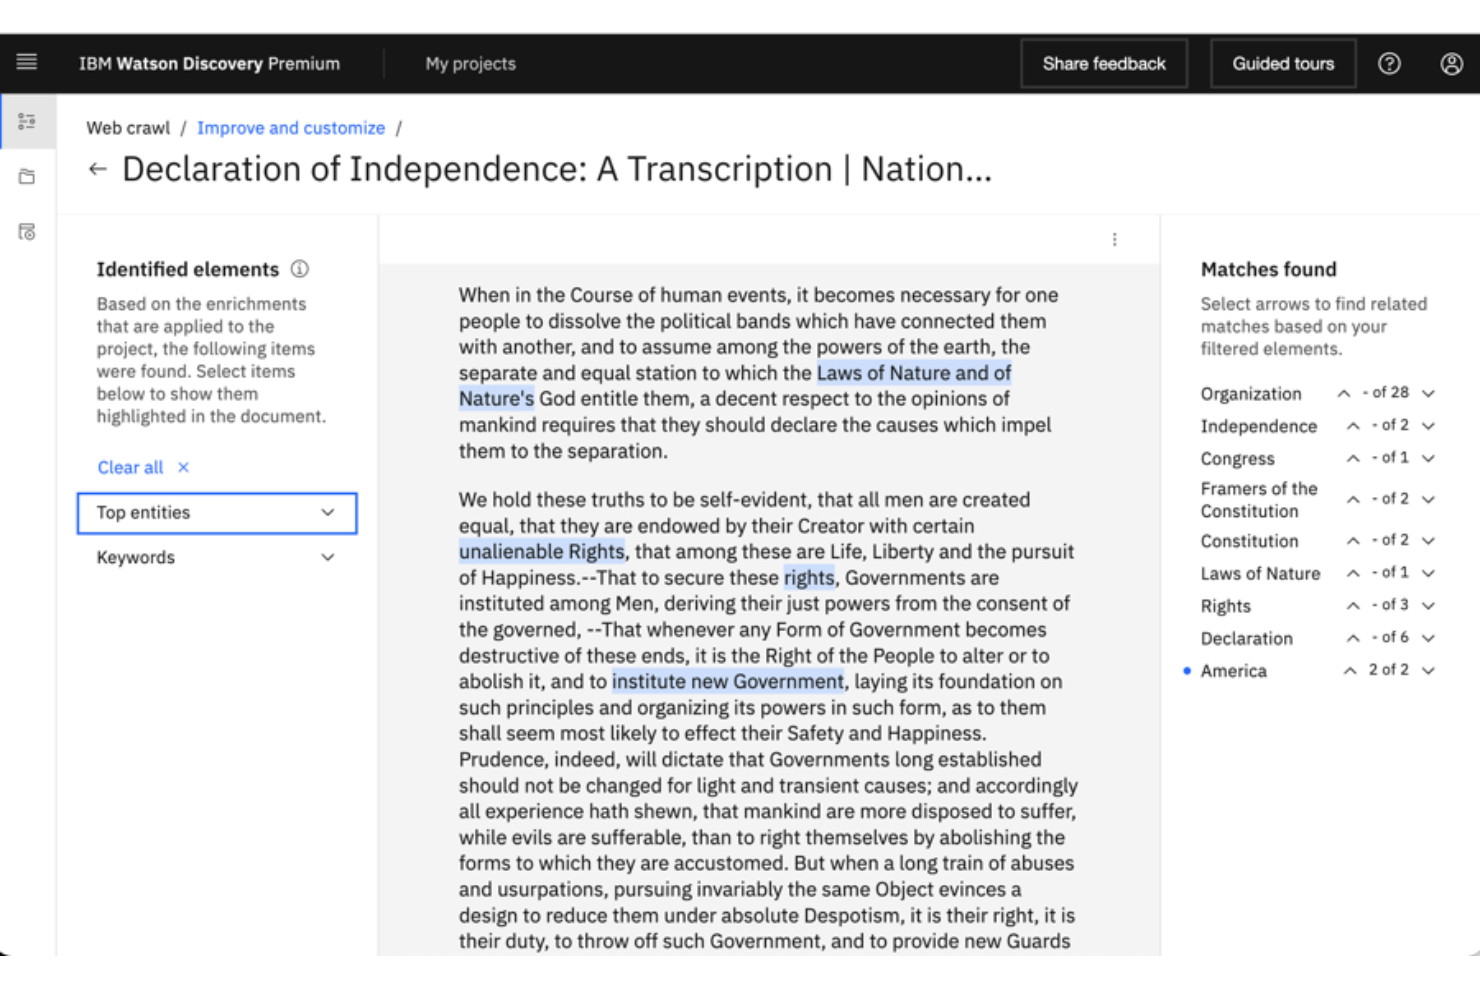
Para los equipos que necesitan extraer información de grandes volúmenes de documentos no estructurados, IBM Watson Discovery ofrece búsqueda y análisis avanzados basados en IA. Es una opción muy adecuada para empresas, organizaciones de investigación y sectores regulados que necesitan encontrar información relevante en fuentes de datos complejas.
A diferencia de Elasticsearch, Watson Discovery utiliza procesamiento del lenguaje natural y aprendizaje automático para comprender el contexto y ofrecer respuestas más precisas a partir de sus documentos.
Por qué IBM Watson Discovery es una buena alternativa a Elasticsearch
Lo que distingue a IBM Watson Discovery es su enfoque en la obtención de información de documentos basada en IA, que va más allá de la búsqueda tradicional por palabras clave. Elegí esta herramienta porque utiliza el procesamiento del lenguaje natural para extraer significado y contexto de los datos no estructurados, lo que facilita encontrar respuestas relevantes en documentos complejos.
Funciones como la recuperación de pasajes y la extracción avanzada de entidades ayudan a los usuarios a encontrar información precisa que los motores de búsqueda estándar podrían pasar por alto. Si su equipo necesita analizar y comprender grandes conjuntos de documentos, Watson Discovery ofrece capacidades difíciles de igualar con Elasticsearch por sí solo.
Funciones principales de IBM Watson Discovery
Algunas otras funciones de IBM Watson Discovery lo convierten en una opción versátil para la búsqueda y el análisis de documentos:
- Conectores de datos personalizados: Conéctese a una variedad de fuentes de datos, incluido el almacenamiento en la nube y los repositorios de contenido empresariales.
- Enriquecimiento inteligente de documentos: Etiquete y enriquezca automáticamente los documentos con metadatos para mejorar su capacidad de búsqueda.
- Entrenamiento de relevancia: Ajuste los resultados de búsqueda entrenando el sistema con lo que más importa a su organización.
- Panel de análisis integrado: Visualice tendencias y patrones en sus datos con herramientas de análisis integradas.
Integraciones de IBM Watson Discovery
IBM Watson Discovery no incluye actualmente una lista de integraciones nativas.
Pros and Cons
Pros:
- El procesamiento avanzado del lenguaje natural ofrece resultados de búsqueda sensibles al contexto
- Los modelos de IA preentrenados extraen entidades y relaciones de los documentos
- Admite la ingesta desde múltiples fuentes de datos, incluidos repositorios en la nube
Cons:
- La configuración inicial y la preparación de datos pueden llevar mucho tiempo en grandes conjuntos de datos
- La personalización de los modelos de IA puede requerir conocimientos especializados
Otras alternativas a Elasticsearch
Estas son algunas opciones adicionales de alternativas a Elasticsearch que no llegaron a mi lista corta, pero que aún merece la pena consultar:
- FactFinder
Ideal para el descubrimiento de productos en el comercio electrónico
- Microsoft Azure AI Search
Ideal para una integración fluida con la nube
- SigNoz
Mejor con herramientas de observabilidad integradas


Cómo evalúo las alternativas a Elasticsearch
Desde reemplazar clústeres de Elastic con licencia SSPL hasta impulsar la búsqueda vectorial en aplicaciones de IA, primero evalúo las herramientas según las capacidades de búsqueda imprescindibles y después según factores diferenciadores como el TCO y las opciones de implementación.
Funcionalidad principal (requisitos básicos para esta lista)
Cuando selecciono herramientas para mi lista, califico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (sobresale en esta área) para cada funcionalidad principal que se indica a continuación. Después, convierto la puntuación total de la herramienta en un porcentaje. Cada herramienta debe alcanzar una puntuación total mínima del 65% para ser considerada para su inclusión.
- Motor de búsqueda de texto completo: Evalúo cómo gestiona cada herramienta la tokenización, la derivación de palabras, los analizadores y la puntuación de relevancia; por ejemplo, la coincidencia difusa en catálogos de productos o la búsqueda de documentos multilingües.
- Arquitectura distribuida y escalable: El escalado horizontal, la fragmentación y la replicación son importantes cuando el índice crece de millones a miles de millones de documentos, por lo que compruebo cómo gestiona cada herramienta la formación de clústeres.
- API RESTful y DSL de consultas: Una API REST bien documentada y un lenguaje de consultas expresivo son lo que sus ingenieros utilizan a diario, por lo que busco una construcción flexible de consultas y disponibilidad de SDK de cliente.
- Indexación en tiempo real: Compruebo con qué rapidez los documentos nuevos se pueden buscar después de su ingesta, especialmente en casos de uso como el seguimiento de pedidos en directo o la supervisión de eventos de seguridad, donde los datos obsoletos representan un problema.
- Compatibilidad con registros y análisis: Herramientas como OpenSearch y Zinc gestionan la agregación de registros, por lo que evalúo en qué medida cada plataforma admite la ingesta de registros estructurados, las agregaciones y los flujos de trabajo de observabilidad.
- Indexación de varios tipos de datos: Además del texto, analizo la compatibilidad con tipos de datos numéricos, geoespaciales y vectoriales, especialmente para equipos que desarrollan búsquedas híbridas o aplicaciones sensibles a la ubicación.
Una vez que tengo una lista de herramientas que cumplen estos criterios, considero qué distingue a cada plataforma.
Factores diferenciadores (lo que distingue a los proveedores)
Así es como comparo y contrasto los distintos proveedores:
Características destacadas
Las capacidades de búsqueda vectorial y semántica son cada vez más importantes a medida que los equipos desarrollan canalizaciones RAG y sistemas de recuperación basados en IA, por lo que evalúo cómo gestiona cada herramienta las consultas kNN y la recuperación híbrida léxica/vectorial. También es importante contar con una oferta en la nube gestionada: los equipos que quieren evitar la gestión de clústeres se benefician de plataformas como Meilisearch Cloud o Amazon OpenSearch Serverless. También busco compatibilidad con consultas SQL, que permite a los analistas consultar datos indexados sin aprender un DSL propietario.
Más allá de las características
La licencia es una de las primeras cosas que compruebo. El cambio de Apache 2.0 a SSPL es lo que llevó inicialmente a muchos equipos a explorar alternativas como OpenSearch, por lo que examino detenidamente las condiciones de licencia y el modelo de gobernanza de cada herramienta. La compatibilidad con el ecosistema también es importante: evalúo si las canalizaciones de Logstash existentes, los agentes Beats o los recopiladores de OpenTelemetry funcionan sin necesidad de realizar cambios importantes. La flexibilidad de implementación completa mi evaluación, especialmente para los equipos de sectores regulados que necesitan opciones locales, aisladas o híbridas.
¿Por qué buscar una alternativa a Elasticsearch?
Aunque Elasticsearch es una buena opción entre las alternativas a Elasticsearch, hay varias razones por las que algunos usuarios buscan soluciones alternativas. Es posible que busques una alternativa a Elasticsearch porque…
- Gestionar y escalar clústeres requiere una experiencia interna considerable
- El ajuste de relevancia integrado es limitado para casos de uso de comercio electrónico o venta minorista
- Las funciones avanzadas de análisis y generación de informes no están incluidas de forma predeterminada
- Falta compatibilidad nativa con la búsqueda vectorial o de imágenes
- Los costes de licencias y asistencia pueden ser impredecibles a gran escala
- Las integraciones con plataformas específicas de comercio electrónico o análisis son limitadas
Si alguna de estas situaciones te resulta familiar, has llegado al lugar adecuado. Mi lista incluye varias opciones alternativas a Elasticsearch más adecuadas para equipos que afrontan estos desafíos con Elasticsearch y buscan soluciones alternativas.
Características clave de Elasticsearch
Estas son algunas de las características clave de Elasticsearch, para ayudarte a contrastar y comparar lo que ofrecen las soluciones alternativas:
- Búsqueda de texto completo con compatibilidad para consultas complejas
- Indexación y recuperación de datos en tiempo real
- Arquitectura distribuida para el escalado horizontal
- API RESTful para la integración con otros sistemas
- Compatibilidad con datos estructurados y no estructurados
- Capacidades integradas de agregación y análisis
- Control de acceso basado en roles y funciones de seguridad
- Integración con Kibana para la visualización de datos
- Compatibilidad con varios idiomas para implementaciones globales
- Creación y restauración de instantáneas para copias de seguridad y recuperación ante desastres