

Hej og velkommen til endnu et kapitel i serien Ledelse inden for test. I denne uge ser vi på servicetest af webapplikationer. Vi kommer ind på:
- Hvad er servicetest?
- Hvad er ydeevnetest?
- Test af pålidelighed/overgang ved fejl
- Test af servicestyring
Lad os begynde.
Hvad er servicetest?
Kvaliteten af den service, som en webapplikation leverer, kan defineres som omfattende alle dens egenskaber, såsom funktionalitet, ydeevne, pålidelighed, brugervenlighed, sikkerhed og så videre.
Her adskiller vi dog tre specifikke servicemål, som falder ind under det, vi vil kalde »servicetest«. Disse mål er:
- Ydeevne: Servicen skal reagere hurtigt over for brugerne, samtidig med at den understøtter den belastning, den udsættes for.
- Pålidelighed: Hvis servicen er designet til at være modstandsdygtig over for fejl, skal den være pålidelig og/eller fortsætte med at levere en service, selv når der opstår en fejl.
- Håndterbarhed: Servicen skal kunne administreres, konfigureres eller ændres, uden at slutbrugerne bemærker en forringelse af servicen. Håndterbarheds- eller driftstest har til formål at demonstrere, at systemets procedurer for administration, styring samt sikkerhedskopiering og gendannelse fungerer effektivt.
I alle tre tilfælde skal vi simulere brugerbelastning for at gennemføre testene effektivt. Mål for ydeevne, pålidelighed og håndterbarhed eksisterer i en kontekst, hvor rigtige kunder bruger webstedet til at drive forretning.
Et websteds reaktionsevne (i dette tilfælde den tid, det tager for én systemnode at svare på en anden nodes anmodning) er direkte relateret til de ressourcer, der er tilgængelige i den tekniske arkitektur.
Efterhånden som flere kunder bruger servicen, er der færre tekniske ressourcer til rådighed til at behandle hver brugers anmodninger, og svartiderne forringes.
En service, der kun er let belastet, har naturligvis mindre sandsynlighed for at svigte. Meget af kompleksiteten i software og hardware eksisterer for at imødekomme efterspørgslen på ressourcer i den tekniske arkitektur, når et websted er tungt belastet.
Når et websted er belastet (eller overbelastet), skal de modstridende anmodninger om ressourcer håndteres af forskellige infrastrukturkomponenter såsom server- og netværksoperativsystemer, databasestyringssystemer, webserverprodukter, objektanmodningsmæglere, middleware og så videre.
Disse infrastrukturkomponenter er normalt mere pålidelige end den specialudviklede applikationskode, der kræver ressourcen, men der kan opstå fejl i begge dele:
- Infrastrukturkomponenter svigter, fordi applikationskoden (på grund af dårligt design eller dårlig implementering) stiller uforholdsmæssigt store krav til ressourcerne.
- Applikationskomponenterne kan svigte, fordi de ressourcer, de har brug for, ikke altid er tilgængelige (i tide).
Ved at simulere typiske og usædvanlige produktionsbelastninger over en længere periode kan testere afsløre fejl i systemets design eller implementering. Når disse fejl er blevet løst, vil de samme test demonstrere, at systemet er modstandsdygtigt. QA-medarbejdere kan benytte værktøjer til belastningstest til at udføre mange af de processer, der er defineret nedenfor.
På alle services er der normalt en række kritiske styringsprocesser, som skal udføres for at holde servicen kørende uden problemer. Det kan være muligt at lukke en service ned for at udføre rutinemæssig vedligeholdelse uden for normal arbejdstid, men de fleste onlinetjenester fungerer 24 timer i døgnet.
Servicens arbejdsdag slutter aldrig. Det er uundgåeligt, at styringsprocedurer skal udføres, mens servicen er aktiv, og brugerne er på systemet. Disse procedurer skal testes, mens systemet er belastet, for at sikre, at de ikke påvirker den aktive service negativt – altså ydeevnetest.
Have an account? Log In
Hvad er ydeevnetest?
Ydeevnetest er en vigtig del af servicetest. Det er en måde at teste, hvordan et system fungerer med hensyn til reaktionsevne og stabilitet under en bestemt arbejdsbelastning. Her er en oversigt over, hvordan det fungerer:
- Ydeevnetest består af en række test ved varierende belastninger, hvor systemet når en stabil tilstand (belastninger og svartider på konstante niveauer).
- Vi måler belastning og svartider for hver belastning, simuleret over en periode på 15-30 minutter, for at opnå et statistisk signifikant antal målinger.
- Vi overvåger og registrerer de vitale tegn for hver simulerede belastning. Det er de forskellige ressourcer i vores system, f.eks. CPU- og hukommelsesforbrug, netværksbåndbredde, I/O-hastigheder osv.
Vi tegner en graf over disse varierende belastninger i forhold til de svartider, som vores “virtuelle” brugere oplever. Når grafen er tegnet, ser den nogenlunde ud som figuren nedenfor.
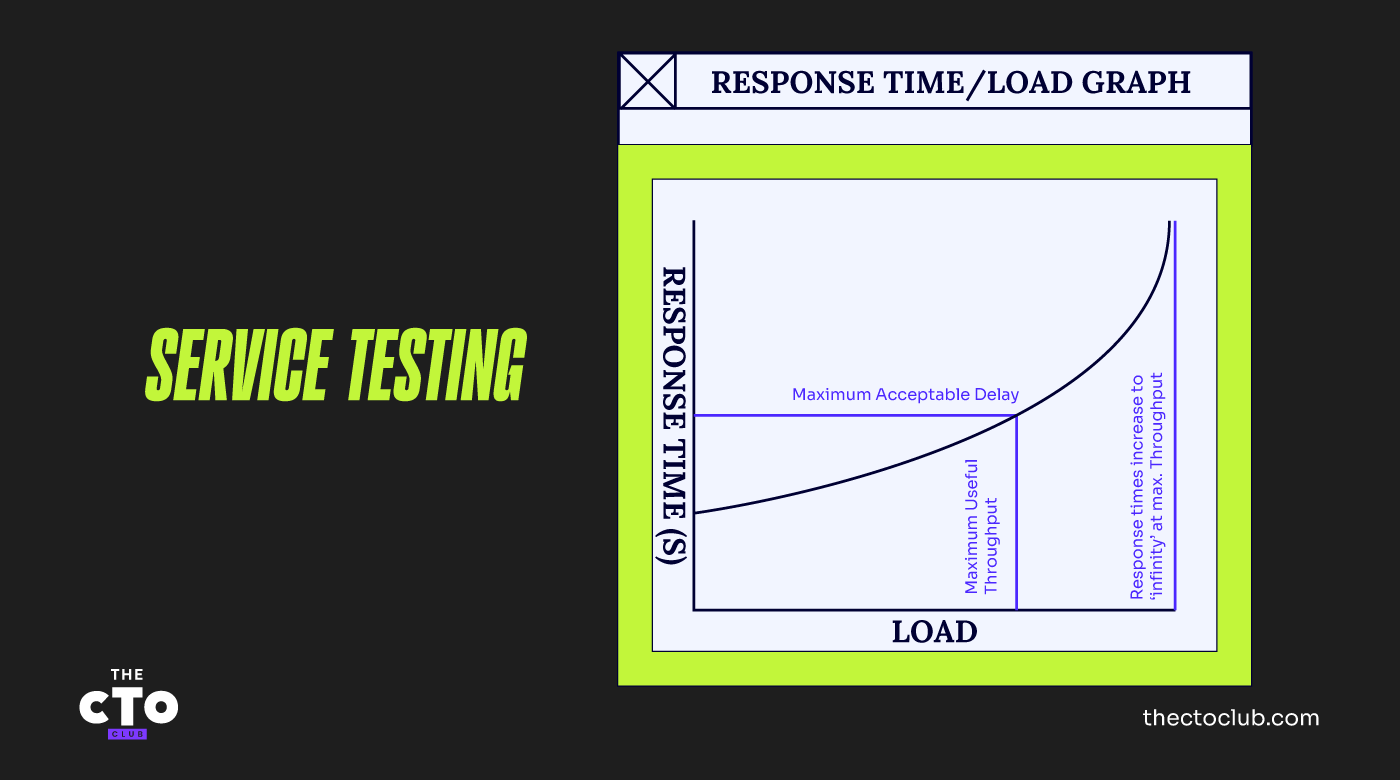
Ved nulbelastning, hvor der kun er en enkelt bruger på systemet, har brugeren hele ressourcen til rådighed, og svartiderne er korte. Når vi indfører stigende belastninger og måler svartiderne, bliver de gradvist dårligere, indtil vi når et punkt, hvor systemet kører med maksimal kapacitet.
På dette tidspunkt er svartiden for vores testtransaktioner teoretisk uendelig, fordi en af systemets vigtigste ressourcer er fuldstændig opbrugt, og der ikke kan behandles flere transaktioner.
Når vi øger belastningerne fra nul til maksimum, overvåger vi også forbruget af forskellige ressourcetyper, f.eks. serverprocessorforbrug, hukommelsesforbrug, netværksbåndbredde, databaselåse osv.
Ved den maksimale belastning er en af disse ressourcer udnyttet 100 %. Denne ressource er den begrænsende ressource, fordi den løber tør først. Svartiderne er naturligvis på dette tidspunkt blevet forringet så meget, at de sandsynligvis er langt langsommere, end hvad der ville være acceptabelt.
Grafen nedenfor viser forbruget/tilgængeligheden af flere ressourcer afbildet i forhold til belastningen.
For at øge gennemløbskapaciteten og/eller reducere svartiderne for et system skal vi gøre en af følgende ting:
- Reducere efterspørgslen efter ressourcen, typisk ved at gøre den software, der bruger ressourcen, mere effektiv (dette er normalt et udvikleransvar).
- Optimere brugen af hardwareressourcen inden for den tekniske arkitektur, f.eks. ved at konfigurere DBMS'et til at cache flere data i hukommelsen eller ved at prioritere nogle processer højere end andre på applikationsserveren.
- Gøre mere af en ressource tilgængelig. Normalt ved at tilføje processorer, hukommelse eller netværksbåndbredde osv.
Som du sikkert allerede er begyndt at indse, kræver ydeevnetest et team af mennesker, der kan hjælpe testerne. Det er tekniske arkitekter, serveradministratorer, netværksadministratorer, udviklere samt database-designere og -administratorer. Disse tekniske eksperter er kvalificerede til at analysere den statistik, der genereres af ressourcemonitoreringsværktøjerne, og vurdere, hvordan applikationen bedst justeres, eller hvordan systemet finindstilles eller opgraderes.
Hvis du er tester, skal du, medmindre du selv er særlig ekspert inden for disse områder, ikke lade dig friste til at lade som om, du kan fortolke denne statistik og træffe beslutninger om finindstilling og optimering. Du skal inddrage disse eksperter tidligt i projektet for at få deres råd og opbakning og senere under testningen for at sikre, at flaskehalse identificeres og løses.
Hold øje med den næste artikel, hvor vi går mere i dybden med, hvordan man håndterer ydeevnetest.
Pålideligheds- og overtagelsestest ved fejl
At sikre kontinuerlig tilgængelighed af en tjeneste er sandsynligvis et vigtigt mål for dit projekt. Pålidelighedstest hjælper med at afdække uklare fejl, der forårsager uventede driftsstop. Test af overtagelse ved fejl hjælper med at sikre, at de indbyggede foranstaltninger til håndtering af forventede fejl faktisk fungerer.
Test af overtagelse ved fejl
Hvor websteder skal være modstandsdygtige og/eller pålidelige, er de typisk designet med pålidelige systemkomponenter med indbygget redundans og funktioner til overtagelse ved fejl, som træder i kraft, når der opstår fejl.
Disse funktioner kan omfatte forskellig netværksrouting, flere servere konfigureret som klynger, middleware og distribueret serviceteknologi, der håndterer belastningsfordeling, samt omdirigering af trafik i fejlsituationer.
Test af overtagelse ved fejl har til formål at undersøge systemets adfærd under udvalgte fejlsituationer før implementering og omfatter normalt følgende:
- Identifikation af de komponenter, der kan svigte og medføre tab af tjeneste (ved at se på fejl indefra og ud).
- Identifikation af de farer, der kan forårsage en fejl og medføre tab af tjeneste (ved at se på trusler udefra og ind).
- En analyse af de fejltilstande eller scenarier, der kan opstå, hvor du har brug for sikkerhed for, at genoprettelsesforanstaltningen vil fungere.
- En automatiseret test, der kan bruges til at belaste systemet og undersøge systemets adfærd over en længere periode.
- Den samme automatiserede test kan også bruges til at belaste systemet under test og overvåge systemets adfærd under fejltilstande.
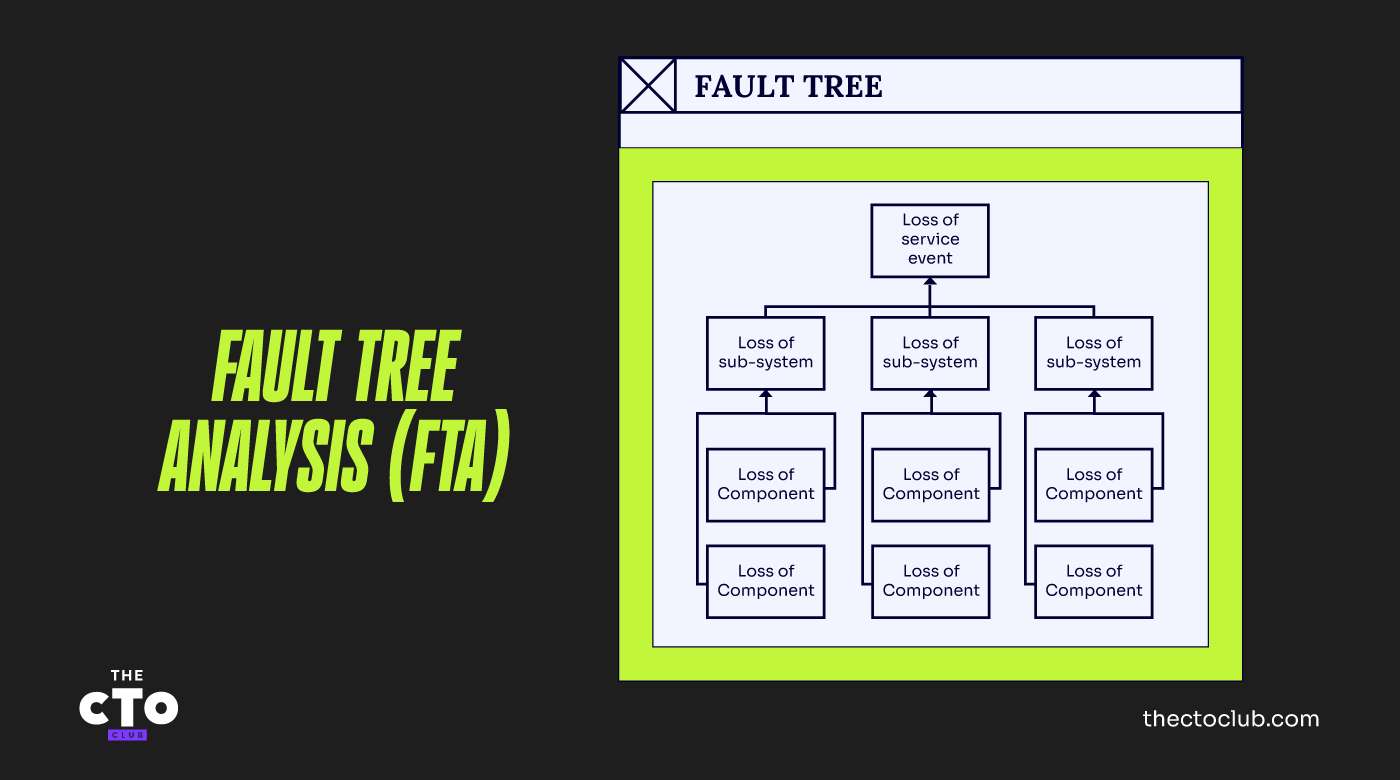
En teknik kaldet fejltræsanalyse (FTA) kan hjælpe dig med at forstå tjenestens afhængigheder af de underliggende komponenter. Fejltræsanalyse og fejltræsdiagrammer er en logisk repræsentation af et system eller en tjeneste samt de måder, hvorpå den kan svigte.
Det enkle skema nedenfor viser forholdet mellem grundlæggende fejl i komponenter, mellemliggende fejl i undersystemer og den øverste hændelse, der repræsenterer en tjenestefejl. Det kan naturligvis være muligt at identificere mere end tre niveauer af fejlhændelser.
Disse tests skal køres med en automatiseret belastning for at undersøge systemets adfærd i produktionssituationer og opnå sikkerhed for, at de indbyggede genoprettelsesforanstaltninger fungerer. Især vil du gerne vide:
- Hvordan opfører arkitekturen sig i fejlsituationer?
- Fungerer belastningsfordelingsfunktionerne korrekt?
- Kan funktionerne til automatisk overtagelse håndtere belastningen, når en komponent svigter?
- Fungerer den automatiske genoprettelse? Indhenter genstartede systemer det forsømte?
I sidste ende fokuserer testene på at afgøre, om tjenesten for slutbrugerne opretholdes, og om brugerne faktisk bemærker, at fejlen opstår.
Pålidelighedstest (eller udholdenhedstest)
Formålet med pålidelighedstest er at kontrollere, at der ikke opstår fejl under belastning.
De fleste hardwarekomponenter er så pålidelige, at deres gennemsnitlige tid mellem fejl kan måles i år. Pålidelighedstest kræver brug (eller genbrug) af automatiserede tests på to måder for at simulere:
- Ekstreme belastninger på specifikke komponenter eller ressourcer i den tekniske arkitektur.
- Forlængede perioder med normale (eller ekstreme) belastninger på hele systemet.
Når vi fokuserer på specifikke komponenter, forsøger vi at stressteste komponenten ved at udsætte den for et urimeligt stort antal anmodninger om at udføre dens tilsigtede funktion. Det er ofte enklere først at stressteste kritiske komponenter isoleret med store mængder enkle anmodninger, før en langt mere kompleks test anvendes på hele infrastrukturen. Der findes også specifikt udviklede værktøjer til stresstest, som gør det lettere for QA-medarbejdere at udføre processen.
Udholdenhedstests er tests, der udsætter et system for en belastning over en længere periode på måske 24, 48 timer eller længere for at finde (det, der normalt er) vanskeligt identificerbare problemer. Uklare fejl viser sig ofte først efter en længere tids brug.
Den automatiserede test behøver ikke nødvendigvis at blive skaleret op til ekstreme belastninger (det dækkes af stresstest). Men vi er især interesserede i systemets evne til at modstå kontinuerlig kørsel af en bred vifte af testtransaktioner for at finde ud af, om der er skjulte hukommelseslækager, låsninger eller kapløbsbetingelser.
More Articles
Test af tjenesteadministration
Til sidst et par ord om test af tjenesteadministration.
Når tjenesten er implementeret i produktion, skal den administreres. At holde en tjeneste kørende kræver, at den overvåges, opgraderes, sikkerhedskopieres og hurtigt repareres, når noget går galt.
De procedurer, som tjenesteadministratorer bruger til at udføre opgraderinger, sikkerhedskopieringer, udgivelser og gendannelser efter fejl, er afgørende for at levere en pålidelig tjeneste. Derfor skal de testes, især hvis tjenesten vil gennemgå hurtige ændringer efter implementeringen.
De konkrete problemer, der skal håndteres, er:
- Procedurer opnår ikke den ønskede effekt.
- Procedurer er upraktiske eller uanvendelige.
- Procedurer forstyrrer den aktive tjeneste.
Testene bør så vidt muligt køres på en så realistisk måde som muligt.
Lidt at tænke over
Nogle systemer er tilbøjelige til at blive udsat for ekstreme belastninger, når en bestemt hændelse indtræffer. En onlinevirksomhed kan for eksempel forvente spidsbelastninger lige efter, at den har annonceret tilbud på tv, eller et nationalt nyhedswebsted kan blive overbelastet, når en stor nyhed bryder ud.
Overvej et system, du kender godt, og som blev påvirket af uplanlagte hændelser i din virksomhed eller i de nationale nyheder.
Hvilke hændelser eller begivenheder kan udløse overbelastninger i dit system?
Kan (eller kunne) du indsamle data fra systemlogfiler, der angiver antallet af udførte transaktioner? Kan du skalere denne hændelse for at forudsige en kritisk hændelse, der forekommer én gang hvert 100. år eller én gang hvert 1.000. år?
Hvilke foranstaltninger kunne du anvende (eller har du anvendt) for enten at reducere sandsynligheden for spidsbelastninger, reducere spidsbelastningernes omfang eller helt eliminere dem?
Tilmeld dig The QA Leads nyhedsbrev for at få besked, når nye dele af serien udkommer. Disse indlæg er uddrag fra Pauls Leadership In Test-kursus, som vi varmt anbefaler, hvis du vil gå mere i dybden med dette og andre emner. Hvis du gør det, kan du bruge vores eksklusive kuponkode QALEADOFFER og få $60 i rabat på kursets fulde pris!
Foreslået læsning: 10 BEDSTE OPEN SOURCE-VÆRKTØJER TIL TESTSTYRING


