

Værktøjer til webscraping er applikationer, der automatiserer udtrækningen af data fra websteder, så det bliver nemt at indsamle oplysninger uden manuel kopiering og indsættelse. Hvis du leder efter de bedste værktøjer til webscraping, har du sandsynligvis brug for at indsamle store mængder webdata på en pålidelig måde – uden at støde på forhindringer som anti-bot-beskyttelse eller ændringer i websteders struktur.
Med så mange muligheder på markedet kan det være svært at vide, hvilket værktøj der faktisk passer til din teknologistak, kan håndtere dine målwebsteder og skalere efter dine behov. Denne guide gennemgår de bedste værktøjer, så du kan sammenligne funktioner og fremgangsmåder og finde præcis det, der fungerer til dine it-projekter.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel: Værktøjer til webscraping
Denne sammenligningstabel opsummerer prisoplysningerne for mine bedste valg blandt værktøjer til webscraping.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til indbygget styring af hovedløs browser | Gratis abonnement tilgængeligt | Fra $30/måned | Website | |
| 2 | Bedst til webskraber i skjultilstand og omgåelse af registrering | 14 dages gratis prøveperiode | Fra $69/måned | Website | |
| 3 | Bedst til håndtering af dynamiske JavaScript-websteder | Gratis abonnement tilgængeligt | Fra $189/måned | Website | |
| 4 | Bedst til direkte pipelineintegration | 30-dages gratis prøveperiode | Fra $199/måned (faktureret årligt) | Website | |
| 5 | Bedst til forudbyggede skabeloner til robotautomatisering | Gratis abonnement tilgængeligt | Fra $19/måned (faktureres årligt) | Website | |
| 6 | Bedst til administreret dataindsamling med botbeskyttelse | Gratis prøveperiode tilgængelig | Fra $0.5/1,000 poster | Website | |
| 7 | Bedst til proxyinfrastruktur i virksomhedsskala | Gratis abonnement tilgængeligt | Fra $1.5/1,000 poster/måned | Website | |
| 8 | Bedst til automatisk detektion af dataskemaer | 30 dages gratis prøveperiode | Fra $0.13/1,000 anmodninger | Website | |
| 9 | Bedst til enkle API-drevne arbejdsgange til dataindsamling | Gratis abonnement tilgængeligt | Fra $49/måned | Website | |
| 10 | Bedst til problemfri IP-rotation i stor skala | 7 dages gratis prøveperiode | Fra $49/måned | Website |


Anmeldelser af de bedste værktøjer til webscraping
Nedenfor finder du mine detaljerede opsummeringer af de bedste værktøjer til webscraping, som kom med på min shortlist. Mine anmeldelser giver et detaljeret indblik i funktionerne, integrationerne og de bedste anvendelsesområder for hvert værktøj, så du kan finde det bedste valg til dig.
 Bedst til indbygget styring af hovedløs browser
- Gratis abonnement tilgængeligt
- Fra $30/måned
Visit WebsiteCustomer Rating:4.9/5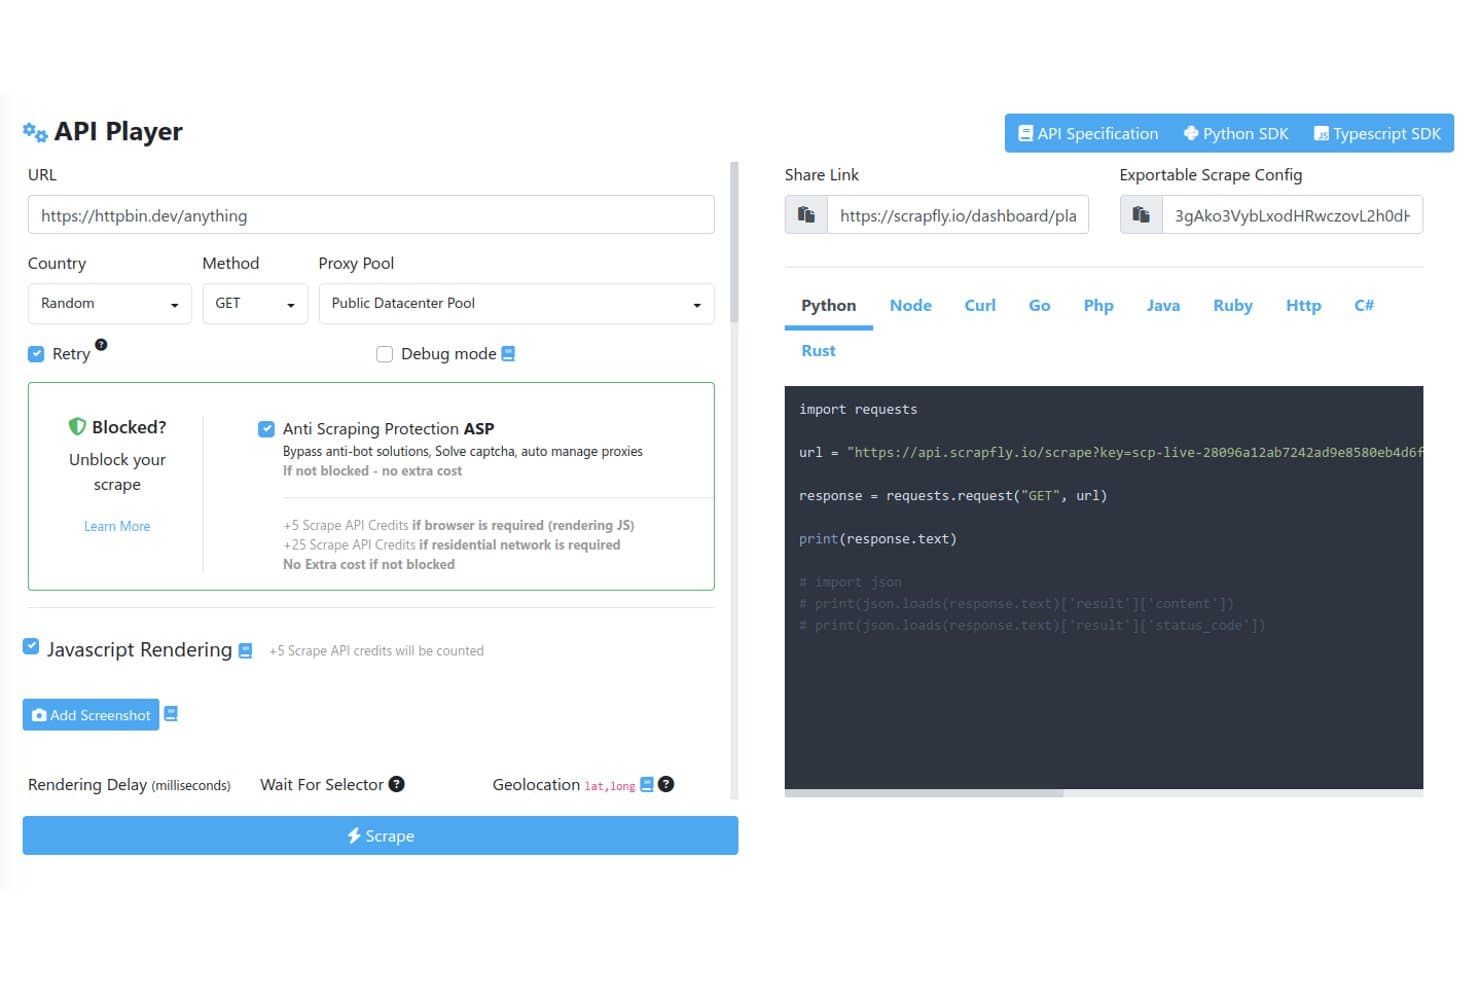
Scrapfly tilbyder en interaktiv API-afspiller med konfigurerbare scraping-indstillinger, herunder proxypuljer, omgåelse af scraping-beskyttelse, JavaScript-gengivelse og automatisk genererede kodestykker på flere sprog. Scrapfly er en webscraping-API, der kombinerer proxyrotation, omgåelse af antibot-beskyttelse, gengivelse i hovedløse browsere, crawling af websteder, optagelse af skærmbilleder og dataudtræk drevet af LLM under én enkelt API-nøgle.
Hvem er Scrapfly bedst egnet til?
Scrapfly er velegnet til udviklere og dataingeniører, der ønsker en kodebaseret scraping-API med SDK'er i Python, TypeScript, Go og Rust.
Hvorfor jeg valgte Scrapfly
Jeg valgte Scrapfly, fordi dets browserarkitektur med to motorer ikke ligner noget andet, jeg har testet. Curlium håndterer byte-perfekte Chrome-JA4-fingeraftryk for at opnå høj hastighed, mens Scrapium kører skjult Chromium over CDP med matchende fingeraftryk, så sessioner kan skifte midt under crawling uden at udløse detektion. Jeg kan også godt lide, at Scrapium er fuldt kompatibel med Playwright og Puppeteer, hvilket betyder, at jeg kan skrive brugerdefinerede JS-scenarier og regler for, hvornår der skal ventes, uden at ændre min eksisterende kode til browserautomatisering.
Scrapflys vigtigste funktioner
- API til dataudtræk med flere metoder: Udtrækker strukturerede data ved hjælp af CSS, XPath, regex, JSON-skemaer og LLM-drevne skabeloner.
- Integrerede proxypuljer: Tilbyder administrerede datacenter- og boligproxies med geografisk målretning samt understøttelse af egne proxies.
- Crawler-API: Gennemsøger hele websteder med kontrol over crawlingdybde, hastighedsbegrænsninger og projektpartitionering.
- Indbyggede planlægningsintegrationer: Understøtter Zapier, Make og n8n til automatiserede arbejdsgange, tilbagevendende jobs og webhook-udløsere.
Scrapfly-integrationer
Scrapfly tilbyder indbyggede integrationer med Zapier, Make, n8n, LlamaIndex, LangChain, CrewAI og OpenClaw. Det tilbyder også SDK'er til Python, TypeScript, Go og Rust. Der findes en API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- To skjulte browsermotorer
- Omgår Cloudflare, DataDome og Imperva
- Skabeloner til dataudtræk fra almindelige webstedstyper
Cons:
- Ingen indbygget planlægning af jobs i produktet
- Ikke egnet til ikke-tekniske brugere
Learn more about Scrapfly: Bedst til webskraber i skjultilstand og omgåelse af registrering
- 14 dages gratis prøveperiode
- Fra $69/måned
Visit WebsiteCustomer Rating:4.7/5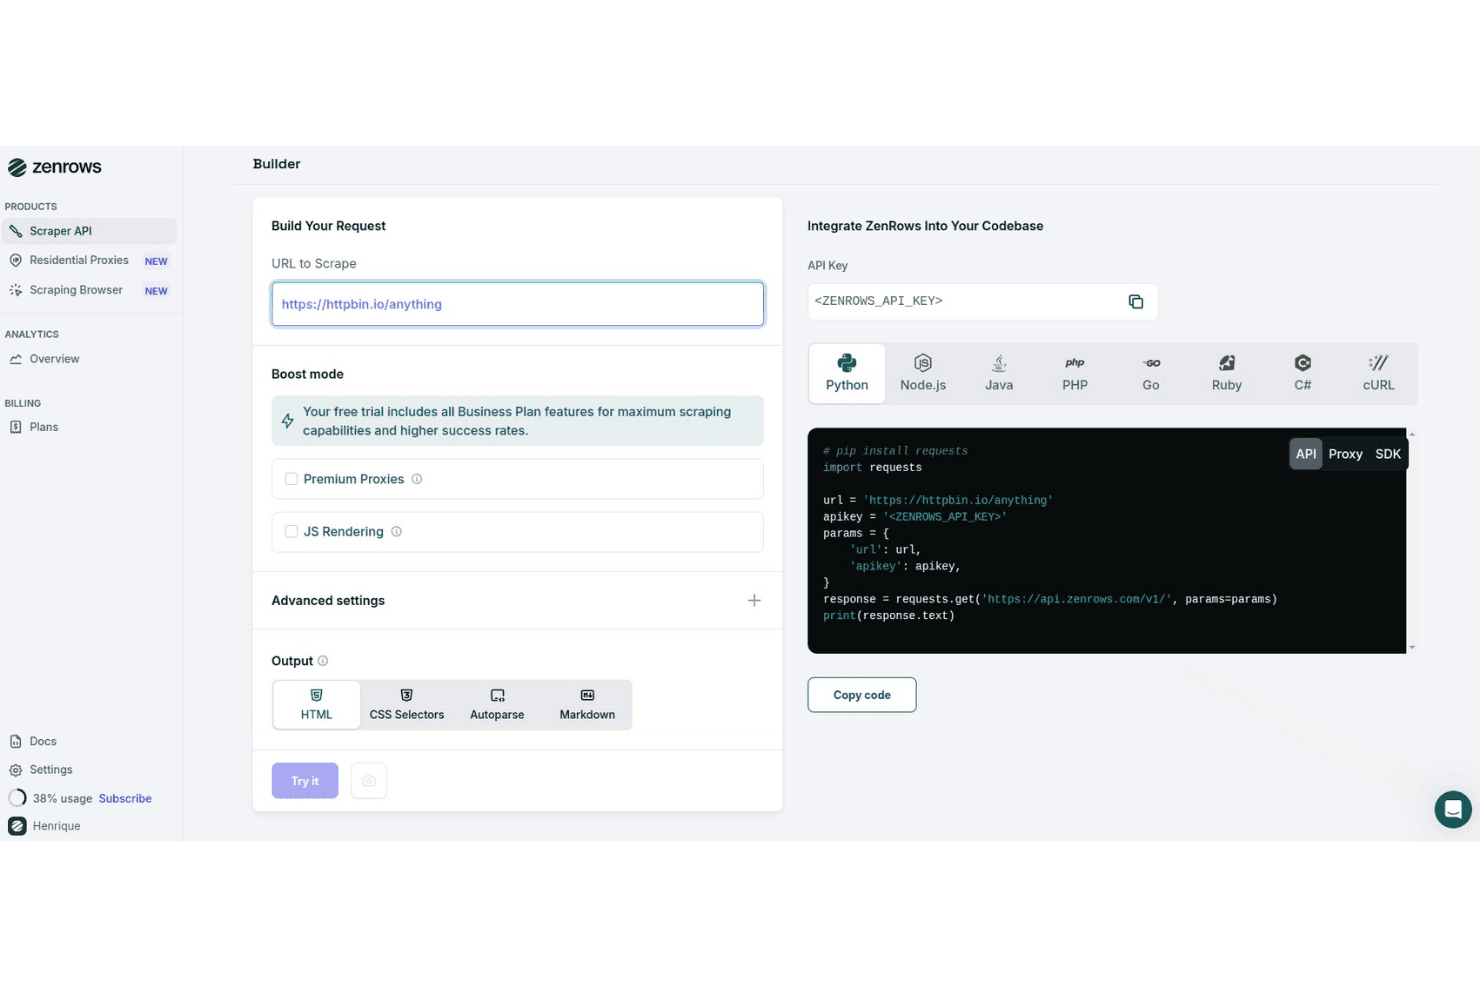
ZenRows tilbyder en visuel forespørgselsbygger med kodegenerering på flere programmeringssprog, muligheder for boost-tilstand og valg af outputformat til webskraber. ZenRows er en API til webskraber og en cloudbrowserplatform, der kombinerer omgåelse af antibotbeskyttelse, rotation af boligproxyer, JavaScript-rendering og struktureret dataudtræk i ét udviklerorienteret værktøj.
Hvem egner ZenRows sig bedst til?
ZenRows egner sig godt til udviklere og dataingeniører, der har brug for at skrabe websteder med aggressiv antibotbeskyttelse i stor skala.
Hvorfor jeg valgte ZenRows
ZenRows kommer med på min shortlist på grund af den måde, tjenesten håndterer antibotbeskyttelse på. Jeg har skrabet Cloudflare-beskyttede websteder, hvor standardværktøjer konsekvent fejler, og ZenRows kommer igennem ved hjælp af omgåelse af fingeraftryksgenkendelse og automatisk CAPTCHA-løsning uden manuel konfiguration. Browseren til webscraping går endnu længere og kører fulde Chromium-sessioner med headere i skjultilstand, der nøje efterligner reel brugeradfærd for at undgå registrering på websteder, der bruger DataDome eller PerimeterX.
ZenRows' vigtigste funktioner
- Universel skraber-API: Send forespørgsler via et enkelt slutpunkt, der tilpasser sig forskellige webstedsstrukturer og krav til webskraber.
- Infrastruktur til boligproxyer: Vælg fra en pulje på over 55 millioner bolig-IP'er fordelt på mere end 185 lande til geografisk målrettet crawling.
- Automatisk parsing til struktureret output: Udtræk og modtag automatisk data i JSON, HTML eller Markdown med indbygget parsing til populære websteder.
- SDK'er til flere programmeringssprog: Få adgang til officielle SDK'er til Python, Node.js, Go, PHP, Ruby, Java og C# for at integrere med udviklingsarbejdsgange.
ZenRows-integrationer
ZenRows tilbyder indbyggede integrationer med Playwright, Puppeteer, n8n, Make, Clay og Zapier. Der findes en API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Omgår Cloudflare og DataDome pålideligt
- Høj succesrate på beskyttede sider
- Fulde headless-browser-sessioner med skjultilstand
Cons:
- Ingen indbyggede funktioner til planlægning eller joborkestrering
- Omkostningerne stiger hurtigt ved store mængder forespørgsler
Learn more about ZenRows: Bedst til håndtering af dynamiske JavaScript-websteder
- Gratis abonnement tilgængeligt
- Fra $189/måned
Visit WebsiteCustomer Rating:4.4/5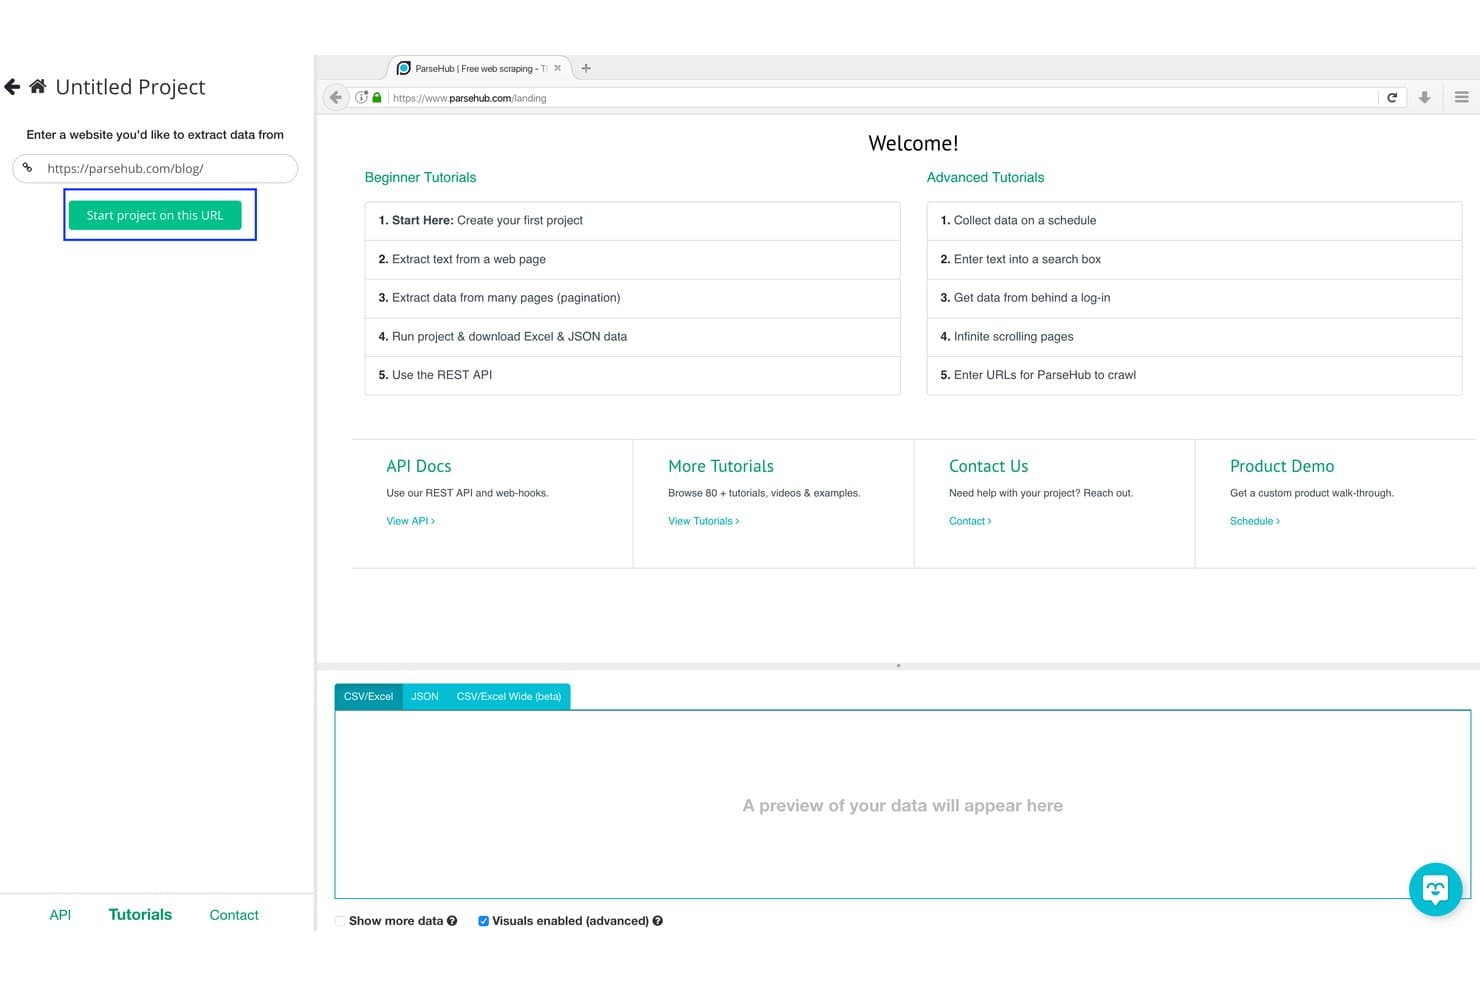
ParseHub tilbyder en visuel grænseflade til projektopsætning, hvor brugerne indtaster en URL og klikker på 'Start projekt på denne URL' for at begynde at indsamle data fra websteder. ParseHub er et visuelt værktøj til webscraping, der udtrækker data fra dynamiske websteder ved hjælp af en klikbaseret grænseflade med understøttelse af JavaScript, AJAX, uendelig rulning, formularfelter og planlagte skybaserede kørsler.
Hvem er ParseHub bedst egnet til?
ParseHub er velegnet til konkurrenceanalysefolk og ikke-tekniske forskere, der har brug for at indsamle data fra JavaScript-tunge websteder uden at skrive kode.
Hvorfor jeg valgte ParseHub
ParseHub fortjener sin plads blandt de bedste på min liste over favoritter, fordi værktøjet håndterer de udfordringer med JavaScript-gengivelse, som får de fleste scrapingværktøjer uden kode til at fejle. Jeg har brugt det til at udtrække data fra sider med uendelig rulning og indhold, der udløses af rullemenuer, hvor scrapers til statisk HTML returnerer tomme resultater. Dets maskinlæringsmotor registrerer automatisk sidens struktur, hvilket betyder, at jeg kan opbygge en fungerende scraper til et AJAX-tungt produktkatalog uden at skrive en eneste linje XPath.
ParseHubs vigtigste funktioner
- Visuel klikbaseret brugerflade: Vælg og udtræk sideelementer uden manuel kodning af selektorer.
- Skybaseret planlægning: Planlæg tilbagevendende scrapingopgaver på ParseHubs skyinfrastruktur.
- Adgang via REST API: Administrer, start og download scrapingresultater programmatisk ved hjælp af API'et.
- Automatisk IP-rotation: Reducer blokeringer ved at rotere udgående IP-adresser under skybaserede kørsler.
ParseHub-integrationer
ParseHub tilbyder indbyggede integrationer med Google Sheets, Tableau, Dropbox og AWS S3. Der findes en API til brugerdefinerede integrationer og automatisering af arbejdsgange.
Pros and Cons
Pros:
- Håndterer JavaScript, AJAX og uendelig rulning direkte
- Den visuelle brugerflade kræver ingen kodning af selektorer
- Scrapingkørsler udføres automatisk på skyinfrastruktur
Cons:
- Har en grænse for store samtidige scrapingopgaver
- Ingen indbygget løsning af CAPTCHA'er
Learn more about ParseHub: Bedst til direkte pipelineintegration
- 30-dages gratis prøveperiode
- Fra $199/måned (faktureret årligt)
Visit WebsiteCustomer Rating:4.2/5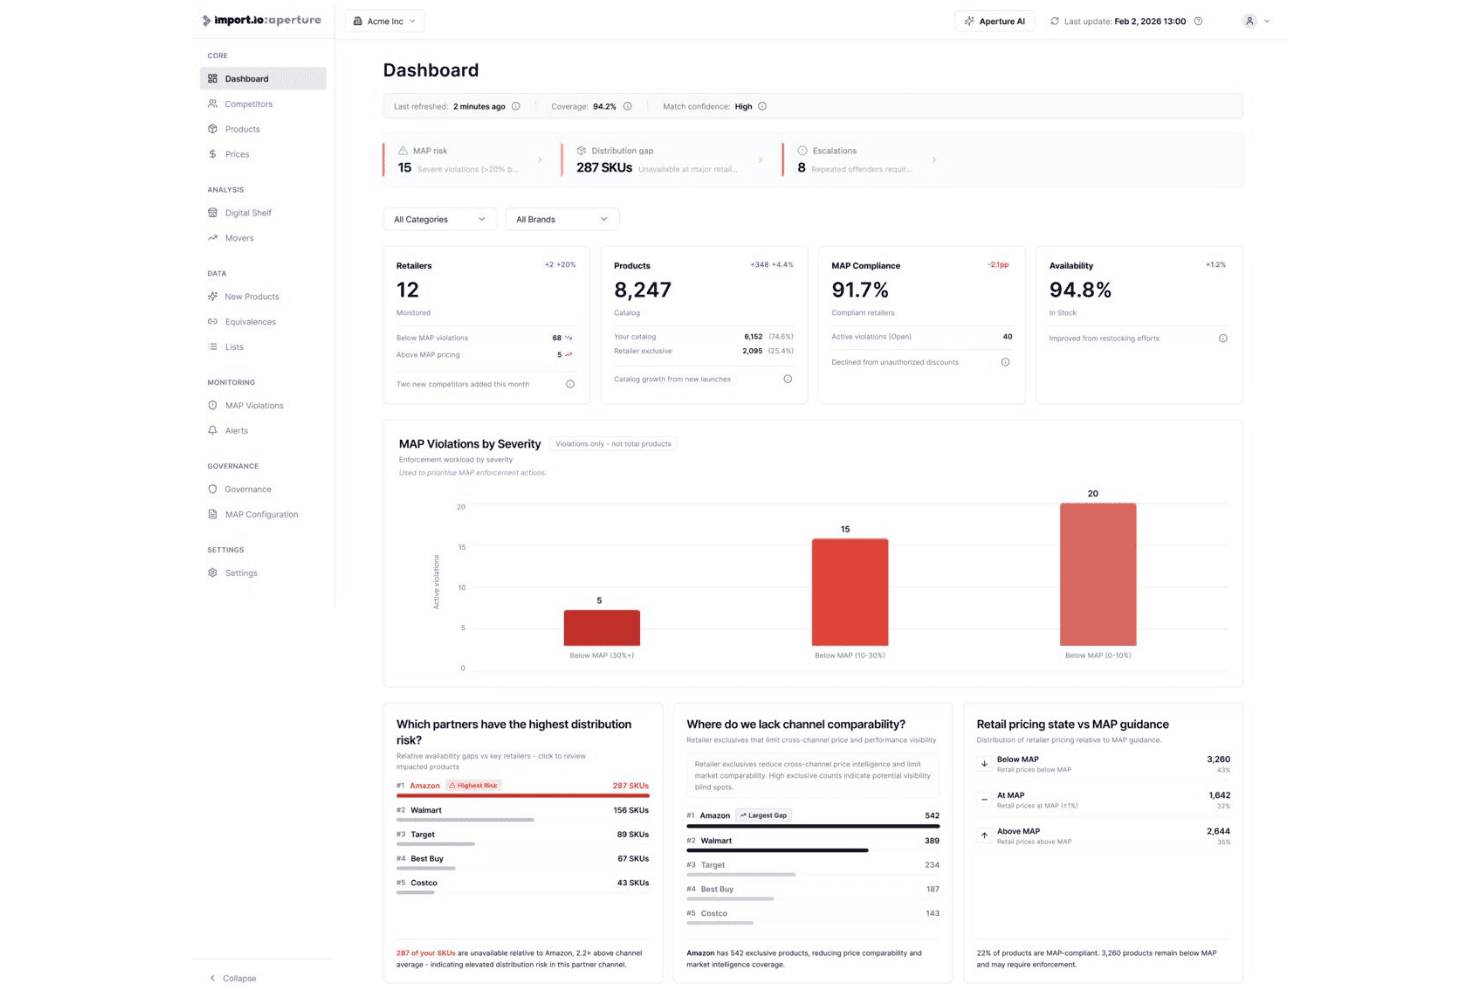
Import.io Aperture-platform tilbyder et kontrolpanel, der viser MAP-compliance, produkttilgængelighed, forhandleres distributionsmangler og prisovertrædelser. Import.io er en AI-baseret, administreret webskrabningsplatform, der udtrækker strukturerede data fra websites i virksomhedsskala og håndterer JavaScript-renderede sider, beskyttede kilder samt direkte levering til datapipelines og analysesystemer.
Hvem er Import.io bedst egnet til?
Import.io er velegnet til datateknik- og konkurrenceintelligensteams i mellemstore og store virksomheder, der har brug for vedligeholdte datapipelines uden selv at skulle udvikle eller administrere skrabere.
Hvorfor valgte jeg Import.io?
Import.io kommer med på min kortliste, fordi strukturerede data flyttes direkte fra nettet til dit datalager, kontrolpanel eller API-endepunkt uden et manuelt eksporttrin imellem. Jeg kan godt lide, at webhooks og API-levering er indbygget i platformen og ikke blot tilføjet som en eftertanke. Det, jeg finder mest værdifuldt, er de selvhelende pipelines: De tilpasser sig automatisk, når målwebsites ændrer struktur, så jeg ikke behøver at genopbygge ekstraktorer, hver gang en forhandler opdaterer sidens layout.
Vigtige funktioner i Import.io
- AI-assisterede ekstraktionsmodeller: Registrerer automatisk sidestrukturer og tilpasser skemaet, efterhånden som websites ændrer sig.
- Administration af virksomhedsproxyer: Understøtter premium- og boligproxyer til skrabning af beskyttede eller geografisk begrænsede websites.
- Visuel værktøjsbygger med peg-og-klik: Vælg og udtræk data fra komplekse websider uden at skrive kode.
- Automatisk maskering af PII: Identificerer og fjerner personhenførbare oplysninger i skrabede datasæt af hensyn til compliance.
Integrationer i Import.io
Import.io tilbyder indbyggede integrationer med Google Sheets, Power BI, Tableau og Excel samt en API til tilpassede integrationer og webhooks til andre systemer.
Pros and Cons
Pros:
- Selvhelende pipelines tilpasser sig automatisk ændringer på websites
- Håndterer stærkt beskyttede websites og websites med login-gate
- Administreret ekstraktion reducerer den interne arbejdsbyrde for ingeniørteamet
Cons:
- Begrænset gennemsigtighed omkring den underliggende skrabningsinfrastruktur
- Begrænset egnethed til skrabningsopgaver i lille skala
Learn more about Import.io: Bedst til forudbyggede skabeloner til robotautomatisering
- Gratis abonnement tilgængeligt
- Fra $19/måned (faktureres årligt)
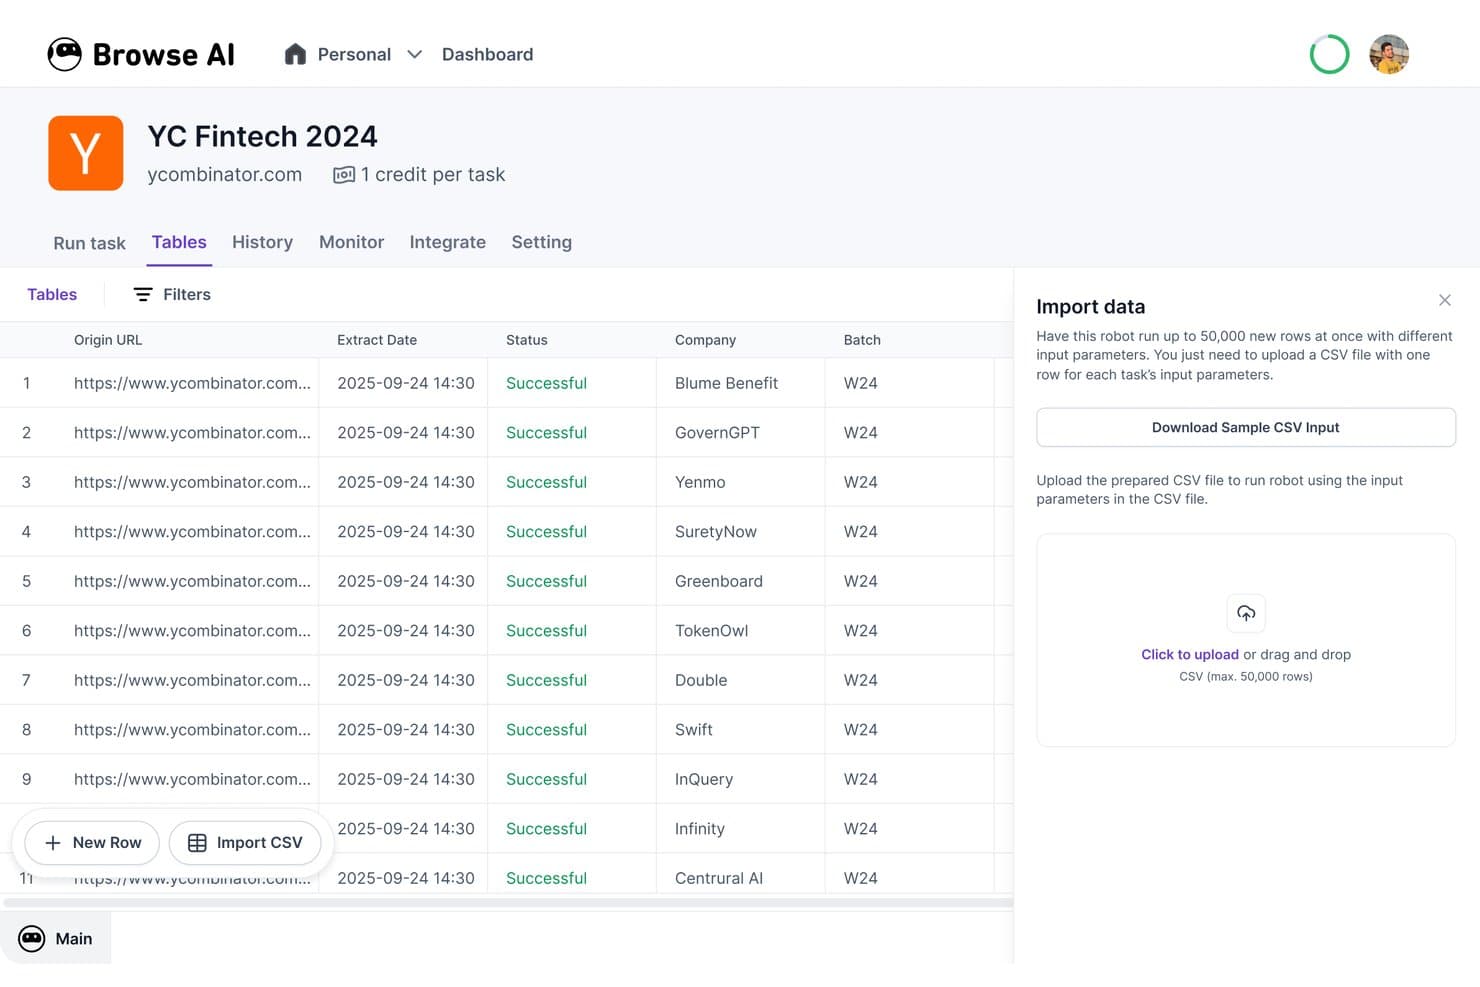
Browse AI tilbyder et webskrabe-kontrolpanel uden kode, hvor brugere kan udtrække strukturerede data fra websites som Y Combinator og eksportere resultater som CSV-filer. Browse AI er en webskrabe- og websideovervågningsplatform uden kode, der kombinerer et visuelt dataudtræksværktøj med peg-og-klik-funktion med over 250 forudbyggede robotskabeloner til automatiseret, planlagt dataindsamling fra websites.
Hvem er Browse AI bedst til?
Browse AI er velegnet til markeds- og konkurrenceanalytikere samt ikke-tekniske teams, der har brug for at indsamle strukturerede webdata uden at skrive kode.
Hvorfor valgte jeg Browse AI?
Browse AI kommer med på min liste over favoritter på grund af det store forspring, som dets bibliotek med forudbyggede robotter har. Jeg kan hente strukturerede lister fra Amazon, Google Maps eller Indeed uden at bygge en webskraber fra bunden, og hver robot håndterer allerede sideinddeling og dynamisk indhold for det pågældende website. Jeg sætter også pris på den AI-drevne layouttilpasning, som automatisk opdaterer en robot, når et målwebsite ændrer sin sidestruktur, så webskraberne ikke pludselig holder op med at fungere midt i datapipelinen.
Vigtige funktioner i Browse AI
- Gengivelse af JavaScript: Automatiserer udtræk fra moderne, JavaScript-tunge websites og enkeltsidesapplikationer.
- Understøttelse af proxyservere med private IP-adresser: Roterer automatisk IP-adresser fra private netværk for at omgå anti-bot-systemer uden manuel opsætning af proxyservere.
- Webhooks og API-adgang: Muliggør programmatisk indsendelse af webskrabeopgaver og hentning af data til integration med interne systemer.
- Automatisk ændringsregistrering: Overvåger websites for visuelle ændringer eller indholdsændringer og sender advarsler, når opdateringer registreres.
Integrationer med Browse AI
Browse AI tilbyder indbyggede integrationer med Google Sheets, Airtable, AWS S3, Zapier og Make.com. API- og webhook-adgang er tilgængelig til tilpassede integrationer.
Pros and Cons
Pros:
- Over 250 forudbyggede robotter klar til brug
- Tilpasser sig automatisk, når målwebsites ændrer layout
- Håndterer CAPTCHA'er og dynamiske sider indbygget
Cons:
- Begrænset kontrol på selektorniveau for udviklere
- Kreditomkostningerne stiger hurtigt ved store datamængder
Learn more about Browse AI: Bedst til administreret dataindsamling med botbeskyttelse
- Gratis prøveperiode tilgængelig
- Fra $0.5/1,000 poster
Visit WebsiteCustomer Rating:4.5/5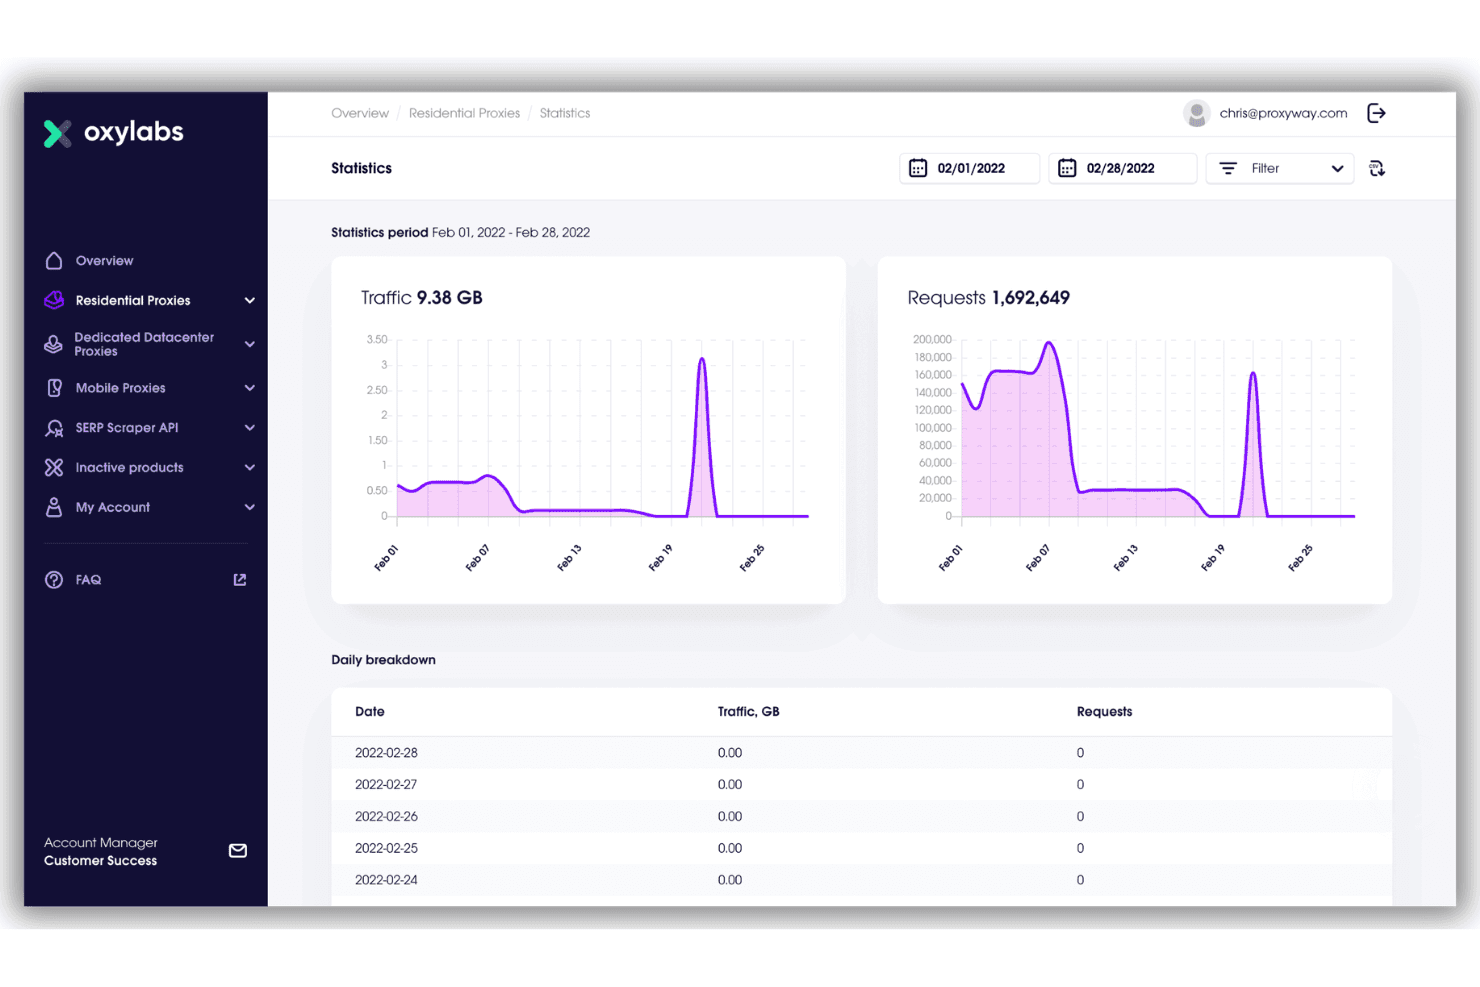
Oxylabs tilbyder et detaljeret statistikinstrumentbræt til private proxyer, der viser trafik- og anmodningsmålinger for et valgt datointerval i februar 2022. Oxylabs er en webscraper-API, der håndterer proxyadministration, løsning af CAPTCHA'er, JavaScript-gengivelse og struktureret dataudtræk på tværs af mere end 50 forudkonfigurerede webstedsmål.
Hvem er Oxylabs bedst til?
Dataingeniører og backendudviklere, der driver store, forretningskritiske dataindsamlingspipelines og har brug for infrastruktur i virksomhedsklasse samt pålidelighed mod botbeskyttelse.
Hvorfor valgte jeg Oxylabs?
Oxylabs kommer med på min liste over favoritter på grund af den måde, tjenesten håndterer den sværeste del af webdataindsamling på: at komme forbi botdetektion uden selv at skulle administrere det. API'en håndterer løsning af CAPTCHA'er, proxyrotation på tværs af mere end 177 mio. private IP-adresser og automatiske genforsøg uden nogen brugerdefineret fejlhåndteringslogik fra min side. Jeg kan også godt lide den succesbaserede prismodel, hvor kun 2xx- og 4xx-svar tæller mod din kvote, så fejl på systemsiden ikke bruger dine resultater op.
Vigtige funktioner i Oxylabs
- Tilpasset parser: Definer CSS- eller XPath-selektorer for at udtrække præcist strukturerede data fra sidens indhold.
- OxyCopilot AI-assistent: Generér instruktioner til dataindsamling og analyselogik ved hjælp af naturlige sprogprompter.
- Forudbyggede målforbindelser: Brug dedikerede slutpunkter til Amazon, Google, eBay, Walmart, Zillow og andre større websteder.
- Integrationer til cloudlagring: Eksportér resultater direkte til AWS S3 og Google Cloud Storage til brug i datapipelines.
Oxylabs-integrationer
Oxylabs tilbyder indbyggede integrationer med AWS S3, Google Cloud Storage, LangChain, LlamaIndex, CrewAI, n8n, Make.com og Zapier. Der findes en API samt SDK'er til Python og Go til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Mere end 177 mio. private IP-adresser i 195 lande
- Succesbaseret prissætning forhindrer spild af anmodningskvoten
- Forudbyggede slutpunkter til mere end 50 større websteder
Cons:
- Højere pris end selvadministrerede værktøjer til dataindsamling
- Der findes ingen visuel scrapergrænseflade uden kode
Learn more about Oxylabs: Bedst til proxyinfrastruktur i virksomhedsskala
- Gratis abonnement tilgængeligt
- Fra $1.5/1,000 poster/måned
Visit WebsiteCustomer Rating:4.7/5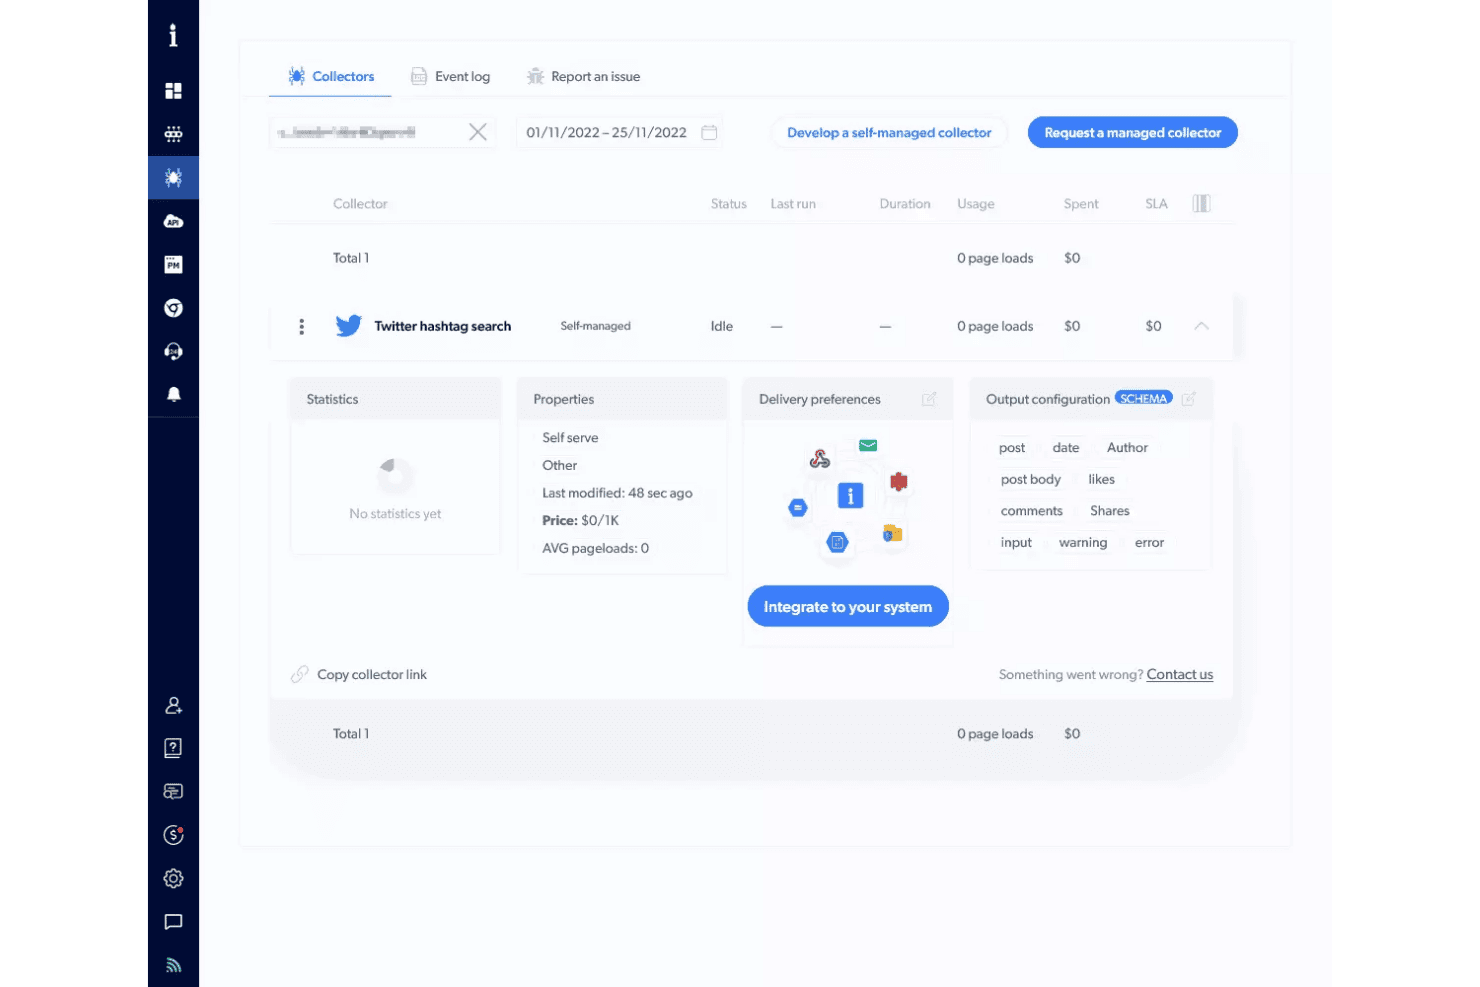
Bright Datas Collectors-kontrolpanel tilbyder en dataindsamler til søgning efter Twitter-hashtags med selvadministreret status, outputkonfiguration og muligheder for systemintegration. Bright Data er en API til webdataindsamling og en kodefri platform til dataindsamling, der kombinerer proxyadministration, JavaScript-gengivelse, CAPTCHA-løsning og levering af strukturerede data på tværs af mere end 1.278 forudbyggede scrapere til populære websteder.
Hvem er Bright Data bedst egnet til?
Dataingeniører og backendudviklere i mellemstore og store organisationer, som har brug for at indsamle strukturerede webdata i stor skala uden selv at skulle administrere proxyinfrastruktur.
Hvorfor jeg valgte Bright Data
Bright Data kommer på min shortlist på grund af det enorme omfang af deres proxynetværk: mere end 400 millioner bolig-IP-adresser i 195 lande med automatisk rotation, CAPTCHA-løsning og Web Unlocker, der er udviklet til at omgå Cloudflare, Akamai og DataDome uden nogen konfiguration. Jeg har indsamlet data fra LinkedIn Sales Navigator og Amazon i stor skala med Bright Data og oplevede ingen blokeringer på tværs af tusindvis af anmodninger. AI Scraper Studio giver mig også mulighed for at generere en fungerende scraper-API til ethvert nyt domæne på få minutter.
Vigtige funktioner i Bright Data
- Forudbyggede scrapermodeller: Mere end 1.200 færdiglavede scrapere er tilgængelige til hurtig implementering på større platforme som LinkedIn, Amazon og YouTube.
- AI-drevet skemaregistrering: AI Scraper Studio genererer brugerdefinerede outputskemaer og automatiserer datatilknytning fra nye domæner.
- API'er til jobadministration: Giver mulighed for batchplanlægning, tilbagevendende kørsler og webhook-udløsere til integration med værktøjer til workflowautomatisering.
- Direkte datalevering: Understøtter eksport af data til JSON, NDJSON, CSV og XLSX eller direkte overførsel til S3, Snowflake, GCS, PubSub eller SFTP.
Bright Data-integrationer
Bright Data tilbyder indbyggede integrationer med Amazon S3, Google Cloud Storage, Azure Blob Storage, Snowflake og Pub/Sub samt en API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Mere end 400 millioner bolig-IP-adresser i 195 lande
- Forudbyggede scrapere til mere end 1.200 populære websteder
- Web Unlocker omgår Cloudflare og DataDome
Cons:
- Brugere rapporterer faktureringstvister ved mislykkede dataindsamlingsforsøg
- Alt for komplekst for købere uden udviklerbaggrund
Learn more about Bright Data: Bedst til automatisk detektion af dataskemaer
- 30 dages gratis prøveperiode
- Fra $0.13/1,000 anmodninger
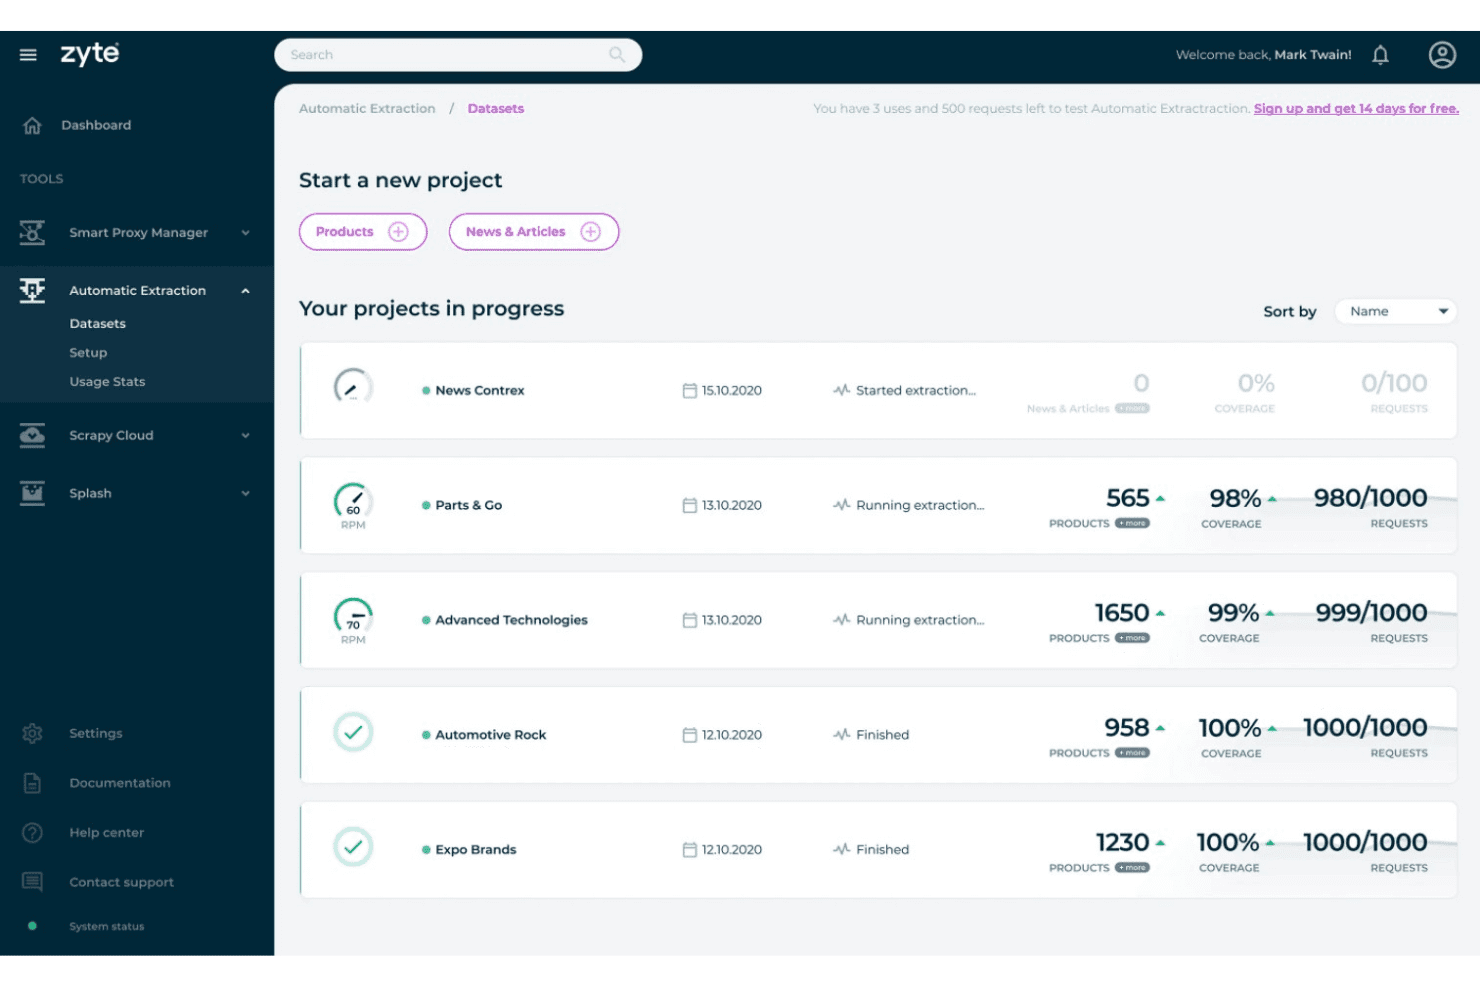
Zytes funktion til automatisk udtræk tilbyder igangværende og afsluttede dataudtræksprojekter med målinger for dækning, antal produkter og forbrug af anmodninger. Zyte API er en webskrabnings-API, der kombinerer gengivelse i browsere uden grafisk brugerflade, automatisk proxyrotation, løsning af CAPTCHA'er og AI-drevet dataudtræk i ét enkelt slutpunkt.
Hvem er Zyte API bedst egnet til?
Zyte API er velegnet til dataingeniører og Python-udviklere, der bygger scraping-pipelines i produktionsskala, som leverer data til ML-modeller eller analysesystemer.
Hvorfor valgte jeg Zyte API?
Zyte API kommer med på min kandidatliste på grund af den måde, det håndterer automatisk skemadetektion på. Peg på en produktside eller artikel, så returnerer det LLM-drevne udtrækslag typisk struktureret JSON uden en eneste CSS-selektor eller XPath-udtryk fra min side. Når et websted opdaterer sin udformning, tilpasser AI'en sig, hvilket betyder, at jeg ikke konstant skal rette fortolkningsprogrammerne, hver gang en konkurrent redesigner sin katalogside.
Vigtige funktioner i Zyte API
- Øjeblikkelig browsergengivelse: Zyte API starter forvarmede browsere uden grafisk brugerflade for at indlæse dynamiske websteder efter behov.
- Fuld proxyinfrastruktur: Skifter automatisk mellem bolig-IP-adresser, datacenter-IP-adresser og mobile IP-adresser ved hver anmodning.
- Sessionsstyring: Bevarer vedvarende cookies og brugersessioner til arbejdsgange, der kræver godkendelse eller handlinger i flere trin.
- Integrationer til levering i skyen: Sender indsamlede data direkte til destinationer som AWS S3, Google Cloud eller Azure til videre behandling.
Integrationer til Zyte API
Zyte API tilbyder indbyggede integrationer med Scrapy, Scrapy Cloud og Python-SDK'er samt en API til tilpassede integrationer. Det understøtter også levering i skyen til AWS S3, Google Cloud og Azure.
Pros and Cons
Pros:
- AI registrerer automatisk skemaer uden manuelle selektorer
- Omgår anti-bot-beskyttelse uden ekstra konfiguration
- Forvarmede browsere eliminerer forsinkelser ved kold opstart
Cons:
- Planlægning af tilbagevendende opgaver kræver eksterne værktøjer
- Kræver programmeringskendskab at implementere
Learn more about Zyte API: Bedst til enkle API-drevne arbejdsgange til dataindsamling
- Gratis abonnement tilgængeligt
- Fra $49/måned
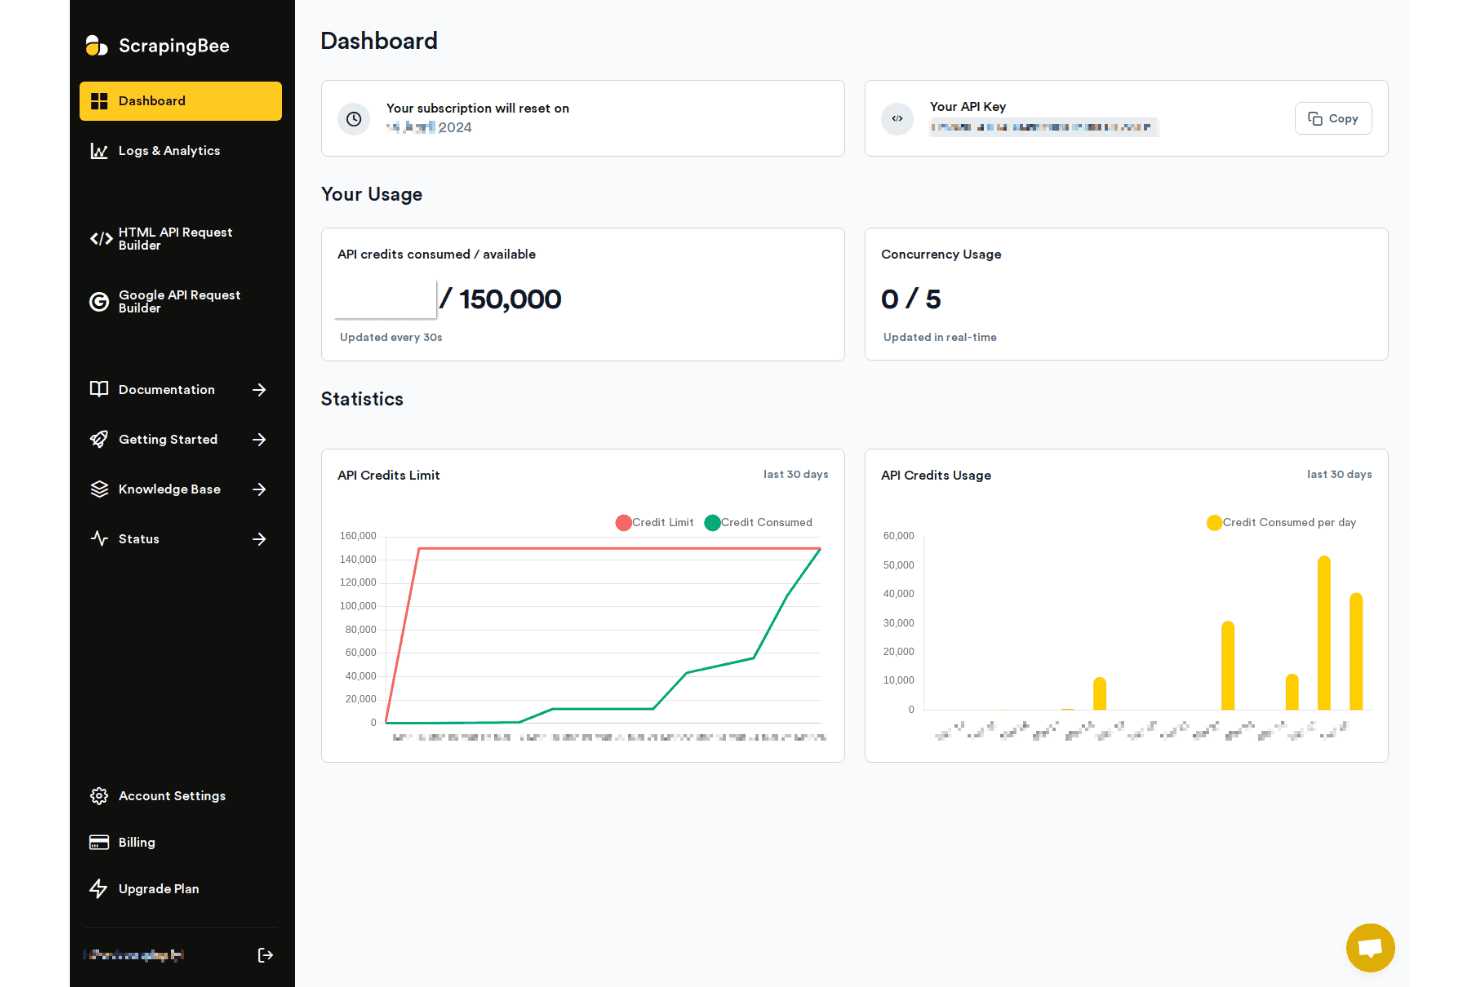
ScrapingBee tilbyder et kontrolpanel med API-kreditforbrug, samtidighedsstatistikker og 30-dages forbrugsdiagrammer til overvågning af dataindsamlingsaktivitet. ScrapingBee er en API til webdataindsamling, der håndterer gengivelse med Chrome uden grafisk brugerflade, rotation af proxyer og omgåelse af antibot-systemer samt dedikerede API'er til dataudtræk fra platforme som Google, Amazon og Walmart.
Hvem er ScrapingBee bedst egnet til?
ScrapingBee er et stærkt valg for udviklere og dataingeniører, der har brug for en pålidelig, kodebaseret API til udtræk af webdata uden selv at skulle opbygge proxy- eller browserinfrastruktur fra bunden.
Hvorfor jeg valgte ScrapingBee
ScrapingBee kommer med på min udvalgte liste på grund af den måde, API'en elegant abstraherer kompleksiteten ved moderne webdataindsamling på. En enkelt forespørgsel håndterer gengivelse med Chrome uden grafisk brugerflade, diskret proxyrotation og JavaScript-eksekvering, så jeg ikke behøver at skrive kode til browserstyring eller konfigurere proxypuljer separat. Jeg kan også godt lide AI-forespørgselsfunktionen, som lader mig beskrive, hvad der skal udtrækkes, i almindeligt sprog i stedet for at skrive CSS- eller XPath-selektorer for hvert nyt websted, jeg målretter.
Vigtige funktioner i ScrapingBee
- Dedikerede API'er til dataindsamling: Vælg forudbyggede slutpunkter til platforme som Amazon, Walmart og Google Søgning for at forenkle almindelige dataindsamlingsopgaver.
- Dataudtræk med AI-forespørgsler: Beskriv, hvilke data der skal udtrækkes, i almindeligt sprog, og generer automatisk strukturerede resultater.
- Markdown-dataindsamler: Konverter enhver webside til Markdown eller almindelig tekst, så den hurtigt kan indlæses i efterfølgende AI-modeller eller databaser.
- Integrationer uden kode: Opret forbindelse til Make, n8n og Zapier for at automatisere arbejdsgange uden at skrive brugerdefinerede planlægningsscripts.
ScrapingBee-integrationer
ScrapingBee tilbyder indbyggede integrationer med Make, n8n og Zapier samt en API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Opkræver kun betaling for vellykkede forespørgsler
- Håndterer Chrome uden grafisk brugerflade uden yderligere opsætning
- Dedikerede API'er til Amazon og Google
Cons:
- Ingen indbygget planlægning af opgaver
- Kreditomkostningerne stiger hurtigt ved stor skala
Learn more about ScrapingBee: Bedst til problemfri IP-rotation i stor skala
- 7 dages gratis prøveperiode
- Fra $49/måned
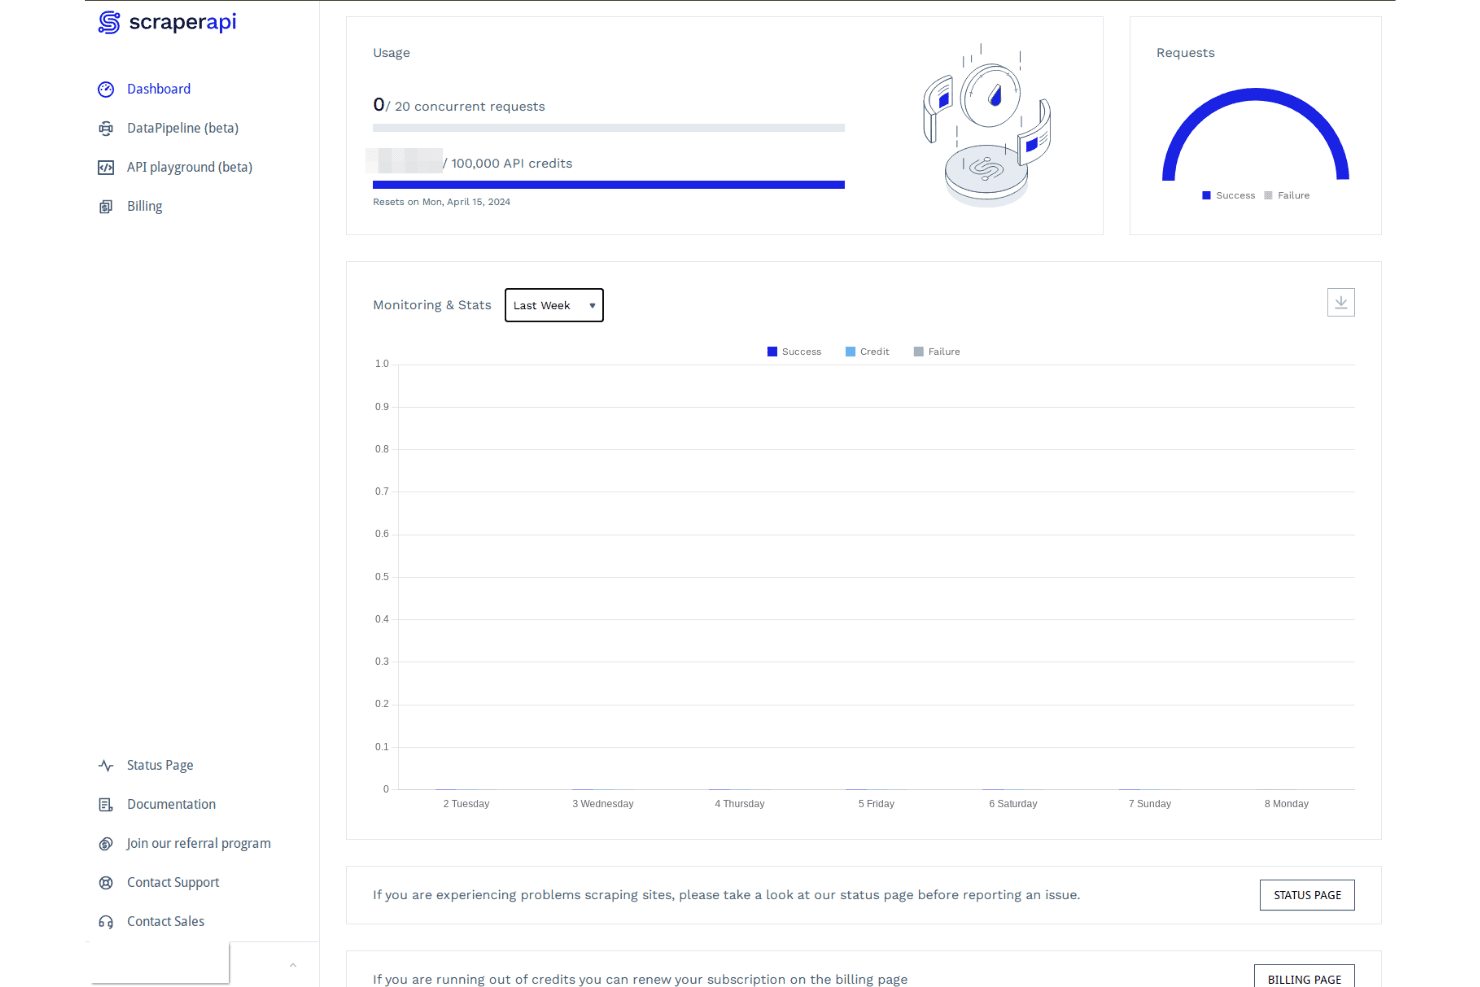
ScraperAPI's kontrolpanel viser brugsstatistik, API-kreditter, samtidige anmodninger og et ugentligt overvågningsdiagram til sporing af skrabningsydelse. ScraperAPI er en API til web-skrabning, der håndterer proxyrotation, JavaScript-gengivelse, omgåelse af CAPTCHA'er og udtræk af strukturerede data med forudbyggede endepunkter til større e-handels- og søgeplatforme.
Hvem egner ScraperAPI sig bedst til?
ScraperAPI er velegnet til backendudviklere og dataingeniører, der har brug for at indsamle data fra botbeskyttede eller JavaScript-tunge websteder i stor skala.
Hvorfor valgte jeg ScraperAPI?
ScraperAPI kommer med på min udvalgte liste på grund af den måde, tjenesten håndterer proxyadministration i baggrunden. Når jeg indsamler prisdata for produkter fra Amazon eller Google Shopping i stor skala, behøver jeg ikke selv at konfigurere eller vedligeholde en proxypulje. ScraperAPI dirigerer hver anmodning gennem sit proxy-netværk med over 40 millioner IP-adresser og prøver automatisk igen ved fejl. Jeg kan også godt lide proxyniveauet med premium-adgang, som aktiveres for websteder, der er beskyttet af Cloudflare eller Datadome, uden at jeg behøver foretage yderligere konfiguration.
Vigtige funktioner i ScraperAPI
- Endepunkter til strukturerede data: Forudbyggede API'er returnerer fortolket JSON fra Amazon, Google-søgning, Walmart og lignende websteder til almindelige skrabningsmål.
- Vedvarende sessioner: Understøtter klæbrige sessioner, så den samme IP-adresse kan bevares på tværs af flere anmodninger, når det er nødvendigt.
- Understøttelse af asynkron skrabning: Muliggør asynkron dataindsamling, så millioner af samtidige anmodninger kan håndteres effektivt.
- Globalt proxynetværk: Giver adgang til over 40 millioner IP-adresser i mere end 50 lande, så geotargeteret skrabning kan udføres i stor skala.
Integrationer med ScraperAPI
ScraperAPI tilbyder SDK'er til Python, Node.js, PHP, Ruby, Java og cURL samt en LangChain-integration til AI-arbejdsgange. Der findes en API til tilpassede integrationer. Indbyggede integrationer er ikke tydeligt dokumenteret.
Pros and Cons
Pros:
- Der opkræves kun betaling for vellykkede anmodninger
- Forudbyggede JSON-endepunkter til Amazon, Google og Walmart
- Geotargeting i mere end 50 lande
Cons:
- Kreditter overføres ikke mellem faktureringsperioder
- JavaScript-gengivelse og premium-proxyer løber hurtigt op i pris
Learn more about ScraperAPI:
Andre værktøjer til webscraping
Her er nogle yderligere muligheder blandt værktøjer til webscraping, som ikke kom med på min shortlist, men som stadig er værd at undersøge:
- 11CrawlbaseBedst til API-adgang til globale datakilder
- 12ScrapyBedst til tilpasningsbare rammer til webscraping i Python
- 13ScrapingdogBedst til hurtig implementering med minimal opsætning
Sådan evaluerer jeg værktøjer til webskrabning
Jeg opdeler min evaluering i to lag: det grundniveau, et værktøj skal kunne håndtere ved webskrabning i den virkelige verden – gengivelse af JavaScript, proxyrotation og planlagte job – samt de særkende, der adskiller de bedste muligheder.
Grundlæggende funktionalitet (uundværlige krav på denne liste)
Når jeg udvælger værktøjer til min liste, vurderer jeg hvert af dem på en skala fra 0 (tilbyder ikke funktionaliteten) til 5 (udmærker sig på området) for hver af de nedenstående grundlæggende funktioner. Derefter omregner jeg værktøjets samlede score til en procentdel. Hvert værktøj skal opnå en samlet minimumsscore på 65 % for at komme i betragtning til optagelse.
- Dataudtræksmotor: Jeg vurderer, om et værktøj understøtter flere vælgermetoder som CSS, XPath og regex eller tilbyder en visuel editor til teams, der foretrækker en opsætning med peg-og-klik.
- JavaScript-gengivelse: Websteder, der er bygget med React, Vue eller Angular, kræver understøttelse af hovedløse browsere. Jeg kontrollerer, om gengivelsen er pålidelig og har konfigurerbare ventebetingelser.
- Proxy- og botbeskyttelseshåndtering: Jeg ser efter indbygget proxyrotation, CAPTCHA-løsning og mekanismer til omgåelse, der håndterer beskyttelser som Cloudflare eller DataDome uden ekstra opsætning.
- Planlægning og automatisering: Gentagne skrabninger bør køre uden opsyn. Jeg vurderer, om værktøjet understøtter planlægning i cron-stil, webhook-udløsere og logik til gentagelse ved fejl.
- Eksport af strukturerede data: Jeg undersøger, hvilke outputformater der er tilgængelige, og om værktøjet kan sende data direkte til destinationer som S3, Google Sheets, databaser eller API'er.
- Skalerbarhed og samtidighed: Store job på tværs af tusindvis af sider kræver parallelle forespørgsler. Jeg ser på grænserne for samtidighed, og om værktøjet understøtter distribueret gennemsøgning.
Når jeg har en liste over værktøjer, der opfylder kriterierne, undersøger jeg, hvad der adskiller de enkelte platforme fra hinanden.
Særkende (det, der adskiller leverandørerne)
Sådan sammenligner jeg de forskellige leverandører:
Fremtrædende funktioner
Omgåelse af botbeskyttelse er det område, hvor jeg ser den største forskel mellem værktøjerne. Jeg ser efter indbygget CAPTCHA-løsning og browserfingeraftryk, der håndterer beskyttelser som Cloudflare eller DataDome, uden at du skal indhente proxytjenester fra tredjeparter. Skabeloner til automatisk registrering har også stor betydning – værktøjer som Bright Data og Zyte tilbyder forudbyggede skrabere til almindelige mål som Amazon eller Googles SERP'er, hvilket sparer timevis af manuel konfiguration af vælgere. Jeg vurderer også funktionerne til planlægning og overvågning, især fejlalarmer og automatiske gentagelser, der holder datapipelines kørende, når målwebsteder ændrer deres layout natten over.
Ud over funktionerne
Prismodellerne varierer meget på dette område – nogle leverandører opkræver betaling pr. API-forespørgsel, mens andre fakturerer efter båndbredde eller antallet af returnerede sider. Jeg vurderer, om omkostningerne forbliver forudsigelige, når du skalerer op til millioner af sider om måneden. Proxyinfrastrukturen er en anden vigtig forskel. Jeg kontrollerer, om et værktøj inkluderer proxy-puljer fra bolignetværk og datacentre med indbygget geografisk målretning på byniveau, eftersom separate proxykontrakter medfører ekstra omkostninger og kompleksitet. Det er også vigtigt, hvordan regler og krav overholdes, især for teams, der skraber data i regulerede brancher, hvor håndteringen af GDPR og robots.txt skal være tydeligt dokumenteret.
Sådan vælger du værktøjer til webscraping
Det er nemt at fare vild i lange funktionslister og komplekse prisstrukturer. For at hjælpe dig med at holde fokus, mens du arbejder dig gennem din unikke proces for valg af software, er her en tjekliste over faktorer, du bør have i tankerne:
| Faktor | Hvad skal du overveje? |
|---|---|
| FaktorSkalerbarhed | Hvad skal du overveje?Kan værktøjet håndtere de forventede stigninger i datamængden og parallelle crawls uden markante prisstigninger eller begrænsninger på forespørgsler? |
| FaktorIntegrationer | Hvad skal du overveje?Leverer værktøjet data direkte til dine målrettede systemer (cloudlager, databaser, arbejdsgange), eller kræver det manuelle trin? |
| FaktorTilpasningsmuligheder | Hvad skal du overveje?Kan du tilpasse udtrækslogikken til unikke webstedsstrukturer, eller er du begrænset til foruddefinerede skabeloner og regler? |
| FaktorBrugervenlighed | Hvad skal du overveje?Kan både tekniske og ikke-tekniske brugere administrere scraping, eller får du brug for løbende involvering fra udviklere for at foretage ændringer? |
| FaktorImplementering og introduktion | Hvad skal du overveje?Hvor hurtigt kan dit team opsætte den første datapipeline, og hvilken support eller dokumentation er tilgængelig, hvis du går i stå? |
| FaktorPris | Hvad skal du overveje?Er prisen forudsigelig, når brugen vokser? Vær realistisk omkring spidsbelastninger, gentagne forsøg og falske positiver i din arbejdsbyrde. |
| FaktorSikkerhedsforanstaltninger | Hvad skal du overveje?Udsætter værktøjet din virksomhed eller arbejdsgang for risici ved manglende overholdelse, datalækage eller uautoriserede adgangspunkter? |
| FaktorKrav om overholdelse | Hvad skal du overveje?Er leverandørens tilgang i overensstemmelse med dine interne og regionale regler (f.eks. GDPR, overholdelse af robots.txt og håndtering af personoplysninger)? |
Hvad er værktøjer til webscraping?
Værktøjer til webscraping er softwareplatforme, der automatiserer hentning og udtrækning af strukturerede data fra websteder. Disse værktøjer gør det muligt at indsamle oplysninger fra sider – herunder dynamisk og JavaScript-genereret indhold – til brug i analyser, rapportering eller integration med interne databaser. De fleste tilbyder muligheder for at konfigurere udtræksregler og eksportere data i udviklervenlige formater.
Funktioner i værktøjer til webscraping
Når du vælger webskrabningsværktøjer, bør du holde øje med følgende vigtige funktioner:
- Motor til dataudtræk: Giver dig mulighed for at definere, hvordan indhold indsamles fra websteder ved hjælp af CSS-selektorer, XPath eller peg-og-klik-grænseflader for at opnå strukturerede resultater.
- JavaScript-gengivelse: Indlæser dynamiske applikationer eller enkeltsidesapps ved at udføre JavaScript, så data, der ikke vises i den statiske HTML, bliver indsamlet.
- Proxyhåndtering: Roterer IP-adresser, ofte ved hjælp af residential-proxytjenester, for at omgå geografiske blokeringer, hastighedsbegrænsninger eller botbeskyttelse, så du pålideligt kan skrabe websteder i stor skala.
- Håndtering af CAPTCHA: Registrerer og løser eller omgår automatisk CAPTCHA-udfordringer, så datapipelines fortsat kan køre, når anti-bot-foranstaltninger udløses.
- Planlægning og automatisering: Planlægger tilbagevendende skrabning eller udløser opgaver baseret på bestemte intervaller, hvilket muliggør drift uden opsyn og integration i datapipelines.
- Eksport af strukturerede data: Understøtter output til JSON, CSV, XML eller direkte levering til skylagring, API'er eller databaser, så manuelle konverterings- og uploadtrin undgås.
- Registrering af ændringer og advarsler: Overvåger målwebsteder for opdateringer af indhold, prisændringer eller nye opslag og giver dig besked, hvis resultaterne adskiller sig fra tidligere kørsler.
- Kontrol af samtidighed: Håndterer flere forespørgsler parallelt for at gøre skrabesessioner hurtigere og understøtter gennemsøgningsopgaver i stor skala på tværs af tusindvis af sider.
- Fejlhåndtering og logføring: Registrerer mislykkede udtræk, forbindelsesafbrydelser eller ændringer på websteder og leverer detaljerede fejllogge, så skrabeproblemer hurtigt kan diagnosticeres og løses.
- Brugeradgangskontrol: Begrænser, hvem der kan redigere projekter, administrere opgaver eller se eksporter, for at opretholde sikkerheden og forhindre utilsigtede eller uautoriserede ændringer.
Almindelige AI-funktioner i webskrabningsværktøjer
Ud over de standardfunktioner i webskrabningsværktøjer, der er nævnt ovenfor, integrerer mange af disse løsninger AI med funktioner som:
- Automatisk registrering af datafelter: Bruger AI til automatisk at identificere og kortlægge relevante datafelter på komplekse eller ukendte websider, hvilket reducerer behovet for manuel opsætning af selektorer.
- Adaptiv genkendelse af webstedsstruktur: Lærer og tilpasser sig ændringer i websteders layout, hvilket minimerer nedetid og vedligeholdelse, når målwebsteder opdaterer deres design.
- Intelligent omgåelse af anti-bot-systemer: Anvender AI til at efterligne menneskelige browsermønstre og tilpasse skrabestrategier i realtid, hvilket hjælper med at omgå avancerede botregistreringssystemer.
- Indholdsfortolkning med naturligt sprog: Udnytter AI til at udtrække, opsummere eller kategorisere ustruktureret tekst, hvilket gør det lettere at analysere anmeldelser, artikler eller forumindlæg.
- Automatisk generering af skabeloner: Opretter genanvendelige skrabeskabeloner til lignende websteder ved at analysere sidestruktur og indholdsmønstre med maskinlæring.
- Smart fejlkorrektion: Registrerer og løser almindelige udtræksfejl eller uregelmæssigheder ved hjælp af AI-baseret diagnosticering, hvilket reducerer behovet for manuel fejlfinding.
Fordele ved webskrabningsværktøjer
Implementering af webskrabningsværktøjer giver flere fordele for dit team og din virksomhed. Her er nogle af de fordele, du kan se frem til:
- Dataindsamling i stor skala: Automatiser udtræk af oplysninger fra mange websteder og sider, så store datasæt bliver tilgængelige til analyse eller maskinlæring.
- Markedsindsigt i realtid: Overvåg konkurrenters priser, produktkataloger og ændringer på websteder øjeblikkeligt med funktioner til planlægning, ændringsregistrering og advarsler.
- Effektiv udnyttelse af ressourcer: Planlæg og automatiser opgaver, så den manuelle indsats reduceres, mens udviklere kan fokusere på projekter med større værdi.
- Ensartet datakvalitet: Eksporter strukturerede data i pålidelige formater som JSON eller CSV, så tidskrævende datarensning og integrationsarbejde minimeres.
- Omgåelse af anti-bot-forhindringer: Brug indbygget proxyrotation eller eksterne roterende proxytjenester sammen med CAPTCHA-håndtering og omgåelse af anti-bot-systemer for at få adgang til indhold, som andre løsninger ikke kan nå.
- Tilpasning til ændringer på websteder: Stol på intelligent fejlhåndtering og (for AI-aktiverede værktøjer) automatisk tilpassende dataudtræk, når websteders layout eller struktur ændres.
- Sikker adgang og overholdelse af regler: Beskyt datapipelines med brugertilladelser, revisionslogføring og overensstemmelse med compliance-rammer eller databeskyttelsesregler.
Omkostninger og priser for webskrabningsværktøjer
Valg af værktøjer til webscraping kræver en forståelse af de forskellige prismodeller og abonnementer, der er tilgængelige. Omkostningerne varierer afhængigt af funktioner, teamstørrelse, tilføjelser og meget mere. Tabellen nedenfor opsummerer almindelige abonnementer, deres gennemsnitlige priser og typiske funktioner, der er inkluderet i løsninger til webscrapingværktøjer:
Sammenligningstabel for abonnementer til webscrapingværktøjer
| Abonnementstype | Gennemsnitlig pris | Almindelige funktioner |
|---|---|---|
| AbonnementstypeGratis abonnement | Gennemsnitlig pris$0-$10/måned | Almindelige funktionerBegrænsede ekstraktioner, grundlæggende planlægning, fællesskabssupport og grundlæggende dataeksportformater. |
| AbonnementstypePersonligt abonnement | Gennemsnitlig pris$15-$40/måned | Almindelige funktionerFlere ekstraktionskreditter, JavaScript-rendering, API-adgang og grundlæggende fejlhåndtering. |
| AbonnementstypeVirksomhedsabonnement | Gennemsnitlig pris$55-$150/måned | Almindelige funktionerHøjere samtidighed, proxyrotation, avanceret planlægning, værktøjer til teamsamarbejde og prioriteret support. |
| AbonnementstypeStorfirmaabonnement | Gennemsnitlig pris$250+/måned | Almindelige funktionerBrugerdefinerede integrationer, SLA-garantier, geografisk målrettede proxyer, assisteret opstart og dedikeret kontoadministration. |
Ofte stillede spørgsmål om webscrapingværktøjer
Her er nogle svar på almindelige spørgsmål om webscrapingværktøjer:
Har jeg brug for kodningsfærdigheder for at bruge webscrapingværktøjer?
Nej, du behøver ikke nødvendigvis programmeringserfaring. Mange visuelle værktøjer tilbyder en løsning uden kode, f.eks. en Chrome-udvidelse med klikfunktion, som gør det muligt for ikke-tekniske brugere visuelt at opbygge ekstraktionsrutiner og navigere på et webstedskort for at indsamle poster til opgaver som leadgenerering.
Kompleks brugerdefineret logik, komplekse datapipelines eller webscraping i stort omfang er dog typisk afhængige af programmeringsværktøjer:
- Python: Et traditionelt Python-bibliotek som BeautifulSoup er ideelt til ren parsing af statiske HTML-dokumenter.
- JavaScript: Et specialiseret Node.js-bibliotek (f.eks. Puppeteer eller Playwright) gør det muligt for udviklere programmatisk at interagere med dynamiske webelementer.
Kan webscrapingværktøjer håndtere dynamiske websteder og websteder med meget JavaScript?
Ja, de fleste moderne værktøjer har JavaScript-renderingsmotorer til at indsamle dynamisk indhold fra enkeltstående sideapplikationer (SPA’er) og interaktive websteder.
Hvordan håndterer webscrapingværktøjer websteders anti-bot-foranstaltninger?
For at omgå botbeskyttelse anvender avancerede værktøjer flere strategier til at undgå registrering:
- Roterende proxyer: Fordeling af forespørgsler på tværs af store IP-puljer (datacenter- og bolig-IP’er) for at undgå hastighedsbegrænsninger eller IP-forbud.
- Automatiske CAPTCHA-løsere: Løsning eller omgåelse af visuelle udfordringer og adfærdsudfordringer.
- Maskering af browserfingeraftryk: Ændring af browserheadere, canvas-fingeraftryk og brugeragenter i motorer (f.eks. WebKit eller Chromium) for at efterligne menneskelige interaktioner på tværs af større browsere som Firefox eller Chrome.
Er webscraping lovligt?
Lovligheden af webscraping afhænger af, hvilke data du indsamler, hvordan du bruger dem, og webstedets servicevilkår. Gennemgå altid juridiske retningslinjer og krav til overholdelse, før du går i gang.
Hvordan modtager og gemmer jeg de indsamlede data?
Du kan typisk eksportere data til formater som CSV, JSON eller Excel eller sende dem direkte til cloudlager, webhooks eller databaser, afhængigt af værktøjets integrationsmuligheder.