

Det kan være en udfordrende opgave at finde det rigtige værktøj til testdatahåndtering. Med så mange tilgængelige muligheder er det svært at afgøre, hvilket værktøj der virkelig opfylder dine behov, uden at spilde værdifuld tid eller ressourcer. Hvis du har oplevet problemer med værktøjer, der er unødigt komplekse, ikke kan skalere med dine projekter eller ikke overholder reglerne for databeskyttelse, er du ikke alene. Et godt værktøj til testdatahåndtering bør effektivisere oprettelsen, håndteringen og sikkerheden af dine datasæt, samtidig med at det integreres problemfrit i dine testarbejdsgange.
Som professionel inden for softwaretest med praktisk erfaring med snesevis af værktøjer har jeg mødt og overvundet de samme udfordringer, som du står over for. Derfor har jeg oprettet denne vejledning: for at forenkle din søgning og give dig en udvalgt liste over de bedste værktøjer til testdatahåndtering, der findes i dag. Uanset om din prioritet er automatisering, overholdelse af regler eller skalerbarhed, hjælper dette indlæg dig med at træffe en velinformeret beslutning.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel for værktøjer til testdatahåndtering
Tabellen nedenfor sammenligner prisoplysningerne for mine bedste værktøjer til testdatahåndtering.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til compliance-tilpasset maskering med automatisk delmængdeinddeling | 14 dages gratis prøveperiode | Pris oplyses efter forespørgsel | Website | |
| 2 | Bedst til syntetiske testdata, der er integreret i CI/CD | Gratis demonstration tilgængelig | Priser oplyses efter anmodning | Website | |
| 3 | Bedst til centraliseret testdatastyring uafhængigt af datamængde | 14 dages gratis prøveperiode | Fra €15,000/bruger/år (faktureres årligt) | Website | |
| 4 | Bedst til TDM i hele livscyklussen med databasekloning | Gratis demo tilgængelig | Priser oplyses efter anmodning | Website | |
| 5 | Bedst til testdatamaskering, der omfatter stormaskine | Ikke tilgængelig | Priser oplyses efter anmodning | Website | |
| 6 | Bedste delmængdeudvælgelse på tværs af databaser i regulerede brancher | Gratis demo tilgængelig | Pris oplyses efter anmodning | Website | |
| 7 | Bedst til databasekloning i Git-stil på tværs af fem databasemotorer | Gratis demo tilgængelig | Priser oplyses ved forespørgsel | Website | |
| 8 | Bedst til virtualisering af komplette produktionsdatabasekloner | Gratis demo tilgængelig | Fra $36,000 pr. TB årligt (faktureres årligt) | Website | |
| 9 | Bedst til SAP-nativ maskering af testdata | 14 dages gratis prøveperiode | Fra $12.00 pr. containertime | Website | |
| 10 | Bedst til AI-drevet testning | 14 dages gratis prøveperiode + gratis demonstration | Priser efter anmodning | Website |




Anmeldelser af de bedste værktøjer til testdatahåndtering
Nedenfor finder du mine detaljerede opsummeringer af de bedste værktøjer til testdatahåndtering, som kom med på min kortliste. Mine anmeldelser giver et detaljeret indblik i de vigtigste funktioner, fordele & ulemper, integrationer og ideelle anvendelsestilfælde for hvert værktøj, så du kan finde det bedste til dig.
 Bedst til compliance-tilpasset maskering med automatisk delmængdeinddeling
- 14 dages gratis prøveperiode
- Pris oplyses efter forespørgsel
Visit WebsiteCustomer Rating:4.3/5
Tonic maskerer og afidentificerer følsomme databasekolonner for at skabe sikre testdata. Tonic Structural er en platform til håndtering af testdata, der maskerer, delmængdeinddeler og klargør produktionsdata til ikke-produktionsmiljøer med understøttelse af relationelle databaser, NoSQL, datavarehuse og filkilder.
Hvem er Tonic bedst egnet til?
Tonic Structural er velegnet til compliance-fokuserede teams inden for sundhedssektoren og finans, som har brug for at maskere og delmængdeinddele produktionsdata, samtidig med at de opretholder revisionsklar dokumentation af databeskyttelsen.
Hvorfor jeg valgte Tonic
Tonic kommer med på min shortlist, fordi platformens maskerings- og delmængdeinddelingsfunktioner er tæt integreret på en måde, jeg sjældent ser. Jeg er især begejstret for, hvordan Privacy Hub markerer hver kolonne som I risikozonen, Beskyttet eller Ikke følsom og derefter lader dig anvende generatorer samlet samt eksportere en komplet privatlivsrapport til revisionsformål. Den patenterede delmængdeinddeler håndterer virtuelle fremmednøgler og cirkulære afhængigheder automatisk, så din maskerede delmængde bevarer referentiel integritet, selv på tværs af komplekse skemaer med flere tabeller.
Tonics vigtigste funktioner
- Strukturel agent: En AI-chatassistent, der er indbygget i appen, og som opsummerer resultaterne af følsomhedsscanninger, anbefaler generatorer og anvender dem automatisk på dine kolonner.
- Kontroller til differentiel databeskyttelse: Kategoriske og kontinuerte generatorer understøtter differentiel databeskyttelse med et konfigurerbart databeskyttelsesbudget, der begrænser statistisk slutning ud fra transformerede data.
- Output til containerlager: Structural skriver maskerede og delmængdeinddelte data direkte som containervolumener til PostgreSQL, MySQL og SQL Server, så du kan starte isolerede databaser efter behov.
- Versionshistorik: Registrerer alle ændringer i arbejdsområdets konfiguration – generatorer, regler for delmængdeinddeling, tabeltilstande og scripts efter job – med angivelse af, hvem der foretog ændringen, samt mulighed for at gendanne tidligere versioner.
Tonics integrationer
Tonic tilbyder indbyggede integrationer med PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, Snowflake, BigQuery, Redshift, Databricks og Amazon S3. Platformen understøtter også REST API, GitHub Actions, Kubernetes, Helm og containerregistre, herunder Amazon ECR, Google Artifact Registry og Azure Container Registry.
Pros and Cons
Pros:
- Bevarer sammenføjninger på tværs af komplekse skemaer
- Privacy Hub kortlægger følsomme kolonner til revisioner
- Produktionslignende data bevarer statistiske relationer
Cons:
- Syntese fra bunden kræver det separate Fabricate-produkt
- Containeriserede databaser kræver Kubernetes-udrulning
Learn more about Tonic: Bedst til syntetiske testdata, der er integreret i CI/CD
- Gratis demonstration tilgængelig
- Priser oplyses efter anmodning
Visit WebsiteCustomer Rating:4.6/5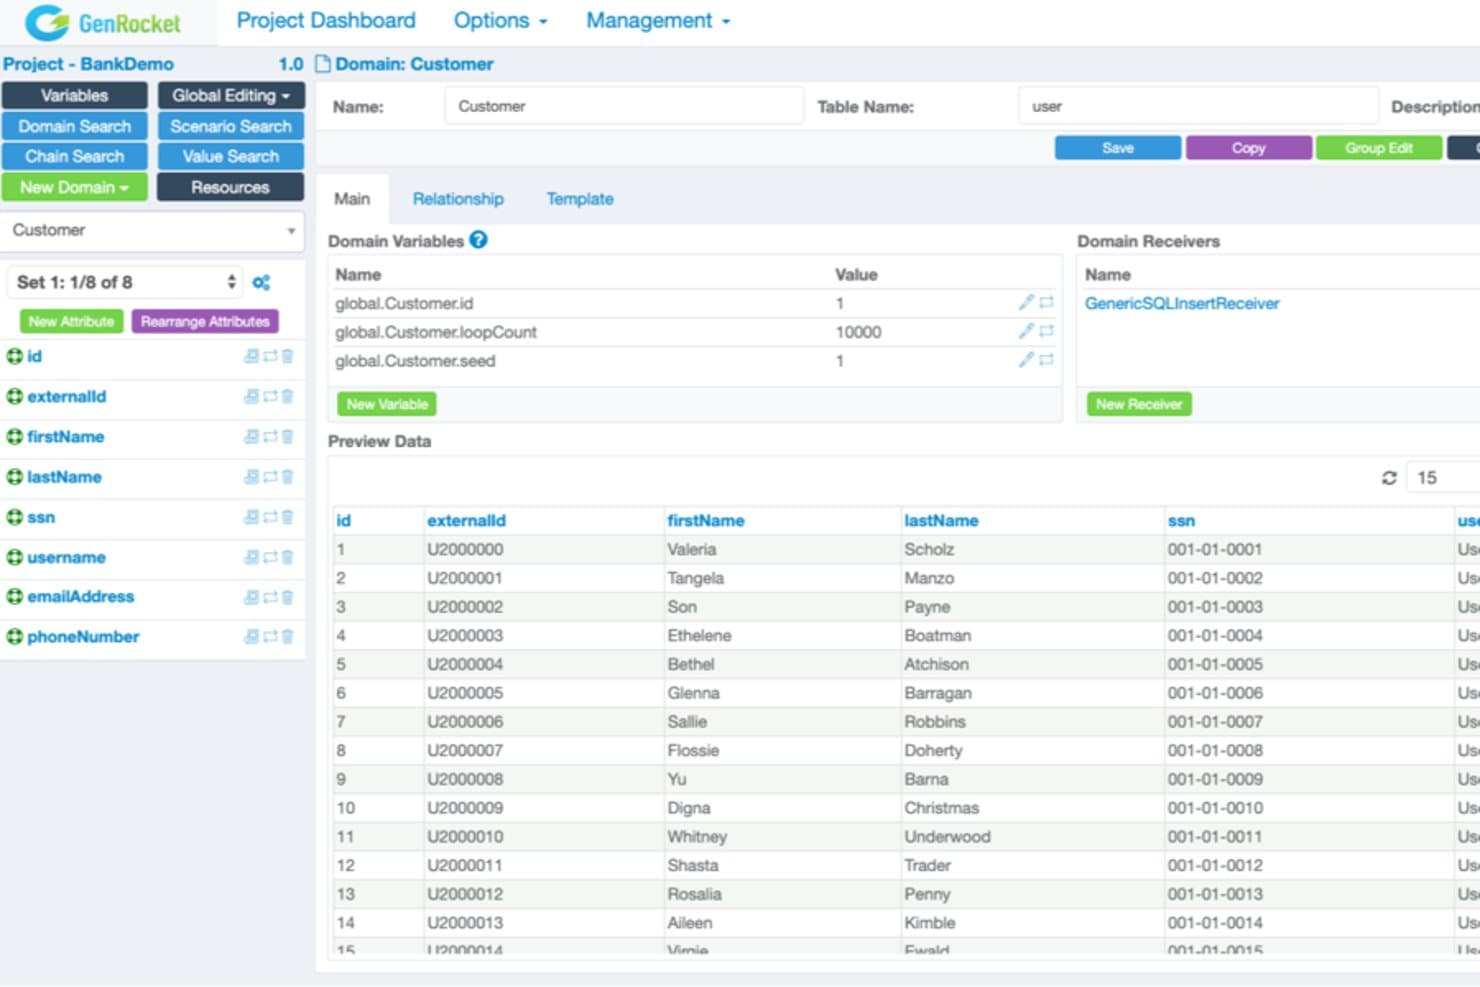
GenRocket giver brugerne mulighed for visuelt at forhåndsvise og konfigurere testdatadomæner. GenRocket er en platform til håndtering af syntetiske testdata, der genererer data i realtid ud fra metadata og skemaer og dækker datamaskering, intelligent deludvælgelse, output i flere formater og selvbetjeningsprovisionering på tværs af CI/CD-pipelines.
Hvem egner GenRocket sig bedst til?
GenRocket er velegnet til QA- og DevOps-teams, der har brug for syntetiske testdata efter behov, genereret direkte i CI/CD-pipelines uden nogensinde at berøre produktionsdata.
Hvorfor valgte jeg GenRocket?
GenRocket kommer med på min liste over favoritter, fordi det er den eneste platform til testdata, jeg har set, der specifikt er udviklet til at generere syntetiske data i realtid direkte i en CI/CD-pipeline uden nogensinde at berøre produktionen. Den patenterede motor til referentiel integritet holder data konsistente på tværs af flere skemaer og databaser samtidig, hvilket er særdeles sjældent. Jeg kan også godt lide, at hvert testdatasæt genereres på helt ned til 100 millisekunder, så pipelineafviklingen ikke går i stå, mens den venter på klargøring af data.
Vigtige funktioner i GenRocket
- Registrering af skemaændringer med G-Delta: Identificerer automatisk ændringer i databaseskemaer på tværs af MySQL, MS SQL, Oracle og PostgreSQL og udløser derefter G-Refactor for at opdatere alle berørte testdatatilfælde.
- Maskering på stedet: Erstatter følsomme felter i Oracle-, MS SQL Server-, IBM DB2-, PostgreSQL- og MySQL-databaser med syntetisk genererede ækvivalenter uden nogensinde at læse ægte produktionsværdier.
- G-Portal-selvbetjeningsportal: Giver udviklere og testere en rollebaseret grænseflade til at søge efter, anmode om, spore og downloade testdatatilfælde uden at involvere et centralt datateam ved hver anmodning.
- Over 750 intelligente datageneratorer: Dækker stort set alle datatyper, domæner og forretningsregler, herunder betinget logik, afhængigheder mellem felter og regex-begrænsninger.
Integrationer med GenRocket
GenRocket integreres med Jenkins, Azure DevOps, TeamCity, CircleCI, GitHub, Cucumber, Selenium, JUnit, JMeter og LoadRunner. Det understøtter også REST API, JDBC, SOAP, TCP/IP-sockets og Docker-implementering til tilpassede CI/CD-arbejdsgange.
Pros and Cons
Pros:
- Syntetisk datagenerering opretholder referentiel integritet
- Klargøring af data i realtid til CI/CD-pipelines
- Ubegrænset datamængde uden opdateringscyklusser
Cons:
- Ingen formatbevarende eller reversibel maskering
- PII-registrering er ikke fuldt tilgængelig før {{year}}
Learn more about GenRocket: Bedst til centraliseret testdatastyring uafhængigt af datamængde
- 14 dages gratis prøveperiode
- Fra €15,000/bruger/år (faktureres årligt)
Visit WebsiteCustomer Rating:4.5/5
Datamaskering hjælper dig med at holde følsomme kundeoplysninger private. DATPROF er en platform til testdatastyring, der kombinerer datamaskering, delmængdedannelse, generering af syntetiske data, opdagelse af personhenførbare oplysninger, virtualisering af databaser og centraliseret klargøring på tværs af relationelle datakilder, NoSQL-datakilder og skybaserede datakilder.
Hvem er DATPROF bedst egnet til?
DATPROF er velegnet til dataingeniører og databaseadministratorer i mellemstore og store virksomheder, der administrerer komplekse miljøer med flere databaser, hvor referentiel integritet og compliance ikke er til forhandling.
Hvorfor valgte jeg DATPROF?
Jeg valgte DATPROF som en af de bedste, fordi licensmodellen, der er uafhængig af datamængden, virkelig adskiller platformen fra andre: Licensomkostningen forbliver den samme, uanset om du maskerer 500 GB eller 100 TB, hvilket er vigtigt, når du opretter en delmængde af en produktionsdatabase som den på 23 TB, som Heineken reducerede til 130 GB. Den patenterede registrering af fremmednøglecyklusser i DATPROF Subset håndterer komplekse skemaer med flere tusinde tabeller, samtidig med at den referentielle integritet på tværs af systemer bevares. Kombineret med den centraliserede orkestrering i Runtime-portalen kan alle teammedlemmer klargøre deres eget opdaterede miljø uden at vente på en databaseadministrator.
Vigtige funktioner i DATPROF
- Deterministisk maskering på tværs af systemer: Anvender ensartede maskerede værdier for det samme input på tværs af flere databaser samtidig, så den referentielle integritet bevares og sporbarheden i ende-til-ende-test sikres.
- Opdagelse og profilering af personhenførbare oplysninger: Scanner databaser for automatisk at identificere, hvor følsomme data findes, med understøttelse af brugerdefinerede registreringsregler ved hjælp af regulære udtryk eller listebaserede udtryk.
- Selvbetjeningsportal til klargøring: Giver testere og udviklere mulighed for at logge ind på DATPROF Runtime og opdatere deres egne testmiljøer uafhængigt uden at vente på en databaseadministrator.
- Databasekloning med kopiering ved skrivning: DATPROF Virtualize opretter virtuelle databasemiljøer i fuld størrelse uden at bruge ekstra lagerplads, og tilbagerulning af øjebliksbilleder gennemføres på under 20 sekunder.
DATPROF-integrationer
DATPROF understøtter CI/CD-integrationer med Jenkins, Azure DevOps, GitLab og Bamboo samt integrationer til testautomatisering med Parasoft og Tosca. Dens REST API understøtter brugerdefinerede integrationer, og der findes markedspladsfortegnelser via Azure Marketplace og AWS Marketplace.
Pros and Cons
Pros:
- Maskering bevarer den referentielle integritet på tværs af databaser
- Delmængdedannelse reducerer effektivt massive produktionsdatasæt
- Rollebaseret webportal til selvbetjent opdatering
Cons:
- Begrænset indbygget understøttelse af SaaS-datakilder
- Ingen stormaskine- eller bredere NoSQL-databasedækning
Learn more about DATPROF: Bedst til TDM i hele livscyklussen med databasekloning
- Gratis demo tilgængelig
- Priser oplyses efter anmodning

Enov8 giver på et øjeblik ledelsesoverblik over PII på tværs af datakilder. Enov8 er en platform til håndtering af testdata, der dækker hele TDM-livscyklussen, herunder AI-drevet profilering af data, maskering, delmængder, syntetisk datagenerering og databasevirtualisering via dens vME-kloningsmotor.
Hvem er Enov8 bedst egnet til?
Enov8 er et stærkt valg for DevOps- og QA-teams i regulerede brancher, som har brug for én platform til samlet håndtering af maskering, delmængder, syntetiske data og databasevirtualisering.
Hvorfor valgte jeg Enov8?
Jeg valgte Enov8 som et af de bedste værktøjer, fordi det er det eneste værktøj på min liste, der kombinerer TDM i hele livscyklussen med sin vME-databasekloningsmotor, som opretter produktionsrealistiske databasekopier på omkring 40 MB pr. klon uanset kildens størrelse. Jeg er især begejstret for, hvordan maskering, delmængder og syntetisk datagenerering alle integreres direkte i virtualiseringslaget, så klonerne allerede er beskyttet af hensyn til privatlivets fred, før de kommer ind i et testmiljø.
Vigtige funktioner i Enov8
- AI-drevet opdagelse af PII: En ML-drevet profileringsmotor scanner automatisk tilsluttede datakilder for at klassificere følsomme felter og markere kolonner med lovgivningsmæssig risiko, før maskeringen begynder.
- Reservation af testdata: Et indbygget bookingsystem lader teams reservere og administrere datasæt centralt, så konflikter mellem samtidige brugere og miljøer undgås.
- Valideringsscanning efter maskering: En ML-drevet valideringskørsel bekræfter maskeringens effektivitet efter hver sikringskørsel og genererer revisionsklar dokumentation for overholdelse af regler.
- Integrationshub til DevOps Manager: Et sprogagnostisk orkestreringslag, der indeholder automatiseringsscripts i Python, Bash, Ansible, Java og flere andre sprog og forbinder Enov8 med CI/CD-pipelines på tværs af Jenkins, GitLab CI/CD og Azure DevOps.
Enov8-integrationer
Enov8 understøtter over 100 integrationer, herunder Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy og Ansible. Dets REST API, webhooks, planlægger og DevOps Manager understøtter tilpassede CI/CD-arbejdsgange.
Pros and Cons
Pros:
- Databasevirtualisering med små kloner på 40 MB
- AI-drevet opdagelse af PII og validering af maskering
- Central reservation af testdata forhindrer konflikter om tildeling
Cons:
- Mængden af offentlige anmeldelser er relativt begrænset
- Ingen attester fra tredjepart om overholdelse af regler er angivet
Learn more about Enov8: Bedst til testdatamaskering, der omfatter stormaskine
- Ikke tilgængelig
- Priser oplyses efter anmodning

Broadcom Test Data Manager holder styr på statusser for importjob i én visning. Broadcom Test Data Manager er en testdatastyringsplatform til virksomheder, der kombinerer datamaskering, generering af syntetiske data, delmængdeudvælgelse, PII-registrering, databasevirtualisering og selvbetjeningsbaseret klargøring – med dedikeret understøttelse af stormaskinemiljøer samt moderne distribuerede databaser og skydatabaser.
Hvem egner Broadcom Test Data Manager sig bedst til?
Store virksomheder, der kører stormaskinemiljøer sammen med moderne distribuerede systemer, får mest ud af denne platform.
Hvorfor valgte jeg Broadcom Test Data Manager?
Jeg har inkluderet Broadcom Test Data Manager blandt mine bedste valg, fordi det er den eneste platform, jeg har set, der behandler stormaskinemiljøer som en central del på lige fod med moderne distribuerede systemer. Det dedikerede CA TDM for Mainframe-modul giver dig mulighed for at maskere og udvælge delmængder af data på tværs af z/OS, VSAM og IMS via den samme brugerflade, som du bruger til SQL Server eller Oracle. Det automatiserede PII-varmekort scanner hele stormaskineskemaer og markerer følsomme felter, før du anvender en eneste maskeringsregel, hvilket reducerer det manuelle kortlægningsarbejde, der normalt belaster compliance-teams.
Vigtige funktioner i Broadcom Test Data Manager
- Selvbetjeningsportal til data: Et centralt katalog, hvor testere efter behov kan anmode om, reservere og frigive testdata ved hjælp af dynamiske formularer uden at vente på databaseadministratorer.
- DAVE-databasevirtualisering: En kloningsmotor med skrivning ved kopiering, der på få minutter opretter uafhængige databasekloner fra et delt basisafbildning med et minimalt lagerforbrug.
- Javelin-arbejdsgangsautomatisering: En indbygget visuel automatiseringsmotor, der orkestrerer opgaver til maskering, delmængdeudvælgelse og klargøring og kan udløses via REST API eller CI/CD-pipelines.
- Bevarelse af referentiel integritet: Maskerings- og delmængdeudvælgelseshandlinger bevarer relationer på tværs af tabeller, så testdatasæt forbliver funktionelt sammenhængende til ende-til-ende-test.
Integrationer med Broadcom Test Data Manager
Dokumenterede integrationer omfatter Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM og CA Agile Central. REST API'er understøtter tilpassede CI/CD-arbejdsgange, mens Docker og Kubernetes understøtter containerbaserede installationer.
Pros and Cons
Pros:
- Testdatamaskering, der omfatter stormaskine
- Automatiseret PII-registrering og varmekort
- Databasevirtualisering med skrivning ved kopiering (DAVE)
Cons:
- Ingen tilgængelig SaaS-installationsmulighed
- Brugerfladen virker forældet og kompleks
Learn more about Broadcom Test Data Manager: Bedste delmængdeudvælgelse på tværs af databaser i regulerede brancher
- Gratis demo tilgængelig
- Pris oplyses efter anmodning

IBM InfoSphere Optim hjælper dig med hurtigt at oprette testdata. IBM Test Data Management er en virksomhedsløsning til håndtering af testdata, der dækker datamaskering, delmængdeudvælgelse på tværs af databaser og behovsbaseret levering af data på tværs af en lang række relationelle datakilder og mainframe-datakilder.
Hvem er IBM Test Data Management bedst egnet til?
IBM Test Data Management er velegnet til store virksomheder i regulerede brancher—finansielle tjenester, sundhedspleje og forsikring—der driver komplekse miljøer med flere databaser eller mainframe-integration, hvor datamaskering og delmængdeudvælgelse på tværs af databaser er krav for overholdelse af regler.
Hvorfor jeg valgte IBM Test Data Management
IBM Test Data Management kommer med på min liste på grund af den måde, løsningen håndterer delmængdeudvælgelse på tværs af databaser på forretningsobjektniveau og samtidig henter delmængder med bevaret referentiel integritet fra flere forbundne databaser. Jeg er især imponeret over dens funktion til fødereret udtræk, som gør det muligt for team at arbejde på tværs af heterogene datalandskaber, herunder mainframe-datakilder som VSAM og IMS, hvor næsten ingen konkurrerende værktøjer fungerer. Dens mere end 40 foruddefinerede maskeringsregler med formatbevarende output gør den reelt nyttig i GDPR- og HIPAA-regulerede miljøer.
Vigtigste funktioner i IBM Test Data Management
- Integration med Governance Catalog: Træk og slip regler for dataklassifikation direkte på kolonne-tilknytninger for automatisk at tildele maskeringsrutiner fra et centralt politikkatalog.
- Apache Spark-kørselsmiljø: En indlejret Spark-motor håndterer databehandling i stor skala i automatiserede arbejdsgange til delmængdeudvælgelse og maskering.
- Rollebaseret adgangskontrol: Keycloak-baseret RBAC med understøttelse af LDAP, SAML, OIDC og Kerberos styrer, hvem der kan få adgang til, anmode om og opdatere testdatasæt.
- Rapportering om overholdelse: Indbygget rapportering validerer håndhævelsen af databeskyttelsespolitikker i GDPR- og HIPAA-regulerede miljøer.
Integrationer med IBM Test Data Management
Dokumenterede integrationer omfatter IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark og databaser som Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza og begrænset MongoDB-understøttelse. Dens OpenAPI 2.0 REST API understøtter brugerdefineret orkestrering og CI/CD-arbejdsgange, mens z/OS-udgaven opretter forbindelse til VSAM og IMS.
Pros and Cons
Pros:
- Bevarer referentiel integritet på tværs af databaser
- Formatbevarende maskering understøtter regulerede data
- Håndterer VSAM- og IMS-delmængder
Cons:
- Ingen indbygget generering af syntetiske data
- Fysiske kopier erstatter virtuel kloning
Learn more about IBM Test Data Management: Bedst til databasekloning i Git-stil på tværs af fem databasemotorer
- Gratis demo tilgængelig
- Priser oplyses ved forespørgsel

Redgate SQL Provision lader brugere administrere databasekloner på tværs af flere SQL-instanser. Redgate SQL Provision er et værktøj til testdatastyring, der dækker datamaskering, delmængder og databasekloning i Git-stil på tværs af SQL Server, PostgreSQL, MySQL, MariaDB og Oracle.
Hvem er Redgate SQL Provision bedst egnet til?
Redgate SQL Provision er et stærkt valg for databaseadministratorer og QA-ingeniører, der har brug for hurtig, versionsstyret databasekloning og maskering på tværs af flere relationelle databasemotorer.
Hvorfor valgte jeg Redgate SQL Provision?
Jeg valgte Redgate SQL Provision som en af de bedste løsninger, fordi databasekloningen i Git-stil virkelig adskiller sig fra alt andet, jeg har set på tværs af fem databasemotorer. Redgate Clone opretter en live-datacontainer på få sekunder uanset databasens størrelse, så en SQL Server-database på 5 TB klargøres lige så hurtigt som en på 128 MB. Du kan oprette grene, nulstille og gemme revisioner som i en Git-arbejdsgang, hvilket gør det nemt at give hver tester sit eget isolerede miljø uden at duplikere lagerplads.
Vigtige funktioner i Redgate SQL Provision
- Anonymiserings-CLI (
rganonymize): Et kommandolinjeværktøj i tre trin, der klassificerer PII-kolonner, knytter maskeringsregler til dem og erstatter reelle værdier på tværs af SQL Server, PostgreSQL, MySQL, MariaDB og Oracle. - Deterministisk maskering: Maskerer den samme inputværdi til det samme output hver gang ved hjælp af en fast startværdi, så maskerede data forbliver konsistente på tværs af relaterede tabeller.
- Dataudvælgelse: CLI-værktøjet
rgsubsethenter en konfigurerbar del af din kildedatabase – som standard 10 % – samtidig med at fremmednøgler følges for at bevare den referentielle integritet. - AI-tilpassede datasæt: Lader dig beskrive de værdier, du har brug for, i almindeligt sprog og genererer en liste på op til 1.000 værdier, som kan gennemgås og bruges til maskeringsudskiftning.
Integrationer med Redgate SQL Provision
Redgate SQL Provision integreres med SQL Server, PostgreSQL, MySQL, MariaDB, Oracle, Docker, AWS CloudFormation, Azure Kubernetes Service, SQL Data Catalog, PowerShell og dbatools. Dets CLI-værktøjer understøtter scriptbaserede CI/CD-arbejdsgange, men oprindelige plugins til Jenkins, Azure DevOps og GitHub Actions er ikke dokumenteret.
Pros and Cons
Pros:
- Forgrening i Git-stil opdaterer testdatabaser hurtigt
- Deterministisk maskering bevarer konsistensen på tværs af tabeller
- Fremmednøglebaseret udvælgelse beskytter den relationelle integritet
Cons:
- Syntetisk datagenerering stopper ved værdilister
- Produktets positionering skaber usikkerhed hos købere
Learn more about Redgate SQL Provision: Bedst til virtualisering af komplette produktionsdatabasekloner
- Gratis demo tilgængelig
- Fra $36,000 pr. TB årligt (faktureres årligt)
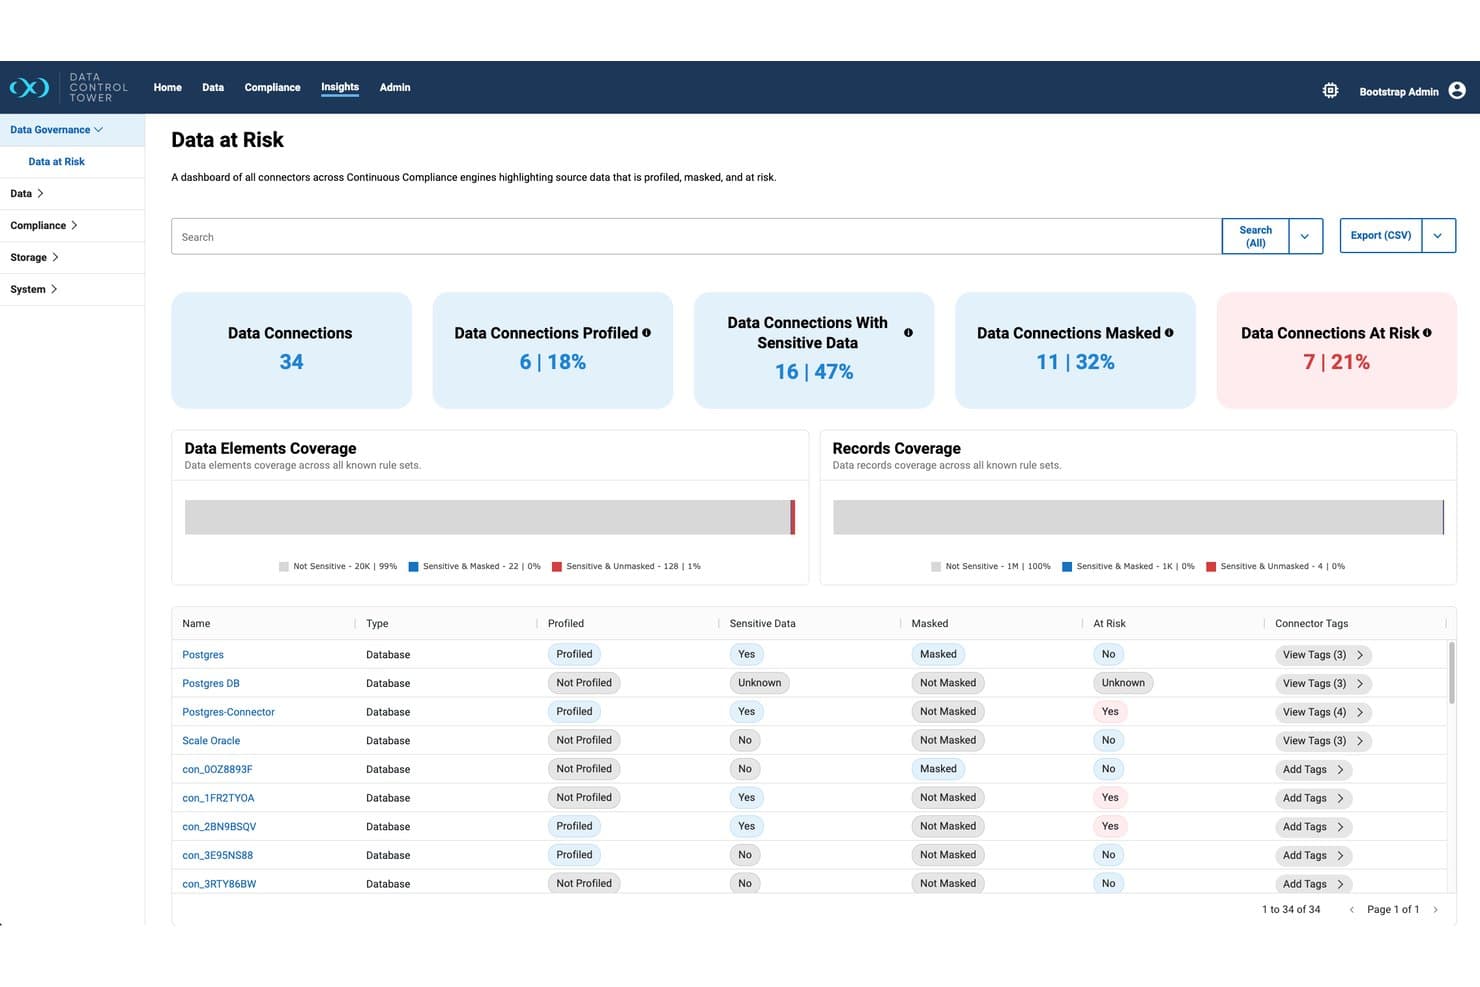
Perforce Delphix viser datarisiko på tværs af alle tilsluttede kilder på et øjeblik. Perforce Delphix er en platform til testdatahåndtering, der kombinerer datavirtualisering, automatiseret maskering, AI-baseret generering af syntetiske data og selvbetjent klargøring på tværs af over 170 datakilder.
Hvem er Perforce Delphix bedst egnet til?
Perforce Delphix er velegnet til store virksomheder med komplekse databasemiljøer med flere kilder, hvor klargøring af produktionslignende testdata i stor skala er et dagligt driftsbehov.
Hvorfor valgte jeg Perforce Delphix?
Perforce Delphix kommer med på min liste over de bedste løsninger, fordi datavirtualisering baseret på kopiering ved skrivning opretter komplette, produktionsidentiske databasekloner på få minutter i stedet for dage – uden at forbruge tilsvarende meget lagerplads. Jeg kan godt lide, at teams kan versionsstyre disse virtuelle kopier som kode ved hjælp af Data Control Tower, så de efter behov kan oprette bogmærker, spole tilbage og forgrene datasæt på tværs af miljøer. Til maskering i stor skala paralleliserer Hyperscale Compliance job på tværs af milliarder af rækker, samtidig med at referentiel integritet bevares på tværs af kilder.
Vigtige funktioner i Perforce Delphix
- Automatiseret identificering af følsomme data: ASDD scanner tilsluttede kilder og genererer en maskeringsfortegnelse med konfidensscorer og foreslåede maskeringsalgoritmer for hvert identificeret felt.
- Hyperscale Compliance: Paralleliserer maskeringsjob på tværs af milliarder af rækker ved hjælp af containerbaseret udførelse, specifikt udviklet til Oracle- og SQL Server-databaser i virksomhedsskala.
- Skabeloner til overholdelsespolitikker: Forudbyggede profiler til GDPR, HIPAA, PCI-DSS og CCPA gør det muligt for teams at anvende maskeringsregler uden at opbygge politikker fra bunden.
- Integration med CI/CD-pipelines: En indbygget Jenkins-udvidelse, en Terraform-provider og en automatiseringsramme med åben kildekode forbinder levering af testdata direkte med dine eksisterende implementeringspipelines.
Integrationer med Perforce Delphix
Perforce Delphix understøtter over 170 datakilder, herunder Oracle, SQL Server, PostgreSQL, Salesforce, SAP HANA, AWS, Azure og Google Cloud. Løsningen tilbyder indbyggede Jenkins- og Terraform-integrationer, forbindelse til Azure Data Factory og Azure Synapse, OpenShift-understøttelse, REST API'er samt en automatiseringsramme med åben kildekode.
Pros and Cons
Pros:
- Opretter kloner i fuld størrelse øjeblikkeligt
- Bevarer referentiel integritet under maskering
- Centraliseret selvbetjening og datastyring
Cons:
- Ingen filtrering på række- eller tabelniveau
- Den indledende opsætning er teknisk krævende
Learn more about Perforce Delphix: Bedst til SAP-nativ maskering af testdata
- 14 dages gratis prøveperiode
- Fra $12.00 pr. containertime
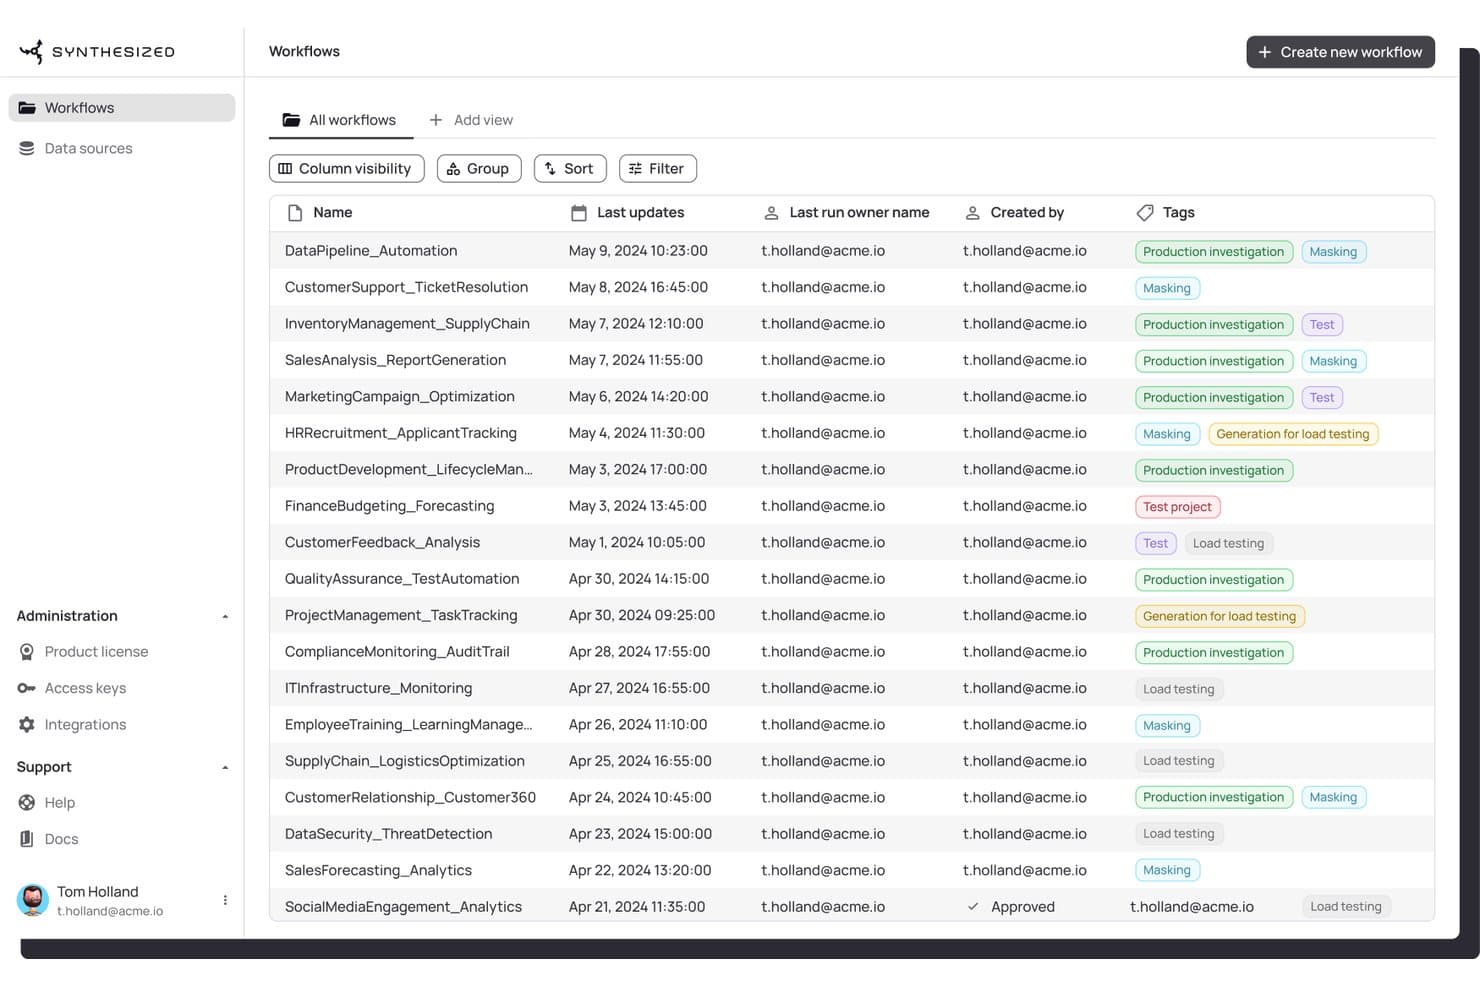
Synthesized organiserer arbejdsgange for testdata med mærker og kørselshistorik. Synthesized er en platform til håndtering af testdata, udviklet til virksomhedsmiljøer, som tilbyder datamaskering, PII-registrering, generering af syntetiske data, deludvælgelse og selvbetjent klargøring på tværs af relationelle databaser og SAP-applikationslandskaber.
Hvem er Synthesized bedst til?
Synthesized passer godt til virksomhedsteams, der driver SAP-landskaber og har brug for kompatible testdata, der er tro mod produktionen, på tværs af komplekse miljøer med flere moduler.
Hvorfor jeg valgte Synthesized
Synthesized kommer på min kandidatliste på grund af den dybe forståelse af SAP's interne datamodel. De fleste TDM-værktøjer behandler SAP som enhver anden database, men Synthesized kortlægger automatisk virtuelle fremmednøgler på tværs af SAP-moduler, hvilket betyder, at deludvælgelse af et ordre-til-betalingsdatasæt ikke efterlader forældreløse poster, der ødelægger din regressionstestpakke. Jeg kan også godt lide, at platformen leveres med forudbyggede maskeringsskabeloner til SAP-specifikke moduler som Ariba og SuccessFactors, så du ikke skal opbygge PII-politikker fra bunden.
Vigtige funktioner i Synthesized
- Automatisk PII-scanning: En indbygget scanner registrerer følsomme data på tværs af 28 kategorier – herunder finansielle identifikatorer, legitimationsoplysninger og lokaliseringsdata – ved hjælp af mønstergenkendelse og valideringsalgoritmer.
- Konfiguration af data som kode: Arbejdsgange for testdata defineres i YAML eller Python DSL, hvilket muliggør Git-baseret versionsstyring og gentagelig, revisionsklar klargøring af datasæt på tværs af miljøer.
- Procentbaseret deludvælgelse: Brugere kan udtrække udsnit på 10 %, 25 % eller 50 % af produktionsdata, filtreret efter dato, ID eller brugerdefinerede betingelser, samtidig med at den fulde referentielle integritet bevares.
- Kubernetes-baseret containeriseret motor: Platformen implementeres via Helm-diagram, Docker Compose, ECS eller EKS og understøtter oprettelse af midlertidige pods med testdata i containerbaserede pipelines.
Integrationer med Synthesized
Synthesized tilbyder indbyggede integrationer med GitHub Actions, GitLab CI, Jenkins, Azure DevOps, Tricentis Tosca, UiPath Test Suite, Testcontainers, Apache Airflow og Prefect. Den tilbyder også en REST API samt forbindelser til SAP HANA, PostgreSQL, Oracle, Snowflake, Salesforce, Workday og ServiceNow.
Pros and Cons
Pros:
- Indbyggede arbejdsgange til SAP-modulbevidst maskering af data
- Automatisk PII-scanning med tilpasselige kategorier
- Deterministisk maskering bevarer datarelationer
Cons:
- Ingen understøttelse af NoSQL eller stormaskiner
- Ekstremt få offentlige brugeranmeldelser
Learn more about Synthesized: Bedst til AI-drevet testning
- 14 dages gratis prøveperiode + gratis demonstration
- Priser efter anmodning
Visit WebsiteCustomer Rating:4.2/5
Tag skærmbilleder af mobilapplikationer for at dokumentere resultatet af dine test. Tricentis’ qTest-modul er designet til at centralisere og organisere softwaretest gennem hele udviklingslivscyklussen. Værktøjet giver dig mulighed for at opnå en automatiseringsgrad på 90 % fra start til slut, hvilket frigiver testtid for dit team. Tricentis er nemt at implementere i din arbejdsgang og tilbyder onlinekurser, der kan hjælpe med oplæringen af dit team. Tricentis giver mulighed for at oprette automatiserede testcases uden brug af scriptskrivning, hvilket gør det muligt for alle medlemmer af dit team at skrive testcases. Værktøjet bruges til automatisering af både brugergrænseflader og API’er, hvilket betyder, at alle dele af din udviklingslivscyklus er dækket. Tricentis understøtter CI/CD og tilbyder understøttelse på tværs af browsere. Tricentis integreres med værktøjer som Azure, Jenkins, Jira og Cucumber. Tricentis tilbyder skræddersyede priser efter anmodning. Værktøjet tilbyder også en gratis prøveperiode.
Learn more about Tricentis Tosca:
Andre værktøjer til testdatahåndtering
Her er nogle yderligere muligheder for værktøjer til testdatahåndtering, som ikke kom med på min kortliste, men som stadig er værd at undersøge:
- 11InformaticaBedst til test i virksomheder
- 12BMC CompuwareBedst til øjeblikkelig test
- 13Rocket Data ExpressBedst til at spare testressourcer
- 14Accelario Continuous DataOps PlatformBedst til CI/CD-udløst databasevirtualisering
- 15Avo Test Data ManagementBedst til hurtig og pålidelig generering af testdata
- 16SynthoBedst til privatlivsorienteret generering af syntetiske data
- 17IRI VoracityBedst til samlet maskering af strukturerede og mørke data
Sådan evaluerer jeg værktøjer til håndtering af testdata
Jeg vurderer værktøjer i to lag: centrale funktioner, som et værktøj skal have for at kvalificere sig, samt differentierende faktorer, der gør ét værktøj bedre egnet end et andet.
Central funktionalitet
Jeg vurderer hvert værktøj på en skala fra 0 til 5 for datamaskering og anonymisering, generering af syntetiske data, dataudvælgelse, understøttelse af flere databasetyper, klargøring af testdata og selvbetjening samt integration med CI/CD og automatisering. Værktøjets samlede score omregnes til en procentdel, og en minimumsscore på 65 % kræves for optagelse.
Differentierende faktorer
Jeg sammenligner blandt andet datavirtualisering, letvægtskloner, AI-drevet dataopdagelse, automatisk klassifikation af følsomme felter og indbygget compliance-rapportering med revisionsspor.
Mere end funktioner
Jeg evaluerer også implementeringsfleksibilitet, herunder lokal installation, cloud og hybrid drift, samt sikkerhedscertificeringer som SOC 2 Type II og ISO 27001. Endelig vurderer jeg skalerbarheden ved store databaser og komplekse skemaer.
Sådan vælger du et værktøj til testdatahåndtering
Det er nemt at fare vild i lange funktionslister og komplekse prisstrukturer. For at hjælpe dig med at holde fokus, mens du arbejder dig gennem din unikke proces for valg af software, får du her en tjekliste over faktorer, du bør have in mente:
| Faktor | Hvad skal du overveje? |
|---|---|
| FaktorSkalerbarhed | Hvad skal du overveje?Vil værktøjet vokse sammen med dit team? Overvej fremtidig datamængde og vækst i antallet af brugere. Se efter fleksible abonnementer, der kan håndtere skalering uden markante omkostningsstigninger. |
| FaktorIntegrationer | Hvad skal du overveje?Fungerer det sammen med dine eksisterende systemer? Kontrollér kompatibiliteten med dine nuværende testværktøjer, databaser og arbejdsgange for at undgå forstyrrelser. |
| FaktorTilpasningsmuligheder | Hvad skal du overveje?Kan du tilpasse værktøjet til dine behov? Vurder, om værktøjet giver mulighed for tilpassede dataskabeloner og arbejdsgange, der passer til dine processer. |
| FaktorBrugervenlighed | Hvad skal du overveje?Er det brugervenligt for dit team? Overvej læringskurven, og om ikke-teknisk personale nemt kan navigere i værktøjet uden omfattende oplæring. |
| FaktorImplementering og introduktion | Hvad skal du overveje?Hvor hurtigt kan du komme i gang? Se efter værktøjer, der tilbyder hurtig opsætning, oplæringsressourcer og support for at sikre en problemfri overgang. |
| FaktorPris | Hvad skal du overveje?Passer det til dit budget? Sammenlign prismodeller, og sørg for, at der ikke er skjulte gebyrer. Undersøg, om der findes en gratis prøveperiode eller demo, som du kan afprøve, før du binder dig. |
| FaktorSikkerhedsforanstaltninger | Hvad skal du overveje?Hvordan beskytter det dine data? Sørg for, at værktøjet overholder standarder for datasikkerhed og tilbyder kryptering og adgangskontroller for at beskytte følsomme oplysninger. |
| FaktorKrav til overholdelse af regler | Hvad skal du overveje?Opfylder det lovgivningsmæssige behov? Kontrollér, om værktøjet understøtter overholdelse af relevante regler for databeskyttelse som GDPR eller HIPAA, afhængigt af kravene i din branche. |
Hvad er værktøjer til testdatahåndtering?
Værktøjer til testdatahåndtering er software, der bruges til at generere, håndtere og vedligeholde data til softwaretest. De håndterer oprettelse og manipulation af testdata og sikrer, at dataene er nøjagtige, sikre og egnede til forskellige testscenarier.
Disse værktøjer spiller en afgørende rolle i organiseringen og klargøringen af data til funktionstest, ydeevnetest og regressionstest i softwareudvikling og arbejder ofte sammen med værktøjer til databasetest for at sikre omfattende datavalidering.
Funktioner
Når du vælger værktøjer til testdatastyring, bør du holde øje med følgende vigtige funktioner:
- Datamaskering: Beskytter følsomme oplysninger ved at erstatte dem med fiktive data og sikrer overholdelse af krav til privatliv.
- Dataudsnit: Udtrækker et udsnit af data fra store datasæt, så test bliver mere overskuelig og effektiv.
- Integrationsmuligheder: Opretter forbindelse til eksisterende testværktøjer og databaser og understøtter smidige arbejdsgange.
- Brugerdefinerede dataskabeloner: Giver brugerne mulighed for at oprette skabeloner, der er tilpasset deres specifikke testbehov, hvilket øger fleksibiliteten.
- AI-drevet datagenerering: Bruger kunstig intelligens til at generere realistiske testdata og forbedrer testnøjagtigheden.
- Klargøring af data i realtid: Giver øjeblikkelig adgang til nødvendige testdata og reducerer forsinkelser i testprocessen.
- Understøttelse af flere cloudmiljøer: Gør det muligt for værktøjet at fungere på tværs af forskellige cloudmiljøer og giver fleksibilitet ved implementering.
- Kryptering og adgangskontrol: Sikrer datasikkerheden ved at kryptere data og fastsætte brugeradgangstilladelser.
- Uddannelsesressourcer: Tilbyder vejledninger, webinarer og andet læringsmateriale, der understøtter introduktion af brugere og anvendelse af værktøjet.
- Understøttelse af compliance: Hjælper med at sikre, at datahåndteringen opfylder branchestandarder og regler som GDPR eller HIPAA.
Fordele
Implementering af værktøjer til testdatastyring giver flere fordele for dit team og din virksomhed. Her er nogle af dem, du kan se frem til:
- Forbedret databeskyttelse: Funktioner til datamaskering hjælper med at beskytte følsomme oplysninger og sikrer overholdelse af regler om privatliv.
- Øget testeffektivitet: Klargøring af data i realtid reducerer forsinkelser og muliggør hurtigere testcyklusser.
- Større datanøjagtighed: AI-drevet datagenerering skaber realistiske testdata og øger pålideligheden af testresultaterne.
- Omkostningsbesparelser: Dataudsnit udtrækker kun de nødvendige data og reducerer omkostningerne til lagring og behandling.
- Fleksibilitet ved implementering: Understøttelse af flere cloudmiljøer gør det muligt for værktøjet at fungere på tværs af forskellige miljøer og tilpasse sig dine infrastrukturbehov.
- Brugervenlig introduktion: Adgang til uddannelsesressourcer og vejledninger understøtter hurtig ibrugtagning og effektiv anvendelse af værktøjet.
- Overholdelse af regler: Funktioner til understøttelse af compliance hjælper med at opfylde branchestandarder og reducerer risikoen for juridiske problemer.
Omkostninger & priser
Valg af værktøjer til testdatastyring kræver en forståelse af de forskellige prismodeller og tilgængelige abonnementer. Omkostningerne varierer afhængigt af funktioner, teamstørrelse, tilføjelser og meget mere. Tabellen nedenfor opsummerer almindelige abonnementer, deres gennemsnitspriser og typiske funktioner, der er inkluderet i løsninger til testdatastyring:
Sammenligningstabel for abonnementer til værktøjer til testdatastyring
| Abonnementstype | Gennemsnitspris | Almindelige funktioner |
|---|---|---|
| AbonnementstypeGratis abonnement | Gennemsnitspris$0 | Almindelige funktionerGrundlæggende datamaskering, begrænset dataudsnit og begrænsede integrationsmuligheder. |
| AbonnementstypePersonligt abonnement | Gennemsnitspris$5-$25/bruger/måned | Almindelige funktionerForbedret databeskyttelse, AI-drevet datagenerering og grundlæggende support. |
| AbonnementstypeVirksomhedsabonnement | Gennemsnitspris$30-$75/bruger/måned | Almindelige funktionerAvanceret dataudsnit, understøttelse af flere cloudmiljøer og adgang til uddannelsesressourcer. |
| AbonnementstypeEnterprise-abonnement | Gennemsnitspris$100+/bruger/måned | Almindelige funktionerBrugerdefinerede dataskabeloner, omfattende understøttelse af compliance, førsteklasses kundesupport og fulde integrationsmuligheder. |
Ofte stillede spørgsmål om værktøjer til testdatahåndtering
Her er nogle svar på almindelige spørgsmål om værktøjer til testdatahåndtering:
Bør du vælge funktioner til maskering eller syntetiske data?
Maskering beskytter rigtige data ved at skjule personlige oplysninger. Software, der genererer syntetiske data, opretter falske, men realistiske datasæt. Vælg maskering, hvis du bruger produktionsdata, og syntetiske data, hvis du ønsker mere sikre, fuldt genererede testsæt.
Hvis du stadig er i fasen, hvor du “skal indsamle flere testdata”, kan du prøve: 10 bedste værktøjer til brugervenlighedstest til feedback fra rigtige brugere.
Hvorfor er datasikkerhed vigtig i TDM-værktøjer?
TDM-software håndterer ofte følsomme produktionsdata. Uden korrekt maskering eller kryptering risikerer du datalæk eller problemer med overholdelse af regler. Vælg altid et værktøj, der understøtter kryptering, anonymisering og adgangskontrol.
Hvilke integrationer bør et TDM-værktøj understøtte?
Det bør fungere sammen med dine CI/CD-værktøjer som Jenkins, GitLab eller Azure DevOps. Integration med større databaser (Oracle, SQL Server, PostgreSQL) og cloudplatforme er også afgørende for problemfri automatisering.
Hvordan tester du et TDM-værktøj, før du køber det?
Gennemfør et lille proof of concept. Prøv at klone, maskere og opdatere data i din faktiske opsætning. Se, hvor hurtigt det kører, og om det passer ind i din eksisterende arbejdsgang.
Hvordan kan TDM-værktøjer hjælpe med overholdelse af regler?
Gode værktøjer sporer alle dataændringer, opbevarer revisionslogfiler og sikrer, at maskerede data forbliver konsistente. Det hjælper dit team med at overholde regler som GDPR, HIPAA eller CCPA.