

De bedste alternativer til Nagios hjælper teams med at overvåge systemer uden at skulle håndtere komplekse opsætningskrav eller støde på begrænsninger i skalerbarheden. De giver tydeligere dashboards, enklere konfigurationer og fleksible integrationer, som gør det lettere at følge ydeevnen på tværs af servere, netværk og applikationer.
Mange organisationer begynder at lede efter alternativer efter at have kæmpet med problemer som konfiguration af Nagios-plugins, der ikke integreres problemfrit, spild af tid på fejlfinding af kryptiske fejlmeddelelser eller begrænset ydeevne, efterhånden som overvågningsbehovene vokser. Disse udfordringer bremser driften og gør det vanskeligere for IT-teams at bevare overblikket i stor skala.
Jeg har testet overvågningsplatforme i aktive produktionsmiljøer, arbejdet med teams, der migrerede væk fra ældre Nagios-installationer, og evalueret, hvordan disse værktøjer fungerer på tværs af hybride infrastrukturer og cloud-infrastrukturer. Disse erfaringer viste mig, hvilke løsninger der rent faktisk reducerer overvågningsarbejdet, og hvilke der skaber nye kompleksiteter.
I denne guide kan du se, hvilke alternativer til Nagios der giver enklere opsætning, bedre skalerbarhed og mere handlingsrettet indsigt, så dit team kan fokusere på at løse problemer i stedet for at kæmpe med overvågningssystemet.
Hvad er Nagios?
Nagios er en open source-platform til overvågning og netværksstyring, der er udviklet til overvågning af netværk og systemer. IT-fagfolk og systemadministratorer bruger generelt Nagios til at holde øje med kritisk infrastruktur og sikre en problemfri drift.
Funktionerne til alarmering, rapportering og overvågning hjælper dig med at opdage problemer, analysere ydeevnen og administrere netværksressourcer effektivt. Overordnet set skaber Nagios værdi ved at hjælpe dit team med at opretholde systemets pålidelighed og minimere nedetid.
Sammenligningstabel over alternativer til Nagios
Denne sammenligningstabel opsummerer prisoplysningerne for mine bedste udvalgte alternativer til Nagios:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bedst til samlet overvågning af enheder og sensorer | 3.7 out of 5 | 4 | 4 | 4 | 3 | 4 | 3 | $200/måned Gratis abonnement + 30 dages gratis prøveperiode | Website |
Bedst til komplekse IT-infrastrukturer | 3.3 out of 5 | 3 | 3 | 3 | 4 | 4 | 3 | $1,400/year Gratis abonnement + 60 dages prøveperiode + demo tilgængelig | Website |
Bedst til overvågning af multicloudmiljøer | 3.7 out of 5 | 4 | 4 | 3 | 4 | 4 | 3 | $10/måned Gratis abonnement + 30-dages prøveperiode + demo tilgængelig | Website |
Bedst til overvågning af webapplikationer | 3.5 out of 5 | 4 | 1 | 4 | 4 | 4 | 4 | $13.33/måned Gratis abonnement + 30 dages gratis prøveperiode + gratis demo tilgængelig | Website |
Bedst til nem opsætning | 3.0 out of 5 | 3 | 2 | 2 | 4 | 3 | 4 | Priser oplyses efter forespørgsel Gratis abonnement + demo tilgængelig | Website |
Bedst til synlighed på tværs af hele stakken | 3.8 out of 5 | 4 | 4 | 4 | 4 | 4 | 3 | $2.80/måned Gratis abonnement + 14 dages gratis prøveperiode + gratis demo tilgængelig | Website |
Bedst til grafvisning | 3.0 out of 5 | 3 | 2 | 3 | 3 | 4 | 3 | Priser oplyses efter anmodning Ikke tilgængelig | Website |
Bedst til AIOps og observerbarhed | 3.5 out of 5 | 3 | 4 | 3 | 4 | 4 | 3 | Pris oplyses efter forespørgsel Gratis demo tilgængelig | Website |
Bedst til overvågning fra ende til anden | 4.3 out of 5 | 4 | 4 | 4 | 5 | 5 | 4 | €283/måned Gratis abonnement + 30 dages prøveperiode + demo tilgængelig | Website |
Bedst til distribuerede netværk | 3.3 out of 5 | 3 | 3 | 3 | 4 | 4 | 3 | $6,000/år Gratis abonnement tilgængeligt | Website |


Hvorfor du kan stole på vores softwareanbefalinger
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vores team har testet og anmeldt software siden 2012. Vi er selv teknologiledere, så vi ved, hvor svært og hvor vigtigt det er at vælge den rigtige software.
Til denne guide har vi vurderet værktøjerne gennem praktisk afprøvning og uafhængig research og givet dem point ud fra vores udvælgelseskriterier.
Vores anmeldelser bygger på vores egen redaktionelle vurdering. De er ikke et salgsargument.
Ekspertanmeldere:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Anmeldelser af de bedste alternativer til Nagios
Nedenfor finder du mine detaljerede opsummeringer af de bedste alternativer til Nagios, som kom med på min kortliste. Mine anmeldelser giver et detaljeret indblik i de vigtigste funktioner, fordele & ulemper, integrationer og ideelle anvendelsesmuligheder for hvert værktøj, så du kan finde det bedste til dig.
 Bedst til samlet overvågning af enheder og sensorer
- Gratis abonnement + 30 dages gratis prøveperiode
- Fra $200/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.6/5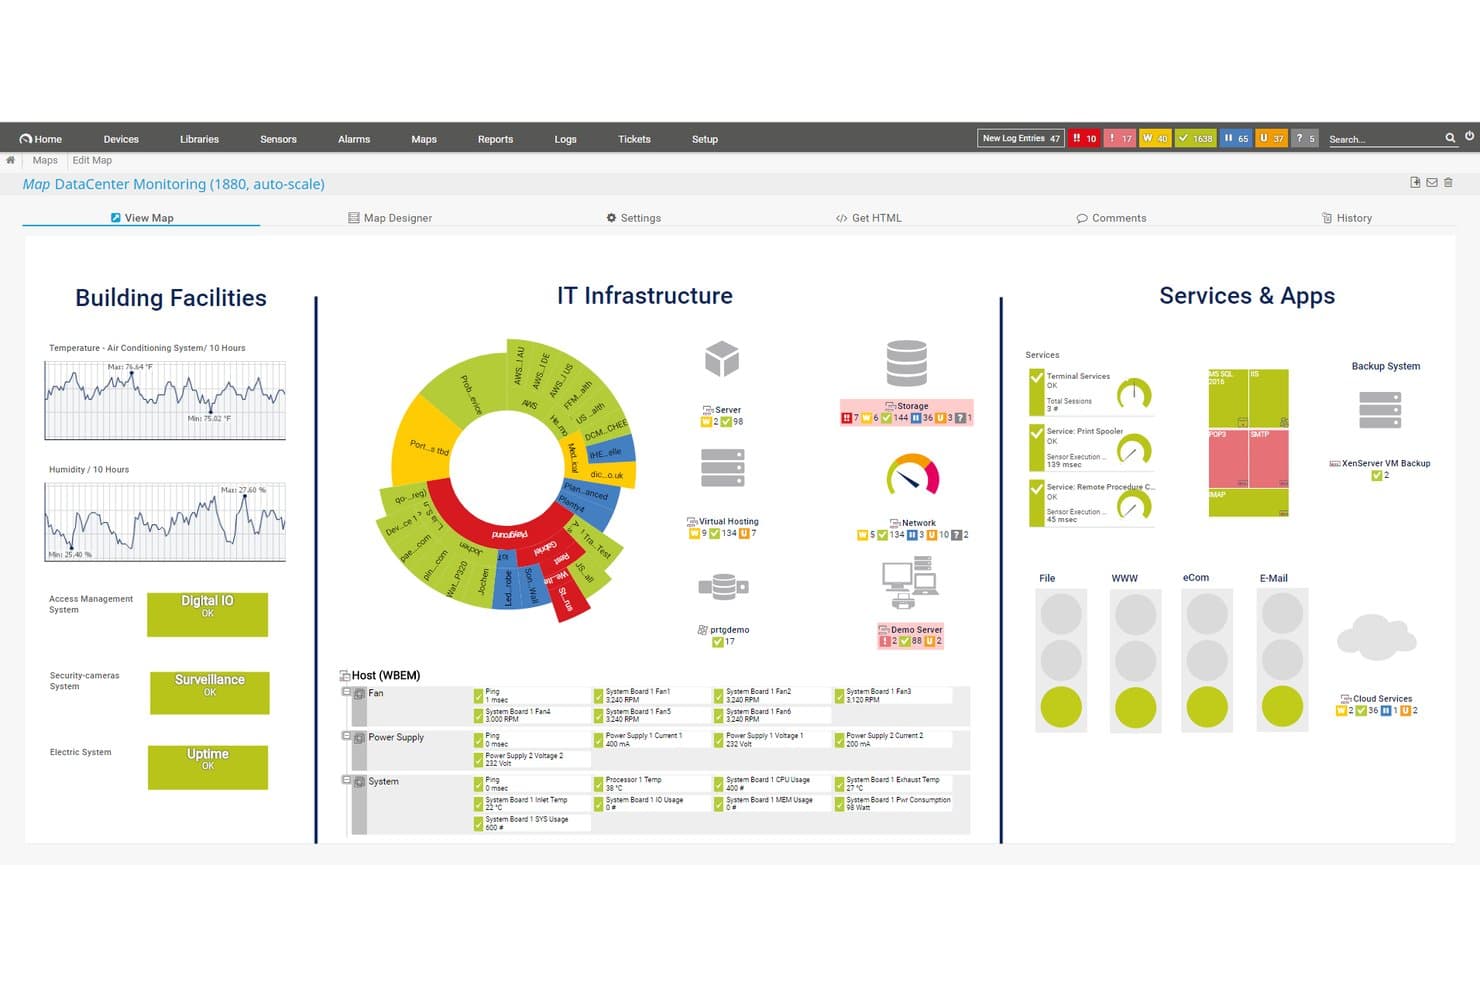
Paessler PRTG tilbyder et tilpasningsbart overvågningskort over datacenteret, der viser bygningsfaciliteter, IT-infrastruktur samt tjenester og apps i en samlet instrumentbrætvisning. Paessler PRTG er en lokal netværksovervågningsplatform, der giver IT-teams og systemadministratorer ét sted til at overvåge servere, netværksenheder, applikationer og OT/IoT-infrastruktur ved hjælp af over 250 forudkonfigurerede sensorer og automatisk registrering uden agenter.
Hvem er Paessler PRTG bedst til?
PRTG passer godt til IT-teams, der administrerer blandede lokale miljøer og har brug for bred dækning af enheder og sensorer uden at skulle opbygge overvågningen fra bunden.
Hvorfor valgte jeg Paessler PRTG?
Jeg valgte PRTG som et af de bedste værktøjer, fordi det samler alt i et enkelt overvågningslag uden at kræve, at du opbygger sensordækningen fra bunden. Det, jeg især godt kan lide, er, hvordan de mere end 250 forudkonfigurerede sensorer dækker servere, netværksenheder, virtuelle miljøer og OT/IoT-udstyr, så du ikke skal sammensætte separate værktøjer for at få det fulde overblik. Den adaptive anomalidetektion baseret på normalniveauer tilfører også stor værdi: PRTG markerer automatisk usædvanlig adfærd, uden at du manuelt skal definere hver enkelt tærskelværdi.
Vigtige funktioner i Paessler PRTG
- Underretninger via flere kanaler: Sender meddelelser via e-mail, SMS, push, Microsoft Teams, Slack, syslog og SNMP-traps med konfigurerbare eskaleringsniveauer og tidsplaner.
- Distribueret overvågning med sonder: Udruller klassiske fjernsonder og sonder til flere platforme for at overvåge undernetværk bag firewalls og fordele belastningen på tværs af systemer.
- Oprettelse af brugerdefinerede sensorer: Opretter brugerdefinerede sensorer ved hjælp af PowerShell, Python, SSH Script, REST Custom og HTTP Push Data for at overvåge det, som de forudkonfigurerede sensorer ikke dækker.
- Planlagte rapporter og rapporter efter behov: Genererer rapporter på sensorniveau og oversigtsrapporter efter en tidsplan eller efter behov med eksport af historiske data i XML-, CSV-, HTML- og PDF-formater.
Integrationer med Paessler PRTG
Paessler PRTG har indbyggede integrationer med Microsoft Teams og Slack samt integrationer med NetBrain, Martello iQ og Siemon. REST API v2, HTTP API v1 og brugerdefinerede sensorer understøtter yderligere integrationer.
Pros and Cons
Pros:
- Forudbyggede sensorer reducerer manuelle Nagios-kontroller
- Bred enhedsdækning samler overvågningen
- Instrumentbrætter gør netværkets tilstand synlig
Cons:
- Forældede kort begrænser driftsvisninger
- Gennemsnit af historiske data begrænser detaljegraden i tendensanalyser
Learn more about Paessler PRTG: Bedst til komplekse IT-infrastrukturer
- Gratis abonnement + 60 dages prøveperiode + demo tilgængelig
- Fra $1,400/year (faktureres årligt)
Visit WebsiteCustomer Rating:4.7/5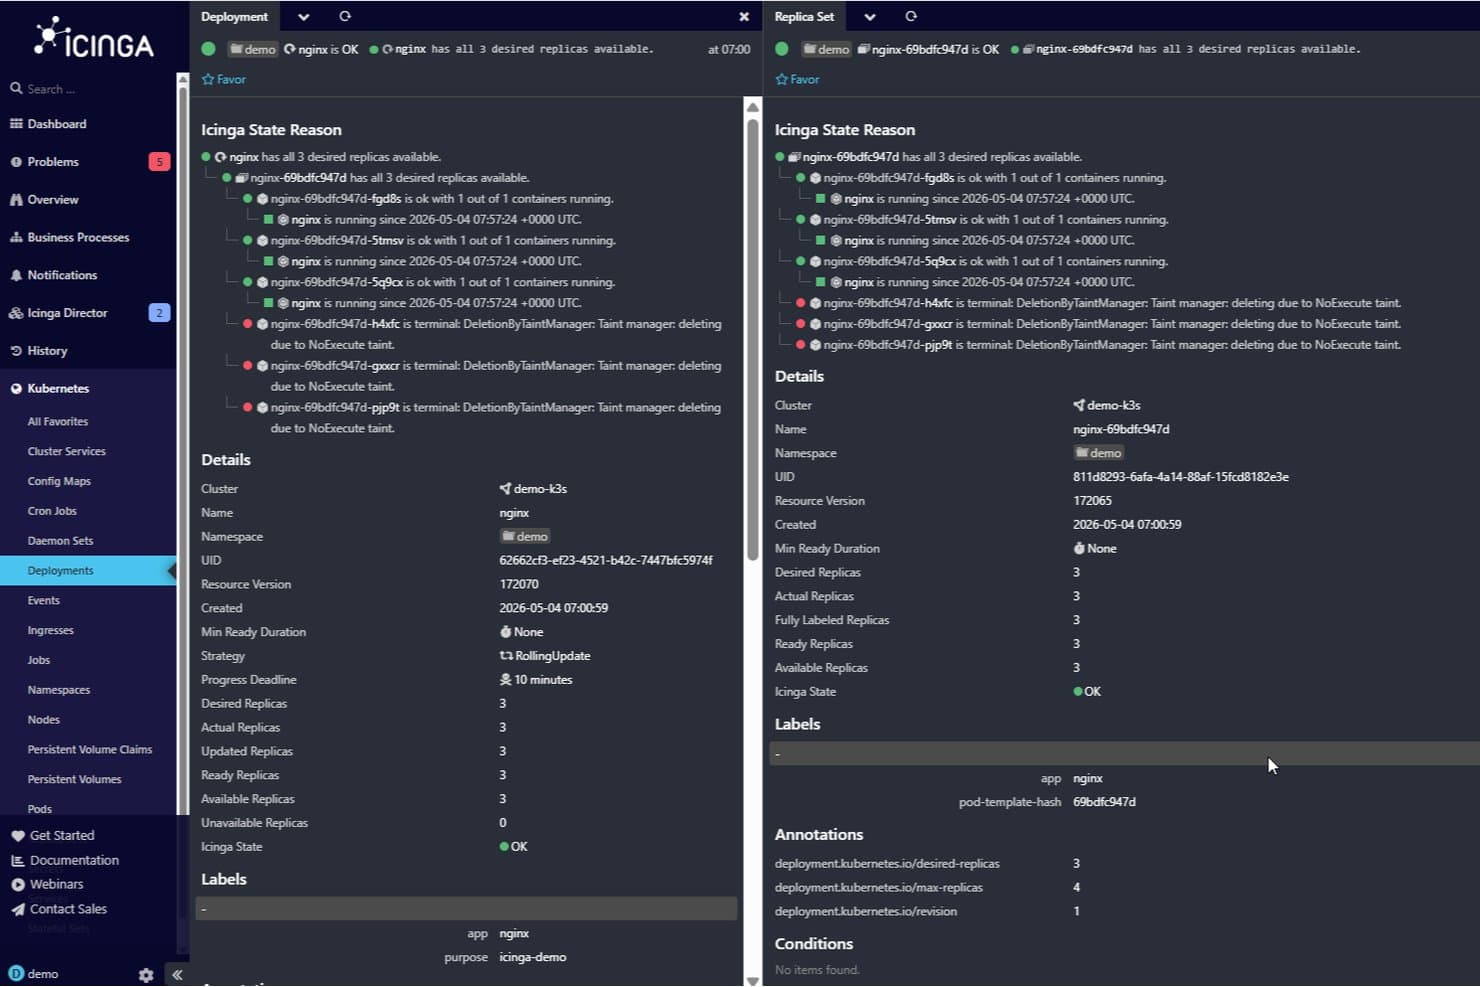
Icinga registrerer alle udrulninger på ét kontrolpanel med etiketter, detaljer og annoteringer. Icinga er en open source-overvågningsplatform, der er udviklet til teams, som administrerer store, distribuerede IT-miljøer, og som tilbyder fuld synlighed på tværs af servere, netværk, applikationer og cloud-infrastruktur fra én enkelt grænseflade.
Hvem er Icinga bedst egnet til?
Icinga er et stærkt valg for infrastruktur- og driftsteams, der administrerer store, distribuerede miljøer på tværs af lokale miljøer, hybridmiljøer og miljøer med flere cloudplatforme.
Hvorfor valgte jeg Icinga?
Icinga kommer med på min shortlist, fordi platformen er udviklet til at håndtere den skala og spredning, der får enklere overvågningsværktøjer til at bryde sammen. Jeg sætter pris på, hvordan master-, satellit- og agentarkitekturen gør det muligt for mit team at fordele kontroller på tværs af eksterne lokationer, netværkssegmenter og cloudmiljøer uden at miste det centrale overblik. Jeg er også afhængig af dens afhængighedskortlægning til at undertrykke kaskaderende alarmstøj, når en overordnet node går ned, hvilket holder hændelseskøerne håndterbare på tværs af mere end 80 lokationer. Kompatibilitet med Nagios-plugins betyder, at eksisterende kontrolscripts kan genbruges i stedet for at blive skrevet helt fra bunden.
Vigtige funktioner i Icinga
- Kompatibilitet med Nagios-plugins: Brug eksisterende Nagios-kompatible overvågningsplugins direkte i Icinga uden at omskrive dine kontrolscripts.
- Indsamling og lagring af målepunkter: Skriv indsamlede systemmålepunkter til tidsseriedatabaser, herunder Graphite, InfluxDB, Elasticsearch og OpenTSDB.
- Rollebaseret adgangskontrol: Tildel detaljerede adgangstilladelser til brugere og teams baseret på deres roller i overvågningsmiljøet.
- Automatiserede konfigurationsregler: Definer anvendelsesregler, der automatisk opretter værts- og tjenestekontroller, efterhånden som dit overvågede miljø ændrer sig.
Integrationer med Icinga
Icinga tilbyder en dokumenteret Grafana-integration samt integrationer med Puppet, Ansible, Chef, AWS, Azure, Google Cloud Platform, Graphite, InfluxDB, Elastic og Graylog. Dens REST API understøtter tilpassede integrationer og automatisering af konfiguration.
Pros and Cons
Pros:
- Håndterer store, distribuerede overvågningsudrulninger
- Skabeloner reducerer gentagen værtskonfiguration
- Genbruger Nagios-kompatible kontroller
Cons:
- Nagios-migreringer kræver genopbygning af konfigurationen
- Levering af notifikationer kræver eksterne scripts
Learn more about Icinga: Bedst til overvågning af multicloudmiljøer
- Gratis abonnement + 30-dages prøveperiode + demo tilgængelig
- Fra $10/måned
Visit WebsiteCustomer Rating:4.7/5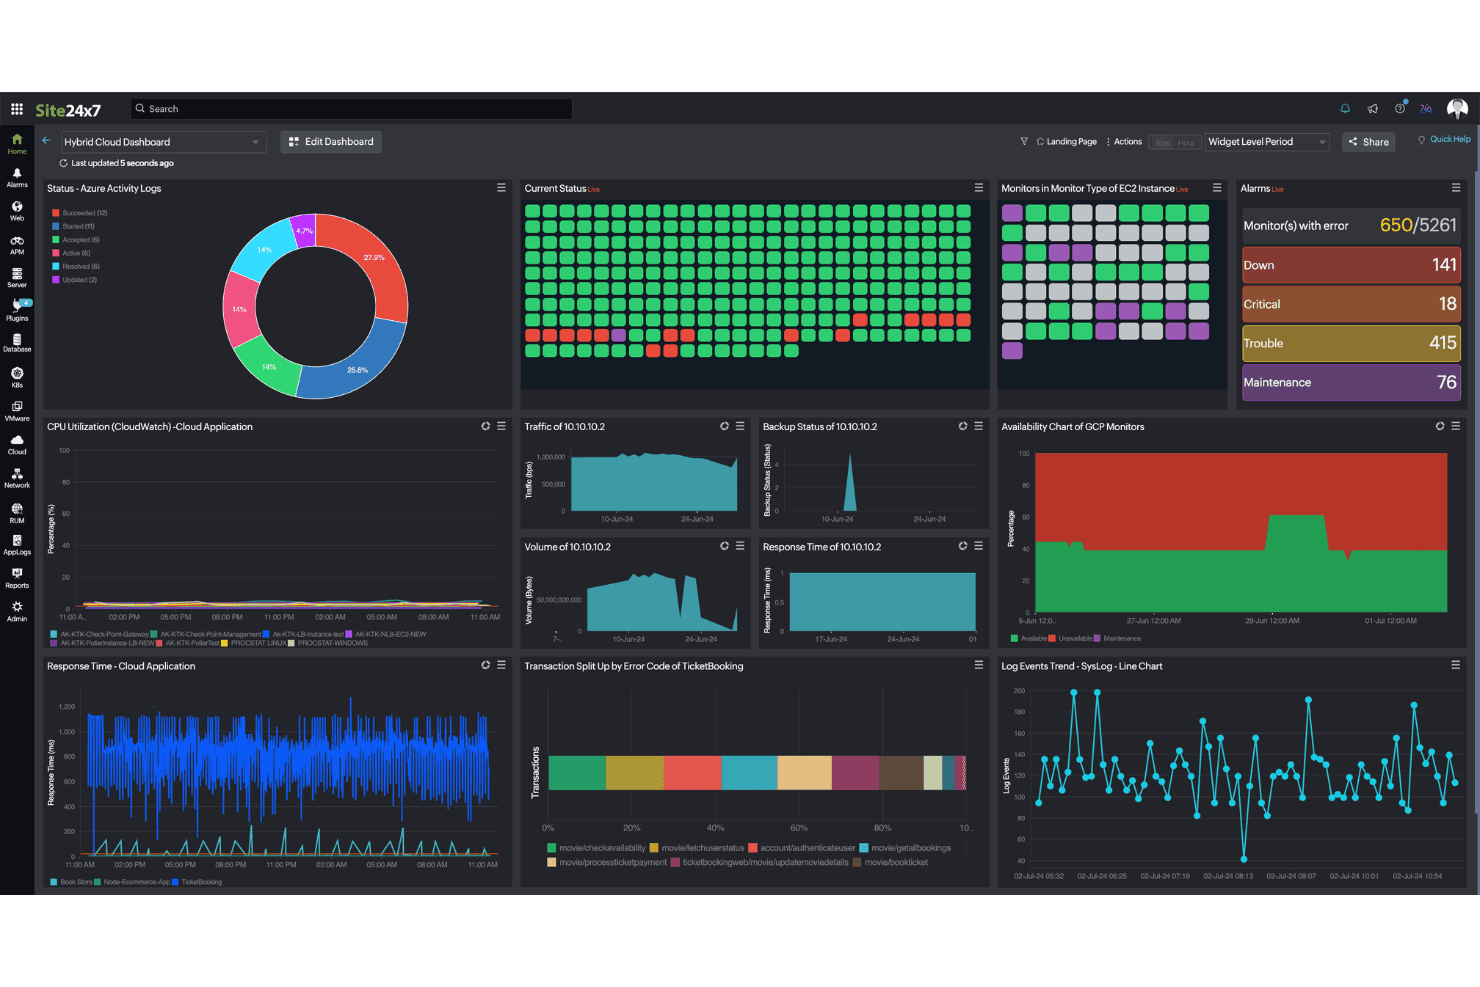
Site24x7 samler overvågning af hybrid cloud på tværs af Azure, AWS og GCP i ét dashboard. Site24x7 er en AI-drevet observabilitetsplatform fra Zoho, der hjælper IT-teams, DevOps-ingeniører og systemadministratorer med at overvåge servere, netværk, cloudinfrastruktur og applikationer fra én enkelt konsol.
Hvem er Site24x7 bedst til?
Site24x7 passer godt til IT- og DevOps-teams, der kører arbejdsbelastninger på tværs af AWS, Azure og GCP, og som ønsker samlet synlighed uden at skulle håndtere flere overvågningsværktøjer.
Hvorfor jeg valgte Site24x7
Jeg valgte Site24x7 som et af de bedste alternativer til Nagios, fordi platformen samler overvågning af AWS, Azure og GCP under én enkelt konsol, hvilket Nagios ganske enkelt ikke er bygget til. Jeg kan især godt lide dens lokale poller, som udvider synligheden til interne ressourcer bag firewalls og VPN'er på tværs af filialer uden at kræve en selvhostet server. Dens Zia-drevne anomalidetektion går også videre end statiske tærskelværdier og sporer dynamisk målingsudsving på tværs af dit multicloudmiljø, så du ikke konstant skal finjustere alarmer manuelt.
Vigtige funktioner i Site24x7
- Kørsel af Nagios-plugins: Kør dine eksisterende Nagios-plugins via Site24x7 Linux-agenten, og send resultaterne til Site24x7 uden at vedligeholde en dedikeret Nagios-server.
- Programopdagelse og afhængighedskortlægning (ADDM): Visualiser applikationsrelationer og topologi ved hjælp af data om 'Kører på', 'Forbinder til' og infrastruktura fhængigheder fra agenter samt netværks-, cloud- og virtualiseringskilder.
- Netværkskonfigurationsstyring: Automatiser konfigurationssikkerhedskopier, registrer uautoriserede ændringer, identificer firmware-sårbarheder, og overvåg overholdelse på tværs af netværksenheder.
- Notifikationsprofiler med flere kanaler: Konfigurer alarmer via e-mail, SMS, taleopkald og push-notifikationer med eskaleringsindstillinger, vedvarende alarmer og forsinkelser efter flere på hinanden følgende fejl.
Site24x7-integrationer
Site24x7 tilbyder indbyggede integrationer med ServiceNow, PagerDuty, Opsgenie, Jira, Slack og Microsoft Teams samt webhooks til hændelsesarbejdsgange. Platformen har en REST API til brugerdefinerede integrationer og understøtter Zapier.
Pros and Cons
Pros:
- Samlet overvågning af cloud og infrastruktur
- Holder Nagios-plugins kørende via en agent
- Polleren overvåger firewallsikrede systemer og filialers systemer
Cons:
- Nagios-plugins kræver manuel JSON-konfiguration
- Alarmstøj kan kræve justering af tærskelværdier
Learn more about Site24x7: Bedst til overvågning af webapplikationer
- Gratis abonnement + 30 dages gratis prøveperiode + gratis demo tilgængelig
- Fra $13.33/måned
Visit WebsiteCustomer Rating:4.5/5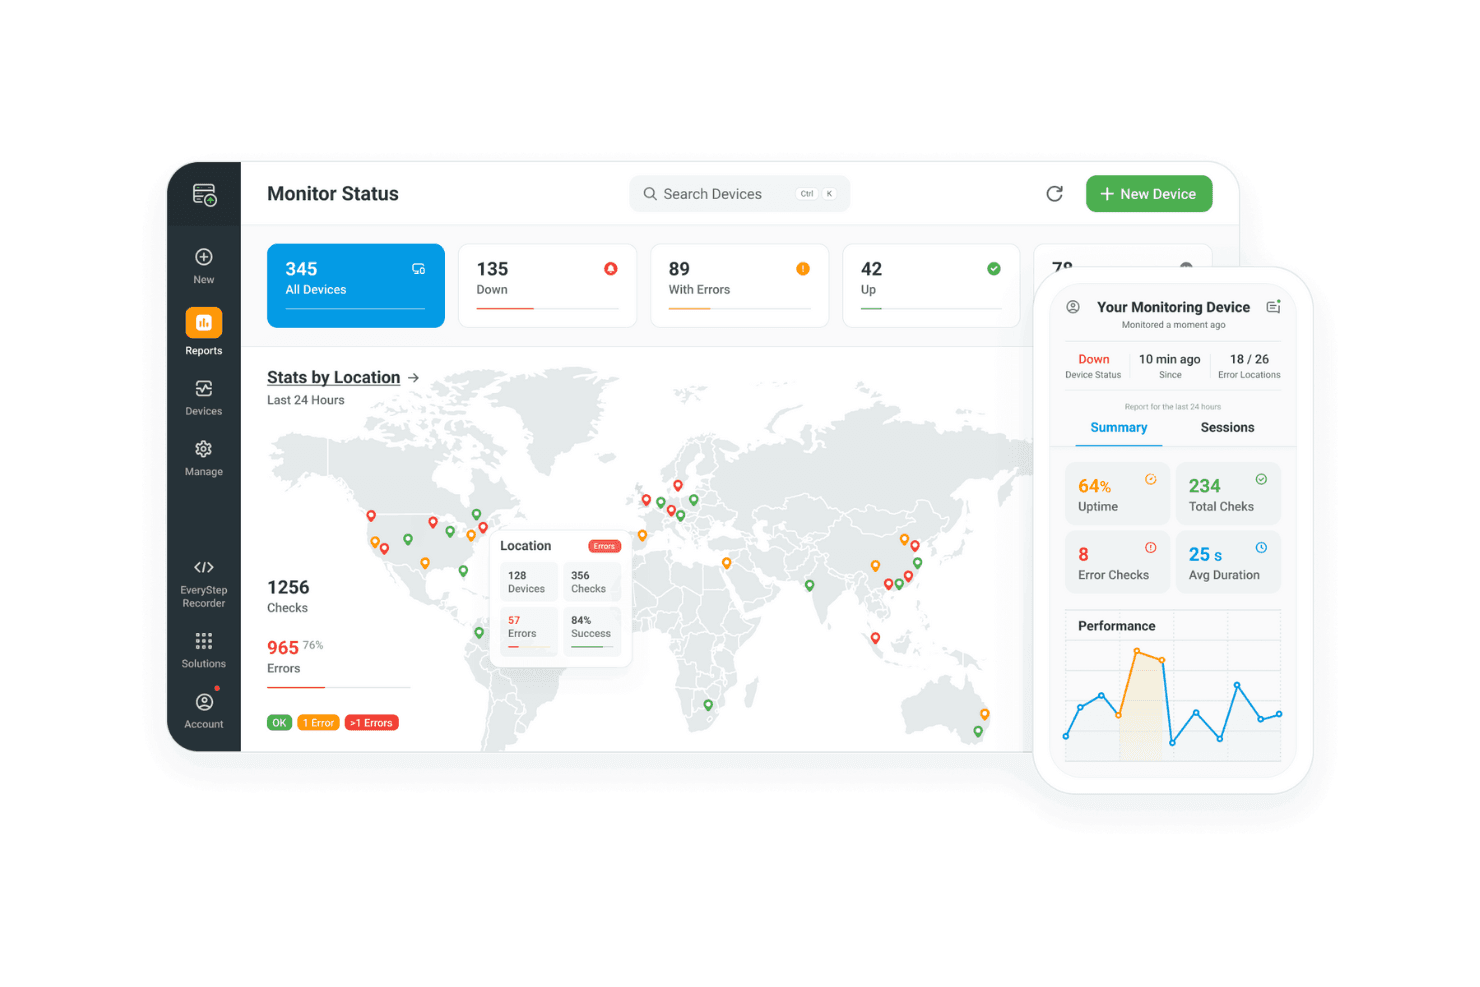
Dotcom-Monitor sporer enheders oppetid, fejl og placeringsstatistikker i realtid. Dotcom-Monitor er en platform til syntetisk overvågning og infrastrukturovervågning, der henvender sig til DevOps- og SRE-teams, som har brug for at overvåge webapplikationer, API'er, servere og netværkstjenester fra ét dashboard – med kontrol i rigtige browsere, protokolovervågning og indbygget dækning af private netværk.
Hvem er Dotcom-Monitor bedst egnet til?
Dotcom-Monitor er velegnet til DevOps- og SRE-teams, der har brug for syntetisk overvågning af webapps, API'er og infrastruktur fra ét dashboard.
Hvorfor valgte jeg Dotcom-Monitor?
Jeg valgte Dotcom-Monitor som en af de bedste løsninger, fordi den bringer syntetisk overvågning i rigtige browsere til kontrol af webapplikationer på en måde, som Nagios ganske enkelt ikke kan matche. Jeg kan godt lide, hvordan EveryStep Web Recorder registrerer brugerrejser i flere trin, f.eks. login eller betalingsforløb, og afspiller dem løbende fra globale placeringer. Når en kontrol mislykkes, får jeg et skærmbillede, en videooptagelse og et vandfaldsdiagram sammen med alarmen, så jeg præcist kan finde ud af, hvor en transaktion gik galt, uden at skulle gennemgå logfiler.
Vigtige funktioner i Dotcom-Monitor
- Private agenter: Udruller letvægtsagenter i dit private netværk for at overvåge interne systemer, intranet og tjenester bag firewalls uden at kræve indgående firewallregler.
- Protokol- og oppetidskontroller: Overvåger HTTP/HTTPS, DNS, SSL/TLS, SMTP, FTP, VoIP/SIP, TCP/UDP, ICMP og traceroute fra én enkelt platform.
- Ydelsestællere (MetricsView): Indsamler Windows-ydeevnetællere, Linux Collectd-målinger og SNMP v1/v2/v3-data med konfigurerbare tærskler og alarmgivning baseret på grundlinjer.
- REST API- og CI/CD-integration: Leverer en komplet REST API til programmatisk oprettelse af enheder, konfiguration af alarmer og klargøring af overvågning direkte fra implementeringspipelines.
Integrationer med Dotcom-Monitor
Dotcom-Monitor tilbyder indbyggede integrationer med PagerDuty, Slack, Microsoft Teams, Splunk On-Call, ServiceNow, Okta og Salesforce. Det understøtter brugerdefinerede integrationer via REST API'en og CI/CD-arbejdsgange samt Zapier.
Pros and Cons
Pros:
- Kontroller i rigtige browsere afslører ødelagte brugerrejser
- Private agenter kan nå interne systemer bag firewalls
- Fejlalarmer indeholder dokumentation for svar og traceroutes
Cons:
- Ingen automatisk registrering af værter eller tjenester
- Navigation i den overfyldte monitorvisning kan besværliggøre rapportering
Learn more about Dotcom-Monitor: Bedst til nem opsætning
- Gratis abonnement + demo tilgængelig
- Priser oplyses efter forespørgsel
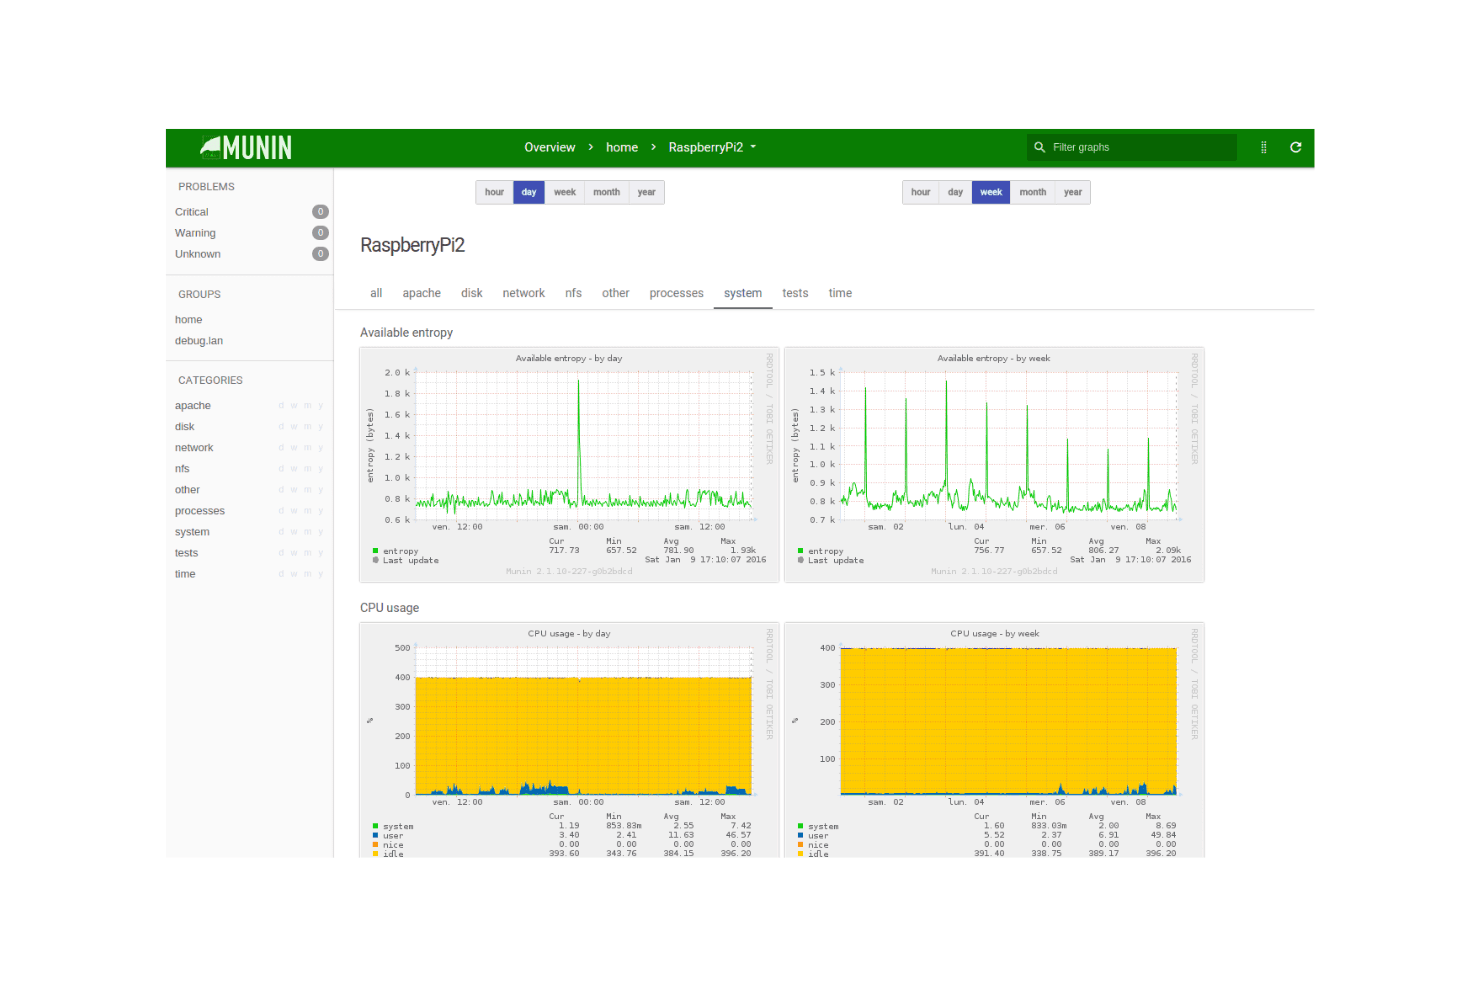
Munin visualiserer CPU-forbrug og systementropi på en Raspberry Pi. Munin er et værktøj med åben kildekode til netværksovervågning, der sporer ressourceudviklingen over tid og viser den som historiske grafer – hvilket gør det velegnet til systemadministratorer og DevOps-teams, der har brug for at diagnosticere ydeevneproblemer og planlægge kapacitet på tværs af serverinfrastrukturen.
Hvem er Munin bedst egnet til?
Munin er velegnet til systemadministratorer og DevOps-teams, der ønsker et billigt værktøj med åben kildekode til at spore infrastrukturens udvikling og diagnosticere ydeevneproblemer over tid.
Hvorfor valgte jeg Munin?
Jeg valgte Munin som et af de bedste værktøjer, fordi den nemme opsætning virkelig lever op til løftet:
munin-node-configure --suggestscanner din node og viser, hvilke udvidelsesmoduler der sandsynligvis vil fungere, og udskriver derefter skal-kommandoerne til at installere dem. Når du placerer udvidelsesmoduler i mappen med udvidelsesmoduler, begynder Munin at tegne RRD-baserede udviklinger i visninger for time, dag, uge, måned og år, uden at der kræves manuel konfiguration af grafer. Jeg sætter også pris på, at biblioteket med 500 udvidelsesmoduler dækker alt fra PostgreSQL-låse til disk-I/O direkte fra start, hvilket reducerer en stor del af det indledende arbejde sammenlignet med Nagios.Vigtige funktioner i Munin
- Tærskelbaserede alarmer: Konfigurer advarsels- og kritiske tærskler pr. udvidelsesmodul med understøttelse af meddelelser via e-mail, brugerdefinerede scripts, Slack og PagerDuty.
- Central server- og nodearkitektur: En central Munin-server spørger noder hvert femte minut, gemmer data i RRD-filer og leverer grafrapporter, der kan tilgås via en browser.
- Understøttelse af SNMPv3: Forespørg på netværksenheder ved hjælp af SNMP-version 1, 2c eller 3, hvor
authPriv-tilstanden giver både godkendelse og kryptering. - TLS-kryptering mellem server og node: Sikr kommunikationen mellem server og node med konfigurerbar TLS, herunder en streng opsætning, der verificeres af en certifikatmyndighed.
Integrationer i Munin
Munin integrerer med Nagios gennem
send_nscaog NSCA til passive kontroller, men tilsvarende værter og tjenester skal registreres i Nagios. Der er ikke dokumenteret nogen offentlig API eller andre navngivne integrationer.Pros and Cons
Pros:
- Forslag til udvidelsesmoduler gør den indledende opsætning af overvågningen nemmere
- Historiske grafer tydeliggør ressourceudviklingen
- Brugerdefinerede udvidelsesmoduler viser detaljerede tjenestemålinger
Cons:
- Polling hvert femte minut kan forsinke registreringen af driftsafbrydelser
- Den forældede grafgrænseflade begrænser kontrolpanelets brugervenlighed
Learn more about Munin: Bedst til synlighed på tværs af hele stakken
- Gratis abonnement + 14 dages gratis prøveperiode + gratis demo tilgængelig
- Fra $2.80/måned
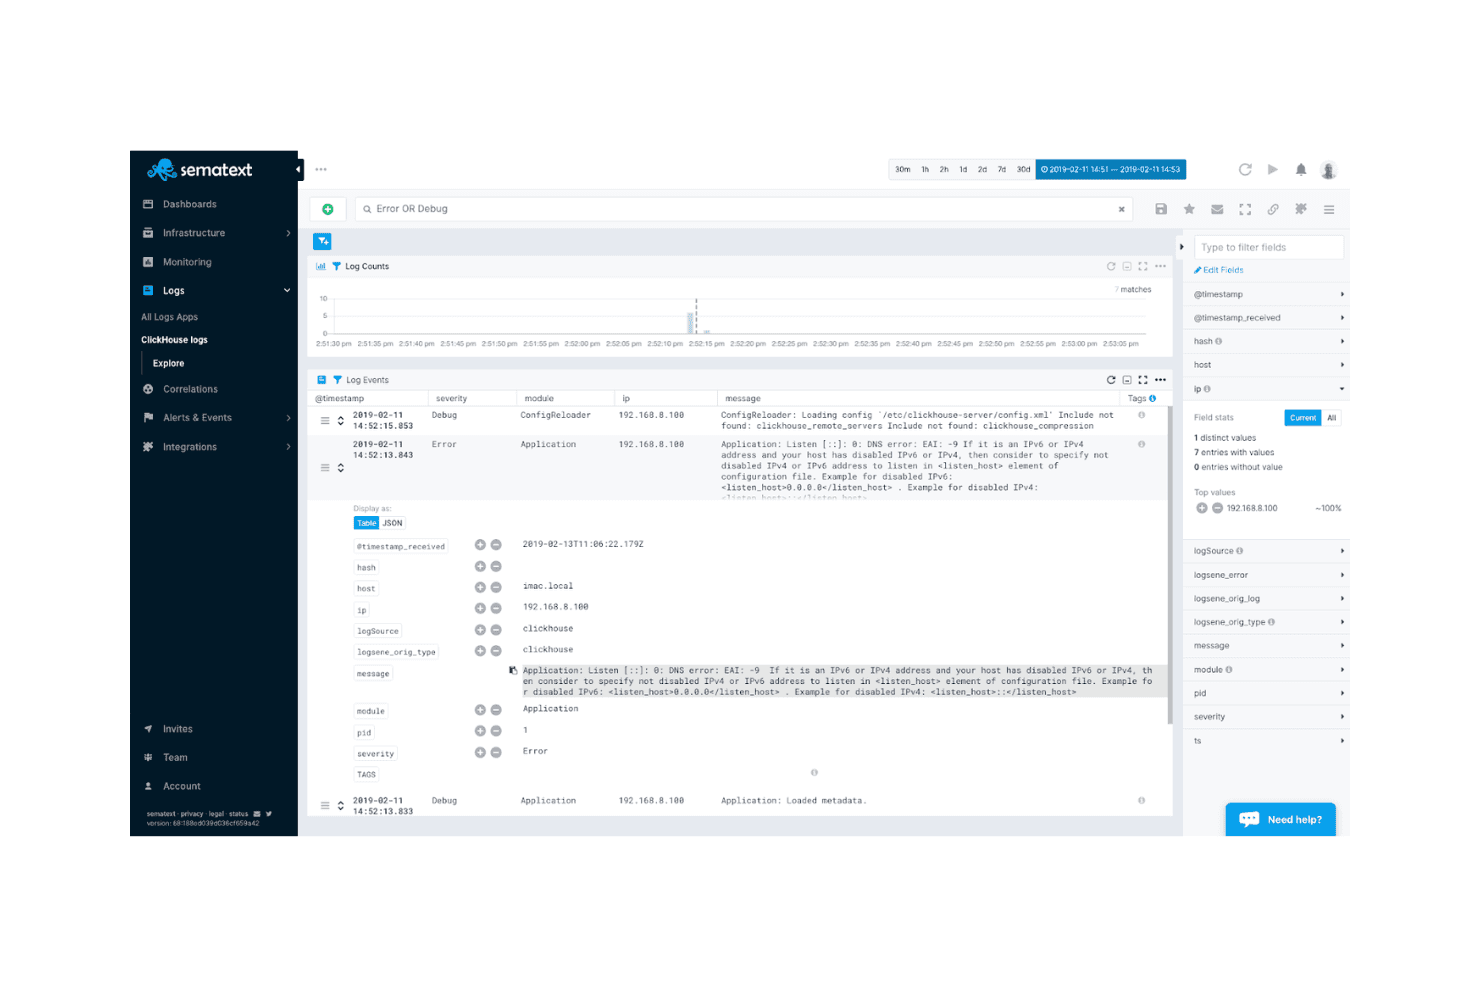
Sematext giver brugerne mulighed for at søge i og filtrere logfiler efter alvorlighedsgrad i realtid. Sematext er en cloudbaseret platform til infrastrukturmonitorering, som henvender sig til DevOps- og SRE-teams, der har brug for at overvåge servere, containere, Kubernetes og cloudinstanser – med indbygget anomalibaseret alarmering og kortlægning af netværkstopologi.
Hvem er Sematext bedst egnet til?
Sematext er et stærkt valg for DevOps- og SRE-teams, der administrerer containeriserede eller Kubernetes-tunge miljøer og har brug for infrastrukturmålinger, alarmering og synlighed over netværkstopologien samlet ét sted.
Hvorfor jeg valgte Sematext
Jeg valgte Sematext som en af de bedste løsninger, fordi platformen leverer fuld synlighed på tværs af hele stakken for servere, containere og Kubernetes på en måde, som Nagios ganske enkelt ikke kan matche uden omfattende pluginarbejde. Jeg kan især godt lide netværkskortet, som bruger eBPF til at visualisere liveforbindelser mellem tjenester, pods og processer på tværs af din infrastruktur. Kombinerer man det med anomalibaseret alarmering, der registrerer usædvanlige stigninger i forhold til en beregnet baseline, får man en monitoreringsopsætning, der opdager problemer, før tærskelværdierne overhovedet overskrides.
Vigtigste funktioner i Sematext
- Advarsler ved manglende signal: Få automatisk besked, når en overvåget server, container eller applikation holder op med at sende data til Sematext Cloud.
- Planlagte rapporter: Send øjebliksbilleder af kontrolpaneler via e-mail til modtagere med daglige, ugentlige, månedlige eller kvartalsvise intervaller uden at give dem fuld adgang til platformen.
- Automatisk tjenesteopdagelse: Sematext-agenten scanner efter kørende tjenester og logfiler, så du kan aktivere overvågning af nye instanser som Elasticsearch-noder direkte fra opdagelsesbrugerfladen.
- Kontrolpaneler fra flere kilder: Kombiner målinger, logfiler, infrastrukturbeholdning, klyngedata og hændelser fra flere apps i ét tilpasseligt kontrolpanel ved hjælp af diagramværktøjet.
Sematext-integrationer
Sematext tilbyder over 100 indbyggede integrationer, herunder Nagios, Slack, PagerDuty, Opsgenie, Microsoft Teams og Pushover. Platformen understøtter også brugerdefinerede webhooks, Zapier og en REST API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Anomalialarmer fanger usædvanlige stigninger i infrastrukturen
- Netværkskort synliggør afhængigheder mellem tjenester og processer
- Brugerne roser de detaljerede kontrolpaneler til fejlfinding
Cons:
- Nogle anmeldere rapporterer langsomme og tætpakkede kontrolpaneler
- Brugerne rapporterer problemer med opsætningen under implementeringer
Learn more about Sematext:
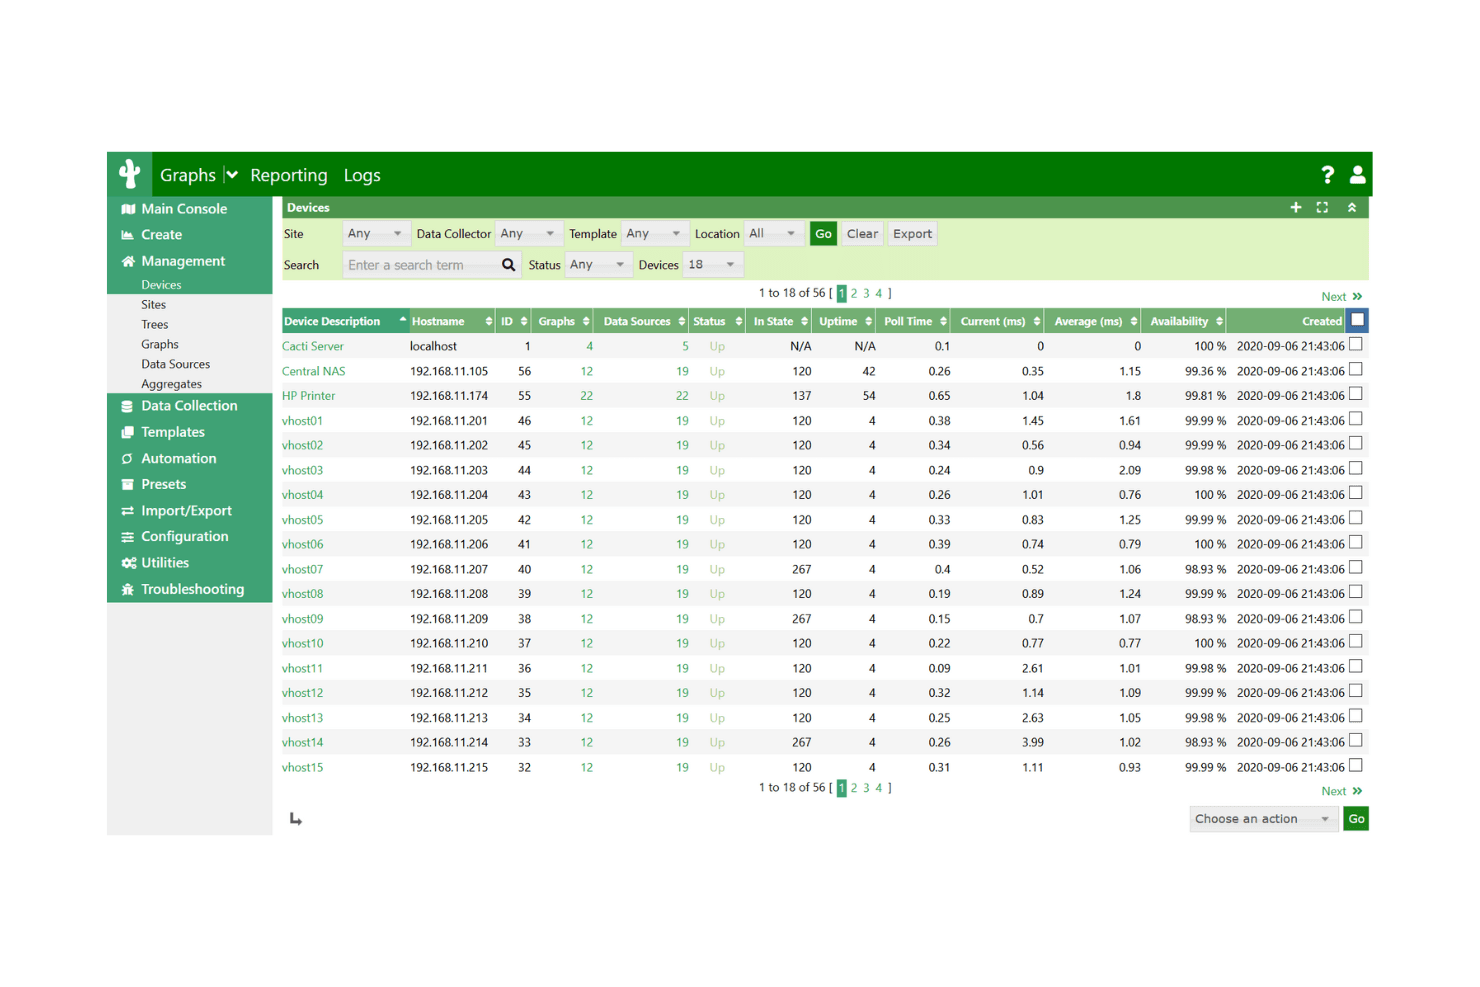
Cacti viser alle overvågede enheder med målinger for oppetid og tilgængelighed. Cacti er en open source, RRDtool-baseret netværksovervågningsplatform, der er udviklet til netværksingeniører og systemadministratorer, som har brug for detaljeret grafvisning og præstationssporing på tværs af store miljøer med SNMP-kompatible enheder som routere, switche og firewalls.
Hvem er Cacti bedst egnet til?
Cacti er et godt valg for netværksdriftsingeniører og systemadministratorer, som har brug for detaljeret, langsigtet grafvisning af SNMP-kompatible enheder som routere, switche og firewalls på tværs af store lokale miljøer.
Hvorfor jeg valgte Cacti
Jeg valgte Cacti som et af de bedste alternativer til Nagios, fordi den RRDtool-baserede grafmotor reelt er uden sidestykke, når det gælder langsigtet visualisering af netværksydelse. Hvor Nagios fokuserer på alarmering, giver Cacti mig mulighed for at opbygge detaljerede, tilpassede grafer for routere, switche og firewalls ved hjælp af SNMP-data, så jeg kan følge grænsefladetrafik, CPU-belastning og BGP-ruter over tid. Jeg sætter også pris på, at enhedsskabeloner giver mig mulighed for at gruppere grafskabeloner og dataforespørgsler efter enhedstype, så det tager minutter i stedet for timer at implementere overvågning af en ny gruppe Cisco-switche.
Cactis nøglefunktioner
- Thold-plugin: Konfigurerer høj/lav-, tidsbaserede og baselineafvigelsestærskler for grafdata med eskaleringer via e-mail, Syslog og SNMP Trap.
- Fjernpollere: Fordeler pollingbelastningen på tværs af flere servere og placerer indsamlingskilder tættere på de overvågede enheder i store netværk.
- Datakildeprofiler: Styrer RRD-filernes størrelse og opbevaringsindstillinger for at administrere, hvor længe historiske præstationsdata gemmes.
- ReportIt-plugin: Genererer planlagte rapporter med rullende tidsrammer og eksporterer data til formaterne CSV, SML og XML.
Cacti-integrationer
Cacti har ingen klart dokumenterede indbyggede integrationer.
Pros and Cons
Pros:
- Detaljerede SNMP-grafer bevarer historikken for ydeevnen
- Tilpassede enhedsskabeloner skræddersyr netværksovervågningen
- Fjernpollere fordeler dataindsamlingen på tværs af store netværk
Cons:
- Meddelelser om tjenestenedbrud kan komme sent
- Pluginopdateringer og konfiguration kræver vedligeholdelse
Learn more about Cacti: Bedst til AIOps og observerbarhed
- Gratis demo tilgængelig
- Pris oplyses efter forespørgsel
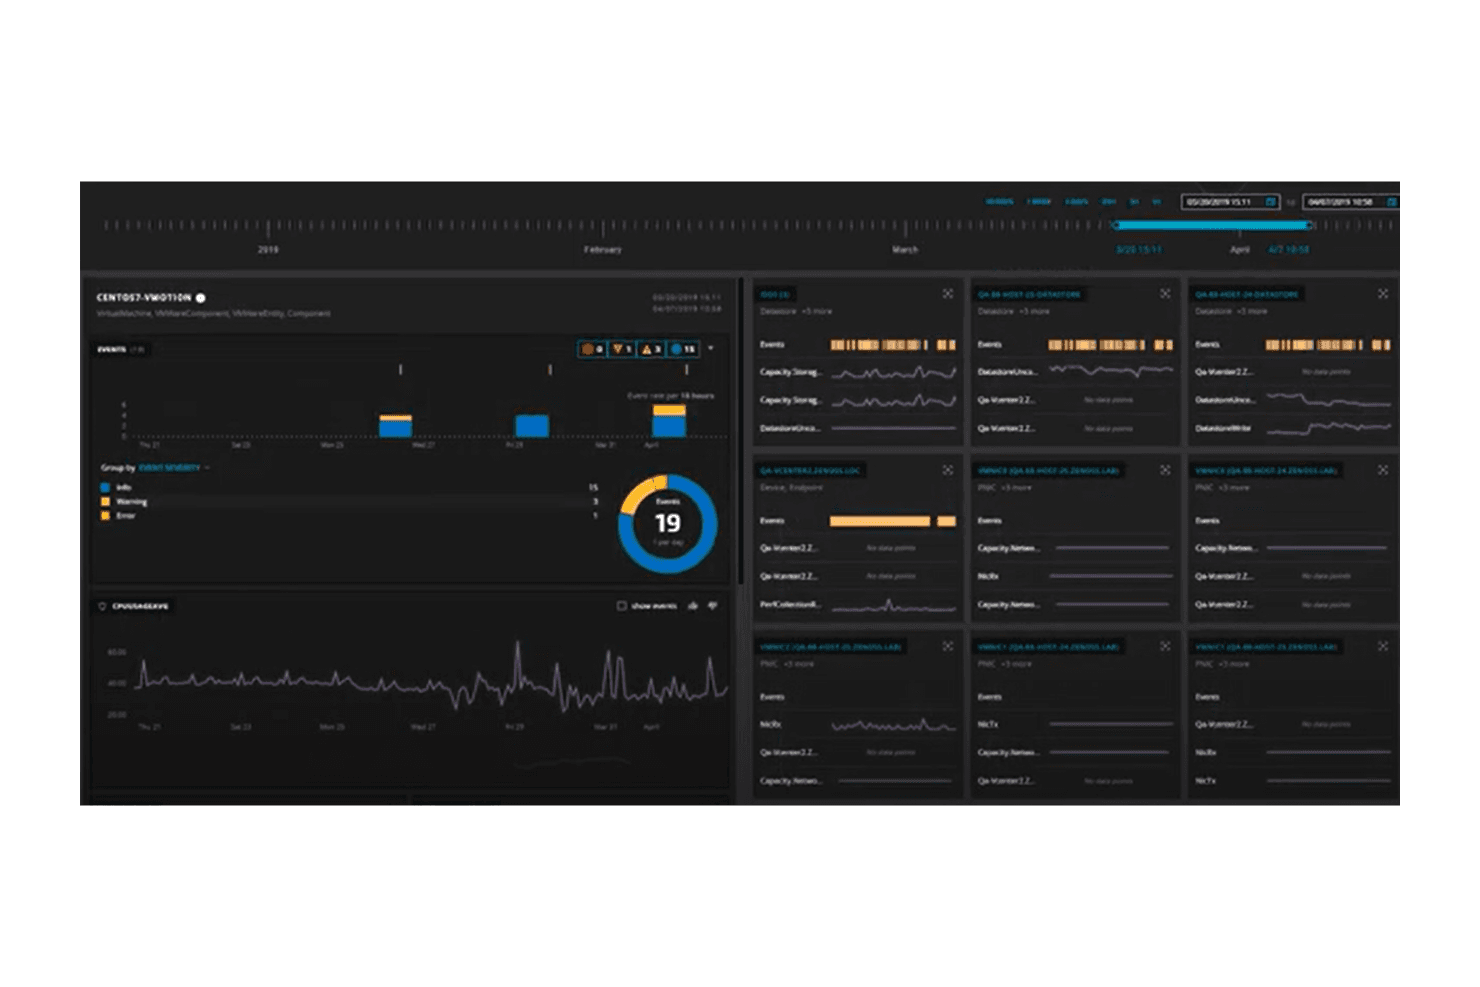
Zenoss Core overvåger infrastrukturhændelser og ydeevnemetrikker i realtid. Virtana Service Observability (tidligere Zenoss) er en AIOps-drevet overvågningsplatform, der forbinder infrastruktur, applikationer og cloudmiljøer i en samlet servicevisning – hvilket gør den velegnet til driftsteams, der administrerer komplekse hybride miljøer og har brug for AI-assisteret årsagsanalyse og afhængighedskortlægning.
Hvem egner Zenoss Core sig bedst til?
Zenoss Core egner sig godt til driftsteams, der administrerer komplekse hybride miljøer og har brug for AI-drevet årsagsanalyse og kortlægning af afhængigheder på serviceniveau i én samlet visning.
Hvorfor jeg valgte Zenoss Core
Jeg valgte Zenoss Core som et af de bedste alternativer til Nagios, fordi det erstatter Nagios' statiske, kontrolbaserede model med et levende, AI-drevet servicekort, der løbende opdager og sammenkæder afhængigheder på tværs af hybrid infrastruktur. Jeg kan især godt lide, hvordan anomalidetektering og en årsagsanalyse rangeret efter sikkerhed indsnævrer, hvor en hændelse faktisk opstår, i stedet for at oversvømme dig med usammenhængende alarmer. Den automatiske opdagelse holder servicemodellerne synkroniserede, efterhånden som cloud- og lokale ressourcer ændrer sig, så du ikke manuelt skal opdatere konfigurationer, hver gang noget ændres.
Vigtige funktioner i Zenoss Core
- Hændelseskorrelation og -filtrering: Samler, deduplikerer og maskerer hændelser på tværs af fysiske, virtuelle og cloudbaserede ressourcer for at fremhæve dem, der med størst sandsynlighed påvirker leveringen af tjenester.
- Udvidelsesmuligheder med ZenPack: Udvider overvågningen med genanvendelige enhedsklasser, overvågningsskabeloner, datakilder, grafer og hændelsesklasser, som kan installeres eller opbygges tilpasset.
- Regler for alarmering via flere kanaler: Kombinerer udløsere baseret på hændelser, metriktærskler og anomaliscorer med destinationer som PagerDuty, Microsoft Teams, Slack og ServiceNow i én konfigurerbar regel.
- Rollebaserede adgangskontroller: Begrænser, hvem der kan oprette og administrere udløsere, destinationer og alarmeringsregler, baseret på tildelte roller på platformen.
Integrationer til Zenoss Core
Zenoss Core har dokumenterede integrationer med ServiceNow, BMC Remedy, CA Service Desk, HP Service Manager, Cisco UCS Director, Chef og Puppet. REST API'er og en gRPC-datamodtager understøtter tilpassede integrationer.
Pros and Cons
Pros:
- Sammenkæder lagrings-, SAN- og servertopologi
- Kortlægger serviceafhængigheder til servicepåvirkning
- Anmeldere roser den letlæselige grænseflade
Cons:
- Anmeldere efterspørger tydeligere visualiseringer af overvågningen
- Anmeldere nævner begrænset overvågning af applikationsydeevne
Learn more about Zenoss Core: Bedst til overvågning fra ende til anden
- Gratis abonnement + 30 dages prøveperiode + demo tilgængelig
- Fra €283/måned (faktureres årligt)
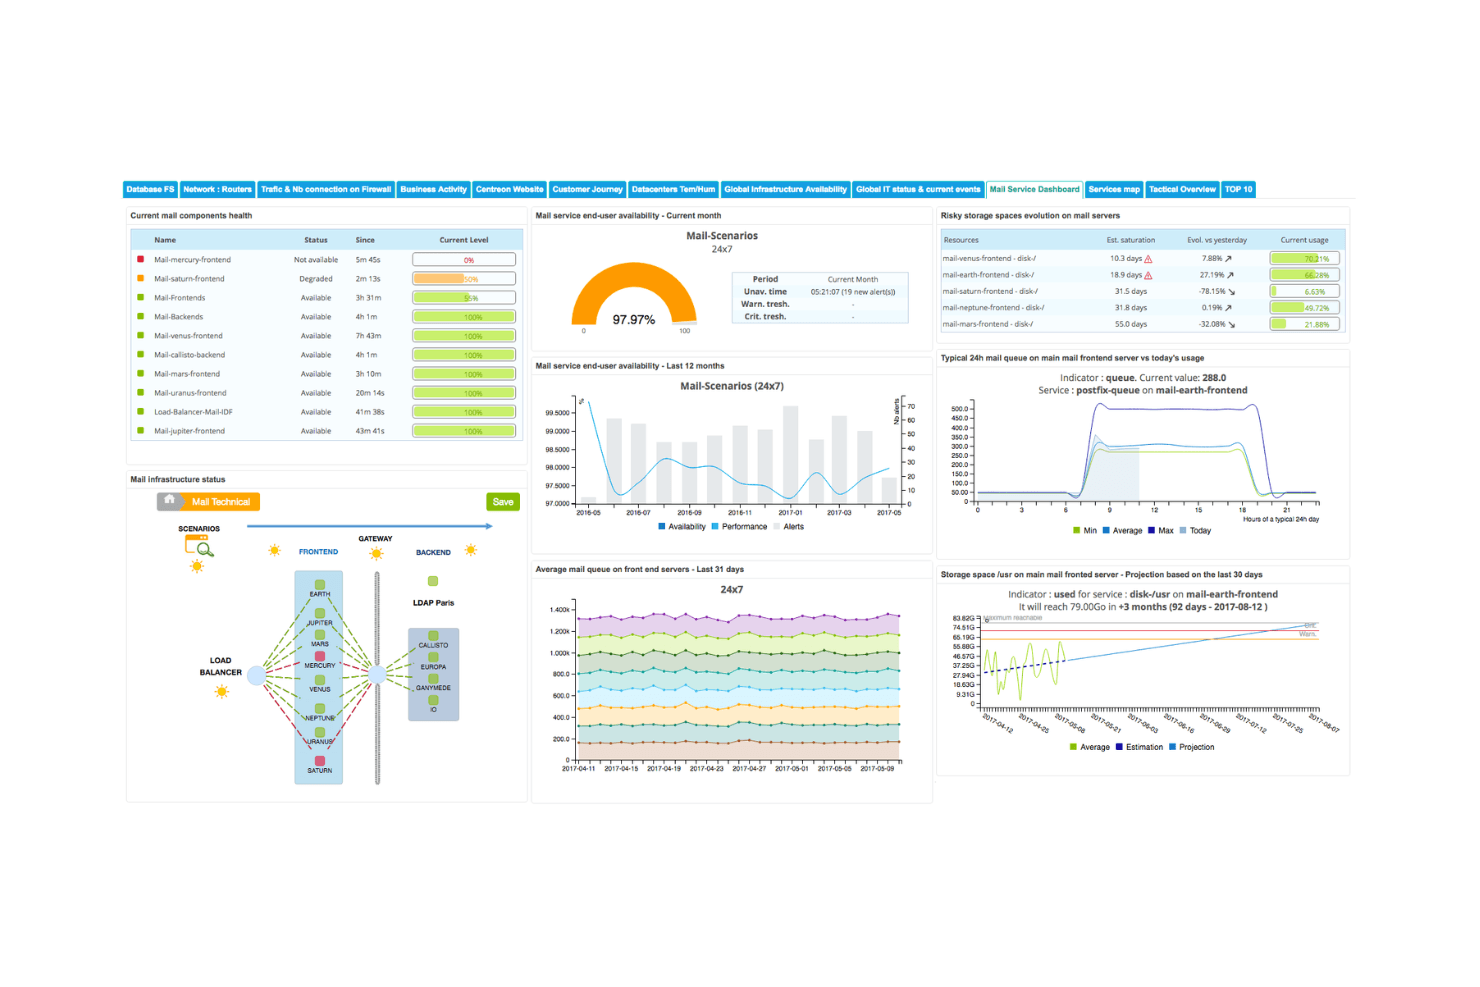
Centreon tilbyder et samlet kontrolpanel for mailtjenester til overvågning af infrastrukturen i realtid. Centreon er en hybrid IT-overvågningsplatform, der er udviklet til systemadministratorer og DevOps-teams, som har brug for samlet synlighed på tværs af servere, netværk, cloudtjenester, containere og OT-systemer – uden at skulle håndtere separate værktøjer for hvert lag i deres infrastruktur.
Hvem er Centreon bedst egnet til?
Centreon er et godt valg for systemadministratorer og DevOps-teams, der administrerer heterogene miljøer, som spænder over lokal infrastruktur, cloudtjenester og ældre systemer side om side.
Hvorfor jeg valgte Centreon
Centreon får en plads på min liste, fordi det er en af de få platforme, der reelt dækker overvågning fra ende til anden på tværs af servere, netværk, cloudtjenester, containere og OT-systemer uden at kræve separate værktøjer til hvert lag. Jeg kan især godt lide funktionen til overvågning af forretningsaktiviteter, som forbinder teknisk servicestatus direkte med forretningsaktiviteter, så mit team ikke kun kan se, at noget er nede, men også hvilke driftsaktiviteter det påvirker. De mere end 700 forudbyggede overvågningsforbindelser med ekspertjusterede standardindstillinger betyder, at jeg kan få Kubernetes-klynger og ældre AS/400-systemer ind i den samme overvågningsvisning.
Centreons vigtigste funktioner
- Migreringsværktøj til Nagios CFG: Et gratis open source-værktøj læser dine eksisterende Nagios CFG-filer og konverterer dem til Centreon CLAPI-kommandoer, så de kan importeres direkte.
- Eskaleringsnotifikationer via flere kanaler: Sender advarsler via e-mail, SMS, Slack, Microsoft Teams og Telegram med konfigurerbare intervaller for gensendelse og eskaleringsregler.
- Distribueret poller-arkitektur: Implementerer pollere og valgfri fjernservere på tværs af lokationer eller netværkszoner for uafhængigt at indsamle og mellem-lagre overvågningsdata uden for den centrale server.
- Rollebaseret adgangskontrol: Tildeler brugergrupper og detaljerede rettigheder på tværs af pollere, ressourcer, UI-menuer og handlinger med understøttelse af LDAP, SAMLv2 og OpenID Connect.
Centreon-integrationer
Centreon tilbyder 736 overvågningsforbindelser på markedspladsen, herunder Amazon EC2, Azure Virtual Machine, Kubernetes API, VMware vCenter, Cisco Standard SNMP, Microsoft SQL Server og PostgreSQL. Det integreres med ServiceNow, Jira, PagerDuty, Grafana og Kafka med understøttelse af REST API v1 og v2, CLAPI og MAP API.
Pros and Cons
Pros:
- Migreringsværktøj til Nagios CFG gør overgangen lettere
- GUI-arbejdsgange erstatter manuelt redigeret konfiguration
- Samlet overvågning af ældre og moderne systemer
Cons:
- Forbindelsesplugins kræver separat vedligeholdelse
- Den indledende opsætning og fastsættelse af tærskelværdier tager tid
Learn more about Centreon: 10Bedst til distribuerede netværk
OpenNMS
- Gratis abonnement tilgængeligt
- Fra $6,000/år (faktureret årligt)
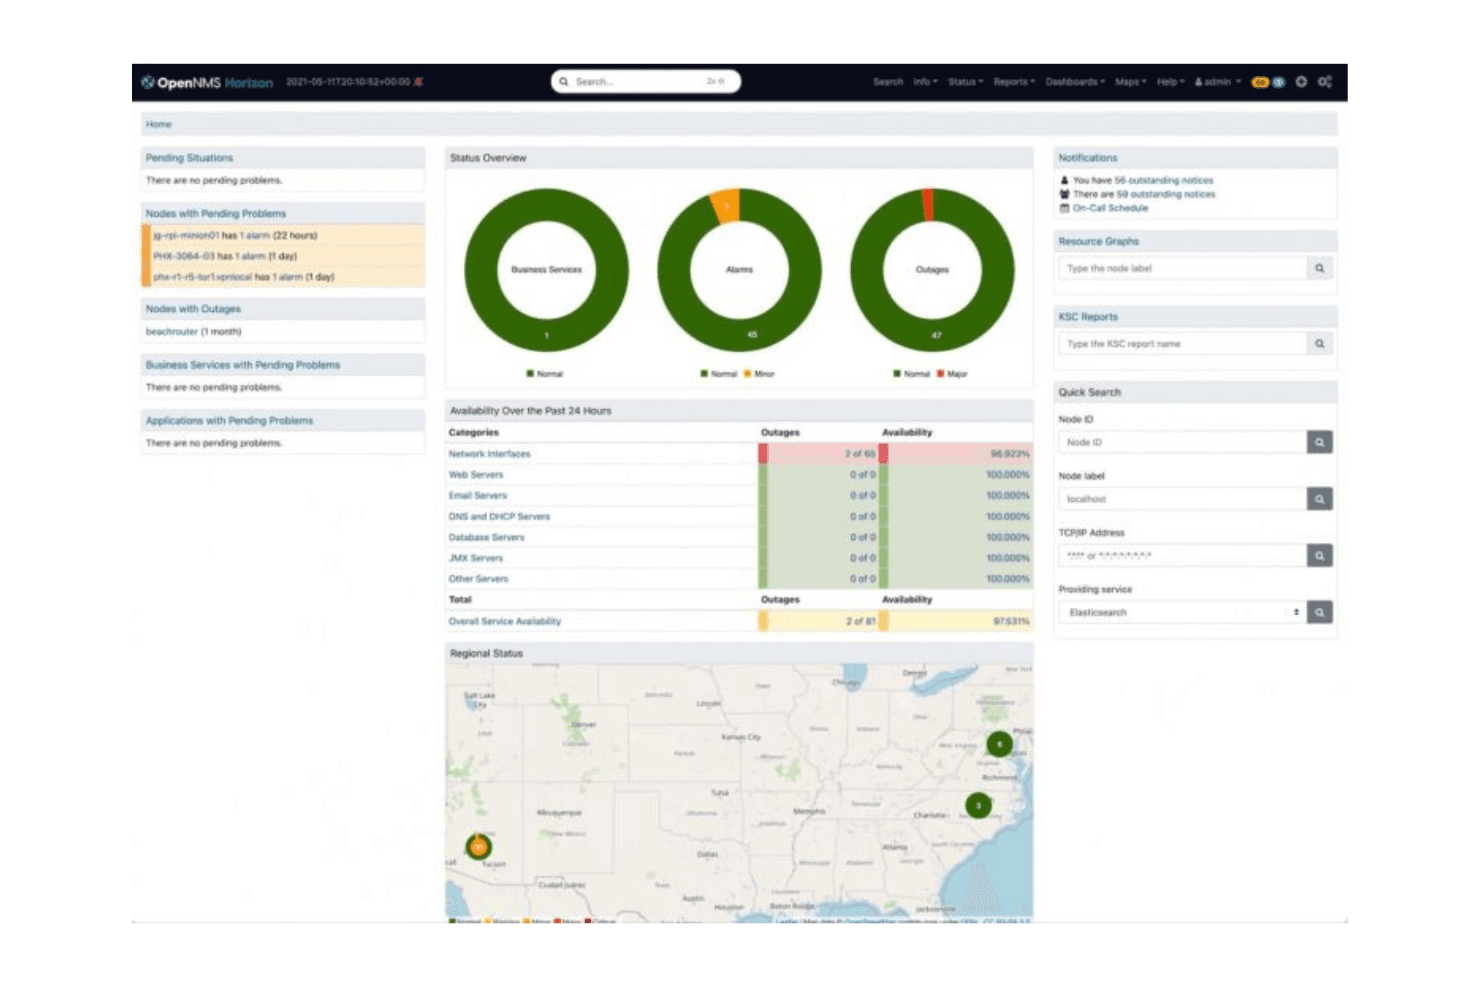
OpenNMS har et centralt instrumentpanel til overvågning af netværksstatus og driftsafbrydelser. OpenNMS er en platform til netværksovervågning med åben kildekode, der er udviklet til teknisk kompetente teams, som har brug for dyb protokolunderstøttelse, distribueret overvågning på tværs af fjernplacerede eller firewallbeskyttede lokationer samt skalerbar synlighed i forbindelse med fejl og ydeevne på tværs af stor og kompleks infrastruktur.
Hvem er OpenNMS bedst egnet til?
OpenNMS er velegnet til netværksdriftsteams, der administrerer stor, distribueret infrastruktur og har brug for dyb protokolunderstøttelse samt fleksibel fjernovervågning på tværs af firewallbeskyttede eller segmenterede lokationer.
Hvorfor jeg valgte OpenNMS
Jeg valgte OpenNMS, fordi Minion-arkitekturen reelt løser problemet med distribueret overvågning, som Nagios håndterer dårligt. Minions placeres i firewallbeskyttede eller NAT-adskilte netværkssegmenter og videresender data tilbage til kernen, så mit team kan overvåge fjernlokationer uden at åbne huller i firewallen eller køre en separat overvågningsinstans på hver lokation. Jeg sætter også pris på, at OpenNMS automatisk registrerer lag 2- og lag 3-topologi, så mit team får et direkte kort over, hvordan enhederne hænger sammen på tværs af disse distribuerede segmenter.
Vigtige funktioner i OpenNMS
- ALEC-alarmkorrelation: Grupperer relaterede alarmer i situationer på højere niveau ved hjælp af tidsmæssig klyngedannelse, maskinlæring og direkte topologidata.
- Indlæsning af NetFlow og streamingtelemetri: Indsamler og behandler NetFlow v5/v9, IPFIX, sFlow og leverandørspecifikke telemetrisystemer, herunder Cisco NX-OS og OpenConfig.
- Sikkerhedskopiering af enhedskonfiguration: Planlægger eller udløser sikkerhedskopier af enhedskonfigurationer efter behov, bevarer versionshistorik og understøtter sammenligning side om side over tid.
- REST-API og API til udvikling af udvidelser: Gør lagerbeholdning, målinger, hændelser, alarmer og flows tilgængelige via en REST-API med en stabil API til udvidelser, så platformens funktionalitet kan udvides eller tilgås.
OpenNMS-integrationer
OpenNMS har dokumenterede, indbyggede integrationer med PagerDuty, Grafana, Jira, Remedy, TSRM, Slack og Mattermost samt forbindelse til Kafka og Prometheus RemoteWrite. REST- og udvidelses-API'erne understøtter tilpassede integrationer.
Pros and Cons
Pros:
- Minions kan nå firewallbeskyttede fjernnetværk
- Bred SNMP-dækning omfatter blandet infrastruktur
- Anmeldere værdsætter grafer og netværksrapporter
Cons:
- XML-ændringer gør udskiftning af Nagios mere besværlig
- Forældede instrumentpaneler kræver ekstra navigation
Learn more about OpenNMS:
Andre alternativer til Nagios
Her er nogle yderligere alternativer til Nagios, som ikke kom med på min kortliste, men som stadig er værd at undersøge:
- 11MonitorixBedst til let overvågning
- 12op5 MonitorBedst til skalerbarhed i virksomheder
- 13NaemonBedst til modulær arkitektur, priser på forespørgsel
- 14ArgusBedst til system- og netværksovervågning
Hvordan jeg evaluerer alternativer til Nagios
Jeg opdeler min evaluering i to lag: det grundlæggende, som ethvert værktøj skal kunne leve op til – alarmering i realtid, dækning af flere miljøer og automatisk registrering – samt de egenskaber, der adskiller de bedste fra resten.
Kernefunktionalitet (grundkrav for denne liste)
Når jeg udvælger værktøjer til min liste, vurderer jeg hvert enkelt på en skala fra 0 (tilbyder ikke funktionaliteten) til 5 (udmærker sig på området) for hver af de nedenstående kernefunktioner. Derefter omregner jeg værktøjets samlede score til en procentdel. Hvert værktøj skal opnå en samlet minimumsscore på 75 % for at komme i betragtning.
- Infrastrukturovervågning: Jeg undersøger, om et værktøj sporer servere, netværksenheder og tjenester med tilstandstjek i realtid og præstationsmålinger – såsom CPU-, hukommelses-, disk- og grænsefladeudnyttelse på tværs af en blandet samling Linux- og Windows-værter.
- Alarmering & notifikationer: Hvert værktøj bør understøtte alarmer via flere kanaler (e-mail, Slack, PagerDuty, SMS) med konfigurerbare tærskler og eskaleringspolitikker, så den rette vagthavende tekniker får en alarm, når en disk bliver fyldt klokken 2 om natten.
- Dashboards & visualisering: Jeg vurderer, om dashboards kan tilpasses tilstrækkeligt til at oprette rollebaserede visninger – for eksempel en vægskærm i et NOC, der viser netværksstatus, over for et DevOps-teams panel for containerpræstation.
- Automatisk registrering & agentunderstøttelse: Værktøjer, der automatisk registrerer værter og tjenester via SNMP, WMI eller API'er fra cloududbydere, sparer timevis af manuel konfiguration, og jeg ser efter fleksible agentbaserede og agentløse muligheder, der kan dække både segmenter beskyttet af firewalls og cloud-VPC'er.
- Integrationer & udvidelsesmuligheder: Jeg ser på forudbyggede integrationer med ITSM-platforme som ServiceNow eller Jira Service Management samt API-adgang og plugin-understøttelse til at skrive brugerdefinerede tjek eller sende data til værktøjer som Grafana.
- Dækning af flere miljøer: Uanset om du kører fysiske servere, arbejdsbelastninger i flere cloudmiljøer på tværs af AWS og Azure eller Kubernetes-klynger, vurderer jeg, hvor godt hvert værktøj overvåger lokale miljøer, cloudmiljøer og containerbaserede miljøer.
Når jeg har en liste over værktøjer, der opfylder disse kriterier, ser jeg på, hvad der adskiller de enkelte platforme.
Differentierende faktorer (det, der adskiller leverandørerne)
Sådan sammenligner jeg forskellige leverandører:
Fremtrædende funktioner
AIOps-funktioner spiller en stor rolle her. Værktøjer, der bruger maskinlæring til at fastlægge normal adfærd og identificere reelle afvigelser, reducerer alarmstøj på måder, som statiske tærskler aldrig kan. Jeg vurderer også kortlægning af afhængigheder og topologi – når en central switch går ned, gør det fejlsøgningen markant hurtigere at kunne se påvirkningsomfanget på tværs af afhængige tjenester. Automatisering og selvreparation fuldender billedet. Jeg ser efter værktøjer, der automatisk kan udløse handlinger fra driftsvejledninger, såsom at genstarte en fejlslagen tjeneste eller rydde en midlertidig mappe, før en alarm overhovedet når det vagthavende team.
Ud over funktionerne
Understøttelse af migrering er vigtig, når du skifter fra Nagios. Jeg undersøger, om et værktøj kan importere eksisterende konfigurationer af tjek eller genbruge brugerdefinerede plugins, så man undgår at skulle genopbygge alt fra bunden. Gennemsigtighed omkring priser er lige så vigtig – Nagios-brugere er vant til open source-økonomi, så jeg vurderer, om leverandørerne tilbyder et gratis niveau eller forudsigelige priser pr. vært, som ikke stiger voldsomt, efterhånden som dit miljø vokser. Fællesskabets og økosystemets sundhed spiller også en rolle. Et aktivt plugin-markedsplads og hyppige udgivelser er tegn på langsigtet levedygtighed.
Hvorfor lede efter et alternativ til Nagios?
Selvom Nagios er et godt valg inden for softwareudvikling, er der en række grunde til, at nogle brugere søger alternative løsninger. Du leder måske efter et alternativ til Nagios, fordi…
- Du har brug for mere intuitive brugergrænseflader
- Dit team har brug for bedre skalerbarhed
- Du leder efter enklere konfiguration
- Du ønsker avancerede analysefunktioner
- Din virksomhed har brug for hurtigere alarmsystemer
Hvis noget af dette lyder som dig, er du kommet til det rette sted. Min liste indeholder flere muligheder inden for softwareudvikling, som er bedre egnet til teams, der står over for disse udfordringer med Nagios og søger alternative løsninger. For teams, der overvejer bredere overvågningsløsninger, kan udforskning af alternativer til New Relic give yderligere muligheder for omfattende overvågning af applikationsydeevne.
Nagios' vigtigste funktioner
Her er nogle af Nagios' vigtigste funktioner, som kan hjælpe dig med at sammenligne, hvad alternative løsninger tilbyder:
- Overvågningsfunktioner: Sporer ydeevnen og tilgængeligheden af servere, applikationer og netværksenheder.
- Alarmsystem: Sender meddelelser via e-mail eller SMS, når der opstår problemer, så der kan reageres hurtigt.
- Webgrænseflade: Giver et brugervenligt kontrolpanel til overvågning og rapportering i realtid.
- Tilpasningsbare plugins: Understøtter en række plugins til udvidet funktionalitet, der er skræddersyet til specifikke behov.
- Skalerbarhed: Kan skaleres til at overvåge store miljøer med mange enheder.
- Support fra fællesskabet: Understøttes af et stærkt fællesskab, der hjælper med fejlfinding og forbedringer.
- Problemafhjælpning: Funktioner som bekræftelse af alarmer og hændelsesbehandlere til automatisk løsning af problemer.
- Proaktiv planlægning: Værktøjer til trendanalyse, kapacitetsplanlægning og håndtering af planlagt nedetid.
- Rapportering: Genererer tilgængeligheds- og historiske rapporter til sporing af ydeevne og overholdelse af SLA'er.
- Funktioner til flere lejere: Giver flere brugere adgang til tilpassede visninger af infrastrukturen.