

Ledarskap inom testning: tjänstetestning

Redaktörens anmärkning: Välkommen till serien Ledarskap i testning från gurun inom programvarutestning och konsulten Paul Gerrard. Serien är utformad för att hjälpa testare med några års erfarenhet – särskilt de som arbetar i agila team – att utmärka sig i roller som testledare och testansvariga.
I den förra artikeln tittade vi på testarnas föränderliga roll och hur man främjar bättre samarbete med sina kollegor. I den här artikeln går vi igenom grunderna i att testa en webbapplikations prestanda, tillförlitlighet och hanterbarhet. Även kallat tjänstetestning.
Anmäl dig till nyhetsbrevet från The QA Lead för att få meddelanden när nya delar av serien publiceras. Dessa inlägg är utdrag ur Pauls kurs i Ledarskap i testning, som vi varmt rekommenderar för en djupare genomgång av detta och andra ämnen. Om du gör det kan du använda vår exklusiva kupongkod QALEADOFFER för att få 60 dollar rabatt på hela kurspriset!
Hej och välkommen till ännu ett kapitel i serien Ledarskap i testning. Den här veckan tittar vi på tjänstetestning för webbapplikationer. Vi kommer att gå igenom:
- Vad är tjänstetestning?
- Vad är prestandatestning?
- Testning av tillförlitlighet och redundans
- Testning av tjänstehantering
Låt oss börja.

Vad är tjänstetestning?
Kvaliteten på den tjänst som en webbapplikation tillhandahåller kan definieras som att den omfattar alla dess egenskaper, såsom funktionalitet, prestanda, tillförlitlighet, användbarhet, säkerhet och så vidare.
För våra syften här skiljer vi dock ut tre särskilda tjänstemål som granskas inom det vi kallar ”tjänstetestning”. Dessa mål är:
- Prestanda: tjänsten måste svara snabbt för användarna samtidigt som den hanterar den belastning som läggs på den.
- Tillförlitlighet: om tjänsten är utformad för att vara motståndskraftig mot fel måste den vara tillförlitlig och/eller fortsätta att tillhandahålla en tjänst även när ett fel inträffar.
- Hanterbarhet: tjänsten måste kunna hanteras, konfigureras eller ändras utan att en försämring av tjänsten märks av slutanvändarna. Hanterbarhet, eller driftstestning, syftar till att visa att systemets administrativa rutiner, hanteringsrutiner samt rutiner för säkerhetskopiering och återställning fungerar effektivt.
I alla tre fallen behöver vi simulera användarbelastning för att kunna genomföra testerna effektivt. Mål för prestanda, tillförlitlighet och hanterbarhet finns i sammanhanget av riktiga kunder som använder webbplatsen för att göra affärer.
En webbplats svarstid (i detta fall den tid det tar för en systemnod att svara på en annan nods begäran) är direkt relaterad till de resurser som finns tillgängliga i den tekniska arkitekturen.
När fler kunder använder tjänsten finns färre tekniska resurser tillgängliga för att hantera varje användares begäranden, och svarstiderna försämras.
En tjänst som är lätt belastad löper uppenbarligen mindre risk att drabbas av fel. Mycket av komplexiteten i programvara och maskinvara finns för att hantera kraven på resurser i den tekniska arkitekturen när en webbplats är hårt belastad.
När en webbplats belastas (eller överbelastas) måste de motstridiga resursbegärandena hanteras av olika infrastrukturkomponenter, såsom server- och nätverksoperativsystem, databashanteringssystem, webbserverprodukter, objektbegäransmäklare, mellanprogramvara och så vidare.
Dessa infrastrukturkomponenter är vanligtvis mer tillförlitliga än den specialbyggda programkod som kräver resursen, men fel kan uppstå i båda fallen:
- Infrastrukturkomponenter slutar fungera eftersom programkoden (genom bristfällig design eller implementering) ställer överdrivna krav på resurserna.
- Applikationskomponenterna kan sluta fungera eftersom de resurser de behöver inte alltid är tillgängliga (i tid).
Genom att simulera typiska och ovanliga produktionsbelastningar under en längre period kan testare avslöja brister i systemets design eller implementering. När dessa brister har åtgärdats kommer samma tester att visa att systemet är motståndskraftigt. Kvalitetssäkringsteam kan dra nytta av verktyg för belastningstestning för att utföra många av de processer som definieras nedan.
För alla tjänster finns det vanligtvis ett antal kritiska hanteringsprocesser som måste utföras för att tjänsten ska fungera smidigt. Det kan vara möjligt att stänga ner en tjänst för rutinunderhåll utanför normala arbetstider, men de flesta onlinetjänster är i drift dygnet runt.
Tjänstens arbetsdag tar aldrig slut. Oundvikligen måste hanteringsrutiner utföras medan tjänsten är i drift och användare befinner sig i systemet. Dessa rutiner måste testas medan systemet är belastat för att säkerställa att de inte påverkar den aktiva tjänsten negativt, vilket även kallas prestandatestning.
Vad är prestandatestning?
Prestandatestning är en viktig del av tjänstetestning. Det är ett sätt att testa hur ett system fungerar när det gäller svarstid och stabilitet under en viss belastning. Här är en översikt över hur det fungerar:
- Prestandatestning består av en rad tester med varierande belastning där systemet når ett stabilt tillstånd (belastning och svarstider på konstanta nivåer).
- Vi mäter belastning och svarstider för varje belastningsnivå, simulerad under en period på 15–30 minuter, för att få ett statistiskt signifikant antal mätningar.
- Vi övervakar och registrerar de viktigaste mätvärdena för varje simulerad belastning. Det handlar om olika resurser i vårt system, till exempel processor- och minnesanvändning, nätverksbandbredd, I/O-hastigheter och så vidare.
Vi ritar en graf över dessa varierande belastningar i förhållande till de svarstider som våra ”virtuella” användare upplever. När grafen ritas ser den ut ungefär som figuren nedan.
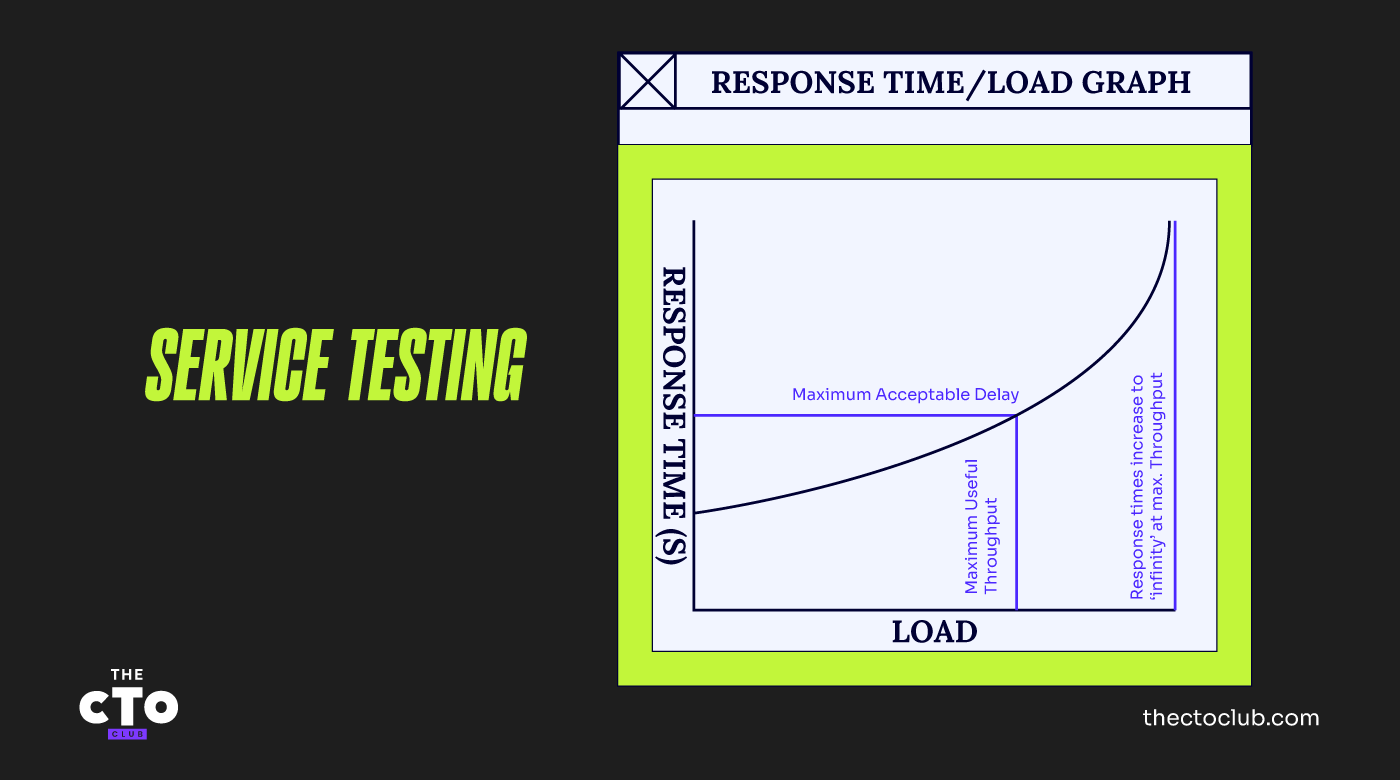
Vid nollbelastning, när det bara finns en enda användare i systemet, har användaren hela resursen för sig själv och svarstiderna är snabba. När vi inför ökad belastning och mäter svarstiderna blir de gradvis sämre tills vi når en punkt där systemet körs med maximal kapacitet.
Vid denna punkt är svarstiden för våra testtransaktioner teoretiskt oändlig, eftersom en av systemets viktigaste resurser är helt förbrukad och inga fler transaktioner kan behandlas.
När vi ökar belastningen från noll upp till maximalt värde övervakar vi också användningen av olika resurs-typer, till exempel serverprocessoranvändning, minnesanvändning, nätverksbandbredd, databaslås och så vidare.
Vid maximal belastning är en av dessa resurser fullt utnyttjad till 100 %. Denna resurs är den begränsande resursen eftersom den tar slut först. Naturligtvis har svarstiderna vid denna punkt försämrats så mycket att de sannolikt är betydligt långsammare än vad som skulle vara acceptabelt.
Grafen nedan visar användningen/tillgängligheten för flera resurser i förhållande till belastningen.
För att öka ett systems genomströmningskapacitet och/eller minska svarstiderna måste vi göra något av följande:
- Minska efterfrågan på resursen, vanligtvis genom att göra programvaran som använder resursen mer effektiv (detta är vanligtvis utvecklingens ansvar).
- Optimera användningen av hårdvaruresursen inom den tekniska arkitekturen, till exempel genom att konfigurera databashanteringssystemet så att mer data cachas i minnet eller genom att prioritera vissa processer framför andra på applikationsservern.
- Göra mer av en resurs tillgänglig. Normalt genom att lägga till processorer, minne eller nätverksbandbredd och så vidare.
Som du säkert redan börjar inse behöver prestandatestning ett team av personer som hjälper testarna. Det handlar om tekniska arkitekter, serveradministratörer, nätverksadministratörer, utvecklare samt databasdesigners och databasadministratörer. Dessa tekniska experter är kvalificerade att analysera den statistik som genereras av resursövervakningsverktygen och bedöma hur applikationen bäst bör justeras eller hur systemet bör finjusteras eller uppgraderas.
Om du är testare bör du, såvida du inte själv är särskilt kunnig inom dessa områden, inte frestas att låtsas att du kan tolka statistiken och fatta beslut om finjustering och optimering. Du behöver involvera dessa experter tidigt i projektet för att få deras råd och stöd och senare, under testningen, för att säkerställa att flaskhalsar identifieras och åtgärdas.
Håll utkik efter nästa artikel, där vi går djupare in på hur man hanterar prestandatestning.
Tillförlitlighets-/redundanstestning
Att säkerställa kontinuerlig tillgänglighet för en tjänst är sannolikt ett viktigt mål för ditt projekt. Tillförlitlighetstestning hjälper till att identifiera svårupptäckta fel som orsakar oväntade störningar. Redundanstestning hjälper till att säkerställa att de inbyggda åtgärderna för förväntade fel faktiskt fungerar.
Redundanstestning
När webbplatser måste vara motståndskraftiga och/eller tillförlitliga utformas de vanligtvis med tillförlitliga systemkomponenter med inbyggd redundans och redundansfunktioner som träder i kraft när fel uppstår.
Dessa funktioner kan omfatta diversifierad nätverksrouting, flera servrar konfigurerade som kluster, mellanprogramvara och distribuerad tjänsteteknik som hanterar lastbalansering samt omdirigering av trafik vid felsituationer.
Syftet med redundanstestning är att undersöka systemets beteende under utvalda felscenarier före driftsättning och omfattar normalt följande:
- Identifiering av de komponenter som kan fallera och orsaka ett tjänsteavbrott (genom att granska fel inifrån och ut).
- Identifiering av de risker som kan orsaka ett fel och leda till ett tjänsteavbrott (genom att granska hot utifrån och in).
- En analys av de fellägen eller scenarier som kan inträffa, där du behöver vara säker på att återställningsåtgärden kommer att fungera.
- Ett automatiserat test som kan användas för att belasta systemet och undersöka systemets beteende under en längre period.
- Samma automatiserade test kan också användas för att belasta systemet under test och övervaka systemets beteende under felförhållanden.
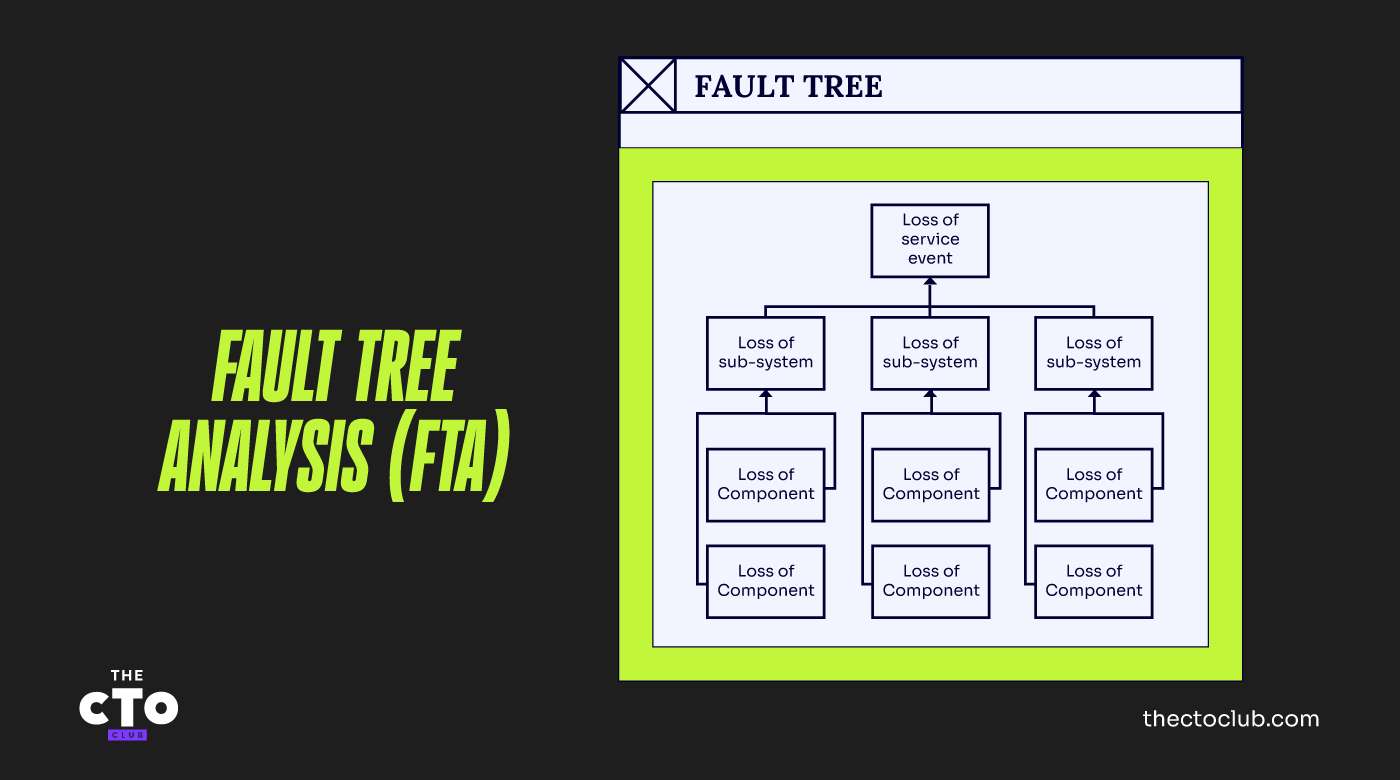
En teknik som kallas felträdsanalys (FTA) kan hjälpa dig att förstå tjänstens beroenden av dess underliggande komponenter. Felträdsanalys och felträdsscheman är en logisk representation av ett system eller en tjänst och de sätt på vilka den kan fallera.
Det enkla schemat nedan visar sambandet mellan grundläggande komponentfel, mellanliggande delsystemfel och det översta tjänstefelssteget. Naturligtvis kan det vara möjligt att identifiera fler än tre nivåer av felhändelser.
Dessa tester måste köras med en automatiserad belastning för att undersöka systemets beteende i produktionssituationer och skapa förtroende för de inbyggda återställningsåtgärderna. Framför allt vill du veta:
- Hur beter sig arkitekturen i felsituationer?
- Fungerar belastningsbalanseringsfunktionerna korrekt?
- Tar redundansfunktionerna över belastningen när en komponent fallerar?
- Fungerar den automatiska återställningen? ”Hinner” omstartade system ikapp?
I slutändan fokuserar testerna på att avgöra om tjänsten för slutanvändarna upprätthålls och om användarna faktiskt märker att felet inträffar.
Tillförlitlighetstestning (eller uthållighetstestning)
Tillförlitlighetstestning syftar till att kontrollera att fel inte uppstår under belastning.
De flesta hårdvarukomponenter är så tillförlitliga att deras medeltid mellan fel kan mätas i år. Tillförlitlighetstester kräver att automatiserade tester används (eller återanvänds) på två sätt för att simulera:
- Extrema belastningar på specifika komponenter eller resurser i den tekniska arkitekturen.
- Långa perioder med normal (eller extrem) belastning på hela systemet.
När vi fokuserar på specifika komponenter vill vi utsätta komponenten för belastning genom att ge den ett orimligt stort antal förfrågningar för att utföra sin avsedda funktion. Det är ofta enklare att först stresstesta kritiska komponenter isolerat med stora mängder enkla förfrågningar, innan ett mycket mer komplext test tillämpas på hela infrastrukturen. Det finns även särskilt utformade verktyg för stresstestning som gör det enklare för kvalitetssäkringsteam att genomföra processen.
Uthållighetstester utsätter ett system för belastning under en längre period, kanske 24, 48 timmar eller längre, för att upptäcka (vanligtvis) svårupptäckta problem. Svårupptäckta fel visar sig ofta först efter en längre tids användning.
Det automatiserade testet behöver inte nödvändigtvis trappas upp till extrema belastningar (det täcks av stresstestning). Men vi är särskilt intresserade av systemets förmåga att klara kontinuerlig körning av många olika testtransaktioner för att upptäcka eventuella svårupptäckta minnesläckor, låsningar eller kapplöpningstillstånd.
Testning av tjänstehantering
Avslutningsvis några ord om testning av tjänstehantering.
När tjänsten har distribuerats i produktion måste den hanteras. För att hålla en tjänst igång och tillgänglig måste den övervakas, uppgraderas, säkerhetskopieras och snabbt åtgärdas när något går fel.
De procedurer som tjänsteansvariga använder för att genomföra uppgraderingar, säkerhetskopieringar, lanseringar och återställningar efter fel är avgörande för att tillhandahålla en tillförlitlig tjänst. Därför behöver de testas, särskilt om tjänsten kommer att genomgå snabba förändringar efter driftsättningen.
De särskilda problem som måste hanteras är:
- Procedurerna uppnår inte den önskade effekten.
- Procedurerna är ogenomförbara eller oanvändbara.
- Procedurerna stör den aktiva tjänsten.
Testerna bör, så långt det är möjligt, genomföras på ett så realistiskt sätt som möjligt.
Något att fundera på
Vissa system är benägna att utsättas för extrema belastningar när en viss händelse inträffar. Ett onlineföretag kan till exempel förvänta sig toppbelastningar strax efter att det har annonserat erbjudanden på TV, eller så kan en nationell nyhetswebbplats bli överbelastad när en stor nyhet når allmänheten.
Tänk på ett system som du känner väl och som påverkades av oplanerade incidenter i ditt företag eller i de nationella nyheterna.
Vilka incidenter eller händelser skulle kunna utlösa överbelastningar i ert system?
Kan (eller skulle) ni samla in data från systemloggar som visar antalet genomförda transaktioner? Kan ni skala denna händelse för att förutsäga en kritisk händelse som inträffar en gång på 100 år eller en gång på 1 000 år?
Vilka åtgärder skulle ni kunna vidta (eller har ni vidtagit) för att antingen minska sannolikheten för toppar, minska topparnas omfattning eller eliminera dem helt?
Prenumerera på nyhetsbrevet från The QA Lead för att få meddelanden när nya delar av serien publiceras. Dessa inlägg är utdrag ur Pauls kursen Leadership In Test, som vi varmt rekommenderar för en djupare genomgång av detta och andra ämnen. Om ni gör det kan ni använda vår exklusiva kupongkod QALEADOFFER för att få $60 rabatt på kursens fullständiga pris!
Föreslagen läsning: 10 BÄSTA TESTHANTERINGSVERKTYGEN MED ÖPPEN KÄLLKOD

