Var kodningsagenter hjälper till och var de misslyckas
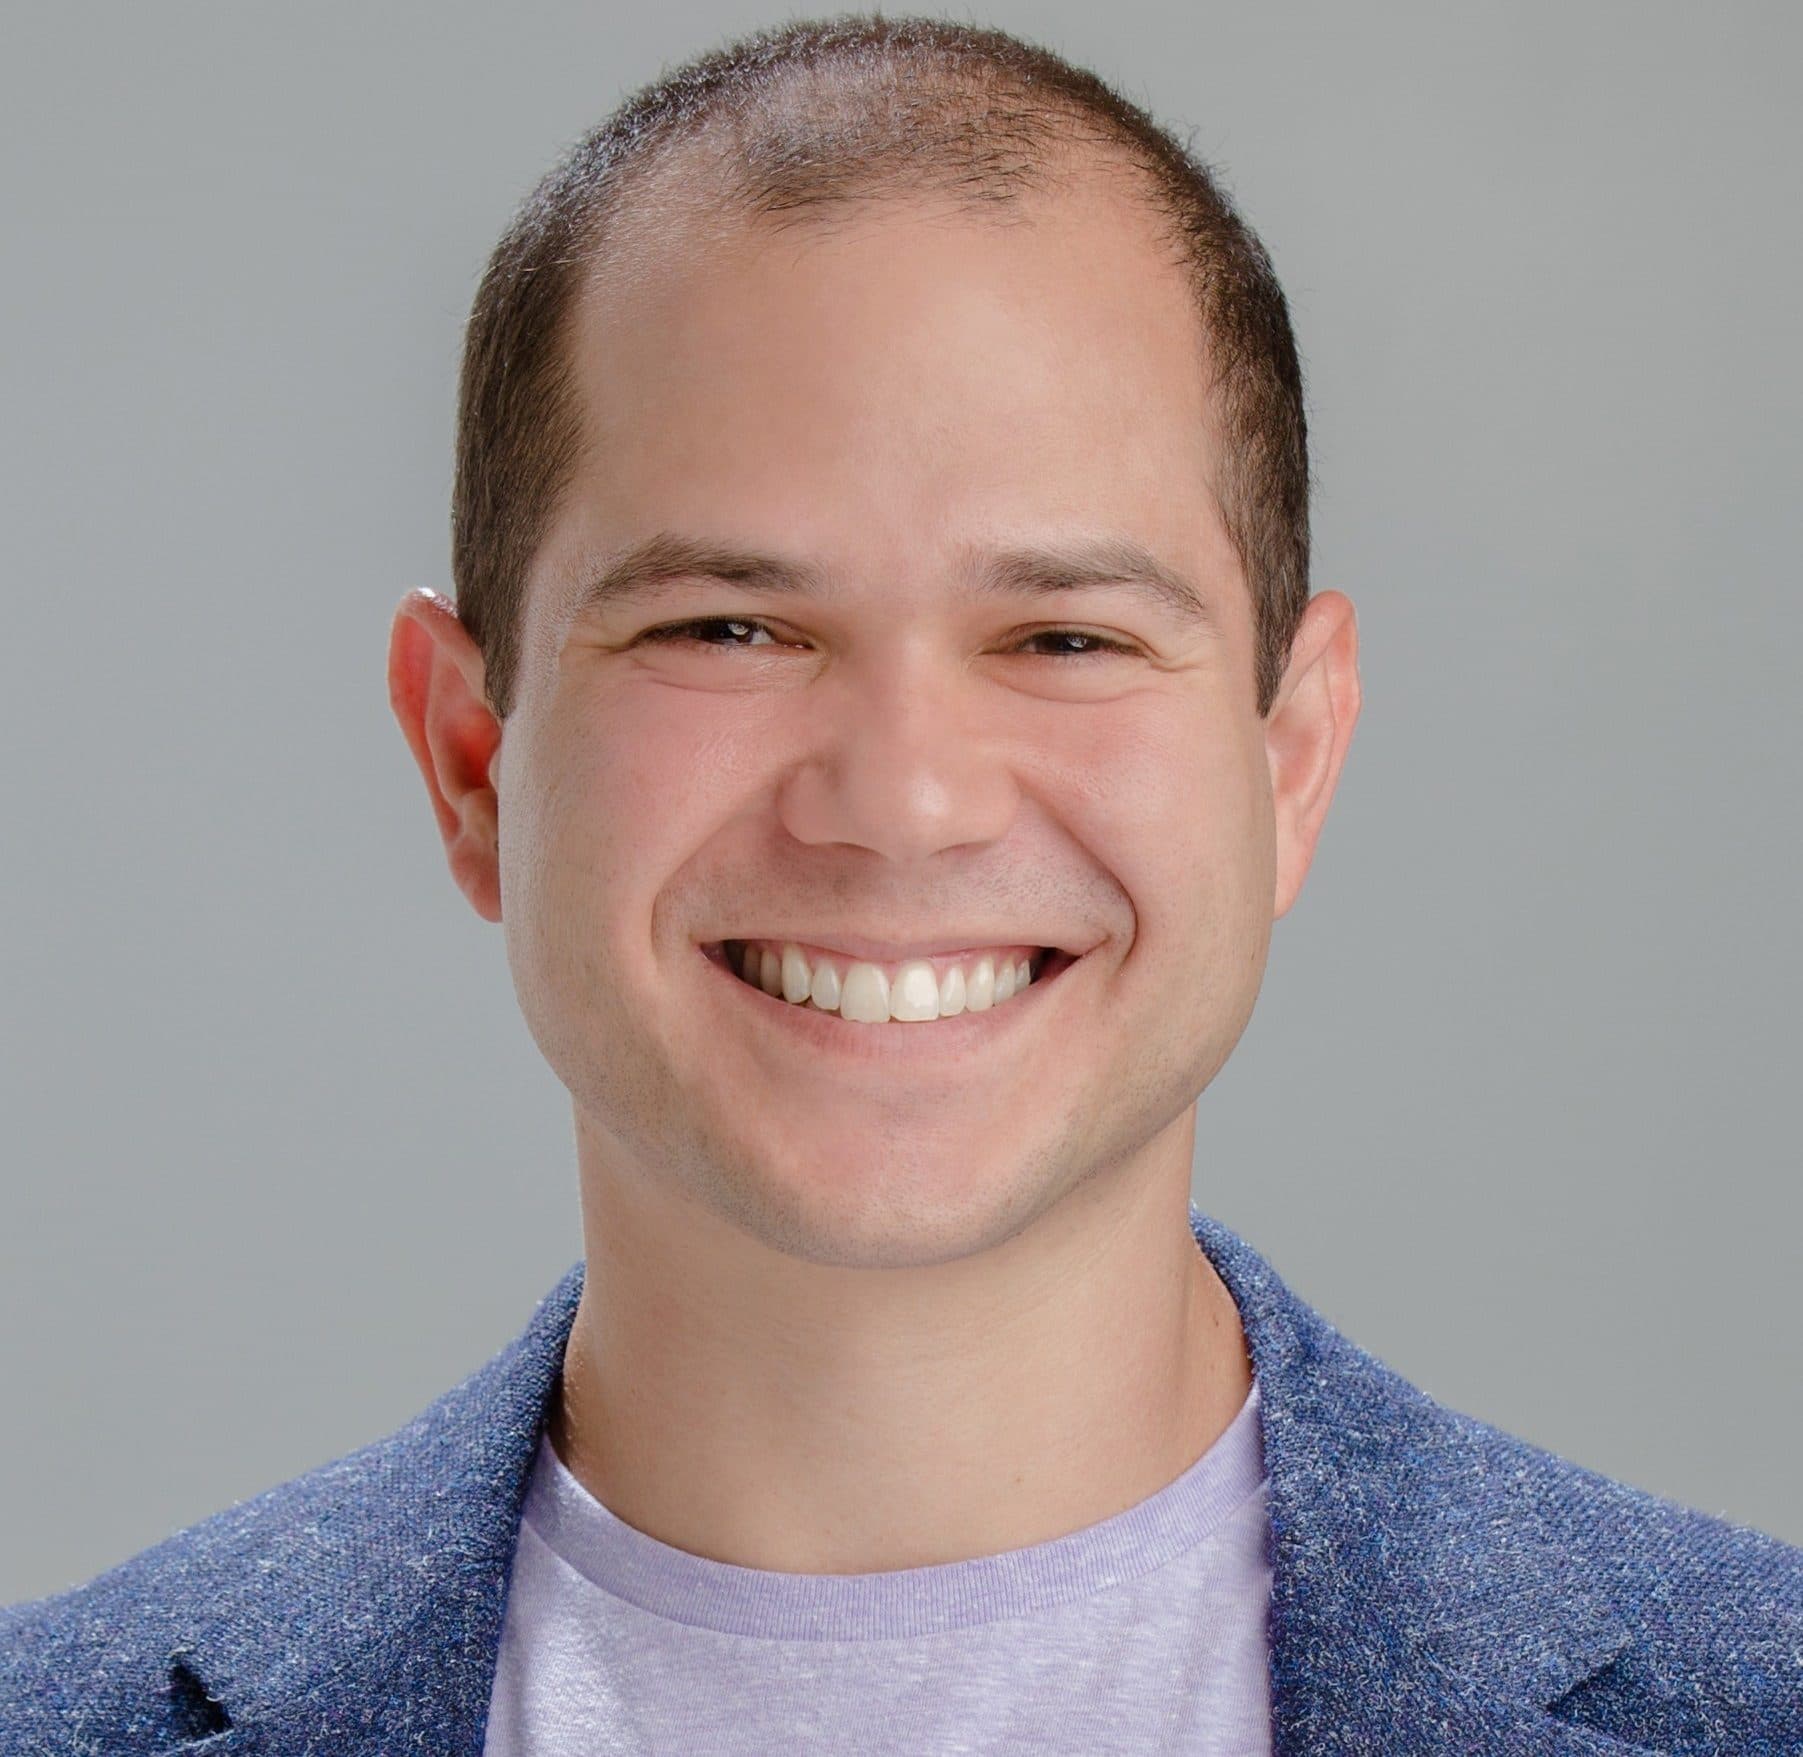
Pedro Alves
Teknisk chef på Thoth AI
Pedro Alves förklarar var AI-kodningsagenter påskyndar ingenjörsarbetet, var de medför dolda risker och varför erfarna utvecklare fortfarande är oumbärliga.
Key Takeaways
Kodningsagenter: Kodningsagenter kan påskynda implementeringen, men mänskligt omdöme måste vägleda arkitektur, kvalitet och beslut för produktionsmiljöer.
Dolda buggar: AI-genererad kod körs ofta framgångsrikt samtidigt som den döljer logiska fel som erfarna granskare måste upptäcka.
Kreativa luckor: Modeller hanterar väldefinierade översättningsuppgifter väl, men människor måste bidra med okonventionella insikter, kopplingar och grundläggande beslut.
Teamets hävstångseffekt: Organisationer vinner mer på att skala upp erfarna yrkespersoner med AI än på att försöka lyfta oerfarna team.
Central styrning: Ett litet AI-fokuserat team kan skapa återanvändbara arbetsflöden, minska dubblerade experiment och förbättra användningen i olika avdelningar.
Pedro Alves har arbetat omfattande med AI i 25 år. Han är för närvarande CTO på Thoth AI och skapare av Last Week in AI.
Vi satte oss ner med Pedro för att diskutera kodningsagenter — och varför det är så viktigt att veta vad de kan och inte kan göra. Här är vad han berättade för oss.
Innan ”AI” var något man satte på presentationsbilder
Jag heter Pedro och är CTO på Thoth AI. Jag arbetade med AI innan det var något man satte på presentationsbilder — redan 2001, när jag studerade datavetenskap på grundnivå, byggde jag en liten simulerad värld full av agenter och lät dem lära sig att överträffa varandra, ett slags digitalt livsspel där hela poängen var att se dem bli bättre. Det var 25 år sedan, och jag jagar fortfarande samma fråga: Hur får man ett system att förbättras?
När det blev dags för forskarutbildningen antog alla att jag skulle doktorera i maskininlärning. Det gjorde jag inte. Det kändes för snävt och för teoretiskt. Jag ville lära mig hantverket genom att arbeta med de rikaste och mest röriga data jag kunde hitta, så jag gav mig in i beräkningsbiologi: proteomik under min masterutbildning och genomik under min doktorandutbildning. Jag lärde mig maskininlärning, statistik och datavetenskap genom att tillämpa dem — gen-gen-interaktionsnätverk, egenskapskonstruktion, neurala nätverk och ensemblemetoder — på problem där det kostade något att ha fel.
Det var där jag lärde mig den lärdom som har präglat allt sedan dess. Inom medicinen byggde jag modeller för sjukdomsförlopp, och det vanliga måttet — övergripande träffsäkerhet — var värdelöst. En ”bra” modell enligt det måttet bekräftade bara de fall som läkarna redan kände till, när hela värdet låg i de fall de skulle missa. I stället för att optimera träffsäkerheten optimerade jag därför partiell AUC — i princip modellens förmåga att hantera de fall som spelade roll. Det mått någon ger dig är nästan aldrig det verkliga målet.
Därefter besökte jag olika branscher: dessa medicinska modeller, en period som konsult för ett professionellt fotbollslag, sedan Silicon Valley och flera år inom datorseende — på den tiden behövde man fortfarande utveckla metoderna för hur man tränade och till och med initierade ett nätverks vikter för att över huvud taget få detektering och klassificering att fungera. Jag arbetade med data från sociala nätverk, detaljhandel, mode och video. Jag tillbringade ett år med att bygga handelsalgoritmer med genetiska algoritmer och optimering med partikelsvärmar — icke-parametriska optimeringsmetoder som jag hade skrivit uppsatser om under forskarutbildningen. Till slut startade jag ett eget företag där jag byggde AI-verktyg för människor som inte var dataforskare.
Bredden knyter ihop allt. Efter ett dussin områden ser jag samma problem i olika skepnader — ett knep som är uppenbart inom genomik visar sig vara nyckeln inom datorseende. Jag bryr mig mer om hur ett problem formuleras än hur det löses, eftersom det är i problemformuleringen hävstången finns.
Det är detta som för mig till Thoth. På pappret är vi ett företag inom dataannotering. Men jag tror att det problem som hela området försöker lösa är fel problem. Ingen vill ha annoterade data — data är bara ett mellansteg. De vill ha en bättre modell. Därför arbetar jag mot en framtid där ett system tar reda på vilka data din modell behöver för att förbättras och hanterar den delen åt dig, så att du kan fokusera på modellen i stället för på etiketteringen.
More Articles
Två sidor av verksamheten
Strukturellt har Thoth AI två sidor. Den ena är motorn för datahantering, som drivs internationellt och i stor skala. Den är större än ett typiskt nystartat företag men fortfarande mycket mindre än jättarna på området, så jag skulle kalla den medelstor. Den andra sidan, den del jag bygger, är ett helt nytt forsknings- och innovationsteam här i Bay Area — för närvarande är vi fem personer, och fler ansluter under de kommande månaderna. Där arbetar vi med resten av modellförbättringen: allt bortom etikettering.
Vår forskning har två huvudsakliga inriktningar. Den första är robotik: att generera förkroppsligade data, utvärdera dem och använda aktiv inlärning för att automatiskt generera bästa möjliga träningsdata, så att robotar kan lära sig sina uppgifter med så lite data som möjligt. Det mesta bygger på egocentrisk data (i princip material ur förstapersonsperspektiv), och en stor del av vårt arbete fokuserar på att ta fram egocentrisk data av så hög kvalitet som möjligt. Den andra inriktningen är tillförlitlighet och effektivitet i språkmodeller: att förstå vad som orsakar hallucinationer och hur de ser ut, samt att på effektivitetssidan identifiera när en mindre modell kan hantera en fråga och sedan omformulera den eller dela upp den i delar så att en enklare och billigare modell kan besvara den. Allt detta är forskning i dag, med sikte på produkter som vi kommer att lansera från det här teamet.
När det gäller utvecklingsfas och storlek är datasidan en etablerad, medelstor internationell verksamhet, medan det amerikanska forskarteamet medvetet befinner sig i ett tidigt skede. Fem av oss arbetar nu på vårt kontor i San Mateo, och ytterligare en eller två personer ansluter under de kommande månaderna. Det är vår nuvarande status.
Hur omfattande testning skapar tillförlitliga resultat
Pedro delar med sig
Förberedelserna sköter sig numera till största delen själva. Men det är inte den verkliga vinsten. Den större förbättringen är kvaliteten: mötet är skarpare och mer fokuserat, och rätt saker når pålitligt fram till vd:n.
Många skyndar sig att automatisera varje uppgift och funktion med AI, men jag är försiktig. AI gör det trivialt att bygga en demo. Att bygga något tillförlitligt för daglig användning är något annat. När man använder de här verktygen på riktigt stöter man på gräns- och specialfall där automatiseringen nästan fungerar, men inte helt. Därför testar jag noggrant innan jag litar på något i ett verkligt arbetsflöde.
I år byggde jag AI-verktyg för vårt veckovisa möte med vd:n som klarade den ribban. Det skickar e-post till områdesansvariga för att samla in uppdateringar, sammanställer automatiskt svar, utkast till rapporter, sammanfattningar och dagordningen samt följer resultaten över tid.
Tidigare gjordes allt detta manuellt. Någon jagade personer efter uppdateringar, sammanfogade manuellt svar, skrev sammanfattningar och dagordningen samt följde upp resultaten från vecka till vecka. Det fungerade, men det gick långsamt, och dagordningen gled lätt över mot det som var färskast snarare än det som var viktigast.
Förberedelserna sköter sig numera till största delen själva. Men det är inte den verkliga vinsten. Den större förbättringen är kvaliteten: mötet är skarpare och mer fokuserat, och rätt saker når pålitligt fram till vd:n. Det handlar alltså mindre om sparad tid och mer om att rikta vd:ns uppmärksamhet mot de beslut som verkligen spelar roll.
Varför omdömet förblir mänskligt medan AI påskyndar kodningen
AI driver nu själva kodningen, nästan överallt. Mina forskare, ingenjörerna som produktionssätter vårt arbete och jag använder alla AI-baserade kodverktyg. Mänskligt omdöme, inte en specifik uppgiftskategori, avgör hur kod byggs, och den här standarden förändras beroende på insatsernas betydelse.
På forskningssidan är målet vanligtvis att få något att fungera, ofta genom att skapa ett GitHub-arkiv för att testa om en idé är genomförbar. Inget går till produktion, så jag är överseende med hur det är skrivet. Om det fungerar och besvarar frågan räcker det.
Produktion är annorlunda. Hur vi bygger något är lika viktigt som huruvida det fungerar, så vi använder AI mer varsamt. Seniora ingenjörer ansvarar för arkitekturen, kvaliteten och granskningarna. AI påskyndar deras arbete, men fattar inte de besluten. Den gränsen förblir mänsklig.
Teamets erfarenhetsnivå hjälper. De använder AI på ett annat sätt än mindre erfarna personer. De vet redan hur något bra ska se ut, så modellen förstärker deras befintliga omdöme i stället för att ersätta det omdöme som de fortfarande håller på att utveckla. Den gör dem snabbare utan att ersätta den väsentliga delen.
Så använder du kodningsagenter effektivt
Nästan varje projekt har en unik sak som det behöver: en icke uppenbar insikt eller ett beslut som problemet kräver … Den del som får ett projekt att fungera är vanligtvis inte genomsnittlig, och AI kan inte komma fram till den på egen hand. Den delen är min att hitta. Sedan bygger AI allt som följer av den snabbare och bättre än jag skulle kunna göra ensam.
Överlag kommer kodningsagenternas effektivitet av att jag disciplinerar mig när det gäller teknikens styrkor och svagheter.
Jag tänker på det som att måla en tavla. Målet är alltid detsamma: att tydliggöra bilden i mitt huvud och sedan använda AI för att översätta den avsikten till fungerande kod så snabbt som möjligt. Framgången beror på en variabel: hur mycket kreativt arbete jag behåller jämfört med hur mycket jag lämnar över.
AI glänser på den första nivån. Jag kan se hela målningen och lägga breda penseldrag, medan AI fyller i detaljerna. Jag vet exakt vad som behöver byggas, och att översätta avsikt till kod är i princip formelbaserat. Det är här AI verkligen förstärker min kapacitet, och större delen av mitt dagliga arbete hör hemma här.
Den andra nivån är användbar men har större variation. Den liknar den första, men jag lämnar medvetet några områden på duken öppna och ber modellen att måla något där. Det kräver viss kreativitet, men min vägledning sätter fortfarande ramarna. Jag betraktar resultatet som ett utkast, inte som ett svar.
Jag varnar människor för den tredje nivån. Den innebär att man överlämnar den kreativa kärnan till AI: projektdefinitionen eller de viktigaste designbesluten. Det ser imponerande ut för någon som inte är insatt i området, men det misslyckas mycket oftare än det lyckas eftersom modellen fyller en lucka som jag själv borde ha fyllt.
Det gapet är hela poängen. Nästan alla projekt har något unikt som de behöver: en icke uppenbar insikt eller ett beslut som problemet kräver. Som standard tillhandahåller modellen genomsnittslösningen, det vanligaste mönstret från sin träning. Det som får ett projekt att fungera är vanligtvis inte genomsnittligt, och AI kan inte komma fram till det på egen hand. Den delen är min att hitta. Sedan bygger AI allt som följer av den snabbare och bättre än jag kunde göra ensam.
Hur kodningsagenter skapar svårupptäckta buggar
Pedro delar med sig
Det tydligaste goda resultatet av kodningsagenter är snabbheten. Kodningen går snabbare, vilket ökar vår driftsättningsfrekvens, och det handlar inte bara om rå hastighet. Sådant som var komplicerat att konfigurera är mycket enklare nu. Den delen är verklig, och den spelar roll.
Det tydligaste goda resultatet av kodningsagenter är snabbheten. Kodningen går snabbare, vilket ökar vår driftsättningsfrekvens, och det handlar inte bara om rå hastighet. Sådant som var komplicerat att konfigurera är mycket enklare nu. Den delen är verklig, och den spelar roll.
Ett mer intressant resultat är hur våra buggar förändrades. Defektfrekvensen har inte ökat, men typerna av defekter har förändrats. AI ser till att koden körs. Den kontrollerar nästan alltid detta innan den lämnar tillbaka koden till dig. Därför dyker de enklaste buggarna — sådana som bara orsakar ett fel eller inte körs alls — upp mycket mer sällan. Det som återstår är logiska buggar, fall som modellen inte tänkte igenom, och dessa är svårare att upptäcka just eftersom koden körs utan problem.
Det är där nackdelen finns. Dessa buggar gömmer sig bättre. Om någon saknar erfarenhet eller förlitar sig för mycket på verktyget ser de koden köras och antar att den är korrekt, fast den inte är det. Faran är inte fler buggar, utan falskt självförtroende. Du behöver någon som vet vad man ska leta efter för att upptäcka sådant som klarar testet "det körs" men ändå är fel.
Varför AI bör användas för att skala upp erfarna personer i stället för att förbättra svaga personer
Det som överraskade mig mest var hävstångseffekten kommer ifrån. Intuitivt skulle man kunna tro att AI sänker erfarenhetströskeln, så att man kan bemanna billigare och mer juniora team och låta verktygen höja deras nivå. Motsatsen visade sig vara sann. Erfarenhet spelar större roll nu, inte mindre.
Det handlar om tillförlitlighet. Att använda AI för att förvandla en senior ingenjör till fem seniora ingenjörer är mycket mer tillförlitligt än att förvandla en junior ingenjör till en senior. AI multiplicerar det omdöme du redan har; den skapar inte omdöme som saknas.
Därför skalar jag ut mina starkaste personer; jag försöker inte skala upp mina svagaste. Några erfarna personer, som var och en arbetar med flera gånger sin tidigare output, slår alltid ett större blandat team.
Varför människor måste stå för kreativiteten — inte AI
AI har uppenbarligen inte lyckats leverera när det gäller forskningens kreativa och sammanlänkande aspekter. När jag utför tekniskt arbete med hjälp av AI behöver en människa fortfarande knyta ihop trådarna: förstå hur någon annans arbete kan vidareutvecklas, koppla samman två artiklar på ett meningsfullt sätt och göra de logiska språng som man annars tar för givna. Den delen kräver fortfarande en människa.
Det är inte förvånande när man minns vad dessa modeller är. De är sannolikhetsmaskiner. De producerar den text som med störst sannolikhet tilltalar läsaren. Vi blir bättre på att träna dem för andra typer av uppgifter, men det blir verkligen svårt när man försöker lära dem själva kreativiteten, eftersom det är svårt att bygga träningssignalen.
Tänk på datamängder. En datamängd för hur en hund ser ut är enkel. Du samlar in många bilder av hundar. En datamängd för kreativitet i att rita hundar innebär ett annat problem. Tänk till exempel på någon som lägger till vingar på en hund. Poängen med exemplet är inte vingarna. Det är den abstrakta handlingen bakom dem: att ta något som inte hör hemma där och placera det på en plats där det inte förväntas. För att få en modell att förstå det behöver du ett enormt antal exempel, så att den lär sig att vingarna inte spelar någon roll; det är den kreativa gesten som gör det.
Även om den kommer så långt stöter du på nästa hinder. Ta nu samma kreativitet och tillämpa den på en matematisk ekvation eller en koddel från en artikel, för att använda den till att vidareutveckla någon annans algoritm. Det är vid den typen av överföring som det faller samman.
Människor förlitar sig på maskiner för exakt den del där de är som svagast. Ironiskt nog är lösningen billig. En liten dos mänsklig kreativitet räcker långt. Förlita dig inte för mycket på maskinen för den delen, så kommer du anmärkningsvärt långt.
Varför CTO:er måste utforma om hur AI-förmågor rör sig genom organisationer
Det här kommer inte att vara det populäraste rådet just nu, men jag tycker att det är det klokaste och det som troligast kommer att löna sig: Var mer eftertänksam än stunden får dig att vara.
Just nu spenderar företag enorma summor pengar utifrån ett enkelt antagande: alla kan automatisera en del av sitt arbete med AI. Därför går direktivet ut till alla. Ingenjörer, datapersonal, säljare, marknadsförare, hela företaget. Skaffa ett konto, automatisera något, bygg dina egna verktyg, kör. Resultatet blir en enorm mängd bortkastade insatser: duplicerat arbete, projekt som inte leder någonstans och verktyg som ingen använder. Företag bränner mycket pengar på insatser, tid och tokens som inte leder till något bestående.
Skapa en riktig process kring det. Centralisera den. Ha ett litet centralt team vars uppgift är att göra alla andra team bättre med AI. De utvecklar arbetsflöden, återanvändbart sammanhang, standarder och effektiva arbetssätt och sprider sedan ut dem, så att enskilda ingenjörer inte var och en behöver betala kostnaden för att upptäcka dem. Det här är den strukturella versionen av det jag sa tidigare om att koncentrera hävstångseffekten hos era starkaste medarbetare: några få AI-kunniga ingenjörer som lyfter hela organisationen.
Detta ger två resultat samtidigt. Utnyttjandegraden ökar eftersom teamen använder beprövade arbetssätt i stället för att gissa. Och ni återvinner en stor mängd tid som i tysthet går förlorad på experimenterande som aldrig behövde göras mer än en gång.
Det här kommer inte att vara det populäraste rådet just nu, men jag tycker att det är det klokaste och det som troligast kommer att löna sig: Var mer eftertänksam än stunden får dig att vara…Skapa en riktig process kring det. Centralisera den. Ha ett litet centralt team vars uppgift är att göra alla andra team bättre med AI.
Följ med
Du kan följa Pedro Alves arbete på LinkedIn eller prenumerera på hans nyhetsbrev, Förra veckan inom AI. Och ta en titt på Thoth AI.
Fler expertintervjuer kommer på The CTO Club!