

Verktyg för spårning av ML-experiment hjälper dig att logga, organisera och jämföra maskininlärningsexperiment så att du kan hantera resultat och återskapa upptäckter med tillförsikt. Om du letar efter praktiska sätt att spåra experiment, dela framsteg med teamet eller hålla dina modeller och datamängder organiserade kan rätt verktyg göra stor skillnad.
I den här listan hittar du lösningar anpassade för olika tekniska stackar och arbetsflöden, som hjälper dig att minska friktion, förenkla rapporteringen och fokusera på tillförlitlig hantering av ML-experiment.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell över verktyg för spårning av ML-experiment
Den här jämförelsetabellen sammanfattar prisuppgifter för mina främsta val av verktyg för spårning av ML-experiment:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för jämförelse av experiment i realtid | Gratisabonnemang tillgängligt | Från $19/användare/månad | Website | |
| 2 | Bäst för anpassningsbara visualiseringsinstrumentpaneler | Gratisplan tillgänglig | Från $60/månad | Website | |
| 3 | Bäst för automatisk versionshantering av arbetsflöden | 14 dagars kostnadsfri provperiod tillgänglig | Pris på begäran | Website | |
| 4 | Bäst för automatisk pipelineorkestrering | Gratisabonnemang tillgängligt | Från $15/användare/månad | Website | |
| 5 | Bäst för stöd för modellens livscykel med öppen källkod | Gratis demo tillgänglig | Pris på begäran | Website | |
| 6 | Bäst för integration med djupinlärningsramverk | Gratis plan för alltid tillgänglig | Gratis för alltid (öppen källkod) | Website | |
| 7 | Bäst för Kubernetes-baserad arbetsflödeshantering | Gratisplan tillgänglig | Gratis och öppen källkod | Website | |
| 8 | Bäst för integration med AWS-molnekosystemet | Gratisplan tillgänglig | Från $0.04/kredit | Website | |
| 9 | Bäst för insticksarkitektur för utbyggbarhet | Gratisplan tillgänglig | Från $399/månad | Website | |
| 10 | Bäst för hybrid- och lokala distributionsalternativ | Gratisplan + kostnadsfri demonstration tillgänglig | Från $450/månad (faktureras årsvis) | Website |


Recensioner av de bästa verktygen för spårning av ML-experiment
Nedan följer mina detaljerade sammanfattningar av de bästa verktygen för spårning av ML-experiment som kom med på min kortlista. Mina recensioner ger en detaljerad inblick i funktionerna, integrationerna och de bästa användningsområdena för varje plattform, så att du kan hitta den bästa för dig.
 Bäst för jämförelse av experiment i realtid
- Gratisabonnemang tillgängligt
- Från $19/användare/månad
Visit WebsiteCustomer Rating:4.4/5
Spårar ML-experiment, modellprestanda och LLM-utvärdering. Comet är en plattform för spårning av ML-experiment och modellutvärdering som loggar mätvärden, hyperparametrar och artefakter från träningskörningar och utökas till LLM-observerbarhet och utvärdering av agentbaserad AI genom sin produkt Opik.
Vem passar Comet bäst för?
Comet passar bra för ML- och AI-team på företag i tillväxtfas eller större företag som genomför stora mängder experiment och behöver direkt insyn i träningskörningar.
Varför jag valde Comet
Jag valde Comet som ett av de bästa alternativen eftersom dess instrumentpanel för direkt spårning av experiment uppdaterar mätvärden medan träningskörningar pågår, så att mitt team kan upptäcka en avvikande förlustkurva och avbryta en misslyckad körning innan den slösar beräkningsresurser. Jag använder också vyn för jämförelse av experiment sida vid sida för att filtrera dussintals körningar efter hyperparametervärde och omedelbart fastställa vilken konfiguration som gav bäst valideringsnoggrannhet. Utöver klassisk MLOps utökar Comet nu sin funktionalitet till LLM-utvärdering genom Opik, vilket innebär att jag inte behöver byta verktyg när jag går från modellträning till övervakning av produktionsagenter.
Comets viktigaste funktioner
- Modellregister: Lagra, versionshantera och hantera tränade modeller i ett centraliserat register med stegmarkeringar som mellanlagring och produktion.
- Artefaktloggning: Logga och versionshantera datamängder, bilder, förväxlingsmatriser och ljudfiler direkt tillsammans med experimentkörningar.
- Anpassade paneler: Skapa anpassade visualiseringar i Comets användargränssnitt med JavaScript för att gå längre än standarddiagrammen för mätvärden.
- Spårning av systemmätvärden: Fångar automatiskt GPU-användning, CPU-belastning och minnesanvändning för varje körning utan ytterligare instrumentering.
Comets integrationer
Comet erbjuder fler än 30 inbyggda integrationer, däribland PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, Ray, Kubeflow, Snowflake och Vertex AI. Tjänsten finns tillgänglig på Zapier och erbjuder ett REST API samt SDK:er för Python, Java, JavaScript och R för anpassade integrationer.
Pros and Cons
Pros:
- Automatisk loggning av mätvärden med minimal kod
- Visualisering av träningskörningar i realtid
- Spårar både ML-experiment och LLM:er
Cons:
- Pro-abonnemanget begränsar team till 10 användare
- Möjligheterna att anpassa användargränssnittet är begränsade
Learn more about Comet: Bäst för anpassningsbara visualiseringsinstrumentpaneler
- Gratisplan tillgänglig
- Från $60/månad

Weights & Biases spårar ML-experiment och mätvärden samt jämför modellkörningar. Weights & Biases är en plattform för spårning av ML-experiment som loggar mätvärden, hyperparametrar och modellkontrollpunkter och låter dig visualisera och jämföra körningar via interaktiva instrumentpaneler.
Vem passar Weights & Biases bäst för?
Weights & Biases passar bra för dataforskare och ML-ingenjörer som genomför frekventa experiment och behöver detaljerade jämförelser av körningar i stora team.
Varför jag valde Weights & Biases
Weights & Biases är ett av mina främsta val eftersom jag uppskattar hur långt plattformen går med anpassningsbara visualiseringsinstrumentpaneler. Jag kan hämta aktuell GPU-användning, förlustkurvor och exempelprognoser till en enda interaktiv instrumentpanel under en träningskörning, vilket gör det snabbt att upptäcka flaskhalsar. Funktionen Sweeps låter mig visualisera resultaten från hyperparametersökningar direkt bredvid mina experimentmätvärden, så att jag jämför allt i en och samma vy. Med Reports kan mitt team dessutom kommentera och dela dessa instrumentpaneler utan att lämna plattformen.
Viktiga funktioner i Weights & Biases
- Artefakter: Versionshantera och spåra datauppsättningar, modeller och utvärderingsresultat mellan experimentkörningar.
- Modellregister: Samla tränade modeller centralt och länka dem direkt till experimenten som skapade dem.
- Gruppering av körningar: Organisera relaterade körningar i grupper för att jämföra resultat mellan olika träningskonfigurationer.
- Aviseringar: Ställ in automatiska aviseringar för tröskelvärden för mätvärden, misslyckade körningar eller händelser när jobb slutförs.
Integreringar med Weights & Biases
Weights & Biases erbjuder inbyggda integreringar med PyTorch, Keras, TensorFlow, Scikit-learn, XGBoost, Hugging Face Transformers och PyTorch Lightning, samt LLM-verktyg som LangChain och LlamaIndex. Plattformen integreras även med Kubeflow, Jenkins, Airflow, GitHub Actions, AWS SageMaker och Google Vertex AI. Ett API och ett Python-SDK finns tillgängliga för anpassade integreringar.
Pros and Cons
Pros:
- Strömning av mätvärden i realtid till aktuella instrumentpaneler
- Automatisk loggning av git-commit och konfiguration
- Omfattande samarbetsrapporter med inbäddade diagram
Cons:
- Webbgränssnittet blir långsammare vid många parallella körningar
- Bristfällig dokumentation kring grundläggande funktioner
Learn more about Weights & Biases: Bäst för automatisk versionshantering av arbetsflöden
- 14 dagars kostnadsfri provperiod tillgänglig
- Pris på begäran

Valohai erbjuder en ML-plattform för experimentspårning och modellträning. Valohai är en ML-plattform som kombinerar automatisk experimentspårning, versionshantering av datamängder, modellhärkomst och orkestrering av molnberäkningar för team som bygger och tränar modeller i stor skala.
Vilka passar Valohai bäst för?
Valohai passar bra för ML-teknikteam på medelstora till stora företag som kör frekventa träningsjobb i flera molnmiljöer.
Varför jag valde Valohai
Jag valde Valohai som en av de bästa eftersom automatisk versionshantering verkligen är inbyggd i varje körning. Mätvärden, metadata, loggar och hyperparametrar versionshanteras utan någon manuell taggning, så jag behöver aldrig rekonstruera vad som kördes och när. Jag gillar också att Valohai spårar fullständig härkomst för datamängder och modeller, vilket innebär att jag exakt kan spåra vilken version av en datamängd som producerade en viss modell. Varje körning är reproducerbar redan från början, vilket eliminerar gissningarna som försvårar granskningar av experiment.
Viktiga funktioner i Valohai
- Jämförelsevy för experiment: Visar flera körningar sida vid sida, så att du kan jämföra hyperparametrar, mätvärden och utdata från experiment i en enda tabell.
- Arbetsflödesbyggare: En visuell redigerare för att skapa ML-arbetsflöden i flera steg, där varje nod motsvarar ett versionshanterat körningssteg.
- Orkestrering av molnberäkningar: Etablerar och avslutar automatiskt molninstanser i AWS, GCP eller Azure för varje träningskörning.
- Utlösare för driftsättning: Befordrar tränade modeller direkt till en serveringsslutpunkt från samma plattform som används för träningen.
Integrationer med Valohai
Valohai erbjuder ett mindre antal förbyggda integrationer via sitt ekosystembibliotek, inklusive anslutningar till Snowflake, BigQuery och Redshift, en Hugging Face-mall samt integrationer med Slurm och OVHcloud. Det körs på AWS, GCP, Azure och Oracle Cloud Infrastructure och tillhandahåller ett REST API för att bygga anpassade integrationer.
Pros and Cons
Pros:
- Loggar automatiskt mätvärden från utskriven JSON
- Körs i valfritt moln eller på lokal hårdvara
- Fullständig härkomstspårning från modell till datamängd
Cons:
- Det kräver arbete att anpassa skript till Valohai-formatet
- Den huvudsakliga experimentvyn känns visuellt ganska intetsägande
Learn more about Valohai: Bäst för automatisk pipelineorkestrering
- Gratisabonnemang tillgängligt
- Från $15/användare/månad

MLOps-plattform med öppen källkod för ML-spårning, pipelines och modellhantering. ClearML är en MLOps-plattform med öppen källkod som omfattar experimentspårning, versionshantering av dataset, modellhantering och pipelineorkestrering under hela maskininlärningens livscykel.
Vem passar ClearML bäst för?
ClearML passar bra för ML-ingenjörer och datavetare på organisationer som själva driftar sin MLOps-infrastruktur och behöver full kontroll över sina pipelines.
Varför jag valde ClearML
ClearML tar plats på min kortlista eftersom den automatiska pipelineorkestreringen verkligen kräver minimalt manuellt arbete. När jag lägger till ett jobb i en kö paketerar ClearML det i en container tillsammans med hela dess miljö och hanterar all schemaläggning och resurshantering automatiskt. Jag behöver inte skriva om kod för att växla mellan lokala miljöer, molnet eller HPC-kluster. Jag uppskattar också att cachade pipelinekomponenter låter mig hoppa över redundanta steg vid nya körningar, vilket minskar cykeltiden avsevärt i iterativa träningsarbetsflöden.
Viktiga funktioner i ClearML
- Automatisk loggning av experiment: Samlar automatiskt in mätvärden, hyperparametrar, konsolutdata och källkod från varje träningskörning utan extra instrumentering.
- Versionshantering av ClearML Data: Versionshantera och hantera dataset med full spårning av härkomst, där varje datasetversion länkas direkt till de experiment som använde den.
- Modellregister: Lagra, märk och hämta tränade modeller med versionskontroll och stadieetiketter under hela utvecklingslivscykeln.
- Optimering av hyperparametrar: Kör automatiserade HPO-sökningar över experiment med inbyggda sökstrategier som bayesiansk optimering och slumpmässig sökning.
Integrationer i ClearML
ClearML erbjuder inbyggda integrationer med PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, FastAI, Optuna och Hydra, samt visualiseringsverktyg som Matplotlib och TensorBoard. Ett API och ett Python-SDK finns tillgängliga för anpassade integrationer.
Pros and Cons
Pros:
- Servern med öppen källkod kan driftas själv och eliminerar prenumerationskostnader
- Loggar automatiskt kod, dataset och hyperparametrar utan instrumentering
- Modulär design gör att du kan använda enskilda komponenter
Cons:
- Bristande dokumentation gör introduktionen långsammare för nya användare
- Navigeringen mellan moduler känns splittrad i stor skala
Learn more about ClearML: Bäst för stöd för modellens livscykel med öppen källkod
- Gratis demo tillgänglig
- Pris på begäran

MLflow spårar ML-experiment, modellversioner och driftsättning. MLflow är en plattform med öppen källkod för spårning av ML-experiment som täcker hela modellens livscykel, från experimentloggning och jämförelse av körningar till paketering, versionshantering och driftsättning av modeller.
Vem passar MLflow bäst för?
MLflow passar naturligt för ML-ingenjörer och dataforskare på organisationer som själva driftar sina verktyg och vill ha full kontroll över sin infrastruktur för experimentspårning utan leverantörsinlåsning.
Varför jag valde MLflow
MLflow tar plats på min kortlista eftersom det täcker hela modellens livscykel i ett enda ramverk med öppen källkod. Jag använder MLflow Tracking API för att logga parametrar, mätvärden och artefakter för olika körningar, och därefter Model Registry för att versionshantera och överföra modeller från utveckling till produktion. Det jag verkligen uppskattar är att jag kan paketera modeller med MLflows standardformat och distribuera dem till valfritt mål utan att skriva om koden för modellservering.
Viktiga MLflow-funktioner
- Automatisk loggning: Fångar automatiskt parametrar, mätvärden och artefakter från bibliotek som stöds, till exempel Scikit-learn, XGBoost och PyTorch, utan manuella loggningsanrop.
- Gränssnitt för jämförelse av körningar: Visualiserar och jämför mätvärden från flera träningskörningar sida vid sida i MLflows inbyggda webbgränssnitt.
- MLflow Projects: Paketerar ML-kod med dess beroenden och startpunkter så att alla körningar kan återskapas exakt på vilken dator som helst.
- Tilläggssystem: Utökar MLflows funktioner för spårning, lagring och driftsättning genom tillägg som byggts av communityn, utan att kärnkoden behöver ändras.
MLflow-integreringar
MLflow erbjuder över 60 inbyggda integreringar, bland annat med PyTorch, TensorFlow, Scikit-learn, XGBoost, LightGBM, Hugging Face Transformers, LangChain, LlamaIndex och OpenAI. Det har även stöd för AWS SageMaker, Azure ML, Databricks och OpenTelemetry. Ett REST API och ett Python-SDK finns tillgängliga för anpassade integreringar.
Pros and Cons
Pros:
- Ramverksoberoende loggning i olika ML-bibliotek
- Fullständig versionshantering av modeller med övergångar mellan stadier
- Kan driftas på valfri infrastruktur
Cons:
- Kräver DevOps-arbete för produktionskonfiguration
- Begränsad inbyggd visualisering av maskinvaruprofiler
Learn more about MLflow: Bäst för integration med djupinlärningsramverk
- Gratis plan för alltid tillgänglig
- Gratis för alltid (öppen källkod)
TensorFlow (Googles ramverk med öppen källkod) erbjuder utveckling av AI-modeller. TensorFlow är ett ramverk för maskininlärning med öppen källkod från Google som omfattar modelldesign, träning, utvärdering och driftsättning inom arbetsflöden för djupinlärning och neurala nätverk.
Vem passar TensorFlow bäst för?
TensorFlow passar naturligt för forskarteam och ML-ingenjörer som bygger och tränar djupinlärningsmodeller i stor skala, särskilt i produktionsmiljöer.
Varför jag valde TensorFlow
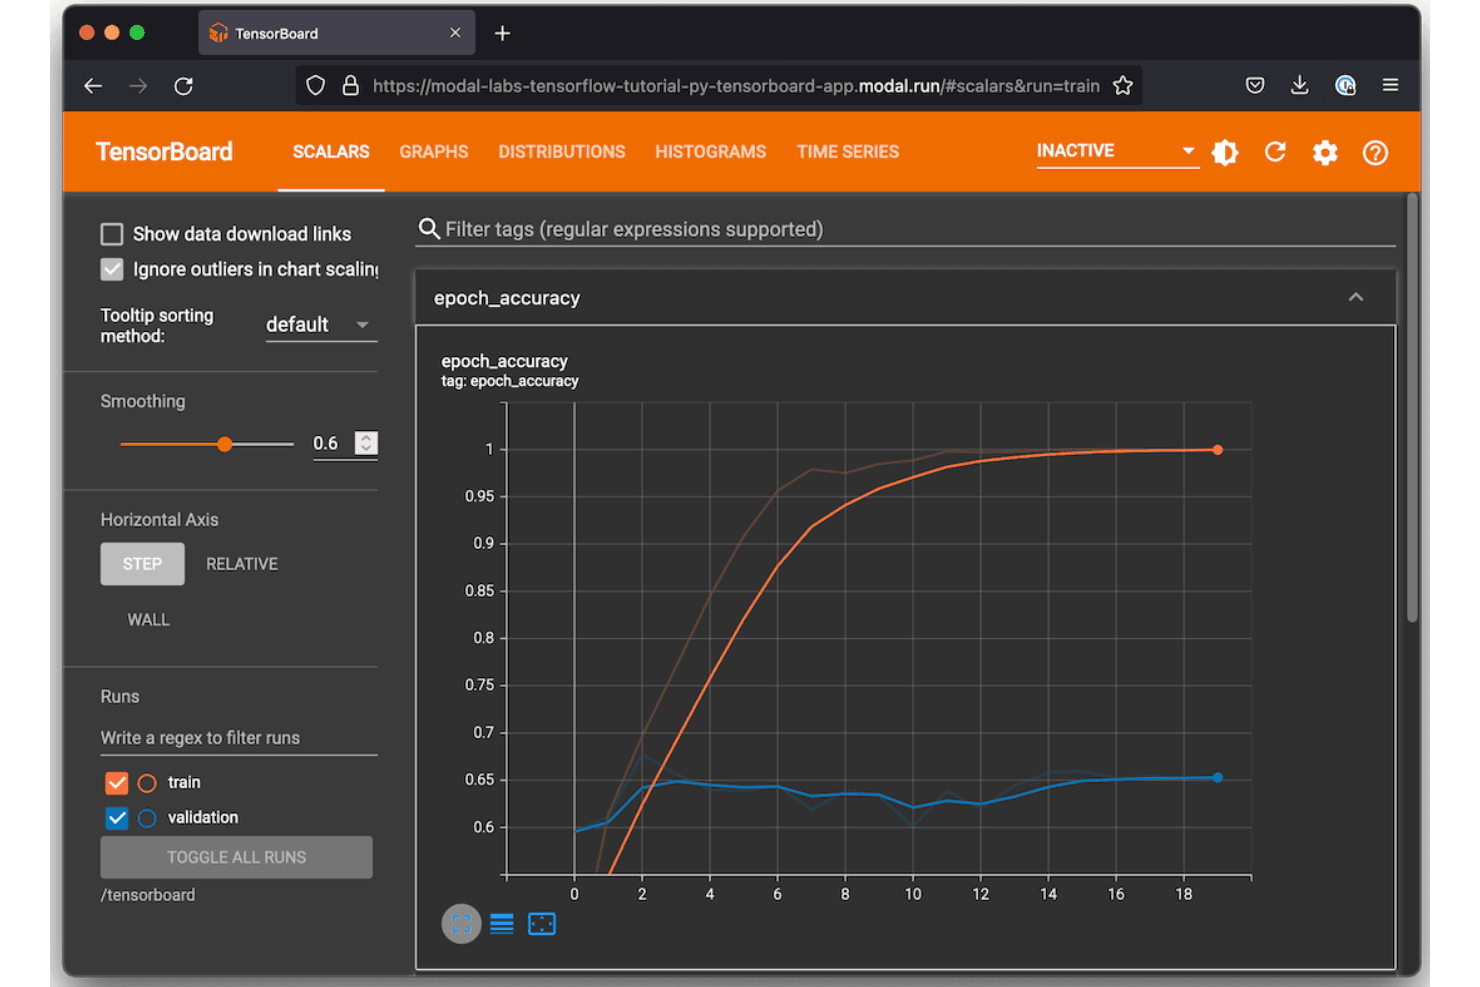
Jag har inkluderat TensorFlow bland mina främsta val eftersom det inbyggda Keras-API:et låter mig bygga och iterera på djupinlärningsarkitekturer utan att byta kontext eller ramverk. Jag använder också TensorBoard direkt i TensorFlow för att följa träningsmått, visualisera beräkningsgrafer och jämföra körningar sida vid sida. TensorFlow Hub ger mig tillgång till förtränade modeller som jag kan finjustera, vilket avsevärt minskar träningstiden för experiment med transferinlärning.
Viktiga TensorFlow-funktioner
- TensorFlow Extended (TFX): Ett produktionsramverk för ML-pipelines som samordnar stegen för datavalidering, transformering, träning och modelutvärdering.
- tf.data API: Skapar skalbara indatapipelines för att läsa in, förbehandla och skapa batchar av datamängder under modellträningskörningar.
- TensorFlow Serving: Driftsätter tränade modeller i produktion via REST- eller gRPC-slutpunkter utan att modellkoden behöver ändras.
- SavedModel-format: Serialiserar tränade modeller med fullständiga beräkningsgrafer och vikter för reproducerbar omladdning och delning.
TensorFlow-integrationer
TensorFlow är ett ramverk med öppen källkod snarare än en SaaS-plattform, så det erbjuder inte traditionella inbyggda integrationer med verktyg från tredje part. I stället innehåller ekosystemet inbyggda bibliotek som TensorBoard, TFX, TensorFlow.js, TensorFlow Serving, Keras och ML Metadata, vilka hanterar experimentuppföljning, pipelineorkestrering och modelldriftsättning inom själva ramverket. Verktyg från tredje part för experimentuppföljning, som MLflow och Weights & Biases, har egna integrationer med TensorFlow, och ett Python-API finns tillgängligt för anpassade utbyggnader.
Pros and Cons
Pros:
- Visualisering av träningsmått och grafer i realtid
- Inbyggda verktyg för hyperparameterjustering och optimering
- Driftsättning på CPU:er, GPU:er och TPU:er
Cons:
- TensorBoard blir långsammare vid många experiment
- Lagrar data lokalt utan inbyggda samarbetsfunktioner
Learn more about TensorFlow: Bäst för Kubernetes-baserad arbetsflödeshantering
- Gratisplan tillgänglig
- Gratis och öppen källkod

Kubeflow erbjuder en ML-plattform med öppen källkod för Kubernetes-arbetsflöden. Kubeflow är en ML-plattform med öppen källkod byggd på Kubernetes som har inbyggt stöd för pipelineorkestrering, experimentspårning, modellträning och hyperparameterjustering inom containeriserad infrastruktur.
Vem passar Kubeflow bäst för?
Kubeflow passar naturligt för ML-teknikteam som redan kör arbetsbelastningar på Kubernetes och vill behålla sin infrastruktur för experimentspårning på samma plattform.
Varför jag valde Kubeflow
Kubeflow tar plats på min kortlista eftersom varje pipelinesteg kopplas direkt till en Kubernetes-pod, vilket ger experimentkörningar samma resurskontroller som alla andra klusterarbetsbelastningar. Jag använder Kubeflow Pipelines för att versionshantera och spela upp träningskörningar utan att lämna Kubernetes-miljön. Komponenten Katib kör parallella hyperparametertester som inbyggda Kubernetes-jobb, utan krav på separat infrastruktur.
Viktiga funktioner i Kubeflow
- Isolering av namnrymder för flera användare: Separera experiment och pipelines efter team eller projekt med hjälp av åtkomstkontroller på Kubernetes-namnområdesnivå.
- Kubeflow Notebooks: Startar Jupyter-anteckningsboksservrar direkt i klustret, vilket håller datautforskningen i samma miljö som träningskörningarna.
- Spårning av artefaktslinjering: Registrerar indata, utdata och metadata för varje pipelinesteg och kopplar dataset och modeller tillbaka till specifika körningar.
- Träningsoperator: Hanterar distribuerade träningsjobb för ramverk som PyTorch, TensorFlow och XGBoost som inbyggda anpassade Kubernetes-resurser.
Kubeflow-integrationer
Kubeflow erbjuder inte traditionella inbyggda integrationer utan fungerar i stället inom Kubernetes-ekosystemet och stöder ML-ramverk som TensorFlow, PyTorch, JAX, XGBoost, HuggingFace och Apache Spark genom operatorerna i sina delprojekt. Du kan också distribuera det på hanterade Kubernetes-tjänster från AWS, Google Cloud, Microsoft Azure och Red Hat OpenShift.
Pros and Cons
Pros:
- Kör experiment direkt på Kubernetes-poddar
- Versionshantering av pipelines spårar varje träningskörning
- Parallell hyperparameterjustering via Katib-komponenten
Cons:
- Klusterkonfigurationen kräver djupa Kubernetes-kunskaper
- Användargränssnittet känns föråldrat jämfört med kommersiella alternativ
Learn more about Kubeflow: Bäst för integration med AWS-molnekosystemet
- Gratisplan tillgänglig
- Från $0.04/kredit

Amazon SageMaker hanterar ML-träning, justering och driftsättning. Amazon SageMaker är en fullständigt hanterad ML-plattform på AWS som omfattar experimentspårning, modellträning, hyperparameterjustering, modellregister och driftsättning under hela maskininlärningens livscykel.
Vem passar Amazon SageMaker bäst för?
Amazon SageMaker passar naturligt för datavetenskaps- och ML-teknikteam som redan kör arbetsbelastningar på AWS-infrastruktur.
Varför jag valde Amazon SageMaker
Jag har tagit med Amazon SageMaker bland mina främsta val eftersom experimentspårningen är direkt integrerad i AWS-ekosystemet på sätt som andra verktyg inte kan återskapa. SageMaker Experiments loggar körningar, parametrar och mätvärden inbyggt tillsammans med lagring av artefakter i S3 och åtkomst som styrs av IAM, så det finns ingen separat infrastruktur att hantera. Mitt team använder också SageMaker Pipelines för att koppla samman träningsjobb, utvärderingar och modellregistrering i ett enda granskningsbart arbetsflöde utan att lämna AWS.
Viktiga funktioner i Amazon SageMaker
- SageMaker-modellregister: Versionshantera, godkänn och förbered tränade modeller med metadataspårning under hela modellens livscykel.
- Automatisk modelljustering: Kör jobb för hyperparameteroptimering med bayesianska strategier, slumpmässig sökning eller rutnätsökning i stor skala.
- SageMaker Debugger: Övervaka träningsjobb i realtid för att upptäcka problem som försvinnande gradienter eller överanpassning när de uppstår.
- SageMaker Feature Store: Lagra, dela och hämta ML-funktioner för tränings- och inferensarbetsbelastningar från ett centraliserat arkiv.
Integrationer med Amazon SageMaker
Amazon SageMaker integreras inbyggt i AWS-ekosystemet, bland annat med Amazon S3, Amazon Redshift, AWS Glue, Amazon EMR, Amazon Athena, Amazon ECR, AWS Lambda, Amazon CloudWatch och MLflow. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Spårar parametrar, data- och kodversioner per körning
- Automatisk kontrollpunktsskapning under långa träningsjobb
- Inbyggd modellövervakning tillsammans med experimentloggar
Cons:
- Oanvända resurser kan obemärkt leda till löpande debiteringar
- Modellartefakter använder AWS-specifika format, vilket begränsar portabiliteten
Learn more about Amazon SageMaker: Bäst för insticksarkitektur för utbyggbarhet
- Gratisplan tillgänglig
- Från $399/månad

Orkestrering av ML-pipelines med öppen källkod, spårning och modellhärkomst. ZenML är en ML-pipelineorkestreringsplattform med öppen källkod som hanterar arbetsflödesorkestrering, artefaktversionshantering, modellhärkomst och experimentspårning i valfri molninfrastruktur eller ML-stack.
Vem passar ZenML bäst för?
ZenML passar bra för ML-ingenjörer och datavetenskapsteam som behöver standardisera och skala ML-pipelines över flera molnmiljöer eller infrastruktursstackar.
Varför jag valde ZenML
ZenML tar plats på min kortlista eftersom arkitekturen med stackkomponenter låter mig byta ut valfri del av min ML-infrastruktur utan att skriva om pipelinekoden. Jag kan ansluta MLflow eller Weights & Biases som experimentspårare, byta artefaktlagringen från lokal lagring till S3 och ändra orkestreraren till Kubeflow, allt genom att ändra den aktiva stacken. Jag använder också ZenML:s anpassade komponentvarianter för att bygga egna spårningsintegrationer som passar direkt in i samma pipelineabstraktion.
Viktiga funktioner i ZenML
- Cachning av pipelinesteg: Cachar automatiskt utdata från tidigare körda steg, så att oförändrade steg inte körs igen under iterativa experiment.
- Artefaktversionshantering: Spårar varje artefakt som produceras av en pipelinekörning, inklusive dataset, modeller och mätvärden, med full härkomst tillbaka till det ursprungliga steget.
- Modellregister: Lagrar och versionshanterar tränade modeller tillsammans med tillhörande metadata, pipelinekörningar och distributionshistorik i ett centralt register.
- ZenML-instrumentpanel: Tillhandahåller ett webbaserat gränssnitt för att bläddra bland pipelinekörningar, jämföra experimentresultat och granska artefaktmetadata över olika stackar.
ZenML-integrationer
ZenML erbjuder 66 inbyggda integrationer i hela ML-ekosystemet, inklusive MLflow, Weights & Biases, Neptune, Comet och TensorBoard, samt orkestrerare som Kubeflow, Apache Airflow, Kubernetes och Databricks, och molninfrastruktur för AWS, Google Cloud och Microsoft Azure. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Byt infrastruktur utan att skriva om pipelinekoden
- Molnoberoende stack förhindrar leverantörsberoende
- Automatisk artefaktversionshantering över pipelinekörningar
Cons:
- Förlitar sig på verktyg från tredje part för experimentvisualisering
- Den initiala stackkonfigurationen kräver omfattande installationsarbete
Learn more about ZenML: 10Bäst för hybrid- och lokala distributionsalternativ
Polyaxon
- Gratisplan + kostnadsfri demonstration tillgänglig
- Från $450/månad (faktureras årsvis)

Polyaxon spårar ML-experiment, arbetsflöden och modeller i olika molnmiljöer. Polyaxon är en plattform för spårning av ML-experiment och arbetsflödesorkestrering som omfattar experimentspårning, optimering av hyperparametrar, versionshantering av artefakter, modellregister och schemaläggning av distribuerade jobb i moln- och lokala infrastrukturer.
Vem passar Polyaxon bäst för?
Polyaxon passar bra för ML-ingenjörer på större företag som arbetar under strikta krav på datastyrning eller behöver köra arbetsbelastningar på privat infrastruktur.
Varför jag valde Polyaxon
Jag har inkluderat Polyaxon bland mina främsta val eftersom det är en av få plattformar för spårning av ML-experiment som från grunden har byggts för att köras helt inom den egna infrastrukturen. Jag kör det på ett privat Kubernetes-kluster, och alla experimentloggar, artefakter och modeller stannar inom vårt nätverk. Den agentbaserade arkitekturen låter mig ansluta isolerade lokala miljöer till ett centralt kontrollplan utan att exponera rådata externt, vilket är ett verkligt krav i reglerade branscher.
Viktiga funktioner i Polyaxon
- Sökning och optimering av hyperparametrar: Kör grupper av experiment parallellt med distribuerade sökstrategier för att hitta optimala modellkonfigurationer.
- Komponenthubb: Definiera återanvändbara moduler med typade indata och utdata som kan delas och versionshanteras i hela teamets arbetsflöden.
- Kraftfull sökning: Filtrera körningar efter namn, beskrivning, reguljära uttryck, specifika fält, mätvärden eller konfigurationer för att snabbt hitta experiment.
- Upprätthållande av SLA: Tillämpa TTL-, tidsgräns- och återförsökspolicyer på enskilda åtgärder för att hålla arbetsflöden inom definierade gränser.
Polyaxon-integreringar
Polyaxon erbjuder ett brett urval av inbyggda integreringar för ML-spårning, orkestrering och infrastruktur, bland annat TensorBoard, PyTorch, TensorFlow, Keras, XGBoost, Hugging Face, Kubeflow, Slack, GitHub och Jenkins. Det kan även anslutas till Zapier och tillhandahåller ett API för anpassade integreringar och CI/CD-automatisering.
Pros and Cons
Pros:
- Kubernetes-nativ schemaläggning av distribuerade träningsjobb
- Inbyggd flerklientfunktion med detaljerade åtkomstkontroller
- Stöd för lokala installationer, moln- och hybriddistributioner
Cons:
- Kräver djupa Kubernetes-kunskaper för drift
- Mindre användargemenskap än MLflow eller W&B
Learn more about Polyaxon:
Andra verktyg för spårning av ML-experiment
Här är några ytterligare verktyg för spårning av ML-experiment som inte kom med på min kortlista, men som ändå är värda att undersöka:
- 11DatabricksBäst för en enhetlig analysarbetsyta för team
- 12Domino Data LabBäst för central styrning inom kollaborativ forskning
- 13iguazioBäst för realtidsövervakning av modeller i stor skala
- 14DagsterBäst för att skapa datapipelines programmatiskt
Så utvärderar jag verktyg för spårning av ML-experiment
Jag delar upp min utvärdering i två lager: vad varje verktyg måste kunna göra (till exempel automatisk loggning av PyTorch-körningar) och vad som skiljer de bästa verktygen från resten.
Grundläggande funktioner (minimikrav för den här listan)
När jag väljer verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärkt inom området) för varje grundläggande funktion som anges nedan. Därefter beräknar jag verktygets totala poäng som en procentsats. Varje verktyg måste uppnå en minsta totalpoäng på 65 % för att övervägas för inkludering.
- Experimentloggning: Jag kontrollerar om verktyget automatiskt samlar in mätvärden, hyperparametrar och telemetri på systemnivå från träningskörningar eller om det kräver manuell SDK-instrumentering för varje datapunkt.
- Körningsjämförelse och visualisering: Tabeller med körningar sida vid sida är en utgångspunkt, men jag letar efter interaktiva diagram, till exempel parallella koordinatdiagram, som hjälper till att upptäcka mönster mellan dussintals körningar i dina ML-projekt.
- Versionshantering av artefakter och modeller: Jag utvärderar hur varje verktyg versionshanterar datauppsättningar, modellkontrollpunkter och utdata, inklusive om det länkar artefakter tillbaka till den exakta körning som skapade dem.
- Stöd för ML-ramverk: Verktyget bör stödja de ramverk som teamet faktiskt använder, från PyTorch och TensorFlow till Hugging Face Transformers och XGBoost, med så lite omslutande kod som möjligt.
- Reproducerbarhet och härledning: Jag letar efter verktyg som samlar in kodändringar, ögonblicksbilder av beroenden och datauppsättningens tillstånd tillsammans, så att du kan köra om ett experiment från för sex månader sedan och få samma resultat.
- Samarbete och delning: Team som arbetar över flera tidszoner behöver delade arbetsytor, rollbaserad åtkomst och möjlighet att kommentera eller dela specifika körningar utan att exportera CSV-filer fram och tillbaka.
När jag har en lista över verktyg som uppfyller dessa kriterier undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer och skiljer dem åt:
Utmärkande funktioner
Optimering av hyperparametrar är en viktig särskiljande faktor. Jag letar efter inbyggd funktionalitet för svepningar som automatiserar sökningar över distribuerade körningar och visualiserar prestanda för olika konfigurationer i en och samma vy. Övervakning av resurser i realtid tillför också stort värde – när du kan följa GPU- och minnesanvändningen under träningen upptäcker du flaskhalsar innan en körning slösar bort timmar av beräkningskapacitet. Samarbetsbaserad rapportering kompletterar helheten för större team, där delbara instrumentpaneler ersätter manuella kalkylblad och gör det möjligt för dataforskare att diskutera resultat med intressenter utan att byta verktyg.
Bortom funktionerna
Flexibilitet vid driftsättning är viktigare än vad många team förväntar sig. Jag utvärderar om ett verktyg stöder självhostade eller isolerade installationer för team som arbetar med känslig immateriell egendom eller reglerade data. Skalbarhet är en annan faktor jag granskar – loggning av tusentals samtidiga körningar bör inte försämra frågeprestandan eller skapa oförutsägbara kostnadstoppar. Även introduktionsupplevelsen skiljer verktyg åt, eftersom tydlig dokumentation för snabbstart och aktiva communityforum innebär att teamet instrumenterar träningsskript på timmar, inte veckor.
Så väljer du verktyg för spårning av ML-experiment
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval följer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| FaktorSkalbarhet | Vad du bör tänka påKan verktyget hantera den volym och frekvens av experiment som du förväntar dig när teamet och datamängden växer? |
| FaktorIntegrationer | Vad du bör tänka påKommer det att ansluta direkt till dina föredragna ML-ramverk, orkestreringsverktyg och distributionssystem? |
| FaktorAnpassningsbarhet | Vad du bör tänka påKan du anpassa metadatafält, arbetsflödessteg och rapportering så att de passar teamets unika krav? |
| FaktorAnvändarvänlighet | Vad du bör tänka påKommer dina forskare och ingenjörer att uppleva gränssnittet som intuitivt, eller är inlärningskurvan brant? |
| FaktorImplementering och introduktion | Vad du bör tänka påHur snabbt kan du gå från köp till att spåra ditt första experiment? Vilka resurser krävs för att komma igång? |
| FaktorKostnad | Vad du bör tänka påÄr användningsbaserad prissättning, lagringsavgifter eller nödvändiga tillägg tydliga och förutsägbara utifrån dina förväntade behov? |
| FaktorSäkerhetsåtgärder | Vad du bör tänka påHar verktyget stöd för kryptering, detaljerade behörigheter och autentisering för att skydda känsliga data? |
| FaktorEfterlevnadskrav | Vad du bör tänka påKommer verktyget att hjälpa dig att uppfylla bransch-, kund- eller geografiska regelverk (SOC 2, ISO 27001, GDPR)? |
Vad är verktyg för spårning av ML-experiment?
Verktyg för spårning av ML-experiment är programvaruplattformar som loggar, organiserar och versionshanterar experiment med maskininlärningsmodeller, inklusive deras parametrar, kod, dataset och mätvärden. Dessa verktyg hjälper teamet att lagra experimenthistorik, jämföra resultat och återskapa tidigare körningar fullständigt, vilket underlättar samarbete och granskning när projektens arbetsflöden blir mer komplexa.
Funktioner
När du väljer verktyg för spårning av ML-experiment bör du hålla utkik efter följande viktiga funktioner:
- Experimentloggning: Registrerar parametrar, konfigurationer, källkodshänvisningar och mätvärden för varje träningskörning för att bevara ett tydligt granskningsspår.
- Jämförelse av körningar: Gör det möjligt att visa och analysera flera experiment sida vid sida för att förstå hur olika inställningar eller ändringar påverkar resultaten.
- Versionshantering av artefakter: Skapar automatiskt versioner av dataset, versionshanterade ML-modeller och andra resultat så att du alltid kan återskapa eller bygga vidare på tidigare arbete.
- Ramverksintegrationer: Ansluter direkt till populära ML-ramverk, vilket gör det enkelt att börja spåra med minimala ändringar i arbetsflödet.
- Spårning av data- och modellhärkomst: Kartlägger hela kedjan från rådata till slutlig modell och stöder krav på reproducerbarhet och regelefterlevnad.
- Samarbetsverktyg: Gör det möjligt för flera användare att kommentera, dokumentera insikter och dela resultat inom teamet.
- Anpassade metadata: Gör det möjligt att lägga till projektspecifika fält eller taggar så att experiment kan kategoriseras på det sätt som arbetsflödet kräver.
- Rollbaserad åtkomstkontroll: Begränsar åtkomsten till känsliga data och åtgärder och stöder styrning och säkerhetsstandarder på organisationsnivå.
- Instrumentpaneler och visualiseringar: Skapar anpassningsbara rapporter och datavisualiseringar som snabbt lyfter fram trender och avvikelser i experimentdata.
- Sökning och filtrering: Gör det enkelt för teamet att hitta relevanta experiment, körningar och artefakter efter parameter, datum eller andra kriterier, vilket sparar tid när projektet växer.
Vanliga AI-funktioner i verktyg för ML-experimentspårning
Utöver de vanliga funktionerna i verktyg för ML-experimentspårning som anges ovan integrerar många av dessa lösningar AI med funktioner som:
- Automatiserad avvikelsedetektering: Använder AI för att övervaka experimentens mätvärden och flagga ovanliga mönster eller avvikande värden, vilket hjälper team att tidigt upptäcka dataförskjutning eller oväntat modellbeteende.
- Intelligenta förslag på hyperparametrar: Använder maskininlärning för att rekommendera optimala hyperparametervärden baserat på historiska experimentdata, vilket minskar behovet av manuella gissningar och snabbar upp modelljusteringen.
- Experimentfrågor på naturligt språk: Gör det möjligt för användare att söka efter och filtrera experiment med samtalsspråk, vilket underlättar för icke-tekniska intressenter att få tillgång till och förstå experimentresultat.
- Förutsägande resursallokering: Använder AI för att förutsäga behovet av beräkningskapacitet och minne för kommande körningar, vilket hjälper team att planera resurser och undvika flaskhalsar.
- Automatiserad experimentsammanfattning: Använder AI för att skapa kortfattade sammanfattningar av experimentresultat och lyfta fram viktiga resultat och trender för snabbare rapportering och beslutsfattande.
Fördelar
Implementering av verktyg för ML-experimentspårning ger flera fördelar för teamet och verksamheten. Här är några av de fördelar du kan se fram emot:
- Reproducerbarhet för experiment: Spåra parametrar, dataset och miljödetaljer för att enkelt återskapa och validera tidigare experiment.
- Effektivare samarbete: Delade instrumentpaneler, kommentarsfunktioner och projektdokumentation hjälper team att arbeta tillsammans och kommunicera resultat effektivt.
- Snabbare modellutveckling: Jämförelser av körningar sida vid sida och automatiserad versionshantering av artefakter snabbar upp experimentcykler och beslutsfattande.
- Centraliserad kunskapshantering: All projekthistorik och experimentmetadata lagras på en plats, vilket bevarar organisationskunskapen när teamen växer.
- Förbättrad efterlevnad och granskningsbarhet: Inbyggd spårning av data- och modellhärkomst samt granskningsloggar stöder regulatoriska behov och styrningsstandarder för företag.
- Kontroll över resurskostnader: Funktioner för övervakning av resurser i realtid och förutsägande allokering gör det möjligt för team att optimera användningen av maskinvara och förhindra onödiga utgifter.
- Stöd för anpassningsbara arbetsflöden: Flexibla metadatafält och arbetsflödesalternativ anpassar sig till teamets befintliga processer och preferenser.
Kostnader och priser
För att välja verktyg för ML-experimentspårning krävs en förståelse av de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för ML-experimentspårning:
Jämförelsetabell för abonnemang för verktyg för ML-experimentspårning
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| PlantypKostnadsfri plan | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande experimentspårning, begränsat antal användare, communitysupport och offentliga projekt. |
| PlantypPersonlig plan | Genomsnittligt pris$5-$25/user/month | Vanliga funktionerObegränsat antal experiment, utökat lagringsutrymme, privata projekt och grundläggande integrationer. |
| PlantypFöretagsplan | Genomsnittligt pris$30-$70/user/month | Vanliga funktionerVerktyg för teamsamarbete, rollbaserad åtkomst, avancerade integrationer, förbättrad säkerhet och granskningsloggar. |
| PlantypEnterprise-plan | Genomsnittligt pris$80-$150/user/month | Vanliga funktionerAnpassade distributionsalternativ, SSO/SAML, verktyg för regelefterlevnad, premiumsupport och avancerade anpassningsmöjligheter. |
Vanliga frågor om verktyg för spårning av ML-experiment
Här är några svar på vanliga frågor om verktyg för spårning av ML-experiment:
Kräver dessa verktyg mycket konfiguration eller kodändringar?
Nej, de flesta verktyg erbjuder lättviktiga SDK:er eller insticksprogram som gör att du kan börja logga experiment med minimala kodändringar. Ofta kan du integrera spårning i dina skript med bara några få rader.
Hur hjälper dessa verktyg till med teamets regelefterlevnad och revisioner?
De loggar parametrar, kod och resultat för varje körning, skapar spårbara experimenthistoriker och upprätthåller granskningsspår – vilket gör det enklare att dokumentera regelefterlevnad och dela bevis vid granskningar eller revisioner.
Fungerar dessa lösningar med Jupyter-anteckningsböcker?
Ja, de flesta verktyg för spårning av ML-experiment är utformade för att fungera direkt i Jupyter-anteckningsböcker samt med skript och pipelines, så du behöver inte ändra ditt arbetsflöde.
Vad händer om mitt team växer ur den kostnadsfria planen?
Du kan uppgradera till en betalnivå för fler användare, högre lagringsgränser, avancerade integrationer och företagsfunktioner. Gå igenom priserna noggrant så att du inte överraskas av övergången.
Kan jag lagra känsliga eller företagshemliga data med dessa verktyg?
Ja, men du bör granska leverantörens säkerhetsåtgärder, såsom kryptering, åtkomstkontroller och certifieringar för regelefterlevnad, för att säkerställa att dina data förblir skyddade. Lokala installationer eller privata molnalternativ kan ge ännu större kontroll.