

10 bästa verktygen för distribution av ML-modeller 2026
Urval av de bästa verktygen för driftsättning av ML-modeller


Verktyg för driftsättning av ML-modeller gör det möjligt att ta tränade maskininlärningsmodeller och omvandla dem till produktionsklara tjänster som du faktiskt kan använda. Om du letar efter sätt att på ett tillförlitligt sätt lansera, övervaka och hantera dina AI-drivna appar är det viktigt att välja rätt driftsättningsplattform. Säkerhet, skalning, automatisering och transparens kan avgöra om ditt arbetsflöde lyckas eller misslyckas.
I den här listan går jag igenom de verktyg för driftsättning av ML-modeller som jag litar mest på och visar exakt var varje verktyg passar in i din teknikstack, så att du kan välja den plattform som motsvarar projektets behov och teamets förväntningar.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Sammanfattning av de bästa verktygen för driftsättning av ML-modeller
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av verktyg för driftsättning av ML-modeller och hjälper dig att hitta det bästa alternativet för din budget och dina affärsbehov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för Kubernetes-inbyggd modellorkestrering | Gratisplan tillgänglig | Gratis att använda | Website | |
| 2 | Bäst för standardiserade inferens-API:er på Kubernetes | Gratisplan tillgänglig | Gratis att använda | Website | |
| 3 | Bäst för att paketera modeller som produktions-API:er | Gratisabonnemang + gratisdemo tillgänglig | Pris på begäran | Website | |
| 4 | Bäst för att köra transformermodeller i stor skala | Gratisplan + gratis demonstration tillgänglig | Från $9/månad | Website | |
| 5 | Bäst för distribution av serverlösa Python-funktioner | Gratisplan tillgänglig | Från $250 + beräkningskostnad/månad | Website | |
| 6 | Bäst för automatiserad modellhantering från början till slut | Gratisabonnemang tillgängligt | Från $0.204/timme | Website | |
| 7 | Bäst för enhetliga data- och AI-arbetsflöden | Gratisabonnemang tillgängligt | Från $0.085/timme | Website | |
| 8 | Bäst för att bygga anpassade webbgränssnitt för modeller | Gratisabonnemang tillgängligt | Pris på begäran | Website | |
| 9 | Bäst för distribuerad servering med Python och Ray | Gratis kredit på 100 $ tillgänglig | Pris på begäran | Website | |
| 10 | Bäst för hantering av modeller i reglerade branscher | Not available | Pris på begäran | Website |


Recensioner av de bästa verktygen för driftsättning av ML-modeller
Nedan hittar du mina detaljerade sammanfattningar av de bästa verktygen för driftsättning av ML-modeller som tog sig med på min lista. Mina recensioner ger en detaljerad överblick över funktionerna, integrationerna och de bästa användningsområdena för varje plattform, så att du kan hitta det bästa alternativet för dig.
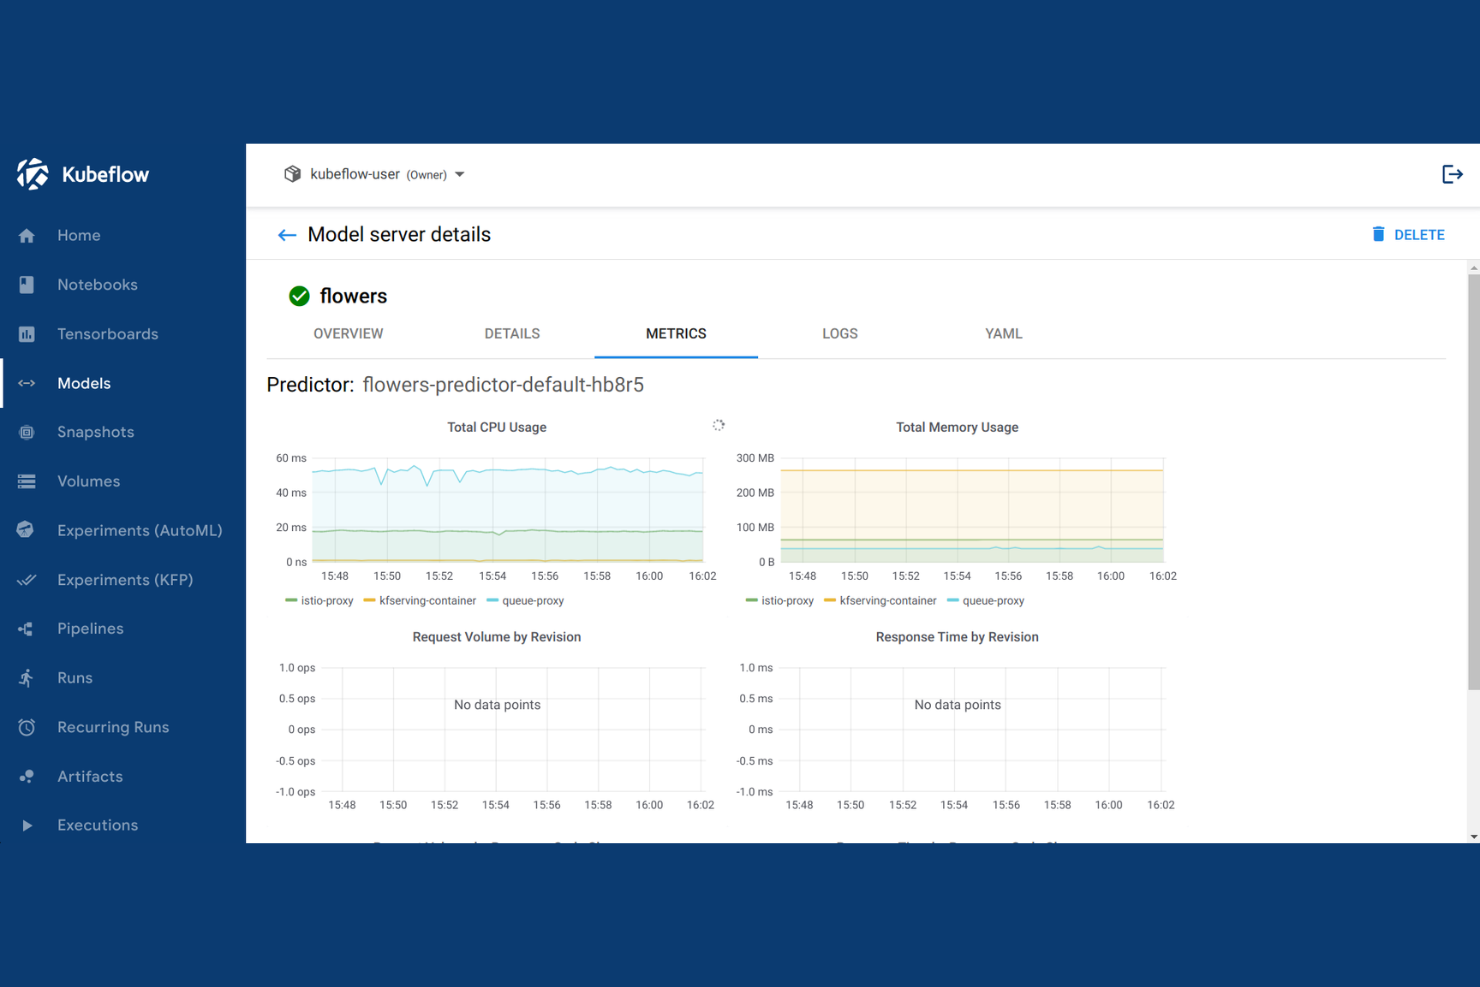
Kubeflow är en ML-plattform med öppen källkod som bygger på Kubernetes och omfattar pipelineorkestrering, modellträning, finjustering av hyperparametrar samt modellservering med flera ramverk i moln- och lokal infrastruktur.
Vem passar Kubeflow bäst för?
Kubeflow passar bra för ML-teknikteam som redan kör Kubernetes och behöver hantera storskaliga träningsjobb samt servering av produktionsmodeller på sin egen infrastruktur.
Därför valde jag Kubeflow
Jag valde Kubeflow som en av de bästa lösningarna eftersom den är särskilt utvecklad för Kubernetes, vilket innebär att varje komponent körs som en inbyggd Kubernetes-arbetsbelastning. Jag uppskattar att Kubeflow Pipelines låter mig definiera ML-arbetsflöden från början till slut som containeriserade DAG:er, så att varje steg kan skalas oberoende. Kubeflow Trainer hanterar distribuerad träning med PyTorch, JAX och DeepSpeed utan någon anpassad klusterkonfiguration. Jag kan också använda Katib för att köra automatiska sökningar efter hyperparametrar direkt mot pågående träningsjobb i samma kluster.
Kubeflows viktigaste funktioner
- KServe: Distribuera tränade modeller som skalbara inferenstjänster på Kubernetes med hjälp av förbyggda körmiljöer för modellservering för TensorFlow, PyTorch och scikit-learn.
- Modellregister: Lagra, versionshantera och spåra registrerade modeller mellan träningskörningar innan de befordras till serveringsmiljöer.
- Notebookservrar: Starta Jupyter Notebook-instanser direkt i klustret med konfigurerbara tilldelningar av CPU, GPU och minne.
- Isolering mellan användare: Hantera separata namnrymder och åtkomstkontroller för olika team eller projekt i ett delat kluster.
Kubeflow-integreringar
Kubeflow erbjuder inte traditionella inbyggda integrationer utan fungerar i stället inom Kubernetes-ekosystemet och stöder ML-ramverk som TensorFlow, PyTorch, JAX, XGBoost, HuggingFace och Apache Spark genom operatorer för delprojekten. Du kan också distribuera det på hanterade Kubernetes-tjänster från AWS, Google Cloud, Microsoft Azure och Red Hat OpenShift.
Pros and Cons
Pros:
- Distribueras hos alla större molnleverantörer av Kubernetes
- Varje pipelinesteg körs i en isolerad container
- Får höga poäng inom distribuerad träning och orkestrering
Cons:
- Den komplexa första konfigurationen kräver Kubernetes-expertis
- Kräver ett särskilt plattformsteam för underhåll

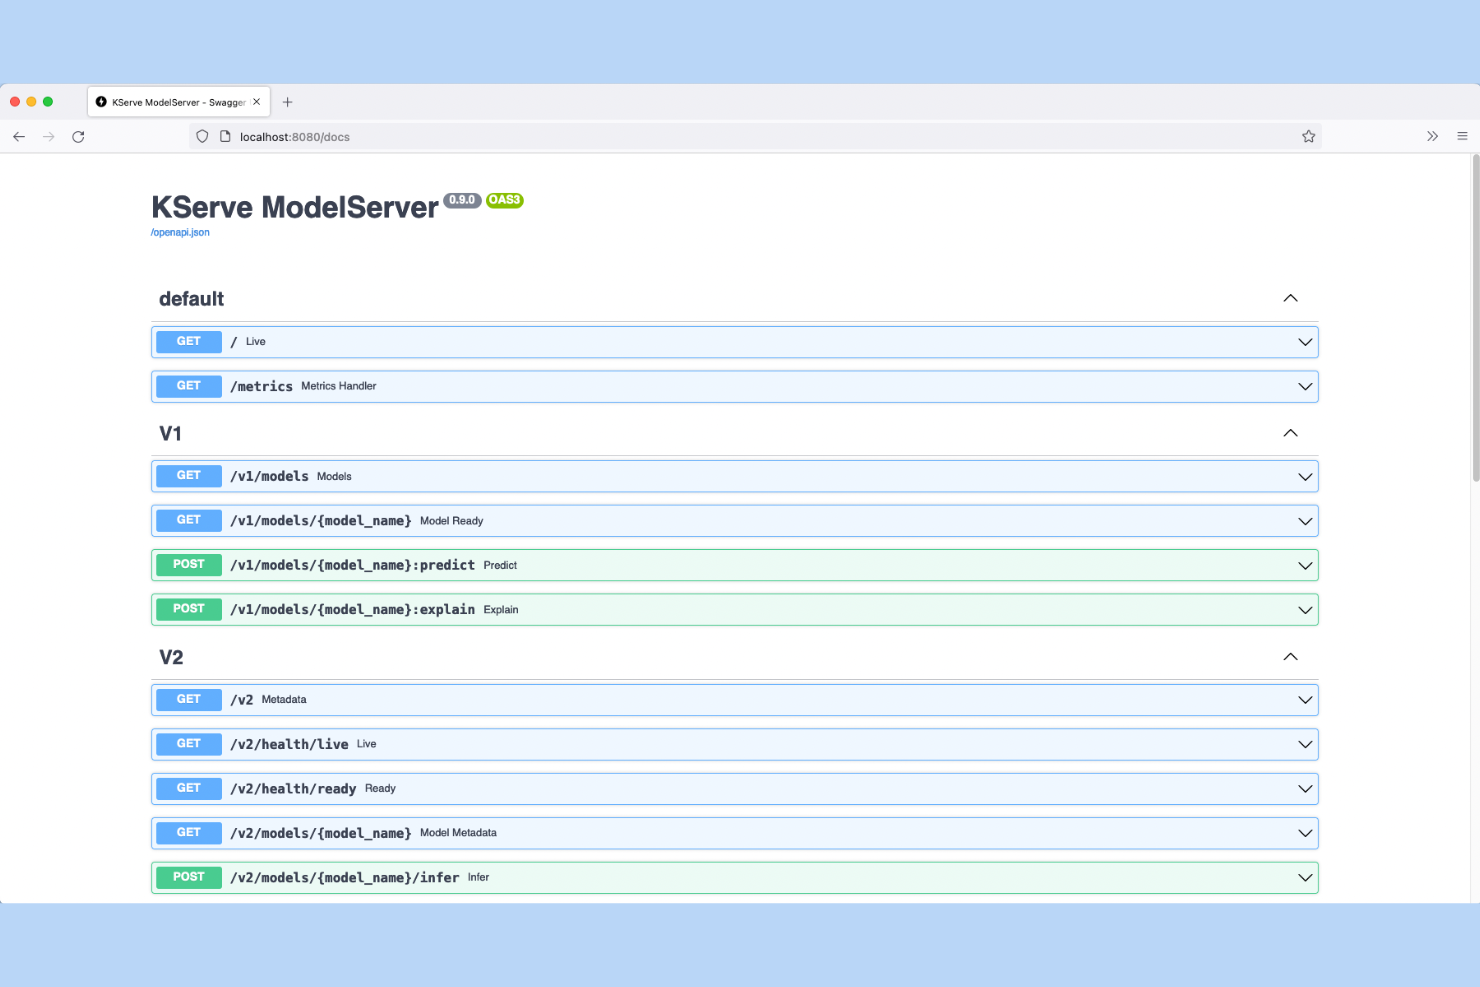
KServe är en modellinferensplattform med öppen källkod och inbyggt Kubernetes-stöd som hanterar modellservering med flera ramverk, canary-distributioner, automatisk skalning och modellförklarbarhet genom ett standardiserat inferens-API-lager.
Vem passar KServe bäst för?
KServe passar bra för ML-teknikteam i medelstora till stora organisationer som kör modellservering i stor skala på Kubernetes och behöver ett ramverksoberoende inferenslager.
Varför jag valde KServe
Jag valde KServe som en av de bästa lösningarna eftersom det bygger på Open Inference Protocol (V2), en standardiserad API-specifikation som gör att mitt team kan byta serveringsmotor, till exempel Triton eller vLLM, utan att skriva om klientkoden. Jag förlitar mig också på dess InferenceService CRD för att deklarativt definiera canary-distributioner och dirigera en procentandel av den aktiva trafiken till en ny modellversion innan den distribueras fullt ut. Inferensendpunkter med REST och gRPC stöds båda, så jag är inte låst till ett enda transportlager.
Viktiga funktioner i KServe
- Automatisk skalning till noll: Knative-baserad automatisk skalning skalar ner inferenspoddar till noll när de är inaktiva och startar upp dem igen vid behov.
- Transformatorer för förfrågningar och svar: Logik för för- och efterbehandling körs i en separat transformatorcontainer bredvid modellservern.
- Canary-distributioner: Trafiken flyttas gradvis till en ny modellversion, så att du kan testa ändringar i produktion utan full exponering.
- Loggning av nyttolaster: Inferensförfrågningar och svar loggas till konfigurerbara mål för revisionsspår och modellövervakning.
KServe-integreringar
KServe har inbyggda integreringar med Knative, Istio och Kubernetes Gateway API för serverlös skalning och ingressdirigering. Det levereras med inbyggda körmiljöer för modellservering med vLLM, llm-d, NVIDIA Triton Inference Server, Seldon MLServer, TorchServe och Hugging Face, och stöder modellagring från Amazon S3, Google Cloud Storage och Azure Blob Storage. Ett Python-SDK för modellservering samt REST- och gRPC-inferens-API:er finns tillgängliga för anpassade integreringar.
Pros and Cons
Pros:
- Automatisk skalning till noll minskar kostnaderna för inaktiva GPU:er
- Ramverksoberoende modellservering via standardiserat inferensprotokoll
- Inbyggda canary-distributioner för säkra uppdateringar
Cons:
- Kräver expertkunskaper i Kubernetes för drift
- Serverlöst läge begränsar anpassningen av volymmontering

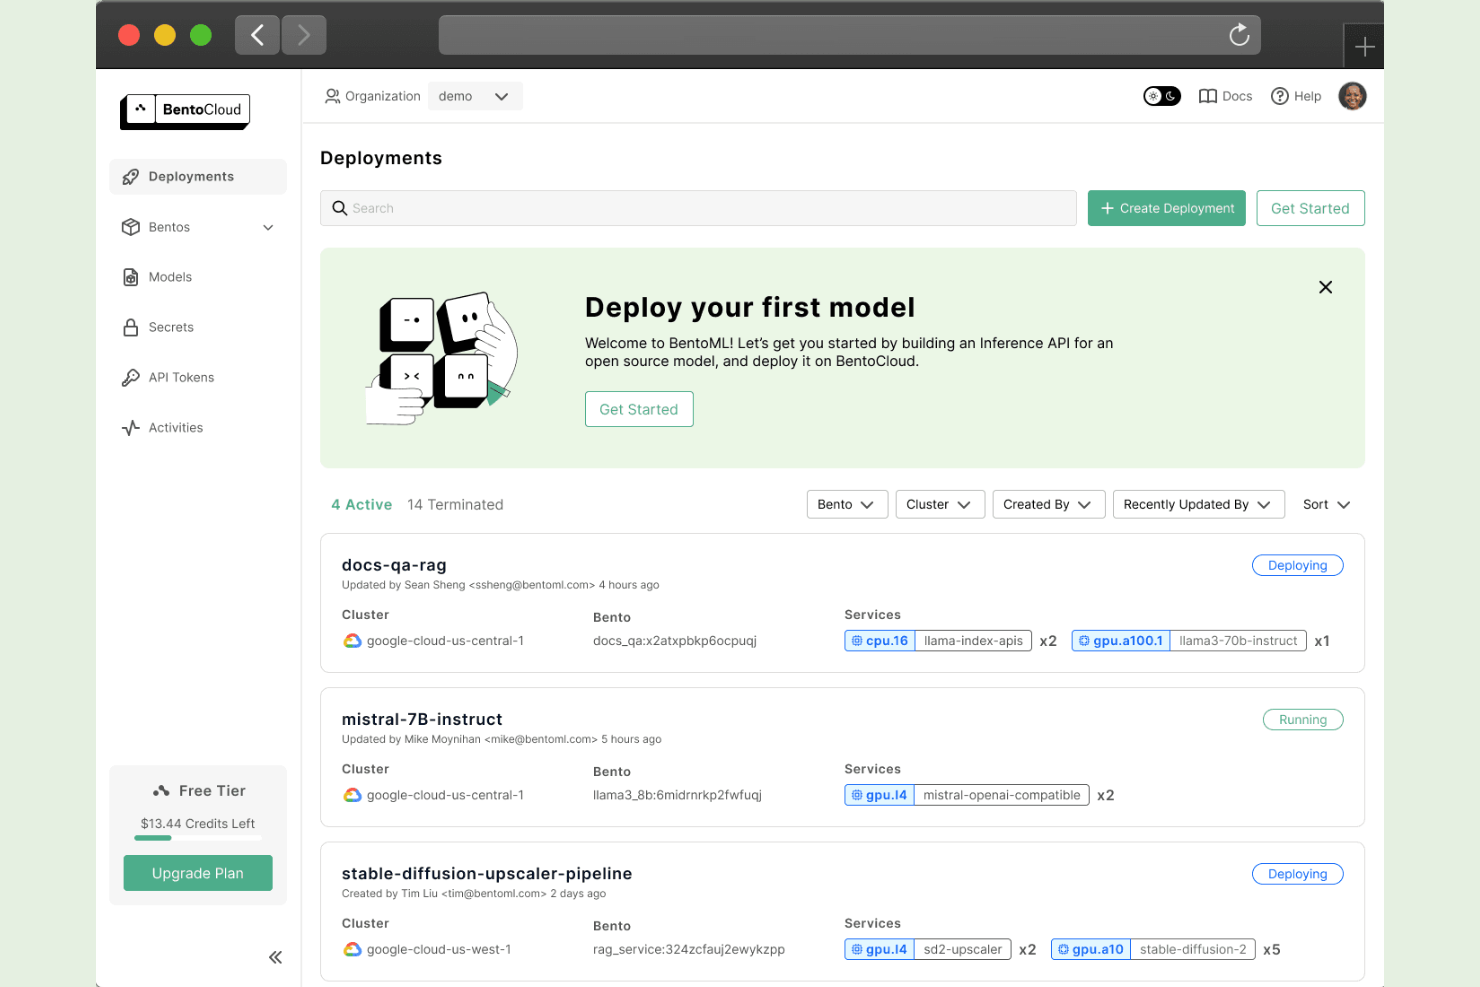
Med utgångspunkt i konceptet med en 'Bento'-artefakt är BentoML ett Python-nativt ramverk för modellservering som hanterar tjänstedefinition, containerisering och paketering av modeller från flera ramverk för produktionsdistribution.
Vem passar BentoML bäst för?
BentoML passar bra för ML-team på företag i tillväxtfas som snabbt behöver gå från en tränad modell till ett produktionsklart API utan en dedikerad MLOps-plattform.
Varför jag valde BentoML
Jag har tagit med BentoML bland mina toppval eftersom det är ett av få ramverk som behandlar modellartefakten och serveringslagret som en enda versionshanterad enhet. Jag gillar att BentoML automatiskt genererar både REST- och gRPC-slutpunkter från samma tjänstedefinition, så att mitt team inte behöver underhålla separata API-specifikationer. Runner-abstraktionen gör det också möjligt för mig att isolera varje modell i sin egen process, vilket innebär att ett CPU-baserat förbehandlingssteg inte konkurrerar om resurser med en GPU-modellkörning.
Viktiga funktioner i BentoML
- Adaptiv batchning: Grupperar automatiskt samtidiga inferensförfrågningar i en enda batch, vilket minskar GPU-belastningen per förfrågan utan kodändringar.
- Inbyggda Prometheus-mätvärden: Exponerar en /metrics-slutpunkt direkt, så att du kan övervaka fördröjning och genomströmning för förfrågningar utan anpassad instrumentering.
- LLM-gateway: Tillhandahåller ett enhetligt API-gränssnitt för flera LLM-leverantörer och ger dig centraliserad kontroll över dirigering och kostnader.
- Byggnation av containeravbildningar: Genererar en produktionsklar Docker-avbildning direkt från en Bento-artefakt med ett enda CLI-kommando.
BentoML-integrationer
BentoML erbjuder dokumenterade integrationer med verktyg i MLOps-ekosystemet, däribland Airflow, MLflow, Ray, Spark, Arize AI, Flink och Triton Inference Server. Det integreras även med Datadog för insamling av mätvärden för BentoML-tjänster. Ett API finns tillgängligt för anpassade integrationer, och BentoML:s containeriserade utdata fungerar direkt med Kubernetes och Docker för flexibel distribution.
Pros and Cons
Pros:
- Inbyggd versionshantering av modeller och spårning av återställningar
- Genererar Docker-containrar från YAML-konfiguration
- Hanterar samtidiga förfrågningar genom skalning av arbetare
Cons:
- Konfigurationsfiler kan upplevas som onödigt komplexa
- Anpassade modellinläsare kräver extra konfiguration

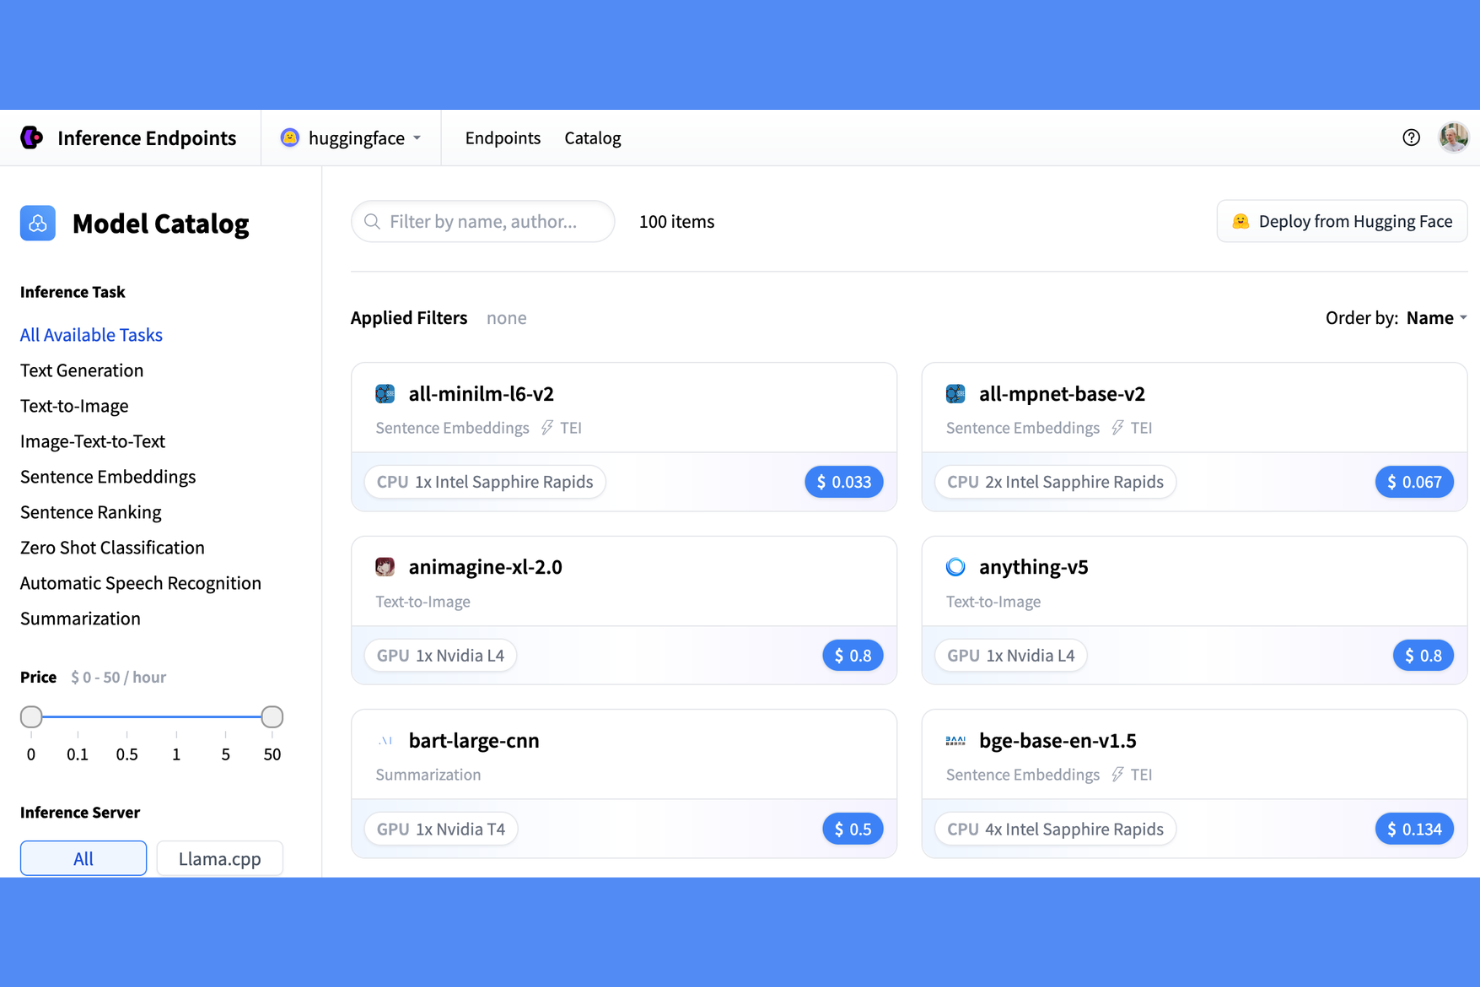
En hanterad plattform för inferens som bygger på Hugging Face Hub. Hugging Face Inference Endpoints hanterar dedikerad molndistribution, konfiguration av slutpunkter och val av maskinvara för ML-modeller i AWS, Azure och Google Cloud.
Vem passar Hugging Face Inference Endpoints bäst för?
Det passar väl för AI-fokuserade nystartade företag och medelstora teknikföretag som behöver produktionsklara modeller utan att bygga och underhålla sin egen infrastruktur för modellservering.
Varför jag valde Hugging Face Inference Endpoints
Hugging Face Inference Endpoints finns med på min kortlista eftersom plattformen är särskilt byggd för ekosystemet med transformermodeller på ett sätt som ingen annan distributionsplattform är. Mitt team kan ta vilken modell som helst från Hub, inklusive storskaliga LLM-modeller och multimodala transformermodeller, och köra den i produktionsskala med konfigurerbara regler för automatisk skalning som reagerar på verklig trafik. Jag uppskattar också hastigheten från noll till slutpunkt: en modell som skulle ta dagar att paketera i en behållare och distribuera manuellt är igång på några minuter.
Viktiga funktioner i Hugging Face Inference Endpoints
- Distribution i flera moln: Välj att distribuera din slutpunkt i AWS, Azure eller Google Cloud utan att hantera separata molnkonton.
- Privat nätverk: Lås slutpunkterna i ett dedikerat VPC så att endast dina interna system kan nå modellens API.
- Tokenbaserad autentisering: Skydda varje slutpunkt med en API-token för att styra vilka tjänster eller användare som kan skicka inferensförfrågningar.
- Användningsövervakning: Följ volymen av förfrågningar, svarstid och felfrekvens direkt från slutpunktens instrumentpanel i realtid.
Integrationer med Hugging Face Inference Endpoints
Hugging Face Inference Providers fungerar med ett växande ekosystem av utvecklingsverktyg, ramverk och plattformar, och verktyg utan uttryckligt stöd är ofta fortfarande kompatibla via dess OpenAI-kompatibla API. Dokumenterade integrationer omfattar AWS Bedrock och SageMaker, Google Gemini Enterprise Agent Platform och Azure AI Foundry, samt LLM-ramverk som LangChain, LlamaIndex, Haystack, CrewAI och PydanticAI. Inference Endpoints kan hanteras helt via API, med slutpunkter dokumenterade genom Swagger, så att du kan bygga anpassade integrationer. Stöd för Zapier är inte tydligt dokumenterat.
Pros and Cons
Pros:
- Distribution med ett klick från Hugging Face Hub
- Stöd för flera backendlösningar för inferensmotorer
- Automatisk skalning med fakturering som skalar till noll
Cons:
- Kallstarter vid skalning från noll
- Kostnaderna för GPU-beräkning ökar snabbt i stor skala

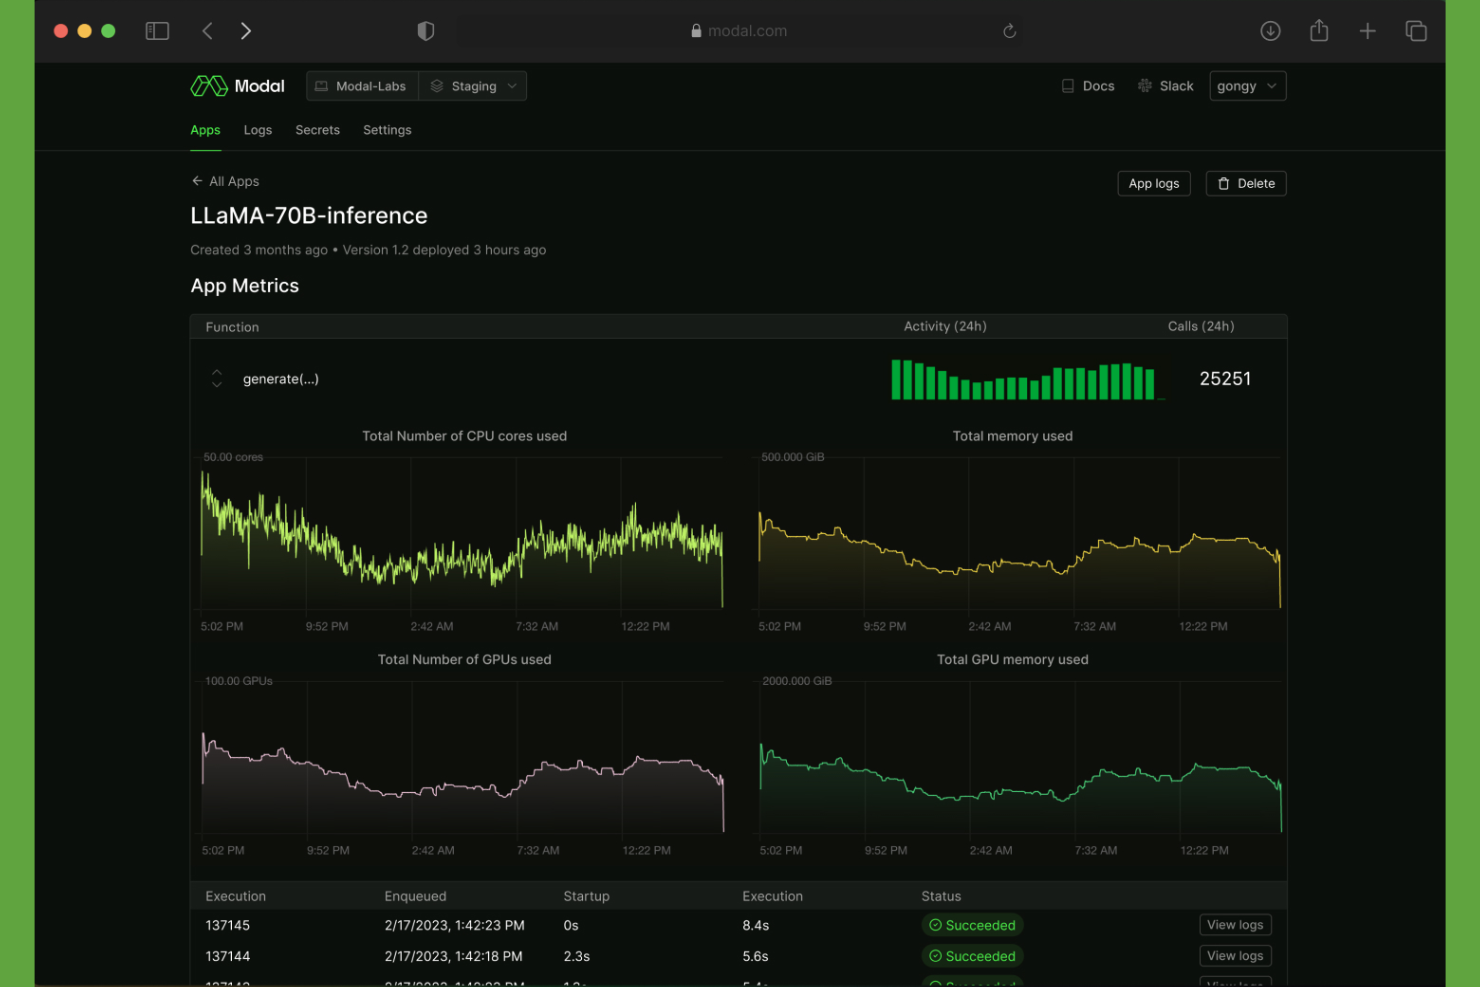
Modal är en serverlös molnplattform för att köra Python-baserade ML-arbetsbelastningar, inklusive GPU-accelererad inferens, batchjobb, träningskörningar och schemalagda uppgifter utan någon hantering av containrar eller infrastruktur.
Vem passar Modal bäst för?
Det är ett naturligt val för nystartade företag och team i tillväxtfas som behöver lansera ML-modeller snabbt utan att anställa särskilda infrastrukturingenjörer.
Varför jag valde Modal
Jag har tagit med Modal bland mina främsta val eftersom plattformen eliminerar gapet mellan att skriva Python och att köra koden i stor skala på GPU:er. Jag kan begära specifik hårdvara, som en A100 eller H100, direkt i min funktionsdefinition, så tillhandahåller Modal den vid behov. Det finns inget kluster att hantera och ingen YAML att skriva. Jag uppskattar också att samma funktion körs identiskt lokalt och i produktion, vilket minskar felsökningstiden avsevärt.
Modals viktigaste funktioner
- Anpassade containeravbildningar: Definierar beroenden, miljövariabler och systempaket direkt i koden, vilket säkerställer konsekventa körningsmiljöer mellan distributioner.
- Beständiga volymer: Monterar molnvolymer för att cachelagra modellvikter mellan körningar, vilket minskar kallstartstiderna vid upprepade distributioner.
- Hantering av hemligheter: Lagrar och injicerar API-nycklar och autentiseringsuppgifter säkert under körning utan att hårdkoda dem i kodbasen.
- Parallell batchkörning: Använd .map() för att köra inferens över stora datamängder parallellt i flera containrar samtidigt.
Modals integrationer
Modal erbjuder ett mindre antal dokumenterade integrationer med fokus på observerbarhet och aviseringar, inklusive Datadog, alla leverantörer som är kompatibla med OpenTelemetry, Slack och Okta SSO. Plattformen stöder även montering av molnbuckets för AWS S3, Google Cloud Storage och Cloudflare R2, samt CI/CD-arbetsflöden via GitHub Actions. Stöd för Zapier är inte dokumenterat, men Modal tillhandahåller ett Python-SDK och webbaserade slutpunkter som stöder anpassade integrationer.
Pros and Cons
Pros:
- Inga Docker-filer eller Kubernetes-konfigurationer behövs
- Hanterar träning, batchbearbetning och inferens
- Dirigerar arbetsbelastningar mellan moln och regioner
Cons:
- Dekoratörsbaserad kod skapar leverantörsinlåsning
- Företagsfunktioner kräver prissättning på premium-nivå
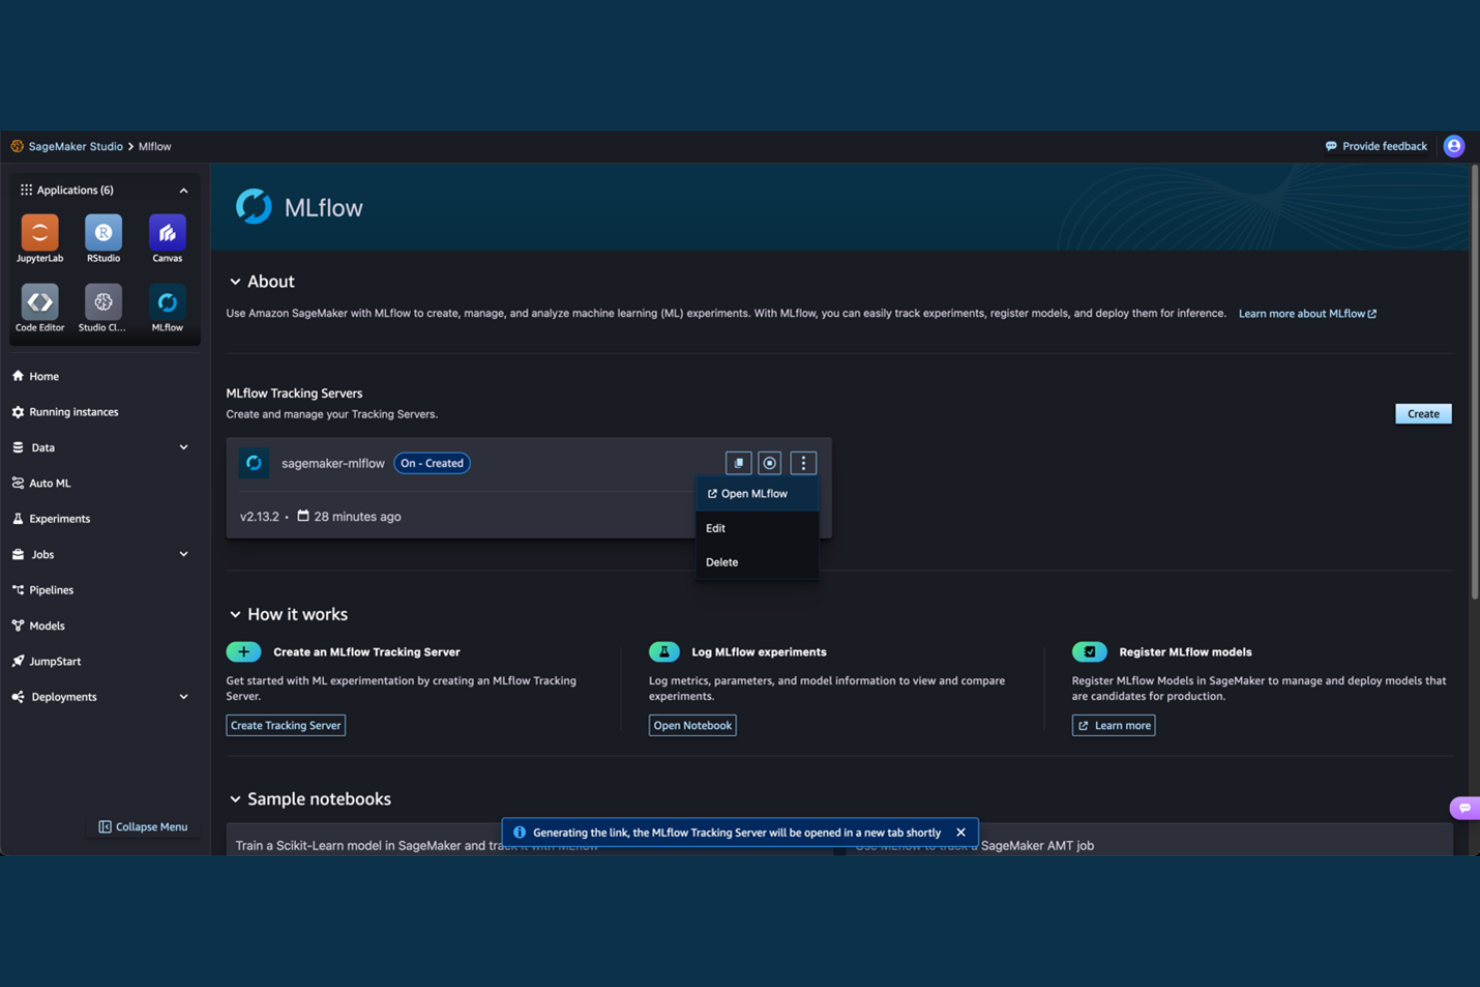
Amazon SageMaker (även känt som AWS Sagemaker) är en AWS-plattform för maskininlärning som täcker hela modellens livscykel – från träning och finjustering till distribution, övervakning och styrning – i en enhetlig utvecklingsmiljö byggd på lakehouse-arkitektur.
Vem passar Amazon SageMaker bäst för?
Amazon SageMaker passar bra för data science- och ML-teknikteam som redan arbetar inom AWS-ekosystemet.
Varför jag valde Amazon SageMaker
Amazon SageMaker tar plats som ett av de bästa alternativen på min kortlista eftersom det täcker automatiserad modellhantering från början till slut utan att du behöver kombinera separata verktyg. Jag uppskattar särskilt SageMaker MLOps, som hanterar pipelineorkestrering, modellregister och uppföljning av distributioner på ett och samma ställe. Jag förlitar mig också på de inbyggda funktionerna för inferens, AI-drift och observerbarhet i SageMaker AI för att övervaka modeller efter distribution och upptäcka drift innan det blir ett produktionsproblem.
Viktiga funktioner i Amazon SageMaker
- SageMaker JumpStart: Få tillgång till över 1 000 förbyggda AI-modeller från ledande leverantörer och distribuera eller finjustera dem direkt i SageMaker.
- SageMaker HyperPod: Skala tränings- och finjusteringsjobb över kluster med hundratals eller tusentals AI-acceleratorer med automatiserad klusterhantering.
- Inferens i flera lägen: Distribuera modeller med realtidsinferens, serverlös, asynkron eller batchbaserad inferens över fler än 70 instanstyper.
- Hanterad MLflow: Följ upp, organisera och jämför iterativa experiment utan att behöva tillhandahålla infrastruktur eller hantera servrar.
Integrationer med Amazon SageMaker
Amazon SageMaker integreras inbyggt i AWS-ekosystemet, bland annat med Amazon S3, Amazon Redshift, Amazon Athena, Amazon EMR och AWS Glue, samt med Amazon Bedrock och Amazon Q Developer. Det fungerar även med verktyg från tredje part som Datadog, Hugging Face, MLflow och Pinecone. Ett API är tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Flera inferenslägen för olika arbetsbelastningar
- Inbyggd AutoML och hyperparameterjustering
- Skuggtestning för säkra modellutrullningar
Cons:
- Tätt kopplat till AWS-ekosystemet
- Det är svårt att felsöka misslyckade träningsjobb


Gemini Enterprise Agent Platform (tidigare Vertex AI) är Google Clouds ML-plattform från början till slut, som omfattar modellträning, finjustering, utvärdering, driftsättning och utveckling av AI-agenter i en enda hanterad miljö.
Vem passar Gemini Enterprise Agent Platform bäst för?
Gemini Enterprise Agent Platform passar naturligt för ML-teknik- och datavetenskapsteam som redan kör sin datainfrastruktur på Google Cloud Platform.
Varför jag valde Gemini Enterprise Agent Platform
Jag har tagit med Gemini Enterprise Agent Platform bland mina toppval eftersom plattformen verkligen överbryggar gapet mellan data- och modellhantering. Jag uppskattar särskilt hur Gemini Enterprise Agent Platforms pipelinefunktion ansluter direkt till BigQuery, så att mitt team kan bygga träningspipelines ovanpå aktiva lagerdata utan att exportera något. Gemini Enterprise Agent Platforms funktionslager låter oss också definiera, tillhandahålla och övervaka funktioner konsekvent för både träning och inferens, vilket eliminerar en viktig källa till skillnader mellan träning och användning.
Viktiga funktioner i Gemini Enterprise Agent Platform
- Gemini Enterprise Agent Platforms modellregister: Ett centraliserat arkiv för versionshantering, organisering och hantering av modeller under hela deras livscykel, före och efter driftsättning.
- Slutpunkter för onlineprediktion: Driftsätt modeller till dedikerade slutpunkter som levererar prediktioner i realtid, med konfigurerbar beräkningskapacitet och trafikfördelning mellan modellversioner.
- Gemini Enterprise Agent Platforms modellövervakning: Upptäcker funktionsskevhet och prediktionsdrift i driftsatta modeller genom att jämföra aktiv trafik med en baslinje från träningsdata.
- Gemini Enterprise Agent Platforms experiment: Spårar, jämför och visualiserar iterativa träningskörningar för att hjälpa team att identifiera de bäst presterande modellkonfigurationerna.
Integrationer med Gemini Enterprise Agent Platform
Gemini Enterprise Agent Platform integreras inbyggt i Google Clouds ekosystem, inklusive BigQuery, Cloud Storage, Dataflow och Pub/Sub, samt har stöd för Kubeflow Pipelines och färdiga containrar för TensorFlow, scikit-learn, XGBoost och PyTorch. Dess datalager stöder även tredjepartsanslutningar för verktyg som Jira och Shopify. Plattformen finns på Zapier, och ett API är tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Modellkatalogen erbjuder över 200 modeller som kan driftsättas
- Slutpunktsbaserad driftsättning från modellkatalogen är enkel
- Inbyggd BigQuery-integration för dataarbetsflöden
Cons:
- Inaktiva dedikerade slutpunkter medför fortfarande kostnader
- Skillnader i regionstilldelning ger otydliga felmeddelanden


Baseten är en plattform för modellinferens som låter ML-team distribuera anpassade modeller, modeller med öppen källkod och finjusterade modeller med GPU-accelererad servering, automatisk skalning och verktyg för prestandaoptimering som är direkt inbyggda i plattformen.
Vem passar Baseten bäst för?
Baseten passar AI-produktteam på företag i tillväxtfas som behöver full kontroll över inferensprestandan för modellinstallationer som är känsliga för fördröjning eller har hög genomströmning.
Varför jag valde Baseten
Baseten tar plats på min kortlista eftersom plattformen låter dig bygga och distribuera anpassade webbgränssnitt ovanpå dina modeller i samma plattform, utan att du behöver en separat teknikstack för användargränssnittet. Jag använder Basetens applikationsbyggare för att skapa interaktiva gränssnitt som anropar modellslutpunkter direkt, vilket är användbart för interna verktyg eller demonstrationer för intressenter. Modellen och dess gränssnitt förblir versionshanterade och distribueras tillsammans.
Viktiga funktioner i Baseten
- Truss-modellpaketering: Paketera valfri anpassad eller finjusterad modell som ett reproducerbart Python-artefakt med inbyggd beroendehantering och omladdning i realtid för lokal testning.
- Baseten-kedjor: Bygg sammansatta AI-arbetsflöden i flera steg där varje steg körs på separat konfigurerad maskinvara med en egen policy för automatisk skalning.
- Hantering av hemligheter: Lagra och injicera API-nycklar och miljöautentiseringsuppgifter direkt i modellinstallationer utan att hårdkoda dem i din serveringskod.
- A/B-fördelning av trafik: Dirigera live-inferenstrafik över flera modellversioner samtidigt för att jämföra prestanda innan en ny installation befordras fullt ut.
Basetens integrationer
Baseten stöder export av mätvärden till Prometheus, Datadog, Grafana Cloud och New Relic via sin OpenTelemetry-baserade slutpunkt för mätvärden. Plattformen är fullt kompatibel med OpenAI, så du kan ansluta den till valfri klient eller gateway som använder OpenAI SDK, inklusive LiteLLM, LlamaIndex och Cloudflare AI Gateway. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Truss-paketering med öppen källkod förenklar modelldistribution
- Distribuera träningskontrollpunkter med ett klick
- Kallstarter på GPU-instanser på under en sekund
Cons:
- Användningsbaserad prissättning kan öka oförutsägbart
- Kräver ML-teknisk expertis för drift


Anyscale bygger på ramverket Ray med öppen källkod och är en hanterad plattform för ML-modellservering som hanterar distribuerad inferens, automatisk skalning och distributioner med flera modeller över GPU- och CPU-kluster.
Vem passar Anyscale bäst för?
Anyscale passar bra för ML-ingenjörer och datavetenskapsteam på medelstora till stora organisationer som kör Python-baserade arbetsbelastningar i stor skala och behöver hantera GPU-kluster utan manuellt infrastrukturarbete.
Varför jag valde Anyscale
Jag valde Anyscale som en av de bästa lösningarna eftersom det är den enda hanterade plattformen som bygger direkt på Ray. Det innebär att mitt team kan skriva vanlig Python för att definiera logik för distribuerad servering utan att behöva lära sig ett separat orkestrerings-DSL. Jag uppskattar särskilt Ray Serves API för distributionsgrafer, som låter mig kombinera flera modeller i en enda inferenspipeline med explicit begäranderoutning. Partiell GPU-allokering är en annan funktion som jag använder regelbundet för att placera lätta modeller på delad hårdvara utan att starta dedikerade instanser.
Anyscales viktigaste funktioner
- Automatisk skalning: Skalar automatiskt antalet repliker upp eller ned baserat på genomströmning av begäranden i realtid och ködjup.
- Trafikdelning: Dirigerar en konfigurerbar andel av den aktiva trafiken till nya modellversioner för gradvisa utrullningar utan driftstopp.
- Batchning av begäranden: Grupperar inkommande inferensbegäranden i batcher för att maximera GPU-utnyttjandet vid samtidiga anrop.
- Modellservering över flera noder: Distribuerar en enda stor modell över flera noder när den överskrider minnesgränserna för en enskild GPU.
Anyscale-integreringar
Anyscale integreras med populära AI/ML-bibliotek och ramverk och har över 50 integreringar inom dataplattformar, orkestrering, ML-ramverk, observerbarhet och ramverk för LLM-appar. Dessa omfattar MLflow, Weights & Biases, MongoDB, Snowflake, Databricks, Hugging Face, PyTorch och TensorFlow samt Airflow, Prefect, Dagster, Datadog, LangChain och LlamaIndex. Ett API finns tillgängligt för anpassade integreringar, och plattformen kan även distribueras som en förstapartstjänst på Amazon EKS, Google GKE, Azure AKS och OCI Kubernetes Engine.
Pros and Cons
Pros:
- Skalar Python-kod över distribuerade GPU-kluster
- Ramverksoberoende modellservering via Ray Serve
- Stöd för spotinstanser med automatisk feltolerans
Cons:
- Tätt kopplad till Ray-ekosystemet
- Kräver djup kunskap om distribuerade system

Andra verktyg för driftsättning av ML-modeller
Här är några ytterligare verktyg för driftsättning av ML-modeller som inte tog sig med på min lista, men som ändå är värda att undersöka:


Hur jag utvärderar verktyg för driftsättning av ML-modeller
Jag utvärderar varje verktyg på två nivåer: grundnivån, som innebär att skicka en PyTorch-modell till en REST-slutpunkt med autoskalning och övervakning av drift, samt de särskiljande egenskaper som är viktiga för MLOps-team.
Kärnfunktioner (grundkrav för denna lista)
När jag väljer verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 65 % för att övervägas för inkludering.
- Modellservering och inferens: Jag undersöker om ett verktyg kan vara värd för modeller bakom REST- eller gRPC-slutpunkter för förutsägelser i realtid och om det även hanterar batchinferens för offlinejobb för poängsättning.
- Stöd för flera ramverk: Jag kontrollerar vilka ML-ramverk som stöds inbyggt – till exempel TensorFlow, PyTorch, XGBoost och ONNX – och om anpassade containrar är ett alternativ för mindre vanliga körmiljöer.
- Modellversionshantering och modellregister: Ett robust register låter dig spåra modellartefakter, metadata och härkomst, så att du kan återställa en felaktig driftsättning på några minuter i stället för att febrilt försöka hitta rätt artefakt.
- Skalning och resurshantering: Jag utvärderar hur autoskalning fungerar under belastning, om GPU- och CPU-allokering kan konfigureras och om verktyget stöder skalning till noll för att minska kostnaderna under inaktiva perioder.
- Övervakning och observerbarhet: Produktionsmodeller försämras i tysthet, så jag letar efter identifiering av datadrift, spårning av förutsägelselatens och aviseringar som flaggar prestandaproblem innan de når slutanvändarna.
- CI/CD och automatisering av driftsättning: Jag överväger om verktyget stöder automatiserade pipelines med strategier för stegvis utrullning, som canary- eller A/B-testning, samt Git-baserade utlösare för att driftsätta modeller på nytt.
När jag har en lista över verktyg som uppfyller dessa kriterier överväger jag vad som särskiljer varje plattform.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Canary- och skuggdriftsättningar skiljer verktygen åt. Jag letar efter möjligheten att dirigera en del av den aktiva trafiken till en ny modellversion medan den aktuella fortsätter att leverera – detta fångar upp försämringar i träffsäkerheten innan de når alla användare. GPU-optimering är en annan särskiljande faktor: dynamisk batchning och stöd för kvantisering genom acceleratorer som NVIDIA Triton eller TensorRT kan drastiskt sänka kostnaden per förutsägelse vid hög volym. Skalning till noll är lika viktigt, eftersom inaktiva slutpunkter som förbrukar GPU-timmar snabbt blir kostsamma i inferenstunga arbetsbelastningar.
Utöver funktionerna
Integration med MLOps-ekosystemet är mycket viktigt – jag kontrollerar om ett verktyg ansluter till experimentspårare som MLflow eller Weights & Biases, orkestrerare som Airflow och CI/CD-system som GitHub Actions. Infrastrukturflexibilitet är lika viktigt: team inom reglerade branscher behöver ofta Kubernetes i egen regi eller BYOC-alternativ i stället för renodlade SaaS-lösningar. Jag utvärderar även styrning och efterlevnad, särskilt RBAC, revisionsloggning och certifieringar som SOC 2 eller HIPAA, som företagets säkerhetsteam kommer att fråga om under upphandlingen.
Så väljer du verktyg för driftsättning av ML-modeller
Det är lätt att fastna i långa funktionslistor och komplicerade prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval följer här en checklista med faktorer att tänka på:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan verktyget hantera plötsliga ökningar av inferenstrafiken utan manuella åtgärder? Kontrollera att det stöder både toppar och perioder med låg volym. |
| Integrationer | Ansluter plattformen direkt till dina experimentuppföljningsverktyg, CI/CD-verktyg eller datalager, eller måste du utveckla och underhålla anpassad kod? |
| Anpassningsbarhet | Kan du anpassa driftsättningsarbetsflöden, åtkomstkontroller för modeller och resurshantering efter dina specifika policyer och teamstrukturer? |
| Användarvänlighet | Hur brant är inlärningskurvan för ditt team? Ta hänsyn till gränssnittets komplexitet, dokumentationens kvalitet och om introduktionen kommer att försena andra projekt. |
| Implementering och introduktion | Hur mycket tekniktid krävs för att gå från test till produktion? Var uppmärksam på dolda konfigurationssteg, nätverksförutsättningar eller obligatorisk utbildning. |
| Kostnad | Är prismodellerna transparenta och förutsägbara när användningen ökar? Jämför faktureringsmetoder – per förutsägelse, beräkningstimme eller slutpunkt – för dina arbetsbelastningar. |
| Säkerhetsskydd | Vilka mekanismer för kryptering, åtkomstkontroll och granskning finns på plats? Bedöm om erbjudandet uppfyller dina interna säkerhetsstandarder och kundernas behov. |
| Efterlevnadskrav | Behöver du HIPAA, GDPR eller SOC 2 Type II? Bekräfta att leverantören tillhandahåller de intyg som krävs och stöder nödvändiga granskningsspår för din bransch. |
Vad är verktyg för driftsättning av ML-modeller?
Verktyg för driftsättning av ML-modeller är plattformar som hjälper dig att operationalisera tränade maskininlärningsmodeller och göra dem tillgängliga via API:er eller batchslutpunkter för användning i verkliga situationer. Dessa verktyg hanterar uppgifter som modellbetjäning, skalning, övervakning och versionshantering, så att du kan leverera korrekta förutsägelser och upprätthålla tillförlitligheten när arbetsbelastningen utvecklas.
Funktioner
När du väljer verktyg för driftsättning av ML-modeller bör du hålla utkik efter följande viktiga funktioner:
- Stöd för flera ramverk: Distribuera modeller som har byggts med TensorFlow, PyTorch, scikit-learn, XGBoost och ONNX utan att behöva omarbeta modellkod eller konverteringssteg.
- Automatisk skalning av inferens: Tilldelar automatiskt beräkningsresurser baserat på trafikmönster och hanterar plötsliga toppar eller lugna perioder för att upprätthålla både prestanda och kostnadseffektivitet.
- Versionshantering av modeller: Håller reda på olika modellversioner, vilket gör det enkelt att återställa, jämföra eller befordra modeller i produktionspipelines med minimala störningar.
- Kanarie- och skuggdistributioner: Möjliggör gradvisa lanseringar eller spegling av live-trafik, så att du säkert kan validera nya modeller mot verkliga data innan fullständig driftsättning.
- Batch- och realtidsbetjäning: Stöder både användningsfall med realtids-API:er och asynkron batchbearbetning, vilket ger flexibilitet för affärsapplikationer och arbetsflöden inom datavetenskap.
- Resurshantering: Gör det möjligt att tilldela och övervaka CPU-, GPU- och minnesanvändning per modell, vilket hjälper till att optimera kostnader och upprätthålla tjänstens hälsa i produktion.
- Säkerhetsskydd: Inkluderar åtkomstkontroll, kryptering och nätverksisolering för att skydda modellartefakter och känsliga inferensdata.
- Integreringsstöd: Ansluter direkt eller via API till MLOps-verktyg, CI/CD-pipelines och datainfrastruktur för att effektivisera kontinuerlig leverans och övervakning.
- Loggning och övervakning: Ger insyn i förfrågningsloggar, fördröjningsmätvärden och felfrekvenser för proaktiv felsökning och driftsäkerhet.
- Efterlevnad och granskningsbarhet: Tillhandahåller funktioner som granskningsloggar och stöd för regelefterlevnad, vilket hjälper dig att uppfylla branschkrav inom hälso- och sjukvård, finans eller andra reglerade områden.
Vanliga AI-funktioner
Utöver de vanliga funktionerna i verktyg för driftsättning av ML-modeller som listas ovan integrerar många av dessa lösningar AI med funktioner som:
- Automatiserad detektering av drift: Använder AI för att övervaka inkommande data och förutsägelser efter förändringar i fördelningen och varna team när omträning eller undersökning krävs för att bibehålla modellens noggrannhet.
- Intelligent resursallokering: Använder AI-algoritmer för att förutsäga arbetsbelastningsmönster och dynamiskt tilldela beräkningsresurser, vilket minskar kostnader och fördröjning utan manuell finjustering.
- Självläkande driftsättningar: Utnyttjar AI för att upptäcka misslyckade eller försämrade modellslutpunkter och automatiskt omdirigera trafik eller utlösa en ny driftsättning, vilket minimerar driftstopp och manuella ingripanden.
- Prediktiv skalning: Använder AI för att prognostisera trafiktoppar eller trafikminskningar baserat på historisk användning och skalar proaktivt infrastrukturen för att säkerställa jämn prestanda och kostnadskontroll.
- Avvikelsedetektering i inferens: Använder AI för att flagga ovanliga eller misstänkta förfrågningar om förutsägelser i realtid, vilket hjälper team att identifiera potentiella problem med datakvaliteten eller säkerhetshot.
- Automatiserad analys av grundorsaker: Använder AI för att analysera loggar och mätvärden och identifiera källan till prestandaförsämringar eller fel, så att team kan lösa problem snabbare och med mindre gissande.
Fördelar
Att implementera verktyg för driftsättning av ML-modeller ger flera fördelar för ditt team och din verksamhet. Här är några som du kan se fram emot:
- Snabbare distributionscykler: Automatiserad paketering, versionshantering och integrering med CI/CD-pipelines gör det möjligt för team att snabbt flytta modeller från utveckling till produktion.
- Konsekvent skalbarhet: Automatisk skalning och dynamisk resurshantering säkerställer att dina distributioner förblir stabila och responsiva när efterfrågan förändras.
- Starkare säkerhetsnivå: Inbyggda åtkomstkontroller, kryptering och revisionsloggning bidrar till att skydda modeller och känsliga data i enlighet med organisatoriska och regulatoriska krav.
- Minskad operativ arbetsbörda: Centraliserad övervakning, aviseringar och loggning minimerar manuell felsökning och frigör tekniska resurser för arbete med högre värde.
- Pålitlig modellstyrning: Versionshantering och distributionsloggning gör det enklare att spåra modeller, återställa ändringar och visa att kraven efterlevs under revisioner.
- Flexibel arbetsflödesintegrering: Stöd för flera ramverk, distributionsstrategier och miljökonfigurationer gör det möjligt för team att anpassa verktygens funktioner efter verksamhetens behov.
- Bättre beredskap för regelefterlevnad: Omfattande revisionsspår och funktioner för regelefterlevnad förenklar uppfyllandet av HIPAA-, GDPR- eller branschspecifika krav och minskar risken för reglerade verksamheter.
Kostnader och priser
För att välja verktyg för distribution av ML-modeller krävs en förståelse av de olika prismodellerna och abonnemangen som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar med verktyg för distribution av ML-modeller:
Jämförelsetabell för abonnemang
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisabonnemang | $0 | Begränsade distributioner, grundläggande övervakning, åtkomst för en användare och communitysupport. |
| Personligt abonnemang | $10-$30/användare/månad | Individuell användning, standardiserad modellversionshantering, måttlig resurstilldelning och e-postsupport. |
| Företagsabonnemang | $40-$100/användare/månad | Teamsamarbete, automatisk skalning, integrationsstöd, förbättrad säkerhet och rollbaserade åtkomstkontroller. |
| Enterprise-abonnemang | $150-$500+/användare/månad | Avancerad regelefterlevnad, premiumsupport, dedikerad infrastruktur, anpassade SLA:er samt utökade verktyg för revision och säkerhet. |
Vanliga frågor om verktyg för distribution av ML-modeller
Här är några svar på vanliga frågor om verktyg för distribution av ML-modeller:
Hur skiljer sig verktyg för distribution av ML-modeller från traditionella verktyg för distribution av applikationer?
Verktyg för distribution av ML-modeller är utformade för att hantera de unika utmaningarna med att tillgängliggöra, övervaka och uppdatera maskininlärningsmodeller, exempelvis hantering av modellversioner, spårning av inferensloggar, stöd för automatisk skalning av modelltrafik och integrering med datapipelines. Traditionella verktyg för applikationsdistribution hanterar vanligtvis inte den här typen av krav.
Kan jag distribuera modeller som har byggts i olika ramverk med samma distributionsverktyg?
Ja, de flesta verktyg för distribution av ML-modeller erbjuder kompatibilitet med flera ramverk, vilket gör att du kan distribuera modeller från TensorFlow, PyTorch, XGBoost med flera utan manuella konverteringar eller omskrivningar. Det gör det enklare för team att arbeta med olika tekniker och standardisera produktionsprocesser.
Vilka säkerhetsfunktioner bör man leta efter i dessa verktyg?
Leta efter funktioner som åtkomstkontroller, krypterade slutpunkter, revisionsspår och nätverksisolering. Dessa bidrar till att säkerställa att endast behöriga användare kan distribuera eller uppdatera modeller samt att dina modellresurser och dataprediktioner förblir säkra.
Har dessa verktyg stöd för både inferens i realtid och batchinferens?
Ja, ledande verktyg för distribution av ML-modeller stöder både realtidsbaserad prediktion via API:er och lägen för batchbearbetning. Det ger teamet flexibilitet att hantera olika användningsområden, från användarvända applikationer till stora offlinejobb för poängsättning.
Hur hjälper dessa verktyg till med modellövervakning och underhåll?
De erbjuder inbyggda instrumentpaneler för övervakning, aviseringar, loggning och automatisk detektering av drift. Dessa funktioner gör att du kan upptäcka försämrad prestanda, datarelaterade problem eller driftfel tidigt – ofta innan de påverkar slutanvändare eller verksamhetens resultat.